# bilibili-note
> **这是插件封装版**,衍生自上游原件 [`3588834014-del/bilibili-note`](https://github.com/3588834014-del/bilibili-note)。
>
> 本仓库 = 上游内容 + DSH bundle 插件封装(`package.json` / `cordis.patch.yml` / `lib/index.js`)。
> 只想要 skill 或 CLI、不需要当插件装的,请用上游原件。
> GitHub 不允许给自己的仓库建同名 fork,所以这里是**衍生副本**,不是 fork 网络里的 fork。
> 把 B站视频链接变成 Obsidian 结构化笔记的 **CLI** 与 dsh skill。
> **只拉字幕,绝不下载视频。**
>
> English: [README.md](README.md)
[](https://github.com/3588834014-del/bilibili-note/actions/workflows/ci.yml)
[](LICENSE)
[](https://www.python.org/)
---
## 它解决什么
把一条 B站视频链接固化成 vault 里的结构化笔记。反复执行的机械环节交给脚本,
需要判断的内容交给 agent,两边不混:
```mermaid
flowchart LR
A[B站链接] --> B["fetch
yt-dlp 取元数据 + ai-zh 字幕"]
B --> C["manifest.json
字幕全文 + 秒级段落"]
C --> D["agent 生成判断性内容
摘要 / 要点 / 总结 / 标签"]
D --> E["write
组装 + 写入 vault"]
E --> F["verify
结构自检"]
```
| 环节 | 谁做 | 怎么保证可复现 |
|------|------|----------------|
| 下载、解析、格式化、落盘、自检 | 脚本 | 命令与参数写死 |
| 一句话摘要、核心要点、总结、标签 | agent | SKILL.md 里的输入输出规约 |
**它不做什么**:不写逆向/爬虫代码(下载只走 yt-dlp),不碰签名算法与私有接口,
不下载视频或音频,字幕缺失时跳过而不是硬造内容。
---
## 真实产出
对一条真实视频执行 `fetch` —— 注意目录里**没有**什么:没有 `.mp4`、`.flv`、`.m4a`、`.part`,
只有字幕文件和它的 manifest。
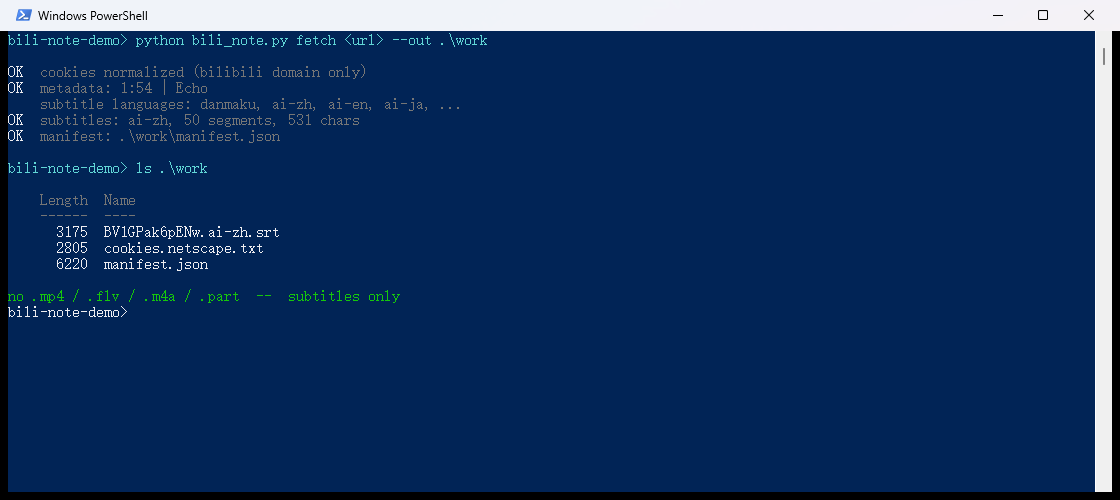
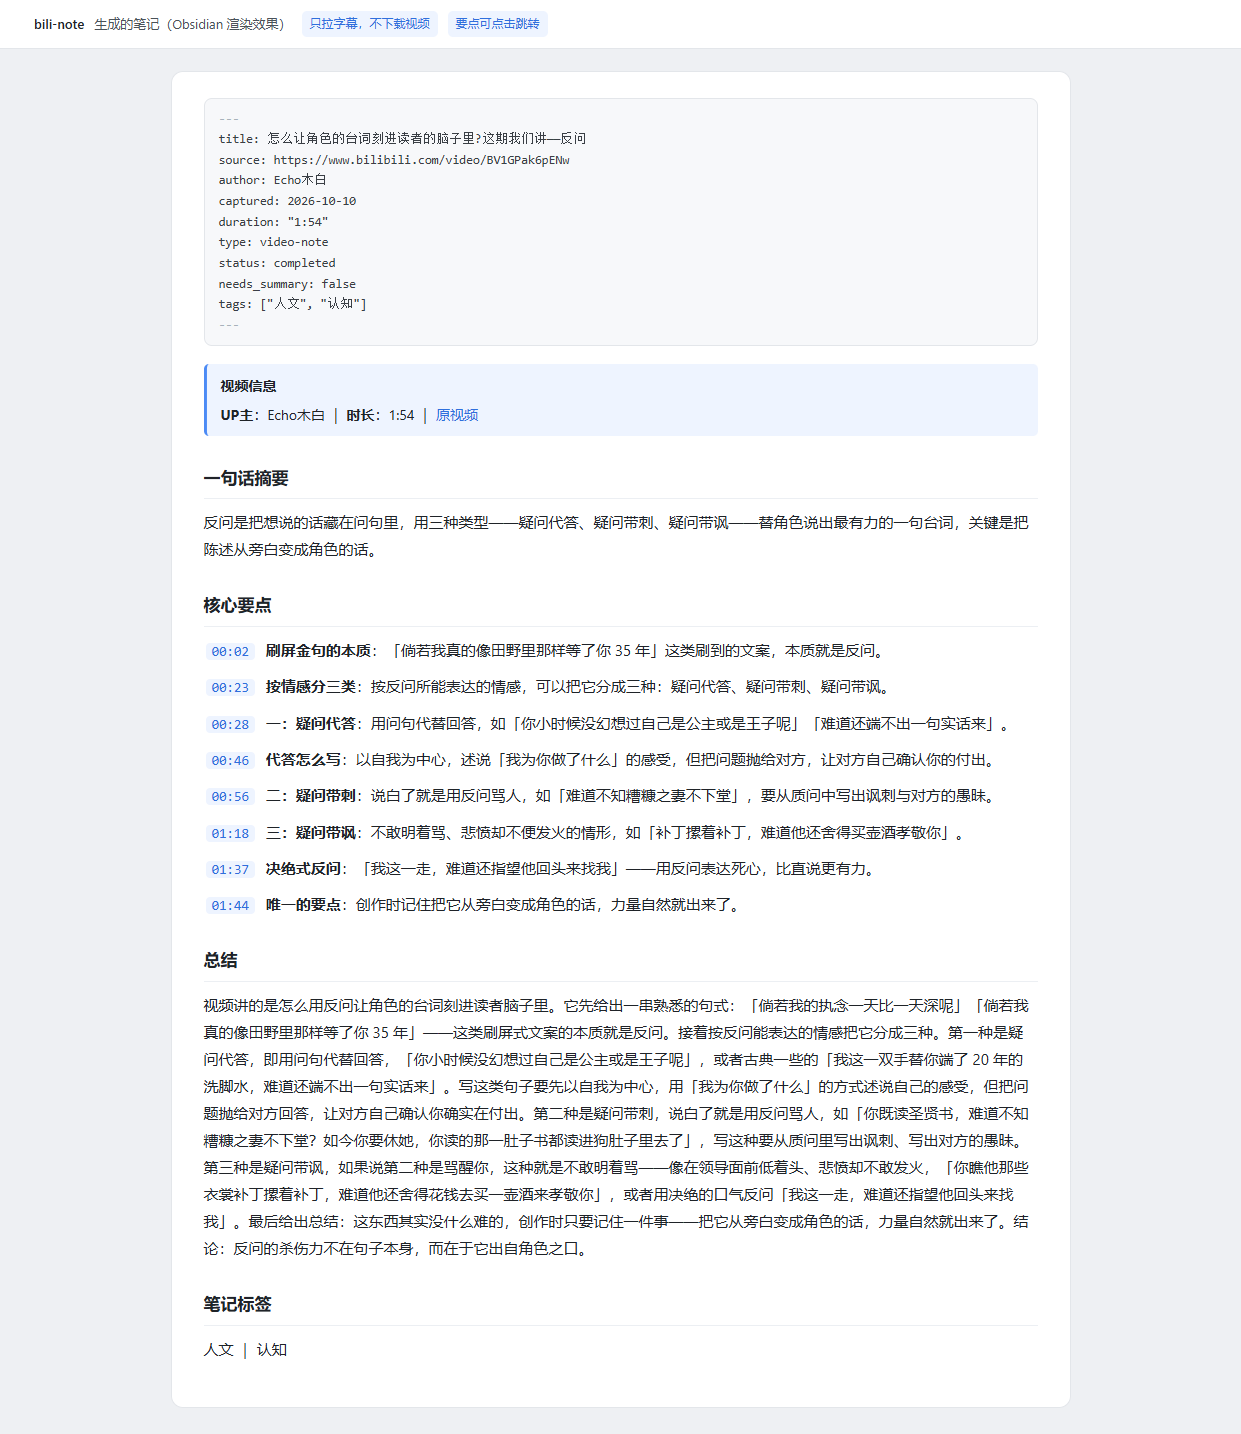
以及它生成的笔记(Obsidian 渲染效果:frontmatter、可点击的 `?t=` 跳转链接、摘要、要点、标签)。
截图来自真实运行,不是示意图:
---
## 安装
同一个实现支持三种用法:**DSH 插件**、**独立 CLI**、**手动放 skill 目录**。
三者共用 `scripts/bili_note.py`,行为不会出现两份。
### 作为 DSH 插件(DeepSeek Harness 用户推荐)
```bash
dsh plugin --profile web add github:3588834014-del/bilibili-note-plugin
```
这是标准的 **bundle 插件**:装完重启 profile,`bilibili-note` 就直接出现在 dsh 的 skill
目录里,不用手工往 `~/.agents/skills` 复制。用「B站笔记」或直接贴一条 BV 链接即可触发。
插件自带 `scripts/bili_note.py`、`docs/` 和 `SKILL.md`,并在注册时把 skill 正文里的
`` 占位符替换成**安装后的绝对路径**——模型不需要猜脚本在哪。
卸载:`dsh plugin --profile web remove dsh-bilibili-note`。
> 目前**还没有发 npm 包**,所以是源码安装:会被 [dsh-plugin.org](https://dsh-plugin.org)
> 收录,但不会出现在 dsh 内置的「插件中心」里。本包没有 `prepare` 脚本,安装时不会执行
> 任何构建代码。
### 作为 CLI
无第三方依赖(只用标准库),`yt-dlp` 是**外部命令**而不是 Python 包。
```bash
pipx install git+https://github.com/3588834014-del/bilibili-note.git
# 或
git clone https://github.com/3588834014-del/bilibili-note.git
cd bilibili-note && python -m pip install .
```
装完即可:
```bash
bili-note --version
bili-note note "https://www.bilibili.com/video/BVxxxxxxxxx" --note-dir ~/MyVault/Sources/Videos
```
### 作为普通 skill(不走插件系统)
仓库本身就是 skill 目录,复制到 dsh 的用户 skill 路径即可:
```bash
# Linux / macOS / Git Bash
git clone https://github.com/3588834014-del/bilibili-note.git
mkdir -p ~/.agents/skills
cp -r bilibili-note ~/.agents/skills/
```
```powershell
# Windows PowerShell
git clone https://github.com/3588834014-del/bilibili-note.git
Copy-Item -Recurse -Force .\bilibili-note "$env:USERPROFILE\.agents\skills\bilibili-note"
```
或用仓库里的安装脚本(自动跳过测试与缓存目录):
```bash
python scripts/install.py # 装到 ~/.agents/skills/bilibili-note
python scripts/install.py --dry-run # 只看会复制什么
```
装好后 dsh 会把它列进 skill 目录,用「B站笔记」之类的触发词即可唤起。
### 前置条件
| 依赖 | 说明 |
|------|------|
| `yt-dlp` | **唯一允许的下载通道**。`pip install -U yt-dlp` |
| B站登录 cookie | AI 字幕需要登录态,见下节 |
| Python 3.8+ | 只用标准库 |
| DSH `>=0.2.0-rc.2 <0.3.0` | 仅插件 / skill 用法需要 |
### 权限与外部依赖
装之前值得知道这个工具会碰什么:
- **网络**:只通过 `yt-dlp` 访问 `bilibili.com`,且只下载**字幕**,不下载视频与音频
(`--skip-download` 是硬性参数,脚本会校验工作目录里没有媒体文件)。
- **凭据**:从 `$BILI_COOKIES` 或 `./cookies.txt` 读取 B站 cookie,会在工作目录旁生成一份
**归一化后的临时副本**喂给 yt-dlp;不上传、不打印、不提交。
- **文件系统**:只写你传入的 `--note-dir` 与一个临时工作目录,不碰其它路径。
- **无遥测、无额外依赖、无逆向接口。**
---
## 配置 cookie(必做)
B站的 AI 字幕接口需要登录态,所以必须先导出 cookie:
1. 浏览器安装扩展 **Get cookies.txt LOCALLY**
2. 打开并登录 [bilibili.com](https://www.bilibili.com)
3. 点扩展图标 → Export → 导出 `cookies.txt`
4. 放到**当前工作目录**,或用环境变量指定:
```bash
export BILI_COOKIES=/path/to/cookies.txt # Linux / macOS
$env:BILI_COOKIES = "C:\path\cookies.txt" # PowerShell
```
> 只有 UP 主自行上传了字幕的视频才能跳过这一步。
### ⚠️ 为什么不能把导出文件直接喂给 yt-dlp
这是本仓库最值得知道的一个坑。该扩展导出的行长这样:
```
.bilibili.com FALSE / FALSE 1819635894 SESSDATA xxxxx
```
domain 带前导点 `.`,但第 2 列的 host-only 标志是 `FALSE`。Python 的
`http.cookiejar` 内部有一条断言:
```python
assert domain_specified == initial_dot
```
两者不一致 → 抛 `LoadError` → yt-dlp 直接拒绝加载整个文件:
```
ERROR: invalid Netscape format cookies file '...': '.bilibili.com\tFALSE\t/...'
```
结果是**字幕永远拿不到,而报错看起来像"这个视频没有字幕"**。
解法是归一化:去掉 domain 前导点并把标志置为 `FALSE`(host-only cookie
仍然会发给 `api.bilibili.com` 等子域,登录态不丢)。`bili_note.py` 的
`normalize_cookies()` 做的就是这个,附带过滤出 bilibili 域(导出文件通常混有
其他站点的 cookie)和按 domain/path/name 去重。
---
## 输出目录
脚本不内置任何默认库路径——不同机器的 vault 位置不同,硬编码一个"看起来对"的
路径只会在别处静默创建出空目录。二选一:
```bash
# 方式一:显式传参
python scripts/bili_note.py write --work ./work --note-dir "/Sources/Videos"
# 方式二:环境变量
export BILI_VAULT="/path/to/MyVault"
export BILI_TARGET_DIR="Sources/Videos" # 可选,默认值
```
---
## 用法
### 用 CLI(推荐)
```bash
# 一步到位:抓字幕 + 写笔记
bili-note note "https://www.bilibili.com/video/BVxxxxxxxxx" --note-dir "/Sources/Videos"
# 带上判断性内容(摘要/要点/总结/标签)
bili-note note "" --note-dir "/Sources/Videos" --content-file content.json
# 分两步:先只抓字幕,供 agent 读 manifest
bili-note fetch "" --out ./work
bili-note write --work ./work --note-dir "/Sources/Videos" --content-file content.json
# 结构自检
bili-note verify --note "<笔记路径>"
# 环境自检:cookie / yt-dlp / 输出目录(不联网)
bili-note selftest
```
`selftest` 回答的正是你实际会遇到的那个问题——**"为什么拿不到字幕?"**——先排除环境原因,再去怀疑代码:
```
✓ cookie 文件:C:\Users\me\cookies.txt
✓ 含 SESSDATA 登录态:…
✓ yt-dlp:C:\...\yt-dlp.EXE
✗ 输出目录:未配置(传 --note-dir,或设 BILI_VAULT/BILI_TARGET_DIR)
```
### 直接跑仓库里的脚本(不安装)
```bash
# 1. 取元数据 + 字幕(只拉字幕,不拉视频)
python scripts/bili_note.py fetch "https://www.bilibili.com/video/BVxxxxxxxxx" --out ./work
# 2. agent 读 work/manifest.json 生成判断性内容,写成 content.json
# 3. 组装并写入笔记(不给 --content-file 则产出草稿)
python scripts/bili_note.py write \
--work ./work \
--note-dir "/Sources/Videos" \
--content-file content.json \
--processed "/Sources/Videos/.processed.json"
# 4. 结构自检
python scripts/bili_note.py verify --note "<笔记路径>"
```
`fetch` 会打印每个环节的结果:
```
✓ cookie 归一化:…(33 条 bilibili 域 cookie)
✓ 元数据:视频标题(UP主)|时长 12:34
可用字幕语言:danmaku, ai-zh, ai-en
✓ 字幕:ai-zh,134 段,1625 字
✓ manifest:/path/to/work/manifest.json
```
### content.json 的形状
```json
{
"summary": "一句话摘要(60-120 字,结论前置)",
"body": "总结正文(200-400 字,讲清论证链条与结论)",
"tags": ["认知", "人文"],
"cards": ["CC_示例"],
"bullets": [
{"time": 0, "title": "小标题", "text": "一句话说明"},
{"time": 23, "title": "小标题", "text": "一句话说明"}
]
}
```
`time` 填**秒数**,脚本负责渲染成 `MM:SS` 和跳转链接。`title` 和 `cards` 可省略。
---
## 产出的笔记长什么样
```markdown
---
title: 视频标题
source: https://www.bilibili.com/video/BVxxxxxxxxx
author: UP主
captured: 2026-01-01
duration: "12:34"
type: video-note
status: completed
needs_summary: false
tags: ["认知", "人文"]
---
> [!info] 视频信息
> **UP主**:UP主 | **时长**:12:34 | [原视频](https://www.bilibili.com/video/BVxxxxxxxxx)
## 一句话摘要
……
## 核心要点
|- [00:00](https://www.bilibili.com/video/BVxxxxxxxxx/?t=0s) **小标题**:说明
|- [00:23](https://www.bilibili.com/video/BVxxxxxxxxx/?t=23s) **小标题**:说明
## 总结
……
## 笔记标签
认知 | 人文
## 相关卡片
- [[CC_示例]]
## 原始字幕
> [!quote]- 完整字幕(点击展开)
> ……(已清理时间码与序号的纯文本)
```
> 要点行的 `|- ` 行首看着像坏掉的表格,但它是**故意的**——下游归档管线的校验器
> 只认这个形状。原因和全部格式约定见 [docs/FORMAT.md](docs/FORMAT.md)。
---
## 测试
无需网络、无需 cookie:
```bash
python -m unittest discover -s tests -v
```
108 个测试,覆盖 SRT 解析与时间戳清理(含 LF/CRLF/BOM、多行 cue、超 1 小时、
HTML 与 ASS 标签、含 `<` `>` 的正文、零宽字符、重复句、空 cue)、两种时间戳
格式化、要点行与下游管线的契约、草稿字面量契约、cookie 归一化、
URL 规范化(含分 P 参数与追踪参数)、多 P 合集时间戳平移与字幕文件选取、
合集重复分 P 检测、落盘与去重、`verify` 的正反用例、CLI 接线、
Python 最低版本兼容性守卫、仓库卫生。
CI 在 Linux + Windows × Python 3.8/3.10/3.12 上跑同一套测试,见
[.github/workflows/ci.yml](.github/workflows/ci.yml)。
---
## 已知限制
- **只支持 B站**。yt-dlp 支持的其他站点不在设计范围内。
- **多 P 合集自动合并**。yt-dlp 对 `...BVxxx` 默认只取 p1;本 skill 会识别合集并
逐分 P 抓字幕、按累计时长平移时间戳拼成连续时间轴(实测 6 分 P / 2:10:32 的合集
得到 2807 段)。传 `...BVxxx?p=6` 则只取该分 P。抓取较慢(每分 P 两次请求),
2 小时合集约 2 分钟;某分 P 无字幕时跳过但保留其时间占位,时间轴不错位。
- **依赖 B站的 AI 字幕**。视频没有字幕(且 UP 主未上传)时跳过,不做语音转写。
视频若需转写,属另一个工具链,本 skill 刻意不引入 ffmpeg/whisper 依赖。
- **AI 字幕有识别错误**。`ai-zh` 由语音识别产生,常有错字漏字。处理边界是:
引语照抄识别结果不"顺手改对"、能合理还原的按语义概括而不写成引号引语、
完全不可解的直接丢弃不猜。详见 SKILL.md §2.6。
- **超 1 小时的要点时间戳**用总分钟数(`[93:31]`),刻意不做小时进位——这是与
语料对齐的结果,不是 bug。
- ⚠️ **超过 99 分钟的视频会触发下游校验器漏判。** 要点标签是总分钟数,所以
100 分钟之后的标签是 **3 位数**(`[100:00]`、`[123:49]`);语料里唯一的 3 位
标签就是这么来的。但下游校验器的正则是 `^\|- \[[0-9]{2}:[0-9]{2}\]`,
**只认 2 位分钟**,于是长视频笔记会被判「要点不足」。实测:2:10:32 的合集里
**24%** 的时刻分钟数是 3 位,最早出现在 100:00。本仓库的 `bilibili2obsidian`
侧工具已把该正则放宽为 `{1,3}`;`verify` 对这类笔记**放行但打印警告**。
---
## 贡献
欢迎 issue 和 PR。改格式相关的东西之前请先读 [docs/FORMAT.md](docs/FORMAT.md),
并确保 `python -m unittest discover -s tests` 仍然全绿——测试套件里
`TestDownstreamContract` 就是拿来钉死这些契约的。
---
## License
[MIT](LICENSE)