# RecallNest
**面向任意 AI 客户端的共享记忆层 —— CLI agent、桌面 app、你自己的脚本**
*一套记忆,每个客户端,上下文跨窗口延续——也跨机器。*
基于 LanceDB 的本地优先记忆系统,把散落在各个终端的对话历史沉淀为可复用知识,跨终端共享,自动召回。
[](https://github.com/AliceLJY/recallnest)
[](LICENSE)
[](https://bun.sh)
[](https://lancedb.com)
[](https://modelcontextprotocol.io)
[](https://github.com/AliceLJY/recallnest/actions/workflows/ci.yml)
[](https://github.com/AliceLJY/recallnest)
[English](README.md) | **简体中文** | [Roadmap](ROADMAP.md) | [项目主页](https://aliceljy.github.io/recallnest/)
---
## 为什么需要 RecallNest?
编程 Agent 每开一个窗口就失忆。项目配置、调试决策、实体映射——散落在 Claude Code、Codex、Kimi、Antigravity 以及你打开的每一个终端里,互相不通。
RecallNest 是**一个 LanceDB 驱动的记忆层,你所有的 Agent 共读共写**。一个窗口存入的上下文,另一个窗口能召回。会话退出时 checkpoint,启动时 resume。记忆会衰减、演化、自组织——它不是一堆等你 grep 的日志。
### 一次召回长什么样
```text
Query : deploy rollback
Hits : 5
# ID Score Category Tier Source Date Age Retrieval Path
1 ee79037a 46.1% cases peripheral cc 2026-08-25 2d vector
[assistant] Rolled back to the previous image and pinned the digest so the next…
prov : evidence/transcript-ingest
imgs : 52 agent-made in this session · read sess=dca70d4a
```
这一小块里有三样东西,几乎就是整个设计:
- **`Source cc` · `Age 2d`** —— 它出自两天前的一个 Claude Code 窗口,而你正在另一个终端、
甚至另一台机器上读它。整个项目就建在这个前提上。
- **`prov : evidence/…`** —— 每一行都标着自己待在哪一层。从对话里刮下来的碎片,永远没资格
冒充你真正做过的决定;要变成稳定记忆,得另走一道带证据门槛的提升流程。
- **`imgs : …`** —— 那个 session 里有 52 张图,**一张都没进数据库**。这一行的存在只是让你知道
那儿有东西可看,而产生它没花一次模型调用、没多一个向量、没占一份存储。
> 上面这一行来自「对话原文入库」。2026-10-06 起这一步默认关:`ingest` 不再把对话记录切块写进库,
> 默认配置下库里只有你存进去的记忆、提炼产物和记忆文件,原始对话交给专门的会话检索工具去查。
> 要让库里重新出现这样的行,见下文「索引已有对话」。
最后这条就是整套做法的缩影:**只存"让一样东西能被找到"所需的部分,不存"将来可能被问到"的一切。**
完整的推理——包括最显然的那种实现错在哪两个地方——在
[图片:可寻址,而不是被编码](#图片可寻址而不是被编码)。
## 核心能力
### 接入与安装
| 能力 | 说明 |
|---|---|
| **CC Plugin** | 一行命令装入 Claude Code,无需手动配置 MCP |
| **共享索引** | 所有客户端共用同一个 LanceDB 存储,跨机指向 `ssh` 即可共用真相源 |
| **双通道接入** | MCP(stdio)给 CLI agent 与能填 MCP 配置的 GUI app + HTTP API 给只会发请求的客户端 |
| **一键接入** | 集成脚本同时安装 MCP 和 continuity 规则 |
### 检索与连续性
| 能力 | 说明 |
|---|---|
| **混合检索** | 6 通道:向量 + BM25 + L0/L1/L2 多向量 + KG 图(PPR)。默认只走向量(2026-06 起),BM25 融合与图扩展要在配置里打开 |
| **4 套检索策略** | default、writing、debug、fact-check —— 按任务类型调优 |
| **会话连续性** | `checkpoint_session` + `resume_context`(full/light/summary 三种模式)+ 仓库状态守卫 |
| **会话蒸馏** | 3 层对话压缩:微缩 → LLM 结构化摘要 → 知识提取 |
| **对话导入** | 支持 Claude Code、Claude.ai、ChatGPT、Slack、纯文本 |
| **Topic Tags** | scope 内 topic 分区,自动检测,搜索时可过滤 |
| **关联 scope 侧栏** | 显式传 `includeRelatedScopes` 时,按 `scopeRelations` 白名单额外检索,并和主 scope 排序分开展示 |
### 记忆生命周期与治理
| 能力 | 说明 |
|---|---|
| **记忆演化** | Supersede 链、衰减评分、LLM 重要性、聚合、归档 |
| **显式升级** | Evidence → Durable Memory,带冲突守卫、合并决议、审计日志 |
| **隐私分级** | 4 级(`ephemeral` / `private` / `durable` / `shared`)+ 级联遗忘 |
| **准入控制** | 写入时门控:噪音过滤、重要性下限、去重、限流 |
| **Memory Lint** | 矛盾、重复、过期、孤儿检测 + 健康评分 |
| **离线整合** | `dream` 命令:聚类、合并、修剪积累的记忆 |
### 推理与结构
| 能力 | 说明 |
|---|---|
| **Knowledge Graph** | 实体关系图 + PPR 算法,支持多跳问题 |
| **建构式检索** | 多源候选扩展 + 溯源锚定的上下文重建 |
| **叙事架构** | 三层自传式元数据(生命阶段 → 一般事件 → 具体事件) |
| **Skill Memory** | 存储、检索、自动提升来自重复模式的可执行技能 |
| **预测式提醒** | 行为信号预测引擎,主动浮现"你可能需要这个" |
| **6 类记忆** | profile、preferences、entities、events、cases、patterns —— 类别分化合并策略 |
### 可视化与运维
| 能力 | 说明 |
|---|---|
| **Dashboard** | Web UI 首页:统计卡片、类别分布、增长趋势、健康概览 |
| **Workflow Observation** | 专门的 append-only 工作流观测层,不混入普通 memory |
| **结构化资产** | Pin、Brief、Distill —— 不只是原始日志 |
| **Data Checkup** | 记忆存储数据质量健康检查(含数据源健康) |
| **数据源心跳** | 按数据源自动追踪 ingest 健康状态,过期告警 |
| **导出图谱** | 导出交互式 HTML 知识图谱可视化 |
| **批量操作** | 单次调用存储最多 20 条记忆,自带去重 |
| **Connector 框架** | 标准 connector-v1 格式接入外部数据源,附带适配器示例 |
---
## 架构
```
CLIENTS ACCESS CORE ENGINE STORAGE
────────────────────── ─────────────────────── ──────────────────────────── ──────────────────────
Claude Code MCP over stdio Retriever LanceDB
Codex ───▶ 44 tools, 3 tiers ───▶ vector · hybrid opt-in ───▶ vector + columnar
Kimi · Antigravity Classifier · 6 categories
Doubao desktop Context composer
HTTP API :4318 resume_context Jina embeddings v5
your scripts · cron ───▶ 21 endpoints ───▶ Decay · Weibull half-life ─▶ 1024-dim, task-aware
Conflict · audit + merge
phone app ───▶ read-only gateway ───▶ Capture: evidence → durable
:8791, token-gated
```
> 图内保留英文术语:等宽字体下中文占两格,混排会把对齐打乱。四段从左到右分别是
> 客户端、接入层(MCP / HTTP / 只读网关)、核心引擎、存储层。
>
> Retriever 一格:`retrieval.mode` 默认是 `"vector"`(纯向量检索);在 `config.json` 里改成 `"hybrid"`
> 后,会加上 BM25 全文检索,并与向量结果做加权分数融合(默认 `vectorWeight` 0.7 / `bm25Weight` 0.3)。
### 内部设计
- **L0 / L1 / L2 动态折叠** —— 每条记忆存储 3 个粒度层(一句话 / 要点概要 / 完整内容);检索时根据相关性分数和 token 预算动态选择返回哪个层级
- **Weibull 衰减 + 情绪调制** —— 记忆沿参数化 Weibull 曲线衰减;情绪显著性可额外延长半衰期最高 30%
- **向量预筛 + LLM 去重** —— 90% 的去重决策用低成本余弦相似度(≥ 0.92);仅临界情况调用 LLM 判断
- **类别分化合并策略** —— `profile` 和 `preferences` 采用冲突合并(新版覆盖);`events` 和 `cases` 采用追加(保留历史)
- **展示分 vs 淘汰分双轨制** —— 检索使用双轨评分:tier floor 防止核心记忆被淘汰,decay boost 让新鲜记忆临时浮现而不永久挤掉稳定记忆
> 完整架构详解:[`docs/architecture.md`](docs/architecture.md)
---
## 谁能接上
**数据层不知道你的客户端长什么样。** RecallNest 把同一个 LanceDB 存储通过三个出口暴露出来,接法按客户端的能力选,而不是绑死在某一种协议上。
| 你的客户端能做什么 | 走哪条 | 已验证 |
|---|---|---|
| 执行本地命令(CLI agent) | **MCP over stdio** | Claude Code、Codex、Kimi、Antigravity |
| 执行本地命令(GUI app,手填 MCP 配置) | **MCP over stdio** | 豆包桌面端——与 Cherry Studio / ChatBox 同一形态 |
| 只会发 HTTP 请求 | **HTTP API** | 自定义 agent、脚本、定时任务 |
| 跑在另一台机器上 | 把 stdio 启动命令换成 `ssh recallnest-mcp` | 笔记本上的四个客户端共读家里服务器上的同一个库 |
两条值得直说的推论:
- **不绑单一协议。** 支持填 MCP 配置的 GUI 聊天 app,接入方式和终端里的 agent 完全一样;只会发 HTTP 请求的客户端,读到的仍是同一份记忆。
- **不绑单台机器。** 因为 MCP 传输走 stdio,启动命令由你定义——把它指向 `ssh`,每台机器上的每个客户端共用同一个真相源,而不是各自长出一个数据库。
接一个新客户端不等于要改 RecallNest:够格的客户端自己写一行配置,能力受限的在 HTTP API 前面加一层薄网关。
### 手机上的 AI app:只读网关
HTTP API(`:4318`)只监听 `127.0.0.1`,并且会拒绝任何 Host 头不是本地的请求——这是**有意的**:它同时暴露写入路由(`/v1/store`、`/v1/checkpoint`),直接开到公网等于把写权限交出去。
所以要让手机上的 AI app 读到同一份记忆,前面加一层只读网关:
```bash
openssl rand -hex 32 > ~/.config/recallnest/gateway-token
chmod 600 ~/.config/recallnest/gateway-token
bun run api # 本机 API,:4318
bun run gateway # 只读网关,:8791 → 转发到 :4318
```
网关只放行读路由(`/recall`、`/search`、`/stats`、`/health`),**任何写路由一律 404**;Bearer token 常量时间比较、每分钟限流、请求与响应都有大小上限。把它放到隧道后面(Tailscale Serve/Funnel、Cloudflare Tunnel 等)即可从手机访问。
```bash
curl -X POST https://<你的隧道地址>/recall \
-H "Authorization: Bearer $(cat ~/.config/recallnest/gateway-token)" \
-H 'content-type: application/json' \
-d '{"query":"上次那个部署问题怎么解决的","limit":3,"allScopes":true}'
```
可选:配 `RECALLNEST_GATEWAY_FILE_ROOTS="notes=/abs/path,wiki=/abs/path"` 会多出一个 `GET /files/search`,用 ripgrep 只读检索你指定的 markdown 目录(查询词以 argv 传入,不经过 shell)。不配就没有这个路由。
> 网关默认也只绑 `127.0.0.1`——把它暴露到公网是隧道的职责,请自行评估风险。
作者用这条路把 iPhone 上的 [OpenMinis](https://github.com/OpenMinis/OpenMinis) 接了上来:手机 app 经 Tailscale Funnel 打到网关,能查到同一份记忆库。有意思的是它查回的是**它自己**的历史——那些对话导出后回流、被索引,于是一个每次冷启动的手机 agent 有了跨会话的记忆。
## 快速开始
### 方式 A:Claude Code Plugin(推荐)
```bash
/plugin marketplace add AliceLJY/recallnest
/plugin install recallnest@AliceLJY
```
RecallNest 随 Claude Code 自动启动,无需手动配置 MCP。
安装时 Claude Code 会提示填写 Jina API key。密钥由 Claude Code 的敏感插件配置保存;自动生成的配置和 LanceDB 数据库则放在插件持久数据目录,不会混进按版本更新的插件缓存。
> Claude Code 插件与 npm 包共用同一个发布版本,并随版本发布同步更新。
>
> **前置要求:** [Bun](https://bun.sh)。首次启动自动安装依赖。
### 方式 B:npm 安装
```bash
npx recallnest --help # 直接运行
# 或
npm install -g recallnest # 全局安装
recallnest doctor
```
支持 Node.js 22+(通过 tsx)或 Bun,无需 clone 仓库。
### 方式 C:手动安装
```bash
git clone https://github.com/AliceLJY/recallnest.git
cd recallnest
bun install
cp config.json.example config.json
cp .env.example .env
# 编辑 .env → 填入 JINA_API_KEY
```
### 启动服务
```bash
bun run api
# → RecallNest API running at http://localhost:4318
```
### 试一下
```bash
# 存入一条记忆
curl -X POST http://localhost:4318/v1/store \
-H "Content-Type: application/json" \
-d '{"text": "用户偏好暗色模式", "category": "preferences"}'
# 搜索记忆
curl -X POST http://localhost:4318/v1/recall \
-H "Content-Type: application/json" \
-d '{"query": "用户偏好"}'
# 查看统计
curl http://localhost:4318/v1/stats
```
### 接入终端
```bash
bash integrations/claude-code/setup.sh
bash integrations/agy/setup.sh
bash integrations/codex/setup.sh
```
每个脚本会同时安装 MCP 和 continuity 规则,新窗口自动触发 `resume_context`。
### 索引已有对话
```bash
bun run src/cli.ts ingest --source all
bun run seed:continuity
bun run src/cli.ts doctor
```
2026-10-06 起,`ingest` 默认只做两件事:对账记忆文件(`sources.memory`),以及把 Minis 投递目录里的文件挪进
`data/minis-archive`。六个对话来源(cc / codex / kimi / gemini / desktop / minis)不切片、不嵌入、不写库。
要把对话原文也索引进来,在运行 `ingest` 的环境里设 `RECALLNEST_TRANSCRIPT_INGEST=on`(只认 `on` 这一个写法)。
关着期间挪进存档的 Minis 对话不会自动补进来,要补就把文件从 `data/minis-archive` 拷回投递目录再跑。
---
## 图片:可寻址,而不是被编码
对话里有图,而文本记忆层没有。通常的答案是上一个多模态 embedding 模型,把每张图编码进
和文字同一个向量空间。那个答案对相册和商品库是对的,放在这里却是错的形状,理由很便宜:
**在对话里,一张图几乎从不孤零零地出现。** 它总被"你看这个报错"包着,而紧跟其后的回复
通常已经描述了图里是什么。图周围的文字,本来就是这张图的索引。缺的从来不是对像素做语义
检索,而是**知道那儿有一张图**。
所以 RecallNest 不编码图片。它只记下**这条记忆所属的 session 里有几张图**,剩下的交给你判断
要不要去翻原始对话。图的含义在需要的那一刻、由当时在问的那个模型现场解读。
代价值得说清楚:**不需要多模态模型,不重新 embedding,不存图片,不改动任何一个向量。**
给存量的 21,319 条记忆补上这个标记,只动了 metadata。
这里面有两个不那么显然的选择,而且两次的第一版都是错的。
### 粒度取 session,是故意的
标记数的是整个 session,不是单轮——比第一眼该有的粒度更粗,而粗正是重点。
一轮如果只有一张截图、几乎没有文字,它根本过不了长度闸,压根没进过库。在真实对话上实测,
**含用户贴图的轮次里有 12.5% 是整轮被丢掉的**——而且丢的恰恰是最值钱的那些:七张截图一个字
没配,或者「操作步骤在这里」配一张图、而那张图**就是**步骤本身。轮次级的标记,对最该被找到的
那批图**无处可挂**。session 级的标记会落到同一个 session 里**其他**进了库的记忆上,而那些才是
搜索会捞出来的东西。
代价不加掩饰:同一个 session 的每条记忆都带同一个数字,所以那些图未必和你眼前这一条有关。
输出里写的是 `in this session` 而不是 `in this memory`,就是为了这个。
### 分成两类,因为它们回答的不是同一个问题
| 类别 | 是什么 | 回答什么问题 |
|---|---|---|
| user-pasted | 人贴进消息里的图 | *我发过的那张截图在哪?* |
| agent-made | 这个 session 产生的其余所有图 | *那个页面当时长什么样?我当时生成的图是哪张?* |
只留第一类很诱人——人翻自己的记忆,想找的是自己的截图。但一个 agent 回溯自己干过的活,
要的是第二类:它画的示意图、它截的渲染结果、它为一篇文章配的插图。**1,767 个带图 session 里,
有 1,103 个一张人贴的图都没有。** 只留第一类,这些 session 就全哑了——而它们恰恰是 agent
做了大量视觉工作的那些。
### 第二类是补集,不是清单
第一版的实现是靠**枚举**定义"AI 产的图":`tool_result` 里的、`payload.output` 里的、
`tool.result` 里的。每一个位置都真实存在,这份清单依然是错的,因为**图片可能出现的方式只会
越来越多**,而枚举会悄无声息地漏掉它没预料到的那一种。
所以第二类改成了补集:数出这条记录里所有的图片信号,减去能明确认定为"人贴的",剩下的
一律归入,不问它从哪儿来。在 9,619 份对话记录上:
| | 枚举 | 补集 |
|---|---|---|
| AI 产的图 | 5,812 | **10,938** |
| 有图的 session | 1,507 | **1,767** |
| 人贴的图 | 1,629 | 1,629 |
**枚举漏掉了 5,126 张图和 376 个 session**,接近一半。漏得最多的是**生图**——它待在那份清单
知道的两个容器之外。而人贴的图在两种口径下数字完全一致,这正是关键的校验点:放宽第二类
没有污染精确的第一类。有一条回归测试钉住这件事:它喂给解析器一个源码里从未出现过的
`image_generation_call`,断言它落进第二类;在枚举式实现下那条测试必红。
一点诚实的说明:补集数的是*信号*,不是确认过的图片张数。一次生图可能同时留下调用和完成
两条记录,被数成两张。这个方向是刻意选的——它要回答的是"这儿有没有东西可看",而不是
"到底几张"。
## 接口
RecallNest 提供两种接口:
- **MCP(stdio)** —— 给任何能启动一条命令的客户端:CLI agent(Claude Code、Codex、Kimi、Antigravity)与能填 MCP 配置的 GUI app(豆包、Cherry Studio、ChatBox)
- **HTTP API** —— 给自定义 Agent、SDK 应用和任何 HTTP 客户端使用
### Agent 框架示例
示例代码位于 [`integrations/examples/`](integrations/examples/):
| 框架 | 示例 | 语言 |
|------|------|------|
| [Claude Agent SDK](integrations/examples/claude-agent-sdk/) | `memory-agent.ts` | TypeScript |
| [OpenAI Agents SDK](integrations/examples/openai-agents-sdk/) | `memory-agent.py` | Python |
| [LangChain](integrations/examples/langchain/) | `memory-chain.py` | Python |
---
MCP 工具(44 个)
| 工具 | 说明 |
|------|------|
| `workflow_observe` | 存储 append-only 工作流观察记录;支持 `idempotencyKey` 防重复写入 |
| `workflow_health` | 查看工作流健康状态或降级面板 |
| `workflow_evidence` | 构建工作流证据包 |
| `store_memory` | 存储一条持久记忆 |
| `store_workflow_pattern` | 存储可复用工作流模式 |
| `store_case` | 存储问题-方案对 |
| `promote_memory` | 显式升级 evidence 为持久记忆 |
| `promote_scan` | 扫描近期 evidence,自动晋升合格记忆为持久存储 |
| `promote_synthesis` | 扫描 dream 合成出的结论,把自身证据集撑得住的那些晋升为持久记忆 |
| `list_conflicts` | 列出或查看冲突候选 |
| `audit_conflicts` | 汇总过期/升级的冲突优先级 |
| `escalate_conflicts` | 预览或应用冲突升级元数据 |
| `resolve_conflict` | 解决冲突(保留 / 接受 / 合并) |
| `checkpoint_session` | 保存当前工作状态;支持 `idempotencyKey` 防重复写入 |
| `latest_checkpoint` | 查看最近的 checkpoint |
| `resume_context` | 为新窗口编排启动上下文 |
| `search_memory` | 任务开始时主动召回 |
| `explain_memory` | 解释为什么这些记忆被匹配 |
| `distill_memory` | 将结果蒸馏为精简摘要 |
| `brief_memory` | 创建结构化摘要并重新索引 |
| `pin_memory` | 将记忆升级为 Pin 资产 |
| `export_memory` | 导出蒸馏摘要到磁盘 |
| `list_pins` | 列出所有 Pin |
| `list_assets` | 列出所有结构化资产 |
| `list_dirty_briefs` | 预览过时的 Brief 资产 |
| `clean_dirty_briefs` | 归档过时 Brief 并移除索引 |
| `memory_stats` | 查看索引统计 |
| `memory_drill_down` | 查看记忆完整元数据和溯源 |
| `auto_capture` | 启发式提取记忆信号(零 LLM) |
| `set_reminder` | 设置前瞻记忆提醒 |
| `consolidate_memories` | 聚类合并近似记忆(默认 dry-run) |
| `store_skill` | 存储可执行技能 |
| `retrieve_skill` | 按语义相似度检索技能 |
| `scan_skill_promotions` | 扫描可升级为技能的候选 |
| `manage_alias` | 新增、删除、列出或解释 BM25 用户查询别名 |
| `list_tools` | 按层级发现工具(core/advanced/full) |
| `batch_store` | 批量存储最多 20 条记忆 |
| `distill_session` | 三层管线蒸馏对话为结构化知识 |
| `import_conversations` | 导入 Claude Code、ChatGPT、Slack 等对话 |
| `data_checkup` | 运行数据质量健康检查 |
| `dream` | 离线记忆整合(聚类、合并、修剪) |
| `memory_lint` | 记忆质量检查:矛盾、重复、过期、孤儿 |
| `forget_memory` | 删除记忆,连同它的 KG 三元组、trigger 行和由它生成的 pin 的索引副本,pin 文件归档,删后回读核对,写审计 |
| `export_graph` | 导出交互式 HTML 知识图谱 |
HTTP API(21 个端点)
基地址:`http://localhost:4318`
| 端点 | 方法 | 说明 |
|------|------|------|
| `/v1/recall` | POST | 快速语义搜索 |
| `/v1/store` | POST | 存储一条记忆 |
| `/v1/capture` | POST | 批量存储结构化记忆 |
| `/v1/pattern` | POST | 存储工作流模式 |
| `/v1/case` | POST | 存储问题-方案对 |
| `/v1/promote` | POST | 升级 evidence 为持久记忆 |
| `/v1/conflicts` | GET | 列出冲突候选 |
| `/v1/conflicts/audit` | GET | 冲突审计汇总 |
| `/v1/conflicts/escalate` | POST | 冲突升级 |
| `/v1/conflicts/resolve` | POST | 解决冲突 |
| `/v1/checkpoint` | POST | 保存工作检查点 |
| `/v1/workflow-observe` | POST | 存储工作流观察 |
| `/v1/checkpoint/latest` | GET | 获取最近检查点 |
| `/v1/workflow-health` | GET | 工作流健康面板 |
| `/v1/workflow-evidence` | GET | 工作流证据包 |
| `/v1/resume` | POST | 编排新窗口启动上下文 |
| `/v1/search` | POST | 高级搜索(含完整元数据) |
| `/v1/stats` | GET | 记忆统计 |
| `/v1/lint` | GET | 记忆质量报告 |
| `/v1/health` | GET | 健康检查 |
完整文档:[`docs/api-reference.md`](docs/api-reference.md)
CLI 命令
```bash
# 搜索与探索
bun run src/cli.ts search "your query"
bun run src/cli.ts explain "your query" --profile debug
bun run src/cli.ts distill "topic" --profile writing
bun run src/cli.ts stats
# 工作流观察
bun run src/cli.ts workflow-observe resume_context "Fresh window skipped continuity recovery." --outcome missed --scope project:recallnest --idempotency-key smoke-2026-06-26
bun run src/cli.ts workflow-health resume_context --scope project:recallnest
bun run src/cli.ts workflow-evidence checkpoint_session --scope project:recallnest
# 冲突管理
bun run src/cli.ts conflicts list
bun run src/cli.ts conflicts list --attention resolved
bun run src/cli.ts conflicts list --group-by cluster --attention resolved
bun run src/cli.ts conflicts audit
bun run src/cli.ts conflicts audit --export --format md
bun run src/cli.ts conflicts escalate --attention stale
bun run src/cli.ts conflicts show af70545a
bun run src/cli.ts conflicts resolve af70545a --keep-existing
bun run src/cli.ts conflicts resolve af70545a --merge
bun run src/cli.ts conflicts resolve --all --keep-existing --status open
# 记忆健康与可视化
bun run src/cli.ts lint # 记忆质量报告
bun run src/cli.ts lint --scope project:myapp # 指定 scope
bun run src/cli.ts graph --open # 导出并打开知识图谱
bun run src/cli.ts graph --max-nodes 50 # 较小的图
# 导入与诊断(对话原文默认不入库,见「索引已有对话」)
bun run src/cli.ts ingest --source all
bun run src/cli.ts doctor
```
---
## Web UI
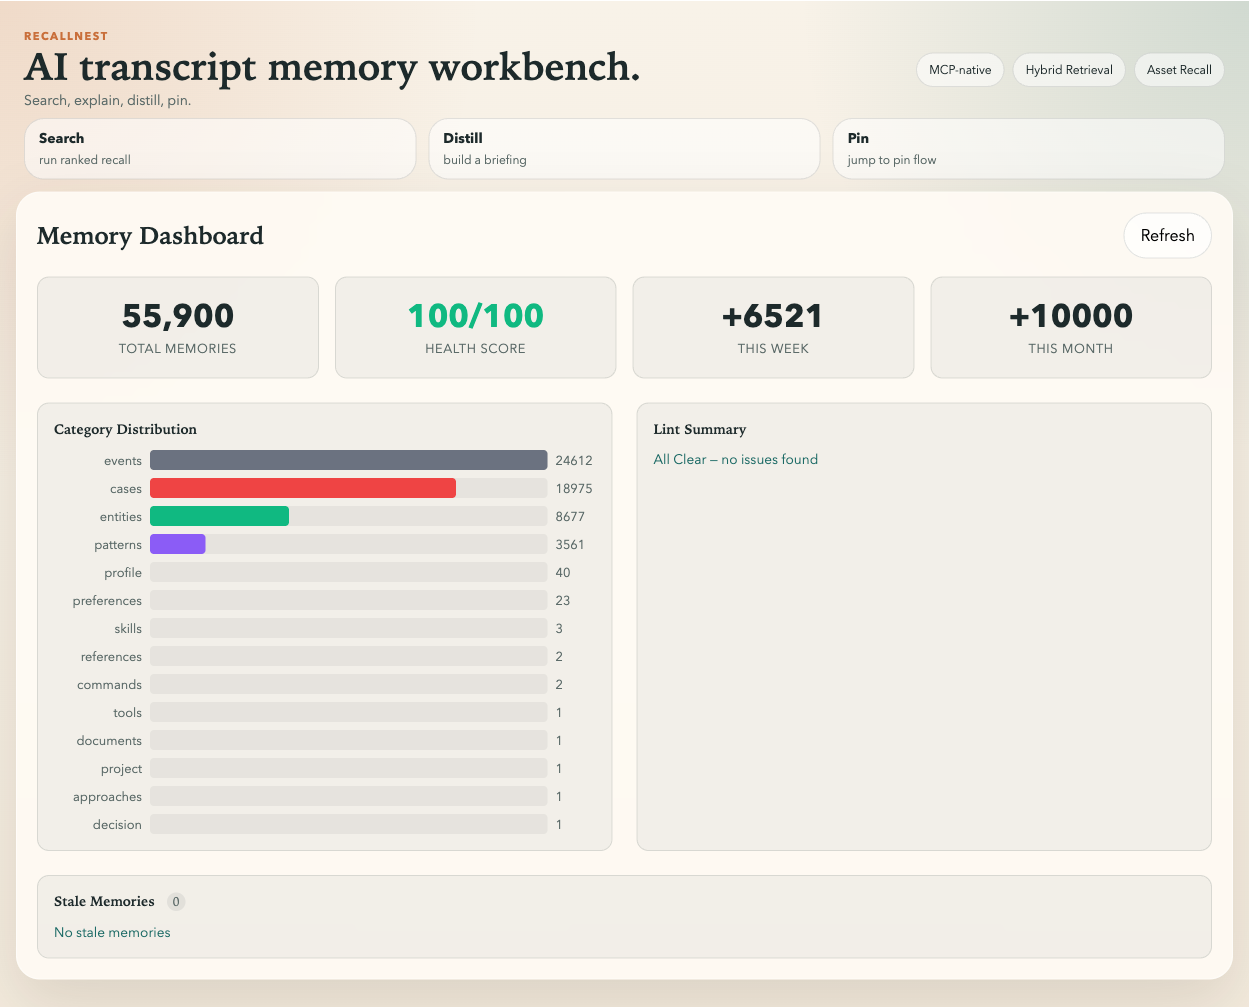
Dashboard —— 总量、类别分布、健康评分、增长趋势一目了然。
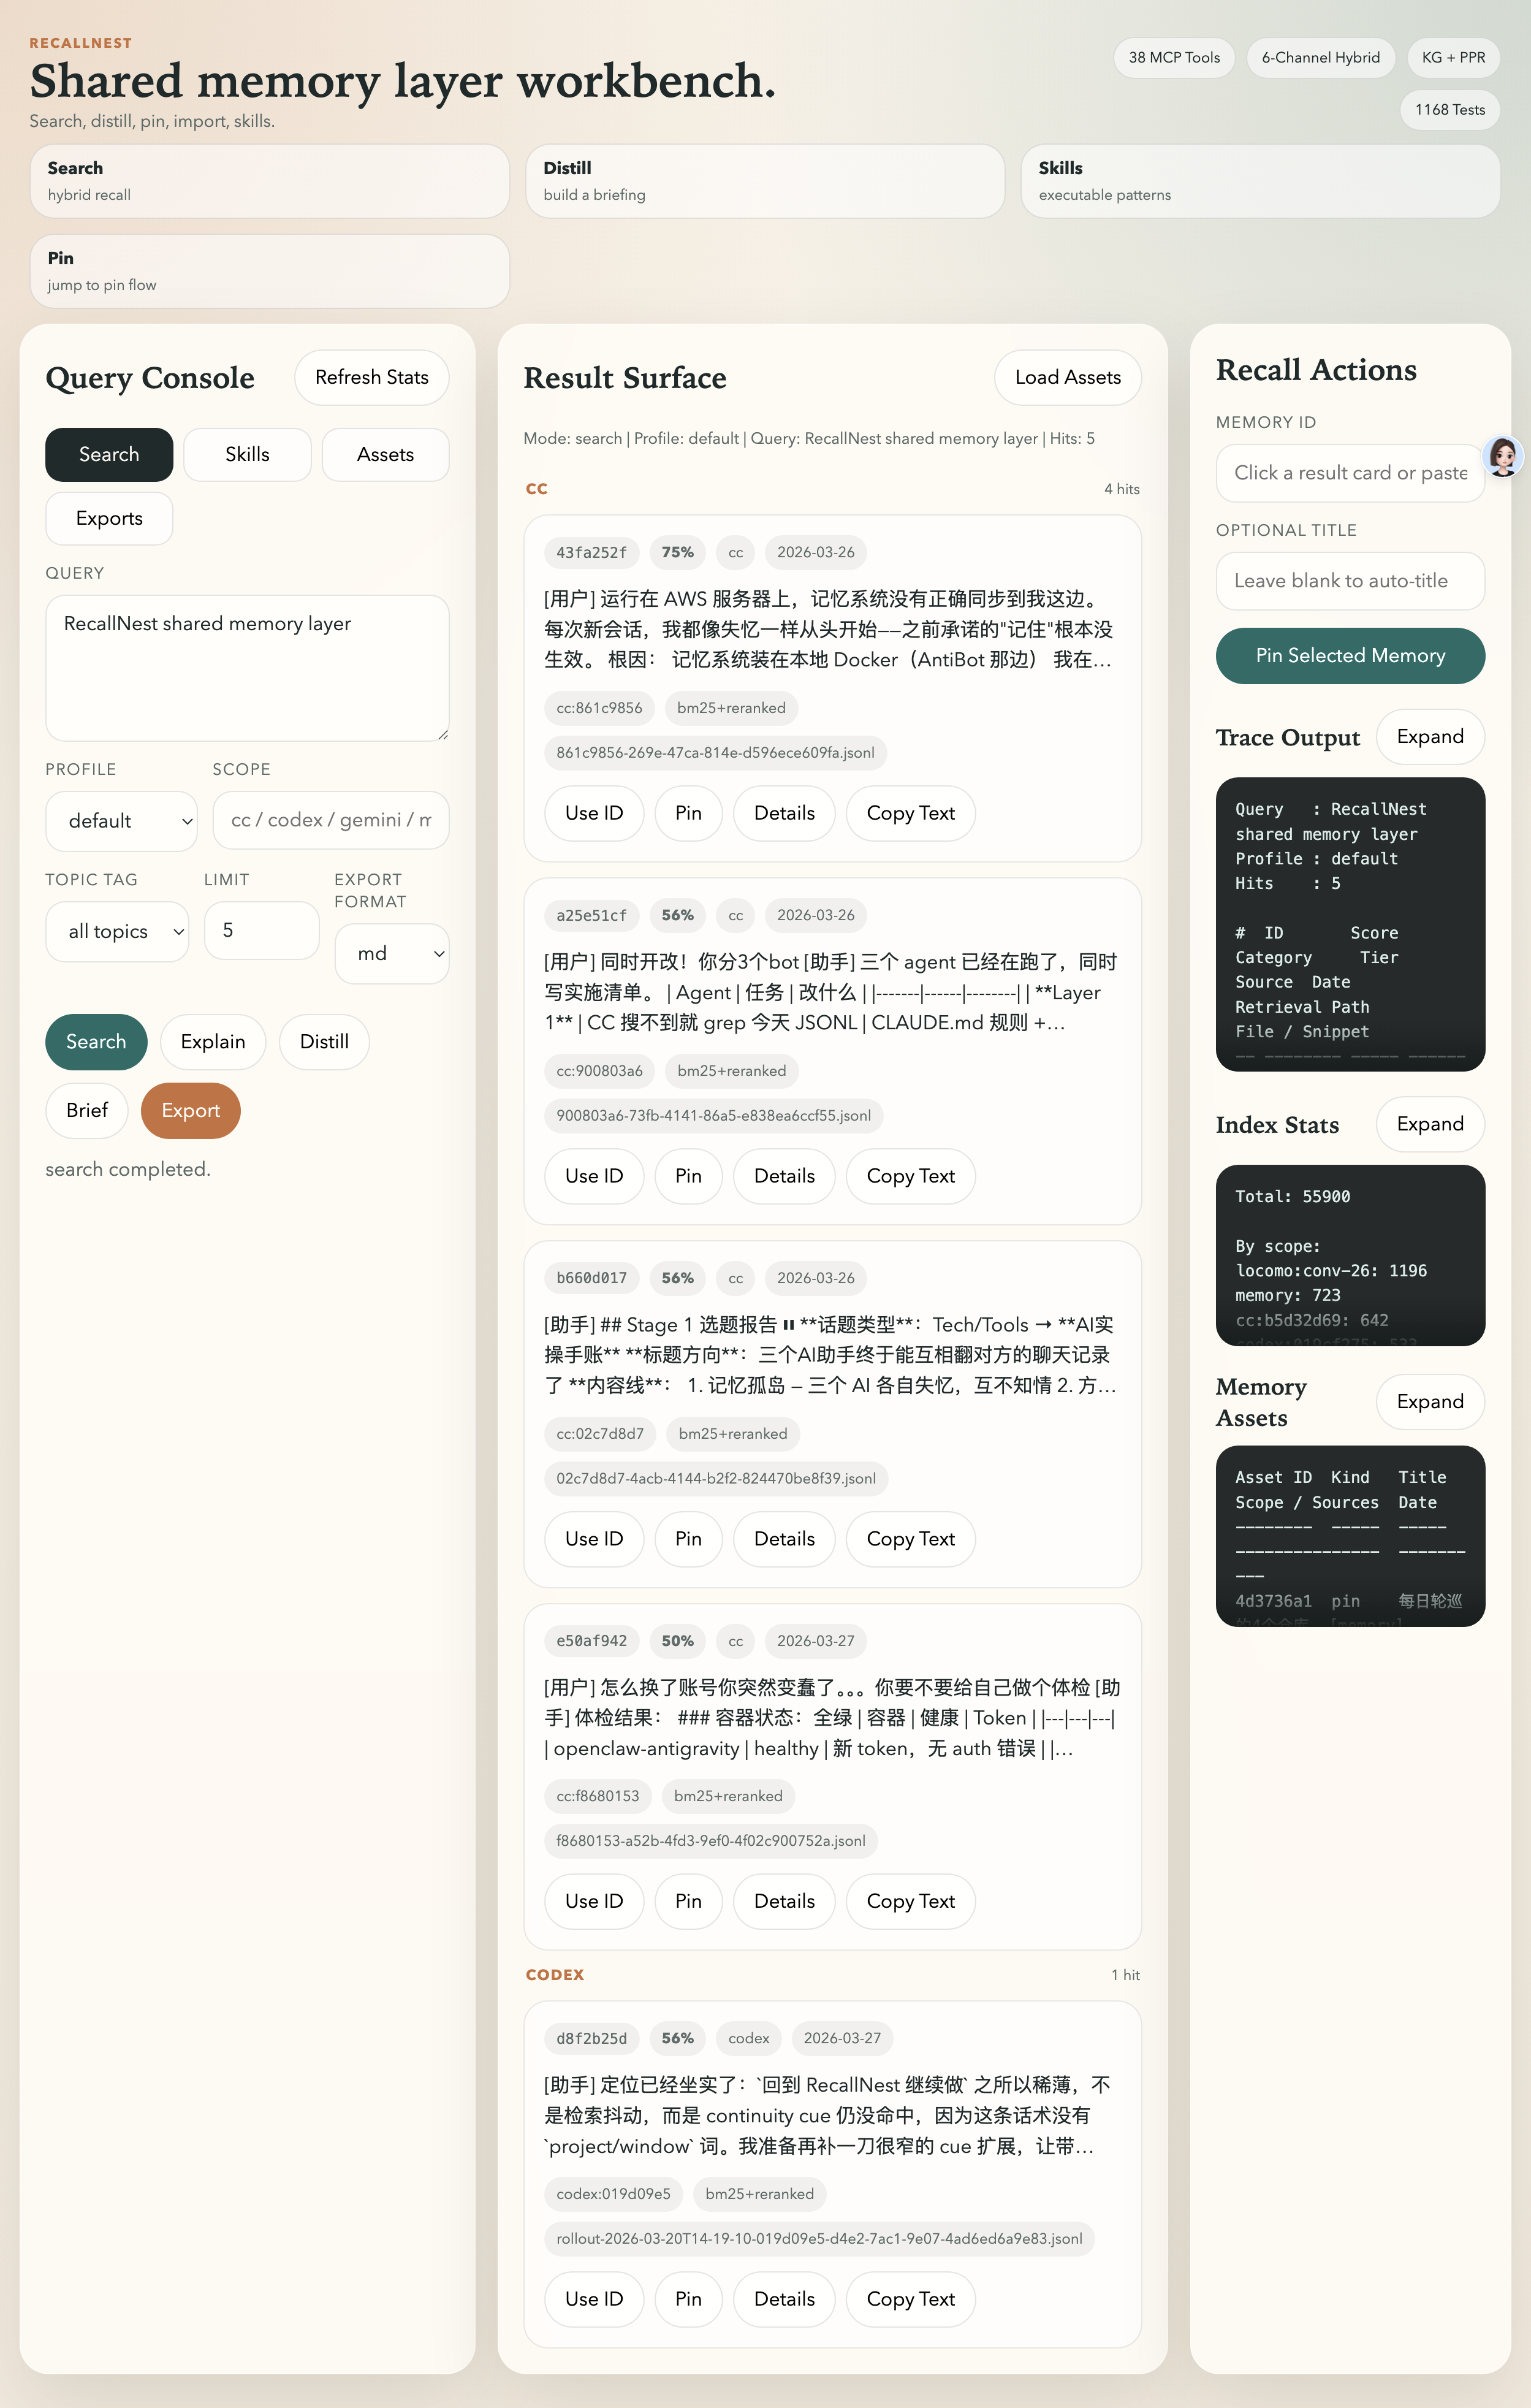
Search Workbench —— 混合检索 + Topic Tag 过滤 + 4 套检索策略 + Skills 浏览 + 资产管理。
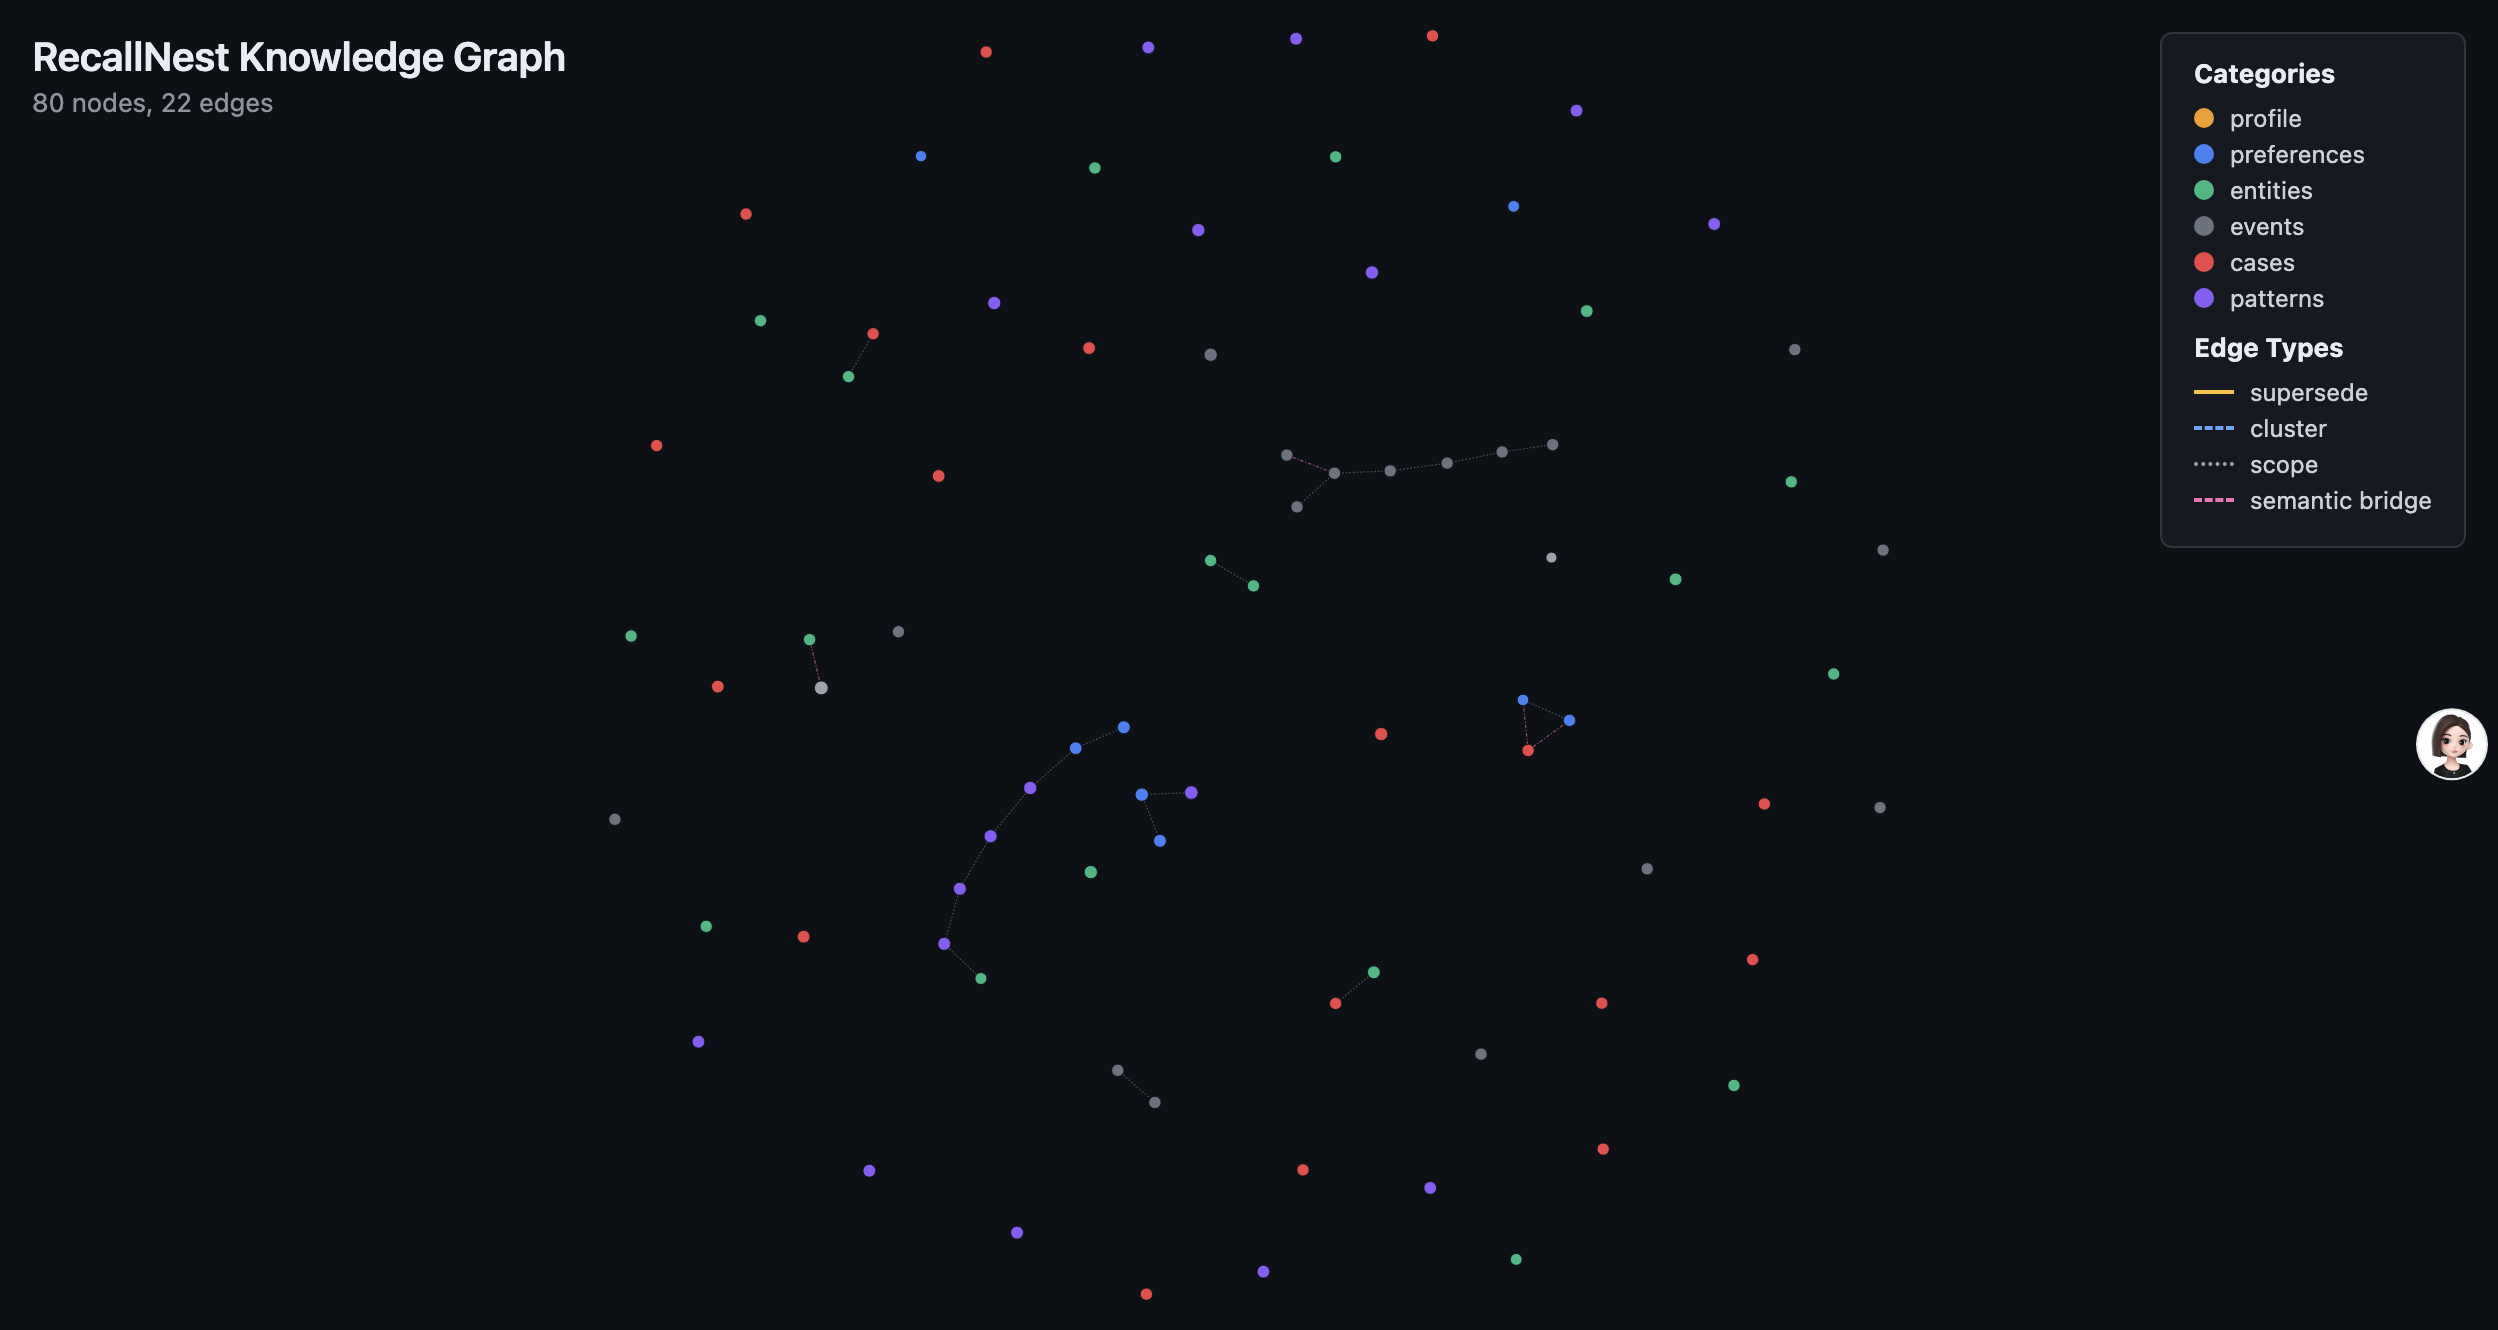
Knowledge Graph —— 交互式力导向图,语义桥接揭示跨域隐藏关联。
```bash
bun run src/ui-server.ts
# → http://localhost:4317
```
---
## 最近更新
**v3.0** 把运行时下限提到 **Node 22**(本次唯一的破坏性变更,Bun 用户不受影响),
并给"合成出来的结论"开了一条通往稳定记忆的路:`dream` 产出的洞察现在可以凭它自己
那套已验证的证据被提升,而不是永远卡在证据层、下游谁也不敢依赖。
同批还修了一个限流回复引发的无限请求风暴——实测在一个正让我们慢下来的接口上
五秒打了六万多次请求。它是被新加的 HTTP 契约测试抓出来的:那些测试让真实的客户端类
去打一个本地回环服务,而不是把 SDK 打桩糊过去。
已有的 LanceDB 数据原地打开,不需要导出导入。
**完整变更历史(v3.0 到 v1.0,含每个版本的升级说明)在
[CHANGELOG.md](CHANGELOG.md)。**
## 多语言支持
RecallNest 开箱即用支持英文。如需多语言记忆(中文、日文、泰文及 20+ 种语言),安装 [babel-memory](https://github.com/AliceLJY/babel-memory) 及所需语言包:
```bash
# 中文
npm install babel-memory jieba-wasm
# 日文
npm install babel-memory @sglkc/kuromoji
# 泰文
npm install babel-memory wordcut
# 欧洲语言(德语、法语、西班牙语、俄语等)
npm install babel-memory snowball-stemmers
# 同时安装多种语言
npm install babel-memory jieba-wasm @sglkc/kuromoji snowball-stemmers
```
RecallNest 启动时自动检测 babel-memory,无需额外配置。未安装 babel-memory 时,RecallNest 仍正常工作,使用标准 BM25 文本搜索。
---
## 项目状态与路线图
RecallNest 持续维护中。所有主要架构阶段已完成——完整路线图和未来计划见 [Roadmap](ROADMAP.md)。
---
## 与 memory-lancedb-pro 的关系
RecallNest 起源于 [memory-lancedb-pro](https://github.com/CortexReach/memory-lancedb-pro) 的 fork,共享混合检索、衰减建模、记忆即系统的核心理念。关键区别:
- **memory-lancedb-pro** 是 OpenClaw 插件——为单个 OpenClaw Agent 添加长期记忆。
- **RecallNest** 是独立记忆层——通过 MCP + HTTP API 同时服务 CLI agent、GUI 聊天 app 与纯 HTTP 调用方,内建会话连续性、结构化资产和冲突管理。
## 致谢
| 来源 | 贡献 |
|------|------|
| [memory-lancedb-pro](https://github.com/CortexReach/memory-lancedb-pro) by [@win4r](https://github.com/win4r) | Fork 基础——混合检索、衰减建模、记忆架构 |
| Claude Code | 基础搭建与早期脚手架 |
| OpenAI Codex | 产品化和 MCP 扩展 |
特别感谢秦超([@win4r](https://github.com/win4r))和 [CortexReach](https://github.com/CortexReach) 团队的基础性工作。
生态系统
**小试AI** 开源 AI 工作流矩阵:
| 项目 | 说明 |
|------|------|
| [babel-memory](https://github.com/AliceLJY/babel-memory) | BM25 多语言预处理——27+ 种语言,零依赖 |
| content-alchemy *(private)* | 5 阶段 AI 写作管线 |
| content-publisher *(private)* | 图片生成 + 排版 + 微信公众号发布 |
| [wechat-ai-bridge](https://github.com/AliceLJY/wechat-ai-bridge) | 在微信中运行 Claude Code / Codex |
| [telegram-ai-bridge](https://github.com/AliceLJY/telegram-ai-bridge) | Telegram Bot:Claude、Codex、Agy、Kimi |
| [telegram-cli-bridge](https://github.com/AliceLJY/telegram-cli-bridge) | Telegram CLI 桥接 Gemini CLI |
| [openclaw-tunnel](https://github.com/AliceLJY/openclaw-tunnel) | Docker ↔ 宿主机 CLI 桥接 |
| openclaw-config *(private)* | OpenClaw Bot 配置与记忆备份 |
| [digital-clone-skill](https://github.com/AliceLJY/digital-clone-skill) | 从语料构建数字分身 |
| [claude-code-studio](https://github.com/AliceLJY/claude-code-studio) | Claude Code 多会话协作平台 |
| [cc-genius](https://github.com/AliceLJY/cc-genius) | Web 版 Claude 客户端(PWA)—— 自托管,iPad 可用 |
| [agent-nexus](https://github.com/AliceLJY/agent-nexus) | 一键安装:记忆 + 远程控制 |
| cc-empire *(private)* | Claude Code 完整工作流脚手架 |
## License
MIT