---
title: "Ejemplo de flujo de trabajo nativo oficial de ComfyUI para generación de video con Wan2.2"
description: "Ejecuta flujos de video Wan2.2 en ComfyUI: modelo híbrido TI2V 5B y ejemplos 14B de texto a video, imagen a video y primer/último fotograma, con descargas."
sidebarTitle: Wan2.2
translationSourceHash: bafc80f0
translationFrom: tutorials/video/wan/wan2_2.mdx
translationBlockHashes:
"_intro": 3d02f6d3
"Model Highlights": fc7121c1
"Wan2.2 Open Source Model Versions": 7ed2d913
"ComfyOrg Wan2.2 Live Streams": 48f6d6e0
"Wan2.2 TI2V 5B Hybrid Version Workflow Example": 927f40b9
"Wan2.2 14B I2V Image-to-Video Workflow Example": c73a3ba4
"Wan2.2 14B FLF2V Workflow Example": 732db33d
"Community Resources": 7463b48b
---
import UpdateReminder from "/snippets/es/tutorials/update-reminder.mdx"
Wan 2.2 es un nuevo modelo generativo multimodal de nueva generación lanzado por WAN AI. Este modelo adopta una innovadora arquitectura MoE (Mixture of Experts), compuesta por modelos expertos de alto ruido y de bajo ruido. Puede dividir los modelos expertos según los pasos de eliminación de ruido (timesteps), generando así contenido de video de mayor calidad.
Wan 2.2 tiene tres características principales: control estético de nivel cinematográfico, que integra profundamente los estándares estéticos de la industria del cine profesional y admite control visual multidimensional como iluminación, color y composición; movimiento complejo a gran escala, que recrea con facilidad diversos movimientos complejos y mejora la fluidez y el control del movimiento; y cumplimiento semántico preciso, que destaca en escenas complejas y en la generación de múltiples objetos, reproduciendo mejor las intenciones creativas del usuario.
El modelo admite varios modos de generación, como texto a video e imagen a video, y es adecuado para la creación de contenido, la creación artística, la educación y la capacitación, entre otros escenarios de aplicación.
[Wan2.2 Prompt Guide](https://alidocs.dingtalk.com/i/nodes/EpGBa2Lm8aZxe5myC99MelA2WgN7R35y)
## Aspectos destacados del modelo
- **Control estético de nivel cinematográfico**: Lenguaje de cámara profesional, admite control visual multidimensional como iluminación, color y composición
- **Movimiento complejo a gran escala**: Restaura suavemente diversos movimientos complejos, mejora la controlabilidad y naturalidad del movimiento
- **Cumplimiento semántico preciso**: Comprensión de escenas complejas, generación de múltiples objetos, mejor restauración de las intenciones creativas
- **Tecnología de compresión eficiente**: Versión 5B con VAE de alta relación de compresión, optimización de memoria, admite entrenamiento mixto
## Versiones de modelos de código abierto Wan2.2
Los modelos de la serie Wan2.2 se basan en la licencia de código abierto Apache 2.0 y admiten el uso comercial. La licencia Apache 2.0 te permite usar, modificar y distribuir estos modelos libremente, incluso con fines comerciales, siempre que conserves el aviso de derechos de autor original y el texto de la licencia.
| Tipo de modelo | Nombre del modelo | Parámetros | Función principal | Repositorio del modelo |
|------------|------------|------------|---------------|-----------------|
| Modelo híbrido | Wan2.2-TI2V-5B | 5B | Versión híbrida que admite tanto texto a video como imagen a video; un solo modelo cubre dos requisitos centrales de tareas | 🤗 [Wan2.2-TI2V-5B](https://huggingface.co/Wan-AI/Wan2.2-TI2V-5B) |
| Imagen a video | Wan2.2-I2V-A14B | 14B | Convierte imágenes estáticas en videos dinámicos, manteniendo la consistencia del contenido y un proceso dinámico suave | 🤗 [Wan2.2-I2V-A14B](https://huggingface.co/Wan-AI/Wan2.2-I2V-A14B) |
| Texto a video | Wan2.2-T2V-A14B | 14B | Genera videos de alta calidad a partir de descripciones de texto, con control estético de nivel cinematográfico y un cumplimiento semántico preciso | 🤗 [Wan2.2-T2V-A14B](https://huggingface.co/Wan-AI/Wan2.2-T2V-A14B) |
## Transmisiones en vivo de ComfyOrg Wan2.2
Para usar ComfyUI Wan2.2, hemos realizado transmisiones en vivo que puedes ver para aprender a usarlos.
Este tutorial usará la versión [🤗 Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
Los pesos de Wan2.2 usan la [licencia Apache 2.0](https://www.apache.org/licenses/LICENSE-2.0), incluido el uso comercial si conservas el aviso de copyright y el texto de la licencia.

## Elegir una plantilla de flujo de trabajo
Elige un flujo en **Biblioteca de plantillas** > **Video** y descarga los modelos desde el pop-up. Pesos reempaquetados: [Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
Texto a vídeo e imagen a vídeo rápidos en una plantilla 5B. Cabe en ~8GB de VRAM con offloading nativo.
Texto a vídeo MoE con expertos de ruido alto y bajo.
Anima una imagen fija con checkpoints I2V 14B.
Interpola el movimiento entre un fotograma inicial y uno final.

## Ejemplo de flujo de trabajo de la versión híbrida Wan2.2 TI2V 5B
La versión Wan2.2 5B debería funcionar bien con 8 GB de VRAM gracias al offloading nativo de ComfyUI.
### Generación de video con Wan 2.2 5B {#video_wan2_2_5B_ti2v}
Generación rápida de texto a video e imagen a video con 5B de parámetros. Optimizada para prototipado rápido y exploración creativa.
Abrir en Comfy Cloud
Descarga el JSON o busca "Wan2.2 5B" en la Biblioteca de plantillas
### 2. Descargar los modelos manualmente
Todos los modelos mencionados se encuentran en [Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
**Modelo de difusión**
Modelo de difusión híbrido de 5B. Colócalo en ComfyUI/models/diffusion_models/
**VAE**
VAE de Wan2.2. Colócalo en ComfyUI/models/vae/
**Codificador de texto**
Codificador de texto FP8. Colócalo en ComfyUI/models/text_encoders/
```
ComfyUI/
├───📂 models/
│ ├───📂 diffusion_models/
│ │ └───wan2.2_ti2v_5B_fp16.safetensors
│ ├───📂 text_encoders/
│ │ └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│ └───📂 vae/
│ └── wan2.2_vae.safetensors
```
### 3. Sigue los pasos

1. Asegúrate de que el nodo `Load Diffusion Model` cargue el modelo `wan2.2_ti2v_5B_fp16.safetensors`.
2. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`.
3. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan2.2_vae.safetensors`.
4. (Opcional) Si necesitas generar imagen a video, puedes usar el atajo Ctrl+B para habilitar el nodo `Load image` y subir una imagen.
5. (Opcional) En el nodo `Wan22ImageToVideoLatent`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas del video (`length`).
6. (Opcional) Si necesitas modificar los prompts (positivo y negativo), hazlo en el nodo `CLIP Text Encoder` del paso 5.
7. Haz clic en el botón `Run` o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Ejemplo de flujo de trabajo de texto a video T2V 14B de Wan2.2
### Wan 2.2 14B de texto a video {#video_wan2_2_14B_t2v}
Genera videos de alta calidad a partir de prompts de texto con control estético cinematográfico y generación de movimiento dinámico usando Wan 2.2.
Abrir en Comfy Cloud
Descarga el JSON o busca "Wan2.2 14B T2V" en la Biblioteca de plantillas
### 2. Descargar los modelos manualmente
Todos los modelos mencionados están disponibles en [Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
**Modelos de difusión**
Modelo de difusión de alto ruido. Colócalo en ComfyUI/models/diffusion_models/
Modelo de difusión de bajo ruido. Colócalo en ComfyUI/models/diffusion_models/
**VAE**
VAE de Wan2.1 (compatible con Wan2.2). Colócalo en ComfyUI/models/vae/
**Codificador de texto**
Codificador de texto FP8. Colócalo en ComfyUI/models/text_encoders/
```
ComfyUI/
├───📂 models/
│ ├───📂 diffusion_models/
│ │ ├─── wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors
│ │ └─── wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors
│ ├───📂 text_encoders/
│ │ └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│ └───📂 vae/
│ └── wan_2.1_vae.safetensors
```
### 3. Sigue los pasos

1. Asegúrate de que el primer nodo `Load Diffusion Model` cargue el modelo `wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors`.
2. Asegúrate de que el segundo nodo `Load Diffusion Model` cargue el modelo `wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors`.
3. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`.
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`.
5. (Opcional) En el nodo `EmptyHunyuanLatentVideo`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas del video (`length`).
6. (Opcional) Si necesitas modificar los prompts (positivo y negativo), hazlo en el nodo `CLIP Text Encoder` del paso 5.
7. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Ejemplo de flujo de trabajo de imagen a video con Wan2.2 14B I2V
### Wan 2.2 14B de imagen a video {#video_wan2_2_14B_i2v}
Transforma imágenes estáticas en videos dinámicos con control preciso del movimiento y conservación del estilo usando Wan 2.2.
Abrir en Comfy Cloud
Descarga el JSON o busca "Wan2.2 14B I2V" en la Biblioteca de plantillas
**Materiales de entrada**
Sube este archivo al nodo `LoadImage` correspondiente:
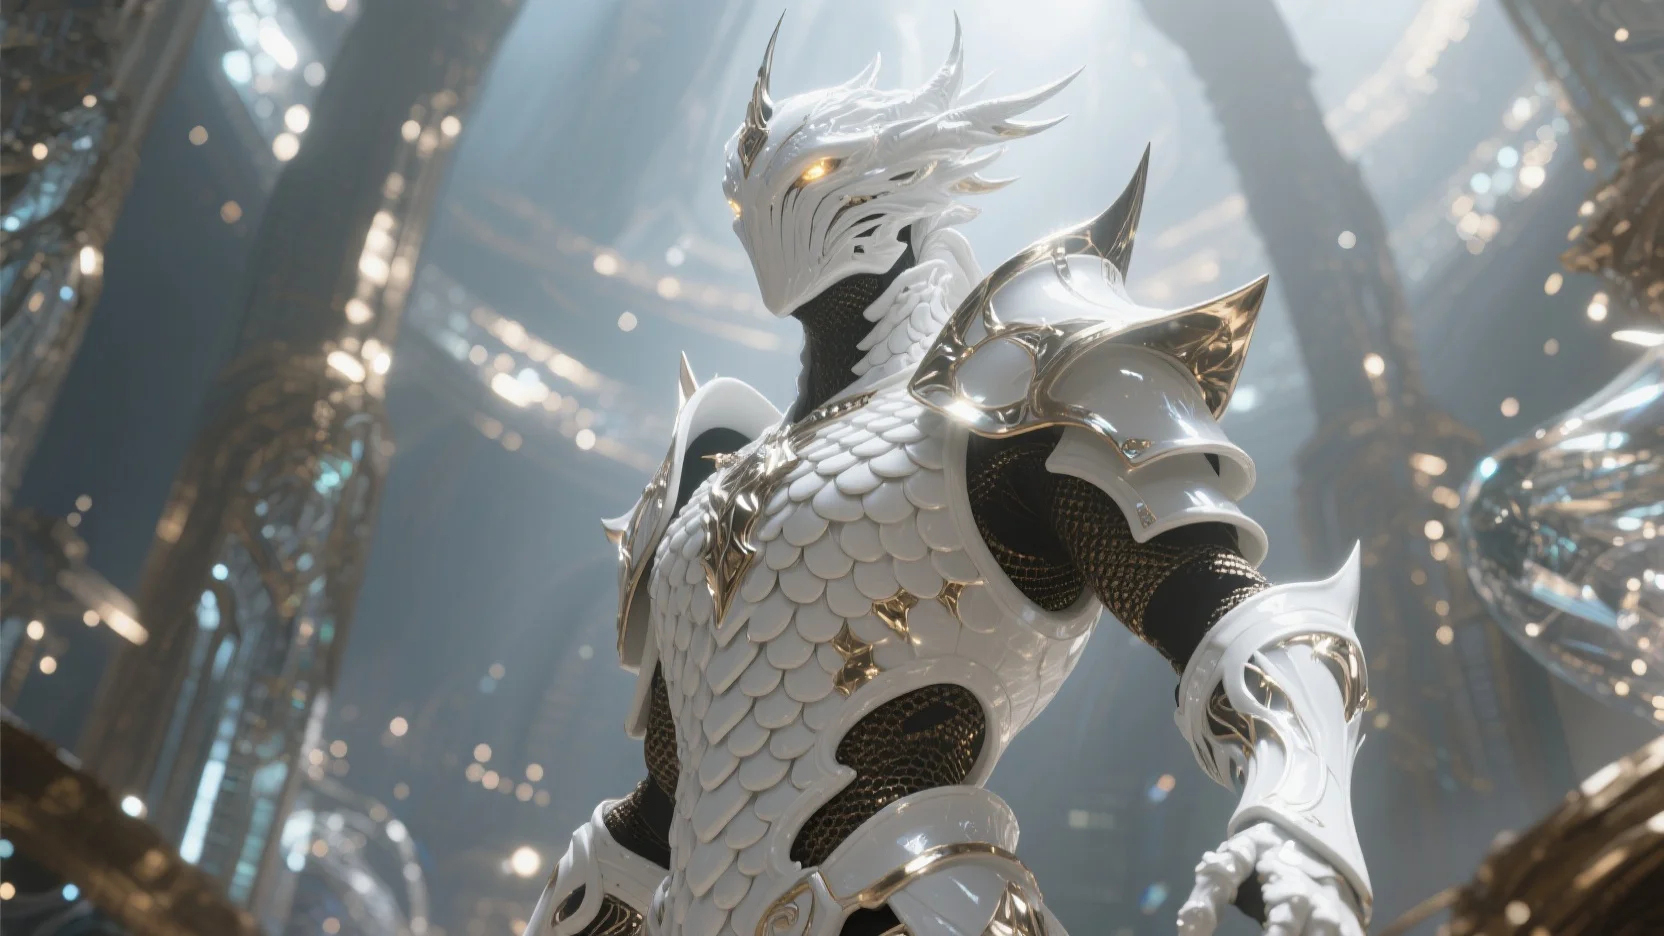
Nodo `LoadImage` 97 · `video_wan2_2_14B_i2v_input_image.jpg`
**Salida de ejemplo**
### 2. Descargar los modelos manualmente
Todos los modelos mencionados están disponibles en [Comfy-Org/Wan_2.2_ComfyUI_Repackaged](https://huggingface.co/Comfy-Org/Wan_2.2_ComfyUI_Repackaged).
**Modelos de difusión**
Modelo de difusión I2V de alto ruido. Colócalo en ComfyUI/models/diffusion_models/
Modelo de difusión I2V de bajo ruido. Colócalo en ComfyUI/models/diffusion_models/
**VAE**
VAE de Wan2.1 (compatible con Wan2.2). Colócalo en ComfyUI/models/vae/
**Codificador de texto**
Codificador de texto FP8. Colócalo en ComfyUI/models/text_encoders/
```
ComfyUI/
├───📂 models/
│ ├───📂 diffusion_models/
│ │ ├─── wan2.2_i2v_low_noise_14B_fp16.safetensors
│ │ └─── wan2.2_i2v_high_noise_14B_fp16.safetensors
│ ├───📂 text_encoders/
│ │ └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│ └───📂 vae/
│ └── wan_2.1_vae.safetensors
```
### 3. Seguir los pasos

1. Asegúrate de que el primer nodo `Load Diffusion Model` cargue el modelo `wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors`.
2. Asegúrate de que el segundo nodo `Load Diffusion Model` cargue el modelo `wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors`.
3. Asegúrate de que el nodo `Load CLIP` cargue el modelo `umt5_xxl_fp8_e4m3fn_scaled.safetensors`.
4. Asegúrate de que el nodo `Load VAE` cargue el modelo `wan_2.1_vae.safetensors`.
5. En el nodo `Load Image`, sube la imagen que se usará como fotograma inicial.
6. Si necesitas modificar los prompts (positivo y negativo), hazlo en el nodo `CLIP Text Encoder` del paso 6.
7. (Opcional) En `EmptyHunyuanLatentVideo`, puedes ajustar las configuraciones de tamaño y el número total de fotogramas del video (`length`).
8. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación del video.
## Ejemplo de flujo de trabajo Wan2.2 14B FLF2V
El flujo de trabajo de primer y último fotograma usa las mismas ubicaciones de modelo que la sección I2V.
### Wan 2.2 14B primer-último fotograma a video {#video_wan2_2_14B_flf2v}
Genera transiciones de video suaves definiendo los fotogramas inicial y final.
Abrir en Comfy Cloud
Descarga el JSON o busca "Wan2.2 14B FLF2V" en la Biblioteca de plantillas
**Materiales de entrada**
Sube estos archivos a los nodos `LoadImage` correspondientes:
Nodo `LoadImage` 62 · `video_wan2_2_14B_flf2v_start_image.png`
Nodo `LoadImage` 68 · `video_wan2_2_14B_flf2v_end_image.png`
### 2. Sigue los pasos

1. Sube la imagen que se usará como fotograma inicial en el primer nodo `Load Image`.
2. Sube la imagen que se usará como fotograma final en el segundo nodo `Load Image`.
3. Ajusta las configuraciones de tamaño en el nodo `WanFirstLastFrameToVideo`.
- De forma predeterminada, se establece un tamaño relativamente pequeño para evitar que los usuarios con poca VRAM consuman demasiados recursos.
- Si tienes suficiente VRAM, puedes probar una resolución de alrededor de 720P.
4. Escribe prompts adecuados según tus fotogramas inicial y final.
5. Haz clic en el botón `Run`, o usa el atajo `Ctrl(cmd) + Enter` para ejecutar la generación de video.
## Recursos de la comunidad
### Versiones GGUF
- [bullerwins/Wan2.2-I2V-A14B-GGUF/](https://huggingface.co/bullerwins/Wan2.2-I2V-A14B-GGUF/)
- [bullerwins/Wan2.2-T2V-A14B-GGUF](https://huggingface.co/bullerwins/Wan2.2-T2V-A14B-GGUF)
- [QuantStack/Wan2.2 GGUFs](https://huggingface.co/collections/QuantStack/wan22-ggufs-6887ec891bdea453a35b95f3)
**Nodo personalizado**
[City96/ComfyUI-GGUF](https://github.com/city96/ComfyUI-GGUF)
### WanVideoWrapper
[Kijai/ComfyUI-WanVideoWrapper](https://github.com/kijai/ComfyUI-WanVideoWrapper)
**Modelos Wan2.2**
[Kijai/WanVideo_comfy_fp8_scaled](https://hf-mirror.com/Kijai/WanVideo_comfy_fp8_scaled)
**Modelos Wan2.1**
[Kijai/WanVideo_comfy/Lightx2v](https://huggingface.co/Kijai/WanVideo_comfy/tree/main/Lightx2v)
**LoRA Lightx2v 4steps**
- [Wan2.2-T2V-A14B-4steps-lora-rank64-V1](https://huggingface.co/lightx2v/Wan2.2-Lightning/tree/main/Wan2.2-T2V-A14B-4steps-lora-rank64-V1)