# omnireach
[English](./README.md) · 中文
**你的 agent 读得了 Twitter,却读不了微信公众号。omnireach 解决这件事。**
omnireach 让你的 agent 搜索 Google 和登录墙后的中文互联网 —— 微信公众号 · 小红书 · 抖音 · B站 · TikTok —— 外加 Twitter、Reddit、HN、YouTube 等。`search` 返回归一化结果,`fetch` 返回干净 Markdown,`media` 把视频整理成有界的元数据和字幕产物。微信搜索**零配置**开箱即用 —— 无 key、无登录:
```bash
omnireach search --on wechat "Claude Code 技巧" # 装完 60 秒内能跑
```
安装为 Claude Code Skill 后,下次会话 agent 自动就知道怎么用了。工具内部不调 LLM、重型源复用你自己的浏览器登录态,没有按次付费的爬取 API。
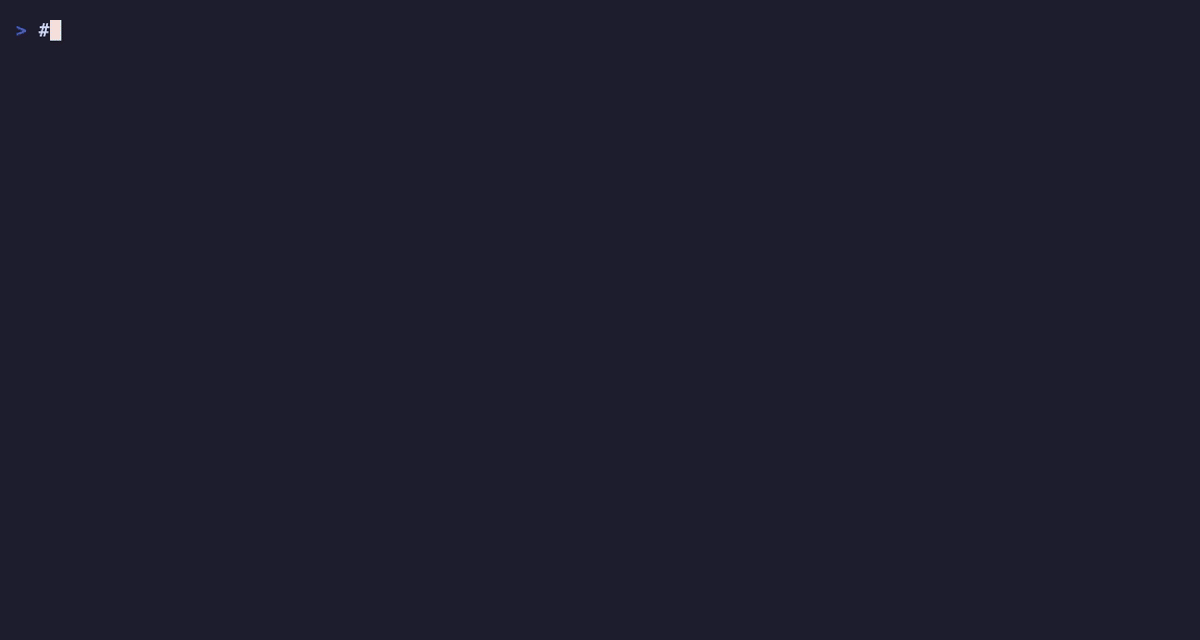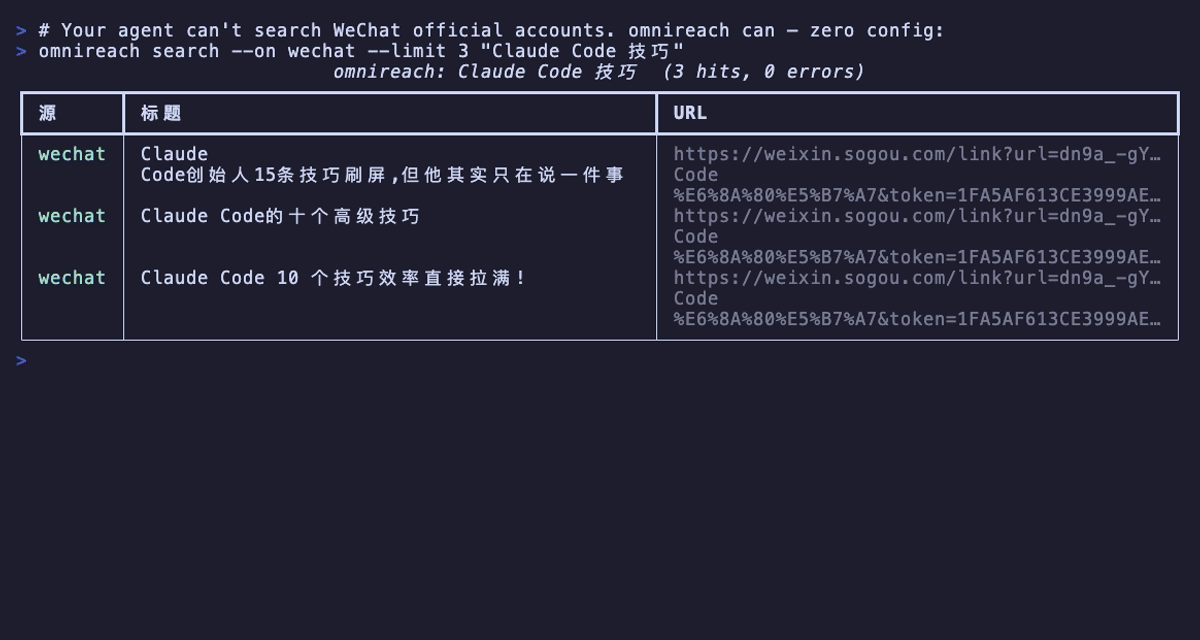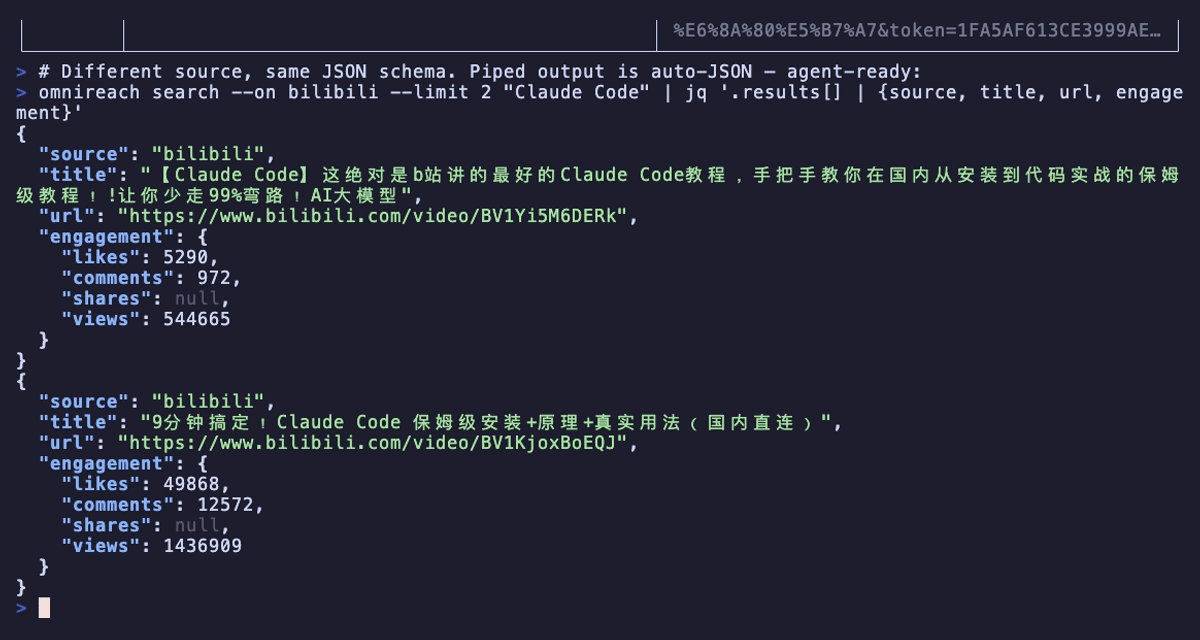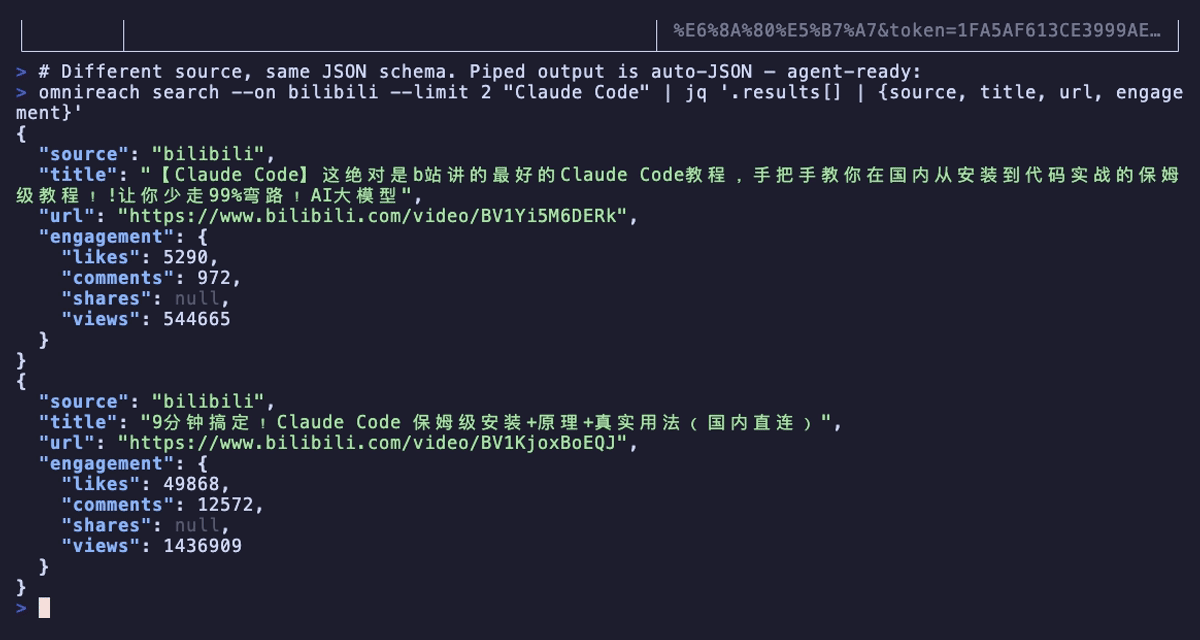
**看它跑起来:**[Overdrive](https://github.com/Daily-AC/assets/releases/download/renders-2026-07/omnireach-overdrive.mp4)(36 秒)· [原生桥接](https://github.com/Daily-AC/assets/releases/download/renders-2026-07/omnireach-native-bridge.mp4)(51 秒)· [终端演示](https://github.com/Daily-AC/assets/releases/download/renders-2026-07/omnireach-douyin-promo.mp4)(30 秒)—— 视频工程源码在 [Daily-AC/assets](https://github.com/Daily-AC/assets)。
### 先读网页,再启动 Playwright
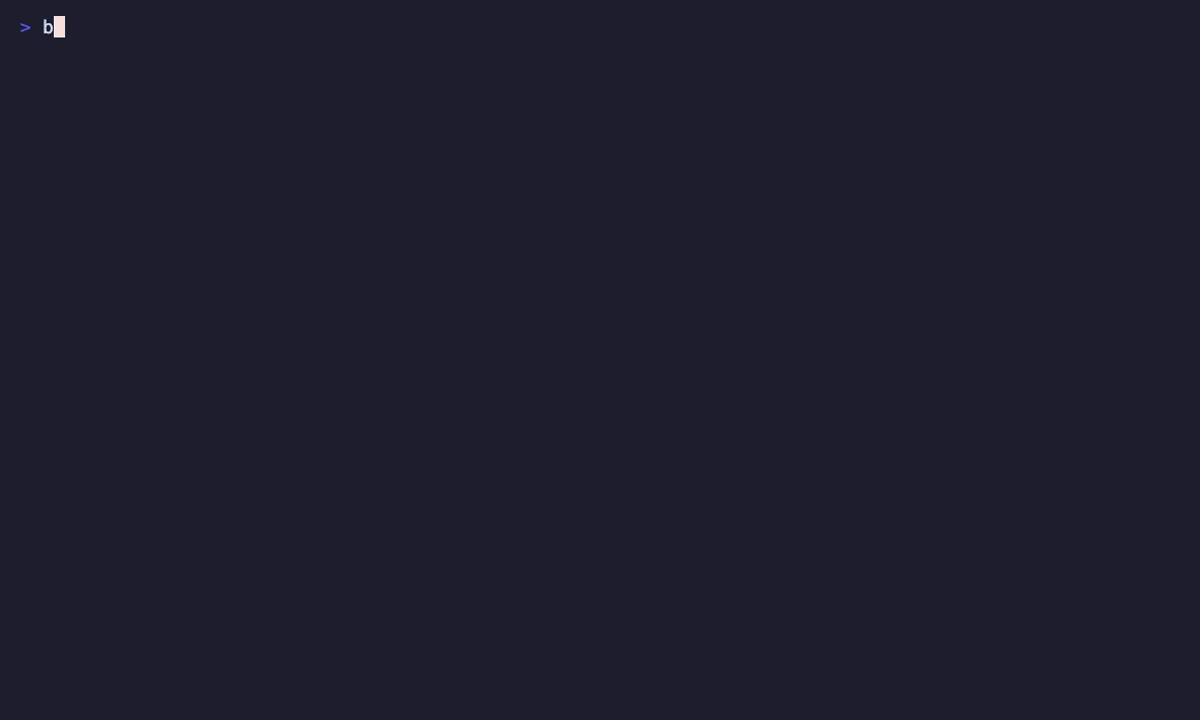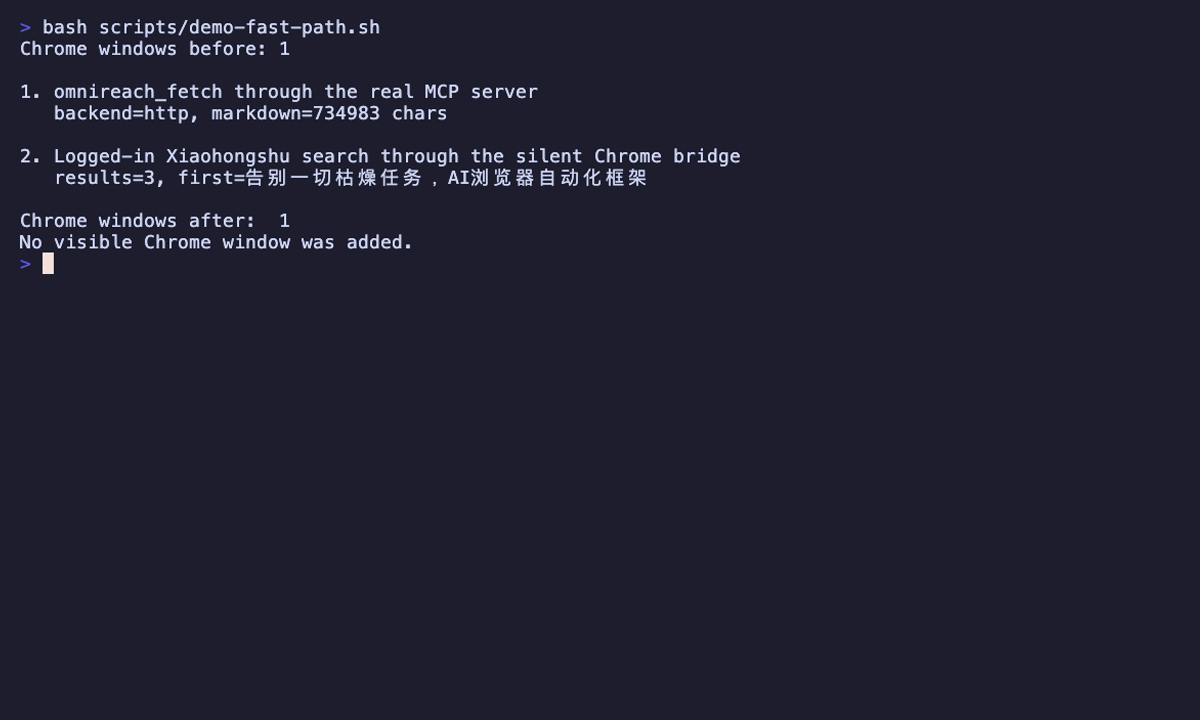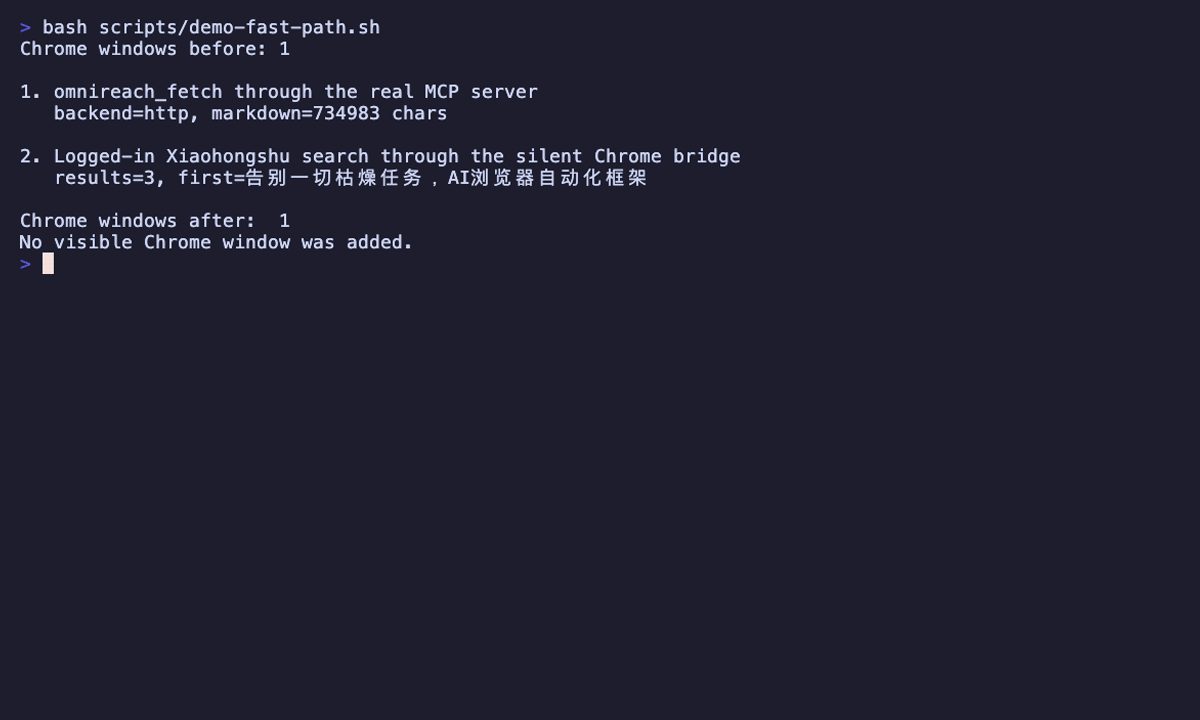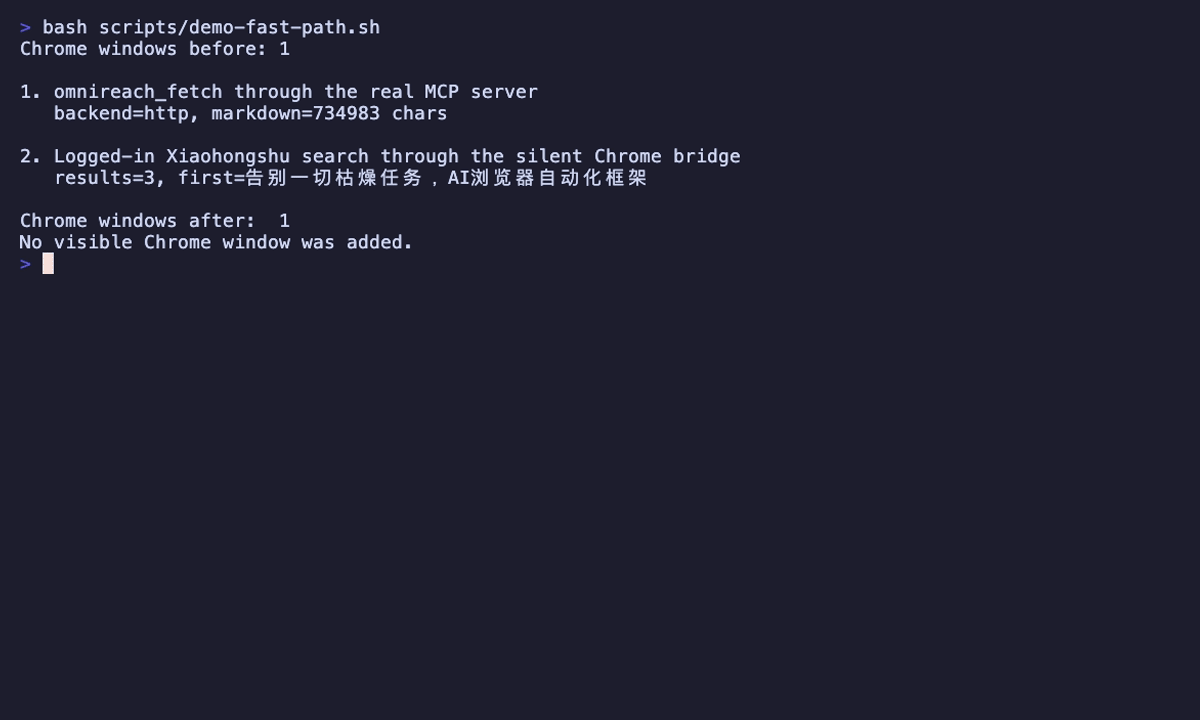
搜索、作者目录、读取、媒体解析和有界抖音下载先用五个聚焦的 MCP 工具,不要先启动浏览器自动化。普通网页 fetch
完全不启动 Chrome;Google、Reddit、Twitter、小红书、TikTok、抖音现在都优先走
Omnireach 自己的轻量只读 Chrome 桥,OpenCLI 保留为兼容回退。浏览器路径使用后台
临时 tab,用完即关;`quick` 模式仍完全不碰浏览器。点击、表单、文件传输、截图和
视觉断言和其他不支持的文件传输继续交给 Playwright。
| 同一次 RFC 9110 读取 | omnireach MCP | Playwright + 无头系统 Chrome |
|---|---:|---:|
| 冷进程,5 次中位数 | **1383.86 ms** | 3749.26 ms |
| 热运行时,5 次中位数 | **1311.46 ms** | 1687.94 ms |
在记录数据的机器上,Playwright 冷路径耗时是 omnireach 的 **2.7 倍**,双方热启动后
是 **1.3 倍**。查看[测试方法与边界](./docs/benchmarks/read-path-v0.12.md),或直接核对
[全部原始样本](./docs/benchmarks/read-path-v0.12.json)。
[](LICENSE)
[](https://www.python.org/)
---
## 安装 —— 直接告诉你的 agent
> **「帮我安装 omnireach」**
你的 agent 会自动执行安装命令,你不需要复制任何东西。
手动备选 —— 如果你更喜欢自己粘贴到终端:
```bash
curl -fsSL https://raw.githubusercontent.com/Daily-AC/omnireach/main/install.sh | sh
```
也上了 [PyPI](https://pypi.org/project/omnireach/):`uv tool install omnireach` 或 `pip install omnireach`(仅 CLI —— 上面的一键脚本会额外注册 Claude Code skill)。不装先试:`uvx omnireach search "vibe coding"`。
这条命令会安装 CLI **并且**注册 Claude Code Skill(下次会话自动发现)。零配置源 —— HackerNews、RSS、微信(Sogou 路径)、B站 —— 立即可用。其他源各需一次性配置步骤。
以 Claude Code plugin 方式安装 repo 时,还会自动注册内置 MCP server。单独运行一键
安装脚本时,即使客户端没有加载 plugin MCP 配置,skill 仍可回退到 CLI。
---
## 你能得到什么
**1. 触达那些触达不了的地方。**
Twitter、Reddit、小红书、微信公众号、抖音、B站、TikTok —— 这些有登录墙的纵向平台,任何 agent 网络搜索都够不着。omnireach 复用你自己的已登录浏览器会话;六个浏览器搜索源都已优先走 Omnireach 原生桥,OpenCLI 保留为兼容回退。
**2. 稳定的 agent 契约。**
`search` 返回归一化结果,`fetch` 返回干净 Markdown,`media` 返回 `MediaEnvelope`:短预览放 JSON,长字幕写入本地文件并提供绝对路径,不挤爆模型上下文。
**3. WebSearch 不可用时照样能搜。**
在 proxy / 中转站 / Bedrock / Vertex-Claude-3.x 等内置 WebSearch server tool 不可用的环境下,omnireach 在客户端直接实现搜索,绕过两层 gate,把搜索能力还给 agent。
---
## Agent 快路径 —— MCP 优先于 Playwright
plugin 暴露五个由模型直接调用的工具:
- `omnireach_search`:联网研究与平台搜索
- `omnireach_author`:某个创作者本人发布的作品,关键词搜索答不了这个问题
- `omnireach_fetch`:把 HTTP/HTTPS URL 读取为 Markdown
- `omnireach_parse_media`:解析 YouTube、B站和直接媒体的元数据或字幕
- `omnireach_download_media`:有界下载抖音 MP4,并返回经过哈希校验的本地产物
全部工具由零新增依赖的 stdio 命令提供:
```bash
omnireach mcp
```
不通过 plugin 加载的 MCP 客户端可使用标准配置:
```json
{
"mcpServers": {
"omnireach": {
"command": "omnireach",
"args": ["mcp"]
}
}
}
```
只读任务优先使用这两个工具,不要启动 Playwright。普通网页 fetch 完全不启动
Chrome;登录墙 adapter 可能通过后台临时 tab 继承现有 Chrome 登录态,调用结束立即
释放。只有点击、表单、上传下载、截图、视觉断言或未支持的交互流程才使用 Playwright。
---
## 和 Agent-Reach 有什么区别?
[Agent-Reach](https://github.com/Panniantong/Agent-Reach)(51k★)开创了这个品类,它做的事情它做得很好。omnireach 做的是另一组取舍 —— 以下是带日期戳的事实,不是营销话术:
| | omnireach | Agent-Reach(v1.5.0,截至 2026-07) |
|---|---|---|
| 微信公众号 | ✅ 零配置搜索(Sogou 路径)+ 登录态 Chrome 全文抓取 | ❌ 2026-06 整体删除([PR #347](https://github.com/Panniantong/Agent-Reach/pull/347),反爬失效) |
| 抖音 | ✅ 登录态 Chrome 搜索 + 有界 MP4 下载 | ❌ 2026-06 删除(上游工具已 archive) |
| TikTok | ✅ 搜索 | ❌ 从未支持 |
| 输出契约 | 全部 17 源统一 pydantic JSON schema;管道自动 JSON | 设计上无包装层 —— 各上游工具各自的格式(YAML / 纯文本 / 字幕文件 / 裸 JSON) |
| `search` / `fetch` 命令 | 内置 `omnireach search` + `omnireach fetch `(host 感知路由) | 无 search/read 命令 —— 引导 agent 直接调各上游工具 |
| Facebook · Instagram · LinkedIn · 雪球 · 播客转录 | ❌ | ✅ |
| 社区 | 早期 —— 你比大部队先找到了这里 | 51k★,30 位贡献者 |
需要 Facebook/LinkedIn/转录,选 Agent-Reach。需要中文互联网(尤其微信)、机器稳定的 JSON 契约、或统一的 fetch 入口,这就是 omnireach 存在的原因。两者都是 MIT,在同一个 agent 里并存完全没问题。
---
## 示例
```bash
# 搜索有登录墙的纵向平台
omnireach search --on xiaohongshu --json "Claude Code 使用技巧"
# 抓取微信文章 —— 有登录墙,走你的浏览器会话
omnireach fetch --json "https://mp.weixin.qq.com/s/"
# 不下载完整视频,只解析 YouTube 字幕
omnireach media parse --language en --json "https://www.youtube.com/watch?v="
# B站字幕需要登录时,显式指定已登录的 Chrome profile
omnireach media parse --cookies-from-browser "chrome:Profile 1" \
--language zh-Hans --json "https://www.bilibili.com/video/"
# 抖音当前需要新鲜浏览器 cookies;结果返回路径、字节数和 SHA-256
omnireach media download --cookies-from-browser "chrome:Profile 1" \
--max-size-mb 500 --json "https://www.douyin.com/video/"
# 完整流水线:搜索 → 批量抓全文
omnireach search --on wechat --json "claude 4.7" \
| jq -r '.results[].url' \
| xargs -I{} omnireach fetch --json {}
```
---
## 命令
| 命令 | 干嘛 |
|---|---|
| `omnireach search ""` | 搜索;原生 bridge 或 OpenCLI 可用时自动加入 Google + Twitter |
| `omnireach search --on twitter,reddit "..."` | 指定源 |
| `omnireach search --sources twitter,reddit "..."` | `--on` 的别名,与 MCP 参数名一致 |
| `omnireach search --profile "..."` | 为本次搜索选择 OpenCLI Browser Bridge profile |
| `omnireach search --timeout 90 "..."` | 覆盖全部源的 timeout;浏览器 heavy 源默认 60 秒 |
| `omnireach search --mode quick "..."` | 只查 HN,不调用浏览器源 |
| `omnireach search --mode deep "..."` | 查所有就绪源 |
| `omnireach search --json "..."` | 显式 JSON 输出 |
| **`omnireach fetch `** | **URL → 全文 markdown** — `mp.weixin.qq.com` 走 OpenCLI 登录态 Chrome,其它 host 走内置 HTTP → Jina fallback |
| `omnireach fetch --backend http` | 强制走内置、无浏览器的 HTTP 提取器 |
| `omnireach fetch --backend jina` | 强制走 Jina Reader SaaS (零本地依赖) |
| `omnireach fetch --backend crwl` | 显式选择本地 Crawl4AI |
| `omnireach fetch --backend opencli` | 强制走 OpenCLI weixin 登录态路径 (v0.10.1+) |
| **`omnireach author "<昵称>"`** | **某个创作者本人的作品** — 关键词搜索搜到的多是别人的二创;这条返回作品目录,附精确的点赞/评论/转发/收藏数 |
| `omnireach author "https://www.douyin.com/user/"` | 直接钉死账号,不靠粉丝数从同名号里猜 |
| `omnireach author "<昵称>" --order likes --limit 30` | 按点赞排全量目录(必须翻完所有作品才能排序,`--timeout` 要给够) |
| `omnireach media inspect ` | 只检查归一化元数据和字幕轨,不写文件 |
| `omnireach media parse --language zh-CN` | 生成元数据、字幕、时间轴 JSON/Markdown 和 manifest |
| `omnireach media parse --subtitle-url ` | 给直接音视频解析旁挂 VTT/SRT/JSON3 字幕 |
| `omnireach media parse --cookies-from-browser "chrome:Profile 1"` | B站字幕需要登录时,显式复用该浏览器 profile |
| `omnireach media parse --no-cache --max-duration 3600` | 跳过哈希校验缓存,并拒绝超过一小时的媒体 |
| `omnireach media download --cookies-from-browser "chrome:Profile 1"` | 默认下载兼容性更好的 H.264 MP4,并返回哈希校验后的本地产物 |
| `omnireach media download --quality small --max-size-mb 100` | 优先最小的合并 MP4,并拒绝超过 100 MiB 的格式 |
| `omnireach mcp` | 通过 MCP stdio 提供搜索、作者目录、抓取、媒体解析和有界抖音下载 |
| `omnireach init` | 写默认 `~/.omnireach/preferences.toml` |
| `omnireach sources` | 列出所有源 + 状态 |
| `omnireach setup ` | 引导式配置一个 🟡 / 🔴 源 |
| `omnireach bridge install` | 安装或更新 Omnireach 原生 Chrome 扩展文件 |
| `omnireach bridge reload` | 让已连接的扩展自己重载并加载刚安装的新文件 |
| `omnireach bridge path` | 输出稳定的未打包扩展目录 |
| `omnireach bridge status --json` | 通过鉴权 localhost 桥真实 ping 扩展 |
| `omnireach agy configure ` | 配置实验性 agy grounded-search backend |
| `omnireach agy status --json` | 检查 agy conversation 与 AgentAPI endpoint |
| `omnireach doctor` | 健康检查 (含 sources / fetch / media / wechat backends) |
真实上游格式、登录态下载、缓存、大小限制、隐私与 MCP 证据见
[抖音下载验证记录](docs/verification/douyin-download.md)。
---
## 支持的源
| 源 | tier | 依赖 | 说明 |
|---|---|---|---|
| hackernews | ✅ ready | 无 | 直连 Algolia, 零配置 |
| youtube | ✅ ready | `yt-dlp` (pip install) | `omnireach setup youtube` |
| github | ✅ ready | `gh` CLI + `gh auth login` | `omnireach setup github` |
| rss | ✅ ready | 内置 feedparser | query 必须是 URL |
| google | 🔴 heavy | Omnireach 原生 Chrome 桥;OpenCLI fallback | 任一 transport 可用时自动加入;后台临时 tab |
| reddit | 🔴 heavy | Omnireach 原生 Chrome 桥;OpenCLI fallback | 未登录可搜公开内容;Chrome 已登录时自动继承登录态 |
| twitter | 🔴 heavy | Omnireach 原生 Chrome 桥;OpenCLI fallback | 任一 transport 可用时自动加入;继承 Chrome 登录态 |
| xiaohongshu | 🔴 heavy | Omnireach 原生 Chrome 桥;OpenCLI fallback | 继承当前 Chrome 登录态 |
| tiktok | 🔴 heavy | Omnireach 原生 Chrome 桥;OpenCLI fallback | TikTok 国际版;从真实 DOM 提取结果 |
| douyin | 🔴 heavy | Omnireach 原生 Chrome 桥;OpenCLI 仅对 search 有回退 | 原生路径继承当前 Chrome 登录态,不调用 OpenCLI。`omnireach author` 没有 OpenCLI 等价物,必须走桥 |
| agy | 🚧 experimental | 已登录 agy CLI + 专用 conversation | 仅显式 `--on agy`;复用 agy 服务端 grounded WebSearch |
| 💎 tavily | booster | env `TAVILY_API_KEY` | 付费 (v0.4) |
| 💎 brave | booster | env `BRAVE_API_KEY` | 付费 (v0.4) |
| 💎 perplexity | booster | env `PERPLEXITY_API_KEY` | 付费 (v0.4) |
| 💎 exa | booster | env `EXA_API_KEY` | 付费 web search (v0.5) |
| wechat | ✅ ready | 无 (可选 `EXA_API_KEY` 增强) | 微信公众号 — search 走 Sogou 免费搜索; `EXA_API_KEY` 可选启用语义增强; v0.10.1 起 `omnireach fetch ` 自动走 OpenCLI 登录态 Chrome 拿正文 |
| bilibili | ✅ ready | 无 (可选 `EXA_API_KEY` 增强) | B站 — v0.9 起默认走 B站官方 search API; `EXA_API_KEY` 可选启用语义增强 |
> **原生浏览器源**: 运行 `omnireach bridge install`,在 `chrome://extensions` 中一次性加载输出目录里的未打包扩展,并在同一 Chrome profile 登录需要的网站。默认 `auto` 对 Google、Reddit、Twitter、小红书、TikTok、抖音优先走这个零新增依赖的原生路径,再回退 OpenCLI。设置 `OMNIREACH_BROWSER_TRANSPORT=native` 可验证全程没有调用 OpenCLI。
> **agy grounded search**: 保持一个已登录的 `agy` CLI 进程运行,创建专用 conversation,然后执行 `omnireach agy configure `。用 `omnireach agy status --json` 验证,再通过 `omnireach search --on agy --json "query"` 显式调用。
> **微信公众号 fetch**: Sogou 零配置搜索现在会在同一 HTTP session 内把签名跳转链接解成直达 `mp.weixin.qq.com` URL;fetch 再用 Daily-AC/OpenCLI fork 的 `weixin download --stdout`,显式创建后台临时 tab,命令结束立即释放。
---
## Agent 调用约定
Agent 应优先调用 `omnireach_search` 做搜索、`omnireach_fetch` 读取网页,并用
`omnireach_parse_media` 解析音视频元数据或字幕,`omnireach_download_media` 有界下载抖音 MP4。只有 MCP 不可用时才回退 CLI;走 CLI 时,**永远显式拿 JSON**:
```bash
# 方式 1:每条命令加 --json
omnireach search --json "..."
omnireach fetch --json ""
omnireach media parse --json ""
# 方式 2:env var(推荐给 agent harness 统一设)
export OMNIREACH_FORCE_JSON=1
```
v0.9.2 加的 `not isatty()` 自动 JSON 在大多数场景够用,但有些 agent 终端(如 Antigravity)给子进程分配真 PTY 让 `isatty()=True`,自动检测失效 —— 显式 `--json` 或 env var 是 always-works 保险。只要带 `--json`,CLI 参数错误也会从 stdout 输出 JSON error envelope。fetch 会拒绝短验证页和登录墙占位内容,不再把“非空”直接算成功;Reddit 验证墙错误会给出登录态 OpenCLI fallback。
完整 Skill 契约:[`skills/omnireach/SKILL.md`](./skills/omnireach/SKILL.md)
---
哪些人具体需要这个?(WebSearch 两层 gate 详解)
Claude Code 的 WebSearch 是**服务端 server tool**(`web_search_20250305`),真实可用性经过**两层独立 gate**:
**Gate 1 — 客户端 gate**(`WebSearchTool.isEnabled()` 看 `getAPIProvider()`):
- 默认 `firstParty`(没设 `CLAUDE_CODE_USE_*` env var,包括只改了 `ANTHROPIC_BASE_URL` 的情况)→ tool **注册**
- 显式 `CLAUDE_CODE_USE_BEDROCK=1` → tool **关**
- 显式 `CLAUDE_CODE_USE_VERTEX=1` + Claude 4+ → 注册;老 Claude → 关
- 显式 `CLAUDE_CODE_USE_FOUNDRY=1` → 注册
**Gate 2 — 上游 server tool 实现 gate**:客户端把 tool schema 发出去后,上游 API 必须**专门实现** `web_search_20250305` 这个 server tool(接收 tool call → 跑搜索 → 返结果给客户端):
- 真 Anthropic API (api.anthropic.com): ✓ 服务端原生跑
- Vertex / Foundry: ✓(各自 backend 实现了)
- **专门支持 Claude Code 的第三方模型厂**(e.g. DeepSeek 的 Anthropic-compat 端点): ✓ 他们专门做了 server tool 处理,接到自己的搜索后端
- **OpenAI 兼容中转站**(cliproxy / anyrouter 等,把 Claude API → OpenAI Chat Completions 单纯转译): ✗ 不识 server tool 这套语义
- **自托管 gateway / 大部分 proxy**: ✗ 一般不专门实现
Gate 2 看的是**「上游有没有专门做 Claude Code server tool 兼容」**,不是「是否真 Anthropic」。专门支持 Claude Code 的厂商(包括 DeepSeek,它不是真 Anthropic 但 WebSearch 工作)都实现了;单纯做 API 转译的中转站不实现。
**各常见痛点的根因不同**:
- 用 DeepSeek 等专门支持 Claude Code 的第三方:两层 gate 都过,WebSearch ✓ —— omnireach 对这群人的价值是补纵向源(Twitter/小红书/微信),不是补 search
- OpenAI 兼容中转站用户:客户端发了 tool,**上游没实现 server tool 处理** → 失败
- 显式 Bedrock 用户 / Vertex Claude 3.x 用户:客户端 `isEnabled` 就关
**就算你的 WebSearch 完全工作**,它也搜不全 —— Twitter 实时讨论 / Reddit 深度评论 / 小红书种草 / 微信公众号 / 抖音 / B站技术视频,这些登录墙纵向源服务端 WebSearch 几乎都够不着。omnireach 的三重价值:
1. 给客户端 gate 关掉的用户**补缺**
2. 给上游不实现 server tool 的用户**补缺**
3. 给 WebSearch 可用但搜不到纵向源的用户**补纵向**
关于命名与架构(search / fetch / parse 三层)
**omnireach** = `omni`(全部)+ `reach`(触达)。完整的「触达全网」语义需要三层能力,三层都将作为**本 repo 内的 sibling binary** 存在(类比 `cargo` / `rustc` / `rustfmt` 同 Rust repo 模式,**不开 sister repo**):
| 层 | 实现 | 职责 | 状态 |
|---|---|---|---|
| **search** | `omnireach search` subcommand | 全网定位 — 返 metadata + URL,不取内容 | ✅ v0.7+ 在用 |
| **fetch** | `omnireach fetch` subcommand | 给定 URL 取全文 markdown — 普通网页走内置无浏览器 HTTP → [Jina Reader](https://r.jina.ai/),登录墙微信走后台 OpenCLI | ✅ |
| **parse** | (暂未实现,未来加在本 repo) | 视频/音频内容解析(字幕/STT/逐帧) | 🔜 未启动 |
v0.10 起 `omnireach` 同时负责 search + fetch 两层(subcommand 形式)。视频解析暂仍走 yt-dlp / whisper 等外部工具组合;parse binary 等真有用户需求才在本 repo 加(YAGNI,不开 sister repo)。
这样拆是有意为之——对照 Anthropic 自己的 [WebSearch](https://docs.anthropic.com/en/docs/build-with-claude/tool-use/web-search) + [WebFetch](https://docs.anthropic.com/en/docs/build-with-claude/tool-use/web-fetch) 拆分:每层 do one thing well,search 不被解析任务拖累延迟,Agent 调用方有自由组合空间。
> 曾考虑把 `omnireach` 改名 `omnisearch`,但 v0.10 落地 `omnireach fetch` subcommand 后该问题消解 —— `omnireach search`(触达 = 找)+ `omnireach fetch`(触达 = 取)都是 reach 的合理子动作,umbrella 名留给项目愿景。**不改名**(2026-05-27 确认)。
升级
omnireach 还在 alpha 频繁迭代。检查 + 升级:
```bash
omnireach check-update # 比对 GitHub Releases
uv tool install --force git+https://github.com/Daily-AC/omnireach.git # 拉最新
```
> ⚠️ `uv tool upgrade omnireach` **不会**拉新 commit(uv 把 git URL 装的工具锁在 install 时的 commit 上)。`--force` 重装才会 fetch 最新。
平台支持
| 平台 | 状态 | 说明 |
|---|---|---|
| macOS | ✅ 主要开发平台 | 内置 HTTP、Jina、OpenCLI 微信、Twitter、TikTok、抖音、Sogou 微信与 B站均跑过真实 E2E;Crawl4AI 保留为可选项 |
| Linux | 🟡 best-effort | 应能 work;setup 流程对 `apt`/`pacman` 不自动 |
| WSL2 | 🟡 best-effort | 跟 Linux 一样 |
| Windows(原生 PowerShell) | 🟡 实验性 (v0.6.3+) | 代码已 macOS 假设解耦:secrets.env 不再调 POSIX chmod;preferences edit fallback notepad;setup github 提示加 `winget install GitHub.cli`;OpenCLI 类源(twitter/xhs)跨平台理论可用但未实测。**遇到问题请提 issue。** |
跑 `omnireach doctor` 会在顶部打印一行 platform / Python 版本,方便提 issue 时附上。
💎 付费 booster (v0.4)
omnireach 默认完全免费。如果你愿意配置付费 API Key,结果质量会更高:
```bash
omnireach setup tavily # 引导拿 Key + 写入 ~/.omnireach/secrets.env
omnireach setup brave
omnireach setup perplexity
omnireach setup exa # v0.5 新增(替代旧 web 源)
```
检测到 Key 后自动启用。结果元数据 `cost="paid"`,TTY 显示前缀 💎,便于审计。
要禁用:编辑 `~/.omnireach/preferences.toml` 设 `[boosters] auto_enable = false`。
⚙️ 用户偏好 (v0.4)
`~/.omnireach/preferences.toml` 可配置默认源、语言、输出格式、`source_trust` 覆盖。
`[media] cookies_from_browser` 给 `omnireach media inspect / parse / download` 指定默认的 yt-dlp 浏览器 cookie 源,不用每次调用都重复写授权过的 profile。显式 `--cookies-from-browser` 永远优先;这条偏好不会把 B 站从它免 cookie 的原生后端上挪走。
```toml
[media]
cookies_from_browser = "chrome:Profile 1"
```
```bash
omnireach preferences show # 查看当前配置
omnireach preferences edit # 用 $EDITOR 编辑
omnireach preferences reset # 重置(备份原文件到 .bak)
omnireach preferences path # 打印文件位置
```
如何取全文 (v0.8)
omnireach 是 search 层,`content` 字段统一截到 ≤ 500 字 + `…`。Validator 在 contract 层(`SearchResult.content` pydantic `field_validator`)对**所有源**生效,任何源的 content 超过 500 都会被截。这是有意为之——全文留给 `omnireach fetch` 层处理。
对于上游本身就返全文的源(wechat / exa / tavily)或返长 thread 的源(twitter),**完整原始 payload 保留在 `result.raw` 字典里**,agent 想要全文时直接取:
```python
# Python(调用 CLI + 解析 JSON envelope)
import json
import subprocess
out = subprocess.run(
["omnireach", "search", "--json", "--on", "wechat", "claude 4.7"],
check=True, capture_output=True, text=True,
)
env = json.loads(out.stdout)
snippet = env["results"][0]["content"] # 500 字 + "…"
full = env["results"][0]["raw"]["text"] # Exa / wechat / twitter 全文
# tavily 对应 raw["content"]
```
```bash
# CLI + jq
omnireach search --json --on tavily "claude 4.7" | \
jq '.results[] | {title, snippet: .content, full: .raw.content}'
```
字段对应表(经 v0.8.1 + v0.9 真实 E2E 校正):
| 源 | `result.adapter` | `result.content` | `result.raw[...]` 取全文/原始 |
|---|---|---|---|
| wechat(默认 Sogou) | `sogou` | snippet(Sogou SERP 摘要) | `raw["item_html"]`(完整 Sogou 卡片 HTML)—— 真要全文要进 mp.weixin.qq.com |
| wechat(EXA_API_KEY 启用) | `exa-api` | snippet | `raw["text"]`(Exa 全文) |
| bilibili(默认 B站 API) | `bilibili-api` | 视频 description(≤500) | `raw` 整个 video item dict,含 desc/cover/aid/bvid |
| bilibili(EXA_API_KEY 启用) | `exa-api` | snippet | `raw["text"]` |
| exa | `exa-api` | snippet | `raw["text"]` |
| tavily | `tavily-api` | snippet | `raw["content"]` |
| twitter | `opencli` | snippet(长 thread 会触发截断) | `raw["text"]` |
| xiaohongshu | `opencli` | 空 —— OpenCLI 搜索结果不含正文 | n/a(search 层无全文) |
`raw[...]` 的具体 key 名跟上游 API schema 直接对应,上游若改 schema 这里也得跟着调;不确定可以先 `print(result.raw.keys())` 探一下。
其他源(HN / GitHub / RSS / YouTube 等)的 content 一般 < 500 字,多半 validator no-op,但不保证——真要全文兜底,看 `result.raw` 有没有对应 key。
### 真要全文怎么办 → `omnireach fetch ` (v0.10+)
v0.10 起 `omnireach fetch ` 是 search → 全文 pipeline 的官方收敛形态,**host-aware** 自动选 backend:
```bash
# 任意网页 → 内置 HTTP 提取,遇到拦截再回退 Jina
omnireach fetch https://example.com/article --json
# 微信公众号 → 自动走 OpenCLI 登录态 Chrome(v0.10.1+),绕过验证码
omnireach fetch https://mp.weixin.qq.com/s/ --json
# search → fetch pipeline 一气呵成
omnireach search --on wechat "claude 4.7" --json \
| jq -r '.results[].url' \
| xargs -I{} omnireach fetch --json {}
```
Backend 矩阵:
| URL host | `--backend auto` 走 | 备注 |
|---|---|---|
| `mp.weixin.qq.com` | **opencli**(登录态 cookie-strategy) | 固定传 `--window background --site-session ephemeral --keep-tab false`,不需要可见浏览器窗口 |
| 其它 host | **http → jina** | 先走内置无浏览器提取;被拦或提取失败时回退 Jina Reader |
显式 `--backend` 覆盖 auto:
| Flag | 行为 |
|---|---|
| `--backend http` | 强制走内置 HTTP + HTML-to-Markdown,不依赖浏览器 |
| `--backend jina` | 强制走 [Jina Reader](https://r.jina.ai/) SaaS —— 零本地依赖,免费额度大 |
| `--backend crwl` | 显式使用本地 Crawl4AI 抓需要浏览器渲染的页面 |
| `--backend opencli` | 强制走 OpenCLI weixin 登录态路径(仅 mp.weixin.qq.com 有意义) |
验证码页不再被当成成功正文返回。auto 模式会在 `errors[]` 记录 `captcha_suspected` 并尝试下一个 backend;全部失败时仍输出 JSON,但进程返回非零。`omnireach doctor` 同时报告内置 HTTP 和 OpenCLI 后台 tab 契约是否可用。
设计文档
详见 `docs/design/2026-05-25-omnireach-design.md`。
License
MIT —— 见 [LICENSE](LICENSE)。