 # ASMR Dubber
**给音声配上另一种语言。原声的位置在哪,配音就在哪。**
识别、翻译、音色克隆配音、混音、字幕,一个程序做完。
支持日语、英语、中文的音频和视频,可以配成中文或英文。 [](https://github.com/EveningStudy/asmr-dubber/releases/latest)  [](LICENSE) **简体中文** · [English](README.en.md) [下载](https://github.com/EveningStudy/asmr-dubber/releases/latest) · [三分钟上手](#三分钟上手) · [使用手册](docs/USER_GUIDE.md) · [全部文档](docs/INDEX.md)
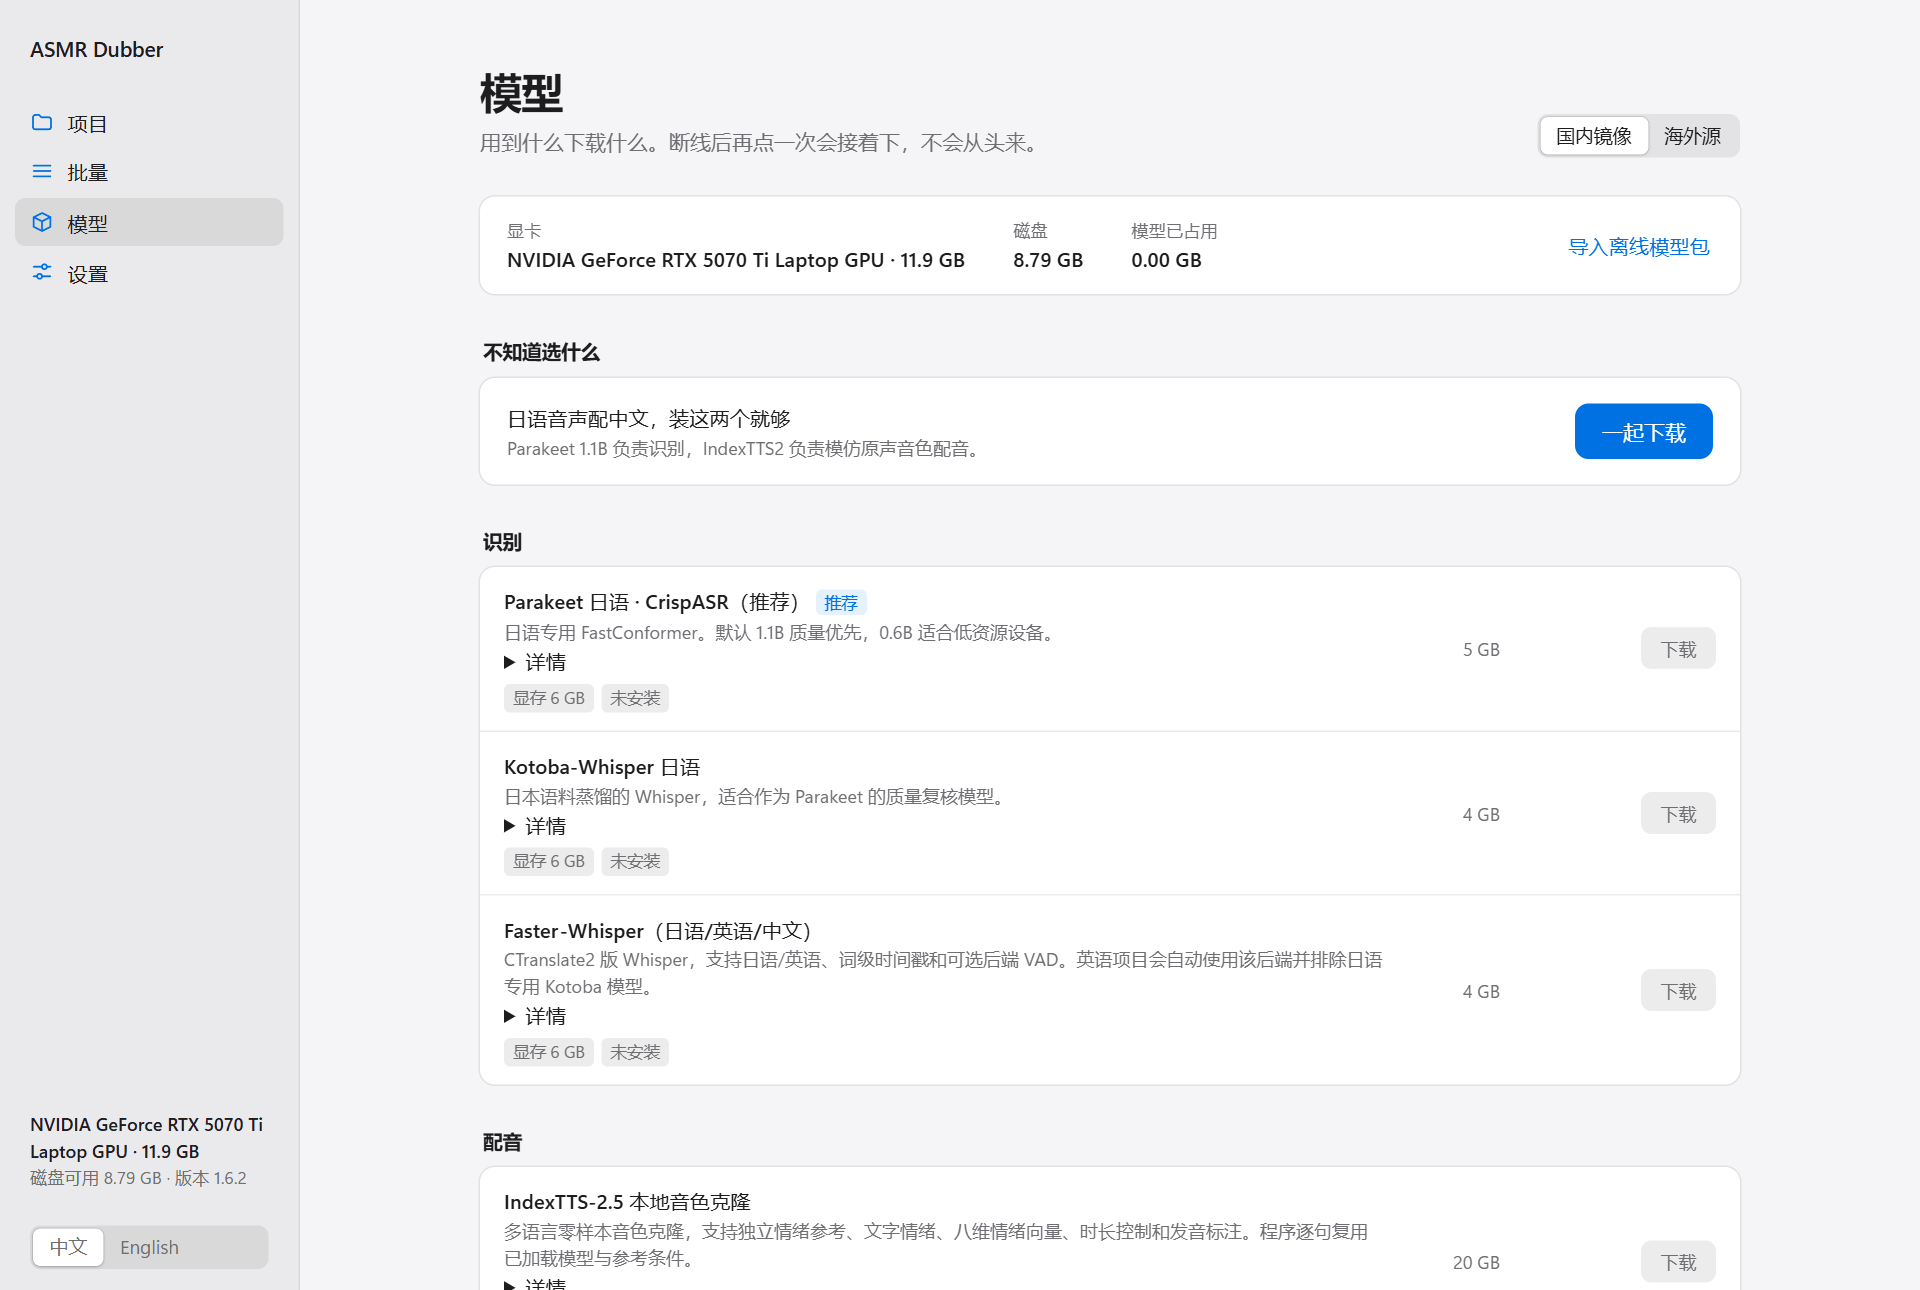
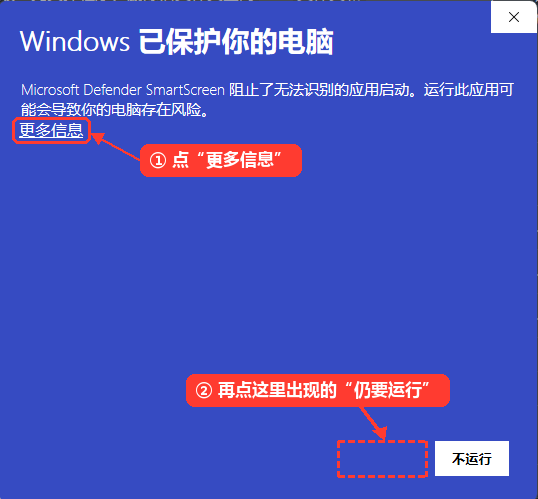 **2. 下载模型。** 打开“模型”页,点“一起下载”。这会装上日语识别模型 Parakeet 和音色克隆模型 IndexTTS2。原声是英语或中文的话,识别模型改下 Faster-Whisper。
**3. 填翻译 Key。** 打开“设置 → 云端服务”,给 DeepSeek(或你有账号的任何一家)填上 API Key。
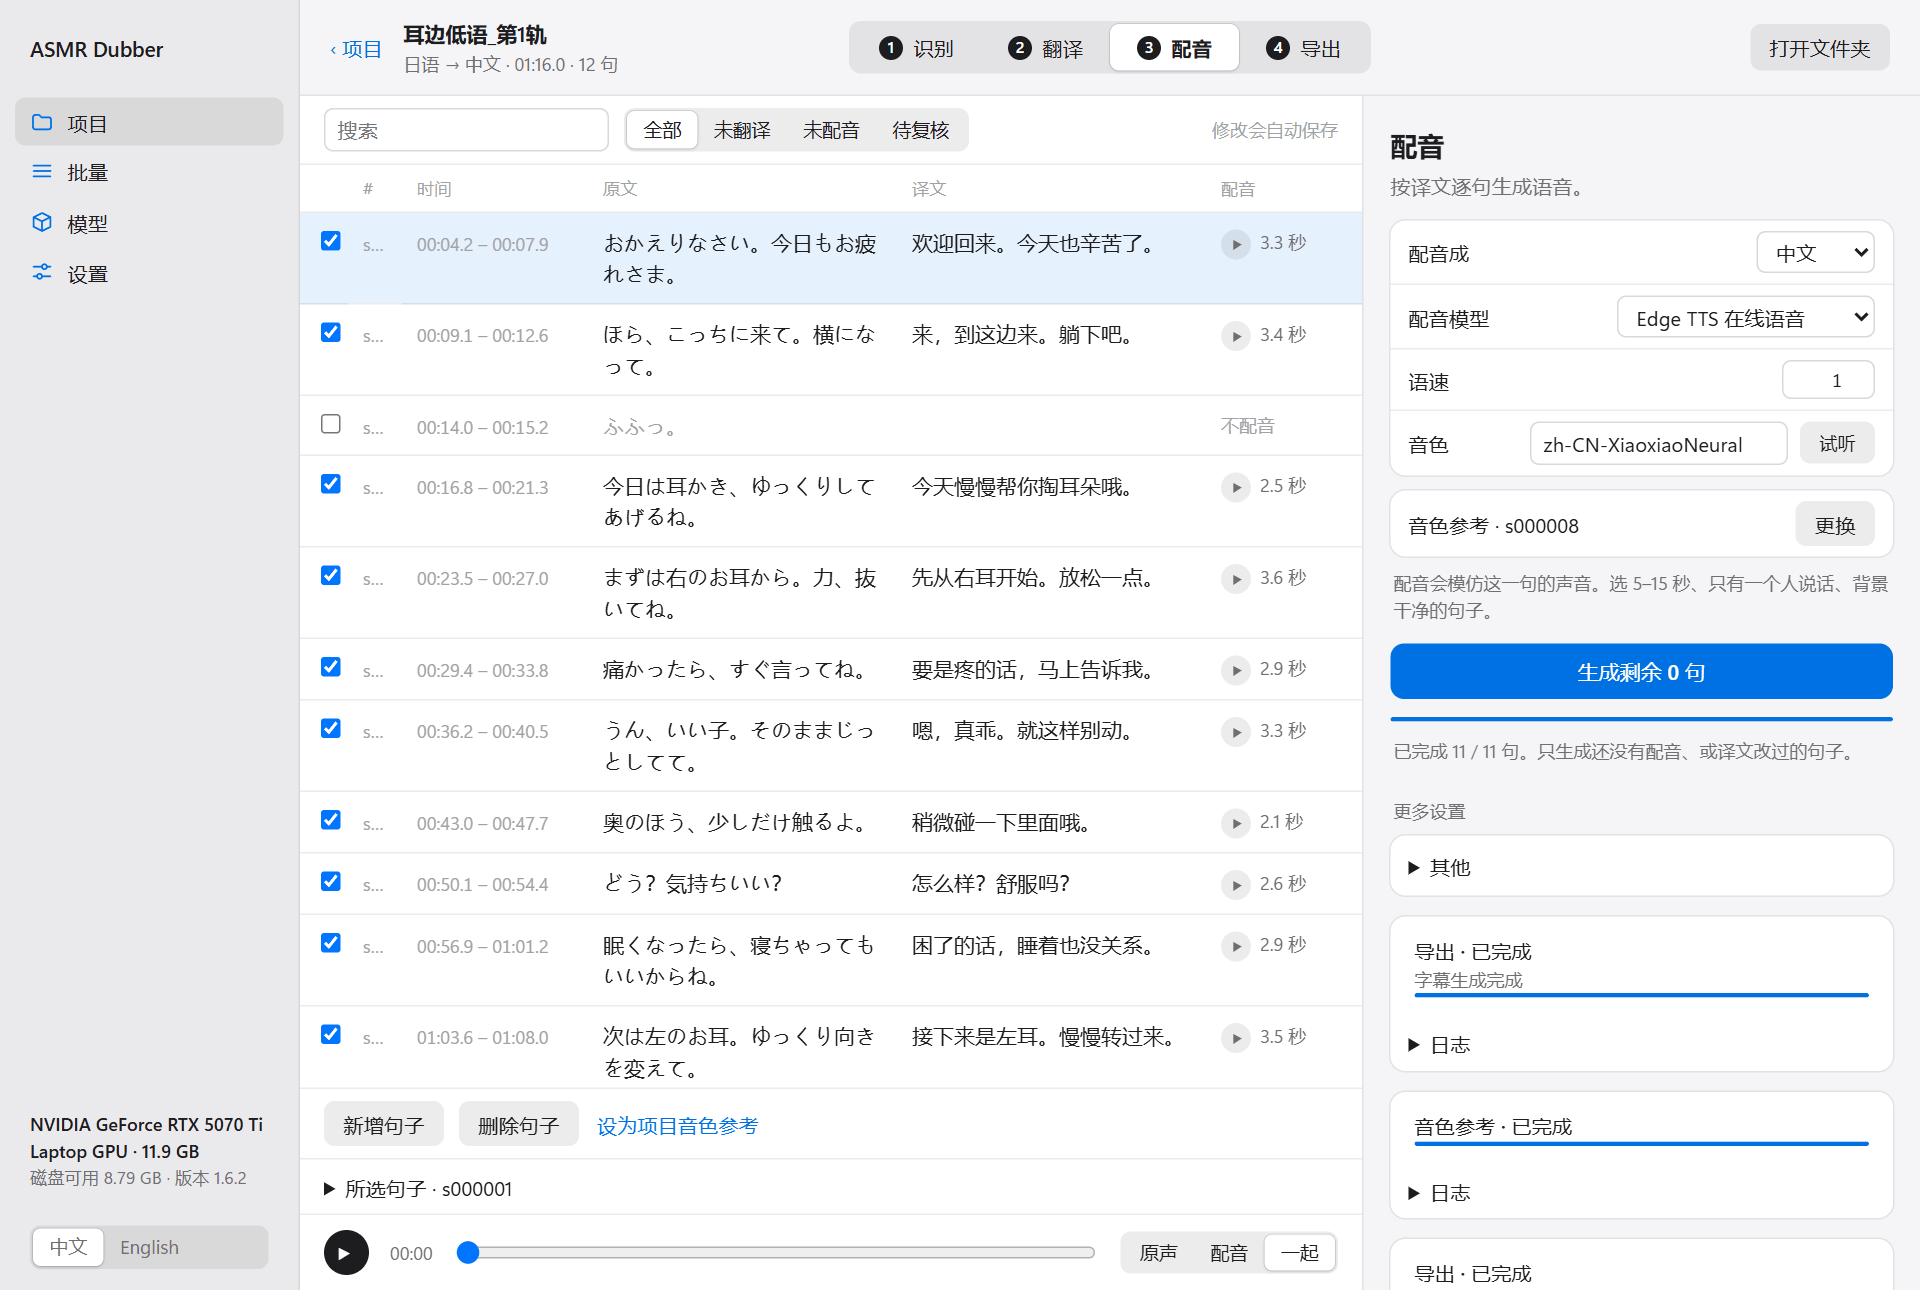
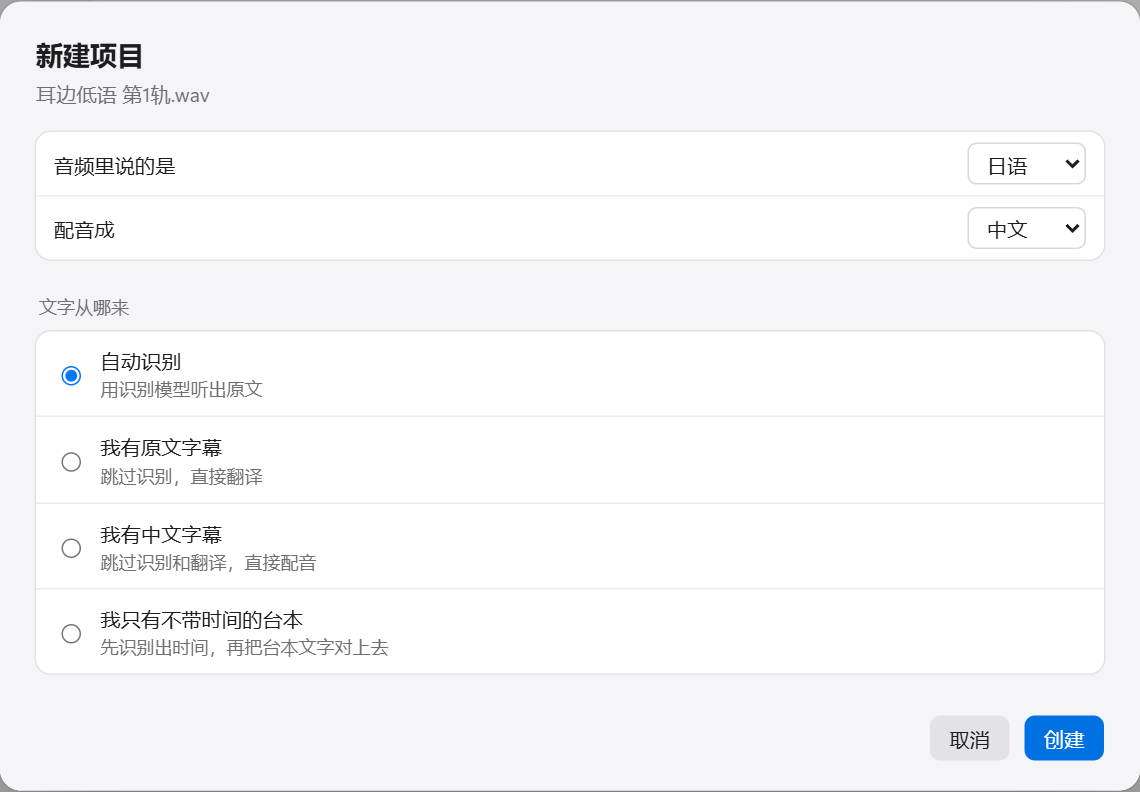
**4. 开始做。** 回到“项目”页,把音频拖进去,选好原声和配音的语言,然后按顶部的四步走:**识别 → 翻译 → 配音 → 导出**。
 没有显卡也能用:配音选内置的 Edge TTS(联网即可,音色固定),识别用处理器跑,会慢一些。
完整的图文步骤在[使用手册](docs/USER_GUIDE.md)。Linux 的启动方式见[安装与模型](docs/INSTALLATION.md#linux-和-wsl2)。
## 文档
| 我想…… | 看这篇 |
|---|---|
| 装好程序、下载模型 | [安装与模型](docs/INSTALLATION.md) |
| 从头做一个音频 | [使用手册](docs/USER_GUIDE.md) |
| 一次处理整个作品文件夹 | [批量处理](docs/BATCH.md) |
| 用现成的字幕或台本 | [字幕与台本](docs/SUBTITLE_WORKFLOW.md) |
| 调空间跟随、音量,做替换版 | [混音与空间跟随](docs/EXPERIMENTAL_AUDIO.md) |
| 让多个模型互相校对识别结果 | [多模型复核](docs/AUDIO_REVIEW_TUTORIAL.md) |
| 换别的识别模型、配音服务、翻译服务 | [模型与服务](docs/BACKENDS.md) |
| 弄清设置存在哪、清理磁盘、备份 | [设置与存储](docs/CONFIGURATION.md) |
| 查某个参数是什么意思 | [参数表](docs/PARAMETERS.md) |
| 解决报错 | [常见问题](docs/TROUBLESHOOTING.md) |
开发相关:[架构](docs/ARCHITECTURE.md) · [命令行](docs/CLI.md) · [贡献](CONTRIBUTING.md) · [全部文档](docs/INDEX.md)
## 需要知道的几件事
- **数据都在程序文件夹里。** 项目、模型、设置都在 `.asmr-dubber` 目录下。备份或搬家时复制整个文件夹。
- **API Key 是明文保存的。** 位置在 `.asmr-dubber/config/secrets.json`,不要把这个文件夹发给别人。
- **用云端服务时,内容会发给服务商。** 翻译会发送台词文本,云端配音会发送译文和参考音频。全部用本地模型时不会上传任何东西。
- **人声分离和替换版是实验性功能。** 可能残留原声,也可能损伤音效。
## 许可
项目代码采用 [MIT](LICENSE) 许可。模型、运行时、云服务、输入作品与生成内容适用各自的规则,不因代码开源而自动获得使用授权。见[第三方声明](docs/THIRD_PARTY_NOTICES.md)。
## 友链
- [LINUX DO](https://linux.do/):新的理想型社区