Biz Novel Studio · 从一句灵感,走向一本完整小说
AI 帮你规划世界与角色、逐章写作、检查和保存,让长篇创作有一条可以继续走下去的路。
Open-source AI novel writing assistant and long-form production studio.




下载 Windows 桌面版 · 项目介绍与文档 · 第一次使用 · 源码运行 · 问题反馈
--- 你只需要先有一个想法。这个工作台会帮你把方向、人物、世界和章节接起来,在创作过程中保留正文、设定与进度。长篇由自动导演持续推进,短篇走独立的完整成稿流程。它面向第一次写小说的人,也为需要维护长期资料、研究 AI 创作流程的作者与开发者提供更细的工具。 **桌面版适合直接开始写作;源码版适合开发和自行部署。** 模型需要使用你自己的 API 配置,知识库检索可按需启用。 [最新更新](#最新更新) · [能做什么](#现在已经能做什么) · [导演版本与模式](#导演版本与运行模式) · [Token 缓存优化](#token-缓存与调用优化) · [功能预览](#功能预览) · [文档导航](#文档导航) · [参与项目](#参与项目) ## 最新更新 ### 2026-10-21 桌面版本 `v0.5.19` 修复章节细化的场景与悬念误判;同日 `v0.5.18` 支持自定义自动导演单章预算。 #### 新增 - 在“设置 → 自动导演”设置单章 AI 用量上限,默认 100,000 Tokens,重启后保留;开始创作时也可为本次任务单独指定额度。 #### 优化 - 预算不足时保存进度并提示是否增加预算,可只调整本章,或同时应用于本任务后续章节;确认后从保存进度继续,已有正文和累计用量保留。 - 明确区分已达到上限与下一步预留不足,展示已用量、当前上限及建议额度;任务保留开始时的预算设置,后续修改全局默认不会改变进行中的任务。 #### 修复 - 细化章节时按实际任务、场景和承接关系检查内容,减少把合法场景安排或自然语言章末悬念误判为冲突、导致无法继续细化的情况。 完整历史更新见 [版本更新说明](./docs/releases/release-notes.md)。 --- ## 现在已经能做什么 | 你想完成的事 | 工作台怎样帮助你 | 了解更多 | | --- | --- | --- | | 把一个点子变成一本书的方向 | 自动导演整理题材、卖点、人物目标和候选方向;也可从热门题材或完成的拆书起步 | [小说与开书入口](./docs/public/modules/novels.md) | | 写一篇完整短篇 | 从想法与方向选择进入 3,000—30,000 字短篇生产,连续阅读、修改和导出;也可另建长篇延展原故事 | [短篇使用路径](#写一篇完整短篇) | | 持续写出后续章节 | V2 围绕授权范围推进近期规划、章节任务、场景、正文、检查与保存;V1 保留原工作流程 | [版本与模式说明](#导演版本与运行模式) | | 维护同一本书的世界与人物 | 保存本书世界、角色、关系和章节状态,查看世界地图与角色关系图,为后续创作提供资料 | [世界样本库](./docs/public/modules/world-sample-library.md) · [角色库](./docs/public/modules/character-library.md) | | 控制作品的表达方式 | 写法资产与反 AI 规则参与正文生成、检查和局部修文;检测与自动修正按本书设置生效 | [写法引擎](./docs/public/modules/style-engine.md) · [反 AI 规则](./docs/public/modules/anti-ai-rules.md) | | 学习参考作品并复用资料 | 拆书分析结构、人物与写法,回溯原文证据;结果可用于知识库、写法资产或参考开书 | [拆书工作台](./docs/public/modules/book-analysis.md) | | 让长期资料参与写作 | 知识库与 RAG 检索召回相关资料,配合本书世界、角色和写法组装章节上下文 | [知识库](./docs/public/modules/knowledge-base.md) | | 看懂 AI 在做什么、消耗多少 | AI 实况查看执行过程并在断线后重连;V2 小说用量页查看已记录的调用消耗;运行记录查看进度与来源 | [运行记录](./docs/public/modules/task-center.md) · [用量说明](#ai-用量怎么看) | | 减少连续创作中的重复消耗 | 稳定资料与动态剧情分开组织,保留可复用的输入前缀,并减少相同条件下的重复审校 | [Token 缓存与调用优化](#token-缓存与调用优化) | | 让不同任务使用合适的模型 | 在页面配置供应商、连接测试与模型路由,为规划、正文、审阅、拆书分别选择模型 | [模型设置](./docs/public/modules/system-settings.md) · [模型路由](./docs/public/modules/model-routing.md) | | 把小说延展成其他素材 | 从已有章节、人物与场景整理漫画分镜、角色视觉资产和短剧素材 | [漫画](./docs/public/modules/comic-workspace.md) · [短剧](./docs/public/modules/short-drama-workspace.md) | 创作中枢 **Creative Hub** 也提供对话式的创作引导、规划和工具调用,帮助你找到下一步。漫画与短剧适合在小说主线、角色和章节内容明确之后使用。[了解创作中枢](./docs/public/modules/creative-hub.md) ## 导演版本与运行模式 **长篇创作先选导演版本,再选这次怎样推进。V2 不等于全自动,V1 也不等于手动。** 短篇使用独立流程,不参与导演版本选择。 ### V1 与 V2 怎么选 | | 导演 V1 | 导演 V2 | | --- | --- | --- | | 使用入口 | 原导演与小说工作台,保留熟悉的分阶段创作入口 | 本书导演台,集中阅读目录、正文和资料,并推进下一段创作 | | 适合情况 | 继续原有小说,或希望沿用原工作台操作 | 从新书开始,按授权范围连续规划和生成 | | 任务与恢复 | 使用自己的任务、检查点与恢复流程 | 使用自己的运行、阶段结果与保存进度 | | 版本选择 | 历史小说保留所属版本 | V2 可用时,新书默认优先选择 V2 | 开书页可以选择可用的导演版本。已有小说需要先结束当前创作,再在本书设置切换;已保存正文与历史记录会保留。**切换版本只保存选择,不会自动开始生成,也不会恢复另一个版本的旧任务。** 桌面版和源码部署默认提供 V1/V2 选择;如需暂时关闭 V2,可显式设置 `DIRECTOR_NEXT_ENABLED=false`。此开关只控制 V2 是否可用,不会替已有小说更换导演。 ### V2 的全自动与按阶段确认 | 创作方式 | AI 怎样推进 | 你需要做什么 | | --- | --- | --- | | **全自动推进** | 在本次授权范围内补齐所需规划,写正文、检查和保存,普通阶段结果自动继续 | 先选择方向和范围;遇到明确暂停事项时处理,再从本书导演台继续 | | **按阶段确认(半自动)** | 在需要确认的阶段保存结果,等待你核对后继续;正文在批次收尾确认 | 打开本阶段结果,核对后点击确认;无需逐章手动触发整条链 | 书名旁与导演台顶部会显示当前方式,后续正文批次沿用所选模式。V2 的阶段确认在本书导演台完成;“运行记录”负责查看状态和打开来源页,继续、恢复、取消等操作在来源工作台处理。 ### 全自动为什么也可能停下 全自动会继续执行你授权的范围,**范围完成后需要你选择下一段**。例如提交第 1—3 章,完成后不会擅自写第 4 章。 遇到模型不可用、需要重新规划、用量保护或数据完整性问题时,系统也可能暂停。普通局部质量问题默认记录为章节提醒并继续;如果明确选择“质量优先”的处理策略,则可能在正文保存后等待人工处理。 V2 单章默认上限为 **100,000 Tokens**,累计包含该章的生成、检查、修文与资料整理调用。新章节按输入扣除供应商已报告的缓存命中后加输出计数;历史章节保留原计量方式。这是用量保护上限,与整次创作预算不同。达到上限时可在本书导演台查看原因,并按建议或自定额度继续本章,保留正文、累计用量和恢复位置。 ## 快速开始 ### 下载安装 普通写作使用推荐 Windows 桌面版,无需安装 Node.js、pnpm 或手动启动服务端。 | 选择 | 下载文件 | 适合谁 | | --- | --- | --- | | 安装版 | `Biz-Novel-Studio-<版本>-setup-x64.exe` | 长期使用,按安装向导完成安装 | | 便携版 | `Biz-Novel-Studio-<版本>-portable-x64.exe` | 希望从独立目录直接启动 | **[前往最新桌面版下载页 →](https://github.com/ExplosiveCoderflome/AI-Novel-Writing-Assistant/releases/latest)** ### 选择创作入口 | 想写什么 | 从哪里进入 | | --- | --- | | 连续推进的长篇小说 | 小说列表或首页的“AI 自动导演开书”,新书可选择 V2 | | 一次读完、有完整结局的短篇 | 小说列表或首页的“创作短篇”,由 AI 整理方向与篇幅 | | 参考一本作品开新书 | 先完成拆书,再从“照着一本书写”进入开书 | ### 用 V2 写出第一段正文 1. **配置模型。** 在系统设置填写供应商、API Key、API 地址和文本模型,完成连接测试;首次使用先确保一个模型可用。 2. **输入灵感。** 从小说开书入口选择 V2,输入故事想法。没有想法时可先看热门题材,有参考作品时可从完成的拆书进入。 3. **选择方向。** 查看候选方案和标题,选定这本书想写成的样子,再进入本书导演台。 4. **选择推进方式与范围。** 想让 AI 连续推进就选全自动,想核对阶段结果就选按阶段确认;先提交一小段章节,观察正文效果与用量。 5. **查看并继续。** 勾选“跟随生成”观看正文流式输出。范围结束后检查已保存章节,选择下一段;出现暂停时阅读原因,从本书导演台处理。 写法引擎、知识库和高级模型路由可以在跑通第一段正文后逐步配置。[安装与准备](./docs/public/installation.md) · [热门题材雷达](./docs/public/modules/market-radar.md) · [参考作品开书](./docs/public/modules/book-analysis.md) ### 写一篇完整短篇 配置好模型后,打开“创作短篇”,输入想法,让 AI 推荐方向与篇幅;选择方向后开始生成。调整篇幅或创作方向时,先让 AI 重新适配方案,再确认生产。 短篇按内部片段生成,阅读与导出呈现连续正文;成稿后进行全篇检查和至多一次必要修复。你可以直接编辑,也可以提出修改要求,核对 AI 的修改范围后确认。“发展成长篇”会创建新作品,保留原短篇。 ### AI 用量怎么看 在 V2 本书顶部或书架打开 **“AI 用量”**,先看全书已记录用量,再按章节、步骤、厂商、模型或状态筛选调用。规划、正文、审阅和修文都可能产生消耗,不能只按最终正文长度判断。 - **总 Tokens = 输入 Tokens + 输出 Tokens。** 缓存命中与未命中属于输入,不要再加一次。 - 缓存统计以厂商返回为准;没有提供的统计显示未知,不能当作零。固定规则与稳定资料更容易复用,正文和章节任务变化时命中率可能不同。 - 用量页覆盖已记录的调用;未记录的旧历史不会被估算补齐。Tokens 是调用计数,实际费用以厂商账单为准。 ### 遇到暂停或错误 先查看本书导演台的暂停原因,再从对应工作台处理;需要追溯时打开“运行记录”查看状态和来源。保存的正文与任务进度有独立边界,重复点击生成不能代替恢复。 [常见问题](./docs/public/faq.md) · [故障排查](./docs/public/troubleshooting.md) ## Token 缓存与调用优化 长篇创作会反复使用本书约定、写法与世界规则。工作台把可复用的规则和书级、卷级资料放在输入前部,再附上本章任务、当前状态与正文,为模型供应商复用相同前缀提供条件。缓存复用的是已处理过的输入,正文仍由模型基于本次任务生成。 ### 哪些部分做了优化 - **稳定资料前置。** 表达规则、作品约定和适用的世界规则按复用范围组织;每次读取当前资料,修改设置后后续调用使用新内容。 - **同章修文复用前缀。** 局部修文把本次修复重点放在同章资料和正文之后,资料与正文未变化时更容易复用前缀,同时保留写法、世界约束和秘密边界。 - **有效审校结果复用。** 正文、创作约定、检查规则、模型与参数等相关条件一致时,复用有效的检查结果,减少相同请求的重复调用。这与厂商的输入缓存是两种机制。 - **减少无效修文与复验。** 检查区分必须修复的缺口和普通表达建议,结合修改位置与实际效果处理局部问题,避免反复改整章;默认完成优先策略下,残余局部问题保留为质量提醒。 ### 不同步骤,复用空间不同 | 步骤 | 可以复用的主要资料 | 必须随创作更新的内容 | | --- | --- | --- | | 章节规划 | 书级定位、作品约定、适用的卷级目标 | 本章任务、近期结果、人物状态 | | 正文生成 | 写法与表达规则、作品约定、适用的世界规则 | 上章接续、本章事件、场景和人物状态 | | 章节检查 | 检查标准、同章任务与约定 | 当前待检查正文与修文结果 | | 局部修文 | 本书写法、同章资料、未变化的正文 | 本次问题证据、修复重点和追加要求 | | 写后资料整理 | 抽取规则、确实未变化的相关资料 | 新正文、角色变化、资源与伏笔状态 | 正文需要输入新的剧情和状态,这部分未命中是正常成本。首次调用、切换模型或通道、修改书级资料,也可能让命中量发生变化。优化效果应结合正文质量、输入命中与未命中 Tokens、输出 Tokens、调用次数和单章总用量一起判断。 ### 从哪里查看实际效果 在本书 **“AI 用量”** 中筛选同一章节、步骤与模型,比较连续调用的输入、输出、命中和未命中 Tokens。也可以在 **AI 实况** 中查看正在执行的调用。 **缓存命中与未命中都属于输入 Tokens,不在总用量之外重复相加。** 缓存统计以厂商实际返回为准,未提供的字段显示未知;缓存收益受厂商、模型与通道的机制影响,不能承诺固定命中率或节省比例。新建章节预算扣除已报告的有效命中量,原始调用总量仍完整保留,实际费用以厂商账单为准。 面向开发者的详细边界见[模型输入缓存 Wiki](./docs/wiki/prompts/llm-input-cache.md)与[小说 AI 用量说明](./docs/wiki/workflows/novel-ai-usage.md)。 ## 功能预览 以下截图展示现有功能示例,包含 V1 工作台与资料工具;界面与当前版本可能有差异。V2 的入口、模式与操作以[上方使用说明](#导演版本与运行模式)为准。 ### 章节写作与拆书 | V1 章节执行工作台 | 拆书与参考资料 | | --- | --- | | 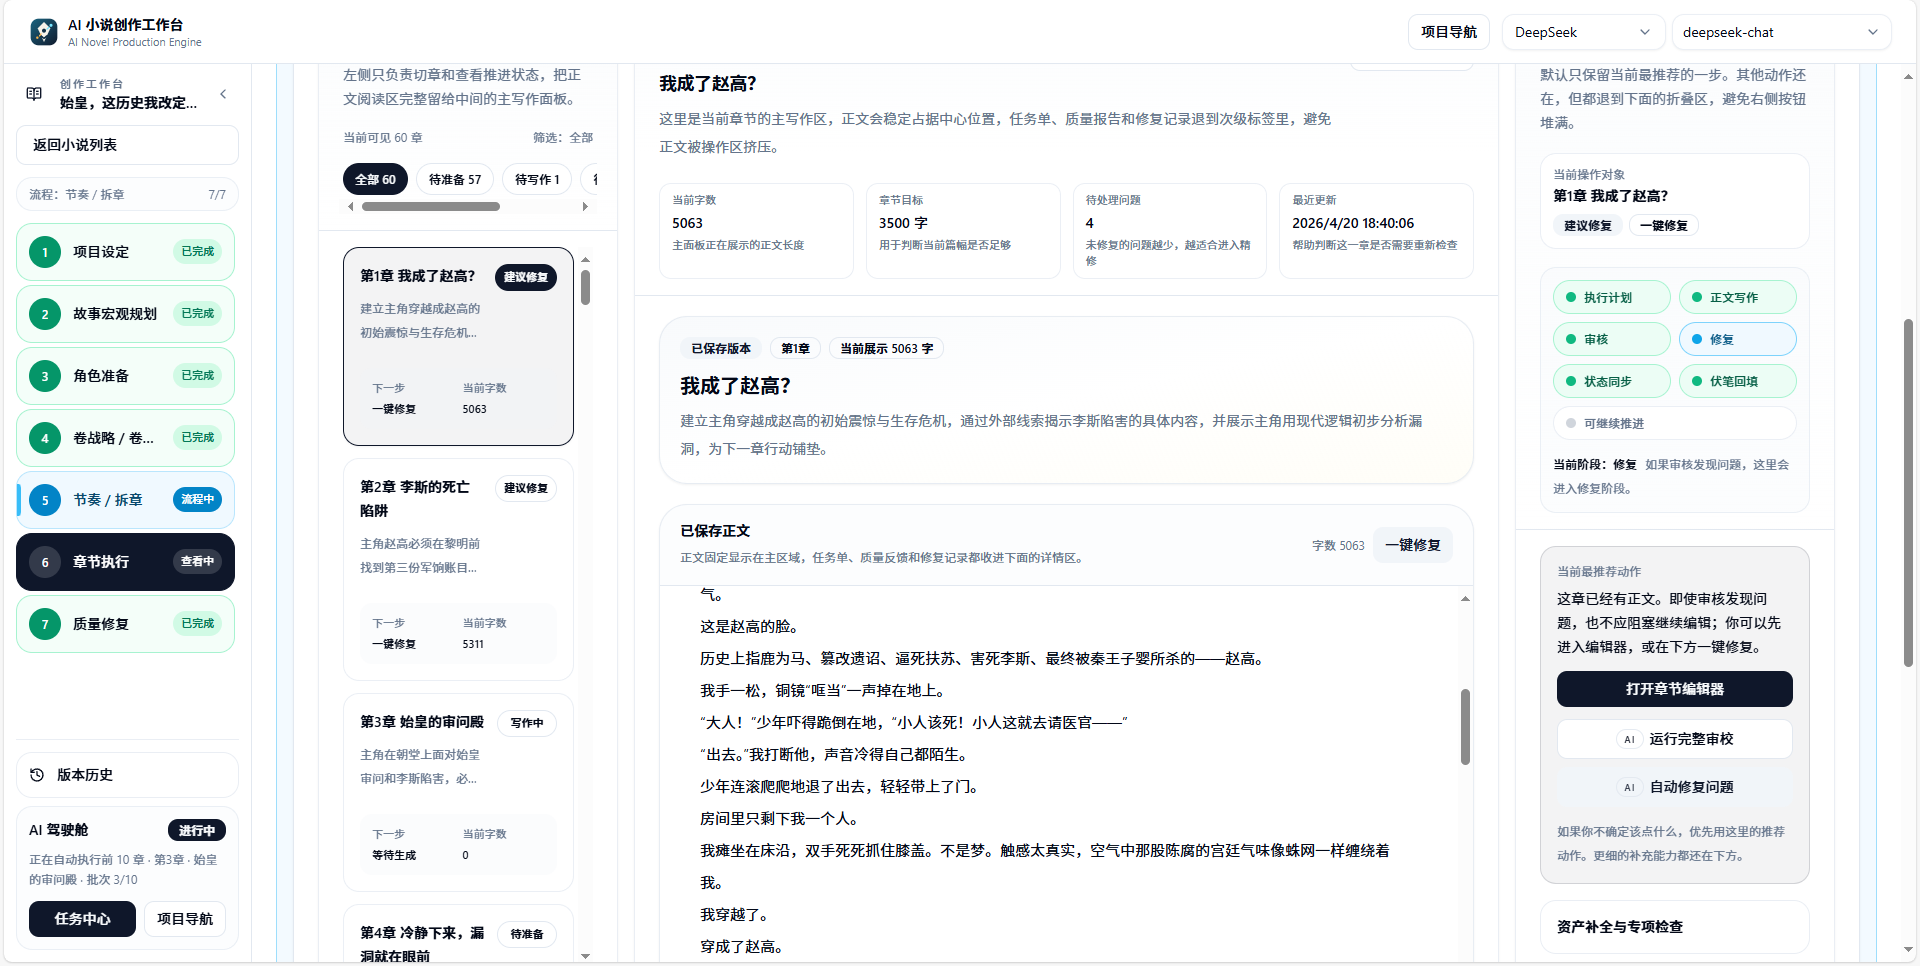 | 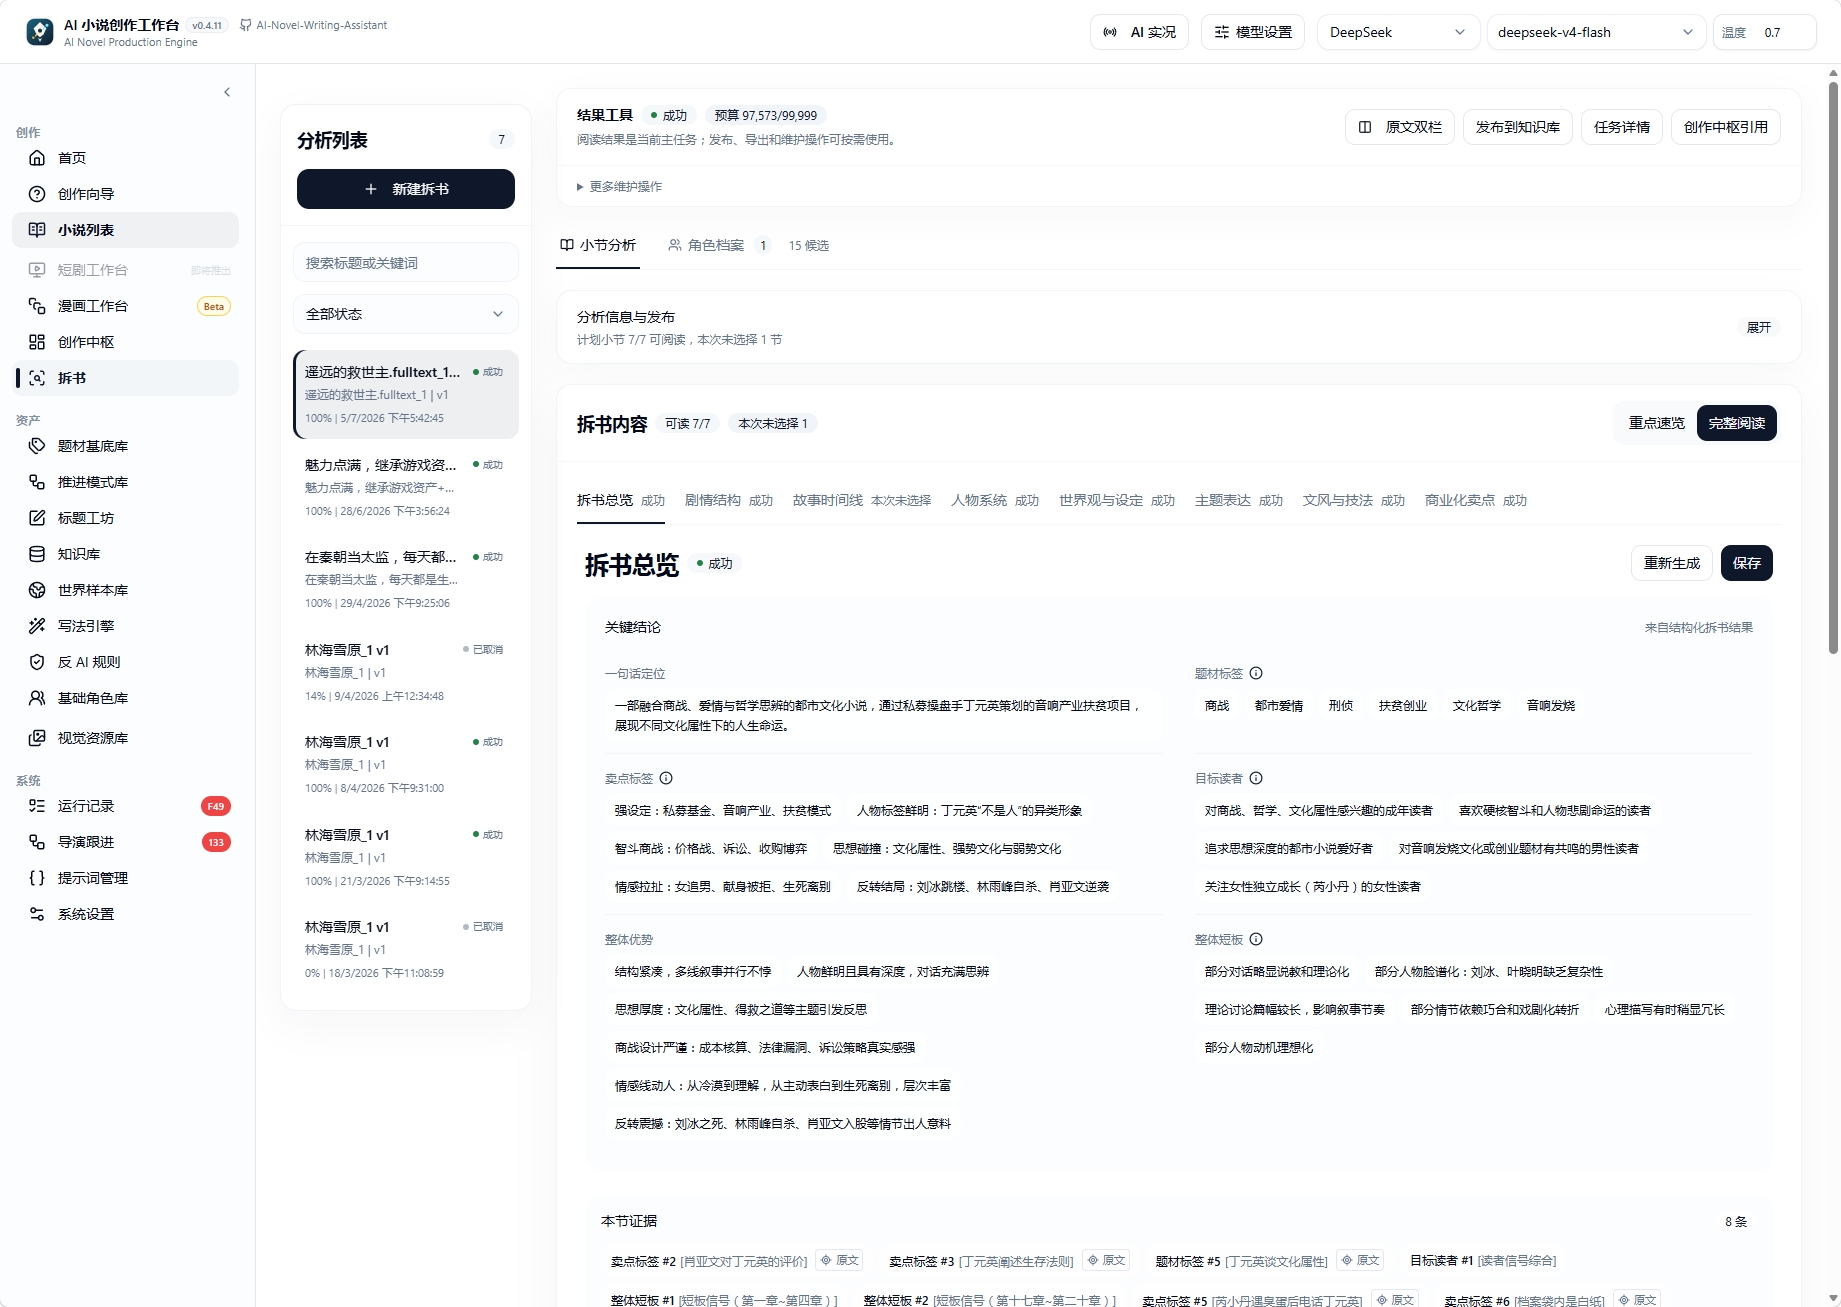 | | 正文、章节任务与检查结果围绕同一章组织。 | 从作品结构和原文证据中整理可复用的创作资料。 | |
 |