# 视频拆解报告:qing_hiphop_full.mp4
**结论**:混合制作:AI 生成视频 52% + 静态图 + 推拉动效 17% + 数字人口播 17% + 3D 渲染 15%;叠加层:文字标注、图形贴片、字幕(代码/剪辑软件合成);用到真实素材:真实照片(3.0s)、商品实拍图(0.7s);复刻需准备参考:人物/场景参考图(1 镜)、商品参考图(1 镜);声音:人声 + BGM 178.2BPM(AI 生成音乐) + 音效 56 处
- 时长 164.958s · 1080×1920 · 24.0fps · 9:16
- 镜头 86 个,平均 1.92s;转场:cut×85、start×1
- 判断置信度(按时长加权):71%;判定方式:确定性取证 + VLM 融合
- VLM 部分生效(gemini-3.1-pro-preview,gemini-3.1-pro-preview-pc,gcp-gemini-3-pro-preview:60/60 个镜头有结果,整片分析失败);由 claude 看图复核 9/86 个镜头,已并入结论
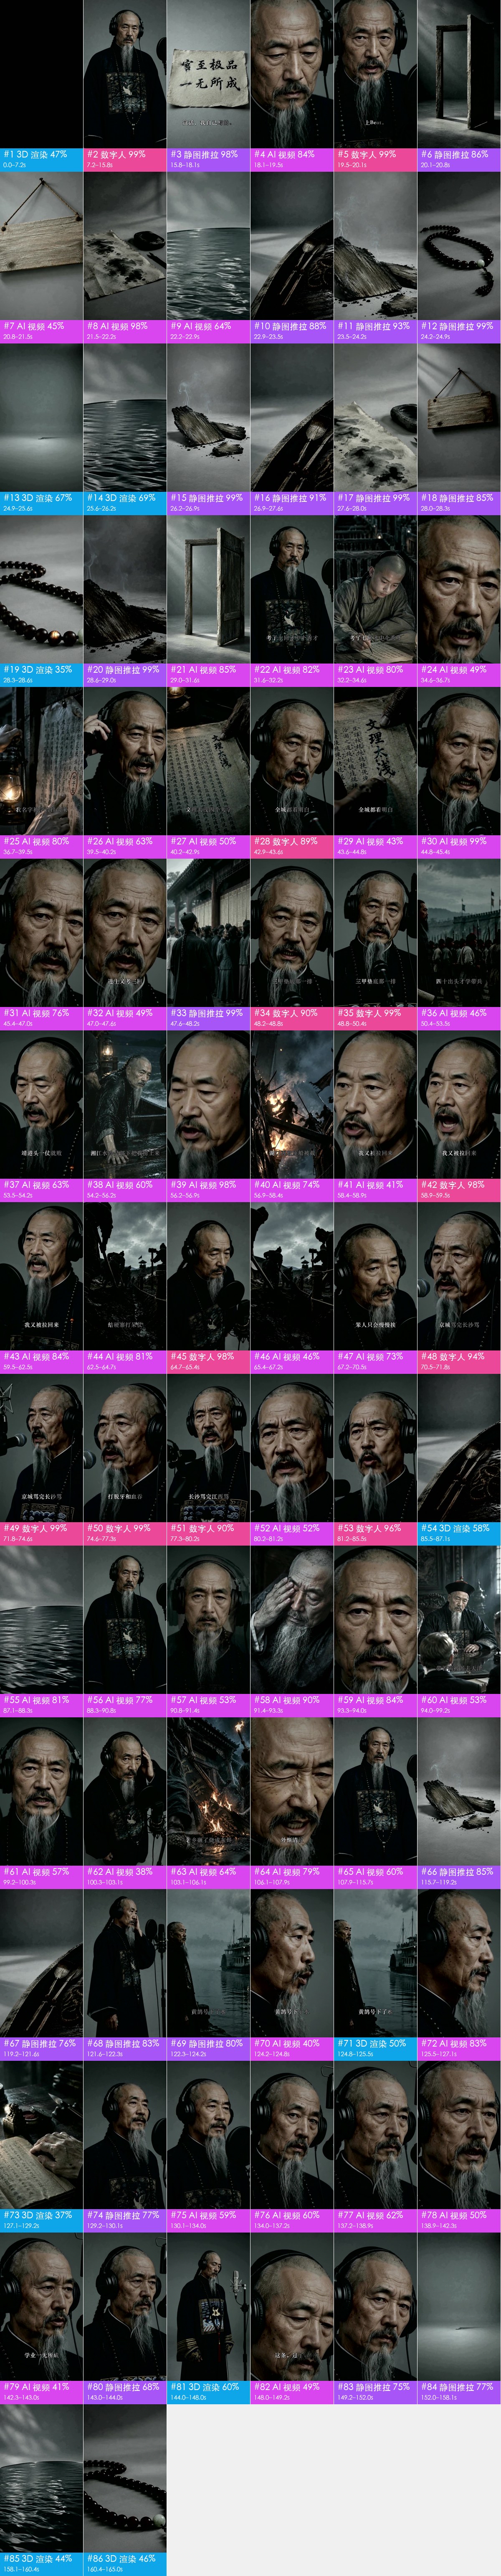
## 制作方式占比
| 底层画面 | 时长 | 占比 |
|---|---|---|
| AI 生成视频 | 86.04s | 52% |
| 静态图 + 推拉动效 | 27.46s | 17% |
| 数字人口播 | 27.25s | 16% |
| 3D 渲染 | 24.21s | 15% |
## 复刻方案
**3D 渲染 10 镜 + AI 视频 45 镜 → 34 个生成单元、34 次 Seedance 2.5 调用;静图推拉/静帧 19 镜 → 本地重建;数字人 12 镜 → TTS + 数字人驱动**
- 默认引擎 Seedance 2.0(含 Mini / Fast) 不支持一次多镜头,用它要逐镜生成 55 次;这里按 Seedance 2.5 规划(单次 ≤30s、可一次出多镜头),共 34 次
- 分组规则:同场景、硬切相连的 AI 镜头合并为一次生成(S01);单次 ≤30s;单元内连续硬切尽量 ≤8s、最多 10s(S06);在叠化/淡入淡出和换场景处切开(S03)
- 声音:模型可以同时生成动作音效和环境声;口播建议单独 TTS 再混进去,方便改文案和卡时间
### 生成单元
| 单元 | 镜头 | 时间 | 时长 | 方式 | 衔接 |
|---|---|---|---|---|---|
| G1 | #1 | 0.0–7.2s | 7.2s | 单镜 | 首帧:参照原片第 1 镜首帧(shots/shot_001_first.jpg)的构图出图,产品换成 @图片1 |
| G2 | #4 | 18.1–19.5s | 1.4s | 单镜 | 首帧:参照原片第 4 镜首帧(shots/shot_004_first.jpg)的构图出图,产品换成 @图片1 |
| G3 | #7 | 20.8–21.5s | 0.7s | 单镜 | 首帧:参照原片第 7 镜首帧(shots/shot_007_first.jpg)的构图出图,产品换成 @图片1 |
| G4 | #8 | 21.5–22.2s | 0.7s | 单镜 | 首帧:参照原片第 8 镜首帧(shots/shot_008_first.jpg)的构图出图,产品换成 @图片1 |
| G5 | #9、#13、#14 | 22.2–22.9s、24.9–26.2s | 2.0s | 一次多镜头 | 首帧:参照原片第 9 镜首帧(shots/shot_009_first.jpg)的构图出图,产品换成 @图片1 |
| G6 | #19、#21 | 28.3–28.6s、29.0–31.6s | 3.0s | 一次多镜头 | 首帧:参照原片第 19 镜首帧(shots/shot_019_first.jpg)的构图出图,产品换成 @图片1 |
| G7 | #22–#23 | 31.6–34.6s | 3.0s | 一次多镜头 | 首帧:参照原片第 22 镜首帧(shots/shot_022_first.jpg)的构图出图,产品换成 @图片1 |
| G8 | #24–#27 | 34.6–42.9s | 8.2s | 一次多镜头 | 首帧:参照原片第 24 镜首帧(shots/shot_024_first.jpg)的构图出图,产品换成 @图片1 |
| G9 | #29 | 43.6–44.8s | 1.2s | 单镜 | 首帧:参照原片第 29 镜首帧(shots/shot_029_first.jpg)的构图出图,产品换成 @图片1 |
| G10 | #30–#32 | 44.8–47.6s | 2.8s | 一次多镜头 | 首帧:参照原片第 30 镜首帧(shots/shot_030_first.jpg)的构图出图,产品换成 @图片1 |
| G11 | #36–#37 | 50.4–54.2s | 3.8s | 一次多镜头 | 首帧:参照原片第 36 镜首帧(shots/shot_036_first.jpg)的构图出图,产品换成 @图片1 |
| G12 | #38 | 54.2–56.2s | 2.0s | 单镜 | 首帧:参照原片第 38 镜首帧(shots/shot_038_first.jpg)的构图出图,产品换成 @图片1 |
| G13 | #39 | 56.2–56.9s | 0.7s | 单镜 | 首帧:参照原片第 39 镜首帧(shots/shot_039_first.jpg)的构图出图,产品换成 @图片1 |
| G14 | #40 | 56.9–58.4s | 1.5s | 单镜 | 首帧:参照原片第 40 镜首帧(shots/shot_040_first.jpg)的构图出图,产品换成 @图片1 |
| G15 | #41 | 58.4–58.9s | 0.5s | 单镜 | 首帧:参照原片第 41 镜首帧(shots/shot_041_first.jpg)的构图出图,产品换成 @图片1 |
| G16 | #43 | 59.5–62.5s | 3.0s | 单镜 | 首帧:参照原片第 43 镜首帧(shots/shot_043_first.jpg)的构图出图,产品换成 @图片1 |
| G17 | #44 | 62.5–64.7s | 2.1s | 单镜 | 首帧:参照原片第 44 镜首帧(shots/shot_044_first.jpg)的构图出图,产品换成 @图片1 |
| G18 | #46 | 65.4–67.2s | 1.8s | 单镜 | 首帧:参照原片第 46 镜首帧(shots/shot_046_first.jpg)的构图出图,产品换成 @图片1 |
| G19 | #47 | 67.2–70.5s | 3.4s | 单镜 | 首帧:参照原片第 47 镜首帧(shots/shot_047_first.jpg)的构图出图,产品换成 @图片1 |
| G20 | #52 | 80.2–81.2s | 1.0s | 单镜 | 首帧:参照原片第 52 镜首帧(shots/shot_052_first.jpg)的构图出图,产品换成 @图片1 |
| G21 | #54 | 85.5–87.1s | 1.7s | 单镜 | 首帧:参照原片第 54 镜首帧(shots/shot_054_first.jpg)的构图出图,产品换成 @图片1 |
| G22 | #55 | 87.1–88.3s | 1.2s | 单镜 | 首帧:参照原片第 55 镜首帧(shots/shot_055_first.jpg)的构图出图,产品换成 @图片1 |
| G23 | #56–#58 | 88.3–93.3s | 5.0s | 一次多镜头 | 首帧:参照原片第 56 镜首帧(shots/shot_056_first.jpg)的构图出图,产品换成 @图片1 |
| G24 | #59 | 93.3–94.0s | 0.7s | 单镜 | 首帧:参照原片第 59 镜首帧(shots/shot_059_first.jpg)的构图出图,产品换成 @图片1 |
| G25 | #60 | 94.0–99.2s | 5.2s | 单镜 | 首帧:参照原片第 60 镜首帧(shots/shot_060_first.jpg)的构图出图,产品换成 @图片1 |
| G26 | #61–#64 | 99.2–107.9s | 8.7s | 一次多镜头 | 首帧:参照原片第 61 镜首帧(shots/shot_061_first.jpg)的构图出图,产品换成 @图片1 |
| G27 | #65、#70 | 107.9–115.7s、124.2–124.8s | 8.4s | 一次多镜头 | 首帧:参照原片第 65 镜首帧(shots/shot_065_first.jpg)的构图出图,产品换成 @图片1 |
| G28 | #71 | 124.8–125.5s | 0.6s | 单镜 | 首帧:参照原片第 71 镜首帧(shots/shot_071_first.jpg)的构图出图,产品换成 @图片1 |
| G29 | #72 | 125.5–127.1s | 1.6s | 单镜 | 首帧:参照原片第 72 镜首帧(shots/shot_072_first.jpg)的构图出图,产品换成 @图片1 |
| G30 | #73 | 127.1–129.2s | 2.1s | 单镜 | 首帧:参照原片第 73 镜首帧(shots/shot_073_first.jpg)的构图出图,产品换成 @图片1 |
| G31 | #75–#77 | 130.1–138.9s | 8.8s | 一次多镜头 | 首帧:参照原片第 75 镜首帧(shots/shot_075_first.jpg)的构图出图,产品换成 @图片1 |
| G32 | #78、#79、#81、#82 | 138.9–143.0s、144.0–149.2s | 9.3s | 一次多镜头 | 首帧用 G31 的尾帧,接上动作(S05) |
| G33 | #85 | 158.1–160.4s | 2.2s | 单镜 | 首帧:参照原片第 85 镜首帧(shots/shot_085_first.jpg)的构图出图,产品换成 @图片1 |
| G34 | #86 | 160.4–165.0s | 4.6s | 单镜 | 首帧:参照原片第 86 镜首帧(shots/shot_086_first.jpg)的构图出图,产品换成 @图片1 |
**G1 · 3D 渲染 · 镜头 #1 · 7.2s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 0.0–7.2s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:清朝官员老者侧面特写,长白胡须,戴着黑色现代头戴式耳机,纯黑背景,极强单侧轮廓光,电影级质感,8k高细节写实
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
黑底侧光下,戴着现代头戴式耳机的清代长须老者面容微动,嘴唇轻微张合低语,镜头极其缓慢向前平推至面部特写,保持高对比度剪影光影不变
```
English prompt
```text
Close-up of an elderly Qing Dynasty official with a long white beard wearing modern over-ear headphones, dramatic side rim lighting against a pure black background, subtle head movement and slight lip movements, slow smooth camera push-in.
```
**G2 · AI 生成视频 · 镜头 #4 · 1.4s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 18.1–19.5s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:高龄亚裔男子特写肖像,饱经沧桑的面容,深邃皱纹与老年斑,浓密八字胡与灰白色长山羊胡,头戴黑色监听耳机,黑色深沉背景,戏剧性电影侧光,超精细皮肤质感,竖屏构图。
- 生成 4s 后剪到 1.4s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
高龄亚裔长须老者低头静止,戴着黑色耳机,随后缓缓抬起眼皮凝视前方镜头,眼神深邃冰冷,面部表情保持严肃,极其微弱的呼吸与头部微动,固定镜头。
```
English prompt
```text
Close-up of an elderly Asian man with long grey beard and studio headphones, initially looking down, slowly raising his eyes to stare into the camera with an intense, solemn expression, minimal movement, locked-off shot.
```
**G3 · AI 生成视频 · 镜头 #7 · 0.7s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 20.8–21.5s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:极简静物摄影,灰色微水泥墙面,单枚老旧铁钉用粗麻绳悬挂一块做旧风化原木长条牌匾,空白无字,柔和侧上方漫射光,细腻木纹质感,竖构图。
- 生成 4s 后剪到 0.7s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
镜头对准悬挂在灰墙上的复古空白木牌,视角略微仰视,画面平稳极其缓慢地向木牌推近。
```
English prompt
```text
Camera slowly and smoothly pushing in on a rustic blank wooden hanging sign on a grey textured wall, subtle low angle, clean still-motion.
```
**G4 · AI 生成视频 · 镜头 #8 · 0.7s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 21.5–22.2s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:特写镜头,深灰色桌面上铺着一张带有黑色水墨晕染痕迹的褶皱宣纸,右侧放着一个黑色砚台和一支毛笔。暗调,极简主义,东方美学。右上角有窗框的清晰投影,电影感光影,高对比度,8k分辨率,写实质感。
- 生成 4s 后剪到 0.7s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
镜头缓慢向右平移,展示桌面上的水墨画纸、砚台和毛笔,光影保持稳定,画面静谧。
```
English prompt
```text
The camera slowly pans to the right, revealing the ink-stained paper, inkstone, and brush on the desk. The lighting remains stable, creating a tranquil atmosphere.
```
**G5 · 3D 渲染 · 镜头 #9、#13、#14 · 2.0s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 22.2–22.9s、24.9–26.2s 片段(剪掉中间插入的画面后拼成一段):参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:黑白摄影,水面波纹特写,微弧地平线,阴沉天空,极简,高对比。
- 这几镜在成片里被插入画面隔开:生成时连着出,剪辑时再把插入画面放回去
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–0.7s):黑白画面,水面泛起涟漪,波纹缓缓推进,天空静止,镜头固定。
镜头2(0.7–1.4s):固定长镜头,空旷昏暗的冷灰雾气影棚中,微小的人影贴地极慢蠕动爬行,单光源拉出极长阴影,画面静止凝固感
镜头3(1.4–2.0s):固定特写镜头,黑色粘稠液体水面波浪不断流动起伏,反射银灰微光,顶部弧线保持稳定,无人物,氛围神秘沉静
```
English prompt
```text
Shot 1 (0.0-0.7s): Black and white, water ripples slowly moving forward, static sky, fixed camera.
Shot 2 (0.7-1.4s): Locked-off wide shot, minimalist misty dark grey studio, a tiny human figure slowly crawls on the floor, single hard spotlight casting an elongated sharp shadow.
Shot 3 (1.4-2.0s): Static close-up shot of dark liquid water ripples flowing continuously, reflecting subtle silvery light, smooth curved rim at the top, minimalist black and white 3D render.
```
**G6 · AI 生成视频 · 镜头 #19、#21 · 3.0s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 28.3–28.6s、29.0–31.6s 片段(剪掉中间插入的画面后拼成一段):参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:极简主义产品摄影,特写镜头。一串深棕色圆润的木质佛珠呈S形摆放在平滑的浅灰色背景上。前景焦点处有一颗带有金色闪亮裂纹的珠子和一颗浅青色玉质珠子。浅景深,背景模糊。柔和的左侧顶光,营造出禅意、宁静的氛围,高品质,写实风格。
- 这几镜在成片里被插入画面隔开:生成时连着出,剪辑时再把插入画面放回去
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–0.3s):镜头缓慢向前推进,特写展示平滑灰色背景上的一串深色木质佛珠,前景有一颗带金色裂纹的珠子和一颗浅青色珠子,画面保持静止,仅有平滑的镜头推进。
镜头2(0.3–3.0s):固定或缓慢向前推镜头,古代书生背对镜头缓步穿过大门向前走,两侧木门固定,远处街道灯笼光芒微闪,水面泛着倒影,整体动作沉稳缓慢
```
English prompt
```text
Shot 1 (0.0-0.3s): Slow push-in shot on a string of dark wooden prayer beads resting on a smooth grey surface in an S-shape. In the foreground, there is a bead with a golden crack and a pale green bead in focus. The scene itself is completely static, with only the camera moving slowly forward.
Shot 2 (0.3-3.0s): Cinematic slow push-in shot, back view of an ancient Chinese scholar in robes slowly walking forward through an open wooden gate into a wet stone alley lined with glowing lanterns at night, subtle motion, moody atmosphere.
```
**G7 · AI 生成视频 · 镜头 #22、#23 · 3.0s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 31.6–34.6s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:真实摄影质感,清朝年迈官员,身穿黑色刺绣仙鹤补服与朝珠,蓄长白山羊胡,头戴专业黑色头戴式监听耳机,面前是防喷麦克风,暗灰色极简影棚背景,电影级冷色调侧光,高反差戏剧性光影,竖屏构图。
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–0.5s):镜头由近景平稳快速推进至老者面部特写,老者戴着大耳机,眼神坚定严肃,对着麦克风开口说唱发力,胡须自然微动,神情冷峻。
镜头2(0.5–3.0s):镜头缓慢向前推进,书生低头专注写字,手部有轻微运笔动作,头部微动。
```
English prompt
```text
Shot 1 (0.0-0.5s): Smooth cinematic fast push-in to a tight close-up of an elderly Qing dynasty official wearing studio headphones, rapping into a podcast microphone with intense expressions, beard moving subtly, cold cinematic studio lighting.
Shot 2 (0.5-3.0s): Camera slowly pushes in. The young scholar looks down, focused on writing, with slight brush movements and subtle head motion.
```
**G8 · AI 生成视频 · 镜头 #24、#25、#26、#27 · 8.2s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 34.6–42.9s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:中国古代老者面部特写,花白胡须,满脸深邃皱纹与老年斑,佩戴黑色现代头戴耳机,低调硬光,电影质感,超写实细节,8k分辨率
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–2.0s):老者面部固定特写,严肃冷峻地对着镜头说话,嘴唇同步张合,面部微动,眼神坚定,镜头保持静止
镜头2(2.0–4.9s):固定特写镜头。夜色中煤油灯火苗微弱闪烁,昏黄灯光照亮榜单。一根手指稳定指向红圈内的'林子安'三个字,榜单纸张随微风极轻微颤动,整体保持幽暗压抑的悬疑氛围。
镜头3(4.9–5.6s):机位固定,戴着黑色耳机的长胡须亚裔老者手扶着耳机,神情沉浸地张口歌唱念诵,面部肌肉与胡须随歌唱轻微自然摆动,暗调影棚侧光。
镜头4(5.6–8.2s):枯瘦的手指缓缓划过奏折上的大字,另一只手从下方入画按住纸面,镜头缓慢推近
```
English prompt
```text
Shot 1 (0.0-2.0s): Extreme close-up of an elderly Asian man speaking seriously, lips synced to audio, intense gaze, highly detailed weathered skin, static shot.
Shot 2 (2.0-4.9s): Close-up static shot. In the dark night, the flame of a kerosene lantern flickers softly, casting warm light on an old paper roster on a wooden wall. A hand with prominent veins points its index finger steadily at the Chinese name '林子安' circled in red ink. Cinematic, low-key lighting, suspenseful atmosphere.
Shot 3 (4.9-5.6s): Fixed close-up shot, an elderly Asian man with long gray beard wearing studio headphones, holding the earcup with his hand, singing with deep emotion, subtle facial muscle and beard movement, low-key dramatic studio lighting.
Shot 4 (5.6-8.2s): Close-up of an old frail finger tracing large ink characters on a yellowed memorial scroll, another hand enters from below, slow push-in, dark cinematic tone
```
**G9 · AI 生成视频 · 镜头 #29 · 1.2s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 43.6–44.8s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:泛黄奏折近景,大字「文理太浅」居中,上方一根手指按住纸边,暗调
- 生成 4s 后剪到 1.2s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
手指按住奏折,镜头轻微推近大字「文理太浅」
```
English prompt
```text
Close shot of the scroll with the large characters, a finger pressing the edge, gentle push-in
```
**G10 · AI 生成视频 · 镜头 #30、#31、#32 · 2.8s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 44.8–47.6s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:特写,年长亚洲男性,长白须,满脸皱纹,皮肤纹理细腻。戴黑色现代头戴式耳机,穿黑色中式服装。纯灰背景。电影级光影,侧面柔光,超写实,肖像摄影。
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–0.6s):特写,戴耳机长须老者对麦克风说话,嘴部动作自然,头部轻微摆动。镜头固定。
镜头2(0.6–2.2s):镜头极其缓慢地向前推进,主角背身静立仰望放榜墙,周围考生背影有微弱的呼吸感摆动,冷峻肃穆的氛围维持至镜头结束。
镜头3(2.2–2.8s):老者直视镜头说话,嘴型自然开合,面部表情微动,头部与身体保持静止,特写镜头,固定机位
```
English prompt
```text
Shot 1 (0.0-0.6s): Close-up, elderly Asian man with long beard wearing headphones speaks into microphone, natural mouth movements, slight head sway. Fixed camera.
Shot 2 (0.6-2.2s): Camera slowly dollies in from behind a Qing dynasty scholar with a braided queue looking up at the imperial examination results board, surrounded by crowds of examinees, somber cold cinematic lighting, subtle atmospheric breathing motion.
Shot 3 (2.2-2.8s): Close-up shot of an elderly Chinese man with a long white beard and deep wrinkles, wearing black over-ear headphones, speaking directly to the camera. Natural lip sync, slight facial expressions, head and body remain still. Solid gray background, side lighting, cinematic texture, fixed camera.
```
**G11 · AI 生成视频 · 镜头 #36、#37 · 3.8s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 50.4–54.2s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:阴云密布的古城墙下,列阵持枪的清代士兵,画面左侧虬髯将领侧脸前景,冷灰电影调色
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–3.1s):士兵队列缓缓移动、尘土扬起,将领侧脸静立,镜头缓慢横移
镜头2(3.1–3.8s):固定特写机位,戴着头戴式耳机的长胡须中国老者对着麦克风沉痛开唱,嘴部张合演唱,面部肌肉与胡须自然微颤,眼神微垂凝重,光影保持稳定。
```
English prompt
```text
Shot 1 (0.0-3.1s): Ancient army ranks beneath a city wall under heavy clouds, a bearded general in profile in the foreground, dust rising, slow lateral move
Shot 2 (3.1-3.8s): Close-up static shot of an elderly East Asian man with a long grey beard wearing over-ear studio headphones, singing with a sorrowful expression into a microphone, natural facial muscle and beard movements, studio low-key moody lighting.
```
**G12 · AI 生成视频 · 镜头 #38 · 2.0s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 54.2–56.2s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:夜晚江面小船上,浑身湿透的白须清代老者双手撑在船板上,背后挂着煤油灯,冷蓝色调
- 生成 4s 后剪到 2.0s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
老者喘息着撑在船板上抬头,身后的人伸手去拉他,江浪翻涌
```
English prompt
```text
At night on a small boat, a drenched old man with a white beard braces on the deck and looks up, someone behind reaches to pull him, waves churning
```
**G13 · AI 生成视频 · 镜头 #39 · 0.7s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 56.2–56.9s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:特写,亚洲白胡子老人,戴黑色头戴式耳机,满脸皱纹,表情激动张嘴,纯灰背景,左侧柔光,高对比度写实肖像。
- 生成 4s 后剪到 0.7s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
老人表情激动地说话或唱歌,嘴型自然开合,头部轻微晃动,保持光影稳定。
```
English prompt
```text
Old man speaking or singing excitedly, natural mouth movement, slight head shake, stable lighting.
```
**G14 · AI 生成视频 · 镜头 #40 · 1.5s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 56.9–58.4s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:竖屏,史诗级古代水战场景,夜晚,战船着火,浓烟滚滚。画面中央是一座连接两船的木桥,几名古代士兵的剪影正在桥上激烈交战,手持长矛和刀剑。背景是冲天的火光和飘扬的战旗。强烈的逆光,高对比度,电影级质感,暗黑风格。
- 生成 4s 后剪到 1.5s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
镜头缓慢向前推进并微微仰拍。士兵们在燃烧的木桥上挥舞长矛和刀剑进行战斗,动作激烈。背景的火焰熊熊燃烧,浓烟随风飘动,火星四溅。整体氛围紧张、混乱。
```
English prompt
```text
Slow push-in and slight low-angle shot. Soldiers fight fiercely with spears and swords on a burning wooden bridge. Flames burn intensely in the background, thick smoke billows in the wind, and sparks fly. The overall atmosphere is tense and chaotic.
```
**G15 · AI 生成视频 · 镜头 #41 · 0.5s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 58.4–58.9s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:特写镜头,一位留着灰白山羊胡的亚洲老年男性,满脸沧桑的皱纹,表情严肃,戴着黑色监听耳机,在深灰色背景前对着麦克风说话。平视角度,单侧硬光照明突出面部纹理,冷色调,超高清晰度写实摄影,电影级质感,竖屏。
- 生成 4s 后剪到 0.5s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
不适用,此为音频驱动的数字人
```
English prompt
```text
Not applicable, this is an audio-driven avatar
```
**G16 · AI 生成视频 · 镜头 #43 · 3.0s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 59.5–62.5s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:特写镜头,饱经风霜的中国古代老者,长白胡须,深色古装。神情凝重,低头执笔写字。背景昏暗军营帐篷,隐约火光。电影级光影,左侧柔和主光。
- 生成 4s 后剪到 3.0s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
镜头缓慢推近,老者神情凝重,手执毛笔缓缓书写,胡须微晃,背景火光闪烁。
```
English prompt
```text
Slow push-in shot. An ancient Chinese elder with a long white beard, wearing dark traditional clothes, is writing with a brush with a solemn expression. His beard sways slightly. Dim military tent background with flickering firelight.
```
**G17 · AI 生成视频 · 镜头 #44 · 2.1s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 62.5–64.7s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:竖屏,全景,略仰拍。古代战场营地,阴沉压抑的乌云天空。前景是一群古代士兵的黑色剪影,正在用铲子挖壕沟、用大锤打桩。背景隐约可见木制瞭望塔。强烈的逆光剪影效果,高对比度,暗黑史诗风格。
- 生成 4s 后剪到 2.1s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
镜头固定。画面中的古代士兵剪影开始动作,左侧士兵挥动铲子挖土,右侧士兵挥舞大锤砸向木桩,动作沉重。背景天空的乌云缓慢流动。保持强烈的逆光剪影和暗黑压抑氛围。
```
English prompt
```text
Fixed camera. The silhouettes of ancient soldiers begin to move. The soldier on the left swings a shovel to dig dirt, and the soldier on the right swings a sledgehammer to hit a wooden stake, with heavy movements. The dark clouds in the background sky flow slowly. Maintain a strong backlight silhouette and a dark, oppressive atmosphere.
```
**G18 · AI 生成视频 · 镜头 #46 · 1.8s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 65.4–67.2s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:阴云营地,一群清代兵丁逆光剪影,挥锤打木桩,远处瞭望塔和旗帜
- 生成 4s 后剪到 1.8s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
人们弯腰挥锤反复打桩,泥土飞溅,镜头固定
```
English prompt
```text
Silhouetted soldiers hammering wooden stakes in a muddy camp under overcast sky, mud splashing, static camera
```
**G19 · AI 生成视频 · 镜头 #47 · 3.4s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 67.2–70.5s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:特写肖像,竖屏。一位满脸皱纹、留着灰白长山羊胡的清代老年官员,戴着现代黑色头戴式监听耳机,身穿黑色刺绣清代官服,灰色纯色影棚背景,顶部柔光,电影质感,冷调低饱和。
- 生成 4s 后剪到 3.4s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
固定特写镜头。一位留灰白长须、穿清代官服戴现代耳机的老年男子面对镜头激昂说话说唱,头部随语调轻微点动,眼神坚定,嘴部动作自然逼真,灰色极简影棚背景。
```
English prompt
```text
Fixed close-up shot. An elderly Chinese man with a grey goatee wearing Qing dynasty attire and modern over-ear headphones passionately rapping to the camera, head nodding subtly with speech rhythm, dark moody studio lighting.
```
**G20 · AI 生成视频 · 镜头 #52 · 1.0s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 80.2–81.2s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:一位白发苍苍的亚洲老者特写,留着长长的白胡须,戴着黑色头戴式耳机,面前有一个黑色麦克风。深灰色纯色背景。超写实,电影级光影,高对比度,面部皱纹和毛孔细节丰富,左侧主光。
- 生成 4s 后剪到 1.0s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
老者对着麦克风讲话,嘴型自然,头部有轻微的自然摆动,眼神专注,保持面部特征稳定。
```
English prompt
```text
Close-up of an elderly Asian man with a long white beard, wearing black headphones, speaking into a black microphone. Natural lip sync, slight head movements, focused expression. Dark grey background, cinematic lighting, highly detailed.
```
**G21 · 3D 渲染 · 镜头 #54 · 1.7s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 85.5–87.1s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:特写镜头,一艘破旧的木船停泊在黑暗、雾气弥漫的水面上,船内放着两把木桨和一捆粗糙的绳索。极简主义,暗黑氛围,电影级光影,冷色调,8k分辨率。
- 生成 4s 后剪到 1.7s(太短的镜头单独生成不稳定)
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
镜头缓慢向前推进,画面保持静止,展现破旧木船、木桨和绳索的细节,背景是浓雾弥漫的黑暗水面,氛围阴郁静谧。
```
English prompt
```text
The camera slowly pushes forward, the scene remains static, showing the details of a dilapidated wooden boat, wooden oars, and ropes. The background is a dark water surface covered in thick fog, with a gloomy and quiet atmosphere.
```
**G22 · AI 生成视频 · 镜头 #55 · 1.2s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 87.1–88.3s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:黑白暗黑风,波纹水面,阴沉天空,微光穿云,弧形地平线,极简电影感。
- 生成 4s 后剪到 1.2s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
黑白暗黑水面,水波缓荡,阴沉天空,光影随波流动,镜头缓推。
```
English prompt
```text
B&W dark water, slow ripples, gloomy sky, flowing light, slow push in.
```
**G23 · AI 生成视频 · 镜头 #56、#57、#58 · 5.0s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 88.3–93.3s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:清代晚期老者,长满皱纹的面容,苍白长胡须,穿着黑色暗纹清代官袍,枯瘦苍老的右手捂着右眼,表情痛苦疲惫,微弱侧光,电影质感,超逼真细节,冷色调,竖屏
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–2.4s):老者保持右手捂住右眼的姿势,手指轻微颤动,胸口微微起伏呼吸,镜头缓慢向前推近老者的面部特写,整体环境昏暗压抑。
镜头2(2.4–3.1s):正面特写老道长戴着耳机对镜头严肃说话,嘴唇根据语音开合,面部微表情变化,头部轻微自然晃动,身体和背景保持静止,镜头缓慢推进。
镜头3(3.1–5.0s):摄影机缓慢向老者面部推近,老者保持手按额头的动作,眉头微蹙,微弱呼吸,全身保持静止微动,暗黑电影氛围。
```
English prompt
```text
Shot 1 (0.0-2.4s): Close-up of an elderly Qing dynasty man covering his right eye with his wrinkled hand, subtle breathing motion and slight finger twitch, slow camera push-in towards the tired face, cinematic low-key lighting.
Shot 2 (2.4-3.1s): Close-up of an elderly Asian man with a long grey beard wearing modern studio headphones, speaking seriously to camera, lip-sync talking motion, subtle head movement, camera slowly zooming in, cinematic muted lighting.
Shot 3 (3.1-5.0s): Slow push-in shot onto the face of an elderly Chinese man with long white beard holding his forehead in dizziness, subtle breathing, dark cinematic lighting.
```
**G24 · AI 生成视频 · 镜头 #59 · 0.7s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 93.3–94.0s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:饱经风霜的东亚年长男性正脸特写,满脸深皱纹,灰白小胡子与山羊胡,严肃冷酷眼神,头戴黑色头箍/耳机,纯深灰背景,高反差电影级人像棚拍布光,极高细节。
- 生成 4s 后剪到 0.7s(太短的镜头单独生成不稳定)
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
画面缓慢平稳向前微推,老者表情严肃冷峻保持凝视,面部伴随极其微弱的呼吸漂移感,眼神坚定不动。
```
English prompt
```text
Slow smooth push-in shot on the elderly Asian man, stoic and intense gaze fixed on the camera, extremely subtle breathing micro-movements, cinematic dramatic portrait lighting.
```
**G25 · AI 生成视频 · 镜头 #60 · 5.2s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 94.0–99.2s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 首帧图像提示词:电影剧照,清代白发白须老官员端坐深色谈判桌前,戴官帽着仙鹤补服,面容沧桑神情凝重,前景虚焦洋人背影,侧逆冷光,暗调青灰,高反差电影质感。
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
清代老官员坐在谈判桌前沉重注视,双手轻按桌面,前景洋人手持折叠文书,镜头缓慢推进,冷峻肃穆的电影历史正剧氛围。
```
English prompt
```text
Cinematic shot of an elderly Qing dynasty Chinese official in official robe sitting somberly at a negotiation table, Western diplomats blurred in the foreground, slow subtle push-in, dark cold moody lighting.
```
**G26 · AI 生成视频 · 镜头 #61、#62、#63、#64 · 8.7s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 99.2–107.9s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 镜头 #61、#62、#63、#64 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–1.1s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头2(1.1–3.9s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头3(3.9–6.9s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头4(6.9–8.7s):(缺提示词:开 --vlm 或 agent 看图补写)
```
**G27 · AI 生成视频 · 镜头 #65、#70 · 8.4s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 107.9–115.7s、124.2–124.8s 片段(剪掉中间插入的画面后拼成一段):参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 这几镜在成片里被插入画面隔开:生成时连着出,剪辑时再把插入画面放回去
- 镜头 #65、#70 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–7.8s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头2(7.8–8.4s):(缺提示词:开 --vlm 或 agent 看图补写)
```
**G28 · 3D 渲染 · 镜头 #71 · 0.6s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 124.8–125.5s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 生成 4s 后剪到 0.6s(太短的镜头单独生成不稳定)
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
- 镜头 #71 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
(缺提示词:开 --vlm 或 agent 看图补写)
```
**G29 · AI 生成视频 · 镜头 #72 · 1.6s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 125.5–127.1s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 生成 4s 后剪到 1.6s(太短的镜头单独生成不稳定)
- 镜头 #72 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
(缺提示词:开 --vlm 或 agent 看图补写)
```
**G30 · 3D 渲染 · 镜头 #73 · 2.1s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 127.1–129.2s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 生成 4s 后剪到 2.1s(太短的镜头单独生成不稳定)
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
- 镜头 #73 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
(缺提示词:开 --vlm 或 agent 看图补写)
```
**G31 · AI 生成视频 · 镜头 #75、#76、#77 · 8.8s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 130.1–138.9s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 镜头 #75、#76、#77 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–3.9s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头2(3.9–7.1s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头3(7.1–8.8s):(缺提示词:开 --vlm 或 agent 看图补写)
```
**G32 · AI 生成视频 · 镜头 #78、#79、#81、#82 · 9.3s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 138.9–143.0s、144.0–149.2s 片段(剪掉中间插入的画面后拼成一段):参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 这几镜在成片里被插入画面隔开:生成时连着出,剪辑时再把插入画面放回去
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
- 镜头 #78、#79、#81、#82 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。镜头之间硬切。
镜头1(0.0–3.5s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头2(3.5–4.2s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头3(4.2–8.2s):(缺提示词:开 --vlm 或 agent 看图补写)
镜头4(8.2–9.3s):(缺提示词:开 --vlm 或 agent 看图补写)
```
**G33 · 3D 渲染 · 镜头 #85 · 2.2s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 158.1–160.4s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 生成 4s 后剪到 2.2s(太短的镜头单独生成不稳定)
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
- 镜头 #85 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
(缺提示词:开 --vlm 或 agent 看图补写)
```
**G34 · 3D 渲染 · 镜头 #86 · 4.6s**
- 参考素材:`@图片1` 产品实拍图(正面 + 带 Logo 面),用户提供;`@图片2` 人物参考图(每个角色一张正脸 + 半身),保证跨镜头长相一致;`@视频1` 原片 160.4–165.0s 片段:参考动作、运镜和剪辑节奏(只作参考,不复制画面)
- 另一条路:3D 工程。让 LLM 写 Blender 脚本或 Three.js 场景,角色/道具建模一次、按镜头设机位渲染,多角度和角色一致性最好,改文案和镜头也只是改代码(R08)
- 镜头 #86 缺提示词
```text
竖屏 9:16;夜景/弱光环境光,没有专门补光,柔光(明暗过渡宽),中性(约 5000K),背景明显虚化(浅景深/人像模式)。产品外观以 @图片1 为准,Logo 和细节保持一致。人物以 @图片2 为准。参考 @视频1 的动作、运镜和剪辑节奏。
(缺提示词:开 --vlm 或 agent 看图补写)
```
### 本地重建
- #3 静态图 + 推拉动效 2.3s;#6 静态图 + 推拉动效 0.7s;#10 静态图 + 推拉动效 0.7s;#11 静态图 + 推拉动效 0.7s;#12 静态图 + 推拉动效 0.7s;#15 静态图 + 推拉动效 0.7s;#16 静态图 + 推拉动效 0.7s;#17 静态图 + 推拉动效 0.3s;#18 静态图 + 推拉动效 0.3s;#20 静态图 + 推拉动效 0.4s;#33 静态图 + 推拉动效 0.6s;#66 静态图 + 推拉动效 3.5s;#67 静态图 + 推拉动效 2.4s;#68 静态图 + 推拉动效 0.7s;#69 静态图 + 推拉动效 1.9s;#74 静态图 + 推拉动效 0.9s;#80 静态图 + 推拉动效 1.0s;#83 静态图 + 推拉动效 2.8s;#84 静态图 + 推拉动效 6.1s:一张图 + 测得的缩放/平移参数,ffmpeg 直接出
## 拍法、打光与剪辑
- 取景:景别 特写 55%、大特写 45%;机位角度 平视;主体是人脸(按脸高算景别)
- 机位:固定机位(三脚架/支架/放在桌上) 57%、移动机位(稳定器/手持平移) 43%;常见运镜 拉
- 打光:夜景/弱光环境光,没有专门补光。主光 画面右侧偏前方,从上往下(顶灯/路灯/高位光源);光比 约 1.5:1(相差 0.6 档);柔光(明暗过渡宽);色温中性(约 5000K);背景明显虚化(浅景深/人像模式)
- 调色:暗调低饱和(电影感);低饱和、对比正常、黑位正常、整体偏冷
- 剪辑:每分钟 30.9 刀,实拍镜头平均 2.27s;机位/场景 5 个;同机位跳切 0 处、推近切 0 处;插入画面(截图/录屏/卡片/素材)占 84%;50% 的切点落在说话停顿处
**复刻拍摄方案**
1. 取景:以特写为主,平视
2. 机位:固定机位(三脚架/支架/放在桌上) 57%、移动机位(稳定器/手持平移) 43%;常见运镜 拉
3. 布光:夜景/弱光环境光,没有专门补光——主光来自环境(路灯、招牌、室内顶灯、屏幕),主体偏暗、反差由环境决定
4. 剪辑:每分钟 30.9 刀,实拍镜头平均 2.27s;机位/场景 5 个;同机位跳切 0 处、推近切 0 处;插入画面(截图/录屏/卡片/素材)占 84%;50% 的切点落在说话停顿处
器材:
- 手机夜景/人像模式,找一盏路灯或招牌做主光,人站在灯斜下方
- 想更干净:镜头旁加一个低亮度暖色 LED 小灯(3200K)
- 注意:背景明显虚化(浅景深/人像模式)
| 维度 | 项目 | 结论 | 来源 |
|---|---|---|---|
| 取景 | 景别 | 特写 | 测量:特写;VLM:近景(半身) |
| 取景 | 机位角度 | 平视 | VLM:平视 |
| 取景 | 构图 | 居中构图,竖屏 | VLM:居中构图,竖屏 |
| 机位 | 拍摄方式 | 三脚架/支架固定 | 测量:混合:固定机位(三脚架/支架/放在桌上) 57%、移动机位(稳定器/手持平移) 43%;VLM:三脚架/支架固定 |
| 机位 | 镜头 | 相机人像/长焦 | VLM:相机人像/长焦 |
| 打光 | 场景 | 室内;影棚 | VLM:室内;影棚 |
| 打光 | 主光 | 画面左侧偏上,柔光箱 | VLM:画面左侧偏上,柔光箱 |
| 打光 | 软硬 | 柔光(明暗过渡宽) | 测量:柔光(明暗过渡宽);VLM:柔光 |
| 打光 | 补光 | 有暗部补光,阴影过渡柔和 | VLM:有暗部补光,阴影过渡柔和 |
| 打光 | 轮廓光 | 无明显轮廓光 | VLM:无明显轮廓光 |
| 打光 | 眼神光 | 微弱点状 | VLM:微弱点状 |
| 打光 | 可见光源 | 无 | VLM:无 |
| 打光 | 色温 | 中性(约 5000K) | 测量:中性(约 5000K);VLM:中性偏冷 |
| 打光 | 布光方案 | 左侧主灯柔光 + 右侧微弱轮廓光 | VLM:左侧主灯柔光 + 右侧微弱轮廓光 |
| 调色 | 调色风格 | 暗调低饱和(电影感) | 测量:暗调低饱和(电影感) |
- 说明:光比、软硬、色温、景别由主体像素测得(有人脸用人脸,没有用画面清晰区域,后者是估算);平台转码会压暗部,软硬和补光偏保守;机位角度、光源种类、眼神光、轮廓光以看图结果为准。测量和看图不一致时两者都列出。
## 元数据线索
- 编码器:`Lavf61.7.100`
## 声音拆解

- 整体响度 -17.4 dBFS,峰值 -1.9 dBFS
- **人声**:有,占 26% 时长,基频约 142.8Hz(偏男声)
- **背景音乐**:占 97% 时长(0.0–164.5s),约 178.2 BPM(也可能是 89.1/356.4),调性 A minor(置信 0.658),段落变化点 4.0s, 19.0s, 63.5s, 68.0s, 107.5s, 111.5s, 123.0s, 133.5s
- **剪辑与节拍**:38% 的切点落在节拍上(随机约 40%)
**声音来源:AI 生成还是现成素材**
- **结论**:视频类型:音乐 MV / 歌曲类(整片是一首唱出来的歌) → 人声TTS 配音;音乐AI 生成音乐(倾向,待确认);音效音效库/剪辑软件后期添加(倾向,待确认)
- **剥离出的音轨**:`stems/original.wav`(原声)、`stems/vocals.wav`(人声干声,瞬态音效也会落在这里)、`stems/music.wav`(配乐 + 环境声)
- 视频形式:疑似带唱歌曲/MV;AI 画面占 69%,实拍占 0%
- **背景音乐**:AI 生成音乐(ai_generated 52%,popular_song 26%,existing_library 22%)
- 整片音乐不间断,人声是唱的(持续音高占比 0.24):像一首带人声的歌/音乐 MV,AI 歌概率高(未开 VLM,按 MV 先验但降权)
- 音乐与视频同时收尾:按片长剪辑或定制过(两种来源都可能,弱证据)
- 确认方法:在抖音/小红书原视频页面看音乐标签:显示歌名 → 现成曲目;显示「@作者创作的原声」→ 作者自己上传(MV 类多为 AI 歌)
- 确认方法:用汽水音乐/QQ 音乐「听歌识曲」或 ACRCloud 识别:识别得到就是现成歌曲
- 确认方法:听:AI 歌常见咬字含糊、高频发虚带金属感、歌词紧扣画面内容;曲库配乐多为无人声、结构标准、片尾被截断或淡出
- **人声**:TTS 配音(tts 64%,human_recording 27%,ai_video_native 9%)
- 人声和背景声跨切点连续:整条旁白是后期单独配上去的(TTS 或真人配音)
- **音效**:音效库/剪辑软件后期添加(library_editor 57%,ai_native 29%,live_sync 14%)
- 3D/动画类视频的卡通音效也常由程序合成或音效库添加(例如 capsule-cinema plush 配方用程序合成)
- 逐段原生音频检测:切点处背景声变化 6.4dB,镜头内 6.1dB(比值 1.05)→ 声音跨切点连续,是后期整体铺的
**音效**(56 处;来源 vlm=大模型听出,deterministic=信号检测的候选,置信度低)
| 时间 | 类型 | 描述 | 对应画面 | 来源 |
|---|---|---|---|---|
| 10.29s | ding | | | deterministic |
| 20.79s | ding | | 切点 | deterministic |
| 31.67s | ding | | 切点 | deterministic |
| 32.00s | ding | | | deterministic |
| 50.71s | ding | | | deterministic |
| 51.37s | whoosh | | | deterministic |
| 51.57s | whoosh | | | deterministic |
| 52.07s | whoosh | | | deterministic |
| 59.72s | whoosh | | | deterministic |
| 59.90s | whoosh | | | deterministic |
| 60.07s | ding | | | deterministic |
| 60.23s | whoosh | | | deterministic |
| 63.63s | hit | | | deterministic |
| 67.70s | pop | | | deterministic |
| 84.71s | whoosh | | | deterministic |
| 86.09s | whoosh | | | deterministic |
| 86.42s | whoosh | | | deterministic |
| 86.77s | whoosh | | | deterministic |
| 88.13s | pop | | | deterministic |
| 97.65s | whoosh | | | deterministic |
| 100.02s | ding | | | deterministic |
| 100.37s | whoosh | | 切点 | deterministic |
| 102.72s | whoosh | | | deterministic |
| 119.41s | whoosh | | | deterministic |
| 122.12s | whoosh | | | deterministic |
| 123.50s | ding | | | deterministic |
| 123.83s | ding | | | deterministic |
| 125.88s | ding | | | deterministic |
| 132.68s | whoosh | | | deterministic |
| 133.02s | ding | | | deterministic |
| 135.05s | ding | | | deterministic |
| 135.64s | pop | | | deterministic |
| 136.41s | ding | | | deterministic |
| 136.92s | ding | | | deterministic |
| 137.09s | ding | | | deterministic |
| 137.43s | ding | | | deterministic |
| 137.76s | ding | | | deterministic |
| 142.48s | whoosh | | | deterministic |
| 151.37s | whoosh | | | deterministic |
| 152.06s | pop | | 切点 | deterministic |
**声音复刻方案**
- voice(A01-narration):人声,male → capsule-cinema DoubaoTTSTool / UniversalTTSTool(或 MiniMax 克隆音色);需要卡原时间窗时用时长可控 TTS(A02)
- music(A03-music):178.2 BPM;A minor → 原曲倾向 AI 生成:用 Suno 等(capsule-cinema UniversalMusicGenerationTool)按风格/BPM/调性重新生成,MV 类连歌词一起按新内容写
- sfx(A04-sfx):56 个音效 → 按时间点摆放:capsule-cinema SoundEffectsTool / 音效库,或像 plush 配方那样程序合成(音高对齐 BGM 调性)
## 画面里的真实素材
共 2 个镜头、3.04s(2%)的画面里有真实素材(录屏、截图、照片、嵌入视频),复刻时要拿到原文件,不能用模型生成替代:
- 镜头 #3(00:15.750):真实照片,整个画面
- 镜头 #3(00:15.750):真实照片,画面局部,深灰台面上手写毛笔书法粗糙宣纸的静态实拍照片
- 镜头 #12(00:24.208):真实照片,整个画面
- 镜头 #12(00:24.208):商品实拍图,画面局部,整个画面是一张佛珠手串的产品摄影照片
## 复刻要准备的参考素材
这些镜头的画面是生成或拍摄出来的,下面是画面里出现、复刻时应作为参考图 / 道具准备的东西(不是嵌入的真实像素):
- 镜头 #7(00:20.833):人物/场景参考图,悬挂木牌高清单品静物实拍图
- 镜头 #19(00:28.292):商品参考图,深色木质佛珠静物摄影照片
## 分镜表
| # | 时间 | 时长 | 底层画面 | 置信度 | 素材来源 | 叠加层 | 运镜 | 复刻路线 |
|---|---|---|---|---|---|---|---|---|
| 1 | 00:00.000 | 7.25s | 3D 渲染 | 47% | 制作方渲染 | 文字 | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 2 | 00:07.250 | 8.50s | 数字人口播 | 99% | AI 生成 | 字幕 | 固定 | R03-talking-head → capsule_cinema |
| 3 | 00:15.750 | 2.33s | 静态图 + 推拉动效 | 98% | 用户真实素材:真实照片 | 字幕、文字 | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 4 | 00:18.083 | 1.38s | AI 生成视频 | 84% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 5 | 00:19.458 | 0.67s | 数字人口播 | 99% | AI 生成 | 字幕、图形贴片 | 平滑运镜 | R03-talking-head → capsule_cinema |
| 6 | 00:20.125 | 0.71s | 静态图 + 推拉动效 | 86% | AI 生成 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 7 | 00:20.833 | 0.67s | AI 生成视频 | 45% | AI 生成;复刻参考:人物/场景参考图 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 8 | 00:21.500 | 0.67s | AI 生成视频 | 98% | AI 生成 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 9 | 00:22.167 | 0.71s | AI 生成视频 | 64% | AI 生成 | 图形贴片 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 10 | 00:22.875 | 0.67s | 静态图 + 推拉动效 | 88% | 制作方渲染 | 图形贴片 | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 11 | 00:23.542 | 0.67s | 静态图 + 推拉动效 | 93% | AI 生成 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 12 | 00:24.208 | 0.71s | 静态图 + 推拉动效 | 99% | 用户真实素材:真实照片、商品实拍图 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 13 | 00:24.917 | 0.67s | 3D 渲染 | 67% | 制作方渲染 | — | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 14 | 00:25.583 | 0.67s | 3D 渲染 | 69% | 制作方渲染 | 图形贴片 | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 15 | 00:26.250 | 0.67s | 静态图 + 推拉动效 | 99% | AI 生成 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 16 | 00:26.917 | 0.71s | 静态图 + 推拉动效 | 91% | AI 生成 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 17 | 00:27.625 | 0.33s | 静态图 + 推拉动效 | 99% | AI 生成 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 18 | 00:27.958 | 0.33s | 静态图 + 推拉动效 | 85% | AI 生成 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 19 | 00:28.292 | 0.33s | 3D 渲染 | 35% | 制作方渲染;复刻参考:商品参考图 | — | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 20 | 00:28.625 | 0.38s | 静态图 + 推拉动效 | 99% | AI 生成 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 21 | 00:29.000 | 2.62s | AI 生成视频 | 85% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 22 | 00:31.625 | 0.54s | AI 生成视频 | 82% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 23 | 00:32.167 | 2.46s | AI 生成视频 | 80% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 24 | 00:34.625 | 2.04s | AI 生成视频 | 49% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 25 | 00:36.667 | 2.88s | AI 生成视频 | 80% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 26 | 00:39.542 | 0.71s | AI 生成视频 | 63% | AI 生成 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 27 | 00:40.250 | 2.62s | AI 生成视频 | 50% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 28 | 00:42.875 | 0.71s | 数字人口播 | 89% | AI 生成 | 文字 | 平滑运镜 | R03-talking-head → capsule_cinema |
| 29 | 00:43.583 | 1.21s | AI 生成视频 | 43% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 30 | 00:44.792 | 0.62s | AI 生成视频 | 99% | AI 生成 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 31 | 00:45.417 | 1.54s | AI 生成视频 | 76% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 32 | 00:46.958 | 0.62s | AI 生成视频 | 49% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 33 | 00:47.583 | 0.62s | 静态图 + 推拉动效 | 99% | AI 生成 | 文字 | 平滑运镜 | R17-still-motion → local_ffmpeg |
| 34 | 00:48.208 | 0.58s | 数字人口播 | 90% | AI 生成 | 文字 | 平滑运镜 | R03-talking-head → capsule_cinema |
| 35 | 00:48.792 | 1.58s | 数字人口播 | 99% | AI 生成 | 文字 | 固定(主体在动) | R03-talking-head → capsule_cinema |
| 36 | 00:50.375 | 3.08s | AI 生成视频 | 46% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 37 | 00:53.458 | 0.75s | AI 生成视频 | 63% | AI 生成 | 文字、图形贴片 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 38 | 00:54.208 | 2.00s | AI 生成视频 | 60% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 39 | 00:56.208 | 0.71s | AI 生成视频 | 98% | AI 生成 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 40 | 00:56.917 | 1.50s | AI 生成视频 | 74% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 41 | 00:58.417 | 0.50s | AI 生成视频 | 41% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 42 | 00:58.917 | 0.58s | 数字人口播 | 98% | AI 生成 | 文字、图形贴片 | 平滑运镜 | R03-talking-head → capsule_cinema |
| 43 | 00:59.500 | 3.04s | AI 生成视频 | 84% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 44 | 01:02.542 | 2.12s | AI 生成视频 | 81% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 45 | 01:04.667 | 0.71s | 数字人口播 | 98% | AI 生成 | 图形贴片 | 平滑运镜 | R03-talking-head → capsule_cinema |
| 46 | 01:05.375 | 1.79s | AI 生成视频 | 46% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 47 | 01:07.167 | 3.38s | AI 生成视频 | 73% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 48 | 01:10.542 | 1.25s | 数字人口播 | 94% | AI 生成 | 文字、图形贴片 | 平滑运镜 | R03-talking-head → capsule_cinema |
| 49 | 01:11.792 | 2.79s | 数字人口播 | 99% | AI 生成 | 字幕、图形贴片 | 固定(主体在动) | R03-talking-head → capsule_cinema |
| 50 | 01:14.583 | 2.71s | 数字人口播 | 99% | AI 生成 | 字幕 | 固定(主体在动) | R03-talking-head → capsule_cinema |
| 51 | 01:17.292 | 2.92s | 数字人口播 | 90% | AI 生成 | 字幕、图形贴片 | 平滑运镜 | R03-talking-head → capsule_cinema |
| 52 | 01:20.208 | 1.00s | AI 生成视频 | 52% | AI 生成 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 53 | 01:21.208 | 4.25s | 数字人口播 | 96% | AI 生成 | 字幕 | 平滑运镜 | R03-talking-head → capsule_cinema |
| 54 | 01:25.458 | 1.67s | 3D 渲染 | 58% | 制作方渲染 | — | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 55 | 01:27.125 | 1.21s | AI 生成视频 | 81% | AI 生成 | 图形贴片 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 56 | 01:28.333 | 2.42s | AI 生成视频 | 77% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 57 | 01:30.750 | 0.67s | AI 生成视频 | 53% | AI 生成 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 58 | 01:31.417 | 1.92s | AI 生成视频 | 90% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 59 | 01:33.333 | 0.67s | AI 生成视频 | 84% | AI 生成 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 60 | 01:34.000 | 5.21s | AI 生成视频 | 53% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 61 | 01:39.208 | 1.12s | AI 生成视频 | 57% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 62 | 01:40.333 | 2.79s | AI 生成视频 | 38% | AI 生成 | 文字、图形贴片 | 手持晃动 | R07-product-hero → capsule_cinema |
| 63 | 01:43.125 | 3.00s | AI 生成视频 | 64% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 64 | 01:46.125 | 1.79s | AI 生成视频 | 79% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 65 | 01:47.917 | 7.79s | AI 生成视频 | 60% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 66 | 01:55.708 | 3.50s | 静态图 + 推拉动效 | 85% | 待确认;待确认是否真实:照片/图片素材 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 67 | 01:59.208 | 2.38s | 静态图 + 推拉动效 | 76% | 制作方渲染 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 68 | 02:01.583 | 0.71s | 静态图 + 推拉动效 | 83% | 制作方渲染 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 69 | 02:02.292 | 1.92s | 静态图 + 推拉动效 | 80% | 待确认;待确认是否真实:照片/图片素材 | 文字 | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 70 | 02:04.208 | 0.62s | AI 生成视频 | 40% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 71 | 02:04.833 | 0.62s | 3D 渲染 | 50% | 制作方渲染 | 文字 | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 72 | 02:05.458 | 1.62s | AI 生成视频 | 83% | AI 生成 | — | 平滑运镜 | R07-product-hero → capsule_cinema |
| 73 | 02:07.083 | 2.12s | 3D 渲染 | 37% | 制作方渲染 | 文字 | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 74 | 02:09.208 | 0.92s | 静态图 + 推拉动效 | 77% | 制作方渲染 | 文字、图形贴片 | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 75 | 02:10.125 | 3.88s | AI 生成视频 | 59% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 76 | 02:14.000 | 3.25s | AI 生成视频 | 60% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 77 | 02:17.250 | 1.62s | AI 生成视频 | 62% | AI 生成 | 图形贴片 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 78 | 02:18.875 | 3.46s | AI 生成视频 | 50% | AI 生成 | 文字 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 79 | 02:22.333 | 0.71s | AI 生成视频 | 41% | AI 生成 | 文字、图形贴片 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 80 | 02:23.042 | 0.96s | 静态图 + 推拉动效 | 68% | 制作方渲染 | 图形贴片 | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 81 | 02:24.000 | 4.04s | 3D 渲染 | 60% | 制作方渲染 | 字幕 | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 82 | 02:28.042 | 1.12s | AI 生成视频 | 49% | AI 生成 | 字幕 | 平滑运镜 | R07-product-hero → capsule_cinema |
| 83 | 02:29.167 | 2.83s | 静态图 + 推拉动效 | 75% | 待确认;待确认是否真实:照片/图片素材 | 文字 | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 84 | 02:32.000 | 6.12s | 静态图 + 推拉动效 | 77% | 待确认;待确认是否真实:照片/图片素材 | — | 整图推拉/平移 | R17-still-motion → local_ffmpeg |
| 85 | 02:38.125 | 2.25s | 3D 渲染 | 44% | 制作方渲染 | 图形贴片 | 平滑运镜 | R08-product-multiview → capsule_cinema |
| 86 | 02:40.375 | 4.58s | 3D 渲染 | 46% | 制作方渲染 | — | 平滑运镜 | R08-product-multiview → capsule_cinema |
## 逐镜详情
### #1 00:00.000–00:07.250 · 3D 渲染 + 代码/剪辑叠加(文字标注)

- 概率:3D 渲染 47%,代码/模板渲染 24%,AI 生成视频 17%(fused)
- 素材来源:制作方渲染
- 可能的工具:Midjourney + Kling/Hailuo
- 纹理呈渲染特征:平坦色块 66%、95% 像素仅用 5 种颜色、横竖直边 19%
- 逐帧清晰度呈周期性起伏(周期 2 帧,相关 0.07):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(22%,周期 1):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 清朝官员长须老者戴现代耳机的典型 AI 创意概念
- [VLM] 动作极轻微,仅头部略微偏转与微张嘴唇,符合图生视频特征
- [VLM] 侧逆光下皮肤与须发的高反差极简光影,背景全黑无实际物理环境
- 画面:黑底背景下,身穿清朝官服、留长白须、头戴现代大耳机的老者侧脸,在侧逆光下缓缓微动并张嘴说话,镜头平缓向前推进至面部特写。
- 拍法/打光:特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 1.4:1(相差 0.5 档);柔光(明暗过渡宽)
- 文字轨(文字/middle):大清有说唱
- 文字轨(文字/middle):和血吞
- 文字轨(文字/middle):作词Claude作曲Suno演唱曾国fan
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
- 首帧图像提示词:清朝官员老者侧面特写,长白胡须,戴着黑色现代头戴式耳机,纯黑背景,极强单侧轮廓光,电影级质感,8k高细节写实
- 视频提示词:黑底侧光下,戴着现代头戴式耳机的清代长须老者面容微动,嘴唇轻微张合低语,镜头极其缓慢向前平推至面部特写,保持高对比度剪影光影不变
### #2 00:07.250–00:15.750 · 数字人口播 + 代码/剪辑叠加(字幕)

- 概率:数字人口播 98%,AI 生成视频 1%,3D 渲染 0%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney + LivePortrait/Hedra
- 镜头内动效节拍:8.21s、9.96s、10.50s、14.71s
- 人脸占画面 9%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.14、用色 29 种、平坦块 36%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 100% 的采样帧有正脸且机位固定,音轨有人声
- [VLM] 人物身体、衣服、耳机、麦克风在整个片段中完全静止无形变
- [VLM] 仅有嘴部开合和头部轻微晃动,符合单图音频驱动特征
- [VLM] 00:04-00:08 嘴部运动时,下巴处的长胡须有不自然的扭曲和拉扯感
- 画面:一位身穿仙鹤刺绣中式长袍、留长白须的老者,戴着现代头戴式耳机,在麦克风前说话。纯灰背景,半身近景,固定镜头,影棚柔光。
- 拍法/打光:特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 2.1:1(相差 1.0 档);柔光(明暗过渡宽)
- 文字轨(字幕/bottom):官至极品,一无所成。 / 这话,我自己写的。
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:竖屏,半身近景,一位中国古代老者,留着长长的白胡须,穿着黑色中式长袍,胸前有精美的仙鹤刺绣,头上戴着现代的黑色头戴式耳机,面前有一个麦克风。纯灰色背景,影棚柔光,左侧主光,右侧轮廓光,电影级质感,超高细节,写实风格。
- 视频提示词:保持画面静止,人物嘴部根据语音同步说话,头部有轻微自然的晃动,胡须随之轻微摆动。
### #3 00:15.750–00:18.083 · 静态图 + 推拉动效(真实照片) + 代码/剪辑叠加(字幕、文字标注);引入真实素材(真实照片)

- 概率:静态图 + 推拉动效 98%,实拍 1%,定格动画 0%(fused)
- 静帧来源:photo
- 素材来源:用户真实素材:真实照片
- 可能的工具:剪映
- 整帧按单一刚体变换运动(拟合内点 99%,残差 0.07px,无局部运动)→ 静态图推拉:缩放 +10.9%/s,平移 55px/s
- 纹理呈照片/视频特征:噪声 σ=0.57、用色 25 种、平坦块 1%
- [VLM] 画面内部没有任何独立物体运动或透视变化
- [VLM] 画面仅做平面的线性缓慢推镜头(Ken Burns 缩放特效)
- [VLM] 纸张纤维边缘与毛笔书法墨迹清晰自然,为实物静物摄影照片
- 画面:特写镜头,一张手作毛边宣纸平铺于深灰色桌面上,上书毛笔字'官至极品 一无所成',镜头平缓向前推进放大。
- 文字轨(字幕/bottom):这话,我自己写的 / 这话,我自己写的。
- 文字轨(文字/middle):官至极品
- 文字轨(文字/middle):一无所成
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻;需要用户提供真实素材:真实照片(整个画面)、真实照片(画面局部)
### #4 00:18.083–00:19.458 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 84%,数字人口播 8%,3D 渲染 2%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney + Kling / Hailuo
- 低照度画面:39% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 1%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.45、用色 42 种、平坦块 19%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(4%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 面部细节虽极其丰富逼真,但运动极缓,胡须与下颌微动时带有 AI 视频常见的细微形变与轻微黏连感
- [VLM] 呼吸和头部微动缺乏真实肌肉弹力与生理微颤,呈图生视频经典缓慢抬头看镜头模式
- 画面:戴头戴式耳机、留长白胡须的老年亚裔男子微垂双眼,随后缓缓抬头直视镜头,表情深沉肃穆,背景为灰暗纯色工作室。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.6:1(相差 0.7 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):上Beat。
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:高龄亚裔男子特写肖像,饱经沧桑的面容,深邃皱纹与老年斑,浓密八字胡与灰白色长山羊胡,头戴黑色监听耳机,黑色深沉背景,戏剧性电影侧光,超精细皮肤质感,竖屏构图。
- 视频提示词:高龄亚裔长须老者低头静止,戴着黑色耳机,随后缓缓抬起眼皮凝视前方镜头,眼神深邃冰冷,面部表情保持严肃,极其微弱的呼吸与头部微动,固定镜头。
### #5 00:19.458–00:20.125 · 数字人口播 + 代码/剪辑叠加(字幕、图形贴片)

- 概率:数字人口播 64%,AI 生成视频 35%,3D 渲染 0%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney + HeyGen/SadTalker/剪映数字人
- 人脸占画面 30%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.19、用色 35 种、平坦块 37%
- [VLM] 人物皮肤纹理和光影过于完美,具有典型 Midjourney 生成的质感
- [VLM] 多帧对比显示,人物身体和背景完全静止,仅头部和嘴部有动作,符合音频驱动数字人(Avatar)的特征
- 画面:特写镜头,白须老者戴耳机说话,纯色背景,固定机位,侧逆光。
- 拍法/打光:大特写;平视;三脚架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 2.0:1(相差 1.0 档);柔光(明暗过渡宽)
- 文字轨(字幕/bottom):上Beat. / LBeat.
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:特写,亚洲白须老者,戴黑色头戴耳机,黑色中式服装。暗灰背景。电影光影,左侧主光,右侧冷色轮廓光,极度写实。
- 视频提示词:老者面对镜头说话,嘴型自然,头部微动,身体静止。
### #6 00:20.125–00:20.833 · 静态图 + 推拉动效(AI 生成图)

- 概率:静态图 + 推拉动效 86%,3D 渲染 6%,AI 生成视频 6%(fused)
- 静帧来源:ai_image
- 素材来源:AI 生成
- 可能的工具:Midjourney + 剪映
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.03px,无局部运动)→ 静态图推拉:缩放 +2.3%/s,平移 11px/s
- 纹理呈渲染特征:平坦色块 27%、95% 像素仅用 27 种颜色、横竖直边 26%
- [VLM] 画面为单张静态图像的缓慢推焦与轻微平移(Ken Burns效果)
- [VLM] 画面内部的木质纹理与阴影完全静止,无内部物理运动
- [VLM] 超现实孤立木门置于虚无暗黑空间,强AI概念图特征
- 画面:黑暗虚无空间中伫立着一扇半开的粗糙老木门,左上方有束状冷光倾泻而下,镜头缓慢缓慢向前推进推进。
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #7 00:20.833–00:21.500 · AI 生成视频

- 概率:AI 生成视频 45%,3D 渲染 32%,实拍 8%(fused)
- 素材来源:AI 生成;复刻参考:人物/场景参考图
- 可能的工具:剪映/PR 关键帧平移动效
- [VLM] 木板纹理、木节、麻绳纤维及锈蚀铁钉细节高度真实
- [VLM] 木牌与墙面投影之间无独立三维透视变化,镜头运动为纯2D平移推进
- 画面:一面灰墙上用麻绳和铁钉悬挂的复古空白长方形木牌,镜头微斜向上缓慢推近。
- 拍法/打光:近景;略仰拍;移动机位(稳定器/手持平移);侧前方主光 + 补光(标准布光);主光画面左侧偏前方;光比约 1.7:1(相差 0.8 档);柔光(明暗过渡宽)
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧;生成时作参考:人物/场景参考图
- 首帧图像提示词:极简静物摄影,灰色微水泥墙面,单枚老旧铁钉用粗麻绳悬挂一块做旧风化原木长条牌匾,空白无字,柔和侧上方漫射光,细腻木纹质感,竖构图。
- 视频提示词:镜头对准悬挂在灰墙上的复古空白木牌,视角略微仰视,画面平稳极其缓慢地向木牌推近。
### #8 00:21.500–00:22.167 · AI 生成视频

- 概率:AI 生成视频 97%,静态图 + 推拉动效 1%,3D 渲染 0%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney (底图) + Kling / Runway Gen-2
- [VLM] 画面呈现高度风格化的静物摄影质感,光影完美但缺乏真实物理细节(如纸张边缘厚度)
- [VLM] 运镜为平滑右移,透视有微小变化,符合AI图生视频的3D运镜特征
- 画面:特写镜头,深灰桌面铺着带墨迹的褶皱纸张,旁有砚台毛笔。背景有窗框投影。镜头缓慢右移。
- 拍法/打光:特写;略俯拍;移动机位(稳定器/手持平移);正面柔光(平光);主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.0:1(相差 0.1 档);柔光(几乎没有明暗分界)
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写镜头,深灰色桌面上铺着一张带有黑色水墨晕染痕迹的褶皱宣纸,右侧放着一个黑色砚台和一支毛笔。暗调,极简主义,东方美学。右上角有窗框的清晰投影,电影感光影,高对比度,8k分辨率,写实质感。
- 视频提示词:镜头缓慢向右平移,展示桌面上的水墨画纸、砚台和毛笔,光影保持稳定,画面静谧。
### #9 00:22.167–00:22.875 · AI 生成视频 + 代码/剪辑叠加(图形贴片)

- 概率:AI 生成视频 64%,3D 渲染 34%,2D 动画 0%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling/Runway/Hailuo
- [VLM] 水波运动略显粘稠和形变,缺乏真实流体动力学的复杂高频细节
- [VLM] 天空云层完全静止,仅水面局部运动,符合 AI 视频常见特征
- 画面:黑白水面特写,波纹荡漾,带弧度地平线,阴沉天空,镜头固定。
- 拍法/打光:特写;平视;三脚架/支架固定;户外阴天/背阴处柔光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.3 档);柔光(几乎没有明暗分界)
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:黑白摄影,水面波纹特写,微弧地平线,阴沉天空,极简,高对比。
- 视频提示词:黑白画面,水面泛起涟漪,波纹缓缓推进,天空静止,镜头固定。
### #10 00:22.875–00:23.542 · 静态图 + 推拉动效(cg_3d) + 代码/剪辑叠加(图形贴片)

- 概率:静态图 + 推拉动效 88%,3D 渲染 10%,实拍 1%(fused)
- 静帧来源:cg_3d
- 素材来源:制作方渲染
- 可能的工具:剪映
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.10px,无局部运动)→ 静态图推拉:缩放 +5.7%/s,平移 28px/s
- 纹理呈渲染特征:平坦色块 25%、95% 像素仅用 29 种颜色、横竖直边 9%
- [VLM] 画面内部水面、绳索、木船无任何动态物理位移
- [VLM] 全片仅有缓慢匀速的平移与轻微缩放运镜(Ken Burns 效果)
- 画面:极简暗调场景,俯视一艘黑色旧木舟,船舱内摆放双桨与麻绳,左侧投下微弱光影条纹,镜头缓慢推拉平移。
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #11 00:23.542–00:24.208 · 静态图 + 推拉动效(AI 生成图)

- 概率:静态图 + 推拉动效 93%,AI 生成视频 6%,屏幕录制/截图 0%(fused)
- 静帧来源:ai_image
- 素材来源:AI 生成
- 可能的工具:Midjourney + 剪映
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.03px,无局部运动)→ 静态图推拉:缩放 +1.4%/s,平移 7px/s
- 纹理呈照片/视频特征:噪声 σ=0.46、用色 30 种、平坦块 5%
- [VLM] 烟雾形态全程静态无流动,局部运动率为0
- [VLM] 画面仅存在纯2D缓慢推拉缩放(Ken Burns运动)
- [VLM] 焦炭碎屑与木纹质感具备典型AI图像渲染特征
- 画面:特写焦黑碳化木板残片,表面残存白烟静止凝固,置于灰色极简台面,微慢镜头推近。
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #12 00:24.208–00:24.917 · 静态图 + 推拉动效(真实照片);引入真实素材(真实照片、商品实拍图)

- 概率:静态图 + 推拉动效 99%,静帧停留 0%,AI 生成视频 0%(fused)
- 静帧来源:photo
- 素材来源:用户真实素材:真实照片、商品实拍图
- 可能的工具:剪映/PR
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.12px,无局部运动)→ 静态图推拉:缩放 +13.9%/s,平移 59px/s
- [VLM] 画面内部无任何独立运动,珠子、流苏、光影保持绝对静止
- [VLM] 珠子材质反光真实,符合影棚产品摄影特征
- [VLM] 参考信号提示高 kenburns_score,可能存在极缓慢的推拉,但主体无变化
- 画面:一串黑色佛珠手串静置在深灰色背景上,带有白色主珠和黑色流苏,画面呈现极缓慢的推拉或完全静止,突出产品质感。
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻;需要用户提供真实素材:真实照片(整个画面)、商品实拍图(画面局部)
### #13 00:24.917–00:25.583 · 3D 渲染

- 概率:3D 渲染 66%,AI 生成视频 18%,实拍 14%(fused)
- 素材来源:制作方渲染
- 可能的工具:Blender
- [VLM] 极简三维暗黑灰调空间,无缝纯色渐变地面与雾气环境
- [VLM] 极小的爬行人形投射出规整、平直的硬边缘长阴影
- [VLM] 画面无动态噪波与形变,符合 3D 渲染器(如 Blender/C4D)的体积雾与聚光灯效果
- 画面:极远景俯视空旷灰暗空间,地面中央一人影微弱俯伏匍匐,聚光灯打出细长投影,氛围孤寂冷清。
- 拍法/打光:远景;略俯拍;三脚架/支架固定;正面柔光(平光);主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.1:1(相差 0.2 档);柔光(几乎没有明暗分界)
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
- 首帧图像提示词:极远景,空旷冰冷的灰度雾气空间,一人趴在地面匍匐,单侧低角度强聚光灯投射出细长硬影,极简暗黑概念艺术,竖屏
- 视频提示词:固定长镜头,空旷昏暗的冷灰雾气影棚中,微小的人影贴地极慢蠕动爬行,单光源拉出极长阴影,画面静止凝固感
### #14 00:25.583–00:26.250 · 3D 渲染 + 代码/剪辑叠加(图形贴片)

- 概率:3D 渲染 69%,AI 生成视频 20%,实拍 10%(fused)
- 素材来源:制作方渲染
- 可能的工具:Blender/C4D
- [VLM] 水面波纹高度规则且符合置换贴图位移动画特征
- [VLM] 顶部弧形边缘几何极其规整平滑,无实拍噪点或镜头畸变
- [VLM] 单色黑白色调与金属感水体反光,典型 3D 渲染器材质预设
- 画面:黑白极简风格的黑色液体水面,细密波纹持续荡漾,上方是一道平滑弧形边缘与阴霾天空背景,镜头固定仰望。
- 拍法/打光:特写;平视;三脚架/支架固定;侧前方主光 + 补光(标准布光);主光画面左侧偏前方;光比约 1.5:1(相差 0.6 档);中等柔度
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
- 首帧图像提示词:黑白特写,暗黑色流体水面,微波荡漾,泛着银灰色金属高光,背景上方是一道平滑的弧形边界与昏暗天空,极简主义,3D渲染质感
- 视频提示词:固定特写镜头,黑色粘稠液体水面波浪不断流动起伏,反射银灰微光,顶部弧线保持稳定,无人物,氛围神秘沉静
### #15 00:26.250–00:26.917 · 静态图 + 推拉动效(AI 生成图)

- 概率:静态图 + 推拉动效 99%,AI 生成视频 0%,屏幕录制/截图 0%(fused)
- 静帧来源:ai_image
- 素材来源:AI 生成
- 可能的工具:Midjourney (图片) + 剪映/PR (缩放动效)
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.03px,无局部运动)→ 静态图推拉:缩放 +1.8%/s,平移 9px/s
- 纹理呈照片/视频特征:噪声 σ=0.50、用色 30 种、平坦块 2%
- [VLM] 画面中的烟雾完全静止,没有任何飘动或消散的迹象
- [VLM] 整个画面只有均匀的放大(推镜头)效果,没有任何内部元素的相对运动
- 画面:几块烧焦的木头放置在灰色背景前,木头上散发着静止的青烟,画面缓慢向前推进。
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #16 00:26.917–00:27.625 · 静态图 + 推拉动效(AI 生成图)

- 概率:静态图 + 推拉动效 91%,AI 生成视频 8%,屏幕录制/截图 0%(fused)
- 静帧来源:ai_image
- 素材来源:AI 生成
- 可能的工具:剪映
- 整帧按单一刚体变换运动(拟合内点 98%,残差 0.18px,无局部运动)→ 静态图推拉:缩放 +7.9%/s,平移 45px/s
- 纹理呈渲染特征:平坦色块 28%、95% 像素仅用 29 种颜色、横竖直边 6%
- [VLM] 画面内部水面、船体、木桨完全静止无独立物理动态
- [VLM] 镜头仅呈现轻微整体二维推拉位移(Ken Burns 效果)
- [VLM] 木桨与船舱边缘纹理具 AI 绘画典型的超精细做旧质感
- 画面:特写视角下破旧木船一角,船舱内斜倚着两只磨损旧木桨,背景为朦胧灰暗的雾气水面,镜头缓慢微推。
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #17 00:27.625–00:27.958 · 静态图 + 推拉动效(AI 生成图)

- 概率:静态图 + 推拉动效 99%,AI 生成视频 0%,屏幕录制/截图 0%(fused)
- 静帧来源:ai_image
- 素材来源:AI 生成
- 可能的工具:Midjourney + 剪映特效
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.10px,无局部运动)→ 静态图推拉:缩放 +0.4%/s,平移 10px/s
- [VLM] 画面完全无内部运动
- [VLM] 序列帧显示纯2D平移
- [VLM] 墨迹边缘具AI生成特征
- 画面:宣纸墨迹与砚台特写。
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #18 00:27.958–00:28.292 · 静态图 + 推拉动效(AI 生成图)

- 概率:静态图 + 推拉动效 85%,AI 生成视频 9%,屏幕录制/截图 2%(fused)
- 静帧来源:ai_image
- 素材来源:AI 生成
- 可能的工具:Midjourney / Stable Diffusion
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.05px,无局部运动)→ 静态图推拉:缩放 +3.3%/s,平移 17px/s
- [VLM] 画面在提供的时间序列内完全静止,没有丝毫运动或变化
- [VLM] 确定性分析给出 temporal_noise 较高,可能是视频编码带来的噪声,但无实际运动
- [VLM] 木牌的纹理和光影看起来像是 AI 生成的写实图像
- 画面:一面灰墙上挂着一块空白的做旧木牌,左上角有斜向下的光影
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #19 00:28.292–00:28.625 · 3D 渲染

- 概率:3D 渲染 35%,AI 生成视频 31%,实拍 18%(fused)
- 素材来源:制作方渲染;复刻参考:商品参考图
- [VLM] 画面内容为静态图像,没有任何内部运动(如珠子的滚动、光影的变化等),这是still_motion的典型特征
- [VLM] 提供的时间轴切片图(file_2.jpg)显示,在不同时间点,画面内容完全一致,仅通过推拉或平移来产生运动感
- [VLM] 确定性初判中的 dup_ratio=0 且 kenburns_score=0.235 支持了这是一张静态图片做推拉摇移(Ken Burns)的判断
- 画面:镜头展示了一串深色木质佛珠放置在平整的灰色背景上。珠串呈S形蜿蜒,近景处有一颗带有金色裂纹和一颗浅青色的珠子作为点缀。画面整体呈现出宁静、禅意的氛围。
- 拍法/打光:特写;略俯拍;三脚架/支架固定;正面柔光(平光);主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);柔光(几乎没有明暗分界)
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染;生成时作参考:商品参考图
- 首帧图像提示词:极简主义产品摄影,特写镜头。一串深棕色圆润的木质佛珠呈S形摆放在平滑的浅灰色背景上。前景焦点处有一颗带有金色闪亮裂纹的珠子和一颗浅青色玉质珠子。浅景深,背景模糊。柔和的左侧顶光,营造出禅意、宁静的氛围,高品质,写实风格。
- 视频提示词:镜头缓慢向前推进,特写展示平滑灰色背景上的一串深色木质佛珠,前景有一颗带金色裂纹的珠子和一颗浅青色珠子,画面保持静止,仅有平滑的镜头推进。
### #20 00:28.625–00:29.000 · 静态图 + 推拉动效(AI 生成图)

- 概率:静态图 + 推拉动效 99%,AI 生成视频 0%,屏幕录制/截图 0%(fused)
- 静帧来源:ai_image
- 素材来源:AI 生成
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.05px,无局部运动)→ 静态图推拉:缩放 +1.6%/s,平移 8px/s
- [VLM] 画面内部的烟雾和颗粒没有任何动态变化,多帧对比完全一致。
- [VLM] 木炭的纹理、烟雾的形态具有AI生成图像的典型特征,如细节不合理、边缘模糊等。
- 画面:深色背景下,几块燃烧后的木炭,上方有几缕白烟。画面整体呈暗色调,静止不动。
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #21 00:29.000–00:31.625 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 85%,3D 渲染 10%,实拍 3%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney + Kling/Runway
- 逐帧清晰度呈周期性起伏(周期 2 帧,相关 0.36):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 人物行走步态微弱滑动,与地面接触无真实重力摩擦
- [VLM] 两侧木门及背景瓦片、灯笼的几何边缘有轻微的AI动态流变与闪烁
- [VLM] 水面反光与雨夜光影具有典型的Midjourney/Runway式暗调写实质感
- 画面:古代书生背影缓步穿过木门,走向灯火点缀的狭长雨夜古街。中远景,缓慢向前推进运镜,青灰色冷调与灯笼暖黄光对比。
- 拍法/打光:全景;平视;稳定器;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.2 档);硬光(明暗分界清楚)
- 文字轨(字幕/bottom):十四岁进考棚 / 考了七回才中个秀才
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:电影质感,古代中国青衫书生背影,站在敞开的木质大门前,面前是一条狭窄延伸的湿漉漉石板古街,街道两旁挂满微弱的暖黄色灯笼,深蓝冷调雨夜,细腻写实,纵深感,竖屏构图
- 视频提示词:固定或缓慢向前推镜头,古代书生背对镜头缓步穿过大门向前走,两侧木门固定,远处街道灯笼光芒微闪,水面泛着倒影,整体动作沉稳缓慢
### #22 00:31.625–00:32.167 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 67%,数字人口播 15%,3D 渲染 10%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney + Kling
- 人脸占画面 34%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.27、用色 36 种、平坦块 29%
- [VLM] 人物面部皮肤与毛发纹理具有典型的超写实 AI 生成质感
- [VLM] 镜头推近时胡须与唇周运动略显粘滞与浮动,符合 AI 视频/数字驱动特征
- [VLM] 清代官服配现代录音棚大耳机、麦克风,为概念合成场景
- 画面:身穿清朝一品仙鹤补服、头戴现代耳机的老者对着录音麦克风说唱,镜头平滑快速推向面部特写,光线冷暗严肃。
- 拍法/打光:大特写;平视;稳定器;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.8:1(相差 0.9 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):考了七回才中个秀才
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:真实摄影质感,清朝年迈官员,身穿黑色刺绣仙鹤补服与朝珠,蓄长白山羊胡,头戴专业黑色头戴式监听耳机,面前是防喷麦克风,暗灰色极简影棚背景,电影级冷色调侧光,高反差戏剧性光影,竖屏构图。
- 视频提示词:镜头由近景平稳快速推进至老者面部特写,老者戴着大耳机,眼神坚定严肃,对着麦克风开口说唱发力,胡须自然微动,神情冷峻。
### #23 00:32.167–00:34.625 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 80%,数字人口播 8%,实拍 5%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling / Runway / Luma
- 低照度画面:43% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.56、用色 32 种、平坦块 6%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 纸上的文字是无法辨认的类汉字乱码
- [VLM] 人物手部握笔姿势略显僵硬,运笔动作与纸面无实际交互
- [VLM] 画面整体有AI生成的平滑质感和微弱的动态漂浮感
- 画面:清朝装扮的年轻书生在昏暗环境中伏案写字,镜头缓慢推进,展现苦读场景。
- 拍法/打光:近景;略俯拍;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):考了七回才中个秀才
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:清朝年轻书生,剃发留辫,穿灰布衫,在昏暗书房伏案用毛笔写字。桌上有字卷,背景有模糊的灯笼。左侧柔和主光,电影级质感,暗调,竖屏。
- 视频提示词:镜头缓慢向前推进,书生低头专注写字,手部有轻微运笔动作,头部微动。
### #24 00:34.625–00:36.667 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 49%,实拍 34%,数字人口播 7%(fused)
- 素材来源:AI 生成
- 可能的工具:LivePortrait / SadTalker / HeyGen
- 低照度画面:28% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 2%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.47、用色 41 种、平坦块 10%
- [VLM] 面部仅有嘴唇和下颌随音频变动,眼睛及额头皱纹几乎无自然联动的微表情
- [VLM] 牙齿与口腔内壁细节平滑且存在轻微形变,符合AI音频驱动口型(Avatar)特征
- [VLM] 发丝与胡须边缘在微动时有局部轻微涂抹感
- 画面:古代老者面部极特写,戴着现代头戴耳机,面部充满沧桑皱纹与老人斑,伴随台词进行口型说话。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.6:1(相差 0.7 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):同一场我爹上了榜
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:中国古代老者面部特写,花白胡须,满脸深邃皱纹与老年斑,佩戴黑色现代头戴耳机,低调硬光,电影质感,超写实细节,8k分辨率
- 视频提示词:老者面部固定特写,严肃冷峻地对着镜头说话,嘴唇同步张合,面部微动,眼神坚定,镜头保持静止
### #25 00:36.667–00:39.542 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 80%,3D 渲染 9%,实拍 9%(fused)
- 画面里物体上的字(不是后期字幕):光港流、光港海、光张、乖来染流库烧林子安、聚流摩烧林子安、项洗
- 素材来源:AI 生成
- 可能的工具:Kling
- 纹理呈照片/视频特征:噪声 σ=0.48、用色 70 种、平坦块 9%
- [VLM] 榜单上的毛笔字迹大部分为无意义假字/伪汉字变形,仅红圈内的'林子安'清晰
- [VLM] 提灯手部和指榜单的手部细节静止微动,手部青筋与皮肤有AI质感,缺乏真实的微动态与肌肉形变
- [VLM] 油灯火苗动态极轻微,背景与榜纸纹理呈现典型的AI视频时间序列流动微变形
- 画面:昏暗夜色中,一只手提着煤油灯,另一只手的手指指向木墙上张贴的黄色榜单,红圈圈出'林子安'名字,镜头平稳近景特写,微弱暖黄灯光照亮局部。
- 拍法/打光:特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.3 档);硬光(明暗分界清楚)
- 文字轨(文字/bottom):我名字被学台挂出来
- 文字轨(字幕/middle):光港流 / 光港海 / 光张 / 紫汽林子安
- 文字轨(字幕/middle):乖来染流库烧林子安 / 聚流摩烧林子安 / 项洗 / X
- 文字轨(文字/middle):茂
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写,夜晚,古风悬疑氛围。左手提着一盏点燃的复古马灯,暖黄火焰透过玻璃罩发光。右侧木墙上贴着一张泛黄的毛笔字名单,右手青筋凸显的手指正指着榜单上用红圈圈出的汉字'林子安'。电影级质感,微弱暗黑环境与局部暖光对比,细节逼真。
- 视频提示词:固定特写镜头。夜色中煤油灯火苗微弱闪烁,昏黄灯光照亮榜单。一根手指稳定指向红圈内的'林子安'三个字,榜单纸张随微风极轻微颤动,整体保持幽暗压抑的悬疑氛围。
### #26 00:39.542–00:40.250 · AI 生成视频

- 概率:AI 生成视频 36%,实拍 29%,数字人口播 26%(fused)
- 素材来源:AI 生成
- 人脸占画面 25%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.15、用色 35 种、平坦块 37%
- [VLM] 面部皮肤毛孔、细微老年斑与胡须发丝极其细腻自然,无闪烁形变
- [VLM] 手扶耳机的指节、骨骼结构及动作物理完全真实
- [VLM] 说话时口腔内部牙齿、舌头动态与肌肉联动完全符合真实物理规律
- [claude 看图] 与相邻对口型镜头是同一个 AI 角色(白须老者、同款耳机和佛珠)、同一录音棚背景
- [claude 看图] 嘴型随说唱歌词变化,整片没有任何实拍场景
- [claude 看图] 整条 MV 的人物、服装在 AI 镜头和这些镜头之间完全一致
- 画面:特写镜头,长胡须的老年亚裔男性戴着头戴式监听耳机,手扶耳机正在深情演唱或说话,纯深灰影棚背景,暗调侧光人像质感。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.8:1(相差 0.9 档);硬光(明暗分界清楚)
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写镜头,一位留着花白山羊胡须的亚裔老者,头戴黑色监听耳机,一只手扶在耳机边缘,深色中式对襟上衣,深灰极简背景,侧向单光源硬光,皮肤纹理清晰,电影胶片质感,竖屏
- 视频提示词:机位固定,戴着黑色耳机的长胡须亚裔老者手扶着耳机,神情沉浸地张口歌唱念诵,面部肌肉与胡须随歌唱轻微自然摆动,暗调影棚侧光。
### #27 00:40.250–00:42.875 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 48%,3D 渲染 24%,实拍 21%(fused)
- 画面里物体上的字(不是后期字幕):道枝憶花、杨况機光心、植税流横清热境福土文
- 素材来源:AI 生成
- 纹理呈渲染特征:平坦色块 34%、95% 像素仅用 25 种颜色、横竖直边 12%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 手指皮肤纹理、指甲缝及老年斑细节极度真实自然,无AI形变
- [VLM] 纸张纤维、墨迹渗透和折痕物理特性完全符合实拍
- [VLM] 左上角油灯微弱火光产生的自然暗调侧逆光与手部阴影一致
- [VLM] 书卷文字笔画工整稳定,无AI生成文字常见的融化与闪烁
- [claude 看图] 奏折上除了「文理太浅」四个大字,竖排小字是不成字的伪汉字(臣謹枝槎、趙洼),生成画面的典型破绽
- 画面:古风暗调特写,枯瘦干瘪的手指按在写有“文理太浅”的宣纸古籍上,镜头缓慢微移,油灯侧光照亮局部。
- 拍法/打光:特写;俯拍;稳定器;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.2 档);中等柔度
- 文字轨(字幕/bottom):理太浅四个 / 文理太浅四个大字 / 全城都看明白
- 文字轨(字幕/middle):文理太浅 / 治国之道道楼 / 治国之道道洼 / 治国之道趙挂播
- 文字轨(字幕/middle):道枝憶花 / 杨况機光心 / 植税流横清热境福土文
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:暗调特写,泛黄古旧奏折,墨书大字「文理太浅」,一只苍老枯瘦的手指按在纸上,电影感低饱和
- 视频提示词:枯瘦的手指缓缓划过奏折上的大字,另一只手从下方入画按住纸面,镜头缓慢推近
### #28 00:42.875–00:43.583 · 数字人口播 + 代码/剪辑叠加(文字标注)

- 概率:数字人口播 67%,AI 生成视频 22%,代码/模板渲染 8%(fused)
- 素材来源:AI 生成
- 可能的工具:LivePortrait / SadTalker / Midjourney
- 人脸占画面 25%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.22、用色 31 种、平坦块 30%
- [VLM] 身体与背景完全静止无物理微颤
- [VLM] 仅嘴部随音频形变对口型,边缘略带涂抹感
- [VLM] 古风长须长者佩戴现代头戴式耳机的超现实AI图像质感
- 画面:特写镜头,戴耳机的白须古风老者对着麦克风说话,嘴唇根据音频对口型,机位固定。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.6:1(相差 0.7 档);硬光(明暗分界清楚)
- 文字轨(文字/bottom):全城都看明白
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:特写肖像,饱经沧桑的中国古代道士老人,白色长胡须,头戴专业黑色头戴式监听耳机,面前有黑色麦克风,暗灰色纯色背景,电影感侧光,超写实细节,低饱和度冷色调。
- 视频提示词:静止镜头,老人嘴部开合说话对口型,眼神微动,身体与头部保持稳定,神情严肃沉稳。
### #29 00:43.583–00:44.792 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 41%,实拍 32%,3D 渲染 21%(fused)
- 画面里物体上的字(不是后期字幕):文理太浅、臣遒枝槎协、臣枝槎说、治国之道趙挞挂播、治国之道趙洼、治国之道挞洼
- 素材来源:AI 生成
- [VLM] 手指皮肤纹理、指甲与褶皱极其逼真自然
- [VLM] 宣纸纤维、墨迹渗透与纸张凹凸光影物理真实
- [VLM] 无AI形变或闪烁,符合影视剧微距实拍道具特征
- [claude 看图] 同一张奏折,小字依旧是伪汉字(挞洼、趙挞),字形逐帧轻微变化
- [claude 看图] 手指和纸张质感写实,风格与 #27 连续,属同一次生成
- 画面:特写影视镜头,粗糙苍老的手指按在写有墨迹文书的宣纸上,纸上书有大字“文理太浅”,镜头微幅缓慢推进。
- 拍法/打光:特写;俯拍;稳定器;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.2 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):全城都看明白
- 文字轨(字幕/middle):文理太浅 / 臣遒枝槎协 / 臣枝槎说 / 臣道枝槎倾协
- 文字轨(字幕/middle):治国之道趙挞挂播 / 治国之道趙洼 / 治国之道挞洼 / 台国之道随姑洼
- 文字轨(文字/middle):号
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:泛黄奏折近景,大字「文理太浅」居中,上方一根手指按住纸边,暗调
- 视频提示词:手指按住奏折,镜头轻微推近大字「文理太浅」
### #30 00:44.792–00:45.417 · AI 生成视频

- 概率:AI 生成视频 86%,数字人口播 12%,实拍 0%(fused)
- 画面里物体上的字(不是后期字幕):福
- 素材来源:AI 生成
- 可能的工具:Midjourney + Kling/Hailuo/Hedra
- 低照度画面:42% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 6%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.36、用色 34 种、平坦块 24%
- [VLM] 极高精度的皮肤纹理和毛发细节,带有典型的超写实 AI 质感
- [VLM] 古风老人与现代耳机麦克风的组合,是常见的 AI 创作概念
- [VLM] 背景纯净,光影完美,符合高质量图生视频的特征
- 画面:特写,长白须亚洲老者戴耳机对麦克风说话,纯灰背景,光影立体,极度写实。
- 拍法/打光:大特写;平视;三脚架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.6:1(相差 0.6 档);柔光(明暗过渡宽)
- 文字轨(文字/middle):福
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写,年长亚洲男性,长白须,满脸皱纹,皮肤纹理细腻。戴黑色现代头戴式耳机,穿黑色中式服装。纯灰背景。电影级光影,侧面柔光,超写实,肖像摄影。
- 视频提示词:特写,戴耳机长须老者对麦克风说话,嘴部动作自然,头部轻微摆动。镜头固定。
### #31 00:45.417–00:46.958 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 76%,3D 渲染 14%,实拍 8%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney + Kling/Runway
- 镜头内动效节拍:46.25s
- [VLM] 清朝考生背影和榜单群像带有典型Midjourney风格的写实但质感平滑油润特征
- [VLM] 榜单上的汉字笔画模糊不规则,呈现AI生成的文字乱码伪文字
- [VLM] 画面运动为极微弱的缓慢推近与局部微动,缺少真实的物理交互与人群动量
- 画面:清代科举放榜场景,一名清朝书生头戴瓜皮帽梳长辫背对镜头,仰望榜单,周围挤满同样看榜的人群,镜头缓慢微弱推进。
- 拍法/打光:中景(背身半身至腰部);略仰拍;稳定器;夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 2.0:1(相差 1.0 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):进士又考三回
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:清代科举皇榜放榜现场,背影中景,一位梳着清朝长辫、戴瓜皮帽穿深色长衫的书生仰望木廊下的黄色金榜,身旁围满看榜的考生背影,中式古建长廊,阴天冷调,电影光影质感,超写实细节。
- 视频提示词:镜头极其缓慢地向前推进,主角背身静立仰望放榜墙,周围考生背影有微弱的呼吸感摆动,冷峻肃穆的氛围维持至镜头结束。
### #32 00:46.958–00:47.583 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 49%,实拍 34%,数字人口播 7%(fused)
- 素材来源:AI 生成
- 可能的工具:HeyGen / D-ID / SadTalker
- 低照度画面:33% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 3%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.47、用色 36 种、平坦块 14%
- [VLM] 人物面部细节(如皱纹、毛发)在多帧间保持绝对静止,仅嘴部区域有开合动作,符合典型的单图音频驱动数字人特征
- 画面:白须老者面部特写,戴着耳机,正视镜头说话,背景纯灰
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.5:1(相差 0.6 档);硬光(明暗分界清楚)
- 文字轨(文字/bottom):进士又考三回
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写镜头,一位中国老者,白色长胡须,面部布满深邃皱纹,戴着黑色头戴式耳机,纯灰色背景,侧光照明,电影级质感,8k高细节
- 视频提示词:老者直视镜头说话,嘴型自然开合,面部表情微动,头部与身体保持静止,特写镜头,固定机位
### #33 00:47.583–00:48.208 · 静态图 + 推拉动效(AI 生成图) + 代码/剪辑叠加(文字标注)

- 概率:静态图 + 推拉动效 99%,AI 生成视频 0%,屏幕录制/截图 0%(fused)
- 静帧来源:ai_image
- 素材来源:AI 生成
- 可能的工具:Midjourney (生成图片) + 剪辑软件 (推镜头)
- 整帧按单一刚体变换运动(拟合内点 92%,残差 0.19px,无局部运动)→ 静态图推拉:缩放 +7.8%/s,平移 23px/s
- [VLM] 画面内部人物完全静止,无任何微小动作(如呼吸、衣物飘动)
- [VLM] 唯一的运动是整个画面的缓慢匀速推镜头(缩放)
- [VLM] 背景人群边缘和细节有典型的 AI 图像融合特征
- 画面:一群清朝男子背对镜头仰望墙上榜单,中景,缓慢推镜头,阴天冷色调。
- 文字轨(文字/bottom):三甲垫底那一排
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #34 00:48.208–00:48.792 · 数字人口播 + 代码/剪辑叠加(文字标注)

- 概率:数字人口播 68%,AI 生成视频 22%,实拍 8%(fused)
- 素材来源:AI 生成
- 可能的工具:LivePortrait / Hedra / 剪映数字人
- 人脸占画面 38%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.29、用色 35 种、平坦块 25%
- [VLM] 基底为典型AI生成的写实国风老者戴现代监听耳机肖像
- [VLM] 身体与耳机线缆完全静止,仅嘴唇、下巴及胡须随音频微幅形变驱动
- [VLM] 牙齿与口腔边缘伴有音频驱动人像常见的局部插值模糊
- 画面:白须道长/老者头戴黑色监听耳机,在暗调影棚对麦克风说话,嘴唇同步微动,景别为特写,机位固定。
- 拍法/打光:大特写;平视;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.6:1(相差 0.6 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):三甲垫底那一排
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:特写,清瘦矍铄的中国古代老者,满脸皱纹与白胡须,头戴专业头戴式黑色监听耳机,身前有播客麦克风,暗灰色背景,影棚侧光,胶片质感,超写实细节
- 视频提示词:老人头部微动,嘴唇跟随说话音频自然开合,下巴胡须轻微晃动,身体和耳机保持稳定,摄影机固定
### #35 00:48.792–00:50.375 · 数字人口播 + 代码/剪辑叠加(文字标注)

- 概率:数字人口播 80%,AI 生成视频 19%,3D 渲染 0%(fused)
- 素材来源:AI 生成
- 可能的工具:HeyGen/D-ID/剪映数字人 (底图可能来自 Midjourney)
- 人脸占画面 21%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.12、用色 30 种、平坦块 39%
- 100% 的采样帧有正脸且机位固定,音轨有人声
- [VLM] 人物头部有轻微摆动和说话口型,但身体、耳机、麦克风及背景完全静止
- [VLM] 胡须在下巴运动时有轻微的图像扭曲拉扯感,符合单图驱动数字人的特征
- [VLM] 人物面部质感和光影过于完美,带有典型的AI生成图像特征
- 画面:特写镜头,一位戴着头戴式耳机、留着长白胡须的老年男性对着麦克风说话,背景为纯暗色。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.5:1(相差 0.6 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):三甲垫底那一排
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:特写镜头,一位中国老年男性,留着长长的白胡须,穿着黑色中式立领服装,戴着黑色头戴式监听耳机,面前有一个黑色麦克风。暗灰色背景,左侧柔和主光,电影感,高细节,写实风格,8k分辨率。
- 视频提示词:人物头部轻微自然摆动,嘴部做出说话的口型,眼神有微小变化,身体、耳机和麦克风保持绝对静止。
### #36 00:50.375–00:53.458 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 44%,实拍 35%,3D 渲染 16%(fused)
- 素材来源:AI 生成
- 纹理呈渲染特征:平坦色块 23%、95% 像素仅用 25 种颜色、横竖直边 21%
- [VLM] 影视剧实拍摄影质感,群演与服装道具细节真实且具有自然动态
- [VLM] 左侧将领面部微表情与皮肤纹理自然,无AI形变或闪烁
- [VLM] 镜头带有缓慢推移与环境扬尘效果,物理交互真实
- [claude 看图] 写实的古代军阵,人群和旗帜细节在帧间轻微漂移,远处士兵形体模糊融合
- [claude 看图] 与全片同一套冷灰电影调色,无实拍片场的噪声和景深变化
- 画面:阴云密布的城墙下,左侧前景一位蓄须的中年将领手持卷轴侧身肃立,后景大批手持长矛的清军士兵列队行进。镜头缓慢向前推进,整体呈现低饱和度、压抑凝重的古装战争史诗氛围。
- 拍法/打光:中景(前景人物半身侧影);平视;稳定器;夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 1.8:1(相差 0.9 档);柔光(明暗过渡宽)
- 文字轨(字幕/bottom):四十出头才学带兵 / 靖港头一仗就败
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:阴云密布的古城墙下,列阵持枪的清代士兵,画面左侧虬髯将领侧脸前景,冷灰电影调色
- 视频提示词:士兵队列缓缓移动、尘土扬起,将领侧脸静立,镜头缓慢横移
### #37 00:53.458–00:54.208 · AI 生成视频 + 代码/剪辑叠加(文字标注、图形贴片)

- 概率:AI 生成视频 36%,实拍 29%,数字人口播 26%(fused)
- 素材来源:AI 生成
- 人脸占画面 24%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.16、用色 37 种、平坦块 36%
- [VLM] 真实的皮肤褶皱、老年斑与毛细血管细节自然
- [VLM] 胡须与毛发边缘清晰稳定,无AI融化或闪烁伪影
- [VLM] 口型肌肉与牙齿开合运动符合生理真实
- [claude 看图] 与相邻对口型镜头是同一个 AI 角色(白须老者、同款耳机和佛珠)、同一录音棚背景
- [claude 看图] 嘴型随说唱歌词变化,整片没有任何实拍场景
- [claude 看图] 整条 MV 的人物、服装在 AI 镜头和这些镜头之间完全一致
- 画面:录音室特写,留长胡须的白发老者戴着头戴式耳机在麦克风前沉郁开唱,固定机位平视,低调暗沉光影。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.1:1(相差 0.2 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):靖港头一仗就败
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写镜头,一位留着长灰色山羊胡须的东亚老者,戴着黑色头戴式耳机在录音室麦克风前,深色中式服装,纯深灰背景,专业电影级低调柔光侧光,极高面部皱纹细节,逼真摄影质感。
- 视频提示词:固定特写机位,戴着头戴式耳机的长胡须中国老者对着麦克风沉痛开唱,嘴部张合演唱,面部肌肉与胡须自然微颤,眼神微垂凝重,光影保持稳定。
### #38 00:54.208–00:56.208 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 58%,实拍 32%,3D 渲染 6%(fused)
- 素材来源:AI 生成
- 低照度画面:50% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 1%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.58、用色 41 种、平坦块 2%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 真实的演员皮肤细节、肌肉线条与湿水光泽
- [VLM] 水滴从胡须、湿透长衫自然滴落的流体物理表现
- [VLM] 影视剧级别的专业夜戏布光与色彩分级
- [claude 看图] 湿透的老者趴在船沿,背景士兵手臂和船灯边缘帧间形变
- 画面:夜间江面木船上,一位浑身湿透、蓄着白须的清代老者被部下从冰冷江水中拉上船板,双手撑地,神情复杂凝重。
- 拍法/打光:近景;略俯拍;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.3 档);硬光(明暗分界清楚)
- 文字轨(字幕/bottom):湘江水冷是部下把我捞上来 / 湘江水冷是部下把我捞上菜
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:夜晚江面小船上,浑身湿透的白须清代老者双手撑在船板上,背后挂着煤油灯,冷蓝色调
- 视频提示词:老者喘息着撑在船板上抬头,身后的人伸手去拉他,江浪翻涌
### #39 00:56.208–00:56.917 · AI 生成视频

- 概率:AI 生成视频 78%,数字人口播 21%,实拍 0%(fused)
- 画面里物体上的字(不是后期字幕):一、一
- 素材来源:AI 生成
- 可能的工具:Kling / Hailuo / Hedra (图生视频或音频驱动)
- 人脸占画面 46%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.28、用色 43 种、平坦块 20%
- [VLM] 皮肤纹理与毛发具有典型的高质量AI生成质感
- [VLM] 运动高度集中在嘴部开合与头部轻微晃动,符合图片驱动视频或数字人特征
- [VLM] 纯色背景与极浅景深的标准AI肖像生成风格
- 画面:特写:一位白胡子亚洲老人戴着耳机,表情激动地说话或唱歌,纯灰背景。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);柔光(几乎没有明暗分界)
- 文字轨(文字/middle):一
- 文字轨(文字/middle):D
- 文字轨(文字/middle):一
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写,亚洲白胡子老人,戴黑色头戴式耳机,满脸皱纹,表情激动张嘴,纯灰背景,左侧柔光,高对比度写实肖像。
- 视频提示词:老人表情激动地说话或唱歌,嘴型自然开合,头部轻微晃动,保持光影稳定。
### #40 00:56.917–00:58.417 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 73%,3D 渲染 13%,实拍 4%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling/Runway/Hailuo
- 纹理呈照片/视频特征:噪声 σ=0.46、用色 80 种、平坦块 6%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 画面中士兵挥舞的武器(长矛、刀剑)在运动过程中发生不自然的弯曲和形变
- [VLM] 背景的火焰和浓烟边缘存在AI生成常见的“沸腾”和闪烁感
- [VLM] 人物的动作略显漂浮,缺乏真实的物理重量感和受力反馈
- 画面:夜晚古代水战场景,士兵在燃烧的战船木桥上激烈交战,背景火光冲天、浓烟滚滚,人物呈剪影状态,镜头缓慢推进。
- 拍法/打光:全景;仰拍;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 1.8:1(相差 0.9 档);中等柔度
- 文字轨(字幕/bottom):湖口再败座船被截 / 我又被拉回来
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:竖屏,史诗级古代水战场景,夜晚,战船着火,浓烟滚滚。画面中央是一座连接两船的木桥,几名古代士兵的剪影正在桥上激烈交战,手持长矛和刀剑。背景是冲天的火光和飘扬的战旗。强烈的逆光,高对比度,电影级质感,暗黑风格。
- 视频提示词:镜头缓慢向前推进并微微仰拍。士兵们在燃烧的木桥上挥舞长矛和刀剑进行战斗,动作激烈。背景的火焰熊熊燃烧,浓烟随风飘动,火星四溅。整体氛围紧张、混乱。
### #41 00:58.417–00:58.917 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 41%,实拍 27%,3D 渲染 16%(fused)
- 素材来源:AI 生成
- 可能的工具:HeyGen/D-ID
- 人脸占画面 45%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.36、用色 46 种、平坦块 16%
- [VLM] 人物的面部肌肉运动(尤其是嘴型和眼部)显得僵硬,缺乏真实人类说话时自然的肌肉联动,更符合音频驱动的数字人(avatar)特征
- [VLM] 人物皮肤纹理虽然逼真,但在说话过程中几乎没有光影的自然变化,更像是单张静态图片加上了局部的面部扭曲
- [VLM] 头部的晃动轨迹相对机械,不像真实说话时有自然的重心偏移
- [VLM] 牙齿和口腔内部的渲染在说话时显得不够自然,有粘贴感
- 画面:一位满脸皱纹、留着灰白胡须的亚洲老年男性,戴着黑色头戴式耳机,对着麦克风说话
- 拍法/打光:大特写;平视;三脚架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.3 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):我又被拉回来
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写镜头,一位留着灰白山羊胡的亚洲老年男性,满脸沧桑的皱纹,表情严肃,戴着黑色监听耳机,在深灰色背景前对着麦克风说话。平视角度,单侧硬光照明突出面部纹理,冷色调,超高清晰度写实摄影,电影级质感,竖屏。
- 视频提示词:不适用,此为音频驱动的数字人
### #42 00:58.917–00:59.500 · 数字人口播 + 代码/剪辑叠加(文字标注、图形贴片)

- 概率:数字人口播 97%,AI 生成视频 1%,3D 渲染 0%(fused)
- 素材来源:AI 生成
- 可能的工具:Hedra / D-ID
- 人脸占画面 32%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.29、用色 44 种、平坦块 24%
- [VLM] 身体和背景完全静止,仅头部和嘴部有动作
- [VLM] 胡须随下巴整体移动,无独立毛发动态
- [VLM] 符合单图音频驱动数字人的典型特征
- 画面:特写镜头,戴耳机白须老者在深色背景前激情演唱,表情夸张。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.1:1(相差 0.1 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):我又被拉回来
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:特写肖像,亚洲老者,长白须,戴黑色头戴式耳机,穿黑色铆钉服装。深灰背景。电影级光影,左侧主光,高对比度,突出面部纹理,超写实。
- 视频提示词:以图片为底图,输入激昂音频驱动人物大张嘴唱歌,头部轻微摆动。
### #43 00:59.500–01:02.542 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 84%,数字人口播 8%,3D 渲染 2%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling / Hailuo
- 低照度画面:45% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.54、用色 38 种、平坦块 4%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 握笔手指略显僵硬,笔尖与纸面接触缺乏真实物理反馈
- [VLM] 胡须边缘有轻微闪烁和不自然飘动
- 画面:特写镜头,白须老者身穿古装,在昏暗营帐背景下执笔写字,镜头微推。
- 拍法/打光:特写;平视略俯;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.7:1(相差 0.8 档);柔光(明暗过渡宽)
- 文字轨(字幕/bottom):我又被拉回来 / 祁门被围遗嘱写好 / 不肯退营等最坏
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写镜头,饱经风霜的中国古代老者,长白胡须,深色古装。神情凝重,低头执笔写字。背景昏暗军营帐篷,隐约火光。电影级光影,左侧柔和主光。
- 视频提示词:镜头缓慢推近,老者神情凝重,手执毛笔缓缓书写,胡须微晃,背景火光闪烁。
### #44 01:02.542–01:04.667 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 81%,3D 渲染 17%,2D 动画 1%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling/Hailuo/Runway
- 纹理呈渲染特征:平坦色块 34%、95% 像素仅用 27 种颜色、横竖直边 13%
- [VLM] 人物挖掘和挥锤的动作不符合物理规律,有漂浮感和轻微形变
- [VLM] 左侧人物挥动铲子时,铲柄与手臂连接处出现模糊和结构不稳定
- 画面:古代士兵在阴暗天空下挖掘壕沟的剪影,人物挥动铲子和锤子,背景有瞭望塔,整体呈高对比度暗黑风格。
- 拍法/打光:全景;略仰拍;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.2 档);柔光(明暗过渡宽)
- 文字轨(字幕/bottom):结硬寨打呆仗 / 结硬寨打枭仗
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:竖屏,全景,略仰拍。古代战场营地,阴沉压抑的乌云天空。前景是一群古代士兵的黑色剪影,正在用铲子挖壕沟、用大锤打桩。背景隐约可见木制瞭望塔。强烈的逆光剪影效果,高对比度,暗黑史诗风格。
- 视频提示词:镜头固定。画面中的古代士兵剪影开始动作,左侧士兵挥动铲子挖土,右侧士兵挥舞大锤砸向木桩,动作沉重。背景天空的乌云缓慢流动。保持强烈的逆光剪影和暗黑压抑氛围。
### #45 01:04.667–01:05.375 · 数字人口播 + 代码/剪辑叠加(图形贴片)

- 概率:数字人口播 97%,AI 生成视频 1%,3D 渲染 0%(fused)
- 素材来源:AI 生成
- 可能的工具:HeyGen / D-ID / SadTalker / 剪映数字人
- 人脸占画面 12%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.09、用色 26 种、平坦块 40%
- [VLM] 人物身体、耳机、麦克风完全静止,仅头部和嘴部有轻微驱动动作
- [VLM] 胡须与衣服交界处在头部运动时有轻微的 2D 图像拉扯形变
- [VLM] 典型的单张图片音频驱动数字人特征
- 画面:近景,戴耳机、留长白胡须的老者在麦克风前,头部微动,嘴唇微启,灰色背景。
- 拍法/打光:特写;平视;三脚架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.5:1(相差 0.6 档);中等柔度
- 文字轨(文字/bottom):汉盛
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:超写实肖像摄影,亚洲老年男性,长白胡须,满脸皱纹,戴黑色头戴式监听耳机,穿黑色中式服装,胸前有仙鹤刺绣,面前有黑色电容麦克风,灰色纯色背景,侧面柔光照明,电影级质感,8k。
- 视频提示词:使用底图,输入音频驱动人物嘴型说话,头部伴随语音自然轻微摆动,保持身体、耳机、麦克风和背景静止。
### #46 01:05.375–01:07.167 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 43%,实拍 31%,3D 渲染 18%(fused)
- 素材来源:AI 生成
- 纹理呈渲染特征:平坦色块 35%、95% 像素仅用 27 种颜色、横竖直边 13%
- [VLM] 泥土飞溅与挥锤劳作的物理动态极其真实无形变
- [VLM] 背光人物剪影轮廓和雨天漫射自然光层次分明
- [VLM] 典型院线历史/战争电影现场实拍质感
- [claude 看图] 逆光剪影的劳作人群,人物动作重复、锤子和木桩在帧间轻微变形
- [claude 看图] 构图和调色与全片一致,属同一批 AI 镜头
- 画面:阴雨天古代泥泞工地上,多名劳工挥锹挖土、抡大锤砸桩,背景有木制瞭望塔与远山,低机位平移。
- 拍法/打光:中景;略仰拍;稳定器;夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 1.9:1(相差 0.9 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):笨人只会慢慢挨
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:阴云营地,一群清代兵丁逆光剪影,挥锤打木桩,远处瞭望塔和旗帜
- 视频提示词:人们弯腰挥锤反复打桩,泥土飞溅,镜头固定
### #47 01:07.167–01:10.542 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 44%,数字人口播 28%,实拍 19%(fused)
- 素材来源:AI 生成
- 人脸占画面 24%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.12、用色 32 种、平坦块 40%
- 逐帧清晰度呈周期性起伏(周期 6 帧,相关 0.03):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 面部毛孔、皱纹与老年斑细节极其细腻自然,无AI形变或涂抹感
- [VLM] 胡须与头发发丝随头部运动有真实的物理摆动与遮挡关系
- [VLM] 发声时嘴唇肌肉、牙齿透视与舌头运动自然协调
- [VLM] 耳机皮质与金属反光符合真实物理光学
- 画面:清代官员装扮的白胡子老年男子戴着监听耳机,对着麦克风情绪饱满地口播说唱,灰色纯色背景,固定特写镜头。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧(侧光);光比约 2.5:1(相差 1.3 档);柔光(明暗过渡宽)
- 文字轨(字幕/bottom):笨人只会慢慢挨 / 打脱牙和血吞 / 京城骂完长沙骂
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写肖像,竖屏。一位满脸皱纹、留着灰白长山羊胡的清代老年官员,戴着现代黑色头戴式监听耳机,身穿黑色刺绣清代官服,灰色纯色影棚背景,顶部柔光,电影质感,冷调低饱和。
- 视频提示词:固定特写镜头。一位留灰白长须、穿清代官服戴现代耳机的老年男子面对镜头激昂说话说唱,头部随语调轻微点动,眼神坚定,嘴部动作自然逼真,灰色极简影棚背景。
### #48 01:10.542–01:11.792 · 数字人口播 + 代码/剪辑叠加(文字标注、图形贴片)

- 概率:数字人口播 63%,AI 生成视频 31%,实拍 5%(fused)
- 素材来源:AI 生成
- 可能的工具:LivePortrait
- 人脸占画面 24%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.22、用色 35 种、平坦块 29%
- [VLM] 身体与背景完全静止,仅嘴唇与下颌随音频变形驱动
- [VLM] 老者面容、白须及耳机具备典型 Midjourney 超写实生成特征
- [VLM] 麦克风边缘与胡须交界处无物理遮挡交互与自然阴影变化
- 画面:黑衣长髯老道戴监听耳机对着麦克风念白,面部特写,平视固定机位,暗调影棚光。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.1:1(相差 0.2 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):京城骂完长沙骂
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:写实摄影,中式老者特写,蓄白长须,头戴专业黑耳机,面朝侧方话筒,深色道袍,暗调摄影棚背景,伦勃朗光。
- 视频提示词:老者保持面朝麦克风姿势,随说唱音频张嘴念白,头部轻微晃动,神情严肃,镜头固定。
### #49 01:11.792–01:14.583 · 数字人口播 + 代码/剪辑叠加(字幕、图形贴片)

- 概率:数字人口播 74%,AI 生成视频 25%,3D 渲染 0%(fused)
- 画面里物体上的字(不是后期字幕):2
- 素材来源:AI 生成
- 可能的工具:LivePortrait / SadTalker / Hedra
- 人脸占画面 14%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.15、用色 34 种、平坦块 35%
- 100% 的采样帧有正脸且机位固定,音轨有人声
- [VLM] 身体、服饰及周围麦克风和防喷网完全静止无物理微动
- [VLM] 面部仅有嘴部与下颌根据音频进行唇形同步拉伸变形,胡须根部随嘴唇运动有算法拉扯感
- [VLM] 头部仅有微弱的算法位移与倾斜,眼部运动僵硬,属于典型静态图驱动口播
- 画面:清代官员装扮的长须老者戴专业监听耳机,面对电容麦克风说唱对口型,固定镜头近景,深灰摄影棚背景。
- 拍法/打光:特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.3 档);柔光(几乎没有明暗分界)
- 文字轨(字幕/bottom):京城骂完长沙骂 / 打脱牙和血吞
- 文字轨(文字/bottom):2
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:写实肖像,清朝晚期白发苍苍的长髯官员,身穿深色补服挂朝珠,头戴现代专业黑色监听耳机,面前立着录音电容麦克风,深灰色纯色录音室背景,侧光强反差,面部皱纹分明,8k细节
- 视频提示词:人物嘴部自然张合说唱对口型,胡须随下颌开合轻微摆动,眼神专注,身体与背景固定不动
### #50 01:14.583–01:17.292 · 数字人口播 + 代码/剪辑叠加(字幕)

- 概率:数字人口播 80%,AI 生成视频 19%,3D 渲染 0%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney (生成底图) + D-ID / HeyGen / SadTalker (音频驱动)
- 人脸占画面 23%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.22、用色 36 种、平坦块 29%
- 100% 的采样帧有正脸且机位固定,音轨有人声
- [VLM] 人物头部有轻微的摆动,嘴部有说话的开合动作,但肩膀、衣服、佩戴的耳机以及画面左侧的麦克风在整个视频中完全静止不动,这是典型的单张图片音频驱动(数字人/Avatar)特征。
- [VLM] 人物皮肤纹理过于锐利完美,带有典型的AI生成图像质感。
- 画面:特写镜头,一位留着长白胡须的老者戴着现代头戴式耳机,对着麦克风说话。画面背景为深灰色,光影对比强烈。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);硬光(明暗分界清楚)
- 文字轨(字幕/bottom):打脱牙和血吞 / 长沙骂完江西骂
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:特写镜头,一位中国古代风格的白须老者,面部布满皱纹,眼神深邃,头上戴着现代的黑色头戴式监听耳机,面前放着一个专业麦克风。深灰色纯色背景,左侧单光源硬光照明,高对比度,电影级质感,8k分辨率,极其逼真的皮肤纹理。
- 视频提示词:老者对着麦克风说话,嘴型自然开合,头部有轻微的自然晃动,身体、耳机和麦克风保持完全静止。
### #51 01:17.292–01:20.208 · 数字人口播 + 代码/剪辑叠加(字幕、图形贴片)

- 概率:数字人口播 55%,AI 生成视频 36%,3D 渲染 9%(fused)
- 画面里物体上的字(不是后期字幕):C
- 素材来源:AI 生成
- 可能的工具:LivePortrait / Hedra(底图为 Midjourney 生成)
- 人脸占画面 15%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.16、用色 35 种、平坦块 33%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 躯干与背景完全静止,仅唇形与头部随音频轻微摆动
- [VLM] 清代官服配现代录音耳机与电容麦的AI合成构图
- [VLM] 嘴部张合边缘与胡须交界处存在轻度驱动拉伸痕迹
- 画面:身穿清朝官服、佩戴监听耳机的老者对着麦克风说唱,头部随节奏微晃,暗调摄影棚近景。
- 拍法/打光:特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 1.5:1(相差 0.6 档);硬光(明暗分界清楚)
- 文字轨(字幕/bottom):长沙骂完江西骂 / 岳州败靖港败湖口败
- 文字轨(文字/bottom):C
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:写实肖像摄影,一位神似曾国藩的清代老者,灰白八字胡与长山羊胡,身着清代朝服挂念珠,佩戴专业黑色监听耳机,身前架着播客麦克风,暗灰纯色背景,高反差电影棚拍顶光,竖屏近景。
- 视频提示词:老者面朝麦克风对口型说唱,头部随语速轻微晃动,神情严肃,身体与肩膀保持不动,固定机位,写实暗调。
### #52 01:20.208–01:21.208 · AI 生成视频

- 概率:AI 生成视频 52%,实拍 28%,数字人口播 7%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney (底图) + Hedra / HeyGen / 剪映数字人
- 低照度画面:37% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 6%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.30、用色 38 种、平坦块 21%
- [VLM] 极度清晰的皮肤纹理(毛孔、皱纹)带有典型的 Midjourney V6 超写实风格
- [VLM] 动作仅限于嘴部开合和头部轻微摆动,身体和背景完全静止,符合单图音频驱动数字人的特征
- [VLM] 胡须在嘴部运动时可能存在轻微的非物理形变
- 画面:一位白发长须的老者特写,戴着头戴式耳机,对着麦克风讲话。深灰色纯色背景,高对比度光影凸显面部沧桑感。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);柔光(几乎没有明暗分界)
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:一位白发苍苍的亚洲老者特写,留着长长的白胡须,戴着黑色头戴式耳机,面前有一个黑色麦克风。深灰色纯色背景。超写实,电影级光影,高对比度,面部皱纹和毛孔细节丰富,左侧主光。
- 视频提示词:老者对着麦克风讲话,嘴型自然,头部有轻微的自然摆动,眼神专注,保持面部特征稳定。
### #53 01:21.208–01:25.458 · 数字人口播 + 代码/剪辑叠加(字幕)

- 概率:数字人口播 58%,AI 生成视频 38%,实拍 3%(fused)
- 素材来源:AI 生成
- 可能的工具:LivePortrait / SadTalker / Hedra
- 人脸占画面 25%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.23、用色 35 种、平坦块 28%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 身体与衣物完全静止,仅嘴唇与头部小幅度驱动形变
- [VLM] 胡须与唇周有典型的数字人音频驱动(Lip-sync)融合边缘
- [VLM] 底图具有强烈的 AI 人像质感,皮肤毛孔与深邃皱纹细节偏超现实
- 画面:白发长须长者头戴耳机面对麦克风念白,镜头固定,暗调影棚侧光。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.1:1(相差 0.2 档);硬光(明暗分界清楚)
- 文字轨(字幕/bottom):口一口和血吞 / 一口一口和血吞
- 复刻:数字人口播:先克隆/合成配音,再用数字人模型由人像 + 音频驱动
- 首帧图像提示词:特写肖像,饱经风霜的东亚老年道长,光头,花白八字胡与极长白山羊胡,头戴专业黑色监听耳机,身穿黑色中式盘扣长袍,冷调侧光,面部刻满深邃皱纹,深灰暗调纯色背景,电影质感,超写实细节。
- 视频提示词:老年男子头戴耳机对着麦克风严肃念词,嘴唇开合对准唱词,头部仅有极微幅点头与偏转,眼神坚定深沉,固定特写机位。
### #54 01:25.458–01:27.125 · 3D 渲染

- 概率:3D 渲染 58%,AI 生成视频 24%,代码/模板渲染 12%(fused)
- 素材来源:制作方渲染
- 可能的工具:Midjourney + 剪映
- 纹理呈渲染特征:平坦色块 30%、95% 像素仅用 27 种颜色、横竖直边 8%
- 逐帧清晰度呈周期性起伏(周期 4 帧,相关 0.50):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 画面内部没有任何独立运动(如水面波纹、绳索晃动),仅有整体画面的极其缓慢的推拉摇移(Ken Burns效果),符合静态图片处理特征。
- 画面:特写镜头,一艘破旧木船停泊在黑暗、雾气弥漫的水面上,船内放着两把木桨和一捆绳索,氛围阴郁极简。
- 拍法/打光:特写;俯拍;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面左侧(侧光);光比约 5.4:1(相差 2.4 档);柔光(明暗过渡宽)
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
- 首帧图像提示词:特写镜头,一艘破旧的木船停泊在黑暗、雾气弥漫的水面上,船内放着两把木桨和一捆粗糙的绳索。极简主义,暗黑氛围,电影级光影,冷色调,8k分辨率。
- 视频提示词:镜头缓慢向前推进,画面保持静止,展现破旧木船、木桨和绳索的细节,背景是浓雾弥漫的黑暗水面,氛围阴郁静谧。
### #55 01:27.125–01:28.333 · AI 生成视频 + 代码/剪辑叠加(图形贴片)

- 概率:AI 生成视频 80%,3D 渲染 18%,2D 动画 0%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling/Runway
- 逐帧清晰度呈周期性起伏(周期 5 帧,相关 0.56):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 水波运动规律粘稠,缺真实混沌感
- [VLM] 光影反射平滑完美,具AI质感
- [VLM] 地平线弧度不自然
- 画面:暗黑水面特写,水波荡漾,天空阴沉,镜头缓推。
- 拍法/打光:近景;平视略俯拍;稳定器 (模拟);户外阴天/背阴处柔光;主光画面左侧偏前方;光比约 1.6:1(相差 0.6 档);柔光(明暗过渡宽)
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:黑白暗黑风,波纹水面,阴沉天空,微光穿云,弧形地平线,极简电影感。
- 视频提示词:黑白暗黑水面,水波缓荡,阴沉天空,光影随波流动,镜头缓推。
### #56 01:28.333–01:30.750 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 77%,实拍 8%,数字人口播 7%(fused)
- 素材来源:AI 生成
- 可能的工具:Kling
- 低照度画面:62% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.52、用色 36 种、平坦块 9%
- 逐帧清晰度呈周期性起伏(周期 4 帧,相关 0.34):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 手指骨节、皮肤褶皱与胡须有轻微的AI平滑融合与动态漂移感
- [VLM] 手部遮掩右眼的动作极其微弱,主要是极其平缓的镜头推进与面部微动
- [VLM] 典型由AI图像(图生视频)生成的超写实电影质感画面
- 画面:身穿清代官服的白须老者右手遮住右眼,神情苍老疲倦,镜头缓慢推进,环境昏暗沉重。
- 拍法/打光:特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 1.9:1(相差 0.9 档);硬光(明暗分界清楚)
- 文字轨(文字/bottom):同治九年右眼失明
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:清代晚期老者,长满皱纹的面容,苍白长胡须,穿着黑色暗纹清代官袍,枯瘦苍老的右手捂着右眼,表情痛苦疲惫,微弱侧光,电影质感,超逼真细节,冷色调,竖屏
- 视频提示词:老者保持右手捂住右眼的姿势,手指轻微颤动,胸口微微起伏呼吸,镜头缓慢向前推近老者的面部特写,整体环境昏暗压抑。
### #57 01:30.750–01:31.417 · AI 生成视频

- 概率:AI 生成视频 53%,实拍 27%,数字人口播 7%(fused)
- 素材来源:AI 生成
- 可能的工具:LivePortrait / SadTalker / HeyGen
- 低照度画面:44% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 6%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.29、用色 36 种、平坦块 25%
- [VLM] 静态AI人像结合口播唇形驱动,身体与耳机完全静止
- [VLM] 嘴部张合时胡须有轻微拉伸形变伪影
- [VLM] 头部微弱位移,主要动态局限在嘴部区域
- 画面:戴耳机的白胡子老者面部特写,面向镜头说话,背景为纯色冷调棚拍背景,镜头缓慢微推。
- 拍法/打光:大特写;平视;三脚架/支架固定;夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 2.0:1(相差 1.0 档);柔光(明暗过渡宽)
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写镜头,饱经沧桑的中国老道长,戴着现代头戴式耳机,长白胡须,深沉严肃的眼神,直视镜头,深色道袍,纯深灰色棚拍背景,电影级写实,低饱和度,冷色调柔光。
- 视频提示词:正面特写老道长戴着耳机对镜头严肃说话,嘴唇根据语音开合,面部微表情变化,头部轻微自然晃动,身体和背景保持静止,镜头缓慢推进。
### #58 01:31.417–01:33.333 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 90%,实拍 8%,定格动画 0%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney + Kling
- 逐帧清晰度呈周期性起伏(周期 6 帧,相关 0.10):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- [VLM] 老者手部皮肤与眼眶贴合处有AI特有的融合与轻微形变
- [VLM] 胡须与皮肤纹理在慢速推镜过程中呈现微弱的AI流动沸腾感
- [VLM] 极度雕刻化的高对比度电影级皱纹质感,具有典型 Midjourney 风格
- 画面:白发长髯老者闭目按揉太阳穴,神情眩晕痛苦,镜头缓慢向前推近。
- 拍法/打光:特写;平视;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 2.0:1(相差 1.0 档);中等柔度
- 文字轨(文字/bottom):床在转头晕个不停
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:特写镜头,白发苍白长胡须的中国古代老者,满脸皱纹,一只布满青筋的手捂住右眼和额头,神情痛苦头晕,深色长袍,低饱和度暗黑色调,侧光雕刻面部质感,电影感,高细节真实纹理。
- 视频提示词:摄影机缓慢向老者面部推近,老者保持手按额头的动作,眉头微蹙,微弱呼吸,全身保持静止微动,暗黑电影氛围。
### #59 01:33.333–01:34.000 · AI 生成视频

- 概率:AI 生成视频 76%,实拍 15%,数字人口播 7%(fused)
- 素材来源:AI 生成
- 可能的工具:Midjourney + Kling
- 低照度画面:21% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 1%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.50、用色 43 种、平坦块 6%
- [VLM] 皮肤毛孔与深邃皱纹具有典型 Midjourney 风格的高密度合成质感
- [VLM] 画面仅有极轻微的漂移与局部微动,缺少自然的呼吸与眨眼起伏
- [VLM] 胡须与发际线交界处略显过度雕琢与轻微边缘融合
- 画面:亚裔年长男子面部大特写,眼神坚毅深邃,镜头缓慢向前平推,棚拍高对比布光。
- 拍法/打光:大特写;平视;三脚架/支架固定;侧前方主光 + 补光(标准布光);主光画面右侧偏前方;光比约 1.8:1(相差 0.8 档);柔光(明暗过渡宽)
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:饱经风霜的东亚年长男性正脸特写,满脸深皱纹,灰白小胡子与山羊胡,严肃冷酷眼神,头戴黑色头箍/耳机,纯深灰背景,高反差电影级人像棚拍布光,极高细节。
- 视频提示词:画面缓慢平稳向前微推,老者表情严肃冷峻保持凝视,面部伴随极其微弱的呼吸漂移感,眼神坚定不动。
### #60 01:34.000–01:39.208 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 46%,实拍 42%,数字人口播 7%(fused)
- 素材来源:AI 生成
- 低照度画面:34% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.56、用色 56 种、平坦块 1%
- [VLM] 清代一品仙鹤补服刺绣精细准确,朝珠与官帽质感真实
- [VLM] 老者手部皮肤、老人斑及关节生理结构自然,桌面倒影符合物理光学
- [VLM] 前景人物拿起与放下文书的动作流畅,物理交互真实
- [VLM] 无AI视频常见的纹理沸腾、手指变形或闪烁现象
- [claude 看图] 同一 AI 角色换上清朝官服,场景是清代谈判长桌,属于剧情化的 AI 生成画面
- [claude 看图] 光线、颗粒和人物与前后 AI 镜头一致
- 画面:清代谈判长桌前,穿一品官服的白须老官员沉重凝视,前景有洋人背影及文书动作,冷调侧光,微推镜头。
- 拍法/打光:近景;平视;稳定器;侧前方主光 + 补光(标准布光);主光画面右侧偏前方;光比约 1.6:1(相差 0.7 档);柔光(明暗过渡宽)
- 文字轨(字幕/bottom):带着病被派去天津 / 案子一结卖国贼成了我的名
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
- 首帧图像提示词:电影剧照,清代白发白须老官员端坐深色谈判桌前,戴官帽着仙鹤补服,面容沧桑神情凝重,前景虚焦洋人背影,侧逆冷光,暗调青灰,高反差电影质感。
- 视频提示词:清代老官员坐在谈判桌前沉重注视,双手轻按桌面,前景洋人手持折叠文书,镜头缓慢推进,冷峻肃穆的电影历史正剧氛围。
### #61 01:39.208–01:40.333 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 57%,实拍 25%,数字人口播 8%(deterministic)
- 素材来源:AI 生成
- 低照度画面:53% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 3%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.27、用色 36 种、平坦块 28%
- 拍法/打光:大特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.6:1(相差 0.7 档);柔光(明暗过渡宽)
- 文字轨(文字/middle):10777
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #62 01:40.333–01:43.125 · AI 生成视频 + 代码/剪辑叠加(文字标注、图形贴片)

- 概率:AI 生成视频 38%,3D 渲染 27%,实拍 18%(deterministic)
- 素材来源:AI 生成
- 人脸占画面 10%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.11、用色 30 种、平坦块 39%
- 拍法/打光:特写;手持;夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):湖广会馆挂我的匾
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #63 01:43.125–01:46.125 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 65%,3D 渲染 19%,实拍 6%(deterministic)
- 素材来源:AI 生成
- 纹理呈照片/视频特征:噪声 σ=0.54、用色 69 种、平坦块 7%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:近景;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.6:1(相差 0.7 档);硬光(明暗分界清楚)
- 文字轨(字幕/bottom):老乡砸了烧成灰烟 / 外惭清议
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #64 01:46.125–01:47.917 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 79%,数字人口播 8%,实拍 7%(deterministic)
- 素材来源:AI 生成
- 低照度画面:31% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 0%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.40、用色 42 种、平坦块 15%
- 逐帧清晰度呈周期性起伏(周期 2 帧,相关 0.01):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:大特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.6:1(相差 0.7 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):外惭清议
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #65 01:47.917–01:55.708 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 60%,3D 渲染 24%,数字人口播 6%(deterministic)
- 素材来源:AI 生成
- 镜头内动效节拍:108.46s、111.12s、112.96s
- 人脸占画面 7%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.17、用色 30 种、平坦块 33%
- 逐帧清晰度呈周期性起伏(周期 6 帧,相关 0.01):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:近景;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 2.4:1(相差 1.2 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):打脱牙和血吞
- 文字轨(文字/bottom):GA
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #66 01:55.708–01:59.208 · 静态图 + 推拉动效

- 概率:静态图 + 推拉动效 85%,AI 生成视频 9%,屏幕录制/截图 2%(deterministic)
- 静帧来源:unknown
- 素材来源:待确认;待确认是否真实:照片/图片素材
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.03px,无局部运动)→ 静态图推拉:缩放 +1.8%/s,平移 9px/s
- 纹理呈照片/视频特征:噪声 σ=0.51、用色 29 种、平坦块 2%
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #67 01:59.208–02:01.583 · 静态图 + 推拉动效(设计/渲染图形)

- 概率:静态图 + 推拉动效 76%,AI 生成视频 14%,屏幕录制/截图 4%(deterministic)
- 静帧来源:graphic
- 素材来源:制作方渲染
- 整帧按单一刚体变换运动(拟合内点 99%,残差 0.15px,无局部运动)→ 静态图推拉:缩放 +6.9%/s,平移 39px/s
- 纹理呈渲染特征:平坦色块 26%、95% 像素仅用 29 种颜色、横竖直边 7%
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #68 02:01.583–02:02.292 · 静态图 + 推拉动效(设计/渲染图形)

- 概率:静态图 + 推拉动效 83%,AI 生成视频 10%,屏幕录制/截图 3%(deterministic)
- 静帧来源:graphic
- 素材来源:制作方渲染
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.08px,无局部运动)→ 静态图推拉:缩放 -0.3%/s,平移 4px/s
- 纹理呈渲染特征:平坦色块 42%、95% 像素仅用 16 种颜色、横竖直边 22%
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #69 02:02.292–02:04.208 · 静态图 + 推拉动效 + 代码/剪辑叠加(文字标注)

- 概率:静态图 + 推拉动效 80%,AI 生成视频 12%,屏幕录制/截图 3%(deterministic)
- 静帧来源:unknown
- 素材来源:待确认;待确认是否真实:照片/图片素材
- 整帧按单一刚体变换运动(拟合内点 98%,残差 0.16px,无局部运动)→ 静态图推拉:缩放 +2.9%/s,平移 14px/s
- 文字轨(文字/bottom):黄号下了水
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #70 02:04.208–02:04.833 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 40%,3D 渲染 23%,实拍 20%(deterministic)
- 素材来源:AI 生成
- 人脸占画面 21%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.30、用色 40 种、平坦块 25%
- 拍法/打光:大特写;移动机位(稳定器/手持平移)
- 文字轨(文字/bottom):黄号下了水
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #71 02:04.833–02:05.458 · 3D 渲染 + 代码/剪辑叠加(文字标注)

- 概率:3D 渲染 50%,AI 生成视频 24%,代码/模板渲染 12%(deterministic)
- 素材来源:制作方渲染
- 纹理呈渲染特征:平坦色块 22%、95% 像素仅用 22 种颜色、横竖直边 24%
- 拍法/打光:中景;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):黄号下了水
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
### #72 02:05.458–02:07.083 · AI 生成视频

- 概率:AI 生成视频 83%,3D 渲染 5%,实拍 4%(deterministic)
- 素材来源:AI 生成
- 低照度画面:38% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 6%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.32、用色 39 种、平坦块 21%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:大特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.5:1(相差 0.6 档);中等柔度
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #73 02:07.083–02:09.208 · 3D 渲染 + 代码/剪辑叠加(文字标注)

- 概率:3D 渲染 37%,AI 生成视频 29%,实拍 18%(deterministic)
- 素材来源:制作方渲染
- 拍法/打光:中景;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面左侧(侧光);光比约 3.9:1(相差 2.0 档);柔光(明暗过渡宽)
- 文字轨(文字/bottom):幼童出洋的折子我签了
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
### #74 02:09.208–02:10.125 · 静态图 + 推拉动效(设计/渲染图形) + 代码/剪辑叠加(文字标注、图形贴片)

- 概率:静态图 + 推拉动效 77%,AI 生成视频 13%,屏幕录制/截图 4%(deterministic)
- 静帧来源:graphic
- 素材来源:制作方渲染
- 整帧按单一刚体变换运动(拟合内点 97%,残差 0.19px,无局部运动)→ 静态图推拉:缩放 -3.5%/s,平移 37px/s
- 纹理呈渲染特征:平坦色块 39%、95% 像素仅用 24 种颜色、横竖直边 13%
- 文字轨(文字/bottom):?
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #75 02:10.125–02:14.000 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 59%,3D 渲染 25%,数字人口播 6%(deterministic)
- 素材来源:AI 生成
- 人脸占画面 12%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.10、用色 27 种、平坦块 40%
- 逐帧清晰度呈周期性起伏(周期 None 帧,相关 0.00):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.1:1(相差 0.1 档);硬光(明暗分界清楚)
- 文字轨(文字/bottom):船开那天我没等到
- 文字轨(文字/middle):C
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #76 02:14.000–02:17.250 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 60%,3D 渲染 24%,数字人口播 6%(deterministic)
- 素材来源:AI 生成
- 人脸占画面 23%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.22、用色 33 种、平坦块 30%
- 逐帧清晰度呈周期性起伏(周期 2 帧,相关 0.01):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:大特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.1:1(相差 0.1 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):通籍三十年官至极品
- 文字轨(文字/middle):大
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #77 02:17.250–02:18.875 · AI 生成视频 + 代码/剪辑叠加(图形贴片)

- 概率:AI 生成视频 62%,3D 渲染 22%,数字人口播 6%(deterministic)
- 素材来源:AI 生成
- 人脸占画面 28%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.30、用色 34 种、平坦块 27%
- 逐帧清晰度呈周期性起伏(周期 2 帧,相关 0.21):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:大特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.5:1(相差 0.6 档);中等柔度
- 文字轨(文字/middle):大
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #78 02:18.875–02:22.333 · AI 生成视频 + 代码/剪辑叠加(文字标注)

- 概率:AI 生成视频 50%,实拍 32%,数字人口播 7%(deterministic)
- 素材来源:AI 生成
- 低照度画面:38% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 3%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.40、用色 34 种、平坦块 18%
- 拍法/打光:大特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面右侧偏前方;光比约 1.4:1(相差 0.5 档);中等柔度
- 文字轨(文字/bottom):学业一无所成
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #79 02:22.333–02:23.042 · AI 生成视频 + 代码/剪辑叠加(文字标注、图形贴片)

- 概率:AI 生成视频 41%,3D 渲染 24%,实拍 18%(deterministic)
- 素材来源:AI 生成
- 人脸占画面 27%、100% 的采样帧都有:是人物近景画面,平坦色块多来自墙面/衣服,渲染特征降权
- 纹理呈照片/视频特征:噪声 σ=0.27、用色 34 种、平坦块 28%
- 拍法/打光:大特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.3:1(相差 0.4 档);柔光(几乎没有明暗分界)
- 文字轨(文字/bottom):学业一无所成
- 文字轨(文字/middle):大
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #80 02:23.042–02:24.000 · 静态图 + 推拉动效(设计/渲染图形) + 代码/剪辑叠加(图形贴片)

- 概率:静态图 + 推拉动效 68%,屏幕录制/截图 15%,AI 生成视频 12%(deterministic)
- 静帧来源:graphic
- 素材来源:制作方渲染
- 整帧按单一刚体变换运动(拟合内点 96%,残差 0.18px,无局部运动)→ 静态图推拉:缩放 +0.1%/s,平移 15px/s
- 纹理呈渲染特征:平坦色块 38%、95% 像素仅用 30 种颜色、横竖直边 15%
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #81 02:24.000–02:28.042 · 3D 渲染 + 代码/剪辑叠加(字幕)

- 概率:3D 渲染 60%,AI 生成视频 20%,代码/模板渲染 12%(deterministic)
- 素材来源:制作方渲染
- 纹理呈渲染特征:平坦色块 37%、95% 像素仅用 29 种颜色、横竖直边 16%
- 逐帧清晰度呈周期性起伏(周期 2 帧,相关 0.02):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:近景;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.2:1(相差 0.3 档);硬光(明暗分界清楚)
- 文字轨(字幕/bottom):德行一无可许 / 这条,过了
- 文字轨(文字/middle):同茶
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
### #82 02:28.042–02:29.167 · AI 生成视频 + 代码/剪辑叠加(字幕)

- 概率:AI 生成视频 49%,实拍 32%,数字人口播 7%(deterministic)
- 素材来源:AI 生成
- 低照度画面:27% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 6%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.49、用色 33 种、平坦块 13%
- 拍法/打光:大特写;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光正面(光从镜头方向来,主体两侧亮度接近);光比约 1.0:1(相差 0.0 档);柔光(几乎没有明暗分界)
- 文字轨(字幕/bottom):这条,过了。 / 这条,过了
- 复刻:原片为 AI 生成:取原镜头首尾帧做首尾帧生成,可高度还原构图与动作;换主体时先用图像模型改首帧
### #83 02:29.167–02:32.000 · 静态图 + 推拉动效 + 代码/剪辑叠加(文字标注)

- 概率:静态图 + 推拉动效 75%,AI 生成视频 15%,屏幕录制/截图 3%(deterministic)
- 静帧来源:unknown
- 素材来源:待确认;待确认是否真实:照片/图片素材
- 整帧按单一刚体变换运动(拟合内点 100%,残差 0.14px,无局部运动)→ 静态图推拉:缩放 +0.1%/s,平移 2px/s
- 低照度画面:34% 的区域接近全黑但带颗粒(不是纯色底),亮部平坦块只有 8%、且有人脸:平坦块/少色是暗部被压缩造成的,不按渲染特征算
- 纹理呈照片/视频特征:噪声 σ=0.47、用色 35 种、平坦块 20%
- 文字轨(文字/middle):m
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #84 02:32.000–02:38.125 · 静态图 + 推拉动效

- 概率:静态图 + 推拉动效 77%,AI 生成视频 14%,屏幕录制/截图 3%(deterministic)
- 静帧来源:unknown
- 素材来源:待确认;待确认是否真实:照片/图片素材
- 镜头内动效节拍:155.00s
- 整帧按单一刚体变换运动(拟合内点 94%,残差 0.15px,无局部运动)→ 静态图推拉:缩放 +5.3%/s,平移 25px/s
- 复刻:静态图推拉:用一张图 + 测得的缩放/平移参数在本地 ffmpeg 精确复刻
### #85 02:38.125–02:40.375 · 3D 渲染 + 代码/剪辑叠加(图形贴片)

- 概率:3D 渲染 44%,AI 生成视频 41%,代码/模板渲染 9%(deterministic)
- 素材来源:制作方渲染
- 逐帧清晰度呈周期性起伏(周期 4 帧,相关 0.39):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:近景;移动机位(稳定器/手持平移);夜景/弱光环境光,没有专门补光;主光画面左侧偏前方;光比约 1.6:1(相差 0.7 档);柔光(明暗过渡宽)
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
### #86 02:40.375–02:44.958 · 3D 渲染

- 概率:3D 渲染 46%,AI 生成视频 37%,代码/模板渲染 11%(deterministic)
- 素材来源:制作方渲染
- 逐帧清晰度呈周期性起伏(周期 4 帧,相关 0.64):画面经过插帧/帧率转换,原始帧率更低
- 重复帧呈 interpolated 规律(0%,周期 None):原始素材为 24/25fps 后转码,常见于 AI 生成视频、3D/动画渲染或电影素材
- 拍法/打光:近景;移动机位(稳定器/手持平移);侧前方主光 + 补光(标准布光);主光画面右侧偏前方;光比约 1.6:1(相差 0.6 档);中等柔度
- 复刻:3D 渲染:可用首尾帧 AI 生成近似;需要精确多角度时走 3D 建模 + Blender 渲染
## 说明
- 确定性取证对「是否在动、是否整图推拉、是否渲染纹理、是否 24→30 帧率转换」很可靠;对实拍 / AI / 3D 的区分要依赖 VLM 与人工复核。
- 元数据经平台转码常被清除,缺失不代表没有。