# 動画分解レポート:qing_hiphop_full.mp4
> これは rea-video がこの動画に対して生成した Markdown レポート [report.md](report.md) の日本語訳です。セクションの順序と内容はツールの出力に従います。画面上で認識されたテキスト(「テキストトラック」の行)と音声から聞き取った歌詞は、フレームや音声に現れるままの中国語で残しています。
**結論**:混合制作:AI 生成動画 52% + 静止画 + ズーム・パン効果 17% + デジタルヒューマン 17% + 3D レンダリング 15%;オーバーレイ:テキスト注記、グラフィック貼り付け、字幕(コード/編集ソフトで合成);使用した実素材:実写の写真(3.0s)、商品の実写画像(0.7s);再現に用意する参考:人物/シーン参考画像(1 ショット)、商品参考画像(1 ショット);音声:ボーカル + BGM 178.2BPM(AI 生成音楽) + 効果音 56 箇所
- 尺 164.958s · 1080×1920 · 24.0fps · 9:16
- ショット 86 個、平均 1.92s;トランジション:cut×85、start×1
- 判定の確信度(尺で加重):71%;判定方法:決定論的フォレンジクス + VLM との統合
- VLM は部分的に有効(gemini-3.1-pro-preview,gemini-3.1-pro-preview-pc,gcp-gemini-3-pro-preview:60/60 ショットで結果あり、全編分析は失敗);claude が 9/86 ショットを画像で再確認し、結論に統合済み
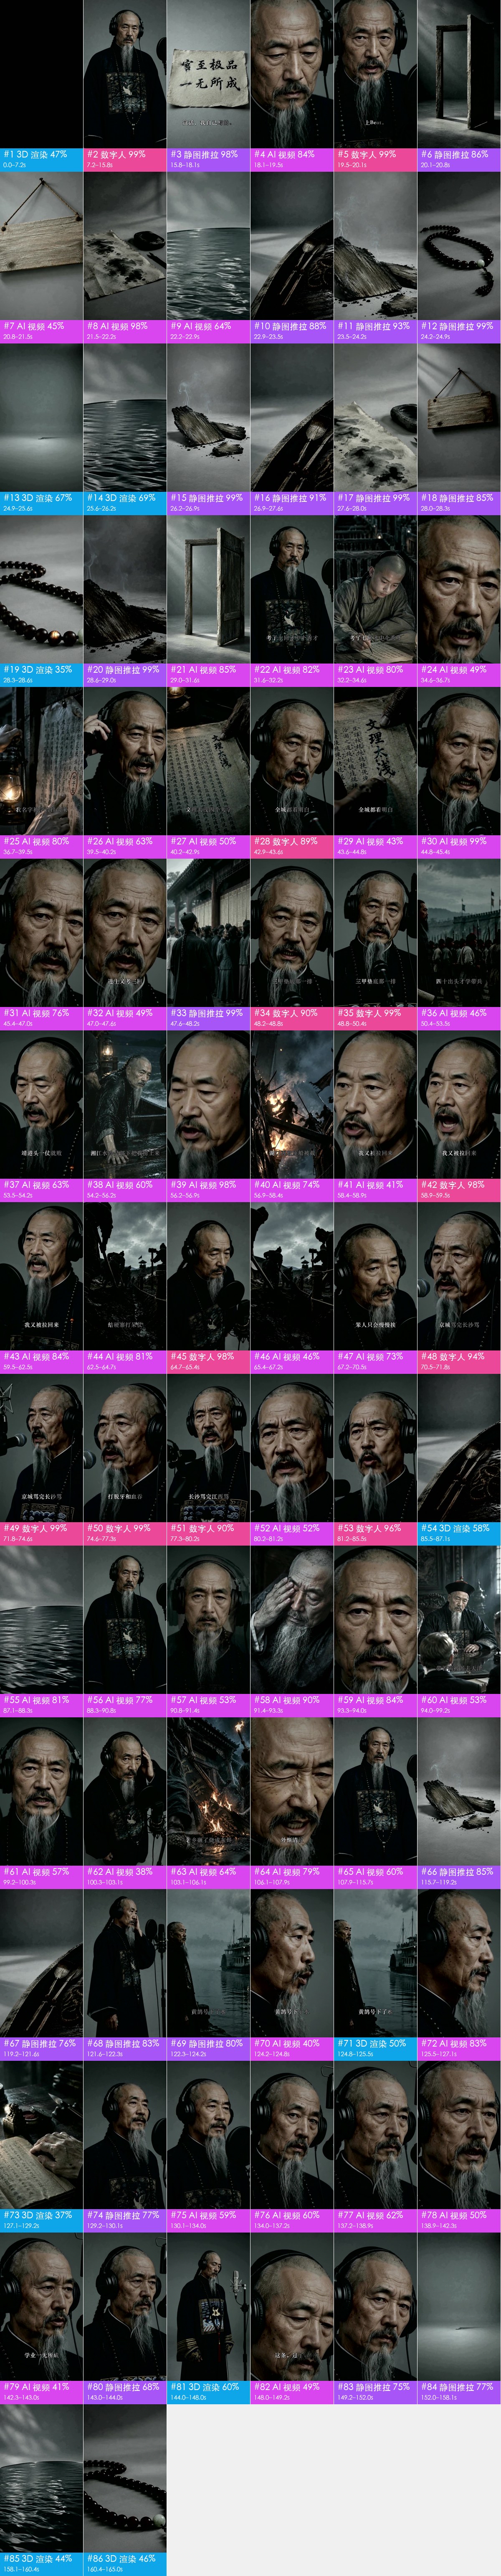
## 制作方法の割合
| ベース画面 | 尺 | 割合 |
|---|---|---|
| AI 生成動画 | 86.04s | 52% |
| 静止画 + ズーム・パン効果 | 27.46s | 17% |
| デジタルヒューマン | 27.25s | 16% |
| 3D レンダリング | 24.21s | 15% |
## 再現プラン
**3D レンダリング 10 ショット + AI 動画 45 ショット → 34 個の生成ユニット、Seedance 2.5 を 34 回呼び出し;静止画ズーム・パン/静止フレーム 19 ショット → ローカルで再構築;デジタルヒューマン 12 ショット → TTS + デジタルヒューマン駆動**
- デフォルトエンジンの Seedance 2.0(Mini / Fast を含む)は 1 回で複数ショットを出せないため、これを使う場合はショットごとに 55 回生成することになります。ここでは Seedance 2.5(1 回 ≤30s、1 回で複数ショット可)を前提に計画し、合計 34 回
- グループ化ルール:同じシーンでハードカットでつながる AI ショットは 1 回の生成にまとめる(S01);1 回 ≤30s;ユニット内の連続ハードカットはなるべく ≤8s、最大 10s(S06);ディゾルブ/フェードイン・アウトとシーン切り替えの箇所で分割する(S03)
- 音声:モデルは動作の効果音と環境音を同時に生成できます。語りは別途 TTS で作ってからミックスすることを推奨します。コピーの修正やタイミング合わせがしやすくなります
### 生成ユニット
| ユニット | ショット | 時間 | 尺 | 方式 | つなぎ |
|---|---|---|---|---|---|
| G1 | #1 | 0.0–7.2s | 7.2s | 単一ショット | 先頭フレーム:元動画の第 1 ショット先頭フレーム(shots/shot_001_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G2 | #4 | 18.1–19.5s | 1.4s | 単一ショット | 先頭フレーム:元動画の第 4 ショット先頭フレーム(shots/shot_004_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G3 | #7 | 20.8–21.5s | 0.7s | 単一ショット | 先頭フレーム:元動画の第 7 ショット先頭フレーム(shots/shot_007_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G4 | #8 | 21.5–22.2s | 0.7s | 単一ショット | 先頭フレーム:元動画の第 8 ショット先頭フレーム(shots/shot_008_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G5 | #9、#13、#14 | 22.2–22.9s、24.9–26.2s | 2.0s | 1 回で複数ショット | 先頭フレーム:元動画の第 9 ショット先頭フレーム(shots/shot_009_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G6 | #19、#21 | 28.3–28.6s、29.0–31.6s | 3.0s | 1 回で複数ショット | 先頭フレーム:元動画の第 19 ショット先頭フレーム(shots/shot_019_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G7 | #22–#23 | 31.6–34.6s | 3.0s | 1 回で複数ショット | 先頭フレーム:元動画の第 22 ショット先頭フレーム(shots/shot_022_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G8 | #24–#27 | 34.6–42.9s | 8.2s | 1 回で複数ショット | 先頭フレーム:元動画の第 24 ショット先頭フレーム(shots/shot_024_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G9 | #29 | 43.6–44.8s | 1.2s | 単一ショット | 先頭フレーム:元動画の第 29 ショット先頭フレーム(shots/shot_029_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G10 | #30–#32 | 44.8–47.6s | 2.8s | 1 回で複数ショット | 先頭フレーム:元動画の第 30 ショット先頭フレーム(shots/shot_030_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G11 | #36–#37 | 50.4–54.2s | 3.8s | 1 回で複数ショット | 先頭フレーム:元動画の第 36 ショット先頭フレーム(shots/shot_036_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G12 | #38 | 54.2–56.2s | 2.0s | 単一ショット | 先頭フレーム:元動画の第 38 ショット先頭フレーム(shots/shot_038_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G13 | #39 | 56.2–56.9s | 0.7s | 単一ショット | 先頭フレーム:元動画の第 39 ショット先頭フレーム(shots/shot_039_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G14 | #40 | 56.9–58.4s | 1.5s | 単一ショット | 先頭フレーム:元動画の第 40 ショット先頭フレーム(shots/shot_040_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G15 | #41 | 58.4–58.9s | 0.5s | 単一ショット | 先頭フレーム:元動画の第 41 ショット先頭フレーム(shots/shot_041_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G16 | #43 | 59.5–62.5s | 3.0s | 単一ショット | 先頭フレーム:元動画の第 43 ショット先頭フレーム(shots/shot_043_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G17 | #44 | 62.5–64.7s | 2.1s | 単一ショット | 先頭フレーム:元動画の第 44 ショット先頭フレーム(shots/shot_044_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G18 | #46 | 65.4–67.2s | 1.8s | 単一ショット | 先頭フレーム:元動画の第 46 ショット先頭フレーム(shots/shot_046_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G19 | #47 | 67.2–70.5s | 3.4s | 単一ショット | 先頭フレーム:元動画の第 47 ショット先頭フレーム(shots/shot_047_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G20 | #52 | 80.2–81.2s | 1.0s | 単一ショット | 先頭フレーム:元動画の第 52 ショット先頭フレーム(shots/shot_052_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G21 | #54 | 85.5–87.1s | 1.7s | 単一ショット | 先頭フレーム:元動画の第 54 ショット先頭フレーム(shots/shot_054_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G22 | #55 | 87.1–88.3s | 1.2s | 単一ショット | 先頭フレーム:元動画の第 55 ショット先頭フレーム(shots/shot_055_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G23 | #56–#58 | 88.3–93.3s | 5.0s | 1 回で複数ショット | 先頭フレーム:元動画の第 56 ショット先頭フレーム(shots/shot_056_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G24 | #59 | 93.3–94.0s | 0.7s | 単一ショット | 先頭フレーム:元動画の第 59 ショット先頭フレーム(shots/shot_059_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G25 | #60 | 94.0–99.2s | 5.2s | 単一ショット | 先頭フレーム:元動画の第 60 ショット先頭フレーム(shots/shot_060_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G26 | #61–#64 | 99.2–107.9s | 8.7s | 1 回で複数ショット | 先頭フレーム:元動画の第 61 ショット先頭フレーム(shots/shot_061_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G27 | #65、#70 | 107.9–115.7s、124.2–124.8s | 8.4s | 1 回で複数ショット | 先頭フレーム:元動画の第 65 ショット先頭フレーム(shots/shot_065_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G28 | #71 | 124.8–125.5s | 0.6s | 単一ショット | 先頭フレーム:元動画の第 71 ショット先頭フレーム(shots/shot_071_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G29 | #72 | 125.5–127.1s | 1.6s | 単一ショット | 先頭フレーム:元動画の第 72 ショット先頭フレーム(shots/shot_072_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G30 | #73 | 127.1–129.2s | 2.1s | 単一ショット | 先頭フレーム:元動画の第 73 ショット先頭フレーム(shots/shot_073_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G31 | #75–#77 | 130.1–138.9s | 8.8s | 1 回で複数ショット | 先頭フレーム:元動画の第 75 ショット先頭フレーム(shots/shot_075_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G32 | #78、#79、#81、#82 | 138.9–143.0s、144.0–149.2s | 9.3s | 1 回で複数ショット | 先頭フレームに G31 の末尾フレームを使い、動作をつなげる(S05) |
| G33 | #85 | 158.1–160.4s | 2.2s | 単一ショット | 先頭フレーム:元動画の第 85 ショット先頭フレーム(shots/shot_085_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
| G34 | #86 | 160.4–165.0s | 4.6s | 単一ショット | 先頭フレーム:元動画の第 86 ショット先頭フレーム(shots/shot_086_first.jpg)の構図を参照して画像を生成し、製品を @画像1 に差し替える |
**G1 · 3D レンダリング · ショット #1 · 7.2s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 0.0–7.2s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:清朝の老官吏の横顔クローズアップ、長い白ひげ、黒いモダンなヘッドホンを装着、純黒の背景、非常に強い片側のリムライト、映画級の質感、8k の高精細フォトリアル
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
黒背景のサイド光の下、モダンなヘッドホンを着けた清代の長ひげの老人の顔がわずかに動き、唇をかすかに開閉してつぶやく。カメラはきわめてゆっくりと前方へ平行に押し込み顔のクローズアップへ、高コントラストのシルエット的な光と影は変えない
```
English prompt(ツールが生成した英語版)
```text
Close-up of an elderly Qing Dynasty official with a long white beard wearing modern over-ear headphones, dramatic side rim lighting against a pure black background, subtle head movement and slight lip movements, slow smooth camera push-in.
```
**G2 · AI 生成動画 · ショット #4 · 1.4s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 18.1–19.5s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:高齢のアジア系男性のクローズアップ肖像、風雪を経た顔立ち、深い皺と老人性のしみ、濃い八の字ひげと灰白色の長いあごひげ、黒いモニターヘッドホンを装着、黒く深い背景、ドラマチックな映画的サイド光、超精細な肌の質感、縦構図。
- 4s 生成してから 1.4s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
高齢のアジア系の長ひげの老人がうつむいて静止し、黒いヘッドホンを着けている。その後ゆっくりとまぶたを上げて正面のカメラを凝視する。眼差しは深く冷たく、表情は厳粛なまま、ごくわずかな呼吸と頭の微動、固定ショット。
```
English prompt(ツールが生成した英語版)
```text
Close-up of an elderly Asian man with long grey beard and studio headphones, initially looking down, slowly raising his eyes to stare into the camera with an intense, solemn expression, minimal movement, locked-off shot.
```
**G3 · AI 生成動画 · ショット #7 · 0.7s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 20.8–21.5s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:ミニマルな静物写真、グレーのマイクロセメント壁、古びた鉄釘 1 本に太い麻縄で吊るされたエイジング加工の風化した木の長い看板、空白で文字なし、柔らかい斜め上からの拡散光、繊細な木目の質感、縦構図。
- 4s 生成してから 0.7s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
カメラはグレーの壁に吊るされたレトロな空白の木札を捉え、視点はわずかにあおり、画面は安定したままきわめてゆっくりと木札へ押し込む。
```
English prompt(ツールが生成した英語版)
```text
Camera slowly and smoothly pushing in on a rustic blank wooden hanging sign on a grey textured wall, subtle low angle, clean still-motion.
```
**G4 · AI 生成動画 · ショット #8 · 0.7s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 21.5–22.2s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:クローズアップ、濃いグレーの机の上に黒い墨のにじみ跡のあるしわの寄った宣紙が広げられ、右側に黒い硯と筆が 1 本置かれている。ダークトーン、ミニマリズム、東洋の美学。右上に窓枠のくっきりした影、映画的な光と影、高コントラスト、8k 解像度、フォトリアルな質感。
- 4s 生成してから 0.7s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
カメラはゆっくりと右へパンし、机の上の水墨画の紙、硯、筆を見せる。光と影は安定したまま、画面は静謐。
```
English prompt(ツールが生成した英語版)
```text
The camera slowly pans to the right, revealing the ink-stained paper, inkstone, and brush on the desk. The lighting remains stable, creating a tranquil atmosphere.
```
**G5 · 3D レンダリング · ショット #9、#13、#14 · 2.0s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 22.2–22.9s、24.9–26.2s の区間(間に挿入された画面を切り取って 1 本につなぐ):動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:モノクロ写真、水面の波紋のクローズアップ、わずかに弧を描く地平線、陰鬱な空、ミニマル、高コントラスト。
- これらのショットは完成版では挿入画面で分断されています。生成時は続けて出し、編集時に挿入画面を戻します
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–0.7s):モノクロ画面、水面に波紋が広がり、波はゆっくりと手前へ進む、空は静止、カメラ固定。
ショット2(0.7–1.4s):固定のロングショット、がらんとした薄暗い冷たいグレーの霧のスタジオで、小さな人影が地面に貼りつくようにきわめてゆっくりと這って進む、単一光源が非常に長い影を引き、画面は静止して凝固したような感覚
ショット3(1.4–2.0s):固定のクローズアップ、黒い粘性のある液体の水面が波打ち続けて起伏し、銀灰色の微光を反射する、上部の弧線は安定したまま、人物なし、神秘的で静かな雰囲気
```
English prompt(ツールが生成した英語版)
```text
Shot 1 (0.0-0.7s): Black and white, water ripples slowly moving forward, static sky, fixed camera.
Shot 2 (0.7-1.4s): Locked-off wide shot, minimalist misty dark grey studio, a tiny human figure slowly crawls on the floor, single hard spotlight casting an elongated sharp shadow.
Shot 3 (1.4-2.0s): Static close-up shot of dark liquid water ripples flowing continuously, reflecting subtle silvery light, smooth curved rim at the top, minimalist black and white 3D render.
```
**G6 · AI 生成動画 · ショット #19、#21 · 3.0s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 28.3–28.6s、29.0–31.6s の区間(間に挿入された画面を切り取って 1 本につなぐ):動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:ミニマルな製品写真、クローズアップ。深い茶色で丸みのある木製の数珠が、滑らかなライトグレーの背景の上に S 字形に置かれている。前景のピント位置に金色に輝くひび割れのある珠 1 つと薄い青緑の玉の珠 1 つ。浅い被写界深度、背景はボケ。柔らかい左上からの光が、禅的で静かな雰囲気を作る、高品質、フォトリアル。
- これらのショットは完成版では挿入画面で分断されています。生成時は続けて出し、編集時に挿入画面を戻します
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–0.3s):カメラはゆっくりと前へ押し込み、滑らかなグレーの背景の上の濃い色の木製数珠をクローズアップで見せる。前景に金色のひび割れのある珠 1 つと薄い青緑の珠 1 つ。画面は静止したまま、滑らかなカメラの押し込みだけがある。
ショット2(0.3–3.0s):固定またはゆっくり前へ押し込むカメラ、古代の書生がカメラに背を向けてゆっくりと大門をくぐって前へ歩く。両側の木の扉は固定、遠くの通りの提灯の光がかすかに揺らぎ、水面に反射が映る。全体の動きは落ち着いてゆっくり
```
English prompt(ツールが生成した英語版)
```text
Shot 1 (0.0-0.3s): Slow push-in shot on a string of dark wooden prayer beads resting on a smooth grey surface in an S-shape. In the foreground, there is a bead with a golden crack and a pale green bead in focus. The scene itself is completely static, with only the camera moving slowly forward.
Shot 2 (0.3-3.0s): Cinematic slow push-in shot, back view of an ancient Chinese scholar in robes slowly walking forward through an open wooden gate into a wet stone alley lined with glowing lanterns at night, subtle motion, moody atmosphere.
```
**G7 · AI 生成動画 · ショット #22、#23 · 3.0s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 31.6–34.6s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:実写写真の質感、清朝の年老いた官吏、鶴の刺繍のある黒い補服と朝珠を身に着け、長い白いあごひげを蓄え、プロ用の黒いモニターヘッドホンを装着、目の前にポップガード付きマイク、ダークグレーのミニマルなスタジオ背景、映画級の寒色系サイド光、高コントラストでドラマチックな光と影、縦構図。
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–0.5s):カメラはミディアムクローズから安定して素早く老人の顔のクローズアップへ押し込む。老人は大きなヘッドホンを着け、眼差しは毅然として厳粛、マイクに向かって口を開き力強くラップする。ひげが自然にわずかに動き、表情は冷徹。
ショット2(0.5–3.0s):カメラはゆっくりと前へ押し込み、書生がうつむいて集中して字を書く。手にはわずかな運筆の動き、頭が微動。
```
English prompt(ツールが生成した英語版)
```text
Shot 1 (0.0-0.5s): Smooth cinematic fast push-in to a tight close-up of an elderly Qing dynasty official wearing studio headphones, rapping into a podcast microphone with intense expressions, beard moving subtly, cold cinematic studio lighting.
Shot 2 (0.5-3.0s): Camera slowly pushes in. The young scholar looks down, focused on writing, with slight brush movements and subtle head motion.
```
**G8 · AI 生成動画 · ショット #24、#25、#26、#27 · 8.2s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 34.6–42.9s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:中国古代の老人の顔のクローズアップ、白髪まじりのひげ、顔中に深い皺と老人性のしみ、黒いモダンなヘッドホンを装着、ローキーの硬い光、映画的な質感、超リアルなディテール、8k 解像度
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–2.0s):老人の顔の固定クローズアップ、厳粛で冷徹にカメラに向かって話す。唇が音声に同期して開閉し、顔がわずかに動き、眼差しは毅然、カメラは静止したまま
ショット2(2.0–4.9s):固定のクローズアップ。夜の闇の中で灯油ランプの炎がかすかに揺らぎ、薄黄色の明かりが名簿を照らす。1 本の指が赤い丸の中の「林子安」の 3 文字を安定して指し、名簿の紙がそよ風でごくわずかに震える。全体として暗く重苦しいサスペンスの雰囲気を保つ。
ショット3(4.9–5.6s):カメラ固定、黒いヘッドホンを着けた長ひげのアジア系の老人がヘッドホンに手を添え、没入した表情で口を開いて歌い唱える。顔の筋肉とひげが歌に合わせて軽く自然に揺れる、ダークトーンのスタジオのサイド光。
ショット4(5.6–8.2s):痩せこけた指が上奏文の大きな文字の上をゆっくりとなぞり、もう一方の手が下から画面に入って紙面を押さえる。カメラはゆっくりと押し込む
```
English prompt(ツールが生成した英語版)
```text
Shot 1 (0.0-2.0s): Extreme close-up of an elderly Asian man speaking seriously, lips synced to audio, intense gaze, highly detailed weathered skin, static shot.
Shot 2 (2.0-4.9s): Close-up static shot. In the dark night, the flame of a kerosene lantern flickers softly, casting warm light on an old paper roster on a wooden wall. A hand with prominent veins points its index finger steadily at the Chinese name '林子安' circled in red ink. Cinematic, low-key lighting, suspenseful atmosphere.
Shot 3 (4.9-5.6s): Fixed close-up shot, an elderly Asian man with long gray beard wearing studio headphones, holding the earcup with his hand, singing with deep emotion, subtle facial muscle and beard movement, low-key dramatic studio lighting.
Shot 4 (5.6-8.2s): Close-up of an old frail finger tracing large ink characters on a yellowed memorial scroll, another hand enters from below, slow push-in, dark cinematic tone
```
**G9 · AI 生成動画 · ショット #29 · 1.2s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 43.6–44.8s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:黄ばんだ上奏文のミディアムクローズ、大きな文字「文理太浅」(文章が浅すぎる)が中央、上に 1 本の指が紙の端を押さえている、ダークトーン
- 4s 生成してから 1.2s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
指が上奏文を押さえ、カメラは大きな文字「文理太浅」へわずかに押し込む
```
English prompt(ツールが生成した英語版)
```text
Close shot of the scroll with the large characters, a finger pressing the edge, gentle push-in
```
**G10 · AI 生成動画 · ショット #30、#31、#32 · 2.8s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 44.8–47.6s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:クローズアップ、年配のアジア系男性、長い白ひげ、顔中の皺、きめ細かな肌の質感。黒いモダンなヘッドホンを装着、黒い中国式の服装。無地のグレー背景。映画級の光と影、サイドからの柔らかい光、超リアル、ポートレート写真。
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–0.6s):クローズアップ、ヘッドホンを着けた長ひげの老人がマイクに向かって話す。口の動きは自然、頭が軽く揺れる。カメラ固定。
ショット2(0.6–2.2s):カメラはきわめてゆっくりと前へ押し込み、主人公は背を向けて静かに立ち合格発表の壁を見上げる。周囲の受験生の後ろ姿にはかすかな呼吸のような揺れがあり、冷徹で厳粛な雰囲気がショット終了まで続く。
ショット3(2.2–2.8s):老人がカメラを直視して話し、口の形は自然に開閉し、表情がわずかに動く。頭と体は静止したまま、クローズアップ、固定カメラ
```
English prompt(ツールが生成した英語版)
```text
Shot 1 (0.0-0.6s): Close-up, elderly Asian man with long beard wearing headphones speaks into microphone, natural mouth movements, slight head sway. Fixed camera.
Shot 2 (0.6-2.2s): Camera slowly dollies in from behind a Qing dynasty scholar with a braided queue looking up at the imperial examination results board, surrounded by crowds of examinees, somber cold cinematic lighting, subtle atmospheric breathing motion.
Shot 3 (2.2-2.8s): Close-up shot of an elderly Chinese man with a long white beard and deep wrinkles, wearing black over-ear headphones, speaking directly to the camera. Natural lip sync, slight facial expressions, head and body remain still. Solid gray background, side lighting, cinematic texture, fixed camera.
```
**G11 · AI 生成動画 · ショット #36、#37 · 3.8s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 50.4–54.2s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:暗雲が垂れ込める古い城壁の下、槍を手に整列した清代の兵士たち、画面左側に前景としてもじゃもじゃのひげの将軍の横顔、冷たいグレーの映画的カラーグレーディング
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–3.1s):兵士の隊列がゆっくりと動き、土煙が舞う。将軍の横顔は静かに立ち、カメラはゆっくりと横移動
ショット2(3.1–3.8s):固定のクローズアップ、ヘッドホンを着けた長ひげの中国の老人がマイクに向かって沈痛に歌い出す。口が開閉して歌い、顔の筋肉とひげが自然にかすかに震え、視線はわずかに伏せて重々しい。光と影は安定したまま。
```
English prompt(ツールが生成した英語版)
```text
Shot 1 (0.0-3.1s): Ancient army ranks beneath a city wall under heavy clouds, a bearded general in profile in the foreground, dust rising, slow lateral move
Shot 2 (3.1-3.8s): Close-up static shot of an elderly East Asian man with a long grey beard wearing over-ear studio headphones, singing with a sorrowful expression into a microphone, natural facial muscle and beard movements, studio low-key moody lighting.
```
**G12 · AI 生成動画 · ショット #38 · 2.0s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 54.2–56.2s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:夜の川面の小舟の上、全身ずぶ濡れの白ひげの清代の老人が両手を船板についている。背後に灯油ランプが掛かり、冷たい青の色調
- 4s 生成してから 2.0s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
老人が息を切らして船板に手をつき顔を上げる。後ろの人物が手を伸ばして引き上げようとし、川の波が逆巻く
```
English prompt(ツールが生成した英語版)
```text
At night on a small boat, a drenched old man with a white beard braces on the deck and looks up, someone behind reaches to pull him, waves churning
```
**G13 · AI 生成動画 · ショット #39 · 0.7s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 56.2–56.9s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:クローズアップ、白ひげのアジア系の老人、黒いヘッドホンを装着、顔中の皺、興奮した表情で口を開けている、無地のグレー背景、左からの柔らかい光、高コントラストのフォトリアルな肖像。
- 4s 生成してから 0.7s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
老人が興奮した表情で話すか歌う。口の形は自然に開閉し、頭が軽く揺れ、光と影は安定したまま。
```
English prompt(ツールが生成した英語版)
```text
Old man speaking or singing excitedly, natural mouth movement, slight head shake, stable lighting.
```
**G14 · AI 生成動画 · ショット #40 · 1.5s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 56.9–58.4s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:縦画面、壮大な古代の水上戦のシーン、夜、軍船が燃え、濃い煙が立ちのぼる。画面中央に 2 隻の船をつなぐ木の橋があり、数名の古代の兵士のシルエットが橋の上で槍や刀剣を手に激しく戦っている。背景は天を衝く火の光とはためく軍旗。強烈な逆光、高コントラスト、映画級の質感、ダークスタイル。
- 4s 生成してから 1.5s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
カメラはゆっくりと前へ押し込み、わずかにあおりで撮る。兵士たちが燃える木の橋の上で槍や刀剣を振るって戦い、動きは激しい。背景の炎は激しく燃え、濃い煙が風に流れ、火の粉が飛び散る。全体の雰囲気は緊迫して混沌。
```
English prompt(ツールが生成した英語版)
```text
Slow push-in and slight low-angle shot. Soldiers fight fiercely with spears and swords on a burning wooden bridge. Flames burn intensely in the background, thick smoke billows in the wind, and sparks fly. The overall atmosphere is tense and chaotic.
```
**G15 · AI 生成動画 · ショット #41 · 0.5s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 58.4–58.9s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:クローズアップ、灰白色のあごひげを蓄えたアジア系の年配男性、風雪を経た皺だらけの顔、厳粛な表情、黒いモニターヘッドホンを装着し、ダークグレーの背景の前でマイクに向かって話す。目線の高さ、片側からの硬い光が顔の質感を際立たせる、寒色系、超高精細のフォトリアル写真、映画級の質感、縦画面。
- 4s 生成してから 0.5s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
該当なし、これは音声駆動のデジタルヒューマン
```
English prompt(ツールが生成した英語版)
```text
Not applicable, this is an audio-driven avatar
```
**G16 · AI 生成動画 · ショット #43 · 3.0s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 59.5–62.5s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:クローズアップ、風雪を経た中国古代の老人、長い白ひげ、暗い色の古装。表情は重々しく、うつむいて筆を執り字を書く。背景は薄暗い軍営のテント、かすかな火の光。映画級の光と影、左からの柔らかいキーライト。
- 4s 生成してから 3.0s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
カメラはゆっくりと押し込み、老人は重々しい表情で筆を手にゆっくりと書き、ひげがわずかに揺れ、背景の火の光が揺らぐ。
```
English prompt(ツールが生成した英語版)
```text
Slow push-in shot. An ancient Chinese elder with a long white beard, wearing dark traditional clothes, is writing with a brush with a solemn expression. His beard sways slightly. Dim military tent background with flickering firelight.
```
**G17 · AI 生成動画 · ショット #44 · 2.1s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 62.5–64.7s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:縦画面、フルショット、ややあおり。古代の戦場の陣地、陰鬱で重苦しい暗雲の空。前景は古代の兵士たちの黒いシルエットで、シャベルで塹壕を掘り、大槌で杭を打っている。背景にかすかに木製の物見櫓が見える。強烈な逆光のシルエット効果、高コントラスト、ダークな叙事詩スタイル。
- 4s 生成してから 2.1s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
カメラ固定。画面内の古代の兵士のシルエットが動き始め、左の兵士はシャベルを振るって土を掘り、右の兵士は大槌を振り上げて木の杭に打ち下ろす。動きは重い。背景の空の暗雲がゆっくりと流れる。強烈な逆光のシルエットとダークで重苦しい雰囲気を保つ。
```
English prompt(ツールが生成した英語版)
```text
Fixed camera. The silhouettes of ancient soldiers begin to move. The soldier on the left swings a shovel to dig dirt, and the soldier on the right swings a sledgehammer to hit a wooden stake, with heavy movements. The dark clouds in the background sky flow slowly. Maintain a strong backlight silhouette and a dark, oppressive atmosphere.
```
**G18 · AI 生成動画 · ショット #46 · 1.8s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 65.4–67.2s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:曇天の陣地、逆光のシルエットになった清代の兵卒の一団が槌を振るって木の杭を打つ、遠くに物見櫓と旗
- 4s 生成してから 1.8s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
人々が腰をかがめて槌を振るい繰り返し杭を打ち、泥が飛び散る、カメラ固定
```
English prompt(ツールが生成した英語版)
```text
Silhouetted soldiers hammering wooden stakes in a muddy camp under overcast sky, mud splashing, static camera
```
**G19 · AI 生成動画 · ショット #47 · 3.4s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 67.2–70.5s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:クローズアップ肖像、縦画面。顔中に皺があり灰白色の長いあごひげを蓄えた清代の年配の官吏が、モダンな黒いモニターヘッドホンを装着し、黒い刺繍入りの清代官服を着ている。グレー無地のスタジオ背景、上からの柔らかい光、映画的な質感、寒色系で低彩度。
- 4s 生成してから 3.4s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
固定のクローズアップ。灰白色の長ひげを蓄え、清代の官服を着てモダンなヘッドホンを着けた年配の男性がカメラに向かって激しく語りラップする。頭が語調に合わせて軽くうなずき、眼差しは毅然、口の動きは自然でリアル、グレーのミニマルなスタジオ背景。
```
English prompt(ツールが生成した英語版)
```text
Fixed close-up shot. An elderly Chinese man with a grey goatee wearing Qing dynasty attire and modern over-ear headphones passionately rapping to the camera, head nodding subtly with speech rhythm, dark moody studio lighting.
```
**G20 · AI 生成動画 · ショット #52 · 1.0s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 80.2–81.2s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:白髪のアジア系の老人のクローズアップ、長い白ひげを蓄え、黒いヘッドホンを装着し、目の前に黒いマイクがある。ダークグレーの無地背景。超リアル、映画級の光と影、高コントラスト、顔の皺と毛穴のディテールが豊富、左からのキーライト。
- 4s 生成してから 1.0s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
老人がマイクに向かって話す。口の形は自然、頭に軽く自然な揺れがあり、眼差しは集中、顔の特徴を安定して保つ。
```
English prompt(ツールが生成した英語版)
```text
Close-up of an elderly Asian man with a long white beard, wearing black headphones, speaking into a black microphone. Natural lip sync, slight head movements, focused expression. Dark grey background, cinematic lighting, highly detailed.
```
**G21 · 3D レンダリング · ショット #54 · 1.7s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 85.5–87.1s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:クローズアップ、暗く霧の立ちこめる水面に老朽化した木の船が停泊し、船の中に 2 本の木の櫂と粗いロープの束が置かれている。ミニマリズム、ダークな雰囲気、映画級の光と影、寒色系、8k 解像度。
- 4s 生成してから 1.7s にカット(短すぎるショットは単独生成が不安定なため)
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
カメラはゆっくりと前へ押し込み、画面は静止したまま、老朽化した木の船、木の櫂、ロープのディテールを見せる。背景は濃い霧に包まれた暗い水面、雰囲気は陰鬱で静か。
```
English prompt(ツールが生成した英語版)
```text
The camera slowly pushes forward, the scene remains static, showing the details of a dilapidated wooden boat, wooden oars, and ropes. The background is a dark water surface covered in thick fog, with a gloomy and quiet atmosphere.
```
**G22 · AI 生成動画 · ショット #55 · 1.2s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 87.1–88.3s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:モノクロのダークスタイル、波紋のある水面、陰鬱な空、雲間から差す微光、弧を描く地平線、ミニマルな映画感。
- 4s 生成してから 1.2s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
モノクロのダークな水面、水の波がゆるやかに揺れ、陰鬱な空、光と影が波とともに流れ、カメラはゆっくり押し込む。
```
English prompt(ツールが生成した英語版)
```text
B&W dark water, slow ripples, gloomy sky, flowing light, slow push in.
```
**G23 · AI 生成動画 · ショット #56、#57、#58 · 5.0s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 88.3–93.3s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:清代末期の老人、皺だらけの顔、白く長いひげ、黒い地紋入りの清代官服を着て、痩せこけて老いた右手で右目を覆い、苦しく疲れた表情、かすかなサイド光、映画的な質感、超リアルなディテール、寒色系、縦画面
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–2.4s):老人は右手で右目を覆った姿勢を保ち、指がわずかに震え、胸がかすかに上下して呼吸する。カメラはゆっくりと前へ老人の顔のクローズアップへ押し込み、環境全体は薄暗く重苦しい。
ショット2(2.4–3.1s):正面クローズアップ、ヘッドホンを着けた年老いた道長がカメラに向かって厳粛に話す。唇が音声に合わせて開閉し、顔の微表情が変化し、頭が軽く自然に揺れ、体と背景は静止したまま、カメラはゆっくりと押し込む。
ショット3(3.1–5.0s):カメラはゆっくりと老人の顔へ押し込み、老人は額に手を当てた動作を保ち、眉をわずかにひそめ、かすかに呼吸し、全身は静止したまま微動、ダークな映画の雰囲気。
```
English prompt(ツールが生成した英語版)
```text
Shot 1 (0.0-2.4s): Close-up of an elderly Qing dynasty man covering his right eye with his wrinkled hand, subtle breathing motion and slight finger twitch, slow camera push-in towards the tired face, cinematic low-key lighting.
Shot 2 (2.4-3.1s): Close-up of an elderly Asian man with a long grey beard wearing modern studio headphones, speaking seriously to camera, lip-sync talking motion, subtle head movement, camera slowly zooming in, cinematic muted lighting.
Shot 3 (3.1-5.0s): Slow push-in shot onto the face of an elderly Chinese man with long white beard holding his forehead in dizziness, subtle breathing, dark cinematic lighting.
```
**G24 · AI 生成動画 · ショット #59 · 0.7s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 93.3–94.0s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:風雪を経た東アジア系の年配男性の正面クローズアップ、顔中の深い皺、灰白色の口ひげとあごひげ、厳粛で冷酷な眼差し、黒いヘッドバンド/ヘッドホンを装着、無地のダークグレー背景、高コントラストの映画級ポートレートスタジオライティング、きわめて高いディテール。
- 4s 生成してから 0.7s にカット(短すぎるショットは単独生成が不安定なため)
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
画面はゆっくりと安定して前へわずかに押し込み、老人は厳粛で冷徹な表情で凝視を続け、顔にはごくかすかな呼吸による揺らぎ、眼差しは毅然として動かない。
```
English prompt(ツールが生成した英語版)
```text
Slow smooth push-in shot on the elderly Asian man, stoic and intense gaze fixed on the camera, extremely subtle breathing micro-movements, cinematic dramatic portrait lighting.
```
**G25 · AI 生成動画 · ショット #60 · 5.2s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 94.0–99.2s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 先頭フレーム画像プロンプト:映画のスチール、白髪白ひげの清代の老官吏が暗い色の交渉テーブルの前に端座し、官帽をかぶり鶴の補服を着て、風雪を経た顔に重々しい表情、前景にピントの外れた西洋人の後ろ姿、サイドからの冷たい逆光、ダークトーンの青灰色、高コントラストの映画的質感。
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
清代の老官吏が交渉テーブルの前に座り重々しく見つめ、両手を軽くテーブルに置く。前景の西洋人は折りたたんだ文書を手にし、カメラはゆっくりと押し込む。冷徹で厳粛な歴史正劇の映画の雰囲気。
```
English prompt(ツールが生成した英語版)
```text
Cinematic shot of an elderly Qing dynasty Chinese official in official robe sitting somberly at a negotiation table, Western diplomats blurred in the foreground, slow subtle push-in, dark cold moody lighting.
```
**G26 · AI 生成動画 · ショット #61、#62、#63、#64 · 8.7s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 99.2–107.9s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- ショット #61、#62、#63、#64 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–1.1s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット2(1.1–3.9s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット3(3.9–6.9s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット4(6.9–8.7s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
**G27 · AI 生成動画 · ショット #65、#70 · 8.4s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 107.9–115.7s、124.2–124.8s の区間(間に挿入された画面を切り取って 1 本につなぐ):動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- これらのショットは完成版では挿入画面で分断されています。生成時は続けて出し、編集時に挿入画面を戻します
- ショット #65、#70 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–7.8s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット2(7.8–8.4s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
**G28 · 3D レンダリング · ショット #71 · 0.6s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 124.8–125.5s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 4s 生成してから 0.6s にカット(短すぎるショットは単独生成が不安定なため)
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
- ショット #71 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
**G29 · AI 生成動画 · ショット #72 · 1.6s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 125.5–127.1s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 4s 生成してから 1.6s にカット(短すぎるショットは単独生成が不安定なため)
- ショット #72 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
**G30 · 3D レンダリング · ショット #73 · 2.1s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 127.1–129.2s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 4s 生成してから 2.1s にカット(短すぎるショットは単独生成が不安定なため)
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
- ショット #73 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
**G31 · AI 生成動画 · ショット #75、#76、#77 · 8.8s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 130.1–138.9s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- ショット #75、#76、#77 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–3.9s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット2(3.9–7.1s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット3(7.1–8.8s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
**G32 · AI 生成動画 · ショット #78、#79、#81、#82 · 9.3s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 138.9–143.0s、144.0–149.2s の区間(間に挿入された画面を切り取って 1 本につなぐ):動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- これらのショットは完成版では挿入画面で分断されています。生成時は続けて出し、編集時に挿入画面を戻します
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
- ショット #78、#79、#81、#82 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。ショット間はハードカット。
ショット1(0.0–3.5s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット2(3.5–4.2s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット3(4.2–8.2s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
ショット4(8.2–9.3s):(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
**G33 · 3D レンダリング · ショット #85 · 2.2s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 158.1–160.4s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 4s 生成してから 2.2s にカット(短すぎるショットは単独生成が不安定なため)
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
- ショット #85 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
**G34 · 3D レンダリング · ショット #86 · 4.6s**
- 参考素材:`@画像1` 製品の実写画像(正面 + ロゴ面)、ユーザーが用意;`@画像2` 人物参考画像(各キャラクターにつき正面 1 枚 + 半身 1 枚)、ショット間で顔を一致させるため;`@動画1` 元動画 160.4–165.0s の区間:動作・カメラワーク・カット間隔の参考(参考のみ、画面は複製しない)
- 別ルート:3D プロジェクト。LLM に Blender スクリプトや Three.js シーンを書かせ、キャラクター/小道具を一度モデリングしてショットごとにカメラを設定してレンダリングします。多アングルとキャラクターの一貫性が最も良く、コピーやショットの変更もコードを直すだけで済みます(R08)
- ショット #86 はプロンプト欠落
```text
縦画面 9:16;夜景/弱光の環境光、専用の補助光なし、柔らかい光(明暗の遷移が広い)、中性(約 5000K)、背景は明らかにボケている(浅い被写界深度/ポートレートモード)。製品の外観は @画像1 を基準とし、ロゴと細部を一致させる。人物は @画像2 を基準とする。@動画1 の動作・カメラワーク・カット間隔を参考にする。
(プロンプト欠落:--vlm を有効にするか agent が画像を見て補筆)
```
### ローカル再構築
- #3 静止画 + ズーム・パン効果 2.3s;#6 静止画 + ズーム・パン効果 0.7s;#10 静止画 + ズーム・パン効果 0.7s;#11 静止画 + ズーム・パン効果 0.7s;#12 静止画 + ズーム・パン効果 0.7s;#15 静止画 + ズーム・パン効果 0.7s;#16 静止画 + ズーム・パン効果 0.7s;#17 静止画 + ズーム・パン効果 0.3s;#18 静止画 + ズーム・パン効果 0.3s;#20 静止画 + ズーム・パン効果 0.4s;#33 静止画 + ズーム・パン効果 0.6s;#66 静止画 + ズーム・パン効果 3.5s;#67 静止画 + ズーム・パン効果 2.4s;#68 静止画 + ズーム・パン効果 0.7s;#69 静止画 + ズーム・パン効果 1.9s;#74 静止画 + ズーム・パン効果 0.9s;#80 静止画 + ズーム・パン効果 1.0s;#83 静止画 + ズーム・パン効果 2.8s;#84 静止画 + ズーム・パン効果 6.1s:画像 1 枚 + 計測したズーム/パンのパラメータで、ffmpeg から直接出力
## 撮り方・ライティング・編集
- 構図:ショットサイズ クローズアップ 55%、極端なクローズアップ 45%;カメラアングル 目線;被写体は顔(顔の高さでショットサイズを算出)
- カメラ:固定カメラ(三脚/スタンド/机に置く) 57%、移動カメラ(ジンバル/手持ちパン) 43%;よく使われるカメラワーク 引き
- ライティング:夜景/弱光の環境光、専用の補助光なし。キーライト 画面右側やや前方、上から下へ(天井灯/街灯/高い位置の光源);ライティング比 約 1.5:1(0.6 段差);柔らかい光(明暗の遷移が広い);色温度は中性(約 5000K);背景は明らかにボケている(浅い被写界深度/ポートレートモード)
- カラー:ダークで低彩度(シネマティック);低彩度、コントラスト通常、黒レベル通常、全体に寒色寄り
- 編集:1 分あたり 30.9 カット、実写ショット平均 2.27s;カメラ位置/シーン 5 個;同一カメラ位置のジャンプカット 0 箇所、寄りカット 0 箇所;挿入画面(スクリーンショット/画面録画/カード/素材)が 84%;切り替え点の 50% が発話の間に落ちる
**再現撮影プラン**
1. 構図:クローズアップ中心、目線
2. カメラ:固定カメラ(三脚/スタンド/机に置く) 57%、移動カメラ(ジンバル/手持ちパン) 43%;よく使われるカメラワーク 引き
3. ライティング:夜景/弱光の環境光、専用の補助光なし——キーライトは環境(街灯、看板、室内の天井灯、画面)由来、被写体はやや暗く、コントラストは環境で決まる
4. 編集:1 分あたり 30.9 カット、実写ショット平均 2.27s;カメラ位置/シーン 5 個;同一カメラ位置のジャンプカット 0 箇所、寄りカット 0 箇所;挿入画面(スクリーンショット/画面録画/カード/素材)が 84%;切り替え点の 50% が発話の間に落ちる
機材:
- スマートフォンの夜景/ポートレートモード、街灯や看板をキーライトにし、人は灯りの斜め下に立つ
- よりクリーンにしたい場合:レンズの脇に低輝度の暖色 LED 小型ライト(3200K)を追加
- 注意:背景は明らかにボケている(浅い被写界深度/ポートレートモード)
| 次元 | 項目 | 結論 | 出典 |
|---|---|---|---|
| 構図 | ショットサイズ | クローズアップ | 計測:クローズアップ;VLM:ミディアムクローズ(半身) |
| 構図 | カメラアングル | 目線 | VLM:目線 |
| 構図 | 構図 | 中央配置、縦画面 | VLM:中央配置、縦画面 |
| カメラ | 撮影方法 | 三脚/スタンド固定 | 計測:混合:固定カメラ(三脚/スタンド/机に置く) 57%、移動カメラ(ジンバル/手持ちパン) 43%;VLM:三脚/スタンド固定 |
| カメラ | レンズ | カメラのポートレート/望遠 | VLM:カメラのポートレート/望遠 |
| ライティング | シーン | 屋内;スタジオ | VLM:屋内;スタジオ |
| ライティング | キーライト | 画面左側やや上、ソフトボックス | VLM:画面左側やや上、ソフトボックス |
| ライティング | 硬さ | 柔らかい光(明暗の遷移が広い) | 計測:柔らかい光(明暗の遷移が広い);VLM:柔らかい光 |
| ライティング | フィル | 暗部にフィルあり、影の遷移が柔らかい | VLM:暗部にフィルあり、影の遷移が柔らかい |
| ライティング | リムライト | 明確なリムライトなし | VLM:明確なリムライトなし |
| ライティング | キャッチライト | 弱い点状 | VLM:弱い点状 |
| ライティング | 可視光源 | なし | VLM:なし |
| ライティング | 色温度 | 中性(約 5000K) | 計測:中性(約 5000K);VLM:中性やや寒色 |
| ライティング | ライティングプラン | 左のキーライトは柔らかい光 + 右に弱いリムライト | VLM:左のキーライトは柔らかい光 + 右に弱いリムライト |
| カラー | カラースタイル | ダークで低彩度(シネマティック) | 計測:ダークで低彩度(シネマティック) |
- 注記:ライティング比、硬さ、色温度、ショットサイズは被写体のピクセルから計測(顔があれば顔、なければ画面の鮮明な領域を使い、後者は推定値);プラットフォームのトランスコードで暗部が潰れるため、硬さとフィルは控えめに出ます;カメラアングル、光源の種類、キャッチライト、リムライトは画像確認の結果を優先します。計測と画像確認が一致しない場合は両方を併記します。
## メタデータの手がかり
- エンコーダー:`Lavf61.7.100`
## 音声の分解

- 全体のラウドネス -17.4 dBFS、ピーク -1.9 dBFS
- **ボーカル・音声**:あり、尺の 26%、基本周波数約 142.8Hz(男声寄り)
- **BGM**:尺の 97%(0.0–164.5s)、約 178.2 BPM(89.1/356.4 の可能性もあり)、調 A minor(確信度 0.658)、セクションの変化点 4.0s, 19.0s, 63.5s, 68.0s, 107.5s, 111.5s, 123.0s, 133.5s
- **編集とビート**:切り替え点の 38% がビート上に落ちる(ランダムで約 40%)
**音声の出どころ:AI 生成か既存素材か**
- **結論**:動画の種類:音楽 MV/楽曲タイプ(全編が歌われた 1 曲) → ボーカル・音声は TTS 吹き替え;音楽は AI 生成音楽(傾向、要確認);効果音は効果音ライブラリ/編集ソフトで後から追加(傾向、要確認)
- **分離したステム**:`stems/original.wav`(元音声)、`stems/vocals.wav`(ボーカルのドライ音声、過渡的な効果音もここに入る)、`stems/music.wav`(音楽 + 環境音)
- 動画の形式:歌入りの楽曲/MV と推定;AI 画面 69%、実写 0%
- **BGM**:AI 生成音楽(ai_generated 52%、popular_song 26%、existing_library 22%)
- 全編で音楽が途切れず、ボーカルは歌唱(持続音高の割合 0.24):ボーカル入りの歌/音楽 MV のようで、AI ソングの確率が高い(VLM 未使用、MV の事前確率に基づくが重みは下げている)
- 音楽と動画が同時に終わる:尺に合わせて編集またはカスタムされている(どちらの出どころもあり得る、弱い証拠)
- 確認方法:Douyin(抖音)/小紅書(Xiaohongshu)の元動画ページで音楽タグを見る:曲名が表示 → 既存の楽曲;「@作者の作成したオリジナル音源」と表示 → 作者自身がアップロード(MV タイプは AI ソングが多い)
- 確認方法:Soda Music/QQ Music の「楽曲認識」や ACRCloud で識別する:ヒットすれば既存の楽曲
- 確認方法:聴く:AI ソングは発音が曖昧、高域が薄く金属的、歌詞が画面の内容に密着していることが多い;ライブラリ音楽の多くはボーカルなし、標準的な構成で、末尾が切られるかフェードアウト
- **ボーカル・音声**:TTS 吹き替え(tts 64%、human_recording 27%、ai_video_native 9%)
- ボーカルと背景音が切り替え点をまたいで連続:ナレーション全体が後から個別に当てられている(TTS または人の吹き替え)
- **効果音**:効果音ライブラリ/編集ソフトで後から追加(library_editor 57%、ai_native 29%、live_sync 14%)
- 3D/アニメーション系動画のカートゥーン効果音もプログラム合成や効果音ライブラリで追加されることが多い(例えば capsule-cinema の plush レシピはプログラム合成)
- 区間ごとのネイティブ音声検出:切り替え点での背景音の変化 6.4dB、ショット内 6.1dB(比 1.05)→ 音声は切り替え点をまたいで連続しており、後から全体に敷かれたもの
**効果音**(56 箇所;出典 vlm=大規模モデルが聞き取り、deterministic=信号検出の候補、確信度低)
| 時間 | 種類 | 説明 | 対応する画面 | 出典 |
|---|---|---|---|---|
| 10.29s | ding | | | deterministic |
| 20.79s | ding | | 切り替え点 | deterministic |
| 31.67s | ding | | 切り替え点 | deterministic |
| 32.00s | ding | | | deterministic |
| 50.71s | ding | | | deterministic |
| 51.37s | whoosh | | | deterministic |
| 51.57s | whoosh | | | deterministic |
| 52.07s | whoosh | | | deterministic |
| 59.72s | whoosh | | | deterministic |
| 59.90s | whoosh | | | deterministic |
| 60.07s | ding | | | deterministic |
| 60.23s | whoosh | | | deterministic |
| 63.63s | hit | | | deterministic |
| 67.70s | pop | | | deterministic |
| 84.71s | whoosh | | | deterministic |
| 86.09s | whoosh | | | deterministic |
| 86.42s | whoosh | | | deterministic |
| 86.77s | whoosh | | | deterministic |
| 88.13s | pop | | | deterministic |
| 97.65s | whoosh | | | deterministic |
| 100.02s | ding | | | deterministic |
| 100.37s | whoosh | | 切り替え点 | deterministic |
| 102.72s | whoosh | | | deterministic |
| 119.41s | whoosh | | | deterministic |
| 122.12s | whoosh | | | deterministic |
| 123.50s | ding | | | deterministic |
| 123.83s | ding | | | deterministic |
| 125.88s | ding | | | deterministic |
| 132.68s | whoosh | | | deterministic |
| 133.02s | ding | | | deterministic |
| 135.05s | ding | | | deterministic |
| 135.64s | pop | | | deterministic |
| 136.41s | ding | | | deterministic |
| 136.92s | ding | | | deterministic |
| 137.09s | ding | | | deterministic |
| 137.43s | ding | | | deterministic |
| 137.76s | ding | | | deterministic |
| 142.48s | whoosh | | | deterministic |
| 151.37s | whoosh | | | deterministic |
| 152.06s | pop | | 切り替え点 | deterministic |
**音声の再現プラン**
- voice(A01-narration):ボーカル・音声、male → capsule-cinema DoubaoTTSTool / UniversalTTSTool(または MiniMax のクローン音声);元のタイミング枠に合わせる必要がある場合は尺を制御できる TTS(A02)を使う
- music(A03-music):178.2 BPM;A minor → 元の曲は AI 生成の傾向:Suno など(capsule-cinema UniversalMusicGenerationTool)でスタイル/BPM/調に合わせて再生成し、MV タイプは歌詞も新しい内容に合わせて書く
- sfx(A04-sfx):効果音 56 個 → 時間位置に合わせて配置:capsule-cinema SoundEffectsTool/効果音ライブラリ、または plush レシピのようにプログラム合成(音高を BGM の調に合わせる)
## 画面内の実素材
合計 2 ショット、3.04s(2%)の画面に実素材(画面録画、スクリーンショット、写真、埋め込み動画)が含まれます。再現時には元ファイルを入手する必要があり、モデル生成で代替できません:
- ショット #3(00:15.750):実写の写真、画面全体
- ショット #3(00:15.750):実写の写真、画面の一部、濃いグレーの台の上の手書き毛筆書道の粗い宣紙の静物実写写真
- ショット #12(00:24.208):実写の写真、画面全体
- ショット #12(00:24.208):商品の実写画像、画面の一部、画面全体が数珠ブレスレットの商品写真
## 再現用に用意する参考素材
これらのショットの画面は生成または撮影されたものです。以下は画面に登場し、再現時に参考画像/小道具として用意すべきものです(埋め込まれた実ピクセルではありません):
- ショット #7(00:20.833):人物/シーン参考画像、吊り下げた木札の高精細な単品静物実写画像
- ショット #19(00:28.292):商品参考画像、濃い色の木製数珠の静物写真
## ショットリスト
| # | 時間 | 尺 | ベース画面 | 確信度 | 素材の出どころ | オーバーレイ | カメラワーク | 再現ルート |
|---|---|---|---|---|---|---|---|---|
| 1 | 00:00.000 | 7.25s | 3D レンダリング | 47% | 制作側レンダリング | テキスト | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 2 | 00:07.250 | 8.50s | デジタルヒューマン | 99% | AI 生成 | 字幕 | 固定 | R03-talking-head → capsule_cinema |
| 3 | 00:15.750 | 2.33s | 静止画 + ズーム・パン効果 | 98% | ユーザーの実素材:実写の写真 | 字幕、テキスト | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 4 | 00:18.083 | 1.38s | AI 生成動画 | 84% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 5 | 00:19.458 | 0.67s | デジタルヒューマン | 99% | AI 生成 | 字幕、グラフィック貼り付け | スムーズな移動 | R03-talking-head → capsule_cinema |
| 6 | 00:20.125 | 0.71s | 静止画 + ズーム・パン効果 | 86% | AI 生成 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 7 | 00:20.833 | 0.67s | AI 生成動画 | 45% | AI 生成;再現参考:人物/シーン参考画像 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 8 | 00:21.500 | 0.67s | AI 生成動画 | 98% | AI 生成 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 9 | 00:22.167 | 0.71s | AI 生成動画 | 64% | AI 生成 | グラフィック貼り付け | スムーズな移動 | R07-product-hero → capsule_cinema |
| 10 | 00:22.875 | 0.67s | 静止画 + ズーム・パン効果 | 88% | 制作側レンダリング | グラフィック貼り付け | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 11 | 00:23.542 | 0.67s | 静止画 + ズーム・パン効果 | 93% | AI 生成 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 12 | 00:24.208 | 0.71s | 静止画 + ズーム・パン効果 | 99% | ユーザーの実素材:実写の写真、商品の実写画像 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 13 | 00:24.917 | 0.67s | 3D レンダリング | 67% | 制作側レンダリング | — | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 14 | 00:25.583 | 0.67s | 3D レンダリング | 69% | 制作側レンダリング | グラフィック貼り付け | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 15 | 00:26.250 | 0.67s | 静止画 + ズーム・パン効果 | 99% | AI 生成 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 16 | 00:26.917 | 0.71s | 静止画 + ズーム・パン効果 | 91% | AI 生成 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 17 | 00:27.625 | 0.33s | 静止画 + ズーム・パン効果 | 99% | AI 生成 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 18 | 00:27.958 | 0.33s | 静止画 + ズーム・パン効果 | 85% | AI 生成 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 19 | 00:28.292 | 0.33s | 3D レンダリング | 35% | 制作側レンダリング;再現参考:商品参考画像 | — | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 20 | 00:28.625 | 0.38s | 静止画 + ズーム・パン効果 | 99% | AI 生成 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 21 | 00:29.000 | 2.62s | AI 生成動画 | 85% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 22 | 00:31.625 | 0.54s | AI 生成動画 | 82% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 23 | 00:32.167 | 2.46s | AI 生成動画 | 80% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 24 | 00:34.625 | 2.04s | AI 生成動画 | 49% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 25 | 00:36.667 | 2.88s | AI 生成動画 | 80% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 26 | 00:39.542 | 0.71s | AI 生成動画 | 63% | AI 生成 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 27 | 00:40.250 | 2.62s | AI 生成動画 | 50% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 28 | 00:42.875 | 0.71s | デジタルヒューマン | 89% | AI 生成 | テキスト | スムーズな移動 | R03-talking-head → capsule_cinema |
| 29 | 00:43.583 | 1.21s | AI 生成動画 | 43% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 30 | 00:44.792 | 0.62s | AI 生成動画 | 99% | AI 生成 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 31 | 00:45.417 | 1.54s | AI 生成動画 | 76% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 32 | 00:46.958 | 0.62s | AI 生成動画 | 49% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 33 | 00:47.583 | 0.62s | 静止画 + ズーム・パン効果 | 99% | AI 生成 | テキスト | スムーズな移動 | R17-still-motion → local_ffmpeg |
| 34 | 00:48.208 | 0.58s | デジタルヒューマン | 90% | AI 生成 | テキスト | スムーズな移動 | R03-talking-head → capsule_cinema |
| 35 | 00:48.792 | 1.58s | デジタルヒューマン | 99% | AI 生成 | テキスト | 固定(被写体が動く) | R03-talking-head → capsule_cinema |
| 36 | 00:50.375 | 3.08s | AI 生成動画 | 46% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 37 | 00:53.458 | 0.75s | AI 生成動画 | 63% | AI 生成 | テキスト、グラフィック貼り付け | スムーズな移動 | R07-product-hero → capsule_cinema |
| 38 | 00:54.208 | 2.00s | AI 生成動画 | 60% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 39 | 00:56.208 | 0.71s | AI 生成動画 | 98% | AI 生成 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 40 | 00:56.917 | 1.50s | AI 生成動画 | 74% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 41 | 00:58.417 | 0.50s | AI 生成動画 | 41% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 42 | 00:58.917 | 0.58s | デジタルヒューマン | 98% | AI 生成 | テキスト、グラフィック貼り付け | スムーズな移動 | R03-talking-head → capsule_cinema |
| 43 | 00:59.500 | 3.04s | AI 生成動画 | 84% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 44 | 01:02.542 | 2.12s | AI 生成動画 | 81% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 45 | 01:04.667 | 0.71s | デジタルヒューマン | 98% | AI 生成 | グラフィック貼り付け | スムーズな移動 | R03-talking-head → capsule_cinema |
| 46 | 01:05.375 | 1.79s | AI 生成動画 | 46% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 47 | 01:07.167 | 3.38s | AI 生成動画 | 73% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 48 | 01:10.542 | 1.25s | デジタルヒューマン | 94% | AI 生成 | テキスト、グラフィック貼り付け | スムーズな移動 | R03-talking-head → capsule_cinema |
| 49 | 01:11.792 | 2.79s | デジタルヒューマン | 99% | AI 生成 | 字幕、グラフィック貼り付け | 固定(被写体が動く) | R03-talking-head → capsule_cinema |
| 50 | 01:14.583 | 2.71s | デジタルヒューマン | 99% | AI 生成 | 字幕 | 固定(被写体が動く) | R03-talking-head → capsule_cinema |
| 51 | 01:17.292 | 2.92s | デジタルヒューマン | 90% | AI 生成 | 字幕、グラフィック貼り付け | スムーズな移動 | R03-talking-head → capsule_cinema |
| 52 | 01:20.208 | 1.00s | AI 生成動画 | 52% | AI 生成 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 53 | 01:21.208 | 4.25s | デジタルヒューマン | 96% | AI 生成 | 字幕 | スムーズな移動 | R03-talking-head → capsule_cinema |
| 54 | 01:25.458 | 1.67s | 3D レンダリング | 58% | 制作側レンダリング | — | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 55 | 01:27.125 | 1.21s | AI 生成動画 | 81% | AI 生成 | グラフィック貼り付け | スムーズな移動 | R07-product-hero → capsule_cinema |
| 56 | 01:28.333 | 2.42s | AI 生成動画 | 77% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 57 | 01:30.750 | 0.67s | AI 生成動画 | 53% | AI 生成 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 58 | 01:31.417 | 1.92s | AI 生成動画 | 90% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 59 | 01:33.333 | 0.67s | AI 生成動画 | 84% | AI 生成 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 60 | 01:34.000 | 5.21s | AI 生成動画 | 53% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 61 | 01:39.208 | 1.12s | AI 生成動画 | 57% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 62 | 01:40.333 | 2.79s | AI 生成動画 | 38% | AI 生成 | テキスト、グラフィック貼り付け | 手持ちブレ | R07-product-hero → capsule_cinema |
| 63 | 01:43.125 | 3.00s | AI 生成動画 | 64% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 64 | 01:46.125 | 1.79s | AI 生成動画 | 79% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 65 | 01:47.917 | 7.79s | AI 生成動画 | 60% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 66 | 01:55.708 | 3.50s | 静止画 + ズーム・パン効果 | 85% | 要確認;実物かどうか要確認:写真/画像素材 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 67 | 01:59.208 | 2.38s | 静止画 + ズーム・パン効果 | 76% | 制作側レンダリング | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 68 | 02:01.583 | 0.71s | 静止画 + ズーム・パン効果 | 83% | 制作側レンダリング | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 69 | 02:02.292 | 1.92s | 静止画 + ズーム・パン効果 | 80% | 要確認;実物かどうか要確認:写真/画像素材 | テキスト | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 70 | 02:04.208 | 0.62s | AI 生成動画 | 40% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 71 | 02:04.833 | 0.62s | 3D レンダリング | 50% | 制作側レンダリング | テキスト | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 72 | 02:05.458 | 1.62s | AI 生成動画 | 83% | AI 生成 | — | スムーズな移動 | R07-product-hero → capsule_cinema |
| 73 | 02:07.083 | 2.12s | 3D レンダリング | 37% | 制作側レンダリング | テキスト | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 74 | 02:09.208 | 0.92s | 静止画 + ズーム・パン効果 | 77% | 制作側レンダリング | テキスト、グラフィック貼り付け | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 75 | 02:10.125 | 3.88s | AI 生成動画 | 59% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 76 | 02:14.000 | 3.25s | AI 生成動画 | 60% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 77 | 02:17.250 | 1.62s | AI 生成動画 | 62% | AI 生成 | グラフィック貼り付け | スムーズな移動 | R07-product-hero → capsule_cinema |
| 78 | 02:18.875 | 3.46s | AI 生成動画 | 50% | AI 生成 | テキスト | スムーズな移動 | R07-product-hero → capsule_cinema |
| 79 | 02:22.333 | 0.71s | AI 生成動画 | 41% | AI 生成 | テキスト、グラフィック貼り付け | スムーズな移動 | R07-product-hero → capsule_cinema |
| 80 | 02:23.042 | 0.96s | 静止画 + ズーム・パン効果 | 68% | 制作側レンダリング | グラフィック貼り付け | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 81 | 02:24.000 | 4.04s | 3D レンダリング | 60% | 制作側レンダリング | 字幕 | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 82 | 02:28.042 | 1.12s | AI 生成動画 | 49% | AI 生成 | 字幕 | スムーズな移動 | R07-product-hero → capsule_cinema |
| 83 | 02:29.167 | 2.83s | 静止画 + ズーム・パン効果 | 75% | 要確認;実物かどうか要確認:写真/画像素材 | テキスト | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 84 | 02:32.000 | 6.12s | 静止画 + ズーム・パン効果 | 77% | 要確認;実物かどうか要確認:写真/画像素材 | — | 全体ズーム/パン | R17-still-motion → local_ffmpeg |
| 85 | 02:38.125 | 2.25s | 3D レンダリング | 44% | 制作側レンダリング | グラフィック貼り付け | スムーズな移動 | R08-product-multiview → capsule_cinema |
| 86 | 02:40.375 | 4.58s | 3D レンダリング | 46% | 制作側レンダリング | — | スムーズな移動 | R08-product-multiview → capsule_cinema |
## ショット別詳細
### #1 00:00.000–00:07.250 · 3D レンダリング + コード/編集オーバーレイ(テキスト注記)

- 確率:3D レンダリング 47%、コード/テンプレートレンダリング 24%、AI 生成動画 17%(fused)
- 素材の出どころ:制作側レンダリング
- 想定ツール:Midjourney + Kling/Hailuo
- テクスチャはレンダリングの特徴:平坦な色ブロック 66%、95% のピクセルが 5 色のみ、水平/垂直の直線エッジ 19%
- フレームごとの鮮明度が周期的に変動(周期 2 フレーム、相関 0.07):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(22%、周期 1):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 清朝の官吏の長ひげの老人がモダンなヘッドホンを着けるという典型的な AI クリエイティブコンセプト
- [VLM] 動きはきわめてわずかで、頭をわずかに傾け唇をかすかに開くだけ、画像から動画生成の特徴に合致
- [VLM] サイド逆光の下での肌とひげ・髪の高コントラストでミニマルな光と影、背景は全黒で実在の物理環境がない
- 画面:黒背景の下、清朝の官服を着て長い白ひげを蓄え、モダンな大きいヘッドホンを着けた老人の横顔が、サイド逆光の下でゆっくりとわずかに動き口を開いて話す。カメラはなめらかに前へ押し込み顔のクローズアップへ。
- 撮り方/ライティング:クローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 1.4:1(0.5 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/middle):大清有说唱
- テキストトラック(テキスト/middle):和血吞
- テキストトラック(テキスト/middle):作词Claude作曲Suno演唱曾国fan
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
- 先頭フレーム画像プロンプト:清朝の老官吏の横顔クローズアップ、長い白ひげ、黒いモダンなヘッドホンを装着、純黒の背景、非常に強い片側のリムライト、映画級の質感、8k の高精細フォトリアル
- 動画プロンプト:黒背景のサイド光の下、モダンなヘッドホンを着けた清代の長ひげの老人の顔がわずかに動き、唇をかすかに開閉してつぶやく。カメラはきわめてゆっくりと前方へ平行に押し込み顔のクローズアップへ、高コントラストのシルエット的な光と影は変えない
### #2 00:07.250–00:15.750 · デジタルヒューマン + コード/編集オーバーレイ(字幕)

- 確率:デジタルヒューマン 98%、AI 生成動画 1%、3D レンダリング 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + LivePortrait/Hedra
- ショット内のモーションビート:8.21s、9.96s、10.50s、14.71s
- 顔が画面の 9%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.14、使用色 29 種、平坦ブロック 36%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- サンプルフレームの 100% に正面の顔がありカメラ固定、音声トラックに声あり
- [VLM] 人物の体、衣服、ヘッドホン、マイクが区間全体で完全に静止し変形なし
- [VLM] 口の開閉と頭のわずかな揺れだけがあり、単一画像の音声駆動の特徴に合致
- [VLM] 00:04-00:08 の口の動きの際、あごの長いひげに不自然なねじれと引っ張られる感じがある
- 画面:鶴の刺繍のある中国式の長衣を着て長い白ひげを蓄えた老人が、モダンなヘッドホンを着けてマイクの前で話す。無地のグレー背景、半身のミディアムクローズ、固定ショット、スタジオの柔らかい光。
- 撮り方/ライティング:クローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 2.1:1(1.0 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(字幕/bottom):官至极品,一无所成。 / 这话,我自己写的。
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:縦画面、半身のミディアムクローズ、中国古代の老人、長い白ひげを蓄え、黒い中国式の長衣を着て、胸元に精巧な鶴の刺繍、頭にモダンな黒いヘッドホンを着け、目の前にマイクがある。無地のグレー背景、スタジオの柔らかい光、左からキーライト、右からリムライト、映画級の質感、超高精細、フォトリアル。
- 動画プロンプト:画面は静止したまま、人物の口は音声に同期して話し、頭に軽く自然な揺れがあり、ひげがそれに合わせてわずかに揺れる。
### #3 00:15.750–00:18.083 · 静止画 + ズーム・パン効果(実写の写真) + コード/編集オーバーレイ(字幕、テキスト注記);実素材を導入(実写の写真)

- 確率:静止画 + ズーム・パン効果 98%、実写 1%、ストップモーション 0%(fused)
- 静止フレームの出どころ:photo
- 素材の出どころ:ユーザーの実素材:実写の写真
- 想定ツール:CapCut(剪映)
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 99%、残差 0.07px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +10.9%/s、パン 55px/s
- テクスチャは写真/動画の特徴:ノイズ σ=0.57、使用色 25 種、平坦ブロック 1%
- [VLM] 画面内部に独立した物体の動きや透視の変化が一切ない
- [VLM] 画面は平面的な線形のゆっくりした押し込みのみ(Ken Burns のズーム効果)
- [VLM] 紙の繊維の縁と毛筆書道の墨跡が鮮明で自然、実物の静物写真
- 画面:クローズアップ、手作りの耳付き宣紙が濃いグレーの机の上に広げられ、毛筆で「官至极品 一无所成」(官位は極まれど何も成せず)と書かれている。カメラはなめらかに前へ押し込み拡大する。
- テキストトラック(字幕/bottom):这话,我自己写的 / 这话,我自己写的。
- テキストトラック(テキスト/middle):官至极品
- テキストトラック(テキスト/middle):一无所成
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現;ユーザーが用意する実素材が必要:実写の写真(画面全体)、実写の写真(画面の一部)
### #4 00:18.083–00:19.458 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 84%、デジタルヒューマン 8%、3D レンダリング 2%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + Kling / Hailuo
- 低照度画面:39% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 1% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.45、使用色 42 種、平坦ブロック 19%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(4%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 顔のディテールはきわめて豊富でリアルだが、動きがきわめて遅く、ひげと下あごがわずかに動く際に AI 動画によくある微細な変形と軽い癒着感がある
- [VLM] 呼吸と頭の微動に本物の筋肉の弾力と生理的な微細な震えがなく、画像から動画生成の典型的な「ゆっくり顔を上げてカメラを見る」パターン
- 画面:ヘッドホンを着け長い白ひげを蓄えた年配のアジア系男性がわずかに目を伏せ、その後ゆっくりと顔を上げてカメラを直視する。表情は深く厳粛、背景は暗い無地のスタジオ。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.6:1(0.7 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):上Beat。
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:高齢のアジア系男性のクローズアップ肖像、風雪を経た顔立ち、深い皺と老人性のしみ、濃い八の字ひげと灰白色の長いあごひげ、黒いモニターヘッドホンを装着、黒く深い背景、ドラマチックな映画的サイド光、超精細な肌の質感、縦構図。
- 動画プロンプト:高齢のアジア系の長ひげの老人がうつむいて静止し、黒いヘッドホンを着けている。その後ゆっくりとまぶたを上げて正面のカメラを凝視する。眼差しは深く冷たく、表情は厳粛なまま、ごくわずかな呼吸と頭の微動、固定ショット。
### #5 00:19.458–00:20.125 · デジタルヒューマン + コード/編集オーバーレイ(字幕、グラフィック貼り付け)

- 確率:デジタルヒューマン 64%、AI 生成動画 35%、3D レンダリング 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + HeyGen/SadTalker/CapCut(剪映)デジタルヒューマン
- 顔が画面の 30%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.19、使用色 35 種、平坦ブロック 37%
- [VLM] 人物の肌の質感と光と影が完璧すぎ、典型的な Midjourney 生成の質感を持つ
- [VLM] 複数フレームの比較で、人物の体と背景は完全に静止し、頭と口だけが動いており、音声駆動のデジタルヒューマン(Avatar)の特徴に合致
- 画面:クローズアップ、白ひげの老人がヘッドホンを着けて話す。無地の背景、固定カメラ、サイド逆光。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 2.0:1(1.0 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(字幕/bottom):上Beat. / LBeat.
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:クローズアップ、白ひげのアジア系の老人、黒いヘッドホンを装着、黒い中国式の服装。ダークグレーの背景。映画的な光と影、左からキーライト、右から寒色のリムライト、極度にフォトリアル。
- 動画プロンプト:老人がカメラに向かって話す。口の形は自然、頭が微動、体は静止。
### #6 00:20.125–00:20.833 · 静止画 + ズーム・パン効果(AI 生成画像)

- 確率:静止画 + ズーム・パン効果 86%、3D レンダリング 6%、AI 生成動画 6%(fused)
- 静止フレームの出どころ:ai_image
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + CapCut(剪映)
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.03px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +2.3%/s、パン 11px/s
- テクスチャはレンダリングの特徴:平坦な色ブロック 27%、95% のピクセルが 27 色のみ、水平/垂直の直線エッジ 26%
- [VLM] 画面は 1 枚の静止画像のゆっくりしたズームインとわずかなパン(Ken Burns 効果)
- [VLM] 画面内部の木の質感と影は完全に静止し、内部の物理的な動きはない
- [VLM] 超現実的な孤立した木の扉が虚無の暗黒空間に置かれており、強い AI コンセプトアートの特徴
- 画面:暗い虚無の空間に半開きの粗い古い木の扉が立ち、左上から束状の冷たい光が降り注ぐ。カメラはゆっくりゆっくりと前へ押し込み押し込む。
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #7 00:20.833–00:21.500 · AI 生成動画

- 確率:AI 生成動画 45%、3D レンダリング 32%、実写 8%(fused)
- 素材の出どころ:AI 生成;再現参考:人物/シーン参考画像
- 想定ツール:CapCut(剪映)/PR のキーフレームパンアニメーション
- [VLM] 木板の木目、節、麻縄の繊維、錆びた鉄釘のディテールが高度にリアル
- [VLM] 木札と壁の影の間に独立した三次元の透視変化がなく、カメラの動きは純粋な 2D のパンと押し込み
- 画面:グレーの壁に麻縄と鉄釘で吊るされたレトロな空白の長方形の木札、カメラはわずかに斜め上向きにゆっくりと押し込む。
- 撮り方/ライティング:ミディアムクローズ;ややあおり;移動カメラ(ジンバル/手持ちパン);斜め前からのキーライト + フィル(標準的なライティング);キーライトは画面左側やや前方;ライティング比約 1.7:1(0.8 段差);柔らかい光(明暗の遷移が広い)
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します;生成時の参考:人物/シーン参考画像
- 先頭フレーム画像プロンプト:ミニマルな静物写真、グレーのマイクロセメント壁、古びた鉄釘 1 本に太い麻縄で吊るされたエイジング加工の風化した木の長い看板、空白で文字なし、柔らかい斜め上からの拡散光、繊細な木目の質感、縦構図。
- 動画プロンプト:カメラはグレーの壁に吊るされたレトロな空白の木札を捉え、視点はわずかにあおり、画面は安定したままきわめてゆっくりと木札へ押し込む。
### #8 00:21.500–00:22.167 · AI 生成動画

- 確率:AI 生成動画 97%、静止画 + ズーム・パン効果 1%、3D レンダリング 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney (ベース画像) + Kling / Runway Gen-2
- [VLM] 画面は高度に様式化された静物写真の質感を示し、光と影は完璧だが実際の物理的なディテール(紙の縁の厚みなど)を欠く
- [VLM] カメラワークはなめらかな右移動で、透視にわずかな変化があり、AI の画像から動画生成の 3D カメラワークの特徴に合致
- 画面:クローズアップ、濃いグレーの机に墨跡のあるしわの寄った紙が広げられ、脇に硯と筆。背景に窓枠の影。カメラはゆっくりと右へ移動。
- 撮り方/ライティング:クローズアップ;やや俯瞰;移動カメラ(ジンバル/手持ちパン);正面からの柔らかい光(フラットライト);キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.0:1(0.1 段差);柔らかい光(明暗の境界がほとんどない)
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、濃いグレーの机の上に黒い墨のにじみ跡のあるしわの寄った宣紙が広げられ、右側に黒い硯と筆が 1 本置かれている。ダークトーン、ミニマリズム、東洋の美学。右上に窓枠のくっきりした影、映画的な光と影、高コントラスト、8k 解像度、フォトリアルな質感。
- 動画プロンプト:カメラはゆっくりと右へパンし、机の上の水墨画の紙、硯、筆を見せる。光と影は安定したまま、画面は静謐。
### #9 00:22.167–00:22.875 · AI 生成動画 + コード/編集オーバーレイ(グラフィック貼り付け)

- 確率:AI 生成動画 64%、3D レンダリング 34%、2D アニメーション 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Kling/Runway/Hailuo
- [VLM] 水波の動きがやや粘性があり変形しており、本物の流体力学の複雑な高周波ディテールを欠く
- [VLM] 空の雲は完全に静止し、水面の一部だけが動いており、AI 動画によくある特徴に合致
- 画面:モノクロの水面のクローズアップ、波紋が揺れ、弧を描く地平線、陰鬱な空、カメラ固定。
- 撮り方/ライティング:クローズアップ;目線;三脚/スタンド固定;屋外の曇天/日陰の柔らかい光;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.3 段差);柔らかい光(明暗の境界がほとんどない)
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:モノクロ写真、水面の波紋のクローズアップ、わずかに弧を描く地平線、陰鬱な空、ミニマル、高コントラスト。
- 動画プロンプト:モノクロ画面、水面に波紋が広がり、波はゆっくりと手前へ進む、空は静止、カメラ固定。
### #10 00:22.875–00:23.542 · 静止画 + ズーム・パン効果(cg_3d) + コード/編集オーバーレイ(グラフィック貼り付け)

- 確率:静止画 + ズーム・パン効果 88%、3D レンダリング 10%、実写 1%(fused)
- 静止フレームの出どころ:cg_3d
- 素材の出どころ:制作側レンダリング
- 想定ツール:CapCut(剪映)
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.10px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +5.7%/s、パン 28px/s
- テクスチャはレンダリングの特徴:平坦な色ブロック 25%、95% のピクセルが 29 色のみ、水平/垂直の直線エッジ 9%
- [VLM] 画面内部の水面、ロープ、木の船に動的な物理的変位が一切ない
- [VLM] 全体を通してゆっくり等速のパンとわずかなズームのカメラワークのみ(Ken Burns 効果)
- 画面:ミニマルなダークトーンのシーン、黒い古い木の小舟を俯瞰し、船内に 2 本の櫂と麻縄が置かれ、左側に弱い光の筋が落ちる。カメラはゆっくりとズーム・パン移動。
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #11 00:23.542–00:24.208 · 静止画 + ズーム・パン効果(AI 生成画像)

- 確率:静止画 + ズーム・パン効果 93%、AI 生成動画 6%、画面録画/スクリーンショット 0%(fused)
- 静止フレームの出どころ:ai_image
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + CapCut(剪映)
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.03px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +1.4%/s、パン 7px/s
- テクスチャは写真/動画の特徴:ノイズ σ=0.46、使用色 30 種、平坦ブロック 5%
- [VLM] 煙の形状は全体を通して静止して流れず、局所的な動きの割合は 0
- [VLM] 画面には純粋な 2D のゆっくりしたズーム・パン(Ken Burns の動き)しか存在しない
- [VLM] 炭のかけらと木目の質感は典型的な AI 画像レンダリングの特徴を持つ
- 画面:黒く炭化した木板の破片のクローズアップ、表面に残る白い煙は静止して凝固し、グレーのミニマルな台の上に置かれ、カメラはわずかにゆっくりと押し込む。
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #12 00:24.208–00:24.917 · 静止画 + ズーム・パン効果(実写の写真);実素材を導入(実写の写真、商品の実写画像)

- 確率:静止画 + ズーム・パン効果 99%、静止フレームのホールド 0%、AI 生成動画 0%(fused)
- 静止フレームの出どころ:photo
- 素材の出どころ:ユーザーの実素材:実写の写真、商品の実写画像
- 想定ツール:CapCut(剪映)/PR
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.12px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +13.9%/s、パン 59px/s
- [VLM] 画面内部に独立した動きは一切なく、珠、房、光と影は絶対的に静止
- [VLM] 珠の素材の反射がリアルで、スタジオの商品撮影の特徴に合致
- [VLM] 参考信号は高い kenburns_score を示しており、きわめてゆっくりしたズーム・パンがある可能性があるが、被写体に変化はない
- 画面:黒い数珠ブレスレットが濃いグレーの背景に静かに置かれ、白い親珠と黒い房があり、画面はきわめてゆっくりしたズーム・パンまたは完全な静止で、製品の質感を際立たせる。
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現;ユーザーが用意する実素材が必要:実写の写真(画面全体)、商品の実写画像(画面の一部)
### #13 00:24.917–00:25.583 · 3D レンダリング

- 確率:3D レンダリング 66%、AI 生成動画 18%、実写 14%(fused)
- 素材の出どころ:制作側レンダリング
- 想定ツール:Blender
- [VLM] ミニマルな三次元のダークグレー空間、継ぎ目のない無地のグラデーションの地面と霧の環境
- [VLM] きわめて小さな這う人型が、整然とした真っ直ぐな硬いエッジの長い影を落とす
- [VLM] 画面に動的なノイズや変形がなく、3D レンダラー(Blender/C4D など)のボリュームフォグとスポットライト効果に合致
- 画面:極端なロングショットでがらんとした薄暗い空間を俯瞰し、地面の中央に人影がかすかにうつ伏せで這い、スポットライトが細長い影を打ち出す。孤独で冷え冷えとした雰囲気。
- 撮り方/ライティング:ロング;やや俯瞰;三脚/スタンド固定;正面からの柔らかい光(フラットライト);キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.1:1(0.2 段差);柔らかい光(明暗の境界がほとんどない)
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
- 先頭フレーム画像プロンプト:極端なロングショット、がらんとした冷たいグレースケールの霧の空間、1 人が地面にうつ伏せで這い、片側の低い角度からの強いスポットライトが細長い硬い影を落とす、ミニマルなダークコンセプトアート、縦画面
- 動画プロンプト:固定のロングショット、がらんとした薄暗い冷たいグレーの霧のスタジオで、小さな人影が地面に貼りつくようにきわめてゆっくりと這って進む、単一光源が非常に長い影を引き、画面は静止して凝固したような感覚
### #14 00:25.583–00:26.250 · 3D レンダリング + コード/編集オーバーレイ(グラフィック貼り付け)

- 確率:3D レンダリング 69%、AI 生成動画 20%、実写 10%(fused)
- 素材の出どころ:制作側レンダリング
- 想定ツール:Blender/C4D
- [VLM] 水面の波紋が高度に規則的で、ディスプレイスメントマップによる変位アニメーションの特徴に合致
- [VLM] 上部の弧形のエッジの形状がきわめて整然となめらかで、実写のノイズやレンズの歪みがない
- [VLM] モノクロの色調と金属的な水体の反射、典型的な 3D レンダラーのマテリアルプリセット
- 画面:モノクロのミニマルスタイルの黒い液体の水面、細かい波紋が揺れ続け、上方になめらかな弧形のエッジと曇り空の背景、カメラは固定であおる。
- 撮り方/ライティング:クローズアップ;目線;三脚/スタンド固定;斜め前からのキーライト + フィル(標準的なライティング);キーライトは画面左側やや前方;ライティング比約 1.5:1(0.6 段差);中程度の柔らかさ
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
- 先頭フレーム画像プロンプト:モノクロのクローズアップ、暗黒色の流体の水面、さざ波が揺れ、銀灰色の金属的なハイライトを帯びる、背景上方になめらかな弧形の境界と薄暗い空、ミニマリズム、3D レンダリングの質感
- 動画プロンプト:固定のクローズアップ、黒い粘性のある液体の水面が波打ち続けて起伏し、銀灰色の微光を反射する、上部の弧線は安定したまま、人物なし、神秘的で静かな雰囲気
### #15 00:26.250–00:26.917 · 静止画 + ズーム・パン効果(AI 生成画像)

- 確率:静止画 + ズーム・パン効果 99%、AI 生成動画 0%、画面録画/スクリーンショット 0%(fused)
- 静止フレームの出どころ:ai_image
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney (画像) + CapCut(剪映)/PR (ズームアニメーション)
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.03px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +1.8%/s、パン 9px/s
- テクスチャは写真/動画の特徴:ノイズ σ=0.50、使用色 30 種、平坦ブロック 2%
- [VLM] 画面内の煙は完全に静止し、漂ったり消えたりする兆候が一切ない
- [VLM] 画面全体に均一な拡大(押し込み)効果しかなく、内部要素の相対的な動きは一切ない
- 画面:焼け焦げた木が数本グレーの背景の前に置かれ、木から静止した青い煙が立ちのぼり、画面はゆっくりと前へ押し込む。
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #16 00:26.917–00:27.625 · 静止画 + ズーム・パン効果(AI 生成画像)

- 確率:静止画 + ズーム・パン効果 91%、AI 生成動画 8%、画面録画/スクリーンショット 0%(fused)
- 静止フレームの出どころ:ai_image
- 素材の出どころ:AI 生成
- 想定ツール:CapCut(剪映)
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 98%、残差 0.18px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +7.9%/s、パン 45px/s
- テクスチャはレンダリングの特徴:平坦な色ブロック 28%、95% のピクセルが 29 色のみ、水平/垂直の直線エッジ 6%
- [VLM] 画面内部の水面、船体、木の櫂は完全に静止し独立した物理的な動きがない
- [VLM] カメラはわずかな全体の二次元ズーム・パン変位のみ(Ken Burns 効果)
- [VLM] 木の櫂と船室の縁の質感は AI 絵画に典型的な超精細なエイジング質感
- 画面:クローズアップ視点での古い木の船の一角、船室に摩耗した 2 本の古い木の櫂が斜めに立てかけられ、背景はぼんやりと暗い霧の水面、カメラはゆっくりわずかに押し込む。
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #17 00:27.625–00:27.958 · 静止画 + ズーム・パン効果(AI 生成画像)

- 確率:静止画 + ズーム・パン効果 99%、AI 生成動画 0%、画面録画/スクリーンショット 0%(fused)
- 静止フレームの出どころ:ai_image
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + CapCut(剪映)エフェクト
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.10px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +0.4%/s、パン 10px/s
- [VLM] 画面に内部の動きが完全にない
- [VLM] 連続フレームは純粋な 2D パンを示す
- [VLM] 墨跡の縁に AI 生成の特徴がある
- 画面:宣紙の墨跡と硯のクローズアップ。
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #18 00:27.958–00:28.292 · 静止画 + ズーム・パン効果(AI 生成画像)

- 確率:静止画 + ズーム・パン効果 85%、AI 生成動画 9%、画面録画/スクリーンショット 2%(fused)
- 静止フレームの出どころ:ai_image
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney / Stable Diffusion
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.05px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +3.3%/s、パン 17px/s
- [VLM] 画面は提供された時間範囲内で完全に静止し、わずかな動きや変化もない
- [VLM] 決定論的分析では temporal_noise がやや高いが、動画エンコードによるノイズの可能性があり、実際の動きはない
- [VLM] 木札の質感と光と影は AI 生成のフォトリアル画像のように見える
- 画面:グレーの壁に空白のエイジング加工の木札が掛かり、左上に斜め下向きの光と影がある
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #19 00:28.292–00:28.625 · 3D レンダリング

- 確率:3D レンダリング 35%、AI 生成動画 31%、実写 18%(fused)
- 素材の出どころ:制作側レンダリング;再現参考:商品参考画像
- [VLM] 画面の内容は静止画像で、内部の動き(珠の転がり、光と影の変化など)が一切なく、これは still_motion の典型的な特徴
- [VLM] 提供されたタイムラインのスライス画像(file_2.jpg)は、異なる時点で画面の内容が完全に一致し、ズーム・パンによってのみ動きの感覚を出していることを示す
- [VLM] 決定論的な初期判定の dup_ratio=0 と kenburns_score=0.235 は、これが 1 枚の静止画像によるズーム・パン(Ken Burns)であるという判断を支持する
- 画面:カメラは平らなグレーの背景に置かれた濃い色の木製数珠を見せる。珠の列は S 字に蛇行し、手前に金色のひび割れのある珠 1 つと薄い青緑の珠 1 つがアクセントになっている。画面全体は静かで禅的な雰囲気。
- 撮り方/ライティング:クローズアップ;やや俯瞰;三脚/スタンド固定;正面からの柔らかい光(フラットライト);キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.3:1(0.4 段差);柔らかい光(明暗の境界がほとんどない)
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング;生成時の参考:商品参考画像
- 先頭フレーム画像プロンプト:ミニマルな製品写真、クローズアップ。深い茶色で丸みのある木製の数珠が、滑らかなライトグレーの背景の上に S 字形に置かれている。前景のピント位置に金色に輝くひび割れのある珠 1 つと薄い青緑の玉の珠 1 つ。浅い被写界深度、背景はボケ。柔らかい左上からの光が、禅的で静かな雰囲気を作る、高品質、フォトリアル。
- 動画プロンプト:カメラはゆっくりと前へ押し込み、滑らかなグレーの背景の上の濃い色の木製数珠をクローズアップで見せる。前景に金色のひび割れのある珠 1 つと薄い青緑の珠 1 つ。画面は静止したまま、滑らかなカメラの押し込みだけがある。
### #20 00:28.625–00:29.000 · 静止画 + ズーム・パン効果(AI 生成画像)

- 確率:静止画 + ズーム・パン効果 99%、AI 生成動画 0%、画面録画/スクリーンショット 0%(fused)
- 静止フレームの出どころ:ai_image
- 素材の出どころ:AI 生成
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.05px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +1.6%/s、パン 8px/s
- [VLM] 画面内部の煙と粒子に動的な変化が一切なく、複数フレームの比較で完全に一致。
- [VLM] 炭の質感、煙の形状は AI 生成画像の典型的な特徴(ディテールの不合理さ、縁のぼやけなど)を持つ。
- 画面:暗い背景の下、燃えた後の木炭が数個あり、上方に数筋の白い煙。画面全体はダークトーンで、静止して動かない。
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #21 00:29.000–00:31.625 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 85%、3D レンダリング 10%、実写 3%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + Kling/Runway
- フレームごとの鮮明度が周期的に変動(周期 2 フレーム、相関 0.36):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 人物の歩行の足取りがわずかに滑っており、地面との接触に本物の重力と摩擦がない
- [VLM] 両側の木の扉と背景の瓦、提灯の幾何学的なエッジに軽い AI の動的な流動と明滅がある
- [VLM] 水面の反射と雨夜の光と影は典型的な Midjourney/Runway 風のダークトーンのフォトリアルな質感を持つ
- 画面:古代の書生の後ろ姿がゆっくりと木の扉をくぐり、灯火が点在する細長い雨夜の古い通りへ歩いていく。ミディアムロング、ゆっくりと前へ押し込むカメラワーク、青灰色の寒色と提灯の暖かい黄色の光の対比。
- 撮り方/ライティング:フル;目線;ジンバル;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.2 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(字幕/bottom):十四岁进考棚 / 考了七回才中个秀才
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:映画的な質感、古代中国の青い長衫の書生の後ろ姿、開いた木の大門の前に立ち、目の前には狭く伸びる濡れた石畳の古い通り、通りの両側に弱い暖かい黄色の提灯が並び、深い青の寒色の雨夜、繊細でフォトリアル、奥行き感、縦構図
- 動画プロンプト:固定またはゆっくり前へ押し込むカメラ、古代の書生がカメラに背を向けてゆっくりと大門をくぐって前へ歩く。両側の木の扉は固定、遠くの通りの提灯の光がかすかに揺らぎ、水面に反射が映る。全体の動きは落ち着いてゆっくり
### #22 00:31.625–00:32.167 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 67%、デジタルヒューマン 15%、3D レンダリング 10%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + Kling
- 顔が画面の 34%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.27、使用色 36 種、平坦ブロック 29%
- [VLM] 人物の顔の肌と毛髪の質感は典型的な超リアル AI 生成の質感を持つ
- [VLM] カメラが押し込む際にひげと唇周りの動きがやや粘着的で浮遊しており、AI 動画/デジタル駆動の特徴に合致
- [VLM] 清代の官服にモダンなレコーディングスタジオの大きなヘッドホンとマイクを合わせた、コンセプト合成シーン
- 画面:清朝一品の鶴の補服を着てモダンなヘッドホンを着けた老人がレコーディングマイクに向かってラップし、カメラはなめらかに素早く顔のクローズアップへ押し込む。光は冷たく暗く厳粛。
- 撮り方/ライティング:極端なクローズアップ;目線;ジンバル;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.8:1(0.9 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):考了七回才中个秀才
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:実写写真の質感、清朝の年老いた官吏、鶴の刺繍のある黒い補服と朝珠を身に着け、長い白いあごひげを蓄え、プロ用の黒いモニターヘッドホンを装着、目の前にポップガード付きマイク、ダークグレーのミニマルなスタジオ背景、映画級の寒色系サイド光、高コントラストでドラマチックな光と影、縦構図。
- 動画プロンプト:カメラはミディアムクローズから安定して素早く老人の顔のクローズアップへ押し込む。老人は大きなヘッドホンを着け、眼差しは毅然として厳粛、マイクに向かって口を開き力強くラップする。ひげが自然にわずかに動き、表情は冷徹。
### #23 00:32.167–00:34.625 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 80%、デジタルヒューマン 8%、実写 5%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Kling / Runway / Luma
- 低照度画面:43% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 0% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.56、使用色 32 種、平坦ブロック 6%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 紙の上の文字は判読できない漢字風の文字化け
- [VLM] 人物の筆を握る手の姿勢がやや硬く、運筆の動作と紙面に実際の相互作用がない
- [VLM] 画面全体に AI 生成のなめらかな質感とかすかな動的な浮遊感がある
- 画面:清朝の装いの若い書生が薄暗い環境で机に向かって字を書き、カメラはゆっくりと押し込み、苦学の場面を見せる。
- 撮り方/ライティング:ミディアムクローズ;やや俯瞰;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.3:1(0.4 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/bottom):考了七回才中个秀才
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:清朝の若い書生、剃髪して弁髪、グレーの木綿の長衣を着て、薄暗い書斎で机に向かい毛筆で字を書く。机の上に巻物、背景にぼやけた提灯。左からの柔らかいキーライト、映画級の質感、ダークトーン、縦画面。
- 動画プロンプト:カメラはゆっくりと前へ押し込み、書生がうつむいて集中して字を書く。手にはわずかな運筆の動き、頭が微動。
### #24 00:34.625–00:36.667 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 49%、実写 34%、デジタルヒューマン 7%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:LivePortrait / SadTalker / HeyGen
- 低照度画面:28% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 2% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.47、使用色 41 種、平坦ブロック 10%
- [VLM] 顔は唇と下あごだけが音声に合わせて動き、目や額の皺にはほとんど自然に連動する微表情がない
- [VLM] 歯と口腔内壁のディテールがなめらかで軽い変形があり、AI 音声駆動のリップシンク(Avatar)の特徴に合致
- [VLM] 髪の毛とひげの縁がわずかに動く際に局所的に軽い塗りつぶし感がある
- 画面:古代の老人の顔の極端なクローズアップ、モダンなヘッドホンを着け、顔は風雪を経た皺と老人性のしみに満ち、セリフに合わせてリップシンクで話す。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.6:1(0.7 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):同一场我爹上了榜
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:中国古代の老人の顔のクローズアップ、白髪まじりのひげ、顔中に深い皺と老人性のしみ、黒いモダンなヘッドホンを装着、ローキーの硬い光、映画的な質感、超リアルなディテール、8k 解像度
- 動画プロンプト:老人の顔の固定クローズアップ、厳粛で冷徹にカメラに向かって話す。唇が音声に同期して開閉し、顔がわずかに動き、眼差しは毅然、カメラは静止したまま
### #25 00:36.667–00:39.542 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 80%、3D レンダリング 9%、実写 9%(fused)
- 画面内の物体に書かれた文字(後付けの字幕ではない):光港流、光港海、光张、乖来染流库烧林子安、聚流摩烧林子安、项洗
- 素材の出どころ:AI 生成
- 想定ツール:Kling
- テクスチャは写真/動画の特徴:ノイズ σ=0.48、使用色 70 種、平坦ブロック 9%
- [VLM] 榜(合格発表の紙)の毛筆の文字の大部分は無意味な偽字/擬似漢字の変形で、赤丸の中の「林子安」だけが鮮明
- [VLM] 灯を提げる手と榜を指す手のディテールは静止してわずかに動き、手の血管と肌に AI の質感があり、本物の微細な動きと筋肉の変形を欠く
- [VLM] 油灯の炎の動きはきわめてわずかで、背景と榜の紙の質感に典型的な AI 動画の時系列的な流動と微細な変形が現れる
- 画面:薄暗い夜の闇の中、片手が灯油ランプを提げ、もう一方の手の指が木の壁に貼られた黄色い榜を指す。赤丸で「林子安」の名前が囲まれ、カメラは安定したミディアムクローズのクローズアップ、弱い暖かい黄色の明かりが一部を照らす。
- 撮り方/ライティング:クローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.3 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(テキスト/bottom):我名字被学台挂出来
- テキストトラック(字幕/middle):光港流 / 光港海 / 光张 / 紫汽林子安
- テキストトラック(字幕/middle):乖来染流库烧林子安 / 聚流摩烧林子安 / 项洗 / X
- テキストトラック(テキスト/middle):茂
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、夜、古風なサスペンスの雰囲気。左手に火のついたレトロなカンテラを提げ、暖かい黄色の炎がガラスの覆いを通して光る。右側の木の壁に黄ばんだ毛筆の名簿が貼られ、血管の浮き出た右手の指が榜の上で赤丸で囲まれた漢字「林子安」を指している。映画級の質感、弱い暗黒の環境と局所的な暖かい光の対比、ディテールがリアル。
- 動画プロンプト:固定のクローズアップ。夜の闇の中で灯油ランプの炎がかすかに揺らぎ、薄黄色の明かりが名簿を照らす。1 本の指が赤い丸の中の「林子安」の 3 文字を安定して指し、名簿の紙がそよ風でごくわずかに震える。全体として暗く重苦しいサスペンスの雰囲気を保つ。
### #26 00:39.542–00:40.250 · AI 生成動画

- 確率:AI 生成動画 36%、実写 29%、デジタルヒューマン 26%(fused)
- 素材の出どころ:AI 生成
- 顔が画面の 25%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.15、使用色 35 種、平坦ブロック 37%
- [VLM] 顔の肌の毛穴、細かな老人性のしみ、ひげの毛がきわめて繊細で自然、明滅や変形なし
- [VLM] ヘッドホンに添えた手の指の関節、骨格の構造、動作の物理が完全にリアル
- [VLM] 話す際の口腔内の歯、舌の動きと筋肉の連動が完全に実際の物理法則に合致
- [claude 画像による再確認] 隣接するリップシンクのショットと同じ AI キャラクター(白ひげの老人、同じヘッドホンと数珠)、同じレコーディングスタジオの背景
- [claude 画像による再確認] 口の形がラップの歌詞に合わせて変化し、全編に実写のシーンは一切ない
- [claude 画像による再確認] MV 全体の人物、衣装が AI ショットとこれらのショットの間で完全に一致
- 画面:クローズアップ、長ひげの年配のアジア系男性がモニターヘッドホンを着け、ヘッドホンに手を添えて感情を込めて歌うか話している。無地のダークグレーのスタジオ背景、ダークトーンのサイド光のポートレートの質感。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.8:1(0.9 段差);硬い光(明暗の境界がはっきり)
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、白髪まじりのあごひげを蓄えたアジア系の老人、黒いモニターヘッドホンを装着、片手をヘッドホンの縁に添え、暗い色の中国式の前合わせの上着、ダークグレーのミニマルな背景、横からの単一光源の硬い光、肌の質感が鮮明、映画フィルムの質感、縦画面
- 動画プロンプト:カメラ固定、黒いヘッドホンを着けた長ひげのアジア系の老人がヘッドホンに手を添え、没入した表情で口を開いて歌い唱える。顔の筋肉とひげが歌に合わせて軽く自然に揺れる、ダークトーンのスタジオのサイド光。
### #27 00:40.250–00:42.875 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 48%、3D レンダリング 24%、実写 21%(fused)
- 画面内の物体に書かれた文字(後付けの字幕ではない):道枝憶花、杨况機光心、植税流横清热境福土文
- 素材の出どころ:AI 生成
- テクスチャはレンダリングの特徴:平坦な色ブロック 34%、95% のピクセルが 25 色のみ、水平/垂直の直線エッジ 12%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 指の肌の質感、爪の隙間、老人性のしみのディテールが極度にリアルで自然、AI の変形なし
- [VLM] 紙の繊維、墨の浸透、折り目の物理的特性が完全に実写に合致
- [VLM] 左上の油灯の弱い火の光が生む自然なダークトーンのサイド逆光が手の影と一致
- [VLM] 巻物の文字の筆画は整然として安定し、AI 生成文字によくある溶けや明滅がない
- [claude 画像による再確認] 上奏文の「文理太浅」の 4 つの大きな文字以外、縦書きの小さな文字は字になっていない擬似漢字(臣謹枝槎、趙洼)で、生成画面の典型的な破綻
- 画面:古風なダークトーンのクローズアップ、痩せこけて干からびた指が「文理太浅」(文章が浅すぎる)と書かれた宣紙の古書を押さえ、カメラはゆっくりとわずかに移動し、油灯のサイド光が一部を照らす。
- 撮り方/ライティング:クローズアップ;俯瞰;ジンバル;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.2 段差);中程度の柔らかさ
- テキストトラック(字幕/bottom):理太浅四个 / 文理太浅四个大字 / 全城都看明白
- テキストトラック(字幕/middle):文理太浅 / 治国之道道楼 / 治国之道道洼 / 治国之道趙挂播
- テキストトラック(字幕/middle):道枝憶花 / 杨况機光心 / 植税流横清热境福土文
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:ダークトーンのクローズアップ、黄ばんだ古い上奏文、墨書きの大きな文字「文理太浅」、年老いて痩せこけた指 1 本が紙を押さえている、映画的な低彩度
- 動画プロンプト:痩せこけた指が上奏文の大きな文字の上をゆっくりとなぞり、もう一方の手が下から画面に入って紙面を押さえる。カメラはゆっくりと押し込む
### #28 00:42.875–00:43.583 · デジタルヒューマン + コード/編集オーバーレイ(テキスト注記)

- 確率:デジタルヒューマン 67%、AI 生成動画 22%、コード/テンプレートレンダリング 8%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:LivePortrait / SadTalker / Midjourney
- 顔が画面の 25%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.22、使用色 31 種、平坦ブロック 30%
- [VLM] 体と背景は完全に静止し、物理的な微細な震えがない
- [VLM] 口だけが音声に合わせて変形してリップシンクし、縁にやや塗りつぶし感がある
- [VLM] 古風な長ひげの長老がモダンなヘッドホンを着ける超現実的な AI 画像の質感
- 画面:クローズアップ、ヘッドホンを着けた白ひげの古風な老人がマイクに向かって話し、唇は音声に合わせてリップシンク、カメラ固定。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.6:1(0.7 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(テキスト/bottom):全城都看明白
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:クローズアップ肖像、風雪を経た中国古代の道士の老人、白く長いひげ、プロ用の黒いモニターヘッドホンを装着、目の前に黒いマイク、ダークグレーの無地背景、映画的なサイド光、超リアルなディテール、低彩度の寒色系。
- 動画プロンプト:静止ショット、老人の口が開閉して話しリップシンクし、眼がわずかに動き、体と頭は安定したまま、表情は厳粛で落ち着いている。
### #29 00:43.583–00:44.792 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 41%、実写 32%、3D レンダリング 21%(fused)
- 画面内の物体に書かれた文字(後付けの字幕ではない):文理太浅、臣遒枝槎协、臣枝槎说、治国之道趙挞挂播、治国之道趙洼、治国之道挞洼
- 素材の出どころ:AI 生成
- [VLM] 指の肌の質感、爪、皺がきわめてリアルで自然
- [VLM] 宣紙の繊維、墨の浸透、紙の凹凸の光と影が物理的にリアル
- [VLM] AI の変形や明滅がなく、映像作品のマクロ実写小道具の特徴に合致
- [claude 画像による再確認] 同じ上奏文で、小さな文字は依然として擬似漢字(挞洼、趙挞)、字形がフレームごとにわずかに変化
- [claude 画像による再確認] 指と紙の質感はフォトリアルで、スタイルは #27 と連続しており、同じ生成に属する
- 画面:クローズアップの映像的ショット、粗く老いた指が墨書きの文書が書かれた宣紙を押さえ、紙には大きな文字「文理太浅」が書かれ、カメラはわずかにゆっくりと押し込む。
- 撮り方/ライティング:クローズアップ;俯瞰;ジンバル;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.2 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):全城都看明白
- テキストトラック(字幕/middle):文理太浅 / 臣遒枝槎协 / 臣枝槎说 / 臣道枝槎倾协
- テキストトラック(字幕/middle):治国之道趙挞挂播 / 治国之道趙洼 / 治国之道挞洼 / 台国之道随姑洼
- テキストトラック(テキスト/middle):号
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:黄ばんだ上奏文のミディアムクローズ、大きな文字「文理太浅」が中央、上に 1 本の指が紙の端を押さえている、ダークトーン
- 動画プロンプト:指が上奏文を押さえ、カメラは大きな文字「文理太浅」へわずかに押し込む
### #30 00:44.792–00:45.417 · AI 生成動画

- 確率:AI 生成動画 86%、デジタルヒューマン 12%、実写 0%(fused)
- 画面内の物体に書かれた文字(後付けの字幕ではない):福
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + Kling/Hailuo/Hedra
- 低照度画面:42% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 6% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.36、使用色 34 種、平坦ブロック 24%
- [VLM] きわめて高精度の肌の質感と毛髪のディテールで、典型的な超リアル AI の質感を帯びる
- [VLM] 古風な老人とモダンなヘッドホン・マイクの組み合わせは、よくある AI クリエイティブのコンセプト
- [VLM] 背景は清潔で、光と影は完璧、高品質な画像から動画生成の特徴に合致
- 画面:クローズアップ、長い白ひげのアジア系の老人がヘッドホンを着けてマイクに向かって話す。無地のグレー背景、光と影は立体的、極度にフォトリアル。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.6:1(0.6 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/middle):福
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、年配のアジア系男性、長い白ひげ、顔中の皺、きめ細かな肌の質感。黒いモダンなヘッドホンを装着、黒い中国式の服装。無地のグレー背景。映画級の光と影、サイドからの柔らかい光、超リアル、ポートレート写真。
- 動画プロンプト:クローズアップ、ヘッドホンを着けた長ひげの老人がマイクに向かって話す。口の動きは自然、頭が軽く揺れる。カメラ固定。
### #31 00:45.417–00:46.958 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 76%、3D レンダリング 14%、実写 8%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + Kling/Runway
- ショット内のモーションビート:46.25s
- [VLM] 清朝の受験生の後ろ姿と榜の群像は、典型的な Midjourney スタイルのフォトリアルだが質感がなめらかで油っぽい特徴を帯びる
- [VLM] 榜の上の漢字の筆画はぼやけて不規則で、AI 生成の文字化けした擬似文字を示す
- [VLM] 画面の動きはきわめてわずかなゆっくりした押し込みと局所的な微動で、本物の物理的な相互作用と群衆の運動量を欠く
- 画面:清代の科挙の合格発表のシーン、瓜皮帽をかぶり長い弁髪を結った清朝の書生がカメラに背を向けて榜を見上げ、周囲は同じく榜を見る人々でひしめき、カメラはゆっくりとわずかに押し込む。
- 撮り方/ライティング:ミディアム(背中側の半身から腰まで);ややあおり;ジンバル;夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 2.0:1(1.0 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):进士又考三回
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:清代の科挙の皇榜発表の現場、後ろ姿のミディアムショット、清朝の長い弁髪を結い瓜皮帽をかぶり暗い色の長衫を着た書生が木の回廊の下の黄色い金榜を見上げ、傍らは榜を見る受験生の後ろ姿で囲まれ、中国式の古建築の長い回廊、曇天の寒色、映画的な光と影の質感、超リアルなディテール。
- 動画プロンプト:カメラはきわめてゆっくりと前へ押し込み、主人公は背を向けて静かに立ち合格発表の壁を見上げる。周囲の受験生の後ろ姿にはかすかな呼吸のような揺れがあり、冷徹で厳粛な雰囲気がショット終了まで続く。
### #32 00:46.958–00:47.583 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 49%、実写 34%、デジタルヒューマン 7%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:HeyGen / D-ID / SadTalker
- 低照度画面:33% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 3% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.47、使用色 36 種、平坦ブロック 14%
- [VLM] 人物の顔のディテール(皺、毛髪など)は複数フレーム間で絶対的に静止し、口の領域だけに開閉の動作があり、典型的な単一画像の音声駆動デジタルヒューマンの特徴に合致
- 画面:白ひげの老人の顔のクローズアップ、ヘッドホンを着け、カメラを正視して話す、背景は無地のグレー
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.5:1(0.6 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(テキスト/bottom):进士又考三回
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、中国の老人、白く長いひげ、顔中に深い皺、黒いヘッドホンを装着、無地のグレー背景、サイド光の照明、映画級の質感、8k の高精細
- 動画プロンプト:老人がカメラを直視して話し、口の形は自然に開閉し、表情がわずかに動く。頭と体は静止したまま、クローズアップ、固定カメラ
### #33 00:47.583–00:48.208 · 静止画 + ズーム・パン効果(AI 生成画像) + コード/編集オーバーレイ(テキスト注記)

- 確率:静止画 + ズーム・パン効果 99%、AI 生成動画 0%、画面録画/スクリーンショット 0%(fused)
- 静止フレームの出どころ:ai_image
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney (画像生成) + 編集ソフト (押し込み)
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 92%、残差 0.19px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +7.8%/s、パン 23px/s
- [VLM] 画面内部の人物は完全に静止し、微小な動き(呼吸、衣服のなびきなど)が一切ない
- [VLM] 唯一の動きは画面全体のゆっくりした等速の押し込み(ズーム)
- [VLM] 背景の群衆の縁とディテールに典型的な AI 画像の融合の特徴がある
- 画面:清朝の男たちの一団がカメラに背を向けて壁の榜を見上げる、ミディアム、ゆっくりした押し込み、曇天の寒色。
- テキストトラック(テキスト/bottom):三甲垫底那一排
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #34 00:48.208–00:48.792 · デジタルヒューマン + コード/編集オーバーレイ(テキスト注記)

- 確率:デジタルヒューマン 68%、AI 生成動画 22%、実写 8%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:LivePortrait / Hedra / CapCut(剪映)デジタルヒューマン
- 顔が画面の 38%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.29、使用色 35 種、平坦ブロック 25%
- [VLM] ベースは典型的な AI 生成のフォトリアルな中国風の老人がモダンなモニターヘッドホンを着けた肖像
- [VLM] 体とヘッドホンのケーブルは完全に静止し、唇、あご、ひげだけが音声に合わせてわずかに変形して駆動される
- [VLM] 歯と口腔の縁に音声駆動ポートレートによくある局所的な補間のぼけが伴う
- 画面:白ひげの道長/老人が黒いモニターヘッドホンを着け、ダークトーンのスタジオでマイクに向かって話し、唇が同期してわずかに動く。ショットサイズはクローズアップ、カメラ固定。
- 撮り方/ライティング:極端なクローズアップ;目線;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.6:1(0.6 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):三甲垫底那一排
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:クローズアップ、痩せて矍鑠とした中国古代の老人、顔中の皺と白ひげ、プロ用の黒いモニターヘッドホンを装着、身の前にポッドキャスト用マイク、ダークグレーの背景、スタジオのサイド光、フィルムの質感、超リアルなディテール
- 動画プロンプト:老人の頭が微動し、唇が話す音声に合わせて自然に開閉し、あごのひげが軽く揺れ、体とヘッドホンは安定したまま、カメラ固定
### #35 00:48.792–00:50.375 · デジタルヒューマン + コード/編集オーバーレイ(テキスト注記)

- 確率:デジタルヒューマン 80%、AI 生成動画 19%、3D レンダリング 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:HeyGen/D-ID/CapCut(剪映)デジタルヒューマン (ベース画像は Midjourney 由来の可能性)
- 顔が画面の 21%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.12、使用色 30 種、平坦ブロック 39%
- サンプルフレームの 100% に正面の顔がありカメラ固定、音声トラックに声あり
- [VLM] 人物の頭に軽い揺れと話す口の形があるが、体、ヘッドホン、マイク、背景は完全に静止
- [VLM] あごが動く際にひげに軽い画像のねじれと引っ張られる感じがあり、単一画像駆動のデジタルヒューマンの特徴に合致
- [VLM] 人物の顔の質感と光と影が完璧すぎ、典型的な AI 生成画像の特徴を帯びる
- 画面:クローズアップ、ヘッドホンを着け長い白ひげを蓄えた年配男性がマイクに向かって話し、背景は無地の暗色。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.5:1(0.6 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):三甲垫底那一排
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:クローズアップ、中国の年配男性、長い白ひげを蓄え、黒い中国式の立ち襟の服を着て、黒いモニターヘッドホンを装着し、目の前に黒いマイクがある。ダークグレーの背景、左からの柔らかいキーライト、映画感、高精細、フォトリアル、8k 解像度。
- 動画プロンプト:人物の頭が軽く自然に揺れ、口は話す形をし、眼差しにわずかな変化があり、体、ヘッドホン、マイクは絶対的に静止したまま。
### #36 00:50.375–00:53.458 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 44%、実写 35%、3D レンダリング 16%(fused)
- 素材の出どころ:AI 生成
- テクスチャはレンダリングの特徴:平坦な色ブロック 23%、95% のピクセルが 25 色のみ、水平/垂直の直線エッジ 21%
- [VLM] 映像作品の実写撮影の質感で、エキストラと衣装・小道具のディテールがリアルで自然な動きがある
- [VLM] 左側の将軍の顔の微表情と肌の質感が自然で、AI の変形や明滅なし
- [VLM] カメラにゆっくりした移動と環境の土煙の効果があり、物理的な相互作用がリアル
- [claude 画像による再確認] フォトリアルな古代の軍陣だが、群衆と旗のディテールがフレーム間でわずかに漂い、遠くの兵士の形がぼやけて融合している
- [claude 画像による再確認] 全編と同じ冷たいグレーの映画的カラーグレーディングで、実写の現場のノイズや被写界深度の変化がない
- 画面:暗雲が垂れ込める城壁の下、左側の前景にひげを蓄えた中年の将軍が巻物を手に横向きに厳粛に立ち、後景に槍を手にした大勢の清軍の兵士が隊列を組んで行進する。カメラはゆっくりと前へ押し込み、全体に低彩度で重苦しく厳粛な時代劇の戦争叙事詩の雰囲気。
- 撮り方/ライティング:ミディアム(前景人物の半身の横向きシルエット);目線;ジンバル;夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 1.8:1(0.9 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(字幕/bottom):四十出头才学带兵 / 靖港头一仗就败
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:暗雲が垂れ込める古い城壁の下、槍を手に整列した清代の兵士たち、画面左側に前景としてもじゃもじゃのひげの将軍の横顔、冷たいグレーの映画的カラーグレーディング
- 動画プロンプト:兵士の隊列がゆっくりと動き、土煙が舞う。将軍の横顔は静かに立ち、カメラはゆっくりと横移動
### #37 00:53.458–00:54.208 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記、グラフィック貼り付け)

- 確率:AI 生成動画 36%、実写 29%、デジタルヒューマン 26%(fused)
- 素材の出どころ:AI 生成
- 顔が画面の 24%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.16、使用色 37 種、平坦ブロック 36%
- [VLM] リアルな肌の皺、老人性のしみ、毛細血管のディテールが自然
- [VLM] ひげと毛髪の縁が鮮明で安定し、AI の溶けや明滅のアーティファクトなし
- [VLM] 口の筋肉と歯の開閉の動きが生理的にリアル
- [claude 画像による再確認] 隣接するリップシンクのショットと同じ AI キャラクター(白ひげの老人、同じヘッドホンと数珠)、同じレコーディングスタジオの背景
- [claude 画像による再確認] 口の形がラップの歌詞に合わせて変化し、全編に実写のシーンは一切ない
- [claude 画像による再確認] MV 全体の人物、衣装が AI ショットとこれらのショットの間で完全に一致
- 画面:レコーディングスタジオのクローズアップ、長いひげを蓄えた白髪の老人がヘッドホンを着けてマイクの前で沈鬱に歌い出す。固定カメラで目線、ローキーの暗い光と影。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.1:1(0.2 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/bottom):靖港头一仗就败
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、長いグレーのあごひげを蓄えた東アジア系の老人、黒いヘッドホンを着けてレコーディングスタジオのマイクの前にいる、暗い色の中国式の服装、無地のダークグレー背景、プロの映画級ローキーの柔らかいサイド光、きわめて高い顔の皺のディテール、リアルな写真の質感。
- 動画プロンプト:固定のクローズアップ、ヘッドホンを着けた長ひげの中国の老人がマイクに向かって沈痛に歌い出す。口が開閉して歌い、顔の筋肉とひげが自然にかすかに震え、視線はわずかに伏せて重々しい。光と影は安定したまま。
### #38 00:54.208–00:56.208 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 58%、実写 32%、3D レンダリング 6%(fused)
- 素材の出どころ:AI 生成
- 低照度画面:50% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 1% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.58、使用色 41 種、平坦ブロック 2%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] リアルな俳優の肌のディテール、筋肉のライン、濡れた光沢
- [VLM] 水滴がひげやずぶ濡れの長衫から自然に滴る流体物理の表現
- [VLM] 映像作品レベルのプロの夜間シーンのライティングとカラーグレーディング
- [claude 画像による再確認] ずぶ濡れの老人が船べりに伏せ、背景の兵士の腕と船灯の縁がフレーム間で変形
- 画面:夜の川面の木の船の上、全身ずぶ濡れで白ひげを蓄えた清代の老人が部下に冷たい川の水から船板に引き上げられ、両手を地につき、表情は複雑で重々しい。
- 撮り方/ライティング:ミディアムクローズ;やや俯瞰;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.3 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(字幕/bottom):湘江水冷是部下把我捞上来 / 湘江水冷是部下把我捞上菜
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:夜の川面の小舟の上、全身ずぶ濡れの白ひげの清代の老人が両手を船板についている。背後に灯油ランプが掛かり、冷たい青の色調
- 動画プロンプト:老人が息を切らして船板に手をつき顔を上げる。後ろの人物が手を伸ばして引き上げようとし、川の波が逆巻く
### #39 00:56.208–00:56.917 · AI 生成動画

- 確率:AI 生成動画 78%、デジタルヒューマン 21%、実写 0%(fused)
- 画面内の物体に書かれた文字(後付けの字幕ではない):一、一
- 素材の出どころ:AI 生成
- 想定ツール:Kling / Hailuo / Hedra (画像から動画生成または音声駆動)
- 顔が画面の 46%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.28、使用色 43 種、平坦ブロック 20%
- [VLM] 肌の質感と毛髪は典型的な高品質 AI 生成の質感を持つ
- [VLM] 動きは口の開閉と頭のわずかな揺れに高度に集中しており、画像駆動の動画またはデジタルヒューマンの特徴に合致
- [VLM] 無地の背景と極端に浅い被写界深度の標準的な AI ポートレート生成スタイル
- 画面:クローズアップ:白ひげのアジア系の老人がヘッドホンを着け、興奮した表情で話すか歌う、無地のグレー背景。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.3:1(0.4 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/middle):一
- テキストトラック(テキスト/middle):D
- テキストトラック(テキスト/middle):一
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、白ひげのアジア系の老人、黒いヘッドホンを装着、顔中の皺、興奮した表情で口を開けている、無地のグレー背景、左からの柔らかい光、高コントラストのフォトリアルな肖像。
- 動画プロンプト:老人が興奮した表情で話すか歌う。口の形は自然に開閉し、頭が軽く揺れ、光と影は安定したまま。
### #40 00:56.917–00:58.417 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 73%、3D レンダリング 13%、実写 4%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Kling/Runway/Hailuo
- テクスチャは写真/動画の特徴:ノイズ σ=0.46、使用色 80 種、平坦ブロック 6%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 画面内の兵士が振るう武器(槍、刀剣)が動きの過程で不自然に曲がり変形する
- [VLM] 背景の炎と濃い煙の縁に AI 生成によくある「沸騰」と明滅感がある
- [VLM] 人物の動きがやや浮遊しており、本物の物理的な重量感と力のフィードバックを欠く
- 画面:夜の古代の水上戦のシーン、兵士が燃える軍船の木の橋の上で激しく戦い、背景は火の光が天を衝き濃い煙が立ちのぼり、人物はシルエット状態、カメラはゆっくりと押し込む。
- 撮り方/ライティング:フル;あおり;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 1.8:1(0.9 段差);中程度の柔らかさ
- テキストトラック(字幕/bottom):湖口再败座船被截 / 我又被拉回来
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:縦画面、壮大な古代の水上戦のシーン、夜、軍船が燃え、濃い煙が立ちのぼる。画面中央に 2 隻の船をつなぐ木の橋があり、数名の古代の兵士のシルエットが橋の上で槍や刀剣を手に激しく戦っている。背景は天を衝く火の光とはためく軍旗。強烈な逆光、高コントラスト、映画級の質感、ダークスタイル。
- 動画プロンプト:カメラはゆっくりと前へ押し込み、わずかにあおりで撮る。兵士たちが燃える木の橋の上で槍や刀剣を振るって戦い、動きは激しい。背景の炎は激しく燃え、濃い煙が風に流れ、火の粉が飛び散る。全体の雰囲気は緊迫して混沌。
### #41 00:58.417–00:58.917 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 41%、実写 27%、3D レンダリング 16%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:HeyGen/D-ID
- 顔が画面の 45%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.36、使用色 46 種、平坦ブロック 16%
- [VLM] 人物の顔の筋肉の動き(特に口の形と目元)が硬く、本物の人間が話す際の自然な筋肉の連動を欠き、音声駆動のデジタルヒューマン(avatar)の特徴により合致
- [VLM] 人物の肌の質感はリアルだが、話す過程で光と影の自然な変化がほとんどなく、1 枚の静止画像に局所的な顔の歪みを加えたもののよう
- [VLM] 頭の揺れの軌跡が比較的機械的で、本物の発話時のような自然な重心の移動がない
- [VLM] 歯と口腔内部のレンダリングが話す際に不自然で、貼り付けた感じがある
- 画面:顔中に皺があり灰白色のひげを蓄えたアジア系の年配男性が、黒いヘッドホンを着け、マイクに向かって話す
- 撮り方/ライティング:極端なクローズアップ;目線;三脚固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.3 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/bottom):我又被拉回来
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、灰白色のあごひげを蓄えたアジア系の年配男性、風雪を経た皺だらけの顔、厳粛な表情、黒いモニターヘッドホンを装着し、ダークグレーの背景の前でマイクに向かって話す。目線の高さ、片側からの硬い光が顔の質感を際立たせる、寒色系、超高精細のフォトリアル写真、映画級の質感、縦画面。
- 動画プロンプト:該当なし、これは音声駆動のデジタルヒューマン
### #42 00:58.917–00:59.500 · デジタルヒューマン + コード/編集オーバーレイ(テキスト注記、グラフィック貼り付け)

- 確率:デジタルヒューマン 97%、AI 生成動画 1%、3D レンダリング 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Hedra / D-ID
- 顔が画面の 32%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.29、使用色 44 種、平坦ブロック 24%
- [VLM] 体と背景は完全に静止し、頭と口だけに動作がある
- [VLM] ひげはあごと一体となって動き、独立した毛の動きがない
- [VLM] 単一画像の音声駆動デジタルヒューマンの典型的な特徴に合致
- 画面:クローズアップ、ヘッドホンを着けた白ひげの老人が暗い背景の前で情熱的に歌い、表情は誇張気味。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.1:1(0.1 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/bottom):我又被拉回来
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:クローズアップ肖像、アジア系の老人、長い白ひげ、黒いヘッドホンを装着、黒いスタッズ付きの服を着ている。ダークグレーの背景。映画級の光と影、左からキーライト、高コントラスト、顔の質感を際立たせる、超リアル。
- 動画プロンプト:画像をベースに、激昂した音声を入力して人物が大きく口を開けて歌うよう駆動し、頭が軽く揺れる。
### #43 00:59.500–01:02.542 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 84%、デジタルヒューマン 8%、3D レンダリング 2%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Kling / Hailuo
- 低照度画面:45% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 0% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.54、使用色 38 種、平坦ブロック 4%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 筆を握る指がやや硬く、筆先と紙面の接触に本物の物理的なフィードバックがない
- [VLM] ひげの縁に軽い明滅と不自然ななびきがある
- 画面:クローズアップ、白ひげの老人が古装を着て、薄暗い陣営のテントを背景に筆を執って字を書き、カメラはわずかに押し込む。
- 撮り方/ライティング:クローズアップ;目線やや俯瞰;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.7:1(0.8 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(字幕/bottom):我又被拉回来 / 祁门被围遗嘱写好 / 不肯退营等最坏
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、風雪を経た中国古代の老人、長い白ひげ、暗い色の古装。表情は重々しく、うつむいて筆を執り字を書く。背景は薄暗い軍営のテント、かすかな火の光。映画級の光と影、左からの柔らかいキーライト。
- 動画プロンプト:カメラはゆっくりと押し込み、老人は重々しい表情で筆を手にゆっくりと書き、ひげがわずかに揺れ、背景の火の光が揺らぐ。
### #44 01:02.542–01:04.667 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 81%、3D レンダリング 17%、2D アニメーション 1%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Kling/Hailuo/Runway
- テクスチャはレンダリングの特徴:平坦な色ブロック 34%、95% のピクセルが 27 色のみ、水平/垂直の直線エッジ 13%
- [VLM] 人物の掘る動作と槌を振る動作が物理法則に合わず、浮遊感と軽い変形がある
- [VLM] 左側の人物がシャベルを振る際、シャベルの柄と腕の接続部にぼけと構造の不安定さが現れる
- 画面:暗い空の下で塹壕を掘る古代の兵士のシルエット、人物がシャベルと槌を振るい、背景に物見櫓、全体に高コントラストのダークスタイル。
- 撮り方/ライティング:フル;ややあおり;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.2 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(字幕/bottom):结硬寨打呆仗 / 结硬寨打枭仗
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:縦画面、フルショット、ややあおり。古代の戦場の陣地、陰鬱で重苦しい暗雲の空。前景は古代の兵士たちの黒いシルエットで、シャベルで塹壕を掘り、大槌で杭を打っている。背景にかすかに木製の物見櫓が見える。強烈な逆光のシルエット効果、高コントラスト、ダークな叙事詩スタイル。
- 動画プロンプト:カメラ固定。画面内の古代の兵士のシルエットが動き始め、左の兵士はシャベルを振るって土を掘り、右の兵士は大槌を振り上げて木の杭に打ち下ろす。動きは重い。背景の空の暗雲がゆっくりと流れる。強烈な逆光のシルエットとダークで重苦しい雰囲気を保つ。
### #45 01:04.667–01:05.375 · デジタルヒューマン + コード/編集オーバーレイ(グラフィック貼り付け)

- 確率:デジタルヒューマン 97%、AI 生成動画 1%、3D レンダリング 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:HeyGen / D-ID / SadTalker / CapCut(剪映)デジタルヒューマン
- 顔が画面の 12%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.09、使用色 26 種、平坦ブロック 40%
- [VLM] 人物の体、ヘッドホン、マイクは完全に静止し、頭と口だけに軽い駆動の動作がある
- [VLM] ひげと衣服の境界に頭の動きの際、軽い 2D 画像の引っ張りによる変形がある
- [VLM] 典型的な単一画像の音声駆動デジタルヒューマンの特徴
- 画面:ミディアムクローズ、ヘッドホンを着け長い白ひげを蓄えた老人がマイクの前で、頭が微動し、唇がわずかに開く、グレーの背景。
- 撮り方/ライティング:クローズアップ;目線;三脚固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.5:1(0.6 段差);中程度の柔らかさ
- テキストトラック(テキスト/bottom):汉盛
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:超リアルなポートレート写真、アジア系の年配男性、長い白ひげ、顔中の皺、黒いモニターヘッドホンを装着、黒い中国式の服を着て、胸元に鶴の刺繍、目の前に黒いコンデンサーマイク、グレーの無地背景、サイドからの柔らかい光の照明、映画級の質感、8k。
- 動画プロンプト:ベース画像を使い、音声を入力して人物の口を話す形に駆動し、頭が音声に合わせて自然に軽く揺れ、体、ヘッドホン、マイク、背景は静止したまま。
### #46 01:05.375–01:07.167 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 43%、実写 31%、3D レンダリング 18%(fused)
- 素材の出どころ:AI 生成
- テクスチャはレンダリングの特徴:平坦な色ブロック 35%、95% のピクセルが 27 色のみ、水平/垂直の直線エッジ 13%
- [VLM] 泥の飛び散りと槌を振る労働の物理的な動きがきわめてリアルで変形なし
- [VLM] 逆光の人物のシルエットの輪郭と雨天の拡散した自然光の階調がはっきりしている
- [VLM] 典型的な劇場公開の歴史/戦争映画の現場実写の質感
- [claude 画像による再確認] 逆光のシルエットの労働する人々だが、人物の動作が繰り返し、槌と木の杭がフレーム間でわずかに変形
- [claude 画像による再確認] 構図とカラーグレーディングが全編と一致し、同じ一群の AI ショットに属する
- 画面:雨の曇天の古代の泥だらけの作業場で、多数の労働者がシャベルで土を掘り大槌で杭を打つ。背景に木製の物見櫓と遠山、低い位置からのパン。
- 撮り方/ライティング:ミディアム;ややあおり;ジンバル;夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 1.9:1(0.9 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):笨人只会慢慢挨
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:曇天の陣地、逆光のシルエットになった清代の兵卒の一団が槌を振るって木の杭を打つ、遠くに物見櫓と旗
- 動画プロンプト:人々が腰をかがめて槌を振るい繰り返し杭を打ち、泥が飛び散る、カメラ固定
### #47 01:07.167–01:10.542 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 44%、デジタルヒューマン 28%、実写 19%(fused)
- 素材の出どころ:AI 生成
- 顔が画面の 24%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.12、使用色 32 種、平坦ブロック 40%
- フレームごとの鮮明度が周期的に変動(周期 6 フレーム、相関 0.03):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 顔の毛穴、皺、老人性のしみのディテールがきわめて繊細で自然、AI の変形や塗りつぶし感なし
- [VLM] ひげと髪の毛が頭の動きに合わせて本物の物理的な揺れと遮蔽関係を持つ
- [VLM] 発声時の唇の筋肉、歯の透視、舌の動きが自然に協調
- [VLM] ヘッドホンの革と金属の反射が実際の物理光学に合致
- 画面:清代の官吏の装いの白ひげの年配男性がモニターヘッドホンを着け、マイクに向かって感情豊かに語りラップする。グレーの無地背景、固定のクローズアップ。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側(サイド光);ライティング比約 2.5:1(1.3 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(字幕/bottom):笨人只会慢慢挨 / 打脱牙和血吞 / 京城骂完长沙骂
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ肖像、縦画面。顔中に皺があり灰白色の長いあごひげを蓄えた清代の年配の官吏が、モダンな黒いモニターヘッドホンを装着し、黒い刺繍入りの清代官服を着ている。グレー無地のスタジオ背景、上からの柔らかい光、映画的な質感、寒色系で低彩度。
- 動画プロンプト:固定のクローズアップ。灰白色の長ひげを蓄え、清代の官服を着てモダンなヘッドホンを着けた年配の男性がカメラに向かって激しく語りラップする。頭が語調に合わせて軽くうなずき、眼差しは毅然、口の動きは自然でリアル、グレーのミニマルなスタジオ背景。
### #48 01:10.542–01:11.792 · デジタルヒューマン + コード/編集オーバーレイ(テキスト注記、グラフィック貼り付け)

- 確率:デジタルヒューマン 63%、AI 生成動画 31%、実写 5%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:LivePortrait
- 顔が画面の 24%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.22、使用色 35 種、平坦ブロック 29%
- [VLM] 体と背景は完全に静止し、唇と下あごだけが音声に合わせて変形して駆動される
- [VLM] 老人の顔立ち、白ひげ、ヘッドホンは典型的な Midjourney の超リアル生成の特徴を備える
- [VLM] マイクの縁とひげの境界に物理的な遮蔽の相互作用と自然な影の変化がない
- 画面:黒衣で長いひげの老道士がモニターヘッドホンを着けマイクに向かって語る、顔のクローズアップ、目線の固定カメラ、ダークトーンのスタジオ光。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.1:1(0.2 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/bottom):京城骂完长沙骂
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:フォトリアル写真、中国式の老人のクローズアップ、白く長いひげを蓄え、プロ用の黒いヘッドホンを装着、横向きのマイクに顔を向け、暗い色の道服、ダークトーンのスタジオ背景、レンブラントライト。
- 動画プロンプト:老人はマイクに顔を向けた姿勢を保ち、ラップの音声に合わせて口を開いて語り、頭が軽く揺れ、表情は厳粛、カメラ固定。
### #49 01:11.792–01:14.583 · デジタルヒューマン + コード/編集オーバーレイ(字幕、グラフィック貼り付け)

- 確率:デジタルヒューマン 74%、AI 生成動画 25%、3D レンダリング 0%(fused)
- 画面内の物体に書かれた文字(後付けの字幕ではない):2
- 素材の出どころ:AI 生成
- 想定ツール:LivePortrait / SadTalker / Hedra
- 顔が画面の 14%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.15、使用色 34 種、平坦ブロック 35%
- サンプルフレームの 100% に正面の顔がありカメラ固定、音声トラックに声あり
- [VLM] 体、衣装、周囲のマイクとポップガードは完全に静止し、物理的な微動がない
- [VLM] 顔は口と下あごだけが音声に合わせてリップシンクの引き伸ばし変形をし、ひげの根元に唇の動きに伴うアルゴリズム的な引っ張り感がある
- [VLM] 頭にはかすかなアルゴリズム的な変位と傾きしかなく、目の動きが硬く、典型的な静止画駆動のトークに属する
- 画面:清代の官吏の装いの長ひげの老人がプロ用モニターヘッドホンを着け、コンデンサーマイクに向かってラップのリップシンク、固定ショットのミディアムクローズ、ダークグレーのスタジオ背景。
- 撮り方/ライティング:クローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.3 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(字幕/bottom):京城骂完长沙骂 / 打脱牙和血吞
- テキストトラック(テキスト/bottom):2
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:フォトリアルな肖像、清朝末期の白髪で長いひげの官吏、暗い色の補服を着て朝珠を掛け、モダンなプロ用の黒いモニターヘッドホンを装着、目の前にレコーディング用コンデンサーマイクが立ち、ダークグレー無地のレコーディングスタジオ背景、サイド光の強いコントラスト、顔の皺がはっきり、8k のディテール
- 動画プロンプト:人物の口が自然に開閉してラップのリップシンクをし、ひげが下あごの開閉に合わせて軽く揺れ、眼差しは集中、体と背景は固定して動かない
### #50 01:14.583–01:17.292 · デジタルヒューマン + コード/編集オーバーレイ(字幕)

- 確率:デジタルヒューマン 80%、AI 生成動画 19%、3D レンダリング 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney (ベース画像生成) + D-ID / HeyGen / SadTalker (音声駆動)
- 顔が画面の 23%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.22、使用色 36 種、平坦ブロック 29%
- サンプルフレームの 100% に正面の顔がありカメラ固定、音声トラックに声あり
- [VLM] 人物の頭に軽い揺れがあり、口に話す開閉の動作があるが、肩、衣服、着けているヘッドホン、画面左側のマイクは動画全体で完全に静止して動かない。これは典型的な単一画像の音声駆動(デジタルヒューマン/Avatar)の特徴。
- [VLM] 人物の肌の質感が鋭く完璧すぎ、典型的な AI 生成画像の質感を帯びる。
- 画面:クローズアップ、長い白ひげを蓄えた老人がモダンなヘッドホンを着け、マイクに向かって話す。画面の背景はダークグレーで、光と影のコントラストが強い。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.3:1(0.4 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(字幕/bottom):打脱牙和血吞 / 长沙骂完江西骂
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:クローズアップ、中国古代風の白ひげの老人、顔中に皺、眼差しは深く、頭にモダンな黒いモニターヘッドホンを着け、目の前にプロ用マイクが置かれている。ダークグレーの無地背景、左からの単一光源の硬い光、高コントラスト、映画級の質感、8k 解像度、きわめてリアルな肌の質感。
- 動画プロンプト:老人がマイクに向かって話し、口の形は自然に開閉し、頭に軽く自然な揺れがあり、体、ヘッドホン、マイクは完全に静止したまま。
### #51 01:17.292–01:20.208 · デジタルヒューマン + コード/編集オーバーレイ(字幕、グラフィック貼り付け)

- 確率:デジタルヒューマン 55%、AI 生成動画 36%、3D レンダリング 9%(fused)
- 画面内の物体に書かれた文字(後付けの字幕ではない):C
- 素材の出どころ:AI 生成
- 想定ツール:LivePortrait / Hedra(ベース画像は Midjourney 生成)
- 顔が画面の 15%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.16、使用色 35 種、平坦ブロック 33%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 胴体と背景は完全に静止し、口の形と頭だけが音声に合わせて軽く揺れる
- [VLM] 清代の官服にモダンなレコーディング用ヘッドホンとコンデンサーマイクを合わせた AI 合成の構図
- [VLM] 口の開閉の縁とひげの境界に軽い駆動による引き伸ばしの痕跡がある
- 画面:清朝の官服を着てモニターヘッドホンを着けた老人がマイクに向かってラップし、頭がリズムに合わせてわずかに揺れる、ダークトーンのスタジオのミディアムクローズ。
- 撮り方/ライティング:クローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 1.5:1(0.6 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(字幕/bottom):长沙骂完江西骂 / 岳州败靖港败湖口败
- テキストトラック(テキスト/bottom):C
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:フォトリアルなポートレート写真、曾国藩に似た清代の老人、灰白色の八の字ひげと長いあごひげ、清代の朝服を着て数珠を掛け、プロ用の黒いモニターヘッドホンを装着、身の前にポッドキャスト用マイクが立ち、ダークグレー無地の背景、高コントラストの映画的スタジオのトップライト、縦画面のミディアムクローズ。
- 動画プロンプト:老人がマイクに顔を向けてリップシンクでラップし、頭が話す速さに合わせて軽く揺れ、表情は厳粛、体と肩は動かず、固定カメラ、フォトリアルなダークトーン。
### #52 01:20.208–01:21.208 · AI 生成動画

- 確率:AI 生成動画 52%、実写 28%、デジタルヒューマン 7%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney (ベース画像) + Hedra / HeyGen / CapCut(剪映)デジタルヒューマン
- 低照度画面:37% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 6% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.30、使用色 38 種、平坦ブロック 21%
- [VLM] 極度に鮮明な肌の質感(毛穴、皺)は典型的な Midjourney V6 の超リアルスタイルを帯びる
- [VLM] 動きは口の開閉と頭の軽い揺れに限られ、体と背景は完全に静止しており、単一画像の音声駆動デジタルヒューマンの特徴に合致
- [VLM] 口が動く際にひげに軽い非物理的な変形がある可能性
- 画面:白髪で長いひげの老人のクローズアップ、ヘッドホンを着け、マイクに向かって話す。ダークグレーの無地背景、高コントラストの光と影が顔の風雪を経た感じを際立たせる。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.3:1(0.4 段差);柔らかい光(明暗の境界がほとんどない)
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:白髪のアジア系の老人のクローズアップ、長い白ひげを蓄え、黒いヘッドホンを装着し、目の前に黒いマイクがある。ダークグレーの無地背景。超リアル、映画級の光と影、高コントラスト、顔の皺と毛穴のディテールが豊富、左からのキーライト。
- 動画プロンプト:老人がマイクに向かって話す。口の形は自然、頭に軽く自然な揺れがあり、眼差しは集中、顔の特徴を安定して保つ。
### #53 01:21.208–01:25.458 · デジタルヒューマン + コード/編集オーバーレイ(字幕)

- 確率:デジタルヒューマン 58%、AI 生成動画 38%、実写 3%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:LivePortrait / SadTalker / Hedra
- 顔が画面の 25%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.23、使用色 35 種、平坦ブロック 28%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 体と衣服は完全に静止し、唇と頭だけが小さく駆動されて変形
- [VLM] ひげと唇周りに典型的なデジタルヒューマンの音声駆動(Lip-sync)の融合した縁がある
- [VLM] ベース画像は強い AI ポートレートの質感を持ち、肌の毛穴と深い皺のディテールが超現実寄り
- 画面:白髪で長いひげの長老がヘッドホンを着けマイクに向かって語る、カメラ固定、ダークトーンのスタジオのサイド光。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.1:1(0.2 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(字幕/bottom):口一口和血吞 / 一口一口和血吞
- 再現:デジタルヒューマン:まず音声をクローン/合成し、次にデジタルヒューマンモデルで人物画像 + 音声から駆動する
- 先頭フレーム画像プロンプト:クローズアップ肖像、風雪を経た東アジア系の年配の道長、剃髪、白髪まじりの八の字ひげときわめて長い白いあごひげ、プロ用の黒いモニターヘッドホンを装着、黒い中国式のチャイナボタンの長衣を着て、寒色系のサイド光、顔に深い皺が刻まれ、ダークグレーの暗い無地背景、映画的な質感、超リアルなディテール。
- 動画プロンプト:年配の男性がヘッドホンを着けマイクに向かって厳粛に歌詞を語り、唇の開閉が歌詞に合い、頭にはごくわずかなうなずきと傾きしかなく、眼差しは毅然として深い、固定のクローズアップ。
### #54 01:25.458–01:27.125 · 3D レンダリング

- 確率:3D レンダリング 58%、AI 生成動画 24%、コード/テンプレートレンダリング 12%(fused)
- 素材の出どころ:制作側レンダリング
- 想定ツール:Midjourney + CapCut(剪映)
- テクスチャはレンダリングの特徴:平坦な色ブロック 30%、95% のピクセルが 27 色のみ、水平/垂直の直線エッジ 8%
- フレームごとの鮮明度が周期的に変動(周期 4 フレーム、相関 0.50):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 画面内部に独立した動き(水面の波紋、ロープの揺れなど)が一切なく、画面全体のきわめてゆっくりしたズーム・パン(Ken Burns 効果)しかなく、静止画像の処理の特徴に合致。
- 画面:クローズアップ、老朽化した木の船が暗く霧の立ちこめる水面に停泊し、船の中に 2 本の木の櫂とロープの束が置かれ、雰囲気は陰鬱でミニマル。
- 撮り方/ライティング:クローズアップ;俯瞰;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側(サイド光);ライティング比約 5.4:1(2.4 段差);柔らかい光(明暗の遷移が広い)
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
- 先頭フレーム画像プロンプト:クローズアップ、暗く霧の立ちこめる水面に老朽化した木の船が停泊し、船の中に 2 本の木の櫂と粗いロープの束が置かれている。ミニマリズム、ダークな雰囲気、映画級の光と影、寒色系、8k 解像度。
- 動画プロンプト:カメラはゆっくりと前へ押し込み、画面は静止したまま、老朽化した木の船、木の櫂、ロープのディテールを見せる。背景は濃い霧に包まれた暗い水面、雰囲気は陰鬱で静か。
### #55 01:27.125–01:28.333 · AI 生成動画 + コード/編集オーバーレイ(グラフィック貼り付け)

- 確率:AI 生成動画 80%、3D レンダリング 18%、2D アニメーション 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Kling/Runway
- フレームごとの鮮明度が周期的に変動(周期 5 フレーム、相関 0.56):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 水波の動きが規則的で粘性があり、本物の混沌とした感じを欠く
- [VLM] 光と影の反射がなめらかで完璧、AI の質感を持つ
- [VLM] 地平線の弧度が不自然
- 画面:ダークな水面のクローズアップ、水の波が揺れ、空は陰鬱、カメラはゆっくり押し込む。
- 撮り方/ライティング:ミディアムクローズ;目線やや俯瞰;ジンバル (シミュレート);屋外の曇天/日陰の柔らかい光;キーライトは画面左側やや前方;ライティング比約 1.6:1(0.6 段差);柔らかい光(明暗の遷移が広い)
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:モノクロのダークスタイル、波紋のある水面、陰鬱な空、雲間から差す微光、弧を描く地平線、ミニマルな映画感。
- 動画プロンプト:モノクロのダークな水面、水の波がゆるやかに揺れ、陰鬱な空、光と影が波とともに流れ、カメラはゆっくり押し込む。
### #56 01:28.333–01:30.750 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 77%、実写 8%、デジタルヒューマン 7%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Kling
- 低照度画面:62% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 0% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.52、使用色 36 種、平坦ブロック 9%
- フレームごとの鮮明度が周期的に変動(周期 4 フレーム、相関 0.34):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 指の関節、肌の皺、ひげに軽い AI のなめらかな融合と動的な漂いの感じがある
- [VLM] 手で右目を覆う動作はきわめてわずかで、主にきわめて緩やかなカメラの押し込みと顔の微動
- [VLM] 典型的な AI 画像(画像から動画生成)による超リアルな映画的質感の画面
- 画面:清代の官服を着た白ひげの老人が右手で右目を覆い、表情は老いて疲れ、カメラはゆっくりと押し込み、環境は薄暗く重い。
- 撮り方/ライティング:クローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 1.9:1(0.9 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(テキスト/bottom):同治九年右眼失明
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:清代末期の老人、皺だらけの顔、白く長いひげ、黒い地紋入りの清代官服を着て、痩せこけて老いた右手で右目を覆い、苦しく疲れた表情、かすかなサイド光、映画的な質感、超リアルなディテール、寒色系、縦画面
- 動画プロンプト:老人は右手で右目を覆った姿勢を保ち、指がわずかに震え、胸がかすかに上下して呼吸する。カメラはゆっくりと前へ老人の顔のクローズアップへ押し込み、環境全体は薄暗く重苦しい。
### #57 01:30.750–01:31.417 · AI 生成動画

- 確率:AI 生成動画 53%、実写 27%、デジタルヒューマン 7%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:LivePortrait / SadTalker / HeyGen
- 低照度画面:44% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 6% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.29、使用色 36 種、平坦ブロック 25%
- [VLM] 静止した AI ポートレートにトークのリップシンク駆動を組み合わせ、体とヘッドホンは完全に静止
- [VLM] 口の開閉時にひげに軽い引き伸ばし変形のアーティファクト
- [VLM] 頭はかすかに変位し、主な動きは口の領域に限られる
- 画面:ヘッドホンを着けた白ひげの老人の顔のクローズアップ、カメラに向かって話す。背景は無地の寒色のスタジオ背景、カメラはゆっくりわずかに押し込む。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 2.0:1(1.0 段差);柔らかい光(明暗の遷移が広い)
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、風雪を経た中国の老道長、モダンなヘッドホンを装着、長い白ひげ、深く厳粛な眼差し、カメラを直視、暗い色の道服、無地のダークグレーのスタジオ背景、映画級のフォトリアル、低彩度、寒色系の柔らかい光。
- 動画プロンプト:正面クローズアップ、ヘッドホンを着けた年老いた道長がカメラに向かって厳粛に話す。唇が音声に合わせて開閉し、顔の微表情が変化し、頭が軽く自然に揺れ、体と背景は静止したまま、カメラはゆっくりと押し込む。
### #58 01:31.417–01:33.333 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 90%、実写 8%、ストップモーション 0%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + Kling
- フレームごとの鮮明度が周期的に変動(周期 6 フレーム、相関 0.10):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- [VLM] 老人の手の肌と眼窩が接する部分に AI 特有の融合と軽い変形がある
- [VLM] ひげと肌の質感がゆっくりした押し込みの過程でかすかな AI の流動・沸騰感を示す
- [VLM] 極度に彫刻的な高コントラストの映画級の皺の質感で、典型的な Midjourney スタイル
- 画面:白髪で長いひげの老人が目を閉じてこめかみを揉み、表情はめまいと苦痛、カメラはゆっくりと前へ押し込む。
- 撮り方/ライティング:クローズアップ;目線;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 2.0:1(1.0 段差);中程度の柔らかさ
- テキストトラック(テキスト/bottom):床在转头晕个不停
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:クローズアップ、白髪で白く長いひげの中国古代の老人、顔中の皺、血管の浮き出た片手で右目と額を覆い、表情は苦痛とめまい、暗い色の長衣、低彩度のダークトーン、サイド光が顔の質感を彫刻のように際立たせる、映画感、高精細でリアルな質感。
- 動画プロンプト:カメラはゆっくりと老人の顔へ押し込み、老人は額に手を当てた動作を保ち、眉をわずかにひそめ、かすかに呼吸し、全身は静止したまま微動、ダークな映画の雰囲気。
### #59 01:33.333–01:34.000 · AI 生成動画

- 確率:AI 生成動画 76%、実写 15%、デジタルヒューマン 7%(fused)
- 素材の出どころ:AI 生成
- 想定ツール:Midjourney + Kling
- 低照度画面:21% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 1% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.50、使用色 43 種、平坦ブロック 6%
- [VLM] 肌の毛穴と深い皺は典型的な Midjourney スタイルの高密度な合成の質感を持つ
- [VLM] 画面にはきわめて軽い漂いと局所的な微動しかなく、自然な呼吸やまばたきの起伏を欠く
- [VLM] ひげと生え際の境界がやや過度に作り込まれ、軽い縁の融合がある
- 画面:アジア系の年配男性の顔の極端なクローズアップ、眼差しは毅然として深く、カメラはゆっくりと前へ平行に押し込む、スタジオの高コントラストのライティング。
- 撮り方/ライティング:極端なクローズアップ;目線;三脚/スタンド固定;斜め前からのキーライト + フィル(標準的なライティング);キーライトは画面右側やや前方;ライティング比約 1.8:1(0.8 段差);柔らかい光(明暗の遷移が広い)
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:風雪を経た東アジア系の年配男性の正面クローズアップ、顔中の深い皺、灰白色の口ひげとあごひげ、厳粛で冷酷な眼差し、黒いヘッドバンド/ヘッドホンを装着、無地のダークグレー背景、高コントラストの映画級ポートレートスタジオライティング、きわめて高いディテール。
- 動画プロンプト:画面はゆっくりと安定して前へわずかに押し込み、老人は厳粛で冷徹な表情で凝視を続け、顔にはごくかすかな呼吸による揺らぎ、眼差しは毅然として動かない。
### #60 01:34.000–01:39.208 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 46%、実写 42%、デジタルヒューマン 7%(fused)
- 素材の出どころ:AI 生成
- 低照度画面:34% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 0% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.56、使用色 56 種、平坦ブロック 1%
- [VLM] 清代一品の鶴の補服の刺繍が精細で正確、朝珠と官帽の質感がリアル
- [VLM] 老人の手の肌、老人性のしみ、関節の生理的構造が自然で、テーブルの反射が物理光学に合致
- [VLM] 前景の人物が文書を取り上げて置く動作がなめらかで、物理的な相互作用がリアル
- [VLM] AI 動画によくある質感の沸騰、指の変形、明滅の現象がない
- [claude 画像による再確認] 同じ AI キャラクターが清朝の官服に着替え、シーンは清代の交渉の長テーブルで、ドラマ化された AI 生成画面に属する
- [claude 画像による再確認] 光、粒子、人物が前後の AI ショットと一致
- 画面:清代の交渉の長テーブルの前で、一品の官服を着た白ひげの老官吏が重々しく見つめ、前景に西洋人の後ろ姿と文書の動作、寒色のサイド光、わずかに押し込むカメラ。
- 撮り方/ライティング:ミディアムクローズ;目線;ジンバル;斜め前からのキーライト + フィル(標準的なライティング);キーライトは画面右側やや前方;ライティング比約 1.6:1(0.7 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(字幕/bottom):带着病被派去天津 / 案子一结卖国贼成了我的名
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
- 先頭フレーム画像プロンプト:映画のスチール、白髪白ひげの清代の老官吏が暗い色の交渉テーブルの前に端座し、官帽をかぶり鶴の補服を着て、風雪を経た顔に重々しい表情、前景にピントの外れた西洋人の後ろ姿、サイドからの冷たい逆光、ダークトーンの青灰色、高コントラストの映画的質感。
- 動画プロンプト:清代の老官吏が交渉テーブルの前に座り重々しく見つめ、両手を軽くテーブルに置く。前景の西洋人は折りたたんだ文書を手にし、カメラはゆっくりと押し込む。冷徹で厳粛な歴史正劇の映画の雰囲気。
### #61 01:39.208–01:40.333 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 57%、実写 25%、デジタルヒューマン 8%(deterministic)
- 素材の出どころ:AI 生成
- 低照度画面:53% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 3% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.27、使用色 36 種、平坦ブロック 28%
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.6:1(0.7 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/middle):10777
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #62 01:40.333–01:43.125 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記、グラフィック貼り付け)

- 確率:AI 生成動画 38%、3D レンダリング 27%、実写 18%(deterministic)
- 素材の出どころ:AI 生成
- 顔が画面の 10%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.11、使用色 30 種、平坦ブロック 39%
- 撮り方/ライティング:クローズアップ;手持ち;夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.3:1(0.4 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):湖广会馆挂我的匾
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #63 01:43.125–01:46.125 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 65%、3D レンダリング 19%、実写 6%(deterministic)
- 素材の出どころ:AI 生成
- テクスチャは写真/動画の特徴:ノイズ σ=0.54、使用色 69 種、平坦ブロック 7%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:ミディアムクローズ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.6:1(0.7 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(字幕/bottom):老乡砸了烧成灰烟 / 外惭清议
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #64 01:46.125–01:47.917 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 79%、デジタルヒューマン 8%、実写 7%(deterministic)
- 素材の出どころ:AI 生成
- 低照度画面:31% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 0% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.40、使用色 42 種、平坦ブロック 15%
- フレームごとの鮮明度が周期的に変動(周期 2 フレーム、相関 0.01):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.6:1(0.7 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):外惭清议
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #65 01:47.917–01:55.708 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 60%、3D レンダリング 24%、デジタルヒューマン 6%(deterministic)
- 素材の出どころ:AI 生成
- ショット内のモーションビート:108.46s、111.12s、112.96s
- 顔が画面の 7%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.17、使用色 30 種、平坦ブロック 33%
- フレームごとの鮮明度が周期的に変動(周期 6 フレーム、相関 0.01):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:ミディアムクローズ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 2.4:1(1.2 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):打脱牙和血吞
- テキストトラック(テキスト/bottom):GA
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #66 01:55.708–01:59.208 · 静止画 + ズーム・パン効果

- 確率:静止画 + ズーム・パン効果 85%、AI 生成動画 9%、画面録画/スクリーンショット 2%(deterministic)
- 静止フレームの出どころ:unknown
- 素材の出どころ:要確認;実物かどうか要確認:写真/画像素材
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.03px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +1.8%/s、パン 9px/s
- テクスチャは写真/動画の特徴:ノイズ σ=0.51、使用色 29 種、平坦ブロック 2%
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #67 01:59.208–02:01.583 · 静止画 + ズーム・パン効果(デザイン/レンダリンググラフィック)

- 確率:静止画 + ズーム・パン効果 76%、AI 生成動画 14%、画面録画/スクリーンショット 4%(deterministic)
- 静止フレームの出どころ:graphic
- 素材の出どころ:制作側レンダリング
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 99%、残差 0.15px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +6.9%/s、パン 39px/s
- テクスチャはレンダリングの特徴:平坦な色ブロック 26%、95% のピクセルが 29 色のみ、水平/垂直の直線エッジ 7%
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #68 02:01.583–02:02.292 · 静止画 + ズーム・パン効果(デザイン/レンダリンググラフィック)

- 確率:静止画 + ズーム・パン効果 83%、AI 生成動画 10%、画面録画/スクリーンショット 3%(deterministic)
- 静止フレームの出どころ:graphic
- 素材の出どころ:制作側レンダリング
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.08px、局所的な動きなし)→ 静止画のズーム・パン:ズーム -0.3%/s、パン 4px/s
- テクスチャはレンダリングの特徴:平坦な色ブロック 42%、95% のピクセルが 16 色のみ、水平/垂直の直線エッジ 22%
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #69 02:02.292–02:04.208 · 静止画 + ズーム・パン効果 + コード/編集オーバーレイ(テキスト注記)

- 確率:静止画 + ズーム・パン効果 80%、AI 生成動画 12%、画面録画/スクリーンショット 3%(deterministic)
- 静止フレームの出どころ:unknown
- 素材の出どころ:要確認;実物かどうか要確認:写真/画像素材
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 98%、残差 0.16px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +2.9%/s、パン 14px/s
- テキストトラック(テキスト/bottom):黄号下了水
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #70 02:04.208–02:04.833 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 40%、3D レンダリング 23%、実写 20%(deterministic)
- 素材の出どころ:AI 生成
- 顔が画面の 21%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.30、使用色 40 種、平坦ブロック 25%
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン)
- テキストトラック(テキスト/bottom):黄号下了水
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #71 02:04.833–02:05.458 · 3D レンダリング + コード/編集オーバーレイ(テキスト注記)

- 確率:3D レンダリング 50%、AI 生成動画 24%、コード/テンプレートレンダリング 12%(deterministic)
- 素材の出どころ:制作側レンダリング
- テクスチャはレンダリングの特徴:平坦な色ブロック 22%、95% のピクセルが 22 色のみ、水平/垂直の直線エッジ 24%
- 撮り方/ライティング:ミディアム;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.3:1(0.4 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/bottom):黄号下了水
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
### #72 02:05.458–02:07.083 · AI 生成動画

- 確率:AI 生成動画 83%、3D レンダリング 5%、実写 4%(deterministic)
- 素材の出どころ:AI 生成
- 低照度画面:38% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 6% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.32、使用色 39 種、平坦ブロック 21%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.5:1(0.6 段差);中程度の柔らかさ
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #73 02:07.083–02:09.208 · 3D レンダリング + コード/編集オーバーレイ(テキスト注記)

- 確率:3D レンダリング 37%、AI 生成動画 29%、実写 18%(deterministic)
- 素材の出どころ:制作側レンダリング
- 撮り方/ライティング:ミディアム;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側(サイド光);ライティング比約 3.9:1(2.0 段差);柔らかい光(明暗の遷移が広い)
- テキストトラック(テキスト/bottom):幼童出洋的折子我签了
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
### #74 02:09.208–02:10.125 · 静止画 + ズーム・パン効果(デザイン/レンダリンググラフィック) + コード/編集オーバーレイ(テキスト注記、グラフィック貼り付け)

- 確率:静止画 + ズーム・パン効果 77%、AI 生成動画 13%、画面録画/スクリーンショット 4%(deterministic)
- 静止フレームの出どころ:graphic
- 素材の出どころ:制作側レンダリング
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 97%、残差 0.19px、局所的な動きなし)→ 静止画のズーム・パン:ズーム -3.5%/s、パン 37px/s
- テクスチャはレンダリングの特徴:平坦な色ブロック 39%、95% のピクセルが 24 色のみ、水平/垂直の直線エッジ 13%
- テキストトラック(テキスト/bottom):?
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #75 02:10.125–02:14.000 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 59%、3D レンダリング 25%、デジタルヒューマン 6%(deterministic)
- 素材の出どころ:AI 生成
- 顔が画面の 12%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.10、使用色 27 種、平坦ブロック 40%
- フレームごとの鮮明度が周期的に変動(周期 None フレーム、相関 0.00):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:クローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.1:1(0.1 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(テキスト/bottom):船开那天我没等到
- テキストトラック(テキスト/middle):C
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #76 02:14.000–02:17.250 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 60%、3D レンダリング 24%、デジタルヒューマン 6%(deterministic)
- 素材の出どころ:AI 生成
- 顔が画面の 23%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.22、使用色 33 種、平坦ブロック 30%
- フレームごとの鮮明度が周期的に変動(周期 2 フレーム、相関 0.01):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.1:1(0.1 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/bottom):通籍三十年官至极品
- テキストトラック(テキスト/middle):大
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #77 02:17.250–02:18.875 · AI 生成動画 + コード/編集オーバーレイ(グラフィック貼り付け)

- 確率:AI 生成動画 62%、3D レンダリング 22%、デジタルヒューマン 6%(deterministic)
- 素材の出どころ:AI 生成
- 顔が画面の 28%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.30、使用色 34 種、平坦ブロック 27%
- フレームごとの鮮明度が周期的に変動(周期 2 フレーム、相関 0.21):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.5:1(0.6 段差);中程度の柔らかさ
- テキストトラック(テキスト/middle):大
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #78 02:18.875–02:22.333 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記)

- 確率:AI 生成動画 50%、実写 32%、デジタルヒューマン 7%(deterministic)
- 素材の出どころ:AI 生成
- 低照度画面:38% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 3% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.40、使用色 34 種、平坦ブロック 18%
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面右側やや前方;ライティング比約 1.4:1(0.5 段差);中程度の柔らかさ
- テキストトラック(テキスト/bottom):学业一无所成
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #79 02:22.333–02:23.042 · AI 生成動画 + コード/編集オーバーレイ(テキスト注記、グラフィック貼り付け)

- 確率:AI 生成動画 41%、3D レンダリング 24%、実写 18%(deterministic)
- 素材の出どころ:AI 生成
- 顔が画面の 27%、サンプルフレームの 100% に存在:人物のミディアムクローズ画面で、平坦な色ブロックの多くは壁/衣服由来、レンダリング特徴の重みを下げる
- テクスチャは写真/動画の特徴:ノイズ σ=0.27、使用色 34 種、平坦ブロック 28%
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.3:1(0.4 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(テキスト/bottom):学业一无所成
- テキストトラック(テキスト/middle):大
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #80 02:23.042–02:24.000 · 静止画 + ズーム・パン効果(デザイン/レンダリンググラフィック) + コード/編集オーバーレイ(グラフィック貼り付け)

- 確率:静止画 + ズーム・パン効果 68%、画面録画/スクリーンショット 15%、AI 生成動画 12%(deterministic)
- 静止フレームの出どころ:graphic
- 素材の出どころ:制作側レンダリング
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 96%、残差 0.18px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +0.1%/s、パン 15px/s
- テクスチャはレンダリングの特徴:平坦な色ブロック 38%、95% のピクセルが 30 色のみ、水平/垂直の直線エッジ 15%
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #81 02:24.000–02:28.042 · 3D レンダリング + コード/編集オーバーレイ(字幕)

- 確率:3D レンダリング 60%、AI 生成動画 20%、コード/テンプレートレンダリング 12%(deterministic)
- 素材の出どころ:制作側レンダリング
- テクスチャはレンダリングの特徴:平坦な色ブロック 37%、95% のピクセルが 29 色のみ、水平/垂直の直線エッジ 16%
- フレームごとの鮮明度が周期的に変動(周期 2 フレーム、相関 0.02):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:ミディアムクローズ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.2:1(0.3 段差);硬い光(明暗の境界がはっきり)
- テキストトラック(字幕/bottom):德行一无可许 / 这条,过了
- テキストトラック(テキスト/middle):同茶
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
### #82 02:28.042–02:29.167 · AI 生成動画 + コード/編集オーバーレイ(字幕)

- 確率:AI 生成動画 49%、実写 32%、デジタルヒューマン 7%(deterministic)
- 素材の出どころ:AI 生成
- 低照度画面:27% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 6% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.49、使用色 33 種、平坦ブロック 13%
- 撮り方/ライティング:極端なクローズアップ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは正面(光はレンズ方向から来て、被写体の両側の明るさが近い);ライティング比約 1.0:1(0.0 段差);柔らかい光(明暗の境界がほとんどない)
- テキストトラック(字幕/bottom):这条,过了。 / 这条,过了
- 再現:元動画は AI 生成:元ショットの先頭・末尾フレームで先頭・末尾フレーム生成を行えば、構図と動作を高い精度で再現できます。被写体を差し替える場合は先に画像モデルで先頭フレームを編集します
### #83 02:29.167–02:32.000 · 静止画 + ズーム・パン効果 + コード/編集オーバーレイ(テキスト注記)

- 確率:静止画 + ズーム・パン効果 75%、AI 生成動画 15%、画面録画/スクリーンショット 3%(deterministic)
- 静止フレームの出どころ:unknown
- 素材の出どころ:要確認;実物かどうか要確認:写真/画像素材
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 100%、残差 0.14px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +0.1%/s、パン 2px/s
- 低照度画面:34% の領域がほぼ黒だが粒状(無地の塗りではない)、明部の平坦ブロックは 8% のみ、かつ顔あり:平坦ブロック/少色は暗部の圧縮によるもので、レンダリング特徴としては数えない
- テクスチャは写真/動画の特徴:ノイズ σ=0.47、使用色 35 種、平坦ブロック 20%
- テキストトラック(テキスト/middle):m
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #84 02:32.000–02:38.125 · 静止画 + ズーム・パン効果

- 確率:静止画 + ズーム・パン効果 77%、AI 生成動画 14%、画面録画/スクリーンショット 3%(deterministic)
- 静止フレームの出どころ:unknown
- 素材の出どころ:要確認;実物かどうか要確認:写真/画像素材
- ショット内のモーションビート:155.00s
- フレーム全体が単一の剛体変換で動く(フィッティングのインライア 94%、残差 0.15px、局所的な動きなし)→ 静止画のズーム・パン:ズーム +5.3%/s、パン 25px/s
- 再現:静止画のズーム・パン:画像 1 枚 + 計測したズーム/パンのパラメータでローカルの ffmpeg で正確に再現
### #85 02:38.125–02:40.375 · 3D レンダリング + コード/編集オーバーレイ(グラフィック貼り付け)

- 確率:3D レンダリング 44%、AI 生成動画 41%、コード/テンプレートレンダリング 9%(deterministic)
- 素材の出どころ:制作側レンダリング
- フレームごとの鮮明度が周期的に変動(周期 4 フレーム、相関 0.39):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:ミディアムクローズ;移動カメラ(ジンバル/手持ちパン);夜景/弱光の環境光、専用の補助光なし;キーライトは画面左側やや前方;ライティング比約 1.6:1(0.7 段差);柔らかい光(明暗の遷移が広い)
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
### #86 02:40.375–02:44.958 · 3D レンダリング

- 確率:3D レンダリング 46%、AI 生成動画 37%、コード/テンプレートレンダリング 11%(deterministic)
- 素材の出どころ:制作側レンダリング
- フレームごとの鮮明度が周期的に変動(周期 4 フレーム、相関 0.64):画面はフレーム補間/フレームレート変換を経ており、元のフレームレートはより低い
- 重複フレームが interpolated のパターン(0%、周期 None):元素材は 24/25fps でその後トランスコード、AI 生成動画、3D/アニメーションレンダリング、映画素材によく見られる
- 撮り方/ライティング:ミディアムクローズ;移動カメラ(ジンバル/手持ちパン);斜め前からのキーライト + フィル(標準的なライティング);キーライトは画面右側やや前方;ライティング比約 1.6:1(0.6 段差);中程度の柔らかさ
- 再現:3D レンダリング:先頭・末尾フレームの AI 生成で近似できます。正確な多アングルが必要なら 3D モデリング + Blender レンダリング
## 注記
- 決定論的フォレンジクスは「動いているか、全体ズーム・パンか、レンダリングのテクスチャか、24→30 のフレームレート変換があるか」については信頼できます。実写/AI/3D の区別は VLM と人による再確認に依存します。
- メタデータはプラットフォームのトランスコードで消去されることが多く、欠けていても元からなかったとは限りません。