# rea-video Reverse Engineering für jedes Video. Talking Head, Tabletop, KI-Video, 3D, Motion Graphics, gemischte Schnitte: Gib ihm ein beliebiges davon,
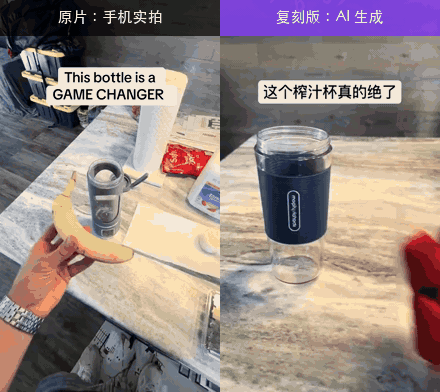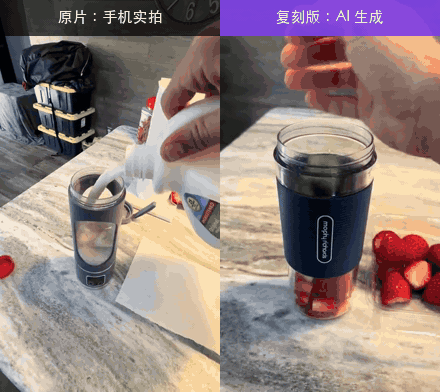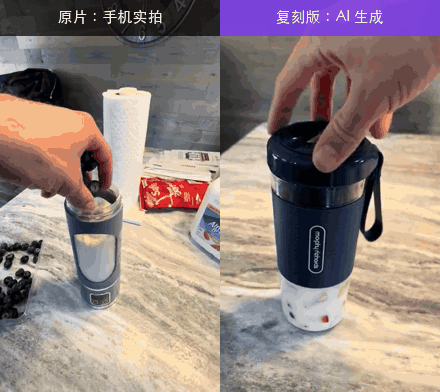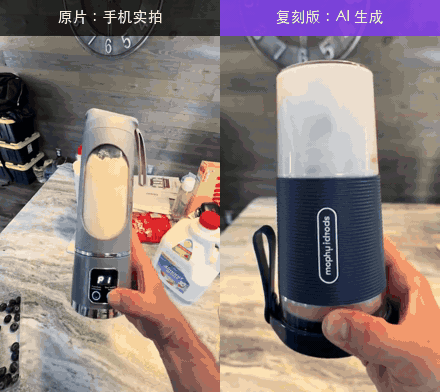
und es sagt dir Shot für Shot, wie Bild, gestaltete Texte, Schnitt und Ton entstanden sind, und gibt dir dann einen Plan, um so ein Video selbst zu machen. [中文](README_zh.md) | [English](../README.md) | [Русский](README_ru.md) | [日本語](README_ja.md) | [한국어](README_ko.md) | [Español](README_es.md) | [Português](README_pt.md) | [Français](README_fr.md) | Deutsch [![Stars](https://img.shields.io/github/stars/JuneYaooo/rea-video?style=flat)](https://github.com/JuneYaooo/rea-video/stargazers) ![Python](https://img.shields.io/badge/python-%E2%89%A53.10-blue) ![Agent](https://img.shields.io/badge/runs%20in-Claude%20Code%20%7C%20Codex-8A2BE2) Links: TikTok-Original, mit dem Handy gedreht; rechts: KI-Remake von jemand anderem mit einem anderen Produkt Links: eine TikTok-Werbung, mit dem Handy gedreht. Rechts: das KI-Remake von jemand anderem, mit einem anderen Produkt.
Das Urteil von rea-video: Links ist alles echtes Filmmaterial, ein Set und zwei Kamerapositionen; rechts ist alles KI-generiert, und die 8 Shots lassen sich in 3 Generierungen erzeugen.
> Berichte werden auf Chinesisch oder Englisch erstellt (dein Agent übergibt `--lang`). Die ausführliche Dokumentation gibt es vorerst nur auf Chinesisch; dein Agent liest sie und antwortet dir in deiner Sprache. Die sechs Beispielberichte unten sind auf Englisch, damit du ohne Installation sehen kannst, wie ein Bericht aussieht. ## Was es zerlegen kann | Videotyp | Beispiele | Was du bekommst | |---|---|---| | Echtes Filmmaterial | Talking Head, Tabletop, Produktdemo aus der Hand, Vlog, Ladenbesuch | Sets und Kamerapositionen, Bildausschnitt, Kamerabewegungen, Licht (12 Setups mit Ausrüstungslisten), Color Grading | | KI-Video | Text/Bild-zu-Video, KI-Kurzserie, KI-Musikvideo | Belege, ein rekonstruierter Prompt pro Shot, wie man die Shots zu Generierungen bündelt und welches Modell man nimmt | | Avatar | Ein per Audio animiertes Porträt, Lippensynchronisation | Welche Shots Avatar-Shots sind, welches Porträt und welches Audio du brauchst | | 3D / Animation | Blender- / C4D-Erklärvideos, Produktanimation, 2D-Animation, Stop-Motion | Ob man mit einem Videomodell generiert oder aus 3D-Code rendert | | Code / Vorlage | Kinetische Typografie, UI-Demos, Diagramme, Karten im Folienstil | Text, Layout und Animations-Timing, bereit zum Nachbau als Remotion-Projekt | | Bildschirmaufnahme | Software-Tutorials, Web-Demos | Welche Teile echtes Material sind, das du selbst aufnehmen musst | | Gemischt / Schnitte | KI-Figuren + Code-UI + echte Bildschirmaufnahme; echtes Filmmaterial mit KI-Bearbeitung | Jeder Shot wird einzeln beurteilt und dann auf der Original-Timeline wieder zusammengesetzt | Neben der Frage, wie das Bild entstanden ist, bekommt jedes Video außerdem: - Untertitel und gestaltete Texte: Anfang und Ende jeder Zeile (Export als SRT / ASS), dazu Farbe, Kontur und wie der Text eingeblendet wird - Sticker, Emoji, Bild-in-Bild: wo sie sitzen und wie lange sie bleiben - Schnitt: wo die Schnitte liegen, wie schnell sie sind, ob sie auf den Beat fallen - Audio: menschliche oder KI-Stimme, KI- oder Archivmusik und ihre BPM, wo jeder Soundeffekt sitzt - Material, das du selbst liefern musst: Bildschirmaufnahmen, Screenshots, Produktfotos ## Schnellstart rea-video ist für KI-Agenten gebaut. Sag in Claude Code, Codex oder einem anderen Agenten, der Befehle ausführen kann: ```text Installiere https://github.com/JuneYaooo/rea-video und zerlege dann dieses Video: /path/to/video.mp4 ``` Der Agent installiert die CLI, lernt den Ablauf und führt alles aus. Du brauchst ffmpeg und Python 3.10+.
Manuell installieren ```bash brew install ffmpeg # sudo apt install ffmpeg git clone https://github.com/JuneYaooo/rea-video && cd rea-video bash scripts/install_skill.sh # installiert die CLI (pip, sonst pipx / lokales .venv) und verlinkt den Skill rea-video --help ```
Du bekommst: - eine einzeilige Zusammenfassung, z. B. „41 % KI-Video + 59 % Code-UI, 8 s echte Bildschirmaufnahme, Archivmusik mit 122 BPM“ - einen Remake-Plan, aufgeteilt in das, was zu filmen, zu generieren und zu programmieren ist - einen vollständigen `report.html` mit Frames pro Shot, Belegen, Prompts, Hinweisen zu Kamera und Licht sowie der Audio-Analyse Füge ein videofähiges Modell hinzu – Gemini oder Doubao funktionieren beide: Gib dem Agenten Endpoint und Key. Damit werden die Einstufungen echt/KI/3D genauer, und für jeden Shot wird ein rekonstruierter Prompt geschrieben. Ohne Modell funktioniert es trotzdem; wenn dein Agent Bilder sehen kann, prüft er die unsicheren Shots selbst. ## Beispiele

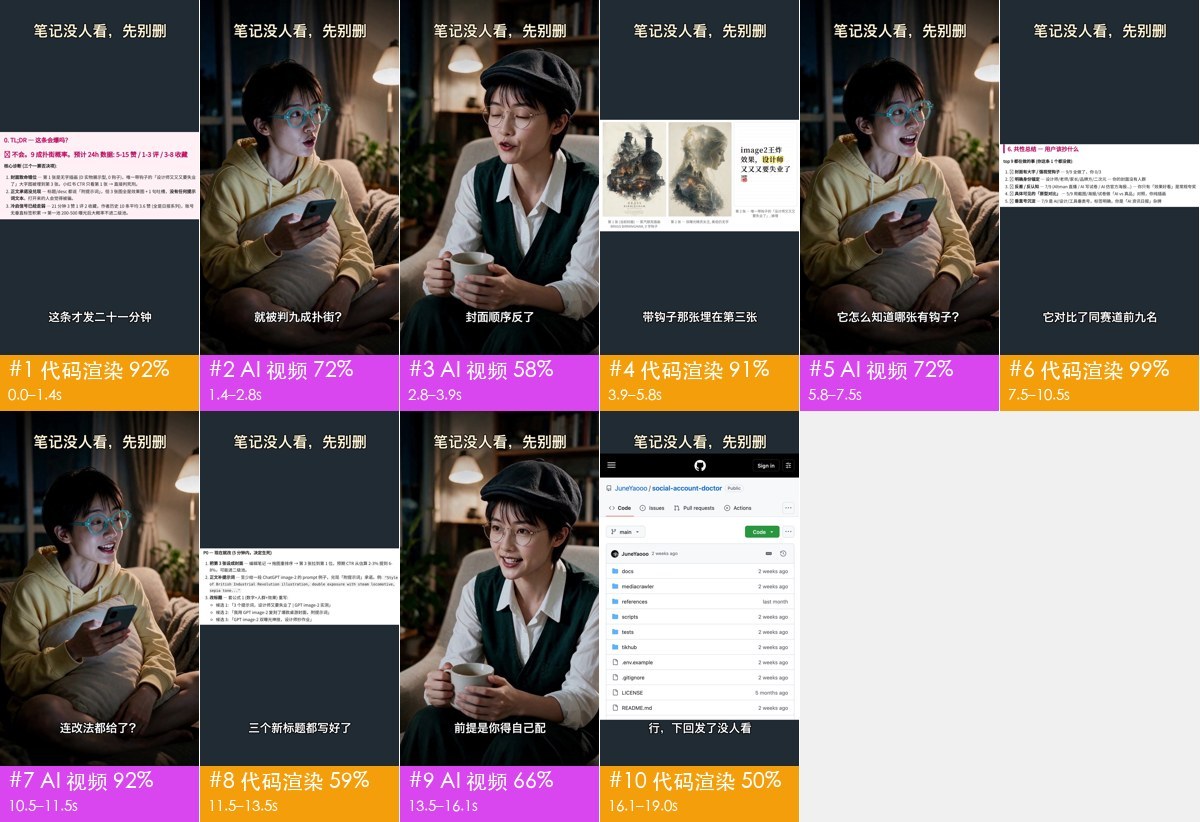
Gemischter Clip · 19 s · 10 Shots
KI-Figuren im Gespräch + per Code gebaute UI + 8 s echte Bildschirmaufnahme. Die 5 Dialog-Shots werden durch UI-Segmente unterbrochen, teilen sich aber ein Set, daher reicht eine Generierung für alle.
Video · Bericht

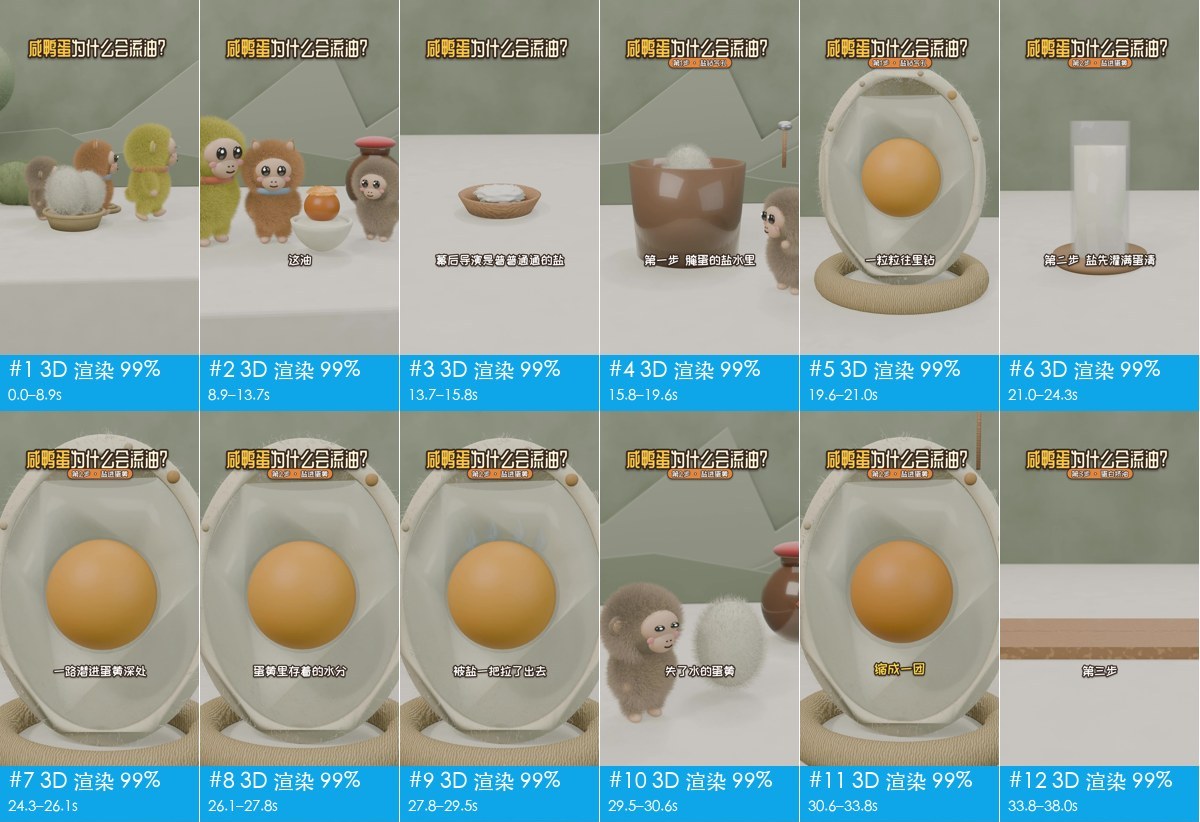
3D-Erklärvideo · 67 s · 21 Shots
Komplett 3D, KI-Sprecher. Machbar mit 10 Videogenerierungen, oder man lässt ein LLM Blender- / Three.js-Code schreiben.
Video · Bericht

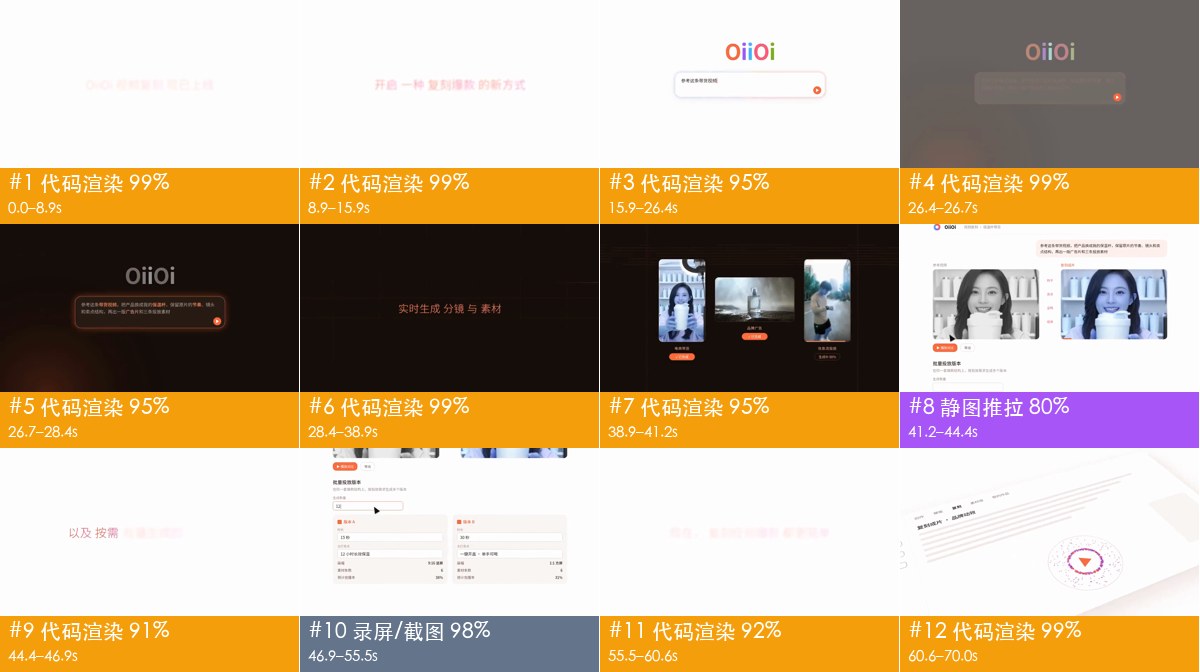
Produktvideo · 70 s · 12 Shots
83 % codegesteuerte Motion Graphics, 12 % Bildschirmaufnahme. Kein Videomodell nötig; ein Remotion-Projekt erledigt das.
Video · Bericht

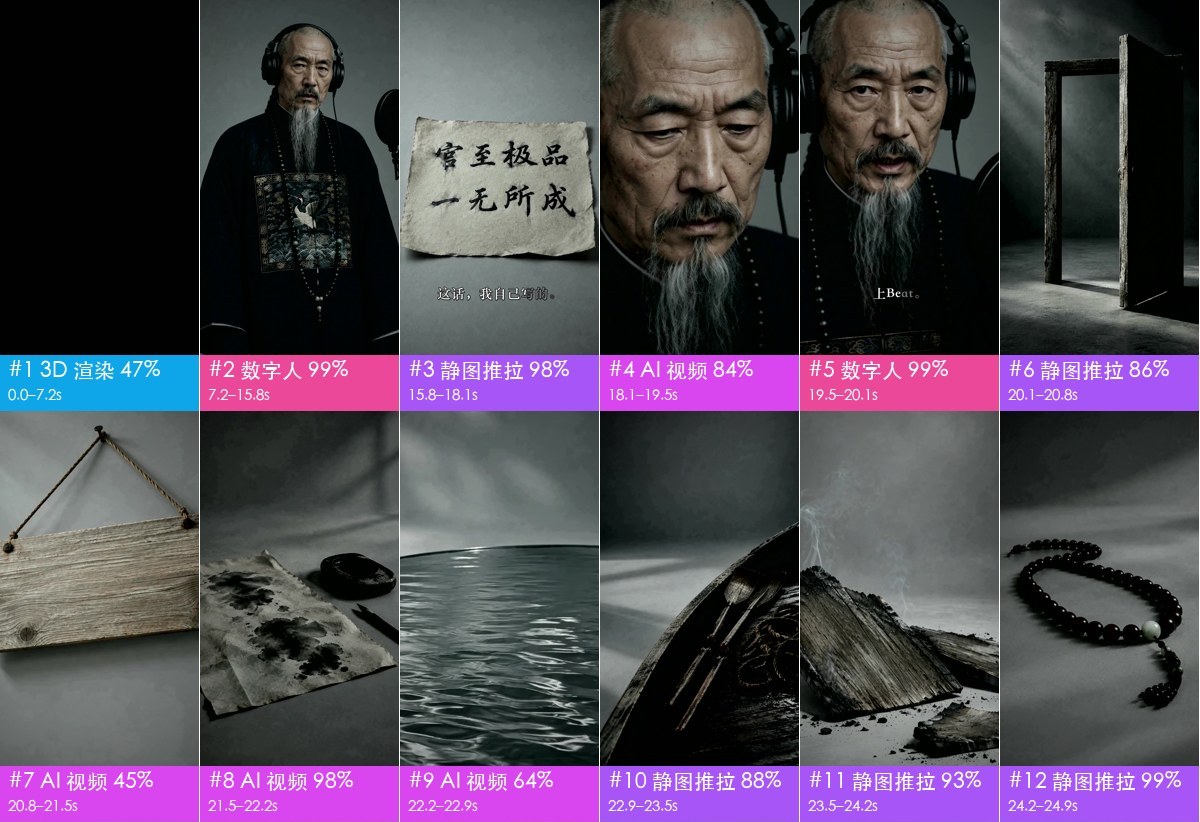
KI-Musikvideo · 165 s · 86 Shots
Erkennt den Song korrekt als KI-generiert (er wurde mit Suno gemacht). Das Vision-Modell hielt einige Shots für „Realfilm-Drama“; der Agent entdeckte falsche chinesische Schriftzeichen auf einer Schriftrolle und stufte sie als KI ein.
Video · Bericht

Unboxing mit echtem Filmmaterial · 72 s · 29 Shots
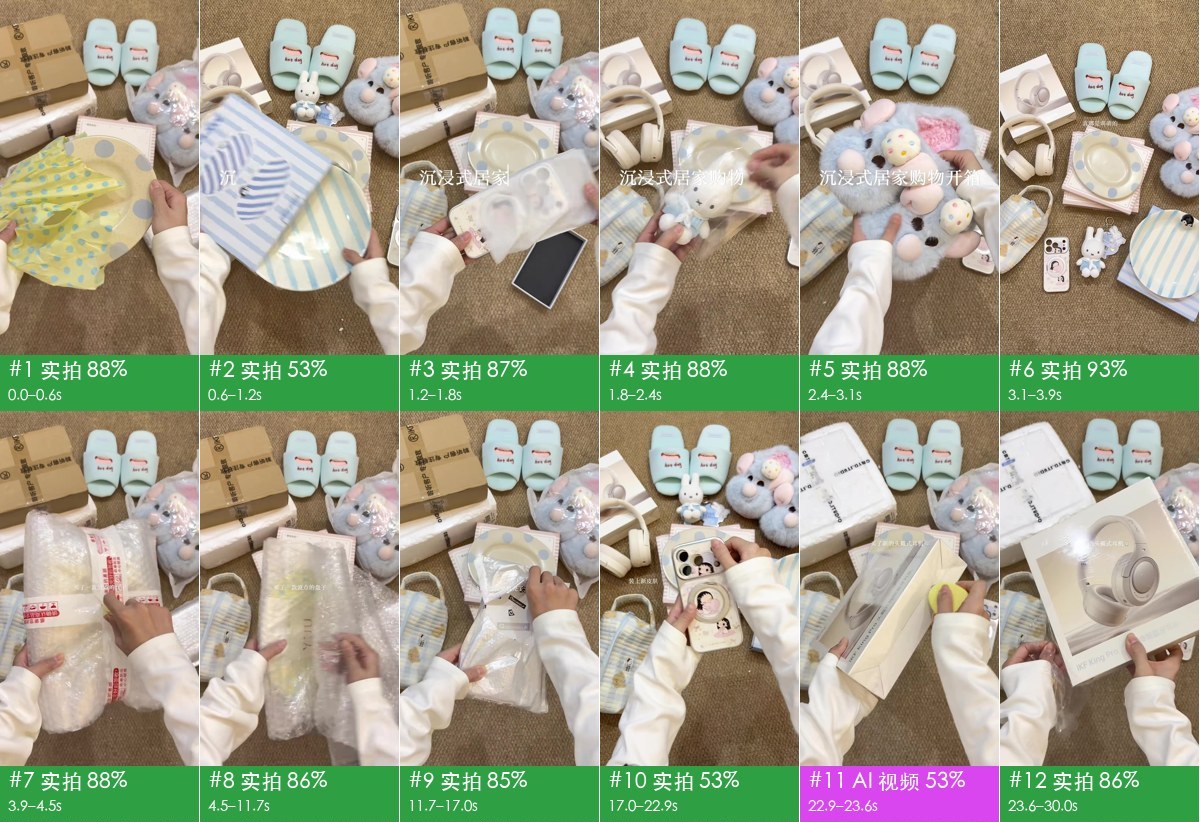
Alles echtes Material: ein Handy-Rig von oben, ein Teppich, eine Kameraposition, kein Voice-over, Raumton plus Archiv-BGM. Nach der Transkodierung durch die Plattform stufte das Offline-Tool 35 % als KI ein; die Prüfung durch den Agenten brachte es auf 97 % echtes Material.
Video · Bericht

Hybrid aus KI und echter Person · 58 s · 21 Shots
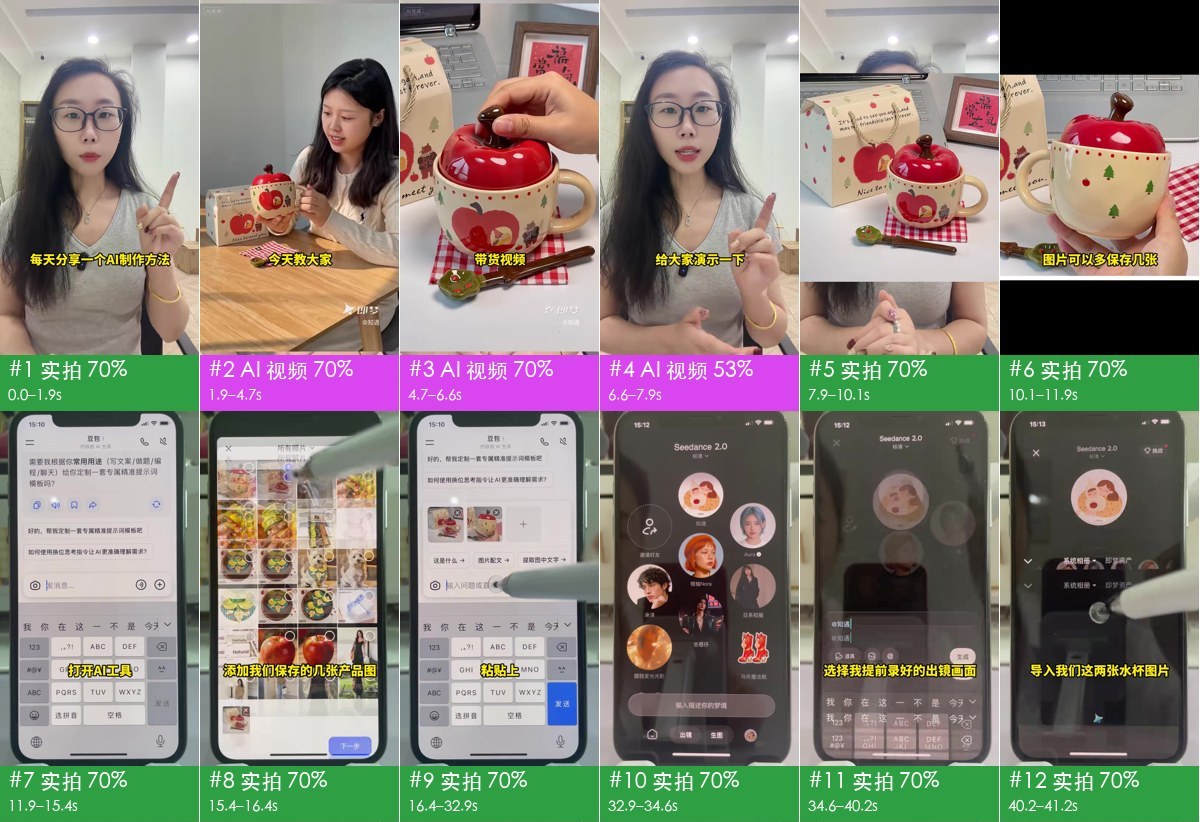
75 % echt (Talking Head + abgefilmter Handybildschirm) und 25 % KI: Die Creatorin gab Jimeng ihren eigenen Clip vor der Kamera und zwei Produktfotos, um ein Produktsegment mit „echter Person“ zu generieren. Der KI-Teil fiel durch das Jimeng-Wasserzeichen und verstümmelten Text auf der Geschenkbox auf.
Video · Bericht
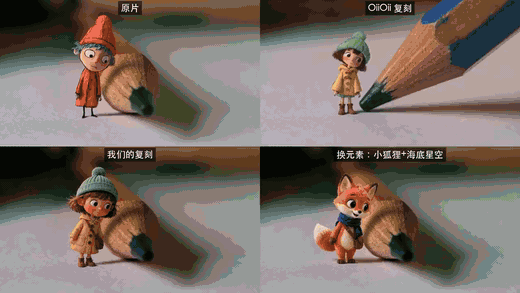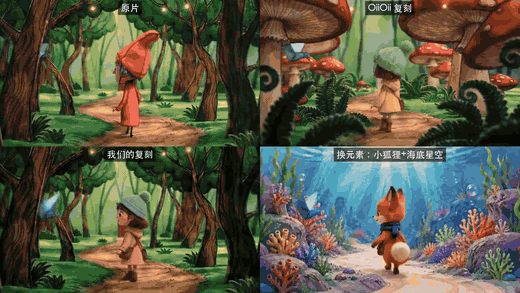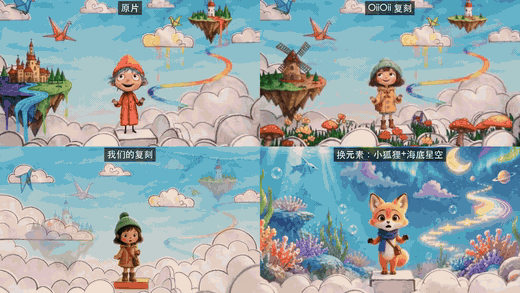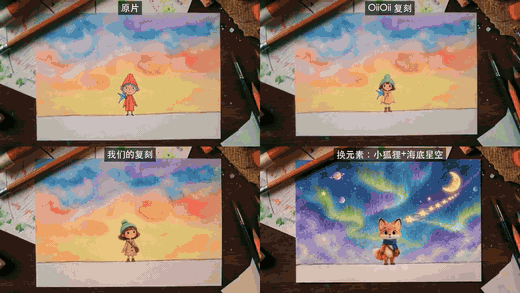
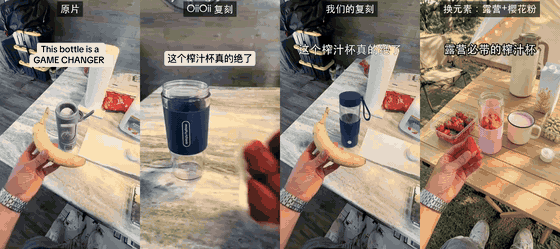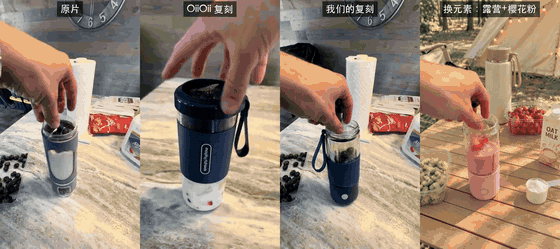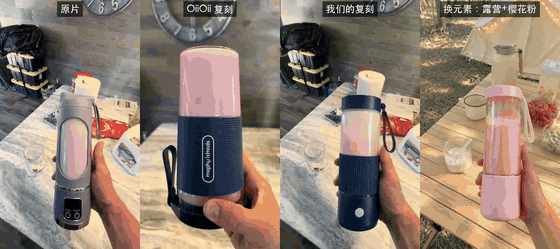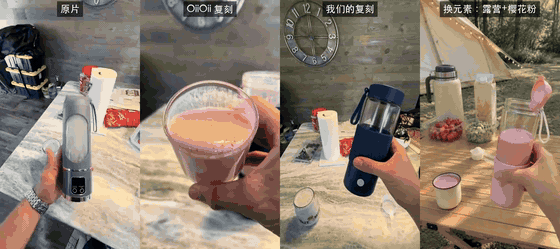
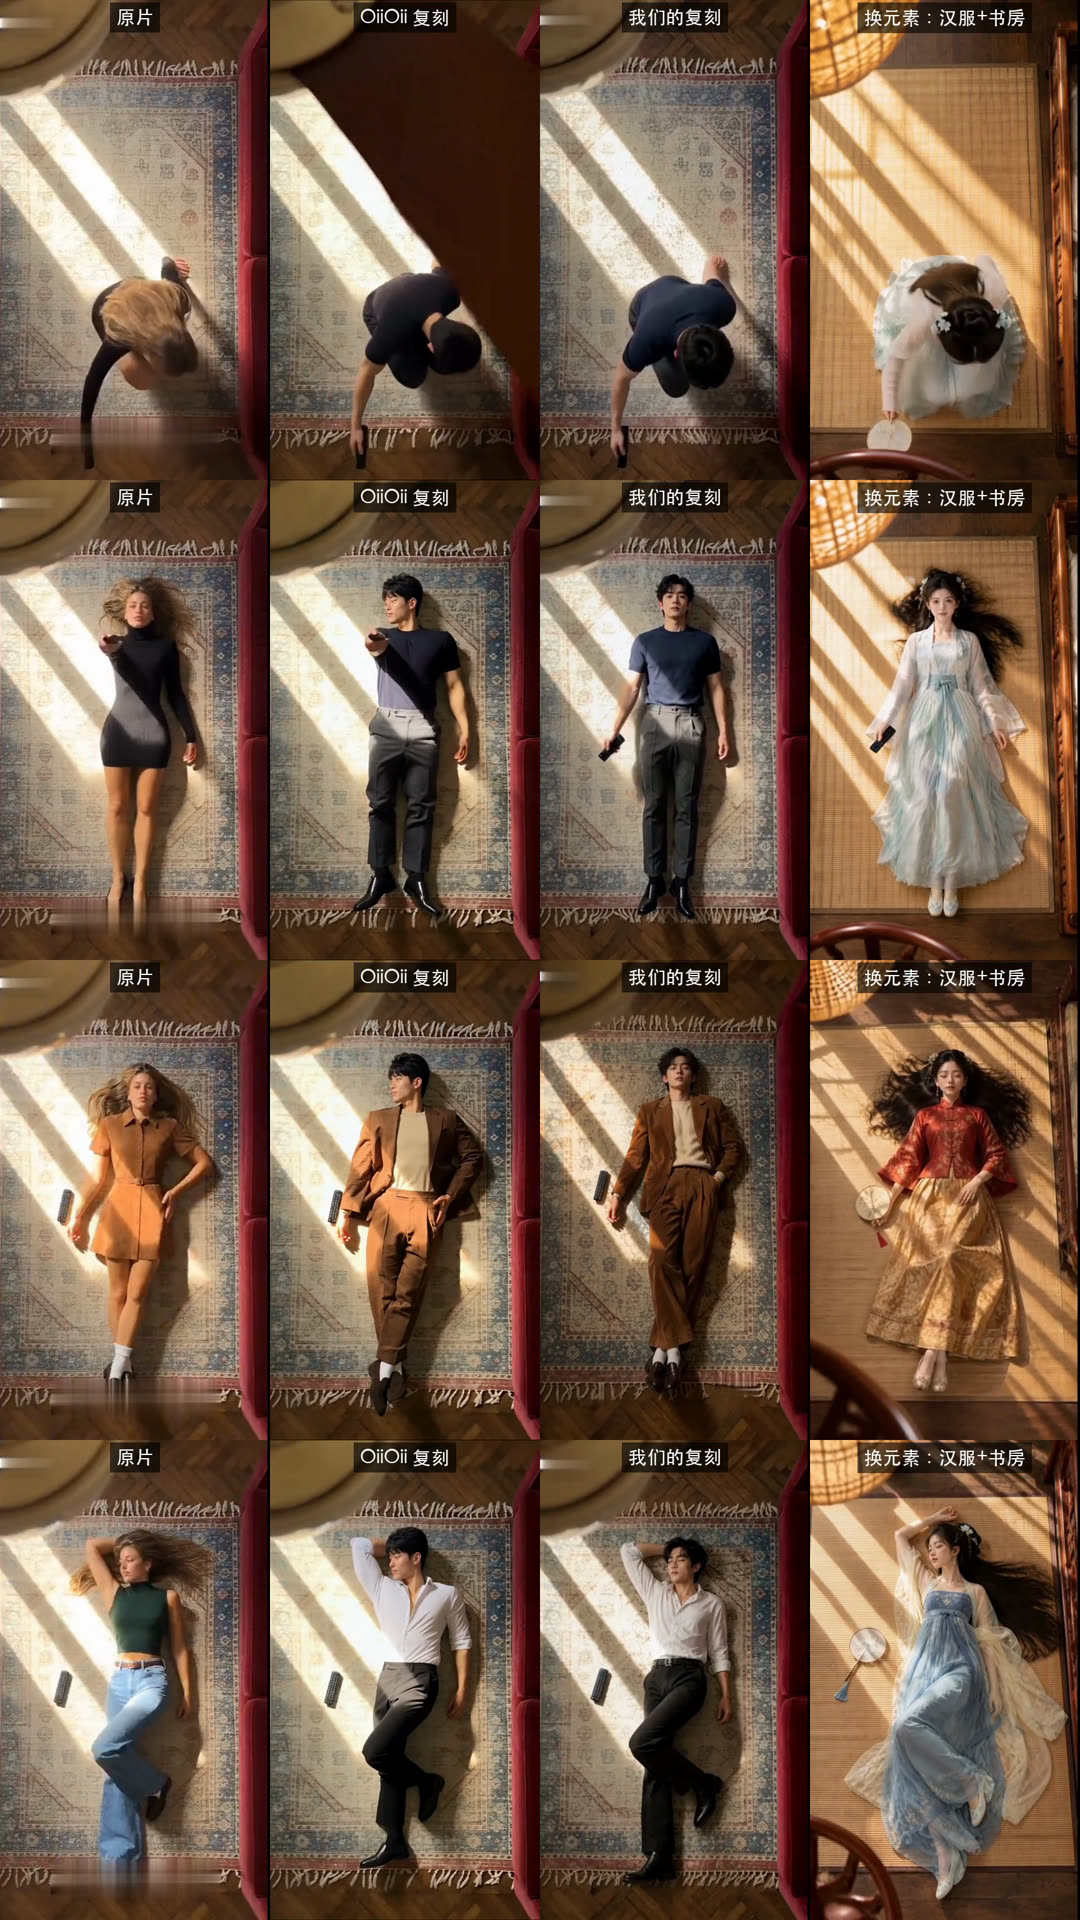
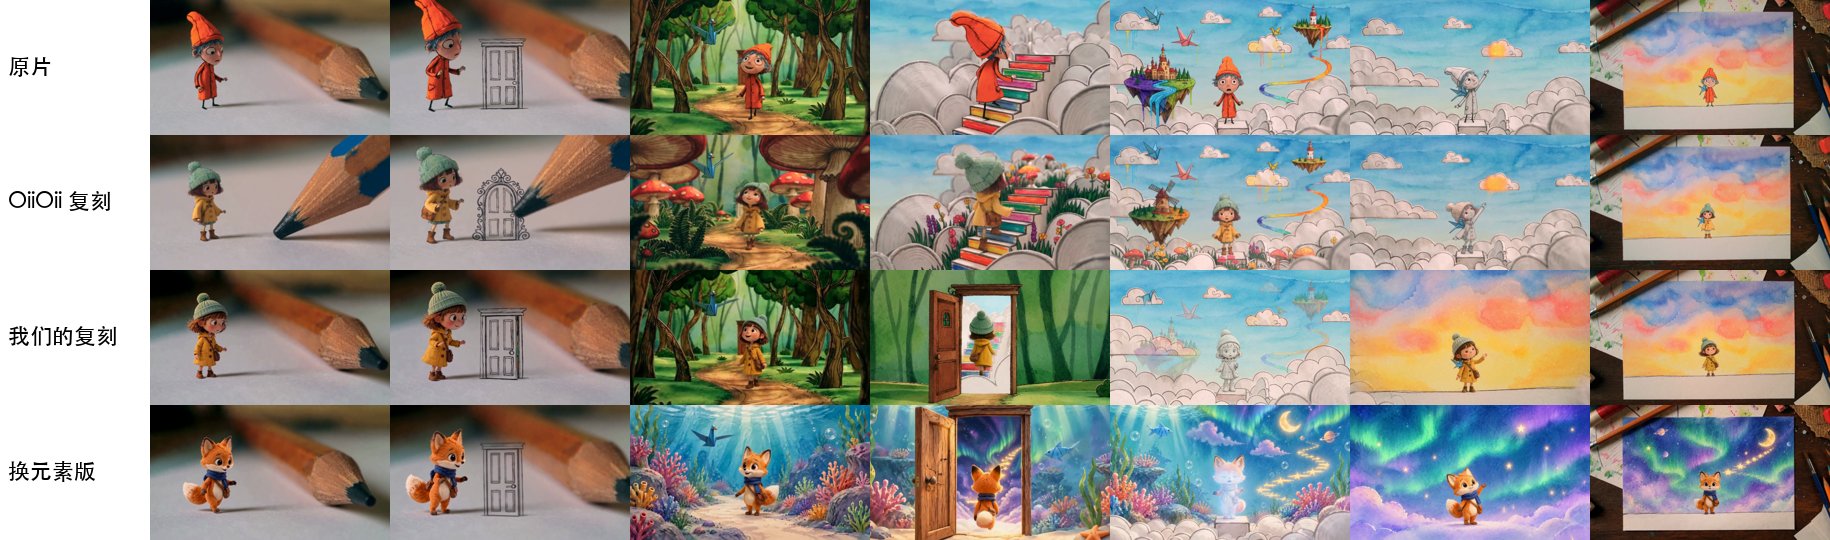
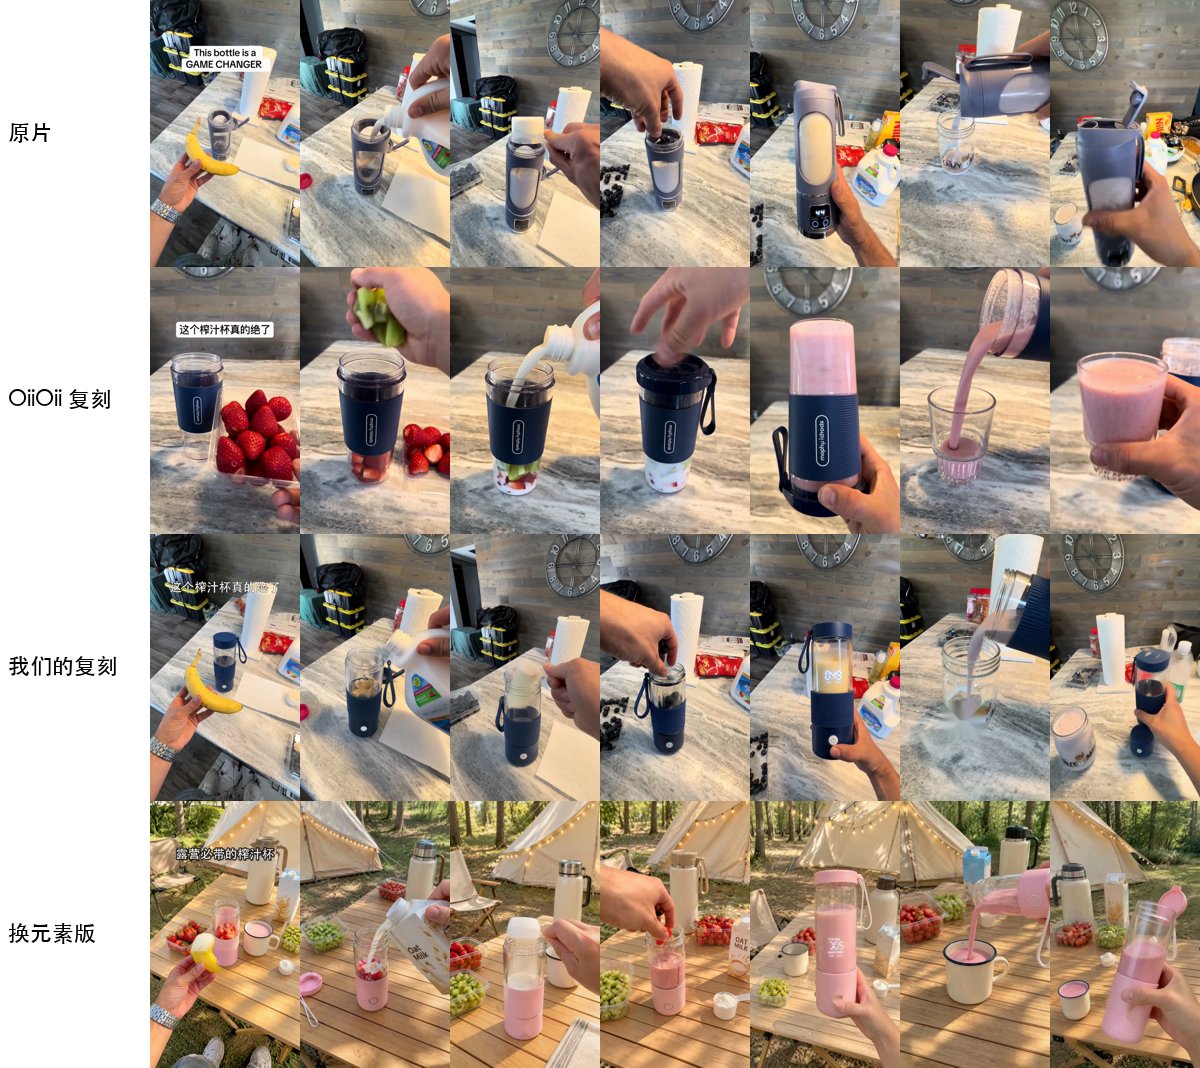
## Remakes Nachdem rea-video ein Video zerlegt hat, erzeugt das Remake-Rezept in [capsule-cinema](https://github.com/JuneYaooo/capsule-cinema) eine neue Version: Kamera, Bewegung, Tempo und Übergänge folgen dem Original, nur die Elemente, die du auswählst, werden ausgetauscht. Diese Ergebnisse wurden mit einem selbst gehosteten MiniMax H3 erzeugt: Der Original-Shot dient als Bewegungsreferenz, und Keyframes mit den ausgetauschten Elementen (gpt-image-2) bestimmen den Look. Unten sind drei Remakes, die OiiOii in seinen WeChat-Artikeln gezeigt hat. Für jedes haben wir zwei Versionen gemacht: denselben Austausch wie OiiOii und eine, die zusätzlich Hauptfigur, Umgebung und Requisiten austauscht. Jedes GIF spielt vier Versionen synchron ab: Original, OiiOii-Remake, unser Remake, Version mit ausgetauschten Elementen.
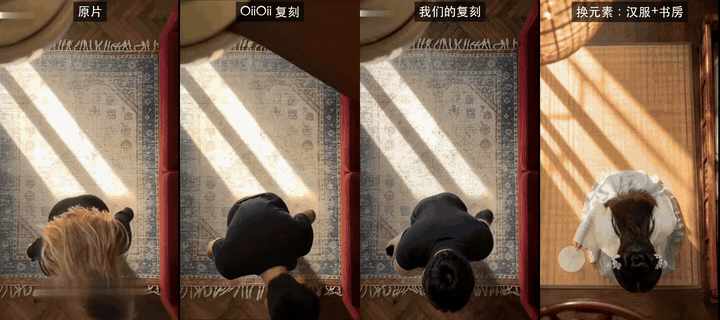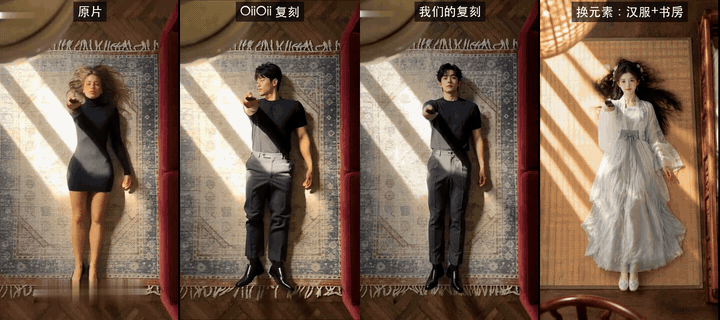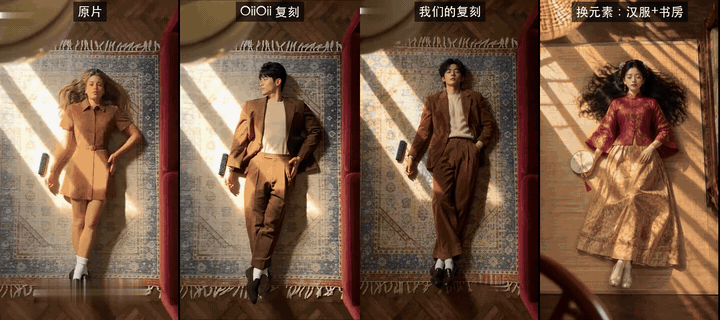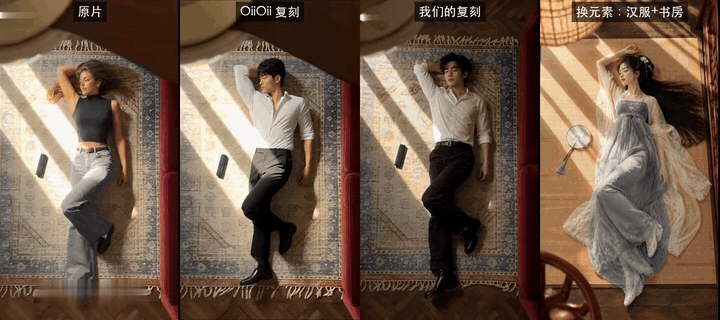
Outfitwechsel von oben · 12 s
Gleicher Austausch: Frau → Mann, drei Outfits → passende Herrenmode. Elementaustausch: ein Mädchen in drei historischen Hanfu-Outfits in einem chinesischen Studierzimmer; die Fernbedienung wird zu einem runden Fächer.

HD-Vergleichsvideo (mit Ton) · Standbilder vom selben Moment
Papier- / Aquarell-Animation · 30 s
Gleicher Austausch: ein neues Mädchen aus Knete als Hauptfigur. Elementaustausch: ein Fuchs; Wald → Korallenriff, Wolken → Sternenhimmel, Sonnenuntergang → Polarlicht.

HD-Vergleichsvideo (mit Ton) · Standbilder vom selben Moment
Produktvideo aus der Hand · 21 s · 11 Shots
Gleicher Austausch: ein eigenes neues Produkt, englischer Sticker → chinesische Bildunterschrift. Elementaustausch: rosa Produkt, Küche → Campingtisch, neue Zutaten.

HD-Vergleichsvideo (mit Ton) · Standbilder vom selben Moment
Die HD-Vergleichsvideos verwenden den Originalton. Die Originale und die OiiOii-Versionen stammen aus den Artikeln und werden nur zum Vergleich gezeigt. ## Genauigkeit Genauigkeit bei der Frage, wie ein Shot entstanden ist, gewichtet nach Shot-Dauer: | | Tuning-Set (15) | Holdout (16) | Neu kodierte WeChat-Videos (10) | |---|---|---|---| | Nur Tools (offline, kostenlos) | 98.3% | 99.6% / 98.9% | 88.6% | | + Vision-Modell (Gemini) | — | 99.6% / 99.8% | 99.6% | | + visuelle Prüfung durch den Agenten | — | 99.6% / 99.8% | 100% | Die beiden Holdout-Werte sind holdout (9 Videos) und holdout2 (7 Videos). Bei Originaldateien reichen die Tools allein meist aus. Von Plattformen heruntergeladene Videos wurden neu komprimiert, was die Rauschspuren tilgt; daher braucht es eine visuelle Prüfung, um wieder über 99 % zu kommen. Die Erkennung echter Assets liegt bei 97–99 %, und alle Shot-Grenzen sind korrekt. Zahlen und wie man sie reproduziert: [eval/RESULTS.md](../eval/RESULTS.md). ## So funktioniert es ![rea-video-Pipeline](../docs/rea-flow_de.svg) 1. Aufteilen: das Video in Shots schneiden und den Ton in Stimme, Musik und Effekte trennen. 2. Belege sammeln: die Frames messen (Frame-Takt, Sensorrauschen, ob sich das ganze Bild wie eine Ebene verschiebt, AIGC-Tags in den Metadaten); die Bilder ansehen (Hände, Text, Physik); hinhören (BPM, Tonart, Gesang oder Sprache). 3. Entscheiden: Harte Belege wie AIGC-Tags und Frame-Takt wiegen schwerer als „sieht aus wie“. Widersprüche werden markiert, damit der Agent sie visuell prüft. 4. Remake planen: Shots danach bündeln, was das Ziel-Videomodell tatsächlich kann, etwa maximale Cliplänge, Unterstützung für mehrere Shots und wie viele Referenzbilder es annimmt. ## FAQ
Was unterscheidet das von Ein-Klick-Remake-Tools wie Hypit? [Hypit](https://github.com/hypit-ai/hypit) nimmt ein Referenzvideo und macht daraus ein neues: Der Agent liest Frame-Raster, um das Original zu verstehen, generiert Material mit den unterstützten Modellen (Seedance, PixVerse, MiniMax, Wan und andere) und rendert Untertitel und Motion Graphics in HTML. Es fragt nicht, wie das Original entstanden ist. Eine Realfilm-Vorlage durchläuft dieselbe Pipeline; es sagt dir nicht, wie viele Kameras im Einsatz waren oder wie ausgeleuchtet wurde. Welche KI-Videos es nachbilden kann, hängt von seinen Modellen ab: kein Kling oder Veo, kein eigener Avatar- oder 3D-Weg und keine KI-Musik – die bringst du selbst mit. Am stärksten ist es bei Talking-Head-, Podcast- und Interview-Videos, die einem Skript folgen, schwächer bei musikgetriebenen Schnitten, Produkt-Motion-Graphics und filmischen Kurzfilmen. rea-video rendert kein Video. Es ermittelt Shot für Shot, ob etwas gefilmt, KI-generiert oder in Code gebaut wurde, und liefert dann für jeden einen Drehplan, Prompts oder einen Code-Ansatz. Für einen schnellen Nachbau ist Hypit schneller. Wer verstehen will, wie das Original gemacht wurde, und es günstig nachbauen will, nimmt rea-video. Beide lassen sich gut kombinieren.
Brauche ich ein videofähiges Modell? Was kostet das? Nein. Der reine Tool-Modus läuft offline, ist kostenlos und bei Originaldateien bereits genau. Für neu komprimierte Plattform-Downloads fügst du ein videofähiges Modell hinzu (Gemini oder Doubao funktionieren beide) oder nutzt einen Agenten, der Bilder sehen kann; du zahlst, was dieser Dienst berechnet. Die automatische Videogenerierung (capsule-cinema) macht zuerst einen kostenlosen Probelauf und ruft kostenpflichtige Modelle erst nach deiner Bestätigung auf.
Kann es das ganze Video automatisch nachbauen? Teilweise. Mit installiertem [capsule-cinema](https://github.com/JuneYaooo/capsule-cinema) werden KI-Shots automatisch generiert und auf die Original-Timeline zurückgesetzt. Realfilm-Shots drehst du nach dem Drehplan; Code-Shots schreibt der Agent als Remotion-Projekt. Siehe [docs/replicate.md](../docs/replicate.md).
Kann ich einfach das Video von jemand anderem neu posten? Nein. rea-video ist dafür da, Struktur, Tempo und Techniken eines Videos zu lernen und es dann mit Material nachzubauen, an dem du die Rechte hast. Verwende nicht das Filmmaterial, die Musik, die Figuren oder das Abbild anderer. Halte dich beim Veröffentlichen an die Plattformregeln und die lokalen Kennzeichnungspflichten für KI-Inhalte.
## Dokumentation - [docs/what-it-detects.md](../docs/what-it-detects.md): alles, was erkannt wird (10 Bildtypen, Kamera, Licht, Grading, Audio) - [docs/replicate.md](../docs/replicate.md): Nachbau anhand des Berichts - [docs/cases.md](../docs/cases.md): Details zu den Fällen - [docs/decompose.md](../docs/decompose.md): Erkennungsregeln - [docs/cli.md](../docs/cli.md): CLI-Nutzung und capsule-cinema-Integration - [rea_video/capabilities/](../rea_video/capabilities/README.md): Fähigkeitstabellen für Video- / Bild- / Audiomodelle, mit denen die Modelle für den Remake-Plan ausgewählt werden - [eval/RESULTS.md](../eval/RESULTS.md): Evaluationsergebnisse Die Dokumentation gibt es vorerst nur auf Chinesisch. ## Community Fragen, Analysen und Remake-Ideen: [GitHub Discussions](https://github.com/JuneYaooo/rea-video/discussions). Chatte mit uns auf [Discord](https://discord.gg/dZj8D3GqWT). Chinesischsprachige finden uns auch auf [linux.do](https://linux.do/). Soll ein Video zerlegt werden? Eröffne ein [Request-Issue](https://github.com/JuneYaooo/rea-video/issues/new?template=request_breakdown.yml) mit dem Link, und wir veröffentlichen das Ergebnis als Fallbeispiel. ## Danksagung Inspiriert von [REA (Reverse Engineer Anything)](https://github.com/morluto/rea): vom Sichtbaren zurückverfolgen, wie es entstanden ist, jede Aussage mit Belegen stützen und durch Messung überprüfen.