# rea-video Haz ingeniería inversa de cualquier vídeo. Vídeos a cámara, tabletop, vídeo con IA, 3D, motion graphics, montajes mixtos: dale cualquiera de ellos,
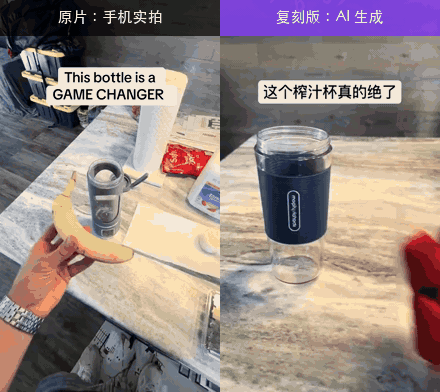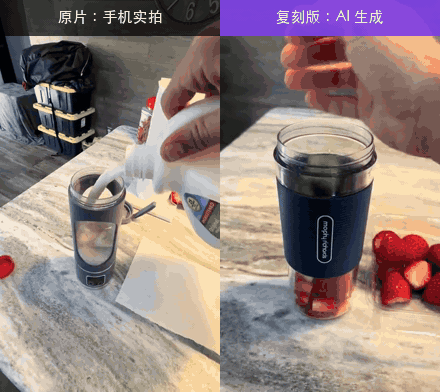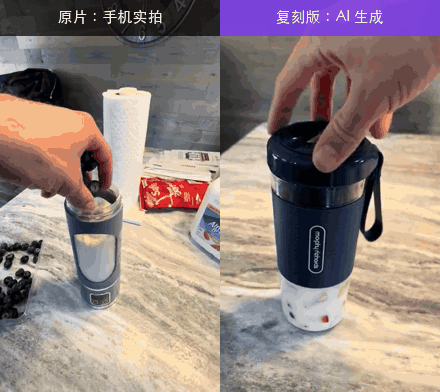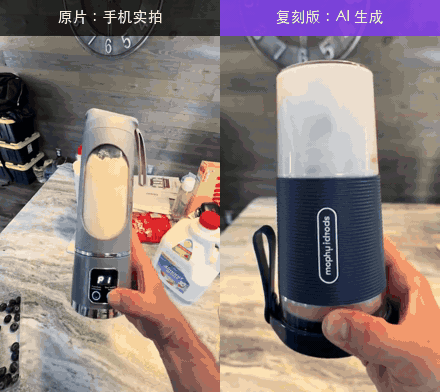
y te explica plano a plano cómo se hicieron la imagen, los textos con estilo, el montaje y el audio, y luego te da un plan para hacerlo tú mismo. [中文](README_zh.md) | [English](../README.md) | [Русский](README_ru.md) | [日本語](README_ja.md) | [한국어](README_ko.md) | Español | [Português](README_pt.md) | [Français](README_fr.md) | [Deutsch](README_de.md) [![Stars](https://img.shields.io/github/stars/JuneYaooo/rea-video?style=flat)](https://github.com/JuneYaooo/rea-video/stargazers) ![Python](https://img.shields.io/badge/python-%E2%89%A53.10-blue) ![Agent](https://img.shields.io/badge/runs%20in-Claude%20Code%20%7C%20Codex-8A2BE2) Izquierda: original de TikTok grabado con un móvil; derecha: el remake con IA que hizo otra persona con un producto distinto Izquierda: un anuncio de TikTok grabado con un móvil. Derecha: el remake con IA que hizo otra persona, cambiando el producto.
Veredicto de rea-video: el de la izquierda es todo imagen real, un decorado y dos posiciones de cámara; el de la derecha es todo generado por IA, y sus 8 planos se pueden producir en 3 generaciones.
> Los informes se generan en chino o en inglés (tu agente pasa `--lang`). La documentación detallada está en chino por ahora; tu agente la lee y te responde en tu idioma. Los seis informes de ejemplo de abajo están en inglés, así puedes ver cómo es un informe sin instalar nada. ## Qué puede analizar | Tipo de vídeo | Ejemplos | Qué obtienes | |---|---|---| | Imagen real | Vídeo a cámara, tabletop, demo de producto en mano, vlog, visita a tienda | Configuraciones de rodaje y posiciones de cámara, encuadre, movimientos de cámara, iluminación (12 esquemas con lista de equipo), etalonaje | | Vídeo con IA | Texto/imagen a vídeo, microdramas con IA, videoclips con IA | Evidencias, un prompt reconstruido por plano, cómo agrupar en generaciones y qué modelo usar | | Avatar | Un retrato animado por audio, sincronización labial | Qué planos son de avatar, qué retrato y qué audio necesitas | | 3D / animación | Vídeos explicativos en Blender / C4D, animación de producto, animación 2D, stop-motion | Si generarlo con un modelo de vídeo o renderizarlo a partir de código 3D | | Código / plantilla | Tipografía cinética, demos de UI, gráficos, tarjetas tipo diapositiva | Texto, maquetación y tiempos de animación, listos para reconstruir como proyecto de Remotion | | Grabación de pantalla | Tutoriales de software, demos web | Qué partes son material real que tendrás que grabar tú | | Mixto / montajes | Personajes de IA + UI en código + captura de pantalla real; imagen real con retoques de IA | Cada plano se evalúa por separado y luego se vuelve a montar sobre la línea de tiempo original | Además de cómo se hizo la imagen, cada vídeo incluye: - Subtítulos y textos con estilo: inicio y fin de cada línea (exporta a SRT / ASS), además de color, contorno y cómo entra el texto - Stickers, emojis, picture-in-picture: dónde aparecen y cuánto duran - Montaje: dónde están los cortes, a qué ritmo, si van a tempo - Audio: voz humana o de IA, música de IA o de biblioteca y su BPM, dónde cae cada efecto de sonido - Material que tendrás que aportar tú: grabaciones de pantalla, capturas, fotos de producto ## Inicio rápido rea-video está pensado para agentes de IA. En Claude Code, Codex o cualquier agente que pueda ejecutar comandos, di: ```text Instala https://github.com/JuneYaooo/rea-video y luego analiza este vídeo: /path/to/video.mp4 ``` El agente instala la CLI, aprende el flujo de trabajo y lo ejecuta todo. Necesitas ffmpeg y Python 3.10+.
Instalación manual ```bash brew install ffmpeg # sudo apt install ffmpeg git clone https://github.com/JuneYaooo/rea-video && cd rea-video bash scripts/install_skill.sh # instala la CLI (pip, o pipx / .venv local) y enlaza el skill rea-video --help ```
Obtienes: - un resumen de una línea, p. ej. "41 % vídeo con IA + 59 % UI en código, 8 s de grabación de pantalla real, música de biblioteca a 122 BPM" - un plan de remake, dividido en qué grabar, qué generar y qué programar - un `report.html` completo con fotogramas por plano, evidencias, prompts, notas de cámara e iluminación, y el desglose del audio Añade un modelo que entienda vídeo (sirven tanto Gemini como Doubao): dale al agente el endpoint y la clave. Así distingue mejor entre imagen real, IA y 3D, y escribe un prompt reconstruido para cada plano. Sin él también funciona; si tu agente puede ver imágenes, revisará él mismo los planos dudosos. ## Ejemplos

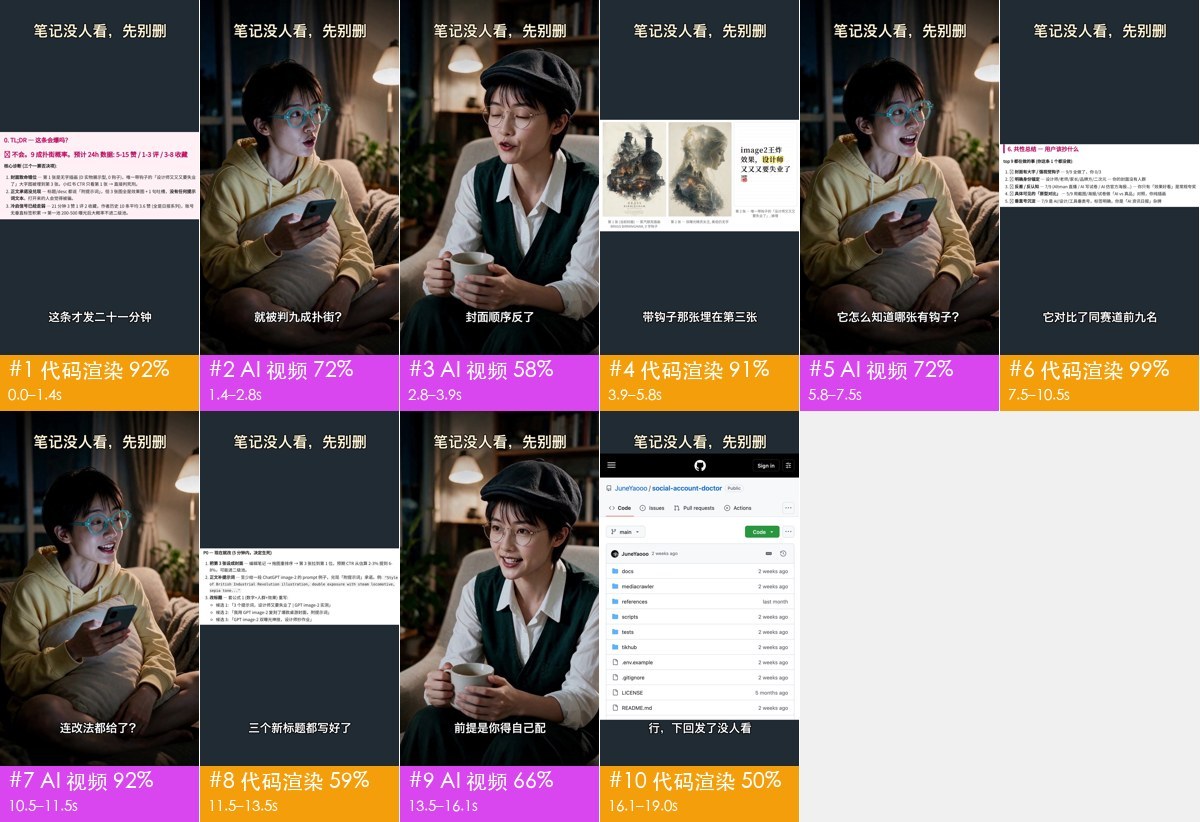
Clip mixto · 19 s · 10 planos
Personajes de IA conversando + UI hecha en código + 8 s de grabación de pantalla real. Los 5 planos de diálogo están separados por segmentos de UI, pero comparten decorado, así que basta una generación para todos.
Vídeo · Informe

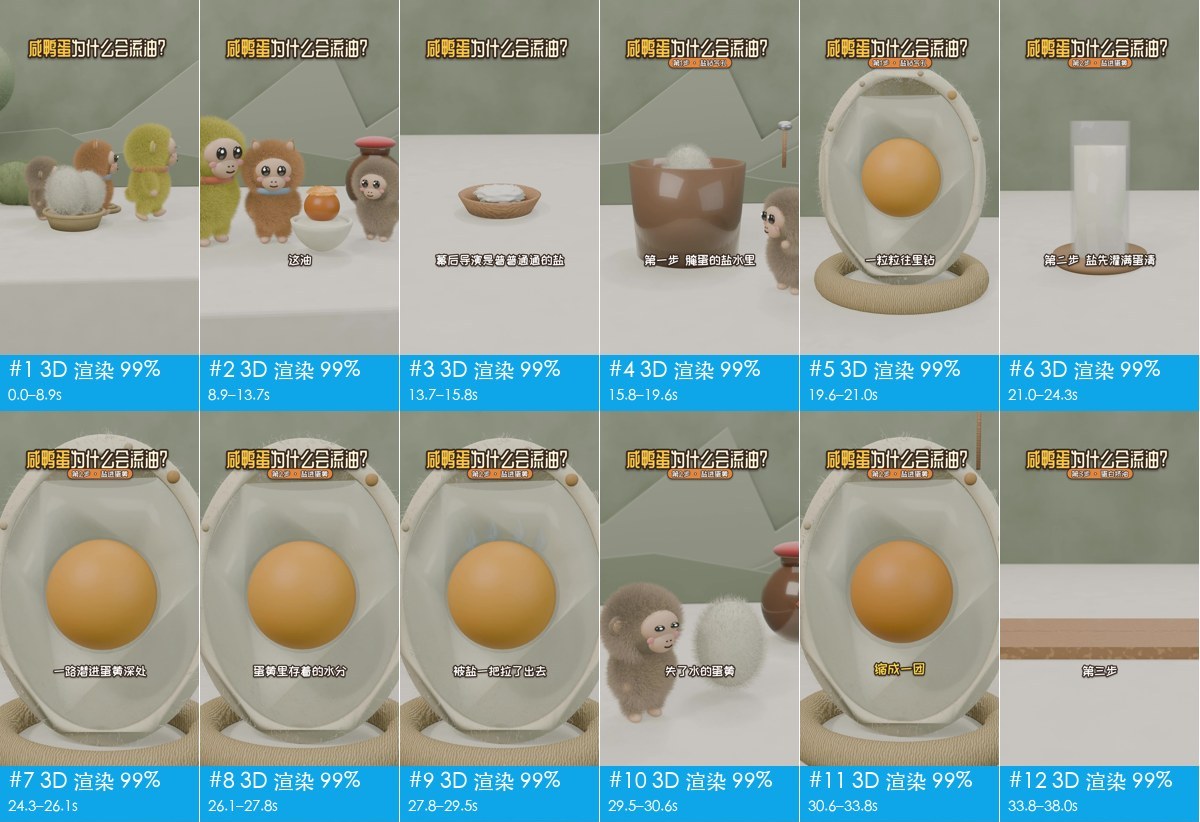
Vídeo explicativo en 3D · 67 s · 21 planos
Todo en 3D, narración con IA. Se puede hacer en 10 generaciones de vídeo, o pedirle a un LLM que escriba código de Blender / Three.js.
Vídeo · Informe

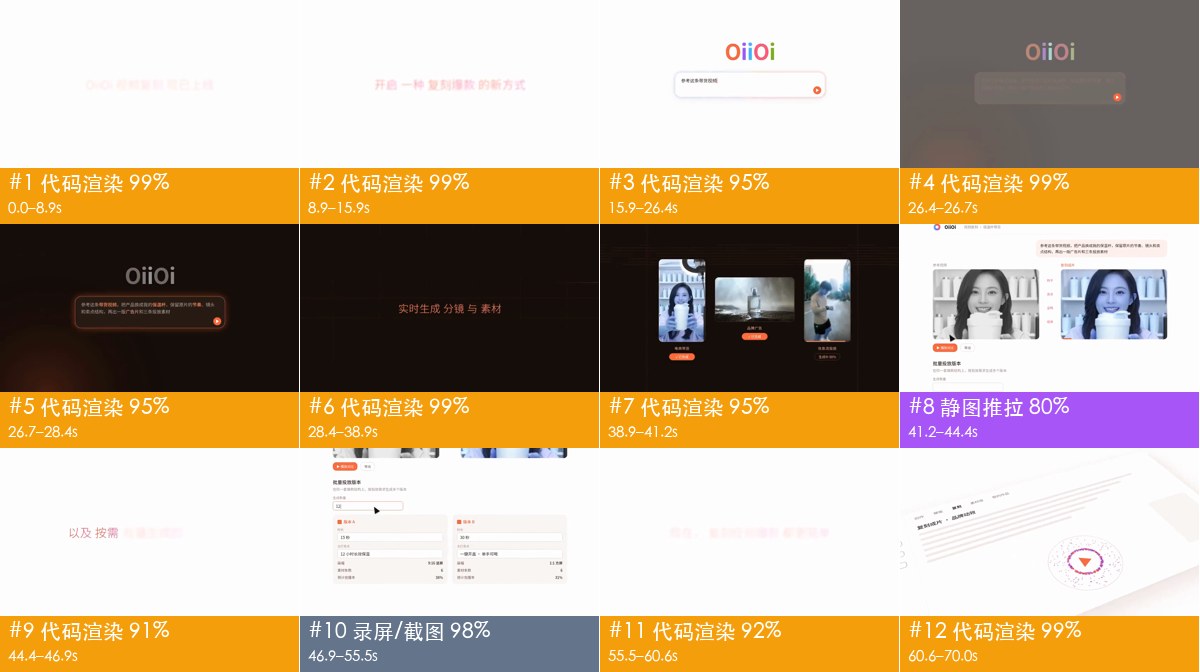
Vídeo promocional de producto · 70 s · 12 planos
83 % motion graphics generados por código, 12 % grabación de pantalla. No hace falta modelo de vídeo; basta un proyecto de Remotion.
Vídeo · Informe

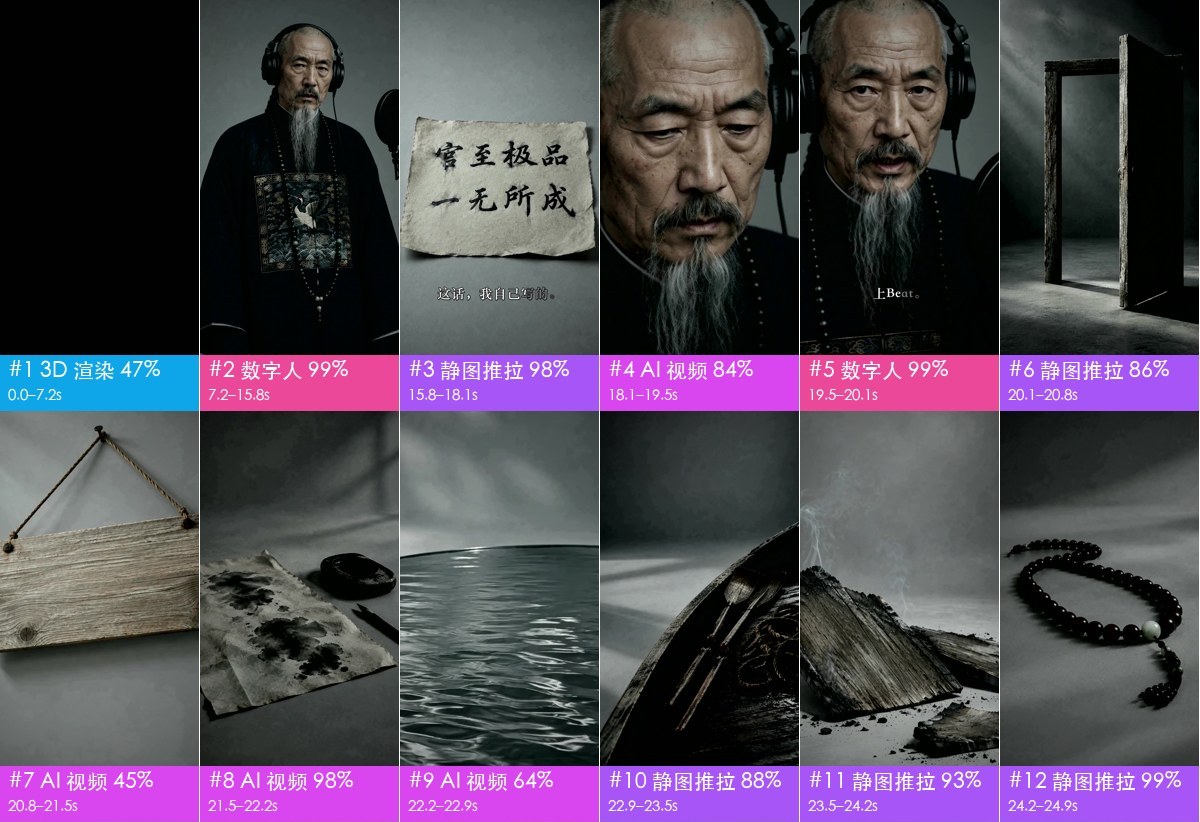
Videoclip con IA · 165 s · 86 planos
Identifica correctamente la canción como generada por IA (se hizo con Suno). El modelo de visión catalogó algunos planos como "drama de imagen real"; el agente detectó caracteres chinos falsos en un pergamino y los dictaminó como IA.
Vídeo · Informe

Unboxing con imagen real · 72 s · 29 planos
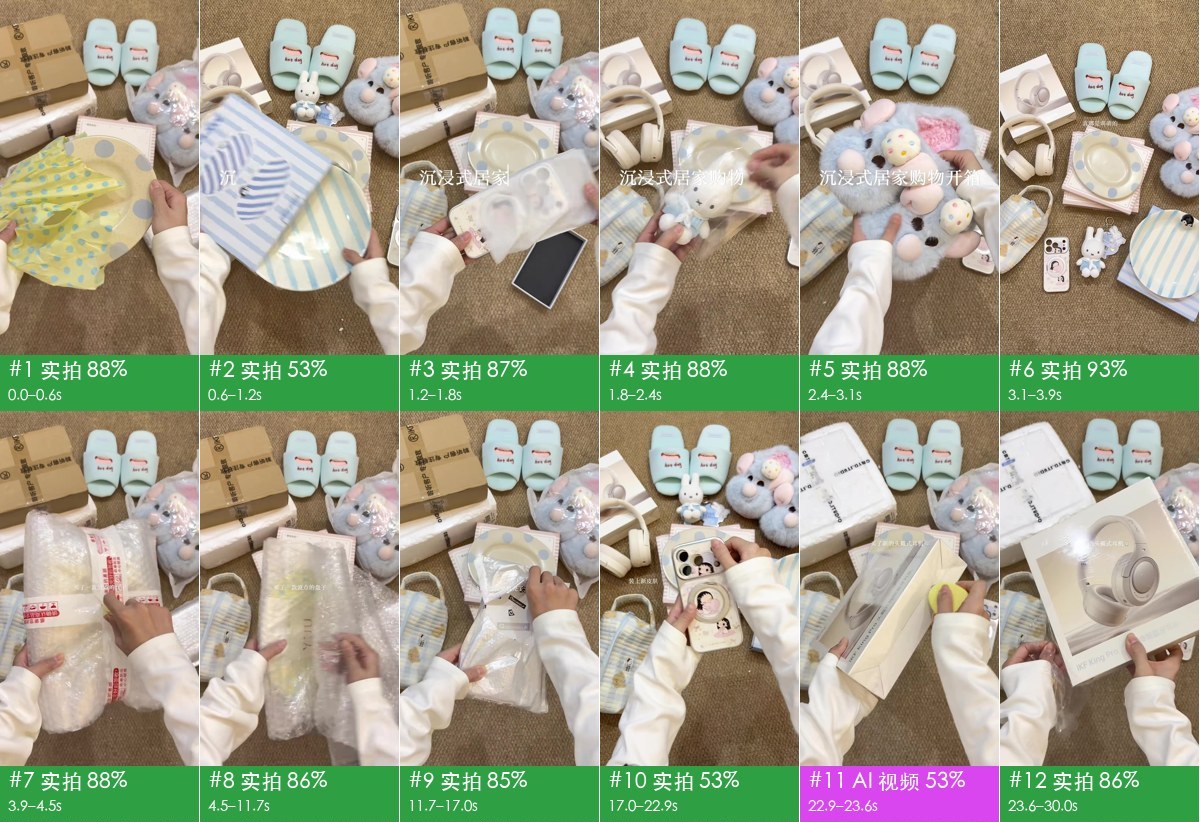
Todo imagen real: un soporte cenital para el móvil, una alfombra, una sola posición de cámara, sin voz en off, sonido ambiente más música de fondo de biblioteca. Tras la recompresión de la plataforma, la herramienta offline marcó un 35 % como IA; la revisión del agente lo dejó en un 97 % de imagen real.
Vídeo · Informe

Híbrido de IA y persona real · 58 s · 21 planos
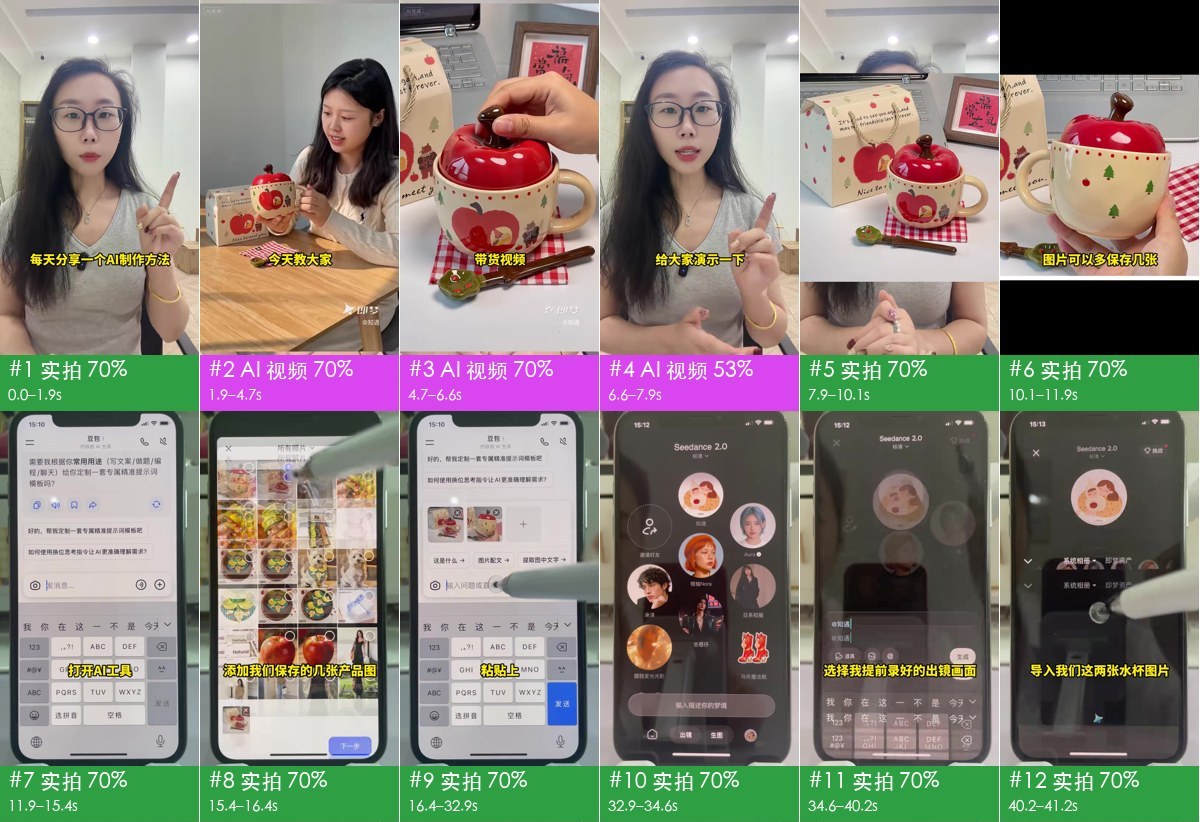
75 % real (vídeo a cámara + grabación de la pantalla de un móvil) y 25 % IA: la creadora le dio a Jimeng un clip suyo a cámara y dos fotos del producto para generar un segmento de producto "con persona real". La parte de IA se detectó por la marca de agua de Jimeng y el texto deformado de la caja de regalo.
Vídeo · Informe
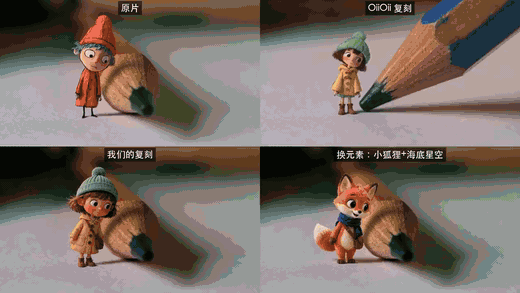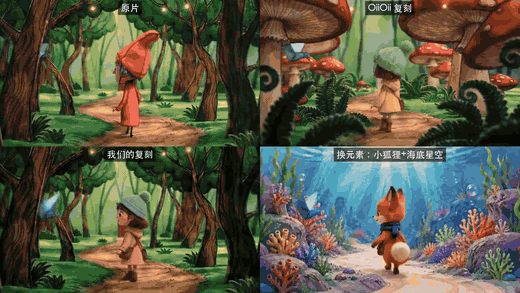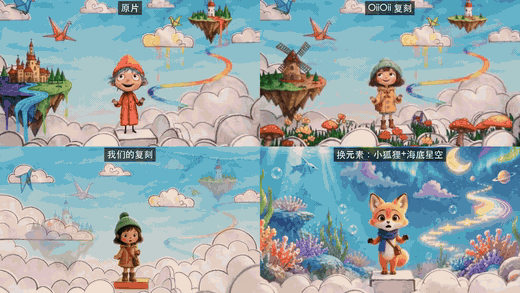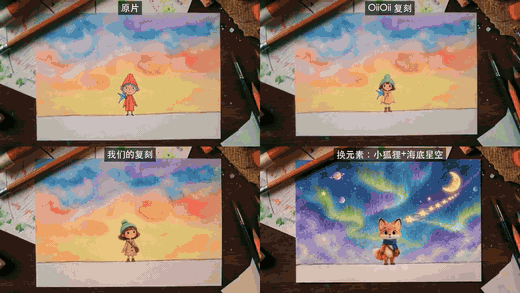
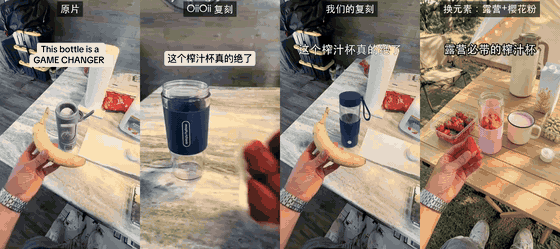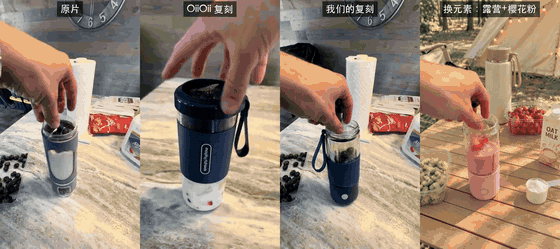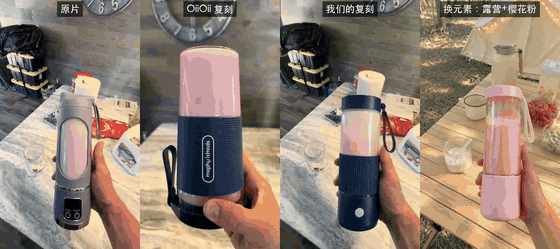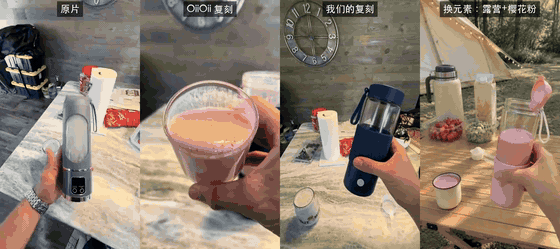
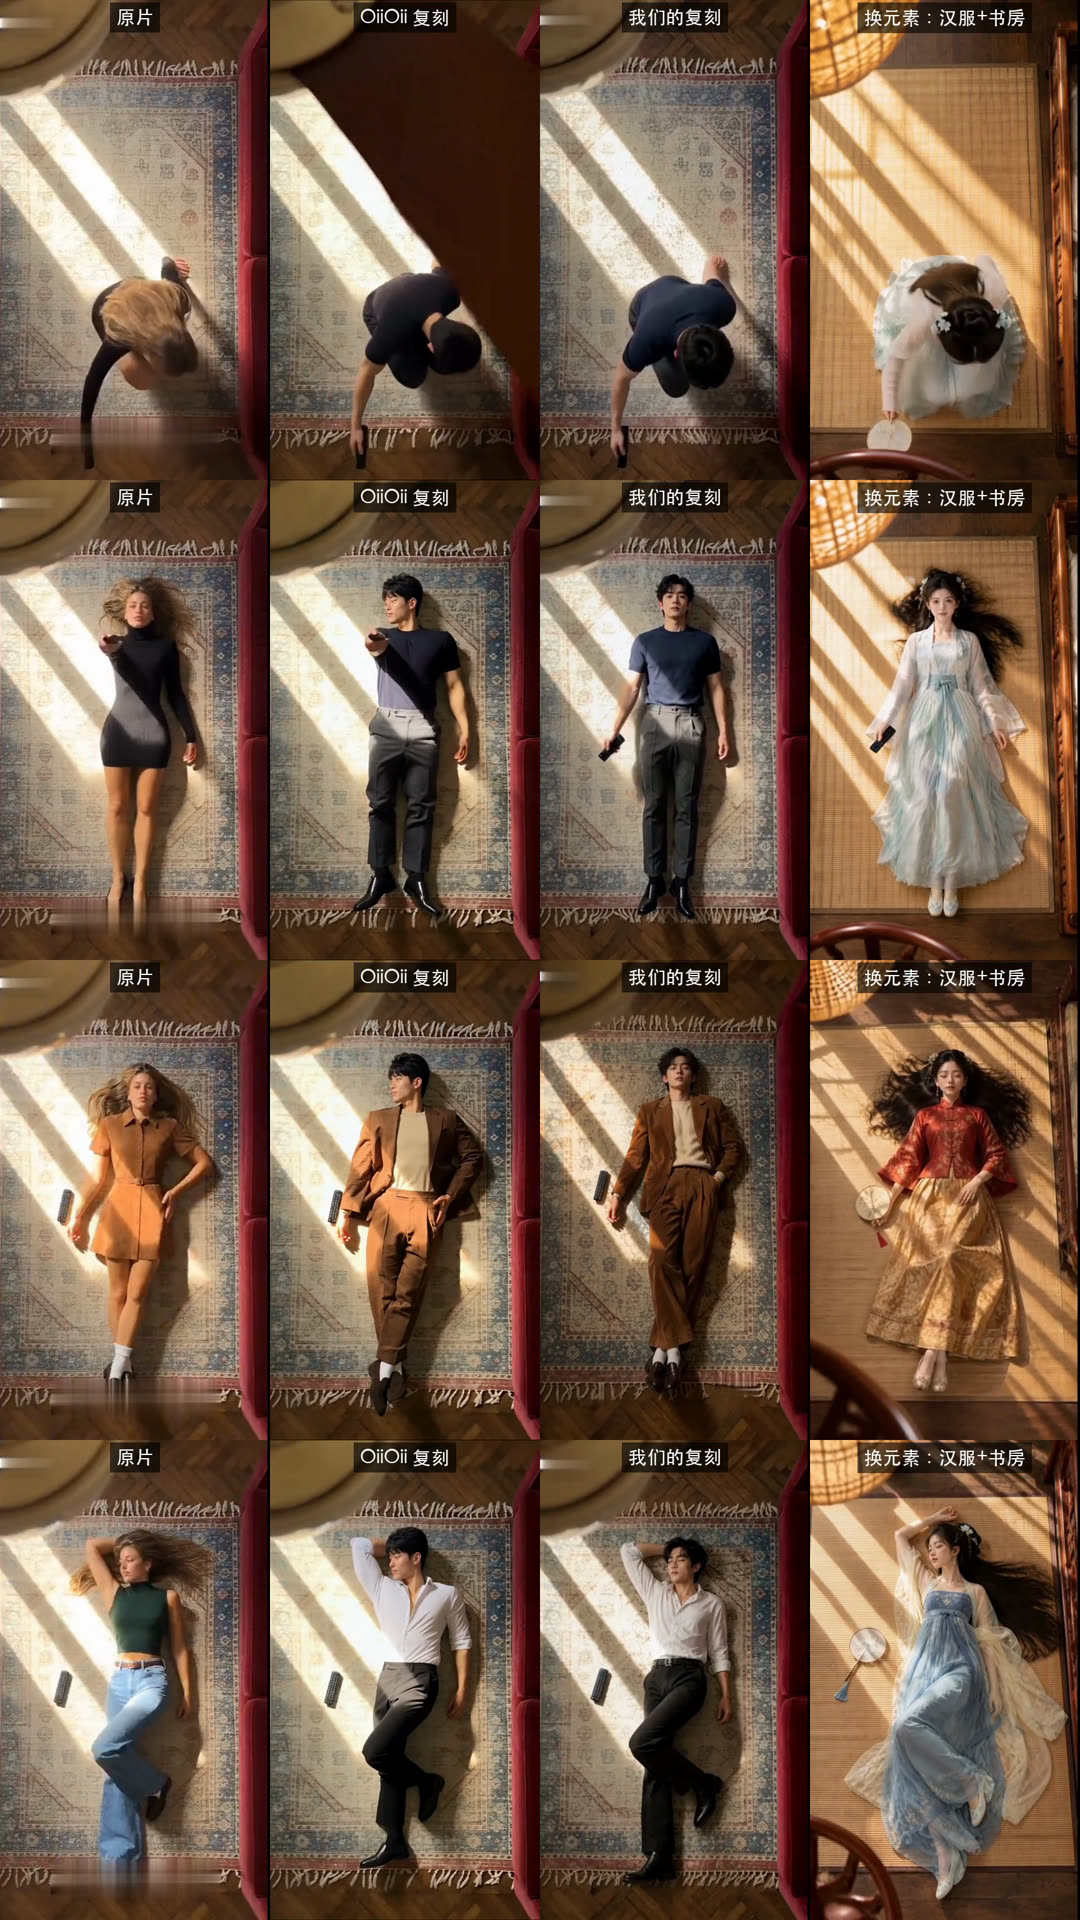
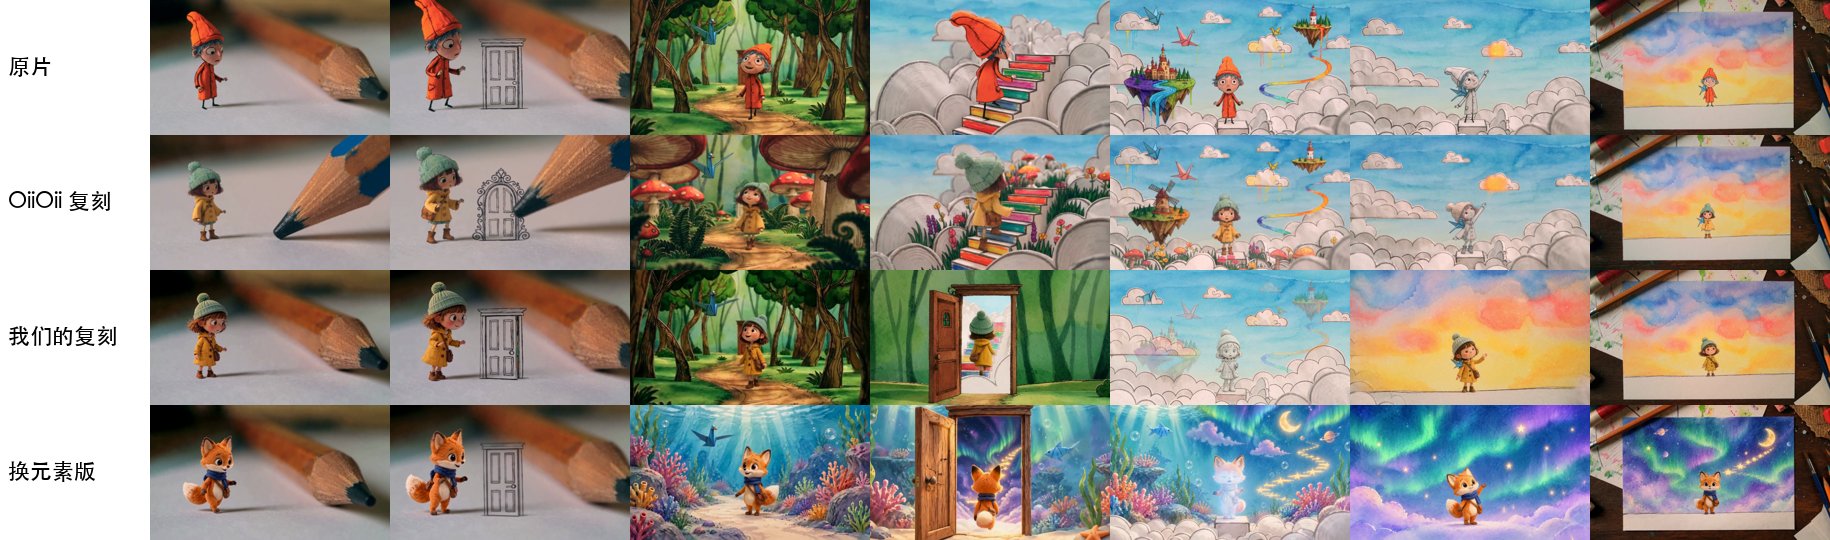
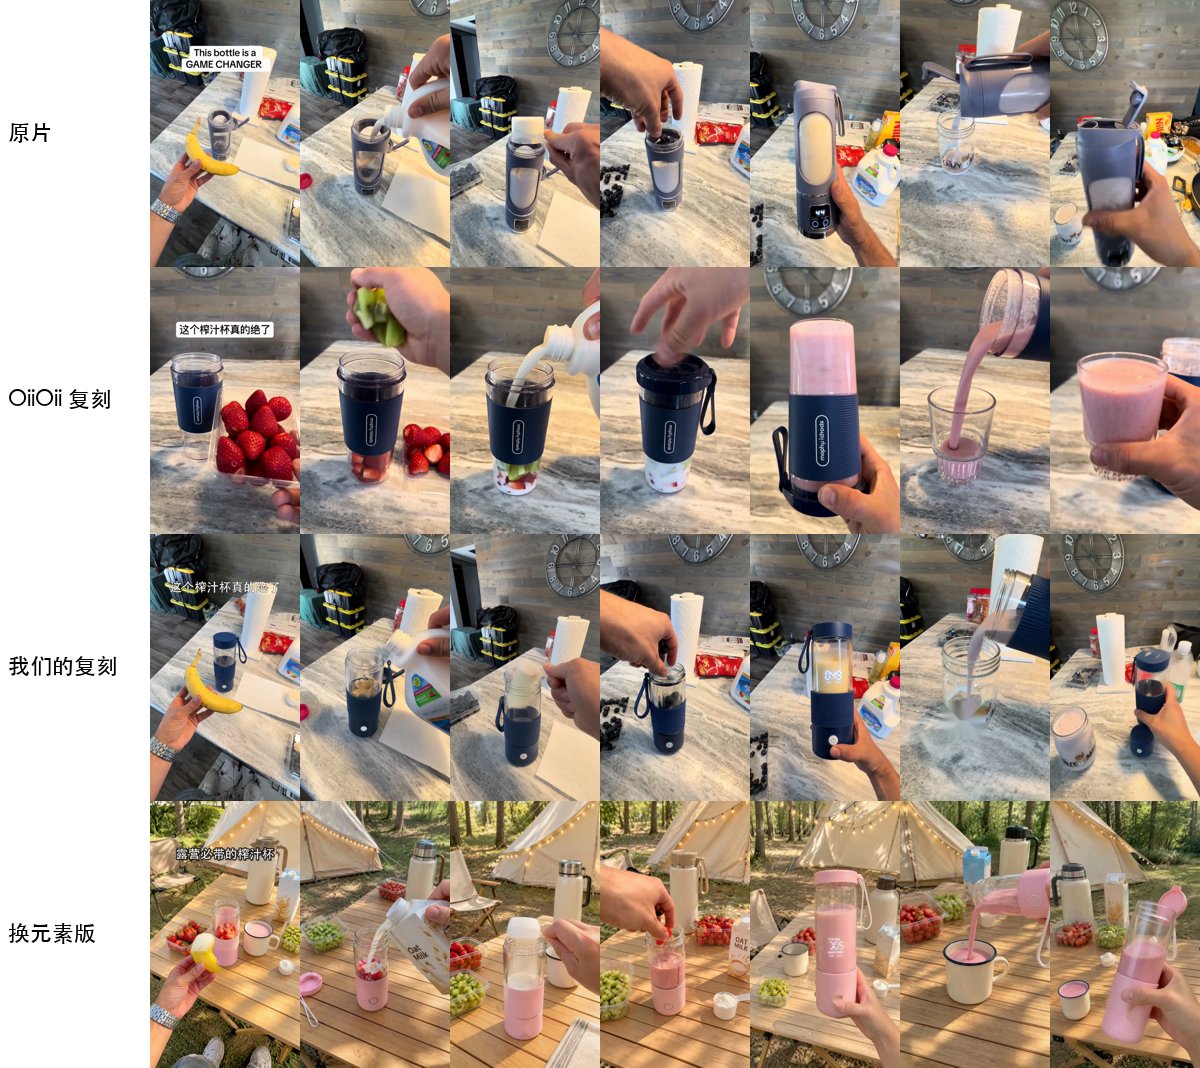
## Remakes Después de que rea-video analice un vídeo, la receta de remake de [capsule-cinema](https://github.com/JuneYaooo/capsule-cinema) genera una versión nueva: la cámara, el movimiento, el ritmo y las transiciones siguen al original, y solo se cambian los elementos que elijas. Estos resultados se generaron con un MiniMax H3 autoalojado: el plano original sirve de referencia de movimiento, y los fotogramas clave con los elementos cambiados (gpt-image-2) definen el aspecto. Abajo hay tres remakes que OiiOii mostró en sus artículos de WeChat. De cada uno hicimos dos versiones: el mismo cambio que OiiOii, y otra que además cambia el protagonista, el escenario y el atrezo. Cada GIF reproduce cuatro versiones sincronizadas: original, remake de OiiOii, nuestro remake y versión con elementos cambiados.
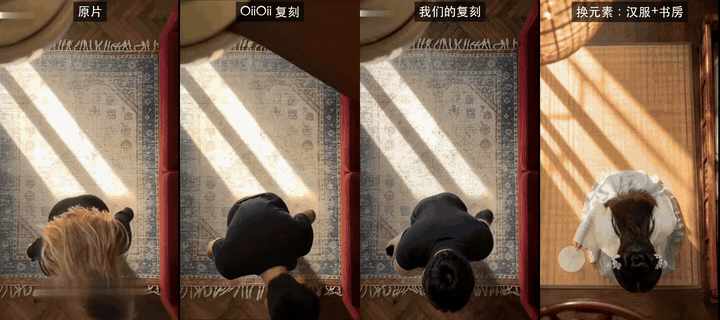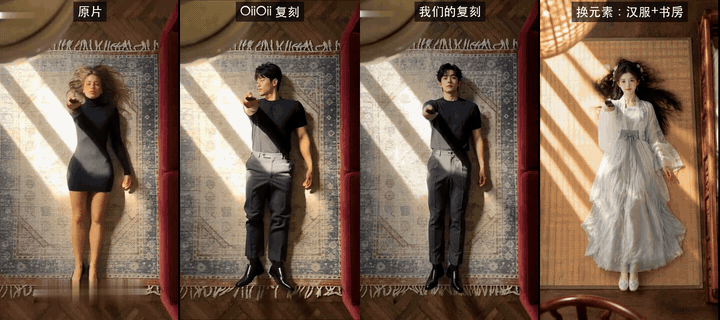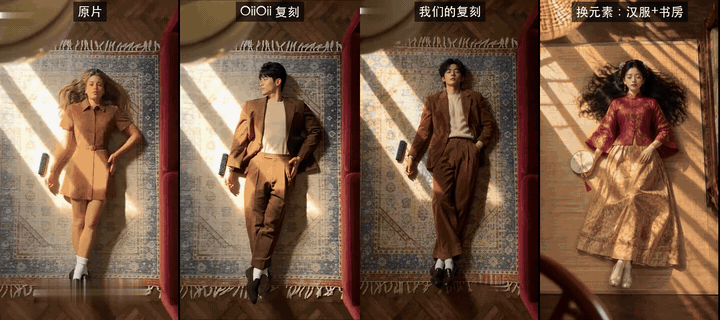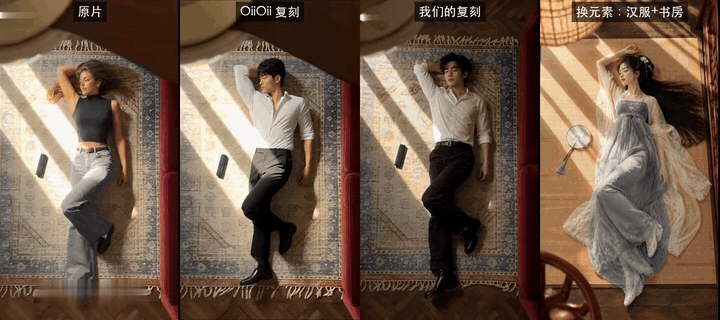
Cambio de ropa en cenital · 12 s
Mismo cambio: mujer → hombre, tres conjuntos → ropa de hombre equivalente. Cambio de elementos: una chica con tres trajes históricos Hanfu en un estudio chino; el mando a distancia pasa a ser un abanico redondo.

Vídeo comparativo en HD (con audio) · fotogramas del mismo instante
Animación de papel / acuarela · 30 s
Mismo cambio: una nueva chica de plastilina como protagonista. Cambio de elementos: un zorro; bosque → arrecife de coral, nubes → cielo estrellado, atardecer → aurora.

Vídeo comparativo en HD (con audio) · fotogramas del mismo instante
Vídeo de producto en mano · 21 s · 11 planos
Mismo cambio: un producto nuevo original, sticker en inglés → subtítulo en chino. Cambio de elementos: producto rosa, cocina → mesa de camping, ingredientes nuevos.

Vídeo comparativo en HD (con audio) · fotogramas del mismo instante
Los vídeos comparativos en HD usan el audio original. Los originales y las versiones de OiiOii proceden de los artículos y se muestran solo a efectos de comparación. ## Precisión Precisión al determinar cómo se hizo cada plano, ponderada por duración: | | Conjunto de ajuste (15) | Holdout (16) | Vídeos de WeChat recodificados (10) | |---|---|---|---| | Solo herramientas (offline, gratis) | 98.3% | 99.6% / 98.9% | 88.6% | | + modelo de visión (Gemini) | — | 99.6% / 99.8% | 99.6% | | + revisión visual del agente | — | 99.6% / 99.8% | 100% | Las dos cifras de holdout corresponden a holdout (9 vídeos) y holdout2 (7 vídeos). Con archivos originales, las herramientas solas suelen bastar. Los vídeos descargados de plataformas se han recomprimido, lo que borra la evidencia del ruido, así que hace falta una revisión visual para volver a superar el 99 %. La detección de material real está entre el 97 y el 99 %, y los límites de plano son todos correctos. Cifras y cómo reproducirlas: [eval/RESULTS.md](../eval/RESULTS.md). ## Cómo funciona ![Pipeline de rea-video](../docs/rea-flow_es.svg) 1. Dividir: corta el vídeo en planos y separa el audio en voz, música y efectos. 2. Reunir evidencias: mide los fotogramas (cadencia de fotogramas, ruido del sensor, si toda la imagen se desplaza como un único plano, etiquetas AIGC en los metadatos); mira las imágenes (manos, texto, física); escucha (BPM, tonalidad, canto o habla). 3. Decidir: la evidencia dura, como las etiquetas AIGC o la cadencia de fotogramas, pesa más que el "parece que". Los conflictos se marcan para que el agente los revise visualmente. 4. Planificar el remake: agrupa los planos según lo que el modelo de vídeo de destino puede hacer de verdad, como la duración máxima del clip, si admite varios planos y cuántas imágenes de referencia acepta. ## Preguntas frecuentes
¿En qué se diferencia de herramientas de remake con un clic como Hypit? [Hypit](https://github.com/hypit-ai/hypit) toma un vídeo de referencia y crea uno nuevo: el agente lee cuadrículas de fotogramas para entender el original, genera imágenes con los modelos que admite (Seedance, PixVerse, MiniMax, Wan y otros) y renderiza subtítulos y motion graphics en HTML. No se pregunta cómo se hizo el original. Un vídeo de imagen real pasa por el mismo pipeline; no te dirá cuántas cámaras se usaron ni cómo se iluminó. El vídeo con IA que puede igualar depende de los modelos que tiene: no hay Kling ni Veo, ni una vía dedicada para avatares o 3D, ni música con IA: la pones tú. Donde más destaca es en vídeos a cámara, podcasts y entrevistas que siguen un guion, y flojea en montajes guiados por la música, motion graphics de producto y cortos cinematográficos. rea-video no renderiza ningún vídeo. Determina plano a plano si algo se grabó, se generó con IA o se construyó con código, y luego da para cada uno un plan de rodaje, prompts o un enfoque en código. Para un parecido rápido, Hypit es más rápido. Para entender cómo se hizo el original y rehacerlo con poco presupuesto, usa rea-video. Funcionan bien juntos.
¿Necesito un modelo que entienda vídeo? ¿Cuánto cuesta? No. El modo solo herramientas funciona offline, es gratis y ya es preciso con archivos originales. Para descargas recomprimidas de plataformas, añade un modelo que entienda vídeo (sirven tanto Gemini como Doubao) o usa un agente que pueda ver imágenes; pagas lo que cobre ese servicio. La generación automática de vídeo (capsule-cinema) hace primero una prueba en seco gratuita y solo llama a modelos de pago después de que confirmes.
¿Puede rehacer el vídeo entero automáticamente? En parte. Con [capsule-cinema](https://github.com/JuneYaooo/capsule-cinema) instalado, los planos de IA se generan y se colocan automáticamente en la línea de tiempo original. Los planos de imagen real los grabas tú siguiendo el plan de rodaje; los planos de código los escribe el agente como proyecto de Remotion. Consulta [docs/replicate.md](../docs/replicate.md).
¿Puedo simplemente volver a publicar el vídeo de otra persona? No. rea-video sirve para aprender la estructura, el ritmo y las técnicas de un vídeo, y luego rehacerlo con material sobre el que tengas derechos. No reutilices imágenes, música, personajes ni la imagen de otras personas. Al publicar, respeta las normas de la plataforma y los requisitos locales de etiquetado de contenido generado por IA.
## Documentación - [docs/what-it-detects.md](../docs/what-it-detects.md): todo lo que detecta (10 tipos visuales, cámara, iluminación, etalonaje, audio) - [docs/replicate.md](../docs/replicate.md): cómo hacer el remake a partir del informe - [docs/cases.md](../docs/cases.md): detalles de los casos - [docs/decompose.md](../docs/decompose.md): reglas de detección - [docs/cli.md](../docs/cli.md): uso de la CLI e integración con capsule-cinema - [rea_video/capabilities/](../rea_video/capabilities/README.md): tablas de capacidades de modelos de vídeo / imagen / audio, usadas para elegir modelos en el plan de remake - [eval/RESULTS.md](../eval/RESULTS.md): resultados de la evaluación La documentación está en chino por ahora. ## Comunidad Preguntas, análisis e ideas de remake: [GitHub Discussions](https://github.com/JuneYaooo/rea-video/discussions). También charlamos en [Discord](https://discord.gg/dZj8D3GqWT). Quienes hablan chino también pueden encontrarnos en [linux.do](https://linux.do/). ¿Quieres que analicemos un vídeo? Abre una [issue de solicitud](https://github.com/JuneYaooo/rea-video/issues/new?template=request_breakdown.yml) con el enlace y publicaremos el resultado como caso. ## Créditos Inspirado en [REA (Reverse Engineer Anything)](https://github.com/morluto/rea): rastrear desde lo que ves hasta cómo se hizo, respaldar cada afirmación con evidencias y verificar midiendo.