# rea-video 어떤 영상이든 역설계합니다. 토킹헤드, 테이블탑, AI 영상, 3D, 모션 그래픽, 혼합 편집 영상 등 무엇이든 넣으면,
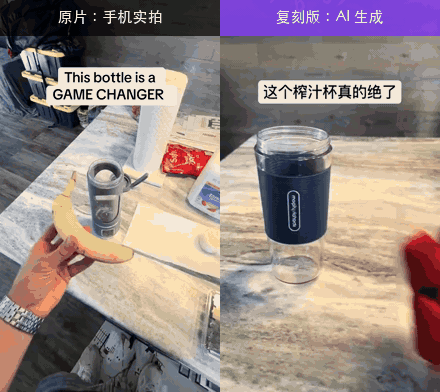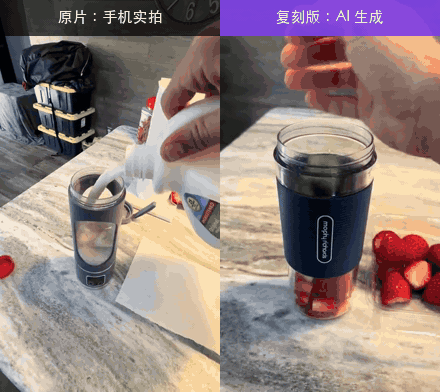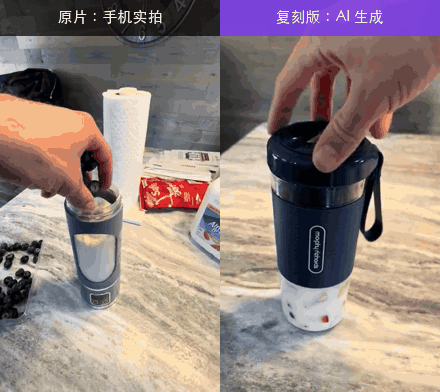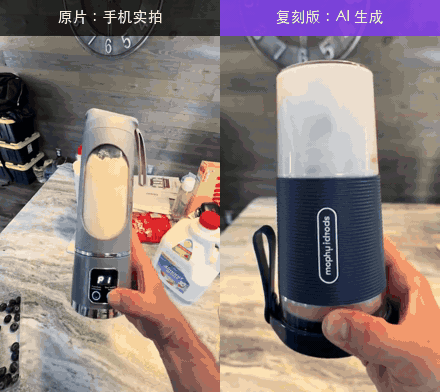
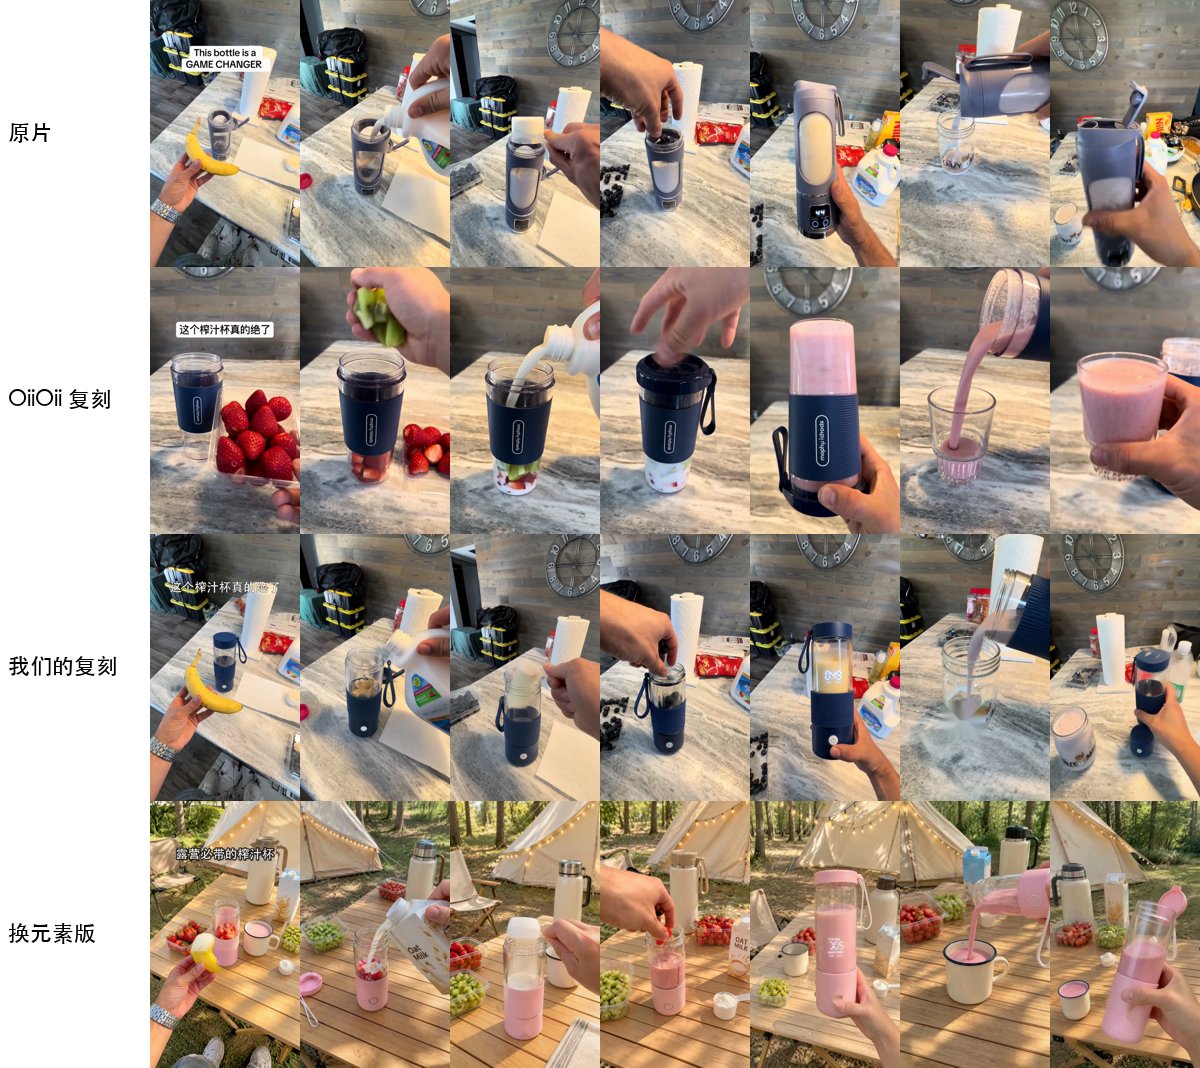
화면, 스타일 텍스트, 편집, 오디오가 어떻게 만들어졌는지 샷 단위로 알려 주고, 직접 만들 수 있는 계획까지 제시합니다. [中文](README_zh.md) | [English](../README.md) | [Русский](README_ru.md) | [日本語](README_ja.md) | 한국어 | [Español](README_es.md) | [Português](README_pt.md) | [Français](README_fr.md) | [Deutsch](README_de.md) [![Stars](https://img.shields.io/github/stars/JuneYaooo/rea-video?style=flat)](https://github.com/JuneYaooo/rea-video/stargazers) ![Python](https://img.shields.io/badge/python-%E2%89%A53.10-blue) ![Agent](https://img.shields.io/badge/runs%20in-Claude%20Code%20%7C%20Codex-8A2BE2) 왼쪽: 휴대폰으로 촬영한 TikTok 원본, 오른쪽: 다른 제품으로 바꾼 누군가의 AI 리메이크 왼쪽: 휴대폰으로 촬영한 TikTok 광고. 오른쪽: 다른 제품으로 바꿔 넣은 누군가의 AI 리메이크.
rea-video의 판정: 왼쪽은 전부 실사 촬영이며 세트 하나에 카메라 위치 두 곳, 오른쪽은 전부 AI 생성이며 8개 샷을 3번의 생성으로 만들 수 있습니다.
> 리포트는 중국어 또는 영어로 생성됩니다(에이전트가 `--lang`을 전달합니다). 상세 문서는 현재 중국어로만 제공되며, 에이전트가 문서를 읽고 사용자의 언어로 답해 줍니다. 아래 예시 리포트 6개는 영어로 되어 있어, 설치하지 않고도 리포트가 어떤 모습인지 확인할 수 있습니다. ## 분석할 수 있는 영상 | 영상 유형 | 예시 | 얻을 수 있는 정보 | |---|---|---| | 실사 촬영 | 토킹헤드, 테이블탑, 핸드헬드 제품 시연, 브이로그, 매장 방문 | 세트와 카메라 위치, 프레이밍, 카메라 무빙, 조명(장비 목록이 포함된 12가지 셋업), 색보정 | | AI 영상 | 텍스트/이미지 투 비디오, AI 숏드라마, AI 뮤직비디오 | 근거, 샷별 역설계 프롬프트, 생성 단위로 묶는 방법과 사용할 모델 | | 아바타 | 오디오로 구동되는 인물 사진, 립싱크 | 어떤 샷이 아바타 샷인지, 필요한 인물 사진과 오디오 | | 3D / 애니메이션 | Blender / C4D 설명 영상, 제품 애니메이션, 2D 애니메이션, 스톱모션 | 영상 모델로 생성할지, 3D 코드로 렌더링할지 | | 코드 / 템플릿 | 키네틱 타이포그래피, UI 데모, 차트, 슬라이드형 카드 | 텍스트, 레이아웃, 모션 타이밍. Remotion 프로젝트로 바로 재구성 가능 | | 화면 녹화 | 소프트웨어 튜토리얼, 웹 데모 | 직접 녹화해야 하는 실제 소재가 어느 부분인지 | | 혼합 / 편집 | AI 캐릭터 + 코드 UI + 실제 화면 녹화, AI 편집이 들어간 실사 촬영 | 샷마다 따로 판정한 뒤 원본 타임라인에 맞춰 다시 조립 | 화면 제작 방식 외에도 모든 영상에 대해 다음을 제공합니다. - 자막과 스타일 텍스트: 각 줄의 시작과 끝(SRT / ASS로 내보내기), 색상, 외곽선, 텍스트 등장 방식 - 스티커, 이모지, 화면 속 화면(PIP): 위치와 노출 시간 - 편집: 컷 위치, 컷 속도, 비트에 맞췄는지 여부 - 오디오: 사람 목소리인지 AI 음성인지, AI 음악인지 라이브러리 음악인지와 BPM, 각 효과음의 위치 - 직접 준비해야 하는 소재: 화면 녹화, 스크린샷, 제품 사진 ## 빠른 시작 rea-video는 AI 에이전트용으로 만들어졌습니다. Claude Code, Codex 또는 명령을 실행할 수 있는 에이전트에게 이렇게 말하세요. ```text https://github.com/JuneYaooo/rea-video 를 설치하고, 이 영상을 분석해 줘: /path/to/video.mp4 ``` 에이전트가 CLI를 설치하고, 워크플로를 익힌 뒤 전체 과정을 실행합니다. ffmpeg와 Python 3.10 이상이 필요합니다.
직접 설치하기 ```bash brew install ffmpeg # sudo apt install ffmpeg git clone https://github.com/JuneYaooo/rea-video && cd rea-video bash scripts/install_skill.sh # CLI 설치(pip, 안 되면 pipx / 로컬 .venv) 후 skill 연결 rea-video --help ```
결과물: - 한 줄 요약. 예: "AI 영상 41% + 코드 UI 59%, 실제 화면 녹화 8초, 122 BPM 라이브러리 음악" - 촬영할 것, 생성할 것, 코딩할 것으로 나눈 리메이크 계획 - 샷별 프레임, 근거, 프롬프트, 카메라·조명 메모, 오디오 분석이 담긴 전체 `report.html` 영상을 이해할 수 있는 모델(Gemini 또는 Doubao 모두 가능)을 추가하려면 에이전트에게 엔드포인트와 키를 알려 주세요. 실사/AI/3D 판정이 더 정확해지고 모든 샷에 대해 역설계 프롬프트를 작성합니다. 모델이 없어도 동작하며, 에이전트가 이미지를 볼 수 있다면 불확실한 샷은 에이전트가 직접 확인합니다. ## 예시

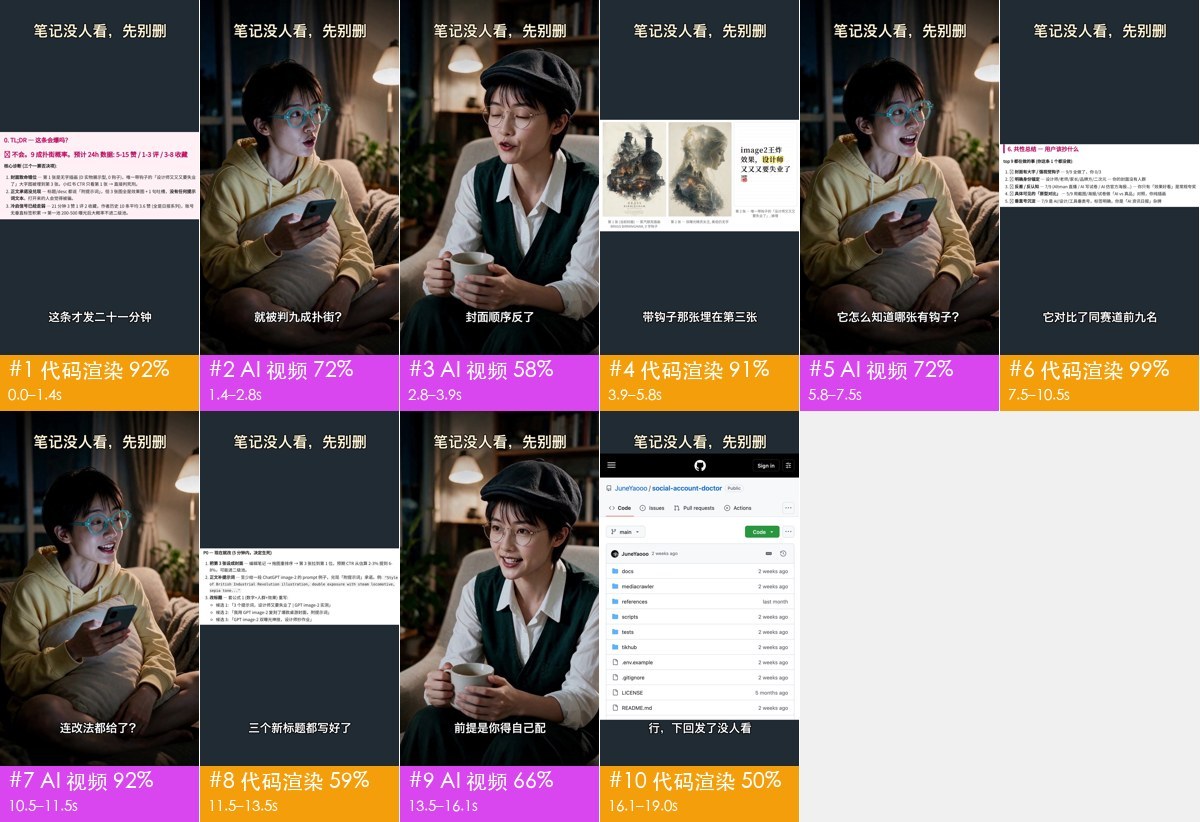
혼합 미디어 클립 · 19초 · 10샷
AI 캐릭터 대화 + 코드로 만든 UI + 실제 화면 녹화 8초. 대화 샷 5개는 UI 구간으로 나뉘어 있지만 세트가 같아서 한 번의 생성으로 처리할 수 있습니다.
영상 · 리포트

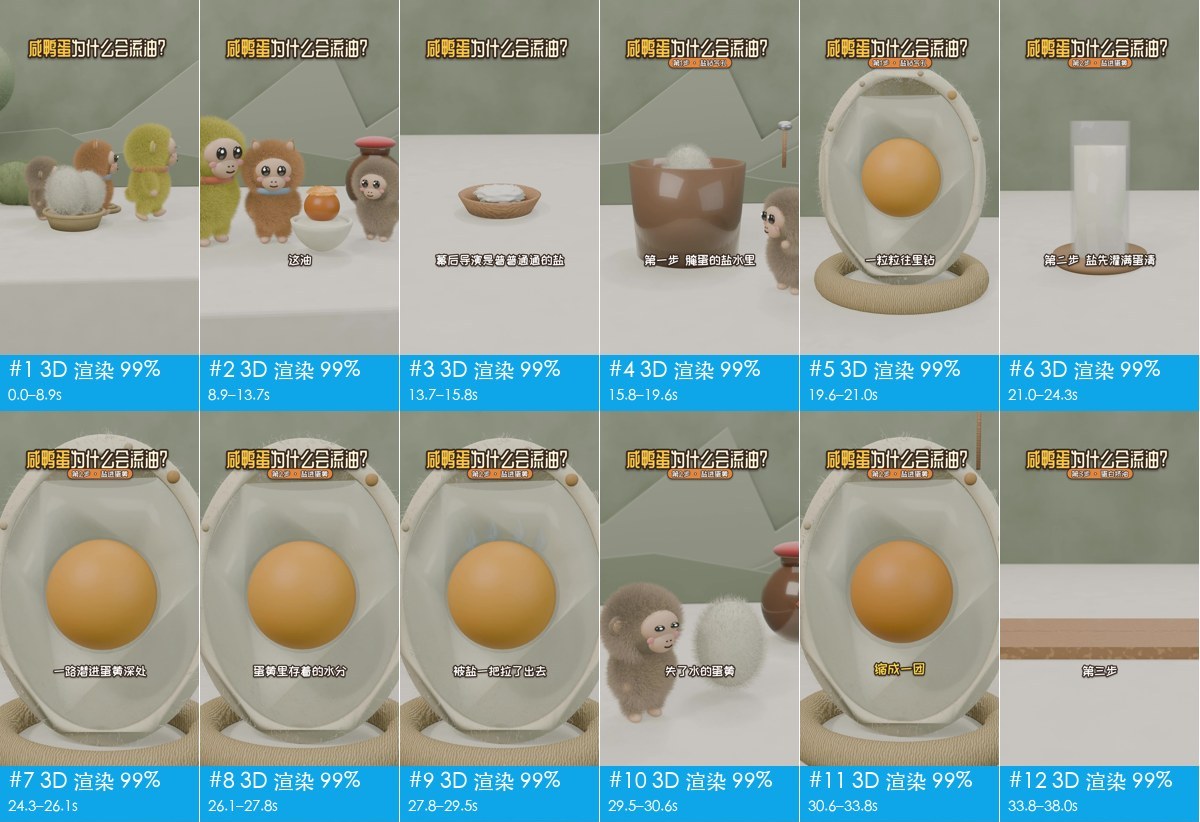
3D 설명 영상 · 67초 · 21샷
전부 3D, AI 내레이션. 영상 생성 10번으로 만들 수도 있고, LLM에게 Blender / Three.js 코드를 작성하게 할 수도 있습니다.
영상 · 리포트

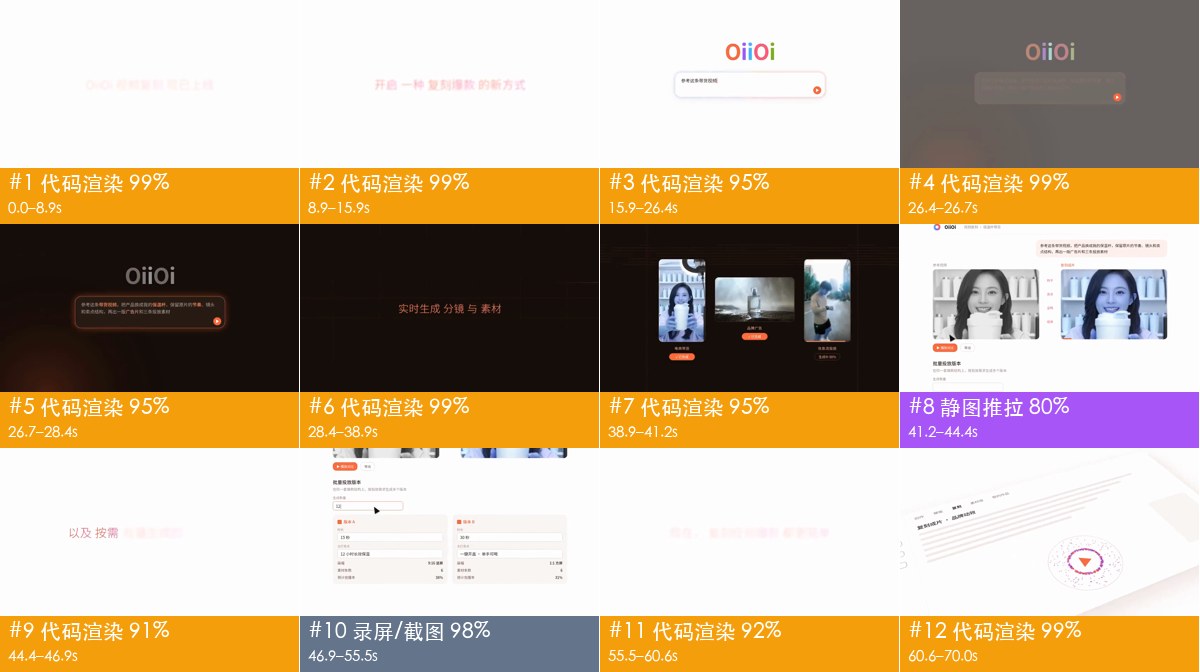
제품 홍보 영상 · 70초 · 12샷
83%가 코드 기반 모션 그래픽, 12%가 화면 녹화. 영상 모델이 필요 없으며 Remotion 프로젝트 하나로 만들 수 있습니다.
영상 · 리포트

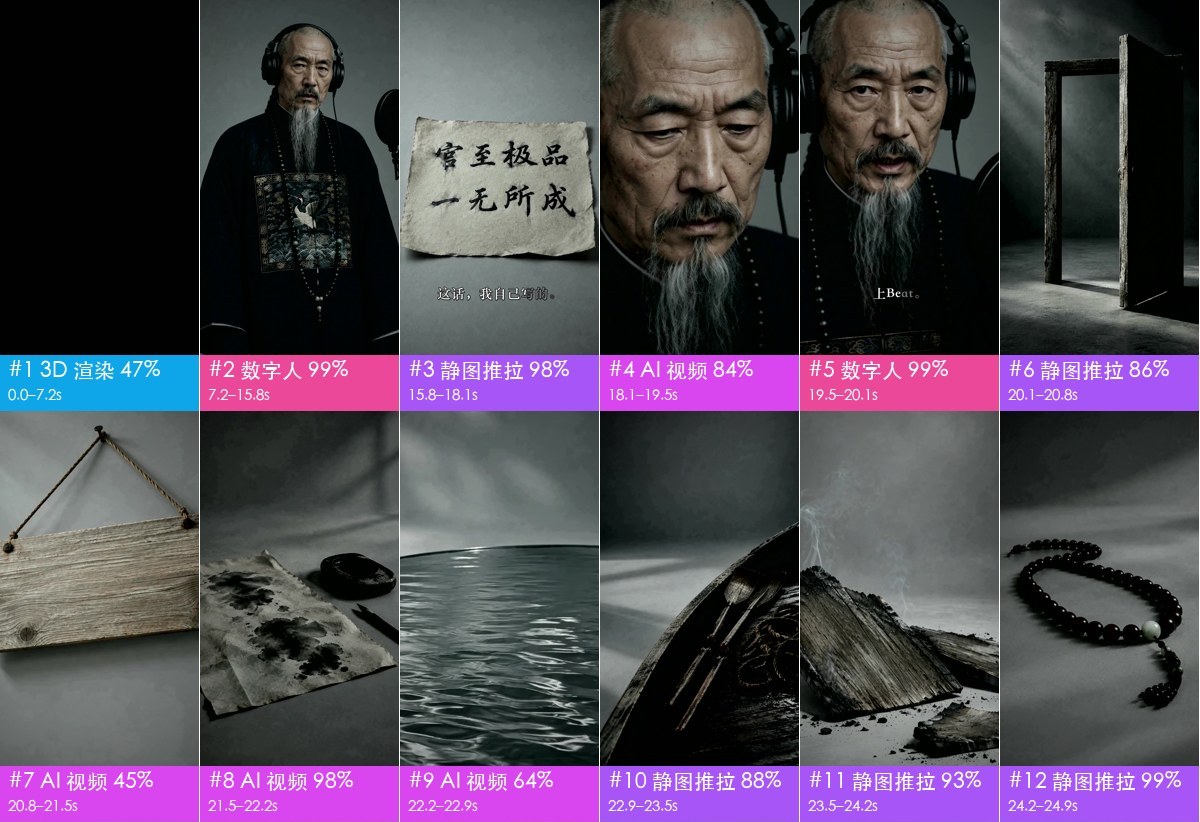
AI 뮤직비디오 · 165초 · 86샷
노래가 AI로 생성되었음을 정확히 판별했습니다(Suno로 제작). 비전 모델은 일부 샷을 "실사 드라마"로 판정했지만, 에이전트가 두루마리 위의 가짜 한자를 발견해 AI로 판정했습니다.
영상 · 리포트

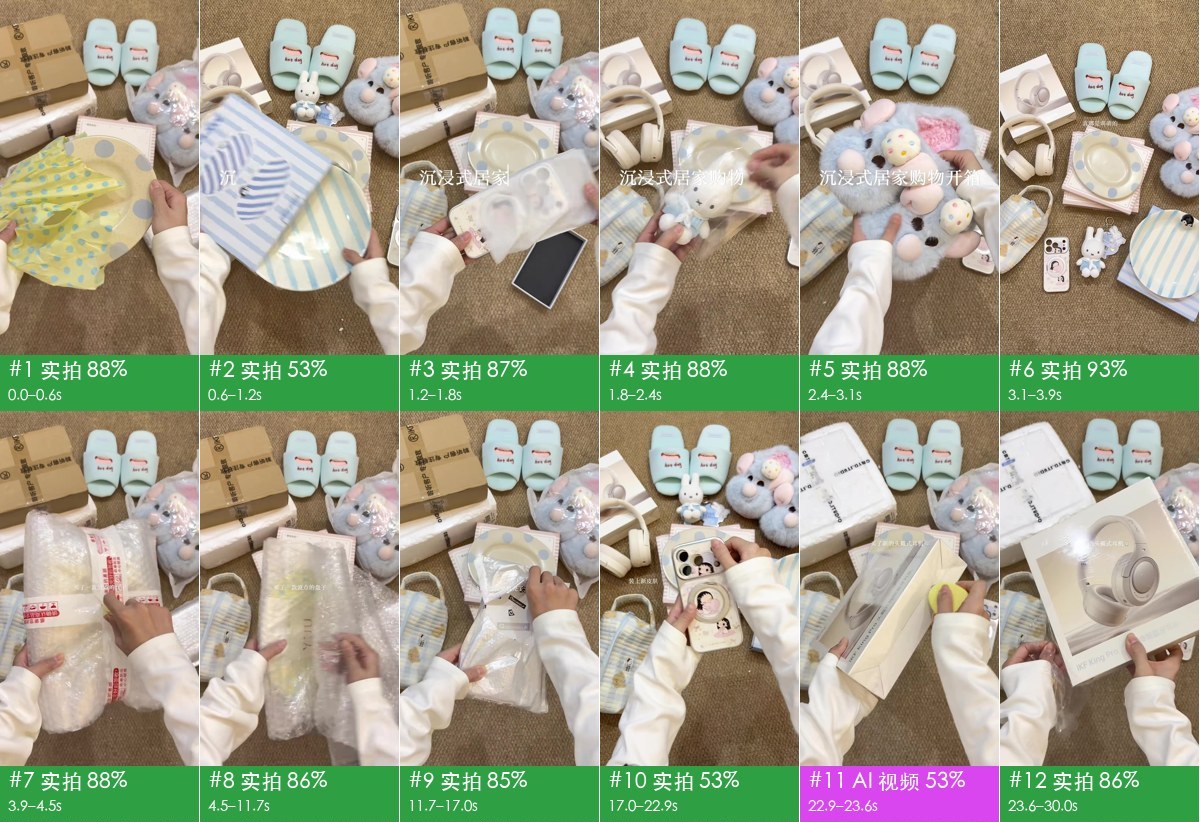
실사 언박싱 · 72초 · 29샷
전부 실제 촬영: 부감 휴대폰 거치대, 러그 한 장, 카메라 위치 한 곳, 보이스오버 없음, 현장음과 라이브러리 BGM. 플랫폼 트랜스코딩을 거친 영상이라 오프라인 도구는 35%를 AI로 판정했지만, 에이전트 검토 후 97% 실사로 바로잡았습니다.
영상 · 리포트

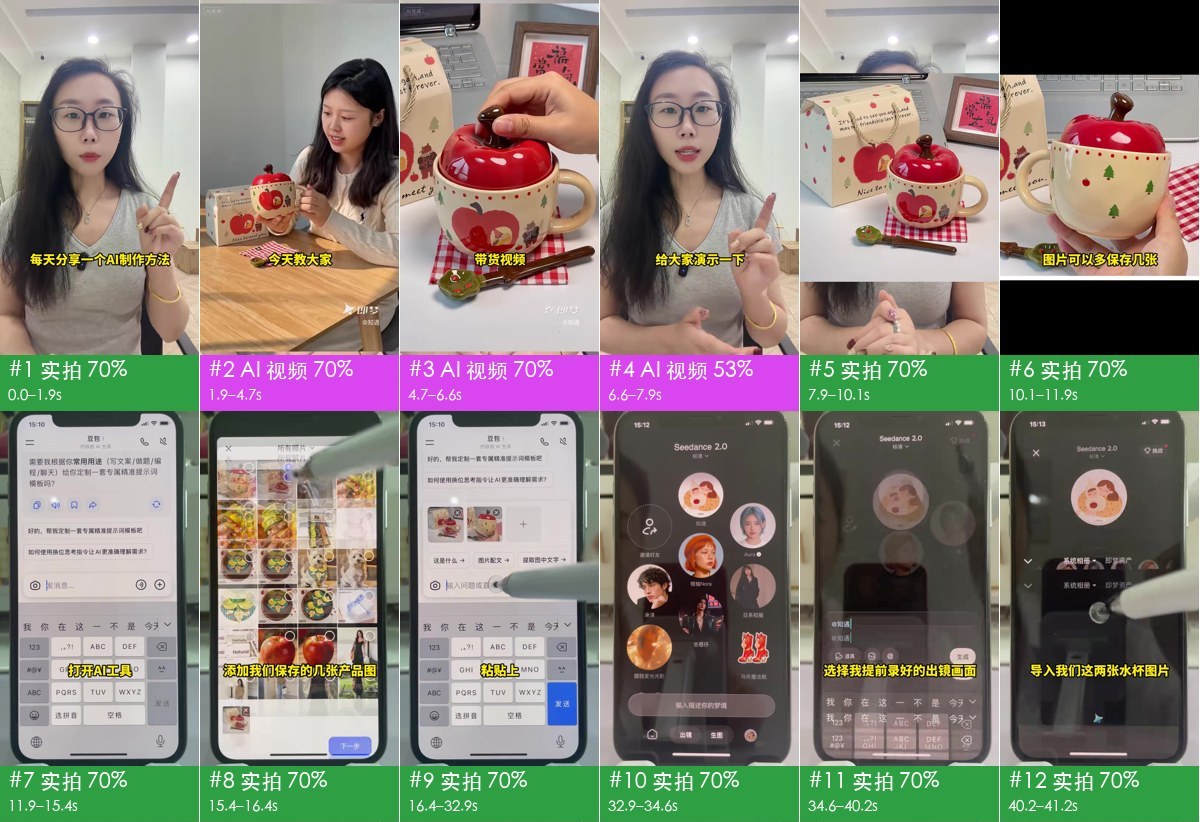
AI + 실제 인물 혼합 · 58초 · 21샷
75%는 실제 촬영(토킹헤드 + 휴대폰 화면 촬영), 25%는 AI: 크리에이터가 자신의 출연 클립과 제품 사진 두 장을 Jimeng에 넣어 "실제 인물" 제품 구간을 생성했습니다. AI 부분은 Jimeng 워터마크와 선물 상자의 깨진 글자로 잡아냈습니다.
영상 · 리포트
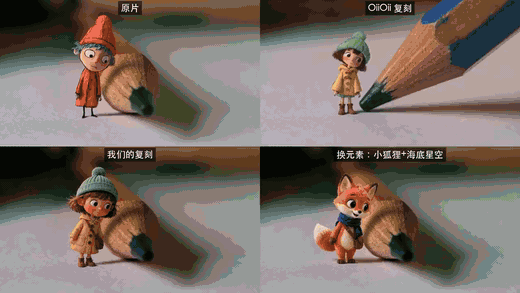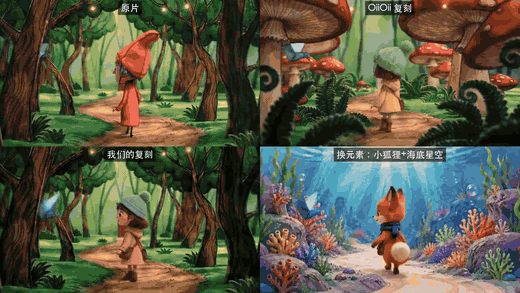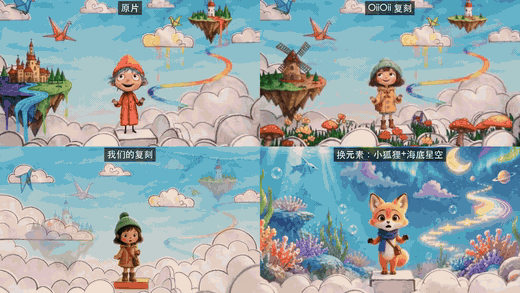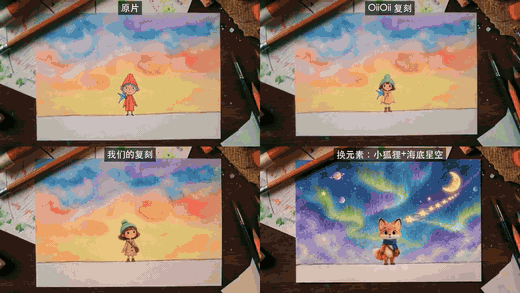
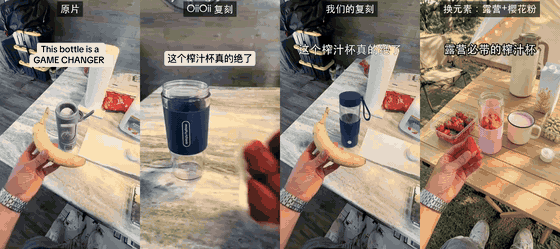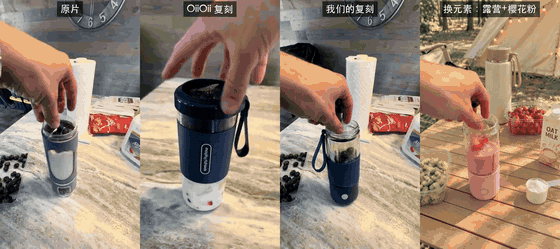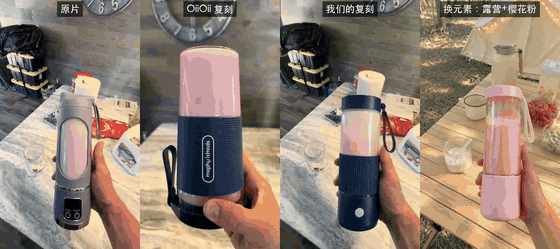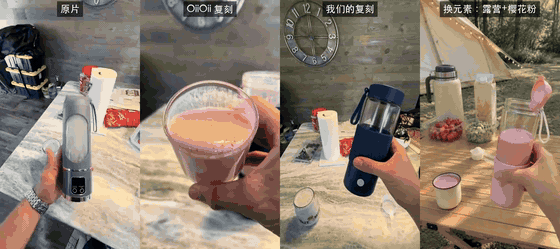
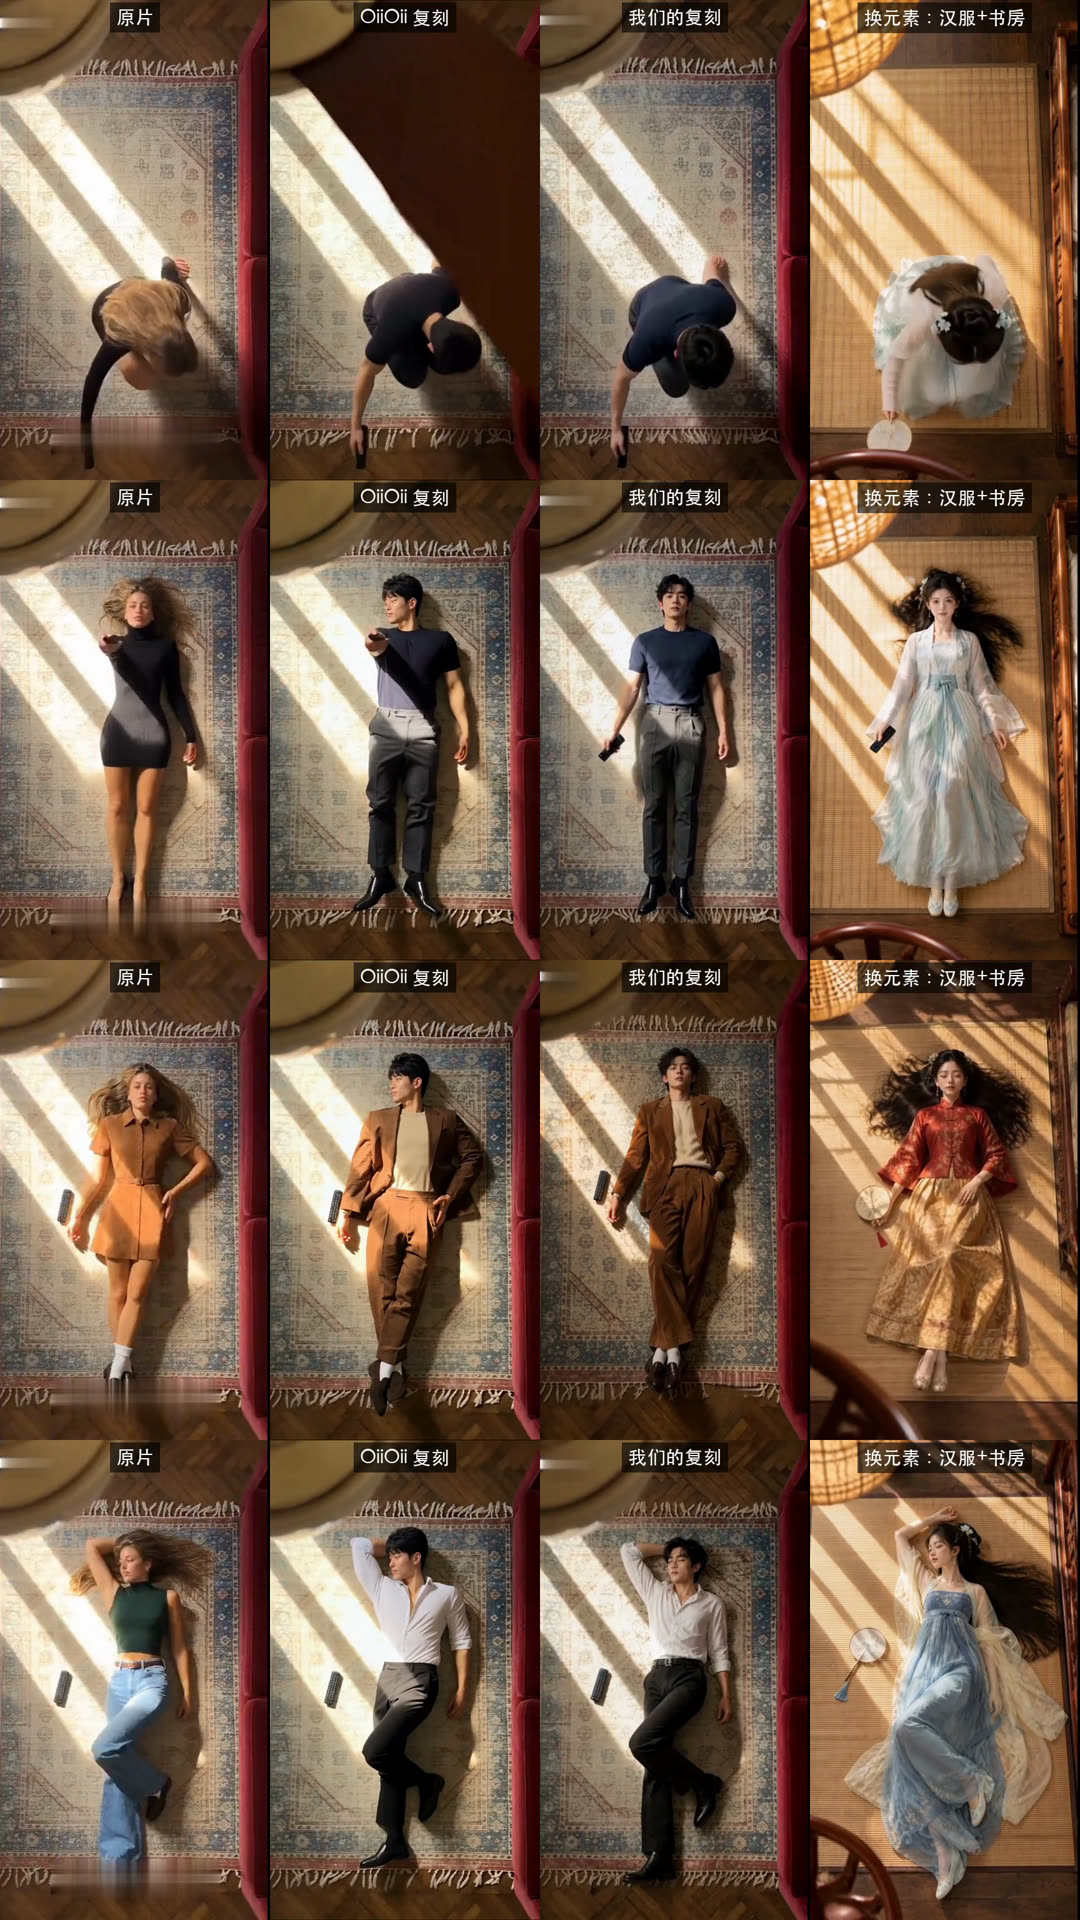
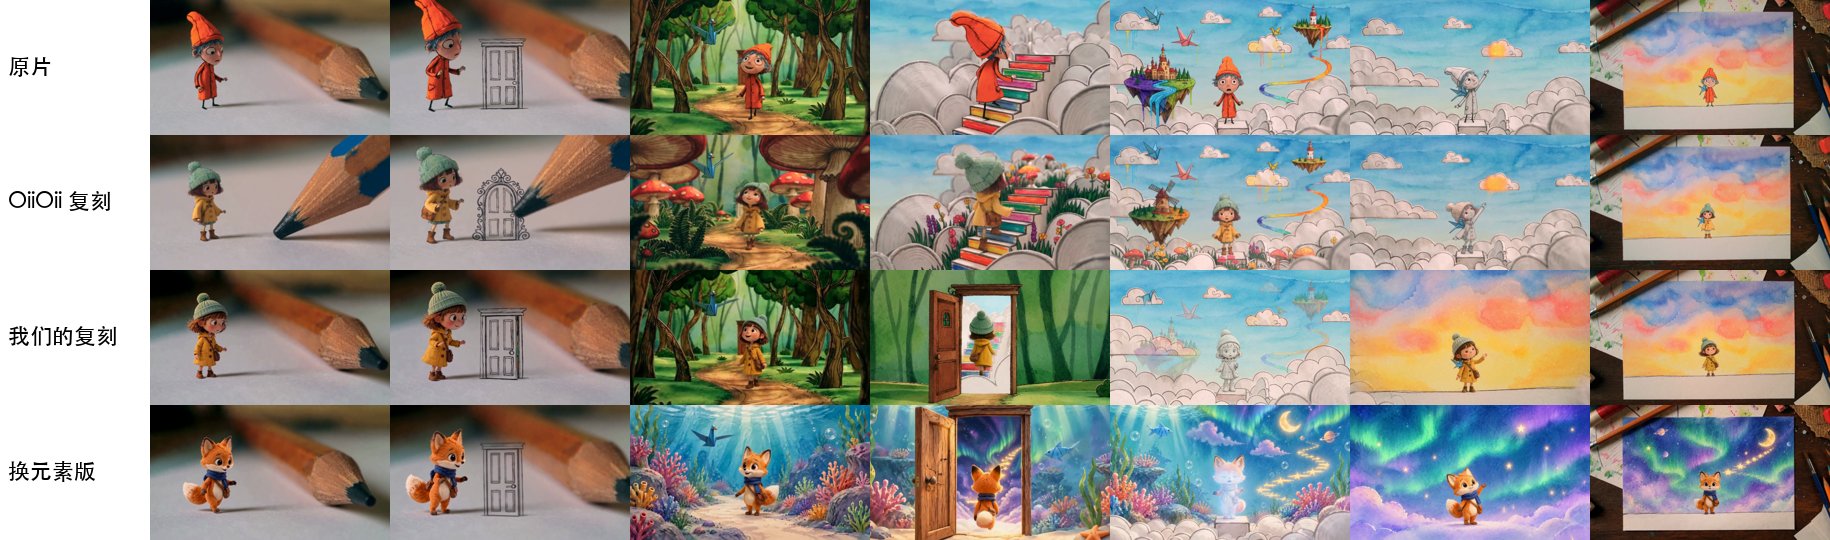
## 리메이크 rea-video로 영상을 분석한 뒤 [capsule-cinema](https://github.com/JuneYaooo/capsule-cinema)의 리메이크 레시피로 새 버전을 생성합니다. 카메라, 움직임, 템포, 전환은 원본을 따르고, 선택한 요소만 바뀝니다. 아래 결과는 자체 호스팅한 MiniMax H3로 생성했습니다. 원본 샷을 모션 레퍼런스로, 요소를 바꾼 키프레임(gpt-image-2)을 룩 레퍼런스로 사용했습니다. 아래는 OiiOii가 WeChat 글에서 소개한 리메이크 세 편입니다. 각각 두 가지 버전을 만들었습니다. 하나는 OiiOii와 같은 요소를 바꾼 버전, 다른 하나는 주체, 배경, 소품까지 바꾼 버전입니다. 각 GIF는 원본, OiiOii 리메이크, 우리 리메이크, 요소 교체 버전의 네 가지를 동시에 재생합니다.
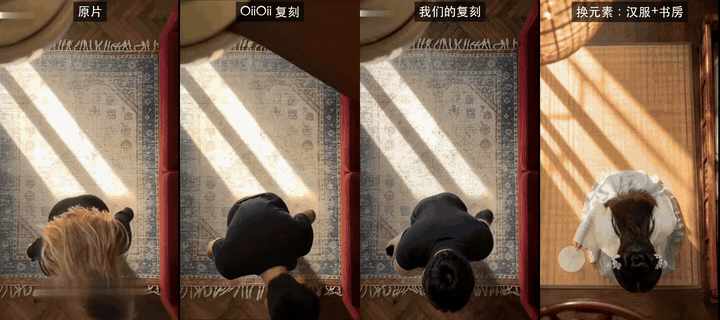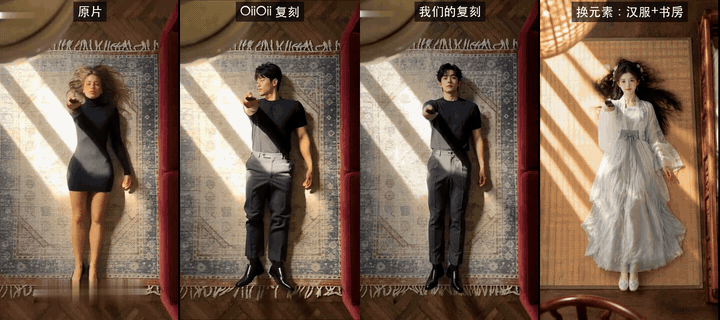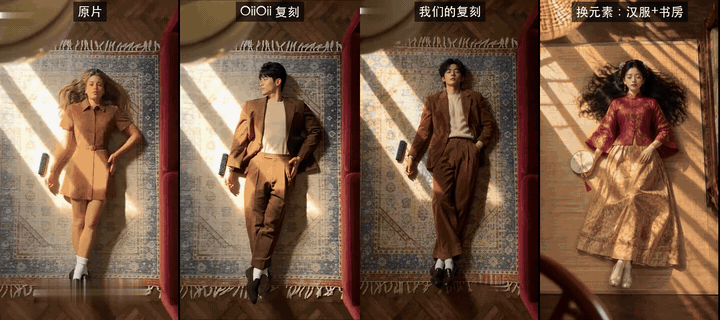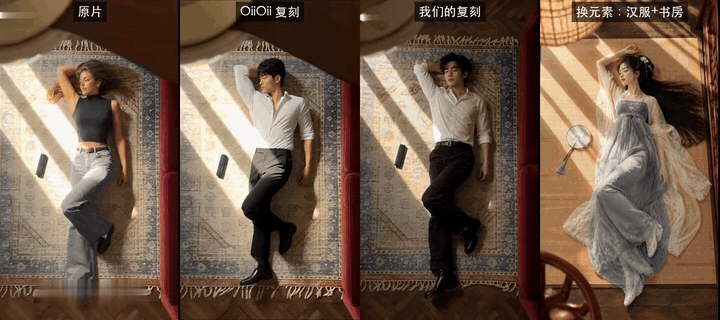
부감 의상 체인지 · 12초
같은 교체: 여성 → 남성, 의상 세 벌 → 그에 맞는 남성복. 요소 교체: 중국식 서재에서 역사 한푸 세 벌을 입은 소녀, 리모컨은 둥근 부채로.

HD 비교 영상(오디오 포함) · 같은 순간 스틸
페이퍼 크래프트 / 수채화 애니메이션 · 30초
같은 교체: 새 점토 소녀를 주인공으로. 요소 교체: 여우, 숲 → 산호초, 구름 → 별이 빛나는 하늘, 노을 → 오로라.

HD 비교 영상(오디오 포함) · 같은 순간 스틸
핸드헬드 제품 영상 · 21초 · 11샷
같은 교체: 오리지널 신제품, 영어 스티커 → 중국어 자막. 요소 교체: 분홍색 제품, 주방 → 캠핑 테이블, 새로운 재료.

HD 비교 영상(오디오 포함) · 같은 순간 스틸
HD 비교 영상은 원본 오디오를 사용합니다. 원본과 OiiOii 버전은 해당 글에서 가져온 것으로, 비교 목적으로만 보여 드립니다. ## 정확도 제작 방식 판정 정확도(샷 길이 가중): | | 튜닝 세트 (15) | 홀드아웃 (16) | 재인코딩된 WeChat 영상 (10) | |---|---|---|---| | 도구만 사용(오프라인, 무료) | 98.3% | 99.6% / 98.9% | 88.6% | | + 비전 모델(Gemini) | — | 99.6% / 99.8% | 99.6% | | + 에이전트 시각 검토 | — | 99.6% / 99.8% | 100% | 홀드아웃의 두 수치는 각각 holdout(영상 9개)과 holdout2(영상 7개)입니다. 원본 파일은 대부분 도구만으로 충분합니다. 플랫폼에서 내려받은 영상은 재압축되면서 노이즈 근거가 사라지기 때문에, 99% 이상으로 끌어올리려면 시각 검토가 필요합니다. 실제 소재 탐지율은 97–99%이고, 샷 경계는 모두 정확합니다. 수치와 재현 방법: [eval/RESULTS.md](../eval/RESULTS.md). ## 작동 방식 ![rea-video 파이프라인](../docs/rea-flow_ko.svg) 1. 분할: 영상을 샷 단위로 자르고, 오디오를 음성, 음악, 효과음으로 분리합니다. 2. 근거 수집: 프레임을 측정하고(프레임 케이던스, 센서 노이즈, 화면 전체가 하나의 평면처럼 패닝하는지, 메타데이터의 AIGC 태그), 이미지를 보고(손, 글자, 물리), 소리를 듣습니다(BPM, 키, 노래인지 말인지). 3. 판정: AIGC 태그나 프레임 케이던스 같은 확실한 근거가 "그렇게 보인다"보다 우선합니다. 근거가 충돌하면 표시해 두고 에이전트가 시각적으로 검토합니다. 4. 리메이크 계획: 대상 영상 모델이 실제로 할 수 있는 것(최대 클립 길이, 멀티샷 지원 여부, 받을 수 있는 레퍼런스 이미지 수 등)에 맞춰 샷을 묶습니다. ## FAQ
Hypit 같은 원클릭 리메이크 도구와 무엇이 다른가요? [Hypit](https://github.com/hypit-ai/hypit)은 레퍼런스 영상을 받아 새 영상을 만듭니다. 에이전트가 프레임 그리드를 읽어 원본을 이해하고, 지원하는 모델(Seedance, PixVerse, MiniMax, Wan 등)로 영상을 생성하며, 자막과 모션 그래픽은 HTML로 렌더링합니다. 원본이 어떻게 만들어졌는지는 따지지 않습니다. 실사 원본도 같은 파이프라인을 거치므로, 카메라를 몇 대 썼는지나 조명을 어떻게 했는지는 알려 주지 않습니다. 맞출 수 있는 AI 영상은 보유한 모델에 따라 달라집니다. Kling이나 Veo는 없고, 아바타나 3D 전용 경로도 없으며, AI 음악도 없어 직접 준비해야 합니다. 대본을 따르는 토킹헤드, 팟캐스트, 인터뷰 영상에 가장 강하고, 음악 중심 편집, 제품 모션 그래픽, 시네마틱 숏폼에는 약합니다. rea-video는 영상을 렌더링하지 않습니다. 샷마다 촬영한 것인지, AI로 생성한 것인지, 코드로 만든 것인지 판별한 뒤 각각에 대해 촬영 계획, 프롬프트 또는 코드 접근법을 제시합니다. 비슷한 영상을 빠르게 만들려면 Hypit이 더 빠릅니다. 원본이 어떻게 만들어졌는지 이해하고 저렴하게 리메이크하려면 rea-video를 쓰세요. 둘을 함께 써도 잘 맞습니다.
영상을 이해하는 모델이 꼭 필요한가요? 비용은 얼마인가요? 필요 없습니다. 도구 전용 모드는 오프라인에 무료이며, 원본 파일에서는 이미 정확합니다. 재압축된 플랫폼 영상이라면 영상을 이해하는 모델(Gemini 또는 Doubao 모두 가능)을 추가하거나 이미지를 볼 수 있는 에이전트를 사용하세요. 비용은 해당 서비스 요금만큼 듭니다. 자동 영상 생성(capsule-cinema)은 먼저 무료 드라이런을 하고, 확인한 뒤에만 유료 모델을 호출합니다.
영상 전체를 자동으로 리메이크할 수 있나요? 일부는 가능합니다. [capsule-cinema](https://github.com/JuneYaooo/capsule-cinema)를 설치하면 AI 샷이 자동으로 생성되어 원본 타임라인에 배치됩니다. 실사 샷은 촬영 계획에 따라 직접 촬영하고, 코드 샷은 에이전트가 Remotion 프로젝트로 작성합니다. [docs/replicate.md](../docs/replicate.md)를 참고하세요.
다른 사람의 영상을 그대로 다시 올려도 되나요? 안 됩니다. rea-video는 영상의 구조, 템포, 기법을 배우고 권리를 가진 소재로 다시 만들기 위한 도구입니다. 다른 사람의 영상, 음악, 캐릭터, 초상을 재사용하지 마세요. 게시할 때는 플랫폼 규정과 해당 지역의 AI 콘텐츠 표시 요건을 따르세요.
## 문서 - [docs/what-it-detects.md](../docs/what-it-detects.md): 탐지 항목 전체(10가지 화면 유형, 카메라, 조명, 색보정, 오디오) - [docs/replicate.md](../docs/replicate.md): 리포트를 바탕으로 리메이크하기 - [docs/cases.md](../docs/cases.md): 사례 상세 - [docs/decompose.md](../docs/decompose.md): 판정 규칙 - [docs/cli.md](../docs/cli.md): CLI 사용법과 capsule-cinema 연동 - [rea_video/capabilities/](../rea_video/capabilities/README.md): 영상 / 이미지 / 오디오 모델의 능력표. 리메이크 계획의 모델 선택에 사용 - [eval/RESULTS.md](../eval/RESULTS.md): 평가 결과 문서는 현재 중국어로만 제공됩니다. ## 커뮤니티 질문, 분석 사례, 리메이크 아이디어: [GitHub Discussions](https://github.com/JuneYaooo/rea-video/discussions). [Discord](https://discord.gg/dZj8D3GqWT)에서도 이야기할 수 있습니다. 중국어 사용자는 [linux.do](https://linux.do/)에서도 만날 수 있습니다. 분석받고 싶은 영상이 있나요? 링크와 함께 [요청 이슈](https://github.com/JuneYaooo/rea-video/issues/new?template=request_breakdown.yml)를 열어 주시면 결과를 사례로 공개합니다. ## 크레딧 [REA (Reverse Engineer Anything)](https://github.com/morluto/rea)에서 영감을 받았습니다. 보이는 것에서 출발해 어떻게 만들어졌는지 거슬러 올라가고, 모든 주장은 근거로 뒷받침하며, 측정으로 검증합니다.