TensorRT LLM
===========================
TensorRT LLM 为大语言模型(LLM)与视觉生成模型(Visual Gen)提供极致推理优化,具备面向高频算子的定制化专用 Kernel、高效的底层运行时以及符合 Python 习惯的高可扩展框架,支持深度自定义与系统级功能扩展。
[](https://nvidia.github.io/TensorRT-LLM/)
[](https://deepwiki.com/NVIDIA/TensorRT-LLM)
[](https://www.python.org/downloads/release/python-3123/)
[](https://www.python.org/downloads/release/python-31012/)
[](https://developer.nvidia.com/cuda-downloads)
[](https://pytorch.org)
[](https://github.com/NVIDIA/TensorRT-LLM/blob/main/tensorrt_llm/version.py)
[](https://github.com/NVIDIA/TensorRT-LLM/blob/main/LICENSE)
[架构概览 (Architecture)](https://nvidia.github.io/TensorRT-LLM/developer-guide/overview.html) | [性能概述 (Performance)](https://nvidia.github.io/TensorRT-LLM/developer-guide/perf-overview.html) | [实战样例 (Examples)](https://nvidia.github.io/TensorRT-LLM/quick-start-guide.html) | [官方文档 (Documentation)](https://nvidia.github.io/TensorRT-LLM/) | [技术路线图 (Roadmap)](https://github.com/NVIDIA/TensorRT-LLM/issues?q=is%3Aissue%20state%3Aopen%20label%3Aroadmap)
English | 简体中文
---
## 技术博客 (Tech Blogs)
* [10/14] TensorRT LLM 中的 KV 缓存压缩技术 (KV Cache Compression in TensorRT LLM)
✨ [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/blogs/tech_blog/blog30_KV_Cache_Compression_in_TensorRT-LLM.md)
* [09/22] GVR V2:通过自采样与多阈值机制加速稀疏注意力中的精准 Top-K 选择
✨ [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/blogs/tech_blog/blog29_GVR_V2_Self_Sampling_Exact_TopK_for_Sparse_Attention.md)
* [09/02] 在 TensorRT-LLM 中通过 GEMM 量化、注意力机制量化与 Skip Softmax 注意力加速视频生成
✨ [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/blogs/tech_blog/blog28_Accelerating_Video_Generation_with_GEMM_Quantization_Attention_Quantization_and_Skip_Softmax_Attention_in_TensorRT-LLM.md)
* [08/20] 通过轨迹重放(Trace Replay)与作业级指标评测智能体(Agentic)推理服务
✨ [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/blogs/tech_blog/blog27_Evaluating_Agentic_Serving_with_Trace_Replay_and_Job_Level_Metrics.md)
* [07/17] NVIDIA Blackwell 上的 DeepSeek-V4:TensorRT LLM 中针对特定模型与智能体工作负载的深度优化
✨ [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/blogs/tech_blog/blog26_DeepSeek_V4_on_NVIDIA_Blackwell_Model_Specific_and_Agentic_Workload_Optimizations_in_TensorRT-LLM.md)
* [07/01] 借助 TensorRT-LLM 在 NVL72 机架规模上横向扩展视频生成推理
✨ [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/blogs/tech_blog/blog25_Scaling_Video_Generation_Across_NVL72_Rack_with_TensorRT-LLM.md)
* [05/15] 智能体应用与 TensorRT-LLM 的端到端联合协同优化
✨ [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/blogs/tech_blog/blog23_Joint_Optimization_of_Agent_Applications_and_TensorRT-LLM.md)
* [04/03] 调优 CUDA Graph 批处理尺寸以获得更高输出吞吐量
✨ [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/blogs/tech_blog/blog20_Tuning_CUDA_Graph_Batch_Sizes_for_Higher_Output_Throughput.md)
* [04/03] DWDP:面向 NVL72 高性能大模型推理的分布式权重数据并行
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog19_DWDP_Distributed_Weight_Data_Parallelism_for_High_Performance_LLM_Inference_on_NVL72.html)
* [03/16] 基于 NVLink 单边 AlltoAll 优化 MoE 跨卡通信
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog18_Optimizing_MoE_Communication_with_One_Sided_AlltoAll_Over_NVLink.html)
* [03/04] TensorRT LLM 中的稀疏注意力机制 (Sparse Attention in TensorRT LLM)
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog17_Sparse_Attention_in_TensorRT-LLM.html)
* [02/06] 使用 Skip Softmax 注意力加速长文本上下文推理
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog16_Accelerating_Long_Context_Inference_with_Skip_Softmax_Attention.html)
* [01/09] 在 NVIDIA Blackwell GPU 上极致优化 DeepSeek-V3.2 推理
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog15_Optimizing_DeepSeek_V32_on_NVIDIA_Blackwell_GPUs)
历史博客 (Previous Blogs)
* [10/13] TensorRT LLM 专家并行扩展(第 3 部分:突破性能极限)
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog14_Scaling_Expert_Parallelism_in_TensorRT-LLM_part3.html)
* [09/26] TensorRT LLM 中的推理计算(Inference Time Compute)工程实现
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog13_Inference_Time_Compute_Implementation_in_TensorRT-LLM.html)
* [09/19] 结合引导解码(Guided Decoding)与投机解码(Speculative Decoding):实现 CPU 与 GPU 的无缝协同
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog12_Combining_Guided_Decoding_and_Speculative_Decoding.html)
* [08/29] ADP 负载均衡策略 (ADP Balance Strategy)
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog10_ADP_Balance_Strategy.html)
* [08/05] 使用 TensorRT LLM 运行高性能 GPT-OSS-120B 推理服务器
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog9_Deploying_GPT_OSS_on_TRTLLM.html)
* [08/01] TensorRT LLM 专家并行扩展(第 2 部分:性能现状与优化)
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog8_Scaling_Expert_Parallelism_in_TensorRT-LLM_part2.html)
* [07/26] TensorRT LLM 中的 N-Gram 投机解码
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog7_NGram_performance_Analysis_And_Auto_Enablement.html)
* [06/19] TensorRT LLM 中的解耦分离式推理服务(Disaggregated Serving)
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog5_Disaggregated_Serving_in_TensorRT-LLM.html)
* [06/05] TensorRT LLM 专家并行扩展(第 1 部分:大规模 EP 设计与实现)
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog4_Scaling_Expert_Parallelism_in_TensorRT-LLM.html)
* [05/30] 在 NVIDIA Blackwell GPU 上优化 DeepSeek R1 吞吐量:开发者深度解析
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog3_Optimizing_DeepSeek_R1_Throughput_on_NVIDIA_Blackwell_GPUs.html)
* [05/23] DeepSeek R1 多词元预测(MTP)实现与优化
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog2_DeepSeek_R1_MTP_Implementation_and_Optimization.html)
* [05/16] 突破延迟边界:在 NVIDIA B200 GPU 上优化 DeepSeek-R1 性能
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/tech_blog/blog1_Pushing_Latency_Boundaries_Optimizing_DeepSeek-R1_Performance_on_NVIDIA_B200_GPUs.html)
## 最新动态 (Latest News)
* [04/03] 🎨 TensorRT LLM 现已全面支持面向视觉生成(Visual Gen)的扩散模型 [➡️ 链接](https://github.com/NVIDIA/TensorRT-LLM/blob/main/docs/source/models/visual-generation.md)
历史动态 (Previous News)
* [08/05] 🌟 TensorRT LLM 零日首发支持 OpenAI 最新开源权重模型:GPT-OSS-120B [➡️ 链接](https://huggingface.co/openai/gpt-oss-120b) 与 GPT-OSS-20B [➡️ 链接](https://huggingface.co/openai/gpt-oss-20b)
* [07/15] 🌟 TensorRT LLM 零日首发支持 LG AI Research 最新开源模型 EXAONE 4.0 [➡️ 链接](https://huggingface.co/LGAI-EXAONE/EXAONE-4.0-32B)
* [05/22] Blackwell 搭配 Meta Llama 4 Maverick 突破单用户 1,000 TPS 性能大关
✨ [➡️ 链接](https://developer.nvidia.com/blog/blackwell-breaks-the-1000-tps-user-barrier-with-metas-llama-4-maverick/)
* [04/10] TensorRT LLM DeepSeek R1 性能评测最佳实践现已正式发布。
✨ [➡️ 链接](https://nvidia.github.io/TensorRT-LLM/blogs/Best_perf_practice_on_DeepSeek-R1_in_TensorRT-LLM.html)
* [04/05] TensorRT LLM 在 B200 GPU 上运行 Llama 4 吞吐量突破每秒 40,000 Token!
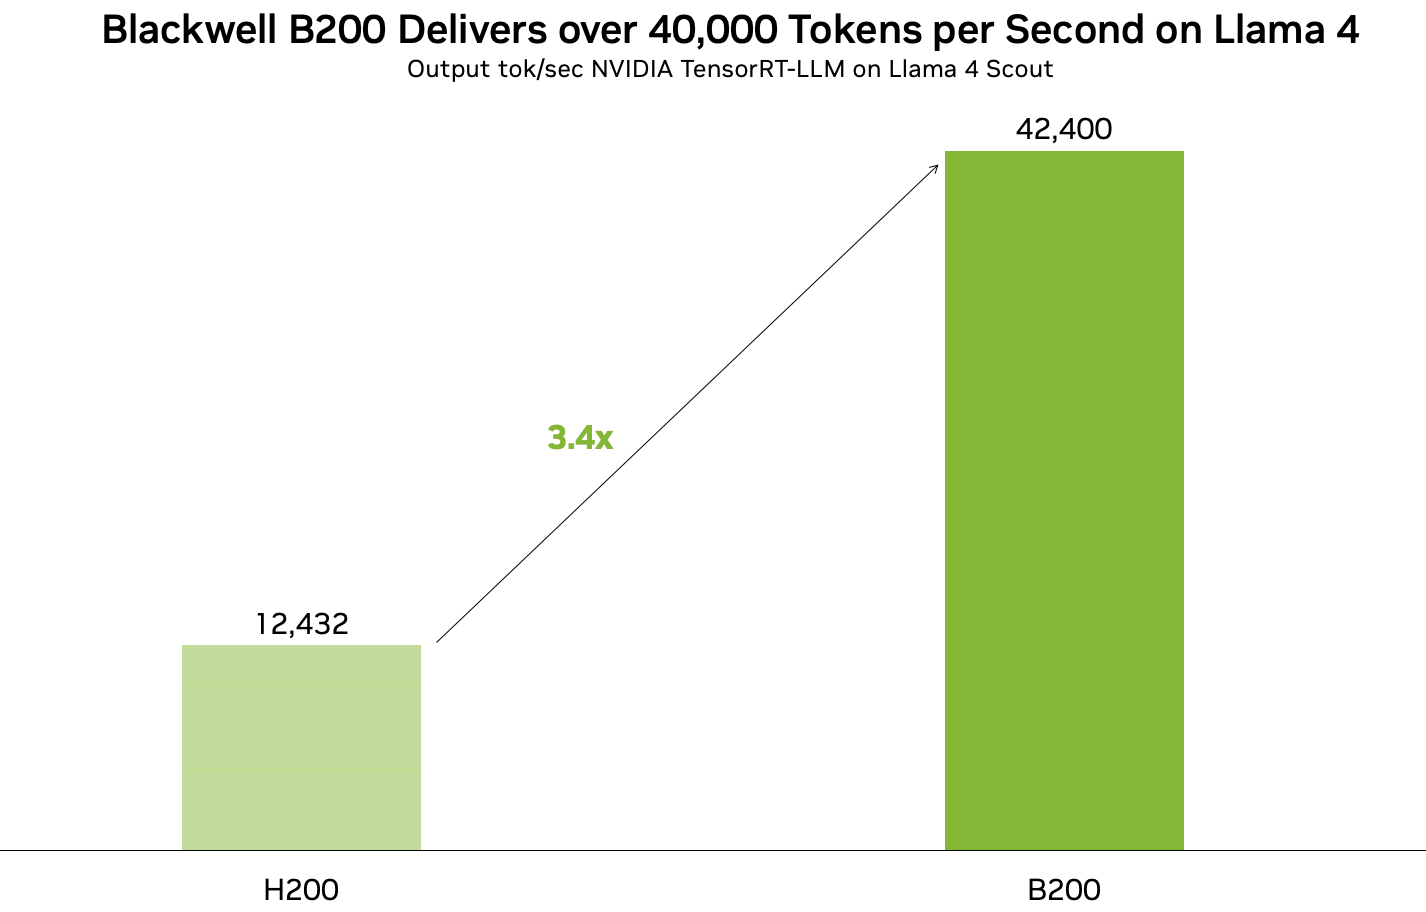
* [03/22] TensorRT LLM 现已全面开源,所有核心开发正式迁移至 GitHub!
* [03/18] 🚀🚀 NVIDIA Blackwell 结合 TensorRT LLM 创下 DeepSeek-R1 推理性能世界纪录 [➡️ 链接](https://developer.nvidia.com/blog/nvidia-blackwell-delivers-world-record-deepseek-r1-inference-performance/)
* [02/28] 🌟 NAVER Place 借助 TensorRT LLM 极致优化基于 SLM 的垂直服务 [➡️ 链接](https://developer.nvidia.com/blog/spotlight-naver-place-optimizes-slm-based-vertical-services-with-nvidia-tensorrt-llm/)
* [02/25] 🌟 DeepSeek-R1 针对 Blackwell 架构性能优化现已就绪 [➡️ 链接](https://huggingface.co/nvidia/DeepSeek-R1-FP4)
* [02/20] 探索以最低业务成本达成卓越精度、高吞吐与极低延迟的完整指南,请查阅[电子书](https://www.nvidia.com/en-us/solutions/ai/inference/balancing-cost-latency-and-performance-ebook/?ncid=so-twit-348956&linkId=100000341423615)。
* [02/18] 在 AWS EKS 上通过自动弹性伸缩解锁 LLM 推理潜能 ✨ [➡️ 链接](https://aws.amazon.com/blogs/hpc/scaling-your-llm-inference-workloads-multi-node-deployment-with-tensorrt-llm-and-triton-on-amazon-eks/)
* [02/12] 🦸⚡ 借助 DeepSeek-R1 与推理扩展(Inference Time Scaling)实现 GPU Kernel 自动化生成 [➡️ 链接](https://developer.nvidia.com/blog/automating-gpu-kernel-generation-with-deepseek-r1-and-inference-time-scaling/?ncid=so-twit-997075&linkId=100000338909937)
* [02/12] 🌟 扩展定律(Scaling Laws)如何驱动更智能、更强悍的 AI 模型 [➡️ 链接](https://blogs.nvidia.com/blog/ai-scaling-laws/?ncid=so-link-889273&linkId=100000338837832)
* [2025/01/25] NVIDIA 将 AI 研发重心转向推理成本与执行效率 [➡️ 链接](https://www.fierceelectronics.com/ai/nvidia-moves-ai-focus-inference-cost-efficiency?linkId=100000332985606)
* [2025/01/24] 🏎️ 借助 NVIDIA 全栈解决方案优化 AI 推理性能 [➡️ 链接](https://developer.nvidia.com/blog/optimize-ai-inference-performance-with-nvidia-full-stack-solutions/?ncid=so-twit-400810&linkId=100000332621049)
* [2025/01/23] 🚀 高速、低成本推理成为实现高收益 AI 的关键之钥 [➡️ 链接](https://blogs.nvidia.com/blog/ai-inference-platform/?ncid=so-twit-693236-vt04&linkId=100000332307804)
* [2025/01/16] TensorRT LLM 推出全新 KV 缓存复用(KV Cache Reuse)优化技术 [➡️ 链接](https://developer.nvidia.com/blog/introducing-new-kv-cache-reuse-optimizations-in-nvidia-tensorrt-llm/?ncid=so-twit-363876&linkId=100000330323229)
* [2025/01/14] 📣 微软必应(Bing)向 LLM/SLM 架构全面转型:使用 TensorRT LLM 深度优化搜索系统 [➡️ 链接](https://blogs.bing.com/search-quality-insights/December-2024/Bing-s-Transition-to-LLM-SLM-Models-Optimizing-Search-with-TensorRT-LLM)
* [2025/01/04] ⚡ 借助 TensorRT LLM 投机解码将 Llama 3.3 70B 推理吞吐量提升 3 倍 [➡️ 链接](https://developer.nvidia.com/blog/boost-llama-3-3-70b-inference-throughput-3x-with-nvidia-tensorrt-llm-speculative-decoding/)
* [2024/12/10] ⚡ 来自 Meta AI 的 Llama 3.3 70B 全面支持 TensorRT-LLM 加速。在推理、数学、指令遵循和工具调用方面与 Llama 3.1 405B 并驾齐驱。探索技术预览版 [➡️ 链接](https://build.nvidia.com/meta/llama-3_3-70b-instruct)
* [2024/12/03] 🌟 将 AI 推理吞吐量最高提升 3.6 倍。NVIDIA TensorRT-LLM 现已全面支持投机解码,Token 生成吞吐量翻三倍,专为生成式 AI 应用量身定制。在深度技术解析中探索实现细节 [➡️ 链接](https://nvda.ws/3ZCZTzD)
* [2024/12/02] 正在为高性能关键型应用部署 ONNX 模型?欢迎体验 NVIDIA Nsight Deep Learning Designer ⚡ 具备直观易用的图形界面并与 NVIDIA TensorRT 深度集成:
✅ ONNX 模型计算图直观可视化
✅ 快速调整模型架构与超参数
✅ 支持通过 ORT 或 TensorRT 进行细粒度性能分析
✅ 轻松构建 TensorRT 推理引擎
[➡️ 链接](https://developer.nvidia.com/nsight-dl-designer?ncid=so-link-485689&linkId=100000315016072)
* [2024/11/26] 📣 正式推出面向 Jetson AGX Orin 的 TensorRT LLM,在 JetPack 6.1 中通过 TensorRT LLM 仓库的 v0.12.0-jetson 分支提供初步支持,极大简化了在 Jetson 边缘计算平台上的部署难度。✅ 预编译的 TensorRT LLM Wheel 包与容器镜像轻松集成 ✅ 详尽指南与文档快速上手 [➡️ 链接](https://forums.developer.nvidia.com/t/tensorrt-llm-for-jetson/313227?linkId=100000312718869)
* [2024/11/21] NVIDIA HGX H200 上借助 TensorRT LLM Multiblock Attention 在长序列长度下将吞吐量提升 3 倍以上 [➡️ 链接](https://developer.nvidia.com/blog/nvidia-tensorrt-llm-multiblock-attention-boosts-throughput-by-more-than-3x-for-long-sequence-lengths-on-nvidia-hgx-h200/)
* [2024/11/19] Llama 3.2 全栈优化解锁 NVIDIA GPU 极致性能表现 [➡️ 链接](https://developer.nvidia.com/blog/llama-3-2-full-stack-optimizations-unlock-high-performance-on-nvidia-gpus/?ncid=so-link-721194)
* [2024/11/09] 🚀🚀🚀 基于 NVSwitch 与 TensorRT LLM MultiShot 实现 3 倍更快的 AllReduce 集合通信 [➡️ 链接](https://developer.nvidia.com/blog/3x-faster-allreduce-with-nvswitch-and-tensorrt-llm-multishot/)
* [2024/11/09] ✨ NVIDIA 与 LG AI Research 携手推进 AI 生态演进 🙌 [➡️ 链接](https://blogs.nvidia.co.kr/blog/nvidia-lg-ai-research/)
* [2024/11/02] 🌟🌟🌟 NVIDIA 与 LlamaIndex 开发者竞赛,参赛赢取包括 NVIDIA® GeForce RTX™ 4080 SUPER GPU、DLI 培训积分等丰厚大奖 🙌 [➡️ 链接](https://developer.nvidia.com/llamaindex-developer-contest)
* [2024/10/28] 🏎️🏎️🏎️ NVIDIA GH200 超级芯片在 Llama 模型多轮交互推理中提速 2 倍 [➡️ 链接](https://developer.nvidia.com/blog/nvidia-gh200-superchip-accelerates-inference-by-2x-in-multiturn-interactions-with-llama-models/)
* [2024/10/22] 📝 逐步实战指南:✅ 使用 NVIDIA TensorRT-LLM 优化大模型,✅ 结合 Triton Inference Server 部署优化模型,✅ 在 Kubernetes 环境中实现大模型自动弹性伸缩。深度技术解析:[➡️ 链接](https://nvda.ws/3YgI8UT)
* [2024/10/07] 🚀🚀🚀 使用 NVIDIA 加速库优化微软必应视觉搜索 (Bing Visual Search) [➡️ 链接](https://developer.nvidia.com/blog/optimizing-microsoft-bing-visual-search-with-nvidia-accelerated-libraries/)
* [2024/09/29] 🌟 Meta AI PyTorch + TensorRT v2.4 正式发布:⚡TensorRT 10.1 ⚡PyTorch 2.4 ⚡CUDA 12.4 ⚡Python 3.12 [➡️ 链接](https://github.com/pytorch/TensorRT/releases/tag/v2.4.0)
* [2024/09/17] ✨ NVIDIA TensorRT LLM 线下交流会资料 [➡️ 链接](https://drive.google.com/file/d/1RR8GqC-QbuaKuHj82rZcXb3MS20SWo6F/view?usp=share_link)
* [2024/09/17] ✨ Databricks 借助 TensorRT-LLM 加速 LLM 推理技术分享 [➡️ 链接](https://drive.google.com/file/d/1NeSmrLaWRJAY1rxD9lJmzpB9rzr38j8j/view?usp=sharing)
* [2024/09/17] ✨ Baseten 上的 TensorRT LLM 实践 [➡️ 链接](https://drive.google.com/file/d/1Y7L2jqW-aRmt31mCdqhwvGMmCSOzBUjG/view?usp=share_link)
* [2024/09/04] 🏎️🏎️🏎️ BentoML 调优 TensorRT LLM 实现最佳线上推理服务实践 [➡️ 链接](https://www.bentoml.com/blog/tuning-tensor-rt-llm-for-optimal-serving-with-bentoml)
* [2024/08/20] 🏎️ SDXL 搭配 Model Optimizer ⏱️⚡ 🏁 缓存扩散 🏁 量化感知训练 🏁 QLoRA 🏁 Python 3.12 [➡️ 链接](https://developer.nvidia.com/blog/nvidia-tensorrt-model-optimizer-v0-15-boosts-inference-performance-and-expands-model-support/)
* [2024/08/13] 🐍 基于 Mamba 的极速代码补全:⚡ TensorRT LLM 提供极致速度 🤖 NIM 简化部署流程 ☁️ 支持任意云端环境部署 [➡️ 链接](https://developer.nvidia.com/blog/revolutionizing-code-completion-with-codestral-mamba-the-next-gen-coding-llm/)
* [2024/08/06] 🗫 多语言挑战圆满达成:🤖 TensorRT LLM 全面加速希伯来语、印尼语及越南语等低资源语言 [➡️ 链接](https://developer.nvidia.com/blog/accelerating-hebrew-llm-performance-with-nvidia-tensorrt-llm/?linkId=100000278659647)
* [2024/07/30] 推出 SliceX AI ELM Turbo:🤖 单次训练 ELM ⚡ TensorRT LLM 极致优化 ☁️ 随处部署 [➡️ 链接](https://developer.nvidia.com/blog/supercharging-llama-3-1-across-nvidia-platforms)
* [2024/07/23] 👀 Meta AI Llama 3.1 405B 在 16K NVIDIA H100 集群上完成训练,推理全面经 TensorRT LLM 优化 ⚡ 单节点 400 tok/s,每用户 37 tok/s,单节点即可运行推理 [➡️ 链接](https://developer.nvidia.com/blog/supercharging-llama-3-1-across-nvidia-platforms)
* [2024/07/09] 借助 TensorRT LLM 推理最大化 Meta Llama 3 多语言性能清单:✅ 多语言 ✅ NIM ✅ LoRA 微调适配器 [➡️ 技术博客](https://developer.nvidia.com/blog/deploy-multilingual-llms-with-nvidia-nim/)
* [2024/07/02] 释放 Mistral AI MoE 词元生成算力 📈 🚀 H100 上搭载 NVIDIA TensorRT LLM 的 Mixtral 8x7B [➡️ 技术博客](https://developer.nvidia.com/blog/achieving-high-mixtral-8x7b-performance-with-nvidia-h100-tensor-core-gpus-and-tensorrt-llm?ncid=so-twit-928467)
* [2024/06/24] 经 NVIDIA TensorRT LLM 深度优化,Upstage solar-10.7B-instruct 现已就绪,通过官方 API 目录助力开发者项目 🏎️ [➡️ 链接](https://build.nvidia.com/upstage/solar-10_7b-instruct?snippet_tab=Try)
* [2024/06/18] Stable Diffusion 3 全新发布:使用 TensorRT INT8 量化大幅加速 SD3 体验 [➡️ 链接](https://build.nvidia.com/upstage/solar-10_7b-instruct?snippet_tab=Try)
* [2024/06/18] 🧰 使用 TensorRT 部署 ComfyUI?配置指南详见 [➡️ 链接](https://github.com/comfyanonymous/ComfyUI_TensorRT)
* [2024/06/11] ✨ TensorRT 权重剥离推理引擎 (Weight-Stripped Engines) 深度技术解析:✅ +99% 压缩率 ✅ 1 套权重跨多 GPU 共享 ✅ 零性能损耗 ✅ 支持 LLM、CNN 等各类架构 [➡️ 链接](https://developer.nvidia.com/blog/maximum-performance-and-minimum-footprint-for-ai-apps-with-nvidia-tensorrt-weight-stripped-engines/)
* [2024/06/04] ✨ TensorRT 与 GeForce RTX 释放 ComfyUI SD 超强潜能 🦸⚡ 🎥 演示视频: [➡️ 链接](https://youtu.be/64QEVfbPHyg) 📗 实战 Notebook: [➡️ 链接](https://console.brev.dev/launchable/deploy?userID=2x2sil999&orgID=ktj33l4xj&name=ComfyUI_TensorRT&instance=L4%40g2-standard-4%3Anvidia-l4%3A1&diskStorage=500&cloudID=GCP&baseImage=docker.io%2Fpytorch%2Fpytorch%3A2.2.0-cuda12.1-cudnn8-runtime&ports=ComfUI%3A8188&file=https%3A%2F%2Fgithub.com%2Fbrevdev%2Fnotebooks%2Fblob%2Fmain%2Ftensorrt-comfyui.ipynb&launchableID=env-2hQX3n7ae5mq3NjNZ32DfAG0tJf)
* [2024/05/28] ✨ 面向 ResNet-50 的 TensorRT 权重剥离技术:✅ +99% 压缩率 ✅ 1 套权重共享至多卡 ✅ 零性能损耗 [➡️ 链接](https://console.brev.dev/launchable/deploy?userID=2x2sil999&orgID=ktj33l4xj&launchableID=env-2h6bym7h5GFNho3vpWQQeUYMwTM&instance=L4%40g6.xlarge&diskStorage=500&cloudID=devplane-brev-1&baseImage=nvcr.io%2Fnvidia%2Ftensorrt%3A24.05-py3&file=https%3A%2F%2Fgithub.com%2FNVIDIA%2FTensorRT%2Fblob%2Frelease%2F10.0%2Fsamples%2Fpython%2Fsample_weight_stripping%2Fnotebooks%2Fweight_stripping.ipynb&name=tensorrt_weight_stripping_resnet50)
* [2024/05/21] ✨ Modal 团队开源了在 TensorRT LLM 上部署 Serverless Meta Llama 3 的完整方案 [➡️ 链接](https://modal.com/docs/examples/trtllm_llama)
* [2024/05/08] NVIDIA Model Optimizer —— TensorRT 生态的最新成员,汇集后训练与训练中模型优化技术:✅ 量化 ✅ 稀疏化 ✅ QAT [➡️ 博客](https://developer.nvidia.com/blog/accelerate-generative-ai-inference-performance-with-nvidia-tensorrt-model-optimizer-now-publicly-available/)
* [2024/05/07] 🦙🦙🦙 每秒 24,000 Token!Meta Llama 3 搭载 TensorRT LLM 极速起飞 [➡️ 链接](https://blogs.nvidia.com/blog/meta-llama3-inference-acceleration/)
* [2024/02/06] [🚀 使用 TRT-LLM 中的前沿量化技术加速推理](./docs/source/blogs/quantization-in-TRT-LLM.md)
* [2024/01/30] [全新 XQA-Kernel 在相同延迟预算下将 Llama-70B 吞吐量提升 2.4 倍](./docs/source/blogs/XQA-kernel.md)
* [2023/12/04] [基于 INT4 AWQ 在单张 H200 GPU 上运行 Falcon-180B,相比 A100 获得 6.7 倍的 Llama-70B 提速](./docs/source/blogs/Falcon180B-H200.md)
* [2023/11/27] [AWS SageMaker LMI 现已支持 TensorRT LLM:相比早前版本提升 60% 吞吐量](https://aws.amazon.com/blogs/machine-learning/boost-inference-performance-for-llms-with-new-amazon-sagemaker-containers/)
* [2023/11/13] [H200 在 Llama2-13B 上达成近 12,000 tok/sec 吞吐量](./docs/source/blogs/H200launch.md)
* [2023/10/22] [🚀 在 Windows 上结合 TensorRT LLM 与 LlamaIndex 运行 RAG 检索增强生成 🦙](https://github.com/NVIDIA/trt-llm-rag-windows#readme)
* [2023/10/19] 快速上手指南 - [使用 NVIDIA TensorRT-LLM 优化大语言模型推理正式公开发布](https://developer.nvidia.com/blog/optimizing-inference-on-llms-with-tensorrt-llm-now-publicly-available/)
* [2023/10/17] [借助适用于 Windows 的 TensorRT LLM,RTX 显卡上的大语言模型运行速度提升高达 4 倍](https://blogs.nvidia.com/blog/2023/10/17/tensorrt-llm-windows-stable-diffusion-rtx/)
## 项目概览 (TensorRT LLM Overview)
**TensorRT LLM** 是一套专为优化大语言模型(LLM)与视觉生成模型(Visual Gen)推理而开源的高性能计算库。它提供业界最前沿的推理优化技术,包括针对常见推理操作(注意力机制 Attention、通用矩阵乘法 GEMM、混合专家模型 MoE 等)的定制优化 Kernel、算法级运行时优化(预填充与解码解耦 Prefill-Decode Disaggregation、宽专家并行 Wide Expert Parallelism、投机解码 Speculative Decoding 等),以在 NVIDIA GPU 上实现极致高效的推理运行。
[基于 PyTorch 架构打造](https://github.com/NVIDIA/TensorRT-LLM/blob/release/1.1/docs/source/developer-guide/overview.md),TensorRT LLM 提供了易用的上层 Python [LLM API](https://nvidia.github.io/TensorRT-LLM/quick-start-guide.html#llm-api),全面支持从单卡、多卡到多节点集群部署的多样化推理场景。它内置多种分布式并行策略及高级特性,并能无缝接入更广泛的推理生态体系,包括 NVIDIA [Dynamo](https://github.com/ai-dynamo/dynamo) 与 [Triton Inference Server](https://github.com/triton-inference-server/server)。
TensorRT LLM 采用模块化设计且易于二次开发。其原生 PyTorch 架构允许开发者自由探索运行时机制或扩展系统功能。仓库中已预先定义了多种前沿主流模型,并支持通过[原生 PyTorch 代码](./tensorrt_llm/_torch/models/modeling_deepseekv3.py)进行深度定制,轻松适配具体的业务与工程需求。
## 快速上手 (Getting Started)
要开始使用 TensorRT-LLM,欢迎查阅官方文档:
- [快速上手指南 (Quick Start Guide)](https://nvidia.github.io/TensorRT-LLM/quick-start-guide.html)
- [运行 DeepSeek 示例](./examples/models/core/deepseek_v3)
- [安装指南 (Installation Guide)](https://nvidia.github.io/TensorRT-LLM/installation/index.html)
- [支持的硬件架构、模型与关联软件矩阵 (Support Matrix)](https://nvidia.github.io/TensorRT-LLM/reference/support-matrix.html)
- [性能基准测试指南 (Benchmarking Performance)](https://nvidia.github.io/TensorRT-LLM/performance/performance-tuning-guide/benchmarking-default-performance.html#benchmarking-with-trtllm-bench)
- [版本发布说明 (Release Notes)](https://nvidia.github.io/TensorRT-LLM/release-notes.html)
## 弃用政策 (Deprecation Policy)
弃用机制用于提前向开发者预警某些 API 和工具已被列入废弃计划、不再推荐使用。自 1.0 版本起,TensorRT LLM 遵循以下弃用政策:
1. 弃用信息告知 (Communication of Deprecation)
- 弃用通知将在版本发布说明(Release Notes)中明确记载。
- 被弃用的 API、方法、类或参数将在源代码中包含显式注释,注明其被弃用的具体版本。
- 在运行时调用被弃用的方法、类或参数时,系统将发出运行时弃用警告。
2. 迁移过渡期 (Migration Period)
- TensorRT LLM 自宣布弃用之日起提供为期 3 个月的迁移过渡期。
- 在此过渡期内,被弃用的 API、工具或参数仍可正常工作,但会触发弃用警告。
3. 弃用范围 (Scope of Deprecation)
- 完整 API/方法/类弃用:整个 API、方法或类被标记为未来移除。
- 部分参数弃用:若仅弃用了某一 API/方法的特定参数(例如 `LLM.generate(param1, param2)` 中的 `param1`),方法本身仍保持可用,仅弃用参数将在后续版本中移除。
4. 过渡期结束后的正式移除 (Removal After Migration Period)
- 3 个月迁移过渡期结束后,被弃用的 API、工具或参数将遵循语义化版本规范正式移除(主版本号变更可能包含破坏性移除变更)。
## 遥测数据收集说明 (Telemetry Data Collection)
TensorRT-LLM 默认会收集匿名的遥测数据。这些数据仅以聚合汇总的方式用于理解整体使用模式并指导工程研发优先级。**收集的数据绝无法反向追踪至任何个人用户。** 系统绝不收集任何 Prompt 提示词文本、模型输出文本、模型权重、模型路径、分词器路径、用户身份识别信息、原始自由格式配置字符串或持久化唯一标识符。任何部署标识符均为临时随机生成、随单次部署生命周期即用即弃,且绝不与用户身份绑定。收集的数据项包括:
- 访问入口点(例如 LLM API、CLI 命令行、serve 服务命令)
- 部署持续运行时间(通过周期性心跳信号上报)
- GPU 硬件型号规格(SKU)、卡数、显存容量及 CUDA 版本
- 公开的模型架构标识符(例如 `LlamaForCausalLM` 或 `Qwen3ForTextEmbedding`)。这可以是上游模型的检查点架构,也可以是 TensorRT-LLM 文档中公开记载的运行时架构。任何不在已登记公开白名单中的自定义标识符,仅会以确定性 SHA-256 哈希值形式上报,绝不上报原始自定义名称
- 并行策略配置(TP/PP/CP/MoE-EP/MoE-TP 并行度)、量化算法、计算数据类型(dtype)、KV 缓存数据类型
- 系统环境信息(操作系统平台、Python 版本、CPU 架构体系、CPU 核心数)
- TRT-LLM 版本号及执行后端
- 特性启用概览标识(LoRA、投机解码、前缀缓存 Prefix Caching、CUDA Graphs、分块上下文 Chunked Context、数据并行)
- 分离式解耦推理服务元数据(节点角色与临时部署 ID)
- 本地进程级 LLM 生命周期统计(初始化尝试次数、成功与活跃实例数、峰值并发度、初始化失败次数)
- 受监控进程的有界终止状态(已知退出码或系统信号、终止类型归类、生命周期阶段、组件模块与上报来源)
- 选定的 LLM API 配置参数:并行度、数据类型、KV 缓存、调度器、CUDA Graph 及编译配置项
- 诊断数据指纹:用于验证数据来源的 Schema 校验和、已采集字段计数,以及是否跳过了任何自由格式文本值
在 CI 自动化测试与离线评测环境中,遥测数据收集会自动被完全禁用。
若 LLM 启动失败,初始上报数据仍可包含当前可用的环境信息与经过脱敏清洗的配置信息,并标记为部分上下文。
### 退出遥测数据收集 (Opting Out of Telemetry Data Collection)
如需关闭遥测数据收集,可使用以下任意一种方法:
- **环境变量**:设置 `TRTLLM_NO_USAGE_STATS=1`、`DO_NOT_TRACK=1` 或 `TELEMETRY_DISABLED=true`
- **配置文件**:创建空文件 `~/.config/trtllm/do_not_track`
- **Python API**:在初始化时向 `LLM()` 传入 `TelemetryConfig(disabled=True)`
- **CLI 命令行参数**:在运行 `trtllm-serve`、`trtllm-bench` 或 `trtllm-eval` 时添加 `--no-telemetry` 参数
CLI 终端遥测可能会记录某个参数或 YAML 配置格式无效。此类终止事件仅记录分类性的终止原因与生命周期元数据,绝不记录任何原始参数或 YAML 配置原文。环境变量、配置文件和 CLI 标志等退出设置均会在 CLI 及 YAML 解析校验之前优先读取并生效。
遥测收集源码完全开源且透明可审计,位于 [`tensorrt_llm/usage/`](./tensorrt_llm/usage/)。关于每一项采集字段的详细定义,请参阅 [Schema 模式文档](./tensorrt_llm/usage/schemas/README.md)。
## 常用链接 (Useful Links)
- [Hugging Face 上的预量化模型集合](https://huggingface.co/collections/nvidia/model-optimizer-66aa84f7966b3150262481a4):包含持续丰富扩展的经量化(如 FP8、FP4)与优化的大模型权重,涵盖 [DeepSeek FP4](https://huggingface.co/nvidia/DeepSeek-R1-FP4),支持直接使用 TensorRT LLM 进行极速推理。
- [NVIDIA Dynamo](https://github.com/ai-dynamo/dynamo):专为数据中心级规模设计、可与 TensorRT LLM 无缝配合的分布式推理服务框架。
- [官方微信技术交流群](https://github.com/NVIDIA/TensorRT-LLM/issues/5359):获取 TensorRT LLM 实时答疑与最新动态的技术社群。
---
> **翻译说明(Translation Disclaimer)**
> 本文档由社区志愿者([@JasonYeYuhe](https://github.com/JasonYeYuhe))人工翻译并维护,旨在降低中文开发者的阅读门槛。最后同步日期:2026年10月28日。若译文与英文原版存在任何出入或滞后,请以 [英文原版 (README.md)](README.md) 为准。欢迎通过 PR 协助改进译文!