


English | 简体中文
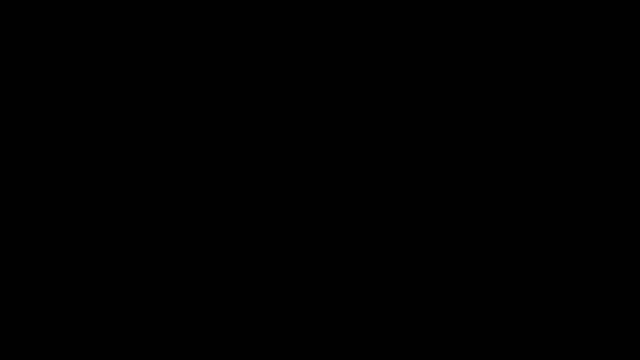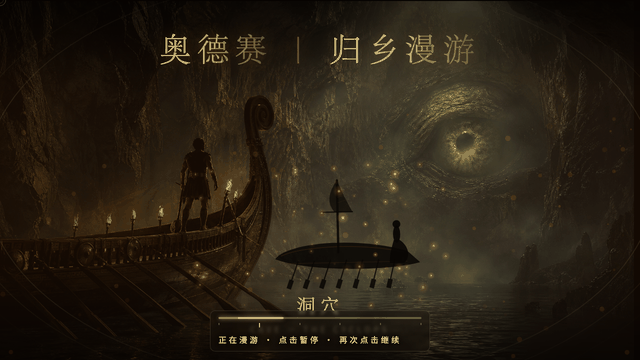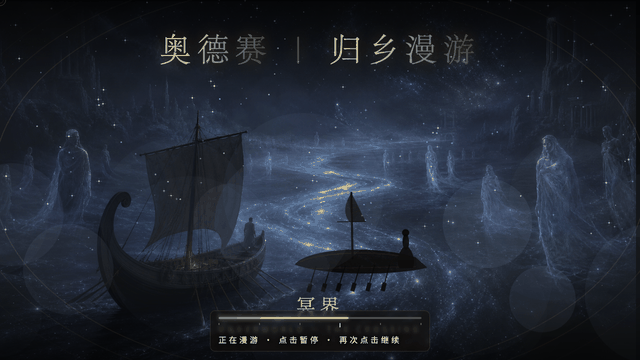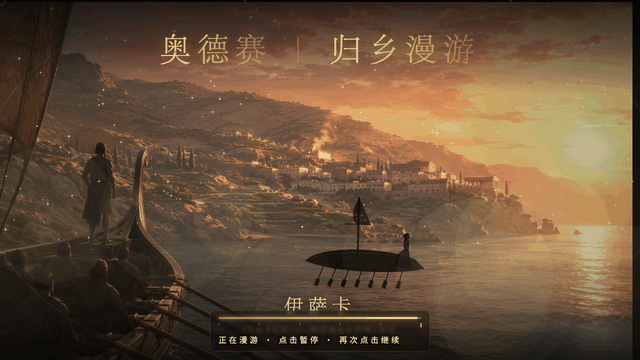 #### PPT 设计
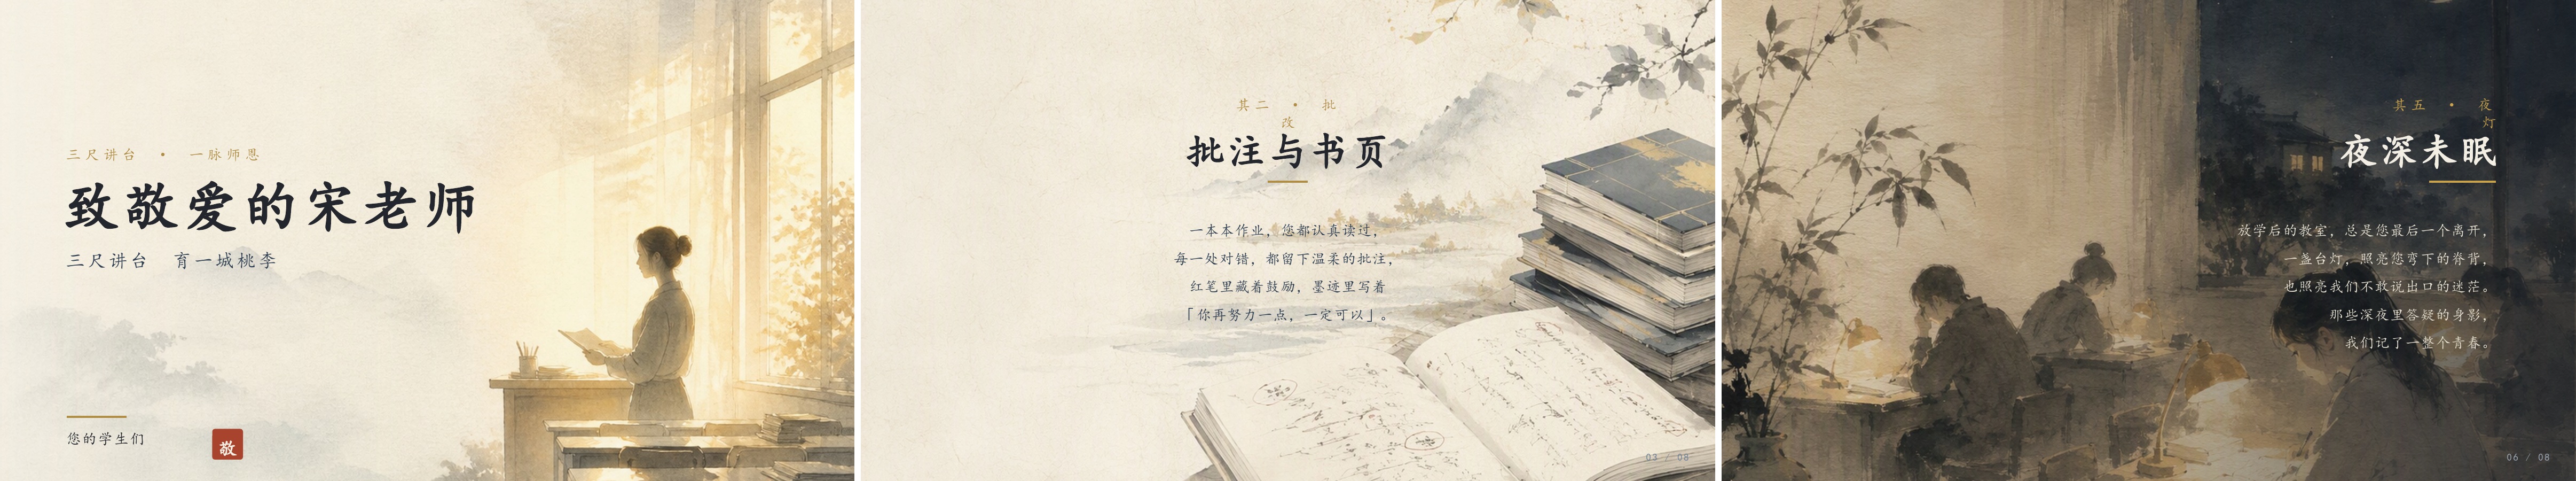
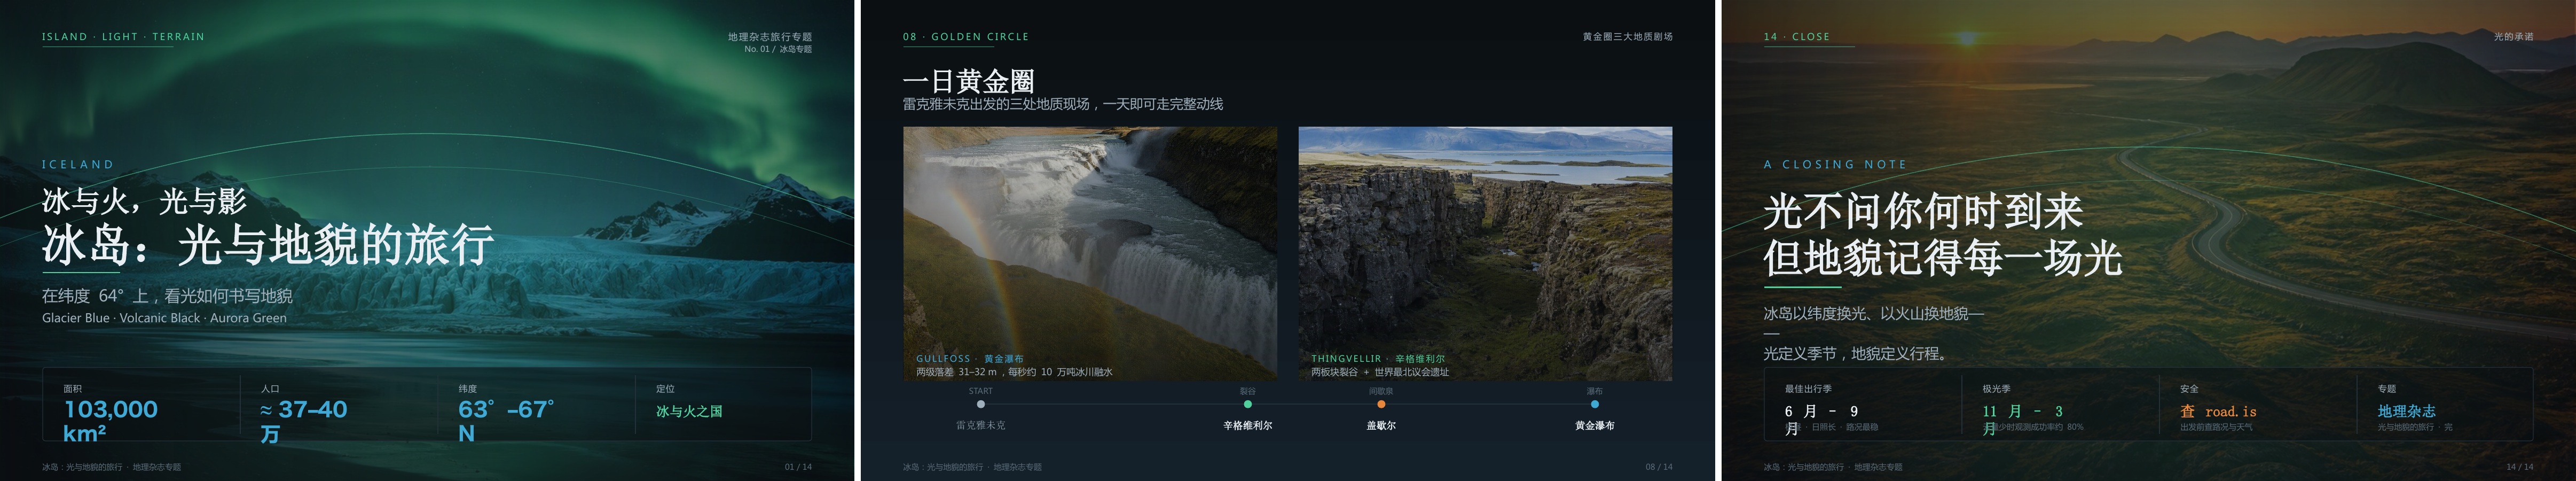
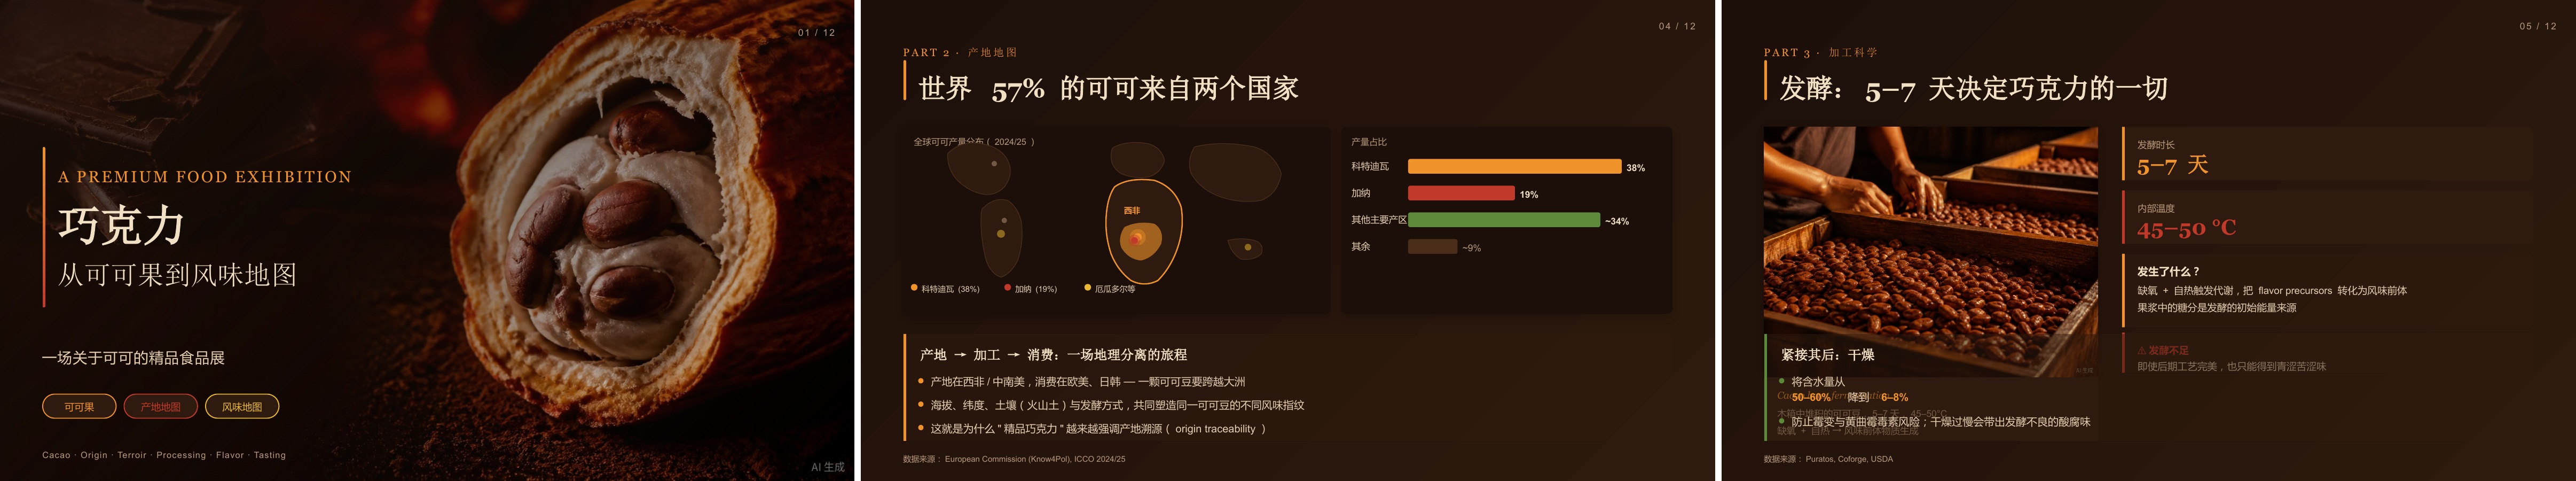
#### 数据分析
## 模型概述
**SenseNova-Loop-9B-Preview** 是一个面向长上下文和智能体工作流的多模态语言模型。模型接收文本和图像输入,生成文本输出,适用于结合文档理解、编程及外部工具交互的应用。
模型将**循环解码器与双流流形约束超连接(mHC)**相结合。一段连续的解码器层共享权重,依次执行两遍;循环模块中的可学习映射负责管理两条残差流之间的信息流动。通过这种设计,模型无需复制循环模块的参数,就能增加实际执行深度。
已有训练方案结合了长序列、多模态输入和带监督的任务轨迹,最长训练序列为 262,144 个 token。为更好地发挥模型性能,建议使用我们提供的部署环境与参数配置。
### 模型亮点
- **共享循环模块:**24 个解码器层依次执行两遍,使 32 个独立层在一次前向传播中完成 56 次层计算。
- **双流 mHC:**通过可学习映射,对循环模块中两条残差流的信息进行路由与融合。
- **混合注意力:**解码器以四层为一个循环单元,交替使用线性注意力与全注意力。
- **长上下文多模态训练:**已有训练方案涵盖文本、图像、代码和工具调用轨迹,序列长度最长为 256K token。
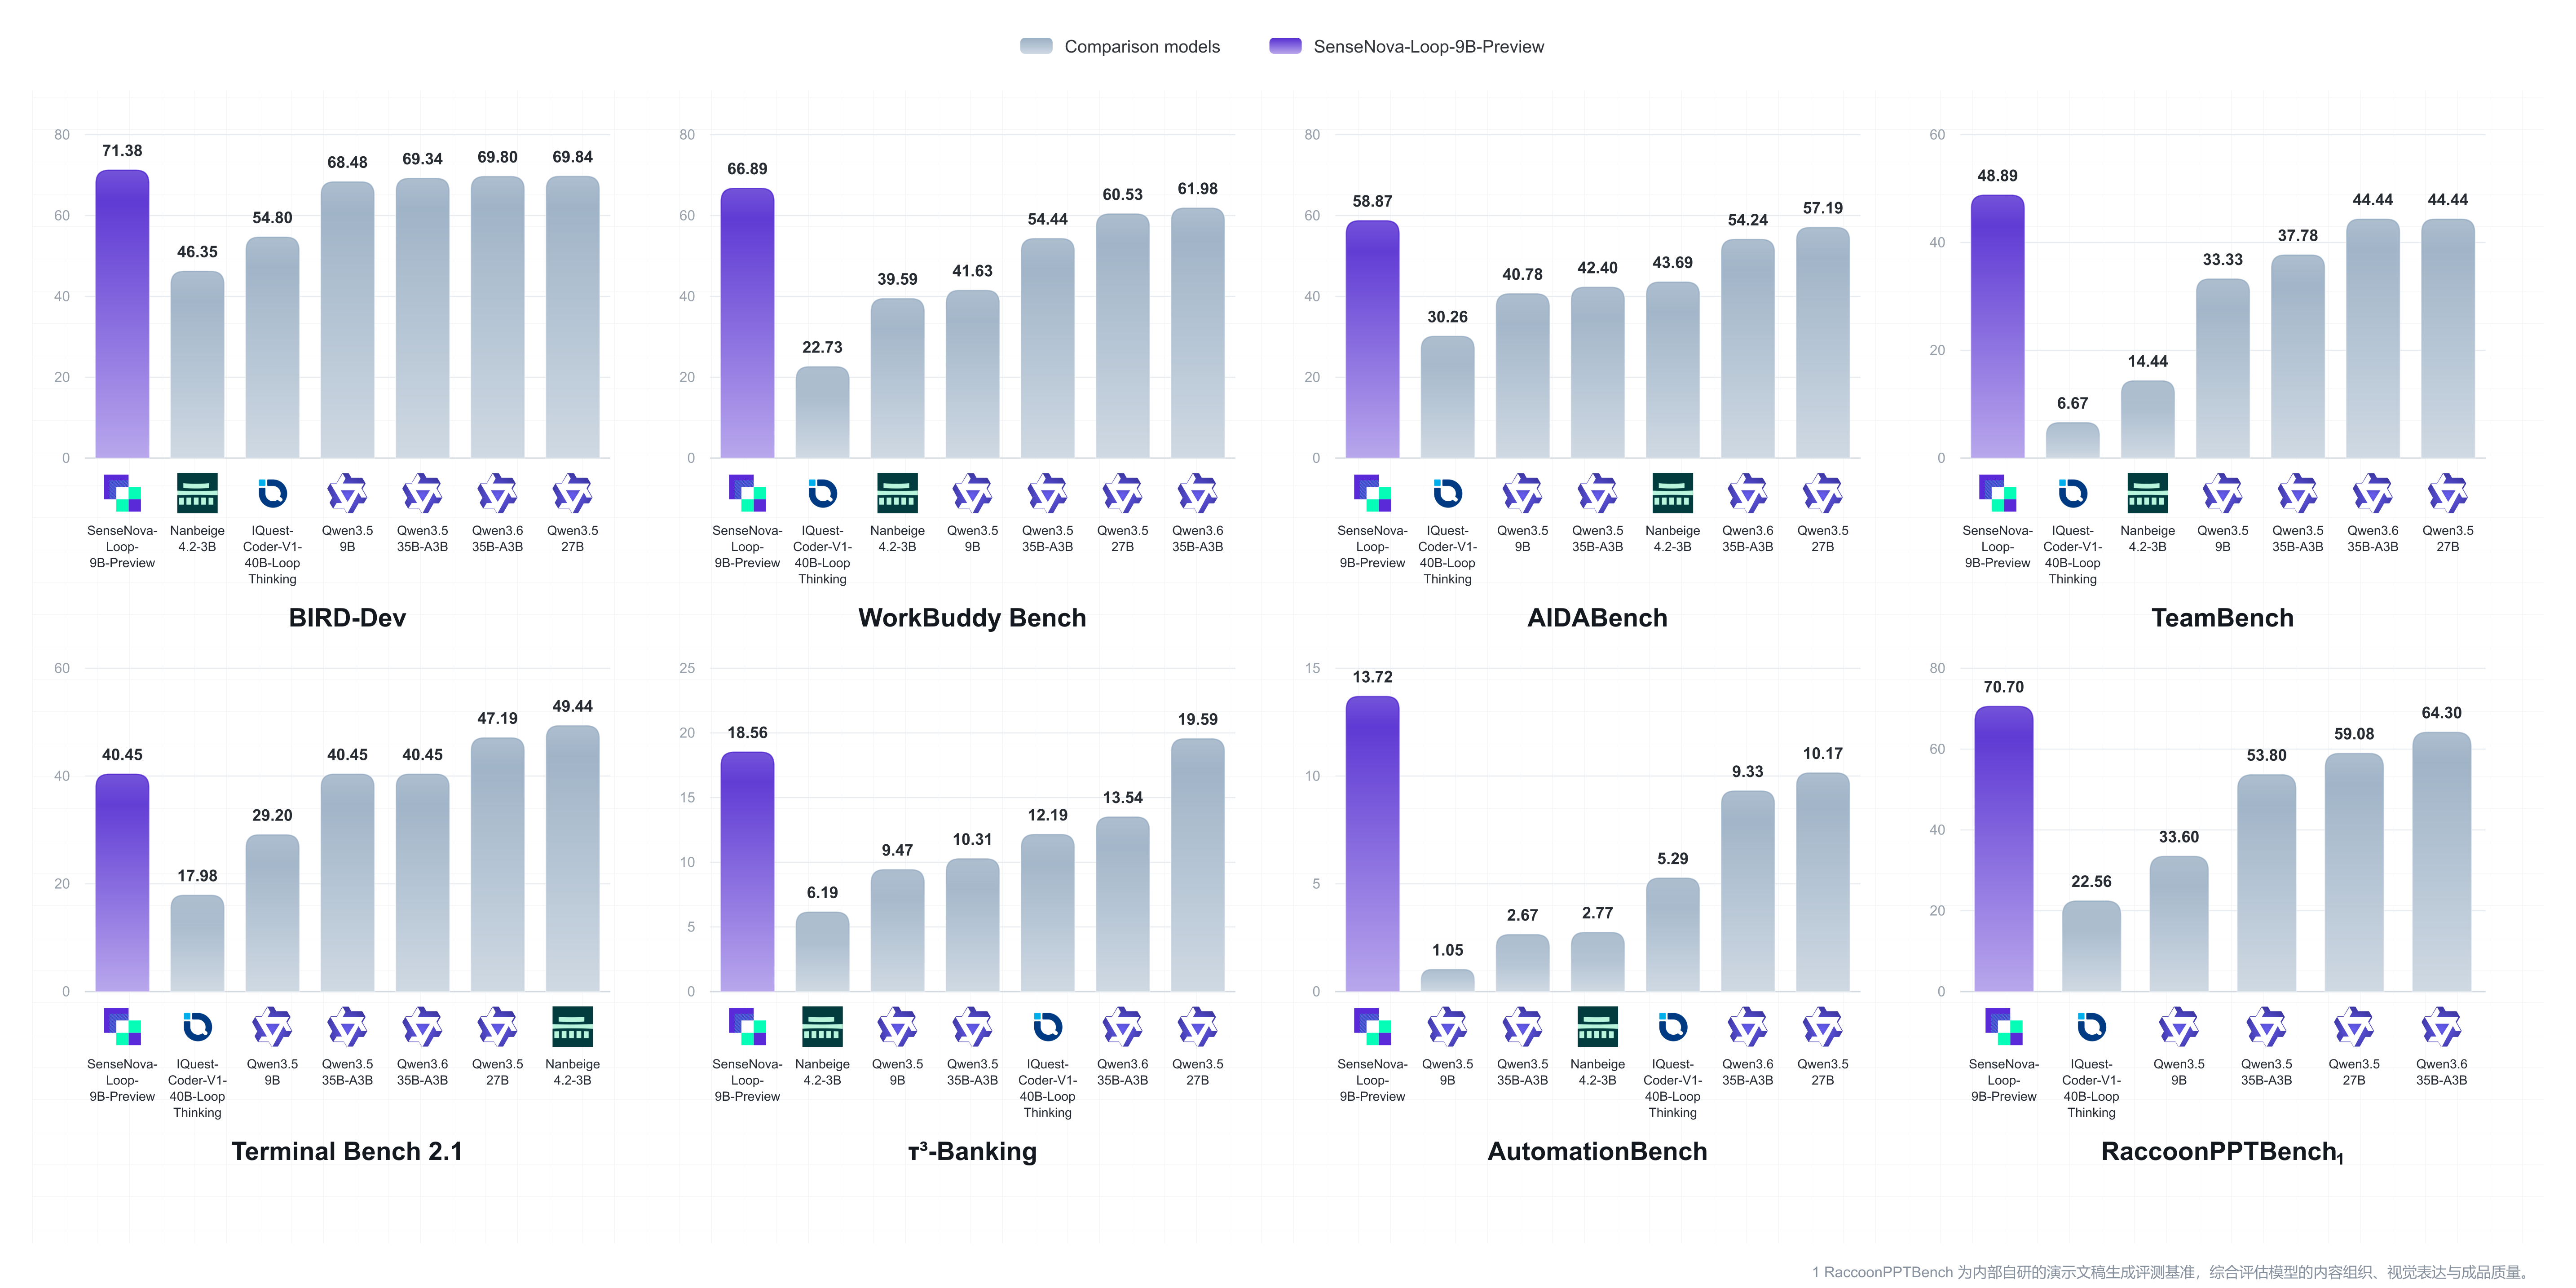
## 📊 核心评测
## 模型规格
| 项目 | SenseNova-Loop-9B-Preview |
| --- | --- |
| 架构 | 自回归多模态解码器;循环模块采用双流 mHC |
| 参数规模 | 总共约 9B 参数,推理实际约 14.6B 参数 |
| 输入 / 输出 | 文本和图像 / 文本 |
| 独立解码器层数 | 32 |
| 循环层范围 / 执行次数 | [4, 28) / 2 次,共享权重 |
| 解码器层执行次数 | 每次前向传播执行 56 次 |
| mHC 残差流数量 | 2 |
| 训练上下文长度 | 最长 262,144 个 token |
| 现有导出精度 | 主干为 BF16;mHC 路由参数为 FP32 |
## 模型架构
SenseNova-Loop-9B-Preview 以 32 层多模态解码器为基础,结合共享权重的循环计算、混合注意力与双流流形约束超连接(mHC)。下文将分别介绍这些组件如何拓展模型的计算路径,并组织模型内部的信息流动。
### 循环解码器
输入首先经过第 0–3 层,随后依次通过同一组第 4–27 层两次,最后由第 28–31 层和输出头生成模型输出。若用 *B* 表示循环模块、*h* 表示其输入,则循环计算可写为 **B(B(h))**。
推理时,模型每次前向传播完成 **56 次解码器层计算,只需存储 32 层解码器权重**。循环模块在两次执行中复用同一组权重,第二次执行以第一次的输出作为输入。
### 混合注意力
解码器交替使用线性注意力层与全注意力层。每四层为一组,依次包含三层线性注意力和一层全注意力。循环模块的边界与完整的四层组对齐,因此两次执行都保持相同的注意力排列。
### 双流 mHC
在循环模块中,mHC 使用两条残差流传递解码器层计算前后的信息。可学习映射决定各层如何读取残差流、混合流间信息,以及将层输出写入残差状态。流间混合映射采用 Sinkhorn 归一化进行约束;已有配置使用 20 次迭代。
循环层范围、执行次数和 mHC 路由参数共同构成模型检查点的执行配置。兼容的推理实现需要加载这些参数,并保持相同的计算顺序。
| 配置 | 数值 |
| --- | --- |
| 独立解码器层数 / 执行次数 | 32 / 56 |
| 循环层范围 / 执行次数 | [4, 28) / 2 |
| 隐藏层维度 | 4,096 |
| 前馈网络维度 | 12,288 |
| 词表大小 | 248,320 |
| 全注意力头数 / KV 头数 | 16 / 4 |
| mHC 残差流数量 / Sinkhorn 迭代次数 | 2 / 20 |
## 推理加速
SenseNova-Loop-9B-Preview 已支持 **MTP** 推理加速。**Dspark** 和 **Dflash2** 正在开发中,目前处于训练阶段。
| 方法 | 状态 |
| --- | --- |
| MTP | 已可用 |
| Dspark | 训练中 |
| Dflash2 | 训练中 |
实际加速效果取决于任务负载、硬件和服务配置。
## 快速开始
使用 Transformers 从 Hugging Face 仓库或本地模型目录中加载模型及其自定义实现。下面的示例展示了如何在单张 GPU 上进行文本生成。
### 环境要求
已核对的推理环境使用 **Transformers 5.18.0** 和 **PyTorch 2.11.0(CUDA 13.0)**。模型目录需要包含配置、分词器、对话模板、模型代码,以及可访问的权重分片。
请先安装与 CUDA 环境兼容的 [PyTorch 版本](https://pytorch.org/get-started/locally/),再安装其余依赖:
```bash
python -m pip install "transformers==5.18.0" accelerate safetensors
```
### 使用 Transformers 生成文本
将 `model_id` 设置为 Hugging Face 仓库 ID 或本地模型目录,然后运行:
```python
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
model_id = "sensenova/SenseNova-Loop-9B-Preview"
device = "cuda:0"
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
model_id,
trust_remote_code=True,
dtype=torch.bfloat16,
device_map={"": device},
).eval()
messages = [{"role": "user", "content": "13 乘以 7 等于多少?只回答数字。"}]
prompt = tokenizer.apply_chat_template(
messages,
tokenize=False,
add_generation_prompt=True,
enable_thinking=False,
)
inputs = tokenizer(prompt, return_tensors="pt").to(device)
with torch.inference_mode():
outputs = model.generate(
**inputs,
max_new_tokens=256,
do_sample=False,
use_cache=True,
)
response = tokenizer.decode(
outputs[0, inputs.input_ids.shape[1]:],
skip_special_tokens=True,
)
print(response)
```
示例采用贪心解码,最多生成 256 个新 token。将 `enable_thinking=True` 可开启思考模式,修改 `device` 可选择其他 GPU。
`trust_remote_code=True` 用于加载 SenseNova Loop 的自定义模型实现。
## 训练
### 主模型训练
在配置好的训练环境中,可使用以下命令在单机 8 卡上对 **SenseNova-Loop-9B-Preview** 进行采用 mHC 的微调:
```bash
git clone https://github.com/OpenSenseNova/torchtitan.git
cd torchtitan
MODEL_PATH=/path/to/SenseNova-Loop-9B-Preview DATASET=/path/to/train.jsonl \
bash examples/train/SenseNova-Loop-9B-Preview/mhc2_loop2_titan.sh
```
请将 `/path/to/train.jsonl` 替换为你的 SFT 数据集路径。配置选项、DPO 和 MTP 训练方法请参见[训练指南](https://github.com/OpenSenseNova/torchtitan/tree/main/examples/train/SenseNova-Loop-9B-Preview)。
### 推测解码训练
如需在单机 8 卡上为 **SenseNova-Loop-9B-Preview** 训练 DSpark 或 DFlash2 draft model,请使用 [SenseSpec 仓库](https://github.com/OpenSenseNova/SenseSpec)提供的训练脚本。
首先,克隆仓库并进入项目目录:
```bash
git clone https://github.com/OpenSenseNova/SenseSpec.git
cd SenseSpec
```
#### DSpark 训练
运行以下命令训练 DSpark draft model:
```bash
bash examples/SenseNova-Loop-9B-Preview-dspark/run.sh
```
#### DFlash2 训练
运行以下命令训练 DFlash2 draft model:
```bash
bash examples/SenseNova-Loop-9B-Preview-dflash2/run.sh
```
## 部署
### [LightLLM](https://github.com/ModelTC/LightLLM)
以下为四卡 GPU 部署示例,请将本地模型路径替换为实际路径:
```bash
docker pull ghcr.io/modeltc/lightllm:main
docker run --rm --gpus all --ipc=host -p 8000:8000 \
-v /path/to/SenseNova-Loop-9B-Preview:/model \
-e LOADWORKER=4 -e LIGHTLLM_TRITON_AUTOTUNE_LEVEL=1 \
ghcr.io/modeltc/lightllm:main \
python -m lightllm.server.api_server \
--model_dir /model --model_name SenseNova-Loop-9B-Preview \
--tp 4 --host 0.0.0.0 --port 8000
```
请求示例:
```bash
curl http://localhost:8000/v1/chat/completions \
-H 'Content-Type: application/json' \
-d '{"model": "SenseNova-Loop-9B-Preview", "messages": [{"role": "user", "content": "Hello!"}], "max_tokens": 128}'
```
### [SGLang](https://github.com/sgl-project/sglang/pull/47281)
请使用包含 SenseNova Loop 实现的 [SGLang PR #47281](https://github.com/sgl-project/sglang/pull/47281) 对应版本,并将下方模型路径替换为本地 checkpoint 目录:
```bash
git clone https://github.com/sgl-project/sglang.git
cd sglang
git fetch origin pull/47281/head
git checkout -b sensenova-loop FETCH_HEAD
python -m pip install -e ./python
sglang serve --model-path /path/to/SenseNova-Loop-9B-Preview
```
### [vLLM](https://github.com/vllm-project/vllm/pull/64832)
请使用包含 SenseNova Loop 实现的 [vLLM PR #64832](https://github.com/vllm-project/vllm/pull/64832) 对应版本进行推理:
```bash
git clone https://github.com/vllm-project/vllm.git
cd vllm
git fetch origin pull/64832/head
git checkout -b sensenova-loop FETCH_HEAD
python -m pip install -e .
vllm serve sensenova/SenseNova-Loop-9B-Preview \
--served-model-name sensenova_loop \
--tensor-parallel-size 4 \
--dtype bfloat16
```
## 许可证与引用
**许可证:**[Apache License 2.0](https://github.com/OpenSenseNova/SenseNova-Loop-9B-Preview/blob/main/LICENSE)。