Arbor — Optimize anything

🌳 Arbor

在相同算力预算下,效果超越 Claude Code 与 Codex 2.5× 的自主科研智能体

Paper GitHub Project Page Live Demo Docs Discussions License: Apache 2.0

English | 简体中文

给 Arbor 一个基准和一个目标。它会提出假设、修改代码、运行真实实验,只保留经得起留出 数据验证的改进——生长出一棵假设树,而不是过后即弃、忘记失败的教训。

> **▶️ 30 秒上手——无需 API key,无需配置:** > > ```bash > pip install arbor-agent && arbor replay --demo # 实时观看假设树的生长过程 > ``` > > 或者**现在就在浏览器里看**——无需安装任何东西:**[▶️ 在线 Demo](https://RUC-NLPIR.github.io/Arbor/demo.html)**。 ### 🏆 一个控制器,六项任务——全部赢下留出测试集 | 任务 | 指标 | Claude Code | Codex | **Arbor** | | --- | --- | :---: | :---: | :---: | | BrowseComp | acc ↑ | 53.33 | 50.00 | **67.67** | | Terminal-Bench 2.0 | pass ↑ | 71.70 | 73.59 | **77.36** | | Math-Reasoning Data | gap ↑ | 8.33 | 6.25 | **20.83** | 外加 **MLE-Bench Lite 上 86.36% Any-Medal**(GPT-5.5)。→ [查看全部六项任务](#-实验结果) · [项目主页](https://ruc-nlpir.github.io/Arbor/) · [论文](https://arxiv.org/pdf/2606.11926) · [文档](https://ruc-nlpir.github.io/Arbor/docs/) ## 📣 最新动态 - **2026-06-30** — **Arbor 会从自己的运行中学习。** 每次运行都会留下具体、可复用的发现——数据集上能提分的特性、需要避开的坑;下次类似任务在 intake 时把它们召回,于是 agent 从经验出发,而不是从零开始。🧠 - **2026-06-22** — **内置文献检索与想法新颖性审查。** Arbor 现在可以通过 [alphaXiv](https://www.alphaxiv.org) 公共 API 把研究建立在已有工作之上——零配置,无需搜索端点或密钥。动手前用 `arbor idea-check "<你的想法>"` 审查任意想法的新颖性,或让 Coordinator 自动为每个新分支把关。详见[文献检索与新颖性审查](#-文献检索与新颖性审查)。🔎 - **2026-06-18** — Arbor 被美国知名科技媒体 [VentureBeat](https://venturebeat.com/) 报道:[《New AI optimization framework beats Claude Code and Codex by 2.5x on the same compute budget》](https://venturebeat.com/orchestration/new-ai-optimization-framework-beats-claude-code-and-codex-by-2-5x-on-the-same-compute-budget)。📰 - **2026-06-12** — Arbor 原生 CLI 运行时与智能体技能套件(Codex / Claude Code)正式发布。🚀 - **2026-06-11** — Arbor 论文在 [arXiv](https://arxiv.org/abs/2606.11926) 发布。🎉 ## 💡 为什么选择 Arbor - **通用优化能力** — 只要有明确的优化目标和可量化的指标,无论模型训练、评测工程还是数据合成,Arbor 都能胜任。 - **长期结构化探索** — 假设树框架进行累积式搜索:实验结果、失败原因与提炼的洞察都保存在想法树中并向上传播,让后续想法越来越聪明,而非淹没在上下文滚动里。 - **严格的实验纪律** — 执行器在开发集上迭代、在留出测试集上验证,只有超过可配置阈值的改进才会合并——且每个实验都在独立 git 工作树中运行,合并前 `main` 始终不受影响。 - **基于文献的想法把关** — 免 key 搜索后端(alphaXiv + 网页)在投入算力*之前*审查想法的新颖性与先行工作,以节点判定或 `arbor idea-check` 呈现。 - **灵活的模型与工作流** — 通过 LiteLLM 支持 Anthropic、OpenAI / Responses API 及 OpenAI 兼容后端(DeepSeek、Gemini、Qwen、vLLM、Ollama…),既可用原生 CLI,也可作为技能套件在 Codex / Claude Code 中加载。 - **高度可控** — 实时仪表盘、只读 WebUI、可选人工审核,以及一行配置的领域插件,让你无需改动核心代码即可调整实验走向。 ## 🧩 框架原理
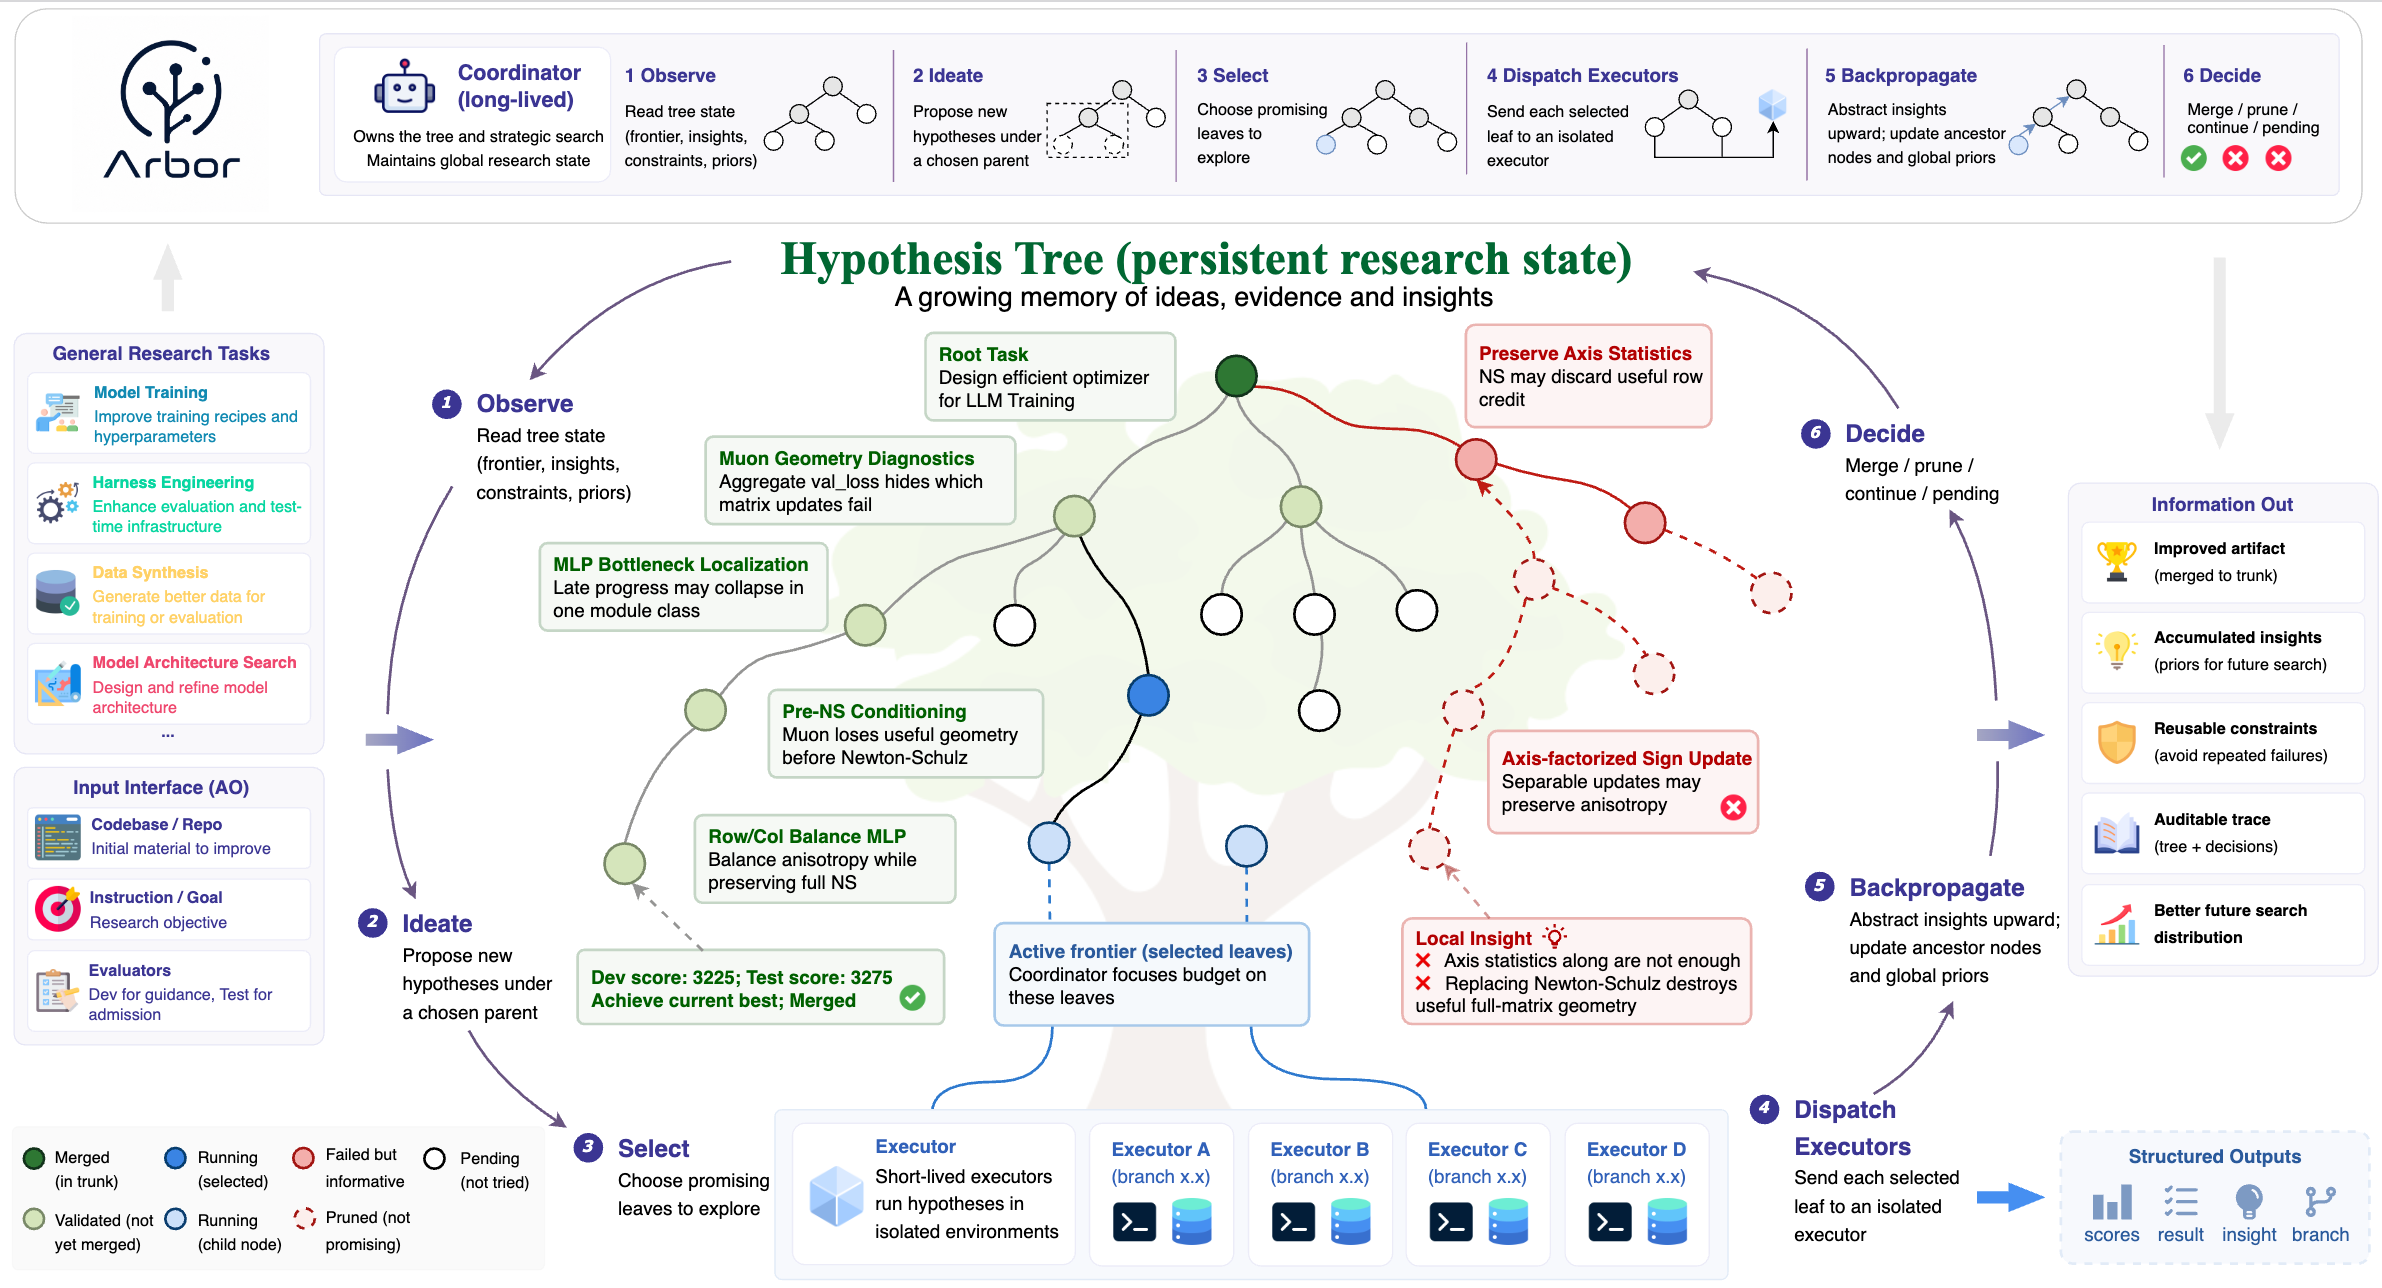
Arbor 框架

Arbor 由**两个协同工作的智能体**组成: - **协调器(Coordinator)** — 研究总监。负责维护想法树、驱动 Arbor 循环并下发实验任务。 - **执行器(Executor)** — 研究工程师。接收单个想法后,忠实地实现代码变更,在隔离的 git 工作树中运行实验,并汇报实验证据。 两者共同重复执行六步 **Arbor 循环**: 1. **观察(Observe)** — 协调器重新审视想法树,读取当前活跃前沿、约束条件、祖先节点的洞察、近期实验证据及当前最优产物。 2. **构思(Ideate)** — 选择一个父节点,提出子假设,对树中已有知识进行精化、修正或扩展。 3. **择优(Select)** — 在当前最优方向与未解决的备选方案之间取得平衡,选出最值得测试的待处理叶节点。 4. **派发(Dispatch)** — 将选中的假设分发给独立的执行器,执行器在全新工作树中实现并在开发信号上评估。 5. **反向传播(Backpropagate)** — 记录每个实验的结果、分数、洞察和分支,并将归纳出的经验向上传递给祖先节点和未来的想法。 6. **决策(Decide)** — 协调器决定是否合并、剪枝、继续探索、将节点置为待定,或终止研究,合并决策以留出集验证为依据。 ## 🎬 演示 https://github.com/user-attachments/assets/49c1a306-d2e9-49d6-9c83-65e38a62df30 ## 🚀 CLI 与技能套件版本 本仓库提供三种使用 Arbor 的方式: | 版本 | 位置 | 适用场景 | 是否需要 API 密钥? | | --------------- | ---------------------------------------------------- | ------------------------------------------------------------ | ----------------------------------------------------------- | | 原生 CLI 运行时 | Python 包及 `arbor` 命令 | 真实的 Arbor 研究运行、长时间实验、仪表盘、检查点、执行器工具、合并/测试纪律、插件、报告 | **需要** —— 在 `arbor setup` 中配置 provider/model。 | | 无密钥 Harness 集成 | `arbor install` + `arbor mcp`(或 Claude Code 插件) | 在 **Claude Code / Codex 内部、直接使用该 harness 自带的模型** 运行 Arbor —— 例如 Claude 订阅套餐,没有可提供给 Arbor 的 API 密钥 | **不需要** —— 由宿主模型充当大脑,Arbor 只提供确定性工具。 | | 智能体技能套件(独立) | [`skills/`](skills/README.md) | 不安装 Python 包也能复现上面的 harness 流程 —— 纯指令 + 一个仅依赖标准库的兜底脚本 | **不需要** | 如果你能运行 CLI 并且有 API 密钥,原生运行时提供最完整的 Arbor 行为:任务摄入、研究合同、实时仪表盘、事件总线、检查点与恢复、执行器派发、受保护的开发/测试评估纪律、搜索智能体、插件和最终报告生成。如果你只有一个使用订阅模型(没有原始 API 密钥)的编程智能体,请使用下面的 **无密钥 Harness 集成** —— 见[在 Claude Code 或任意 Harness 中使用](#-在-claude-code-或任意-harness-中使用无需-api-密钥)。 仓库根目录下的 [`skills/`](https://claude.ai/chat/skills/README.md) 目录是一套 Codex/Claude Code 技能套件。安装完成后,在 Codex 中调用 `$arbor-research-agent`,或在 Claude Code 中调用 `/arbor-research-agent`,然后像描述 Arbor 任务一样描述你的研究目标即可。当目标、指标、数据、权限、预算或运行模式不明确时,技能套件会先进行 Arbor 风格的澄清确认,再加载协调器和各阶段技能。该目录与存放在 `src/skills/` 下的内部运行时技能是分开的。 ------ ## 📦 安装 **环境要求:** Python ≥ 3.10 及 Git。推荐使用虚拟环境。 ```bash pip install arbor-agent # 或使用:uv pip install arbor-agent arbor doctor # 验证 PATH、git 及 API 密钥 ``` > 想要全局命令?使用 `pipx install arbor-agent` 可将 `arbor` 命令安装至全局环境。
从源码安装(用于开发) ```bash git clone https://github.com/RUC-NLPIR/Arbor.git cd Arbor python -m venv .venv && source .venv/bin/activate # 推荐 pip install -e . # 或使用:uv pip install -e . arbor doctor ``` 若需本地查看文档站点,运行 `pip install -e ".[docs]" && mkdocs serve`,或通过上方的 **Docs** 徽章在线阅读。
------ ## 🔑 在 Claude Code 或任意 Harness 中使用(无需 API 密钥) 在 Claude **订阅套餐** 下,你没有可以交给独立工具的 API 密钥。Arbor 的无密钥集成 解决了这个问题:**Arbor 自身从不调用 LLM** —— 由你的编程智能体自带的模型驱动研究 循环,而 Arbor 以确定性工具的形式提供持久化的 Idea Tree、评估、git worktree 隔离、 受保护的合并以及报告。 **1. 安装技能套件**(无需再手动复制目录): ```bash pip install arbor-agent arbor install # 自动检测 harness;也可用 --claude / --codex / --project / --target ``` **2. 注册无密钥工具服务**(可选但推荐 —— 让技能运行在 Arbor 真实的 树/评估/合并/报告实现之上): ```bash pip install "arbor-agent[mcp]" # MCP 服务是可选附加项 claude mcp add arbor -- arbor mcp # Claude Code;任何支持 MCP 的 harness 均可 ``` **或使用 Claude Code 插件一步到位:** ```bash claude plugin marketplace add RUC-NLPIR/Arbor claude plugin install arbor # 安装技能 + 注册 arbor mcp ``` **3. 在项目内、于编程智能体中运行:** ```text /arbor-research-agent optimize this repo for . Ask before training, package installs, or B_test. ``` **4. 在浏览器中查看进度**(只读,同样无需密钥)。可让智能体调用 `open_dashboard` 工具,或自己运行: ```bash arbor web # 在 http://127.0.0.1:8765 提供该 session 的视图 ``` 之后如需移除技能:`arbor uninstall`(只会处理 Arbor 自己的 `arbor-*` 目录)。 完整的技能套件说明与手动安装步骤见 [`skills/README.md`](skills/README.md)。 ------ ## ⚡ 快速开始 **先看它跑起来 —— 无需 API 密钥、无需配置:** ```bash arbor replay --demo # 回放一次录制好的运行:假设树在眼前生长 ``` > 想要可分享的版本?`arbor replay --demo --html` 会生成一个自包含的交互式页面 > (无需服务器、无外部依赖),可在浏览器打开或附到任意地方。 **然后在你自己的任务上运行:** ```bash arbor quickstart # 约 2 分钟:免费密钥(Gemini/Groq)或本地模型(Ollama) arbor # 在当前目录启动交互式会话 ``` 已有模型提供商?`arbor setup` 提供完整的 提供商 / 模型 / base_url / API 密钥 配置流程; `arbor doctor` 用于诊断安装。`quickstart` 与 `setup` 都会将配置写入 `~/.arbor/config.yaml`,此后日常使用直接运行 `arbor` 即可,无需额外参数。Arbor 启动后首先进行一次**任务摄入对话**,将你的目标、目标目录、评估指标、基线、预算、开发/测试纪律和产物路径整理成一份简洁的 **Arbor 研究合同**。阅读/讨论请求保持在受限的只读模式;实验计划会先暂存,只有你在后续消息中明确确认后才会启动。确认完整合同后,实时仪表盘随即接管。 ```bash # 指定基准目录和配置文件 arbor --cwd ./benchmark --config research_config.yaml # 预先提供初始目标,摄入对话会补全其余细节 arbor "提升验证集分数,不得修改测试集" --cwd ./benchmark # 小规模试运行 arbor --cwd ./benchmark --config research_config.yaml --max-cycles 3 ``` 运行过程中,你可以随时输入 `/status`、`/tree`、`/evidence`、`/branches`、`/cost`、`/pause`、`/resume`、`/report` 或 `/abort` 来查看状态或控制流程。 ### 准备基准 你的目标目录应包含: - 一个可运行的评估脚本(例如 `run_eval.py`), - 评估数据(最好区分**开发集**和留出的**测试集**),以及 - 一个干净的 git 仓库(无未提交的改动)。 一个最简的 `research_config.yaml` 示例: ```yaml # LLM/API 配置由 `arbor setup` 管理;项目配置通常只需指定任务和预算。 task: > 优化智能体在该基准上的准确率。 不得修改评估框架或数据文件。 coordinator: max_cycles: 10 # Arbor 循环轮数 max_depth: 2 # 想法树深度 merge_threshold: 5.0 # 合并到主干所需的留出集最低提升百分比 ui: interaction_mode: review # auto | direction | review | collaborative executor: max_turns: 100 ``` 包含所有选项的完整示例配置文件位于 [`examples/research_config.example.yaml`](https://claude.ai/chat/examples/research_config.example.yaml)。 ### 试用可运行的示例任务 如果你只想完整地看一遍 Arbor 是怎么工作的——**不耗 API 预算、不需要 GPU**—— [`examples/algotune_knn/`](examples/algotune_knn) 是一个仿照 [AlgoTune](https://algotune.io/) 的迷你基准。任务是让一个暴力 k 近邻求解器在**输出完全相同**的前提下**跑得更快**, 指标是相对参考实现的加速比。它纯 NumPy、仅用 CPU、亚秒级、且完全确定性,并留有多个 真实可达的优化点供想法树去发现。 ```bash cp -r examples/algotune_knn /tmp/algotune_knn # 在 Arbor 仓库之外运行 cd /tmp/algotune_knn git init -q && git add -A && git commit -qm baseline arbor ``` 在一次 6 轮的运行中,它把开发集加速比从 **1.01x 提升到 7.77x**(留出测试集 **1.00x → 7.22x**)。 研究契约与可调参数详见 [`examples/algotune_knn/README.md`](examples/algotune_knn/README.md)。 ------ ## 🧠 工作原理 ### Arbor 循环 每轮循环执行六个步骤: ``` ① 观察(OBSERVE) 分析当前结果与失败模式 ② 构思(IDEATE) 基于分析和树中洞察,提出 1–3 个新想法 ③ 择优(SELECT) 选择优先级最高的想法进行测试 ④ 派发(DISPATCH) 在隔离的 git 工作树中运行执行器 ⑤ 反向传播(BACKPROP) 记录结果,将洞察向上抽象至祖先节点 ⑥ 决策(DECIDE) 继续 / 合并到主干 / 剪枝 / 停止 ``` ### 想法树 ``` ROOT(基线:20%) ├── 1:检索优化 [洞察:"检索质量是瓶颈"] │ ├── 1.1:约束分解 + 验证 [40%,已合并] │ ├── 1.2:周期性重读注入 [40%,已剪枝 — 无净收益] │ └── 1.3:答案抽取调优 [35%,已剪枝] ├── 2:多视角搜索 [洞察:"搜索脚手架在此场景下有害"] │ └── 2.1:广度优先搜索 [25%,已剪枝] └── 3:代码层干预 [洞察:"代码层 > 提示层"] ├── 3.1:续写注入 [70%,已合并] └── 3.2:ANSWER 标签抽取 [45%,已完成] ``` - **深度 0(根节点):** 研究目标与全局洞察。 - **深度 1:** 研究方向(论文题目级别的想法)。 - **深度 2+:** 具体方法,由执行器实现并测试。 ### Git 策略与评估 每个执行器在专属分支的独立工作树中工作。经过验证的改进会合并到本次运行专属的 `trunk` 分支;只有当你满意时,才将 `trunk` 推入 `main`(`git merge research/run_xxx/trunk`)。执行器在**开发集**上迭代,但一个改动只有在**留出测试集**上超过阈值才会被保留,以防止对评估指标的过拟合。 ### 人工介入 通过 `ui.interaction_mode`(或 `--interaction-mode`)设置你的介入程度: | 模式 | 行为 | | --------------- | -------------------------------------- | | `auto` | 完全自主运行。 | | `direction` | 在构思阶段询问你下一步的方向。 | | `review` | 在每个节点和执行器启动前暂停等待确认。 | | `collaborative` | `direction` + `review` 的组合。 | 在完全自主模式下,如果纯文本回复声明了马上要执行的下一步操作,Arbor 会先提示智能体 实际执行该操作,再将本次运行视为完成。 暂停时,你的输入会开启一个与只读伴侣智能体的独立讨论,不会污染协调器的上下文。完整说明请参阅 [`docs/`](https://claude.ai/chat/docs/index.md)。 ------ ## ⚙️ 配置 通过 `arbor setup` 一次性配置 LLM 访问(存储在 `~/.arbor/config.yaml`),只需填写一个 `provider` 字段: | `provider` | 适用场景 | | --- | --- | | `auto`(默认) | 交给 Arbor 自动判断:探测端点的 OpenAI **Responses** API,支持就用(保留思维链),否则回退到 chat completions;Claude 模型走原生 Anthropic API。探测结果会被冻结写入配置。 | | `openai-responses` | OpenAI / o 系列模型,走 Responses API(跨轮保留加密思维链)。 | | `openai-chat` | 任何 OpenAI 兼容的 chat-completions 端点——DeepSeek / Qwen / GLM / vLLM / Ollama / 本地网关。 | | `anthropic` | Claude,走原生 Anthropic Messages API(签名思维块 + 提示缓存)。 | 大多数用户只需运行 `arbor setup`、保持 `auto`、填好 `model` 与 `base_url` 即可。API 密钥从环境变量或配置文件中读取;针对具体项目的任务和预算配置则放在 `research_config.yaml` 中。详情请参阅[配置指南](https://ruc-nlpir.github.io/Arbor/docs/configuration/)和 [`examples/research_config.example.yaml`](examples/research_config.example.yaml)。 ------ ## 🧰 CLI 参考 日常使用只需记住 `arbor`: | 命令 | 功能 | | ------------------------ | ----------------------------------------------------------- | | `arbor` | 启动交互式研究会话。 | | `arbor --continue`(`-C`) | 续聊当前目录下最近一段未结束的规划对话(类似 `claude -c`)。 | | `arbor replay --demo` | 在实时仪表盘里回放一次内置示例运行 —— 无需 API 密钥;加 `--html` 生成可分享的网页。 | | `arbor replay ` | 按时间轴回放任意历史运行的 `events.jsonl`(`--html` 可导出交互式页面)。 | | `arbor quickstart` | 用免费密钥(Gemini/Groq)或本地模型(Ollama)快速跑起来。 | | `arbor setup` | 配置模型提供商 / 模型 / API 密钥 → `~/.arbor/config.yaml`。 | | `arbor report ` | 重新渲染某次历史会话的 `REPORT.md`。 | | `arbor idea-check "<想法>"` | 针对单个想法对照 alphaXiv 做新颖性 / 先行工作审查(Python ≥ 3.12 默认内置)。 | | `arbor export [output]` | 将历史会话导出为自包含 HTML;当 `output` 以 `.jsonl` 结尾时导出 JSONL。 | | `arbor doctor` | 诊断安装状态、PATH、git 及 API 密钥。 | | `arbor version` | 打印已安装的版本号。 | | `arbor install` / `arbor uninstall` | 将智能体技能套件安装到编程智能体 / 从中移除(`--claude` / `--codex` / `--project` / `--target`)。 | | `arbor mcp` | 以 MCP 服务的形式运行 Arbor 的无密钥确定性工具(需要 `[mcp]` 附加项)。 | | `arbor web ` | 为某次会话打开只读浏览器监控(无需正在进行的运行)。 | 底层入口点(`run-research`、`coordinator`、`executor`、`review-research`)保留供调试使用——详见 [CLI 参考文档](https://ruc-nlpir.github.io/Arbor/docs/cli/)。 ------ ## 🔎 文献检索与新颖性审查 好的研究始于了解已有工作。Arbor 内置了一个**零配置搜索后端**,直连 [alphaXiv](https://www.alphaxiv.org) 公共 API——无需自建搜索服务,也无需 alphaXiv 密钥——因此它可以调研相关工作并判断一个想法的新颖性。判定结果轻量且面向决策:对该领域的简短总结、最接近的相关论文、`novel` / `partial-overlap` / `prior-art-exists` 三档新颖性评估,以及具体的重叠风险。 ### 开启 无需安装——在 **Python ≥ 3.12** 上该后端随 Arbor 默认内置(自带 `alphaxiv-py`), 复用你已有的 Arbor LLM 凭证,`arbor idea-check` 开箱即用。(在 Python 3.10/3.11 上 `alphaxiv-py` 不可用,后端会以清晰的提示优雅降级。) ### 三种用法 **1. 独立使用 —— 审查单个想法,无需启动运行。** 在投入之前快速验证一个方向最便捷的方式: ```bash arbor idea-check "用实体-关系草稿提升多跳问答" arbor idea-check "在代码生成中对方案做树搜索" --json # 输出原始 JSON ``` **2. 实验前 —— 自动为每个想法把关。** 开启 `auto_search_on_add`,Coordinator 会在新想法加入树的那一刻后台派发一次新颖性审查;判定结果在执行器运行*之前*就写入该节点的 `related_work` 字段,于是 Arbor 可以修订或剪掉不新颖的想法,而不是把算力浪费在上面: ```yaml title="research_config.yaml" search: enabled: true builtin_backend: alphaxiv # none | alphaxiv auto_search_on_add: true # 每个新想法在运行前先做新颖性审查 ``` **3. 实验后 —— 为有效的想法做标注。** 默认情况下(`auto_search_on_add: false`),Arbor 仍会为*跑赢主干*的想法调研相关工作,在合并决策前附上先行工作上下文——让每个成果都带着引用到来。 ### 关闭 在运行中它**默认关闭**:`builtin_backend` 为 `none`,因此除非你设置 `search.builtin_backend: alphaxiv`(实验前审查还需 `auto_search_on_add: true`),Arbor 绝不会为文献检索访问网络。`arbor idea-check` 本身就是按需调用——只有你主动运行时才会产生开销。更想用自己的搜索服务?通过 `search.web_search_endpoint` 接入自建的 BrowseComp 风格后端的 BYO 路径依然可用。 每个选项的细节请参阅[配置指南](https://ruc-nlpir.github.io/Arbor/docs/configuration/)与 [`arbor idea-check`](https://ruc-nlpir.github.io/Arbor/docs/cli/#arbor-idea-check)。 ------ ## 🔌 插件与技能 一行配置即可将智能体切换到新领域——评估协议、受保护的数据目录、必要的输出内容和超时预设均由插件提供: ```yaml plugin: mle_kaggle # 切换到 Kaggle/MLE 模式 ``` 插件是一个 YAML 文件(包含提示注入点、配置覆盖、运行配置、生命周期钩子和评估合同);技能则是智能体在运行时按需加载的 Markdown 手册。Kaggle 配置的开箱即用示例位于 [`examples/kaggle_config.example.yaml`](https://claude.ai/chat/examples/kaggle_config.example.yaml)。 ------ ## 💾 输出与恢复 每次运行会在 `.arbor/sessions/` 下创建一个会话目录,包含 `REPORT.md`、`events.jsonl`、`run_stats.json`、想法树以及各实验的产物文件。运行支持断点恢复——用 `Ctrl+C` 中断后,稍后使用 `--resume` 继续;Arbor 会重新加载想法树并从中断处继续。 ```bash arbor report .arbor/sessions/ # 重新渲染历史报告 arbor export # 写入 .arbor/sessions//arbor-session-.html arbor export session.jsonl # 导出 JSONL 产物包 arbor --resume --run-name # 继续中断的运行 ``` ------ ## 📊 实验结果 Arbor 作为**单一控制器**,在模型训练、harness 工程和数据合成等场景中进行评测;实验中只改变材料、 目标、评测器和预算。在全部六项任务上,Arbor 都在留出 test 上超过了强大的单智能体基线。 | 任务 | 优化方向 | 初始值 | Codex | Claude Code | **Arbor** | 提升 | | ------------------ | -------- | ------ | ----- | ----------- | ---------- | ------ | | 优化器设计 | 步数 ↓ | 3325 | 3325 | 3287.5 | **3237.5** | +2.63% | | 架构设计 | 损失 ↓ | 1.098 | 1.083 | 1.033 | **1.028** | +6.38% | | Terminal-Bench 2.0 | 通过率 ↑ | 69.81 | 73.59 | 71.70 | **77.36** | +7.55 | | BrowseComp | 准确率 ↑ | 45.33 | 50.00 | 53.33 | **67.67** | +22.34 | | 搜索智能体数据 | 差距 ↑ | 5.00 | 9.00 | 12.00 | **18.00** | +13.0 | | 数学推理数据 | 差距 ↑ | 1.04 | 6.25 | 8.33 | **20.83** | +19.79 | 在使用 GPT-5.5 的 **MLE-Bench Lite** 上,Arbor 达到了 **86.36% 任意奖牌率**(100% 有效提交,95.45% 超过中位数,77.27% 获得金奖)。完整的实验协议和消融分析请参阅[论文](https://arxiv.org/pdf/2606.11926)。 ------ ## 🗂️ 项目结构 代码位于 `src/`,以 `arbor` 包的形式导入。 ``` src/ # `arbor` 包 ├── core/ 共享基础设施:ReAct 循环、工具、LLM 提供方、上下文管理 ├── executor/ Executor agent 和 `executor` CLI ├── coordinator/ Coordinator agent、Idea Tree、orchestrator、coordinator 工具 ├── cli/ `arbor` CLI:intake、实时仪表盘、setup、doctor、config ├── events/ 类型化 event bus 和 payload ├── report/ 报告生成 ├── webui/ 只读运行监控 Web 服务器 ├── plugins/ 领域插件(例如 mle_kaggle.yaml) ├── skills/ 按需加载的 Markdown 手册 ├── dashboard.py HTML 仪表盘生成器 ├── run.py `run-research` CLI └── review.py `review-research` CLI ``` ------ ## 🙏 致谢 Arbor 构建在优秀的开源项目 [claw-code](https://github.com/ultraworkers/claw-code) 之上。 claw-code 是 Claude Code 的开源 Rust 复现,为 Arbor CLI 提供了 REPL 框架、 工具调用基础设施和跨平台编译能力。非常感谢 ultraworkers 团队的出色工作。 🔗 claw-code: https://github.com/ultraworkers/claw-code ------ ## 📚 引用 ```bibtex @misc{jin2026arbor, title = {Toward Generalist Autonomous Research via Hypothesis-Tree Refinement}, author = {Jiajie Jin and Yuyang Hu and Kai Qiu and Qi Dai and Chong Luo and Guanting Dong and Xiaoxi Li and Tong Zhao and Xiaolong Ma and Gongrui Zhang and Zhirong Wu and Bei Liu and Zhengyuan Yang and Linjie Li and Lijuan Wang and Hongjin Qian and Yutao Zhu and Zhicheng Dou}, year = {2026}, eprint = {2606.11926}, archivePrefix = {arXiv}, url = {https://arxiv.org/abs/2606.11926} } ``` ------ ## 📄 许可证 本项目基于 [Apache License 2.0](https://claude.ai/chat/LICENSE) 开源发布。 ------ 由中国人民大学高瓴人工智能学院与微软研究院联合研发。