---
title: 布隆过滤器详解(原理、实现、应用场景)
description: 解析 Bloom Filter 的原理与误判特性,结合哈希与位数组实现,适用于海量数据去重与缓存穿透防护。
category: 计算机基础
tag:
- 数据结构
head:
- - meta
- name: keywords
content: 布隆过滤器,Bloom Filter,误判率,哈希函数,位数组,去重,缓存穿透
---
# 布隆过滤器
布隆过滤器相信大家没用过的话,也已经听过了。
布隆过滤器主要是为了解决海量数据的存在性问题。对于海量数据中判定某个数据是否存在且容忍轻微误差这一场景(比如缓存穿透、海量数据去重)来说,非常适合。
文章内容概览:
1. 什么是布隆过滤器?
2. 布隆过滤器的原理介绍。
3. 布隆过滤器使用场景。
4. 通过 Java 编程手动实现布隆过滤器。
5. 利用 Google 开源的 Guava 中自带的布隆过滤器。
6. Redis 中的布隆过滤器。
## 什么是布隆过滤器?
首先,我们需要了解布隆过滤器的概念。
布隆过滤器(Bloom Filter,BF)是一个叫做 Bloom 的老哥于 1970 年提出的。我们可以把它看作由二进制向量(或者说位数组)和一系列随机映射函数(哈希函数)两部分组成的数据结构。相比于我们平时常用的 List、Map、Set 等数据结构,它占用空间更少并且效率更高,但是缺点是其返回的结果是概率性的,而不是非常准确的。理论情况下添加到集合中的元素越多,误报的可能性就越大。并且,存放在布隆过滤器的数据不容易删除。
Bloom Filter 会使用一个较大的 bit 数组来保存所有的数据,数组中的每个元素都只占用 1 bit,并且每个元素只能是 0 或者 1(代表 false 或者 true),这也是 Bloom Filter 节省内存的核心所在。这样来算的话,申请一个 100w 个元素的位数组只占用 1000000 Bit / 8 = 125000 Byte = 125000 / 1024 KB ≈ 122 KB 的空间。
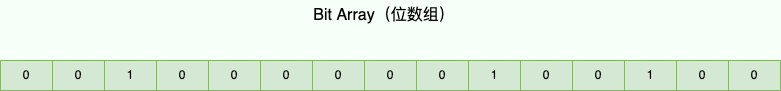
总结:**一个名叫 Bloom 的人提出了一种来检索元素是否在给定大集合中的数据结构,这种数据结构是高效且性能很好的,但缺点是具有一定的错误识别率和删除难度。并且,理论情况下,添加到集合中的元素越多,误报的可能性就越大。**
## 布隆过滤器的原理介绍
**当一个元素加入布隆过滤器中的时候,会进行如下操作:**
1. 使用布隆过滤器中的哈希函数对元素值进行计算,得到哈希值(有几个哈希函数得到几个哈希值)。
2. 根据得到的哈希值,在位数组中把对应下标的值置为 1。
**当我们需要判断一个元素是否存在于布隆过滤器的时候,会进行如下操作:**
1. 对给定元素再次进行相同的哈希计算;
2. 检查这些哈希值对应的 bit:如果存在一个 bit 不为 1,说明该元素一定没有被插入;如果全部为 1,只能说明该元素可能被插入,仍然存在误判。
Bloom Filter 的简单原理图如下:
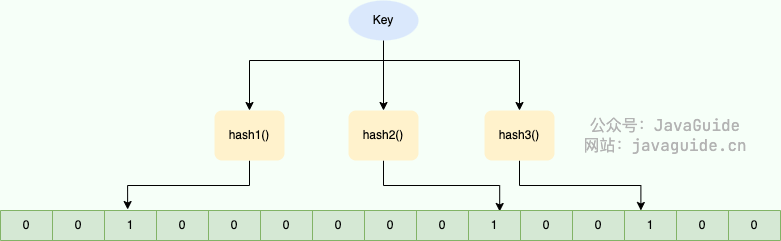
如图所示,当字符串要加入布隆过滤器时,该字符串首先由多个哈希函数生成不同的哈希值,然后将位数组中的对应位置设置为 1(位数组初始化时,所有位置均为 0)。再次查询相同字符串时,对应位置会全部为 1,因此布隆过滤器会返回“可能存在”;最终是否真的存在,仍需结合业务数据确认。
如果需要判断某个字符串是否在布隆过滤器中,只需对它再次进行相同的哈希计算。如果任一对应位置为 0,该元素一定没有被插入;如果所有对应位置都是 1,该元素可能被插入,也可能是其他元素共同造成的假阳性。
**不同的字符串可能哈希出来的位置相同,这种情况我们可以适当增加位数组大小或者调整我们的哈希函数。**
综上,我们可以得出:**布隆过滤器说某个元素存在,小概率会误判。布隆过滤器说某个元素不在,那么这个元素一定不在。**
## 布隆过滤器使用场景
1. 判断给定数据是否存在:比如判断一个数字是否存在于包含大量数字的数字集中(数字集很大,上亿)、防止缓存穿透(判断请求的数据是否有效避免直接绕过缓存请求数据库)等等、邮箱的垃圾邮件过滤(判断一个邮件地址是否在垃圾邮件列表中)、黑名单功能(判断一个 IP 地址或手机号码是否在黑名单中)等等。
2. 去重:比如爬给定网址的时候对已经爬取过的 URL 去重、对巨量的 QQ 号/订单号去重。
去重场景也需要用到判断给定数据是否存在,因此布隆过滤器主要是为了解决海量数据的存在性问题。
## 编码实战
### 通过 Java 编程手动实现布隆过滤器
我们上面已经说了布隆过滤器的原理,知道了布隆过滤器的原理之后就可以自己手动实现一个了。
如果你想要手动实现一个的话,你需要:
1. 一个合适大小的位数组保存数据
2. 几个不同的哈希函数
3. 添加元素到位数组(布隆过滤器)的方法实现
4. 判断给定元素是否存在于位数组(布隆过滤器)的方法实现。
下面给出一个我觉得写的还算不错的代码(参考网上已有代码改进得到,对于所有类型对象皆适用):
```java
import java.util.BitSet;
public class MyBloomFilter {
/**
* 位数组的大小
*/
private static final int DEFAULT_SIZE = 2 << 24;
/**
* 通过这个数组可以创建 6 个不同的哈希函数
*/
private static final int[] SEEDS = new int[]{3, 13, 46, 71, 91, 134};
/**
* 位数组。数组中的元素只能是 0 或者 1
*/
private BitSet bits = new BitSet(DEFAULT_SIZE);
/**
* 存放包含 hash 函数的类的数组
*/
private SimpleHash[] func = new SimpleHash[SEEDS.length];
/**
* 初始化多个包含 hash 函数的类的数组,每个类中的 hash 函数都不一样
*/
public MyBloomFilter() {
// 初始化多个不同的 Hash 函数
for (int i = 0; i < SEEDS.length; i++) {
func[i] = new SimpleHash(DEFAULT_SIZE, SEEDS[i]);
}
}
/**
* 添加元素到位数组
*/
public void add(Object value) {
for (SimpleHash f : func) {
bits.set(f.hash(value), true);
}
}
/**
* 判断指定元素是否存在于位数组
*/
public boolean contains(Object value) {
boolean ret = true;
for (SimpleHash f : func) {
ret = bits.get(f.hash(value));
if(!ret)
return ret;
}
return ret;
}
/**
* 静态内部类。用于 hash 操作!
*/
public static class SimpleHash {
private int cap;
private int seed;
public SimpleHash(int cap, int seed) {
this.cap = cap;
this.seed = seed;
}
/**
* 计算 hash 值
*/
public int hash(Object value) {
int h;
return (value == null) ? 0 : Math.abs((cap - 1) & seed * ((h = value.hashCode()) ^ (h >>> 16)));
}
}
}
```
测试:
```java
String value1 = "https://javaguide.cn/";
String value2 = "https://github.com/Snailclimb";
MyBloomFilter filter = new MyBloomFilter();
System.out.println(filter.contains(value1));
System.out.println(filter.contains(value2));
filter.add(value1);
filter.add(value2);
System.out.println(filter.contains(value1));
System.out.println(filter.contains(value2));
```
Output:
```plain
false
false
true
true
```
测试:
```java
Integer value1 = 13423;
Integer value2 = 22131;
MyBloomFilter filter = new MyBloomFilter();
System.out.println(filter.contains(value1));
System.out.println(filter.contains(value2));
filter.add(value1);
filter.add(value2);
System.out.println(filter.contains(value1));
System.out.println(filter.contains(value2));
```
Output:
```java
false
false
true
true
```
### 利用 Google 开源的 Guava 中自带的布隆过滤器
自己实现的目的主要是为了让自己搞懂布隆过滤器的原理,Guava 中布隆过滤器的实现算是比较权威的,所以实际项目中我们不需要手动实现一个布隆过滤器。
首先我们需要在项目中引入 Guava 的依赖。版本建议由项目的依赖管理统一维护,并根据 [Guava Releases](https://github.com/google/guava/releases) 选择仍受维护的版本:
```xml
com.google.guava
guava
${guava.version}
```
实际使用如下:
我们创建了一个预计插入 1500 个整数的布隆过滤器,并将目标误判率设置为 1%(0.01)。这里的 1500 是容量估计,不是达到后立即失效的硬上限。
```java
// 创建布隆过滤器对象
BloomFilter filter = BloomFilter.create(
Funnels.integerFunnel(),
1500,
0.01);
// 判断指定元素是否存在
System.out.println(filter.mightContain(1));
System.out.println(filter.mightContain(2));
// 将元素添加进布隆过滤器
filter.put(1);
filter.put(2);
System.out.println(filter.mightContain(1));
System.out.println(filter.mightContain(2));
```
在这个示例中,`mightContain()` 返回 `false` 表示该元素一定没有被插入;返回 `true` 只表示可能被插入。参数 `0.01` 表示在容量估计和实现假设成立时,对未插入元素查询的目标假阳性概率约为 1%,不能据此推导出“返回 true 后有 99% 的概率确实存在”。
**Guava 的布隆过滤器保存在当前进程内存中,使用简单,适合单进程或不需要跨节点共享的场景。如果多个节点需要共享同一份过滤器状态,可以考虑 RedisBloom 等集中式方案。**
## Redis 中的布隆过滤器
### 介绍
RedisBloom 提供布隆过滤器、布谷鸟过滤器等概率型数据结构。从 Redis 8 开始,这些能力已经包含在 Redis Open Source 中,不再需要安装旧的第三方 `rebloom` 镜像。具体命令和客户端支持可以查看 [Redis Bloom Filter 官方文档](https://redis.io/docs/latest/develop/data-types/probabilistic/bloom-filter/)。
### 使用 Docker 安装
可以通过 Docker 启动 Redis 8 进行体验。实际项目建议固定经过验证的具体版本,不要依赖 `latest` 标签:
```bash
docker run -d --name redis -p 6379:6379 redis:8
docker exec -it redis redis-cli
```
生产环境的安装和版本选择请以 [Redis Open Source 安装文档](https://redis.io/docs/latest/operate/oss_and_stack/) 为准。
### 常用命令一览
> 注意:key:布隆过滤器的名称,item:添加的元素。
1. `BF.ADD`:将元素添加到布隆过滤器中,如果该过滤器尚不存在,则创建该过滤器。格式:`BF.ADD {key} {item}`。
2. `BF.MADD`:将一个或多个元素添加到布隆过滤器中,并创建一个尚不存在的过滤器。该命令的操作方式与 `BF.ADD` 相同,只不过它允许多个输入并返回多个值。格式:`BF.MADD {key} {item} [item ...]`。
3. `BF.EXISTS`:确定元素是否在布隆过滤器中存在。格式:`BF.EXISTS {key} {item}`。
4. `BF.MEXISTS`:确定一个或者多个元素是否在布隆过滤器中存在。格式:`BF.MEXISTS {key} {item} [item ...]`。
另外,`BF.RESERVE` 命令需要单独介绍一下:
这个命令的格式如下:
`BF.RESERVE {key} {error_rate} {capacity} [EXPANSION expansion]`。
下面简单介绍一下每个参数的具体含义:
1. key:布隆过滤器的名称
2. error_rate:期望的误报率。该值必须介于 0 到 1 之间。例如,对于期望的误报率 0.1%(1000 中为 1),error_rate 应该设置为 0.001。该数字越接近零,则每个项目的内存消耗越大,并且每个操作的 CPU 使用率越高。
3. capacity:预计插入的元素数量。可扩展过滤器超过该容量后会创建子过滤器,查询时需要检查更多子过滤器;如果使用 `NONSCALING` 创建固定容量过滤器,继续插入则会使实际误判率高于设定值。
可选参数:
- expansion:如果创建了一个新的子过滤器,则其大小将是当前过滤器的大小乘以 `expansion`。默认扩展值为 2。这意味着每个后续子过滤器将是前一个子过滤器的两倍。
### 实际使用
```shell
127.0.0.1:6379> BF.ADD myFilter java
(integer) 1
127.0.0.1:6379> BF.ADD myFilter javaguide
(integer) 1
127.0.0.1:6379> BF.EXISTS myFilter java
(integer) 1
127.0.0.1:6379> BF.EXISTS myFilter javaguide
(integer) 1
127.0.0.1:6379> BF.EXISTS myFilter github
(integer) 0
```
## 面试复盘重点
布隆过滤器面试最常见的 4 个问题是:为什么快、为什么省空间、为什么会误判、为什么不好删除。
| 问题 | 回答要点 |
| ---------------- | ----------------------------------------------------- |
| 为什么省空间? | 用位数组和多个哈希函数表示集合,不存储原始元素 |
| 为什么会误判? | 多个元素可能把同一批 bit 置为 1,查询时误以为目标存在 |
| 会不会漏判? | 标准布隆过滤器不会把已加入元素判断为不存在 |
| 为什么删除困难? | 一个 bit 可能被多个元素共享,清零会影响其他元素 |
典型工程场景:
- 缓存穿透:先用布隆过滤器判断 key 是否可能存在,不存在就不查数据库。
- 大规模去重:比如 URL 去重、黑名单过滤、推荐系统已读过滤。
- 分布式场景:单机 Guava 方案简单,但跨节点共享通常会考虑 RedisBloom。
回答时要主动补一句局限:布隆过滤器适合“允许少量误判,但不能接受漏判”的场景。如果业务要求 100% 精确存在性判断,就不能只靠布隆过滤器。
## 常见追问
- 误判率和位数组大小、哈希函数个数有什么关系?
- 布隆过滤器能不能删除元素?
- 缓存穿透、缓存击穿、缓存雪崩分别是什么?
- Guava 布隆过滤器和 RedisBloom 怎么选?
- 如果容量预估错了,会发生什么?