# An Open-Source Toolkit for LLM Watermarking
[](https://generative-watermark.github.io/)
[](https://arxiv.org/abs/2405.10051) [](https://huggingface.co/Generative-Watermark-Toolkits) [](https://aclanthology.org/2024.emnlp-demo.7/) [](https://colab.research.google.com/drive/169MS4dY6fKNPZ7-92ETz1bAm_xyNAs0B?usp=sharing) [](https://www.youtube.com/watch?v=QN3BhNvw14E&)
> 🎉 **We welcome PRs!** If you have implemented a LLM watermarking algorithm or are interested in contributing one, we'd love to include it in MarkLLM. Join our community and help make text watermarking more accessible to everyone!
> 🔥 If you are interested in watermarking for diffusion models (image/video watermark), please refer to the [MarkDiffusion](https://github.com/THU-BPM/MarkDiffusion/) toolkit from our group.
### 💡 Some other watermark papers from our team that may interest you ✨
1. [ #### Key Features of MarkLLM
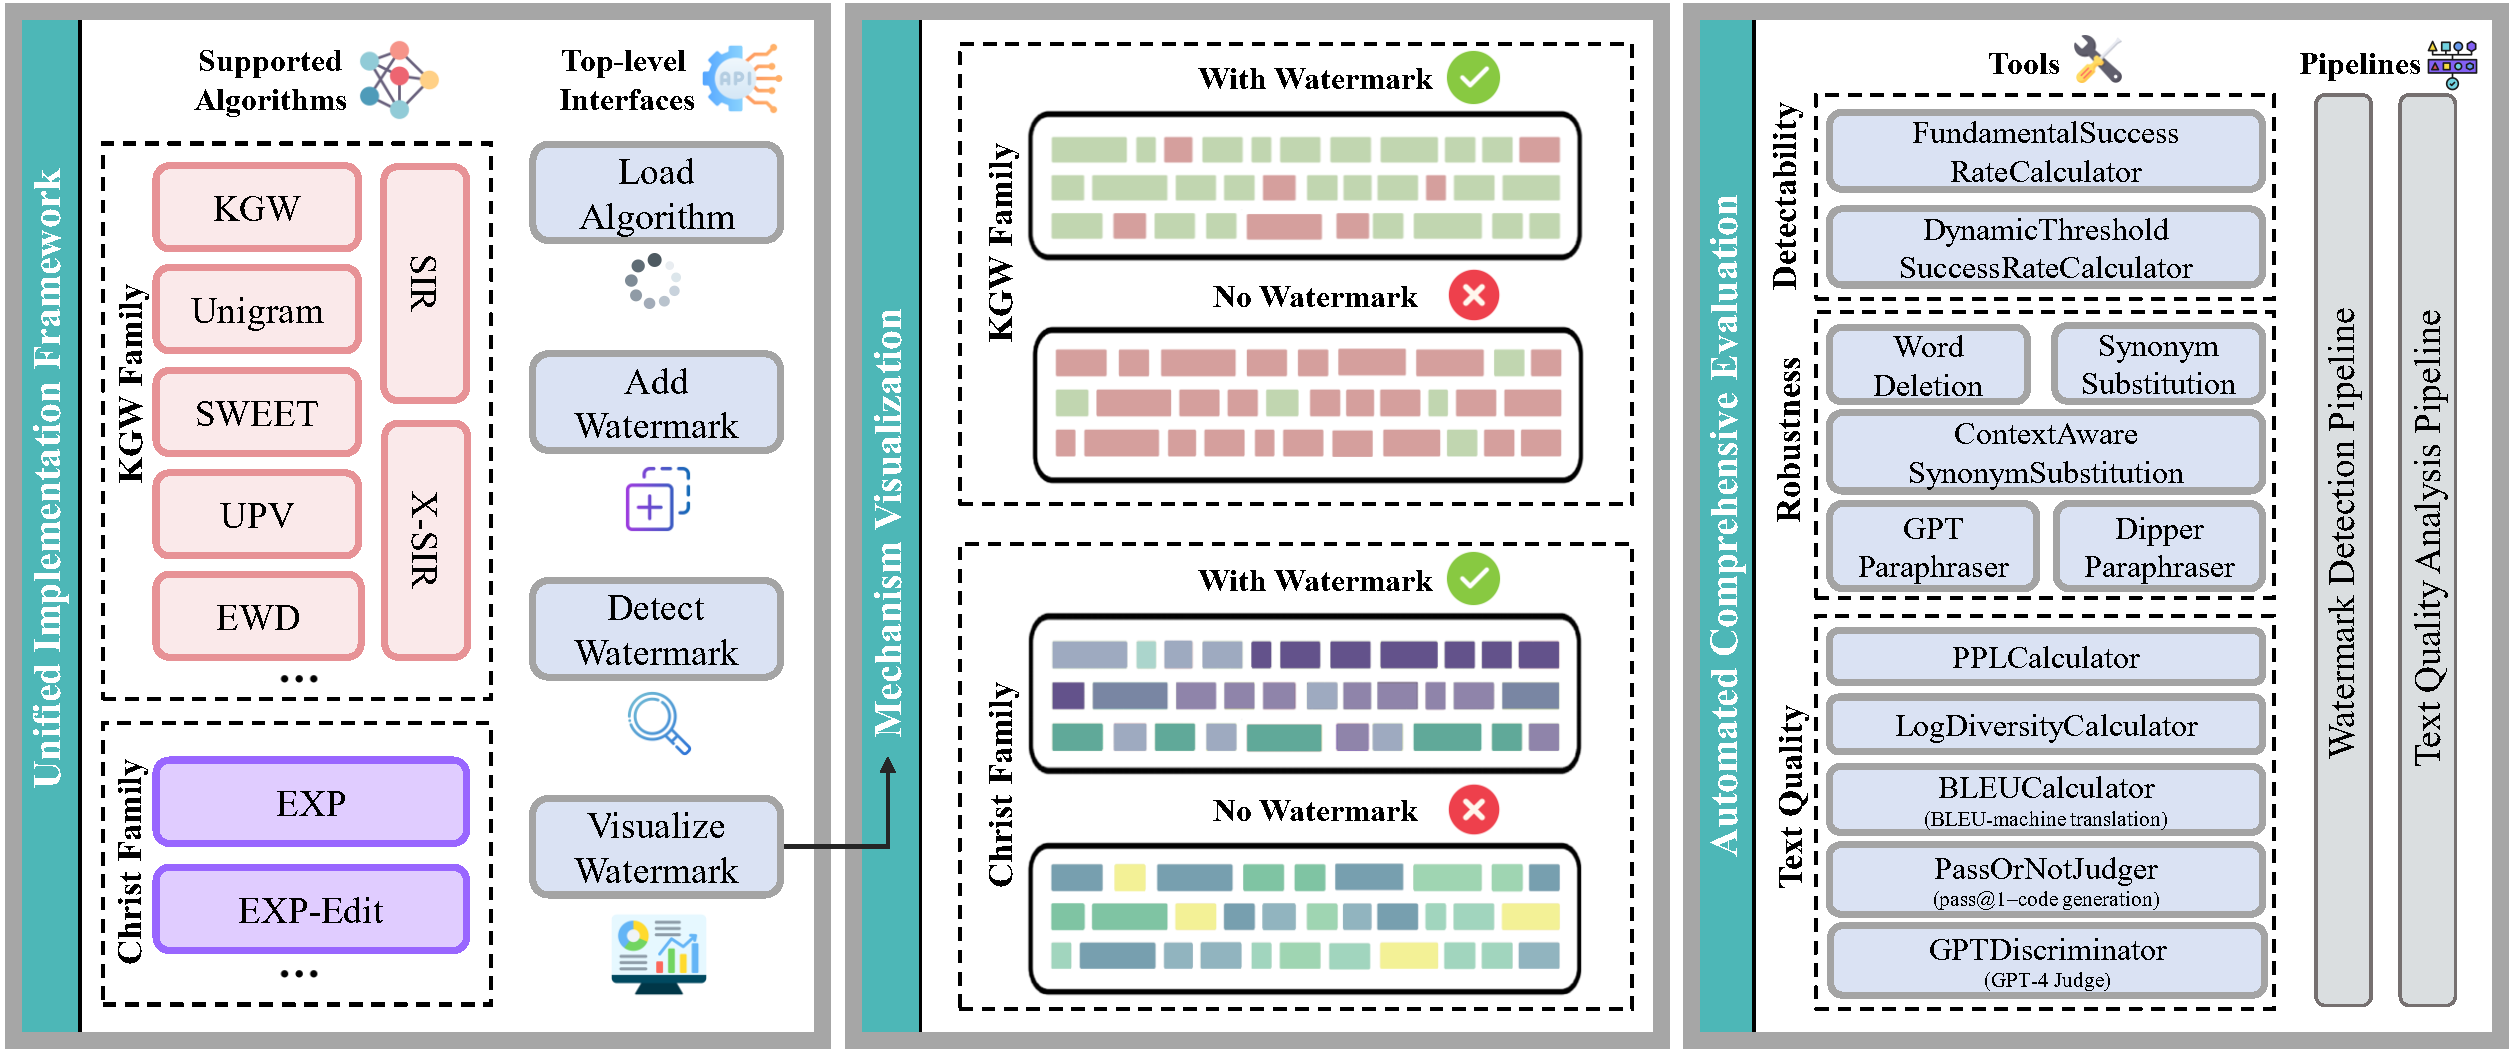
- **Implementation Framework:** MarkLLM provides a unified and extensible platform for the implementation of various LLM watermarking algorithms. It currently supports nine specific algorithms from two prominent families, facilitating the integration and expansion of watermarking techniques.
**Framework Design**:
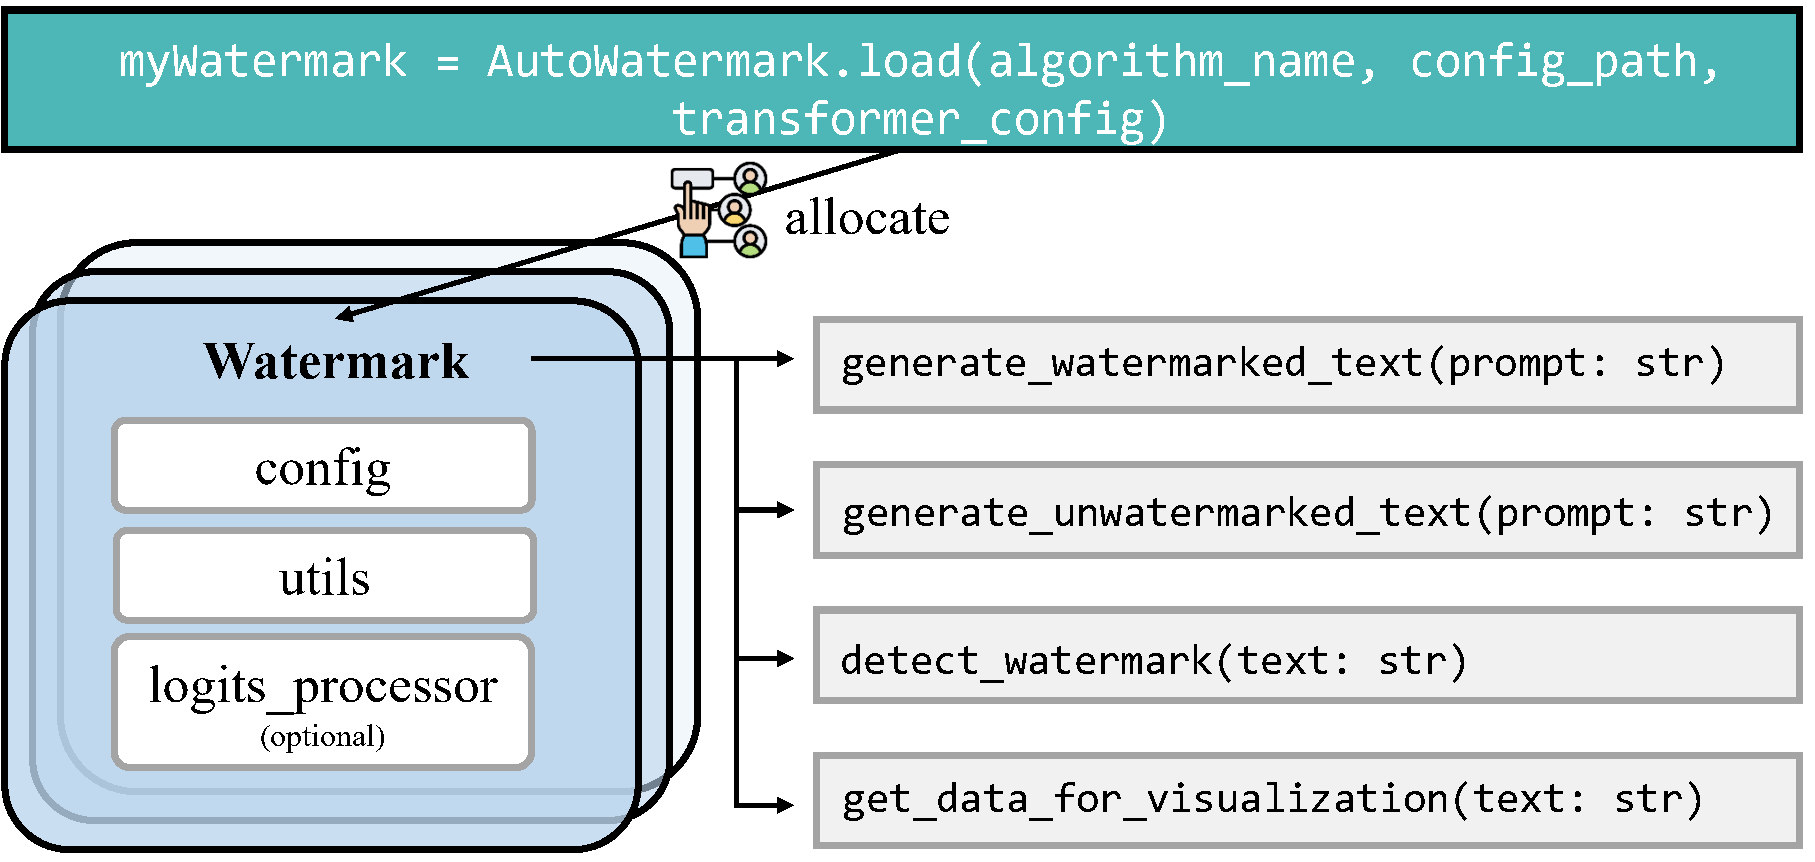
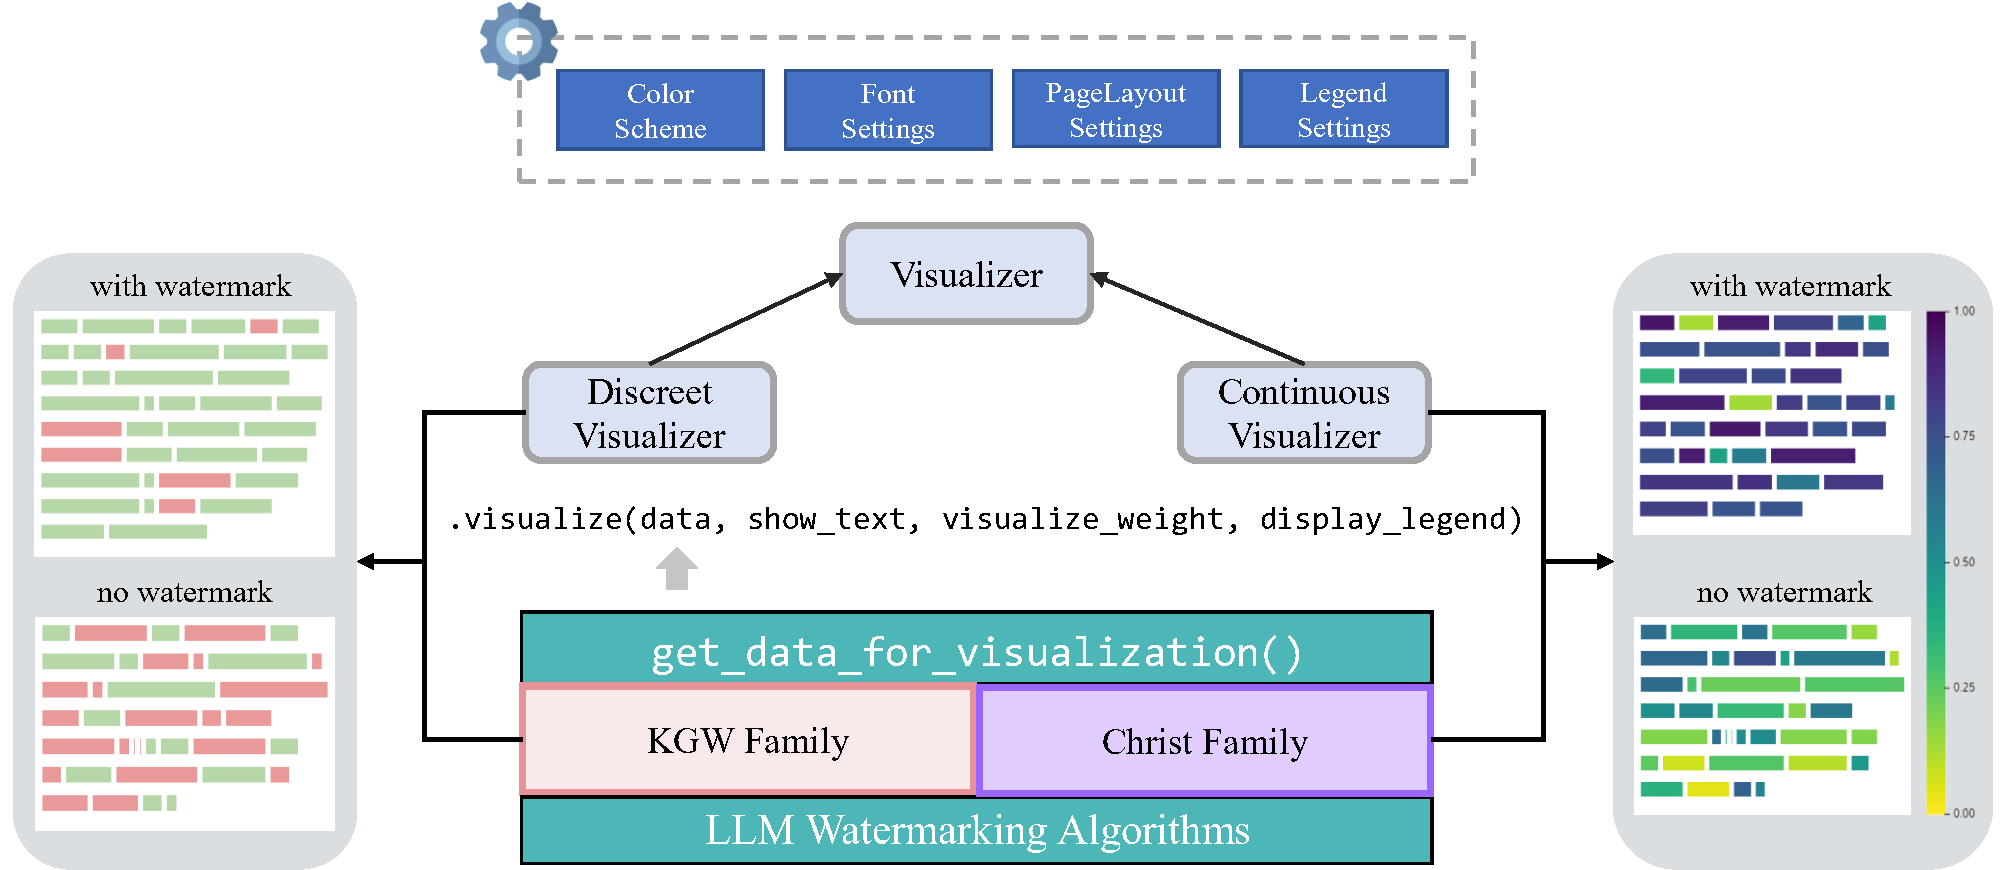 - **Evaluation Module:** With 12 evaluation tools that cover detectability, robustness, and impact on text quality, MarkLLM stands out in its comprehensive approach to assessing watermarking technologies. It also features customizable automated evaluation pipelines that cater to diverse needs and scenarios, enhancing the toolkit's practical utility.
**Tools:**
- **Success Rate Calculator of Watermark Detection:** FundamentalSuccessRateCalculator, DynamicThresholdSuccessRateCalculator
- **Text Editor:** WordDeletion, SynonymSubstitution, ContextAwareSynonymSubstitution, GPTParaphraser, DipperParaphraser, RandomWalkAttack
- **Text Quality Analyzer:** PPLCalculator, LogDiversityAnalyzer, BLEUCalculator, PassOrNotJudger, GPTDiscriminator
**Pipelines:**
- **Watermark Detection Pipeline:** WatermarkedTextDetectionPipeline, UnwatermarkedTextDetectionPipeline
- **Text Quality Pipeline:** DirectTextQualityAnalysisPipeline, ReferencedTextQualityAnalysisPipeline, ExternalDiscriminatorTextQualityAnalysisPipeline
### How to use the toolkit in your own code
#### Setting up the environment
- python 3.10
- pytorch
- pip install -r requirements.txt
*Tips:* If you wish to utilize the EXPEdit or ITSEdit algorithm, you will need to import for .pyx file, take EXPEdit as an example:
- run `python watermark/exp_edit/cython_files/setup.py build_ext --inplace`
- move the generated `.so` file into `watermark/exp_edit/cython_files/`
#### Invoking watermarking algorithms
```python
import torch
from watermark.auto_watermark import AutoWatermark
from utils.transformers_config import TransformersConfig
from transformers import AutoModelForCausalLM, AutoTokenizer
# Device
device = "cuda" if torch.cuda.is_available() else "cpu"
# Transformers config
transformers_config = TransformersConfig(model=AutoModelForCausalLM.from_pretrained('facebook/opt-1.3b').to(device),
tokenizer=AutoTokenizer.from_pretrained('facebook/opt-1.3b'),
vocab_size=50272,
device=device,
max_new_tokens=200,
min_length=230,
do_sample=True,
no_repeat_ngram_size=4)
# Load watermark algorithm
myWatermark = AutoWatermark.load('KGW',
algorithm_config='config/KGW.json',
transformers_config=transformers_config)
# Prompt
prompt = 'Good Morning.'
# Generate and detect
watermarked_text = myWatermark.generate_watermarked_text(prompt)
detect_result = myWatermark.detect_watermark(watermarked_text)
unwatermarked_text = myWatermark.generate_unwatermarked_text(prompt)
detect_result = myWatermark.detect_watermark(unwatermarked_text)
```
#### Visualizing mechanisms
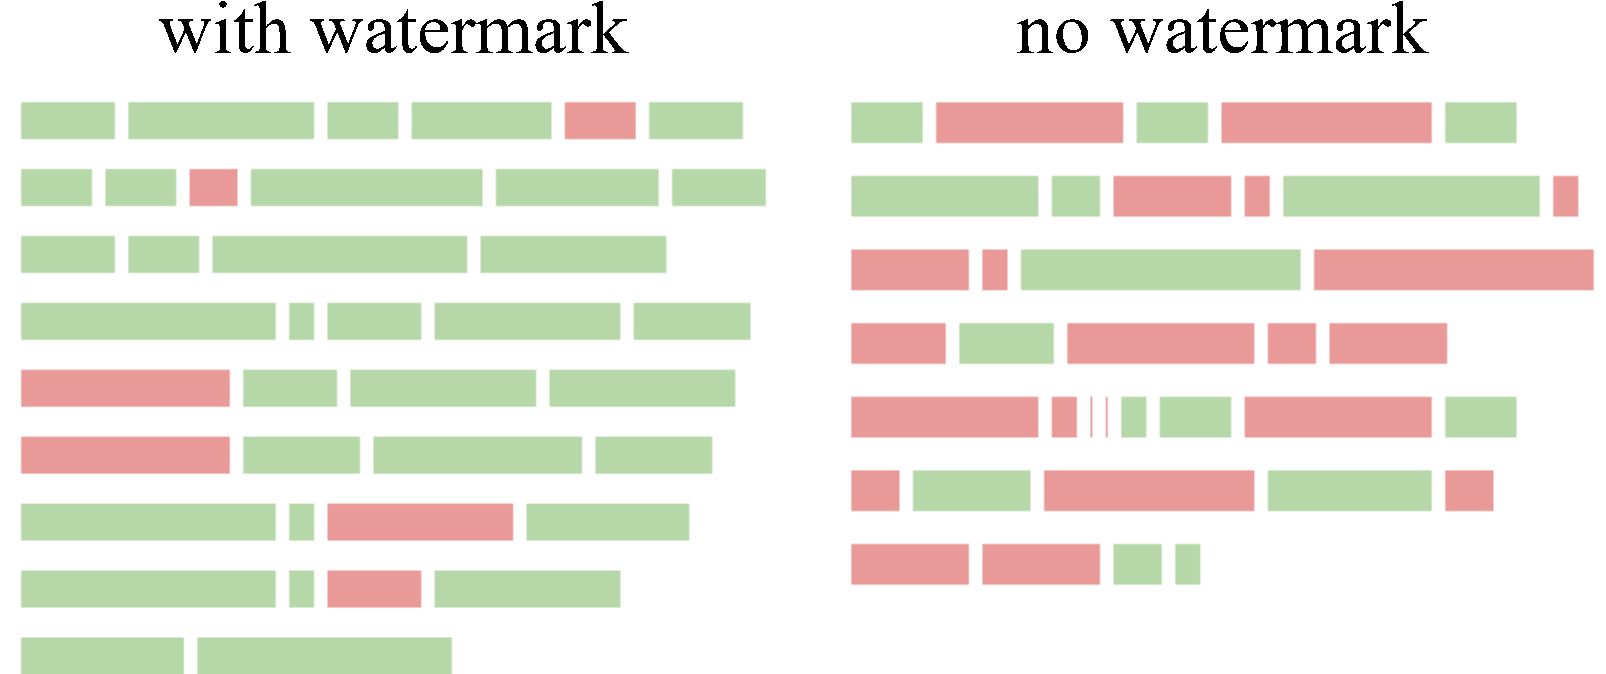
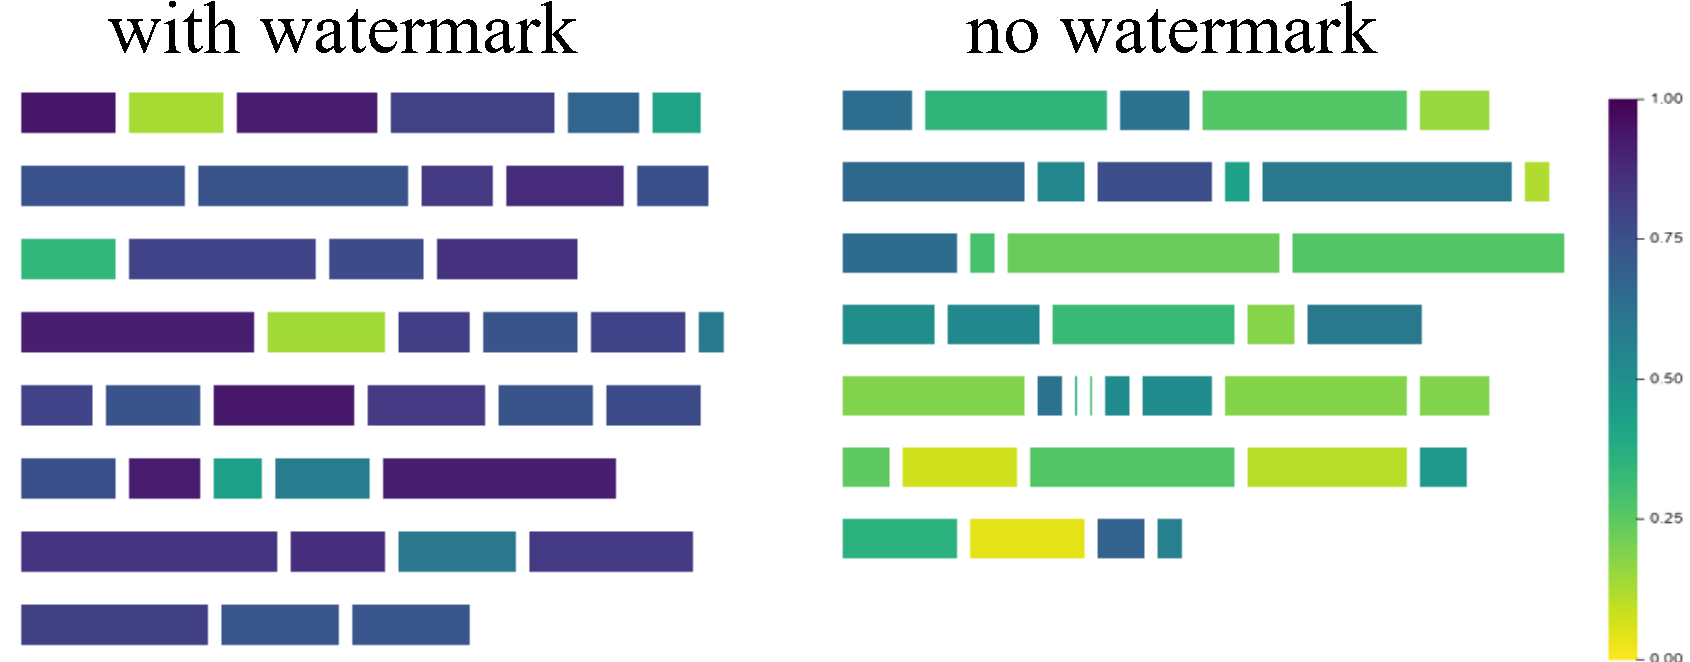
Assuming you already have a pair of `watermarked_text` and `unwatermarked_text`, and you wish to visualize the differences and specifically highlight the watermark within the watermarked text using a watermarking algorithm, you can utilize the visualization tools available in the `visualize/` directory.
**KGW Family**
```python
import torch
from visualize.font_settings import FontSettings
from watermark.auto_watermark import AutoWatermark
from utils.transformers_config import TransformersConfig
from transformers import AutoModelForCausalLM, AutoTokenizer
from visualize.visualizer import DiscreteVisualizer
from visualize.legend_settings import DiscreteLegendSettings
from visualize.page_layout_settings import PageLayoutSettings
from visualize.color_scheme import ColorSchemeForDiscreteVisualization
# Load watermark algorithm
device = "cuda" if torch.cuda.is_available() else "cpu"
transformers_config = TransformersConfig(
model=AutoModelForCausalLM.from_pretrained('facebook/opt-1.3b').to(device),
tokenizer=AutoTokenizer.from_pretrained('facebook/opt-1.3b'),
vocab_size=50272,
device=device,
max_new_tokens=200,
min_length=230,
do_sample=True,
no_repeat_ngram_size=4)
myWatermark = AutoWatermark.load('KGW',
algorithm_config='config/KGW.json',
transformers_config=transformers_config)
# Get data for visualization
watermarked_data = myWatermark.get_data_for_visualization(watermarked_text)
unwatermarked_data = myWatermark.get_data_for_visualization(unwatermarked_text)
# Init visualizer
visualizer = DiscreteVisualizer(color_scheme=ColorSchemeForDiscreteVisualization(),
font_settings=FontSettings(),
page_layout_settings=PageLayoutSettings(),
legend_settings=DiscreteLegendSettings())
# Visualize
watermarked_img = visualizer.visualize(data=watermarked_data,
show_text=True,
visualize_weight=True,
display_legend=True)
unwatermarked_img = visualizer.visualize(data=unwatermarked_data,
show_text=True,
visualize_weight=True,
display_legend=True)
# Save
watermarked_img.save("KGW_watermarked.png")
unwatermarked_img.save("KGW_unwatermarked.png")
```