HY-World 2.0:A Multi-Modal World Model for Reconstructing, Generating, and Simulating 3D Worlds
[English](README.md) | [简体中文](README_zh.md)
"What Is Now Proved Was Once Only Imagined"
## 🎥 视频
https://github.com/user-attachments/assets/b56f4750-25c9-48fb-83ff-d58526711463
## 🔥 最新动态
- **[2026年5月18日]**:🤗 开源世界生成推理代码和 WorldStereo 2.0 模型权重!
- **[2026年5月11日]**:🤗 开源 HY-Pano 2.0 推理代码和模型权重!
- **[2026年4月16日]**:🚀 发布 HY-World 2.0 技术报告及部分代码!
- **[2026年4月16日]**:🤗 开源 WorldMirror 2.0 推理代码和模型权重!
## 📋 目录
- [📖 介绍](#-介绍)
- [✨ 亮点](#-亮点)
- [🧩 架构](#-架构)
- [📝 开源计划](#-开源计划)
- [🎁 模型库](#-模型库)
- [🤗 快速开始](#-快速开始)
- [🔮 性能表现](#-性能表现)
- [🎬 更多示例](#-更多示例)
- [📖 文档](#-文档)
- [📚 引用](#-引用)
## 📖 介绍
**HY-World 2.0** 是一个面向**世界生成**和**世界重建**的多模态世界模型框架。它接受多种输入模态——文本、单视图图像、多视图图像和视频——并生成3D世界表示(网格 / 3D高斯点云)。它提供两大核心能力:
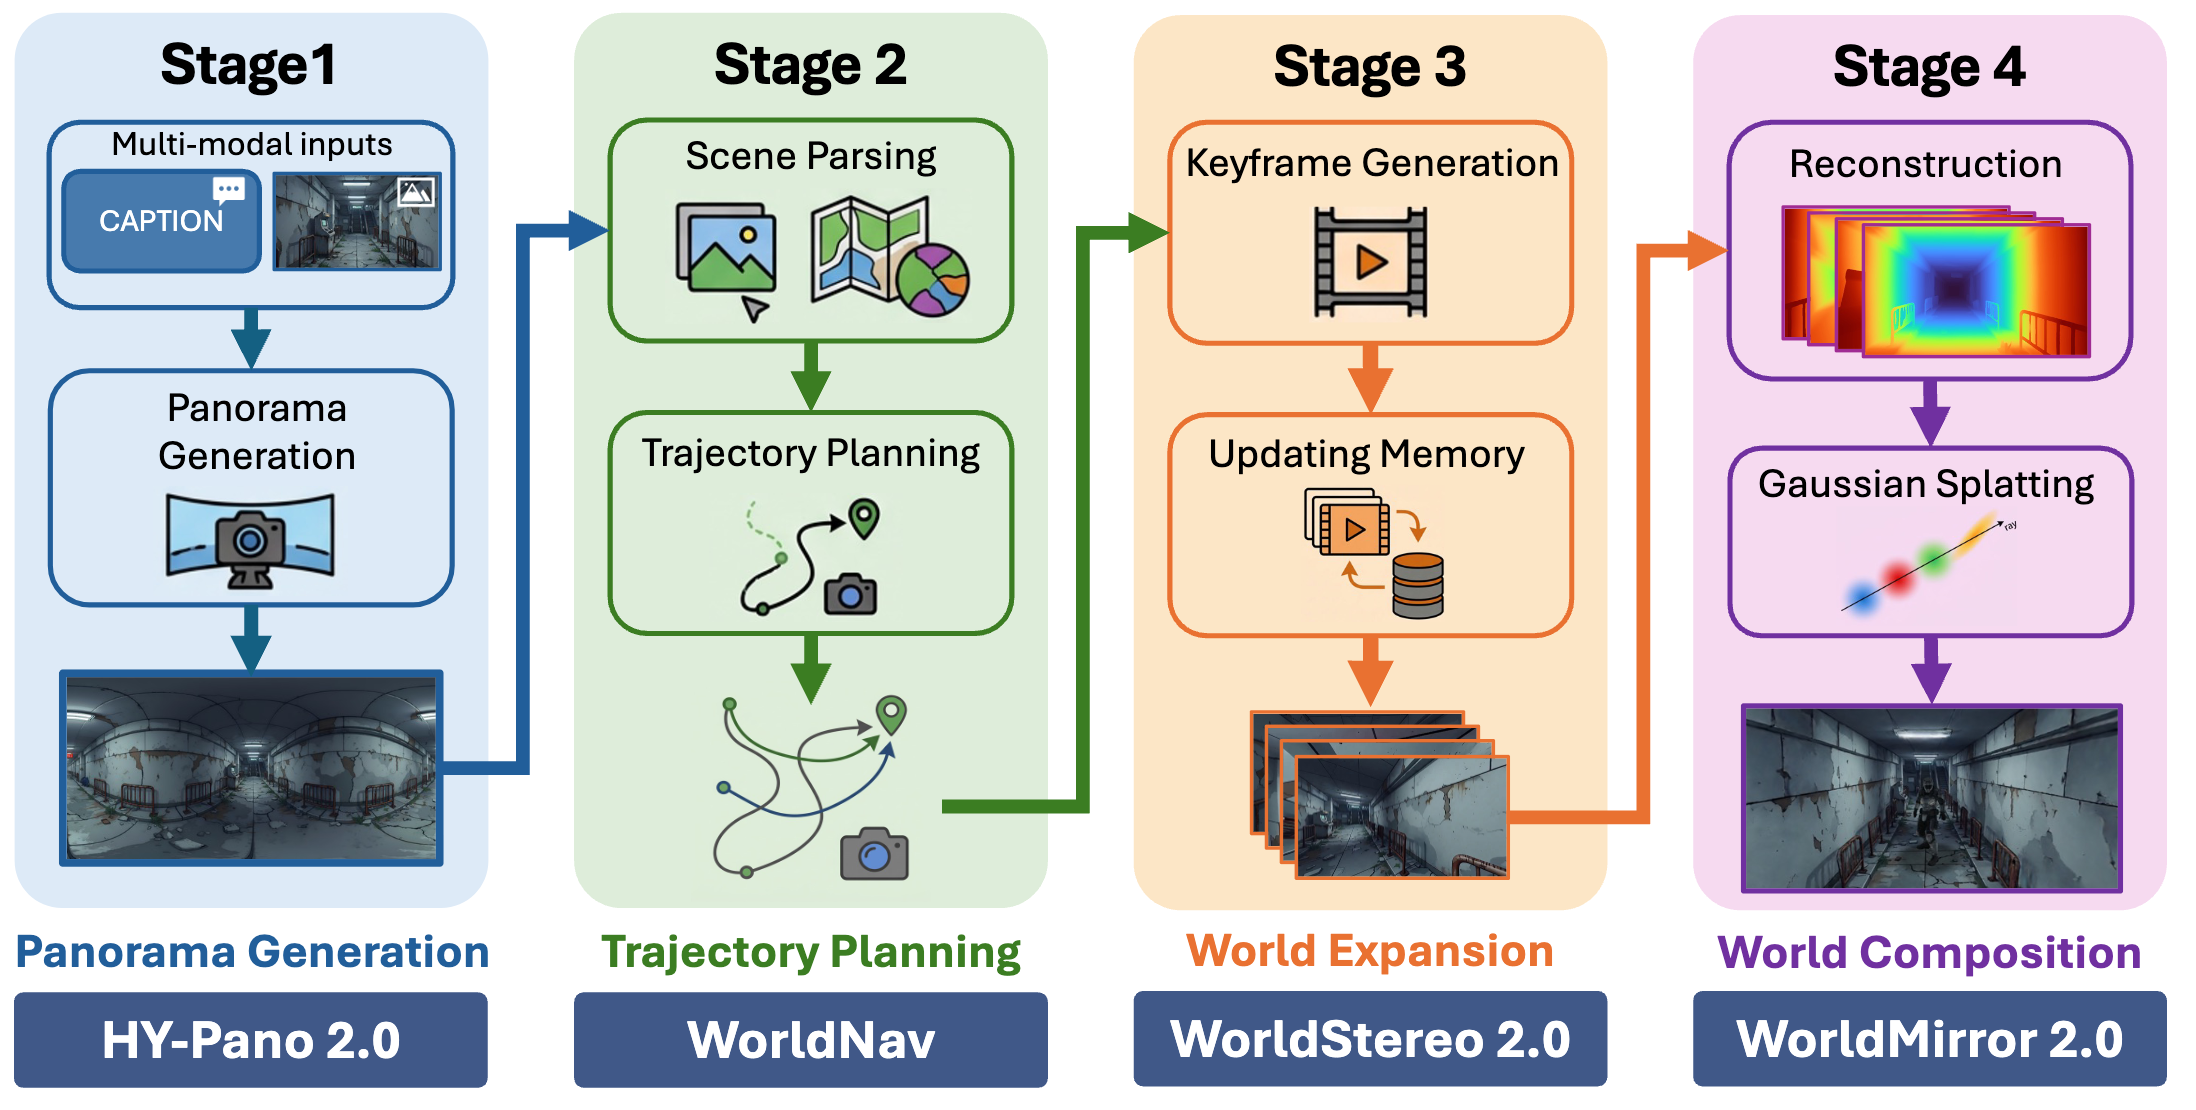
- **世界生成**(文本 / 单张图像 → 3D 世界):通过四阶段方法合成高保真、可导航的3D场景——a) (HY-Pano 2.0),b) (WorldNav),c) (WorldStereo 2.0),d) (WorldMirror 2.0 + 3DGS 学习)。
- **世界重建**(多视图图像 / 视频 → 3D):由 WorldMirror 2.0 驱动,这是一个统一的前馈模型,能够在单次前向传播中同时预测深度、表面法线、相机参数、3D点云和3DGS属性。
HY-World 2.0 是**开源的**3D世界模型。我们已经发布模型权重、代码和技术细节,以促进可复现性并推动该领域的研究进展。
### 为什么需要3D世界模型?
现有的世界模型(如 Genie 3、Cosmos、HY-World 1.5(WorldPlay+WorldCompass))生成的是像素级视频——本质上是"看一部电影",播放结束即消失。**HY-World 2.0 采用了完全不同的方法**:它直接生成可编辑、可持久化的3D资产(网格 / 3DGS),可以直接导入到 Blender/Unity/Unreal Engine/Isaac Sim 等游戏引擎中——更像是"构建一个可玩的游戏",而非录制一段视频。这种范式转变从根本上解决了视频世界模型的许多长期痛点:
| | 视频世界模型 | 3D 世界模型(HY-World 2.0) |
|--|---|---|
| **输出** | 像素视频(不可编辑) | 真实 3D 资产——网格 / 3DGS(完全可编辑) |
| **可交互时长** | 有限(通常 1 分钟) | 无限——资产永久保存 |
| **3D 一致性** | 无保证(闪烁、跨视角伪影) | 原生一致——内在3D一致性 |
| **实时渲染** | 需要逐帧推理;延迟高 | 消费级 GPU 即可实时渲染 |
| **可控性** | 弱(角色控制不精确,无真实物理) | 精确——零误差控制、真实物理碰撞、准确光照 |
| **推理成本** | 随每次交互累积 | 一次生成;渲染成本 ≈ 0 |
| **引擎兼容性** | ✗ 仅视频文件 | ✓ 可直接导入 Blender / UE / Isaac Engine |
| | $\color{IndianRed}{\textsf{看完视频,即刻消失}}$ | $\color{RoyalBlue}{\textbf{构建世界,永久保留}}$ |
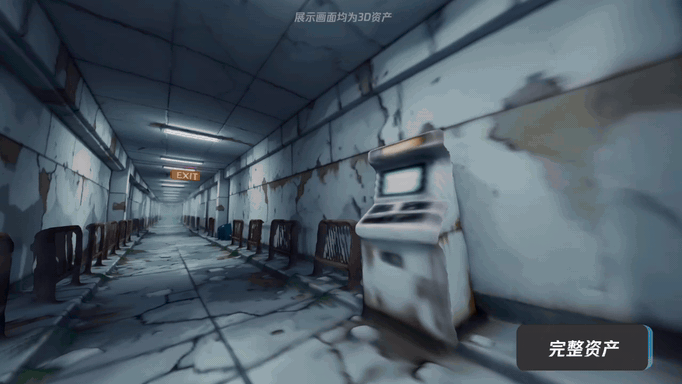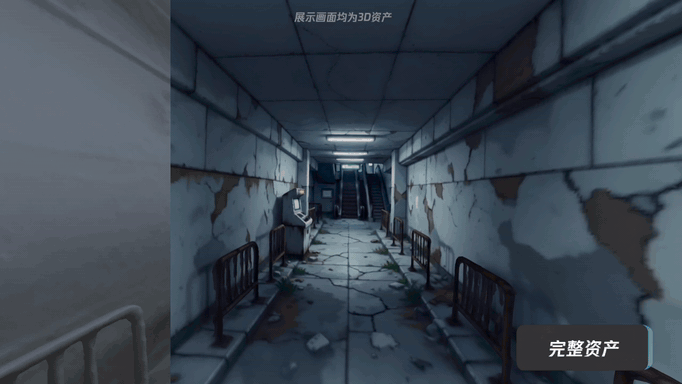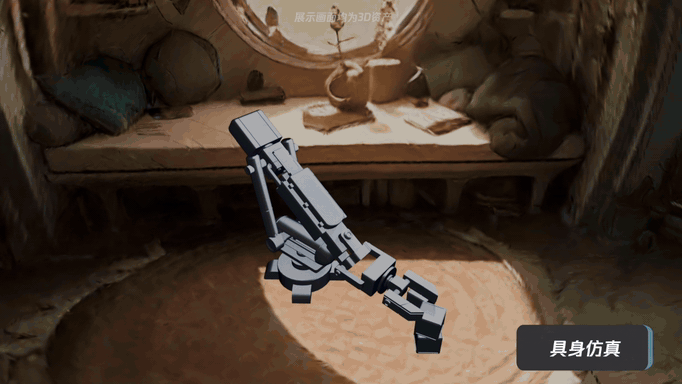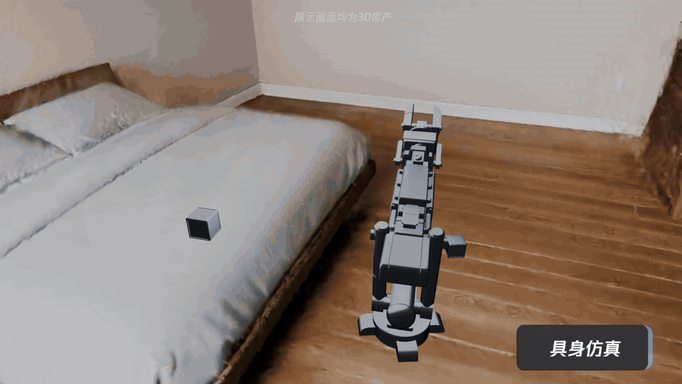
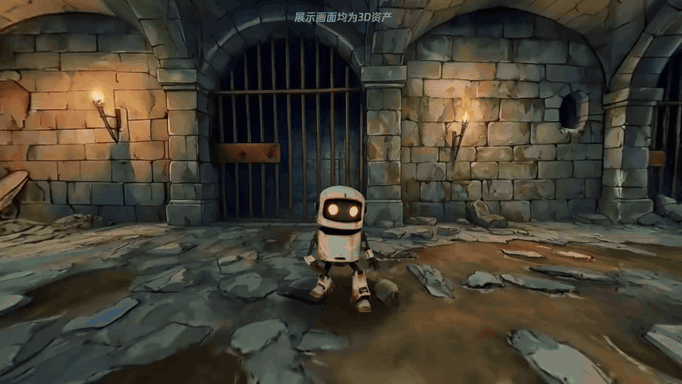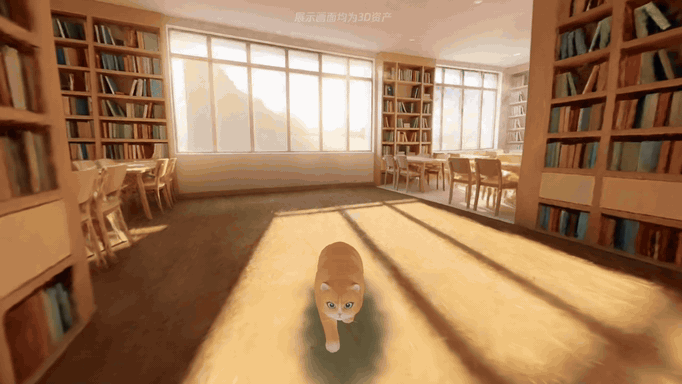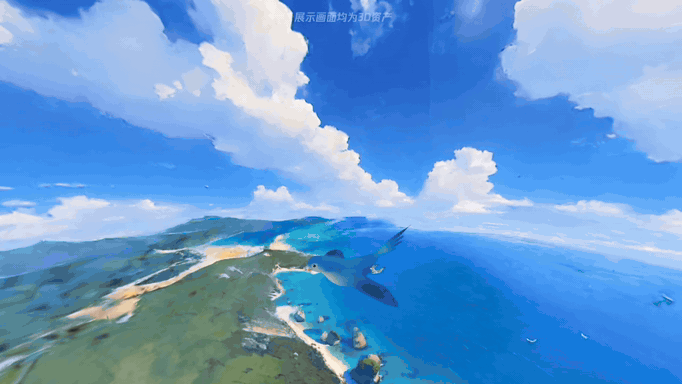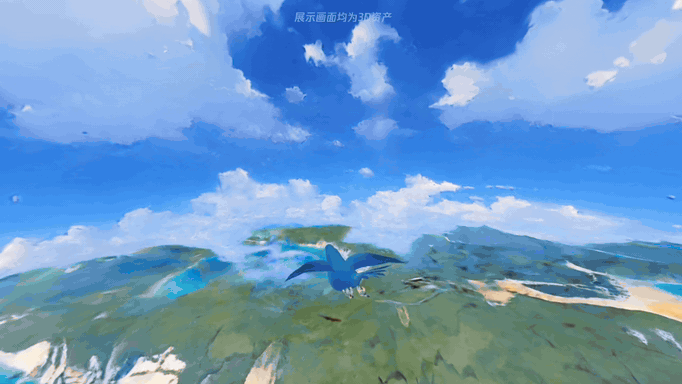
以上均为真实3D资产(非生成视频),完全由 HY-World 2.0 创建——截取自实时交互画面。
## ✨ 亮点
- **真实3D世界,而非仅仅是视频**
与纯视频世界模型(如 Genie 3、HY World 1.5)不同,HY-World 2.0 生成**真实3D资产**——3DGS、网格和点云——可自由浏览、编辑,并直接导入 **Unity / Unreal Engine / Isaac**。从一段文本提示或一张图像出发,即可创建多种风格的可导航3D世界:写实、卡通、游戏等。
- **从照片和视频即时3D重建**
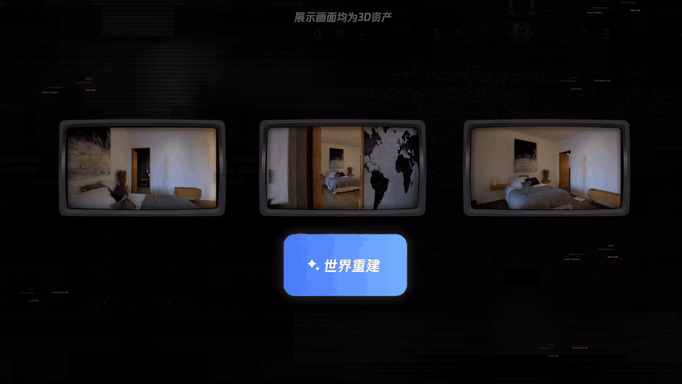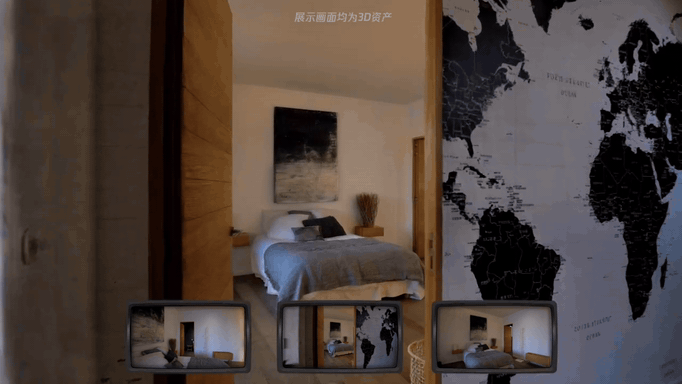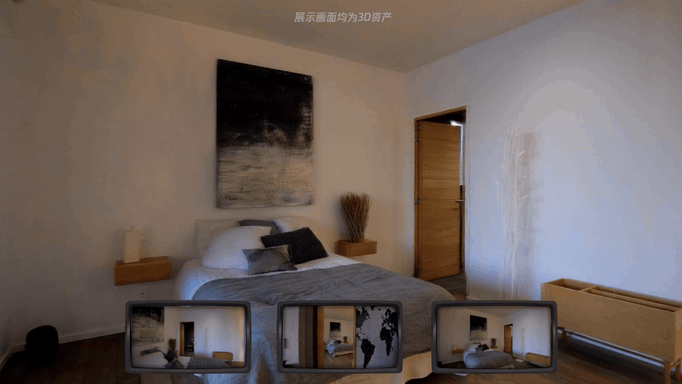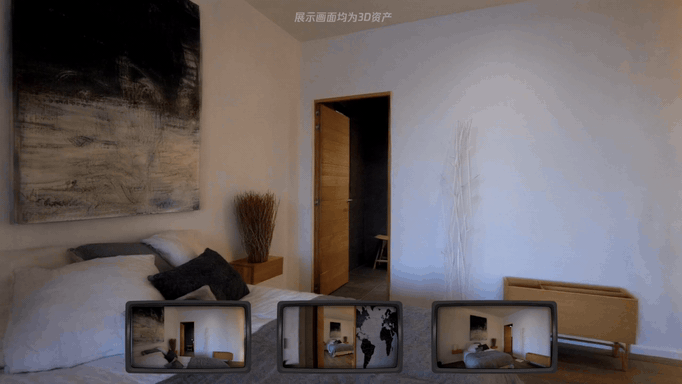
由 **WorldMirror 2.0** 驱动,这是一个统一的前馈模型,能够在单次前向传播中从多视图图像或随手拍摄的视频中预测稠密点云、深度图、表面法线、相机参数和3DGS。支持灵活分辨率推理(50K–500K 像素),精度达到 SOTA 水平。拍摄一段视频,即可获得数字孪生。
- **交互式角色探索**
不仅仅是观看——**在生成的世界中自由漫游**。HY-World 2.0 支持第一人称导航和第三人称角色模式,用户可以在 AI 生成的街道、建筑和景观中自由探索,并具备基于物理的碰撞效果。前往[我们的产品页面](https://3d.hunyuan.tencent.com/sceneTo3D)免费体验 ()。
## 🧩 架构
- **详细信息请参阅我们的技术报告**
HY-World 2.0 的系统化流水线——*全景生成*(HY-Pano-2.0)→ *轨迹规划*(WorldNav)→ *世界扩展*(WorldStereo 2.0)→ *世界组合*(WorldMirror 2.0 + Splattings Learning)——能够自动将文本或单张图像转化为高保真、可漫游的3D世界(3DGS/网格输出)。
## 📝 开源计划
- [x] 技术报告
- [x] WorldMirror 2.0 代码和模型权重
- [x] 世界生成推理代码(WorldNav + WorldStereo 2.0 + 3DGS 组合)
- [x] 全景生成(HY-Pano 2.0)模型和代码
- [x] WorldStereo 2.0 模型权重
## 🎁 模型库
### 世界重建 — WorldMirror 系列
| 模型 | 描述 | 参数量 | 日期 | Hugging Face |
|------|------|--------|------|--------------|
| WorldMirror-2 [new] | 多视图 / 视频 → 3D 重建 | ~1.2B | 2026 | [下载](https://huggingface.co/tencent/HY-World-2.0/tree/main/HY-WorldMirror-2.0) |
| WorldMirror-1 | 多视图 / 视频 → 3D 重建(旧版) | ~1.2B | 2025 | [下载](https://huggingface.co/tencent/HunyuanWorld-Mirror/tree/main) |
### 全景生成 — HY-Pano 系列
| 模型 | 描述 | 参数量 | 日期 | Hugging Face |
|------|------|--------|------|--------------|
| HY-Pano-2 [new] | 文本 / 图像 → 360° 全景 | ~80B | 2026 | [下载](https://huggingface.co/tencent/HY-World-2.0/tree/main/HY-Pano-2.0) |
| HY-Pano-2-Qwen [new] | 文本 / 图像 → 360° 全景 | ~425M | 2026 | [下载](https://huggingface.co/tencent/HY-World-2.0/blob/main/HY-Pano-2.0/pytorch_lora_weights.safetensors) |
### 世界扩展 — WorldStereo 系列
| 模型 | 描述 | 参数量 | 日期 | Hugging Face |
|-----------------|------|--------|------|--------------|
| WorldStereo-2 [new] | 全景 → 3DGS 世界 | ~17B | 2026 | [下载](https://huggingface.co/hanshanxue/WorldStereo/tree/main) |
我们建议参考我们之前的工作 [WorldStereo](https://github.com/FuchengSu/WorldStereo) 和 [WorldMirror](https://github.com/Tencent-Hunyuan/HunyuanWorld-Mirror),以了解3D世界生成和重建的背景知识。
## 🤗 快速开始
### 安装依赖
我们建议使用 **CUDA 12.8** 和 **Python 3.11+**。推荐先准备一个共享环境,先满足 **世界重建(WorldMirror 2.0)** 的运行需求,再按需安装 **世界生成** 的额外组件。
#### 1. 创建共享环境
```bash
git clone https://github.com/Tencent-Hunyuan/HY-World-2.0
cd HY-World-2.0
conda create -n hyworld2 python=3.11.15
conda activate hyworld2
```
#### 2. 安装世界重建依赖
完成此步骤后,环境即可运行 **worldrecon / WorldMirror 2.0**。
```bash
# worldrecon 和 worldgen 共用的基础依赖
pip install -r requirements.txt
# 推荐:安装一次自定义 gsplat 版本,同时支持 worldrecon 和 worldgen
cd hyworld2/worldgen/third_party/gsplat_maskgaussian
pip install -e . --no-build-isolation
cd ../../../../
```
如果你只需要 **worldrecon**,并希望使用更简单的妥协安装方式,也可以安装官方 `gsplat`:
```bash
pip install git+https://github.com/nerfstudio-project/gsplat.git
```
安装 **一种** FlashAttention 后端:
```bash
# Hopper GPU 推荐:FlashAttention-3
git clone https://github.com/Dao-AILab/flash-attention.git
cd flash-attention/hopper
python setup.py install
cd ../../
rm -rf flash-attention
```
```bash
# 更简单的替代方案:FlashAttention-2
pip install flash-attn --no-build-isolation
```
#### 3. 添加世界生成额外依赖
如果需要运行 **worldgen**,请继续执行以下步骤。以下命令假设已经激活上面的 `hyworld2` 环境。
```bash
# git 依赖需要先安装好 torch/CUDA
pip install --no-build-isolation -r requirements_git.txt
# recastnavigation 通过 git submodule 管理
git submodule update --init --recursive
# 用于轨迹规划的 Recast navmesh 扩展
cd hyworld2/worldgen/third_party/navmesh
pip install . --no-build-isolation
cd ../../../../
```
**HY-Pano-2** 的安装请参阅 **[hyworld2/panogen/README_zh_CN.md](hyworld2/panogen/README_zh_CN.md)**。
### 代码使用 — 全景生成(HY-Pano-2)
完整文档和命令行参考,请参阅 **[hyworld2/panogen/README_zh_CN.md](hyworld2/panogen/README_zh_CN.md)**。
我们为 HY-Pano 2.0 提供类似 `diffusers` 的 Python API。模型权重将在首次运行时自动从 Hugging Face 下载。
```python
from pipeline import HunyuanPanoPipeline
pipeline = HunyuanPanoPipeline.from_pretrained('tencent/HY-World-2.0')
output = pipeline('input.png')
output.save('output_panorama.png')
```
### 代码使用 — 世界生成(WorldNav、WorldStereo-2 和 3DGS)
世界生成流程会将全景场景转换为可导航的 3D 世界,主要包含五个阶段:
| 阶段 | 脚本 | 说明 |
|------|------|------|
| 1. 轨迹规划 | `traj_generate.py` | 基于 VLM 的相机轨迹规划,支持障碍物感知导航 |
| 2. 轨迹渲染 | `traj_render.py` | 沿规划轨迹进行多卡点云渲染 |
| 3. 世界扩展 | `video_gen.py` | 使用 WorldStereo-2 进行带记忆一致性的关键帧生成 |
| 4. GS 数据准备 | `gen_gs_data.py` | 提取用于 3DGS 训练的图像、对齐深度、法线和相机参数 |
| 5. 3DGS 训练 | `world_gs_trainer.py` | 优化并导出最终的 Gaussian Splatting 世界 |
完整文档、运行前置条件和命令行参数,请参阅 **[hyworld2/worldgen/README.md](hyworld2/worldgen/README.md)**。
### 代码使用 — WorldMirror 2.0
WorldMirror 2.0 支持以下使用方式:
- [代码使用](#代码使用--worldmirror-20)
- [Gradio 应用](#gradio-应用--worldmirror-20)
我们提供了类似 `diffusers` 的 Python API。模型权重将在首次运行时自动从 Hugging Face 下载。
```python
from hyworld2.worldrecon.pipeline import WorldMirrorPipeline
pipeline = WorldMirrorPipeline.from_pretrained('tencent/HY-World-2.0')
result = pipeline('path/to/images')
```
**使用先验注入(相机位姿和深度):**
```python
result = pipeline(
'path/to/images',
prior_cam_path='path/to/prior_camera.json',
prior_depth_path='path/to/prior_depth/',
)
```
> 关于相机/深度先验的详细格式和准备方法,请参阅[先验准备指南](DOCUMENTATION_zh.md#先验注入)。
**命令行:**
```bash
# 单卡推理
python -m hyworld2.worldrecon.pipeline --input_path path/to/images
# 多卡推理
torchrun --nproc_per_node=2 -m hyworld2.worldrecon.pipeline \
--input_path path/to/images \
--use_fsdp --enable_bf16
```
> **重要提示:** 在多卡模式下,输入图像数量必须 **>= GPU 数量**。例如,使用 `--nproc_per_node=8` 时,需要提供至少 8 张图像。
### Gradio 应用 — WorldMirror 2.0
我们提供了一个交互式 [Gradio](https://www.gradio.app/) Web 演示。上传图像或视频,即可在浏览器中可视化 3DGS、点云、深度图、法线图和相机参数。
```bash
# 单卡
python -m hyworld2.worldrecon.gradio_app
# 多卡
torchrun --nproc_per_node=2 -m hyworld2.worldrecon.gradio_app \
--use_fsdp --enable_bf16
```
关于 Gradio 应用的完整参数列表(端口、分享、本地检查点等),请参阅 [DOCUMENTATION_zh.md](DOCUMENTATION_zh.md#gradio-应用)。
## 🔮 性能表现
完整的基准测试结果请参阅[技术报告](https://3d-models.hunyuan.tencent.com/world/)。
### WorldStereo 2.0 — 相机控制
| 方法 |
相机指标 |
视觉质量 |
| RotErr ↓ | TransErr ↓ | ATE ↓ |
Q-Align ↑ | CLIP-IQA+ ↑ | Laion-Aes ↑ | CLIP-I ↑ |
| SEVA | 1.690 | 1.578 | 2.879 | 3.232 | 0.479 | 4.623 | 77.16 |
| Gen3C | 0.944 | 1.580 | 2.789 | 3.353 | 0.489 | 4.863 | 82.33 |
| WorldStereo | 0.762 | 1.245 | 2.141 | 4.149 | 0.547 | 5.257 | 89.05 |
| WorldStereo 2.0 | 0.492 | 0.968 | 1.768 | 4.205 | 0.544 | 5.266 | 89.43 |
### WorldStereo 2.0 — 基于单帧输入的生成式重建
| Methods |
Tanks-and-Temples |
MipNeRF360 |
| Precision ↑ |
Recall ↑ |
F1-Score ↑ |
AUC ↑ |
Precision ↑ |
Recall ↑ |
F1-Score ↑ |
AUC ↑ |
| SEVA |
33.59 |
35.34 |
36.73 |
51.03 |
22.38 |
55.63 |
28.75 |
46.81 |
| Gen3C |
46.73 |
25.51 |
31.24 |
42.44 |
23.28 |
75.37 |
35.26 |
52.10 |
| Lyra |
50.38 |
28.67 |
32.54 |
43.05 |
30.02 |
58.60 |
36.05 |
49.89 |
| FlashWorld |
26.58 |
20.72 |
22.29 |
30.45 |
35.97 |
53.77 |
42.60 |
53.86 |
| WorldStereo 2.0 |
43.62 |
41.02 |
41.43 |
58.19 |
43.19 |
65.32 |
51.27 |
65.79 |
| WorldStereo 2.0 (DMD) |
40.41 |
44.41 |
43.16 |
60.09 |
42.34 |
64.83 |
50.52 |
65.64 |
### WorldMirror 2.0 — 点云重建
**在 7-Scenes、NRGBD 和 DTU 上的点图重建。** 我们报告了 WorldMirror 在不同输入配置下的平均精度和完整度。**加粗**为最优结果。"L / M / H" 分别代表低 / 中 / 高推理分辨率。"+ all priors" 表示同时注入相机外参、相机内参和深度先验。
| 方法 |
7-Scenes (场景) |
NRGBD (场景) |
DTU (物体) |
| Acc. ↓ | Comp. ↓ |
Acc. ↓ | Comp. ↓ |
Acc. ↓ | Comp. ↓ |
| WorldMirror 1.0 |
| L | 0.043 | 0.055 | 0.046 | 0.049 | 1.476 | 1.768 |
| L + all priors | 0.021 | 0.026 | 0.022 | 0.020 | 1.347 | 1.392 |
| M | 0.043 | 0.049 | 0.041 | 0.045 | 1.017 | 1.780 |
| M + all priors | 0.018 | 0.023 | 0.016 | 0.014 | 0.735 | 0.935 |
| H | 0.079 | 0.087 | 0.077 | 0.093 | 2.271 | 2.113 |
| H + all priors | 0.042 | 0.041 | 0.078 | 0.082 | 1.773 | 1.478 |
|
| WorldMirror 2.0 |
| L | 0.041 | 0.052 | 0.047 | 0.058 | 1.352 | 2.009 |
| L + all priors | 0.019 | 0.024 | 0.017 | 0.015 | 1.100 | 1.201 |
| M | 0.033 | 0.046 | 0.039 | 0.047 | 1.005 | 1.892 |
| M + all priors | 0.013 | 0.017 | 0.013 | 0.013 | 0.690 | 0.876 |
| H | 0.037 | 0.040 | 0.046 | 0.053 | 0.845 | 1.904 |
| H + all priors | 0.012 | 0.016 | 0.015 | 0.016 | 0.554 | 0.771 |
### WorldMirror 2.0 — 先验对比
**WorldMirror 与 Pow3R、MapAnything 在不同先验条件下的对比。** 结果为 7-Scenes、NRGBD 和 DTU 数据集上的平均值。Pow3R (pro) 指使用 Procrustes 对齐的原版 Pow3R。

## 🎬 更多示例
## 📖 文档
详细的使用指南、参数参考、输出格式说明和先验注入说明,请参阅 **[DOCUMENTATION_zh.md](DOCUMENTATION_zh.md)**。
## 📚 引用
如果您觉得 HunyuanWorld 2.0 对您的研究有帮助,请引用:
```bibtex
@article{hyworld22026,
title={HY-World 2.0: A Multi-Modal World Model for Reconstructing, Generating, and Simulating 3D Worlds},
author={Team HY-World},
journal={arXiv preprint arXiv:2604.14268},
year={2026}
}
@article{hunyuanworld2025tencent,
title={HunyuanWorld 1.0: Generating Immersive, Explorable, and Interactive 3D Worlds from Words or Pixels},
author={Team HunyuanWorld},
year={2025},
journal={arXiv preprint}
}
```
## 📧 联系方式
如有任何问题或反馈,请发送邮件至 tengfeiwang12@gmail.com。
## 🙏 致谢
我们衷心感谢 [HunyuanWorld 1.0](https://github.com/Tencent-Hunyuan/HunyuanWorld-1.0)、[WorldMirror](https://github.com/Tencent-Hunyuan/HunyuanWorld-Mirror)、[WorldPlay](https://github.com/Tencent-Hunyuan/HY-WorldPlay)、[WorldStereo](https://github.com/FuchengSu/WorldStereo)、[HunyuanImage](https://github.com/Tencent-Hunyuan/HunyuanImage-3.0) 的杰出工作。


