Hy Memory
工业级双系统认知记忆框架,为 LLM Agent 提供类人长期记忆能力。


[English](README.md) | 中文
**[Hy Memory](https://memory.hunyuan.tencent.com/)**(官网:[memory.hunyuan.tencent.com](https://memory.hunyuan.tencent.com/))是面向自演化 LLM Agent 的工业级双系统认知记忆引擎与 Python SDK(`hy-memory`),针对三类任务场景提供专用记忆链路:面向日常对话的 **Chat** 多层认知记忆、面向生产力任务的 **Working**“会话事实 + 可复用经验”双层记忆,以及面向软件工程的 **Coding** 双层记忆与代码版本演进链(diff 链)。基于 Hy Memory 构建的 **[MemHub](memhub/README.md)** 是本地优先的桌面端与 CLI 产品,可将用户授权的多个 AI 应用(如 Claude Code、Cursor、Codex、OpenCode、Qwen Code 等)的历史对话与操作轨迹汇入统一的本地受管 Runtime 与数据目录,并向授权宿主提供受治理的跨应用记忆召回。
---
## 最新动态
* *[new]* 🔥🔥🔥 **[2026-10]**: 🚀 **模型开源** 在 Hugging Face 发布 **Hy-Memory-30B-A3B** 的 **FP8**(**[Hy-Memory-30B-A3B-FP8](https://huggingface.co/tencent/Hy-Memory-30B-A3B-FP8)**)与 **GGUF**(**[Hy-Memory-30B-A3B-GGUF](https://huggingface.co/tencent/Hy-Memory-30B-A3B-GGUF)**)量化版本模型!
* *[new]* 🔥🔥🔥 **[2026-10]**: 📦 **正式发布 [MemHub v1.0.4](https://github.com/Tencent-Hunyuan/Hy-Memory/releases/tag/v1.0.4)** 与 **[memhub-cli 1.0.5](https://www.npmjs.com/package/memhub-cli/v/1.0.5)**,提供已签名的 macOS 桌面应用及经过验证的 macOS/Linux Runtime!
* *[new]* 🔥🔥🔥 **[2026-10]**: 🚀 **正式发布** **Hy Memory 2.0 (`hy-memory==2.0.4`)**(已上线 [PyPI](https://pypi.org/project/hy-memory/2.0.4/)),并开源 **Hy-Memory** monorepo 与 **[MemHub](memhub/README.md)**!
* *[new]* 🔥🔥🔥 **[2026-10]**: 🚀 **模型开源** 在 Hugging Face 发布 **[Hy-Memory-30B-A3B](https://huggingface.co/tencent/Hy-Memory-30B-A3B)** 长期记忆写入模型及[技术报告](https://arxiv.org/abs/2610.22196)!
* *[new]* 🔥🔥 **[2026-09]**: 📊 **基准与方法发布** 推出长周期与交错式编程记忆评测基准 **[CMB: A Coding Memory Benchmark for Long-Horizon and Interleaved Coding Agents](docs/papers/CMB_A_Coding_Memory_Benchmark_for_Long_Horizon_and_Interleaved_Coding_Agents.pdf)**(已投稿 **ICLR 2027**)。
* *[new]* 🔥🔥 **[2026-08]**: 🎉 **论文录用** 双系统认知记忆架构论文 **[Memory Beyond Recall: A Dual-Process Cognitive Memory System for Self-Evolving LLM Agents](https://arxiv.org/abs/2606.09483)** 被 **EMNLP 2026** 接收!
* 🔥 **[2026-05]**: 🌟 **初代发布** 正式发布第一代认知记忆框架 **[Hy Memory 1.0](https://mp.weixin.qq.com/s/dH5PGpxqArFZkSq3-QxWYA)**,推出面向自演化 LLM Agent 的双系统长期记忆架构。
---
## 论文
欢迎了解 **Hy Memory 记忆研究体系**,涵盖对话认知记忆、长周期编程记忆以及强化学习记忆写入模型:
> [**Memory Beyond Recall: A Dual-Process Cognitive Memory System for Self-Evolving LLM Agents**](https://arxiv.org/abs/2606.09483) *(**EMNLP 2026** 已接收)*
> **TL;DR:** 提出面向 **Chat** 的双系统(System 1 + System 2)认知记忆架构,将个人长期记忆组织为 8 层认知结构(原始对话、原子事实、会话摘要、心智图式与前瞻意图等),支持冲突消解与跨域图式归纳。
> 📄 Paper: https://arxiv.org/abs/2606.09483
> [**CMB: A Coding Memory Benchmark for Long-Horizon and Interleaved Coding Agents**](docs/papers/CMB_A_Coding_Memory_Benchmark_for_Long_Horizon_and_Interleaved_Coding_Agents.pdf) *(**ICLR 2027** 已投稿)*
> **TL;DR:** 提出面向长周期与交错式 **Coding** Agent 的记忆评测基准与“双层记忆 + 代码版本演进链(diff 链)”方法,在保留可复用工程经验的同时完整追踪代码历次修改轨迹。
> 📄 Paper: [docs/papers/CMB_A_Coding_Memory_Benchmark_for_Long_Horizon_and_Interleaved_Coding_Agents.pdf](docs/papers/CMB_A_Coding_Memory_Benchmark_for_Long_Horizon_and_Interleaved_Coding_Agents.pdf)
> [**Hy-Memory-30B-A3B: Attributed Reinforcement Learning for Long-Term Memory Writing**](https://arxiv.org/abs/2610.22196) *(开源模型技术报告)*
> **TL;DR:** 提出面向长期记忆写入的归因强化学习(Attributed RL)训练框架,开源专门针对高精度记忆抽取与冲突消解优化的 30B-A3B MoE 模型。
> 📄 Paper: https://arxiv.org/abs/2610.22196 · Model: https://huggingface.co/tencent/Hy-Memory-30B-A3B
---
## 快速开始
### 1. 安装
```bash
pip install hy-memory==2.0.4 # 核心(含 ChromaDB 与 Kuzu)
pip install "hy-memory[qdrant]==2.0.4" # + Qdrant
pip install "hy-memory[faiss]==2.0.4" # + FAISS
pip install "hy-memory[graph]==2.0.4" # + Neo4j
pip install "hy-memory[mysql]==2.0.4" # + MySQL 缓存
pip install "hy-memory[rerank]==2.0.4" # + 本地多语言 cross-encoder rerank
pip install "hy-memory[all]==2.0.4" # 全部
```
### 2. 配置
只需 LLM 和 Embedding 两组配置,支持任何兼容 OpenAI API 格式的服务:
```bash
export MEMORY_LLM_API_KEY="sk-your-key"
export MEMORY_LLM_BASE_URL="https://api.deepseek.com"
export MEMORY_LLM_MODEL="deepseek-chat"
export MEMORY_EMBEDDER_API_KEY="sk-your-key"
export MEMORY_EMBEDDER_BASE_URL="https://dashscope.aliyuncs.com/compatible-mode/v1"
export MEMORY_EMBEDDER_MODEL="text-embedding-v3"
export MEMORY_EMBEDDING_DIMS=1024
```
或使用 OpenAI 默认配置(单个 key):
```bash
export OPENAI_API_KEY="sk-your-key"
```
完整配置见 [环境变量参考](docs/env_reference.md)。
### 3. Chat 记忆
```python
from hy_memory import HyMemoryClient
client = HyMemoryClient(mode="pro")
# 写入:纯文本或 OpenAI messages 格式
client.add("用户喜欢科幻电影,特别是《星际穿越》", user_id="user_1")
client.add([
{"role": "user", "content": "推荐一部电影"},
{"role": "assistant", "content": "推荐《星际穿越》,诺兰的经典科幻之作"},
], user_id="user_1")
# 检索:返回 profile / normal / proactive 三路
results = client.search("用户喜欢什么类型的电影?", user_ids=["user_1"], limit=10)
for mem in results["memories"]["normal"]:
print(f" [{mem['score']:.2f}] {mem['content']}")
client.close()
```
### 4. Working / Coding 记忆
写入需要包含工具调用轨迹(`tool_calls` 或 `role="tool"` 消息),且仅在 `pro` / `ultra` 模式下生效(`lite` 会忽略 `scene`,一律按原始记忆存取):
```python
messages = [
{"role": "user", "content": "Fix the timeout in the search client."},
{"role": "assistant", "content": "", "tool_calls": [{
"id": "call_1", "type": "function",
"function": {"name": "apply_patch", "arguments": '{"path":"src/search.py"}'},
}]},
{"role": "tool", "tool_call_id": "call_1", "name": "apply_patch",
"content": "Patch applied successfully"},
]
client.add(
messages,
scene="coding", # 或 "working"
user_id="user_123",
workspace_id="github.com/example/service", # 可选:按仓库 / 项目隔离
branch="fix/search-timeout", # 可选:需同时传 workspace_id
)
result = client.search(
"Which timeout implementation was finally kept?",
scene="coding",
user_ids=["user_123"],
workspace_id="github.com/example/service",
branch="fix/search-timeout",
limit=5,
)
result["facts"] # 事实层
result["experiences"] # 经验层
result["chain_block"] # 仅 coding:版本演进上下文(默认空;需 MEMORY_CODING_CHAIN_BLOCK_ENABLED)
```
### 5. 自动路由、来源过滤与进阶 API
- **自动场景路由**:不传 `scene` 时,不含工具调用的写入直接走 `chat`(零 LLM 开销),含工具调用的写入用一次 LLM 在 `chat` / `working` / `coding` 间分类;检索在 `search_mode="default"` 下固定走 `chat`(零 LLM),`search_mode="agentic"` 下自动完成场景分类、query 改写和时间范围解析。详见 [Working/Coding Scene](docs/scene_coding_usage.md)。
- **按来源区分记忆**:写入时传入 `source="openclaw" | "cursor" | "codex"`,检索时通过 `include_sources` / `exclude_sources` 过滤,实现与 `agent_id` 正交的宿主应用隔离。
- **常用管理与演进 API**:`client.get(id)`、`client.update(id, text)`、`client.delete(id)`、`client.list_memories(user_id=...)`,以及在 `ultra` 模式下显式触发 System 2 认知加工的 `client.evolve(user_id=...)`。
- **Per-call Embedding 端点覆盖**:支持在 `add()` / `search()` 中传 `embed_override={"base_url": ..., "api_key": ...}`,或使用并发安全的 `with embed_endpoint_override(...):` 上下文管理器。
服务商配置、存储后端、场景与完整 API 见 [使用指南](docs/usage.md)。
---
## 架构设计
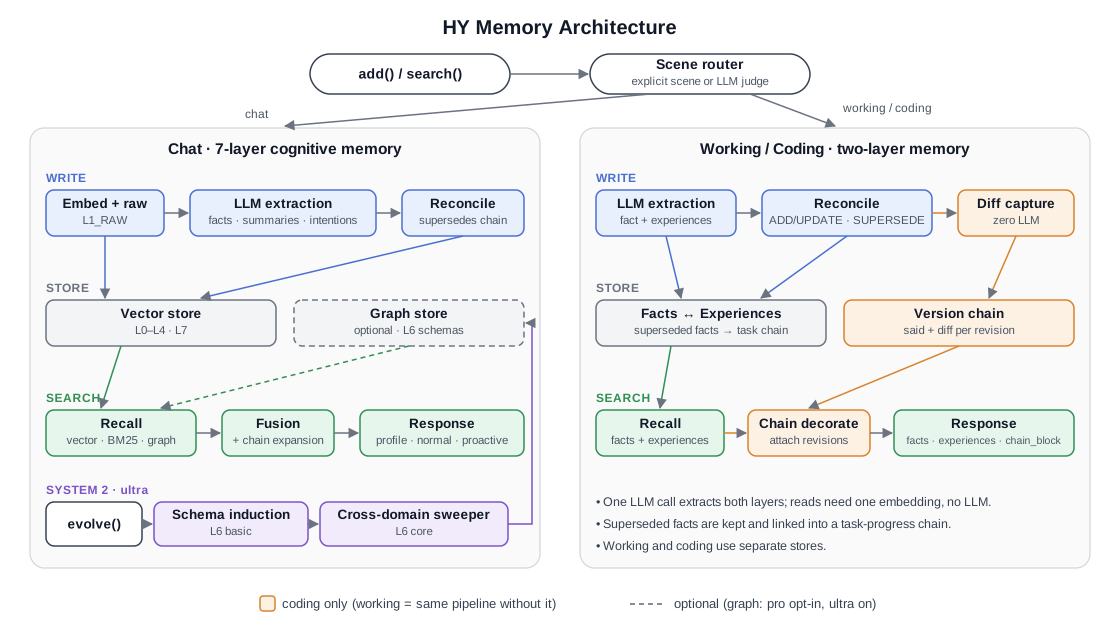
Hy Memory 按任务类型提供三种记忆场景(`scene`)。`add()` / `search()` 先经过 scene 路由,再进入 Chat 或 Working / Coding 链路(图中橙色部分为 Coding 独有,去掉后即为 Working):
| `scene` | 面向的任务 | 记忆形态 |
|---|---|---|
| `chat` | 闲聊、个人信息、偏好、一般问答 | 记忆分层(L0–L7) |
| `working` | 文档、表格、研究、财经分析、内容创作、电脑操作等生产力任务 | 双层记忆:会话事实 + 可复用经验 |
| `coding` | 编码、调试、测试、构建、API/SDK、脚本、SQL 等软件工程任务 | 与 working 相同的双层记忆,外加代码版本演进链(diff 链) |
### 1. Chat:记忆分层
面向个人长期记忆。原始对话逐层抽象成事实、摘要、画像和更高层的认知结构:
| 层 | 名称 | 内容 |
|---|---|---|
| L0 | `BASIC_INFO` | 基础信息 |
| L1 | `RAW` | 原始对话(append-only) |
| L2 | `FACT` | 原子事实(版本化,不可变记录) |
| L3 | `SUMMARY` | 会话摘要 |
| L4 | `IDENTITY` | 保留 |
| L5 | `KNOWLEDGE` | 保留 |
| L6 | `SCHEMA` | 心智模型(抽象叙事模板,图层) |
| L7 | `INTENTION` | 前瞻意图(带有效期,过期后转为普通事实) |
**处理模式**
| 模式 | 功能 | 图数据库 | 适用场景 |
|------|------|---------|---------|
| `lite` | 只对原始记忆做 embedding 写入与检索,不调 LLM;忽略 `scene` 和 `layers` | 否 | 纯向量 RAG,快速写入,零 LLM 开销 |
| `pro` | + LLM 提取 + reconcile 冲突处理 | 可选(`MEMORY_ENABLE_GRAPH`,默认关) | 标准场景 |
| `ultra` | + System 2 图式归纳 + 跨域 sweeper(通过 `evolve()` 触发) | 是(自动开启) | 完整认知架构 |
### 2. Working:双层生产力记忆
面向"做事"的场景。一次带工具调用的会话(trace)会同时产出两层记忆:
| 层 | 记录什么 | 每次会话产出 | 结构 |
|---|---|---|---|
| **事实层**(`WorkingFact`) | 这次会话做了什么:任务、做法、结果 | 恰好 1 条,不设门槛 | `statement`、`subject`、`files`、`details`(原文留存) |
| **经验层**(`Experience`) | 下次遇到类似任务可以直接复用的做法 | 0–N 条,需通过价值门槛 | `task`、`search_keys`、`solution`、`boundary_envs`、`confidence` |
事实层保证"做过的事一定记得",经验层负责"学到的东西能复用"。两层互相链接(`fact.derived_experience_ids` ↔ `experience.source_fact_ids`),旧事实被覆盖时以 superseded 状态保留并通过任务进展链(`fact_chain_summary`)回溯演化过程。
### 3. Coding:双层记忆 + 版本演进链
Coding 与 Working **复用同一套双层 pipeline 和数据 schema**,区别有三点:
| | Working | Coding |
|---|---|---|
| **抽取规范** | 生产力任务规范 | 软件工程规范:主语必须是代码或决策,记录精确坐标(文件 / 函数 / 分支)而不是粘贴代码 |
| **存储** | `coding_memory.db` + `*_coding_keys` / `*_working_facts` 向量集合 | `coding_memory_cv.db` + `*_cv` 向量集合,与 working 完全隔离 |
| **版本演进链** | 无 | **有**:记录同一处代码被改了几次、每次改了什么 |
**为什么需要版本演进链**:事实层的抽取刻意不粘贴代码(预算留给更有信息量的坐标),所以被撤掉的那一版代码不会出现在事实里。
而那一版往往不在工作区、也不在 HEAD,事后读不回来。版本演进链零 LLM 地把每一版的真实 diff 存下来,补上摘要必然丢掉的这类信息。
**设计要点**(`hy_memory/coding/chain_store.py`):
- **装饰器而非检索器**:向量层决定返回哪几条事实;演进链只负责在每条事实下面挂上它所涉及代码的全部改动版本(每版的用户原话 + 真实 diff)。
- **修改来源**:本地 Git diff(设置 `MEMORY_CODING_CHAIN_REPO_ROOT`),或工具轨迹中带 `path` / `old` / `new` 的确定性替换动作。
- **分链粒度与隔离**:一条 thread 对应“某分支、某文件、某函数的某一块”,由 `user_id` 与 `workspace_id` 共同隔离。
---
## 支持
### 存储后端
- 向量库:ChromaDB(默认)、Qdrant、FAISS
- 图库(ultra 模式):Kuzu(默认)、Neo4j
- Working / Coding 的元数据使用本地 SQLite
### 文档
- [使用指南](docs/usage.md) — 完整配置参考、API 详情、部署模式
- [环境变量参考](docs/env_reference.md) — 配置说明与默认值
- [Search 与 Reader 指南](docs/hy_memory_search_skill.md) — Reader 选择、Schema 配额、Rerank 与返回通道
- [Working/Coding Scene](docs/scene_coding_usage.md) — 生产力记忆路由、返回结构与 Coding 链行为
- [Graph 记忆设计](docs/pro_graph_design.md) — 图投影、重排、关系路径与部署限制
- [环境变量模板](.env.example) — 可直接复制的配置模板
- [MemHub 说明文档](memhub/README.md) — 本地优先桌面端与 CLI 产品总览、Runtime 命令与隐私边界
- [Hermes 原生记忆 Provider](plugins/hermes/README.md) — 显式用户与 Agent 隔离,独立 HTTP 服务,自动记录与召回默认关闭。
- [OpenClaw 插件](plugins/openclaw/README.md) — Agent 集成见 `plugins/`(总览:[plugins/README.md](plugins/README.md))
### License
Hy-Memory 使用 Apache-2.0,详见 [LICENSE](LICENSE)。第三方组件仍受各自许可证与声明约束。