# Learning Beyond Gradients
> [Jiayi Weng](https://trinkle23897.github.io/cv/)
Continual Learning 一直难以被解决,主要卡在神经网络的灾难性遗忘:学了新东西,旧能力就容易被冲掉。那如果不把目光只放在神经网络权重上,还有没有其他解决方案?
随着 LLM agent 变强,coding 的速度和质量都在提升。但我最近更在意的是另一个现象:coding agent 不训练新网络、不更新权重,只是持续看失败、改代码、加测试、看回放,也能把一套程序系统越养越强。
这让我重新看待 heuristic,也就是手写规则和程序策略。过去很多 heuristic 不是没用,而是没人养得起;coding agent 改变的是这条维护成本曲线。于是,过去只能当一次性补丁的规则,开始变成值得长期拥有的代码。
凡是可以被持续迭代的,都开始能被解决。这也是 Continual Learning 一直想要解决的问题。它会是既 Pretrain、RLHF、Large-scale RL/RLVR 之后的下一个范式吗?
## 异常现象
在业余时间维护 [EnvPool](https://github.com/sail-sg/envpool) 的时候,我想用一个便宜一点的策略来测试游戏环境正确性,不然每次 CI 都跑神经网络,很费测试资源。
一开始的问题只是:
```text
能不能写一些便宜、可复现、比随机强很多的 heuristic,
专门把环境跑到有信息量的状态?
```
我试着使用 codex(gpt-5.4)写一个基于规则的版本,完全不依赖 NN。没想到弄了几下,结果比我预期离谱很多:
- 一个打砖块游戏 Atari Breakout,策略从 `387 -> 507 -> 839 -> 864`,最后打到理论最高分;
- 一个仿真四足机器人关节控制任务 MuJoCo Ant,纯 Python 程序策略先学会节律步态,再接上短视窗模型规划,最后上了 `6000+` 分,进入常见 Deep RL 结果的量级;
- 一个仿真机器人跑步任务 MuJoCo HalfCheetah,靠可解释的步态/姿态规则和在线规划,迭代到 5 局复测均值 `11836.7`,也进入了常见 Deep RL 结果的量级;
- 一个第一人称视觉控制任务 VizDoom,只用 cv2/NumPy 搓屏幕 CV、不训练神经网络,D3 Battle 的 10 seeds 结果也能到 `mean=557.0`、`min=440.0`;
- 一整套 Atari 57 个游戏,一共跑了 57 个游戏 x 2 种输入 x 3 次运行 = 342 条 coding-agent 搜索轨迹,表现有好有坏;但在固定环境交互步数下,中位数 HNS 游戏得分在 `1M` 环境步附近已经远高于 PPO 这类 Deep RL 算法的曲线。
这些结果第一次见到十分震撼,更让我在意的是:codex 没有训练神经网络,它在维护一套还能继续生长的软件系统。
Breakout 策略到最后远远超过一句“球在左边就往左”。这个策略长出来的是动作探测、状态读取、球和挡板检测、落点预测、卡住循环检测、回归测试、视频回放和实验记录。Ant 策略也超过一条步态公式,里面有节律控制、姿态反馈、接触信息、短视窗模型展开。
于是我意识到有必要在这里创造一个新的概念:这里被更新的对象已经不只是策略函数,而是一套带有记忆、反馈入口和回归机制的软件系统。
## Heuristic Learning
在接着和 codex 交流了一阵子之后,我想把这个过程定义为 **Heuristic Learning(HL)**:
- HL 的主体由程序代码构成;
- 它和今天常见的 Deep RL 实践共享状态、动作、反馈、更新的闭环;但更新对象从神经网络参数换成了软件结构;
- 它的反馈由 coding agent 消化,可以来自环境 reward、testcase、日志、视频、回放、人类反馈;
- 它的更新不走反向传播;coding agent 直接修改 policy、状态检测器、测试、配置或者 memory;
- HL 是学习和更新的过程;被 HL 长期维护的对象称之为 **Heuristic System(HS)**;
- HS 超过一个孤立的 `policy.py`:它至少包含程序策略、状态表示、反馈入口、实验记录、回放或测试、memory,以及由 coding agent 执行的更新机制。单条 rule 不够,规则、反馈、历史和下一轮更新全部接起来,才称之为 HS。
列一个表就是:
| 维度 | Deep RL | HL |
| --- | --- | --- |
| Policy(策略) | 由神经网络参数构成 | 由代码构成,可以是代码规则、状态机、controller、MPC、宏动作 |
| State(状态) | 通常由显式观测表示 | 通常显式写成变量、检测器、缓存等可表示的东西 |
| Action(动作) | 由神经网络一次 forward 生成 | 执行代码逻辑生成 |
| Feedback(反馈) | 主要由固定 reward 提供 | 由 coding agent 根据 context 提供,testcase、环境反馈、日志、回放都算 context |
| Update(更新) | 由 Deep RL 算法对神经网络参数做梯度更新 | 由 coding agent 直接修改代码 |
| Memory(历史记录) | on-policy 基本没有,off-policy 有 replay buffer | 可以显式记录 trials、summary、失败原因、回放、版本 diff |
Heuristic Learning 相比 Deep RL 有很多良好的性质:
- 可解释性(Explainability):神经网络很难解释,HL 的代码策略可以翻译成人话;
- 样本效率(Sample Efficiency):一次有效代码更新可以直接跳到新策略,不用调学习率慢慢爬;
- 可回归 / 可验证(Regression-testable):旧能力可以变成 test、replay、golden case;
- 可约束过拟合:代码 heuristic 也会过拟合到 seed、环境细节或测试漏洞,但简化、回归和多 seed 检查可以形成一种工程正则化;
- 可以避免一部分灾难性遗忘(Catastrophic Forgetting):旧能力不用全靠模型自己记住,可以被写进 rule set 和测试里。
重点在于,有一类原来因为维护成本太高而不值得写的 heuristic,现在突然可能值得长期拥有了。
## 为什么 Heuristic Learning 以前没发展起来
如果说 HL 的前身是专家系统、规则系统,那么在 coding agent 没发展起来之前,这玩意的维护成本十分高昂。
人类手工维护 heuristic 很容易变成这样:
```text
今天加一条规则修 case A。
明天发现 case B 被修坏了。
后天再加一个 if。
大后天没人敢删了。
```
问题不在 heuristic 没用,在没人力能养得起。之前人力维护专家系统,有点像工业革命前手工纺纱:规模一大,稳定性和维护成本就压死人。纺织机改变的是产能曲线;coding agent 改变的是 heuristic 的维护曲线。它像一条可以输送智力的营养管道,可以持续浇灌一个 HS,让它自己迭代进化。
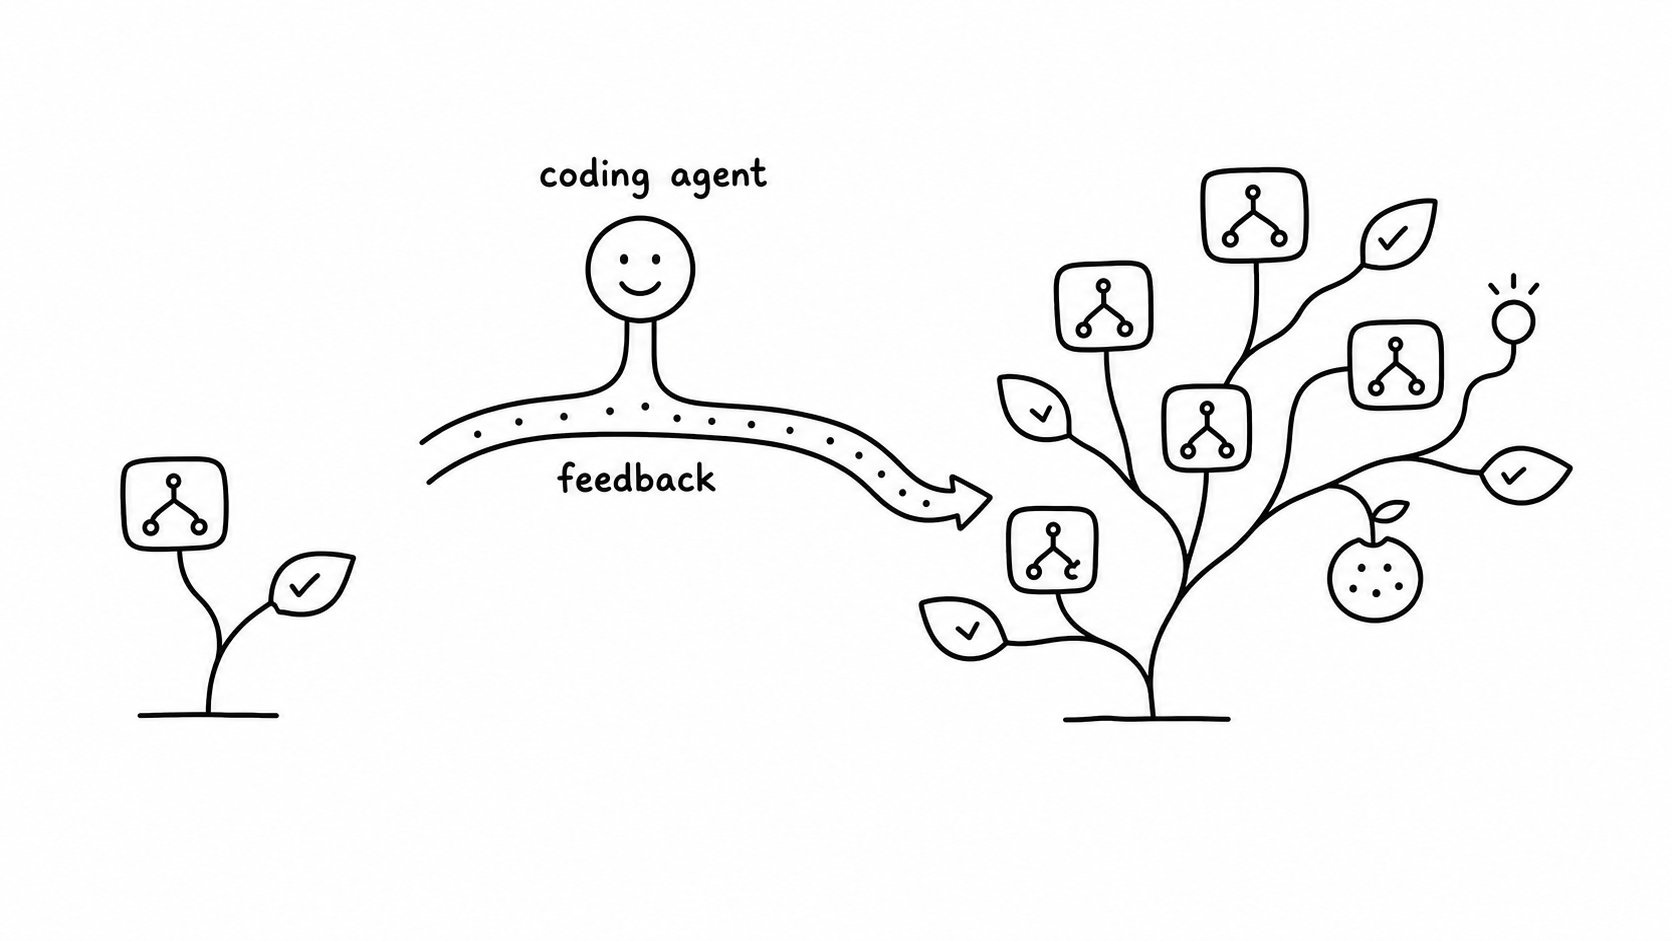
目前常见的 agentic 反馈闭环主要是:
```text
feature request -> agent 写代码 -> 过 test -> 人类给一点反馈 -> 下一轮 patch
```
但随着大模型能力提升,人类介入次数会逐渐变少,这个反馈循环就有机会在某些边界明确的系统里自动闭合,从而能够实现自动化用 HL 批量生产 HS:
```text
环境反馈 / 测试失败 / 日志异常
-> coding agent 读 context
-> 修改 policy / test / memory
-> 重新运行
-> 把结果写回 trials 和 summary
-> 下一轮继续
```
## Heuristic Learning 怎么做 Continual Learning
神经网络里的灾难性遗忘,是新数据把参数往新任务推,旧能力被覆盖掉。HL 也会忘,例如:
- 新规则修好了一个失败模式,同时破坏旧场景;
- 新 memory 把 agent 反复带到错误方向;
- 新测试太窄,导致策略学会钻空子;
- 新 patch 改了公共接口,旧调用方悄悄坏掉;
- 规则越堆越多,最后 agent 自己也维护不动。
所以 HL 不会自动解决 Continual Learning。它把“防遗忘”变成了更工程化的东西。
在 HL 里,旧能力可以被固化成:
- 回归测试;
- 固定 seed 的 replay;
- golden trace;
- 失败视频;
- 版本 diff;
- 明确写下来的失败方向。
与神经网络把经验压进权重完全不一样:HL 的历史是显式、可读、可删、可重构的。它负责“记住”,也负责把一堆局部补丁压缩成更简单的表示。
(只增长不压缩的 HS,最后一定会变成屎山代码。它会“记住”很多东西,但记住的方式太差,导致谁也不敢动,从而腐化)
所以一个健康的 HS 至少需要两个操作维持:
1. 吸收反馈:把新失败、新日志、新 reward 写回系统。
2. 压缩历史:把一堆局部补丁折回更简单、更可维护的表示。
这就把 Continual Learning 从“怎么更新参数”变成了“怎么维护一个持续吸收反馈的软件系统”。
## Heuristic System 的复杂度
此处定义 **耦合复杂度** 为 coding agent 能维护多复杂的策略来支持 HL。展开说,就是一次更新必须同时照顾多少相互牵连的状态、规则、测试、反馈和历史。
这个量不能按代码行数算。一个 500 行策略,如果模块边界清楚、测试完整、状态可复现,可能很好维护;一个 80 行策略,如果每行都互相牵制、没有日志、没有回放,也可能是个定时炸弹,一碰就崩。
朝代码一侧看,耦合复杂度受模块边界、接口稳定性、测试覆盖、日志观测性、回滚成本和状态可复现性限制。好的模块化会把全局耦合切成局部耦合,从而降低耦合复杂度;好的测试能让 coding agent 不必每次在脑子里模拟整个系统。
朝 coding agent 一侧看,能接受多少耦合复杂度,取决于模型能力、上下文长度、memory 质量、工具质量、整体迭代速度。更强的模型能够同时处理更多相互作用;更长的上下文能让它少丢线索;memory 可以把跨轮次迭代经验留下;搜索、定位、运行、回放这些工具能够把一部分认知负担搬到外部。
把这两侧放一起,可以得到一组判断:
- 反馈越清楚,单位 agent 智力能维护的耦合复杂度越高;
- 同等工具和反馈下,模型能力越强,能处理的耦合复杂度越高;
- 模块化、测试、回放会把一部分耦合复杂度转移到环境里;
- memory 和工具会提高 agent 的有效上下文;
- 只增长不压缩的 HS 会让耦合复杂度持续上升,直到超过维护能力。
Breakout 策略能走到 `864` 的满分,有规则简单的一面,也有失败可以视频回放、局部复现、回归验证的一面。Ant 复杂得多,但它可以拆成节律、姿态、接触、residual MPC 这些模块。
Montezuma 是一个很好的反例。Atari57 里有一条无人值守的记录到了 `400` 分,但那条路线由 `86` 个宏动作组成,基本是开环执行。这个例子说明,有些环境需要更强的程序形态,比如可组合宏动作、可恢复搜索状态、长期 memory。普通 `if else` 不能解决所有问题。
## 下一个范式?
目前的范式转移是从最开始的 pretrain,到 RLHF,再变成 large-scale RL / RLVR。凡是可以验证的,都开始能被解决。
Online Learning 和 Continual Learning 可以被当前 RLVR 生产出来的 agentic coding,通过 Heuristic Learning 的方式部分解决。从这个愿景出发,我愿称其为下一个范式:凡是可以被持续迭代的,都开始能被解决。
为什么说是部分解决?因为 Heuristic Learning 并不能做所有神经网络能做的事情。它受制于代码的表达能力,比如复杂感知和长程泛化。比如在我目前认知范围内,我想不出有个 agent 能搓出一个纯 Python code、不用神经网络去解决 ImageNet。
于是问题在于如何结合神经网络和 HL,同时解决 Online Learning 和 Continual Learning。最有希望的方向是:用 HL 处理在线数据快速生成在线经验,把在线经验内化成可训练、可回归、可筛选的数据,再周期性更新神经网络。
以机器人为例,如果套用 System 1/2 的术语,一个可能的分工形态如下:
- 专用、浅层 NN:当作 System 1 的一部分,快、便宜,负责感知、分类、物体状态估计;
- HL:也可以当作 System 1 的一部分,负责最新数据处理、规则、测试、回放、memory、安全边界、局部恢复;
- LLM agent:作为 System 2,负责给 HL 提供反馈、改进数据,并周期性提取 HL 生成的数据来更新自身。
这套东西可以继续拆成层级结构:
```text
关节级 HL -> 肢体级 HL -> 全身平衡 HL -> 任务级 HL
```
低层负责安全和低延迟控制,中层负责步态和接触,高层负责任务、恢复和长期记忆。coding agent 不一定直接“懂得走路”,它更像插进系统里的更新管线:持续把失败视频、传感器流、仿真结果、测试结果喂进系统,再把反馈改写成代码、参数、保护规则和 memory。
LLM agent 可以共享,也可以相互隔离在机器人体内自行学习。这里的问题是:HL 提供的*特定数据分布*如何才能不让 LLM 的周期性更新崩溃。这是一个经典的 post-training 问题,已经有很多成熟经验,由于某些原因在这里就不展开了。
Agentic coding 改变了写代码速度,也改写了哪些代码值得被长期拥有。
过去很多 heuristic 看起来没有前途,原因常常落在维护成本上;它们本身未必太弱。coding agent 改变的是这条维护成本曲线。规则、测试、日志、memory 和补丁原来只是散落的工程材料,现在开始可以组成一个会持续更新的 Heuristic System,能够真正解决 Online Learning 和 Continual Learning 所未能解决的问题。
欢迎来到下一个范式!
## 免责声明
本文仅代表个人观点,不代表公司立场;文中讨论与任何公司具体项目、产品规划或内部工作无关。
## 致谢
感谢 [Costa Huang](https://costa.sh/)、[Tairan He](https://tairanhe.com/) 和 [Hao Sheng](https://hsheng.org) 的反馈。
## 引用
如果需要在 LaTeX 里引用这篇文章,可以用下面这个 BibTeX。
```bibtex
@misc{weng2026learning_beyond_gradients,
title = {Learning Beyond Gradients},
author = {Weng, Jiayi},
year = {2026},
month = may,
howpublished = {\url{https://trinkle23897.github.io/learning-beyond-gradients/}},
note = {Blog post}
}
```
## 附录:实验过程和复现入口
完整 artifact repo 在 [https://github.com/Trinkle23897/learning-beyond-gradients](https://github.com/Trinkle23897/learning-beyond-gradients)。下面命令默认你已经 clone 了这个 repo,并在仓库根目录运行;GitHub Pages 只展示文章和必要静态文件,完整脚本、CSV、视频和实验材料都在 repo 里。
以下实验中 codex 模型版本均为 gpt-5.4,最新版本模型尚未测试。以下实验报告均由 codex 自行攥写。
### A.1 实验过程简述
一开始我直接问 Codex:“写一个能解决 Breakout 的策略。”效果一般。低分没有解释力:它不知道是动作语义错了、状态检测错了、评测设置错了,还是策略结构本身不行。后来我把任务改成另一种形式:别只交一个 `policy.py`,要维护完整闭环。
闭环大概长这样:
```text
探测动作和观测
-> 写状态检测器
-> 写策略
-> 跑完整回合
-> 记录 trials.jsonl 和 summary.csv
-> 生成视频或曲线
-> 看失败模式
-> 改策略
-> 简化代码并做回归
```
到这里,任务的形状已经变了。最后产出的东西从一个策略文件,变成了一套还能继续改的实验系统。它有探测器,有记录,有回放,有失败模式,也有下一轮该怎么改的线索。
#### Breakout
相关 artifact:[heuristic_breakout.py]、[heuristic_breakout_trials.jsonl]、[heuristic_breakout_trials_summary.csv]。
Breakout 表面上是几何问题:球在哪里,挡板在哪里,球撞墙以后会落到哪里。麻烦在后半段。策略可以一直接到球,却不再打到新砖,分数卡在一个稳定循环里。
Codex 第一轮先确认动作空间和观测形状,再从 RGB 画面里找挡板、球、砖块颜色,然后用这些图像标签去扫 128 个 RAM 字节。早期实验记录大概是这样:
```text
trial_name score cumulative_env_steps note
shape_action_probe - 32 inspect obs/info/action
ram_byte_corr_probe_v1 - 5,032 correlate RAM bytes
ram_fit_action_probe_v2 - 9,532 action 2=right, 3=left
baseline_v0 99 16,303 initial RAM intercept
tunnel0_v1 387 43,303 no tunnel offset
```
`387` 是第一个很容易骗过人的局部高分。策略已经能稳定接球,但它把球送进了一个周期:不会死,也不会继续清砖。人手写到这里,很容易继续调“接球精度”。Codex 看了视频和最后几十步轨迹后,把问题定位到球路缺少扰动。
视频 artifact:[heuristic_breakout_score387_tunnel0_render210x160.mp4]。
第一个有效机制是打破循环:如果连续很久没有奖励,就在预测落点上周期性加偏移,把球从局部循环里打出去。这一改把分数从 `387` 推到 `507`。
```python
if steps_since_reward >= stuck_trigger_steps:
phase = stuck_offset_index % 4
if phase == 0:
offset = +stuck_offset_px
elif phase == 1:
offset = -stuck_offset_px
elif phase == 2:
offset = +0.5 * stuck_offset_px
else:
offset = -0.5 * stuck_offset_px
else:
offset = 0.0
```
视频 artifact:[heuristic_breakout_score507_stuckbreaker_render210x160.mp4]。
后来又遇到另一个失败模式:高速低位球如果按普通截距追,挡板会被过度前视带偏。Codex 加了 `fast_low_ball_lead_steps=3`,分数从 `507` 跳到 `839`。
```python
if vy > 0.1 and ball_y <= paddle_y:
steps_to_paddle = max((paddle_y - ball_y) / vy, 0.0)
intercept_x = reflect_position(ball_x + vx * steps_to_paddle)
target_x = intercept_x + stuck_offset
elif vy >= fast_ball_min_vy:
target_x = ball_x + fast_low_ball_lead_steps * vx
else:
target_x = ball_x + chase_lead_steps * vx
```
视频 artifact:[heuristic_breakout_score839_fastlead_render210x160.mp4]。
从 `839` 到 `864`,更像是在照料一个已经变复杂的系统。Codex 试了死区、发球偏移、卡住偏移、砖块平衡偏置、前视步数,很多方向都没用。最后起作用的是一个后期条件:分数超过第一面墙以后,卡住偏移只在离挡板还远的时候生效;快接球时把偏移逐步收掉,不然最后几块砖阶段会把挡板带偏。同时它加了一个很小的挡板漂移补偿,用来补动作和挡板位置之间的一步延迟。
```python
if score >= 432 and stuck_release_horizon_steps > 0:
release_ratio = clip(steps_to_paddle / stuck_release_horizon_steps, 0.0, 1.0)
offset *= release_ratio
if score >= 432 and ball_y >= 170 and last_action == RIGHT:
control_paddle_x = paddle_x + 2.0
elif score >= 432 and ball_y >= 170 and last_action == LEFT:
control_paddle_x = paddle_x - 2.0
```
视频 artifact:[heuristic_breakout_ci3985ae2_score864_render210x160.mp4]。
最终 RAM 默认配置三局验证是 `864 / 864 / 864`。后面 Codex 又把同一套几何控制迁移回纯图像输入:不用 RAM,只用 RGB 分割找挡板、球和砖块平衡。纯图像版本先是 `310`,然后 `428`,最后把后期“卡住偏移逐步收掉”的阈值放低到全程生效,7 个策略本地回合后第一次到 `864`,对应 `14,504` 个策略本地环境步。
[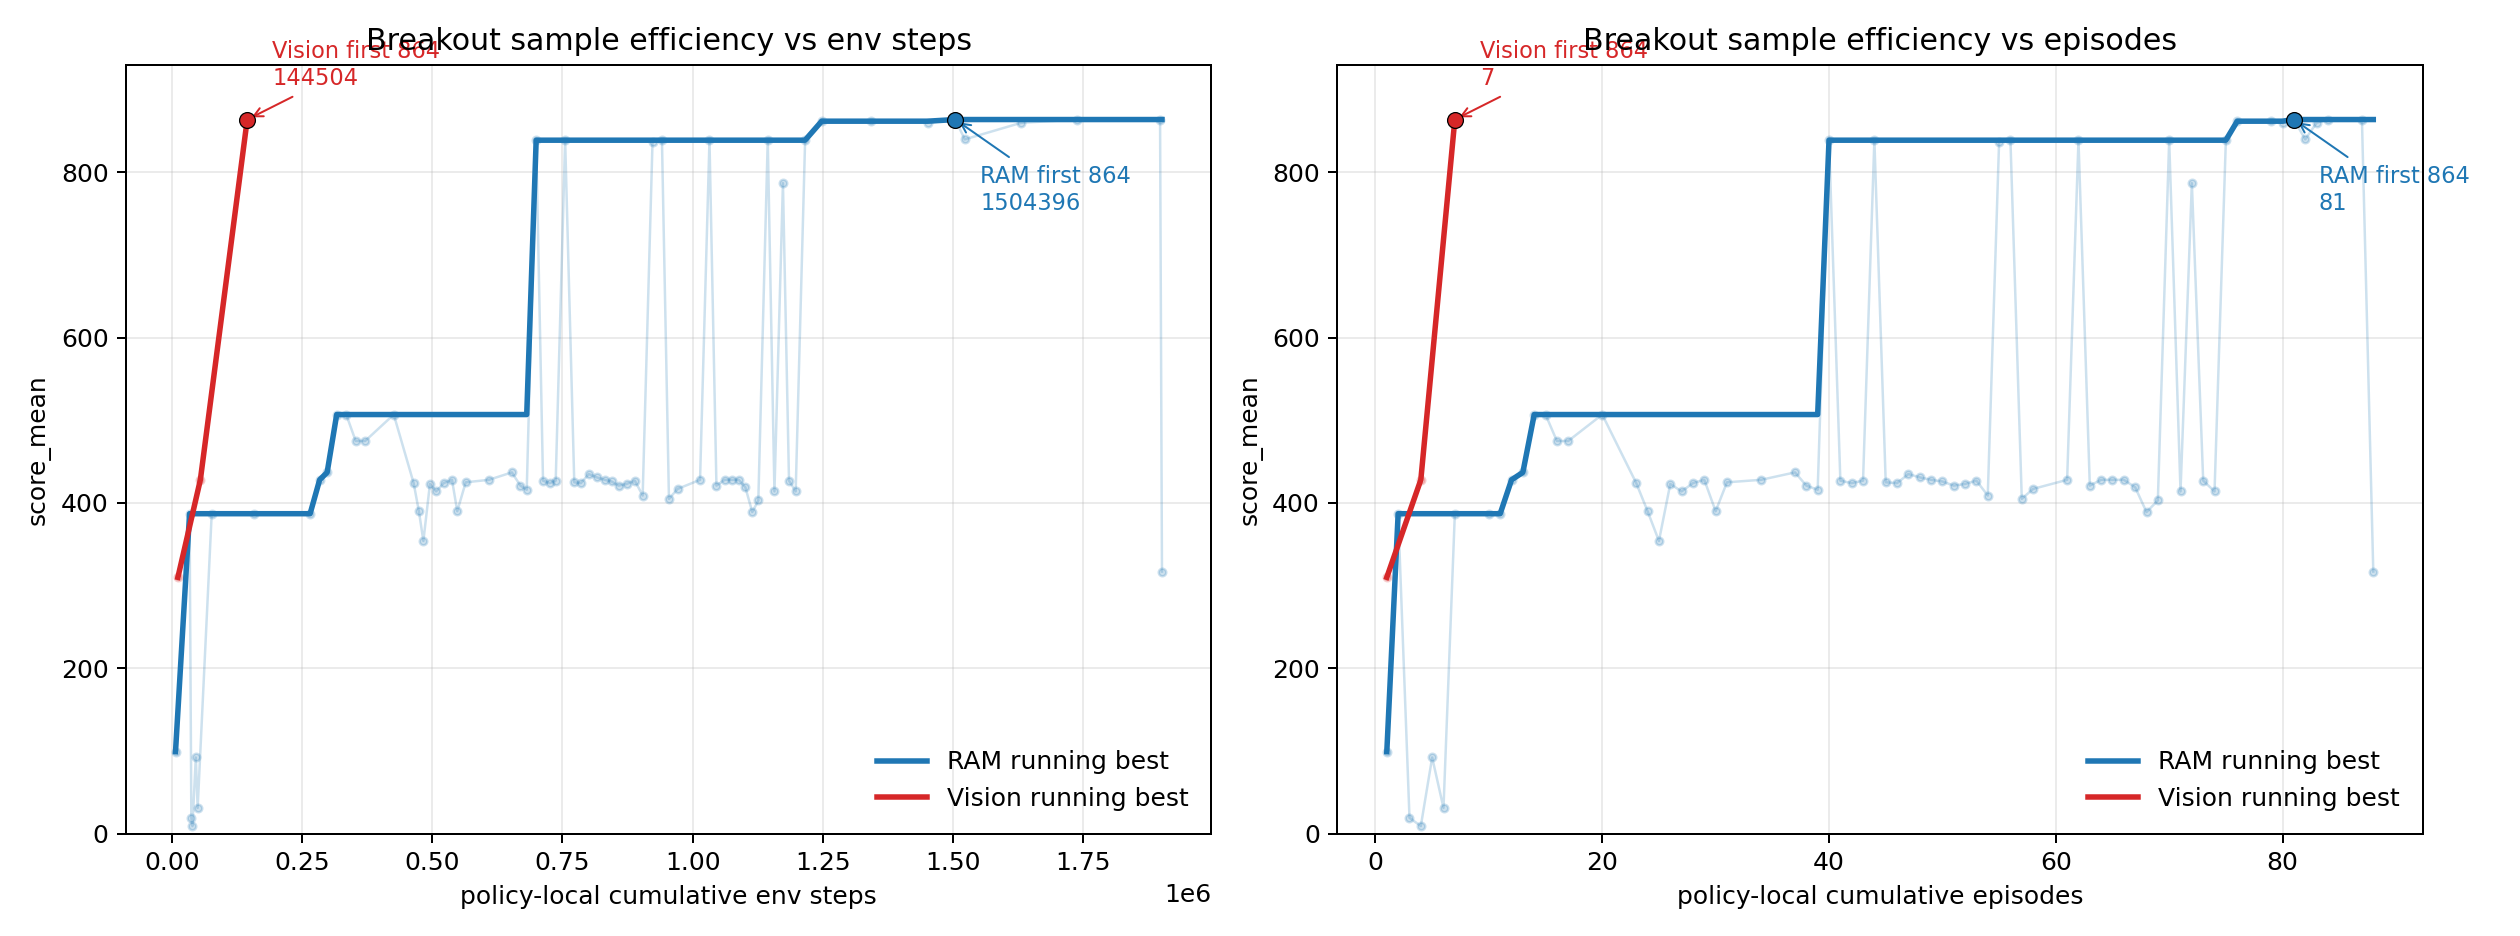][heuristic_breakout_sample_efficiency.png]
这里不能写成“纯图像从零 14.5K 步到满分”。真实过程是:Codex 先在 RAM 版本里摸出了几何控制、打破循环、后期收偏移这些结构;等结构稳定以后,再把状态读取层从 RAM 换成 RGB 检测器。纯图像的 `14.5K` 是迁移预算。
#### Ant 和 HalfCheetah
相关 artifact:[heuristic_ant.py]、[ant_envpool.xml]、[heuristic_ant_trials.jsonl]、[heuristic_ant_trials_summary.csv]、[heuristic_halfcheetah_v5.py]、[heuristic_halfcheetah_v5_log.md]。
Ant 的信号和 Breakout 不一样。Breakout 的几何结构很直观;Ant 是连续控制,动作是 8 个关节,失败模式也从“球没接到”变成了身体动力学问题。
我没有一开始就指定“用 CPG”或“用 MPC”。要求只有几条:别训练神经网络,能本地复现,每轮实验留下记录,继续把分数往上推。Codex 先读 EnvPool/Gymnasium 的 Ant 观测和回报,确认动作顺序、根部速度、躯干朝向、关节位置和关节速度,然后自己提出第一版节律步态。
第一版是四腿相位振荡器:左右腿反相,髋关节和踝关节跟踪正弦目标角,动作由 PD 控制器给出。它不优雅,但一上来就比随机强很多,5 个随机种子的平均分是 `2291`。
```python
leg_phase = warp_phase(phase + LEG_PHASE, stance_duty(vx))
stance = leg_phase < pi
hip_wave = HIP_BIAS + stance_or_swing_scale * (
HIP_AMP * sin(leg_phase)
+ HIP_H2_AMP * sin(2 * leg_phase + HIP_H2_PHASE)
+ HIP_H3_AMP * sin(3 * leg_phase + HIP_H3_PHASE)
)
action[0::2] = KP * (
HIP_SIGN * hip_wave
+ HEADING_AXIS * (YAW_GAIN * yaw + YAW_RATE_GAIN * yaw_rate)
- q[0::2]
)
action[1::2] = KP * (ANKLE_SIGN * (ankle_wave + balance) - q[1::2])
```
后面的早期迭代很像调一个真实控制器:先加偏航反馈到 `2718`,再调相位速度、髋/踝幅度、偏航角速度增益到 `3025`,然后加二阶/三阶谐波到 `3162`。Codex 也试过大范围参数搜索,但结果没有稳定超过当前节律策略,于是停止扩大搜索预算,转向另一种表示。
跃迁来自 residual MPC。粗略讲,MPC 是“边走边想一小段未来”:保留节律步态作为基础反射,每个真实环境步在本地 MuJoCo 模型里采样几十条小的残差动作序列,打分后只执行第一个残差动作;下一步重新看状态、重新规划,并把上一轮没执行完的计划作为热启动。
这样每一步都不用从零规划 8 个关节怎么动。策略先有一个稳定步态,再用短视窗模型规划去修正它。
```python
base = cpg_action(phase, q, dq, roll, pitch, yaw, rates, contacts, vx)
best_plan = previous_plan.copy()
best_obj = rollout_objective(obs, best_plan)
for _ in range(CANDIDATES - 1):
residuals = clip(
best_plan + rng.normal(0.0, MPC_SIGMA, size=(HORIZON, 8)),
-MPC_CLIP,
MPC_CLIP,
)
residuals[1:] = 0.6 * residuals[1:] + 0.4 * residuals[:-1]
obj = rollout_objective(obs, residuals)
if obj > best_obj:
best_obj = obj
best_plan = residuals
plan[:-1] = PLAN_DECAY * best_plan[1:]
return clip(base + best_plan[0], -1.0, 1.0)
```
```text
trial_name score_mean cumulative_env_steps note
ant_lr_cpgpd_v1 2291.9 5,000 左右腿反相 CPG + PD
ant_yawaxis_grid_v2 2857.9 20,000 偏航反馈 + 重调参数
ant_h3_428_v1 3162.0 50,000 二阶/三阶谐波
ant_mpc_residual_v1_ep1 3635.5 62,000 视窗=6,候选=32
ant_mpc_residual_cfg4_eval5 3964.7 67,000 视窗=8,候选=48
ant_mpc_residual_cand07_eval5 4647.1 73,000 围绕 MPC 配置做局部搜索
ant_mpc_residual_narrow04_eval5 4871.3 79,000 降低 z 目标,增大 kp/候选数
ant_mpc_residual_warm02_eval5 5165.2 85,000 热启动残差计划
ant_mpc_fast065x060_sigma008_clip012 5759.4 95,000 更快步态 + 更大残差
ant_mpc_term001_ep1 6054.5 100,000 终端速度代价
ant_mpc_default_adaptive_ep1 6146.2 106,300 速度自适应相位 + 支撑期
```
到最后,策略里有振荡器相位、支撑期比例、速度自适应、滚转/俯仰/偏航反馈、脚部接触、短视窗模型内展开、残差平滑、终端速度代价、热启动计划衰减。人类当然能写其中一两个模块,但要在短时间内同时照顾实验记录、代码、视频和失败方向,难度完全不同。
[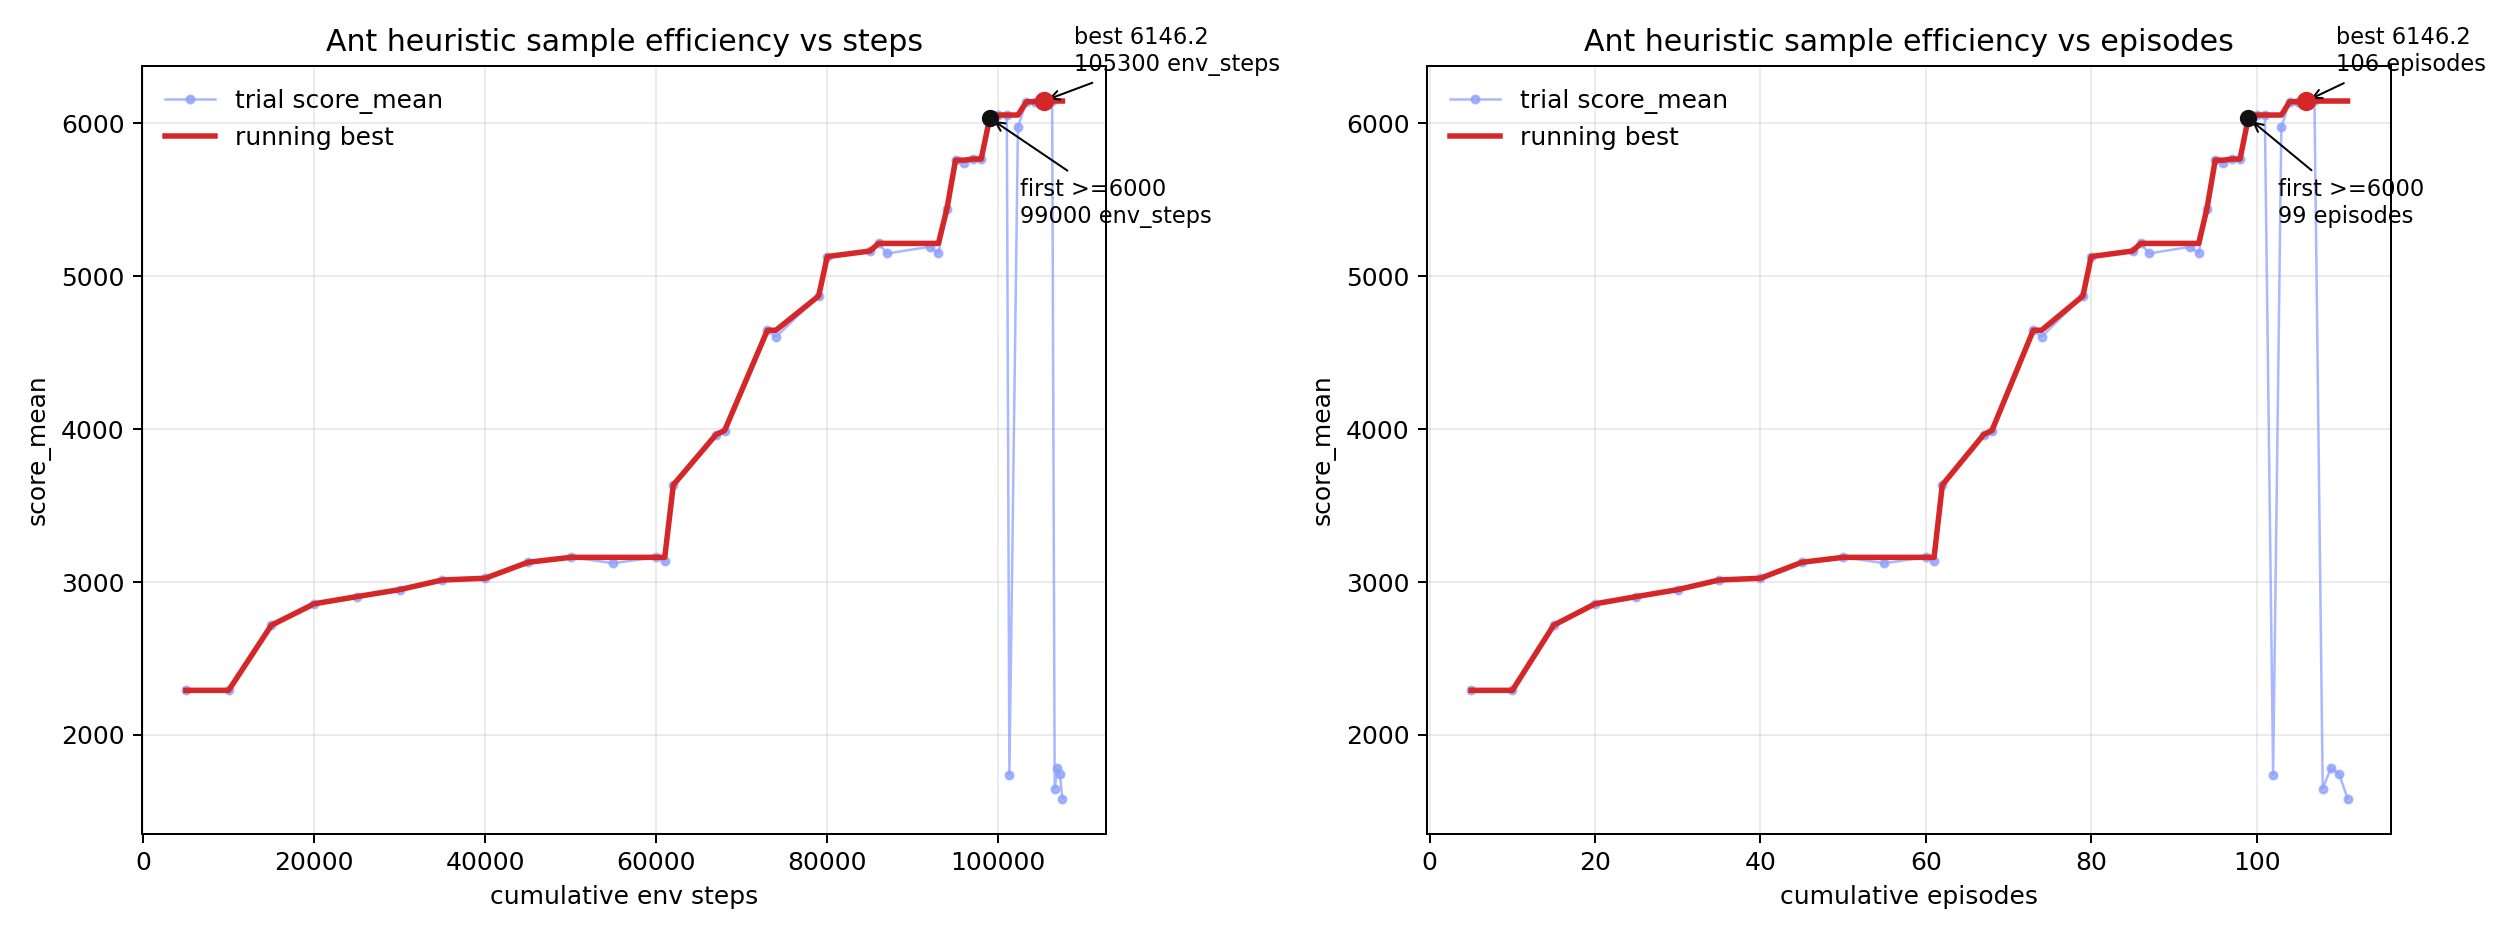][heuristic_ant_sample_efficiency.png]
视频 artifact:[heuristic_ant_mpc_default_6146_render480.mp4]。
HalfCheetah 是同一类证据的另一个点。我重新跑了 `mpc-staged-tree-asym-pd-cpg` 的 5 局复测,seeds `100..104` 的结果是均值 `11836.7`、最小值 `11735.0`、最大值 `12041.2`。策略靠的是可解释的步态/姿态规则和在线 staged-tree MPC:先用 CPG/PD 形成高分步态,再用短视窗模型评分和 staged swing-amplitude schedule 修正动作。
[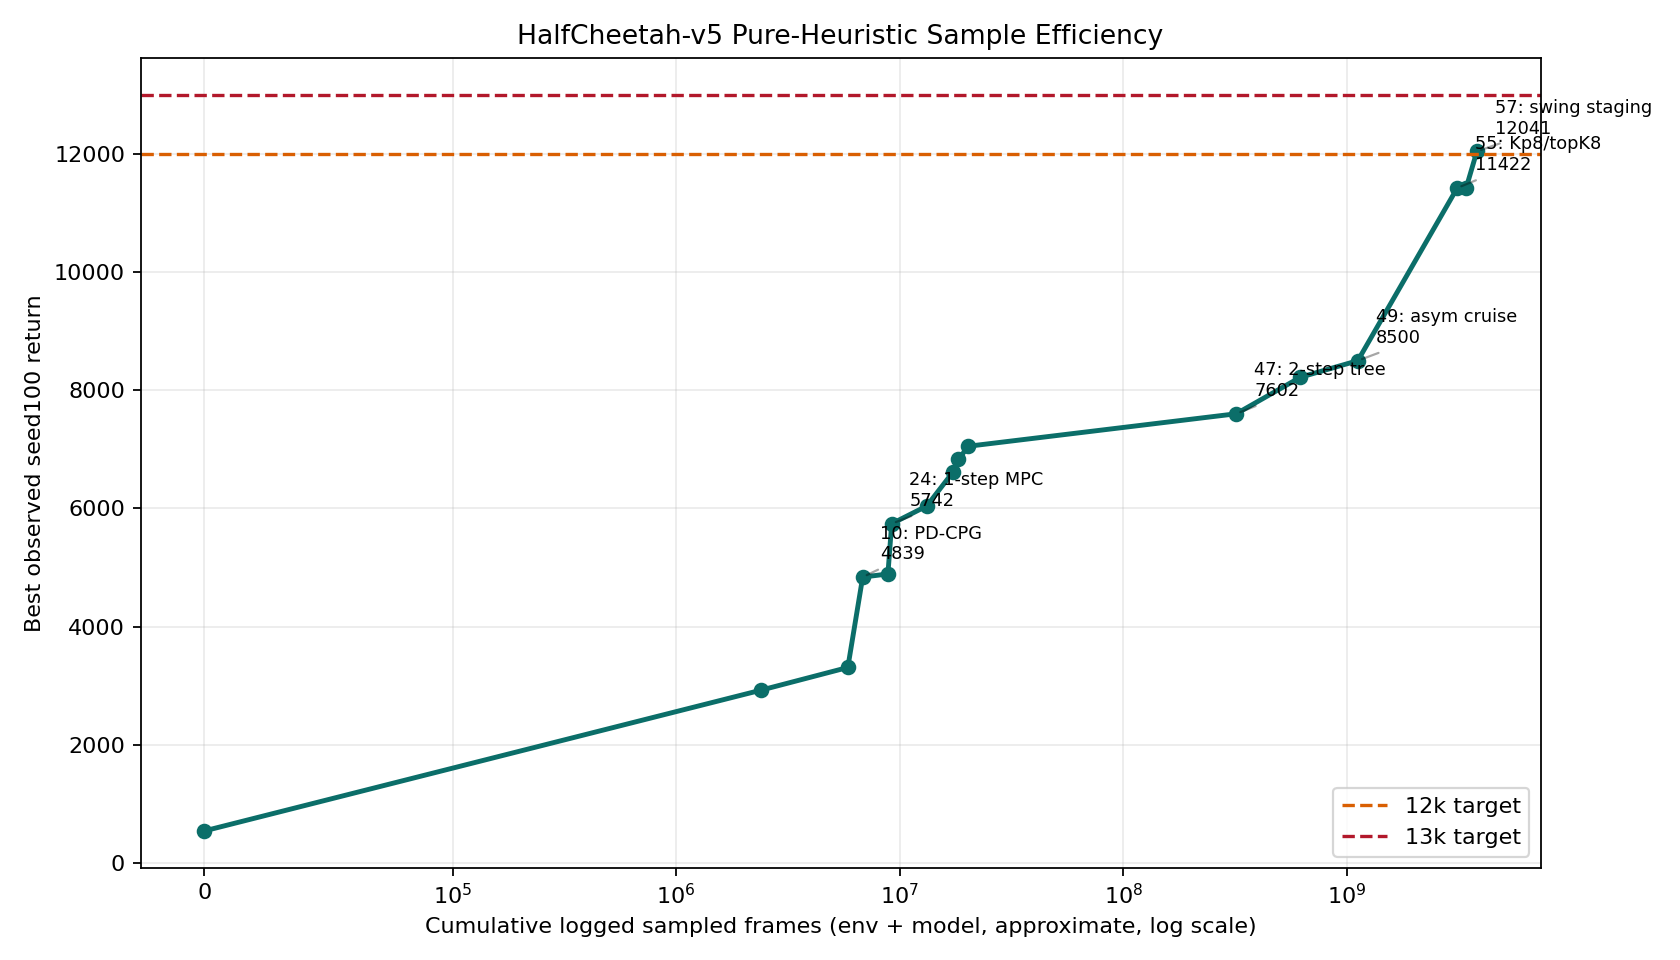][heuristic_halfcheetah_sample_efficiency.png]
#### VizDoom
相关 artifact:[heuristic_vizdoom_d1_cv.py]、[heuristic_vizdoom_d3_cv.py]、[record_vizdoom_d3_cv.py]、[d1_cv_10seed_render_35fps.mp4]、[d3_cv_best_10seed_render_35fps.mp4]。
D1 Basic 是先验证“只要能等到合适时机吃血包,reward 就接近上限”的小实验。我先用 object/info 版本确认行为上限,10 seeds 接近 `1.01`;然后把不可复现的信息删掉,只保留 pip EnvPool、`render()` 屏幕像素和公开的 `HEALTH`。最终纯 CV 版用亮度阈值、形态学 close/dilate 和连通域找 medikit,用 bbox 中心决定转向/前进;血量还高且离血包太近时先 staging,等掉血后再吃。10 seeds 是 `mean=0.9441`、`min=0.2900`。
视频 artifact:[d1_cv_10seed_render_35fps.mp4]。
D3 Battle 更接近 FPS smoke policy:它不是背地图,而是把行为拆成三个闭环:看见怪就杀、低血/低弹时找补给、长时间没目标时高速探索。屏幕侧用 cv2/NumPy 做颜色阈值和连通域,提取 enemy candidate、ammo/health item candidate、墙面/洞口的暗区比例;EnvPool info 只用公开 game variables,比如 `HEALTH`、`AMMO2`、`HITCOUNT`、`DAMAGECOUNT`、`KILLCOUNT`。迭代方式是每次并行跑 10 个 seed,再直接用 `render()` 录 35fps 10-grid 视频看失败类型。早期试过地图、object info 和 seed 特判,后面都删掉了;保留下来的是屏幕 CV + 公开变量的闭环控制。10 seeds 是 `mean=557.0`、`min=440.0`。
视频 artifact:[d3_cv_best_10seed_render_35fps.mp4]。
#### Atari57
相关 artifact:[atari57_prompt_template.txt]、[atari57_aggregate_curve_steps.csv]、[atari57_env_mode_summary.csv]、[openrl_atari57_per_game_hns_comparison.csv]、[atari57_hns_normalization_inferred.csv]。
Breakout 和 Ant 都是单点故事。Atari57 想看的,是这套工作流离开单个漂亮案例以后还剩多少。做法很直接:把同一套 Codex 流程扔到整套 Atari57 上,每个环境同时跑 `ram` 和 `native_obs` 两种输入,每种输入跑 3 个独立重复。总共是:
```text
57 个游戏 x 2 种输入 x 3 次运行 = 342 条 coding-agent 搜索轨迹
```
这组实验没有人在旁边一点点提示。每个 agent 拿到同一个模板和不同的 `ENV_ID / OBS_MODE / REPEAT_INDEX`,然后自己执行到停止。每个 run 都要写 `policy.py`、`trials.jsonl`、`summary.csv`、`sample_efficiency.png` 和 `README.md`。
完整提示词放在 [atari57_prompt_template.txt]。核心摘要是:
Atari57 批量提示词摘要
```text
目标:只针对一个 EnvPool Atari 环境,在给定 OBS_MODE 下自己设计并迭代手写 heuristic policy。
模型运行方式:不要请求确认,不要输出中途汇报,直到满足停止规则后再总结。
硬约束:
- 不训练神经网络。
- 不读环境源码、测试、ROM 细节或隐藏状态。
- native_obs 模式只能用 reset/step 返回的原生 obs。
- ram 模式可以用 info["ram"]。
- Atari 初始化参数固定,包括 frame_skip=1、reward_clip=False、sticky action=0。
- 所有实际 step 过环境的 probe/debug/trial 都必须计入 cumulative_env_steps。
输出文件:
- policy.py:当前最好且尽量简化的 heuristic。
- trials.jsonl:每次 trial 的分数、环境步、配置、备注。
- summary.csv:从 trials 汇总。
- sample_efficiency.png:按环境步和 episode 画分数曲线。
- README.md:最好分数、复现命令、失败方向、停止原因。
停止规则:
- Atari frame budget = 20,000,000。
- budget 前不要因为平台期或已经超过参考分数就停止。
- 每次刷新 best score 后要进入代码简化阶段,确认不掉分再保留。
```
先看环境步曲线。HNS 是 human-normalized score,也就是把每个游戏分数按人类基线归一化以后再比较。在完全无人工介入的批量运行里,`native_obs` 到 `1M` 步附近的 Atari median HNS 已经到 `0.32`,`ram` 是 `0.26`,明显高于图里 PPO2 / CleanRL EnvPool PPO 的早期曲线;到 `9.7M` 步附近,`native_obs` 是 `0.81`,`ram` 是 `0.59`。同一张对比里,OpenRL Benchmark 保存的 PPO2 / CleanRL EnvPool PPO median HNS 曲线到 `10M` 步大约是 `0.88 / 0.92`。
[][atari57_openrl_sample_efficiency_context.png]
这里比较的是环境交互效率;coding agent 读日志、写代码和看视频的开销没有折算进总计算成本。它给出的信号很具体:一个还很粗糙的 coding agent 批量流程,在完全不看中途结果的情况下,已经能把 Atari57 的中位数推进到接近这些 baseline 的区间。
如果换成每个游戏最终取 best input 的汇总口径,Codex median HNS 是 `0.83`,OpenAI Baselines PPO2 是 `0.80`,CleanRL EnvPool PPO 是 `0.98`;如果再放宽到 best single run,Codex median HNS 是 `1.18`。这个口径不能替代严格训练曲线比较,但能更直接地说明这批无人值守搜索最后覆盖到了什么水平。
聚合曲线会把差异压到一个中位数里,所以我又看了每个游戏自己的 HNS。Breakout、Krull、DoubleDunk、Boxing、DemonAttack 这些游戏里,heuristic 和 Deep RL baseline 都能拿到明显高于人类基线的分数;Asterix、Jamesbond、Centipede、Bowling、Skiing、Tennis 这类游戏里 heuristic 相对突出;Atlantis、VideoPinball、UpNDown、Assault、RoadRunner、StarGunner 上 PPO 明显强很多。
[][atari57_per_game_hns_comparison.png]
Atari57 最有意思的地方,是样本效率的来源变了。传统神经网络 Atari 学习要在每个环境里从高维输入重新学表示、信用分配和动作含义;Codex 做的是把环境拆成可维护的小程序系统:射击游戏的瞄准/躲避,接球游戏的反弹,躲避游戏的位置规则,环境包装器细节,以及每个环境自己的失败实验记录。
#### Montezuma
相关 artifact:[heuristic_montezuma.py]、[heuristic_montezuma_state_graph_search.py]、[heuristic_montezuma_400_policy.py]、[heuristic_montezuma_400_macros.json]、[heuristic_montezuma_400_metadata.json]。
有些环境不适合普通反应式启发式策略。Montezuma's Revenge 是典型例子。
之前那轮单独搜 Montezuma 的状态图搜索能把钥匙距离从 `72` 推到 `28`,但奖励仍然是 `0`。后面 Atari57 的纯图像批量实验里,有一条无人值守 Codex run 到了 `400.0` 分:修复后的最佳回放是 `repair_replay_r1_t19734`,seed 是 `10001`,用了 `1769` 个环境步,本质是一条 `86` 个宏动作组成的开环路线。
视频 artifact:[montezuma_400_render_seed10001_h264.mp4]。
Montezuma 暴露的是表达力问题。普通 `policy.py` 状态机很难装下这类路线:动作必须对齐时机,失败后要能恢复,中间状态还要能重新进入计划。有些环境需要可组合宏动作、可恢复搜索状态,甚至需要一种比普通 `if else` 更适合长期规划的程序结构。
这类失败对 HL 很有价值。它告诉我们边界在哪里,也提示下一层抽象大概该长什么样。有些反馈需要新的表示和新的程序形态,才进得了系统。Montezuma 指向的下一层接口,大概会包括宏动作、可恢复状态、搜索和长期记忆。
### A.2 复现入口
下面这些命令默认在本文所在目录运行,依赖已经按 `requirements.txt` 装好,用来检查前面提到的几个代表性结果。
#### Pong 21
复现入口:[heuristic_pong.py]。
```bash
python atari/pong/heuristic_pong.py \
--policy ram \
--episodes 1 \
--seed 0
```
期望输出里应该包含 `episode=0 score=21.0` 和 `mean=21.000`。
#### Breakout 中间节点
这些命令用来复现附录里 `387 -> 507 -> 839` 三个中间节点。它们不是最终策略,只是把每一步机制固定下来,方便看出分数是怎么长出来的。
复现 387 分:只接球,不打破循环
```bash
rm -f /tmp/repro_breakout_387.jsonl /tmp/repro_breakout_387.csv
python atari/breakout/heuristic_breakout.py \
--policy ram \
--episodes 1 \
--seed 0 \
--max-steps 27000 \
--deadband 3 \
--chase-lead-steps 6 \
--tunnel-offset 0 \
--launch-offset 24 \
--fast-ball-min-vy 1000000000 \
--stuck-trigger-steps 1000000000 \
--stuck-switch-steps 0 \
--stuck-offset 0 \
--stuck-release-horizon-steps 0 \
--brick-balance-bias-min-score 1000000000 \
--late-game-paddle-lag-px 0 \
--trial-name repro_breakout_387 \
--log-path /tmp/repro_breakout_387.jsonl \
--summary-path /tmp/repro_breakout_387.csv
```
期望输出里应该包含 `score=387.0` 和 `mean=387.000`。
复现 507 分:加入卡住循环扰动
```bash
rm -f /tmp/repro_breakout_507.jsonl /tmp/repro_breakout_507.csv
python atari/breakout/heuristic_breakout.py \
--policy ram \
--episodes 1 \
--seed 0 \
--max-steps 27000 \
--deadband 3 \
--chase-lead-steps 6 \
--tunnel-offset 0 \
--launch-offset 24 \
--fast-ball-min-vy 1000000000 \
--stuck-trigger-steps 1024 \
--stuck-switch-steps 256 \
--stuck-offset 12 \
--stuck-release-horizon-steps 0 \
--brick-balance-bias-min-score 1000000000 \
--late-game-paddle-lag-px 0 \
--trial-name repro_breakout_507 \
--log-path /tmp/repro_breakout_507.jsonl \
--summary-path /tmp/repro_breakout_507.csv
```
期望输出里应该包含 `score=507.0` 和 `mean=507.000`。
复现 839 分:处理高速低位球
```bash
rm -f /tmp/repro_breakout_839.jsonl /tmp/repro_breakout_839.csv
python atari/breakout/heuristic_breakout.py \
--policy ram \
--episodes 1 \
--seed 0 \
--max-steps 27000 \
--deadband 3 \
--chase-lead-steps 6 \
--tunnel-offset 0 \
--launch-offset 24 \
--fast-ball-min-vy 3 \
--fast-low-ball-lead-steps 3 \
--stuck-trigger-steps 1024 \
--stuck-switch-steps 256 \
--stuck-offset 12 \
--stuck-release-horizon-steps 0 \
--brick-balance-bias-min-score 1000000000 \
--late-game-paddle-lag-px 0 \
--trial-name repro_breakout_839 \
--log-path /tmp/repro_breakout_839.jsonl \
--summary-path /tmp/repro_breakout_839.csv
```
期望输出里应该包含 `score=839.0` 和 `mean=839.000`。
#### Breakout 864
复现入口:[heuristic_breakout.py]。
```bash
rm -f /tmp/repro_breakout_864.jsonl /tmp/repro_breakout_864.csv
python atari/breakout/heuristic_breakout.py \
--policy ram \
--episodes 1 \
--seed 0 \
--max-steps 108000 \
--deadband 3 \
--chase-lead-steps 6 \
--tunnel-offset 0 \
--launch-offset 24 \
--fast-ball-min-vy 3 \
--fast-low-ball-lead-steps 3 \
--stuck-trigger-steps 1024 \
--stuck-switch-steps 256 \
--stuck-offset 12 \
--stuck-release-horizon-steps 8 \
--brick-balance-deadzone 0.01 \
--brick-balance-bias-min-score 432 \
--late-game-paddle-lag-px 2 \
--late-game-lag-ball-y 170 \
--trial-name repro_breakout_864 \
--log-path /tmp/repro_breakout_864.jsonl \
--summary-path /tmp/repro_breakout_864.csv
```
期望输出里应该包含 `score=864.0` 和 `mean=864.000`。
#### Ant 默认 MPC 策略
复现入口:[heuristic_ant.py]、[ant_envpool.xml]。
```bash
rm -f /tmp/repro_ant_6146_eval5.jsonl /tmp/repro_ant_6146_eval5.csv
python mujoco/ant/heuristic_ant.py \
--policy mpc \
--episodes 5 \
--seed 0 \
--max-steps 1000 \
--mujoco-xml-path mujoco/ant/ant_envpool.xml \
--trial-name repro_ant_6146_eval5 \
--log-path /tmp/repro_ant_6146_eval5.jsonl \
--summary-path /tmp/repro_ant_6146_eval5.csv
```
我本地重跑时是 `mean=6005.521`、`min=5776.805`、`max=6146.208`。
#### HalfCheetah staged-tree MPC
复现入口:[heuristic_halfcheetah_v5.py]。
```bash
python mujoco/halfcheetah/heuristic_halfcheetah_v5.py \
--policy mpc-staged-tree-asym-pd-cpg \
--eval-episodes 5 \
--eval-seed 100
```
我本地重跑时 5 局均值是 `11836.693`。
#### VizDoom D1 Basic CV 策略
复现入口:[heuristic_vizdoom_d1_cv.py]。
```bash
python vizdoom/heuristic_vizdoom_d1_cv.py --episodes 10 --seed 0
```
我本地重跑时是 `mean=0.9440999741666019`、`min=0.28999998047947884`。这个版本只依赖 pip 的 EnvPool;不需要 `vizdoom` Python 包,也不需要任何本地编译扩展。
要重新生成 35fps 视频:
```bash
python vizdoom/heuristic_vizdoom_d1_cv.py \
--episodes 10 \
--seed 0 \
--record-mp4 vizdoom/d1_cv_10seed_render_35fps.mp4
```
#### VizDoom D3 Battle CV 策略
复现入口:[heuristic_vizdoom_d3_cv.py]、[record_vizdoom_d3_cv.py]。
```bash
python vizdoom/heuristic_vizdoom_d3_cv.py
```
我本地重跑时是 `mean=557.0`、`min=440.0`,10 个 seed 的奖励是 `[545, 475, 480, 440, 690, 500, 600, 595, 530, 715]`。
要重新生成 35fps 视频:
```bash
python vizdoom/record_vizdoom_d3_cv.py
```
#### Montezuma 400 分回放
复现入口:[heuristic_montezuma_400_policy.py]。
```bash
python atari/montezuma/heuristic_montezuma_400_policy.py \
--metadata-out /tmp/repro_montezuma_400.json
```
期望输出里应该包含 `"score": 400.0` 和 `"env_steps": 1769`。这条是边界案例,不要把它理解成通用 Montezuma 策略。
## 评论
[heuristic_breakout.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/breakout/heuristic_breakout.py
[heuristic_breakout_trials.jsonl]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/breakout/heuristic_breakout_trials.jsonl
[heuristic_breakout_trials_summary.csv]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/breakout/heuristic_breakout_trials_summary.csv
[heuristic_breakout_score387_tunnel0_render210x160.mp4]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/breakout/heuristic_breakout_score387_tunnel0_render210x160.mp4
[heuristic_breakout_score507_stuckbreaker_render210x160.mp4]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/breakout/heuristic_breakout_score507_stuckbreaker_render210x160.mp4
[heuristic_breakout_score839_fastlead_render210x160.mp4]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/breakout/heuristic_breakout_score839_fastlead_render210x160.mp4
[heuristic_breakout_ci3985ae2_score864_render210x160.mp4]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/breakout/heuristic_breakout_ci3985ae2_score864_render210x160.mp4
[heuristic_breakout_sample_efficiency.png]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/breakout/heuristic_breakout_sample_efficiency.png
[heuristic_ant.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/ant/heuristic_ant.py
[ant_envpool.xml]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/ant/ant_envpool.xml
[heuristic_ant_trials.jsonl]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/ant/heuristic_ant_trials.jsonl
[heuristic_ant_trials_summary.csv]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/ant/heuristic_ant_trials_summary.csv
[heuristic_ant_sample_efficiency.png]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/ant/heuristic_ant_sample_efficiency.png
[heuristic_ant_mpc_default_6146_render480.mp4]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/ant/heuristic_ant_mpc_default_6146_render480.mp4
[heuristic_halfcheetah_v5.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/halfcheetah/heuristic_halfcheetah_v5.py
[heuristic_halfcheetah_v5_log.md]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/halfcheetah/heuristic_halfcheetah_v5_log.md
[heuristic_halfcheetah_sample_efficiency.png]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/mujoco/halfcheetah/heuristic_halfcheetah_sample_efficiency.png
[heuristic_vizdoom_d3_cv.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/vizdoom/heuristic_vizdoom_d3_cv.py
[record_vizdoom_d3_cv.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/vizdoom/record_vizdoom_d3_cv.py
[heuristic_vizdoom_d1_cv.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/vizdoom/heuristic_vizdoom_d1_cv.py
[d3_cv_best_10seed_render_35fps.mp4]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/vizdoom/d3_cv_best_10seed_render_35fps.mp4
[d1_cv_10seed_render_35fps.mp4]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/vizdoom/d1_cv_10seed_render_35fps.mp4
[atari57_prompt_template.txt]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/atari57/atari57_prompt_template.txt
[atari57_aggregate_curve_steps.csv]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/atari57/atari57_aggregate_curve_steps.csv
[atari57_env_mode_summary.csv]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/atari57/atari57_env_mode_summary.csv
[openrl_atari57_per_game_hns_comparison.csv]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/atari57/openrl_atari57_per_game_hns_comparison.csv
[atari57_hns_normalization_inferred.csv]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/atari57/atari57_hns_normalization_inferred.csv
[atari57_openrl_sample_efficiency_context.png]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/atari57/atari57_openrl_sample_efficiency_context.png
[atari57_per_game_hns_comparison.png]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/atari57/atari57_per_game_hns_comparison.png
[heuristic_montezuma.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/montezuma/heuristic_montezuma.py
[heuristic_montezuma_state_graph_search.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/montezuma/heuristic_montezuma_state_graph_search.py
[heuristic_montezuma_400_policy.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/montezuma/heuristic_montezuma_400_policy.py
[heuristic_montezuma_400_macros.json]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/montezuma/heuristic_montezuma_400_macros.json
[heuristic_montezuma_400_metadata.json]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/montezuma/heuristic_montezuma_400_metadata.json
[montezuma_400_render_seed10001_h264.mp4]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/montezuma/montezuma_400_render_seed10001_h264.mp4
[heuristic_pong.py]: https://github.com/Trinkle23897/learning-beyond-gradients/blob/main/atari/pong/heuristic_pong.py