# Baichuan-M3-235B
[](https://opensource.org/licenses/Apache-2.0)
[](https://huggingface.co/baichuan-inc/Baichuan-M3-235B)
[](https://huggingface.co/baichuan-inc/Baichuan-M3-235B-GPTQ-INT4)
[](https://www.baichuan-ai.com/blog/baichuan-M3)
[](https://arxiv.org/pdf/2602.06570)
中文 |
English
**从问诊到决策,构建可信赖的医疗 AI**
🏥 即刻体验AI严肃问诊:[ying.ai](https://ying.ai/)
## 🌟 模型简介
**Baichuan-M3** 是百川智能推出的新一代医疗增强大语言模型,继 [Baichuan-M2](https://github.com/baichuan-inc/Baichuan-M2-32B) 之后的又一重要里程碑。
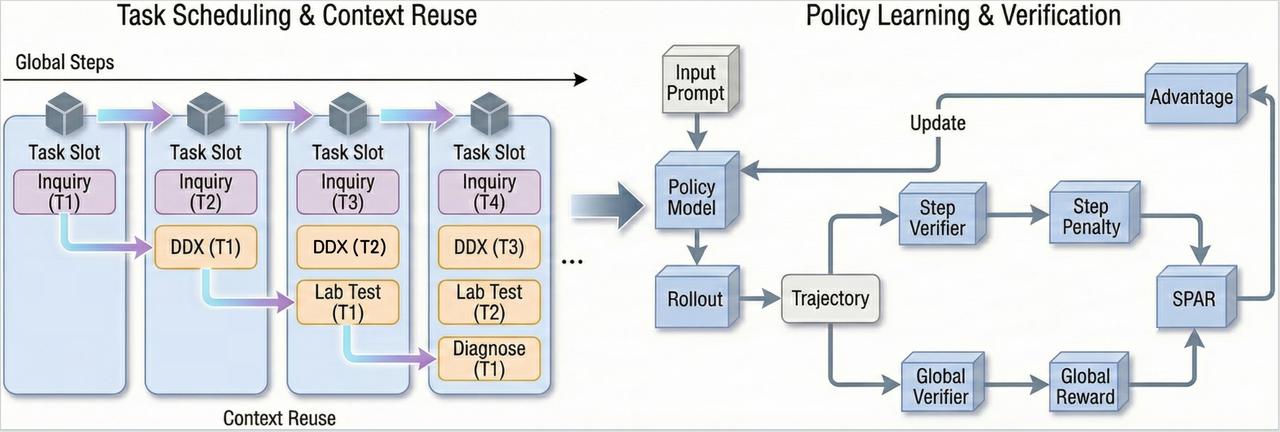
不同于以静态问答或角色扮演为中心的传统范式,Baichuan-M3 以**临床决策过程建模**为核心训练目标,系统性地提升模型在真实医疗场景中的可用性与可靠性。模型不再仅被要求"给出一个看似合理的答案"或"建议您尽快去就诊"这类高频模糊建议,而是被训练为具备**主动收集关键信息**、**构建医学推理路径**、**动态抑制幻觉**的原生医疗增强能力。
### 核心亮点
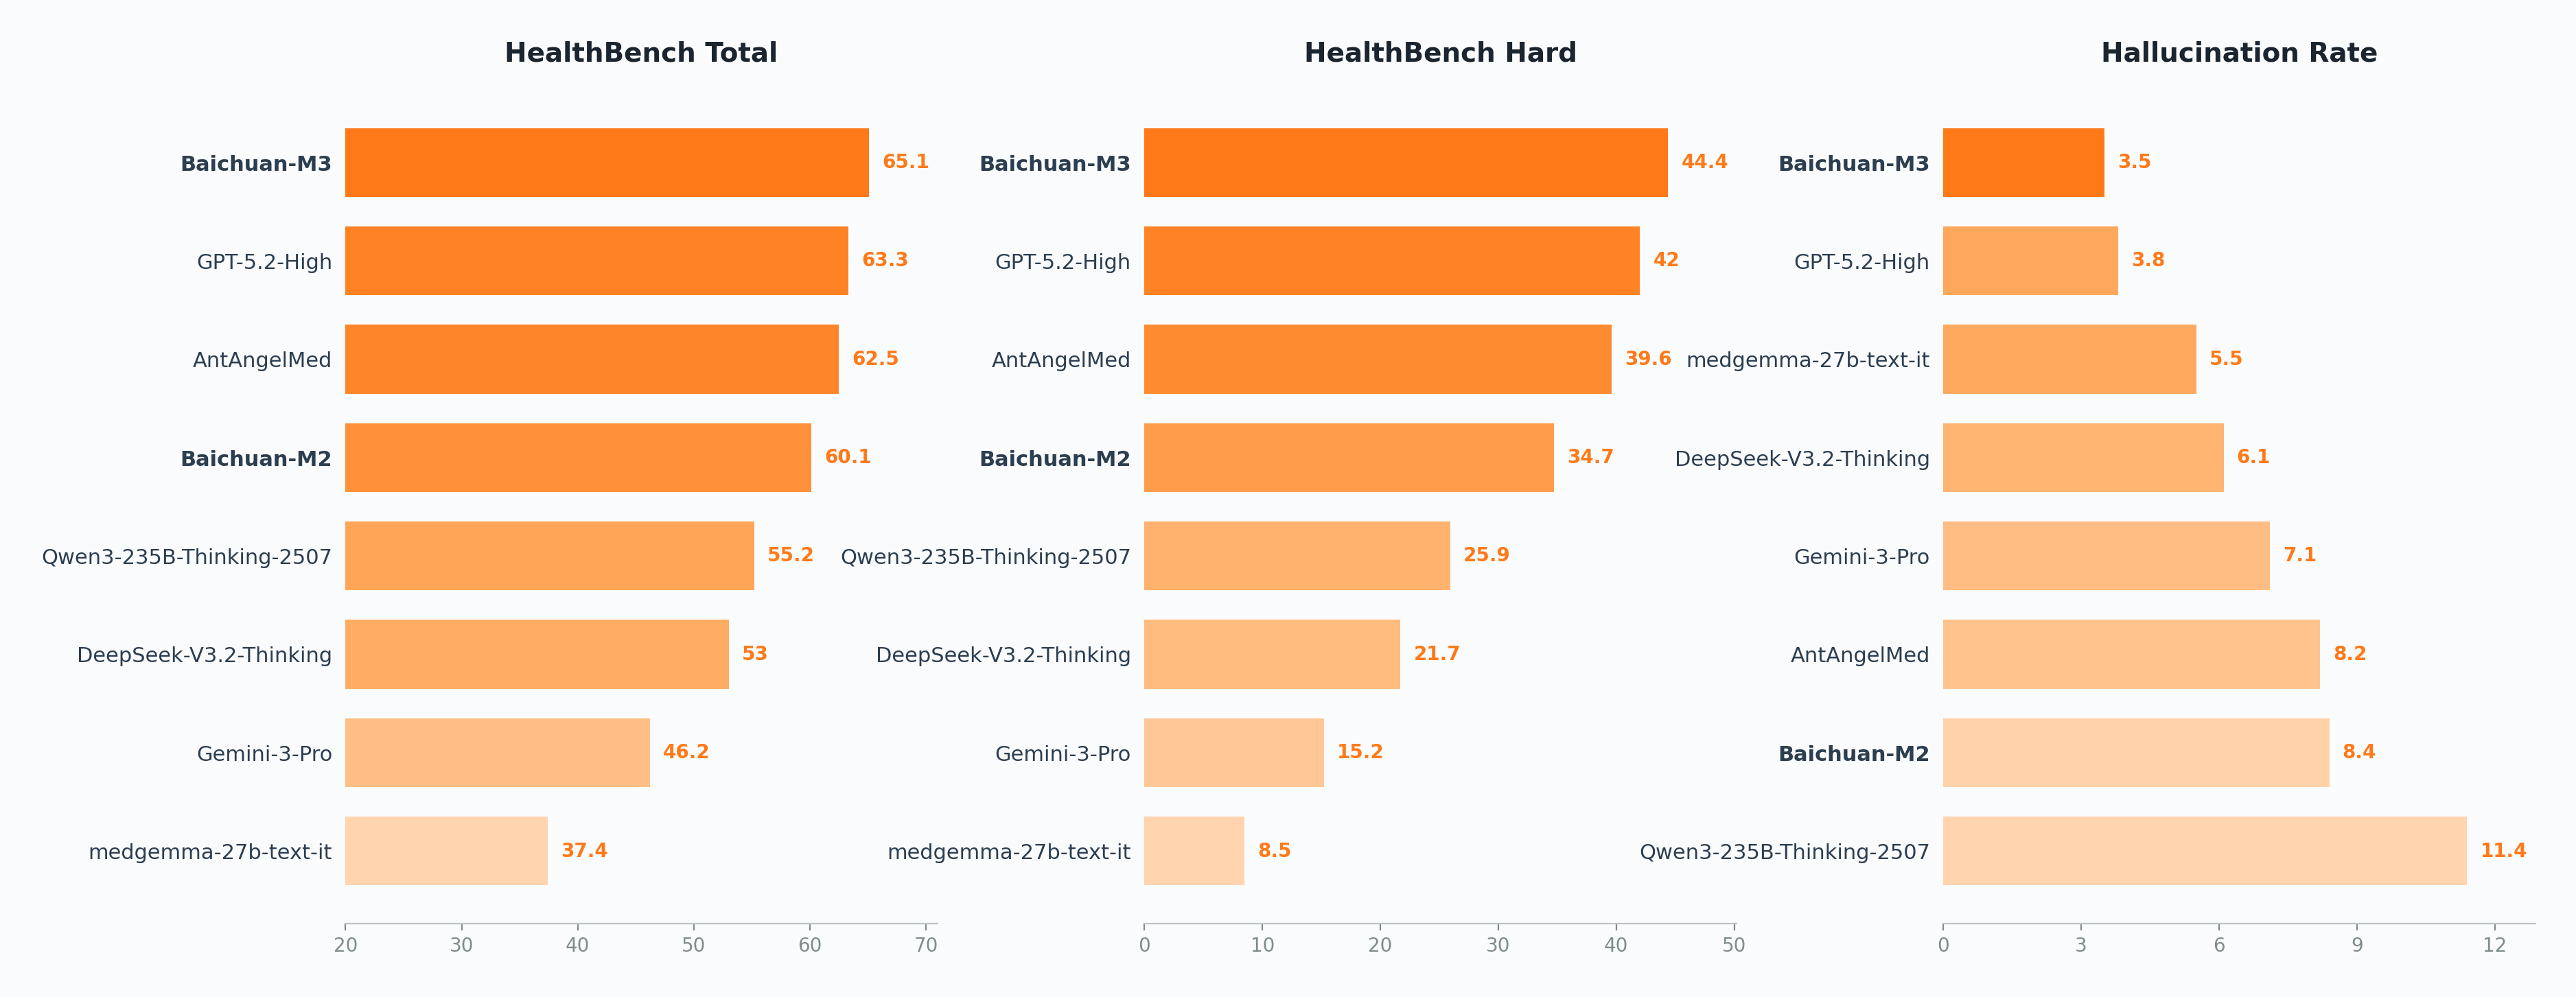
- 🏆 **超越 GPT-5.2**:在 HealthBench、HealthBench-Hard、幻觉评测及 SCAN-bench 评测中全面超越 OpenAI 最新模型,成为全球最强医疗增强模型
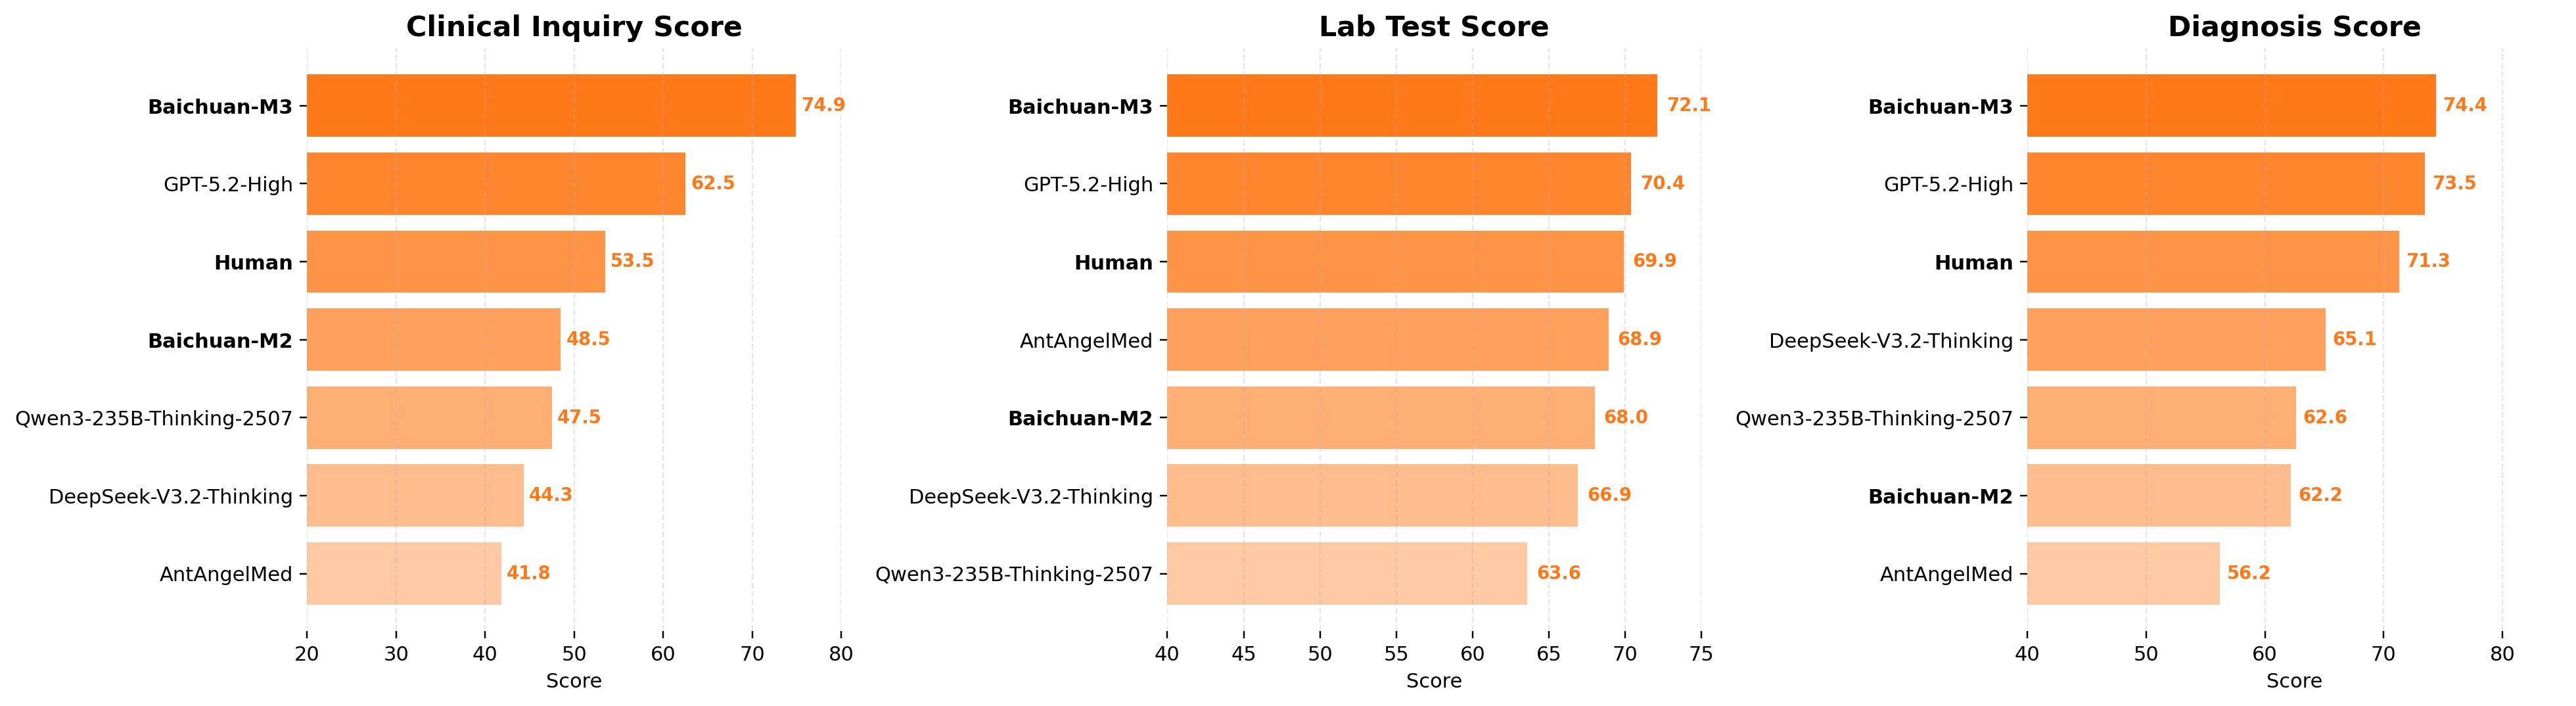
- 🩺 **满血问诊能力**:唯一在 SCAN-bench 三大核心维度(临床问诊、实验室检查、疾病诊断)均位列榜首的模型
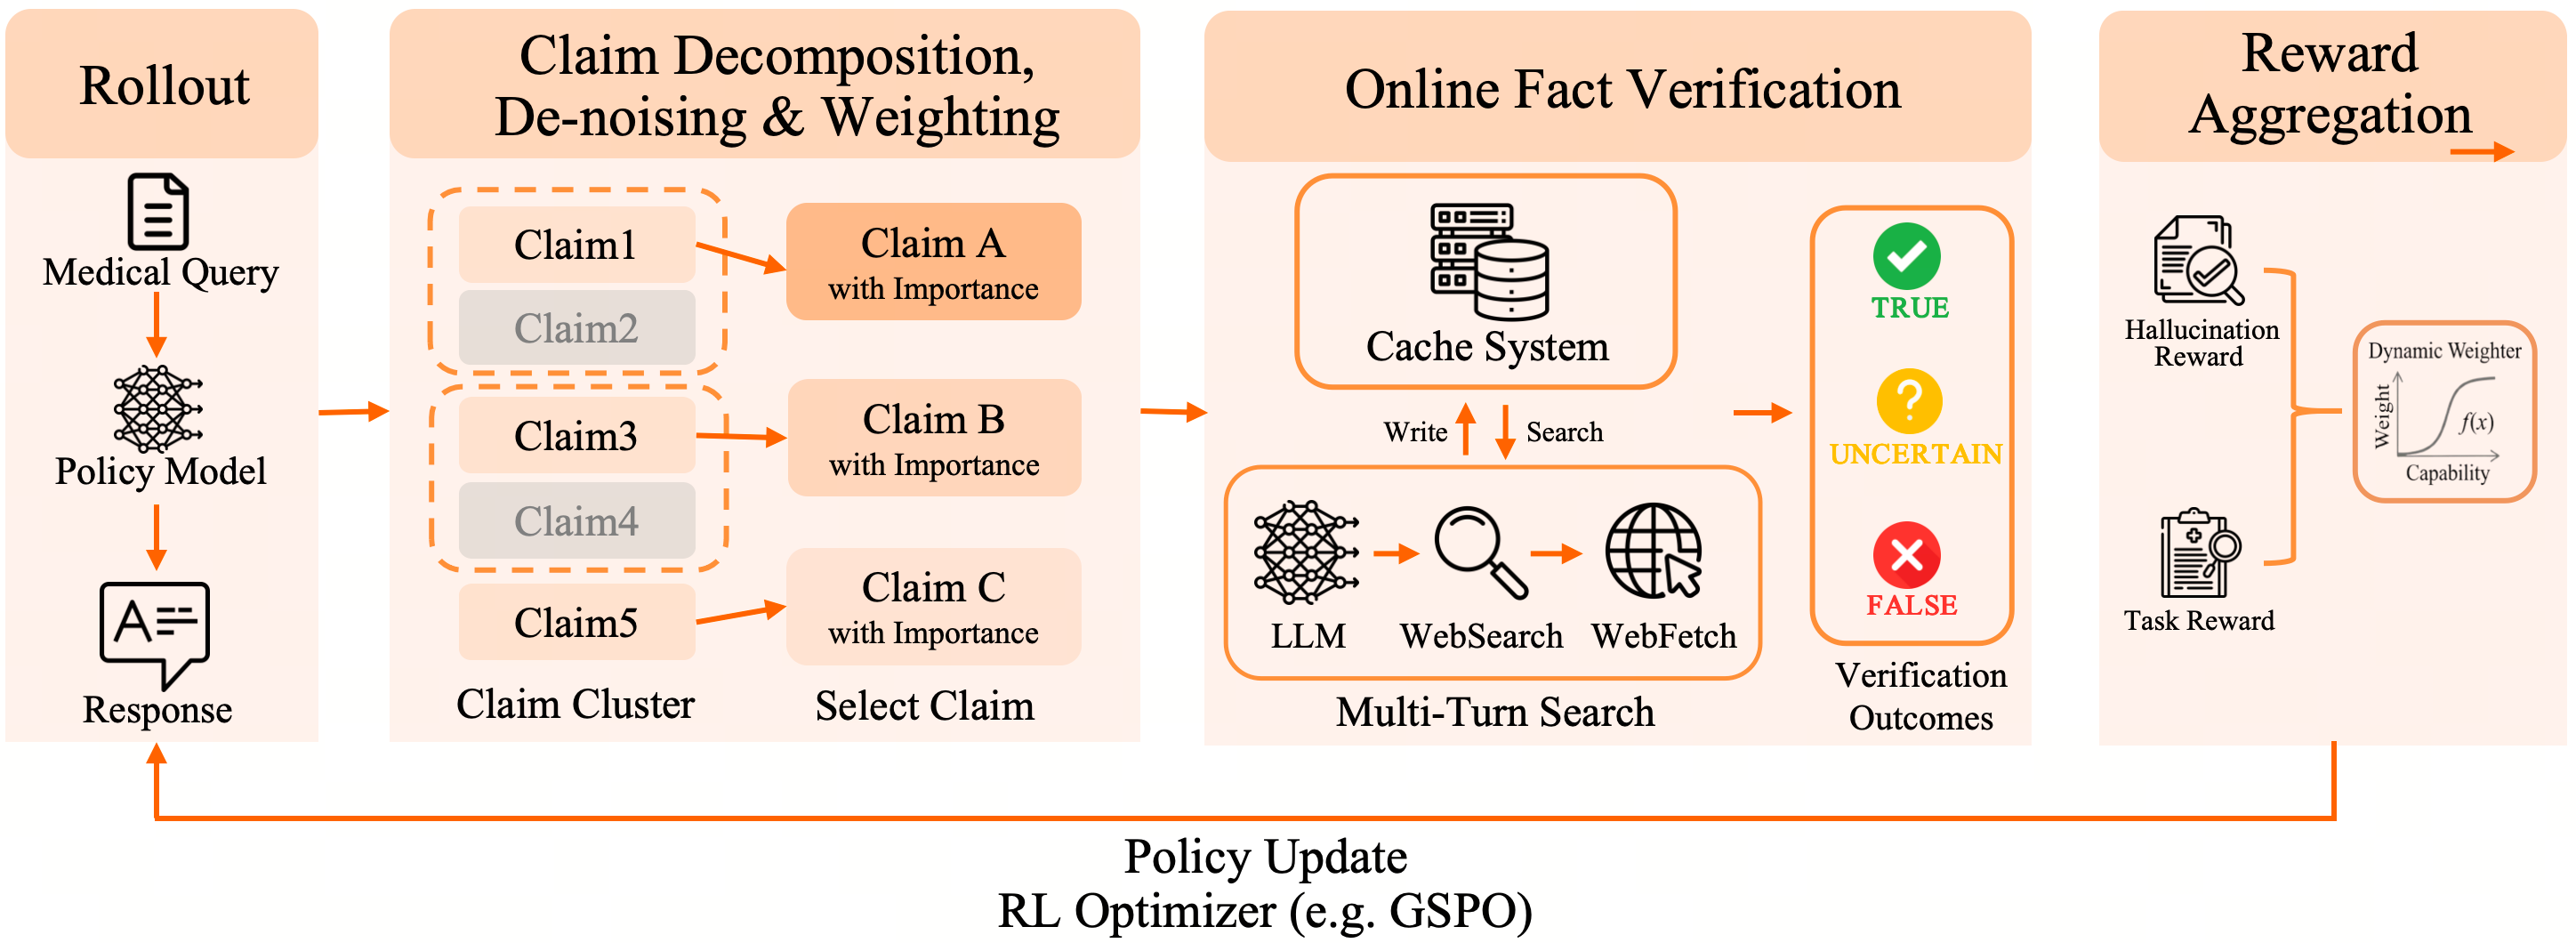
- 🧠 **低幻觉高可靠**:通过 Fact-Aware RL 框架,在无工具辅助下实现低于 GPT-5.2 的幻觉率
- ⚡ **高效推理部署**:W4 量化降低 74% 显存占用,Gated Eagle3 投机解码带来 96% 加速
## 📊 性能表现
### HealthBench 与幻觉评测
HealthBench 是 OpenAI 发布的权威医疗评测集,由 262 名来自 60 个国家和地区的执业医师构建,包含 5,000 个高保真多轮临床对话。