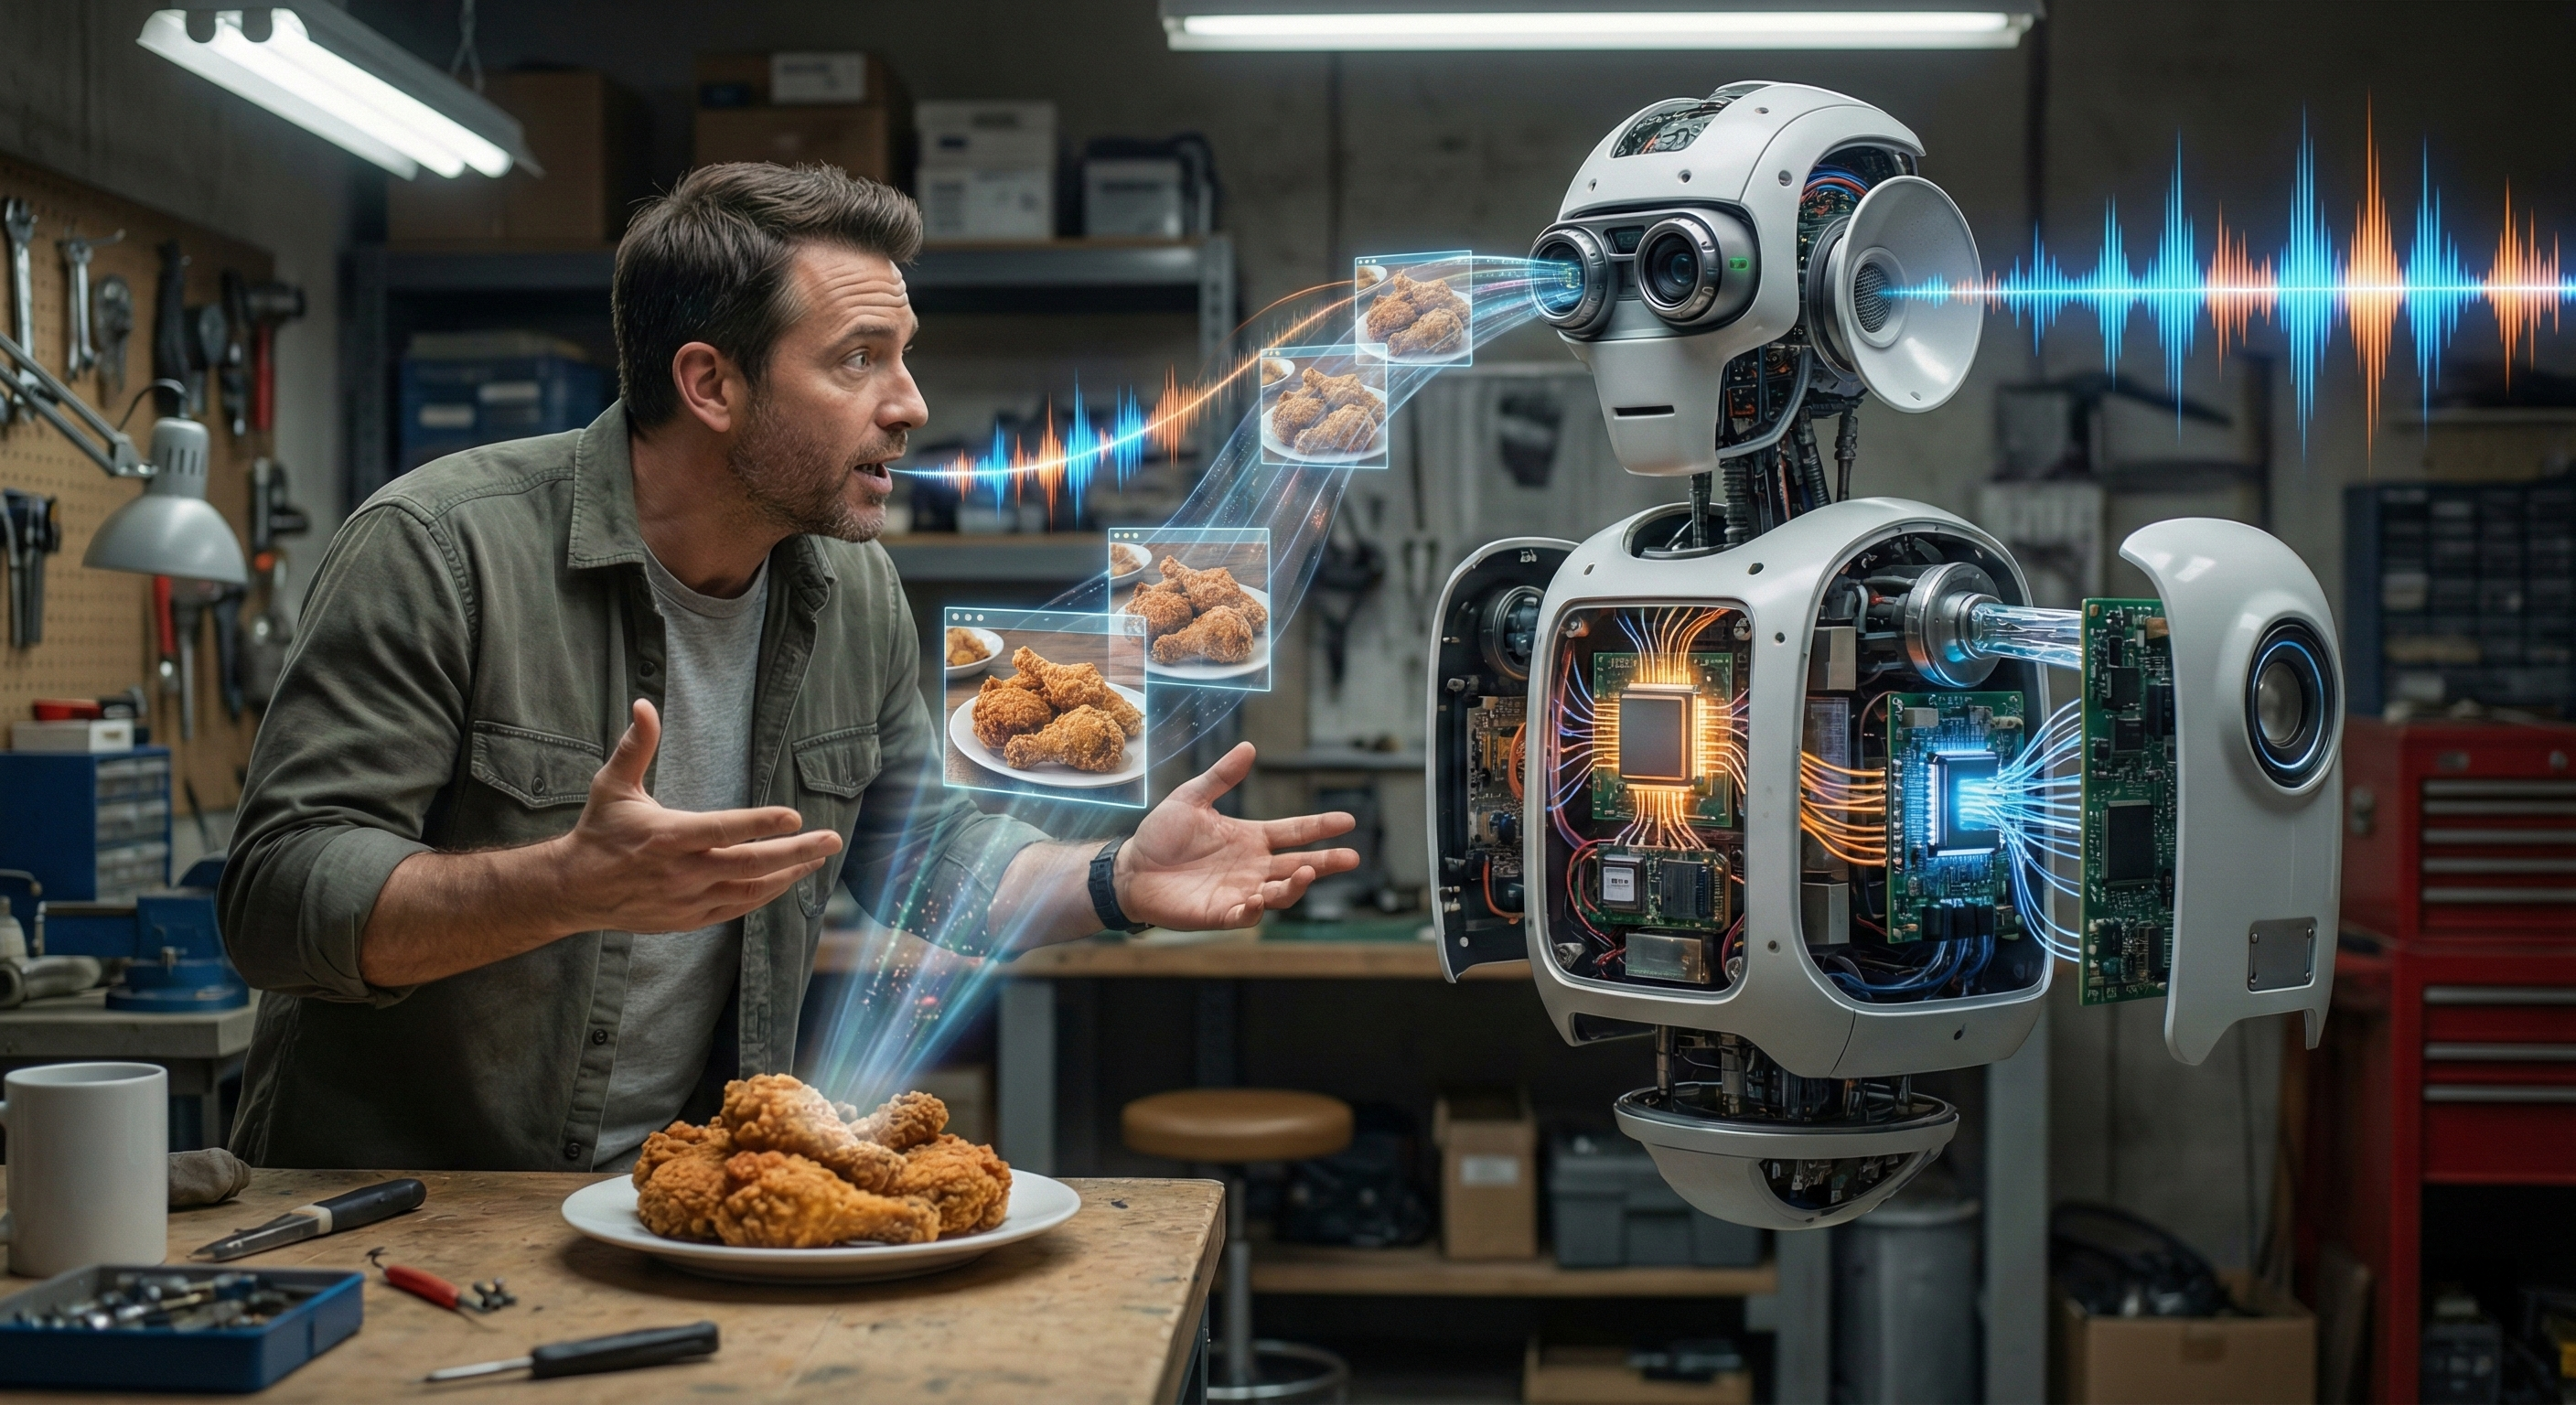
图 19-1 多模态模型 Nano Banana 生成的多模态交互示意图
图 19-1 多模态模型 Nano Banana 生成的多模态交互示意图
| 挑战维度 | 核心关注 | 主要难点 | 演进与策略 |
| 表征 | 异构数据映射到统一空间 | 数据形式差异巨大(如离散符号 vs 连续像素),且含不同程度噪声与冗余。 | 常见策略是“各模态专用编码器 + 共享 token 空间/Transformer 交互”,或先做统一 token 化再用 Transformer 建模,在保留模态特性的同时挖掘互补信息。 |
| 转换 | 模态之间的映射与生成 | 克服“一对多”映射歧义性(Ambiguity),保证“翻译”的语义一致性与真实性。 | 涵盖从图生文(Captioning)到文生图(Diffusion)的多向生成,重点解决逻辑性与质量难题。 |
| 对齐 | 跨模态元素的对应关系 | 识别不同模态中指代同一实体或事件的子结构(从 Patch/Token 到全局 Instance)。 | 通过 CLIP 对比学习,在大规模数据上显式拉近配对数据距离,建立语义匹配。 |
| 融合 | 信息的整合与推理 | 决策时有效结合多模态信息,消除歧义并抑制冲突带来的幻觉。 | 引入 Cross-Attention 等深度交互机制(如 LLaVA),替代简单拼接以实现协同增益。 |
| 协同学习 | 知识的跨模态迁移 | 如何利用高资源模态(如文本)辅助低资源模态的学习。 | 典型手段包括跨模态迁移/蒸馏、伪标注、联合预训练与缺失模态鲁棒训练;目标是在模态可用性不一致时仍能可靠泛化(包括 zero-shot / few-shot)。 |
表 19-1 多模态机器学习五大挑战(基于综述与工程解读)
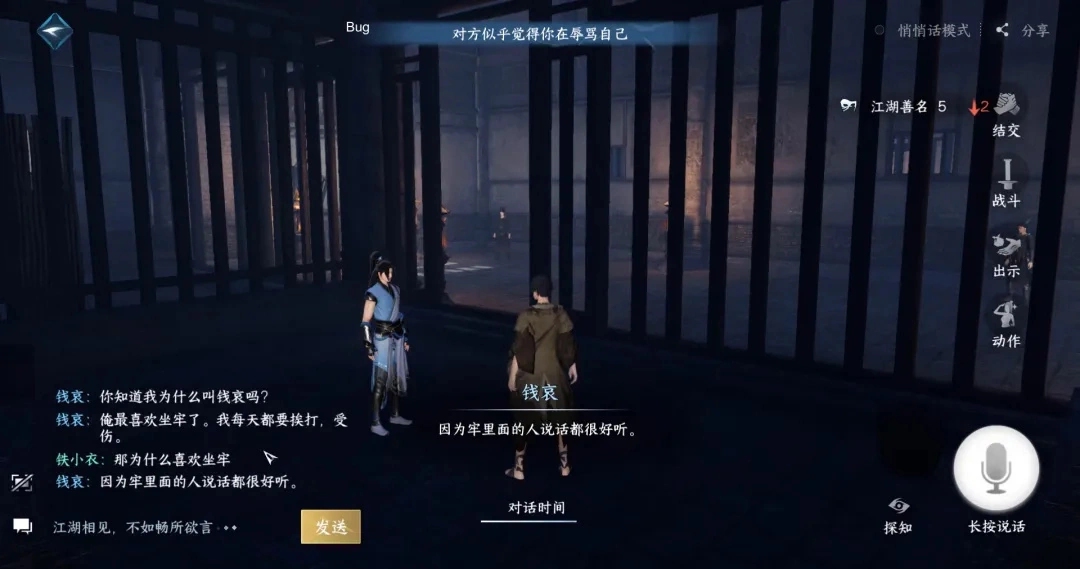
图 19-2 逆水寒智能 NPC
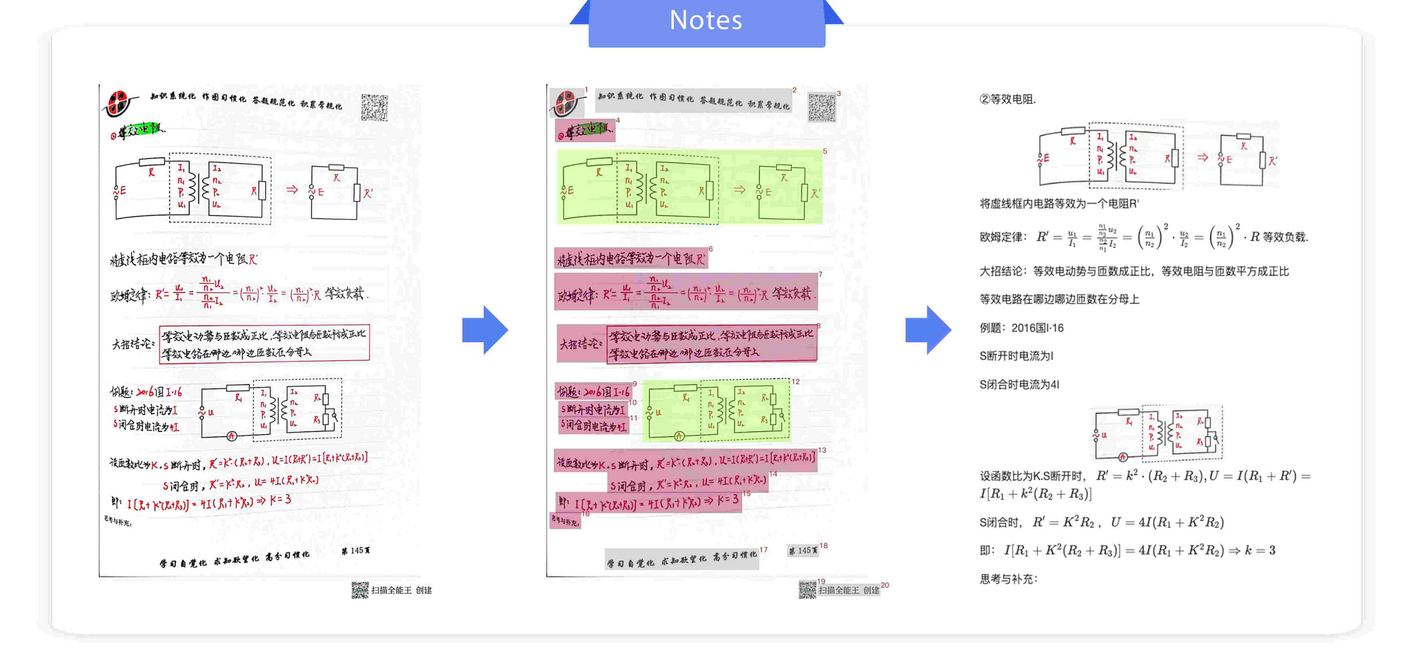
图 19-3 PaddleOCR-VL 识别效果
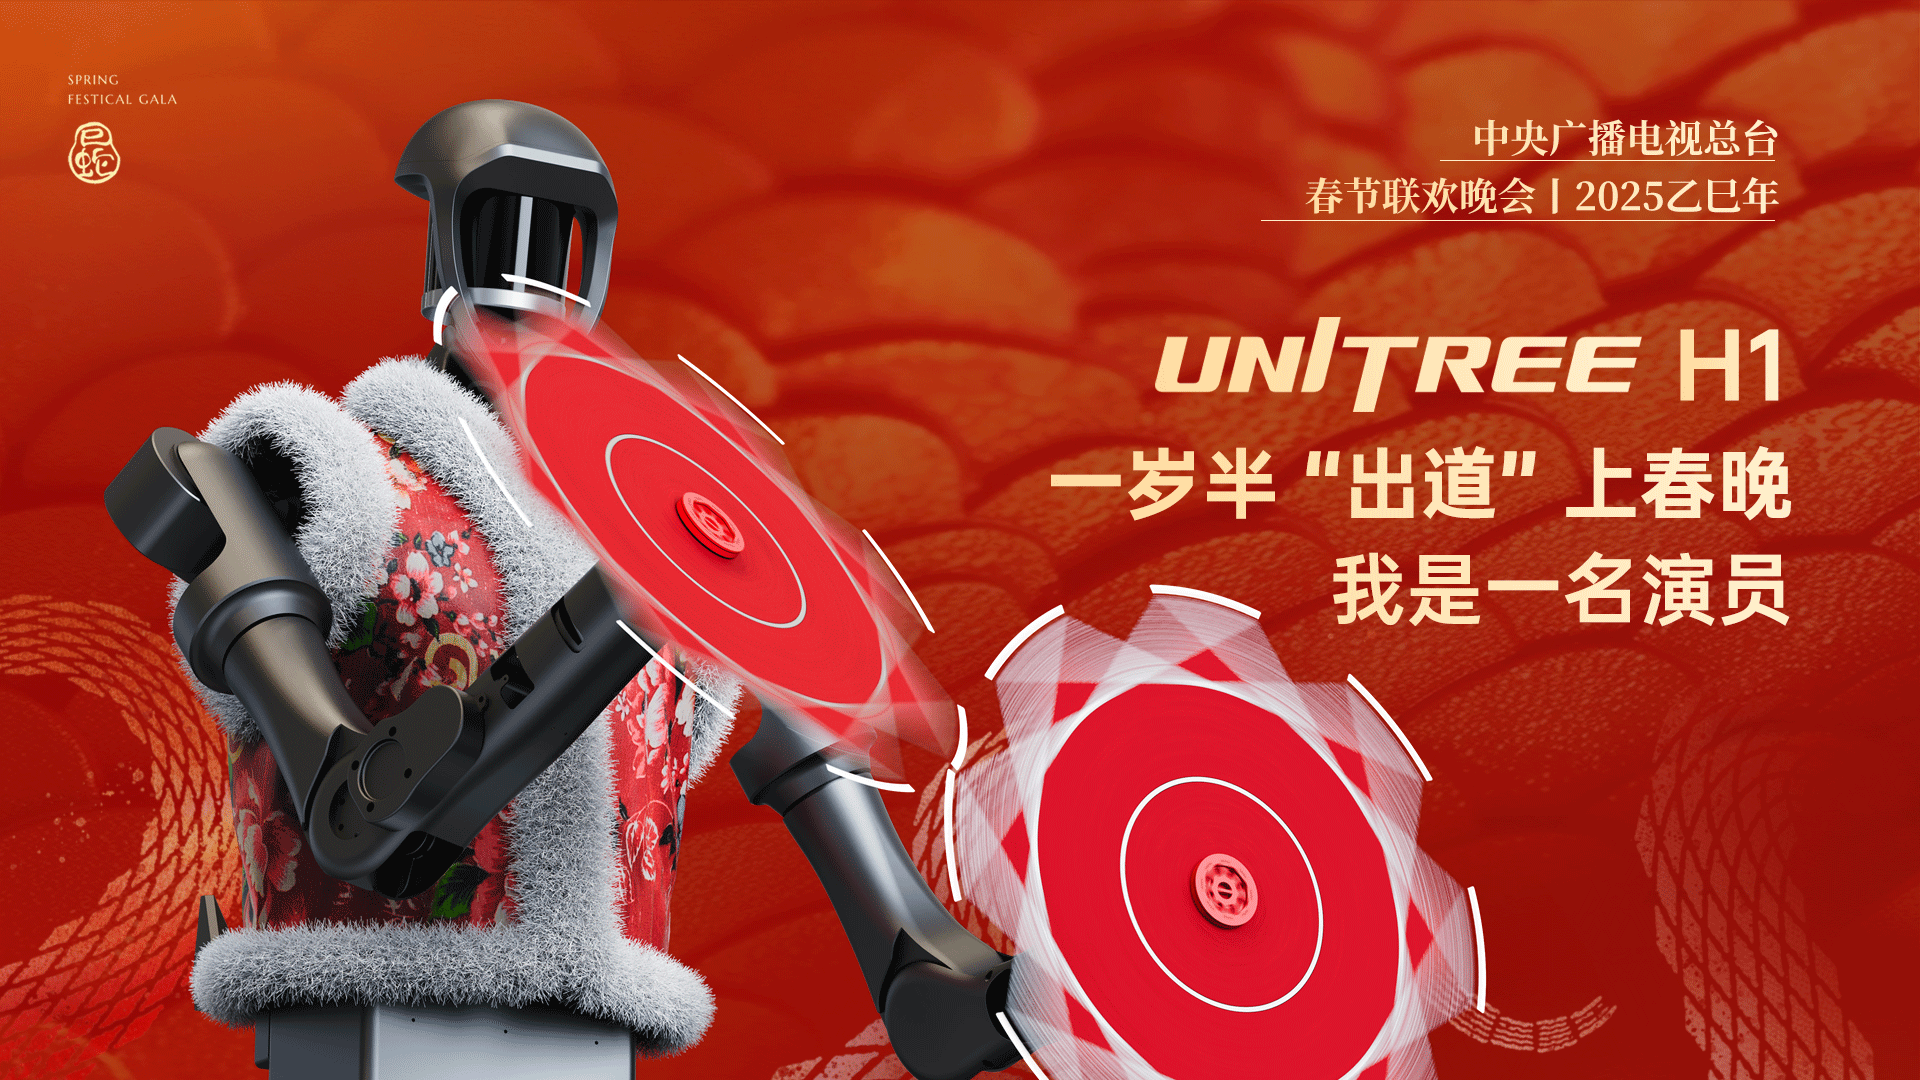
图 19-4 Unitree H1