# 29 - 微调数据准备与对话模板 --- **本章课程目标:** - 能分清 JSONL 的文件组织方式与 Alpaca、ShareGPT 的样本结构,找到任务、输入和参考答案。 - 能对照原文审核答案,处理格式、重复与标注分歧,并判断数据还缺少哪些场景。 - 能说明训练集、验证集和测试集的用途,完成清洗与固定划分,检查数据泄漏和处理报告。 - 能解释字段映射、对话模板和分词器各自的职责,分清训练与推理时提供的内容。 - 能整理后续训练所需的数据与配套记录,并说明自动检查和人工审核各完成了什么。 **学习建议:** 先按第 1~3 节用一条图书馆样本认清任务、文章和答案,审核内容并比较两种数据结构;再到第 5 节清洗、划分数据,最后理解第 6 节的输入转换。第 3.3 节工具调用与第 4 节文档问答为选读,按需要练习;第 6 节代码等第 31 章环境准备好后再运行。章末先独立作答,再逐题核对参考思路。 --- ## 1、认识微调数据 第 28 章中,我们希望模型完成一件很具体的事:读一段中文文本,抽取能够概括主题的关键词,只使用英文分号 `;` 分隔,不输出解释。 现在把这个要求变成训练样本。沿用第 28 章的图书馆教学示例,它不属于课程数据文件: ```text 输入:市图书馆周末开设儿童阅读课,读者可通过公众号预约。 请提取关键词,只输出关键词,并使用英文分号分隔。 参考答案:市图书馆;儿童阅读课;公众号预约 ``` 输入告诉模型“读什么、做什么”,参考答案告诉它“希望怎样回答”。制作自己的数据时,这份答案可能来自人工标注,也可能由另一个模型起草后再审核;不能把未经检查的回复直接当成正确答案。 现在只找本机 `案例与源码-4-微调/` 中的 `keywords_data_sharegpt_small.jsonl`,它是本章的起点。第 5 节再使用清洗脚本和处理结果,训练、预测与导出文件在后续章节用到时查找。
查阅:案例目录与各类文件的用途 **先认识案例文件。** 在课程仓库中打开 `案例与源码-4-微调/`,主要文件如下。先找到 small 样本、清洗脚本和处理结果目录,其他文件用到时再展开。 ```text 案例与源码-4-微调/ ├── README.md # 数据与使用说明 ├── keywords_data_sharegpt_small.jsonl # 本章使用的 2,000 条关键词样本 ├── keywords_data_sharegpt.jsonl # 约 5 万条,供扩展练习使用 ├── prepare_keywords_dataset.py # 清洗、去重并划分数据 ├── evaluate_keywords_predictions.py # 第 32 章评分,清洗脚本也复用其格式检查 ├── convert_keywords_predictions.py # 第 32 章转换预测文件 ├── processed/ # 已处理的数据 │ └── keywords-clean/ # 课程使用的训练集、验证集和测试集 │ ├── keywords_train.jsonl # 训练集:1,600 条,用于学习和更新参数 │ ├── keywords_validation.jsonl # 验证集:200 条,训练中检查表现 │ ├── keywords_test.jsonl # 测试集:200 条,方案确定后检查最终效果 │ ├── cleaning_report.json # 清洗报告:检查了什么、修改了什么 │ ├── manifest.json # 数据说明单:条数、划分规则与文件校验值 │ └── dataset_info.json # 数据集登记:告诉训练工具怎样读取三份数据 ├── document-qa-demo/ # 第 4 节的文档问答练习 ├── configs/ # 后续训练、预测和导出配置 ├── examples/ # 提示词、模板、标注审核与预处理示例 └── results/ # 后续章节用到的训练曲线和预测结果 ``` 约 5 万条的完整数据为本目录中的 `keywords_data_sharegpt.jsonl`,主线跟做使用 small 文件即可。它包含 small 样本,不能把两者分别当成互不重叠的训练集和测试集。 **上面列的是案例目录的主要入口,不都是训练数据。** 三份数据集是 `keywords-clean/` 里的 `keywords_train.jsonl`、`keywords_validation.jsonl` 和 `keywords_test.jsonl`;Python 脚本负责处理数据,配置文件告诉工具怎样运行,报告和记录则保存处理、运行的结果。
本课程从 small 文件的 2,000 条样本出发,经过处理和划分,得到 1,600 条训练集、200 条验证集和 200 条测试集。这三份数据都保留了输入与参考答案,只是用途不同:训练集用于更新模型参数,验证集用于训练中检查表现但不更新参数,测试集留到方案确定后再使用,不参与训练或调参。 `processed/keywords-clean/` 是课程附带的处理结果。第 5 节会带你运行脚本,另存到 `keywords-clean-repro/`,并说明怎样划分、为什么要分开。这里先认识文件和用途。 现在打开 `keywords_data_sharegpt_small.jsonl`。文件名里的 `small` 表示它是供练习使用的小份数据,共 2,000 条;不是一种新的数据格式。 这个文件是 JSONL:**一行就是一条 JSON 记录**。第 1 条样本介绍“高氟铍矿石”的冶炼处理,原始一行很长;下面按原字段和值自动换行,只是为了看清结构,没有改写数据内容。 文件中的样本保存了用户输入和助手参考答案,主要字段如下: - `conversations`:这条样本中的整段对话; - `role`:这句话是谁说的; - `content`:这句话的具体内容。 本例中,`user` 消息包含待抽取的文本和任务指令,`assistant` 消息保存参考关键词答案。 在图中找到三处:待处理的文章、“找出上文中的关键词”这句要求,以及最后用分号分隔的答案。它们与上面的图书馆例子一一对应。 ![关键词数据第 1 条真实 ShareGPT 记录:标出 conversations、user、assistant 和英文分号](images/29/29-1-0-1.svg) 图中展示的是文件中的源记录;标题“模型到底会看到什么”先帮助我们认识文章和参考答案,实际送入模型的内容还要经过第 6 节的模板处理。图内长行有溢出,完整文字见下方展开内容。
展开阅读第 1 条完整记录(原字段与内容保留)
{
  "conversations": [
    {
      "content": "高氟铍矿石在熔炼过程中配入氢氧化铝来脱除其中的氟.结果表明,在配入5%Na2CO3、9.3%Al(OH)3、1400~1500℃熔炼20 min的情况下,BeO回收率达到96%以上,脱氟效果良好(铍玻璃F/BeO能控制在15%以内).为高氟铍矿石的工业应用探索出新的冶炼途径.\n找出上文中的关键词",
      "role": "user"
    },
    {
      "content": "高氟铍矿;配料;熔炼;回收率;脱氟率",
      "role": "assistant"
    }
  ]
}
这里只为阅读展开排版,保存为 JSONL 时仍是一条物理行,消息中的换行写作 `\n`。
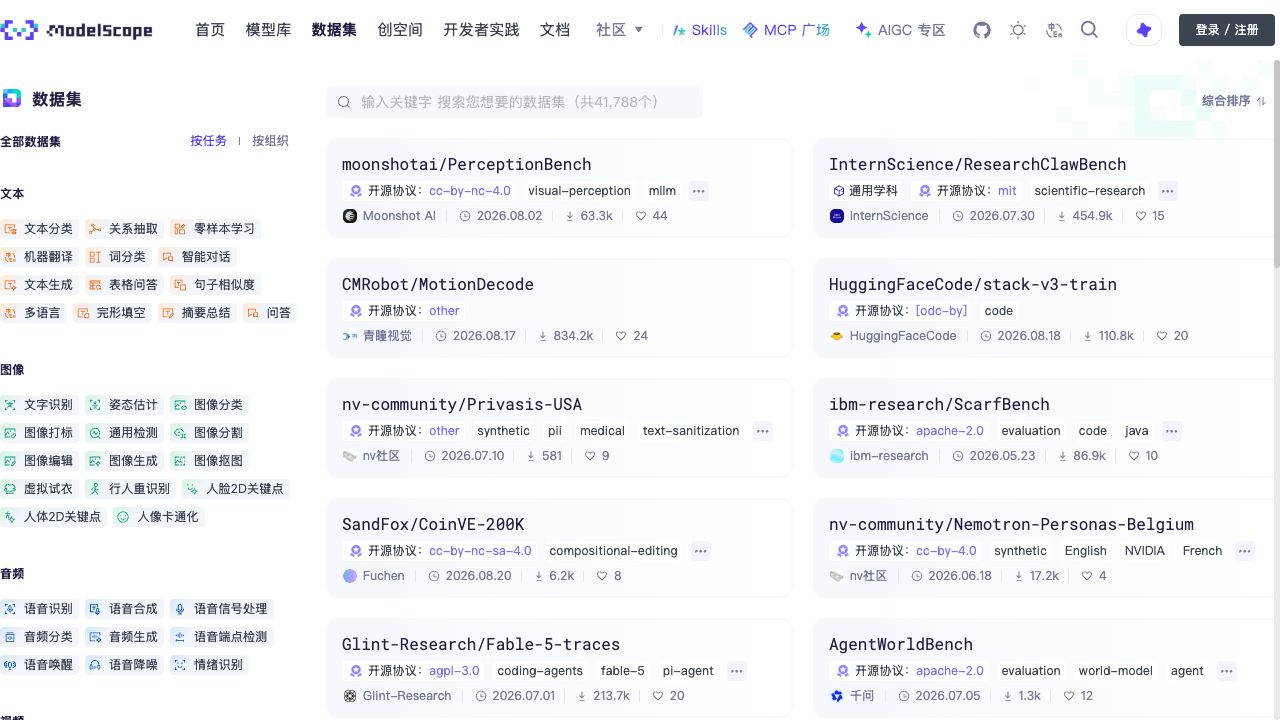
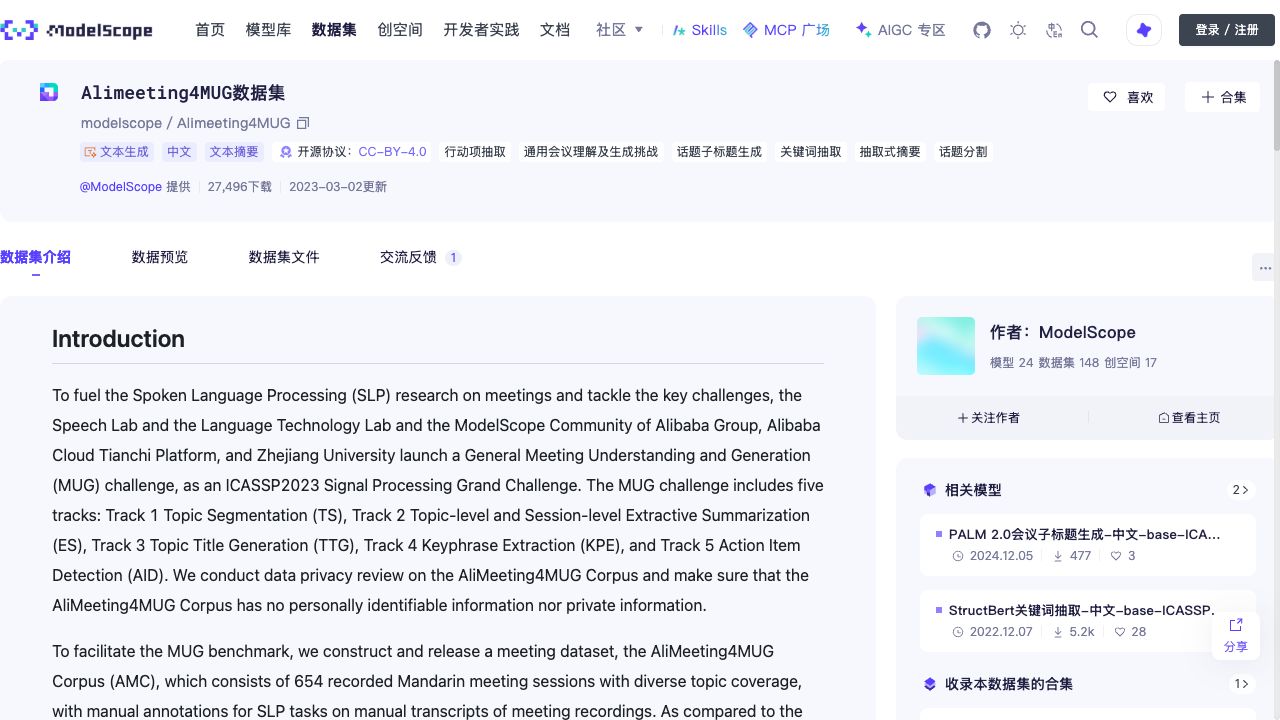
**数据准备工作:** 从文章到训练文件,中间还有几件事:选取符合任务的文章、核对答案、修正格式、处理重复样本,再分出训练和检查时使用的数据。把这些工作连起来,就是微调中的**数据工程**,也就是本章要完成的数据准备。 ## 2、数据来源与质量要求 ### 2.1 数据来源与获取方式 微调数据的内容和答案形式应符合目标任务。 | 数据来源 | 适合做什么 | 常见问题 | | ------------ | ------------------------------------ | -------------------------------- | | 公共数据 | 入门练习,或作为与任务匹配的训练数据 | 可能与自己的任务无关 | | 真实业务数据 | 让模型适应真实业务场景 | 原始格式常常混乱,答案也未必统一 | | 合成数据 | 补齐稀缺场景、扩充边界样本 | 生成得快,但仍然需要检查答案 | 例如,要做企业内部制度问答,通用对话数据可以帮助模型学习问答形式,但“公司年假有多少天”仍需以本公司的制度为准。准备这类任务的数据时,可以结合企业制度、已有问答、客服工单和人工核对的标准答案。 如果真实样本不足,也可以围绕任务规则生成模拟样本,再抽样检查答案是否正确、是否符合业务要求。 #### 2.1.1 ModelScope 数据集查找 公共数据可以从 [ModelScope(魔搭社区)的数据集页面](https://modelscope.cn/datasets)查找。前面介绍的“模型库”用来找模型,“数据集”栏目则用来找训练或评测所需的数据,包含文本、图像、音频等类型。 如果已经知道数据集名称,可以在页面上方直接搜索;还没有具体目标时,可以先按左侧的任务分类浏览。例如,做对话或问答任务时,选择“文本”下的“智能对话”或“问答”,再从列表中查看相关数据集。 ![ModelScope 数据集首页:搜索框、任务分类与数据集列表](images/29/29-2-1-1.jpg) 例如,打开 [Alimeeting4MUG 数据集](https://modelscope.cn/datasets/modelscope/Alimeeting4MUG),可以看到它面向中文会议场景,包含关键词抽取、摘要等任务。页面提供“数据集介绍”“数据预览”和“数据集文件”三个入口: ![ModelScope 数据集详情:任务标签、使用协议和介绍、预览、文件入口](images/29/29-2-1-2.jpg) | 页面入口 | 重点看什么 | | ---------- | -------------------------------------------------------------------------------------------- | | 数据集介绍 | 数据从哪里来、使用什么语言、面向什么任务、怎样标注,以及使用许可是否符合自己的用途。 | | 数据预览 | 直接查看几条输入和答案,判断文本内容、长度和答案形式是否合适。不是每个数据集都支持在线预览。 | | 数据集文件 | 查看实际文件及其格式、大小,确认是否已有训练集、验证集或测试集,并按页面说明下载。 | 如果数据集没有在线预览,可以先阅读介绍页中的结构样例和加载说明,或下载少量数据检查,不必一开始就下载整套。下载后仍需清洗数据,并整理成后文介绍的 Alpaca 或 ShareGPT 等格式,才能接入本课程的训练流程。 #### 2.1.2 常用数据准备工具 当你开始处理自己的文档时,可以了解下面三个数据准备工具: | 工具 | 能帮我们做什么 | 什么时候值得了解 | | --------------------------------------------------------- | ------------------------------------------------------ | ---------------------------------------------------- | | [Easy Dataset](https://github.com/ConardLi/easy-dataset/) | 通过界面导入文档、拆分内容、生成和编辑问答数据 | 想先把一份文档整理成可检查的问答样本 | | [DataFlow](https://github.com/OpenDCAI/DataFlow) | 把数据提取、转换、清洗、筛选和生成等步骤组织成处理流程 | 文档较多,希望批量执行一套数据处理规则 | | [GraphGen](https://github.com/InternScience/GraphGen) | 利用知识图谱中的实体及其关系,辅助生成训练数据 | 数据需要体现多个知识点之间的联系,可作为进阶工具了解 | 第 4 节的独立扩展用 Easy Dataset 完成“导入产品说明 → 生成问答 → 审核 → 导出”。DataFlow 和 GraphGen 可供批量处理与进阶练习时选用。 ### 2.2 关键词标注的质量要求 怎样判断一份关键词答案能不能用?回到前面的教学文本:“市图书馆周末开设儿童阅读课,读者可通过公众号预约。”对照几种输出看看: | 输出示例 | 检查结果 | | -------------------------------- | ---------------------------------------------------- | | `市图书馆;儿童阅读课;公众号预约` | 能概括主要对象、活动和参与方式,是本例的一份参考答案 | | `图书馆;活动` | 没有说错,但过于笼统,丢掉了“儿童阅读课”这一主要信息 | | `市图书馆;成人培训` | 格式没问题,但原文没有成人培训,内容不正确 | | `关键词:市图书馆;儿童阅读课` | 内容与原文有关,但多出了任务不允许的前缀 | 检查一条样本时,可以按这个顺序来:先读原文,自己说出文章主要讲什么;再看参考答案是否抓住主题、有没有添加原文不支持的内容;最后检查分号、前缀和重复关键词。 这就是**内容质量与格式质量的区别**。分号、空项等问题可以交给脚本检查;关键词是否选得恰当,仍需要对照原文判断。专业文本中的名称拿不准时,应请熟悉该领域的人核对,不能只因为某个词看起来陌生就删掉。 关键词答案也不一定只有一种合理写法。例如,“公众号预约”可以看成一个参与方式,也可以拆成渠道与动作。但同一份数据中不能随意切换口径,下一节会约定本例采用哪种写法。 准备自己的数据时,先审核一小批,确认选词要求可执行,再扩大数量。如果某类文章经常漏掉主题,就补充这类文章及可靠答案;反复复制已经有的样本,并不能补上这个问题。 **还要检查:样本是否覆盖实际会收到的文章。** 假如训练材料全是图书馆活动通知,换成农业摘要后频繁漏掉品种名,首先要检查这类主题和名称是否得到充分示范。单纯增加更多活动通知,未必能解决问题。
准备自己的数据时:用一张覆盖表决定补什么 下面是一张可用于自己项目的覆盖检查表。同一篇文章可以同时属于“长文”“含专业名称”等多类,不必把它们当成互斥分类。 | 检查维度 | 从数据中找什么 | 对照答案看什么 | | ---------- | ------------------------------------------------ | ----------------------------------------------- | | 文章主题 | 实际业务中常见的主题,以及较少见但需要支持的主题 | 是否抓住主要对象与事情 | | 文本长度 | 短文、较长文章;长度按分词后的 token 数统计 | 关键内容是否落在截断位置之后,见第 30 章第 4 节 | | 完整名称 | 地名、机构名、活动名、品种名等 | 是否保留影响含义的限定词 | | 全称与缩写 | 同时包含全称和缩写、只包含缩写的文章 | 是否按同一套规则选词 | | 文本噪声 | 多余空白、识别错误、残缺句子 | 能否依据现有文本确认答案;疑点是否单独记录 | 为每一类记下“训练样本数量、验证样本数量、已审核数量、主要错误”。发现验证中某类表现差,就回查训练侧是否缺少这类输入或存在答案冲突;从新的来源补充并审核,避免把验证题直接搬进训练集。各类是否都达标,应分别查看,整体平均分可能掩盖少数类别的问题。 **需要多少条数据,没有适用于所有任务的固定答案。** 本课的 1,600 条训练数据是练习规模。自己的任务应先让常见场景与关键边界有可靠示范,再根据验证结果决定补哪些数据、是否值得扩大训练。样本数量增加,不代表覆盖范围和答案质量一定同步提高。 空文本等不在当前练习范围内的输入,先按[第 28 章任务约定](28-大模型微调概述与整体流程.md?id=_71-任务约定)确定处理方式。如果需要返回“无法抽取”等新状态,应统一修改任务规则和数据版本,避免同类输入对应相互矛盾的答案。
下面先把输出规则写清楚。 ### 2.3 关键词标注规则 这里的“标注”,指的是为一条输入确定参考答案;“标注规则”就是提前约定什么样的答案才算正确。清洗数据前,先把这套规则写清楚。关键词抽取至少要明确: | 需要约定的内容 | 本课程当前规则 | | -------------- | ---------------------------------------- | | 输出内容 | 一行,一个或多个能够概括主题的关键词 | | 分隔方式 | 关键词之间使用英文分号 `;` | | 多余内容 | 不输出解释、序号、“关键词:”前缀或重复词 | | 关键词数量 | 根据文本主题确定,不强行统一数量 | 不同文章包含的主题信息不同,不必为了统一成“3~5 个”,删掉必要的关键词或凑入无关词。业务确实需要限制数量时,应先制定规则,再按规则审核样本。 **格式明确后,还要约定怎样选词。** 下面这套口径用于新增标注和审核草案:从给定文本中选取能概括主题的信息,保留原文语言,不自行翻译或补充背景知识。它不是所有关键词任务唯一的规则;如果业务需要英文标签、固定分类词或固定数量,应先另行约定,再一致地准备数据。 先把选词判断落实到三件事:有原文依据,保留完整名称,覆盖文章主题。例如,“儿童阅读课”不能缩成泛泛的“活动”,“公众号预约”在本例作为一项参与方式整体保留。完整规则如下,审核遇到分歧时回来查。
标注时查阅:完整选词规则与分歧处理 | 容易分歧的地方 | 标注时怎样处理 | 例子 | | -------------------- | -------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------- | | 选原词还是自己概括 | 优先使用原文词语;可去掉虚词整理成短语,但不改变含义、不翻译、不补充事实 | “通过公众号预约”可整理为“公众号预约”;“儿童阅读课”不改成“亲子教育培训” | | 哪些信息要选入 | 先保留文章主要讲的对象和事情,再选影响主题理解的方法、结果或参与方式;不是把所有名词都列一遍 | 本例保留图书馆、活动名称和预约方式;“周末”是否也要选,应按业务对时间信息的需要统一约定 | | 保留完整名称还是缩短 | 保留影响含义的限定词,避免只留下过于宽泛的类别 | 本例选“儿童阅读课”,不缩成“阅读课”或“活动” | | 一个短语要不要拆开 | 能共同表达一项关键信息的短语,优先整体保留,不为凑数量拆词 | 本例选“公众号预约”,不拆成“公众号;预约” | | 全称、简称怎样统一 | 原文同时给出全称和简称时,默认选全称;只有简称时保留简称,不自行补全 | 原文写“高层体系结构(HLA)”时选“高层体系结构”;只写“HLA”时保留“HLA” | | 两个近义词要不要都选 | 表达同一件事时保留一种写法;是否为同义词要结合原文判断 | 不把“儿童阅读课”和自己改写的“少儿阅读课程”同时列入答案 | | 专业含义拿不准怎么办 | 保留原文和疑问,查来源或请领域人员确认;有未解决的内容疑点时,整条记录先不纳入新增训练数据 | 陌生简称不自行扩写,也不只因看不懂就删除 |
按这套口径,图书馆短文可以标为 `市图书馆;儿童阅读课;公众号预约`。`图书馆;阅读课;公众号;预约` 虽然也与原文有关,却缩短了名称、拆开了参与方式,不适合作为这套规则下的标准示范。若业务确实需要把“渠道”和“动作”分别提取,应先调整规则,再一致地标注同类样本。 **先走完一个审核示范。** 按“对照原文 → 判断问题 → 提出修改 → 保留待确认项”检查下面的地名。它来自验证集第 4 条,用于理解审核方法;修改建议先作为待审核草案。 **示例一:名称被截短——“万安县”变成了“安县”。** 第 4 条原文节选: > 近年来,由于苗木的调运引种和生产上的疏忽,柑桔疮痂病在万安县发生危害有加重趋势 原参考答案中包含 `安县`。虽然这两个字能在原文中找到,但它们只是“万安县”的一部分。 | 审核步骤 | 本例记录 | | ------------ | ---------------------------------------------------------------------------- | | 判断问题 | 地名被截短,丢掉了具体所指;关键词不能仅凭“能找到这几个字”就判为正确 | | 提出修改 | 建议恢复为 `万安县`;按文章主题形成的整条草案为 `柑桔疮痂病;万安县;果业生产` | | 保留待确认项 | 是否同时收录“引种”等背景信息,需要统一选词范围;这不影响恢复完整地名的判断 | 这个示范检查的是参考答案本身。若答案由另一个模型起草,也要经过同样审核;下面两例用验证集第 6 条及已有模型回答练习,不需要先学会第 32 章的评分。
继续练习:从农业样本检查漏主题与无依据编号 **示例二:词都有依据,却漏掉了文章主题。** 第 6 条原文的两段节选如下,保留原有文字和标点: > 夏波蒂是加拿大福瑞克通农业试验站用"F58050"为 母本,"Bakeking"为父本经有性杂交育成 > 2003年由榆林市农科所弓1人我市试种,通过5年观察,该品种产量高,炸条品质和食用品质优良,适 宜在我市北部风沙滩水地区推广栽培,现将种植表现及栽·培技术简介如下: 一份已保存的模型回答是: ```text F58050;Bakeking ``` | 审核步骤 | 本例记录 | | ------------ | -------------------------------------------------------------------------------------------------------------------------------------- | | 判断问题 | 两个词确实在原文中,但都在说明亲本来源。只列它们,无法概括“夏波蒂的种植表现”这一主题 | | 提出修改 | 应先保留主品种与种植表现。建议草案为 `夏波蒂;榆林市;种植表现;推广栽培;炸条品质;食用品质` | | 保留待确认项 | 是否收录亲本信息需按业务需要约定;原参考中的“马铃薯”未在给定文本直接出现,须查来源确认。原文“弓1人”“栽·培”等疑似文字识别问题也单独记录 | 这里没有断言“马铃薯”一定错误,而是把“当前文本能确认什么”和“还需要查什么”分开。**有原文依据,是选词的必要检查,但还要看有没有抓住主题。** **示例三:格式正确,却多出了没有依据的词。** 还是第 6 条原文,另一份已保存的回答是: ```text F58050;Bakeking;F68050 ``` | 审核步骤 | 本例记录 | | ------------ | ------------------------------------------------------------------------------------------------ | | 判断问题 | 一行、英文分号、无重复,形式上没有问题;但原文写的是 `F58050`,没有 `F68050`,而且仍漏掉“夏波蒂” | | 提出修改 | 若把它作为新标注的草稿,应排除无依据的 `F68050`,再按示例二补足主题;只删掉这个词,答案仍不完整 | | 保留待确认项 | 不能猜测 `F68050` 是另一个有效编号。若认为输入有错,应查原始资料;确认前不把这份草稿作为训练示范 |
**审核训练草稿时可以提出修改;评估模型时必须保留它原来的回答。** 例如,不能先替模型删除 `F68050`,再把修改后的文本拿去评分。 自己审核时,也为每条样本留下“原始答案、建议答案、原文依据、待确认项”。能确定的修改和需要继续查证的疑点分别记录,确认完成后再纳入新增数据。 课程练习数据主要经过格式和重复检查,部分参考标注仍有内容疑点,不能把它们全部视为已人工审核的标准答案。上面的修改建议也需要确认后才能用于新数据。第 32 章的示例分数以随附参考文件为准;[第 4.1 节](32-微调效果评估与模型部署.md?id=_41-格式检查与内容检查)会区分格式是否合格、是否命中参考答案、内容是否合理。
练习:两个人怎样按同一套规则审核 从准备新增的材料中选一小批文章,例如先用 5 条练习。两人分别阅读原文、写出关键词,暂时不看对方答案,再比较完整名称、短语拆分、选词范围和无依据内容。 如果一人写 `公众号预约`,另一人写 `公众号;预约`,先回到本节约定,说明为什么此处整体保留;不要只投票决定。遇到规则没有覆盖的情况,补充规则和例子,再用修订后的规则重新检查这批文章。专业事实拿不准时,继续保留待确认项。 记录“样本编号、两份答案、分歧原因、最终处理、规则版本”即可。这一步叫作**标注校准**,目的是让不同人对规则形成一致理解。一个人学习时,可以先独立作答,再按规则复查;这种自查不能代替独立复核。
--- ## 3、常见微调数据格式 前面看到的文件名以 `.jsonl` 结尾,内容又被称为 ShareGPT,后面还会出现 Chat Template。它们处理的不是同一件事: | 要解决的问题 | 对应名称 | 本课程中的例子 | | -------------------------------- | ------------------------- | ------------------------------------- | | 多条记录怎样放进文件 | JSONL | 一行保存一条完整的 JSON 记录 | | 每条记录怎样保存指令、输入和答案 | Alpaca、ShareGPT | 三个独立字段,或一组按角色排列的消息 | | 消息怎样组织成模型熟悉的输入 | Chat Template(对话模板) | 加入用户、助手的边界标记,第 6 节展开 | 因此,一个文件可以同时是“JSONL 文件”和“ShareGPT 数据”,两者并不冲突。先看一条记录的两种常见写法。 | 格式 | 一条数据怎样保存 | 更适合的情况 | | -------- | -------------------------------- | ---------------------------------- | | Alpaca | `instruction`、`input`、`output` | 单轮的“指令 + 输入 + 答案”任务 | | ShareGPT | 一组按角色排列的消息 | 用统一的消息结构保存单轮或多轮对话 | ### 3.1 Alpaca 数据格式 Alpaca 格式会把任务说明、具体输入和标准答案拆开保存。仍用第 1 节的图书馆教学示例: ```json { "instruction": "请提取关键词,只输出关键词,并使用英文分号分隔。", "input": "市图书馆周末开设儿童阅读课,读者可通过公众号预约。", "output": "市图书馆;儿童阅读课;公众号预约" } ``` `instruction` 是任务要求,`input` 是这次要处理的文章,`output` 是参考答案。这种拆法直观,适合单轮任务。 ### 3.2 ShareGPT 数据格式 同一条教学样本也可以按本课程采用的 ShareGPT 风格保存: ```json { "conversations": [ { "role": "user", "content": "市图书馆周末开设儿童阅读课,读者可通过公众号预约。\n请提取关键词,只输出关键词,并使用英文分号分隔。" }, { "role": "assistant", "content": "市图书馆;儿童阅读课;公众号预约" } ] } ``` 任务和答案都没有改变,只是把指令与文章放进 `user.content`,把答案放进 `assistant.content`。最外层的 `conversations` 是消息列表: ```text conversations ├── 第 1 条:role = user → 待抽取的文本和任务指令 └── 第 2 条:role = assistant → 标准关键词答案 ``` 上面为了讲解而展开换行;保存为 JSONL 时,整个对象要放在一条物理行中,消息内部的换行用 `\n` 表示。不要把展开后的十几行当作十几条训练样本。 如果以后有多轮任务,也可以在同一条样本里继续追加消息: ```text user1 → assistant1 → user2 → assistant2 ``` 本课程的关键词数据是一问一答。后面使用的清洗脚本也按这种单轮结构检查;换成多轮数据时,需要相应调整检查逻辑,不能直接套用。 字段名不一定永远叫 `conversations`、`role` 和 `content`。有的数据把用户写成 `human`,有的数据把消息列表写成 `messages`。这不是数据一定有问题,而是训练工具需要一份“字段对照表”才能正确读取它。第 31 章第 6.2 节会在 `dataset_info.json` 中填写这份对照表。 > **Alpaca 和 ShareGPT 用来整理样本;训练工具读取这些样本后,还要通过与模型匹配的对话模板和分词器准备模型输入。第 6 节会展示转换前后的区别。** ### 3.3 从单轮问答到工具调用(选读) 关键词任务只需要“读文章 → 输出关键词”。如果希望助手查询儿童阅读课还有没有名额,它还需要判断信息是否齐全、请求查询,并根据查询结果回答。训练样本也要包含这些可观察的步骤。
进阶阅读:从澄清到工具返回的一条完整样本 下面是**虚构的教学示意**,用于理解一条多轮样本,不是已执行的工具记录,也不是可直接上传训练的文件。本例提供 `query_reading_class` 工具,只查询市图书馆儿童阅读课的余位,接收两个参数:`date` 使用 `YYYY-MM-DD`,`time_slot` 使用 `morning`(上午)或 `afternoon`(下午)。 | 顺序 | 谁提供内容 | 消息或动作示意 | | ---- | ---------- | ----------------------------------------------------------------------------- | | 1 | 用户 | 儿童阅读课还有名额吗? | | 2 | 助手 | 你想查询哪一天、上午还是下午的场次? | | 3 | 用户 | 2026 年 9 月 12 日上午。 | | 4 | 助手 | 请求 `query_reading_class`,参数为 `date="2026-09-12"`、`time_slot="morning"` | | 5 | 工具 | 程序执行查询后返回 `remaining=6`,表示还有 6 个名额 | | 6 | 助手 | 查询结果显示,2026 年 9 月 12 日上午的儿童阅读课还有 6 个名额。 | 这里最关键的是第 4、5 步的区别:**模型提出调用请求,程序负责实际执行,再把结果交还给模型。** 助手不能自己写出一个 `remaining=6`,就当作查到了真实余位。保存整条消息链及工具说明,才有条件让模型学习“何时澄清、怎样调用、如何使用结果”。 准备这类数据时,还需要覆盖不同情况: | 情况 | 应有的示范 | | ---------------------------------- | -------------------------------------------------- | | 用户一开始就给齐日期与场次 | 直接填写已有信息,避免重复询问 | | 用户已经贴出通知,只要求提取关键词 | 根据已给文本回答,不为使用工具而调用工具 | | 查询返回“场次不存在”或暂时失败 | 按实际结果说明情况;若允许重试,遵守次数和退出条件 | | 用户信息不足 | 先澄清,不猜测日期或场次 | 落到训练文件时,还要按所用工具核对消息字段、工具参数说明(schema)、调用与返回的对应关系,以及哪些助手消息参与监督。可参考 [SFT 工具调用数据说明](https://huggingface.co/docs/trl/sft_trainer#tool-calling-with-sft)。**本章的单轮关键词清洗脚本不能直接校验这种多轮数据**,字段映射和聊天模板也需要相应验证。 如果用另一个模型起草轨迹,调用结果应由真实执行或明确标注的模拟环境核验,不能把生成的成功描述当作执行证据。后续评估还应分别检查工具是否选对、参数是否正确、结果是否被正确使用,见[第 32 章](32-微调效果评估与模型部署.md?id=finetuning-regression)。只训练关键词抽取,并不能证明模型已经学会这些行为。
继续本课主线时,仍使用单轮关键词数据;下面的文档问答也是独立扩展,不把三种任务混到同一次练习中。 --- ## 4、用 Easy Dataset 制作问答数据 **独立扩展:手里有文档,还没有问答样本时阅读。** 继续关键词主线的读者,可直接进入[第 5 节“关键词数据清洗与划分”](29-微调数据准备与对话模板.md?id=keywords-cleaning)。本节制作的问答仅用于数据制作练习,不混入后续关键词训练。 假设你要为“青禾文档台”制作客服问答数据,现在手里只有一份产品说明。下面用 Easy Dataset 从说明中生成问题和答案,对照原文审核,最后导出一份 JSONL 文件。 这是一个虚构产品。以下使用 Easy Dataset 1.7.3 演示,随附结果包含 6 条审核后的问答;自己跟做时,生成的问法和数量可能不同。 ### 4.1 文档准备与任务说明 在本地课程目录中找到并阅读 `案例与源码-4-微调/document-qa-demo/product-manual.md`,稍后将这份文件上传到 Easy Dataset。 文档只有成员管理、文件上传、删除恢复、任务导出和汇总通知五部分。跟做时只需准备这一份文档,问题和答案会在 Easy Dataset 中生成。 以扫描件的上传要求为例,我们希望从文档中整理出这样的问答: ```text 问题:扫描版 PDF 上传前需要做什么? 答案:先完成 OCR,检查识别出的文字是否准确,再上传处理。 ``` 换成自己的文档时,先去掉重复页眉、导航等无关内容,保留数值、单位、权限和例外条件。扫描件先做 OCR 并检查文字;内部资料还需确认是否允许发送给所用的模型服务。 ### 4.2 创建项目并配置模型 **先打开工具。** 本节使用 Easy Dataset 1.7.3 的浏览器界面。已有工具可直接创建项目;首次使用可从[官方发布页](https://github.com/ConardLi/easy-dataset/releases/tag/1.7.3)选择适合自己系统的桌面客户端,或按下面的步骤从源码运行。
首次安装:从源码构建并启动浏览器界面 先确认本机已安装 Git、Node.js 和 npm,在准备存放工具源码的位置打开终端。 下面按 [Easy Dataset 官方安装说明](https://github.com/ConardLi/easy-dataset/blob/1.7.3/README.zh-CN.md#本地运行)安装 `1.7.3` 标签的源码。示例环境为 macOS(Apple Silicon)、Node.js `20.20.2`、npm `10.8.2`;先用 `node -v`、`npm -v` 查看自己的版本。 ```bash git clone --branch 1.7.3 --depth 1 https://github.com/ConardLi/easy-dataset.git cd easy-dataset git describe --tags --exact-match npm install ``` 依赖安装完成后,执行构建: ```bash npm run build ```
排错:Mac 首次构建提示 Schema engine error 如果首次初始化数据库时只显示 `Error: Schema engine error:`,可以在同一目录开启数据库引擎日志后重试: ```bash RUST_LOG=info npm run build ``` `RUST_LOG=info` 设置数据库引擎的日志级别,便于获取更多报错信息;它不是数据库修复开关。重试后仍然失败时,根据新的日志排查,不要反复执行或删除已有数据库。
构建成功后,再启动服务: ```bash npm run start -- --hostname 127.0.0.1 ``` 终端出现 `Ready` 后,保持终端运行,在同一台电脑的浏览器打开 [http://127.0.0.1:1717](http://127.0.0.1:1717)。`--hostname 127.0.0.1` 让这套练习服务只接受本机连接。
**再创建项目。** 创建“青禾文档台 · 文档问答练习”项目,在描述中写清资料来源和用途。 ![创建项目:填写练习名称、资料来源和用途](images/29/29-4-2-1.jpg) 点击页面顶部的 **「更多 → 项目设置」**,再切换到 **「模型配置」**,填写服务提供的接口地址、API Key 和模型 ID。保存后,打开 **「更多 → 模型测试」**,选中刚配置的模型,发送一个简单问题。 ![Easy Dataset 顶部更多菜单中的项目设置与模型测试入口](images/29/29-4-2-2.jpg) 测试时选中已配置的模型,收到正常回答后再继续制作数据。若报鉴权失败、模型不存在或连接失败,先修正接口配置。 这里配置的模型负责生成问答草稿,可以与后续微调的模型不同。API Key 不要放进截图或课程文件;生成费用按所用服务计收。没有可用接口时,可以先对照随文结果学习。 ![模型测试:选中已配置的模型并确认接口能够正常返回回答](images/29/29-4-2-3.png) 图中的接口类型与模型名称仅用于演示配置位置。`OpenAI` 标签表示接口类型,不等于模型由 OpenAI 提供;跟做时填写自己服务支持的模型 ID。收到回答只能确认接口能用,生成的问答仍要对照原文审核。 ### 4.3 导入文档并检查分块 打开顶部的 **「数据源 → 文件处理」**,在「上传新文件」区域点击「选择文件」,选中 `product-manual.md`,再点击「上传并处理文件」。 ![选择 product-manual.md 后,点击上传并处理文件](images/29/29-4-3-1.jpg) 工具会把文档处理成供模型阅读的**文本块**,也就是一段相对完整的资料。处理完成后,右侧出现已上传的文档,下方显示文本块 `product-manual-part-1`,页面计数为 471 字。 点击文本块卡片右下角的**蓝色眼睛图标**,鼠标停上去会显示「查看详情」,点击后可以阅读处理后的完整正文。 ![文本块卡片右下角的蓝色眼睛图标,悬停提示查看详情](images/29/29-4-3-2.jpg) 此处先看“查看详情”入口。首次导入后,卡片可以尚无问题;图中的“已生成 6 个问题”属于后续生成状态,不是本步骤的完成条件。 ![文本块详情:检查成员上限、文件大小和恢复条件是否保留](images/29/29-4-3-3.jpg) 这份说明很短,五部分内容保留在同一个块里即可。长文档则尽量按完整小节拆分,别把“支持 PDF”和“单文件不超过 20 MB”等关联条件拆散,否则生成的答案容易漏掉限制。 ### 4.4 生成问题和答案 打开 **「更多 → 项目设置 → 任务配置」**,找到「问题生成设置」,将第一个滑块调整到 **「100 个字符生成一个问题」**,将下方的 **「并发限制数量」设为 2**,最后到页面底部点击「保存任务配置」。 ![任务配置:100个字符生成一个问题,并发限制数量为2](images/29/29-4-4-1.jpg) 问题生成密度用于控制希望生成多少问题;并发为 2 表示最多同时处理两项任务。实际使用时,可根据文档长度和模型服务的限制调整。 回到文本块列表,勾选 `product-manual-part-1`,点击「批量生成问题」。进入「问题」页,可以查看生成的问题及其来源文本块。下面这 6 题分别涉及成员人数、文件限制、回收站、任务导出、邮件汇总和扫描件处理。 ![问题列表:六个问题及其来源文本块](images/29/29-4-4-2.jpg) 先删除重复或偏离文档的问题,再点击每题右侧的「生成数据集」,为问题生成答案。这里每题生成一次即可;任务尚未完成时先查看状态,不要连续重复点击。 ### 4.5 对照原文审核答案 进入「数据集 → 单轮问答数据集」,打开一条记录的「查看详情」,通过「文本块」入口回看原文。重点检查答案有没有改数字、漏条件,或添加没有依据的结论。例如,“最多 5 人,包含所有者”不能变成“所有者之外再加 5 人”。 下面这份扫描件问答草稿多写了一句: > ……才能确保后续的处理和问答能够正常进行。 原文只要求先做 OCR、检查识别文字、再上传,并没有作出这个保证。点击答案旁的编辑图标,将答案改为: > 扫描版 PDF 上传前,先完成 OCR(光学字符识别),检查识别出的文字是否准确,再上传处理。 保存后点击「确认保留」。修改后的答案如下: ![答案详情:删去没有依据的保证,保留原文要求的处理步骤](images/29/29-4-5-1.jpg) 其他答案也按同样方式核对。完成后回到列表,本例 6 条问答都显示「已确认」,可以进入导出步骤。 ![审核后的完整列表:六条问答均显示已确认](images/29/29-4-5-2.jpg) “已确认”是人工审核状态,不是自动质量评分。正式业务数据应由熟悉业务的人核对。 ### 4.6 导出并检查问答数据 点击数据集列表上方的「导出」,选择 `JSONL` 和 `ShareGPT`,勾选「仅导出已确认数据」,取消「包含思维链」,系统提示词先留空。本例只保留问题和审核后的答案,不导出模型生成答案时的分析文字。 ![导出设置:JSONL、ShareGPT,仅导出已确认数据,不包含思维链](images/29/29-4-6-1.jpg) 点击「确认导出」,浏览器会下载一个 `.jsonl` 文件。课程保存的 `案例与源码-4-微调/document-qa-demo/product_qa_reviewed.jsonl` 可供对照。 在编辑器中打开文件。本例共 6 行,每行是一组问答;为了看清字段,下面将扫描件这一行展开显示,文件中仍是一行一条记录: ```json { "messages": [ { "role": "user", "content": "扫描版PDF在上传处理前需要完成哪些操作?" }, { "role": "assistant", "content": "扫描版 PDF 上传前,先完成 OCR(光学字符识别),检查识别出的文字是否准确,再上传处理。" } ] } ``` 这里的 `messages` 保存一组对话,`role` 表示角色,`content` 保存内容:`user` 对应问题,`assistant` 对应审核后的答案。与关键词文件的 `conversations` 相比,消息列表的字段名不同,里面仍然是角色和正文;交给训练工具时,需要登记实际使用的字段名。 导出后检查三件事: 1. **条数是否对应。** 本例确认保留了 6 条,文件中也应有 6 条;自己跟做时,以实际保留的数量为准。 2. **问答是否完整。** 每条记录都有问题和答案,角色没有写反,内容没有空缺。 3. **修改是否保存。** 找到刚才修改的扫描件答案,确认文件里是修改后的文字,没有未保存的旧答案,也没有额外的思维链内容。 如果文件还是修改前的答案,回到工具中检查是否保存、确认了该条记录,再重新导出;条数不符时,检查「已确认」状态和导出筛选条件。 至此,文档问答练习的产物是审核后的 JSONL。继续本课时,回到关键词 small 文件完成下一节;这份问答文件单独保留,后续关键词训练仍使用关键词数据。 --- ## 5、关键词数据清洗与划分 按照第 2 节的标注规则整理关键词样本,再把它们分成训练、验证和测试三份。本节的数据处理在本机完成。 ### 5.1 常见问题与处理方法 **数据清洗,就是把不适合直接训练的记录整理好。** 能确定的格式错误可以批量修正;答案内容有问题,则要对照输入重新标注。不能修正、又无法确认的记录,先不放进训练数据。 下面用几个教学示例说明处理方法: | 问题 | 示例 | 处理方法 | | ---------------------------- | -------------------------------------- | ---------------------------------------- | | 多余前缀、中文分号和尾部分号 | `关键词:图书馆;阅读课;` | 改为 `图书馆;阅读课`,保留关键词内容 | | 同一答案重复列词 | `图书馆;阅读课;图书馆` | 删除重复词,保留 `图书馆;阅读课` | | 输入或答案为空 | 有 `user`,但 `content` 没有正文 | 核对来源,补齐后审核;无法补齐则暂不使用 | | 答案缺少依据 | 输入只讲儿童阅读课,答案却有“成人培训” | 按当前输入重新标注,不能只修分号 | 第 2 节已经讲过内容审核。这里要特别区分两种“重复”:上表第二行是在**一个答案中重复列词**;下面则是**同一条样本出现多次**。 ```text 输入 A → 图书馆;阅读课 输入 A → 图书馆;阅读课 ``` 相同输入、相同答案,保留一条即可。如果同一输入对应的答案不同,就不能直接按重复记录删除: ```text 输入 A → 图书馆;阅读课 输入 A → 图书馆;公众号预约 ``` 这叫**答案冲突**。可能是某份标注漏了内容,也可能是两种表达都合理,需要结合文章和选词规则判断。课程脚本遇到这种情况会停止,不会随便留下第一条。 ![关键词样本先检查结构和格式,再处理重复和冲突,随后划分训练验证测试集并登记到训练工具](images/29/29-5-1-1.svg) 这些处理应在划分之前完成,否则同一道题可能同时进入训练集和测试集。清洗与后续评分共用格式检查规则;关键词内容仍需按第 2.2 节的方法对照原文审核。 ### 5.2 训练集、验证集和测试集 第 28 章介绍过三份数据的用途。放到关键词练习中,可以把它们理解为“练习、模拟考试、期末考试”: | 集合与文件 | 类比 | 是否更新参数 | 怎样使用 | | ---------------------------------- | -------------------- | ------------ | ---------------------------------- | | 训练集 `keywords_train.jsonl` | 日常练习册 | 是 | 让模型学习关键词抽取 | | 验证集 `keywords_validation.jsonl` | 备考期间的模拟考试 | 否 | 比较配置、观察表现、选择检查点 | | 测试集 `keywords_test.jsonl` | 最后才拆封的期末考试 | 否 | 方案确定后,比较原始模型与微调模型 | 三份文件都保留参考答案。**checkpoint(检查点)** 是训练时保存的阶段存档,例如训练一轮、两轮后分别保存一个版本,再用验证集比较哪个更合适。 #### 5.2.1 泛化与过拟合 我们训练模型,不是为了让它只会回答这 1,600 条文章,而是希望以后换一篇同类文章,它也能按要求抽取关键词。这种把学到的规律用到未参与训练的新输入上的能力,叫作**泛化能力**。 沿用第 1 节的图书馆例子。假设模型练习过第一篇文章,现在用第二篇检查它。下面是教学示例,不是课程数据或模型实测结果: | 用途 | 文章 | 参考关键词 | | ------------------ | ---------------------------------------------------- | ---------------------------------- | | 训练时练习 | 市图书馆周末开设儿童阅读课,读者可通过公众号预约。 | `市图书馆;儿童阅读课;公众号预约` | | 换一篇同类文章检查 | 区图书馆暑假举办少儿科普讲座,家长可在小程序中报名。 | `区图书馆;少儿科普讲座;小程序报名` | 两篇都要求抽取关键词,但活动、参与方式变了。模型需要根据新文章选词,不能照搬“儿童阅读课”和“公众号预约”。如果它能在多篇这样的新文章上抓住主题、遵守分号格式,才说明学到的做法能用于新输入。 **过拟合**则是模型过分贴合训练样本,在没有参与训练的同类数据上表现不好。可以类比成反复刷熟一套题,原题答得很好,考查内容相同、条件稍有变化的新题却不会做。 例如,继续训练后,模型对练习过的文章选词更准确了,对留出的新文章却经常漏掉主题、带入训练题中的词。如果这种情况在多条样本上持续出现,就需要警惕过拟合,而不能只看练习题答得越来越好。 不过,**一道新题答错不等于过拟合**。参考答案有误、文章被截断,或者新文章明显超出了训练数据覆盖的范围,也可能导致回答不好。需要结合多条样本和训练过程判断,不能看到一个错误就认定“训太多了”。 这也解释了验证集为什么要留在训练集之外:训练过程中用它观察模型处理新文章的表现,再决定是否继续训练、选择哪个阶段的存档。具体怎样结合训练与验证曲线判断,见[第 30 章“过拟合的判断与处理”](30-模型训练原理与高效微调.md?id=_931-过拟合的判断与处理)。 #### 5.2.2 数据泄漏 **不要让测试题混进训练集。** 完整关键词文件包含 small 中的样本,因此不能“用完整文件训练,再用 small 测试”。测试题已经被练过,这是一种**数据泄漏**,分数不能代表模型处理新文章的能力。 验证集也一样:用来检查的文章如果已经参与过训练,就不能再把它的表现当作处理新文章的证据。过拟合说的是模型学得怎样,数据泄漏说的是检查过程出了问题;两者不是同一件事,数据泄漏还可能掩盖模型在新文章上的问题。 同一篇文章换一种问法,也不一定是独立的新材料。课程脚本只比较合并连续空白后的完整输入,不能识别所有近似样本。对于第 4 节那类文档问答,应按来源文档分组,同一文档的关联问答不要随意拆到训练和测试两边。 本例按 `80% / 10% / 10%` 划分,比例可以根据任务调整。如果反复根据测试结果修改参数,测试集也参与了开发,之后需要另备独立测试数据。 ### 5.3 运行数据处理脚本 现在使用 `prepare_keywords_dataset.py` 完成关键词数据的检查、清洗与划分。 脚本按顺序完成: 1. 检查 JSON、`conversations`、`user → assistant` 顺序以及非空内容。 2. 统一关键词前缀、分号、首尾空白,去掉空项和重复关键词。 3. 按输入去重;同一输入对应不同答案时停止,交给人工核对。 4. 对处理后的样本进行固定划分,并检查三份数据的输入互不重复。 在代码编辑器中打开课程项目,在**项目根目录**新建终端,进入案例目录并确认 Python 为 3.10 或以上版本: ```bash cd "案例与源码-4-微调" python3 --version ``` 如果终端已经位于案例目录,就不必再次执行 `cd`。接着运行: ```bash python3 prepare_keywords_dataset.py \ --source keywords_data_sharegpt_small.jsonl \ --seed chapter-29-v1 \ --output-dir processed/keywords-clean-repro ``` | 参数 | 作用 | | -------------- | -------------------------- | | `--source` | 指定要处理的关键词文件 | | `--seed` | 固定分组所用的种子 | | `--output-dir` | 指定一个尚不存在的结果目录 | **种子**可以理解为分组时使用的约定值。数据、处理规则和种子都不变时,每条输入的排序与分组才会保持一致。本例使用 `chapter-29-v1` 作为固定种子,跟做时保持这个值即可。 本次练习另存到 `keywords-clean-repro/`,让你核对自己完成的处理过程。课程后续训练示例固定使用附带的 `keywords-clean/`,两者的用途在下一节对照。脚本遇到已存在的输出目录会停止,避免误覆盖。 脚本使用本机 Python 处理文件,无需联网或显卡。它只适用于单轮**关键词数据**,不能拿第 4 节的自然语言问答按分号规则清洗。 ### 5.4 查看处理结果 正常完成后,终端会列出三份数据的条数。主要输出如下: ```text keywords_train.jsonl: 1600 条 keywords_validation.jsonl: 200 条 keywords_test.jsonl: 200 条 ``` ![关键词数据处理结果图解:1600 条训练数据、200 条验证数据和200条测试数据](images/29/29-5-4-1.svg) 这是一张处理流程图,展示脚本与三份数据、配套报告的关系。运行时使用第 5.3 节写明种子的完整命令。 在编辑器中展开 `processed/keywords-clean-repro/`,检查生成的六个文件: - **三个 JSONL** 是实际数据。分别打开一条,仍能看到 `user` 输入和 `assistant` 参考答案,格式并没有因为划分而改变。 - **`dataset_info.json`** 是数据集登记表,供第 31 章的 LLaMA-Factory 读取。 - **`cleaning_report.json`** 保存自动修改和待检查项目;**`manifest.json`** 保存来源、划分规则和条数,供核对处理结果时查阅。 如果脚本中途停止,按报错检查: | 提示或现象 | 处理方法 | | ------------------------------ | ---------------------------------------------------------------- | | 找不到输入文件 | 检查终端所在目录和 `--source` 路径 | | JSON、角色顺序或空内容错误 | 打开提示的行,修正样本结构与内容 | | 相同输入的答案冲突 | 对照输入审核答案,不让脚本替代判断 | | 只生成清洗报告,没有三个 JSONL | 查看报告中的 `review_required`,修正剩余格式问题后另存新目录重试 | | 输出目录已存在 | 换一个新目录名,避免覆盖已保存的结果 | 脚本完成只说明通过了这些结构、格式和重复检查,不代表每条答案都经过人工审核。换用自己的数据时,还应抽查文章与关键词是否对应、同源或近似样本是否跨组。 **自己的处理结果怎样接到后面?** 先按当前练习选择文件,避免把不同版本混在一起: | 当前在做什么 | 使用哪份产物 | 下一步 | | -------------- | -------------------------------------------- | ---------------------------------------------------------------------------- | | 学习清洗与划分 | 自己生成的 `processed/keywords-clean-repro/` | 核对三份数据的条数、样本、清洗报告和划分记录,确认自己完成了哪些检查 | | 复现本课程训练 | 附带的 `processed/keywords-clean/` | 第 31 章上传这一目录;训练用 train、过程检查用 validation,第 32 章再用 test | | 改用自有数据 | 审核后另存的新数据版本及配套登记表 | 按第 31 章登记自己的文件,训练与评估始终对应同一版划分;新实验单独保存 | 两个目录名称不同,本身不能证明内容相同。若要用自己的复算数据替代课程数据,应先对照处理规则、三份 JSONL 和登记内容;不要只看总条数。预测结果另外保存,参考答案继续留作比较依据。 --- ## 6、对话模板与模型输入 上一节得到的数据仍是一条条 `user` 输入和 `assistant` 参考答案。接下来看:**训练工具读取这些消息后,怎样把它们交给模型。** ### 6.1 对话模板的作用 继续用第 1 节的图书馆例子。我们能通过 `role` 分清哪段是用户的问题、哪段是助手的答案,模型也需要识别这些边界。 **Chat Template(对话模板)**就是组织消息的规则:怎样标出用户消息的开始和结束,怎样标出助手回答的位置。不同模型使用的规则可能不同,因此训练工具需要选择与模型匹配的模板。 这个概念并不只存在于代码里。第 31 章要使用的 LLaMA-Factory 页面,就有一个“对话模板”选项: ![真实 WebUI 局部截图:模型路径 Qwen/Qwen3-0.6B 与对话模板 qwen3_nothink 分别决定加载的模型和消息组织方式](images/29/29-6-1-1.svg) **模型路径决定加载哪份模型,对话模板决定怎样组织消息。** 它与[第 13 章的提示词和消息模板](13-提示词与消息模板.md)分工不同:之前是在填写任务说明、变量和对话内容;这里是按模型要求,给消息加上角色边界。 ### 6.2 查看模板与转换结果 **先找到模板规则。** 第 28 章介绍过模型目录中的权重、配置和分词器文件。以本课程的 `Qwen/Qwen3-0.6B` 为例,打开 `tokenizer_config.json`,搜索 `chat_template`,就能找到模型发布者提供的对话模板。 暂时没有下载模型,也可以打开[官方模型文件页](https://huggingface.co/Qwen/Qwen3-0.6B/blob/c1899de289a04d12100db370d81485cdf75e47ca/tokenizer_config.json),用浏览器查找 `chat_template`。对照下图找到文件名和模板字段: ![Qwen3-0.6B 官方模型文件截图:tokenizer_config.json 文件位置与第 230 行 chat_template 字段](images/29/29-6-2-1.svg) 这一项保存了不同角色和条件的处理规则,由工具读取使用。 **再看同一条消息转换前后有什么变化。** 下面使用模型自带的官方模板处理第 1 节的图书馆教学样本,关闭思考模式,观察消息的组织方式。 ![图书馆教学样本的转换对照:role/content 消息经 Qwen3 官方模板加入角色边界,参考答案内容不变](images/29/29-6-2-2.svg) 对照左右两边,文章和关键词答案都还在,变化主要是消息的边界表示: - `<|im_start|>user`:用户消息开始,后面接文章与任务说明。 - `<|im_end|>`:这一条消息结束。 - `<|im_start|>assistant`:助手消息开始,后面接参考答案。 这里的关键词来自样本中的 `assistant.content`;图中的空 `` 区块由官方模板添加。**模板负责组织已有消息,答案质量仍由数据审核保证。**
遇到回答不结束时再看:消息边界、思考结束与 EOS 还要区分两种“结束”:`` 表示思考区结束,后面仍可继续写答案;消息结束标记则用于划分消息。推理程序还需要配置生成停止条件,识别何时结束助手的输出。常见的 **EOS(End of Sequence,序列结束标记)**以 token 编号参与这项判断,具体编号和用途要与模型、模板及推理引擎对应,不能把 `` 直接当成回答结束。第 32 章再结合[重复输出与生成停止](32-微调效果评估与模型部署.md?id=_24-从单条观察到批量测试)检查实际现象。
**本图用官方模板说明转换过程;实际训练以训练工具的预处理结果为准。** 第 31 章使用 LLaMA-Factory 的 `qwen3_nothink`,与官方模板的处理可能不同,不能直接沿用本图的 token 数量。第 30 章第 4.2 节会带你核对实际输入。 **最后,把文字变成编号。** 前面提到的 **Tokenizer(分词器)**会把文本和标记转换为模型可以计算的编号。每个基本单位叫 **Token(词元)**,不一定对应一个汉字。 例如,用同一份 Qwen3 分词器单独处理“市图书馆”,得到: | 分词后可读的内容 | 对应编号 | | ---------------- | -------- | | 市 | `22697` | | 图书馆 | `106036` | 四个汉字在这个例子里是两个 token,对应输入编号 `[22697, 106036]`。`<|im_start|>` 这样的特殊标记也有自己的编号。`input_ids` 指的就是模型的输入编号序列。 模型输入的转换过程是:**从 JSONL 读出消息 → 按模板组织消息 → 转成 token 编号。** 第一环节还需要告诉工具去哪个字段找消息,这叫字段映射;第 31 章登记数据集时再实际填写。后两步通常可以由工具一起完成,不需要另外保存一份中间文本。 ### 6.3 训练与推理的输入区别 同一条图书馆消息,准备训练样本和实际向模型提问时,输入并不相同: | 对比项 | 准备训练样本 | 准备一次推理 | | -------------- | ---------------------------------- | ---------------------------- | | 提供哪些消息 | `user` 输入和 `assistant` 参考答案 | 只提供 `user` 输入 | | 助手位置放什么 | 已有的参考答案及结束标记 | 回答的起始位置,等待模型续写 | 前面的用户文章相同,重点比较**助手部分的末尾**。下面两段都是官方模板的实际处理结果;显示出来的空行也是模板的一部分。 训练样本包含参考答案: ```text <|im_start|>assistant 市图书馆;儿童阅读课;公众号预约<|im_end|> ``` 推理输入停在准备回答的位置: ```text <|im_start|>assistant ``` 模型接下来才从这里生成关键词。**实际提问时,不能先把参考答案塞进输入,再把后续输出当成模型独立答对的结果。**
代码复现:打印模板结果与分词编号 完成[第 31 章的环境准备与模型下载](31-LLaMA-Factory环境搭建与微调实战.md?id=_51-模型与微调方式)后,可运行下面的代码查看模板输出。 在 **AutoDL 的 JupyterLab 文件面板**中打开 `/root/autodl-tmp/LLaMA-Factory/`,新建文本文件并命名为 `preview_chat_template.py`,将下面的 Python 代码粘贴进去并保存。把 `model_dir` 换成下载完成时返回的实际目录,该目录需要包含 `tokenizer_config.json` 和分词器文件。下面只加载分词器,不加载模型权重,也不启动推理或训练。 ```python from pathlib import Path from transformers import AutoTokenizer model_dir = Path("/root/.cache/modelscope/models/Qwen--Qwen3-0.6B/snapshots/master") tokenizer = AutoTokenizer.from_pretrained(model_dir, local_files_only=True) # 只读取本地分词器文件 messages = [ { "role": "user", "content": "市图书馆周末开设儿童阅读课,读者可通过公众号预约。\n" "请提取关键词,只输出关键词,并使用英文分号分隔。", }, {"role": "assistant", "content": "市图书馆;儿童阅读课;公众号预约"}, ] for name, chat, generation_prompt in [ ("训练样本", messages, False), ("推理输入", messages[:1], True), ]: text = tokenizer.apply_chat_template( chat, tokenize=False, # 返回模板处理后的文字,方便观察消息边界 add_generation_prompt=generation_prompt, # 推理时补上助手回答的起始位置;训练样本不补 enable_thinking=False, # 关闭思考模式 ) token_ids = tokenizer.apply_chat_template( chat, tokenize=True, # 将模板处理后的文字转换为 token 编号 return_dict=False, # 直接返回编号列表,便于用 len() 统计长度 add_generation_prompt=generation_prompt, enable_thinking=False, ) print(f"\n{name},共 {len(token_ids)} 个 token:") print(text) ids = tokenizer.encode("市图书馆", add_special_tokens=False) # 不额外添加特殊标记,只观察短语本身 print("短语编号:", ids) print("逐个解码:", [tokenizer.decode([token_id]) for token_id in ids]) ``` 保存后,新开一个 **AutoDL 的 JupyterLab 终端**,执行: ```bash cd /root/autodl-tmp/LLaMA-Factory source .venv/bin/activate python preview_chat_template.py ``` 终端会依次打印「训练样本」「推理输入」和短语的分词结果。若提示找不到文件,检查 Python 文件的保存目录;若找不到分词器,核对 `model_dir`。 同一组消息调用两次模板:第一次看文字,第二次看编号。`return_dict=False` 明确要求返回列表,因此 `len(token_ids)` 统计的是 token 数量。参数说明见 [Transformers 官方文档](https://huggingface.co/docs/transformers/main/en/main_classes/tokenizer#transformers.PreTrainedTokenizer.apply_chat_template)。 **示例条件:** Transformers `4.57.6`、Qwen3-0.6B [版本 `c1899de` 的官方分词器文件](https://huggingface.co/Qwen/Qwen3-0.6B/tree/c1899de289a04d12100db370d81485cdf75e47ca)。图书馆样本的训练输入为 51 个 token,推理输入为 40 个 token,均包含文章与模板标记;空 `` 区块由该官方模板在关闭思考时加入。 第 31 章使用 Transformers `5.8.0`,运行时以自己加载的分词器和输出为准,不必为对齐这里的数字更换训练环境。官方模板演示与工具训练输入的区别见第 6.2 节;实现细节可查 [LLaMA-Factory 模板源码](https://github.com/hiyouga/LLaMA-Factory/blob/dced5f8804bfbf7109ef7c14401db6bd5cce7e53/src/llamafactory/data/template.py)。 如果想观察课程里的真实样本,可以在循环之前,用下面代码替换教学用的 `messages`,其余部分保持不变: ```python import json data_file = Path( "/root/autodl-tmp/LLaMA-Factory/data/keywords-clean/keywords_train.jsonl" ) with data_file.open(encoding="utf-8") as source: record = next(json.loads(line) for number, line in enumerate(source, 1) if number == 484) messages = record["conversations"] ``` 这条记录是第 1 节图片展示的“高氟铍矿石”样本,在 small 文件中位于第 1 条,划分后位于课程训练集第 484 条。上述固定模板下,训练输入为 139 个 token、推理输入为 121 个 token。
### 6.4 模板选择与注意事项 后续关键词练习在 LLaMA-Factory 中选择 `qwen3_nothink`,并关闭思考设置。先完成下面三项检查;实际回答是否符合要求,到第 32 章再验证。 1. **模型与模板要匹配。** 更换模型后重新核对模板,训练与推理时保持匹配。 2. **JSONL 中保留正常消息。** 不要把上面打印的整段模板文本塞回 `user.content`,也不要手工补上角色标记,否则工具处理时可能重复包装。 3. **检查训练工具的实际输入。** 训练前检查预处理后的长度、角色和答案位置,方法见[第 30 章“检查实际训练长度”](30-模型训练原理与高效微调.md?id=_42-检查实际训练长度)。 关闭思考设置仍不保证没有分析段。课程固定版本中,两种模板添加空思考区块的方式不同;遇到这一现象,再读[第 32 章的模板对照](32-微调效果评估与模型部署.md?id=_24-从单条观察到批量测试),无需在本章先排查推理细节。 --- **章节思考题:** 1. JSON 和 JSONL 在文件保存方式上有什么区别?把一个样本展开成十几行展示,保存时就变成了十几条训练数据吗? **参考思路:** JSON 表示一个完整的 JSON 值;JSONL 则要求每个非空物理行分别是一个完整 JSON 值,本课每行保存一个样本对象。讲解时展开换行仍是同一个样本,写入本课 JSONL 时应放回一条物理行;消息内部的换行用转义形式保存,不能按展示行数计算样本数。 2. 同一条“文章 → 关键词”样本使用 Alpaca 和 ShareGPT 保存时,任务要求、文章和参考答案分别放在哪里? **参考思路:** 本课 Alpaca 示例将任务要求放在 instruction、文章放在 input、参考答案放在 output。ShareGPT 示例将任务与文章放在 user 消息,把参考关键词放在 assistant 消息,并用 conversations 列表组织消息。改变的是组织方式,任务与答案不变;多轮消息仍应保持在同一条样本的对话中。 3. 登记表中的字段映射、Chat Template 和 Tokenizer 分别负责什么?一份能解析的 ShareGPT 数据怎样成为模型输入? **参考思路:** 字段映射告诉训练工具去哪里读消息、怎样识别角色;Chat Template 按模型要求组织角色标记、内容和对话边界;Tokenizer 再把文本转换成 token 编号。文件能解析只完成了读取的前提,还要确认角色映射正确、模板与模型匹配,以及转换后的输入符合预期。 4. 训练时会提供参考关键词,独立推理时应提供哪些内容?怎样检查自己没有把答案提前放进输入? **参考思路:** 训练序列包含任务、文章和助手参考答案,用于后续计算学习目标。独立推理只提供需要的任务与上下文,在助手待回答的位置开始生成,参考答案另存用于比较。检查第 6.3 节展示的转换结果,确认推理输入没有参考关键词,也没有把已经套好的模板再次包装进用户消息。 5. 图书馆原文写的是儿童阅读课,参考答案却写成“市图书馆;成人培训”。分号正确,为什么仍要修订?两位标注者对“公众号预约”是否拆开有分歧时怎样处理? **参考思路:** “成人培训”没有原文依据,属于内容错误;分隔符正确不能弥补它。短语拆分要按第 2.3 节的标注规则统一口径,说明本例整体保留的依据,再复查相关样本。脚本适合检查结构和格式,专业含义与标注分歧仍需人工审核。 6. 训练集、验证集和测试集分别用于什么?比较训练一轮还是三轮时用哪份数据,最终检查又用哪份? **参考思路:** 训练集参与参数更新,验证集用于比较训练方案和选择检查点,测试集用于方案确定后的独立检查。本例按 80%/10%/10% 划分,但比例要随任务确定。若测试结果已经被反复用于开发,应另备未参与选择的数据,不能靠重新随机划分恢复其独立性。 7. 同一篇文章改写出两条不同问法,一条进入训练集,另一条进入测试集,为什么精确去重仍可能发现不了泄漏? **参考思路:** 精确去重只能识别其规则覆盖的重复,问法不同可能使两条记录不再相同,但它们仍共享来源和答案信息。应按原文或关联材料分组划分,再检查集合交叉。本课完整数据与 small 文件也有重叠,不能分别当作训练集和独立测试集。 8. 训练数据大多是活动通知,而验证时农业摘要经常漏掉品种名,下一批数据应怎样准备? **参考思路:** 先对照原文确认错误,检查农业主题、完整名称、长文本等场景是否缺少可靠示范,再补充经过审核的相关样本。若名称标注本身有分歧,先统一规则;重复增加同类通知并不能补齐这些缺口。数据修改后,用验证结果检查目标错误是否减少。 9. 清洗、划分完成后,应交给后续训练哪些文件?怎样说明这批数据已处理什么、还有什么待检查? **参考思路:** 交接训练、验证、测试三份 JSONL,配套登记表、清洗报告和 manifest。核对文件位置、条数、划分记录、重复与集合交叉,抽看实际样本,并说明自动检查范围、人工审核结果和待处理项。文件生成成功只能证明流程产出了文件,不能证明所有答案都已通过语义审核。
选读练习:文档问答与工具调用 1. 用 Easy Dataset 从文档制作问答,为什么要经历“检查分块 → 生成问答 → 对照来源审核 → 导出检查”? **参考思路:** 分块影响生成时能看到的上下文,生成结果可能遗漏限制条件或写错事实,所以要回到来源检查数字、条件和答案依据,保存修订后再导出。打开导出文件核对条数、角色和修改后的答案,确认审核结果确实进入了后续数据。 2. 工具调用训练样本与普通一问一答有什么不同?只有“查询成功,还有 6 个名额”这句回答,缺少了什么? **参考思路:** 还需用户上下文、工具说明、调用名称与参数、对应工具结果和后续回答;必要时包含澄清过程。工具结果应来自真实执行或明确标注且核验过的模拟环境,并覆盖无需调用、调用失败等情况。单轮关键词脚本不能直接校验这些消息之间的对应关系。
**本章小结:** - JSONL 规定每行保存一个 JSON 值,本课每行是一条样本;Alpaca 和 ShareGPT 则规定任务、输入、答案或消息怎样组织。文件格式与样本结构要分开理解。 - 训练答案既要能读取,也要有原文依据并符合标注规则。数据应覆盖实际任务的主题、长度和专业名称,格式清洗不能替代语义审核。 - 训练集用于参数更新,验证集用于选方案,测试集用于独立检查。清洗、去重和来源分组共同减少泄漏,精确去重不能发现所有同源近似样本。 - 字段映射帮助工具读取角色和内容,对话模板按模型要求组织文本,分词器将其转换为 token 编号。训练提供参考答案,独立推理只提供待处理内容与必要上下文。 - 清洗后保留三份数据、登记表、清洗报告和 manifest,并核对实际内容。文档问答需要对照来源审核,工具调用还需要检查请求、执行结果与后续回答的对应关系。 **建议下一步:** 对照第 5.4 节核查生成的文件,抽看三份数据,说明已处理什么、还有什么待审核。后续跟做使用正文约定的 `keywords-clean/`,自己的复现目录单独保留。带着这份数据说明进入[第 30 章](30-模型训练原理与高效微调.md),理解模型怎样利用这些答案更新参数。