展开阅读第 1 条完整记录(原字段与内容保留)
{
  "conversations": [
    {
      "content": "高氟铍矿石在熔炼过程中配入氢氧化铝来脱除其中的氟.结果表明,在配入5%Na2CO3、9.3%Al(OH)3、1400~1500℃熔炼20 min的情况下,BeO回收率达到96%以上,脱氟效果良好(铍玻璃F/BeO能控制在15%以内).为高氟铍矿石的工业应用探索出新的冶炼途径.\n找出上文中的关键词",
      "role": "user"
    },
    {
      "content": "高氟铍矿;配料;熔炼;回收率;脱氟率",
      "role": "assistant"
    }
  ]
}
这里只为阅读展开排版,保存为 JSONL 时仍是一条物理行,消息中的换行写作 `\n`。
**数据准备工作:**
从文章到训练文件,中间还有几件事:选取符合任务的文章、核对答案、修正格式、处理重复样本,再分出训练和检查时使用的数据。把这些工作连起来,就是微调中的**数据工程**,也就是本章要完成的数据准备。
## 2、数据来源与质量要求
### 2.1 数据来源与获取方式
微调数据的内容和答案形式应符合目标任务。
| 数据来源 | 适合做什么 | 常见问题 |
| ------------ | ------------------------------------ | -------------------------------- |
| 公共数据 | 入门练习,或作为与任务匹配的训练数据 | 可能与自己的任务无关 |
| 真实业务数据 | 让模型适应真实业务场景 | 原始格式常常混乱,答案也未必统一 |
| 合成数据 | 补齐稀缺场景、扩充边界样本 | 生成得快,但仍然需要检查答案 |
例如,要做企业内部制度问答,通用对话数据可以帮助模型学习问答形式,但“公司年假有多少天”仍需以本公司的制度为准。准备这类任务的数据时,可以结合企业制度、已有问答、客服工单和人工核对的标准答案。
如果真实样本不足,也可以围绕任务规则生成模拟样本,再抽样检查答案是否正确、是否符合业务要求。
#### 2.1.1 ModelScope 数据集查找
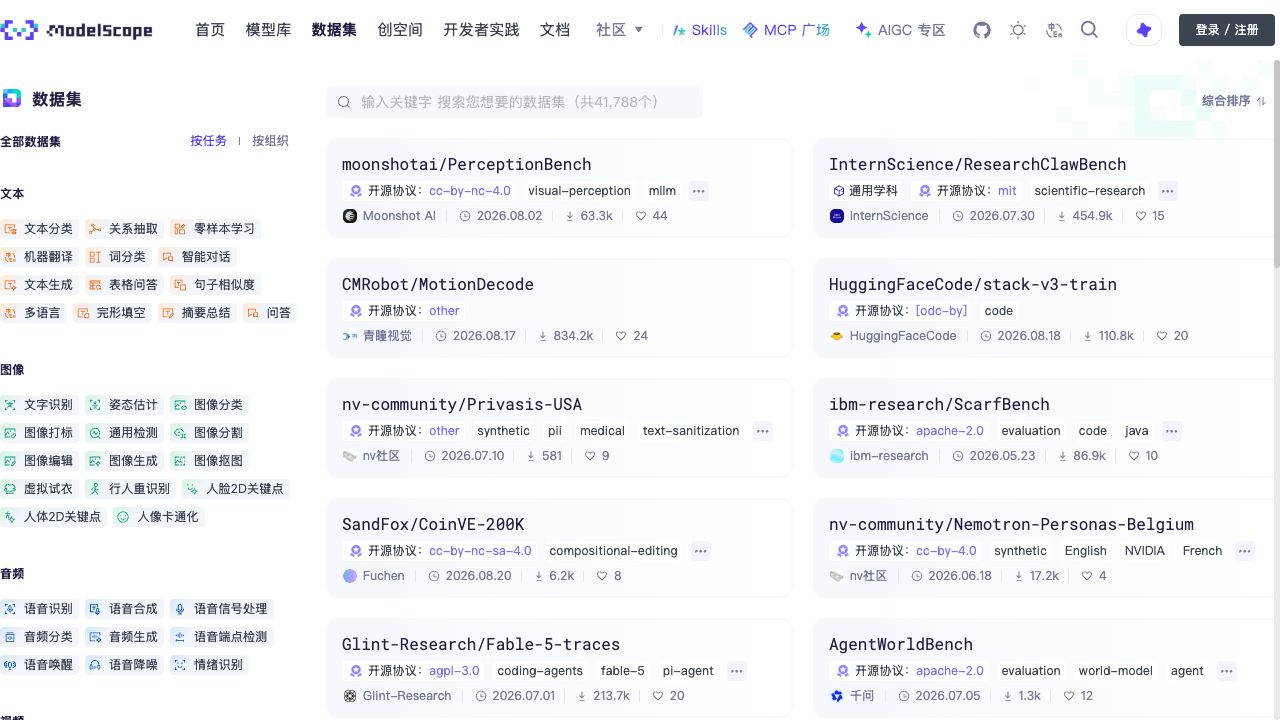
公共数据可以从 [ModelScope(魔搭社区)的数据集页面](https://modelscope.cn/datasets)查找。前面介绍的“模型库”用来找模型,“数据集”栏目则用来找训练或评测所需的数据,包含文本、图像、音频等类型。
如果已经知道数据集名称,可以在页面上方直接搜索;还没有具体目标时,可以先按左侧的任务分类浏览。例如,做对话或问答任务时,选择“文本”下的“智能对话”或“问答”,再从列表中查看相关数据集。
例如,打开 [Alimeeting4MUG 数据集](https://modelscope.cn/datasets/modelscope/Alimeeting4MUG),可以看到它面向中文会议场景,包含关键词抽取、摘要等任务。页面提供“数据集介绍”“数据预览”和“数据集文件”三个入口:
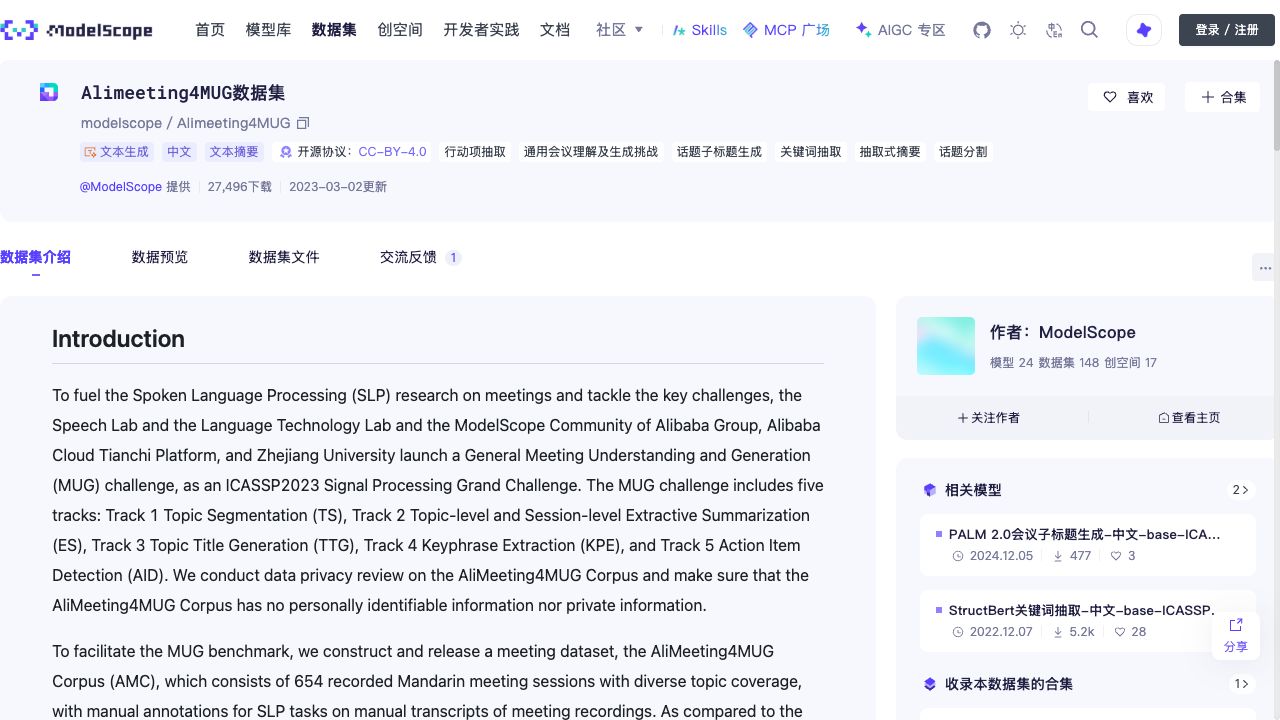
| 页面入口 | 重点看什么 |
| ---------- | -------------------------------------------------------------------------------------------- |
| 数据集介绍 | 数据从哪里来、使用什么语言、面向什么任务、怎样标注,以及使用许可是否符合自己的用途。 |
| 数据预览 | 直接查看几条输入和答案,判断文本内容、长度和答案形式是否合适。不是每个数据集都支持在线预览。 |
| 数据集文件 | 查看实际文件及其格式、大小,确认是否已有训练集、验证集或测试集,并按页面说明下载。 |
如果数据集没有在线预览,可以先阅读介绍页中的结构样例和加载说明,或下载少量数据检查,不必一开始就下载整套。下载后仍需清洗数据,并整理成后文介绍的 Alpaca 或 ShareGPT 等格式,才能接入本课程的训练流程。
#### 2.1.2 常用数据准备工具
当你开始处理自己的文档时,可以了解下面三个数据准备工具:
| 工具 | 能帮我们做什么 | 什么时候值得了解 |
| --------------------------------------------------------- | ------------------------------------------------------ | ---------------------------------------------------- |
| [Easy Dataset](https://github.com/ConardLi/easy-dataset/) | 通过界面导入文档、拆分内容、生成和编辑问答数据 | 想先把一份文档整理成可检查的问答样本 |
| [DataFlow](https://github.com/OpenDCAI/DataFlow) | 把数据提取、转换、清洗、筛选和生成等步骤组织成处理流程 | 文档较多,希望批量执行一套数据处理规则 |
| [GraphGen](https://github.com/InternScience/GraphGen) | 利用知识图谱中的实体及其关系,辅助生成训练数据 | 数据需要体现多个知识点之间的联系,可作为进阶工具了解 |
第 4 节的独立扩展用 Easy Dataset 完成“导入产品说明 → 生成问答 → 审核 → 导出”。DataFlow 和 GraphGen 可供批量处理与进阶练习时选用。
### 2.2 关键词标注的质量要求
怎样判断一份关键词答案能不能用?回到前面的教学文本:“市图书馆周末开设儿童阅读课,读者可通过公众号预约。”对照几种输出看看:
| 输出示例 | 检查结果 |
| -------------------------------- | ---------------------------------------------------- |
| `市图书馆;儿童阅读课;公众号预约` | 能概括主要对象、活动和参与方式,是本例的一份参考答案 |
| `图书馆;活动` | 没有说错,但过于笼统,丢掉了“儿童阅读课”这一主要信息 |
| `市图书馆;成人培训` | 格式没问题,但原文没有成人培训,内容不正确 |
| `关键词:市图书馆;儿童阅读课` | 内容与原文有关,但多出了任务不允许的前缀 |
检查一条样本时,可以按这个顺序来:先读原文,自己说出文章主要讲什么;再看参考答案是否抓住主题、有没有添加原文不支持的内容;最后检查分号、前缀和重复关键词。
这就是**内容质量与格式质量的区别**。分号、空项等问题可以交给脚本检查;关键词是否选得恰当,仍需要对照原文判断。专业文本中的名称拿不准时,应请熟悉该领域的人核对,不能只因为某个词看起来陌生就删掉。
关键词答案也不一定只有一种合理写法。例如,“公众号预约”可以看成一个参与方式,也可以拆成渠道与动作。但同一份数据中不能随意切换口径,下一节会约定本例采用哪种写法。
准备自己的数据时,先审核一小批,确认选词要求可执行,再扩大数量。如果某类文章经常漏掉主题,就补充这类文章及可靠答案;反复复制已经有的样本,并不能补上这个问题。
**还要检查:样本是否覆盖实际会收到的文章。** 假如训练材料全是图书馆活动通知,换成农业摘要后频繁漏掉品种名,首先要检查这类主题和名称是否得到充分示范。单纯增加更多活动通知,未必能解决问题。