# 30 - 模型训练原理与高效微调
---
**本章课程目标:**
- 能沿着一条样本解释 token 预测、Loss、梯度与优化器更新,分清输入上下文和直接监督的位置。
- 能计算 batch、梯度累积和 epoch 对有效批次与更新步数的影响,并解释学习率、预热和衰减的作用。
- 能说明训练显存的主要组成,分清数值精度与量化,理解序列长度、截断和梯度检查点的影响。
- 能比较全参数微调、LoRA 与 QLoRA,读懂 rank、alpha、target 和 dropout 的基本含义。
- 能把配置、训练与验证日志、检查点和实际回答联系起来,判断下一步应检查或调整什么。
**学习建议:** 先跟着分号例子讲清“预测 → 损失 → 梯度 → 更新”,再依次理解批次、学习率、长度、显存与 LoRA。第 8.1 节汇总一次完整训练安排,英文配置字段需要时再查;不用每学一个概念就重新读整张表。章末主线题按这个顺序自测,手算交叉熵与矩阵推导可以后看;读完后应能说明一份配置怎样安排训练,再进入第 31 章实操。
---
第 29 章已经准备好 1,600 条训练数据、200 条验证数据和 200 条测试数据。接下来,我们让 `Qwen/Qwen3-0.6B` 根据“文章 → 关键词”的示例,练习按要求提取关键词。
**先分清:训练设置、模型权重和观察结果。**
训练程序会根据文章和参考答案,调整模型内部参与计算的数值。这些数值叫作**模型参数,也叫权重**,由程序计算和更新。
我们填写的是**训练设置**:一次处理几条、整份数据练几遍、每次更新的幅度怎样控制。日常说“调训练参数”,通常就是修改这些设置。后文谈到“更新模型参数”,则是指程序改变内部权重。
程序还会计算 **Loss(损失值)**、记录训练进度,供我们观察。它们不需要预先填成某个目标数值;例如,“训练 3 轮”由我们设置,“现在完成了多少步”由程序记录。
**先认识五项设置。** 现在只看它们分别回答什么问题,具体变化在对应小节展开:
| 我们要决定的问题 | 训练设置 | 本课程安排 |
| ---------------------------- | ------------------------ | ----------------------------------- |
| 一次处理几条数据? | 批处理大小(batch size) | 每批 4 条 |
| 处理几批后更新一次模型参数? | 梯度累积步数 | 累积 8 批再更新 |
| 把整份训练数据练几遍? | 训练轮数(epoch) | 练习 3 轮 |
| 每次更新的步子有多大? | 学习率(learning rate) | 按 `5e-5` 设置,随训练进度调节 |
| 一条训练样本最多保留多长? | 截断长度(cutoff_len) | 2048 个 token,包含输入和答案等内容 |
本课程使用 **LoRA**:训练时保持原模型权重不变,主要调整新增的一小部分权重。第 6 节介绍它的计算方式,以及怎样减少训练开销。
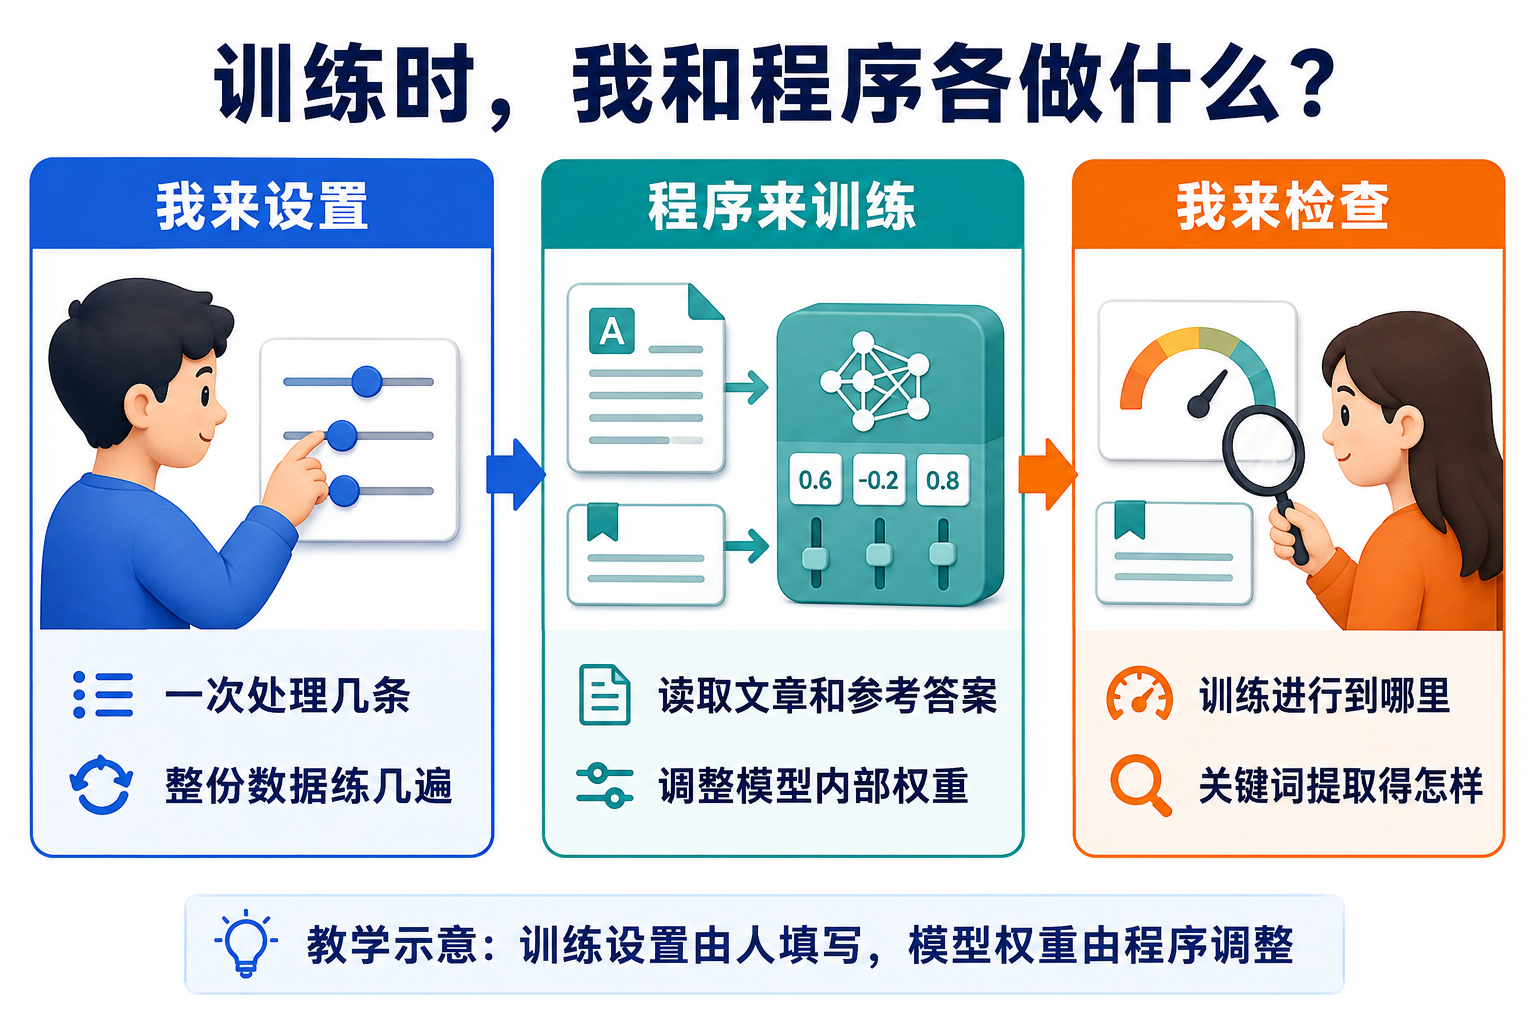
**阅读安排:** 正文结合例子解释训练过程和参数用途,手算与推导放在折叠的选读部分。
- **训练原理:** 上面五项设置的作用,训练怎样利用参考答案,LoRA 改了哪部分,以及 Loss 为什么不能代替实际回答质量。
- **配置参数:** 优化器、预热与调度、LoRA 的 rank 和 alpha、计算精度、梯度检查点等。完整配置在第 8.1 节汇总,实际运行时还需核对精度与显卡的匹配等条件。
- **进阶选读:** 交叉熵手算、标签数组、矩阵推导、量化编码和进一步的实验对照。
---
## 1、微调训练过程
**本节先掌握:** 训练围绕“预测 → 损失 → 调整”展开。模型根据输入预测答案,程序对照参考答案计算损失,再调整可训练权重。
沿用第 29 章的图书馆例子,先只看输入和参考答案:
```text
输入:市图书馆周末开设儿童阅读课,读者可通过公众号预约。
请提取关键词,只输出关键词,并使用英文分号分隔。
参考答案:市图书馆;儿童阅读课;公众号预约
```
第 28 章已经区分过:普通推理使用已有权重,微调会更新可训练权重。现在只跟踪这条样本,看训练程序怎样利用参考答案。
先跟着这条样本走一遍。答案里的“市图书馆”后面应该接英文分号,假设模型在这里还不太倾向于使用分号,训练程序会怎样处理?
1. 模型读入文章、任务说明和前面的答案片段,计算下一个 token 的预测。
2. 程序用参考答案里的分号检查预测,把模型给正确项的概率换算成一个损失值。
3. 程序根据损失求出内部参数的调整方向,再按我们设定的更新规则改变可训练参数。
4. 执行更新后,后续样本会使用新参数继续计算。实际可以先累积多批信息再更新,第 2 节会解释这种安排。
**文章与参考答案没有被改写,改变的是模型内部用来计算预测的数值。** 上面只是跟踪一个位置来理解流程,实际训练会汇总多个位置、多个样本的信息;一次更新也不保证每个位置都预测得更好。下面先看程序怎样衡量预测,再看它怎样更新参数。
### 1.1 预测结果与损失
在“市图书馆”后面,模型会为许多候选 token 计算概率,英文分号只是其中一项。参考答案要求这里使用分号,因此我们先检查模型给它分配了多少概率。下面比较同一个位置的两种假设预测,不是模型实测输出:
| 对同一个正确 token 的预测 | 分号的概率 | 怎样理解 |
| ------------------------- | ---------- | ------------------------------------------ |
| 预测 A | 10% | 模型给正确项的概率较低,这个位置的损失较大 |
| 预测 B | 80% | 模型给正确项的概率较高,这个位置的损失较小 |
程序要用一个可计算的数衡量预测,这个数就是 **Loss(损失值)**。在这里,给正确 token 的概率越高,算出的损失越小。它提供了训练要努力降低的目标,第 1.2 节再解释怎样据此调整参数。
本课程使用**交叉熵(cross entropy)**把模型给正确 token 分配的概率换算成损失。
因此,即使两次预测最后都选中了分号,它们的损失也可能不同。交叉熵还会检查“模型给正确项分配了多大的概率”,不只是记一次对或错。
**先用于判断:Loss 是预测损失,不是关键词准确率。** 它由参考答案中需要学习的多个位置汇总而来。训练使用参考答案中的前文预测后面的 token,具体位置对应关系可展开查看。
进阶选读:预测位置怎样对应,为什么模型不能提前看答案
**分号的预测是怎样得到的?** 第 29 章已将输入和参考答案组织成训练序列。为便于说明,假设答案开头按 `[市] [图书馆] [;]` 拆分;实际分词以工具处理结果为准:
| 要预测的位置 | 模型可以使用的内容 | 用来检查预测的参考 token |
| --------------- | -------------------------------------- | ------------------------ |
| 答案开头 | 用户文章、任务说明和助手回答的起始标记 | `市` |
| `市` 之后 | 上述上下文 + 参考答案中的 `市` | `图书馆` |
| `市图书馆` 之后 | 上述上下文 + 参考答案中的 `市图书馆` | `;` |
表中最后一行就是刚才检查的位置。虽然训练序列含有完整参考答案,但模型预测分号时,只能使用它之前的内容,不能看到待预测的分号及其后文。训练框架可以同时计算多个位置,每个位置都遵守这个限制。
训练时,前面的答案片段来自参考答案;实际让模型回答时,它要接着自己已经生成的内容往下预测。因此,训练不是先生成一整段回复,再拿两段文字逐字找不同。
一条参考答案里的文字、分号和结束标记都可能有需要预测的位置。程序计算并汇总需要计入的位置,得到训练使用的损失;哪些位置不计入,下一小节会说明。**日志中的 Loss 不是答错了几个词,也不是关键词准确率。** 第 9 节再结合实际日志说明汇总范围。
进阶选读:10% 和 80% 怎样变成损失值
本例每个预测位置都有一个确定的参考 token,按普通交叉熵计算,该位置的损失可以写成:
```text
这个位置的 Loss = -ln(正确 token 的概率)
概率 0.1:-ln(0.1) ≈ 2.3026
概率 0.8:-ln(0.8) ≈ 0.2231
```
`ln` 是自然对数,一种数学运算。它在这里把概率转换成损失:概率越接近 1,算出的损失越接近 0;概率越小,损失越大。
再假设一条短答案只有两个需要计分的位置,损失分别为 `2.3026` 和 `0.2231`。若按这两个位置取平均,得到约 `1.2629`。实际日志会进一步汇总多个样本和记录区间,见第 9 节。
公式与忽略标签的规则可对照 [PyTorch 交叉熵说明](https://docs.pytorch.org/docs/2.14/generated/torch.nn.CrossEntropyLoss.html)。这里用概率解释公式;直接调用 PyTorch 的 `CrossEntropyLoss` 时,接口接收的是模型尚未转换成概率的原始分数,不要把这段手算当成接口调用代码。
#### 1.1.1 训练标签与损失计算位置
输入中既有文章和任务说明,也有参考答案。那么,每个位置都要直接计算损失吗?
回到这个任务:我们希望模型学会“读文章、提取关键词”,而不是练习续写用户提交的文章。因此,本课程保留用户文章作为理解任务的上下文,主要根据助手答案中的预测位置计算损失。
这由课程配置中的 `train_on_prompt: false` 控制:用户文章提供上下文,其对应的预测位置不计入损失;助手答案对应的预测位置参与损失计算。下面的标签示例展示了这种区别。
调整时再看:train_on_prompt 改为 true 会改变什么
如果改为 `true`,用户文章中相应的 token 预测也会计入损失,程序就同时练习续写这部分内容。尤其是文章较长、关键词答案较短时,损失中会多出大量文章位置。训练目标的组成变了,不能拿修改前后两个 Loss 的大小直接判断关键词提取是否改善。本课程保持 `false`,将直接监督集中在助手答案上。
选读:训练标签 labels、-100 与预测位置怎样对应
训练程序用 **labels(训练标签)**指定这些位置,它是一串与输入位置对应的目标编号。采用本例的 `train_on_prompt=False` 设置时,Prompt 对应的标签通常记为 `-100`,表示计算损失时忽略这里;助手答案位置则保留要预测的目标编号。
把“能看到的上下文”和“用来检查预测的目标”分开看,就能理解为什么文章需要保留,却不一定直接计入损失:
图中按目标 token 的位置标记标签;训练内部会将前一位置的预测与下一个目标对齐。分词、角色边界和结束标记均为教学示意,实际仍需核对预处理结果。
**`-100` 只标记忽略损失的位置,用户文章仍完整保留在 `input_ids` 中。** 文章依然参与计算、占用序列长度,帮助模型理解任务。
第 29 章打印的模板文本只展示输入形式,没有展示训练标签。要确认实际哪些位置参与损失计算,还需要检查 LLaMA-Factory 预处理得到的 `input_ids` 和 `labels`,不能仅凭模板名称判断。第 4.2 节会结合长度和截断继续检查这一点。
**参考答案的质量也会直接影响训练。** 如果答案里多写了文章没有提到的关键词,训练程序仍会尝试提高这些词的概率。这就是为什么上一章既要检查分号,也要核对关键词含义,不能只确认 JSON 格式正确。
### 1.2 梯度与参数更新
现在,模型给正确分号的概率偏低,损失反映出了这个问题。但只拿到一个 Loss,程序还不知道内部那么多参数应该怎样改。
程序会根据损失算出各个可训练参数的调整线索,这些线索叫作**梯度**。再由**优化器**按规则执行更新,**学习率**控制步长。课程已经选好 AdamW 优化器,我们填写训练设置,计算和更新由程序完成。
Loss 描述当前预测的情况,梯度提供调整线索,优化器执行调整。
模型先从输入算出预测,这叫**前向计算**;得到损失后,沿着计算过程往回求梯度,这叫**反向传播**。求出梯度还不等于改好了权重,真正的更新由优化器执行。
**把图书馆样本放回训练流程:**
读图时,沿着“预测 → 损失 → 梯度 → 更新参数”看一遍,再看回到模型的虚线:下一批数据会使用更新后的参数重新计算预测。改变的是计算结果的产生方式,训练文件里的文章和答案仍保持原样。
进阶选读:梯度怎样提供调整线索,并手算一次更新
先只看其中一个参数:在其他参数暂时不变时,它稍微增大一点,损失倾向于增大还是减小,变化有多明显?损失对这个参数的变化率,给出了当前位置的调整线索。把各个可训练参数的这些变化率放在一起,就是 **Gradient(梯度)**。
梯度由训练框架通过反向传播计算,不需要我们逐个修改参数去试,也不是在训练页面手工填写的数。
有了梯度,接下来由 **Optimizer(优化器)**按更新规则真正改变参数,**学习率(learning rate)**控制更新的步长。先假设某个参数和它的梯度如下,用最简单的规则算一次:
```text
某个可训练参数:0.30
当前梯度:0.20
学习率:0.10
按最简单的梯度下降规则:
新参数 = 原参数 - 学习率 × 梯度
= 0.30 - 0.10 × 0.20
= 0.28
```
这个参数的梯度是正数 `0.20`,表示在当前数值附近,增大它会使损失倾向于增大。因此,简单梯度下降往反方向调整,把参数从 `0.30` 减到 `0.28`;梯度为负时则相反。梯度描述的是当前位置附近的情况,步子迈得太大,仍可能越过合适位置,并不保证每步 Loss 都下降。
上面是**简单梯度下降算例**。课程训练使用 **AdamW 优化器**,还会参考之前梯度的统计信息,为各参数调整更新幅度。两种规则都需要先算出梯度,再执行参数更新。
回到图书馆任务,看到 Loss 偏高,下一步是检查数据与训练过程;训练结束后,再看新文章的关键词是否提取完整、是否按分号分隔。
实际训练通常把多条样本一起处理,还可能先累积几批梯度,再执行参数更新。下一节就来认识控制这个过程的设置。
---
## 2、训练轮次与批次
**本节先掌握:** 分清“一次处理几条”和“处理几批才更新一次”,算出课程为什么是每轮 50 步、3 轮 150 步。
上一节介绍了一次参数更新。现在有 1,600 条训练样本,我们需要决定:每次处理多少条、处理几批以后更新参数,以及整份数据训练几轮。
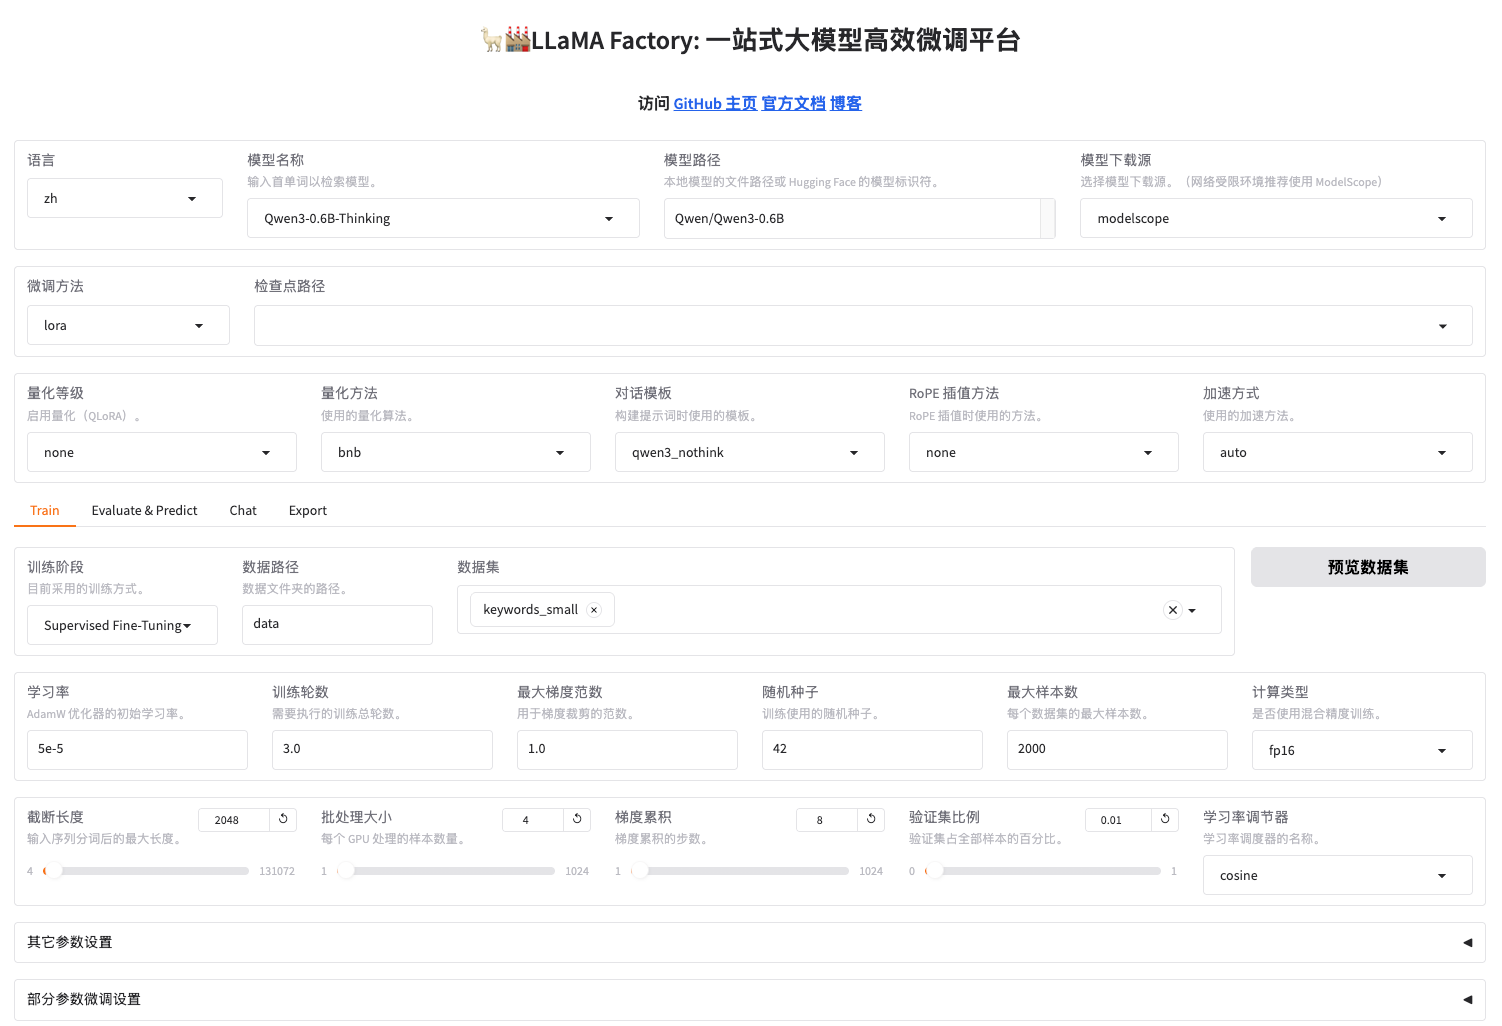
先看 LLaMA-Factory 的 **Train(训练)页面**。选好模型和数据后,下方就是训练参数。下面从真实界面中分别截出本节要认识的三项:批处理大小、梯度累积和训练轮数。截图只用于认识字段,完整配置在第 8.1 节汇总,第 31 章再实际填写。
这里只查看批次和轮数字段。训练时使用 `keywords_train` 和独立的 `keywords_validation`,验证集比例填 `0`;截图大图中的 `keywords_small` 和比例 `0.01` 不用于这套练习,完整填写方法见第 31 章。
本章后面的计算统一采用 `Qwen/Qwen3-0.6B`、单卡、1,600 条训练样本、每批 4 条、梯度累积 8、训练 3 轮。先认识下面三项,其余设置随用随讲:
| 界面名称 | 配置文件中的字段 | 本章取值与作用 |
| ---------- | ---------------------------------------------------------------------------------------------- | -------------------------------- |
| 批处理大小 | per_device_train_batch_size | `4`:每张卡一次处理 4 条样本 |
| 梯度累积 | gradient_accumulation_steps | `8`:累计处理 8 批后更新一次参数 |
| 训练轮数 | num_train_epochs | `3`:整份训练数据训练 3 轮 |
这些设置也保存在 `案例与源码-4-微调/configs/keywords_clean_train.yaml` 中。YAML 是一种配置文件格式,每行用“参数名: 值”记录设置;例如 `num_train_epochs: 3` 就对应界面中的“训练轮数 3”。它保存训练安排,不保存训练样本。
### 2.1 批处理大小、训练轮数与更新步
先把界面设置与日志中的英文名称对应起来:
- **Batch(批次)**:一次放进模型一起处理的样本组。这里一个 batch 是 4 条。
- **Epoch(训练轮)**:训练集中的每条样本大致都被看过一遍,记为一轮。
- **Step(更新步)**:训练程序完成一次参数更新,记为一步。没有使用梯度累积时,处理一个 batch 通常会完成一步更新。
**在本课程按轮数训练的配置中,step 是程序算出的更新进度,无须再另填一个总步数。**
1,600 恰好能被 4 整除:
```text
1 个 epoch:1,600 ÷ 4 = 400 个小 batch
```
这 400 是**处理的小批次数**。课程还设置了梯度累积 8,因此不代表更新了 400 次。接下来算清楚:每处理 8 批才更新一次,会得到多少个更新步?
### 2.2 梯度累积与有效批次
**梯度累积(gradient accumulation)** 的意思是:处理完一个小 batch 后,先不更新参数,而是把本次得到的梯度暂存下来;连续处理若干个小 batch 后,再统一更新一次参数。
先按课程配置走一遍:用一张 GPU(通常简称“单卡”),第 1 批处理 4 条,暂不更新;第 2 批再处理 4 条,继续累积梯度……处理完第 8 批,才执行一次更新。然后开始下一组:
```text
单卡 batch size = 4
梯度累积次数 = 8
4 条 × 8 次 = 32 条样本后更新一次参数
```
这 32 条叫作**有效批次大小**。在单卡场景下,可以先这样理解:
```text
有效批次大小 = 单卡 batch size × 梯度累积次数
```
**假设换了一批更长的文章,模型已经加载成功,但每次处理 4 条时显存不够了。** 我们想改为每次处理 2 条,同时仍然每 32 条更新一次,应该一起改哪项设置?
先只改 batch:每批 2 条、仍然累积 8 批,就变成每 16 条更新一次。每次同时处理的样本少了,但更新也变得更频繁。
如果希望仍然每 32 条更新一次,就要把累积次数同步改为 16。**batch 管一次处理多少条,梯度累积管处理几批才更新。** 数据没有减半,变化的是分组方式:
| 单卡设置 | 一次处理 | 更新前处理几批 | 有效批次 |
| -------------------------- | -------- | -------------- | -------- |
| 原配置:batch 4、累积 8 | 4 条 | 8 批 | 32 条 |
| 只改 batch:2、累积 8 | 2 条 | 8 批 | 16 条 |
| 配套修改:batch 2、累积 16 | 2 条 | 16 批 | 32 条 |
图中对照的是表中的第一种和第三种安排。每个小框是一批,框内的数字是样本条数;沿箭头依次处理,并没有把 32 条一起放进 GPU。累计满 32 条以后才更新,下一组再使用新参数。
在样本长度等条件相同时,每次处理 2 条通常比处理 4 条少保存一些计算中间结果。**降低这部分显存占用靠的是减小单卡 batch;增加累积次数,是为了维持每次更新所用的样本数。** 如果 batch 仍为 4,只增加累积次数,当前这批 4 条所需的空间不会因此缩小。
调整时再看:有效批次相同,运行就一定相同吗
反过来,显存充足时,batch 8、累积 4 也能得到有效批次 32,但一次要同时处理更多样本。有效批次相同,不代表速度和训练结果完全相同,也不保证调整以后一定不会报错;第 5 节会解释其他显存占用。
再把一整轮算完:
```text
训练样本:1,600 条
小批次数:1,600 ÷ 4 = 400 批
每轮更新:400 ÷ 8 = 50 步
训练 3 轮:50 × 3 = 150 步
```
这个计算以单卡、关闭序列打包、全部 1,600 条训练样本被保留为前提;“打包”是把多条短样本拼在一起处理,课程配置不启用。第 31 章的示例启动日志也对应 50 步/轮、共 150 步。样本数或打包方式改变后,应重新核对日志;验证集不参与这些参数更新。
进一步对照:更新频率、验证时机和真实资源变化
把三种安排都算一遍,就能看到修改的连带影响:
| 单卡设置 | 每轮更新步数 | 3 轮总步数 | 每 50 步验证一次,相当于 |
| ---------------- | ----------------- | ---------- | ------------------------ |
| batch 4、累积 8 | `1600 ÷ 32 = 50` | 150 | 每轮检查一次 |
| batch 2、累积 8 | `1600 ÷ 16 = 100` | 300 | 每半轮检查一次 |
| batch 2、累积 16 | `1600 ÷ 32 = 50` | 150 | 每轮检查一次 |
三种配置都把训练集练了 3 遍,但第二种更新得更频繁,按步数设置的验证间隔也落在了不同进度上。**调整 batch 后,要一起核对有效批次、总步数和验证时机。** 第 9 节会解释验证与保存的具体设置。
这样修改会有多大资源收益?第 33 章已有一组真实对照:同一张 V100、同一个模型与课程数据,两组各完成 50 步。batch 4/累积 8 的最高采样显存约为 **27.92 GiB**,整次命令耗时约 **301 秒**;batch 2/累积 16 则约为 **21.71 GiB、560 秒**。本次每批处理更少,留出了更多显存余量,也花了更多时间。
这组 50 步实验统计了从加载到保存的最高采样显存与整次耗时,用来比较资源开销;任务效果还需另行评估。完整记录与复现方法见[第 33 章的 batch 对照](33-微调显存优化与多卡训练.md?id=_26-怎样判断调整是否有效)。
**读到这里可以自查:** 每次处理 2 条,能不能每 32 条才更新一次?能,需要累积 16 批;“一批”与“一次更新”不必是同一件事。
### 2.3 epoch 不是越多越好
**如果练习题越答越熟,新文章反而答得更差,还要继续增加轮数吗?** epoch 增加,会让模型反复看到同一批训练样本。适当重复有助于学习任务规律,但是否继续,要看未参与训练的数据。
第 29 章解释了[泛化与过拟合](29-微调数据准备与对话模板.md?id=_521-泛化与过拟合)。用到 epoch 上,就是每多练一轮,还要检查没有参与训练的同类文章是否也有改善。
例如,其他批次设置保持课程取值,训练 1 轮对应 50 次更新,3 轮对应 150 次。多出的两轮提供了更多学习机会,也增加了计算;是否值得,要看新文章上的回答和验证损失。
本章第 9 节已有同一次训练在第 50、100、150 步保存的结果,可以先比较这些阶段,再决定是否需要新实验。若验证表现持续变差,应按第 9.3.1 节回查原因,不能只因训练 Loss 还在下降就继续加轮数。
---
## 3、学习率与调度
**本节先掌握:** 学习率控制更新步长,调大不等于学得更好。预热和衰减先看懂变化方向,首次训练沿用课程设置。
批次和轮次决定了“多久更新一次、总共更新多少次”。学习率则影响“每次更新走多大一步”。
### 3.1 学习率设置
**把学习率调大,是否就能更快学好关键词抽取?** 学习率控制每次更新的步长。步子太小,有限轮数内变化可能不足;步子太大,也可能使训练不稳定。它不是“学习速度”或“掌握知识量”的直接刻度。
训练页中的“学习率”对应配置字段 `learning_rate`。课程取值是 `5e-5`,在 YAML 中写作 `learning_rate: 5.0e-5`,两种写法表示同一个数:
```text
5e-5 = 5 × 10⁻⁵ = 0.00005
```
这里的 `e-5` 是科学计数法的写法,用来简短地表示这样的小数。数值虽小,是否适合当前训练,仍要结合模型、数据和优化器判断。
| 学习率情况 | 可能发生什么 |
| ---------- | ------------------------------------------------ |
| 过大 | 参数更新过猛,Loss 可能剧烈波动,甚至越训越差 |
| 过小 | 参数变化缓慢,在有限轮数内可能还没有学到任务规律 |
| 合适 | 在当前设置下,训练较稳定,验证表现也有改善 |
把这个含义用到课程设置上:若从原模型重新开始训练,保持其他设置一致,将 `5e-5` 改为 `1e-4`,设定的学习率就从 `0.00005` 提高到 `0.0001`,变成原来的 2 倍。它会让优化器按更大的学习率更新;经过多步后,梯度和参数也会不同,不能推断损失下降或学习速度恰好翻倍。
调整时再看:用什么证据比较学习率
**怎样判断是否值得改?** 先确认样本、答案标签和 Adapter 加载都正确。如果在多个记录区间内,训练与验证损失改善都很慢,可以把较大学习率作为待比较的假设;如果训练反复出现大幅波动,可以比较较小学习率。某一条 Loss 上升只值得继续观察,还不足以决定改值。
比较时,先从日志确认实际学习率按新设置变化,再看相同训练进度下的损失趋势和同一批验证输入的回答。若数字降得更快,漏词或格式错误却更多,就不能只凭下降速度保留新配置。
进阶选读:只改学习率,手算一次更新幅度
回到第 1.2 节那个参数:原值为 `0.30`,梯度为 `0.20`。暂时保持二者不变,只换学习率,按同一条简单梯度下降规则计算:
| 学习率 | 本次减去的数值 | 更新后的参数 |
| ------ | --------------------- | ---------------------- |
| `0.10` | `0.10 × 0.20 = 0.02` | `0.30 - 0.02 = 0.28` |
| `0.01` | `0.01 × 0.20 = 0.002` | `0.30 - 0.002 = 0.298` |
学习率缩小到十分之一,这个算例中的更新幅度也缩小到十分之一。它控制的是“朝这个方向走多大一步”,不是“这次学会了多少知识”。上表继续使用教学数字和简单规则;实际 AdamW 的更新还涉及梯度历史,不能直接套用表中结果。
### 3.2 学习率预热与衰减
如果学习率填的是一个固定数字,为什么日志中的数字还会变化?因为还配置了**学习率调度器(scheduler)**,让学习率随训练进度变化。
界面中的“学习率调节器”就是选择调度规则的地方;展开“其它参数设置”还能找到预热步数。这三项配合使用:
| 界面名称 | 配置写法 | 作用 |
| ------------ | --------------------------- | ------------------------------- |
| 学习率 | `learning_rate: 5.0e-5` | 本例预热结束时达到的学习率 |
| 学习率调节器 | `lr_scheduler_type: cosine` | 预热后按余弦曲线逐渐降低 |
| 预热步数 | `warmup_steps: 5` | 开始的 5 个更新步逐步提高学习率 |
**预热(warmup)**是训练开始时,先使用较小学习率,再逐步升到设定值,用来缓和刚开始的参数更新。
这里用最初 5 个更新步做预热,包含在总共 150 步之内。预热阶段线性升高;预热结束后,学习率再按余弦曲线逐渐降低,这个后半程叫作**衰减**。
主图横轴按实际步数比例绘制,前 5 步因此很窄;下方单独放大预热区,方便看清起步过程。这是配置示意,实际日志中的数值会在第 9.1 节一起看。
为什么后面逐渐降低?参数已经经过许多次调整,继续用较大的步长可能在较好的位置附近来回波动。衰减让后期更新逐渐减小,但它按预先设置的进度执行,并不会自动判断模型已经掌握了哪些知识。
调整时再看:预热步数与总步数变化会影响什么
假设总步数仍为 150,只把预热从 5 步改成 15 步,模型会用更多更新步慢慢升到 `5e-5`,后面的衰减阶段则由 145 步缩为 135 步。这个变化可以直接算出;训练是否更稳定,要结合日志检查。预热拖得过长,也会让有限训练中的更多步骤处于较小学习率。
总步数本身也参与调度。第 2 节若只减小 batch,使总步数从 150 变成 300,即使仍填 `cosine` 和预热 5 步,衰减也会按新的总进度展开。因此,比较同一次训练的第 50 步和第 150 步,与分别新跑“总共 50 步”和“总共 150 步”,不是同一个实验。具体规则见 [Transformers 学习率调度说明](https://huggingface.co/docs/transformers/en/main_classes/optimizer_schedules#transformers.get_cosine_schedule_with_warmup)。
---
## 4、序列长度与截断
**本节先掌握:** 长度上限包含输入和参考答案。缩短之前检查会丢掉什么,提高上限也不一定增加实际训练内容。
训练页面中的“截断长度”对应 `cutoff_len`,用来限制一条训练序列最多有多少 token。第 29 章已经看过对话模板和分词结果,这个长度需要把输入和参考答案一起算进去:
```text
用户文本 + 任务指令 + 模板标记 + 助手参考答案
↓
完整训练序列的 token
```
沿用图书馆样本,实际计入长度的内容包括:
```text
[用户角色标记] 市图书馆周末开设儿童阅读课……请提取关键词……
[助手角色标记] 市图书馆;儿童阅读课;公众号预约 [结束标记]
└──────────────── 整段分词后的 token 总数 ────────────────┘
```
这是内容组成示意,角色标记的实际写法由模板决定。`cutoff_len: 2048` 表示这段完整序列的上限为 2,048 token,不是文章篇数、汉字数,也不是 Chat 页单独设置的“最大生成长度”。
### 4.1 长度上限的影响
长度首先影响模型能看到什么,其次才是显存和速度。假设图书馆原本提供了一篇很长的活动介绍,“读者可通过公众号预约”放在文章后半段。如果截断后这句话没了,参考答案里的“公众号预约”却仍然保留,会发生什么?
模型看到的文章不再有预约方式,训练程序却仍要求它预测出这个关键词。这样一来,一条本来有依据的答案,在截断后就可能失去依据。**第 29 章检查的是原始样本是否合理,这里还要检查模型实际收到的样本是否完整。**
用长度表示,假设一条训练样本处理前共有 2,300 token,而上限只有 2,048,就不能完整保留它。不同部分被截去,会产生不同影响:
| 被截去的内容 | 对关键词任务的影响 |
| ---------------------- | -------------------------------------- |
| 用户文章的一部分 | 答案可能提到了模型已经看不到的内容 |
| 参考答案的一部分 | 模型无法学习完整的关键词和结束方式 |
| 必要的任务说明或上下文 | 输入与答案可能不再构成清楚、完整的任务 |
工具会按自身预处理规则分配输入与答案的长度,不能一概认为只删除文章末尾。
进阶选读:填充与截断有什么区别,短样本也会补到上限吗
长度还涉及**填充(padding)**:两条长短不同的样本放在同一批处理时,工具通常需要把它们整理成一样长。例如,一条有 120 个 token,另一条有 200 个 token;如果按本批最长样本补齐,短的那条就要增加 80 个填充位置。
工具会标记这些用于对齐的填充位置,让它们不作为预测目标计入损失;这里也会用到第 1.1.1 节的标签忽略规则。
读图时可以用两个问题区分:上半部分是“这一批长短不一,怎样排齐”,下半部分是“这一条太长,哪些内容还能保留”。图中没有规定工具具体截掉哪一段,实际结果需要按下一节的方法检查。
因此,`cutoff_len: 2048` 是长度上限,不等于每条短样本都补到 2,048。填充到哪里还取决于批次和工具设置。把上限提高到 8,192,也不能直接认定所有样本都会占用 8,192 个位置。
还要记住:**2048 是上限,不表示每条短样本都会占满 2048 个位置。** 实际占用还与批次及填充设置有关。
### 4.2 检查实际训练长度
先检查课程数据经过 LLaMA-Factory 处理后的长度。下面的结果对应 `Qwen/Qwen3-0.6B`、`qwen3_nothink` 模板、`cutoff_len: 2048` 和 `train_on_prompt: false`。这项检查只运行数据预处理,不需要加载模型权重或训练。
**先看样本有没有被丢弃或截断:**
| 数据文件 | 原始条数 → 处理后条数 | 最长完整序列 | 被截断的条数 |
| --------------------------- | --------------------- | ------------ | ------------ |
| `keywords_train.jsonl` | 1,600 → 1,600 | 957 token | 0 |
| `keywords_validation.jsonl` | 200 → 200 | 604 token | 0 |
这里的长度包含角色标记、用户输入、助手答案和结束标记,不是文章字数。两份数据都低于 2,048 的上限,预处理前后条数一致,也没有因截断改变答案目标的样本。
现在可以根据实际长度判断怎样改上限。保持当前数据和模板不变,先作下面的配置推演:
| 截断长度设置 | 对当前数据能作出的判断 | 要检查什么 |
| ------------ | ---------------------------------------- | ------------------------------------ |
| 保持 2048 | 已有预处理证据表明全部样本完整保留 | 对照上述条数与长度 |
| 提高到 4096 | 当前最长只有 957,不会因此多读到文章内容 | 实际序列和填充是否变化,再观察资源 |
| 降到 512 | 至少已有最长样本无法完整保留 | 重新检查被截去的输入、答案及样本条数 |
**长度设置首先要保证输入和答案完整。** 上面的 4096 与 512 是按已有样本长度作出的推演;实际显存还受批次长度和填充方式影响。排查自己的数据时,可以展开下面的标签核验。
选读:实际样本的输入、答案标签与长度核验
**再看 `input_ids` 和 `labels` 是否对应。** 从这 1,800 条数据中,按完整序列长度选出最短、中间和最长的三条:
| 样本位置(文件行号从 1 开始) | 完整长度 | `labels = -100` 的位置数 | 参与损失计算的位置数 |
| ----------------------------- | -------- | ------------------------ | -------------------- |
| 短:验证集第 133 行 | 39 | 28 | 11 |
| 中:训练集第 636 行 | 158 | 136 | 22 |
| 长:训练集第 631 行 | 957 | 938 | 19 |
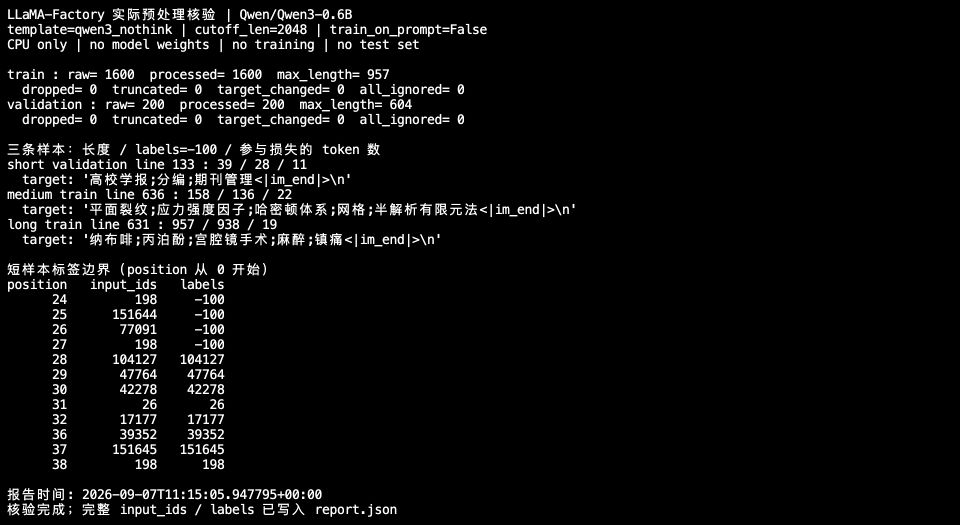
图中短样本的答案是 `高校学报;分编;期刊管理`。它的前 28 个位置是用户输入及角色标记,`labels` 为 `-100`;从位置 28 开始(索引从 0 计数),标签保留答案的 token ID。末尾的 `<|im_end|>` 和换行也计入目标,所以参与损失计算的位置数不等于关键词字数。`-100` 只表示该位置不作为预测目标,**不表示模型看不到这段输入**。
核对标签时,既要检查解码后的输入、答案和角色边界,也要确认每条样本都有参与损失计算的答案位置。表中三条样本与源记录对应,全部 1,800 条数据也没有答案标签全为 `-100` 的情况。可在配套 `examples/preprocessing/report.json` 中查找 `decoded_input`、`decoded_target` 和标签数组;下面给出检查脚本的运行方法。
代码复现:上传并运行预处理检查脚本
先完成第 31 章的环境安装、[模型下载](31-LLaMA-Factory环境搭建与微调实战.md?id=_51-模型与微调方式)和[数据上传](31-LLaMA-Factory环境搭建与微调实战.md?id=_61-数据上传与完整性检查),不需要先启动训练。脚本只用 CPU 检查数据,不会替你下载模型。
在 **AutoDL 的 JupyterLab 终端**准备目录:
```bash
cd /root/autodl-tmp/LLaMA-Factory
source .venv/bin/activate
mkdir -p configs
```
在 JupyterLab 文件面板上传两份本机文件:
| 本机 `案例与源码-4-微调/` 中的文件 | 上传到 AutoDL 的位置 |
| ----------------------------------- | ------------------------ |
| `audit_keywords_preprocessing.py` | `LLaMA-Factory/` 根目录 |
| `configs/keywords_clean_train.yaml` | `LLaMA-Factory/configs/` |
这里使用课程附带的 CLI 训练 YAML,不是 WebUI 的“保存训练参数”文件。若已上传同名文件,先核对内容;本脚本要求其中的 `model_name_or_path` 仍为 `Qwen/Qwen3-0.6B`,实际读取的本地模型位置由下面的 `--model-dir` 单独指定。
回到刚才的 AutoDL 终端,先检查文件,再运行脚本:
```bash
ls audit_keywords_preprocessing.py configs/keywords_clean_train.yaml
ls data/keywords-clean/keywords_train.jsonl data/keywords-clean/keywords_validation.jsonl
python audit_keywords_preprocessing.py \
--data-dir data/keywords-clean \
--config configs/keywords_clean_train.yaml \
--model-dir /root/.cache/modelscope/models/Qwen--Qwen3-0.6B/snapshots/master \
--output-dir /root/autodl-tmp/keywords-preprocessing-check
```
将 `--model-dir` 换成模型下载完成时返回的实际目录;`--output-dir` 必须是尚不存在的新目录,不要指向已有训练结果。`--data-dir` 是待检查的数据位置,`--config` 提供模板、长度等检查条件,并不会因为其中写了 `do_train: true` 就启动训练。
完成后,在文件面板打开输出目录中的 `report.json`,对照上面的条数、截断和标签统计。脚本报配置条件不符时,先核对所上传的 YAML;不要删掉检查条件强行运行。
换成自己的数据或调整模板后,需要重新运行上面的预处理检查,对照原文查看模型实际收到的文章与答案,确认两者仍然完整、对应。具体的解码、标签核验和脚本操作保留在展开框中。**当前数据适合 2,048 的上限,不代表换一批文档后仍然合适。**
---
## 5、训练显存
**本节先掌握:** 模型加载成功,训练仍可能放不下。分清权重与计算中间结果,知道减小 batch 主要减少哪一部分;精度按硬件支持选择。
**显存(VRAM)** 可以先理解为 GPU(训练时主要承担计算的显卡)用来摆放模型和计算中间结果的工作台。工作台放不下,训练就会报内存不足;工作台越大,通常能放下更大的模型、更长的样本或更大的 batch。
这也把前面的界面设置串了起来:“截断长度”影响一条样本有多长,“批处理大小”决定同时处理多少条,“计算类型”影响数值的表示方式。它们都会影响显存,所以不能只按模型文件大小选择显卡。
### 5.1 显存的主要占用
沿着第 1 节的顺序,看看训练用的这张“工作台”上要放什么:
1. **加载模型时,先放入权重。** 模型要使用这些数值计算,权重本身就占一部分空间。此时还没有处理训练样本。
2. **处理一批样本时,产生计算草稿。** 模型各层算出的中间结果叫作**激活值**。后面求梯度还会用到其中一些结果,所以算出预测后不能立刻把草稿全部丢掉。
3. **根据损失往回求梯度。** 程序沿着刚才的计算关系往回求梯度,这个过程叫作**反向传播**。梯度也需要存放;启用梯度累积时,处理下一小批之前还要保留已经累积的梯度。
4. **更新参数时,还要保留更新所需的信息。** AdamW 会参考历史梯度统计,这些信息叫作**优化器状态**,供后续更新继续使用。
因此,“模型加载成功”和“一批训练能够跑完”是两件事。后面几步还需要空间;训练框架、临时工作空间等也有额外的**运行开销**。
这也解释了第 2 节的配置调整:同一个模型,batch 从 4 改为 2,并不是把模型权重缩小一半,而是同时处理的样本少了,需要保存的中间结果通常也更少。文章变长,则会增加这部分负担。
所以,**权重大小主要看模型和数值表示;激活值还要看实际序列长度和单卡 batch。** 第 5.3 节的梯度检查点,就是在“保存草稿”和“需要时重算”之间作取舍。
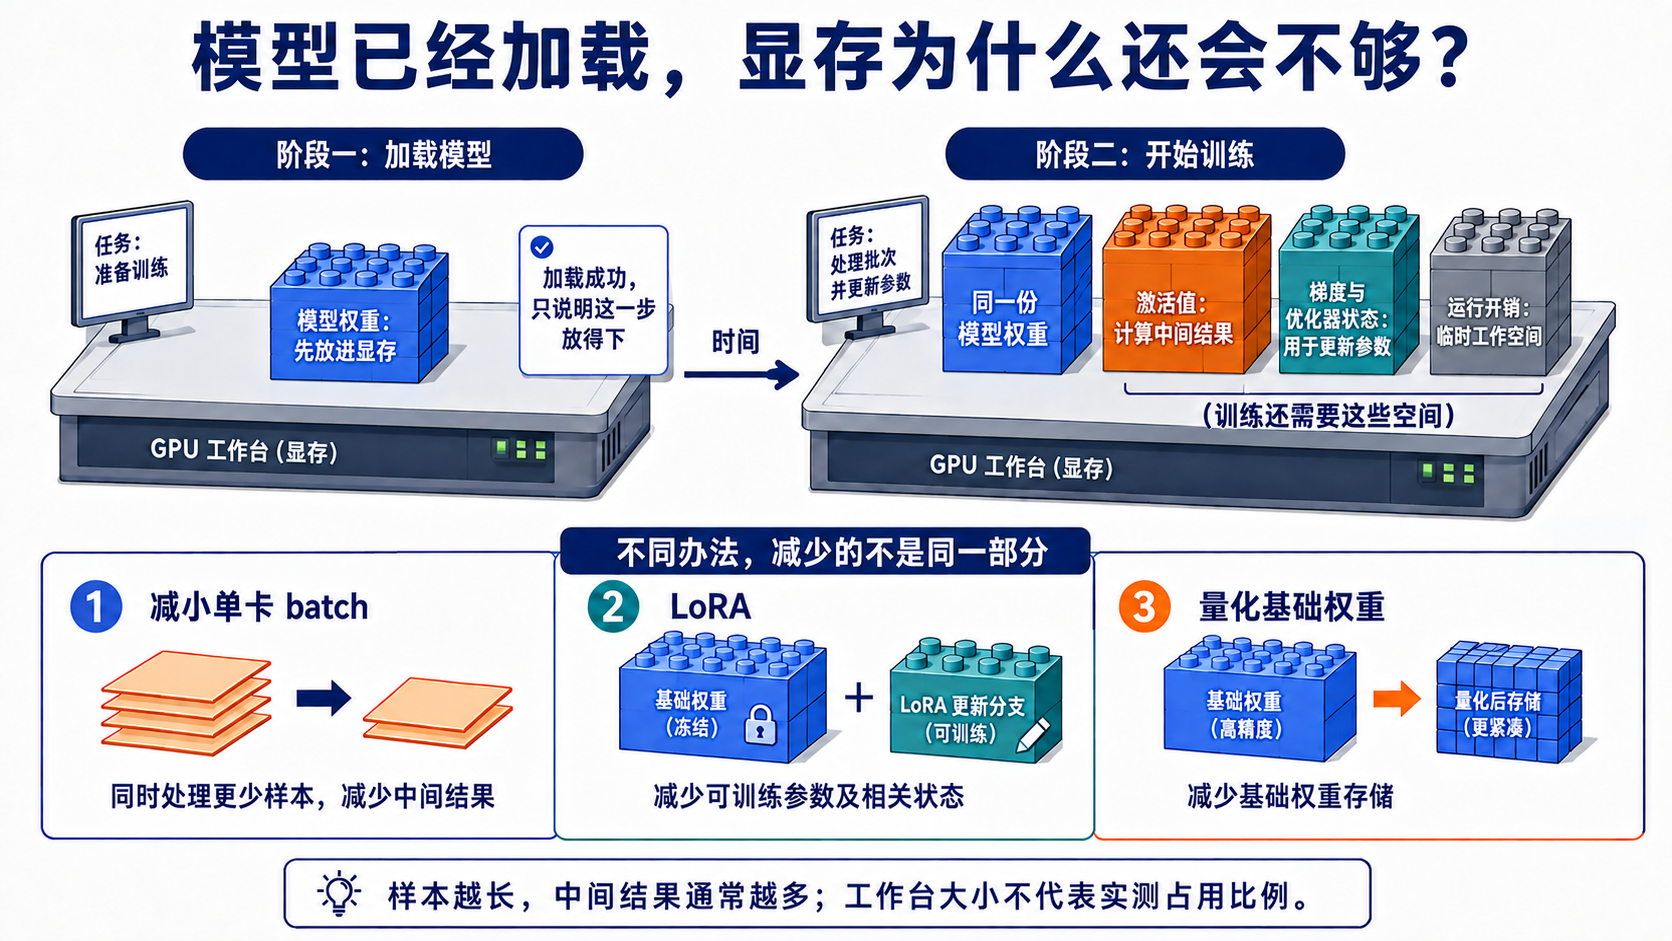
先比较两张工作台:**右边的模型没有变大,增加的是训练需要的其他内容。** 再看下方三种办法,分别减少哪一部分。图中的物体大小不表示实测占用比例。
遇到“显存不足”,先找到发生的阶段,再对照每种办法减少什么:
| 准备调整什么 | 主要影响工作台上的哪部分 | 如何判断方向是否合适 |
| ---------------- | -------------------------------- | -------------------------------- |
| 减小单卡 batch | 同时处理样本产生的中间结果 | 模型已加载,处理批次时空间不足 |
| 降低实际训练长度 | 每条样本产生的中间结果 | 先检查输入和答案是否仍然完整 |
| 使用 LoRA | 大量原权重对应的梯度、优化器状态 | 接受冻结原权重,只训练新增分支 |
| 量化基础权重 | 原模型权重本体 | 加载大模型时,权重已占去过多空间 |
例如,连模型都没加载完就报错,改 batch 无法缩小待加载的权重;已经完成加载,处理长文章时才报错,则应先检查实际长度和 batch。学习率改变参数更新的幅度,并不减少这些数值的数量,不能用它解决显存容量问题。
### 5.2 数值精度与权重大小
模型参数是数值,计算机保存一个数时,也需要选择表示方式。这里说的**数值精度**,不是模型回答的准确率,而是这些数能表示得多细。
可以借记录小数理解:把 `0.12345` 写成 `0.12` 更粗略,写成 `0.1235` 更细;另外,一个格式能否表示特别大或特别小的数,又涉及它的**数值范围**。这是帮助区分“精细程度”和“范围”的例子,FP16 并不是固定保留两位小数。
FP32、FP16、BF16 是几种保存和计算数值的格式。在训练页的“计算类型”中,课程选择 `fp16`,配置对应 `fp16: true`、`bf16: false`。先看它们占用的空间:
| 格式 | 一个数占多少位 | 折合多少字节 |
| ---- | -------------- | ------------ |
| FP32 | 32 bit | 4 字节 |
| FP16 | 16 bit | 2 字节 |
| BF16 | 16 bit | 2 字节 |
8 bit 等于 1 字节。FP16 和 BF16 虽然占的字节相同,数值范围和精度分配却不同,不是只换一个名字;本次 AutoDL V100 使用 FP16,不使用原生 BF16。具体硬件与安装检查放在第 31 章。
进阶选读:按字节计算权重大小,为什么整场显存不会同比例缩小
把 0.6B 粗略按 6 亿个参数计算,若每个权重用 2 字节保存:
```text
600,000,000 × 2 = 1,200,000,000 字节 ≈ 1.2 GB
```
同样的 6 亿个数,若全部按 FP32 的 4 字节保存,权重本体就是约 2.4 GB。数值的数量没变,表示它们所用的空间变了。这里均按十进制 GB 粗算,**只算权重本体**,还没有加入中间结果、梯度和优化器状态等。
所以,从 FP32 改用 FP16 后,不能只据这道题断言整场训练显存减半。实际还有混合精度安排,部分状态仍会使用 FP32;是否稳定、硬件是否支持,也要通过第 31 章的实际运算检查确认。LoRA 的可训练参数比例同样不能直接用来换算整场训练显存。
“计算类型”也不同于模型区域的“量化等级”。本章使用 FP16 计算、不启用量化;第 7 节再解释量化会改变什么。
选读:选择 FP16 后,日志为什么还会出现 FP32
**混合精度**是让不同计算或状态使用不同精度,不是所有数值都统一变成 16 位。示例配置开启 FP16,但启动日志还记录了 `Upcasting trainable params to float32`,表示可训练参数被提升为 FP32。它们并不矛盾:计算设置、参数保存和优化器状态需要分开看。
### 5.3 梯度检查点与显存
如果第 5.1 节中用于反向传播的“草稿”占了太多显存,能不能少保存一些,需要时再算?
**梯度检查点(gradient checkpointing,也称激活检查点)**会少保存一部分中间结果,需要时再计算一次。可以把它理解为:不把所有草稿都留在桌面上,只保留必要位置,后面用到时重算。代价是增加计算,换取较低的显存占用。
不要与训练存档混淆:
| 名称 | 在这里做什么 |
| ------------------------------ | ------------------------------------------------------ |
| 梯度检查点 | 在一次训练计算中减少中间结果的保存,节省显存 |
| 训练检查点,如 `checkpoint-50` | 把某个更新步的权重、状态等保存到磁盘,供后续加载或恢复 |
在其他设置相同的条件下,开启梯度检查点,相当于“少存草稿、多做重算”;关闭后则省去这部分重算,但要保存更多中间结果。如果原来刚好放得下,关闭后可能在处理批次时显存不足;开启后能否以可接受的时间完成,则要同时看资源和耗时。
本次启动日志已有 `Gradient checkpointing enabled.`,说明它已经开启。跟做时先核对启用状态;若要比较开关的影响,再记录完整运行中的占用与时间,不能拿“每 50 步保存文件”替代这个开关。具体排查方法留在第 33 章。
显存中的另一项大开销,是大量可训练参数对应的梯度和优化器状态。接下来介绍的 LoRA,主要从这一部分减少训练负担。
---
## 6、LoRA 高效微调
**本节先掌握:** 原权重继续参与计算,训练主要改变新增分支;得到的 Adapter 仍需原模型配合。第 6.2—6.6 节解释设置的用途,首轮沿用 rank 8、alpha 16、dropout 0、target all,先验证训练和实际回答。需要比较某个设置时,再设计一次有明确目的的实验,不要求一开始调优所有选项。
### 6.1 全参数微调与 LoRA
第 28 章区分了[“用什么反馈教模型”与“更新哪些参数”](28-大模型微调概述与整体流程.md?id=_33-sft-与-lora-是什么关系)。本节保持 SFT 的文章与参考答案不变,重点看第二个问题。
关键词抽取需要模型理解文章,也需要它遵守统一的输出要求。如果直接更新原模型中几乎全部参数,就是**全参数微调**。相应的大量梯度和优化器状态也要占用显存。
**LoRA**换了一种做法:原权重继续负责原来的计算,在选定的层旁边加一条可训练的分支,让它学习需要补上的调整量。两条路径一起参与计算,训练时只改新增分支中的少量参数。
这属于**参数高效微调(PEFT)**:训练时只更新一部分参数,降低相关开销。本章只展开课程会使用的 LoRA 及其量化方式 QLoRA。
LoRA 新增的这一组权重叫作 **Adapter(适配器)**。它不是独立的完整模型,计算时仍需要原模型。这里的“基础模型”是指它依附的原模型 `Qwen/Qwen3-0.6B`,不等于必须选第 28 章介绍的 `-Base` 预训练版本。
| 训练方式 | 原模型权重 | 新增参数 | 主要保存的任务权重 |
| ---------- | ------------ | ------------------------ | -------------------- |
| 全参数微调 | 参与更新 | 通常不需要 LoRA 分支 | 更新后的完整模型权重 |
| LoRA | 冻结,不更新 | 在选定层增加并训练小分支 | Adapter 增量权重 |
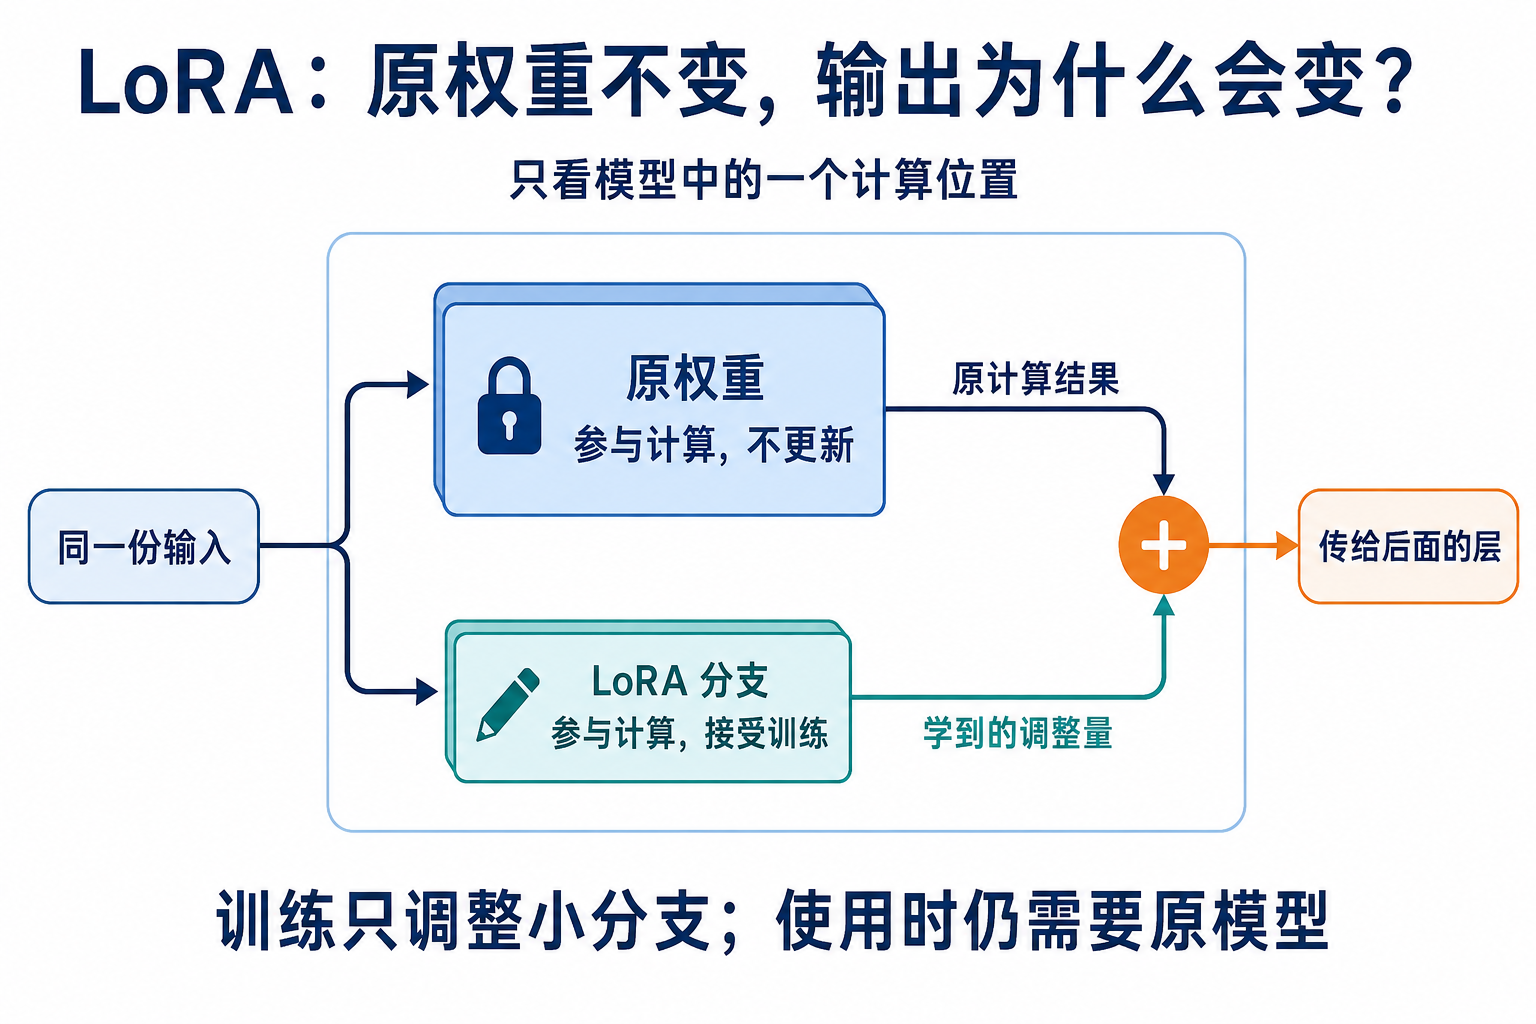
图中只放大模型中的一个计算位置。**两条路都参与计算,只有小分支接受训练。** 这里相加的是计算结果,还不是最终关键词;图中块的大小也不表示显存占比。
“冻结”不是锁住模型文件,也不是训练时不加载它。原权重仍参与计算,只是不为这些冻结参数计算、保存用于更新它们的梯度和优化器状态。反向传播仍需经过相关计算,才能求出可训练分支的梯度。
回到显存组成,少了大量参数的梯度和优化器状态,这部分开销就能减少;原权重和计算中间结果仍需保留。至于关键词提取是否改善,还要看训练后的验证结果。
**冻结原权重,也不保证加载 LoRA 后所有旧任务都保持原样。** 新分支会影响计算结果,模型的回答方式仍可能改变。除了检查关键词效果,还应检查自己需要保留的行为,做法见[第 32 章的回归检查](32-微调效果评估与模型部署.md?id=finetuning-regression)。
在训练页向下展开“LoRA 参数设置”,先找到上方的秩、缩放系数和随机丢弃三项:
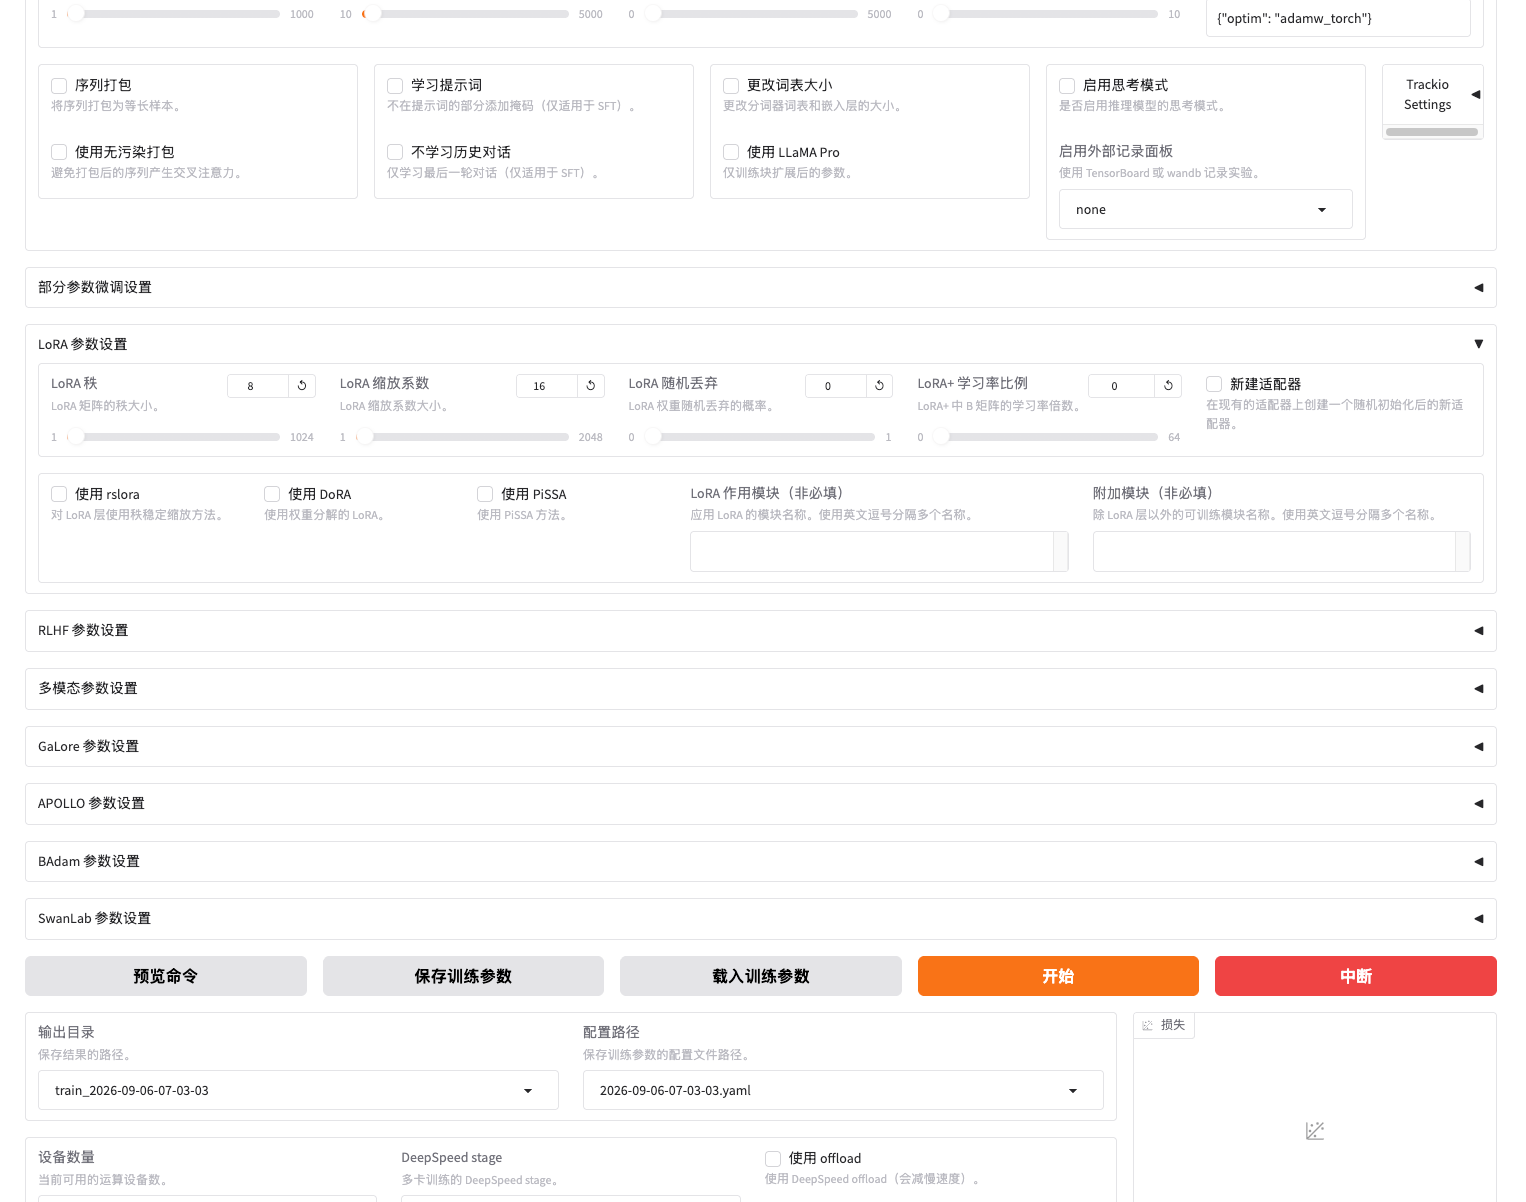
下方的“LoRA 作用模块”在图中留空;课程配置在这里填 `all`,右侧“LoRA 附加模块”留空。第 6.5 节解释作用位置,第 31 章第 7.4 节展示完整填写结果。
| 界面名称 | 配置写法 | 先理解它控制什么 |
| ------------- | ------------------ | ------------------------------------------ |
| LoRA 秩 | `lora_rank: 8` | 新增分支中间有多宽,影响可训练参数量 |
| LoRA 缩放系数 | `lora_alpha: 16` | 配合 rank,控制新增分支的增量缩放 |
| LoRA 随机丢弃 | `lora_dropout: 0` | 训练时是否随机遮住部分分支输入;本章不开启 |
| LoRA 作用模块 | `lora_target: all` | 在当前模型中哪些可用的线性层上添加分支 |
先认识这四项的位置和用途,下面各节再分别解释。其他 LoRA 变体保持未启用,矩阵图和完整手算过程可以按需展开。
### 6.2 A、B 矩阵与计算过程
原权重不更新,输出仍能变化,因为新分支贡献了一个可学习的调整量。LoRA 把这条分支写成两块小的参数矩阵 **A、B**;矩阵就是按行列排列的数值表。
同一份输入在原路径中照常计算,同时先经过 A、再经过 B 得到调整量。两路结果相加后,继续传给后面的层。
**刚加上分支,会不会立刻把原来的输出改乱?** 常见默认初始化让 A 从随机数开始,B 全为零。输入经过 A 后,无论得到什么数,再经过全零的 B,分支贡献都是零;训练随后让这个增量逐渐发生变化。因此,初始分支可以先不改变原路径的结果。
不要把它改成“A、B 都全为零”:在这个两矩阵相乘的结构中,两者都为零会使常规梯度更新无法把分支学起来。默认初始化及其他可选方式可查 [PEFT LoRA 文档](https://huggingface.co/docs/peft/package_reference/lora)。本课保持工具的默认初始化。
进阶选读:A、B 的矩阵图、向量与一次完整手算
原模型权重不更新,为什么它的输出还能改变?看清这个问题,就能理解 LoRA 为什么需要与原模型一起加载。
模型内部用一组组数值计算。一组按顺序排列的数叫作**向量**,按行列排列的数值表叫作**矩阵**。本节关注的**线性层**会用参数矩阵对输入向量做计算,得到另一组数值。LoRA 就是在选定的这些位置,增加用 A、B 表示的两块小矩阵。
下面只画其中一个线性层,不是整个模型。`x` 表示送进这一层的一组数,`h` 表示这一层算出的结果,还不是最终关键词。**第一遍先沿箭头看“两条路径 → 相加”,图中的行列数留到第 6.3 节计算参数量时再看。**
同一份输入走两条路:原权重照常计算,新增的 A、B 分支计算一个调整量,两路输出相加后传给下一层。训练时只更新 A、B,原权重保持不变。这就是图中“冻结”与“可训练”的区别。
先不算矩阵乘法,只看一个两维教学例子的结果。假设同一输入经过原路径,输出为 `[1, 2]`;经过 A、B,得到的调整量为 `[0.1, 0.2]`。暂时不加缩放系数,对应位置相加,就得到 `[1.1, 2.2]`,再交给后面的层处理。
这就是“原权重不改,计算结果仍能改变”的原因。这里的数值是为了说明两路相加,不是实际模型权重;这些中间数也还不是关键词。想知道调整量怎样算出来,可以展开下面的手算。
**选读:文字怎样变成参与计算的向量**
第 29 章把文字变成了 token 编号。例如,“市”的编号是 `22697`,但这个编号只是用来找到对应的 token,不表示它的含义就是数值二万多。
模型会先按编号取出一组数值,作为这个 token 的初始表示,这一步叫作 **Embedding(嵌入)**。这组向量会继续经过模型各层计算,与上下文结合,而不是直接拿 token 编号当作词义大小做加减。编号与向量的对应关系可对照 [PyTorch Embedding 说明](https://docs.pytorch.org/docs/2.14/generated/torch.nn.Embedding.html)。
**选读:A、B 怎样相乘,并用两维数值手算一次输出**
沿用图中“先经过 A,再经过 B”的顺序,先暂时不考虑缩放:
```text
权重增量:ΔW = B × A
等效新权重:W = W₀ + ΔW
原路径的输出:W₀ × x
新增路径的输出:B × (A × x)
这个线性层的输出:h = W₀ × x + B × (A × x)
```
`W₀` 是原权重,`ΔW` 读作“权重的改变量”。**权重与权重相加,输出与输出相加**,不能把 `W₀ × x` 的计算结果直接与 `B × A` 这个矩阵相加。两条路径都要处理同一个 `x`。
训练期间保留 `W₀`,更新 A、B;多个样本共同影响这些小矩阵中的数值。这是 [LoRA 的基本结构](https://arxiv.org/abs/2106.09685)。
**用小数字算一遍。** 为了手算,把图中的 1000 维缩成 2 维,并假设下面是一组训练后的数值;暂时仍不加缩放系数:
```text
输入 x = [1, 2]ᵀ (ᵀ 表示把这两个数竖着排列)
原权重 W₀ = [1 0] A = [0.1 0.2] B = [0.2]
[0 1] [0.4]
```
原路径保持输入不变;新增路径先把两个数算成一个数,再变回两个数:
```text
原路径:W₀ × x = [1, 2]ᵀ
先经过 A:0.1 × 1 + 0.2 × 2 = 0.5
再经过 B:[0.2 × 0.5, 0.4 × 0.5]ᵀ = [0.1, 0.2]ᵀ
两路相加:h = [1, 2]ᵀ + [0.1, 0.2]ᵀ = [1.1, 2.2]ᵀ
```
这两个数还不是最终关键词,而是继续传给后面层的中间输出。此例只用来说明“两条路径处理同一个输入,再把结果相加”;尺寸太小,不用它计算节省比例。下一节再换回大矩阵,计算参数量。
### 6.3 rank 与可训练参数量
**rank(秩,简称 r)控制新增分支中间有多宽。** 课程设置 `lora_rank: 8`,表示输入经过 A 后,先形成 8 个中间数,再由 B 继续计算。
从 8 改成 16,分支会增加可调整的数值,表达调整量的空间更大,相关训练开销也会增加。**更多可训练参数不保证关键词提取更好。** 首轮先沿用 8,需要比较分支容量时,再看下面的数量计算,并同时核对下一节的 alpha。
进阶选读:rank 8 与 16 的参数量、实际日志和比较方法
把第 6.2 节的分支画宽一点,具体会多出多少参数?假设某个线性层的输入和输出都包含 1000 个数,A 先把 1000 个数变成 `r` 个,B 再变回 1000 个:
| rank | A 的参数量 | B 的参数量 | 新增可训练参数合计 |
| ---- | -------------------- | -------------------- | ------------------ |
| 8 | `8 × 1000 = 8,000` | `1000 × 8 = 8,000` | 16,000 |
| 16 | `16 × 1000 = 16,000` | `1000 × 16 = 16,000` | 32,000 |
**从 8 改成 16,这个分支有了更多可调整的数值,能表达的修正范围更大;新增权重及其梯度、优化器状态也更多。** 原路径的 100 万个权重仍在。上表是同一个教学层的尺寸对照,不能推导出整场训练显存翻倍。
什么时候值得比较 rank?如果输入完整、标注一致、Adapter 已正确加载,而现有训练在训练集和验证集上都持续表现不足,可以将分支容量作为一个待验证因素。如果训练题已经答得很好,验证题却变差,就应先检查第 9 节的过拟合问题。
比较时,从相同基础模型分别新建 Adapter,并在日志中核对可训练参数量,再比较同一份验证数据上的损失、关键词回答与资源开销。调整时还要考虑下一节的 alpha,二者会共同决定增量缩放。
**沿用表中的 rank 8,计算节省了多少可训练参数。** A 的尺寸为 `8 × 1000`,B 为 `1000 × 8`。矩阵相乘后,`B × A` 仍是 `1000 × 1000`,能作为与原权重形状相同的增量。
```text
全参数更新这一个矩阵:1,000,000 个可训练参数
LoRA 更新 A 和 B:8,000 + 8,000 = 16,000 个可训练参数
16,000 ÷ 1,000,000 = 1.6%
1,000,000 ÷ 16,000 = 62.5
```
减少的是**这个层的可训练参数**,不是把原来的 100 万个权重删除了。此时原权重与 A、B 一共仍有 `1,016,000` 个参数,只是其中 `16,000` 个需要更新。不能由此说“整场训练显存缩小 62.5 倍”或“速度提升 62.5 倍”。
**这里的“秩”与原矩阵有什么关系?**
`B × A` 的秩不超过 `r`,不保证恰好等于 `r`。这个小宽度限制了增量能表达的变化,并不要求原矩阵本身的秩就是 8。
**实际模型更新了多少参数?** 本次清洗版训练使用 `r=8`,启动日志记录:
```text
trainable params: 5,046,272
all params: 601,096,192
trainable%: 0.8395
```
也就是约 505 万个参数参与更新,占日志统计全部参数的约 0.8395%;分母包含基础模型与新增 Adapter。
教学层的 1.6% 与整模型的 0.8395% 不矛盾:真实模型有多层、不同矩阵尺寸和不同的作用位置。完整启动记录见第 31 章的训练日志 `案例与源码-4-微调/results/keywords-clean/training/train.log`。
### 6.4 alpha 与增量缩放
**alpha 控制新增分支的结果怎样缩放后相加。** 在本课程的标准 LoRA 中,缩放倍数是 `alpha/r`。课程 `rank=8、alpha=16`,所以分支结果先乘以 2,再与原路径结果相加。
先分清两个环节:**学习率控制训练时权重怎样更新,alpha/r 控制计算时分支结果怎样加入。** alpha 不直接改变矩阵尺寸,也不能当作学习率的替代项。
首次保持 `rank=8、alpha=16`。以后改 rank 时,要连同这个比值一起看:只把 rank 改为 16,alpha 仍为 16,比值就从 2 变成 1。需要做配套对照时,再展开下面的例子。
进阶选读:alpha 的数值例子、与 rank 的配套变化及公式
沿用第 6.2 节的教学数字,暂时固定输入与 A、B:原路径输出 `[1, 2]`,新增分支算出 `[0.1, 0.2]`。当 `alpha/r` 为 1,两路相加得到 `[1.1, 2.2]`;保持 rank 不变,将 alpha 加倍,使系数变为 2,分支先乘 2,再相加得到 `[1.2, 2.4]`。**矩阵尺寸没有变,改变的是同一份分支结果加入时的大小。**
这也解释了为什么修改 rank 时需要一起看 alpha:
| 设置 | rank | alpha | alpha/r | 发生了什么 |
| --------------------- | ---- | ----- | ------- | -------------------------- |
| 课程起点 | 8 | 16 | 2 | 当前分支宽度与缩放 |
| 只增加 rank | 16 | 16 | 1 | 分支变宽,缩放系数同时减半 |
| 增加 rank,并维持系数 | 16 | 32 | 2 | 分支变宽,缩放系数仍为 2 |
如果实验要比较“分支宽度变化、相加前的缩放倍数保持一致”,第三行就是一种配套安排。它仍不保证两组梯度、训练过程或输出相同。第二行也可以作为实验,只是结论要承认它同时改变了容量和缩放,不能全部归因于 rank。
本节使用标准 LoRA 的 `alpha/r` 规则,其他变体可能不同。[本次 PEFT 0.18.1 的缩放实现](https://github.com/huggingface/peft/blob/v0.18.1/src/peft/tuners/lora/layer.py)
分支参与计算的方式变化,也会影响随后求出的梯度。比较 alpha 时,应先固定 rank 与作用位置,核对配置中的系数,再比较验证表现。
**选读:把 alpha/r 放回公式中计算**
```text
权重增量:ΔW = (alpha / r) × B × A
线性层输出:h = W₀ × x + (alpha / r) × B × (A × x)
```
暂时固定 A、B,假设 `B × A` 中某个位置是 `0.01`,原权重对应位置是 `0.30`:系数为 1 时,等效权重是 `0.31`;系数为 2 时,是 `0.32`。这是前向计算中如何组合权重的例子,不是说优化器每次更新必然翻倍。
### 6.5 target modules 与作用位置
界面中的“LoRA 作用模块”对应 **target modules(目标模块)**,指定把 LoRA 分支加到哪些层上。课程使用 `lora_target: all`,由工具为当前模型识别可应用 LoRA 的线性层。它与旁边的“附加模块”不是一回事;本课程“附加模块”留空。
模型中同一种层名可能重复出现,每个匹配的层各有自己的 A、B;原权重继续保持冻结。
调整时再看:缩小作用范围会怎样,实际添加到了哪些层
假设保持 rank 为 8,把作用位置从当前的 `all` 缩小到只选 `q_proj、v_proj`:模型中匹配这两个名称的层仍添加分支,原先其他位置的分支则不再添加。因此,可训练参数和相关状态会减少,但模型也少了一些可以学习调整的位置。**rank 决定每条分支有多宽,target 决定哪些地方有分支。**
这类比较适合回答“缩小作用范围,能否在减少开销时保留任务效果”。先从启动日志核对可训练参数量,并查看 `adapter_config.json` 的 `target_modules`,确认实际作用位置;再比较同一份验证数据上的回答。
**这次 Qwen3 的哪些层加入了 LoRA:**
清洗版 Adapter 配置记录了以下名称:
| 层名 | 所属计算部分 | 这里需要理解什么 |
| -------------------------------- | ------------------------------------ | ------------------------------ |
| `q_proj、k_proj、v_proj、o_proj` | 注意力部分的线性映射 | 这些位置会添加并训练 LoRA 分支 |
| `gate_proj、up_proj、down_proj` | 前馈网络,即每层中继续变换数值的部分 | 这些位置同样参与本次 LoRA 训练 |
这些名称在不同网络层中重复出现,各自可以有对应的 A、B。更换模型时,应重新检查它的层名与实际作用位置。
### 6.6 LoRA dropout
界面中的“LoRA 随机丢弃”对应 **LoRA dropout**,是在训练时对 LoRA 分支的部分输入值进行随机丢弃:本次暂时遮住部分输入,下次重新随机选择。
第 6.1 节截图中的辅助文字写成了“LoRA 权重随机丢弃的概率”,容易让人误以为会删除权重。这里按[本次 PEFT 的实际计算](https://github.com/huggingface/peft/blob/v0.18.1/src/peft/tuners/lora/layer.py)理解为对分支输入应用 dropout,A、B 权重仍然保留。
课程设置为 `lora_dropout: 0`,即不启用。假设改为 `0.1`,训练时分支输入中的每个数值会以 10% 的概率被暂时置零,A、B 的尺寸和参数量保持不变。
调整时再看:什么时候比较 dropout,怎样检查效果
这样做是希望分支少依赖某些输入值的固定组合,有时有助于缓解过拟合,也可能让有限训练中的学习更困难。如果核对数据和预处理后,仍出现训练表现持续改善、验证表现持续变差,可以把 dropout 作为候选调整之一。它不负责修正错误标注,也不是省显存开关。
若进行对照,两组从相同基础模型开始,保持其他训练条件一致;重点看验证损失和实际回答是否改善,即使训练损失稍高,也要结合验证结果判断。
正常推理时 dropout 会关闭。首次训练保持课程的 `0`,遇到过拟合问题再考虑是否需要比较其他值。
现在再读本节开头的四项配置:target 决定**分支加在哪里**,rank 决定**分支有多宽**,alpha/r 决定**结果怎样缩放后相加**,dropout 决定**训练时是否随机遮住部分分支输入**。
---
## 7、QLoRA 量化微调
**本节先认识用途:** QLoRA 进一步节省基础权重的存储,但仍有其他训练开销。本课程首轮不启用量化,编码细节属于进阶选读。
本课程先保持“微调方法”为 `lora`、“量化等级”为 `none`,使用 Qwen3-0.6B 练习普通 FP16 LoRA。更换较大的模型后,如果基础权重占用过多显存,再考虑下面的 QLoRA;不要仅因页面提供量化选项就全部开启。
**QLoRA** 可以先理解为“量化版的 LoRA”。它仍然训练 LoRA Adapter;不同之处在于,训练时加载的基础模型会以更低位数保存,从而减少基础模型权重的显存占用。
这里的**量化(quantization)**,是用更少的比特近似保存模型参数。例如原来一个权重用 16 bit 保存,量化后用 4 bit 编码表示;省下了空间,但数值可能出现近似误差,任务效果仍需验证。
选读图解:全参数微调、LoRA 与 QLoRA 的完整对照
### 7.1 量化与近似误差
量化可以理解为:准备一组有限的代表值,把每个原数替换为接近的代表值,并保存对应编号。4 bit 能表示 16 个编号,因此不能精确保留任意小数。计算时根据编号还原近似值,这一步叫作**反量化**。
先只跟踪一个数:在下面的等间距量化教学例子中,原来的 `0.27` 经过“选一个接近的代表值 → 保存编号和缩放因子 → 还原”,得到的是 `0.304`,相差 `0.034`。
为什么还原后不再是 `0.27`?因为保存的是有限选项中的编号,没有保留这个数的全部信息。**量化用近似换空间,反量化取回的是近似值。** 具体编号怎样算、QLoRA 使用的代表值有什么不同,见下方选读。
选读:一个权重怎样变成 4-bit 编号,又怎样还原
将上面的教学例子展开,假设一组参数是:
```text
0.27,0.58,-0.75,1.52
```
这一组绝对值最大的数是 `1.52`。我们把它保留下来作为缩放因子,再把各数除以它,将数值缩到 -1~1 的范围。这里只跟踪第一个数 `0.27`:
| 步骤 | 计算或保存的内容 | 这一步做了什么 |
| -------------- | ----------------------------------- | ------------------------------------------- |
| 缩放到统一范围 | `0.27 ÷ 1.52 ≈ 0.1776` | 先变成便于查表的小数 |
| 找最近的代表值 | `0.1776 → 0.2` | 在 -1~1 的 16 个等间距代表值中选最近的一个 |
| 保存编号 | `0.2` 对应编号 `9`,二进制为 `1001` | 编号只需 4 bit;同时保留这组的缩放因子 |
| 反量化 | `0.2 × 1.52 = 0.304` | 用编号查回代表值,再恢复到原来的量级 |
16 个代表值按从小到大编号为 0~15,编号 9 对应 `-1 + 9 × 2/15 = 0.2`。编号保存的是“选了哪个代表值”,并没有另外记住原数 `0.1776`。
所以,还原后是 `0.304`,不是原来的 `0.27`,绝对误差为 `0.034`。**反量化是恢复近似值,不是无损解压。** 模型是否还能完成任务,要继续评估,不能仅凭文件变小就判断效果。
这里使用的是**等间距量化示例**。QLoRA 中常用的 **NF4** 不是这张等间距表,而是针对权重分布设计的一组非等间距代表值;这里只借简单数字理解“存编号、存缩放因子、存在近似误差”。[QLoRA 论文](https://arxiv.org/abs/2305.14314)
拓展计算:为什么 4-bit 的实际存储还包含额外开销
除了参数的编号,还要保存把这一组数恢复到原量级的缩放因子等辅助信息。假设四个数为一组,原来都用 FP16 保存,一共是 `4×16=64 bit`。现在四个 4-bit 编号占 `16 bit`;若这一组的缩放因子用 FP32 保存,还要加 `32 bit`,合计 `48 bit`。即使暂时不计其他开销,这个小例子的总量也不是原来的四分之一。
四个数分一组只是为了方便计算。若改成每 64 个数共用一个 FP32 缩放因子,编号与缩放因子共占 `64×4+32=288 bit`,相当于每个数平均 `4.5 bit`。这样就能看出:缩放因子也占空间,只是被一组数分摊了。这里仍未计入码表等其他开销,也没有加入下一节的双重量化。
### 7.2 QLoRA 的显存开销
回到第 5 节的显存组成:LoRA 已经减少了需要更新的参数及相关状态,QLoRA 进一步压缩的是仍需加载的**基础模型权重**。Adapter 的梯度、优化器状态和中间计算结果仍然需要空间。
训练时,量化基础权重保持冻结,需要计算时按实现恢复到相应计算精度参与运算;可训练的 LoRA 参数并不是简单地全变成 4-bit。因此不能只看“模型已经量化”就认定一定能训。序列长度、单卡 batch、训练工具的实现和实际 GPU,仍会决定能否稳定运行。
还要区分报错发生在哪一步:**基础权重尚未加载完就显存不足**,先检查模型大小、加载精度和 GPU 上其他进程;**权重已加载、开始处理批次后才不足**,再优先检查长度和单卡 batch。减小 batch 不会缩小基础权重本体,详细排查放在第 33 章。
拓展术语:双重量化与分页优化器
QLoRA 还采用了两项优化:**双重量化(double quantization)** 进一步量化缩放因子等辅助常数,减少这些额外信息的存储;**分页优化器(paged optimizer)** 通过在 CPU 与 GPU 之间按需迁移优化器状态,缓解训练中的显存峰值,但可能增加传输等待。它们都不改变“冻结量化基础权重、训练 LoRA 参数”的更新范围,也不保证任何配置都能放进显存。[QLoRA 论文](https://arxiv.org/abs/2305.14314)
### 7.3 LoRA 与 QLoRA 的选择
| 当前情况 | 优先考虑什么 |
| ------------------------------------------ | ------------------------------------------------ |
| 本课程 Qwen3-0.6B 能在现有显卡上完成 LoRA | 保持 LoRA,先检查训练与任务效果 |
| 换大模型后,仅加载基础权重就占去过多显存 | 检查加载精度,再评估 QLoRA |
| 能加载模型,但处理长样本或大批次时显存不足 | 先检查长度与 batch,不能只靠量化解决 |
| 需要验证两种方法的资源差异 | 固定模型、数据和其余配置,分别记录实际资源与效果 |
调整时再看:从 LoRA 改为 QLoRA,要比较哪些结果
把当前配置中的量化等级从 `none` 改为适当配置的 4-bit 加载,主要变化是基础权重的保存与计算方式;学习的仍然是 LoRA 分支。额外的量化、反量化计算和具体实现会影响速度,因此 QLoRA 也可能更慢。它带来的近似误差是否影响关键词选择,还要检查回答。
对本课程已能完成普通 LoRA 的 0.6B 模型,先用现有配置完成训练与效果检查。将来换大模型,若权重占用成为主要限制,再比较 QLoRA:核对量化是否实际生效,记录能否完整运行、显存与耗时,最后比较同一份验证数据的损失和回答。**能容纳模型、运行成本合适、任务效果可接受,是三个需要分别检查的结果。**
量化依赖、配置和资源对比留到[第 33 章](33-微调显存优化与多卡训练.md)第 2.5、2.6 节选做,结果整理方法见该章第 5.5 节。
---
## 8、训练配置与显存估算
**本节先掌握:** 对照第 8.1 节,把配置读成一次完整的训练安排。第 8.2 节的计算器是更换配置时的选读工具,估算还需要实机验证。
现在回到本章开头的任务:使用第 29 章清洗并划分的数据,在 AutoDL 的现有 V100-32GB 单卡上,对 `Qwen/Qwen3-0.6B` 做 LoRA 微调。下面不增加新参数,而是试着把整份配置读成一次训练安排。
### 8.1 首轮训练配置
第 2 节先认识了训练页面和三个批次参数。现在回到 `案例与源码-4-微调/configs/keywords_clean_train.yaml`,把整套设置连起来读:
先用本章开头的五项设置,把安排说清:每批 4 条、累积 8 批后更新,1,600 条训练数据练 3 轮;学习率按 `5e-5` 调度,每条完整训练序列最多保留 2048 个 token。预计每轮更新 50 步,合计 150 步。
再核对两个条件:使用匹配的模型与模板,V100 上采用已验证的 FP16。LoRA 先沿用课程设置;日志、验证与保存间隔属于观察和留存安排。
运行时查阅:首轮训练的完整字段与取值
| 中文名称与配置字段 | 本次取值 | 对应前面学到的含义 |
| ---------------------------------------------------------------------------------------------------------------- | --------------------- | ------------------------------------------------------------------------------------------------------------ |
| 模型路径
`model_name_or_path` | `Qwen/Qwen3-0.6B` | 指定要微调的模型 |
| 对话模板
`template` | `qwen3_nothink` | 按模型要求组织输入与答案 |
| 思考模式
`enable_thinking` | `false` | 请求关闭思考;实际处理取决于模板,见[第 32 章对照](32-微调效果评估与模型部署.md?id=_24-从单条观察到批量测试) |
| 训练集
`dataset` | `keywords_train` | 1,600 条样本,用于更新参数 |
| 验证集
`eval_dataset` | `keywords_validation` | 200 条样本,用于训练中检查 |
| 自动验证划分
`val_size` | `0` | 已有独立验证文件,不再额外划分 |
| 截断长度
`cutoff_len` | `2048` | 每条训练序列的 token 数上限 |
| 单卡批处理大小
per_device_train_batch_size | `4` | 每张卡每个小批次处理 4 条样本 |
| 梯度累积步数
gradient_accumulation_steps | `8` | 累积 8 个小批次后更新一次参数 |
| 训练轮数
`num_train_epochs` | `3` | 训练集学习 3 遍,预计共 150 个更新步 |
| 优化器
`optim` | `adamw_torch` | 使用 PyTorch 的 AdamW 更新参数 |
| 学习率
`learning_rate` | `5.0e-5` | 本例预热结束时达到的学习率 |
| 学习率调度器
`lr_scheduler_type` | `cosine` | 预热后按余弦曲线降低学习率 |
| 预热步数
`warmup_steps` | `5` | 前 5 个更新步逐步提高学习率 |
| FP16 混合精度
`fp16` | `true` | 开启本次 V100 使用的混合精度训练 |
| BF16 混合精度
`bf16` | `false` | 本次不开启 BF16 |
| LoRA 秩
`lora_rank` | `8` | 设置新增分支的中间宽度 |
| LoRA 缩放系数
`lora_alpha` | `16` | 配合 rank,按 `alpha/r` 缩放分支结果 |
| LoRA 随机丢弃
`lora_dropout` | `0` | 不随机丢弃分支输入 |
| LoRA 作用模块
`lora_target` | `all` | 在工具识别的适用线性层添加分支 |
| 日志间隔
`logging_steps` | `5` | 每 5 个更新步记录一次日志 |
| 验证间隔
`eval_steps` | `50` | 每 50 个更新步检查一次验证损失 |
| 保存间隔
`save_steps` | `50` | 每 50 个更新步保存一次检查点 |
200 条测试数据留给最终检查,不参与本轮训练或检查点选择。第 31 章会把这份配置对应到 WebUI 的填写位置,并提供可选的命令行入口。
这份配置的取值依据需要分开理解:模型与模板要匹配,计算精度要适合硬件,长度要能保留完整样本,这些都有明确的检查条件;batch、学习率、轮数和 LoRA 参数则组成了一套已运行过的起始安排。已有记录便于复现和比较,不能据此称它为最优组合。
选读图解:整套训练配置与产物的对应关系
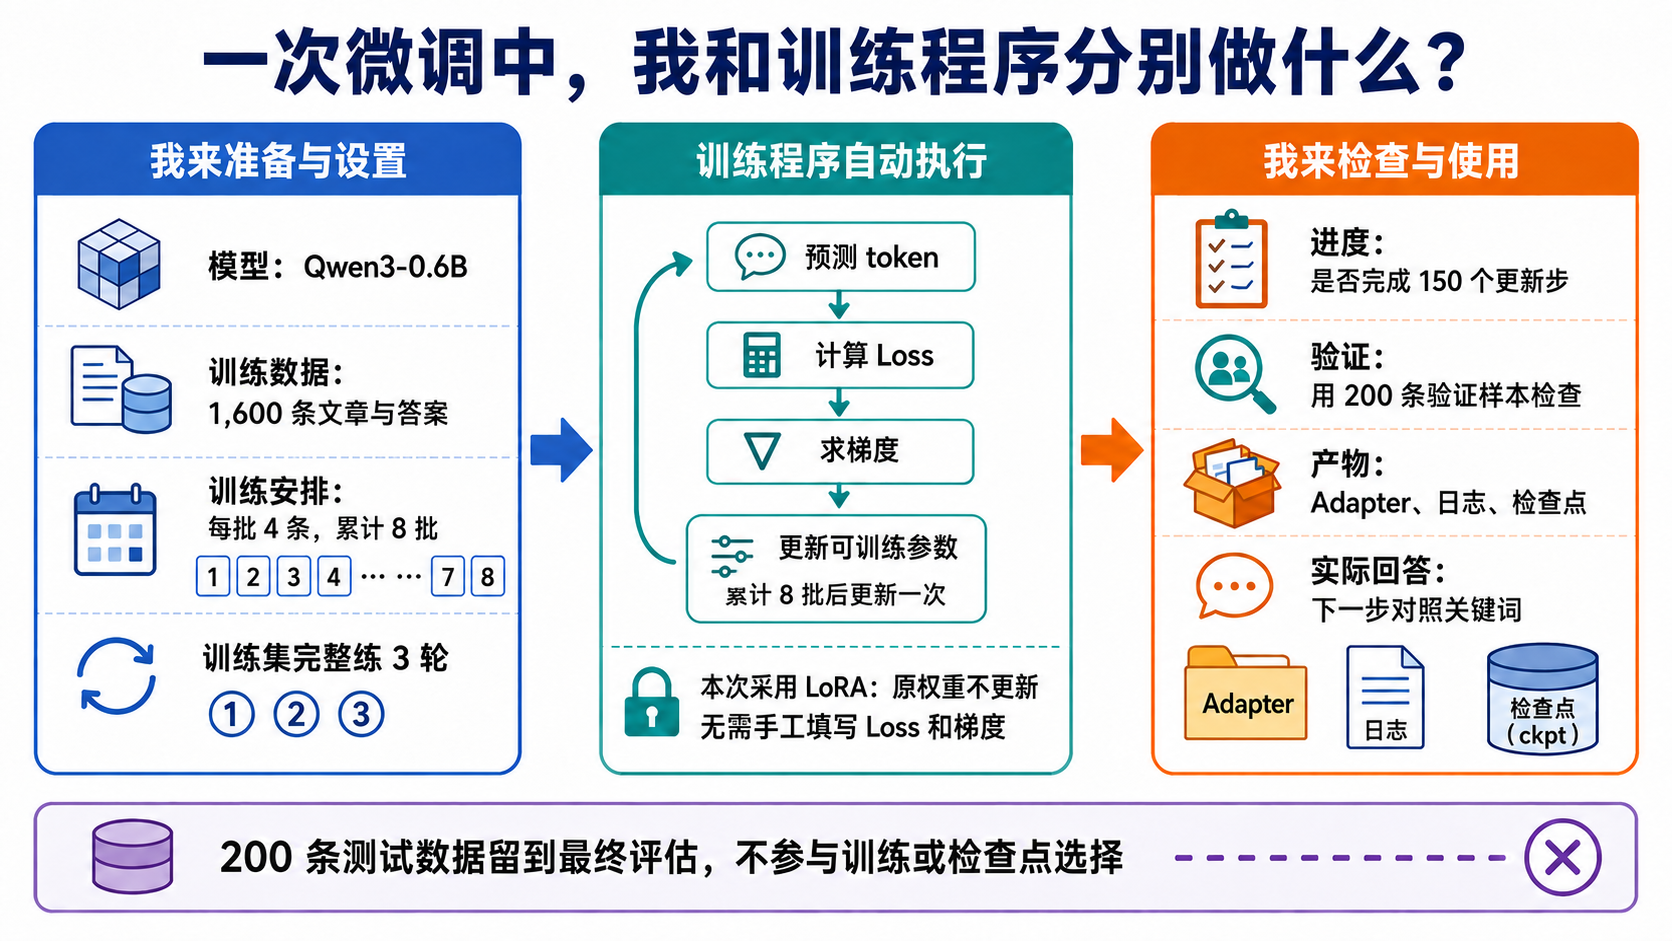
**先不翻前文,试着向别人说明这次训练:**
1. 训练、验证、测试各用多少条?哪一份数据会让参数发生更新?
2. 每次只处理 4 条,为什么不是每轮更新 400 次?第 50 步时准备做什么?
3. 使用 LoRA 后,训练结束得到什么?拿到这个文件,是否就能证明关键词抽取变好了?
参考回答:把配置连成一段完整的训练说明
我们用 1,600 条文章与参考答案训练,只更新选定层的 LoRA 分支。每批处理 4 条,累计 8 批、也就是 32 条后更新一次;每轮 50 步,3 轮共 150 步。每 5 步记录日志,每 50 步用 200 条验证数据检查并保存检查点。验证过程不更新参数,但其结果会用于选择检查点;200 条测试数据继续保留。
训练得到 Adapter、日志和检查点。Adapter 需要与对应的原模型一起使用;接下来还要比较实际生成的关键词,不能只凭 Loss 降了或文件保存成功,就宣布任务效果改善。
能说明这段安排以后,再做一道配置判断题:**假设模型加载成功,但处理批次时显存不足。同学建议同时把 batch 改成 2、学习率改成 `1e-4`、rank 改成 16、截断长度改成 512。你会怎样处理?** 先说出报错对应哪部分占用,再决定保留哪些修改。
参考判断:每个修改都要有目的和检查依据
先把 batch 改为 2,配合累积 16,维持有效批次 32;学习率和 rank 保持课程取值。这次要解决的是同时处理样本的空间问题,增大学习率不会减少占用,增大 rank 还会增加可训练参数的相关开销。
长度先保持 2048。已有记录中最长样本为 957,直接降到 512 会使部分样本无法完整保留。如果后续确实需要缩短,应先检查截断后的输入和答案,不能为了通过第一批而丢掉关键词的来源。
然后核对启动日志:有效批次仍为 32,总更新步数仍为 150。观察原来的报错位置是否通过,并继续看更长批次及验证过程,记录显存与耗时;若仍报错,再按第 33 章检查其他占用。资源问题解决后,实际回答仍按第 32 章验证。
修改配置前,可以用一句话记录实验目的:“我准备改什么,希望改变哪一步,之后用什么结果判断。”例如,比较学习率就固定数据、模型、模板和其他训练设置;比较 rank 并维持相加前的缩放倍数,则按第 6.4 节配套处理 alpha。**一次比较围绕一个明确问题,并记录相关设置的变化。** 不同实验从约定的相同起点开始、使用不同输出目录,才能把结果对上。
### 8.2 使用显存计算器
**本小节选读。** 首次跟做已有课程配置,可以先继续第 9 节。以后更换模型或训练设置时,再用计算器作粗略估算,之后通过实机试跑检查。
记住一个边界:计算器的估算值不等于真实峰值,也不能证明显卡精度兼容或训练一定能完成。
选读操作:填写显存计算器、理解结果并与实际运行对照
打开 [ApX 显存计算器](https://apxml.com/zh/tools/vram-calculator),选择“微调”和“LoRA”,再填写模型与主要训练参数。不要使用“推理”页面估算训练,因为它不包含同样的训练状态。
对照上表,填写模型 Qwen3-0.6B、rank 8、batch 4、长度 2048、梯度累积 8:
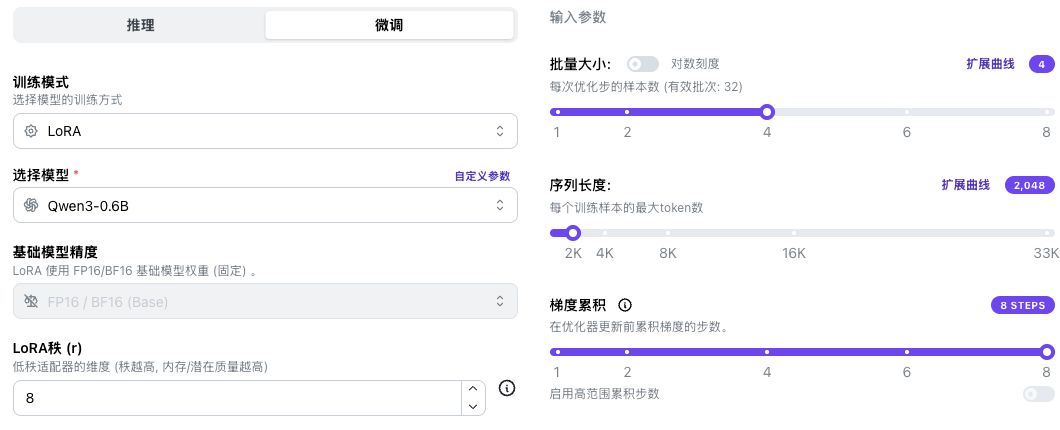
图中 batch 的提示文字提到了“每次优化步”,读时要分清:输入框里的 `4` 是单卡每个小批次的样本数,配合累积 `8` 次,才得到每次参数更新的有效批次 `32`。
计算器中还有三个需要注意的地方:
- 精度统一显示为 FP16/BF16;本次 V100 配置使用 FP16,不能凭这个合并选项判断硬件兼容性。
- 没有 V100 预设时,选择单卡并自定义 32 GB 显存容量;这只匹配容量,不能据此估算 V100 的训练速度。
- 优化器选 AdamW,梯度检查点开启、页面比率为 100%。这是第 5.3 节说的减少中间结果保存,不是训练文件的保存频率。
同一组设置的结果约为 **9.8 GB**:
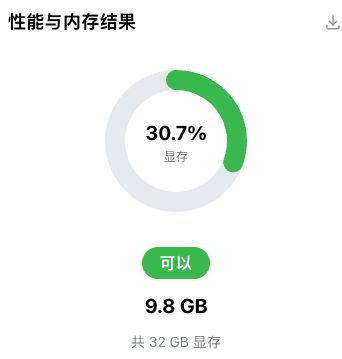
这个数是按页面假设分项相加得到的预算:模型权重约 1.2 GB,中间结果约 7.1 GB,LoRA 优化器与梯度约 0.01 GB,框架开销约 1.5 GB,合计约 9.8 GB。各项是计算器估算值,不是训练过程中的测量值。
**为什么第 33 章实际采样达到约 27.92 GiB?** 两处记录的范围不同:
| 对照项 | 计算器的 9.8 GB | batch 4 对照实验的 27.92 GiB |
| ------------ | --------------------------------------------------------------- | ---------------------------------------------------------- |
| 怎样得到 | 按长度 2048 等输入与页面公式估算各项预算 | 运行 LLaMA-Factory,每 200 毫秒采样一次整张 GPU 的已用显存 |
| 包含哪些条件 | 使用页面默认填充、运行开销等假设;没有 alpha、target 的独立入口 | 包含模型加载、训练、验证和保存期间的实际分配与缓存 |
| 数值表示什么 | 简化预算的合计 | 全程最高采样值 28,588 MiB,约 27.92 GiB,即约 29.98 GB |
实际软件在不同阶段会申请临时空间,并保留部分缓存;计算器的固定预算无法完整反映这个过程。现有记录没有逐项显存追踪,因此还不能把差额归到某一个组件。选配置时用估算筛选方案,确定能否稳定运行则要看[第 33 章的实际资源记录](33-微调显存优化与多卡训练.md?id=_26-怎样判断调整是否有效)。
读完这组截图,可以用前面的知识检查自己的理解:如果模型和精度不变,只把 batch 从 4 改为 8,模型权重不会随之翻倍,主要增加的是并行处理样本的计算占用;如果只提高长度上限,影响还取决于实际样本长度、填充方式以及计算器的假设。
需要估算新配置时,可以先只改 batch,记录新读数;再恢复原值,比较长度上限。假如计算器随上限提高而给出更高估算,先看它是否按所填长度计算,不要直接套到当前最长 957 token 的实际数据上。估算帮助筛选待试的方案,真正保留哪个设置,还要对照实际运行的占用、耗时和样本完整性。
**估算示例:同一个 8B 模型为什么推理与全参数训练占用不同**
下面比较同一计算器在两种输入条件下的估算,用于理解计算过程的差别:
| 模式 | 估算输入条件 | 页面估算 |
| ---------- | ------------------------------------------------------------------ | -------- |
| 推理 | Qwen3-8B、FP16 权重、FP16/BF16 KV 缓存、batch 1、长度 1024、并发 1 | 17.2 GB |
| 全参数微调 | Qwen3-8B、FP16/BF16、batch 1、长度 1024、梯度累积 1 | 143.4 GB |
全参数训练还要保存大量梯度和优化器状态,所以估算明显增大。143.4 GB 不是 8B LoRA 的显存需求,也不能把两项的比值当成所有模型的固定规律。
---
## 9、训练日志与检查点
**本节先掌握:** 看训练进行到哪里、验证结果是否改善、产物保存在哪里。训练 Loss 下降后,还要检查实际生成的关键词。
配置决定预期,日志告诉我们实际发生了什么。下面使用 `keywords-clean` 数据的一次 150 步训练作为示例:本章学习读日志,第 31 章学习怎样运行,第 32 章再检查对应 Adapter 的回答。
先按时间顺序看三个位置:**第 5 步出现一条训练日志,第 50 步完成第一轮并验证、保存,第 150 步完成三轮,再按验证结果选择检查点。** 下面的日志、曲线和文件列表,就按这条顺序来读。
### 9.1 阅读一条训练日志
训练启动后,界面日志区或终端会先列出训练安排。下面摘取示例日志中的关键字段,省略时间和日志前缀:
```text
Num examples = 1,600
Num Epochs = 3
Instantaneous batch size per device = 4
Total train batch size (w. parallel, distributed & accumulation) = 32
Gradient Accumulation steps = 8
Total optimization steps = 150
```
先找到 `Num examples = 1,600`、`Num Epochs = 3` 和 `Total optimization steps = 150`,就能与第 2 节的计算对应起来。有效批次对应 `Total train batch size = 32`;进度条中的 `21/150` 则表示已经完成 21 个更新步。
在示例的 `trainer_state.json` 中,第 5 步包含以下信息。这里只摘取四个字段,Loss 保留四位小数:
```json
{
"step": 5,
"epoch": 0.1,
"loss": 4.1185,
"learning_rate": 0.00004
}
```
| 字段 | 这条记录表示什么 |
| ------------------------ | ---------------------------------------------- |
| `step: 5` | 已完成 5 个参数更新步 |
| `epoch: 0.1` | 第一轮约完成 10%;本轮每轮 50 步,5 ÷ 50 = 0.1 |
| `loss: 4.1185` | 最近记录区间内汇总的训练损失 |
| `learning_rate: 0.00004` | 第 5 次更新使用的学习率,即 `4e-5` |
本次 `logging_steps: 5`,表示每 5 个更新步记录一次。结合梯度累积 8,可以把它读成:正常情况下处理 40 个小 batch 后,出现下一条训练损失记录。
调整时再看:日志记录更少,是否代表训练更新更少
若只把日志间隔从 5 改成 10,正常记录点会从 5、10、15……变成 10、20、30……,每条训练 Loss 的汇总区间也随之改变。更新参数的次数没有因此减半,只是观察得更稀疏了。日志点少,可能漏掉短暂波动;不要把记录点更少、曲线看起来更平滑误读成模型学得更稳。
读到这里,先确认进度在增长、Loss 为有效数值、学习率按预热与衰减安排变化。某一步的精确记录时序需要时再查。
查日志时再看:预热第 5 步的学习率为什么是 4e-5
**配置是 `5e-5`,第 5 步为什么记录 `4e-5`?** 本轮使用 5 步预热,日志记录本次更新所用的学习率。开始第 5 次更新前,调度器已推进 4 次,所以学习率为 `5e-5 × 4/5 = 4e-5`;这次更新完成后,调度器才推进到 5,为下一次更新准备 `5e-5`。这是本轮 [Transformers 5.8.0 的记录与调度顺序](https://github.com/huggingface/transformers/blob/v5.8.0/src/transformers/trainer.py#L1766-L1786)。
日志还可能带有 `grad_norm`,它是梯度整体大小的一个汇总量,可用于排查梯度异常。
**遇到异常时,先分清是哪一种。** 可以按下面的现象选择检查方向:
| 看到的现象 | 首先检查什么 |
| -------------------------------- | --------------------------------------------------------------------------------------------- |
| Loss 在有限数值之间上下波动 | 结合多个记录点与验证表现判断;不同批次难度不同,一次上升不能证明训练失败 |
| Loss 或梯度反复出现 `NaN`、`Inf` | 保留首次异常附近的日志和配置,检查数据、有效答案标签、学习率与计算精度;不要靠增加 epoch 解决 |
| `grad_norm` 偶尔很大 | 对照异常批次和前后记录;这个数受模型、数据和统计方式影响,没有跨任务通用的正常阈值 |
| 报错包含 `CUDA out of memory` | 按第 33 章的报错阶段检查显存占用;它与数值变成 NaN 是不同问题 |
`NaN` 表示运算没有得到有效数值,`Inf` 表示无穷值,可能与数值溢出等问题有关。先回看第 4.2 节的实际输入、截断后答案及 `labels`,确认仍有参与计算的答案位置;再核对精度与原配置。保留出问题的版本,每次只改变一个候选因素,才能判断哪项处理有效。若异常持续,应停止本次运行后排查,不把保存出的权重直接作为有效结果。
排查时再看:梯度裁剪、FP16 与日志里的异常值
**梯度裁剪**是在更新参数前,限制梯度整体大小的一种方法。以本课普通单卡训练使用的范数裁剪为例,当梯度整体大小超过 `max_grad_norm` 时,程序按比例缩小梯度;它限制的是梯度,不是把 Loss 压到这个数值。
本课 Transformers 5.8.0 的 `grad_norm` 记录来自裁剪前的范数。因此,假设阈值为 `1.0`、日志显示 `4.0`,并不说明裁剪没有生效。这里的数字是教学示例;裁剪与记录顺序可查[对应版本源码](https://github.com/huggingface/transformers/blob/v5.8.0/src/transformers/trainer.py#L2496-L2500)。
FP16 的数值表示范围有限。混合精度训练通常使用**梯度缩放**,先放大损失以减轻很小的梯度下溢,再在更新前还原梯度的尺度;它与裁剪处理的环节不同,也不能修复错误数据或保证任何模型都适合 FP16。精度排查仍需遵守第 31 章的显卡兼容条件,不能在 V100 上直接改用 BF16。详见 [PyTorch 混合精度说明](https://docs.pytorch.org/docs/2.14/amp.html#gradient-scaling)。
还要注意,训练工具可能过滤日志汇总中的非有限 Loss。本课版本的 `logging_nan_inf_filter` 只影响日志统计,不负责修复梯度;曲线看起来正常,也不能替代对异常日志和实际回答的检查。具体定义见[训练参数源码](https://github.com/huggingface/transformers/blob/v5.8.0/src/transformers/training_args.py)。
### 9.2 训练损失与验证损失
每处理一批训练数据,程序会计算损失并参与参数更新;**验证时则使用另一份数据计算损失,不执行参数更新**。
本次 `eval_steps: 50`,表示每完成 50 个更新步,就用全部 200 条验证样本做一次检查。因此正好在每轮结束时各有一次验证:
| 更新步 | 训练进度 | 验证 Loss |
| ------ | ----------- | --------- |
| 50 | 第 1 轮结束 | 1.7238 |
| 100 | 第 2 轮结束 | 1.5951 |
| 150 | 第 3 轮结束 | 1.5880 |
这三次验证使用同一份数据。从第 50 步到第 100 步,验证损失降低约 `0.1287`;再到第 150 步,降低约 `0.0071`。后 50 步的改善幅度变小,但三个点还不能证明继续训练一定更好或已经过拟合。
这张表支持的判断是:**本轮训练中,后面的检查点在同一验证集上的损失更低。** 若想判断多练一轮是否值得,下一步应让这些检查点在相同生成设置下回答同一批验证输入,检查漏词、名称与格式。多花了计算时间,任务错误是否也减少,需要这一步来回答。
例如,假设候选甲的验证 Loss 更低,候选乙在关键词检查中更少漏掉完整名称,该怎样选?先确认两者使用相同验证输入、模板和生成设置,再按预先确定的任务验收要求比较。**“按 Loss 选出的最佳检查点”只表示它在这个选择指标上最好。** 若改为按任务指标选型,应记录新的选择依据,并留待独立测试验收。
查日志时再看:最后一条 Loss 与全程 train_loss 为什么不同
训练结束还会出现 `train_loss`。它和中途日志里的 `loss` 不是同一个统计区间:
| 记录 | 本次数值 | 统计含义 |
| ----------------------- | -------- | -------------------------- |
| 第 150 步的 `loss` | 1.4353 | 最近一个日志区间的训练损失 |
| 结束汇总的 `train_loss` | 1.8547 | 全程训练损失的汇总值 |
| 第 150 步的 `eval_loss` | 1.5880 | 这一轮验证数据的损失 |
因此,“最后一条 Loss 是 1.4353,为什么结束统计又是 1.8547”并不矛盾;前期较高的损失也计入全程统计。它们不是百分比,也不是关键词准确率。
表中数值保留四位小数。需要复算时,可在配套 `results/keywords-clean/training/` 中查看 `trainer_state.json` 和 `train_results.json`;阅读时先分清各字段的统计范围。
### 9.3 Loss 曲线与常见现象
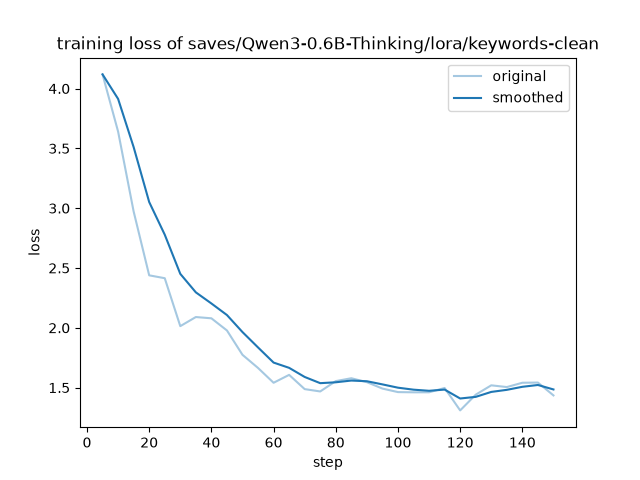
下面分别是示例训练的训练曲线和验证曲线:
**训练曲线:每 5 个更新步记录一次。**
**验证曲线:只在第 50、100、150 步实际检查,共三个记录点。**
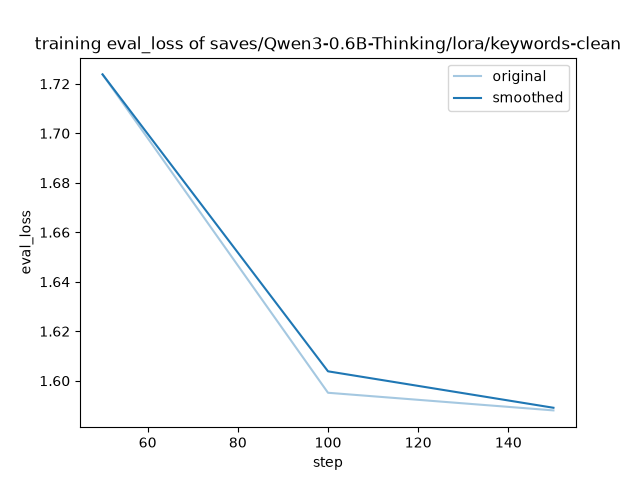
_验证点之间的连线便于观察趋势,期间没有额外的验证记录。_
曲线横轴表示训练进度,纵轴是 Loss。每张图里的浅色 `original` 是原始记录,深色 `smoothed` 是平滑后的线,两条线都来自同一类损失,并非一条训练、一条验证。平滑只是便于观察趋势,没有额外做一次训练或验证。**两张图的纵轴范围不同,不能直接用线条的陡峭程度比较下降幅度。**
先观察整体趋势,再回到日志定位发生变化的位置:
_图:教学示意,不是本次训练曲线。蓝色实线表示训练 Loss,橙色虚线表示验证 Loss;没有画验证线的两行,只讨论训练日志中的现象。_
不要给所有任务规定“Loss 必须降到 0.1”之类合格线。这里比较的是模型对参考答案的预测情况;实际关键词还需要单独检查。
**Loss 下降以后,还要检查实际回答。** 示例 Adapter 对一篇矿山降温文章能按分号格式输出,但相对参考答案仍漏了“制冷降温”“焓差”等词。第 32 章会[逐项拆解这条回答](32-微调效果评估与模型部署.md?id=_23-原始模型与-adapter-的回答对照),再通过批量评估判断问题是否普遍。
#### 9.3.1 过拟合的判断与处理
先练习读一组变化。**下表是为讲解而构造的数字,不是真实运行结果,也不是判断合格的分数线。** 假设每轮结束都按相同方式统计损失,并使用同一份验证集:
| 训练进度 | 训练 Loss | 验证 Loss | 可以观察到什么 |
| ----------- | --------- | --------- | ------------------------------------------------- |
| 第 1 轮结束 | 1.8 | 2.0 | 留下第一次检查结果 |
| 第 2 轮结束 | 1.4 | 1.6 | 两边都下降,验证数据上的预测也在改善 |
| 第 3 轮结束 | 1.1 | 1.7 | 训练继续改善,验证开始变差,需要继续核对 |
| 第 4 轮结束 | 0.9 | 1.9 | 验证连续变差,不应只因训练 Loss 更低就选择第 4 轮 |
第 2 轮以后,模型更贴近训练题的答案,验证题的损失却反而上升。这是需要检查过拟合的信号。重点是**同一训练过程中两边的变化趋势**,不是要求两个 Loss 必须相等,也不是用某一次差值下结论。
遇到这样的走势,按下面的顺序检查:
1. **先确认比较条件没变。** 是否一直使用同一份验证数据、同一套模板与预处理?文章或参考答案是否被截断?先排除数据与处理错误。
2. **再看实际回答。** 用较早和较晚的检查点,在相同生成设置下回答同一批验证输入。对照参考答案,检查新出现的漏词、多词和格式错误,不只盯着两条曲线。
3. **根据验证结果调整。** 如果较晚的检查点在验证损失和实际回答上都更差,可以保留较早的检查点,减少训练轮数;再回查训练数据是否重复过多、题材过于单一或答案有误,而不是继续加轮数。
这些选择都使用验证集,**不拿测试集反复挑检查点**。测试集仍按第 29 章的约定,留给方案确定后的最终比较。
回到本章的真实日志示例:三次验证 Loss 都在下降,不能把上表后两轮的现象套在它身上。下降幅度变小,也不等于已经过拟合。下一节再看示例配置怎样保存和选择检查点。
### 9.4 训练检查点与 Adapter
每隔一段时间保存训练状态,得到的存档就是**训练检查点(checkpoint)**。本次 `save_steps: 50`,实际保存了 `checkpoint-50`、`checkpoint-100` 和 `checkpoint-150`,分别对应完成 50、100、150 次更新时的状态。
把第 9.2 节的验证表与存档对上,就知道为什么同时设置“验证”和“保存”:第 50、100、150 步各有一份验证结果,也各有一份可加载的模型存档。
如果把验证、保存间隔都从 50 改成 25,这次 150 步训练就会在 25、50、75、100、125、150 步检查并存档。候选检查点更密集,验证计算、文件写入和保留存档的磁盘开销也可能增加。两种频率都不直接改变每次参数更新的学习率或 batch;调整时还要满足工具对最佳检查点选择的间隔要求,第 31 章保持二者一致。
配置还设置了 `load_best_model_at_end: true`:训练结束后,按 `eval_loss` 选择验证损失最低的检查点。本次最低值恰好出现在第 150 步,因此选中 `checkpoint-150`。如果最低值出现在较早的检查点,就应按所设规则选它,而不是固定选择最后一份。
跟做时,检查点保存在第 31 章配置的训练输出目录中。先认识两类内容即可,具体文件检查与下载留在第 31 章:
- `adapter_model.safetensors` 和 `adapter_config.json`:保存 LoRA 增量权重与配置,加载时需要匹配的基础模型。
- `checkpoint-*`:除相应 Adapter 外,还保存优化器、调度器、训练状态等,用于恢复训练或检查过程;只复制一份增量权重不等于完整续训存档。
示例 Adapter 权重约 20 MB,只保存新增的 LoRA 权重,不代表完整 Qwen 模型只有这么大。下载和保存时,仍需区分“用于加载的 Adapter”和“用于继续训练的完整检查点”。
推理时可以让基础模型与 Adapter 一起加载,也可以在支持的配置下把增量合并到对应基础权重,再导出完整模型:
图中展示的是两种产物的关系。第 31 章先完成训练和文件保存,第 32 章再实际[加载、比较与导出模型](32-微调效果评估与模型部署.md)。
---
**章节思考题:**
1. 关键词 SFT 中,模型在预测什么?Loss、梯度和优化器怎样把参考答案用于参数更新?
**参考思路:** 模型根据文章、任务说明和前面的参考答案片段,预测后续 token。交叉熵用模型给正确 token 分配的概率衡量损失;反向传播据此求可训练参数的梯度,优化器再按规则更新参数。Loss、梯度由程序计算,学习率等设置由我们配置;训练并不是先生成整段答案,再数错了几个关键词。
2. 本课关闭 train_on_prompt,为什么用户文章仍必须保留?如果参考答案中混入了无依据关键词,Loss 降低又说明什么?
**参考思路:** 关闭该设置表示用户内容对应的预测位置不直接计入损失,文章仍作为上下文参与计算、占用序列长度。错误参考也会成为学习目标,训练可能提高那些错误词的预测概率。因此 Loss 降低只说明更贴近当前训练目标,还要核对参考答案质量和实际生成效果。
3. 单卡、不打包、1,600 条样本均保留,batch 为 4、梯度累积为 8、训练 3 轮:有效批次和总更新步数各是多少?只把 batch 改为 2 后,怎样维持原更新安排?
**参考思路:** 原有效批次为 4×8=32,每轮 1,600÷32=50 步,3 轮共 150 步。只减 batch 时,有效批次变成 16,总步数变成 300;每 50 步验证也变为每半轮一次。将累积同步改成 16,可恢复有效批次 32 和总计 150 步,但耗时与数值结果仍需实际比较。
4. 学习率、预热和衰减分别控制什么?配置填了 learning_rate=5e-5,为什么日志中的学习率仍会变化?
**参考思路:** 学习率控制参数更新步长;预热让初期学习率从较小值逐步升高,衰减让后期学习率逐步降低。本课同时设置 cosine 调度和 5 个预热步,5e-5 是预热结束时达到的值,之后按调度变化。调大学习率不等于学得更好,是否合适要结合训练稳定性与验证回答判断。
5. 训练显存主要用在哪里?Adapter 文件很小,为什么仍可能显存不足?梯度检查点又节省哪部分?
**参考思路:** 主要包括模型权重、梯度、优化器状态和计算中间结果,此外还有运行开销。Adapter 文件只反映部分训练产物,不包含整场计算所需的空间。梯度检查点少保存一些中间结果,需要时重算,以额外计算换显存;它与按步数写入磁盘的训练检查点不是同一件事。
6. FP32、FP16、BF16 保存一个数分别占多少字节?为什么启用 FP16 不等于整场训练显存减半,也不同于 4-bit 量化?
**参考思路:** 分别占 4、2、2 字节;FP16 与 BF16 的数值范围和精度分配不同,选择时还要检查硬件支持。混合精度让不同计算或状态使用不同精度,部分状态仍可能保留 FP32,整场训练也有其他占用。4-bit 量化则用更少比特近似保存基础权重,不表示全部训练计算或 LoRA 参数都变成 4 位。
7. 全参数微调、LoRA 和 QLoRA 分别更新哪些参数?LoRA 冻结原权重后,为什么仍能改变输出,又为什么需要基础模型?
**参考思路:** 全参数微调更新原模型参数;LoRA 冻结基础权重,主要训练新增的低秩分支,分支结果与原层结果相加后影响输出。QLoRA 在此基础上低位量化基础权重,仍训练 LoRA 参数。LoRA 减少大量基础参数的梯度和优化器状态,但基础模型仍参与计算;量化进一步节省权重存储,也引入近似误差。
8. 配置中的 rank=8、alpha=16、target=all 和 dropout=0 分别表示什么?为什么增大 rank 不一定让效果更好?
**参考思路:** rank 控制分支的中间宽度,标准 LoRA 按 alpha/r 缩放增量,此处为 2;target 决定在哪里加分支,all 指本工具识别的适用线性层;dropout=0 表示不随机遮住分支输入。它们改变的部分不同。增大 rank 会增加可训练参数,却不保证任务效果提高;调整时要记录其他设置并比较验证结果。
9. cutoff_len 限制的是字符数还是 token 数?当前最长训练序列为 957 token,上限从 2048 改成 4096 或 512,分别需要怎样判断?
**参考思路:** 它限制预处理后的 token 序列长度,序列包括任务、文章、答案与模板标记。2048 已能容纳当前样本,改成 4096 不会凭空增加内容,显存还取决于实际长度与填充;降到 512 可能截断长样本,要检查文章、答案和保留条数。更换数据、模板或分词器后,应重新统计。
10. 训练 Loss 与验证 Loss 分别反映什么?如果训练 Loss 继续下降,验证 Loss 连续上升,怎样选择后续方案?
**参考思路:** 前者来自参与学习的数据,后者来自不用于参数更新的验证数据。持续背离可能提示过拟合,也要先核对数据和预处理。比较较早与较晚检查点在同一批验证输入上的回答,再决定是否减少轮数或调整训练;更低 Loss 不能直接证明关键词更准确,测试集不用于反复调参。
进阶练习:LoRA 计算与参数变化
1. 常见默认 LoRA 初始化中,A 随机、B 为零,为什么分支开始时不改变原输出?A、B 都为零是否等价?
**参考思路:** B 为零时乘积增量为零,但训练可以先更新 B,随后逐步学习分支。两矩阵都为零,会使这个乘积结构的常规梯度更新无法把分支学起来。这里讨论第 6.2 节的常见默认方式,其他初始化要按相应设计理解。
2. 把 rank 从 8 改成 16,alpha 保持 16,标准 LoRA 的缩放系数怎样变化?怎样保持原系数?
**参考思路:** alpha/r 从 2 变为 1;若希望仍为 2,可把 alpha 改为 32。rank 增大还会增加分支参数量,保持缩放系数不代表输出或任务效果不变,因此仍需比较验证结果与开销。
3. 总计 150 步,预热从 5 步改成 15 步,训练安排会怎样变化?怎样判断这项调整是否有帮助?
**参考思路:** 预热包含在总预算内,总数仍为 150 步,后续衰减阶段从 145 步变成 135 步。学习率上升过程拉长是确定变化;是否更稳定、任务效果是否更好,要在相同起点和其他条件下比较日志与验证回答。
4. LoRA dropout 从 0 改成 0.1,会删除 A、B 的部分权重吗?推理时是否继续随机丢弃?
**参考思路:** 它在训练时随机遮住部分分支输入,A、B 权重尺寸和参数量不变,正常推理时关闭。这个设置有时有助于缓解过拟合,也可能影响有限训练中的学习;它不能修正错误标注,也不是节省显存的开关。
**本章小结:**
- 模型先根据上下文预测 token,Loss 衡量预测,反向传播计算梯度,优化器执行参数更新。本课主要直接监督助手答案的位置,用户文章仍是参与计算的上下文。
- batch、梯度累积和 epoch 决定样本怎样分批、多久更新一次和总共遍历几轮;学习率控制更新步长,预热与衰减安排它随进度的变化。
- 训练显存包括权重、梯度、优化器状态和中间结果,不能只按权重大小估算。混合精度为不同计算或状态选择适用精度;长度要按完整序列检查,梯度检查点则用重算减少部分中间结果的存储。
- 全参数微调更新原模型参数,LoRA 主要训练新增分支,QLoRA 进一步量化基础权重。rank 控制分支宽度,alpha 控制缩放,target 决定作用位置,dropout 在训练时随机遮住部分分支输入。
- 训练与验证 Loss 帮助观察学习过程,检查点保存阶段结果,实际回答用于检查任务表现。配置是否合适,需要结合数据、资源与验证结果判断,不能只凭一条曲线或 Adapter 文件大小下结论。
**建议下一步:** 回到第 8.1 节,解释每项配置的用途,算出有效批次与更新步数,再说明训练会留下哪些文件、怎样检查效果。然后进入[第 31 章](31-LLaMA-Factory环境搭建与微调实战.md),把这些理解用于环境准备、配置填写和真实训练日志的核对。