- [前言](#前言)
- [第一部分:并发编程](#第一部分并发编程)
- [1. 线程状态转换](#1-线程状态转换)
- [新建(New)](#新建new)
- [可运行(Runnable)](#可运行runnable)
- [阻塞(Blocking)](#阻塞blocking)
- [无限期等待(Waiting)](#无限期等待waiting)
- [限期等待(Timed Waiting)](#限期等待timed-waiting)
- [死亡(Terminated)](#死亡terminated)
- [2. Java实现多线程的方式及三种方式的区别](#2-java实现多线程的方式及三种方式的区别)
- [实现 Runnable 接口](#实现-runnable-接口)
- [实现 Callable 接口](#实现-callable-接口)
- [继承 Thread 类](#继承-thread-类)
- [实现接口 VS 继承 Thread](#实现接口-vs-继承-thread)
- [三种方式的区别](#三种方式的区别)
- [3. 基础线程机制](#3-基础线程机制)
- [Executor](#executor)
- [Daemon(守护线程)](#daemon守护线程)
- [sleep()](#sleep)
- [yield()](#yield)
- [线程阻塞](#线程阻塞)
- [4. 中断](#4-中断)
- [InterruptedException](#interruptedexception)
- [interrupted()](#interrupted)
- [Executor 的中断操作](#executor-的中断操作)
- [5. 互斥同步](#5-互斥同步)
- [synchronized](#synchronized)
- [ReentrantLock](#reentrantlock)
- [synchronized 和 ReentrantLock 比较](#synchronized-和-reentrantlock-比较)
- [synchronized与lock的区别,使用场景。看过synchronized的源码没?](#synchronized与lock的区别使用场景看过synchronized的源码没)
- [什么是CAS](#什么是cas)
- [入门例子](#入门例子)
- [Compare And Swap](#compare-and-swap)
- [什么是乐观锁和悲观锁](#什么是乐观锁和悲观锁)
- [Synchronized(对象锁)和Static Synchronized(类锁)区别](#synchronized对象锁和static-synchronized类锁区别)
- [6. 线程之间的协作](#6-线程之间的协作)
- [join()](#join)
- [wait() notify() notifyAll()](#wait-notify-notifyall)
- [await() signal() signalAll()](#await-signal-signalall)
- [sleep和wait有什么区别](#sleep和wait有什么区别)
- [7. J.U.C - AQS](#7-juc---aqs)
- [CountdownLatch](#countdownlatch)
- [CyclicBarrier](#cyclicbarrier)
- [Semaphore](#semaphore)
- [总结](#总结)
- [8. J.U.C - 其它组件](#8-juc---其它组件)
- [FutureTask](#futuretask)
- [BlockingQueue](#blockingqueue)
- [ForkJoin](#forkjoin)
- [9. 线程不安全示例](#9-线程不安全示例)
- [10. Java 内存模型(JMM)](#10-java-内存模型jmm)
- [主内存与工作内存](#主内存与工作内存)
- [内存间交互操作](#内存间交互操作)
- [内存模型三大特性](#内存模型三大特性)
- [1. 原子性](#1-原子性)
- [2. 可见性](#2-可见性)
- [3. 有序性](#3-有序性)
- [指令重排序](#指令重排序)
- [数据依赖性](#数据依赖性)
- [as-if-serial语义](#as-if-serial语义)
- [程序顺序规则](#程序顺序规则)
- [重排序对多线程的影响](#重排序对多线程的影响)
- [先行发生原则(happens-before)](#先行发生原则happens-before)
- [1. 单一线程原则](#1-单一线程原则)
- [2. 管程锁定规则](#2-管程锁定规则)
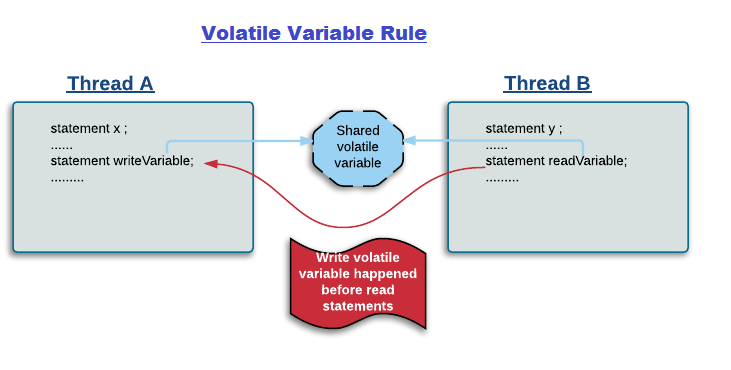
- [3. volatile 变量规则](#3-volatile-变量规则)
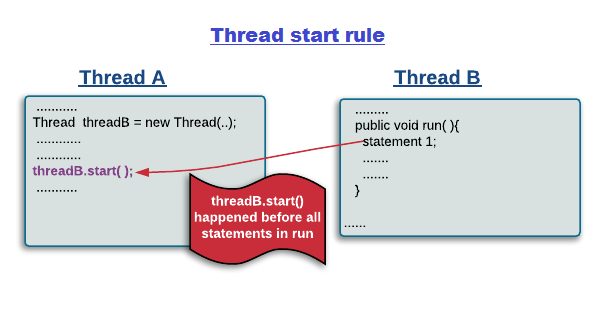
- [4. 线程启动规则](#4-线程启动规则)
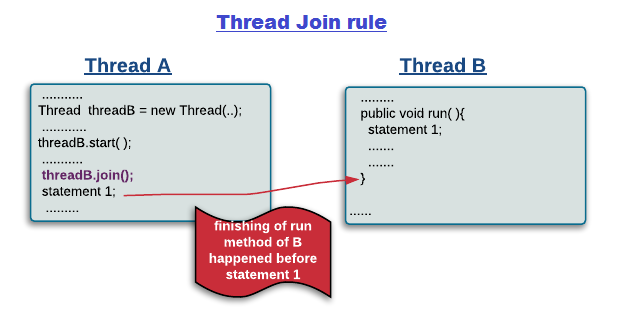
- [5. 线程加入规则](#5-线程加入规则)
- [6. 线程中断规则](#6-线程中断规则)
- [7. 对象终结规则](#7-对象终结规则)
- [8. 传递性](#8-传递性)
- [11. 线程安全](#11-线程安全)
- [线程安全定义](#线程安全定义)
- [线程安全分类](#线程安全分类)
- [1. 不可变](#1-不可变)
- [2. 绝对线程安全](#2-绝对线程安全)
- [3. 相对线程安全](#3-相对线程安全)
- [4. 线程兼容](#4-线程兼容)
- [5. 线程对立](#5-线程对立)
- [线程安全的实现方法](#线程安全的实现方法)
- [1. 阻塞同步(互斥同步)](#1-阻塞同步互斥同步)
- [2. 非阻塞同步](#2-非阻塞同步)
- [3. 无同步方案](#3-无同步方案)
- [(一)可重入代码(Reentrant Code)](#一可重入代码reentrant-code)
- [(二)栈封闭](#二栈封闭)
- [(三)线程本地存储(Thread Local Storage)](#三线程本地存储thread-local-storage)
- [12. 锁优化](#12-锁优化)
- [自旋锁](#自旋锁)
- [锁消除](#锁消除)
- [锁粗化](#锁粗化)
- [轻量级锁](#轻量级锁)
- [偏向锁](#偏向锁)
- [13. 多线程开发良好的实践](#13-多线程开发良好的实践)
- [14. 线程池实现原理](#14-线程池实现原理)
- [并发队列](#并发队列)
- [线程池概念](#线程池概念)
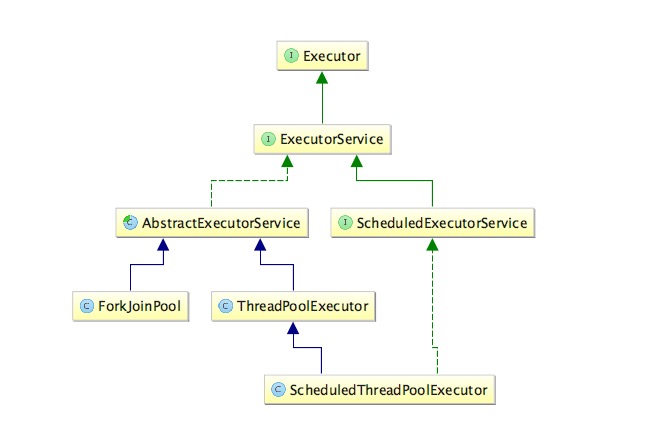
- [Executor类图](#executor类图)
- [线程池工作原理](#线程池工作原理)
- [初始化线程池](#初始化线程池)
- [初始化方法](#初始化方法)
- [常用方法](#常用方法)
- [execute与submit的区别](#execute与submit的区别)
- [shutDown与shutDownNow的区别](#shutdown与shutdownnow的区别)
- [内部实现](#内部实现)
- [线程池的状态](#线程池的状态)
- [线程池其他常用方法](#线程池其他常用方法)
- [如何合理设置线程池的大小](#如何合理设置线程池的大小)
- [第二部分:面试指南](#第二部分面试指南)
- [1. volatile 与 synchronized 的区别](#1-volatile-与-synchronized-的区别)
- [2. 什么是线程池?如果让你设计一个动态大小的线程池,如何设计,应该有哪些方法?线程池创建的方式?](#2-什么是线程池如果让你设计一个动态大小的线程池如何设计应该有哪些方法线程池创建的方式)
- [3. 什么是并发和并行](#3-什么是并发和并行)
- [并发](#并发)
- [并行](#并行)
- [4. 什么是线程安全](#4-什么是线程安全)
- [非线程安全!=不安全?](#非线程安全不安全)
- [线程安全十万个为什么?](#线程安全十万个为什么)
- [5. volatile 关键字的如何保证内存可见性](#5-volatile-关键字的如何保证内存可见性)
- [5. 什么是线程?线程和进程有什么区别?为什么要使用多线程](#5-什么是线程线程和进程有什么区别为什么要使用多线程)
- [6. 多线程共用一个数据变量需要注意什么?](#6-多线程共用一个数据变量需要注意什么)
- [7. 内存泄漏与内存溢出](#7-内存泄漏与内存溢出)
- [Java内存回收机制](#java内存回收机制)
- [Java内存泄露引起原因](#java内存泄露引起原因)
- [静态集合类](#静态集合类)
- [监听器](#监听器)
- [各种连接](#各种连接)
- [内部类和外部模块等的引用](#内部类和外部模块等的引用)
- [单例模式](#单例模式)
- [8. 如何减少线程上下文切换](#8-如何减少线程上下文切换)
- [9. 线程间通信和进程间通信](#9-线程间通信和进程间通信)
- [线程间通信](#线程间通信)
- [进程间通信](#进程间通信)
- [10. 什么是同步和异步,阻塞和非阻塞?](#10-什么是同步和异步阻塞和非阻塞)
- [同步](#同步)
- [异步](#异步)
- [阻塞](#阻塞)
- [非阻塞](#非阻塞)
- [11. Java中的锁](#11-java中的锁)
- [一个简单的锁](#一个简单的锁)
- [锁的可重入性](#锁的可重入性)
- [锁的公平性](#锁的公平性)
- [在 finally 语句中调用 unlock()](#在-finally-语句中调用-unlock)
- [12. 并发包(J.U.C)下面,都用过什么](#12-并发包juc下面都用过什么)
- [13. 从volatile说到,i++原子操作,线程安全问题](#13-从volatile说到i原子操作线程安全问题)
- [参考资料](#参考资料)
- [更新日志](#更新日志)
# 前言
在本文将总结多线程并发编程中的常见面试题,主要核心线程生命周期、线程通信、并发包部分。主要分成 “并发编程” 和 “面试指南” 两 部分,在面试指南中将讨论并发相关面经。
# 第一部分:并发编程
## 1. 线程状态转换
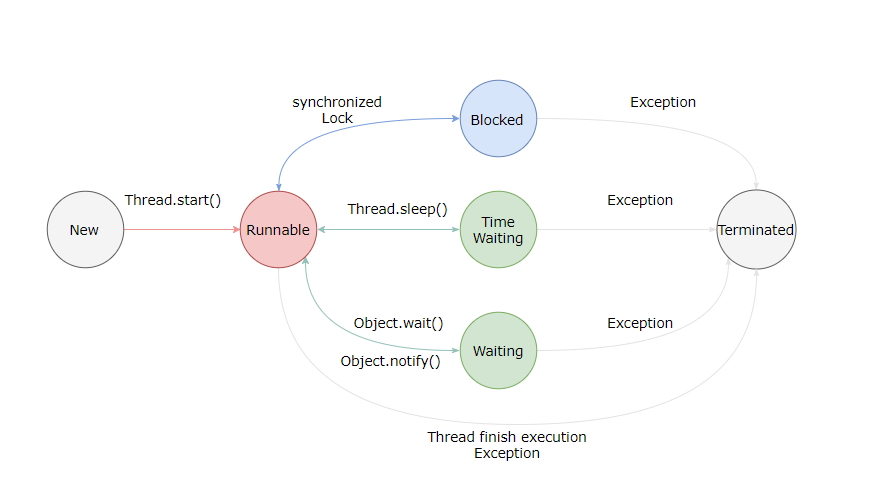
这里笔者也绘制了一张中文版的图,[点击查看](https://raw.githubusercontent.com/frank-lam/2019_campus_apply/master/notes/JavaArchitecture/assets/1536767960941.png)
### 新建(New)
创建后尚未启动。
### 可运行(Runnable)
可能正在运行,也可能正在等待 CPU 时间片。
包含了操作系统线程状态中的 运行(Running ) 和 就绪(Ready)。
### 阻塞(Blocking)
这个状态下,是在多个线程有同步操作的场景,比如正在等待另一个线程的 synchronized 块的执行释放,或者可重入的 synchronized 块里别人调用 wait() 方法,也就是线程在等待进入临界区。
阻塞可以分为:等待阻塞,同步阻塞,其他阻塞
### 无限期等待(Waiting)
等待其它线程显式地唤醒,否则不会被分配 CPU 时间片。
| 进入方法 | 退出方法 |
| ------------------------------------------ | ------------------------------------ |
| 没有设置 Timeout 参数的 Object.wait() 方法 | Object.notify() / Object.notifyAll() |
| 没有设置 Timeout 参数的 Thread.join() 方法 | 被调用的线程执行完毕 |
| LockSupport.park() 方法 | - |
### 限期等待(Timed Waiting)
无需等待其它线程显式地唤醒,在一定时间之后会被系统自动唤醒。
调用 Thread.sleep() 方法使线程进入限期等待状态时,常常用 “**使一个线程睡眠**” 进行描述。
调用 Object.wait() 方法使线程进入限期等待或者无限期等待时,常常用 “**挂起一个线程**” 进行描述。
**睡眠和挂起**是用来描述**行为**,而**阻塞**和等待用来描述**状态**。
阻塞和等待的区别在于,阻塞是被动的,它是在等待获取一个排它锁。而等待是主动的,通过调用 Thread.sleep() 和 Object.wait() 等方法进入。
| 进入方法 | 退出方法 |
| ---------------------------------------- | ----------------------------------------------- |
| Thread.sleep() 方法 | 时间结束 |
| 设置了 Timeout 参数的 Object.wait() 方法 | 时间结束 / Object.notify() / Object.notifyAll() |
| 设置了 Timeout 参数的 Thread.join() 方法 | 时间结束 / 被调用的线程执行完毕 |
| LockSupport.parkNanos() 方法 | - |
| LockSupport.parkUntil() 方法 | - |
### 死亡(Terminated)
- 线程因为 run 方法正常退出而自然死亡
- 因为一个没有捕获的异常终止了 run 方法而意外死亡
## 2. Java实现多线程的方式及三种方式的区别
有三种使用线程的方法:
- 实现 Runnable 接口;
- 实现 Callable 接口;
- 继承 Thread 类。
实现 Runnable 和 Callable 接口的类只能当做一个可以在线程中运行的任务,不是真正意义上的线程,因此最后还需要通过 Thread 来调用。可以说任务是通过线程驱动从而执行的。
### 实现 Runnable 接口
需要实现 run() 方法。
通过 Thread 调用 start() 方法来启动线程。
```java
public class MyRunnable implements Runnable {
public void run() {
// ...
}
}
```
```java
public static void main(String[] args) {
MyRunnable instance = new MyRunnable();
Thread thread = new Thread(instance);
thread.start();
}
```
### 实现 Callable 接口
与 Runnable 相比,Callable 可以有返回值,返回值通过 FutureTask 进行封装。
```java
public class MyCallable implements Callable {
public Integer call() {
return 123;
}
}
```
```java
public static void main(String[] args) throws ExecutionException, InterruptedException {
MyCallable mc = new MyCallable();
FutureTask ft = new FutureTask<>(mc);
Thread thread = new Thread(ft);
thread.start();
System.out.println(ft.get());
}
```
### 继承 Thread 类
同样也是需要实现 run() 方法,因为 Thread 类也实现了 Runable 接口。
```java
public class MyThread extends Thread {
public void run() {
// ...
}
}
```
```java
public static void main(String[] args) {
MyThread mt = new MyThread();
mt.start();
}
```
### 实现接口 VS 继承 Thread
实现接口会更好一些,因为:
- Java 不支持多重继承,因此继承了 Thread 类就无法继承其它类,但是可以实现多个接口;
- 类可能只要求可执行就行,继承整个 Thread 类开销过大。
### 三种方式的区别
- 实现 Runnable 接口可以避免 Java 单继承特性而带来的局限;增强程序的健壮性,代码能够被多个线程共享,代码与数据是独立的;适合多个相同程序代码的线程区处理同一资源的情况。
- 继承 Thread 类和实现 Runnable 方法启动线程都是使用 start() 方法,然后 JVM 虚拟机将此线程放到就绪队列中,如果有处理机可用,则执行 run() 方法。
- 实现 Callable 接口要实现 call() 方法,并且线程执行完毕后会有返回值。其他的两种都是重写 run() 方法,没有返回值。
## 3. 基础线程机制
### Executor
Executor 管理多个异步任务的执行,而无需程序员显式地管理线程的生命周期。这里的异步是指多个任务的执行互不干扰,不需要进行同步操作。
主要有三种 Executor:
- CachedThreadPool:一个任务创建一个线程;
- FixedThreadPool:所有任务只能使用固定大小的线程;
- SingleThreadExecutor:相当于大小为 1 的 FixedThreadPool。
```java
public static void main(String[] args) {
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < 5; i++) {
executorService.execute(new MyRunnable());
}
executorService.shutdown();
}
```
**为什么引入Executor线程池框架?**
new Thread() 的缺点
- 每次 new Thread() 耗费性能
- 调用 new Thread() 创建的线程缺乏管理,被称为野线程,而且可以无限制创建,之间相互竞争,会导致过多占用系统资源导致系统瘫痪。
- 不利于扩展,比如如定时执行、定期执行、线程中断
采用线程池的优点
- 重用存在的线程,减少对象创建、消亡的开销,性能佳
- 可有效控制最大并发线程数,提高系统资源的使用率,同时避免过多资源竞争,避免堵塞
- 提供定时执行、定期执行、单线程、并发数控制等功能
### Daemon(守护线程)
Java 中有两类线程:User Thread (用户线程)、Daemon Thread (守护线程)
用户线程即运行在前台的线程,而守护线程是运行在后台的线程。 守护线程作用是为其他前台线程的运行提供便利服务,而且仅在普通、非守护线程仍然运行时才需要,比如垃圾回收线程就是一个守护线程。当 JVM 检测仅剩一个守护线程,而用户线程都已经退出运行时,JVM 就会退出,因为没有如果没有了被守护这,也就没有继续运行程序的必要了。如果有非守护线程仍然存活,JVM 就不会退出。
守护线程并非只有虚拟机内部提供,用户在编写程序时也可以自己设置守护线程。用户可以用 Thread 的 setDaemon(true) 方法设置当前线程为守护线程。
虽然守护线程可能非常有用,但必须小心确保其他所有非守护线程消亡时,不会由于它的终止而产生任何危害。因为你不可能知道在所有的用户线程退出运行前,守护线程是否已经完成了预期的服务任务。一旦所有的用户线程退出了,虚拟机也就退出运行了。 因此,不要在守护线程中执行业务逻辑操作(比如对数据的读写等)。
**另外有几点需要注意:**
- setDaemon(true) 必须在调用线程的 start() 方法之前设置,否则会跑出 IllegalThreadStateException 异常。
- 在守护线程中产生的新线程也是守护线程。
- 不要认为所有的应用都可以分配给守护线程来进行服务,比如读写操作或者计算逻辑。
守护线程是程序运行时在后台提供服务的线程,不属于程序中不可或缺的部分。
当所有非守护线程结束时,程序也就终止,同时会杀死所有守护线程。
main() 属于非守护线程。
使用 setDaemon() 方法将一个线程设置为守护线程。
```java
public static void main(String[] args) {
Thread thread = new Thread(new MyRunnable());
thread.setDaemon(true);
}
```
### sleep()
Thread.sleep(millisec) 方法会休眠当前正在执行的线程,millisec 单位为毫秒。
sleep() 可能会抛出 InterruptedException,因为异常不能跨线程传播回 main() 中,因此必须在本地进行处理。线程中抛出的其它异常也同样需要在本地进行处理。
```java
public void run() {
try {
Thread.sleep(3000);
} catch (InterruptedException e) {
e.printStackTrace();
}
}
```
### yield()
对静态方法 Thread.yield() 的调用声明了**当前线程已经完成了生命周期中最重要的部分**,可以切换给其它线程来执行。该方法只是对线程调度器的一个建议,而且也只是建议具有相同优先级的其它线程可以运行。
```java
public void run() {
Thread.yield();
}
```
### 线程阻塞
线程可以阻塞于四种状态:
- 当线程执行 Thread.sleep() 时,它一直阻塞到指定的毫秒时间之后,或者阻塞被另一个线程打断;
- 当线程碰到一条 wait() 语句时,它会一直阻塞到接到通知 notify()、被中断或经过了指定毫秒时间为止(若制定了超时值的话)
- 线程阻塞与不同 I/O 的方式有多种。常见的一种方式是 InputStream 的 read() 方法,该方法一直阻塞到从流中读取一个字节的数据为止,它可以无限阻塞,因此不能指定超时时间;
- 线程也可以阻塞等待获取某个对象锁的排他性访问权限(即等待获得 synchronized 语句必须的锁时阻塞)。
> 注意,并非所有的阻塞状态都是可中断的,以上阻塞状态的前两种可以被中断,后两种不会对中断做出反应
## 4. 中断
一个线程执行完毕之后会自动结束,如果在运行过程中发生异常也会提前结束。
### InterruptedException
通过调用一个线程的 interrupt() 来中断该线程,如果该线程处于**阻塞、限期等待或者无限期等待**状态,那么就会抛出 InterruptedException,从而提前结束该线程。但是不能中断 I/O 阻塞和 synchronized 锁阻塞。
对于以下代码,在 main() 中启动一个线程之后再中断它,由于线程中调用了 Thread.sleep() 方法,因此会抛出一个 InterruptedException,从而提前结束线程,不执行之后的语句。
```java
public class InterruptExample {
private static class MyThread1 extends Thread {
@Override
public void run() {
try {
Thread.sleep(2000);
System.out.println("Thread run");
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
}
```
```java
public static void main(String[] args) throws InterruptedException {
Thread thread1 = new MyThread1();
thread1.start();
thread1.interrupt();
System.out.println("Main run");
}
```
```java
Main run
java.lang.InterruptedException: sleep interrupted
at java.lang.Thread.sleep(Native Method)
at InterruptExample.lambda$main$0(InterruptExample.java:5)
at InterruptExample$$Lambda$1/713338599.run(Unknown Source)
at java.lang.Thread.run(Thread.java:745)
```
### interrupted()
如果一个线程的 run() 方法执行一个无限循环,并且没有执行 sleep() 等会抛出 InterruptedException 的操作,那么调用线程的 interrupt() 方法就无法使线程提前结束。
但是调用 interrupt() 方法会设置线程的中断标记,此时调用 interrupted() 方法会返回 true。因此可以在循环体中使用 interrupted() 方法来判断线程是否处于中断状态,从而提前结束线程。
```java
public class InterruptExample {
private static class MyThread2 extends Thread {
@Override
public void run() {
while (!interrupted()) {
// ..
}
System.out.println("Thread end");
}
}
}
```
```javascript
public static void main(String[] args) throws InterruptedException {
Thread thread2 = new MyThread2();
thread2.start();
thread2.interrupt();
}
```
```
Thread end
```
### Executor 的中断操作
调用 Executor 的 shutdown() 方法会等待线程都执行完毕之后再关闭,但是如果调用的是 shutdownNow() 方法,则相当于调用每个线程的 interrupt() 方法。
以下使用 Lambda 创建线程,相当于创建了一个匿名内部线程。
```java
public static void main(String[] args) {
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> {
try {
Thread.sleep(2000);
System.out.println("Thread run");
} catch (InterruptedException e) {
e.printStackTrace();
}
});
executorService.shutdownNow();
System.out.println("Main run");
}
```
```java
Main run
java.lang.InterruptedException: sleep interrupted
at java.lang.Thread.sleep(Native Method)
at ExecutorInterruptExample.lambda$main$0(ExecutorInterruptExample.java:9)
at ExecutorInterruptExample$$Lambda$1/1160460865.run(Unknown Source)
at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1142)
at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:617)
at java.lang.Thread.run(Thread.java:745)
```
如果只想中断 Executor 中的一个线程,可以通过使用 submit() 方法来提交一个线程,它会返回一个 Future 对象,通过调用该对象的 cancel(true) 方法就可以中断线程。
```java
Future future = executorService.submit(() -> {
// ..
});
future.cancel(true);
```
## 5. 互斥同步
Java 提供了两种锁机制来控制多个线程对共享资源的互斥访问,第一个是 JVM 实现的 synchronized,而另一个是 JDK 实现的 ReentrantLock。
### synchronized
**1. 同步一个代码块**
```java
public void func() {
synchronized (this) {
// ...
}
}
```
它只作用于同一个对象,如果调用两个对象上的同步代码块,就不会进行同步。
对于以下代码,使用 ExecutorService 执行了两个线程,由于调用的是同一个对象的同步代码块,因此这两个线程会进行同步,当一个线程进入同步语句块时,另一个线程就必须等待。
```java
public class SynchronizedExample {
public void func1() {
synchronized (this) {
for (int i = 0; i < 10; i++) {
System.out.print(i + " ");
}
}
}
}
```
```java
public static void main(String[] args) {
SynchronizedExample e1 = new SynchronizedExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> e1.func1());
executorService.execute(() -> e1.func1());
}
```
```java
0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9
```
对于以下代码,两个线程调用了不同对象的同步代码块,因此这两个线程就不需要同步。从输出结果可以看出,两个线程交叉执行。
```java
public static void main(String[] args) {
SynchronizedExample e1 = new SynchronizedExample();
SynchronizedExample e2 = new SynchronizedExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> e1.func1());
executorService.execute(() -> e2.func1());
}
```
```
0 0 1 1 2 2 3 3 4 4 5 5 6 6 7 7 8 8 9 9
```
**2. 同步一个方法**
```java
public synchronized void func () {
// ...
}
```
它和同步代码块一样,作用于同一个对象。
**3. 同步一个类**
```java
public void func() {
synchronized (SynchronizedExample.class) {
// ...
}
}
```
作用于整个类,也就是说两个线程调用同一个类的不同对象上的这种同步语句,也会进行同步。
```java
public class SynchronizedExample {
public void func2() {
synchronized (SynchronizedExample.class) {
for (int i = 0; i < 10; i++) {
System.out.print(i + " ");
}
}
}
}
```
```java
public static void main(String[] args) {
SynchronizedExample e1 = new SynchronizedExample();
SynchronizedExample e2 = new SynchronizedExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> e1.func2());
executorService.execute(() -> e2.func2());
}
```
```
0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9
```
**4. 同步一个静态方法**
- 非静态同步函数的锁是:this
- 静态的同步函数的锁是:字节码对象
```java
public synchronized static void fun() {
// ...
}
```
作用于整个类。
### ReentrantLock
重入锁(ReentrantLock)是一种递归无阻塞的同步机制。
```java
public class LockExample {
private Lock lock = new ReentrantLock();
public void func() {
lock.lock();
try {
for (int i = 0; i < 10; i++) {
System.out.print(i + " ");
}
} finally {
lock.unlock(); // 确保释放锁,从而避免发生死锁。
}
}
}
```
```java
public static void main(String[] args) {
LockExample lockExample = new LockExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> lockExample.func());
executorService.execute(() -> lockExample.func());
}
```
```
0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9
```
ReentrantLock 是 java.util.concurrent(J.U.C)包中的锁,相比于 synchronized,它多了以下高级功能:
**1. 等待可中断**
当持有锁的线程长期不释放锁的时候,正在等待的线程可以选择放弃等待,改为处理其他事情。
**2. 可实现公平锁**
公平锁是指多个线程在等待同一个锁时,必须按照申请锁的时间顺序来依次获得锁。
synchronized 中的锁是非公平的,ReentrantLock 默认情况下也是非公平的,但可以通过带布尔值的构造函数要求使用公平锁。
**3. 锁绑定多个条件**
一个 ReentrantLock 对象可以同时绑定多个 Condition 对象。
### synchronized 和 ReentrantLock 比较
**1. 锁的实现**
synchronized 是 JVM 实现的,而 ReentrantLock 是 JDK 实现的。
**2. 性能**
新版本 Java 对 synchronized 进行了很多优化,例如自旋锁等。目前来看它和 ReentrantLock 的性能基本持平了,因此性能因素不再是选择 ReentrantLock 的理由。synchronized 有更大的性能优化空间,应该优先考虑 synchronized。
**3. 功能**
ReentrantLock 多了一些高级功能。
**4. 使用选择**
除非需要使用 ReentrantLock 的高级功能,否则优先使用 synchronized。这是因为 synchronized 是 JVM 实现的一种锁机制,JVM 原生地支持它,而 ReentrantLock 不是所有的 JDK 版本都支持。并且使用 synchronized 不用担心没有释放锁而导致死锁问题,因为 JVM 会确保锁的释放。
### synchronized与lock的区别,使用场景。看过synchronized的源码没?
- (用法)synchronized(隐式锁):在需要同步的对象中加入此控制,synchronized 可以加在方法上,也可以加在特定代码块中,括号中表示需要锁的对象。
- (用法)lock(显示锁):需要显示指定起始位置和终止位置。一般使用 ReentrantLock 类做为锁,多个线程中必须要使用一个 ReentrantLock 类做为对象才能保证锁的生效。且在加锁和解锁处需要通过 lock() 和 unlock() 显示指出。所以一般会在 finally 块中写 unlock() 以防死锁。
- (性能)synchronized 是托管给 JVM 执行的,而 lock 是 Java 写的控制锁的代码。在 Java1.5 中,synchronize 是性能低效的。因为这是一个重量级操作,需要调用操作接口,导致有可能加锁消耗的系统时间比加锁以外的操作还多。相比之下使用 Java 提供的 Lock 对象,性能更高一些。但是到了 Java1.6 ,发生了变化。synchronize 在语义上很清晰,可以进行很多优化,有适应自旋,锁消除,锁粗化,轻量级锁,偏向锁等等。导致 在 Java1.6 上 synchronize 的性能并不比 Lock 差。
- (机制)**synchronized 原始采用的是 CPU 悲观锁机制,即线程获得的是独占锁。Lock 也属于悲观锁**。独占锁意味着其他线程只能依靠阻塞来等待线程释放锁。相对而言乐观锁每次不加锁,而是假设没有冲突而去完成某项操作,如果因为冲突失败就重试,直到成功为止。乐观锁实现的机制就是 CAS 操作(Compare and Swap)。
### 什么是CAS
> 蘑菇街面试,这里简单论述一下
#### 入门例子
在 Java 并发包中有这样一个包,java.util.concurrent.atomic,该包是对 Java 部分数据类型的原子封装,在原有数据类型的基础上,提供了原子性的操作方法,保证了线程安全。下面以 AtomicInteger 为例,来看一下是如何实现的。
```java
public final int incrementAndGet() {
for (;;) {
int current = get();
int next = current + 1;
if (compareAndSet(current, next))
return next;
}
}
public final int decrementAndGet() {
for (;;) {
int current = get();
int next = current - 1;
if (compareAndSet(current, next))
return next;
}
}
```
以这两个方法为例,incrementAndGet 方法相当于原子性的 ++i,decrementAndGet 方法相当于原子性的 --i,这两个方法中都没有使用阻塞式的方式来保证原子性(如 Synchronized ),那它们是如何保证原子性的呢,下面引出 CAS。
#### Compare And Swap
CAS 指的是现代 CPU 广泛支持的一种对内存中的共享数据进行操作的一种特殊指令。这个指令会对内存中的共享数据做原子的读写操作。
简单介绍一下这个指令的操作过程:
- 首先,CPU 会将内存中将要被更改的数据与期望的值做比较。
- 然后,当这两个值相等时,CPU 才会将内存中的数值替换为新的值。否则便不做操作。
- 最后,CPU 会将旧的数值返回。
这一系列的操作是原子的。它们虽然看似复杂,但却是 Java 5 并发机制优于原有锁机制的根本。简单来说,CAS 的含义是:我认为原有的值应该是什么,如果是,则将原有的值更新为新值,否则不做修改,并告诉我原来的值是多少。
简单的来说,CAS 有 3 个操作数,内存值 V,旧的预期值 A,要修改的新值 B。当且仅当预期值 A 和内存值 V 相同时,将内存值 V 修改为 B,否则返回 V。这是一种乐观锁的思路,它相信在它修改之前,没有其它线程去修改它;而 Synchronized 是一种悲观锁,它认为在它修改之前,一定会有其它线程去修改它,悲观锁效率很低。
### 什么是乐观锁和悲观锁
- 为什么需要锁(并发控制)
- 在多用户环境中,在同一时间可能会有多个用户更新相同的记录,这会产生冲突。这就是著名的并发性问题。
- 典型的冲突有:
- 丢失更新:一个事务的更新覆盖了其它事务的更新结果,就是所谓的更新丢失。例如:用户 A 把值从 6 改为 2,用户 B 把值从 2 改为 6,则用户 A 丢失了他的更新。
- 脏读:当一个事务读取其它完成一半事务的记录时,就会发生脏读取。例如:用户 A,B 看到的值都是6,用户 B 把值改为 2,用户 A 读到的值仍为 6。
- 为了解决这些并发带来的问题。 我们需要引入并发控制机制。
- 并发控制机制
- **悲观锁:假定会发生并发冲突**,独占锁,屏蔽一切可能违反数据完整性的操作。
- **乐观锁:假设不会发生并发冲突**,只在提交操作时检查是否违反数据完整性。乐观锁不能解决脏读的问题。
参考资料:
- [乐观锁与悲观锁——解决并发问题 - WhyWin - 博客园](https://www.cnblogs.com/0201zcr/p/4782283.html)
### Synchronized(对象锁)和Static Synchronized(类锁)区别
- 一个是实例锁(锁在某一个实例对象上,如果该类是单例,那么该锁也具有全局锁的概念),一个是全局锁(该锁针对的是类,无论实例多少个对象,那么线程都共享该锁)。
实例锁对应的就是 synchronized关 键字,而类锁(全局锁)对应的就是 static synchronized(或者是锁在该类的 class 或者 classloader 对象上)。
```java
/**
* static synchronized 和synchronized的区别!
* 关键是区别第四种情况!
*/
public class StaticSynchronized {
/**
* synchronized方法
*/
public synchronized void isSynA(){
System.out.println("isSynA");
}
public synchronized void isSynB(){
System.out.println("isSynB");
}
/**
* static synchronized方法
*/
public static synchronized void cSynA(){
System.out.println("cSynA");
}
public static synchronized void cSynB(){
System.out.println("cSynB");
}
public static void main(String[] args) {
StaticSynchronized x = new StaticSynchronized();
StaticSynchronized y = new StaticSynchronized();
/**
* x.isSynA()与x.isSynB(); 不能同时访问(同一个对象访问synchronized方法)
* x.isSynA()与y.isSynB(); 能同时访问(不同对象访问synchronized方法)
* x.cSynA()与y.cSynB(); 不能同时访问(不同对象也不能访问static synchronized方法)
* x.isSynA()与y.cSynA(); 能同时访问(static synchronized方法占用的是类锁,
* 而访问synchronized方法占用的是对象锁,不存在互斥现象)
*/
}
}
```
## 6. 线程之间的协作
当多个线程可以一起工作去解决某个问题时,如果某些部分必须在其它部分之前完成,那么就需要对线程进行协调。
### join()
在线程中调用另一个线程的 join() 方法,会将当前线程挂起,而不是忙等待,直到目标线程结束。
对于以下代码,虽然 b 线程先启动,但是因为在 b 线程中调用了 a 线程的 join() 方法,b 线程会等待 a 线程结束才继续执行,因此最后能够保证 a 线程的输出先于 b 线程的输出。
```java
public class JoinExample {
private class A extends Thread {
@Override
public void run() {
System.out.println("A");
}
}
private class B extends Thread {
private A a;
B(A a) {
this.a = a;
}
@Override
public void run() {
try {
a.join();
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("B");
}
}
public void test() {
A a = new A();
B b = new B(a);
b.start();
a.start();
}
}
```
```java
public static void main(String[] args) {
JoinExample example = new JoinExample();
example.test();
}
```
```
A
B
```
### wait() notify() notifyAll()
调用 wait() 使得线程等待某个条件满足,线程在等待时会被挂起,当其他线程的运行使得这个条件满足时,其它线程会调用 notify()(随机叫醒一个) 或者 notifyAll() (叫醒所有 wait 线程,争夺时间片的线程只有一个)来唤醒挂起的线程。
它们都属于 Object 的一部分,而不属于 Thread。
只能用在**同步方法**或者**同步控制块**中使用!否则会在运行时抛出 IllegalMonitorStateExeception。
使用 wait() 挂起期间,线程会释放锁。这是因为,如果没有释放锁,那么其它线程就无法进入对象的同步方法或者同步控制块中,那么就无法执行 notify() 或者 notifyAll() 来唤醒挂起的线程,造成死锁。
```java
public class WaitNotifyExample {
public synchronized void before() {
System.out.println("before");
notifyAll();
}
public synchronized void after() {
try {
wait();
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("after");
}
}
```
```java
public static void main(String[] args) {
ExecutorService executorService = Executors.newCachedThreadPool();
WaitNotifyExample example = new WaitNotifyExample();
executorService.execute(() -> example.after());
executorService.execute(() -> example.before());
}
```
```
before
after
```
### await() signal() signalAll()
java.util.concurrent 类库中提供了 Condition 类来实现线程之间的协调,可以在 Condition 上调用 await() 方法使线程等待,其它线程调用 signal() 或 signalAll() 方法唤醒等待的线程。相比于 wait() 这种等待方式,await() 可以指定等待的条件,因此更加灵活。
使用 Lock 来获取一个 Condition 对象。
```java
public class AwaitSignalExample {
private Lock lock = new ReentrantLock();
private Condition condition = lock.newCondition();
public void before() {
lock.lock();
try {
System.out.println("before");
condition.signalAll();
} finally {
lock.unlock();
}
}
public void after() {
lock.lock();
try {
condition.await();
System.out.println("after");
} catch (InterruptedException e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}
}
```
```java
public static void main(String[] args) {
ExecutorService executorService = Executors.newCachedThreadPool();
AwaitSignalExample example = new AwaitSignalExample();
executorService.execute(() -> example.after());
executorService.execute(() -> example.before());
}
```
```
before
after
```
### sleep和wait有什么区别
- sleep 和 wait
- wait() 是 Object 的方法,而 sleep() 是 Thread 的静态方法;
- wait() 会释放锁,sleep() 不会。
- 有什么区别
- sleep() 方法(休眠)是线程类(Thread)的静态方法,调用此方法会让当前线程暂停执行指定的时间,将执行机会(CPU)让给其他线程,但是对象的锁依然保持,因此休眠时间结束后会自动恢复(线程回到就绪状态)。
- wait() 是 Object 类的方法,调用对象的 wait() 方法导致当前线程放弃对象的锁(线程暂停执行),进入对象的等待池(wait pool),只有调用对象的 notify() 方法(或 notifyAll() 方法)时才能唤醒等待池中的线程进入等锁池(lock pool),如果线程重新获得对象的锁就可以进入就绪状态。
## 7. J.U.C - AQS
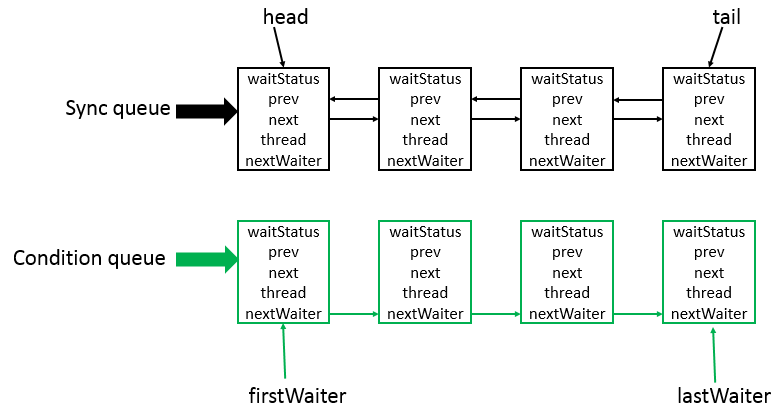
AQS 是 AbstractQueuedSynchronizer 的简称,java.util.concurrent(J.U.C)大大提高了并发性能,AQS (AbstractQueuedSynchronizer) 被认为是 J.U.C 的核心。它提供了一个基于 FIFO 队列,这个队列可以用来构建锁或者其他相关的同步装置的基础框架。下图是 AQS 底层的数据结构:
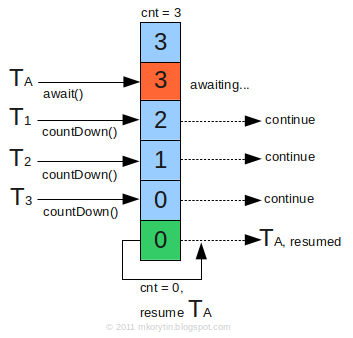
CountDownLatch 类只提供了一个构造器:
```java
public CountDownLatch(int count) { }; // 参数count为计数值
```
然后下面这 3 个方法是 CountDownLatch 类中最重要的方法:
```java
//调用await()方法的线程会被挂起,它会等待直到count值为0才继续执行
public void await() throws InterruptedException { };
//和await()类似,只不过等待一定的时间后count值还没变为0的话就会继续执行
public boolean await(long timeout, TimeUnit unit) throws InterruptedException { };
//将count值减1
public void countDown() { };
```
下面看一个例子大家就清楚 CountDownLatch 的用法了:
```java
public class Test {
public static void main(String[] args) {
final CountDownLatch latch = new CountDownLatch(2);
new Thread() {
public void run() {
try {
System.out.println("子线程" + Thread.currentThread().getName() + "正在执行");
Thread.sleep(3000);
System.out.println("子线程" + Thread.currentThread().getName() + "执行完毕");
latch.countDown();
} catch (InterruptedException e) {
e.printStackTrace();
}
}
;
}.start();
new Thread() {
public void run() {
try {
System.out.println("子线程" + Thread.currentThread().getName() + "正在执行");
Thread.sleep(3000);
System.out.println("子线程" + Thread.currentThread().getName() + "执行完毕");
latch.countDown();
} catch (InterruptedException e) {
e.printStackTrace();
}
}
;
}.start();
try {
System.out.println("等待2个子线程执行完毕...");
latch.await();
System.out.println("2个子线程已经执行完毕");
System.out.println("继续执行主线程");
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
```
执行结果:
```
线程Thread-0正在执行
线程Thread-1正在执行
等待2个子线程执行完毕...
线程Thread-0执行完毕
线程Thread-1执行完毕
2个子线程已经执行完毕
继续执行主线程
```
### CyclicBarrier
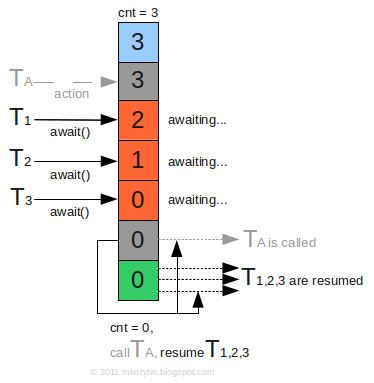
用来控制多个线程互相等待,只有当多个线程都到达时,这些线程才会继续执行。
和 CountdownLatch 相似,都是通过维护计数器来实现的。但是它的计数器是递增的,每次执行 await() 方法之后,计数器会加 1,直到计数器的值和设置的值相等,等待的所有线程才会继续执行。和 CountdownLatch 的另一个区别是,CyclicBarrier 的计数器可以循环使用,所以它才叫做循环屏障。
下图应该从下往上看才正确。
Semaphore 类位于 java.util.concurrent 包下,它提供了2个构造器:
```java
public Semaphore(int permits) {
//参数permits表示许可数目,即同时可以允许多少线程进行访问
sync = new NonfairSync(permits);
}
public Semaphore(int permits, boolean fair) {
//这个多了一个参数fair表示是否是公平的,即等待时间越久的越先获取许可
sync = (fair) ? new FairSync(permits) : new NonfairSync(permits);
}
```
下面说一下 Semaphore 类中比较重要的几个方法,首先是 acquire()、release() 方法:
```java
//获取一个许可
public void acquire() throws InterruptedException { }
//获取permits个许可
public void acquire(int permits) throws InterruptedException { }
//释放一个许可
public void release() { }
//释放permits个许可
public void release(int permits) { }
```
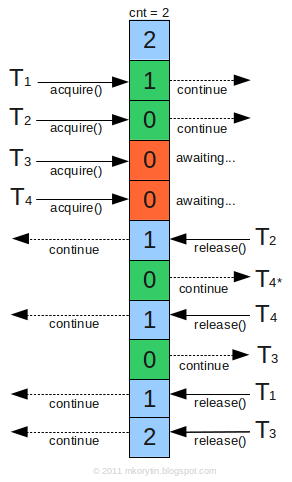
acquire() 用来获取一个许可,若无许可能够获得,则会一直等待,直到获得许可。
release() 用来释放许可。注意,在释放许可之前,必须先获获得许可。
这 4 个方法都会被阻塞,如果想立即得到执行结果,可以使用下面几个方法:
```java
//尝试获取一个许可,若获取成功,则立即返回true,若获取失败,则立即返回false
public boolean tryAcquire() { };
//尝试获取一个许可,若在指定的时间内获取成功,则立即返回true,否则则立即返回false
public boolean tryAcquire(long timeout, TimeUnit unit) throws InterruptedException { };
//尝试获取permits个许可,若获取成功,则立即返回true,若获取失败,则立即返回false
public boolean tryAcquire(int permits) { };
//尝试获取permits个许可,若在指定的时间内获取成功,则立即返回true,否则则立即返回false
public boolean tryAcquire(int permits, long timeout, TimeUnit unit) throws InterruptedException { };
```
另外还可以通过 availablePermits() 方法得到可用的许可数目。
下面通过一个例子来看一下 Semaphore 的具体使用:
假若一个工厂有 5 台机器,但是有 8 个工人,一台机器同时只能被一个工人使用,只有使用完了,其他工人才能继续使用。那么我们就可以通过 Semaphore 来实现:
```java
public class Test {
public static void main(String[] args) {
int N = 8; //工人数
Semaphore semaphore = new Semaphore(5); //机器数目
for (int i = 0; i < N; i++) new Worker(i, semaphore).start();
}
static class Worker extends Thread {
private int num;
private Semaphore semaphore;
public Worker(int num, Semaphore semaphore) {
this.num = num;
this.semaphore = semaphore;
}
@Override
public void run() {
try {
semaphore.acquire();
System.out.println("工人" + this.num + "占用一个机器在生产...");
Thread.sleep(2000);
System.out.println("工人" + this.num + "释放出机器");
semaphore.release();
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
}
```
执行结果:
```
工人0占用一个机器在生产...
工人1占用一个机器在生产...
工人2占用一个机器在生产...
工人4占用一个机器在生产...
工人5占用一个机器在生产...
工人0释放出机器
工人2释放出机器
工人3占用一个机器在生产...
工人7占用一个机器在生产...
工人4释放出机器
工人5释放出机器
工人1释放出机器
工人6占用一个机器在生产...
工人3释放出机器
工人7释放出机器
工人6释放出机器
```
### 总结
下面对上面说的三个辅助类进行一个总结:
- CountDownLatch 和 CyclicBarrier 都能够实现线程之间的等待,只不过它们侧重点不同:
- CountDownLatch 一般用于某个线程A等待若干个其他线程执行完任务之后,它才执行;
- CyclicBarrier 一般用于一组线程互相等待至某个状态,然后这一组线程再同时执行;
- 另外,CountDownLatch 是不能够重用的,而 CyclicBarrier 是可以重用的。
- Semaphore 其实和锁有点类似,它一般用于控制对某组资源的访问权限。
## 8. J.U.C - 其它组件
### FutureTask
在介绍 Callable 时我们知道它可以有返回值,返回值通过 Future 进行封装。FutureTask 实现了 RunnableFuture 接口,该接口继承自 Runnable 和 Future 接口,这使得 FutureTask 既可以当做一个任务执行,也可以有返回值。
```java
public class FutureTask implements RunnableFuture
```
```java
public interface RunnableFuture extends Runnable, Future
```
FutureTask 可用于异步获取执行结果或取消执行任务的场景。当一个计算任务需要执行很长时间,那么就可以用 FutureTask 来封装这个任务,主线程在完成自己的任务之后再去获取结果。
```java
public class FutureTaskExample {
public static void main(String[] args) throws ExecutionException, InterruptedException {
FutureTask futureTask = new FutureTask(new Callable() {
@Override
public Integer call() throws Exception {
int result = 0;
for (int i = 0; i < 100; i++) {
Thread.sleep(10);
result += i;
}
return result;
}
});
Thread computeThread = new Thread(futureTask);
computeThread.start();
Thread otherThread = new Thread(() -> {
System.out.println("other task is running...");
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
});
otherThread.start();
System.out.println(futureTask.get());
}
}
```
```java
other task is running...
4950
```
### BlockingQueue
java.util.concurrent.BlockingQueue 接口有以下阻塞队列的实现:
- **FIFO 队列** :LinkedBlockingQueue、ArrayBlockingQueue(固定长度)
- **优先级队列** :PriorityBlockingQueue
提供了阻塞的 take() 和 put() 方法:如果队列为空 take() 将阻塞,直到队列中有内容;如果队列为满 put() 将阻塞,直到队列有空闲位置。
**使用 BlockingQueue 实现生产者消费者问题**
```java
public class ProducerConsumer {
private static BlockingQueue queue = new ArrayBlockingQueue<>(5);
private static class Producer extends Thread {
@Override
public void run() {
try {
queue.put("product");
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.print("produce..");
}
}
private static class Consumer extends Thread {
@Override
public void run() {
try {
String product = queue.take();
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.print("consume..");
}
}
}
```
```java
public static void main(String[] args) {
for (int i = 0; i < 2; i++) {
Producer producer = new Producer();
producer.start();
}
for (int i = 0; i < 5; i++) {
Consumer consumer = new Consumer();
consumer.start();
}
for (int i = 0; i < 3; i++) {
Producer producer = new Producer();
producer.start();
}
}
```
```
produce..produce..consume..consume..produce..consume..produce..consume..produce..consume..
```
### ForkJoin
主要用于并行计算中,和 MapReduce 原理类似,都是把大的计算任务拆分成多个小任务并行计算。
```java
public class ForkJoinExample extends RecursiveTask {
private final int threshold = 5;
private int first;
private int last;
public ForkJoinExample(int first, int last) {
this.first = first;
this.last = last;
}
@Override
protected Integer compute() {
int result = 0;
if (last - first <= threshold) {
// 任务足够小则直接计算
for (int i = first; i <= last; i++) {
result += i;
}
} else {
// 拆分成小任务
int middle = first + (last - first) / 2;
ForkJoinExample leftTask = new ForkJoinExample(first, middle);
ForkJoinExample rightTask = new ForkJoinExample(middle + 1, last);
leftTask.fork();
rightTask.fork();
result = leftTask.join() + rightTask.join();
}
return result;
}
}
```
```javascript
public static void main(String[] args) throws ExecutionException, InterruptedException {
ForkJoinExample example = new ForkJoinExample(1, 10000);
ForkJoinPool forkJoinPool = new ForkJoinPool();
Future result = forkJoinPool.submit(example);
System.out.println(result.get());
}
```
ForkJoin 使用 ForkJoinPool 来启动,它是一个特殊的线程池,线程数量取决于 CPU 核数。
```java
public class ForkJoinPool extends AbstractExecutorService
```
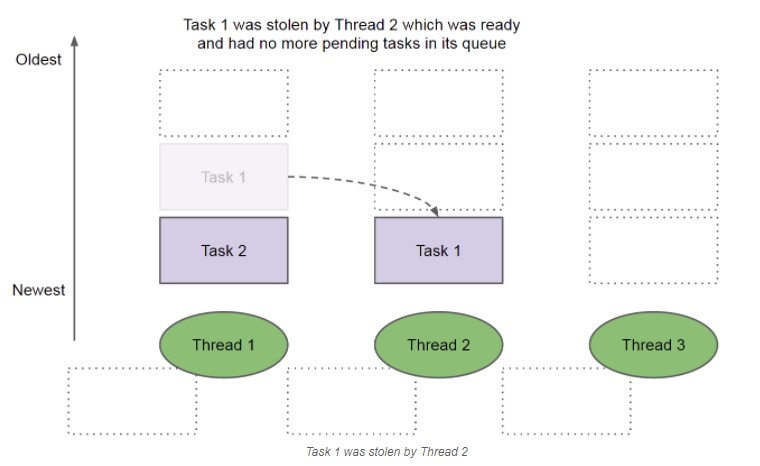
ForkJoinPool 实现了工作窃取算法来提高 CPU 的利用率。每个线程都维护了一个双端队列,用来存储需要执行的任务。工作窃取算法允许空闲的线程从其它线程的双端队列中窃取一个任务来执行。窃取的任务必须是最晚的任务,避免和队列所属线程发生竞争。例如下图中,Thread2 从 Thread1 的队列中拿出最晚的 Task1 任务,Thread1 会拿出 Task2 来执行,这样就避免发生竞争。但是如果队列中只有一个任务时还是会发生竞争。
## 9. 线程不安全示例
如果多个线程对同一个共享数据进行访问而不采取同步操作的话,那么操作的结果是不一致的。
以下代码演示了 1000 个线程同时对 cnt 执行自增操作,操作结束之后它的值为 997 而不是 1000。
```java
public class ThreadUnsafeExample {
private int cnt = 0;
public void add() {
cnt++;
}
public int get() {
return cnt;
}
}
public static void main(String[] args) throws InterruptedException {
final int threadSize = 1000;
ThreadUnsafeExample example = new ThreadUnsafeExample();
final CountDownLatch countDownLatch = new CountDownLatch(threadSize);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < threadSize; i++) {
executorService.execute(() -> {
example.add();
countDownLatch.countDown();
});
}
countDownLatch.await();
executorService.shutdown();
System.out.println(example.get());
}
```
```
997
```
## 10. Java 内存模型(JMM)
Java 内存模型试图屏蔽各种硬件和操作系统的内存访问差异,以实现让 Java 程序在各种平台下都能达到一致的内存访问效果。
### 主内存与工作内存
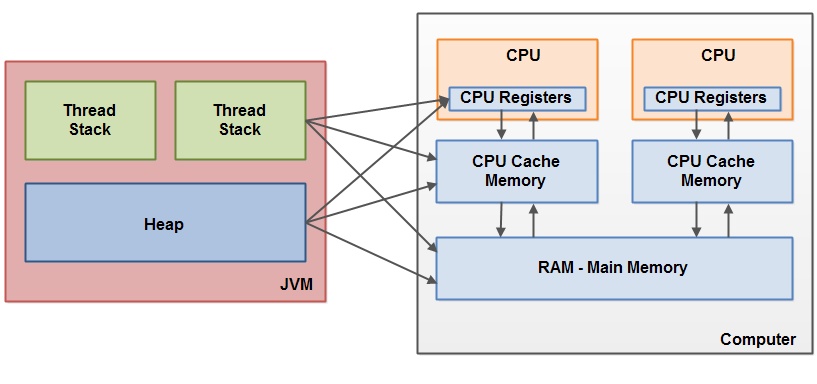
处理器上的寄存器的读写的速度比内存快几个数量级,为了解决这种速度矛盾,在它们之间加入了高速缓存。
加入高速缓存带来了一个新的问题:缓存一致性。如果多个缓存共享同一块主内存区域,那么多个缓存的数据可能会不一致,需要一些协议来解决这个问题。
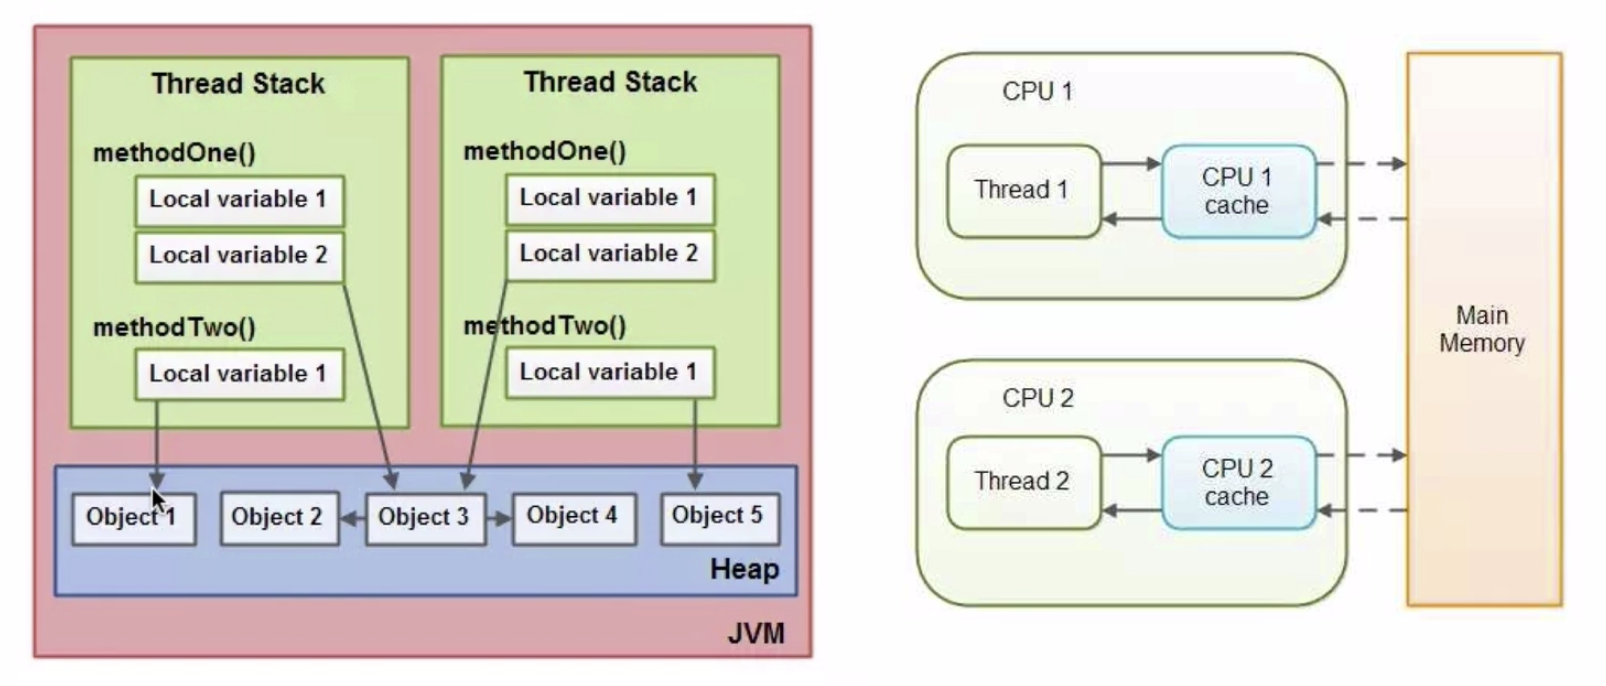
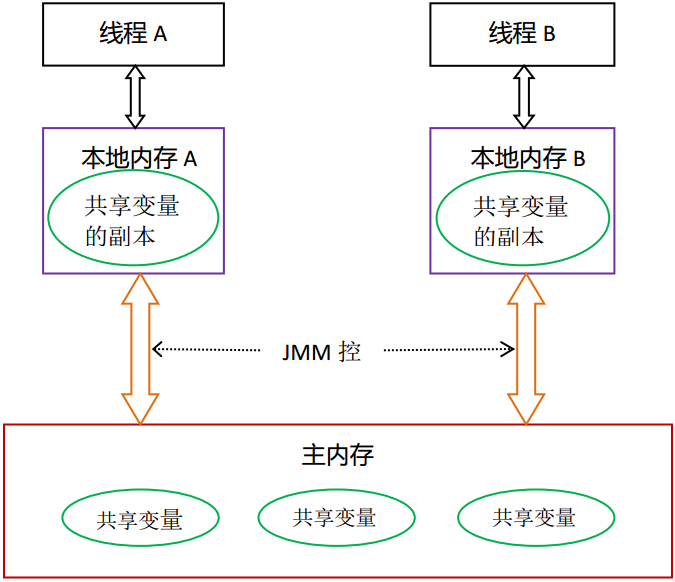
所有的变量都存储在**主内存**中,每个线程还有自己的**工作内存**,工作内存存储在高速缓存或者寄存器中,保存了该线程使用的变量的主内存副本拷贝。
线程只能直接操作工作内存中的变量,不同线程之间的变量值传递需要通过主内存来完成。
**Java内存模型和硬件关系图**
**Java内存模型抽象结构图**
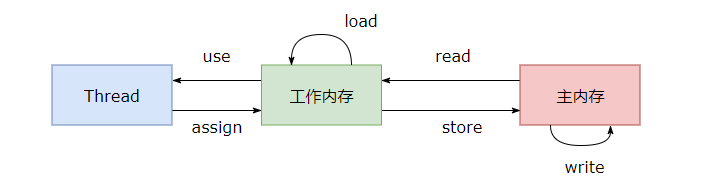
- read:把一个变量的值从主内存传输到工作内存中
- load:在 read 之后执行,把 read 得到的值放入工作内存的变量副本中
- use:把工作内存中一个变量的值传递给执行引擎
- assign:把一个从执行引擎接收到的值赋给工作内存的变量
- store:把工作内存的一个变量的值传送到主内存中
- write:在 store 之后执行,把 store 得到的值放入主内存的变量中
- lock:作用于主内存的变量,把一个变量标识为一条线程独占状态
- unlock:作用于主内存变量,把一个处于锁定状态的变量释放出来,释放后的变量才可以被其他线程锁定
如果要把一个变量从主内存中复制到工作内存,就需要按顺寻地执行 read 和 load 操作,如果把变量从工作内存中同步回主内存中,就要按顺序地执行 store 和 write 操作。Java内存模型只要求上述操作必须按顺序执行,而没有保证必须是连续执行。也就是 read 和 load 之间,store 和 write 之间是可以插入其他指令的,如对主内存中的变量a、b进行访问时,可能的顺序是read a,read b,load b, load a。
**Java内存模型还规定了在执行上述8种基本操作时,必须满足如下规则:**
- 不允许 read 和 load、store 和 write 操作之一单独出现
- 不允许一个线程丢弃它的最近 assign 的操作,即变量在工作内存中改变了之后必须同步到主内存中
- 不允许一个线程无原因地(没有发生过任何assign操作)把数据从工作内存同步回主内存中
- 一个新的变量只能在主内存中诞生,不允许在工作内存中直接使用一个未被初始化(load 或 assign)的变量。即就是对一个变量实施 use 和 store 操作之前,必须先执行过了 assign 和 load 操作。
- 一个变量在同一时刻只允许一条线程对其进行lock操作,lock 和 unlock必须成对出现
- 如果对一个变量执行 lock 操作,将会清空工作内存中此变量的值,在执行引擎使用这个变量前需要重新执行 load 或 assign 操作初始化变量的值
- 如果一个变量事先没有被 lock 操作锁定,则不允许对它执行 unlock 操作;也不允许去 unlock 一个被其他线程锁定的变量。
- 对一个变量执行 unlock 操作之前,必须先把此变量同步到主内存中(执行 store 和 write 操作)。
参考资料:
[volatile关键字与Java内存模型(JMM) - yzwall - 博客园](https://www.cnblogs.com/yzwall/p/6661528.html)
### 内存模型三大特性
#### 1. 原子性
- 概念
- 事物有原子性,这个概念大概都清楚,即一个操作或多个操作要么执行的过程中不被任何因素打断,要么不执行。
- 如何实现原子性?
- 通过同步代码块 synchronized 或者 local 锁来确保原子性
Java 内存模型保证了 read、load、use、assign、store、write、lock 和 unlock 操作具有原子性,例如对一个 int 类型的变量执行 assign 赋值操作,这个操作就是原子性的。但是 Java 内存模型允许虚拟机将没有被 volatile 修饰的 64 位数据(long,double)的读写操作划分为两次 32 位的操作来进行,即 load、store、read 和 write 操作可以不具备原子性。
有一个错误认识就是,int 等原子性的变量在多线程环境中不会出现线程安全问题。前面的线程不安全示例代码中,cnt 变量属于 int 类型变量,1000 个线程对它进行自增操作之后,得到的值为 997 而不是 1000。
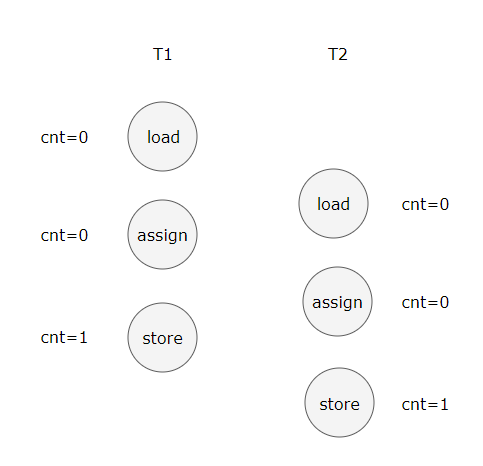
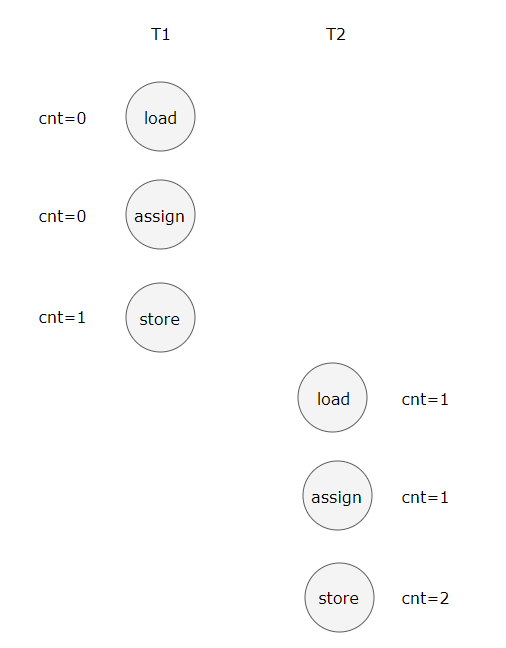
为了方便讨论,将内存间的交互操作简化为 3 个:load、assign、store。
下图演示了两个线程同时对 cnt 变量进行操作,load、assign、store 这一系列操作整体上看不具备原子性,那么在 T1 修改 cnt 并且还没有将修改后的值写入主内存,T2 依然可以读入该变量的值。可以看出,这两个线程虽然执行了两次自增运算,但是主内存中 cnt 的值最后为 1 而不是 2。因此对 int 类型读写操作满足原子性只是说明 load、assign、store 这些单个操作具备原子性。
AtomicInteger 能保证多个线程修改的原子性。
使用 AtomicInteger 重写之前线程不安全的代码之后得到以下线程安全实现:
```java
public class AtomicExample {
private AtomicInteger cnt = new AtomicInteger();
public void add() {
cnt.incrementAndGet();
}
public int get() {
return cnt.get();
}
}
```
```java
public static void main(String[] args) throws InterruptedException {
final int threadSize = 1000;
AtomicExample example = new AtomicExample(); // 只修改这条语句
final CountDownLatch countDownLatch = new CountDownLatch(threadSize);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < threadSize; i++) {
executorService.execute(() -> {
example.add();
countDownLatch.countDown();
});
}
countDownLatch.await();
executorService.shutdown();
System.out.println(example.get());
}
```
```
1000
```
除了使用原子类之外,也可以使用 synchronized 互斥锁来保证操作的原子性。它对应的内存间交互操作为:lock 和 unlock,在虚拟机实现上对应的字节码指令为 monitorenter 和 monitorexit。
```java
public class AtomicSynchronizedExample {
private int cnt = 0;
public synchronized void add() {
cnt++;
}
public synchronized int get() {
return cnt;
}
}
public static void main(String[] args) throws InterruptedException {
final int threadSize = 1000;
AtomicSynchronizedExample example = new AtomicSynchronizedExample();
final CountDownLatch countDownLatch = new CountDownLatch(threadSize);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < threadSize; i++) {
executorService.execute(() -> {
example.add();
countDownLatch.countDown();
});
}
countDownLatch.await();
executorService.shutdown();
System.out.println(example.get());
}
```
```
1000
```
#### 2. 可见性
可见性指当一个线程修改了共享变量的值,其它线程能够立即得知这个修改。Java 内存模型是通过在变量修改后将新值同步回主内存,在变量读取前从主内存刷新变量值来实现可见性的。
主要有有三种实现可见性的方式:
- volatile
- synchronized,对一个变量执行 unlock 操作之前,必须把变量值同步回主内存。
- final,被 final 关键字修饰的字段在构造器中一旦初始化完成,并且没有发生 this 逃逸(其它线程通过 this 引用访问到初始化了一半的对象),那么其它线程就能看见 final 字段的值。
对前面的线程不安全示例中的 cnt 变量使用 volatile 修饰,不能解决线程不安全问题,因为 volatile 并不能保证操作的原子性。
#### 3. 有序性
有序性是指:在本线程内观察,所有操作都是有序的。在一个线程观察另一个线程,所有操作都是无序的,无序是因为发生了指令重排序。
在 Java 内存模型中,允许编译器和处理器对指令进行重排序,重排序过程不会影响到单线程程序的执行,却会影响到多线程并发执行的正确性。
volatile 关键字通过添加内存屏障的方式来禁止指令重排,即重排序时不能把后面的指令放到内存屏障之前。
也可以通过 synchronized 来保证有序性,它保证每个时刻只有一个线程执行同步代码,相当于是让线程顺序执行同步代码。
### 指令重排序
在执行程序时为了提高性能,编译器和处理器常常会对指令做重排序。
指令重排序包括:**编译器重排序**和**处理器重排序**
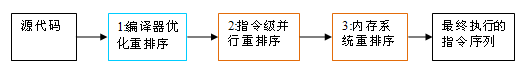
重排序分三种类型:
1. **编译器优化的重排序**。编译器在不改变单线程程序语义的前提下,可以重新安排语句的执行顺序。
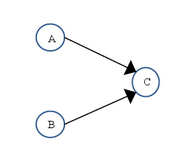
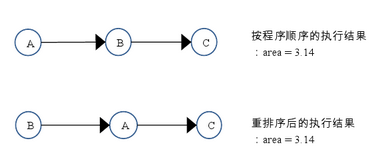
2. **指令级并行的重排序**。现代处理器采用了指令级并行技术(Instruction-Level Parallelism, ILP)来将多条指令重叠执行。如果不存在数据依赖性,处理器可以改变语句对应机器指令的执行顺序。
3. **内存系统的重排序**。由于处理器使用缓存和读/写缓冲区,这使得加载和存储操作看上去可能是在乱序执行。
从 Java 源代码到最终实际执行的指令序列,会分别经历下面三种重排序:
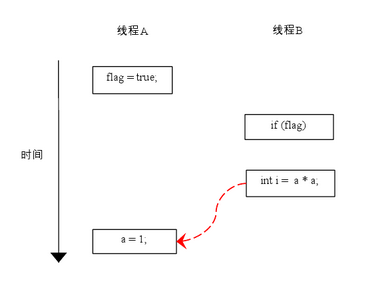
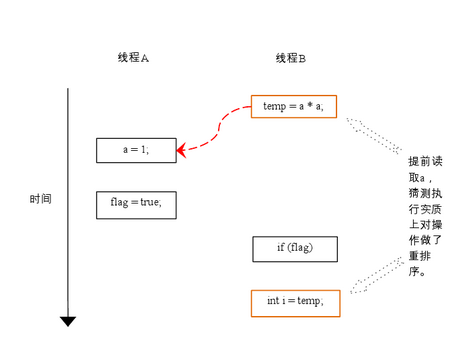
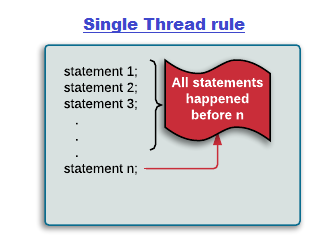
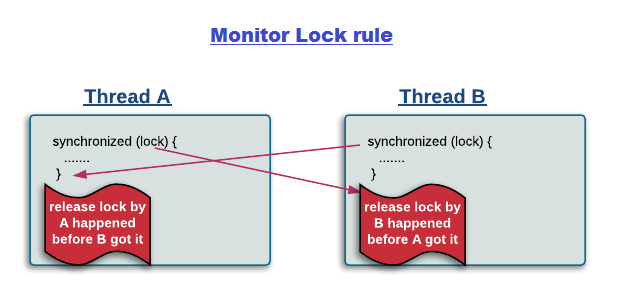
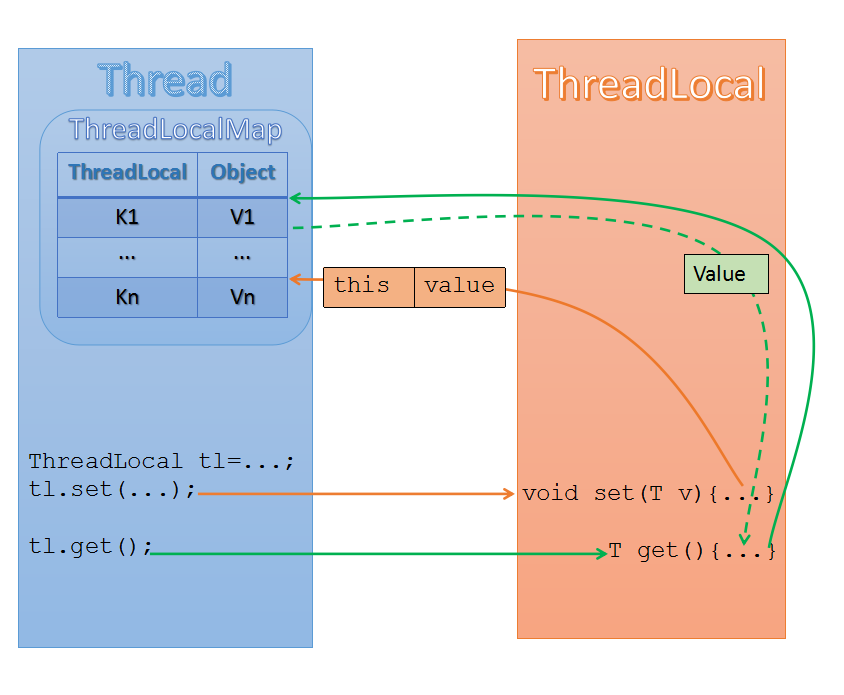
清晰的看到一个线程 Thread 中存在一个 ThreadLocalMap,ThreadLocalMap 中的 key 对应 ThreadLocal,在此处可见 Map 可以存储多个 key 即 (ThreadLocal)。另外 Value 就对应着在 ThreadLocal 中存储的 Value。
因此总结出:每个 Thread 中都具备一个 ThreadLocalMap,而 ThreadLocalMap 可以存储以 ThreadLocal 为key的键值对。这里解释了为什么每个线程访问同一个 ThreadLocal,得到的确是不同的数值。如果此处你觉得有点突兀,接下来看源码分析!
**源码分析**
**1. ThreadLocal#set**
```java
public void set(T value) {
// 获取当前线程对象
Thread t = Thread.currentThread();
// 根据当前线程的对象获取其内部Map
ThreadLocalMap map = getMap(t);
// 注释1
if (map != null)
map.set(this, value);
else
createMap(t, value);
}
```
如上所示,大部分解释已经在代码中做出,注意`注释1`处,得到 map 对象之后,用的 `this` 作为 key,this 在这里代表的是当前线程的 ThreadLocal 对象。 另外就是第二句根据 getMap 获取一个 ThreadLocalMap,其中getMap 中传入了参数 t (当前线程对象),这样就能够获取每个线程的 `ThreadLocal` 了。
继续跟进到 ThreadLocalMap 中查看 set 方法:
**2. ThreadLocalMap**
ThreadLocalMap 是 ThreadLocal 的一个内部类,在分析其 set 方法之前,查看一下其类结构和成员变量。
```java
static class ThreadLocalMap {
// Entry类继承了WeakReference>
// 即每个Entry对象都有一个ThreadLocal的弱引用(作为key),这是为了防止内存泄露。
// 一旦线程结束,key变为一个不可达的对象,这个Entry就可以被GC了。
static class Entry extends WeakReference> {
/** The value associated with this ThreadLocal. */
Object value;
Entry(ThreadLocal k, Object v) {
super(k);
value = v;
}
}
// ThreadLocalMap 的初始容量,必须为2的倍数
private static final int INITIAL_CAPACITY = 16;
// resized时候需要的table
private Entry[] table;
// table中的entry个数
private int size = 0;
// 扩容数值
private int threshold; // Default to 0
}
```
一起看一下其常用的构造函数:
```java
ThreadLocalMap(ThreadLocal firstKey, Object firstValue) {
table = new Entry[INITIAL_CAPACITY];
int i = firstKey.threadLocalHashCode & (INITIAL_CAPACITY - 1);
table[i] = new Entry(firstKey, firstValue);
size = 1;
setThreshold(INITIAL_CAPACITY);
}
```
构造函数的第一个参数就是本 ThreadLocal 实例 (this),第二个参数就是要保存的线程本地变量。构造函数首先创建一个长度为16的 Entry 数组,然后计算出 firstKey 对应的哈希值,然后存储到 table 中,并设置 size 和 threshold。
注意一个细节,计算 hash 的时候里面采用了 hashCode & (size - 1) 的算法,这相当于取模运算 hashCode % size 的一个更高效的实现(和HashMap中的思路相同)。正是因为这种算法,我们要求 size必须是 2 的指数,因为这可以使得 hash 发生冲突的次数减小。
**3. ThreadLocalMap#set**
ThreadLocal 中 put 函数最终调用了 ThreadLocalMap 中的 set 函数,跟进去看一看:
```java
private void set(ThreadLocal key, Object value) {
Entry[] tab = table;
int len = tab.length;
int i = key.threadLocalHashCode & (len-1);
for (Entry e = tab[i];
e != null;
// 冲突了
e = tab[i = nextIndex(i, len)]) {
ThreadLocal k = e.get();
if (k == key) {
e.value = value;
return;
}
if (k == null) {
replaceStaleEntry(key, value, i);
return;
}
}
tab[i] = new Entry(key, value);
int sz = ++size;
if (!cleanSomeSlots(i, sz) && sz >= threshold)
rehash();
}
```
在上述代码中如果 Entry 在存放过程中冲突了,调用 nextIndex 来处理,如下所示。是否还记得 hashmap 中对待冲突的处理?这里好像是另一种套路:只要 i 的数值小于 len,就加1取值,官方术语称为:线性探测法。
```java
private static int nextIndex(int i, int len) {
return ((i + 1 < len) ? i + 1 : 0);
}
```
以上步骤ok了之后,再次关注一下源码中的 cleanSomeSlots,该函数主要的作用就是清理无用的 entry,避免出现内存泄露:
```java
private boolean cleanSomeSlots(int i, int n) {
boolean removed = false;
Entry[] tab = table;
int len = tab.length;
do {
i = nextIndex(i, len);
Entry e = tab[i];
if (e != null && e.get() == null) {
n = len;
removed = true;
i = expungeStaleEntry(i);
}
} while ( (n >>>= 1) != 0);
return removed;
}
```
**4. ThreadLocal#get**
看完了 set 函数,肯定是要关注 get 的,源码如下所示:
```java
public T get() {
// 获取Thread对象t
Thread t = Thread.currentThread();
// 获取t中的map
ThreadLocalMap map = getMap(t);
if (map != null) {
ThreadLocalMap.Entry e = map.getEntry(this);
if (e != null) {
@SuppressWarnings("unchecked")
T result = (T)e.value;
return result;
}
}
// 如果t中的map为空
return setInitialValue();
}
```
如果 map 为 null,就返回 setInitialValue() 这个方法,跟进这个方法看一下:
```java
private T setInitialValue() {
T value = initialValue();
Thread t = Thread.currentThread();
ThreadLocalMap map = getMap(t);
if (map != null)
map.set(this, value);
else
createMap(t, value);
return value;
}
```
最后返回的是 value,而 value 来自 `initialValue() `,进入这个源码中查看:
```java
protected T initialValue() {
return null;
}
```
原来如此,如果不设置 ThreadLocal 的数值,默认就是 null,来自于此。
ThreadLocal 从理论上讲并不是用来解决多线程并发问题的,因为根本不存在多线程竞争。在一些场景 (尤其是使用线程池) 下,由于 ThreadLocal.ThreadLocalMap 的底层数据结构导致 ThreadLocal 有内存泄漏的情况,尽可能在每次使用 ThreadLocal 后手动调用 remove(),以避免出现 ThreadLocal 经典的内存泄漏甚至是造成自身业务混乱的风险。
参考资料:
- [深入理解 Java 之 ThreadLocal 工作原理](https://allenwu.itscoder.com/threadlocal-source)
## 12. 锁优化
这里的锁优化主要是指虚拟机对 synchronized 的优化。
### 自旋锁
互斥同步的进入阻塞状态的开销都很大,应该尽量避免。在许多应用中,共享数据的锁定状态只会持续很短的一段时间。自旋锁的思想是让一个线程在请求一个共享数据的锁时执行忙循环(自旋)一段时间,如果在这段时间内能获得锁,就可以避免进入阻塞状态。
自旋锁虽然能避免进入阻塞状态从而减少开销,但是它需要进行忙循环操作占用 CPU 时间,它只适用于共享数据的锁定状态很短的场景。
在 JDK 1.6 中引入了自适应的自旋锁。自适应意味着自旋的次数不再固定了,而是由前一次在同一个锁上的自旋次数及锁的拥有者的状态来决定。
### 锁消除
锁消除是指对于被检测出不可能存在竞争的共享数据的锁进行消除。
锁消除主要是通过**逃逸分析**来支持,如果堆上的共享数据不可能逃逸出去被其它线程访问到,那么就可以把它们当成私有数据对待,也就可以将它们的锁进行消除。
对于一些看起来没有加锁的代码,其实隐式的加了很多锁。例如下面的字符串拼接代码就隐式加了锁:
```java
public static String concatString(String s1, String s2, String s3) {
return s1 + s2 + s3;
}
```
String 是一个不可变的类,编译器会对 String 的拼接自动优化。在 JDK 1.5 之前,会转化为 StringBuffer 对象的连续 append() 操作:
```java
public static String concatString(String s1, String s2, String s3) {
StringBuffer sb = new StringBuffer();
sb.append(s1);
sb.append(s2);
sb.append(s3);
return sb.toString();
}
```
每个 append() 方法中都有一个同步块。虚拟机观察变量 sb,很快就会发现它的动态作用域被限制在 concatString() 方法内部。也就是说,sb 的所有引用永远不会“逃逸”到 concatString() 方法之外,其他线程无法访问到它,因此可以进行消除。
### 锁粗化
如果一系列的连续操作都对同一个对象反复加锁和解锁,频繁的加锁操作就会导致性能损耗。
上一节的示例代码中连续的 append() 方法就属于这类情况。如果虚拟机探测到由这样的一串零碎的操作都对同一个对象加锁,将会把加锁的范围扩展(粗化)到整个操作序列的外部。对于上一节的示例代码就是扩展到第一个 append() 操作之前直至最后一个 append() 操作之后,这样只需要加锁一次就可以了。
### 轻量级锁
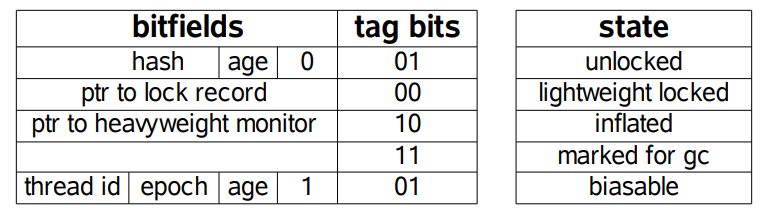
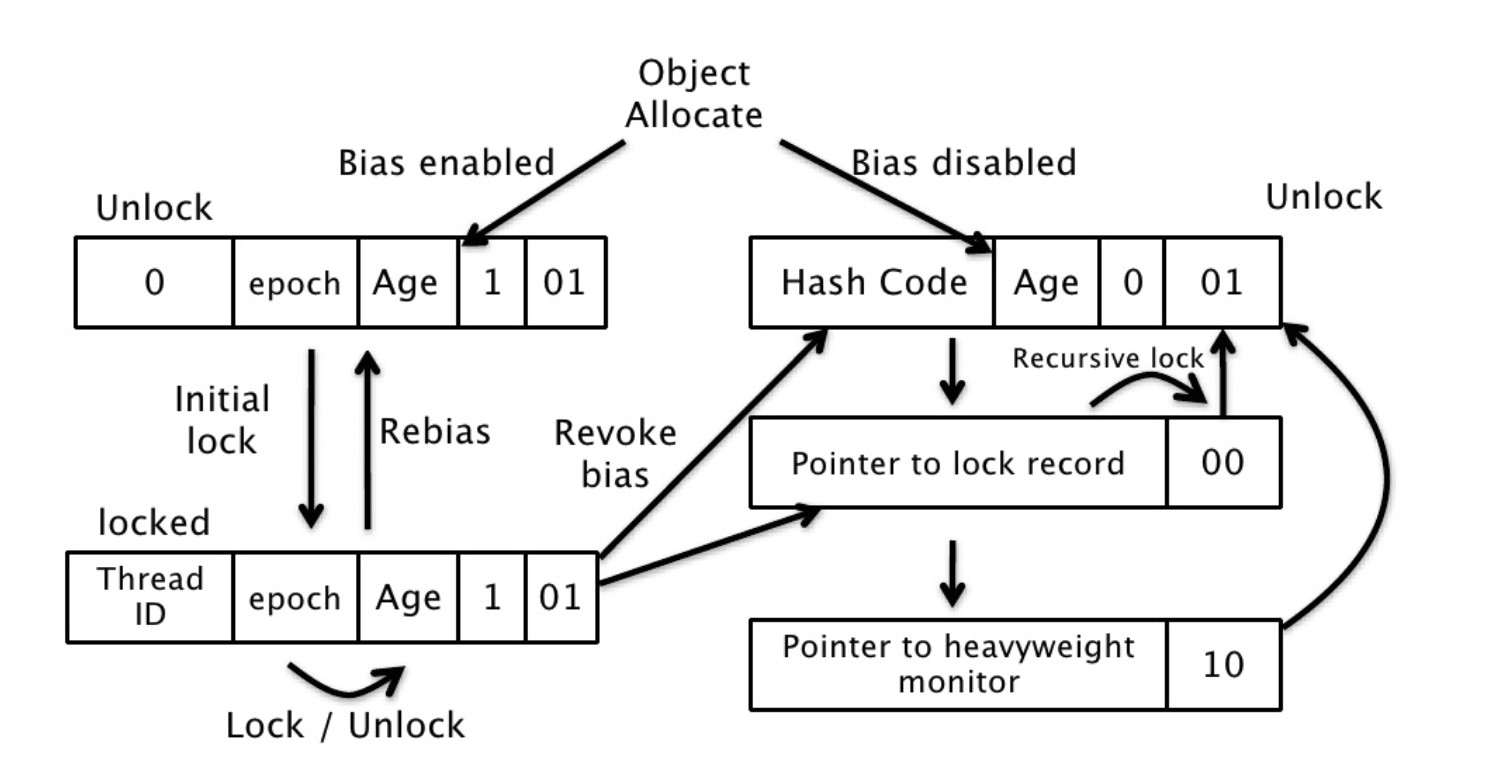
JDK 1.6 引入了偏向锁和轻量级锁,从而让锁拥有了四个状态:无锁状态(unlocked)、偏向锁状态(biasble)、轻量级锁状态(lightweight locked)和重量级锁状态(inflated)。
以下是 HotSpot 虚拟机对象头的内存布局,这些数据被称为 mark word。其中 tag bits 对应了五个状态,这些状态在右侧的 state 表格中给出,应该注意的是 state 表格不是存储在对象头中的。除了 marked for gc 状态,其它四个状态已经在前面介绍过了。
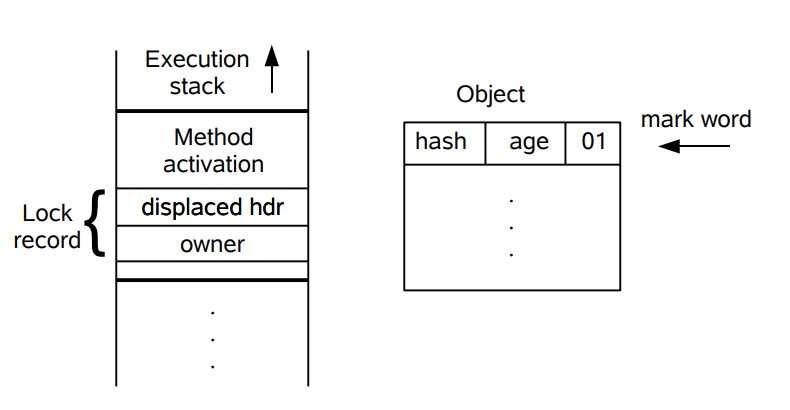
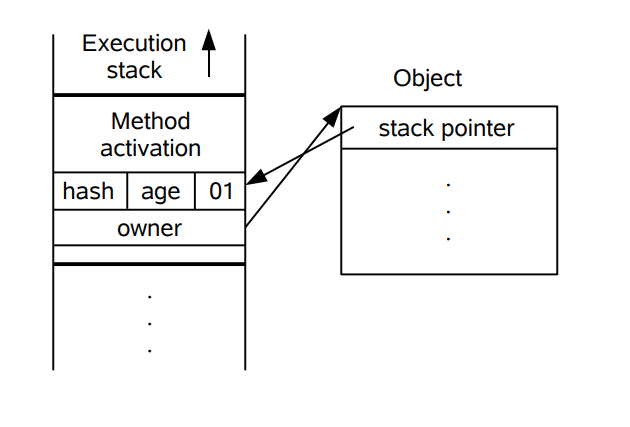
下图左侧是一个线程的虚拟机栈,其中有一部分称为 Lock Record 的区域,这是在轻量级锁运行过程创建的,用于存放锁对象的 Mark Word。而右侧就是一个锁对象,包含了 Mark Word 和其它信息。
### 并发
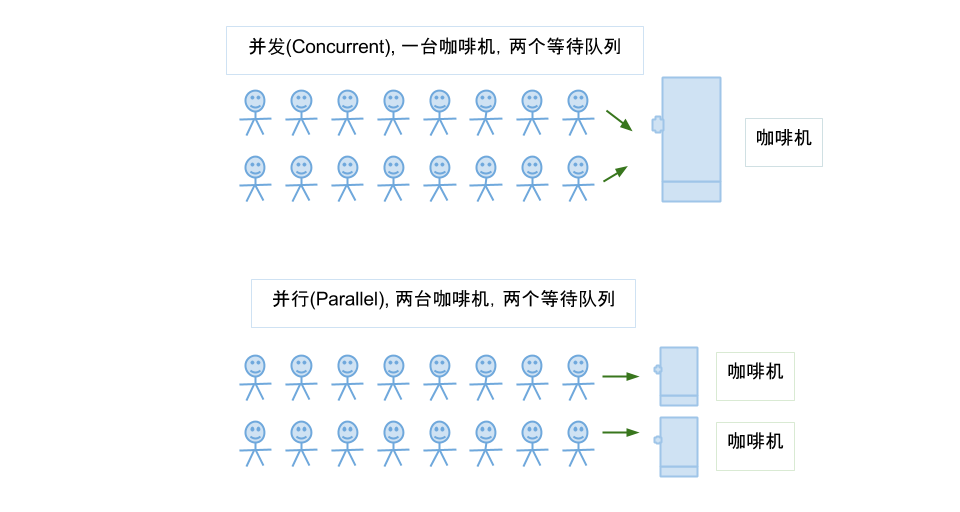
- 并发是指两个任务都请求运行,而处理器只能按受一个任务,就把这两个任务安排轮流进行,由于时间间隔较短,使人感觉两个任务都在运行。
- 如果用一台电脑我先给甲发个消息,然后立刻再给乙发消息,然后再跟甲聊,再跟乙聊。这就叫并发。
- 多个线程操作相同的资源,保证线程安全,合理使用资源
### 并行
- 并行就是两个任务同时运行,就是甲任务进行的同时,乙任务也在进行。(需要多核CPU)
- 比如我跟两个网友聊天,左手操作一个电脑跟甲聊,同时右手用另一台电脑跟乙聊天,这就叫并行。
- 服务能同时处理很多请求,提高程序性能
参考资料:
- [Cplusplus-Concurrency-In-Practice/1.1 What is concurrency.md at master · forhappy/Cplusplus-Concurrency-In-Practice](https://github.com/forhappy/Cplusplus-Concurrency-In-Practice/blob/master/zh/chapter1-Introduction/1.1%20What%20is%20concurrency.md)
## 4. 什么是线程安全
当多个线程访问同一个对象时,如果不用考虑这些线程在运行时环境下的调度和交替运行,也不需要进行额外的同步,或者在调用方进行任何其他的协调操作,调用这个对象的行为都可以获取正确的结果,那这个对象是线程安全的。——来自《深入理解Java虚拟机》
- 定义
- 某个类的行为与其规范一致。
- 不管多个线程是怎样的执行顺序和优先级,或是 wait , sleep , join 等控制方式,如果一个类在多线程访问下运转一切正常,并且访问类不需要进行额外的同步处理或者协调,那么我们就认为它是线程安全的。
- 如何保证线程安全?(更加详细的请转向第一部分 `11. 线程安全`)
- 对变量使用 volitate
- 对程序段进行加锁 (synchronized , lock)
- 注意
- 非线程安全的集合在多线程环境下可以使用,但并不能作为多个线程共享的属性,可以作为某个线程独享的属性。
- 例如 Vector 是线程安全的,ArrayList 不是线程安全的。如果每一个线程中 new 一个 ArrayList,而这个ArrayList 只是在这一个线程中使用,肯定没问题。
### 非线程安全!=不安全?
有人在使用过程中有一个不正确的观点:我的程序是多线程的,不能使用 ArrayList 要使用 Vector,这样才安全。
**非线程安全并不是多线程环境下就不能使用**。注意我上面有说到:**多线程操作同一个对象**。注意是**同一个对象**。比如最上面那个模拟,就是在主线程中 new 的一个 ArrayList 然后多个线程操作同一个 ArrayList 对象。
如果是每个线程中 new 一个 ArrayList,而这个 ArrayList 只在这一个线程中使用,那么肯定是没问题的。
### 线程安全十万个为什么?
**问:平时项目中使用锁和 synchronized 比较多,而很少使用 volatile,难道就没有保证可见性?**
答:锁和 synchronized 即可以保证原子性,也可以保证可见性。都是通过保证同一时间只有一个线程执行目标代码段来实现的。
**问:锁和 synchronized 为何能保证可见性?**
答:根据 [JDK 7的Java doc](http://docs.oracle.com/javase/7/docs/api/java/util/concurrent/package-summary.html#MemoryVisibility) 中对 `concurrent` 包的说明,一个线程的写结果保证对另外线程的读操作可见,只要该写操作可以由 `happen-before` 原则推断出在读操作之前发生。
> The results of a write by one thread are guaranteed to be **visible** to a read by another thread only if the write operation happens-before the read operation. The synchronized and volatile constructs, as well as the Thread.start() and Thread.join() methods, can form happens-before relationships.
**问:既然锁和 synchronized 即可保证原子性也可保证可见性,为何还需要 volatile?**
答:synchronized和锁需要通过操作系统来仲裁谁获得锁,开销比较高,而 volatile 开销小很多。因此在只需要保证可见性的条件下,使用 volatile 的性能要比使用锁和 synchronized 高得多。
**问:既然锁和 synchronized 可以保证原子性,为什么还需要 AtomicInteger 这种的类来保证原子操作?**
答:锁和 synchronized 需要通过操作系统来仲裁谁获得锁,开销比较高,而 AtomicInteger 是通过CPU级的CAS操作来保证原子性,开销比较小。所以使用 AtomicInteger 的目的还是为了提高性能。
**问:还有没有别的办法保证线程安全**
答:有。尽可能避免引起非线程安全的条件——共享变量。如果能从设计上避免共享变量的使用,即可避免非线程安全的发生,也就无须通过锁或者 synchronized 以及 volatile 解决原子性、可见性和顺序性的问题。
**问:synchronized 即可修饰非静态方式,也可修饰静态方法,还可修饰代码块,有何区别**
答:synchronized 修饰非静态同步方法时,锁住的是当前实例;synchronized 修饰静态同步方法时,锁住的是该类的 Class 对象;synchronized 修饰静态代码块时,锁住的是 synchronized 关键字后面括号内的对象。
参考资料:
- [Java进阶(二)当我们说线程安全时,到底在说什么](http://www.jasongj.com/java/thread_safe/)
## 5. volatile 关键字的如何保证内存可见性
- volatile 关键字的作用
- 保证内存的可见性
- 防止指令重排
- 注意:volatile 并不保证原子性
- 内存可见性
- volatile 保证可见性的原理是在每次访问变量时都会进行一次刷新,因此每次访问都是主内存中最新的版本。所以 volatile 关键字的作用之一就是保证变量修改的实时可见性。
- 当且仅当满足以下所有条件时,才应该使用 volatile 变量
- 对变量的写入操作不依赖变量的当前值,或者你能确保只有单个线程更新变量的值。
- 该变量没有包含在具有其他变量的不变式中。
- volatile 使用建议
- 在两个或者更多的线程需要访问的成员变量上使用 volatile。当要访问的变量已在 synchronized 代码块中,或者为常量时,没必要使用volatile。
- 由于使用 volatile 屏蔽掉了 JVM 中必要的代码优化,所以在效率上比较低,因此一定在必要时才使用此关键字。
- volatile 和 synchronized区别
- volatile 不会进行加锁操作:
volatile 变量是一种稍弱的同步机制在访问 volatile 变量时不会执行加锁操作,因此也就不会使执行线程阻塞,因此 volatile 变量是一种比 synchronized 关键字更轻量级的同步机制。
- volatile 变量作用类似于同步变量读写操作:
从内存可见性的角度看,写入 volatile 变量相当于退出同步代码块,而读取 volatile 变量相当于进入同步代码块。
- volatile 不如 synchronized安全:
在代码中如果过度依赖 volatile 变量来控制状态的可见性,通常会比使用锁的代码更脆弱,也更难以理解。仅当 volatile 变量能简化代码的实现以及对同步策略的验证时,才应该使用它。一般来说,用同步机制会更安全些。
- volatile 无法同时保证内存可见性和原子性:
加锁机制(即同步机制)既可以确保可见性又可以确保原子性,而 volatile 变量只能确保可见性,原因是声明为volatile的简单变量如果当前值与该变量以前的值相关,那么 volatile 关键字不起作用,也就是说如下的表达式都不是原子操作:“count++”、“count = count+1”。
## 5. 什么是线程?线程和进程有什么区别?为什么要使用多线程
(1)线程和进程
- 进程是操作系统**分配资源**的最小单位
- 线程是**CPU调度**的最小单位
(2)使用线程的原因
- 使用多线程可以减少程序的响应时间;
- 与进程相比,线程的创建和切换开销更小;
- 多核电脑上,可以同时执行多个线程,提高资源利用率;
- 简化程序的结构,使程序便于理解和维护;
## 6. 多线程共用一个数据变量需要注意什么?
- 当我们在线程对象(Runnable)中定义了全局变量,run方法会修改该变量时,如果有多个线程同时使用该线程对象,那么就会造成全局变量的值被同时修改,造成错误.
- ThreadLocal 是JDK引入的一种机制,它用于解决线程间共享变量,使用 ThreadLocal 声明的变量,即使在线程中属于全局变量,针对每个线程来讲,这个变量也是独立的。
- volatile 变量每次被线程访问时,都强迫线程从主内存中重读该变量的最新值,而当该变量发生修改变化时,也会强迫线程将最新的值刷新回主内存中。这样一来,不同的线程都能及时的看到该变量的最新值。
## 7. 内存泄漏与内存溢出
### Java内存回收机制
不论哪种语言的内存分配方式,都需要返回所分配内存的真实地址,也就是返回一个指针到内存块的首地址。Java中对象是采用 new、反射、clone、反序列化等方法创建的, 这些对象的创建都是在堆(Heap)中分配的,所有对象的回收都是由Java虚拟机通过垃圾回收机制完成的。GC 为了能够正确释放对象,会监控每个对象的运行状况,对他们的申请、引用、被引用、赋值等状况进行监控,Java 会使用有向图的方法进行管理内存,实时监控对象是否可以达到,如果不可到达,则就将其回收,这样也可以消除引用循环的问题。
在 Java 语言中,判断一个内存空间是否符合垃圾收集标准有两个:一个是给对象赋予了空值 null,以下再没有调用过,另一个是给对象赋予了新值,这样重新分配了内存空间。
### Java内存泄露引起原因
首先,什么是内存泄露?经常听人谈起内存泄露,但要问什么是内存泄露,没几个说得清楚。
**内存泄露**:是指无用对象(不再使用的对象)持续占有内存或无用对象的内存得不到及时释放,从而造成的内存空间的浪费称为内存泄露。内存泄露有时不严重且不易察觉,这样开发者就不知道存在内存泄露,但有时也会很严重,会提示 `Out of memory`。
**内存溢出**:指程序运行过程中**无法申请到足够的内存**而导致的一种错误。**内存泄露是内存溢出的一种诱因**,不是唯一因素
那么,Java 内存泄露根本原因是什么呢?长生命周期的对象持有短生命周期对象的引用就很可能发生内存泄露,尽管短生命周期对象已经不再需要,但是因为长生命周期对象持有它的引用而导致不能被回收,这就是 Java 中内存泄露的发生场景。具体主要有如下几大类
#### 静态集合类
静态集合类,使用Set、Vector、HashMap等集合类的时候需要特别注意。当这些类被定义成静态的时候,由于他们的生命周期跟应用程序一样长,这时候就有可能发生内存泄漏。
```java
// 例子
class StaticTest
{
private static Vector v = new Vector(10);
public void init()
{
for (int i = 1; i < 100; i++)
{
Object object = new Object();
v.add(object);
object = null;
}
}
}
```
在上面的代码中,循环申请object对象,并添加到Vector中,然后设置object=null(就是清除栈中引用变量object),但是这些对象被vector引用着,必然不能被GC回收,造成内存泄露。因此要释放这些对象,还需要将它们从vector中删除,最简单的方法就是将vector=null,清空集合类中的引用。
#### 监听器
在 Java 编程中,我们都需要和监听器打交道,通常一个应用中会用到很多监听器,我们会调用一个控件,诸如 `addXXXListener()` 等方法来增加监听器,但往往在释放的时候却没有去删除这些监听器,从而增加了内存泄漏的机会。
#### 各种连接
比如数据库连接(dataSourse.getConnection()),网络连接 (socket) 和 IO 连接,除非其显式的调用了其close() 方 法将其连接关闭,否则是不会自动被 GC 回收的。对于 Resultset 和 Statement 对象可以不进行显式回收,但 Connection 一定要显式回收,因为 Connection 在任何时候都无法自动回收,而 Connection一旦回收,Resultset 和 Statement 对象就会立即为 NULL。但是如果使用连接池,情况就不一样了,除了要显式地关闭连接,还必须显式地关闭 Resultset Statement 对象(关闭其中一个,另外一个也会关闭),否则就会造成大量的 Statement 对象无法释放,从而引起内存泄漏。这种情况下一般都会在 try 里面去的连接,在 finally 里面释放连接。
#### 内部类和外部模块等的引用
内部类的引用是比较容易遗忘的一种,而且一旦没释放可能导致一系列的后继类对象没有释放。在调用外部模块的时候,也应该注意防止内存泄漏,如果模块A调用了外部模块B的一个方法,如: `public void register(Object o) ` 这个方法有可能就使得A模块持有传入对象的引用,这时候需要查看B模块是否提供了出去引用的方法,这种情况容易忽略,而且发生内存泄漏的话,还比较难察觉。
#### 单例模式
因为单利对象初始化后将在 JVM 的整个生命周期内存在,如果它持有一个外部对象的(生命周期比较短)引用,那么这个外部对象就不能被回收,从而导致内存泄漏。如果这个外部对象还持有其他对象的引用,那么内存泄漏更严重。
## 8. 如何减少线程上下文切换
使用多线程时,**不是多线程能提升程序的执行速度**,使用多线程是为了**更好地利用 CPU 资源**!
程序在执行时,多线程是 CPU 通过给每个线程**分配 CPU 时间片来实现**的,时间片是CPU分配给每个线程执行的时间,因时间片非常短,所以**CPU 通过不停地切换线程执行**。
线程**不是越多就越好**的,因为线程上下文切换是有**性能损耗**的,在使用多线程的同时需要考虑如何减少上下文切换
一般来说有以下几条经验
- **无锁并发编程**。多线程竞争时,会引起上下文切换,所以多线程处理数据时,可以用一些办法来避免使用锁,如将数据的 ID 按照Hash取模分段,不同的线程处理不同段的数据
- **CAS算法**。Java 的 Atomic 包使用 CAS 算法来更新数据,**而不需要加锁**。
- **控制线程数量**。避免创建不需要的线程,比如任务很少,但是创建了很多线程来处理,这样会造成大量线程都处于等待状态
- **协程**。在单线程里实现多任务的调度,并在单线程里维持多个任务间的切换
- 协程可以看成是用户态**自管理的“线程”**。**不会参与**CPU时间调度,没有均衡分配到时间。**非抢占式**的
还可以考虑我们的应用是**IO密集型的还是CPU密集型**的。
- 如果是IO密集型的话,线程可以多一些。
- 如果是CPU密集型的话,线程不宜太多。
## 9. 线程间通信和进程间通信
### 线程间通信
- **synchronized 同步**
- 这种方式,本质上就是 “共享内存” 式的通信。多个线程需要访问同一个共享变量,谁拿到了锁(获得了访问权限),谁就可以执行。
- **while 轮询的方式**
- 在这种方式下,线程A不断地改变条件,线程 ThreadB 不停地通过 while 语句检测这个条件`(list.size()==5)` 是否成立 ,从而实现了线程间的通信。但是这种方式会浪费 CPU 资源。之所以说它浪费资源,是因为 JVM 调度器将 CPU 交给线程B执行时,它没做啥“有用”的工作,只是在不断地测试某个条件是否成立。就类似于现实生活中,某个人一直看着手机屏幕是否有电话来了,而不是: 在干别的事情,当有电话来时,响铃通知TA电话来了。
- **wait/notify 机制**
- 当条件未满足时,线程A调用 wait() 放弃CPU,并进入阻塞状态。(不像 while 轮询那样占用 CPU)
当条件满足时,线程B调用 notify() 通知线程A,所谓通知线程A,就是唤醒线程A,并让它进入可运行状态。
- **管道通信**
- java.io.PipedInputStream 和 java.io.PipedOutputStream 进行通信
### 进程间通信
- **管道(Pipe)** :管道可用于具有亲缘关系进程间的通信,允许一个进程和另一个与它有共同祖先的进程之间进行通信。
- **命名管道(named pipe)** :命名管道克服了管道没有名字的限制,因此,除具有管道所具有的功能外,它还允许无亲缘关 系 进程间的通信。命名管道在文件系统中有对应的文件名。命名管道通过命令mkfifo或系统调用mkfifo来创建。
- **信号(Signal)** :信号是比较复杂的通信方式,用于通知接受进程有某种事件发生,除了用于进程间通信外,进程还可以发送 信号给进程本身;Linux除了支持Unix早期信号语义函数sigal外,还支持语义符合Posix.1标准的信号函数sigaction(实际上,该函数是基于BSD的,BSD为了实现可靠信号机制,又能够统一对外接口,用sigaction函数重新实现了signal函数)。
- **消息(Message)队列** :消息队列是消息的链接表,包括Posix消息队列system V消息队列。有足够权限的进程可以向队列中添加消息,被赋予读权限的进程则可以读走队列中的消息。消息队列克服了信号承载信息量少,管道只能承载无格式字节流以及缓冲区大小受限等缺
- **共享内存** :使得多个进程可以访问同一块内存空间,是最快的可用IPC形式。是针对其他通信机制运行效率较低而设计的。往往与其它通信机制,如信号量结合使用,来达到进程间的同步及互斥。
- **内存映射(mapped memory)** :内存映射允许任何多个进程间通信,每一个使用该机制的进程通过把一个共享的文件映射到自己的进程地址空间来实现它。
- **信号量(semaphore)** :主要作为进程间以及同一进程不同线程之间的同步手段。
- **套接口(Socket)** :更为一般的进程间通信机制,可用于不同机器之间的进程间通信。起初是由Unix系统的BSD分支开发出来的,但现在一般可以移植到其它类Unix系统上:linux和System V的变种都支持套接字。
参考资料:
- [Java线程与线程、进程与进程之间通信方式 | 理想村 | 屠杭镝的博客](https://www.tuhd.top/2017/08/04/2017-08-04-threadandprocess/)
- [JAVA多线程之线程间的通信方式 - hapjin - 博客园](https://www.cnblogs.com/hapjin/p/5492619.html)
## 10. 什么是同步和异步,阻塞和非阻塞?
> 同步和异步关注的是消息通信机制 (synchronous communication/ asynchronous communication)
### 同步
- 在发出一个同步调用时,在没有得到结果之前,该调用就不返回。
- 例如:按下电饭锅的煮饭按钮,然后等待饭煮好,把饭盛出来,然后再去炒菜。
### 异步
- 在发出一个异步调用后,调用者不会立刻得到结果,该调用就返回了。
- 例如:按下电钮锅的煮饭按钮,直接去炒菜或者做别的事情,当电饭锅“滴滴滴”响的时候,再回去把饭盛出来。显然,异步式编程要比同步式编程高效得多。
> 阻塞和非阻塞关注的是程序在等待调用结果(消息,返回值)时的状态.
### 阻塞
- 调用结果返回之前,当前线程会被挂起。调用线程只有在得到结果之后才会返回。
- 例子:你打电话问书店老板有没有《分布式系统》这本书,你如果是阻塞式调用,你会一直把自己“挂起”,直到得到这本书有没有的结果
### 非阻塞
- 在不能立刻得到结果之前,该调用不会阻塞当前线程。
- 例子:你打电话问书店老板有没有《分布式系统》这本书,你不管老板有没有告诉你,你自己先一边去玩了, 当然你也要偶尔过几分钟check一下老板有没有返回结果。
参考资料:
- [深入理解并发 / 并行,阻塞 / 非阻塞,同步 / 异步 - 后端 - 掘金](https://juejin.im/entry/58ae4636b123db0052b1caf8)
## 11. Java中的锁
本小结参考:[Java 中的锁 - Java 并发性和多线程 - 极客学院Wiki](http://wiki.jikexueyuan.com/project/java-concurrent/locks-in-java.html)
锁像 synchronized 同步块一样,是一种线程同步机制,但比 Java 中的 synchronized 同步块更复杂。因为锁(以及其它更高级的线程同步机制)是由 synchronized 同步块的方式实现的,所以我们还不能完全摆脱 synchronized 关键字(译者注:这说的是 Java 5 之前的情况)。
自 Java 5 开始,java.util.concurrent.locks 包中包含了一些锁的实现,因此你不用去实现自己的锁了。但是你仍然需要去了解怎样使用这些锁,且了解这些实现背后的理论也是很有用处的。可以参考我对 java.util.concurrent.locks.Lock 的介绍,以了解更多关于锁的信息。
### 一个简单的锁
让我们从 java 中的一个同步块开始:
```java
public class Counter{
private int count = 0;
public int inc(){
synchronized(this){
return ++count;
}
}
}
```
可以看到在 inc()方法中有一个 synchronized(this)代码块。该代码块可以保证在同一时间只有一个线程可以执行 return ++count。虽然在 synchronized 的同步块中的代码可以更加复杂,但是++count 这种简单的操作已经足以表达出线程同步的意思。
以下的 Counter 类用 Lock 代替 synchronized 达到了同样的目的:
```java
public class Counter{
private Lock lock = new Lock();
private int count = 0;
public int inc(){
lock.lock();
int newCount = ++count;
lock.unlock();
return newCount;
}
}
```
lock()方法会对 Lock 实例对象进行加锁,因此所有对该对象调用 lock()方法的线程都会被阻塞,直到该 Lock 对象的 unlock()方法被调用。
这里有一个 Lock 类的简单实现:
```java
public class Counter{
public class Lock{
private boolean isLocked = false;
public synchronized void lock()
throws InterruptedException{
while(isLocked){
wait();
}
isLocked = true;
}
public synchronized void unlock(){
isLocked = false;
notify();
}
}
```
注意其中的 while(isLocked) 循环,它又被叫做 “**自旋锁**”。自旋锁以及 wait() 和 notify() 方法在[线程通信](http://wiki.jikexueyuan.com/project/java-concurrent/thread-communication.html)这篇文章中有更加详细的介绍。当 isLocked 为 true 时,调用 lock() 的线程在 wait() 调用上阻塞等待。为防止该线程没有收到 notify() 调用也从 wait() 中返回(也称作[虚假唤醒](http://wiki.jikexueyuan.com/project/java-concurrent/race-conditions-and-critical-sections.html)),这个线程会重新去检查 isLocked 条件以决定当前是否可以安全地继续执行还是需要重新保持等待,而不是认为线程被唤醒了就可以安全地继续执行了。如果 isLocked 为 false,当前线程会退出 while(isLocked) 循环,并将 isLocked 设回 true,让其它正在调用 lock() 方法的线程能够在 Lock 实例上加锁。
当线程完成了[临界区](http://wiki.jikexueyuan.com/project/java-concurrent/race-conditions-and-critical-sections.html)(位于 lock()和 unlock()之间)中的代码,就会调用 unlock()。执行 unlock()会重新将 isLocked 设置为 false,并且通知(唤醒)其中一个(若有的话)在 lock()方法中调用了 wait()函数而处于等待状态的线程。
### 锁的可重入性
Java 中的 synchronized 同步块是可重入的。这意味着如果一个 Java 线程进入了代码中的 synchronized 同步块,并因此获得了该同步块使用的同步对象对应的管程上的锁,那么这个线程可以进入由同一个管程对象所同步的另一个 java 代码块。下面是一个例子:
```java
public class Reentrant{
public synchronized outer(){
inner();
}
public synchronized inner(){
//do something
}
}
```
注意 outer()和 inner()都被声明为 synchronized,这在 Java 中和 synchronized(this) 块等效。如果一个线程调用了 outer(),在 outer()里调用 inner()就没有什么问题,因为这两个方法(代码块)都由同一个管程对象(”this”) 所同步。如果一个线程已经拥有了一个管程对象上的锁,那么它就有权访问被这个管程对象同步的所有代码块。这就是可重入。线程可以进入任何一个它已经拥有的锁所同步着的代码块。
前面给出的锁实现不是可重入的。如果我们像下面这样重写 Reentrant 类,当线程调用 outer() 时,会在 inner()方法的 lock.lock() 处阻塞住。
```java
public class Reentrant2{
Lock lock = new Lock();
public outer(){
lock.lock();
inner();
lock.unlock();
}
public synchronized inner(){
lock.lock();
//do something
lock.unlock();
}
}
```
调用 outer() 的线程首先会锁住 Lock 实例,然后继续调用 inner()。inner()方法中该线程将再一次尝试锁住 Lock 实例,结果该动作会失败(也就是说该线程会被阻塞),因为这个 Lock 实例已经在 outer()方法中被锁住了。
两次 lock()之间没有调用 unlock(),第二次调用 lock 就会阻塞,看过 lock() 实现后,会发现原因很明显:
```java
public class Lock{
boolean isLocked = false;
public synchronized void lock()
throws InterruptedException{
while(isLocked){
wait();
}
isLocked = true;
}
...
}
```
一个线程是否被允许退出 lock()方法是由 while 循环(自旋锁)中的条件决定的。当前的判断条件是只有当 isLocked 为 false 时 lock 操作才被允许,而没有考虑是哪个线程锁住了它。
为了让这个 Lock 类具有可重入性,我们需要对它做一点小的改动:
```java
public class Lock{
boolean isLocked = false;
Thread lockedBy = null;
int lockedCount = 0;
public synchronized void lock()
throws InterruptedException{
Thread callingThread =
Thread.currentThread();
while(isLocked && lockedBy != callingThread){
wait();
}
isLocked = true;
lockedCount++;
lockedBy = callingThread;
}
public synchronized void unlock(){
if(Thread.curentThread() ==
this.lockedBy){
lockedCount--;
if(lockedCount == 0){
isLocked = false;
notify();
}
}
}
...
}
```
注意到现在的 while 循环(自旋锁)也考虑到了已锁住该 Lock 实例的线程。如果当前的锁对象没有被加锁(isLocked = false),或者当前调用线程已经对该 Lock 实例加了锁,那么 while 循环就不会被执行,调用 lock()的线程就可以退出该方法(译者注:“被允许退出该方法”在当前语义下就是指不会调用 wait()而导致阻塞)。
除此之外,我们需要记录同一个线程重复对一个锁对象加锁的次数。否则,一次 unblock()调用就会解除整个锁,即使当前锁已经被加锁过多次。在 unlock()调用没有达到对应 lock()调用的次数之前,我们不希望锁被解除。
现在这个 Lock 类就是可重入的了。
### 锁的公平性
Java 的 synchronized 块并不保证尝试进入它们的线程的顺序。因此,如果多个线程不断竞争访问相同的 synchronized 同步块,就存在一种风险,其中一个或多个线程永远也得不到访问权 —— 也就是说访问权总是分配给了其它线程。这种情况被称作线程饥饿。为了避免这种问题,锁需要实现公平性。本文所展现的锁在内部是用 synchronized 同步块实现的,因此它们也不保证公平性。[饥饿和公平](http://wiki.jikexueyuan.com/project/java-concurrent/starvation-and-fairness.html)中有更多关于该内容的讨论。
### 在 finally 语句中调用 unlock()
如果用 Lock 来保护临界区,并且临界区有可能会抛出异常,那么在 finally 语句中调用 unlock()就显得非常重要了。这样可以保证这个锁对象可以被解锁以便其它线程能继续对其加锁。以下是一个示例:
```java
lock.lock();
try{
//do critical section code,
//which may throw exception
} finally {
lock.unlock();
}
```
这个简单的结构可以保证当临界区抛出异常时 Lock 对象可以被解锁。如果不是在 finally 语句中调用的 unlock(),当临界区抛出异常时,Lock 对象将永远停留在被锁住的状态,这会导致其它所有在该 Lock 对象上调用 lock()的线程一直阻塞。
## 12. 并发包(J.U.C)下面,都用过什么
- concurrent下面的包
- Executor 用来创建线程池,在实现Callable接口时,添加线程。
- FeatureTask 此 FutureTask 的 get 方法所返回的结果类型。
- TimeUnit
- Semaphore
- LinkedBlockingQueue
- 所用过的类
- Executor
## 13. 从volatile说到,i++原子操作,线程安全问题
从 volatile 说到,i++原子操作,线程安全问题 - CSDN博客
https://blog.csdn.net/zbw18297786698/article/details/53420780
# 参考资料
- [Interview-Notebook/Java 并发.md at master · CyC2018/Interview-Notebook](https://github.com/CyC2018/Interview-Notebook/blob/master/notes/Java%20%E5%B9%B6%E5%8F%91.md)
- [Java 并发编程-极客学院Wiki](http://wiki.jikexueyuan.com/project/java-concurrency/)
# 更新日志
- 2018/9/2 v3.0