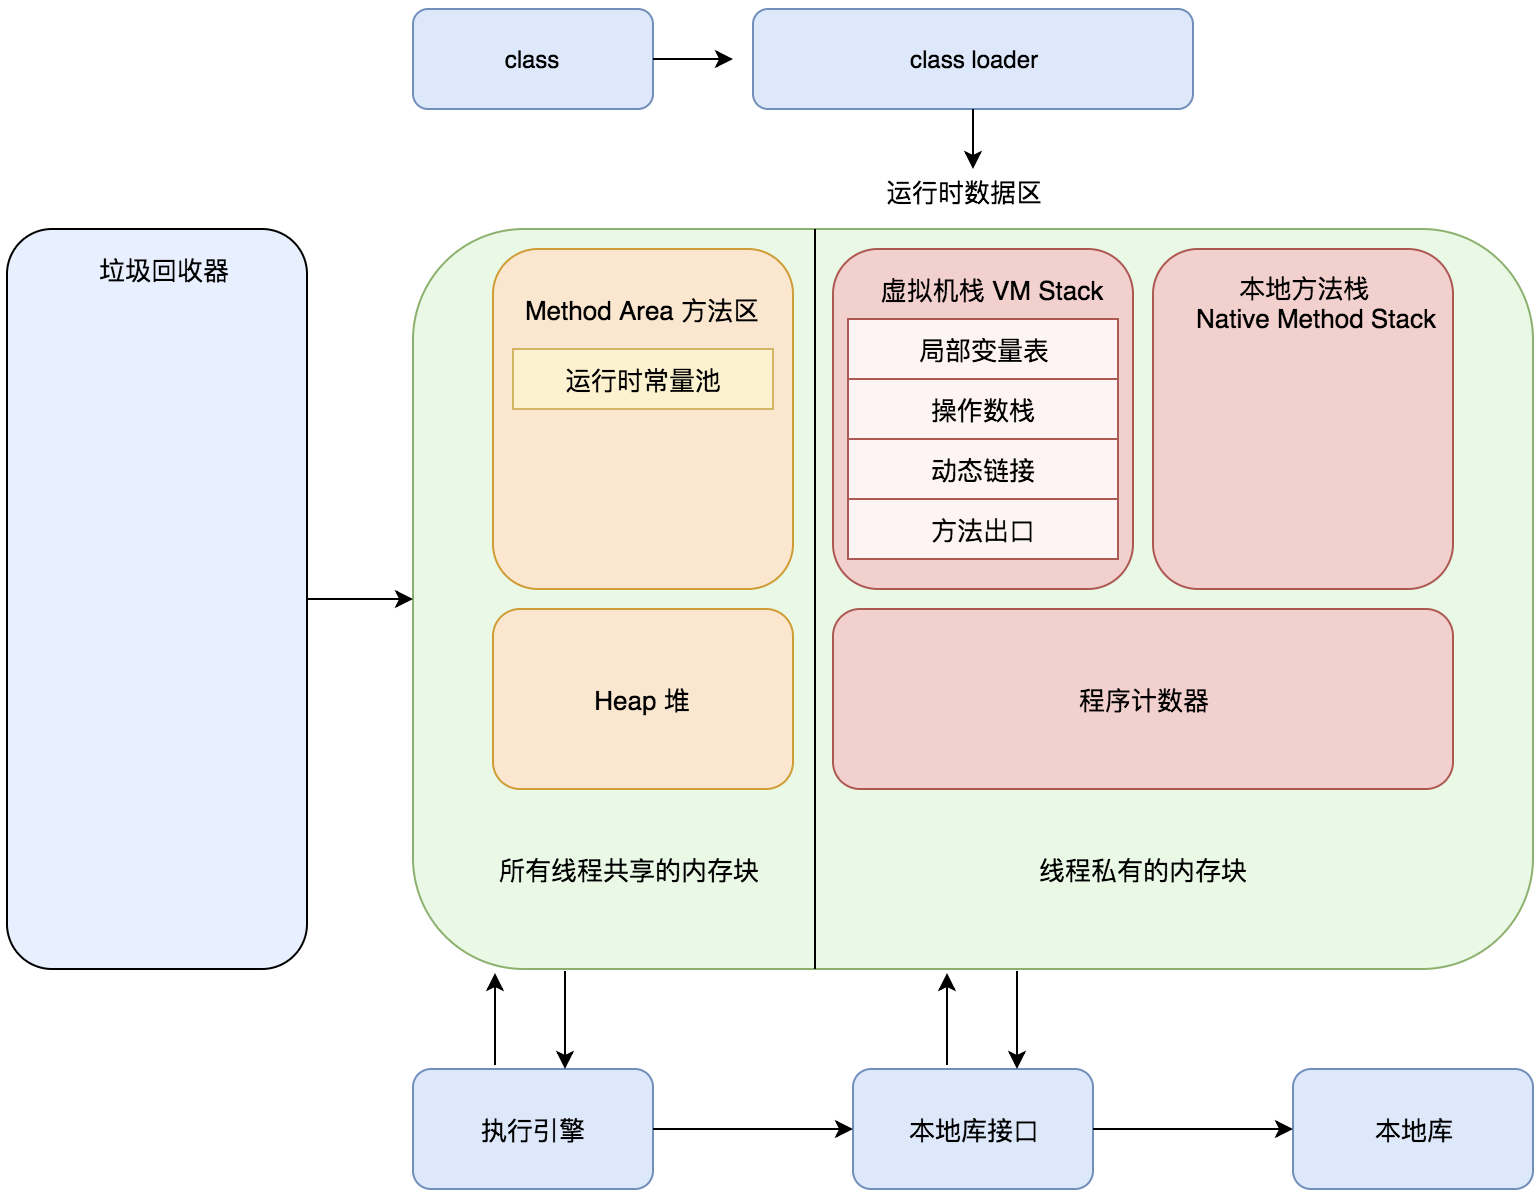
- [前言](#前言) - [核心知识](#核心知识) - [JVM体系结构](#jvm体系结构) - [JVM各个模块简介](#jvm各个模块简介) - [JVM是如何工作的?](#jvm是如何工作的) - [1. 运行时数据区域](#1-运行时数据区域) - [1. 程序计数器(线程私有)](#1-程序计数器线程私有) - [2. 虚拟机栈(线程私有)](#2-虚拟机栈线程私有) - [3. 本地方法栈(线程私有)](#3-本地方法栈线程私有) - [4. 堆](#4-堆) - [新生代 (Young Generation)](#新生代-young-generation) - [老年代 (Old Generation)](#老年代-old-generation) - [永久代 (Permanent Generation)](#永久代-permanent-generation) - [5. 方法区](#5-方法区) - [6. 运行时常量池](#6-运行时常量池) - [7. 直接内存](#7-直接内存) - [2. 判断一个对象是否可被回收](#2-判断一个对象是否可被回收) - [1. 引用计数算法](#1-引用计数算法) - [2. 可达性分析算法](#2-可达性分析算法) - [★ GC用的引用可达性分析算法中,哪些对象可作为GC Roots对象?](#★-gc用的引用可达性分析算法中哪些对象可作为gc-roots对象) - [3. 引用类型](#3-引用类型) - [1. 强引用(Strong Reference)](#1-强引用strong-reference) - [2. 软引用(Soft Reference)](#2-软引用soft-reference) - [3. 弱引用(Weak Reference)](#3-弱引用weak-reference) - [4. 虚引用(Phantom Reference)](#4-虚引用phantom-reference) - [4. 方法区的回收](#4-方法区的回收) - [5. finalize()](#5-finalize) - [3. 垃圾收集算法(垃圾处理方法)](#3-垃圾收集算法垃圾处理方法) - [1. 标记 - 清除](#1-标记---清除) - [2. 标记 - 整理](#2-标记---整理) - [3. 复制回收](#3-复制回收) - [★ 分代收集](#★-分代收集) - [4. 垃圾收集器](#4-垃圾收集器) - [1. Serial](#1-serial) - [2. ParNew](#2-parnew) - [3. Parallel Scavenge](#3-parallel-scavenge) - [4. Serial Old](#4-serial-old) - [5. Parallel Old](#5-parallel-old) - [6. CMS](#6-cms) - [7. G1](#7-g1) - [8. 比较](#8-比较) - [5. 内存分配与回收策略](#5-内存分配与回收策略) - [1. 什么时候进行Minor GC,Full GC](#1-什么时候进行minor-gcfull-gc) - [2. 内存分配策略](#2-内存分配策略) - [1. 对象优先在 Eden 分配](#1-对象优先在-eden-分配) - [2. 大对象直接进入老年代](#2-大对象直接进入老年代) - [3. 长期存活的对象进入老年代](#3-长期存活的对象进入老年代) - [4. 动态对象年龄判定](#4-动态对象年龄判定) - [5. 空间分配担保](#5-空间分配担保) - [3. Full GC 的触发条件](#3-full-gc-的触发条件) - [1. 调用 System.gc()](#1-调用-systemgc) - [2. 老年代空间不足](#2-老年代空间不足) - [3. 空间分配担保失败](#3-空间分配担保失败) - [4. JDK 1.7 及以前的永久代空间不足](#4-jdk-17-及以前的永久代空间不足) - [5. Concurrent Mode Failure](#5-concurrent-mode-failure) - [6. 类加载机制](#6-类加载机制) - [类的生命周期](#类的生命周期) - [类初始化时机](#类初始化时机) - [1. 主动引用](#1-主动引用) - [2. 被动引用](#2-被动引用) - [类加载过程](#类加载过程) - [1. 加载](#1-加载) - [2. 验证](#2-验证) - [3. 准备](#3-准备) - [4. 解析](#4-解析) - [5. 初始化](#5-初始化) - [类加载器](#类加载器) - [1. 类与类加载器](#1-类与类加载器) - [2. 类加载器分类](#2-类加载器分类) - [3. 双亲委派模型](#3-双亲委派模型) - [7. Student s = new Student(); 在内存中做了哪些事情](#7-student-s--new-student-在内存中做了哪些事情) - [8. Java虚拟机工具](#8-java虚拟机工具) - [(1)jps](#1jps) - [(2)jstat](#2jstat) - [(3)jinfo](#3jinfo) - [(4)jmap](#4jmap) - [(5)jhat](#5jhat) - [(6)jstack](#6jstack) - [(7)jconsole](#7jconsole) - [(8)jvisualvm](#8jvisualvm) - [9. 了解过JVM调优没,基本思路是什么](#9-了解过jvm调优没基本思路是什么) - [10. JVM线程死锁,你该如何判断是因为什么?如果用VisualVM,dump线程信息出来,会有哪些信息](#10-jvm线程死锁你该如何判断是因为什么如果用visualvmdump线程信息出来会有哪些信息) - [11. 什么是内存泄露?用什么工具可以查出内存泄漏](#11-什么是内存泄露用什么工具可以查出内存泄漏) - [* 虚拟机参数](#-虚拟机参数) - [附录:参考资料](#附录参考资料) - [更新说明](#更新说明) # 前言 在本文将深入讨论 Java 虚拟机相关核心知识 参考书籍: - 《深入理解 Java 虚拟机》周志明,机械工业出版社 学习课程: - 【炼数成金】深入 JVM 内核—原理、诊断与优化 - 【龙果学院】深入理解 Java 虚拟机( JVM 性能调优+内存模型+虚拟机原理) - 【尚学堂】白鹤翔 JVM 虚拟机优化 # 核心知识 - JVM 基本结构 - 类加载器 - 执行引擎 - 运行时数据区 - 本地接口 Class Files -> ClassLoader -> 运行时数据区 -> 执行引擎,本地库接口 -> 本地方法库 ## JVM体系结构 虚拟机是物理机器的软件实现。Java 的开发遵循 write once run anywhere(“一次编写到处乱跑”)理念,它运行在 VM(虚拟机)上。编译器将 Java 文件编译成 Java.class 文件,之后,将 .class 文件输入到 JVM 中,加载并执行该类文件。下图是 JVM 的体系结构 ![img](assets/435918-20180701233830808-854564995.png) ### JVM各个模块简介 1. 运行时数据区:经过编译生成的字节码文件(class文件),由 class loader(类加载子系统)加载后交给执行引擎执行。在执行引擎执行的过程中产生的数据会存储在一块内存区域。这块内存区域就是运行时区域 2. 程序计数器:用于记录当前线程的正在执行的字节码指令位置。由于虚拟机的多线程是切换线程并分配 cpu 执行时间的方式实现的,不同线程的执行位置都需要记录下来,因此程序计数器是线程私有的 3. 虚拟机栈:虚拟机栈是 Java 方法执行的内存结构,虚拟机会在每个 Java 方法执行时创建一个“栈桢”,用于存储局部变量表,操作数栈,动态链接,方法出口等信息。当方法执行完毕时,该栈桢会从虚拟机栈中出栈。其中局部变量表包含基本数据类型和对象引用 - 在 Java 虚拟机规范中,对这个区域规定了两种异常状态:如果线程请求的栈的深度大于虚拟机允许的深度,将抛出 StackOverFlowError 异常(栈溢出),如果虚拟机栈可以动态扩展(现在大部分 Java 虚拟机都可以动态扩展,只不过 Java 虚拟机规范中也允许固定长度的 Java 虚拟机栈),如果扩展时无法申请到足够的内存空间,就会抛出 OutOfmMemoryError 异常(没有足够的内存) 4. 本地方法栈:类似 Java 方法的执行有虚拟机栈,本地方法的执行则对应有本地方法栈 5. 方法区:用于存储已被虚拟机加载的类信息,常量,静态变量,即时编译器编译后的代码等数据。线程共享(看存储的数据就知道了) 6. Java 堆(Heap):堆的主要作用是存放程序运行过程中创建的对象实例,因为要存放的对象实例有可能会极多,因此也是虚拟机内存管理中最大的一块。并且由于硬件条件有限,所以需要不断回收已“无用”的实例对象来腾出空间给新生成的实例对象;因此 Java 的垃圾回收主要是针对堆进行回收的(还有方法区的常量池),Java 堆很多时候也被称为GC堆(Garbage Collected Heap)。 7. 类加载机制(Class Loader):类加载子系统是根据一个类的全限定名来加载该类的二进制流到内存中,在JVM 中将形成一份描述 Class 结构的元信息对象(方法区),通过该元信息对象可以获知 Class 的结构信息:如构造函数,属性和方法等,Java 允许用户借由这个 Class 相关的元信息对象间接调用 Class 对象的功能。 ### JVM是如何工作的? 如上面的体系结构图所示,JVM 分为三个主要的子系统: 1. 类加载器子系统 2. 运行时数据区 3. 执行引擎 **1、类加载器子系统** Java的动态类加载功能是由类加载器子系统处理的。它负责加载、链接,并且在**运行时**首次引用类的时候初始化类,而不是在编译期间。 **1.1、加载** 这个组件负责加载类。BootStrap类加载器、Extension类加载器和Application类加载器是实现这个功能的三大类加载器。 1. **BootStrap类加载器** —— 负责从classpath加载类,如果没有类存在,将只加载**rt.jar**。这个加载器的优先级最高。 2. **Extension类加载器** —— 负责加载**扩展文件夹(jre\lib)**中的类。 3. **Application类加载器** —— 负责加载**应用级classpath**和环境变量指向的路径下的类。 上述**类加载器**在加载类文件时遵循**委托层次结构算法**。 **1.2、链接** 1. **校验** —— 字节码验证器将校验生成的字节码是否正确,如果校验失败,我们将获得**校验错误信息**。 2. **准备** —— 对于所有的静态变量,内存将被申请并分配默认值。 3. **解析** —— 所有**标记的内存引用**从**方法区域**被替换成的**原始引用**。 **1.3、初始化** 这是类加载的最后阶段,所有的静态变量都将被分配原值,静态代码块将被执行。 运行时数据区 运行时数据区被划分为五个主要部分: - **方法区** —— 所有**类级数据**都将存储在这里,包括**静态变量**。每一个JVM只有一个方法区,并且它是一个共享资源。 - **堆区** —— 所有**对象**及其对应的**实例变量**和**数组**等存储在此,每个JVM同样只有一个堆区。由于**方法区**和**堆区**是多线程内存共享,因此存储的数据是非线程安全的。 - **栈区** —— 每个线程都会创建一个单独的**运行时栈**。在每一次**方法调用**,都会在栈内存中创建一个**栈帧(Stack Frame)**。所有**局部变量**将在栈内存中创建。栈区是线程安全的,因为它不是一个共享资源。栈帧可以被划分为三个实体: > **局部变量数组** —— 与方法中有多少局部变量有关,相应的值将存储在此处。 > **操作数栈** —— 如果任何的中间操作需要被执行,**操作数栈**将作为运行时工作区来执行操作。 > **帧数据** —— 与方法相对应的所有符号存储在此。在任何异常情况下,catch块的信息被保留在帧数据中。 - **PC寄存器** —— 每一个线程都有单独的**PC寄存器**,一旦执行指令,PC寄存器将被下一条指令**更新**,保存当前**执行指令**的地址。 - **本地方法栈** —— 本地方法栈保存本地方法信息,每一个线程都会创建一个单独的本地方栈。 **3、执行引擎** 分配到运行时数据区的字节码将被执行引擎执行。执行引擎读取字节码并逐一执行。 - **解释器** —— 解释器能更加快速地解释字节码,但是执行缓慢。解释器的缺点是当多次调用一个方法时,每次都要重新解释。 - **JIT编译器** —— JIT编译器弥补了解释器的不足。执行引擎使用解释器来转换字节码,当它发现重复的代码时,它将使用JIT编译器来编译整个字节码并转换为本地代码。本地代码将直接被重复的方法所调用,从而提高系统性能。 - **中间代码生成器** —— 生成中间代码。 - **代码优化器** —— 负责优化上述生成的中间代码。 - **目标代码生成器** —— 负责生成机器码或者本地代码。 - **分析器** —— 一个特殊的组件,负责查找热点代码,比如一个方法是否被调用多次。 - **垃圾回收器** —— 回收并删除未引用的对象。可以通过调用**System.gc()**来触发垃圾回收,但不能保证它执行。JVM的垃圾回收是回收被创建的对象。 **Java本地接口(JNI)**:**JNI**与**本地方法库**交互,并为执行引擎提供**本地方法库**。 **本地方法库(Native Method Libraries)**:它是执行引擎所需的本地库集合。 ## 1. 运行时数据区域
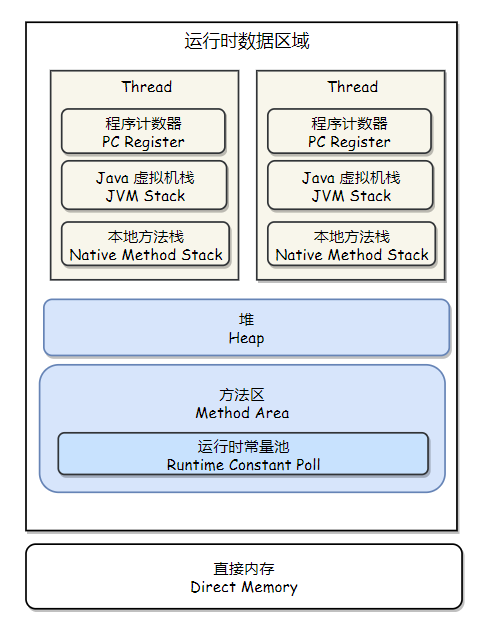
### 1. 程序计数器(线程私有) 记录正在执行的虚拟机字节码指令的地址(如果正在执行的是本地方法则为空)。 - 多个线程竞争时被挂起,程序计数器记录执行到哪里 - 唯一一个在 Java 虚拟机规范中没有规定任何 OutOfMemoryError 情况的区域 ### 2. 虚拟机栈(线程私有) 每个 Java 方法在执行的同时会创建一个栈帧用于存储局部变量表、操作数栈、常量池引用等信息,从调用直至执行完成的过程,就对应着一个栈帧在 Java 虚拟机栈中入栈和出栈的过程。
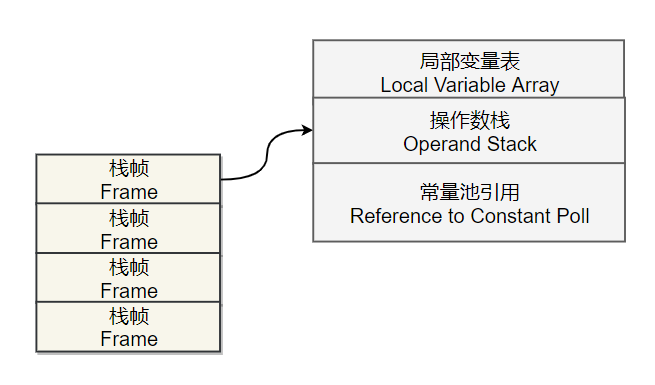
* 补充:栈帧中还存在动态链接、出口(返回地址)等。 可以通过 -Xss 这个虚拟机参数来指定一个程序的 Java 虚拟机栈内存大小: ``` java -Xss=512M HackTheJava ``` 该区域可能抛出以下异常: - 当线程请求的栈深度超过最大值,会抛出 StackOverflowError 异常; - 栈进行动态扩展时如果无法申请到足够内存,会抛出 OutOfMemoryError 异常。 栈帧详解:[虚拟机中的运行时栈帧 - kosamino - 博客园](https://www.cnblogs.com/jing99/p/6076102.html) ### 3. 本地方法栈(线程私有) 本地方法一般是用其它语言(C、C++ 或汇编语言等)编写的,并且被编译为基于本机硬件和操作系统的程序,对待这些方法需要特别处理。 本地方法栈与 Java 虚拟机栈类似,它们之间的区别只不过是本地方法栈为本地方法服务。
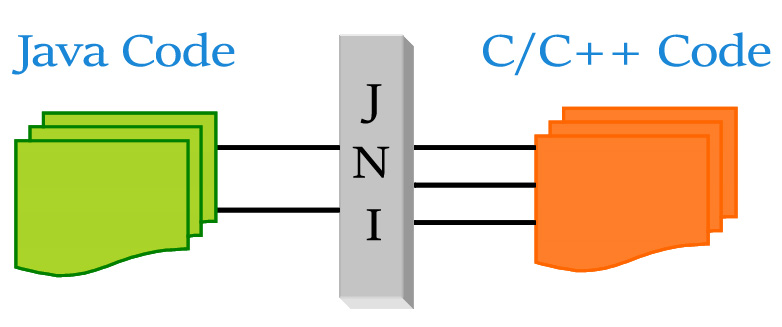
### 4. 堆 所有对象实例都在这里分配内存。 是垃圾收集的主要区域("GC 堆")。现代的垃圾收集器基本都是采用分代收集算法(因为对象的生命周期不一样),主要思想是针对不同的对象采取不同的垃圾回收算法。虚拟机把 Java 堆分成以下三块: #### 新生代 (Young Generation) - 在方法中去 new 一个对象,那这方法调用完毕后,对象就会被回收,这就是一个典型的新生代对象。 #### 老年代 (Old Generation) - 在新生代中经历了 N 次垃圾回收后仍然存活的对象就会被放到老年代中。而且大对象直接进入老年代 - 当 Survivor 空间不够用时,需要依赖于老年代进行分配担保,所以大对象直接进入老年代 #### 永久代 (Permanent Generation) - 即方法区。 当一个对象被创建时,它首先进入新生代,之后有可能被转移到老年代中。 新生代存放着大量的生命很短的对象,因此新生代在三个区域中垃圾回收的频率最高。为了更高效地进行垃圾回收,把新生代继续划分成以下三个空间: - Eden(伊甸园) - From Survivor(幸存者) - To Survivor
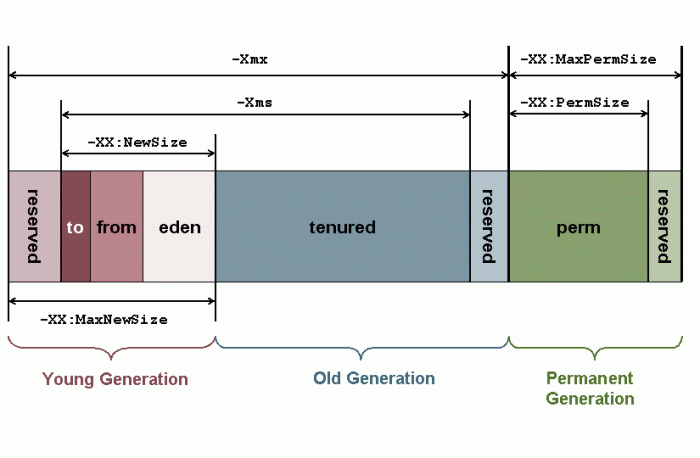
Java 堆不需要连续内存,并且可以动态增加其内存,增加失败会抛出 OutOfMemoryError 异常。 可以通过 -Xms 和 -Xmx 两个虚拟机参数来指定一个程序的 Java 堆内存大小,第一个参数设置初始值,第二个参数设置最大值。 ```java java -Xms=1M -Xmx=2M HackTheJava ``` - 思考:为什么是 8:1:1 ### 5. 方法区 用于存放已被加载的类信息(包含:类版本、字段、方法、接口)、常量 (final)、静态变量 (static)、即时编译器 (JIT) 编译后的代码等数据。因为都是共享的数据,所有要放在方法区。 和 Java 堆一样不需要连续的内存,并且可以动态扩展,动态扩展失败一样会抛出 OutOfMemoryError 异常。 对这块区域进行垃圾回收的主要目标是对常量池的回收和对类的卸载,但是一般比较难实现。 JDK 1.7 之前,HotSpot 虚拟机把它当成永久代来进行垃圾回收,JDK 1.8 之后,取消了永久代,用 metaspace(元数据)区替代。 ### 6. 运行时常量池 运行时常量池是方法区的一部分。 Class 文件中的常量池(编译器生成的各种字面量和符号引用)会在类加载后被放入这个区域。 除了在编译期生成的常量,还允许动态生成,例如 String 类的 intern()。 ```java 在TLAB空间中存在 // 字节码常量 String s1 = "123"; String s2 = "123"; System.out.println(s1 == s1); // true ``` ### 7. 直接内存 在 JDK 1.4 中新加入了 NIO 类,它可以使用 Native 函数库直接分配堆外内存,然后通过一个存储在 Java 堆里的 DirectByteBuffer 对象作为这块内存的引用进行操作。这样能在一些场景中显著提高性能,因为避免了在 Java 堆和 Native 堆中来回复制数据。
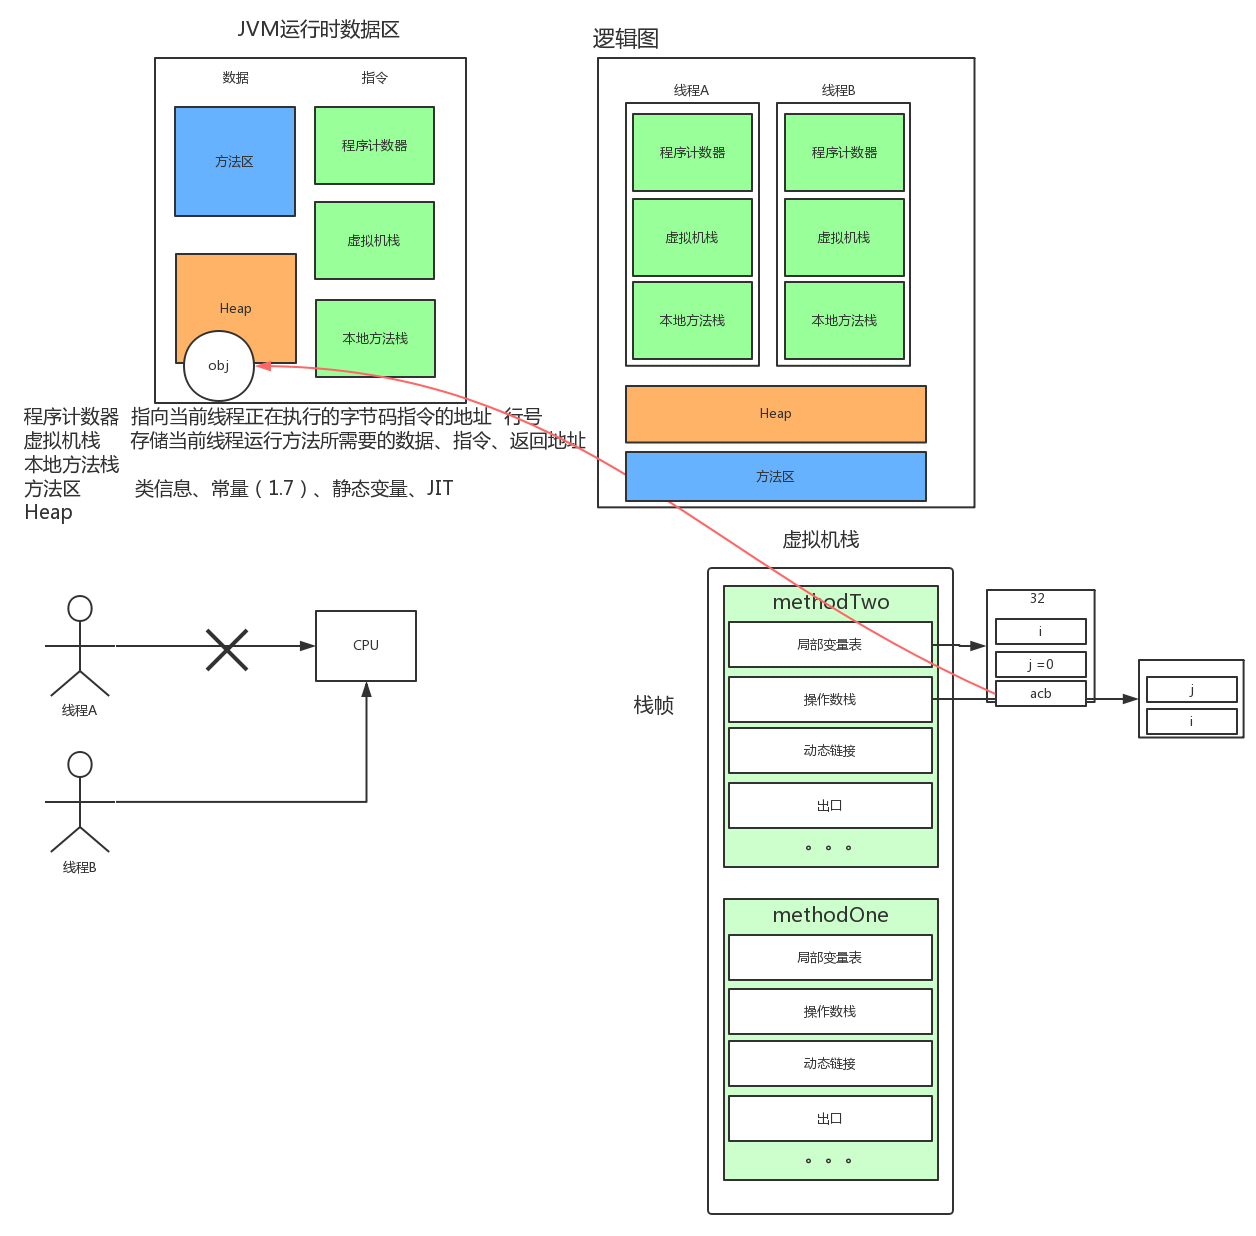
## 2. 判断一个对象是否可被回收 **程序计数器、虚拟机栈和本地方法栈**这三个区域属于线程私有的,只存在于线程的生命周期内,线程结束之后也会消失,因此不需要对这三个区域进行垃圾回收。垃圾回收主要是针对 **Java 堆和方法区**进行。 ### 1. 引用计数算法 **描述**:给对象中添加一个引用计数器每当有一个地方引用它时,计数器就加1;当引用失效时,计数器值就减1;任何时刻计数器为0的对象就是不可能在被使用的。 **缺陷**:很难解决对象间相互循环引用的问题 ### 2. 可达性分析算法 通过 GC Roots 作为起始点进行搜索,能够到达到的对象都是存活的,不可达的对象可被回收。
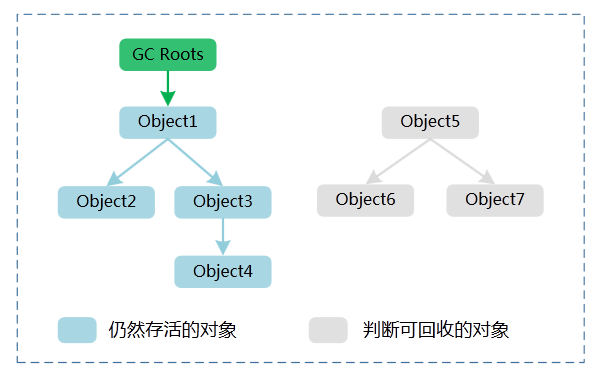
#### ★ GC用的引用可达性分析算法中,哪些对象可作为GC Roots对象? - 虚拟机栈(栈帧中的本地变量表)中引用的对象。 - 方法区中静态属性引用的对象。 - 方法区中常量引用的对象。 - 本地方法栈中 JNI (即一般说的 Native 方法)引用的对象。 ### 3. 引用类型 无论是通过引用计算算法判断对象的引用数量,还是通过可达性分析算法判断对象是否可达,判定对象是否可被回收都与引用有关。 在 JDK 1.2 之后,Java 对引用的概念进行了扩充,将引用分为 强引用(Strong Reference)、软引用(Soft Reference)、弱引用(Weak Reference)、虚引用(Phantom Reference)4种,这4种引用强度依次逐渐减弱。 #### 1. 强引用(Strong Reference) 被强引用关联的对象不会被回收。 使用 new 一个新对象的方式来创建强引用。 ```java Object obj = new Object(); ``` #### 2. 软引用(Soft Reference) 被软引用关联的对象只有在内存不够的情况下才会被回收。 使用 SoftReference 类来创建软引用。 ```java Object obj = new Object(); SoftReference sf = new SoftReference(obj); obj = null; // 使对象只被软引用关联 ``` #### 3. 弱引用(Weak Reference) 被弱引用关联的对象一定会被回收,也就是说它只能存活到下一次垃圾回收发生之前。 使用 WeakReference 类来实现弱引用。 ```java Object obj = new Object(); WeakReference wf = new WeakReference(obj); obj = null; ``` #### 4. 虚引用(Phantom Reference) 又称为幽灵引用或者幻影引用。一个对象是否有虚引用的存在,完全不会对其生存时间构成影响,也无法通过虚引用取得一个对象。 为一个对象设置虚引用关联的唯一目的就是能在这个对象被回收时收到一个系统通知。 使用 PhantomReference 来实现虚引用。 ```java Object obj = new Object(); PhantomReference pf = new PhantomReference(obj); obj = null; ``` ### 4. 方法区的回收 Java虚拟机规范中确实说过可以**不要求虚拟机在方法区实现垃圾收集**,而且在方法区中进行垃圾收集的 “性价比” 一般比较低:在堆中,尤其在新生代中,常规的应用一次垃圾收集一般可以回收 70% ~ 95%的空间,而永久代的垃圾收集效率远低于此。 永久代的垃圾收集主要回收两部分:**废弃常量** 和 **无用的类**。 - 回收废弃常量与回收 Java 堆中的对象非常类似。 - 要判定一个类是否是 “无用的类” 的条件相对苛刻许多。类需要同时满足下面3个条件才能算 “无用的类” - 该类的所有实例都已经被回收。 - 加载该类的 `ClassLoader` 已经被回收。 - 该类对应的 `java.lang.Class` 对象没有在任何地方被引用,无法在任何地方通过反射访问该类的方法。 在大量使用反射、动态代理、GGLib 等 ByteCode 框架、动态生成 Jsp 以及 OSGI 这类频繁自定义 ClassLoader 的场景都需要虚拟机具备类卸载的功能,以保证永久代不会溢出。 ### 5. finalize() finalize() 类似 C++ 的析构函数,用来做关闭外部资源等工作。但是 try-finally 等方式可以做的更好,并且该方法运行代价高昂,不确定性大,无法保证各个对象的调用顺序,因此最好不要使用。 当一个对象可被回收时,如果需要执行该对象的 finalize() 方法,那么就有可能通过在该方法中让对象重新被引用,从而实现自救。自救只能进行一次,如果回收的对象之前调用了 finalize() 方法自救,后面回收时不会调用 finalize() 方法。 ## 3. 垃圾收集算法(垃圾处理方法) ### 1. 标记 - 清除

首先标记出所有需要回收的对象,在标记完成后统一回收所有标记的对象。 **不足:** - **效率问题**:标记和清除的效率都不高 - **空间问题**:标记清除之后会产生大量不连续的内存碎片,导致以后需要分配较大对象时,无法找到足够的连续内存而不得不提前触发另外一次垃圾收集。 ### 2. 标记 - 整理

标记过程仍然与"标记-清除"算法一样,但后续步骤不是直接对可回收对象进行清理,而是让所有存活的对象都向一端移动,然后直接清除掉端边界以外的内存。 ### 3. 复制回收

将内存划分为大小相等的两块,每次只使用其中一块,当这一块内存用完了就将还存活的对象复制到另一块上面,然后再把使用过的内存空间进行一次清理。 主要不足是只使用了内存的一半。 现在的商业虚拟机都**采用这种收集算法来回收新生代**,但是并不是将新生代划分为大小相等的两块,而是分为一块较大的 Eden 空间和两块较小的 Survivor 空间,每次使用 Eden 空间和其中一块 Survivor。在回收时,将 Eden 和 Survivor 中还存活着的对象一次性复制到另一块 Survivor 空间上,最后清理 Eden 和使用过的那一块 Survivor。 HotSpot 虚拟机的 Eden 和 Survivor 的大小比例默认为 8:1,保证了内存的利用率达到 90%。如果每次回收有多于 10% 的对象存活,那么一块 Survivor 空间就不够用了,此时需要依赖于老年代进行分配担保,也就是借用老年代的空间存储放不下的对象。 ### ★ 分代收集 现在的商业虚拟机采用分代收集算法,它根据对象存活周期将内存划分为几块,不同块采用适当的收集算法。 一般将堆分为新生代和老年代。 - 新生代使用:**复制回收** 算法 - 老年代使用:**标记 - 清除** 或者 **标记 - 整理** 算法 ## 4. 垃圾收集器

以上是 HotSpot 虚拟机中的 7 个垃圾收集器,连线表示垃圾收集器可以配合使用。 - 单线程与多线程:单线程指的是垃圾收集器只使用一个线程进行收集,而多线程使用多个线程; - 串行与并行:串行指的是垃圾收集器与用户程序交替执行,这意味着在执行垃圾收集的时候需要停顿用户程序;并形指的是垃圾收集器和用户程序同时执行。除了 CMS 和 G1 之外,其它垃圾收集器都是以串行的方式执行。 ### 1. Serial ![](assets/serial.png) Serial 翻译为串行,也就是说它以串行的方式执行。 它是单线程的收集器,只会使用一个线程进行垃圾收集工作。 它的优点是简单高效,对于单个 CPU 环境来说,由于没有线程交互的开销,因此拥有最高的单线程收集效率。 它是 Client 模式下的默认新生代收集器,因为在用户的桌面应用场景下,分配给虚拟机管理的内存一般来说不会很大。Serial 收集器收集几十兆甚至一两百兆的新生代停顿时间可以控制在一百多毫秒以内,只要不是太频繁,这点停顿是可以接受的。 ### 2. ParNew ![](assets/parNew.png) 它是 Serial 收集器的多线程版本。 是 Server 模式下的虚拟机首选新生代收集器,除了性能原因外,主要是因为除了 Serial 收集器,只有它能与 CMS 收集器配合工作。 在JDK1.5 时期,HotSpot 推出了 CMS 收集器(Concurrent Mark Sweep),它是 HotSpot 虚拟机中第一款真正意义上的**并发收集器**。不幸的是,CMS 作为老年代的收集器,却无法与 JDK1.4.0 中已经存在的新生代收集器 Parallel Scavenge 配合工作,**所以在 JDK1.5中使用 CMS 来收集老年代的时候,新生代只能选择 ParNew 或者 Serial 收集器中的一个**。 默认开启的线程数量与 CPU 数量相同,可以使用 -XX:ParallelGCThreads 参数来设置线程数。 > *Parallel Scavenge 收集器以及后面提到的 G1 收集器都没有使用传统的 GC 收集器代码框架,而另外独立实现,其余集中收集器则共用了部分的框架代码。* ### 3. Parallel Scavenge ![](assets/parallel-scavenge.png) Parallel Scavenge 收集器是一个新生代收集器,它也是使用复制算法的收集器,又是并行的多线程收集器。 **与 ParNew 的不同之处:** 其它收集器关注点是尽可能缩短垃圾收集时用户线程的停顿时间(响应时间),而它的目标是达到一个可控制的吞吐量,它被称为 **吞吐量优先收集器**。 > 吞吐量指 CPU 用于运行用户代码的时间占总时间的比值 > > 吞吐量 = 运行用户代码时间 / (运行用户代码时间 + 垃圾收集时间) 停顿时间越短就越适合需要与用户交互的程序,良好的响应速度能提升用户体验。而高吞吐量则可以高效率地利用 CPU 时间,尽快完成程序的运算任务,主要适合在后台运算而不需要太多交互的任务。 缩短停顿时间是以牺牲吞吐量和新生代空间来换取的:新生代空间变小,垃圾回收变得频繁,导致吞吐量下降。 可以通过一个开关参数打卡 GC 自适应的调节策略(GC Ergonomics),就不需要手工指定新生代的大小(-Xmn)、Eden 和 Survivor 区的比例、晋升老年代对象年龄等细节参数了。虚拟机会根据当前系统运行情况收集性能监控信息,动态调整这些参数,以提供最合适的停顿时间或最大的吞吐量,这种调节方式称为**GC自适应的调节策略(GC Ergonomiscs)** 。 Parallel Scavenge 收集器气提供了两个参数用于**精确控制吞吐量** - **最大垃圾收集停顿时间:** -XX:MaxGCPauseMills - **吞吐量大小:**-XX:GCTimeRatio **MaxGCPauseMills** 参数允许的值是一个大于0的毫秒数,收集器将尽可能地保证内存回收所花费的时间不超过设定值。但 GC 的停顿时间缩短是以牺牲吞吐量和新生代空间来换取的。停顿时间下降,但吞吐量也降下来了。 **GCTimeRatio** 参数的值是一个大于0且小于100的整数,也就是垃圾收集时间占总时间的比例,相当于吞吐量的倒数。区间 1/(1+99) ~ 1/(1+1),即 1% ~ 50%。 由于与吞吐量关系密切,Parallel Scavenge 收集器也经常称为 “吞吐量优先“ 收集器。 **-XX:+UserAdaptiveSizePolicy**: GC 自适应调节策略(GC Ergonomics),打开参数后,就不需要手工指定新生代的大小(-Xmn)、Eden 与 Survivor 区的比例(-XX:SurvivorRatio)、晋升老年代对象的年龄(-XX:PretenureSizeThreshold)等细节参数了。 ### 4. Serial Old ![](assets/serial-old.png) Serial Old 是 Serial 收集器的老年代版本,它同样是一个单线程收集器,使用 ”标记-整理“ 算法。 这个收集器的主要意义也是在于给 Client 模式下的虚拟机使用。如果在 Server 模式下,那么它主要还有两大用途: - 在 JDK 1.5 以及之前版本(Parallel Old 诞生以前)中与 Parallel Scavenge 收集器搭配使用。 - 作为 CMS 收集器的后备预案,在并发收集发生 Concurrent Mode Failure 时使用。 ### 5. Parallel Old ![](assets/parallel-old.png) Parallel Old 是 Parallel Scavenge 收集器的老年代版本,使用多线程和 ”标记-整理“ 算法。 在注重吞吐量以及 CPU 资源敏感的场合,都可以优先考虑 Parallel Scavenge 加 Parallel Old 收集器。 ### 6. CMS ![](assets/cms.png) CMS(Concurrent Mark Sweep),Mark Sweep 指的是 **标记 - 清除** 算法。CMS 是一款优秀的收集器,主要优点:并发收集、低停顿,Sun公司也称之为**并发低停顿收集器**(Concurrent Low Pause Collection)。 特点:并发收集、低停顿。 分为以下四个流程: - 初始标记:仅仅只是标记一下 GC Roots 能直接关联到的对象,速度很快,需要停顿。 - **并发标记**:进行 GC Roots Tracing 的过程,它在整个回收过程中耗时最长,不需要停顿。 - 重新标记:为了修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分对象的标记记录,需要停顿。 - **并发清除**:不需要停顿。 在整个过程中耗时最长的**并发标记**和**并发清除**过程中,收集器线程都可以与用户线程一起工作,不需要进行停顿。 具有以下缺点: - 吞吐量低:低停顿时间是以牺牲吞吐量为代价的,导致 CPU 利用率不够高。 - 无法处理浮动垃圾,可能出现 Concurrent Mode Failure。浮动垃圾是指并发清除阶段由于用户线程继续运行而产生的垃圾,这部分垃圾只能到下一次 GC 时才能进行回收。由于浮动垃圾的存在,因此需要预留出一部分内存,意味着 CMS 收集不能像其它收集器那样等待老年代快满的时候再回收。如果预留的内存不够存放浮动垃圾,就会出现 Concurrent Mode Failure,这时虚拟机将临时启用 Serial Old 来替代 CMS。 - 标记 - 清除算法导致的空间碎片,往往出现老年代空间剩余,但无法找到足够大连续空间来分配当前对象,不得不提前触发一次 Full GC。 - CMS 提供了一个开关参数 **-XX:+UseCMSCompactAtFullCollection**(默认开启),用于在 CMS 收集器顶不住要进行 Full GC 时开启内存碎片的合并整理过程,内存整理的过程是无法并发的。 - 参数 **-XX:CMSFullGCsBeforeCompaction** 用于设置执行多少次不压缩的 Full GC后,跟着来以此带压缩的,(默认值为0) ### 7. G1 G1的第一篇paper(附录1)发表于 2004 年,在 2012 年才在 jdk1.7u4 中可用。oracle 官方计划在 jdk9 中将 G1 变成默认的垃圾收集器,以替代 CMS。 - 为何 oracle 要极力推荐 G1 呢,G1 有哪些优点? - 首先,G1的设计原则就是简单可行的性能调优 - 其次,G1将新生代,老年代的物理空间划分取消了**。** G1(Garbage-First),它是一款面向服务端应用的垃圾收集器,在多 CPU 和大内存的场景下有很好的性能。HotSpot 开发团队赋予它的使命是未来可以替换掉 CMS 收集器。 堆被分为新生代和老年代,其它收集器进行收集的范围都是整个新生代或者老年代,而 G1 可以直接对新生代和老年代一起回收。

G1 把堆划分成多个大小相等的独立区域(Region),新生代和老年代不再物理隔离。

通过引入 Region 的概念,从而将原来的一整块内存空间划分成多个的小空间,使得每个小空间可以单独进行垃圾回收。这种划分方法带来了很大的灵活性,使得可预测的停顿时间模型成为可能。通过记录每个 Region 垃圾回收时间以及回收所获得的空间(这两个值是通过过去回收的经验获得),并维护一个优先列表,每次根据允许的收集时间,优先回收价值最大的 Region。 每个 Region 都有一个 Remembered Set,用来记录该 Region 对象的引用对象所在的 Region。通过使用 Remembered Set,在做可达性分析的时候就可以避免全堆扫描。

如果不计算维护 Remembered Set 的操作,G1 收集器的运作大致可划分为以下几个步骤: - 初始标记 - 并发标记 - 最终标记:为了修正在并发标记期间因用户程序继续运作而导致标记产生变动的那一部分标记记录,虚拟机将这段时间对象变化记录在线程的 Remembered Set Logs 里面,最终标记阶段需要把 Remembered Set Logs 的数据合并到 Remembered Set 中。这阶段需要停顿线程,但是可并行执行。 - 筛选回收:首先对各个 Region 中的回收价值和成本进行排序,根据用户所期望的 GC 停顿时间来制定回收计划。此阶段其实也可以做到与用户程序一起并发执行,但是因为只回收一部分 Region,时间是用户可控制的,而且停顿用户线程将大幅度提高收集效率。 具备如下特点: - 空间整合:整体来看是基于“标记 - 整理”算法实现的收集器,从局部(两个 Region 之间)上来看是基于“复制”算法实现的,这意味着运行期间不会产生内存空间碎片。 - 可预测的停顿:能让使用者明确指定在一个长度为 M 毫秒的时间片段内,消耗在 GC 上的时间不得超过 N 毫秒。 详情请参考: - [【必读】深入理解 Java G1 垃圾收集器 - 文章 - 伯乐在线](http://blog.jobbole.com/109170/) - [Java Hotspot G1 GC的一些关键技术 - 美团技术](https://tech.meituan.com/g1.html) ### 8. 比较 | 收集器 | 单线程/并行 | 串行/并发 | 新生代/老年代 | 收集算法 | 目标 | 适用场景 | | --------------------- | ----------- | --------- | --------------- | -------------------- | ------------ | --------------------------------------------- | | **Serial** | 单线程 | 串行 | 新生代 | 复制 | 响应速度优先 | 单 CPU 环境下的 Client 模式 | | **ParNew** | 并行 | 串行 | 新生代 | 复制算法 | 响应速度优先 | 多 CPU 环境时在 Server 模式下与 CMS 配合 | | **Parallel Scavenge** | 并行 | 串行 | 新生代 | 复制算法 | 吞吐量优先 | 在后台运算而不需要太多交互的任务 | | **Serial Old** | 单线程 | 串行 | 老年代 | 标记-整理 | 响应速度优先 | 单 CPU 环境下的 Client 模式、CMS 的后备预案 | | **Parallel Old** | 并行 | 串行 | 老年代 | 标记-整理 | 吞吐量优先 | 在后台运算而不需要太多交互的任务 | | **CMS** | 并行 | 并发 | 老年代 | 标记-清除 | 响应速度优先 | 集中在互联网站或 B/S 系统服务端上的 Java 应用 | | **G1** | 并行 | 并发 | 新生代 + 老年代 | 标记-整理 + 复制算法 | 响应速度优先 | 面向服务端应用,将来替换 CMS | 参考:[Java GC | Pandora](https://hellojz.me/2017/10/10/jvm/gc/) ## 5. 内存分配与回收策略 ### 1. 什么时候进行Minor GC,Full GC - Minor GC:发生在新生代上,因为新生代对象存活时间很短,因此 Minor GC 会频繁执行,执行的速度一般也会比较快。 - 新生代中的垃圾收集动作,采用的是复制算法 - 对于较大的对象,在 Minor GC 的时候可以直接进入老年代 - Full GC:发生在老年代上,老年代对象其存活时间长,因此 Full GC 很少执行,执行速度会比 Minor GC 慢很多。 - Full GC 是发生在老年代的垃圾收集动作,采用的是 标记-清除/整理 算法。 - 由于老年代的对象几乎都是在 Survivor 区熬过来的,不会那么容易死掉。因此 Full GC 发生的次数不会有 Minor GC 那么频繁,并且 Time(Full GC)>Time(Minor GC) ### 2. 内存分配策略 #### 1. 对象优先在 Eden 分配 大多数情况下,对象在新生代 Eden 区分配,当 Eden 区空间不够时,发起 Minor GC。 #### 2. 大对象直接进入老年代 大对象是指需要连续内存空间的对象,最典型的大对象是那种很长的字符串以及数组。 经常出现大对象会提前触发垃圾收集以获取足够的连续空间分配给大对象。 -XX:PretenureSizeThreshold,大于此值的对象直接在老年代分配,避免在 Eden 区和 Survivor 区之间的大量内存复制。 #### 3. 长期存活的对象进入老年代 为对象定义年龄计数器,对象在 Eden 出生并经过 Minor GC 依然存活,将移动到 Survivor 中,年龄就增加 1 岁,增加到一定年龄则移动到老年代中。 -XX:MaxTenuringThreshold 用来定义年龄的阈值。 #### 4. 动态对象年龄判定 虚拟机并不是永远地要求对象的年龄必须达到 MaxTenuringThreshold 才能晋升老年代,如果在 Survivor 中相同年龄所有对象大小的总和大于 Survivor 空间的一半,则年龄大于或等于该年龄的对象可以直接进入老年代,无需等到 MaxTenuringThreshold 中要求的年龄。 #### 5. 空间分配担保 在发生 Minor GC 之前,虚拟机先检查老年代最大可用的连续空间是否大于新生代所有对象总空间,如果条件成立的话,那么 Minor GC 可以确认是安全的。 如果不成立的话虚拟机会查看 HandlePromotionFailure 设置值是否允许担保失败,如果允许那么就会继续检查老年代最大可用的连续空间是否大于历次晋升到老年代对象的平均大小,如果大于,将尝试着进行一次 Minor GC;如果小于,或者 HandlePromotionFailure 设置不允许冒险,那么就要进行一次 Full GC。 ### 3. Full GC 的触发条件 对于 Minor GC,其触发条件非常简单,当 Eden 空间满时,就将触发一次 Minor GC。而 Full GC 则相对复杂,有以下条件: #### 1. 调用 System.gc() 只是建议虚拟机执行 Full GC,但是虚拟机不一定真正去执行。不建议使用这种方式,而是让虚拟机管理内存。 #### 2. 老年代空间不足 老年代空间不足的常见场景为前文所讲的大对象直接进入老年代、长期存活的对象进入老年代等。 为了避免以上原因引起的 Full GC,应当尽量不要创建过大的对象以及数组。除此之外,可以通过 -Xmn 虚拟机参数调大新生代的大小,让对象尽量在新生代被回收掉,不进入老年代。还可以通过 -XX:MaxTenuringThreshold 调大对象进入老年代的年龄,让对象在新生代多存活一段时间。 #### 3. 空间分配担保失败 使用复制算法的 Minor GC 需要老年代的内存空间作担保,如果担保失败会执行一次 Full GC。具体内容请参考上面的第五小节。 #### 4. JDK 1.7 及以前的永久代空间不足 在 JDK 1.7 及以前,HotSpot 虚拟机中的方法区是用永久代实现的,永久代中存放的为一些 Class 的信息、常量、静态变量等数据。 当系统中要加载的类、反射的类和调用的方法较多时,永久代可能会被占满,在未配置为采用 CMS GC 的情况下也会执行 Full GC。如果经过 Full GC 仍然回收不了,那么虚拟机会抛出 java.lang.OutOfMemoryError。 为避免以上原因引起的 Full GC,可采用的方法为增大永久代空间或转为使用 CMS GC。 #### 5. Concurrent Mode Failure 执行 CMS GC 的过程中同时有对象要放入老年代,而此时老年代空间不足(可能是 GC 过程中浮动垃圾过多导致暂时性的空间不足),便会报 Concurrent Mode Failure 错误,并触发 Full GC。 ## 6. 类加载机制 > 58同城面试,这里好好的再把类加载机制深入一下吧 虚拟机把描述类的数据从 Class 文件加载到内存,并对数据进行校验、转换解析和初始化,最终形成可以被虚拟机直接使用的 Java 类型,这就是虚拟机类加载机制。(类是在运行期间动态加载的) 懒加载:要用的时候再去加载 ### 类的生命周期

包括以下 7 个阶段: - **加载(Loading)** - **验证(Verification)** - **准备(Preparation)** - **解析(Resolution)** - **初始化(Initialization)** - 使用(Using) - 卸载(Unloading) 其中解析过程在某些情况下可以在初始化阶段之后再开始,这是为了支持 Java 的动态绑定。 这 7 个阶段中的:加载、验证、准备、初始化、卸载的顺序是固定的。但它们并不一定是严格同步串行执行,它们之间可能会有交叉,但总是以 “开始” 的顺序总是按部就班的。至于解析则有可能在初始化之后才开始,这是为了支持 Java 语言的运行时绑定(也称为动态绑定或晚期绑定)。 ### 类初始化时机 #### 1. 主动引用 虚拟机规范中并没有强制约束何时进行加载,但是规范严格规定了有且只有下列五种情况必须对类进行初始化(加载、验证、准备都会随之发生): - 遇到 new、getstatic、putstatic、invokestatic 这四条字节码指令时,如果类没有进行过初始化,则必须先触发其初始化。最常见的生成这 4 条指令的场景是:使用 new 关键字实例化对象的时候;读取或设置一个类的静态字段(被 final 修饰、已在编译期把结果放入常量池的静态字段除外)的时候;以及调用一个类的静态方法的时候。 - 使用 java.lang.reflect 包的方法对类进行反射调用的时候,如果类没有进行初始化,则需要先触发其初始化。 - 当初始化一个类的时候,如果发现其父类还没有进行过初始化,则需要先触发其父类的初始化。 - 当虚拟机启动时,用户需要指定一个要执行的主类(包含 main() 方法的那个类),虚拟机会先初始化这个主类; - 当使用 JDK 1.7 的动态语言支持时,如果一个 java.lang.invoke.MethodHandle 实例最后的解析结果为 REF_getStatic, REF_putStatic, REF_invokeStatic 的方法句柄,并且这个方法句柄所对应的类没有进行过初始化,则需要先触发其初始化; #### 2. 被动引用 以上 5 种场景中的行为称为对一个类进行主动引用。除此之外,所有引用类的方式都不会触发初始化,称为被动引用。被动引用的常见例子包括: - 通过子类引用父类的静态字段,不会导致子类初始化。 ```java System.out.println(SubClass.value); // value 字段在 SuperClass 中定义 ``` - 通过数组定义来引用类,不会触发此类的初始化。该过程会对数组类进行初始化,数组类是一个由虚拟机自动生成的、直接继承自 Object 的子类,其中包含了数组的属性和方法。 ```java SuperClass[] sca = new SuperClass[10]; ``` - 常量在编译阶段会存入调用类的常量池中,本质上并没有直接引用到定义常量的类,因此不会触发定义常量的类的初始化。 ```java System.out.println(ConstClass.HELLOWORLD); ``` ### 类加载过程 包含了加载、验证、准备、解析和初始化这 5 个阶段。 #### 1. 加载 加载是类加载的一个阶段,注意不要混淆。 加载过程完成以下三件事: - 通过一个类的全限定名来获取定义此类的二进制字节流 - 将这个字节流所代表的静态存储结构转化为方法区的运行时存储结构 - 在内存中生成一个代表这个类的 Class 对象,作为方法区这个类的各种数据的访问入口 加载源(其中二进制字节流可以从以下方式中获取): - **文件**:从 ZIP 包读取,这很常见,最终成为日后 JAR、EAR、WAR 格式的基础。 - **网络**:从网络中获取,这种场景最典型的应用是 Applet。 - **计算生成一个二进制流**:运行时计算生成,这种场景使用得最多得就是动态代理技术,在 java.lang.reflect.Proxy 中,就是用了 ProxyGenerator.generateProxyClass 的代理类的二进制字节流。 - **由其他文件生成**:由其他文件生成,典型场景是 JSP 应用,即由 JSP 文件生成对应的 Class 类。 - **数据库**:从数据库读取,这种场景相对少见,例如有些中间件服务器(如 SAP Netweaver)可以选择把程序安装到数据库中来完成程序代码在集群间的分发。 #### 2. 验证 目的:确保 Class 文件的字节流中包含的信息符合当前虚拟机的要求,并且不会危害虚拟机自身的安全。 - 文件格式验证:验证字节流是否符合 Class 文件格式的规范,并且能被当前版本的虚拟机处理。 - 是否以 0xCAFEBABE 开头,前四个字节为魔数 - 版本号是否合理,如:JDK1.8(52.0)、JDK1.7(51.0) - 元数据验证:对字节码描述的信息进行语义分析,以保证其描述的信息符合 Java 语言规范的要求。 - 是否有父类-继 - 继承了 final 类? - 非抽象类实现了所有的抽象方法 - 字节码验证(很复杂):通过数据流和控制流分析,确保程序语义是合法、符合逻辑的。 - 运行检查 - 栈数据类型和操作码数据参数吻合 - 跳转指令指定到合理的位置 - 符号引用验证:发生在虚拟机将符号引用转换为直接引用的时候,对类自身以外(常量池中的各种符号引用)的信息进行匹配性校验。 - 常量池中描述类是否存在 - 访问的方法或字段是否存在且有足够的权限 #### 3. 准备 准备阶段正式为类变量分配内存并设置变量的初始值。这些变量使用的内存都将在方法区中进行分配。类变量是被 static 修饰的变量,准备阶段为类变量分配内存并设置初始值,使用的是方法区的内存。 实例变量不会在这阶段分配内存,它将会在对象实例化时随着对象一起分配在堆中。注意,实例化不是类加载的一个过程,类加载发生在所有实例化操作之前,并且类加载只进行一次,实例化可以进行多次。 初始值一般为 0 值,例如下面的类变量 value 被初始化为 0 而不是 123,在初始化的 \ 中才会被设置为1。 - 默认值:int 0, boolean false, float 0.0, char '0', 抽象数据类型 null ```java public static int value = 123; ``` - 对于 static final 类型,在准备阶段就会被赋上正确的值 ```java public static final int value = 123; ``` #### 4. 解析 解析阶段是虚拟机将常量池的**符号引用替换为直接引用**的过程 - 类或接口的解析 - 字段解析 - 类方法解析 - 接口方法解析 **什么是符号引用和直接引用?** - **符号引用**:符号引用是一组符号来描述所引用的目标对象,符号可以是任何形式的字面量,只要使用时能无歧义地定位到目标即可。符号引用与虚拟机实现的内存布局无关,引用的目标对象并不一定已经加载到内存中。 - **直接引用**:直接引用可以是直接指向目标对象的指针、相对偏移量或是一个能间接定位到目标的句柄。直接引用是与虚拟机内存布局实现相关的,同一个符号引用在不同虚拟机实例上翻译出来的直接引用一般不会相同,如果有了直接引用,那引用的目标必定已经在内存中存在。 符号引用就是字符串,这个字符串包含足够的信息,以供实际使用时可以找到相应的位置。你比如说某个方法的符号引用,如:“java/io/PrintStream.println:(Ljava/lang/String;)V”。里面有类的信息,方法名,方法参数等信息。 当第一次运行时,要根据字符串的内容,到该类的方法表中搜索这个方法。运行一次之后,符号引用会被替换为直接引用,下次就不用搜索了。直接引用就是偏移量,通过偏移量虚拟机可以直接在该类的内存区域中找到方法字节码的起始位置。 参考资料: - [【必读】JVM 类加载机制 - 掘金](https://juejin.im/post/5a1d644551882534af25b381) #### 5. 初始化 初始化阶段才真正开始执行类中定义的 Java 程序代码。初始化阶段即虚拟机执行类构造器 \() 方法的过程。 在准备阶段,类变量已经赋过一次系统要求的初始值,而在初始化阶段,根据程序员通过程序制定的主观计划去初始化类变量和其它资源。 \() 方法具有以下特点: - 是由编译器自动收集类中所有类变量的赋值动作和静态语句块中的语句合并产生的,编译器收集的顺序由语句在源文件中出现的顺序决定。特别注意的是,静态语句块只能访问到定义在它之前的类变量,定义在它之后的类变量只能赋值,不能访问。例如以下代码: ```java public class Test { static { i = 0; // 给变量赋值可以正常编译通过 System.out.print(i); // 这句编译器会提示“非法向前引用” } static int i = 1; } ``` - 与类的构造函数(或者说实例构造器 \())不同,不需要显式的调用父类的构造器。虚拟机会自动保证在子类的 \() 方法运行之前,父类的 \() 方法已经执行结束。因此虚拟机中第一个执行 \() 方法的类肯定为 java.lang.Object。 - 由于父类的 \() 方法先执行,也就意味着父类中定义的静态语句块要优先于子类的变量赋值操作。例如以下代码: ```java static class Parent { public static int A = 1; static { A = 2; } } static class Sub extends Parent { public static int B = A; } public static void main(String[] args) { System.out.println(Sub.B); // 2 } ``` - \() 方法对于类或接口不是必须的,如果一个类中不包含静态语句块,也没有对类变量的赋值操作,编译器可以不为该类生成 \() 方法。 - 接口中不可以使用静态语句块,但仍然有类变量初始化的赋值操作,因此接口与类一样都会生成 \() 方法。但接口与类不同的是,执行接口的 \() 方法不需要先执行父接口的 \() 方法。只有当父接口中定义的变量使用时,父接口才会初始化。另外,接口的实现类在初始化时也一样不会执行接口的 \() 方法。 - 虚拟机会保证一个类的 \() 方法在多线程环境下被正确的加锁和同步,如果多个线程同时初始化一个类,只会有一个线程执行这个类的 \() 方法,其它线程都会阻塞等待,直到活动线程执行 \() 方法完毕。如果在一个类的 \() 方法中有耗时的操作,就可能造成多个线程阻塞,在实际过程中此种阻塞很隐蔽。 ### 类加载器 虚拟机设计团队把类加载阶段中的 “通过一个类的全限定名来获取描述此类的二进制字节流(即字节码)” 这个动作放到 Java 虚拟机外部去实现,以便让应用程序自己决定如何去获取所需要的类(通过一个类的全限之名获取描述此类的二进制字节流)。实现这个动作的代码模块称为 **“类加载器”**。 #### 1. 类与类加载器 两个类相等:只有被同一个类加载器加载的类才可能会相等。相同的字节码被不同的类加载器加载的类不相等。 这里的相等,包括类的 Class 对象的 equals() 方法、isAssignableFrom() 方法、isInstance() 方法的返回结果为 true,也包括使用 instanceof 关键字做对象所属关系判定结果为 true。 #### 2. 类加载器分类 从 Java 虚拟机的角度来讲,只存在以下两种不同的类加载器: - **启动类加载器**(Bootstrap ClassLoader),这个类加载器用 C++ 实现,是虚拟机自身的一部分; - **所有其他类的加载器**,这些类由 Java 实现,独立于虚拟机外部,并且全都继承自抽象类 java.lang.ClassLoader。 从 Java 开发人员的角度看,类加载器可以划分得更细致一些: - **启动类加载器**(Bootstrap ClassLoader) - 此类加载器负责将存放在 \lib 目录中的,或者被 -Xbootclasspath 参数所指定的路径中的,并且是虚拟机识别的(仅按照文件名识别,如 rt.jar,名字不符合的类库即使放在 lib 目录中也不会被加载)类库加载到虚拟机内存中。启动类加载器无法被 Java 程序直接引用,用户在编写自定义类加载器时,如果需要把加载请求委派给启动类加载器,直接使用 null 代替即可。 - **扩展类加载器**(Extension ClassLoader) - 这个类加载器是由 ExtClassLoader(sun.misc.Launcher$ExtClassLoader)实现的。它负责将 /lib/ext 或者被 java.ext.dir 系统变量所指定路径中的所有类库加载到内存中,开发者可以直接使用扩展类加载器。 - **应用程序类加载器**(Application ClassLoader) - 这个类加载器是由 AppClassLoader(sun.misc.Launcher$AppClassLoader)实现的。由于这个类加载器是 ClassLoader 中的 getSystemClassLoader() 方法的返回值,因此一般称为系统类加载器。它负责加载用户类路径(ClassPath)上所指定的类库,开发者可以直接使用这个类加载器,如果应用程序中没有自定义过自己的类加载器,一般情况下这个就是程序中默认的类加载器。 - **自定义类加载器** - 载器步骤: - 定义一个类,继承 ClassLoader - 重写 loadClass 方法 - 实例化 Class 对象 - 自定义类加载器的优势 - 类加载器是 Java 语言的一项创新,也是 Java 语言流行的重要原因之一,它最初的设计是为了满足 java applet 的需求而开发出来的 - 高度的灵活性 - 通过自定义类加载器可以实现热部署 - 代码加密 参考资料: - [深入理解Java虚拟机 - JY的博客 | JY Blog](https://jybeyonding.github.io/2018/03/16/%E6%B7%B1%E5%85%A5%E7%90%86%E8%A7%A3Java%E8%99%9A%E6%8B%9F%E6%9C%BA-%E7%AC%AC7%E7%AB%A0-%E8%99%9A%E6%8B%9F%E6%9C%BA%E7%B1%BB%E5%8A%A0%E8%BD%BD%E6%9C%BA%E5%88%B6/) #### 3. 双亲委派模型 - 为什么要使用双亲委派模型? - 主要是为了避免重复加载的问题 JVM 如何加载一个类的过程,双亲委派模型中有哪些方法有没有可能父类加载器和子类加载器,加载同一个类?如果加载同一个类,该使用哪一个类? - **双亲委派机制图**

- **双亲委派概念** - 如果一个类加载器收到了类加载的请求,它首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器去完成,每一个层次的加载器都是如此,因此所有的类加载请求都会传给顶层的启动类加载器,只有当父加载器反馈自己无法完成该加载请求(该加载器的搜索范围中没有找到对应的类)时,子加载器才会尝试自己去加载。 - **加载器** - 启动(Bootstrap)类加载器:是用本地代码实现的类装入器,它负责将 /lib下面的类库加载到内存中(比如rt.jar)。由于引导类加载器涉及到虚拟机本地实现细节,开发者无法直接获取到启动类加载器的引用,所以不允许直接通过引用进行操作。 - 标准扩展(Extension)类加载器:是由 Sun 的 ExtClassLoader(sun.misc.Launcher$ExtClassLoader)实现的。它负责将< Java_Runtime_Home >/lib/ext或者由系统变量 java.ext.dir指定位置中的类库加载到内存中。开发者可以直接使用标准扩展类加载器。 - 系统(System)类加载器:由 Sun 的  AppClassLoader(sun.misc.Launcher$AppClassLoader)实现的。它负责将系统类路径(CLASSPATH)中指定的类库加载到内存中。开发者可以直接使用系统类加载器。除了以上列举的三种类加载器,还有一种比较特殊的类型 — 线程上下文类加载器。 - 如果加载同一个类,该使用哪一个类? - 父类的 ## 7. Student s = new Student(); 在内存中做了哪些事情 1. 加载 Student.class 文件进内存 2. 在栈内存为 s 开辟空间 3. 在堆内存为 Student 对象开辟空间 4. 对 Student 对象的成员变量进行默认初始化 5. 对 Student 对象的成员变量进行显示初始化 6. 通过构造方法对 Student 对象的成员变量赋值 7. Student 对象初始化完毕,把对象地址赋值给 s 变量 ## 8. Java虚拟机工具 JDK 本身提供了很多方便的 JVM 性能调优监控工具,除了 jps、jstat、jinfo、jmap、jhat、jstack 等小巧的工具,还有集成式的 jvisualvm 和 jconsole。 ### (1)jps **jps(JVM Process Status Tool,虚拟机进程监控工具)**,这个命令可以列出正在运行的虚拟机进程,并显示虚拟机执行主类名称,以及这些进程的本地虚拟机唯一 ID。这个 ID 被称为本地虚拟机唯一 ID(local virtual Machine Identifier,简写为LVMID)。如果你在 linux 的一台服务器上使用 jps 得到的 LVMID 其实就是和 ps 命令得到的 PID 是一样的。 **语法格式如下:** ```shell jps [options] [hostid] ``` 如果不指定hostid就默认为当前主机或服务器。 **options参数选项说明如下:** ```shell -q 不输出类名、Jar名和传入main方法的参数 -m 输出传入main方法的参数 -l 输出main类或Jar的全限名 -v 输出传入JVM的参数 ``` **使用(查看所有java进程)** ```shell jps -lv ``` 示例: ```shell [root@chengchi ~]# jps 24804 Jps 1862 mango.jar [root@chengchi ~]# jps -lv 24787 sun.tools.jps.Jps -Dapplication.home=/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.171-8.b10.el7_5.x86_64 -Xms8m 1862 /home/www/api.chengchijinfu.com/mango_server/target/mango.jar -Dserver.port=8080 -Dspring.profiles.active=prod ``` ### (2)jstat **jstat(JVM Statistics Monitoring Tool,虚拟机统计信息监视工具)**,这个命令用于监视虚拟机各种运行状态信息。它可以显示本地或者远程虚拟机进程中的**类装载、内存、垃圾收集、JIT编译等运行数据**,虽然没有GUI图形界面,只是提供了纯文本控制台环境的服务器上,但它是运行期间定位虚拟机性能问题的首选工具。 语法格式如下: ```shell jstat [option vmid [interval [s | ms] [count ] ] ] ``` 例如:需要每 1000 毫秒查询一次进程 16418 垃圾收集状况,一共查询 10 次,那命令如下: ![](assets/tools_stat.png) 参考:[jstat命令详解 - CSDN博客](https://blog.csdn.net/zhaozheng7758/article/details/8623549) ### (3)jinfo **jinfo (Configuration Info for Java,配置信息工具)** 这个命令可以实时地查看和调整虚拟机各项参数。 查看2788的MaxPerm大小可以用 ```shell [root@Bill-8 bin]# jinfo -flag MaxPermSize 2788 -XX:MaxPermSize=134217728 ``` ### (4)jmap **jmap(Memory Map for Java,内存映像工具)**,用于生成堆转存的快照,一般是 heapdump 或者 dump 文件。如果不适用 jmap 命令,可以使用 -XX:+HeapDumpOnOutOfMemoryError 参数,当虚拟机发生内存溢出的时候可以产生快照。或者使用kill -3 pid也可以产生。jmap 的作用并不仅仅是为了获取 dump 文件,它可以查询 finalize 执行队列,java 堆和永久代的详细信息,如空间使用率,当前用的哪种收集器。 **jmap的命令格式:** ```shell jmap [option] vmid ``` ```shell jmap -J-d64 -heap 16418 ``` ### (5)jhat **jhat(虚拟机堆转储快照分析工具)**,这个工具是用来分析 jmap dump 出来的文件。 由于这个工具功能比较简陋,运行起来也比较耗时,所以这个工具不推荐使用,推荐使用MAT。 例如分析dump 出来的 test.bin,命令如下: ```shell jhat test.bin ``` 它会在本地启动一个web服务,端口是7000,这样直接访问 127.0.0.1:7000就能看到分析结果了。 ### (6)jstack > 阿里实习面试 **jstack(Java Stack Trace,Java堆栈跟踪工具)**,这个命令用于查看虚拟机当前时刻的线程快照(一般是threaddump 或者 javacore文件)。线程快照就是当前虚拟机内每一条线程正在执行的方法堆栈的集合。**生成线程快照的主要目的是:**定位线程出现长时间停顿的原因,入线程间死锁、死循环、请求外部资源导致的长时间等待都是导致线程长时间停顿的常见原因。线程出现停顿的时候通过jstack来查看各个线程的调用堆栈,就可以知道没有响应的线程到底在后台做些什么事情。 命令格式: ```shell jstack [option] vmid ``` 使用:查看进程2849 的堆栈信息 ```shell [root@Bill-8 yrd_soft]# jstack 2849 ``` ### (7)jconsole > 阿里面经 JConsole 中,您将能够监视 JVM 内存的使用情况、线程堆栈跟踪、已装入的类和 VM 信息以及 CE MBean。 jconsole:一个 java GUI 监视工具,可以以图表化的形式显示各种数据。并可通过远程连接监视远程的服务器VM。用 Java 写的 GUI 程序,用来监控 VM,并可监控远程的 VM,非常易用,而且功能非常强。命令行里打 jconsole,选则进程就可以了。 ### (8)jvisualvm jvisualvm 同 jconsole 都是一个基于图形化界面的、可以查看本地及远程的 JAVA GUI 监控工具,Jvisualvm 同 jconsole 的使用方式一样,直接在命令行打入 jvisualvm 即可启动,jvisualvm 界面更美观一些,数据更实时: 参考资料: - [JVM性能监控工具](https://www.jianshu.com/p/25e94a1399a0) ## 9. 了解过JVM调优没,基本思路是什么 详情转向:[美团技术:从实际案例聊聊Java应用的GC优化](https://tech.meituan.com/jvm_optimize.html) ## 10. JVM线程死锁,你该如何判断是因为什么?如果用VisualVM,dump线程信息出来,会有哪些信息 - 常常需要在隔两分钟后再次收集一次thread dump,如果得到的输出相同,仍然是大量thread都在等待给同一个地址上锁,那么肯定是死锁了。 ## 11. 什么是内存泄露?用什么工具可以查出内存泄漏 在 Java 中,内存泄漏就是存在一些被分配的对象,这些对象有下面两个特点 - 这些对象是可达的,即在有向图中,存在通路可以与其相连; - 这些对象是无用的,即程序以后不会再使用这些对象。 如果对象满足这两个条件,这些对象就可以判定为 Java 中的内存泄漏,这些对象不会被 GC 所回收,然而它却占用内存。 在 C++ 中,内存泄漏的范围更大一些。有些对象被分配了内存空间,然后却不可达,由于 C++ 中没有 GC,这些内存将永远收不回来。在 Java 中,这些不可达的对象都由 GC 负责回收,因此程序员不需要考虑这部分的内存泄露。 通过分析,我们得知,对于C++,程序员需要自己管理边和顶点,而对于 Java 程序员只需要管理边就可以了(不需要管理顶点的释放)。通过这种方式,Java 提高了编程的效率。

同样给出一个 Java 内存泄漏的典型例子, ```java Vector v = new Vector(10); for (int i = 1; i < 100; i++) { Object o = new Object(); v.add(o); o = null; } ``` 在这个例子中,我们循环申请Object对象,并将所申请的对象放入一个 Vector 中,如果我们仅仅释放引用本身,那么 Vector 仍然引用该对象,所以这个对象对 GC 来说是不可回收的。因此,如果对象加入到Vector 后,还必须从 Vector 中删除,最简单的方法就是将 Vector 对象设置为 null。 **内存泄露查询工具** - **MemoryAnalyzer**:一个功能丰富的 JAVA 堆转储文件分析工具,可以帮助你发现内存漏洞和减少内存消耗 - **EclipseMAT**:是一款开源的JAVA内存分析软件,查找内存泄漏,能容易找到大块内存并验证谁在一直占用它,它是基于Eclipse RCP(Rich Client Platform),可以下载RCP的独立版本或者Eclipse的插件 - **JProbe**:分析Java的内存泄漏。 参考资料:[Java中关于内存泄漏出现的原因以及如何避免内存泄漏(超详细版汇总上)](https://blog.csdn.net/wtt945482445/article/details/52483944) ## * 虚拟机参数 大多数的配置都是为堆服务的 (1)-XX 对于系统级别的(JVM)的配置 - 比如配置日志信息或者配置JVM使用什么样的垃圾回收器 (2)非-XX 配置基本都是对应用层面上的配置 `+ 表示启动`,`- 表示禁用` # 附录:参考资料 - [面试JVM 听这堂课就够了_面试jvm 听这堂课就够了_腾讯视频](https://v.qq.com/x/cover/bcmtqgpddsbj75k/g1423t1uwp5.html) - [咕泡学院-James老师_腾讯课堂](https://ke.qq.com/teacher/2904270631) - [Java虚拟机概述和基本概念](https://centmeng.github.io/2017/03/30/Java%E6%9E%B6%E6%9E%84%E5%B8%88-JVM/) - [JVM性能监控工具 - 简书](https://www.jianshu.com/p/25e94a1399a0) - [探索JVM底层奥秘ClassLoader源码分析与案例讲解_哔哩哔哩 (゜-゜)つロ 干杯~-bilibili](https://www.bilibili.com/video/av17748750?from=search&seid=7485294466500539956) - [一个“Hello World”理解JVM运行时数据区 - 西楼有酒 - 博客园](https://www.cnblogs.com/JunFengChan/p/9250585.html) - [JVM体系结构讲解](https://zhuanlan.zhihu.com/p/28347393) # 更新说明 v1.0 2018/7/21 初版完成 v2.4 2018/8/18 基础初版 v2.5 2018/8/18 修改格式,补充符号链接与直接链接