 UI-Venus-2
English | 简体中文

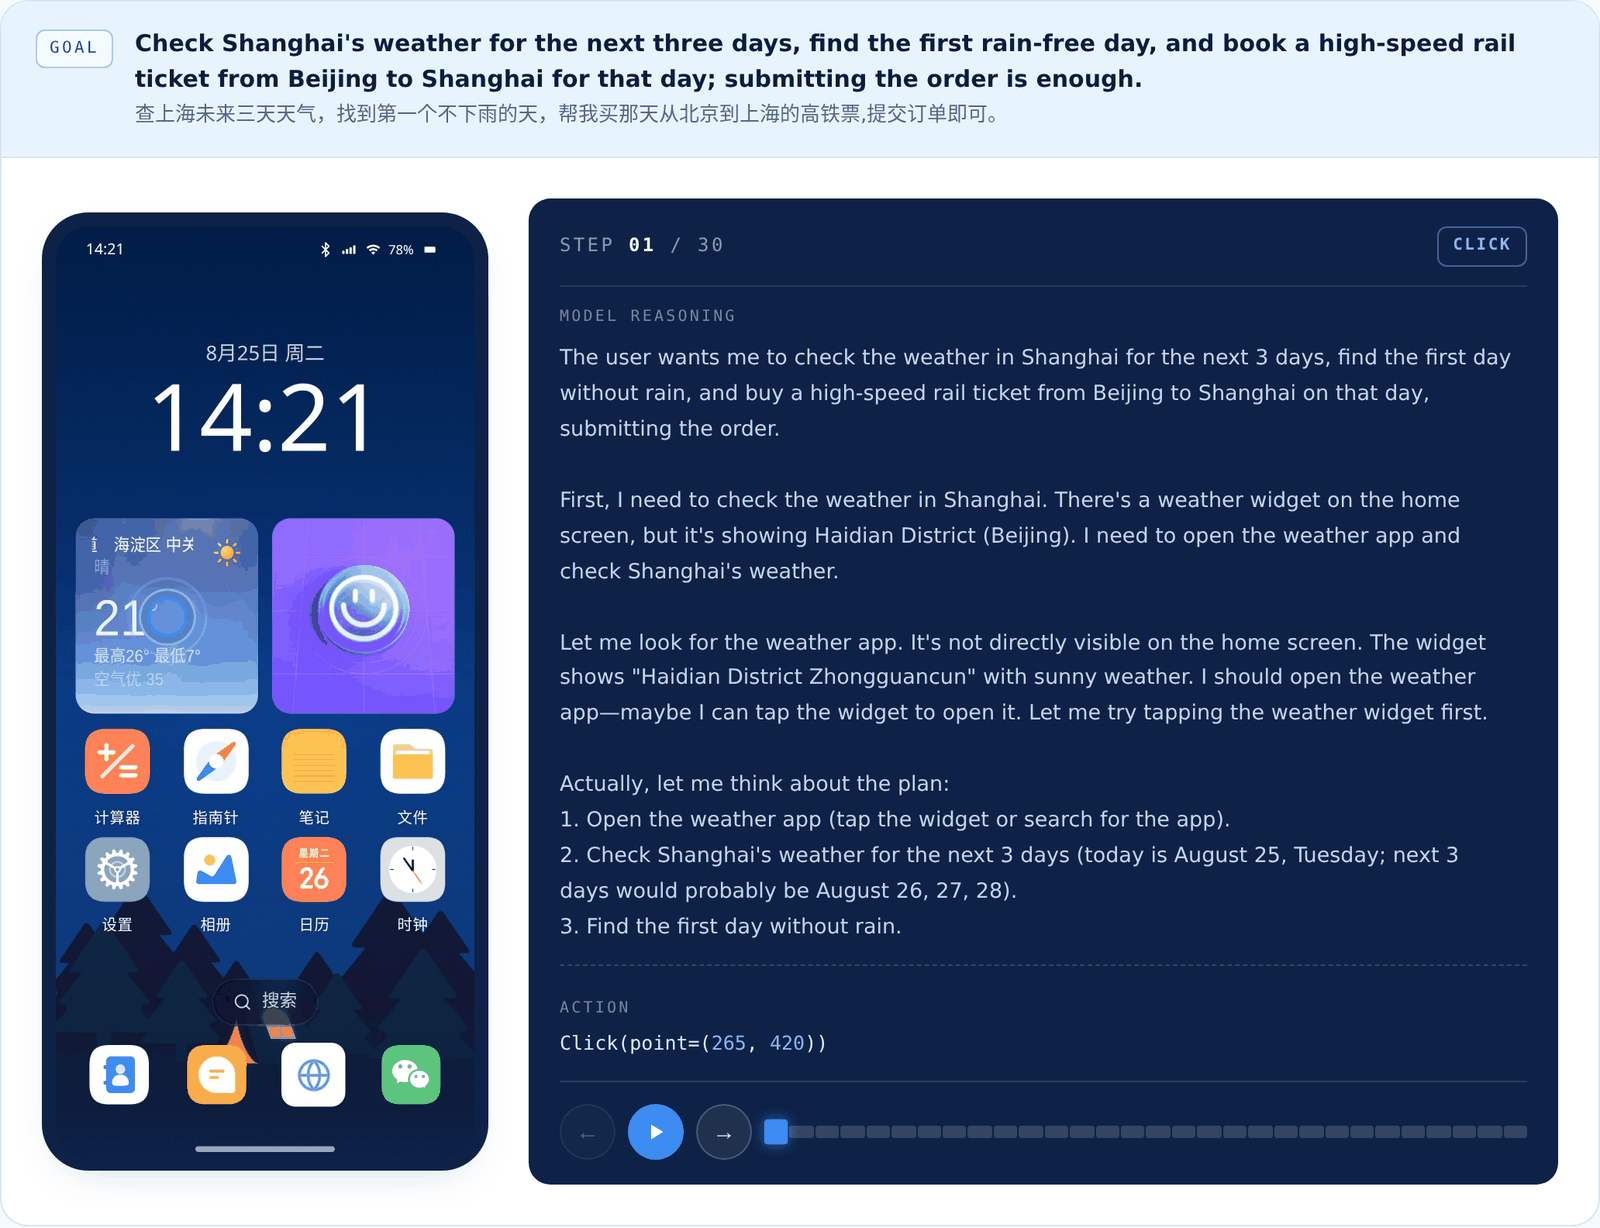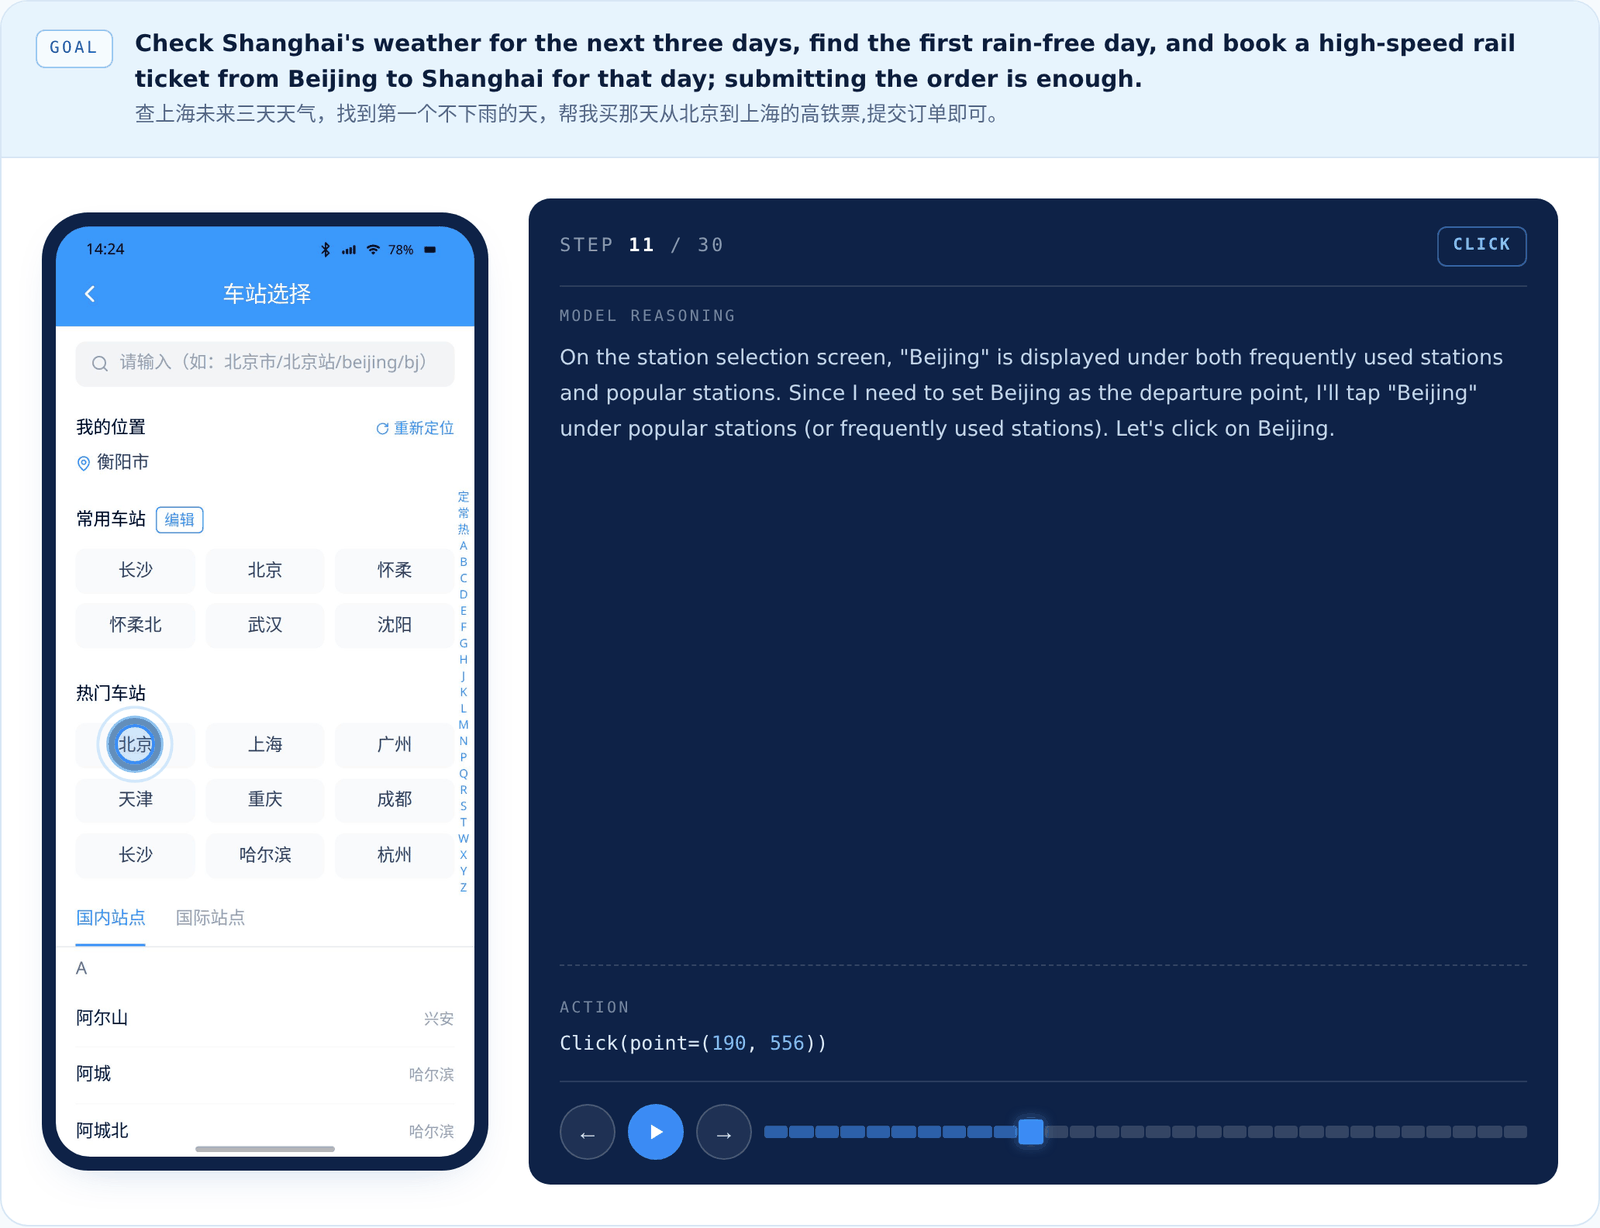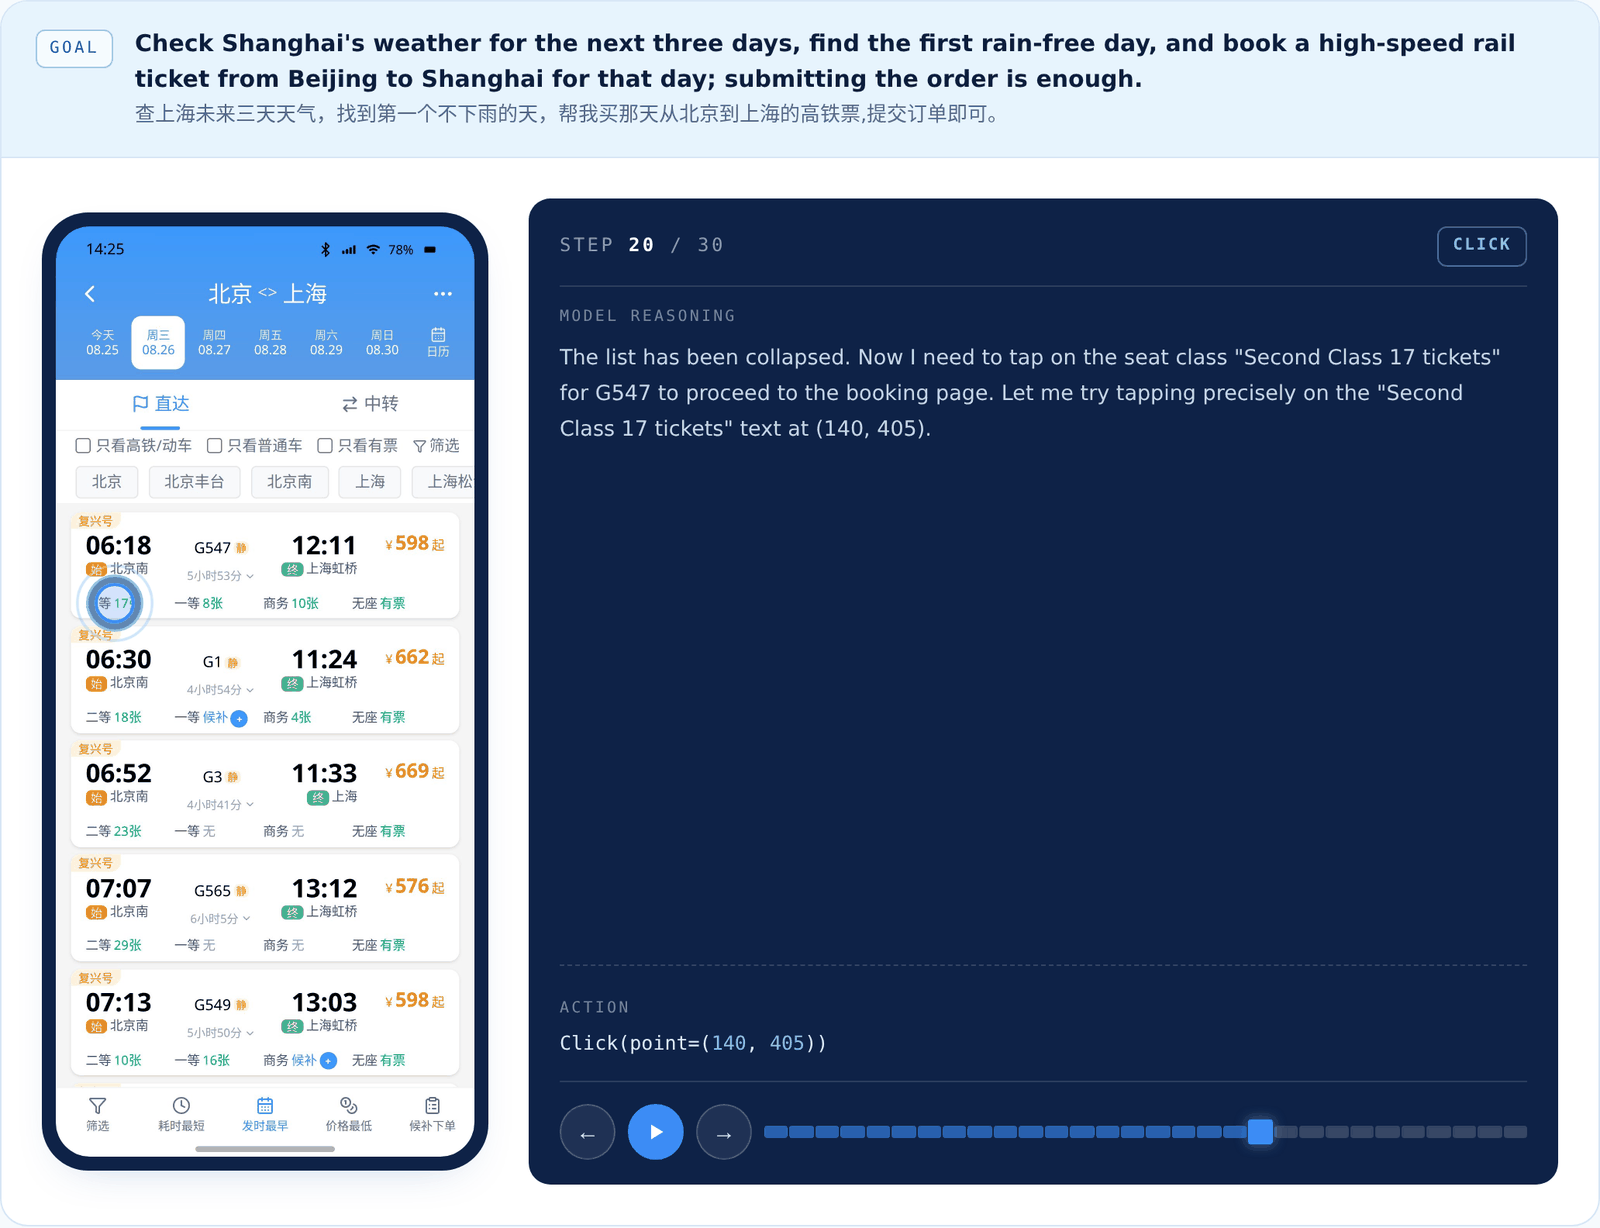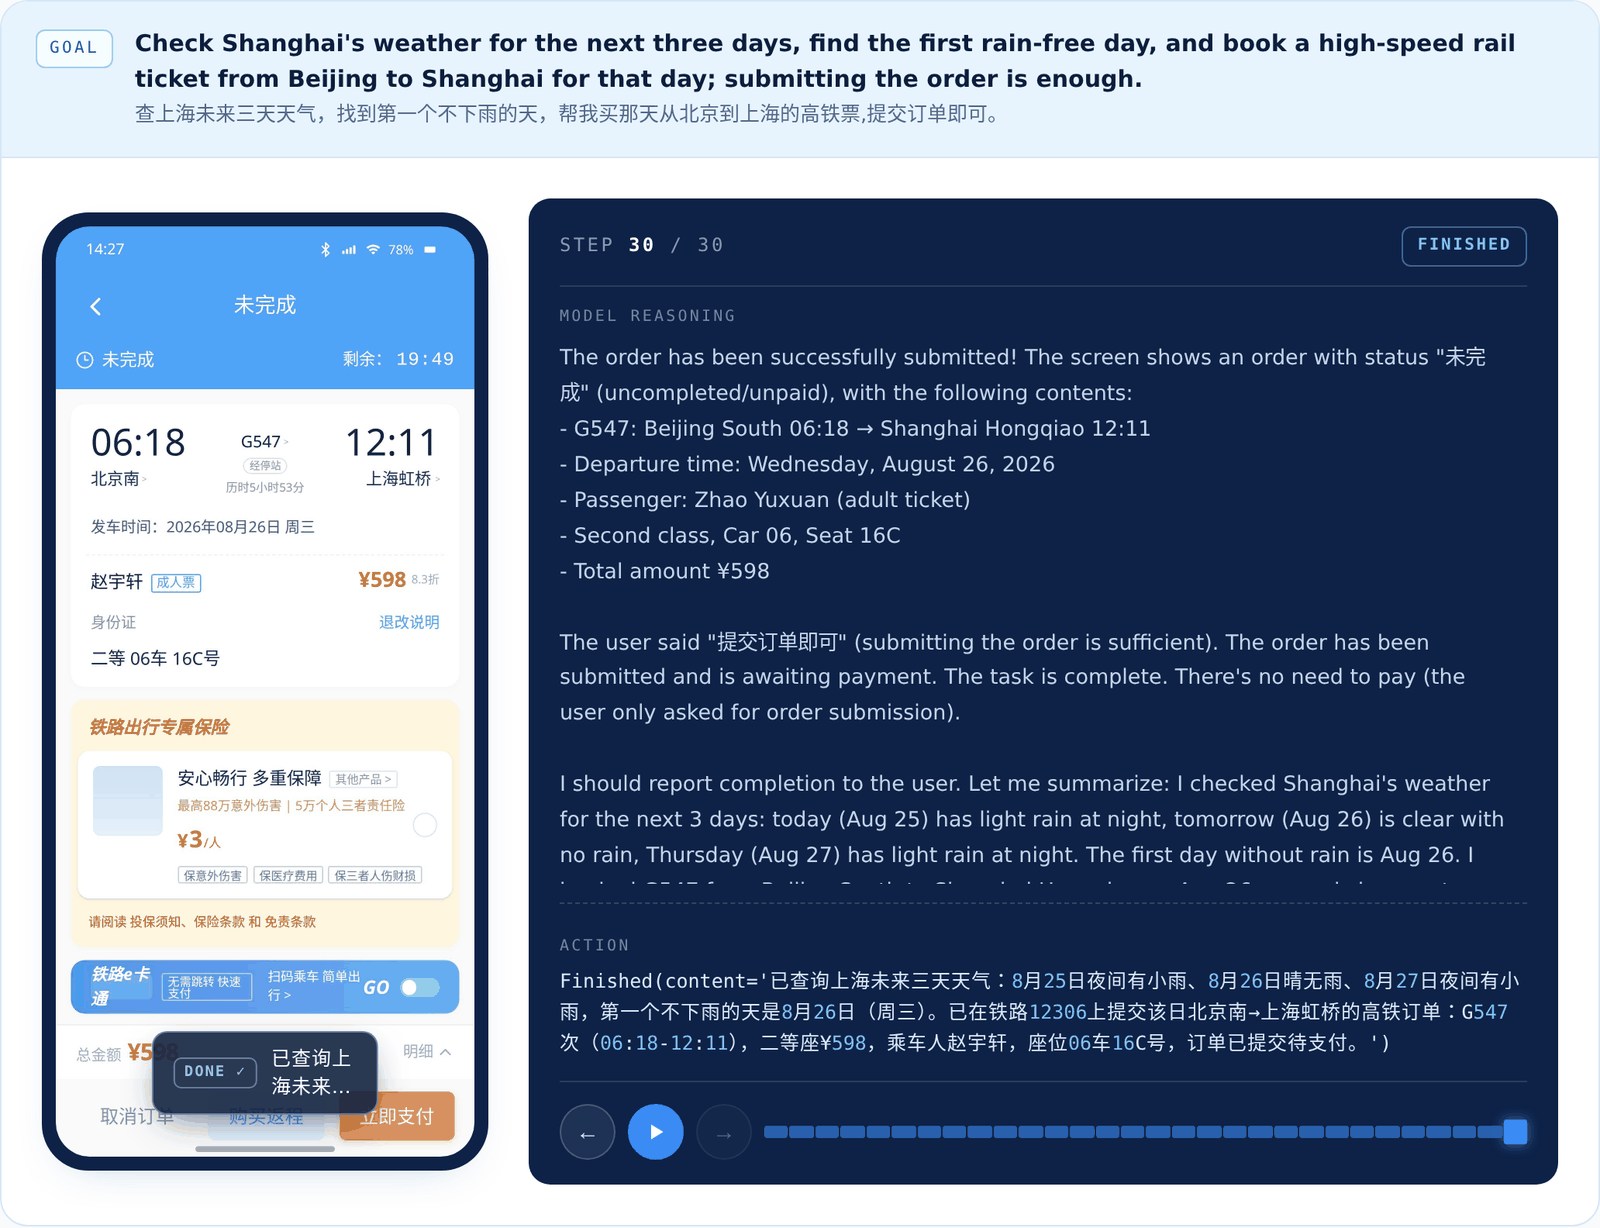
一个面向移动应用、Web 平台和桌面操作系统的通用基础 GUI 智能体——在单一的感知—推理—动作闭环智能体中,联合扩展环境、任务与反馈。
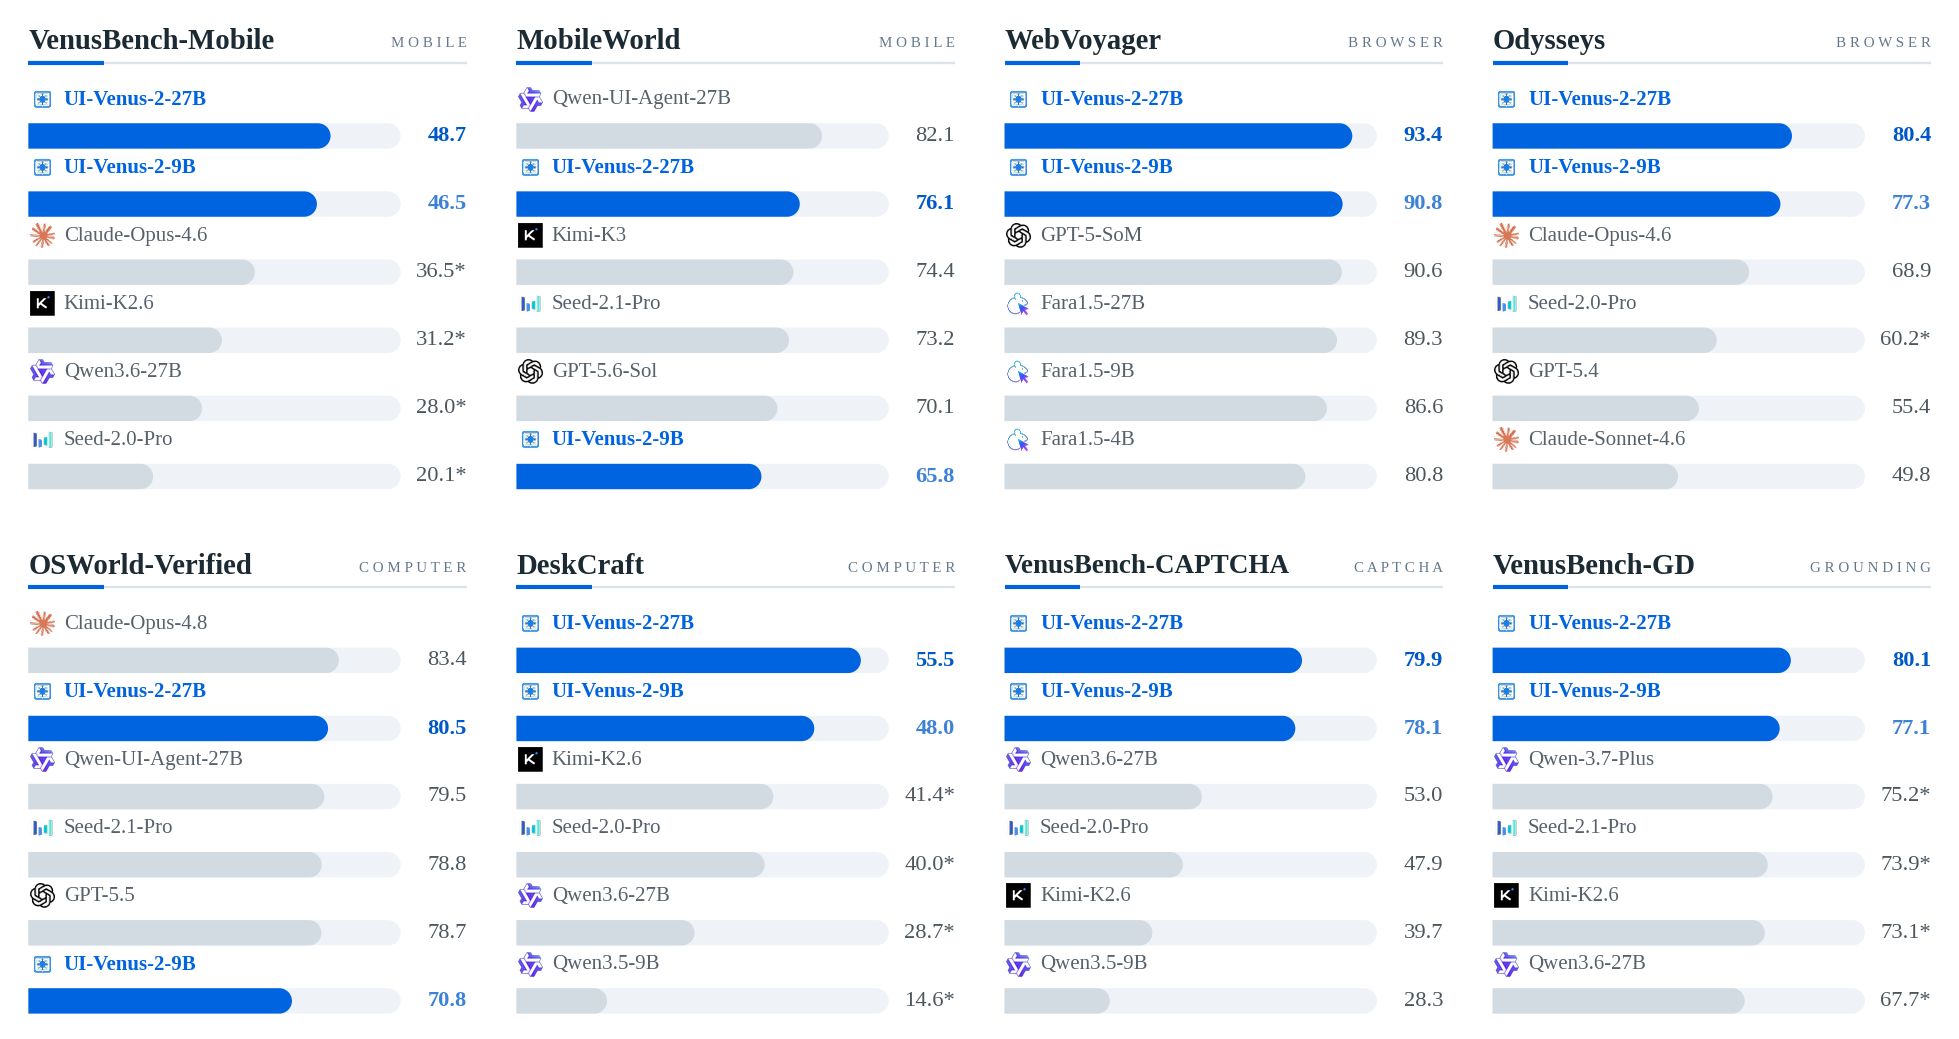
## 🌟 UI-Venus-2 新特性 相较于 UI-Venus-1.5,我们引入了: - 📱 **规模化的多语言移动环境:** 大幅扩展可执行移动应用池,覆盖中英文应用生态;同时采用**深度研究驱动的查询生成**策略,让任务查询以真实应用功能为依据,从而提升生成指令的准确性、有效性和可执行性。 - 🖥️ **从零构建的计算机操作能力:** 通过计算机操作数据采集和专项训练,从头构建桌面操作系统能力,使 UI-Venus 系列能够通过**一个统一的端到端智能体完成移动端、Web 和操作系统交互**。 - 🎯 **基于关键点的验证:** 不再粗略地整体观察最终画面,而是依据**与任务相关的视觉关键点**判断任务是否完成;同时通过**多模型投票**聚合不同类型的评判模型,减少单一评判模型的偏差,并增强奖励信号抵御奖励作弊(reward hacking)的能力。 - 🔄 **验证增强的反思:** 将经过验证的反馈提炼为训练中的**反思监督**,使智能体能够区分部分进展与真正完成,避免因错误理解观察结果而过早终止,并能在长程交互中恢复执行。 ---📈 UI-Venus-2 基准测试表现
 ---
# 🛠 Venus 框架
我们提供了两套用于在真实环境中运行智能体的框架:
| 框架 | 说明 | 文档 |
|---|---|---|
| 移动端框架 | 基于 Android/ADB 的智能体框架,支持单任务执行、多设备批量执行、轨迹记录和反思。 | [中文](./Venus_framework/Venus_framework_mobile/README_CN.md) · [English](./Venus_framework/Venus_framework_mobile/README.md) |
| 浏览器插件 | 一款 Chrome 侧边栏扩展,可将 UI-Venus 连接到当前浏览器标签页并以交互方式执行浏览器任务。 | [中文](./Venus_framework/Venus_plugin_browser/README_CN.md) · [English](./Venus_framework/Venus_plugin_browser/README.md) |
目录结构和入口说明请参阅 [Venus 框架概览](./Venus_framework/README_CN.md)。除非各示例的要求另有说明,否则下方的轻量级领域示例无需依赖这两套框架。
---
# 🚀 快速开始
### 安装
```bash
conda create -n ui-venus-2 python=3.11 -y
conda activate ui-venus-2
pip install -r requirements.txt
```
需要 Python 3.10 或更高版本。以下所有命令均在仓库根目录执行。通过 `MODEL_URL`、`MODEL_NAME` 以及 `API_KEY` 或 `MODEL_API_KEY` 配置兼容 OpenAI 接口的模型服务;也可以在各领域脚本顶部修改相同配置。同时设置两个密钥变量时,`API_KEY` 的优先级更高。请将 `MODEL_NAME` 设置为部署 UI-Venus-2 9B 或 27B 模型时使用的服务名称。
### 移动端
使用仓库内预先录制的截图序列运行多轮推理。`N_IMG` 用于控制保留最近多少张历史截图:
```bash
MODEL_URL=http://127.0.0.1:8000/v1 \
MODEL_NAME=UI-Venus-2 \
N_IMG=2 \
bash scripts/mobile.sh
```
此示例仅执行模型推理,不会在设备上执行操作。如需通过 ADB 自动操作真实设备,请使用上方的移动端框架。
[移动端多轮示例及输入/输出格式](./models/mobile/README_CN.md)
### 计算机
使用预先录制的桌面截图序列运行多轮计算机操作推理:
```bash
MODEL_URL=http://127.0.0.1:8000/v1 \
MODEL_NAME=UI-Venus-2 \
N_IMG=2 \
bash scripts/computer.sh
```
默认命令使用仓库内附带的桌面截图样例。该独立示例会校验并规范化模型操作,但不会在宿主机上执行这些操作;运行时也不依赖 OSWorld。
[计算机多轮示例及操作格式](./models/computer/README_CN.md)
### 浏览器
按照领域文档的说明,以 CDP 端口启动 Chrome,然后运行一个自然语言浏览器任务:
```bash
MODEL_URL=http://127.0.0.1:8000/v1 \
MODEL_NAME=UI-Venus-2 \
bash scripts/browser.sh "打开 https://example.com 并报告页面标题"
```
[浏览器用法及 CDP 配置](./models/browser/README.md)
### 定位
在仓库内附带的三个样例上运行直接定位评测:
```bash
MODEL_URL=http://127.0.0.1:8000/v1 \
MODEL_NAME=UI-Venus-2 \
bash scripts/grounding.sh
```
[定位评测、冒烟测试及基准配置](./models/grounding/README.md)
### CAPTCHA
对仓库内附带的 CAPTCHA 图片运行推理,并将解析后的 JSON 和可视化结果保存到 `results/captcha/`:
```bash
MODEL_URL=http://127.0.0.1:8000/v1 \
MODEL_NAME=UI-Venus-2 \
bash scripts/captcha.sh
```
[CAPTCHA 用法、提示词、操作格式及可视化](./models/captcha/README_CN.md)
---
# 📊 基准测试结果
### Mobile
| Models | MobileGym | VenusBench‑Mobile | AndroidWorld | MobileWorld | KnowUBench | MemGUI |
|---|---|---|---|---|---|---|
| General VLMs | ||||||
| Qwen3.5‑9B | 9.0* | 15.3* | 57.8 | 18.0 (18.0)* | 33.3 | 6.2* |
| Qwen3.6‑27B | 24.6* | 28.0* | 70.3 | 36.8 (41.9)* | - | 25.7* |
| Claude‑Opus‑4.6 | - | 36.5* | - | 44.5 | - | - |
| Kimi‑K2.6 | 38.7* | 31.2* | - | 55.6 | - | 39.1 |
| Kimi‑K3 | - | - | - | 74.4 | - | - |
| Seed‑2.0‑Pro | 52.0 | 20.1* | - | 63.2 | 51.6 | 65.6* |
| Seed‑2.1‑Pro | - | - | - | 73.2 | - | - |
| GPT‑5.6‑Sol | - | - | - | 70.1 | - | - |
| GUI‑specific Models | ||||||
| UI‑Venus‑1.5‑8B | 18.4* | 16.1 | 73.7 | 22.2* | 26.0 | 3.9* |
| UI‑Venus‑1.5‑30B‑A3B | 21.5* | 21.5 | 77.6 | 17.1 | - | 10.9* |
| GUI‑Owl‑1.5‑32B‑Instruct | 20.3* | - | 69.8 | 43.9 | - | 10.9 |
| MAI‑UI‑8B | 21.5* | 12.7 | 70.7 | 27.5 | 26.0 | 17.2* |
| Qwen‑UI‑Agent‑27B | - | - | - | 82.1 (85.5) | - | - |
| Ours | ||||||
| UI‑Venus‑2‑9B | 52.7 | 46.5 | 80.2 | 65.8 (75.2) | 56.5 | 62.6 |
| UI‑Venus‑2‑27B | 60.5 | 48.7 | 84.0 | 76.1 (82.9) | 59.7 | 70.3 |
|
|
|||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| Models | WebVoyager | Online‑Mind2Web | REAL | Odysseys | |
|---|---|---|---|---|---|
| Avg. | Perfect | ||||
| General VLMs | |||||
| Qwen3.5‑9B | 46.9* | 27.3* | 18.2* | 42.6* | 13.5* |
| Qwen3.5‑4B | - | - | - | 42.9 | 10.7 |
| Qwen3.6‑27B | 84.3* | 55.3* | 27.3* | 39.5* | 18.5* |
| OpenAI Operator | 87.0 | 61.3 | - | - | - |
| GPT‑5 (SoM) | 90.6 | - | - | - | - |
| GPT‑5.4 | - | - | - | 55.4 | 33.5 |
| Seed2.0 Pro | 85.1* | 68.5* | 74.4* | 60.2* | 30.1* |
| GLM‑5V‑Turbo | 88.5 | - | - | - | - |
| Claude Opus 4.6 | 88.0 | - | - | 68.9 | 44.5 |
| Claude‑Sonnet‑4.6 | - | - | - | 49.8 | 31.0 |
| Kimi‑K2.6 | 76.8* | - | 74.4* | - | - |
| GUI‑specific Models | |||||
| UI‑TARS‑1.5 | 84.8 | 75.8 | - | - | - |
| UI‑Venus‑1.5‑30B‑A3B | 76.0 | - | 38.0* | - | - |
| GUI‑Owl‑1.5‑32B‑Thinking | 82.1 | - | 44.6* | - | - |
| MolmoWeb‑8B | 78.2 | 35.3 | - | - | - |
| Fara1.5‑4B | 80.8 | - | - | - | - |
| Fara1.5‑9B | 86.6 | 63.4 | - | - | - |
| Fara1.5‑27B | 89.3 | 72.3 | - | - | - |
| Ours | |||||
| UI‑Venus‑2‑9B | 90.8 | 74.0 | 76.9 | 77.3 | 62.0 |
| UI‑Venus‑2‑27B | 93.4 | 78.3 | 80.2 | 80.4 | 66.3 |
| Models | VenusBench‑GD | ScreenSpot‑Pro | OSWorld‑G‑R | UI‑Vision |
|---|---|---|---|---|
| General VLMs | ||||
| Qwen 3.7 Plus | 75.2* | 68.9 | 78.2 | 68.0 |
| Seed 2.1 Pro | 73.9* | 65.3 | 78.0 | 62.0 |
| Kimi‑K2.6 | 73.1* | 52.0* | 69.7* | 51.7* |
| Qwen3.6‑27B | 67.7* | 65.2* | 76.9* | 58.3* |
| GUI‑specific Models | ||||
| UI‑Venus‑Ground‑72B | 70.2 | 61.9 | 69.5 | 36.8 |
| Holo2‑30B‑A3B | 59.5* | 66.1 | 76.1 | 40.9* |
| Step‑GUI‑4B | 54.6* | 60.0 | 66.9 | 30.0* |
| MAI‑UI‑8B | 65.2* | 65.8 | 68.6 | 40.7 |
| MAI‑UI‑32B | - | 67.9 | 73.9 | 47.1 |
| UI‑Venus‑1.5‑30B‑A3B | 75.0 | 69.6 | 76.4 | 54.7 |
| Qwen‑UI‑Agent‑27B | - | 76.6 | 78.5 | 70.0 |
| Ours | ||||
| UI‑Venus‑2‑9B | 77.1 | 73.0 | 78.5 | 53.2 |
| UI‑Venus‑2‑27B | 80.1 | 74.1 | 79.1 | 66.9 |
| Models | VenusBench‑CAPTCHA | MCA‑Bench | Spatial‑CAPTCHA‑Bench | NextGen‑CAPTCHAs | Open CaptchaWorld |
|---|---|---|---|---|---|
| General VLMs | |||||
| Qwen3.5‑9B | 28.3 | 30.4 | 4.9 | 2.8 | 36.4 |
| Qwen3.6‑27B | 53.0 | 51.7 | 31.0 | 14.1 | 47.7 |
| Seed‑2.0‑Pro | 47.9 | 36.5 | 43.8 | 20.4 | 55.6 |
| Kimi‑K2.6 | 39.7 | 38.7 | 24.8 | 7.2 | 47.8 |
| Claude‑Opus‑4.6 | 16.0 | 25.9 | 9.5 | 2.8 | 23.3 |
| Ours | |||||
| UI‑Venus‑2‑9B | 78.1 | 75.7 | 42.8 | 47.6 | 50.7 |
| UI‑Venus‑2‑27B | 79.9 | 79.6 | 48.6 | 54.5 | 56.3 |