# Learning to Look Beyond Screens: Transferable Visual Observation from GUI Grounding
English | 简体中文


[*Ruilin Yao*](https://mr-bigworth.github.io/)1,2,*, [Xinyu Qiu](https://openreview.net/profile?id=~Xinyu_Qiu1)3,*, [Tianyu Zou](https://openreview.net/profile?id=~Tianyu_Zou2)1, [Yi Rong](https://openreview.net/profile?id=~Yi_Rong3)1, [Shengwu Xiong](https://openreview.net/profile?id=~Shengwu_Xiong1)1, [Shuheng Shen](https://openreview.net/profile?id=~Shuheng_Shen2)4,†, [Changhua Meng](https://openreview.net/profile?id=~Changhua_Meng1)4
1武汉理工大学 2中国科学院自动化研究所 3浙江大学 4蚂蚁集团
* 核心贡献者;† 技术负责人(Tech lead)。
**LBS** 通过 GUI 定位学习可迁移的视觉观察能力,提供基于 GRPO 的训练方案,以及 GUI 定位和通用视觉感知评测工具。
模型以 **Qwen3.8-27b** 为基础,先进行冷启动监督微调(**SFT**),再进行 **Agentic RL(GRPO)** 训练。
模型主页:[inclusionAI/LBS-27B](https://huggingface.co/inclusionAI/LBS-27B)。
本仓库不包含模型权重和完整训练数据集。技术报告链接与引用信息将在 arXiv 发布后补充。
[训练](./agentic_gui_grounding_rl/) · [评测](./evaluation/) ·
[结果](./benchmark_results/) · [已核验轨迹](./docs/TRAJECTORIES.md) ·
[在线轨迹可视化](https://mr-bigworth.github.io/LBS/) · [验证说明](./docs/RELEASE_VALIDATION.md)
---
## 项目介绍
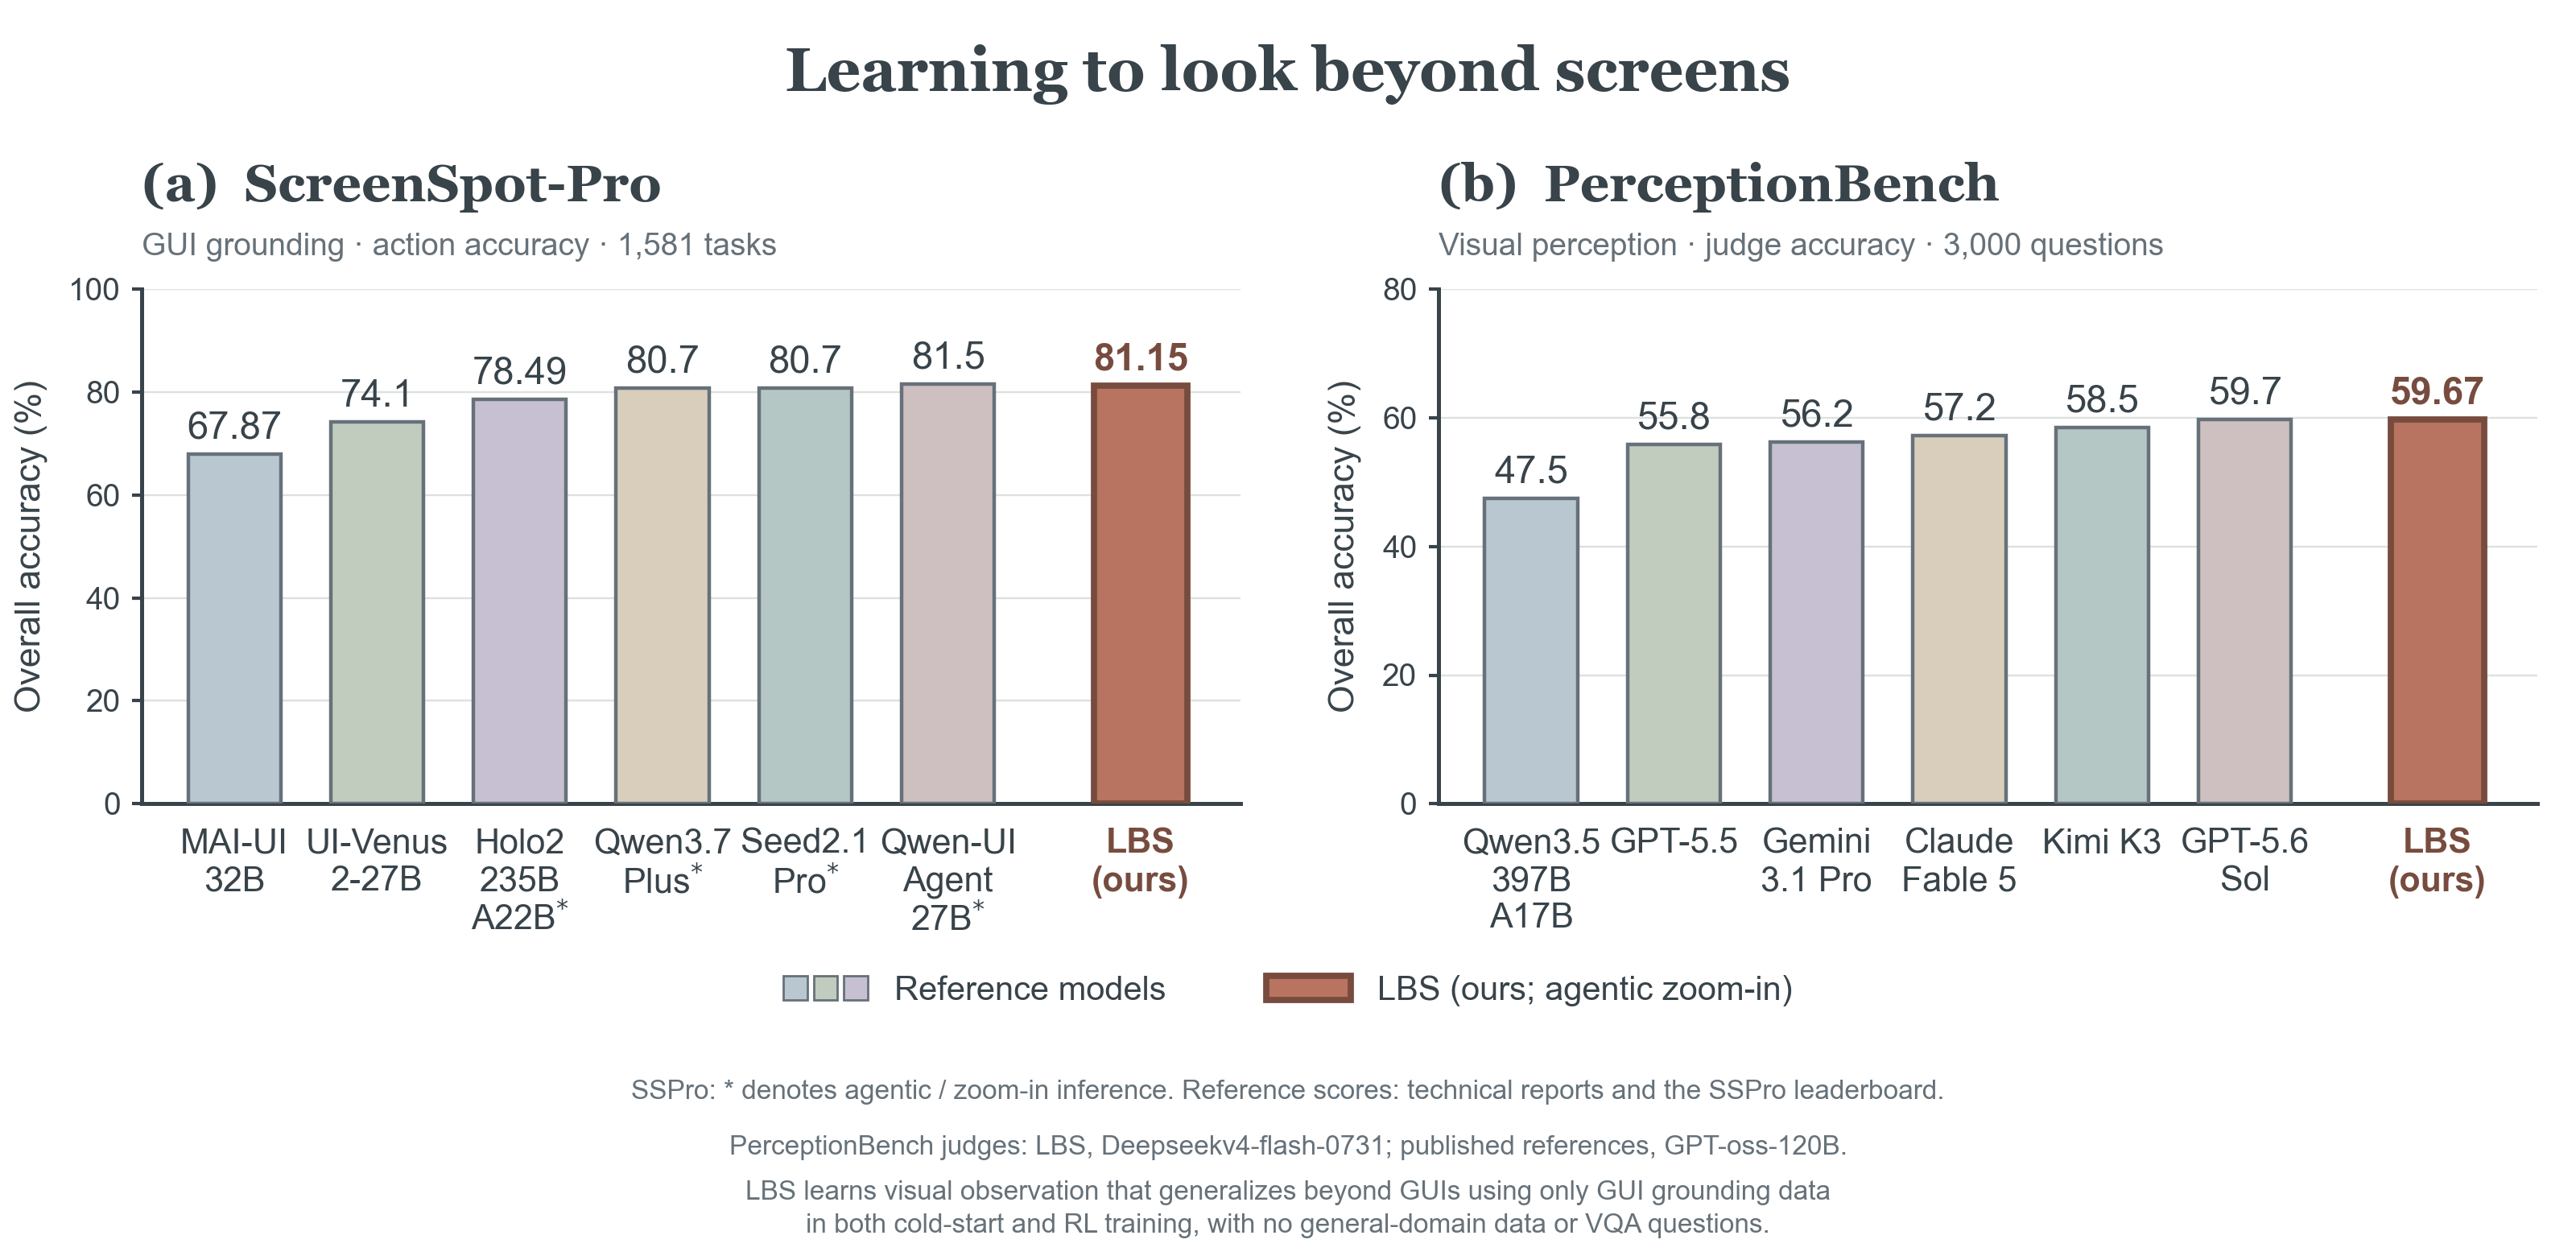
[图表说明与对比来源](./docs/BENCHMARK_OVERVIEW.md)
**从 GUI 定位到视觉感知:** 通过 **agentic zoom-in(自主放大观察)**,LBS 在 ScreenSpot-Pro 上取得 **81.15%** 的总体操作准确率,在 PerceptionBench 上取得 **59.67%** 的总体评判准确率。
图中选取部分参考结果供对照;各方法的推理设置存在差异,PerceptionBench 的评判模型也不同:我们使用 Deepseekv4-flash-0731,上游使用 GPT-oss-120B。
[来源与对比说明](./docs/BENCHMARK_OVERVIEW.md)。
GUI 截图将细小且密集的信息集中在一张高分辨率图像中。
**自主放大观察**模型并非一次性给出定位答案,而是先推理,再通过 `crop_image` 请求放大感兴趣的区域,观察返回的裁剪图像后输出最终坐标。
在 GUI 任务上学到的观察策略,也能迁移到截图之外的视觉证据分析。
### 主要贡献
1. **从 GUI 定位中学习可迁移的视觉观察能力。** 实验表明,**仅使用 GUI 定位训练即可提升通用领域的 agentic VQA 能力**,体现了观察策略向非截图场景的迁移。
参见[高分辨率视觉问答中的迁移示例](#将观察能力迁移到高分辨率视觉问答)。
2. **使用合成数据的紧凑训练方案。** 仅使用合成 GUI 定位数据,先进行约 **10,000** 条样例的冷启动 SFT,再进行 **80** 步 RL 训练,**批大小为 64**,**每条提示生成 8 个 rollout**。
GRPO 通过结果门控的裁剪奖励和单次调用成本,学习何时观察以及观察哪里。
[训练配置](./agentic_gui_grounding_rl/README.md#reported-training-setup)。
3. **可组合的放大观察协议。** 策略基于对话历史,通过明确的局部 `image_path` 引用原图或已有裁剪图像,支持**嵌套细化、重新查看先前视图,以及一轮内请求多个区域并统一返回结果**。
这为灵活观察与多图扩展提供了统一接口;动作通过普通助手文本表达,无需原生工具调用 API。
[协议与适用范围](#多轮放大观察协议)。
4. **开放训练与评测工具。** 提供[评测协议](./evaluation/README.md)、[训练插件](./agentic_gui_grounding_rl/plugins/grounding_zoom_in/README.md)、[训练样例](./agentic_gui_grounding_rl/data_samples/README.md)和[评测轨迹](./benchmark_results/README.md),并配套[已核验图示](./docs/TRAJECTORIES.md)及[交互式浏览器](https://mr-bigworth.github.io/LBS/)。
工具支持多节点训练,以及基于固定默认协议、兼容 OpenAI 服务接口的可续跑评测。
本次发布包含 GRPO 训练方案、评测客户端与已有实验结果:
| 组件 | 路径 | 内容 |
|---|---|---|
| **训练方案** | [`agentic_gui_grounding_rl/`](./agentic_gui_grounding_rl/) | 基于 [ms-swift](https://github.com/modelscope/ms-swift) + [vLLM](https://github.com/vllm-project/vllm) 的多轮 **GRPO** 强化学习,包含五项奖励(几何奖励与可选的 LLM 评判奖励)及真实训练样例。采用 Apache-2.0。 |
| **评测工具** | [`evaluation/`](./evaluation/) | 支持独立运行和断点续跑,覆盖 **ScreenSpot-Pro / OS-World-G (Refine) / PerceptionBench / HR-Bench (4K+8K)**,通过本地 `vllm serve` 服务进行评测。 |
## 评测结果
以下得分来自已完成并保存的完整评测。
`released-checkpoint` 是被测检查点的发布别名,并非公开的模型服务 ID。
| 评测基准 | 样本数 | 报告指标 | 得分(%) |
|---|---:|---|---:|
| ScreenSpot-Pro | 1581 | 操作准确率 | 81.15 |
| OS-World-G (Refine) | 564 | 操作准确率(含拒绝任务) | 84.57 |
| PerceptionBench | 3000 | 评判准确率 | 59.67 |
| HR-Bench 4K | 800 | **严格选项匹配** | **89.13** |
| HR-Bench 8K | 800 | **严格选项匹配** | **87.75** |
评测协议、指标口径与轨迹选取
**OS-World-G(Refine)** 使用 `os-world-g-refine/annotation.json`:包含 470 条边界框任务、40 条多边形任务和 54 条拒绝任务,主要结果覆盖全部 564 条记录。
**HR-Bench 使用严格匹配结果,而非 LLM 评判得分。** 分别读取
`hrbench.json → splits.HRBench4K.strict_accuracy` 和
`hrbench.json → splits.HRBench8K.strict_accuracy`。
每个划分包含 200 组问题,每组进行四种选项轮换。评测器现有的解析逻辑、严格评分与附加评判指标均保留。
PerceptionBench 使用**自托管 Deepseekv4-flash-0731** 评判模型。
LLM 评判受随机性和服务状态影响,重复评判可能产生差异。本次记录中没有失败或跳过的评判。
参见[评判协议说明](./docs/JUDGE_PROTOCOL.md)。
[完整结果](./benchmark_results/README.md)保留所有汇总、细粒度指标,以及全部 6745 条逐样本得分。
完整文本轨迹选取了 20 条 SSPro、20 条 OS-World-G(Refine)、40 条 PerceptionBench,以及 20 条 HR-Bench(每个划分 10 条)。
PerceptionBench 每类选取四条,包含两个成功案例与两个失败案例。这些是精选示例,不能视为随机抽样的性能估计。
### ScreenSpot-Pro:领域与目标类型
六个领域和 26 个应用的划分遵循 [ScreenSpot-Pro 定位排行榜](https://gui-agent.github.io/grounding-leaderboard/)。
所有数值均为**操作准确率(%)**,基于完整的 1581 条评测记录计算。
文本与图标分别使用各自类型的样本数作为分母;总体结果是按记录计算的**微平均**,并非对领域或应用得分直接求平均。
“文本 / 图标”列给出两类样本数量。
| 领域 | 样本数 | 文本 / 图标 | 文本(%) | 图标(%) | 总体(%) |
|---|---:|---:|---:|---:|---:|
| 开发与编程 | 299 | 154 / 145 | 93.51 | 71.03 | 82.61 |
| 创意设计 | 341 | 198 / 143 | 85.86 | 59.44 | 74.78 |
| CAD 与工程 | 261 | 197 / 64 | 83.25 | 59.38 | 77.39 |
| 科学与分析 | 254 | 144 / 110 | 92.36 | 65.45 | 80.71 |
| 办公软件 | 230 | 177 / 53 | 96.61 | 81.13 | 93.04 |
| 操作系统通用任务 | 196 | 107 / 89 | 92.52 | 68.54 | 81.63 |
| **全部领域** | 1581 | 977 / 604 | 90.17 | 66.56 | 81.15 |
全部 26 个应用的样本数与文本/图标准确率
| 领域 | 应用 | 样本数 | 文本 / 图标 | 文本(%) | 图标(%) | 总体(%) |
|---|---|---:|---:|---:|---:|---:|
| 开发与编程 | Visual Studio Code | 55 | 33 / 22 | 93.94 | 90.91 | 92.73 |
| 开发与编程 | PyCharm | 78 | 40 / 38 | 90.00 | 73.68 | 82.05 |
| 开发与编程 | Android Studio | 80 | 36 / 44 | 94.44 | 59.09 | 75.00 |
| 开发与编程 | Quartus | 45 | 13 / 32 | 100.00 | 65.62 | 75.56 |
| 开发与编程 | VMware | 41 | 32 / 9 | 93.75 | 88.89 | 92.68 |
| 创意设计 | Photoshop | 51 | 26 / 25 | 88.46 | 80.00 | 84.31 |
| 创意设计 | Premiere | 52 | 28 / 24 | 78.57 | 70.83 | 75.00 |
| 创意设计 | Illustrator | 31 | 12 / 19 | 100.00 | 47.37 | 67.74 |
| 创意设计 | Blender | 71 | 56 / 15 | 82.14 | 73.33 | 80.28 |
| 创意设计 | FL Studio | 57 | 26 / 31 | 80.77 | 41.94 | 59.65 |
| 创意设计 | Unreal Engine | 35 | 29 / 6 | 93.10 | 50.00 | 85.71 |
| 创意设计 | DaVinci Resolve | 44 | 21 / 23 | 90.48 | 52.17 | 70.45 |
| CAD 与工程 | AutoCAD | 34 | 27 / 7 | 88.89 | 0.00 | 70.59 |
| CAD 与工程 | SolidWorks | 77 | 63 / 14 | 76.19 | 85.71 | 77.92 |
| CAD 与工程 | Inventor | 70 | 59 / 11 | 83.05 | 54.55 | 78.57 |
| CAD 与工程 | Vivado | 80 | 48 / 32 | 89.58 | 62.50 | 78.75 |
| 科学与分析 | MATLAB | 93 | 74 / 19 | 89.19 | 84.21 | 88.17 |
| 科学与分析 | Origin | 62 | 19 / 43 | 89.47 | 51.16 | 62.90 |
| 科学与分析 | Stata | 49 | 8 / 41 | 100.00 | 65.85 | 71.43 |
| 科学与分析 | EViews | 50 | 43 / 7 | 97.67 | 100.00 | 98.00 |
| 办公软件 | Word | 84 | 69 / 15 | 100.00 | 80.00 | 96.43 |
| 办公软件 | PowerPoint | 82 | 57 / 25 | 96.49 | 84.00 | 92.68 |
| 办公软件 | Excel | 64 | 51 / 13 | 92.16 | 76.92 | 89.06 |
| 操作系统通用任务 | Windows | 81 | 34 / 47 | 94.12 | 72.34 | 81.48 |
| 操作系统通用任务 | macOS | 65 | 42 / 23 | 97.62 | 60.87 | 84.62 |
| 操作系统通用任务 | Linux | 50 | 31 / 19 | 83.87 | 68.42 | 78.00 |
来源:[已保存的 SSPro 指标](./benchmark_results/metrics/sspro.json)与[全部逐样本得分](./benchmark_results/per_sample/sspro.jsonl)。
### PerceptionBench:十类视觉感知任务
类别、缩写与顺序遵循 [PerceptionBench 官方排行榜](https://github.com/MoonshotAI/PerceptionBench#leaderboard)。
以下结果使用**自托管 Deepseekv4-flash-0731** 评判模型;上游排行榜使用 GPT-oss-120B,二者的评判设置不同。
LLM 评判可能随运行而变化。这里展示的是发布报告所采用的已保存 `judge_result`,可选的二次评判不会替换原始记录。
| 类别 | 缩写 | 样本数 | 正确数 | 准确率(%) |
|---|:---:|---:|---:|---:|
| 视觉关系 | VRel | 330 | 226 | 68.48 |
| 计数 | Count | 330 | 204 | 61.82 |
| 属性 | Attr | 330 | 217 | 65.76 |
| 深度与三维感知 | Depth | 330 | 166 | 50.30 |
| 定位 | Loc | 330 | 223 | 67.58 |
| 比较 | Comp | 279 | 177 | 63.44 |
| 细粒度识别 | FGR | 290 | 167 | 57.59 |
| 上下文整合 | Ctx | 255 | 134 | 52.55 |
| 光学字符识别 | OCR | 255 | 157 | 61.57 |
| 感知相关幻觉 | Hallu | 271 | 119 | 43.91 |
| **总体** | — | **3000** | **1790** | **59.67** |
总体结果按样本数加权。本次记录中**没有失败或跳过的评判**,全部 3000 条记录均计入结果。
百分比沿用已保存报告的精度:先将准确率保留四位小数,再换算为百分比。
来源:[分类指标](./benchmark_results/metrics/perceptionbench.json)与[全部逐样本得分](./benchmark_results/per_sample/perceptionbench.jsonl)。
## 观察轨迹
在[交互式 HTML 浏览器](https://mr-bigworth.github.io/LBS/)中查看六个经人工视觉核验的案例,切换模型轮次,对齐推理、裁剪动作、返回图像和最终答案。
浏览器使用低饱和度莫兰迪配色区分问题、推理、动作与答案,并将编者分析单独标注。
点击下方预览即可打开在线交互页面。源码与本地预览方法见[可视化说明](./docs/TRAJECTORIES.md#interactive-html-explorer)。
交互式轨迹可视化
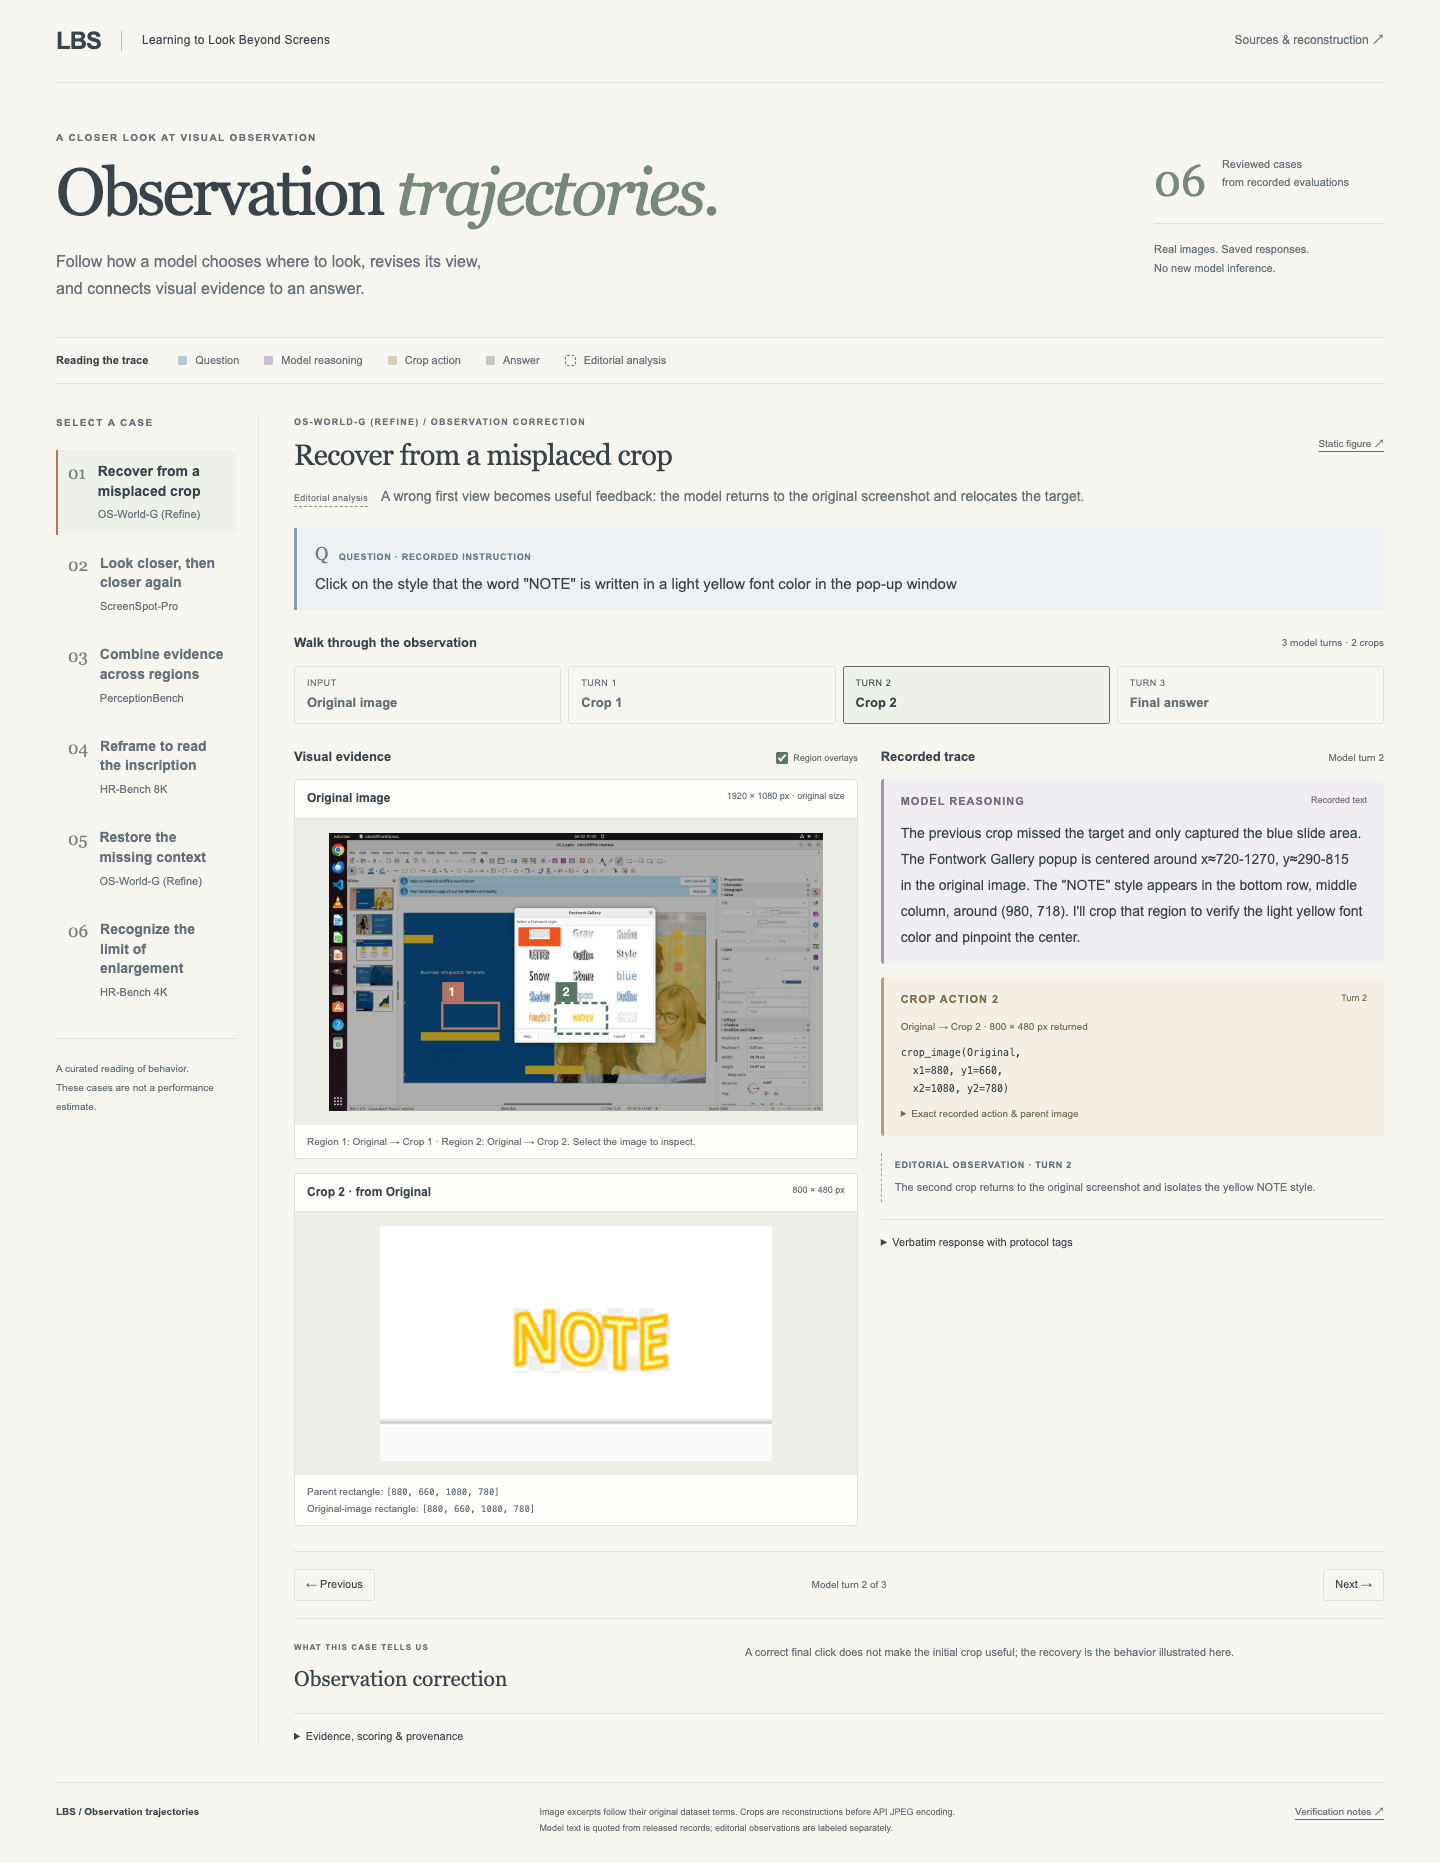
打开在线轨迹浏览器 ↗
下列图示已与官方图像、记录的工具事件及已保存的评判结果核对。
裁剪图像依据记录的父图矩形和缩放规则重建,图注概括实际轨迹。
GUI 最终裁剪图中的鼠尾草绿框表示参考目标,陶土红叉表示模型预测。
生成图示时没有重新运行模型。陶土红和鼠尾草绿分别标识第一次与第二次裁剪,箭头表示观察顺序;PerceptionBench 的分支展示同一轮请求两个区域的情况。
### 从错误的观察位置恢复
第一次裁剪只看到蓝色幻灯片背景。模型识别出偏差后返回原始截图,再次裁剪以定位 Fontwork Gallery 目标。
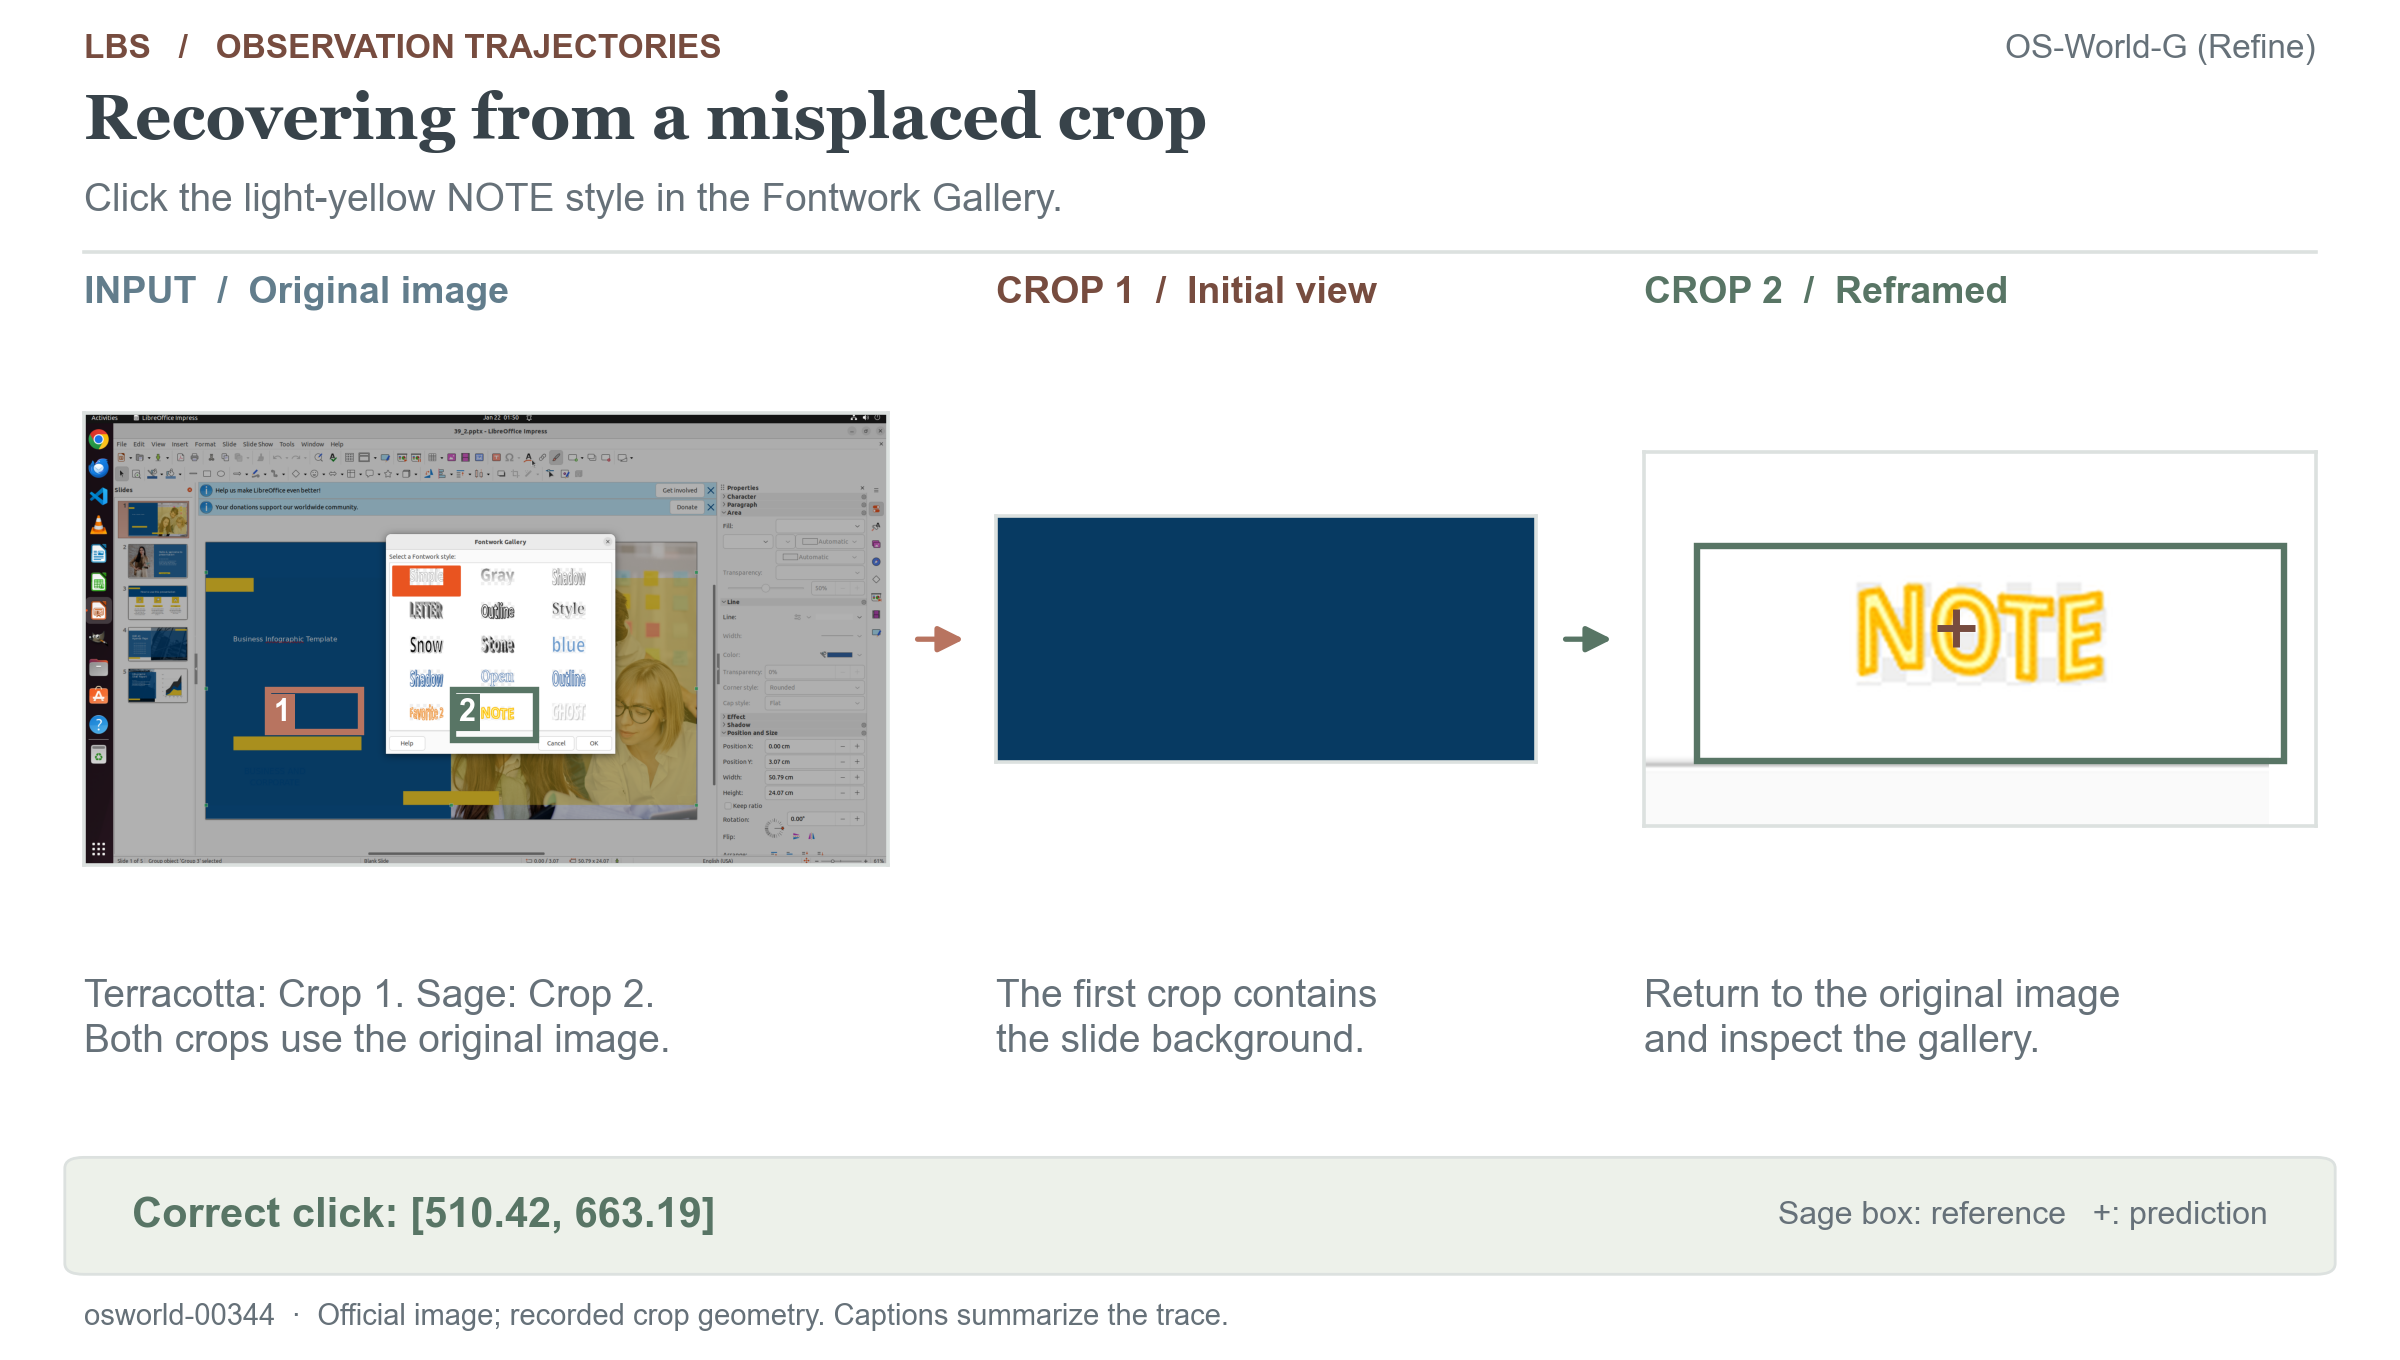
[完整 OS-World-G(Refine)轨迹](./benchmark_results/trajectories/osworld/osworld-00344.json)
### 进一步细化已有裁剪
模型先裁剪工具栏,再对返回的裁剪图继续放大,以辨认细小的 Programmer 图标。最终坐标落在参考框内。
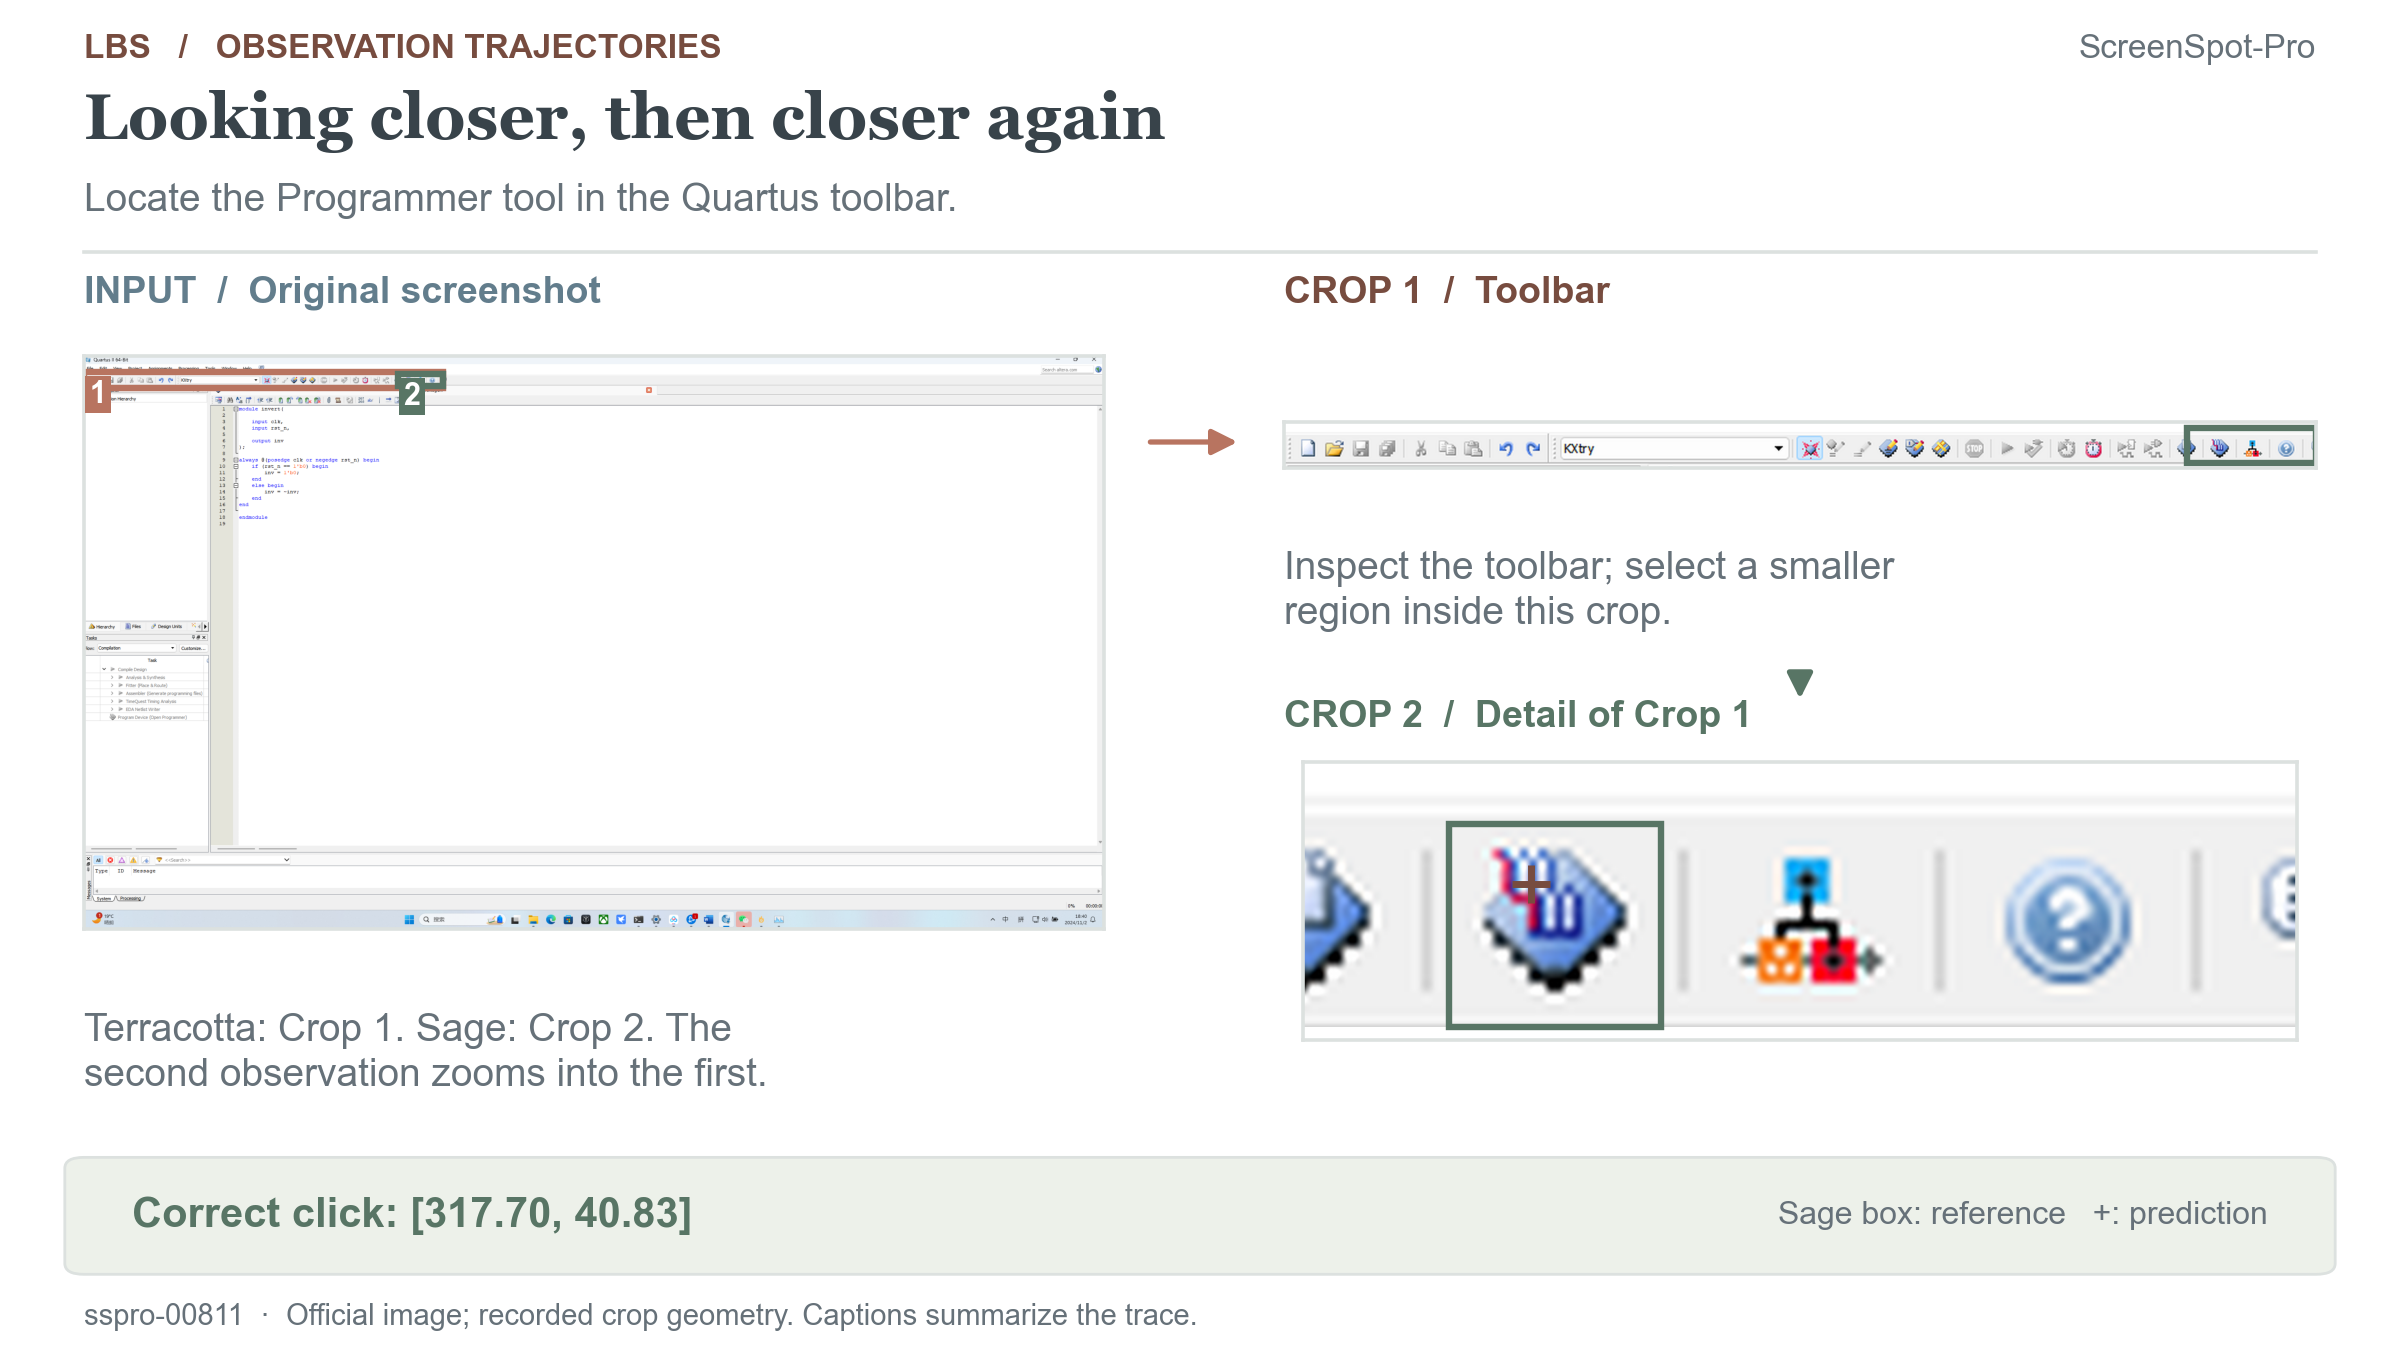
[完整 ScreenSpot-Pro 轨迹](./benchmark_results/trajectories/sspro/sspro-00811.json)
### 综合不同区域的证据
模型在同一轮观察流程图的上下两部分,随后综合观察结果,统计出 13 个圆角矩形流程模块。
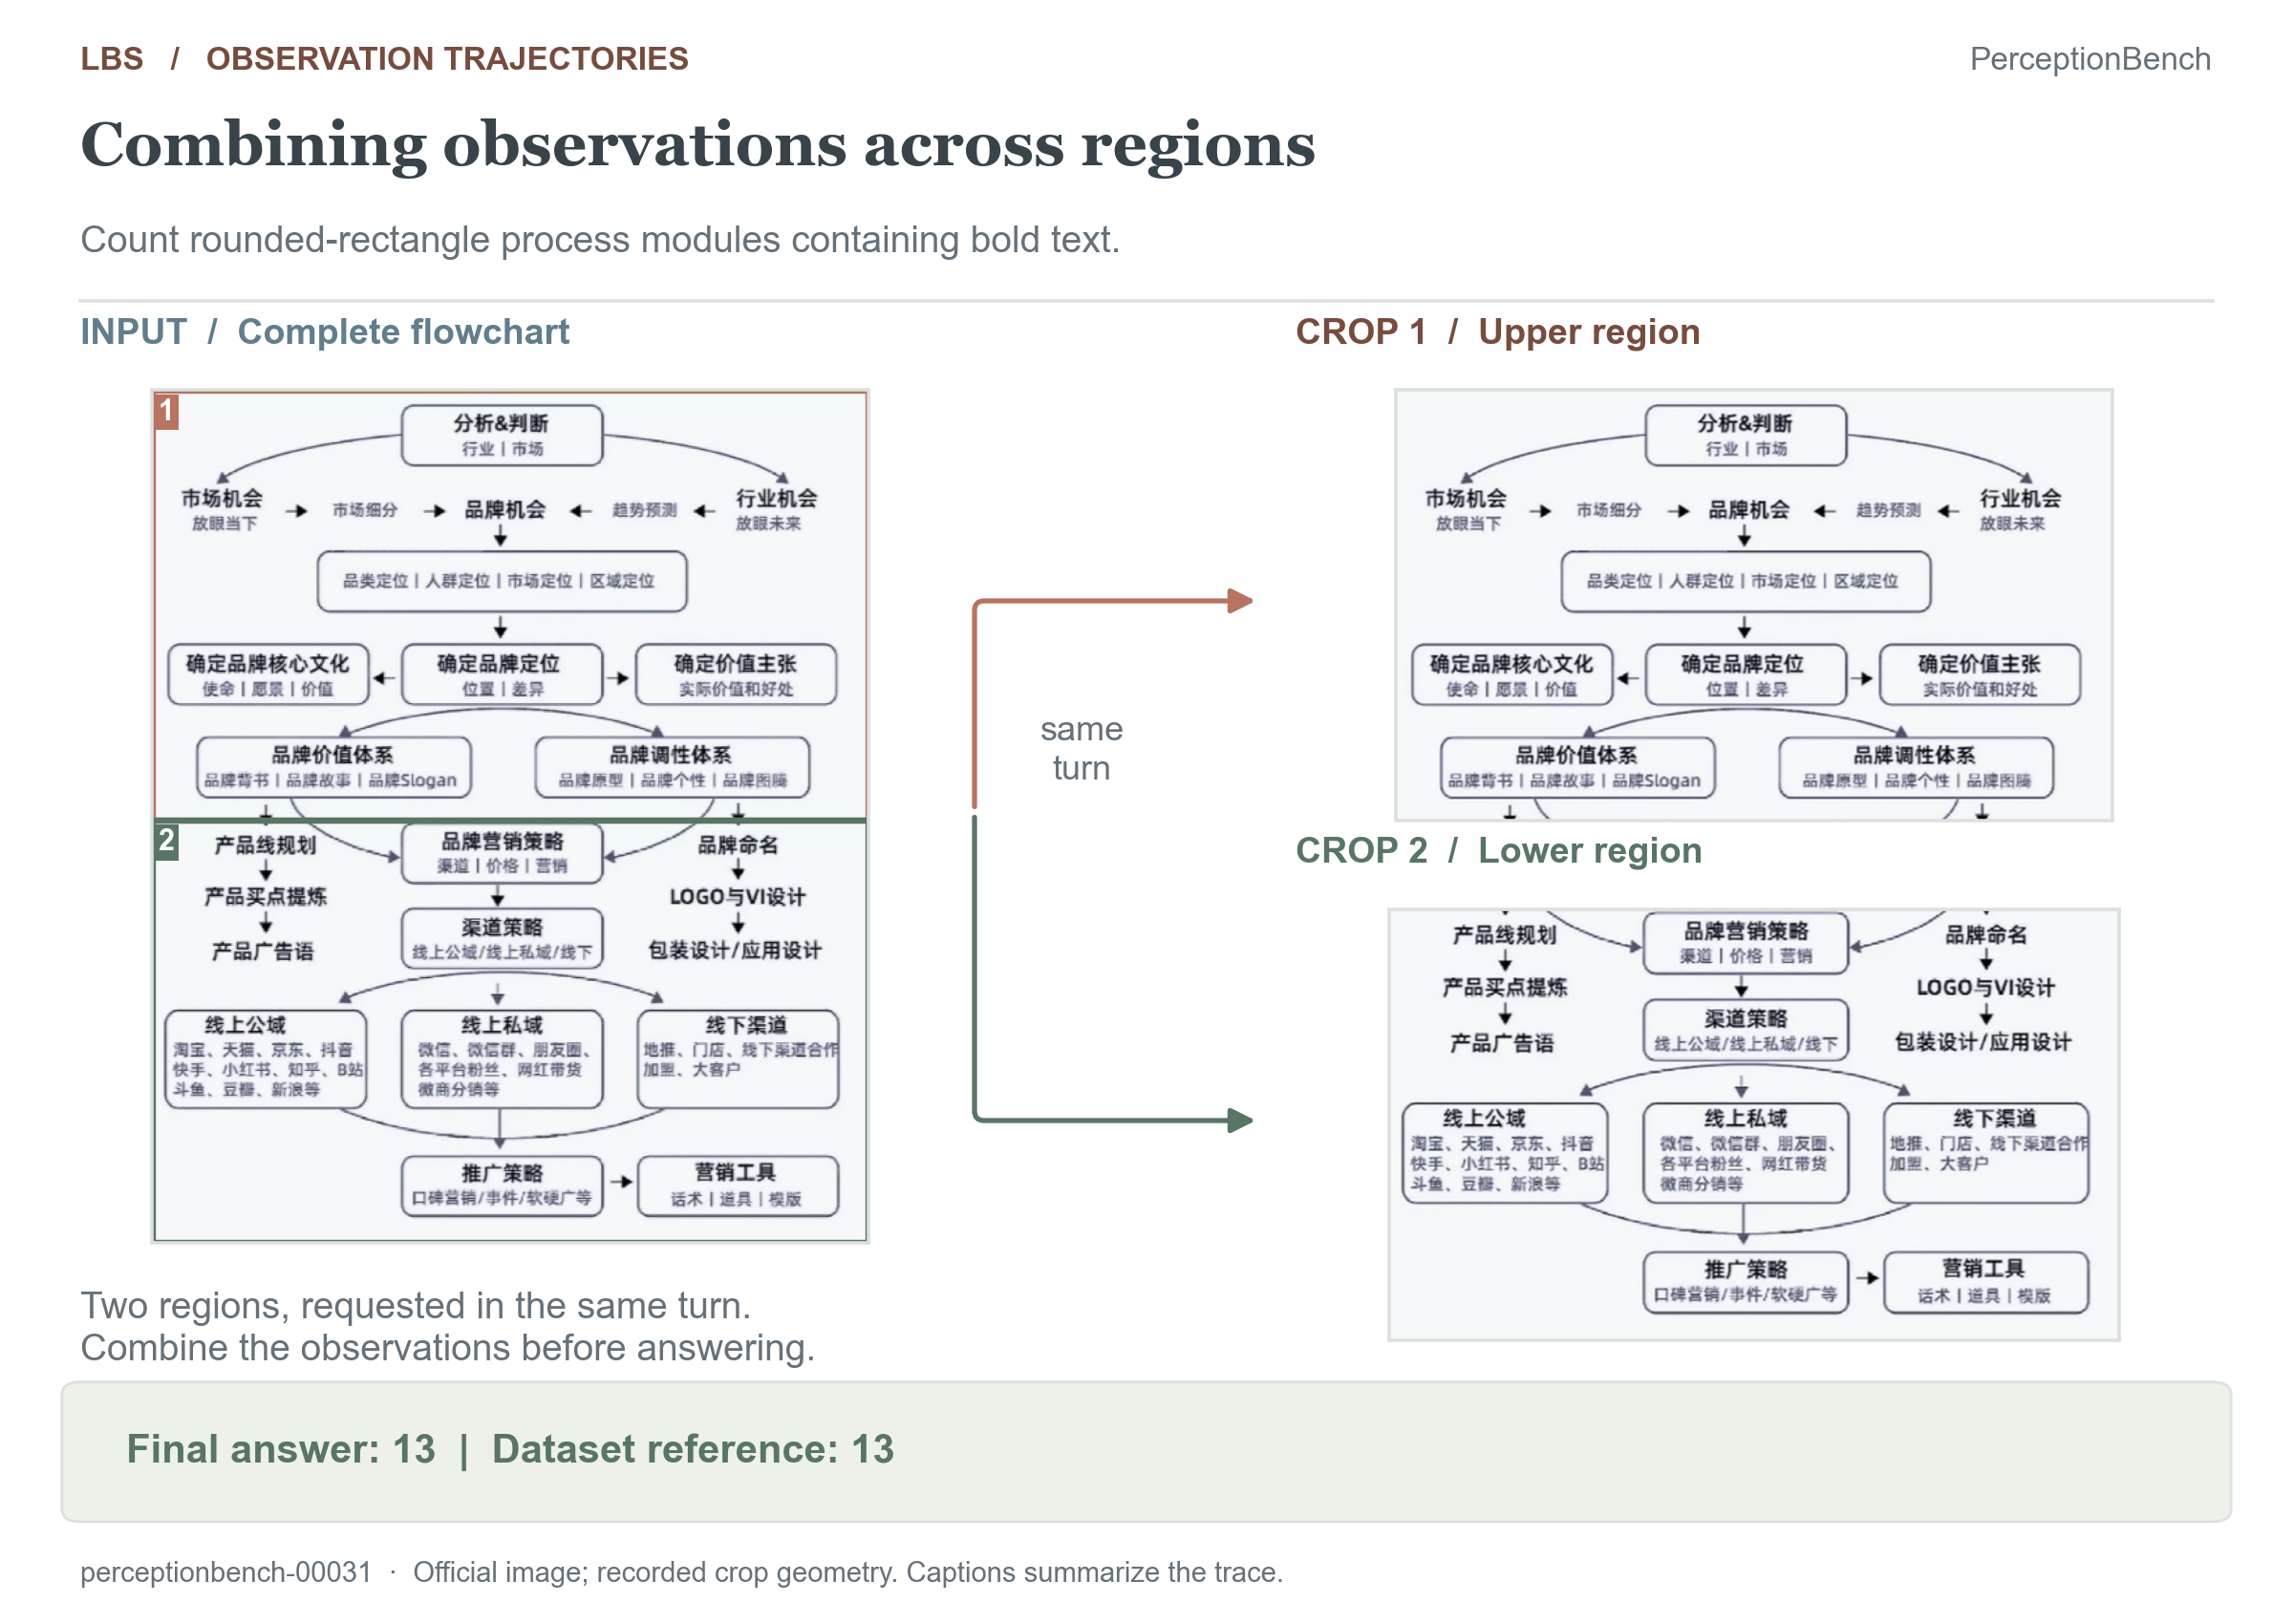
[完整 PerceptionBench 轨迹](./benchmark_results/trajectories/perceptionbench/perceptionbench-00031.json)
### 将观察能力迁移到高分辨率视觉问答
第一次裁剪未覆盖日晷。模型识别出位置偏差后重新选择区域,读出 **1762**,与严格评分下的参考选项一致。
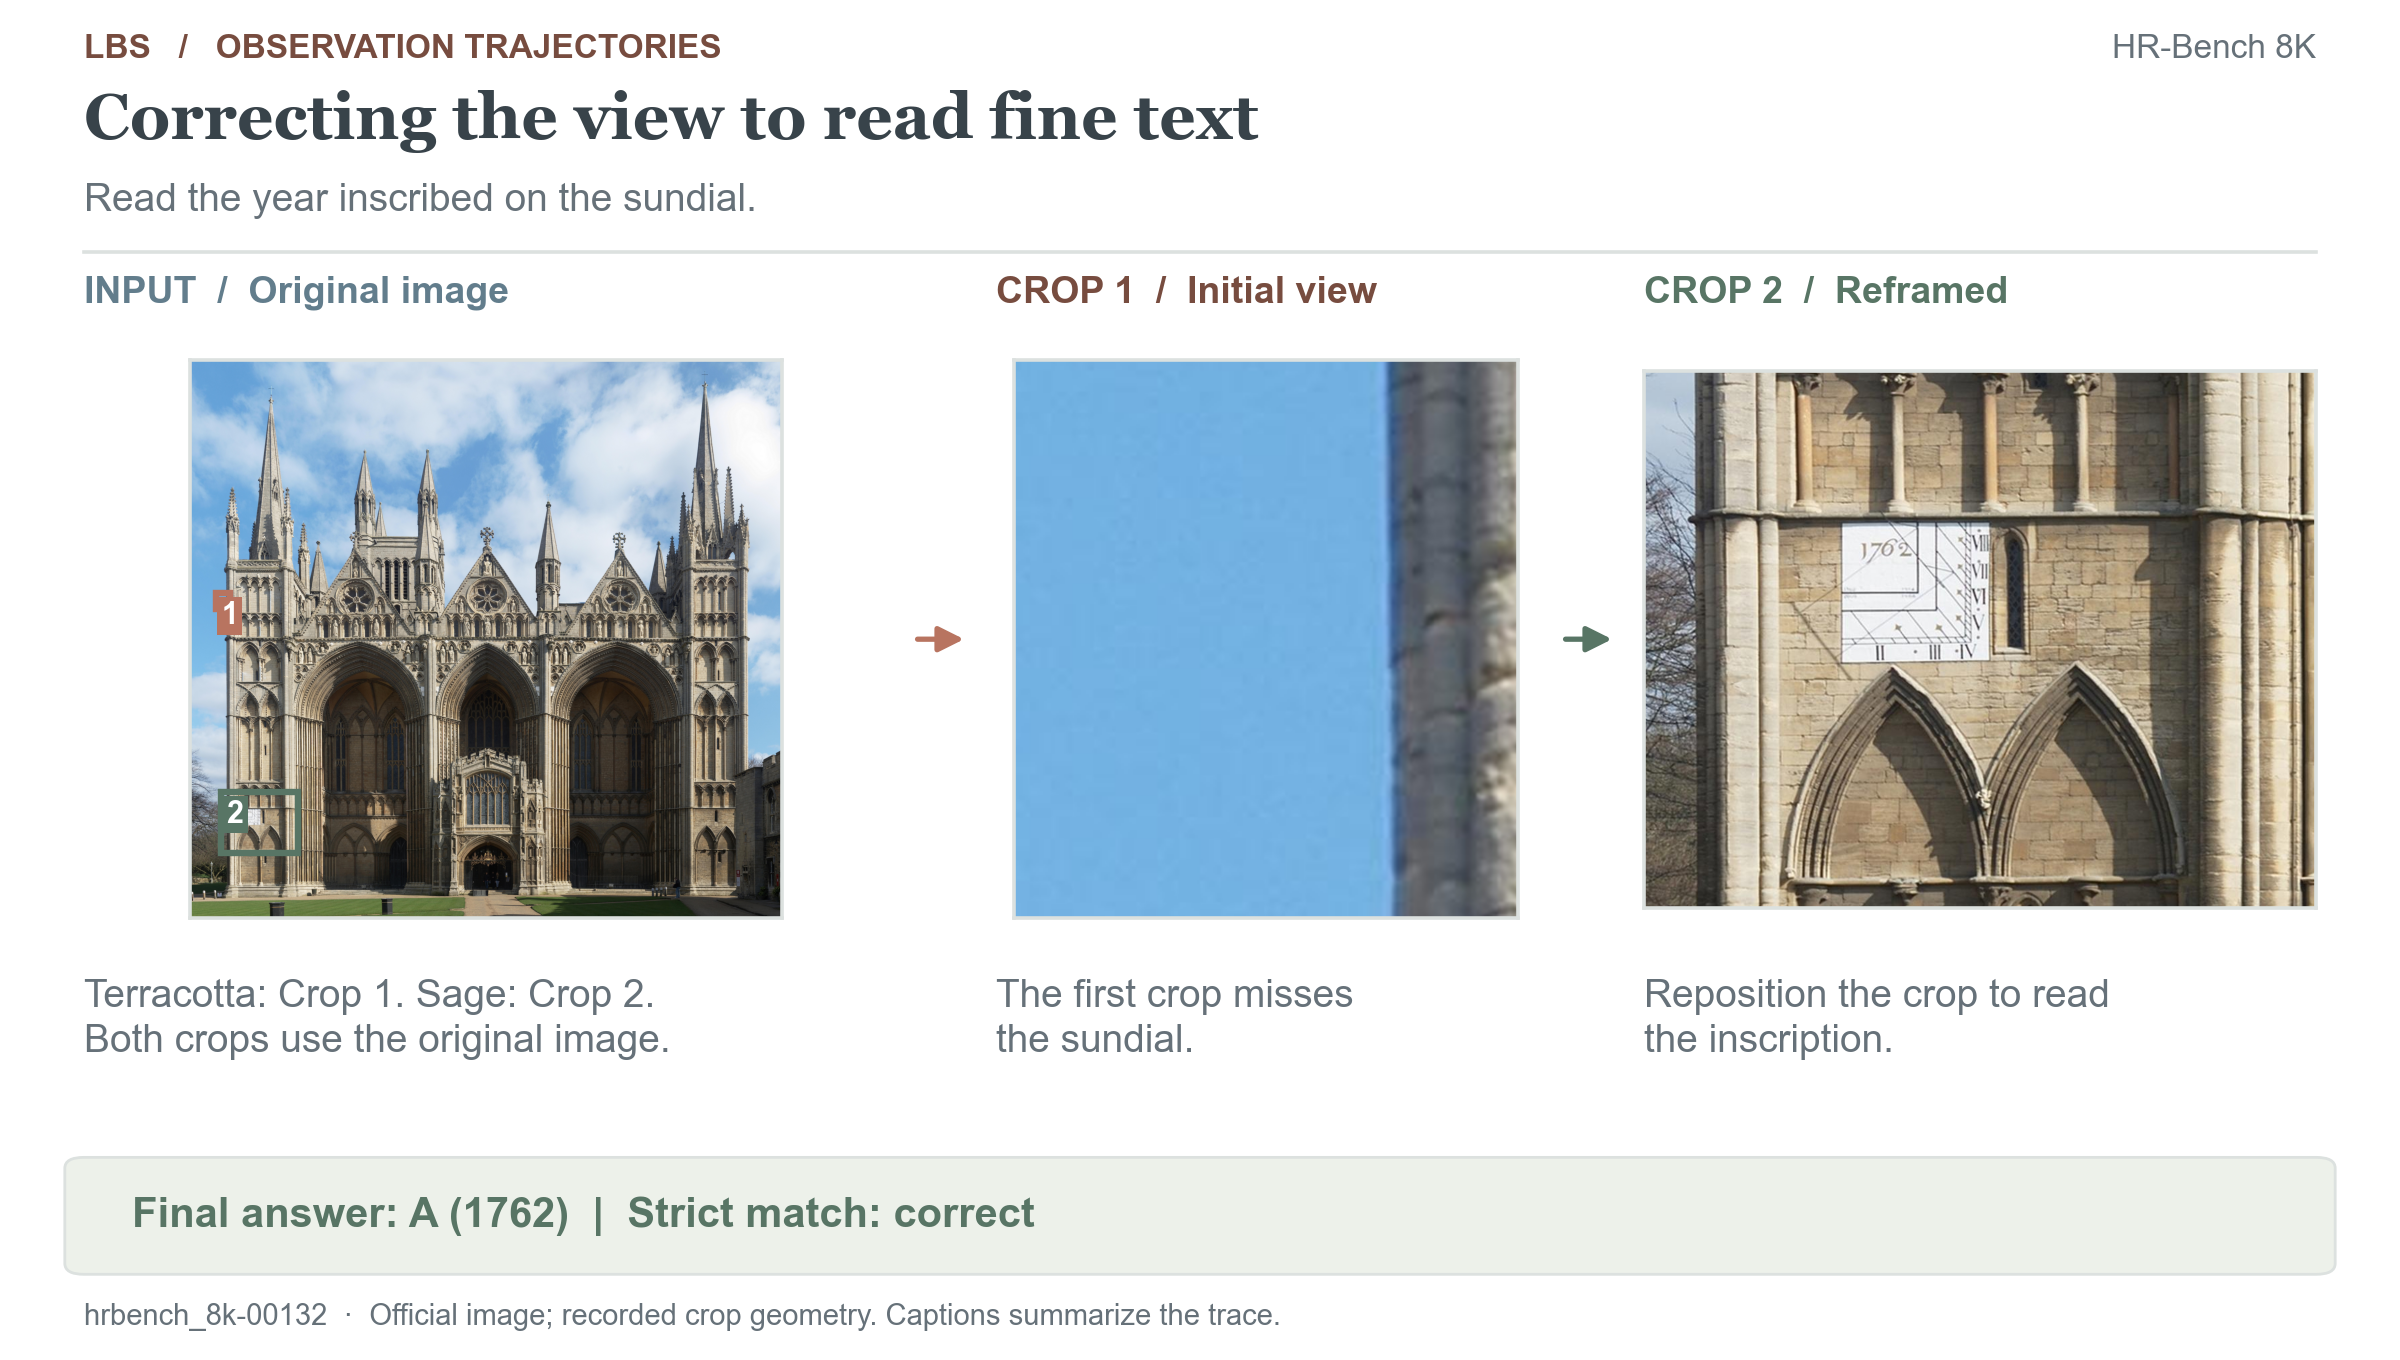
[完整 HR-Bench 8K 轨迹](./benchmark_results/trajectories/hrbench_8k/hrbench_8k-00132.json)
[更多案例、来源与重建说明](./docs/TRAJECTORIES.md)。
## 方法
### 多轮放大观察协议
观察决策以累积对话为依据,包括先前的图像、动作和裁剪反馈。
每个 `image_path` 标识当前任务局部图像注册表中的一张图像,使策略能够[细化已有裁剪](#进一步细化已有裁剪)、[重新查看原图](#从错误的观察位置恢复),或[在一轮内观察多个区域](#综合不同区域的证据)。
这里的**自由放大观察**指在固定动作语法和裁剪预算内,自适应地选择区域与观察顺序。
GUI 定位任务采用以下对话结构:
1. **system**:提供任务指令、原图元数据、`crop_image` 动作规范,以及原图 [0,1000] 归一化坐标下的 `[x.xx,y.yy]` 答案格式。
2. **user**:提供 `image_path: ...` 与原始截图。
3. **assistant**:输出可见的 `` 推理,再给出一个或两个独立的 `crop_image(...)` 动作块,或最终坐标。同批动作只能引用该轮开始前已有的图像。
4. **user**:按动作顺序统一返回裁剪结果,包括新图像路径与尺寸、父图和原图中的区域坐标,以及缩放后的裁剪图像。
裁剪由 PIL 执行,使用 LANCZOS、4× 放大和 4M 像素上限;支持嵌套裁剪,并始终保留到原图坐标的明确映射。
5. 重复上述过程直至最终回答。总裁剪次数上限为 **3**,每轮上限为 **2**。
训练、SSPro 和 PerceptionBench 默认允许 **2** 轮格式纠正,训练中 `MAX_TURNS = 6`;HR-Bench 默认允许 **4** 轮纠正。各基准的默认差异保持不变。
示例:一次裁剪与最终定位坐标
```text
User: image_path: screenshot.png ← original screenshot
Assistant: small target, zoom in
crop_image(image_path="screenshot.png",
x1=560.00, y1=150.00, x2=844.00, y2=240.00)
User: crop result (resized crop + metadata + mapping)
Assistant: found it
[798.23,457.17] ← final point, [0,1000] on the ORIGINAL image
```
实现范围与相关工作
**实现范围。** 一轮助手回复最多包含两个独立裁剪动作,其结果通过同一条用户消息返回;实际裁剪顺序执行。
路径由本地执行器解析,作为明确的图像引用;图像内容也会一并提供给模型。
[PerceptionBench 问答接口](./evaluation/perceptionbench/eval_perceptionbench_agentic.py)已支持多张原始图像。
GUI 训练与定位评测从单张原图开始;若扩展为多张原图,需要相应定义任务、答案和奖励。
当前结果未单独分析多图任务的性能。
**研究背景。** [DeepEyes](https://arxiv.org/abs/2505.14362) 和 [Pixel Reasoner](https://arxiv.org/abs/2505.15966)研究通过 RL 学习视觉工具使用;[Visual Sketchpad](https://arxiv.org/abs/2406.09403) 和 [PyVision](https://arxiv.org/abs/2507.07998)支持通过代码灵活处理视觉信息。
本项目将明确的图像引用、坐标映射与批量动作整合为 GUI 定位训练和视觉感知评测共用的接口。
已有轨迹展示了这些能力;各能力的独立作用仍需通过受控消融实验分析。
### 训练:基于裁剪轨迹的 GRPO
- 自定义 `MultiTurnScheduler` 在 vLLM rollout 服务内驱动多轮对话,由训练器计算**轨迹级 GRPO 优势值**。
- **五项奖励**包括四项确定性几何奖励,以及可选的推理质量 LLM 评判奖励:
| 奖励 | 类型 | 信号 |
|---|---|---|
| `zoomin_accuracy` | ORM | 最终点是否位于真值框内(0/1),作为主要结果信号 |
| `zoomin_crop_process_gated` | ORM | 由最终结果门控的最佳裁剪 IoU,减去重复/无改进惩罚及每次调用成本(默认 0.05) |
| `zoomin_format` | ORM | 最终助手轮次的协议遵循情况 |
| `zoomin_zoom_bonus` | ORM | 对困难样本中通过有效放大获得的正确答案给予额外奖励 |
| `zoomin_cot_rm` | AsyncORM | 可选的纯文本轨迹 CoT 评判分数,通过**正确性门控**抑制奖励作弊;支持兼容 OpenAI 的服务,未配置时跳过请求并使用中性分数 |
- **轮次级损失塑形**:启发式 PRM 过滤和不确定性(熵)过滤屏蔽低价值的中间决策轮次;各助手轮次保留原始 rollout token,用于重要性采样校正。
- **工程稳健性**:清理 NaN/Inf 输出,通过 base64 数据 URI 传输裁剪图像(rollout 与训练节点无需共享文件系统),并支持多种动作表达形式的容错解析。
### 评测:固定协议与本地服务
评测工具通过本地 `vllm serve` 兼容 OpenAI 的接口,在四个基准上评测训练检查点,各阶段均支持检查点续跑:
| 评测基准 | 规模 | 评判方式 | 主要指标字段 |
|---|---|---|---|
| ScreenSpot-Pro | 1581 | 本地几何判定(点是否落入框内) | `sspro.json → metrics.overall.action_acc` |
| OS-World-G (Refine) | 564 (510 正向任务 + 54 拒绝任务) | 本地判定及拒绝行为统计 | `osworld.json → metrics.overall.action_acc` |
| PerceptionBench | 3000 | LLM 评判(通过环境变量配置兼容 OpenAI 的服务) | `perceptionbench_scores.json → overall` |
| HR-Bench 4K / 8K | 每个划分 800 | 严格选项匹配 | `hrbench.json → splits.HRBench4K.strict_accuracy` / `splits.HRBench8K.strict_accuracy` |
## 训练数据与 rollout 记录
仓库同时提供**训练输入样例**和**真实 GRPO 训练中保存的 rollout 轨迹**:
| 样例 | 样本数 | 独立原图数 | 内容 |
|---|---:|---:|---|
| [GRPO 训练输入](./agentic_gui_grounding_rl/data_samples/grpo_train_prompts/train_prompts_head8.jsonl) | 8 | 8 | 仅含提示的样例,包含任务指令、截图引用及奖励计算所需的真值框。 |
| [训练 rollout 记录](./agentic_gui_grounding_rl/data_samples/rollout_trajectories/rollout_trajectories_head32.jsonl) | 32 | 4 | 多轮推理、裁剪动作及反馈、最终回答、奖励与 GRPO 优势值。 |
**32 个 rollout = 4 条不同提示 × 每条提示 8 次生成**,取自训练第 1 步。
每组共享一张原始截图,因此 `originals/` 目录包含 **4** 张图像。
JSONL 内有 32 条独立对话记录:`prompt_group` 标识四组提示,`generation` 在每组内从 0 到 7 编号,可用于比较同一任务下的观察决策、奖励和优势值。
模型文本与训练数值来自保存的训练日志,并进行了已说明的脱敏处理。
47 张裁剪图像依据记录的几何信息,使用训练协议离线重建。
数据格式、来源和加载方式参见[样例指南](./agentic_gui_grounding_rl/data_samples/README.md)。
## 仓库结构
```text
├── agentic_gui_grounding_rl/ # GRPO recipe, plugin, and real training samples
├── evaluation/ # Four-benchmark evaluation kit
│ ├── common/ # Shared text-action pipeline
│ ├── sspro/ # ScreenSpot-Pro and OS-World-G (Refine)
│ ├── perceptionbench/ # VQA pipeline and judge
│ ├── hrbench/ # MCQ evaluation and strict scoring
│ └── scripts/ # Data preparation, serving, and runners
├── benchmark_results/ # Full metrics/scores; 100 selected trajectories
├── docs/ # Judge notes, verified cases, and figure assets
├── scripts/ # Offline publication tools; optional for training/evaluation
├── tests/ # Offline evaluation completion/resume/shard regressions
├── AGENTS.md # Contributor and agent instructions
└── LICENSE / NOTICE # Apache-2.0 and third-party attribution
```
下载的完整基准数据和原始运行产物仅保留在本地,不进入 Git 或发布包。
精选发布结果与运行时输出目录相互独立。各组件的详细用法请参阅对应 README。
### 运行与发布脚本
训练入口为 `agentic_gui_grounding_rl/train_zoomin_grounding_grpo.sh`;评测、服务启动、数据准备与汇总入口位于 `evaluation/scripts/`。
训练与评测流程均不调用根目录 `scripts/` 下的工具。以下六个离线工具用于复现或检查发布资料:
| 根目录脚本 | 用途及与评测的关系 |
|---|---|
| `export_release.py` | 导出已有指标、逐样本得分与经脱敏选取的轨迹,不执行推理或修改评分。 |
| `validate_release.py` | 检查发布资料与样例文件;可选对比已保存指标,并使用当前评测器重放评分。 |
| `render_metric_tables.py` | 依据已有评测指标和得分生成或检查 README 表格。 |
| `render_benchmark_overview.py` | 依据已有总体得分与固定的公开参考结果生成介绍页柱状图。 |
| `render_trajectories.py` | 使用评测裁剪执行器重建已核验的裁剪区域并生成图示。 |
| `export_trajectory_html.py` | 导出交互式查看器;图片再生成沿用已核验的裁剪重建流程。 |
`tests/test_runtime_contracts.py` 使用本地模型桩验证评测失败与续跑、报告完整性、PB 分片兼容性以及包装脚本配置,无需在线模型或 GPU。
参见[离线检查说明](./docs/RELEASE_VALIDATION.md)。
## 安装
检出 `LBS` 分支,并创建评测客户端环境:
```bash
git clone --branch LBS --single-branch https://github.com/inclusionAI/UI-Venus.git
cd UI-Venus
python3 -m venv .venv
source .venv/bin/activate
python3 -m pip install -r evaluation/requirements.txt
```
评测客户端需要 Python 3.10 或更高版本,无需训练框架。
训练与模型服务需要单独配置兼容的 ms-swift/vLLM 环境,并根据模型、图像分辨率、上下文长度和 rollout 配置准备足够的设备内存。
在训练环境中安装依赖:
```bash
python3 -m pip install ms-swift vllm deepspeed pillow qwen-vl-utils
python3 -m pip install openai # only for the optional CoT judge reward
```
## 快速开始
从仓库根目录出发,并使用对应环境。训练和评测可以独立使用;下面的服务启动与评测步骤假设已有检查点。
### 1. 训练:单节点冒烟测试
训练组件提供 8 条样例,用于安装训练依赖并配置好 Qwen3.8-27b SFT 检查点后的冒烟测试。
`/models/qwen3.8-27b-sft` 是冷启动 SFT 检查点的示例本地路径,用作 Agentic RL 的初始化。
请按实际硬件调整设备拓扑:
```bash
(
cd agentic_gui_grounding_rl
MODEL_PATH=/models/qwen3.8-27b-sft NNODES=1 VLLM_TP=1 \
bash train_zoomin_grounding_grpo.sh
)
```
正式训练时,通过 `DATASETS` 环境变量提供自己的 JSONL 数据:
`{"problem": "...", "solution": "[x1,y1,x2,y2]", "images": ["a.png"]}`。
使用 `NNODES`、`NODE_RANK` 和 `ROLLOUT_NNODES` 配置多节点拓扑,参见脚本开头说明与[训练 README](./agentic_gui_grounding_rl/README.md)。
### 2. 启动检查点服务
使用在 Qwen3.8-27b 上经过 SFT 与 Agentic RL 后得到的 LBS 检查点。
以下 `/path/to/checkpoint` 表示其本地目录。
```bash
cd evaluation
bash scripts/serve_vllm.sh start /path/to/checkpoint --name evaluated-model --tp 4 --dp 1 --daemon
cp .env.example .env.run
# Set OPENAI_BASE_URL and MODEL to match the running service.
# Use the model ID from /v1/models; .env.vllm.evaluated-model records this service.
# Configure JUDGE_API_KEY, JUDGE_BASE_URL, and JUDGE_MODEL for PerceptionBench.
bash scripts/fetch_data.sh all
```
### 3. 运行四项评测
继续在 `evaluation/` 目录下操作,并完成 `.env.run` 配置。
并发应匹配服务容量;PerceptionBench 的总并发为 `PB_NUM_SHARDS * PB_SHARD_CONCURRENCY`。
```bash
bash scripts/run_all.sh .env.run results/run-name # full chain, serial
# or individually:
bash scripts/run_sspro.sh .env.run results/run-name
bash scripts/run_osworld.sh .env.run results/run-name
bash scripts/run_perceptionbench.sh .env.run results/run-name 8
bash scripts/run_hrbench.sh .env.run results/run-name
```
中断后,使用相同配置重新执行相同命令即可续跑;修改配置时请使用新的结果目录。
PerceptionBench 可以先保存预测,再进行评判:设置 `PB_SKIP_JUDGE=1 FINALIZE=0 CLEAN_INTERMEDIATES=0`,
随后对每个保留分片重新评判,并使用 `--keep-shards` 完成汇总。
冒烟测试、结果文件与故障排查参见[评测 README](./evaluation/README.md)。
### 4. 使用兼容 OpenAI 的客户端推理
训练完成后可通过 vLLM 提供模型服务,并使用 OpenAI SDK 驱动交互。
客户端解析回复中的 `crop_image(...)`,调用 `zoomin_grounding_protocol.execute_crop` 执行裁剪;
也可让 ms-swift rollout 服务执行多轮循环。
首轮请求示例与裁剪循环说明见[训练 README](./agentic_gui_grounding_rl/README.md#serving--inference-openai-compatible-endpoints)。
## 数据与使用范围
仓库中的评测数据片段仅用于展示已记录的评测结果和观察轨迹,不作任何其他用途。
原有权属、协议及使用条款保持不变;仓库的 Apache-2.0 软件协议不改变这些材料的原有协议。
来源见 [NOTICE](./NOTICE) 和[轨迹说明](./docs/TRAJECTORIES.md)。
- **训练样例**(`agentic_gui_grounding_rl/data_samples/`):真实训练中的 8 条仅含提示的 GRPO 输入与 32 条完整多轮轨迹(4 条提示 × 8 次生成),经过脱敏,可由 ms-swift 或兼容 OpenAI 的客户端加载。截图保留原有权属和条款。
- **评测数据**:ScreenSpot-Pro、OS-World-G(Refine)、PerceptionBench 和 HR-Bench 属于第三方基准,其原有协议和使用条款保持不变。
完整数据另行下载到被 Git 忽略的 `evaluation/data/` 目录。请从官方来源获取并核验:
```bash
pip install -U "huggingface_hub[cli]" # only needed for fetching
cd evaluation
scripts/fetch_data.sh all # download (~11G) + convert + verify
```
| 评测基准 | 官方来源 | 规模 |
|---|---|---|
| ScreenSpot-Pro | [HF likaixin/ScreenSpot-Pro](https://huggingface.co/datasets/likaixin/ScreenSpot-Pro) | ~3.2G |
| OS-World-G (Refine) | [GitHub xlang-ai/OSWorld-G](https://github.com/xlang-ai/OSWorld-G) | ~130M |
| PerceptionBench | [HF moonshotai/PerceptionBench](https://huggingface.co/datasets/moonshotai/PerceptionBench) | ~1.6G |
| HR-Bench | [HF DreamMr/HR-Bench](https://huggingface.co/datasets/DreamMr/HR-Bench) | ~6.5G |
数据核验依据评测工具已验证快照的**字节级与内容级校验记录**:`scripts/data_manifest.sha256` 覆盖 2211 项文件检查,
另由 `scripts/data_manifest_hrbench_tasks_{4k,8k}.json` 核对 HR-Bench 任务。
HR-Bench 清单包含构建时来源信息,因此其 800×2 条任务按内容深度比较。
`scripts/fetch_data.sh` 自动执行核验;下载中断后重新执行相同命令即可续传。
## 协议
仓库软件与两个组件统一使用根目录的 [Apache-2.0 协议](./LICENSE)。
发布分支为 [inclusionAI/UI-Venus](https://github.com/inclusionAI/UI-Venus) 中的 `LBS`。
已有源码版权声明保持不变;verl 训练方案与 PerceptionBench 改编内容的归属见 [NOTICE](./NOTICE)。
基准数据、截图内容和图像片段保留原有权属与条款,软件协议不对其重新授权。
仓库中的评测片段仅用于结果与轨迹展示,参见[数据使用范围](./docs/LICENSE_AUDIT.md)。
## 致谢
本项目基于以下工作,感谢相关团队与作者:
- [ms-swift](https://github.com/modelscope/ms-swift) 与 [vLLM](https://github.com/vllm-project/vllm) 提供 RL 训练与 rollout 基础能力,同时感谢 Venus 团队的支持。
- [ScreenSpot-Pro](https://github.com/likaixin2000/ScreenSpot-Pro-GUI-Grounding)、OS-World-G(Refine)、PerceptionBench 和 HR-Bench 的作者提供评测基准。
- [Qwen 团队](https://github.com/QwenLM) 提供 Qwen3.8-27b,作为 SFT 与 Agentic RL 的基础模型。
## 引用
引用信息将在 arXiv 发布后补充。