## Hive实战
### Hive概述
[Hive](https://hive.apache.org/) 是 Facebook 开源的一款基于 Hadoop 的数据仓库工具,目前由 Apache 软件基金会维护,它是应用最为广泛的大数据解决方案。简单的说,Hive 能将 SQL 查询转变为 MapReduce 或 Spark 任务,对 SQL 提供了完美的支持,能够非常方便的实现大数据统计,让不会使用 Java、Scala 语言的人也可以玩转大数据平台和分布式文件系统,实现对数据的存储和处理。

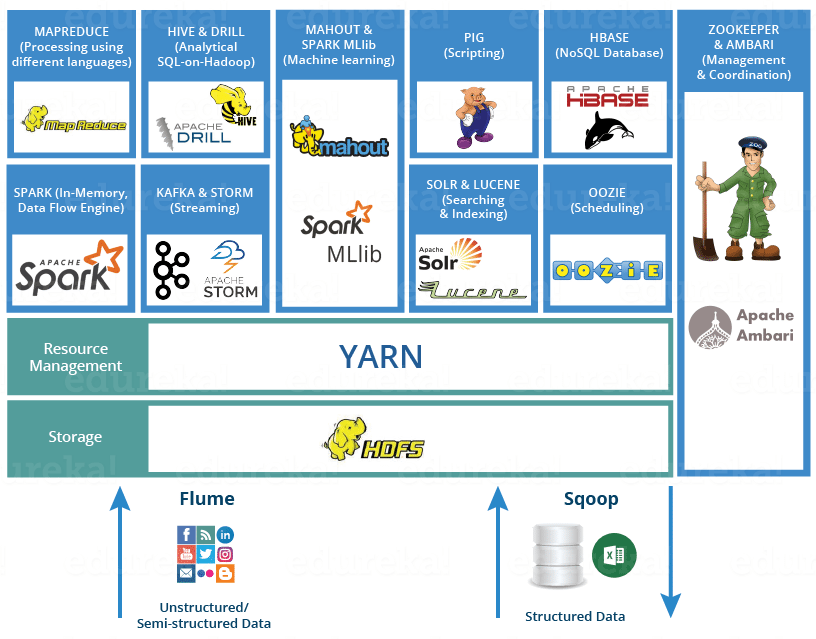 Hive 的主要作用包括:
1. 将结构化的数据文件映射为一张表。
2. 提供类 SQL 的查询语言 HiveQL来操作大规模数据。
3. 底层依赖 Hadoop 的 HDFS 存储和 MapReduce / Spark / Tez 引擎执行任务。
Hive 的特点如下所示:
1. 类 SQL 语法:支持 SQL 查询,降低大数据学习门槛。
2. 可扩展性:能够比较容易的支持 PB 级别数据。
3. 灵活存储:支持多种存储格式(Text、ORC、Parquet、Avro 等)。
4. 可选择的计算引擎:底层执行引擎有 MapReduce、Tez、Spark。
5. 延迟较高:适合离线分析,不适合低延迟 OLTP 查询。
Hive 和传统关系型数据库的对比:
 ### 环境搭建
#### 准备工作
> **说明**:下面的操作以 Ubuntu 系统为例。
1. 同步时区
```bash
sudo timedatectl set-timezone Asia/Shanghai
```
2. 修改下载源
```bash
sudo mv /etc/apt/sources.list /etc/apt/sources.list.bak
sudo vi /etc/apt/sources.list
```
```shell
# 24.04 /etc/apt/sources.list
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ focal main restricted universe multiverse
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ focal-updates main restricted universe multiverse
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ focal-backports main restricted universe multiverse
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ focal-security main restricted universe multiverse
```
```shell
# 18.04 /etc/apt/sources.list
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic main restricted universe multiverse
deb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic main restricted universe multiverse
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-updates main restricted universe multiverse
deb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-updates main restricted universe multiverse
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-backports main restricted universe multiverse
deb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-backports main restricted universe multiverse
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-security main restricted universe multiverse
deb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-security main restricted universe multiverse
deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-proposed main restricted universe multiverse
deb-src https://mirrors.tuna.tsinghua.edu.cn/ubuntu/ bionic-proposed main restricted universe multiverse
```
3. 安装工具软件
```bash
sudo apt update
sudo apt upgrade
sudo apt install -y vim wget net-tools openssh-server
```
4. 启动 SSH
```bash
sudo systemctl start ssh
sudo systemctl enable ssh
sudo systemctl status ssh
```
5. 配置防火墙
```bash
sudo ufw enable
sudo ufw allow ssh
sudo ufw status
sudo ufw disable
```
6. 准备 Hadoop
```bash
wget https://archive.apache.org/dist/hadoop/common/stable2/hadoop-2.10.2.tar.gz
sudo tar -zxvf hadoop-2.10.2.tar.gz -C /opt
```
7. 准备 Hive
```bash
wget https://archive.apache.org/dist/hive/stable-2/apache-hive-2.3.9-bin.tar.gz
sudo tar -zxvf apache-hive-2.3.9-bin.tar.gz -C /opt
```
#### Java 环境
1. 检查
```bash
java -version
```
2. 搜索
```bash
sudo apt search openjdk
```
3. 安装
```
sudo apt install -y openjdk-8-jdk
```
#### MySQL 环境
1. 安装
```bash
sudo apt install mysql-server
```
2. 配置
```bash
mysql_secure_installation
```
3. 启动
```bash
sudo systemctl enable mysql
sudo systemctl start mysql
sudo systemctl status mysql
```
#### Hadoop 配置
> **提示**:详见 PDF 文档。
#### Hive 配置
> **提示**:详见 PDF 文档。
#### 启动环境
1. 启动 HDFS
```bash
start-dfs.sh
start-yarn.sh
```
2. 启动 Hive
```bash
hive --service metastore &
hive --service hiveserver2 > hiveserver2.log 2> hiveerrors.log &
```
3. 检查端口
```bash
ss -ntl
netstat -ntlp
### 常用命令
| 命令 | 用途说明 |
| -------------------------------------------------- | --------------------------------------------------- |
| `hadoop fs -ls ` | 列出目录内容,类似 Linux `ls` |
| `hadoop fs -ls -R ` | 递归列出目录下所有文件 |
| `hadoop fs -du ` | 显示文件或目录大小(非递归) |
| `hadoop fs -du -s ` | 汇总显示目录总大小 |
| `hadoop fs -du -h ` | 以可读格式(KB/MB/GB)显示文件大小 |
| `hadoop fs -COUNT ` | 统计目录下的文件数、目录数、总字节数 |
| `hadoop fs -mkdir ` | 创建目录 |
| `hadoop fs -mkdir -p ` | 递归创建多级目录 |
| `hadoop fs -rm ` | 删除文件 |
| `hadoop fs -rm -r ` | 递归删除目录 |
| `hadoop fs -copyFromLocal ` | 从本地复制文件到 HDFS |
| `hadoop fs -moveFromLocal ` | 从本地移动文件到 HDFS(复制后删除本地文件) |
| `hadoop fs -copyToLocal ` | 从 HDFS 复制文件到本地 |
| `hadoop fs -moveToLocal ` | 从 HDFS 移动文件到本地(复制后删除 HDFS 文件) |
| `hadoop fs -put ` | 等价于 `-copyFromLocal`,上传文件 |
| `hadoop fs -get ` | 等价于 `-copyToLocal`,下载文件 |
| `hadoop fs -getmerge ` | 合并 HDFS 目录下的文件,保存到本地单一文件 |
| `hadoop fs -cat ` | 输出文件内容到标准输出(适合查看小文件) |
| `hadoop fs -tail ` | 显示文件结尾的部分内容 |
| `hadoop fs -text ` | 以文本方式查看压缩文件(如 Gzip、SequenceFile)内容 |
| `hadoop fs -appENDToFile ` | 将本地文件内容追加到 HDFS 文件末尾 |
| `hadoop fs -cp ` | 在 HDFS 内部复制文件或目录 |
| `hadoop fs -mv ` | 在 HDFS 内部移动/重命名文件或目录 |
| `hadoop fs -chown ` | 修改文件或目录的所有者和用户组 |
| `hadoop fs -chgrp ` | 修改文件或目录所属用户组 |
| `hadoop fs -chmod ` | 修改文件或目录权限,类似 Linux `chmod` |
| `hadoop fs -stat ` | 显示文件或目录状态信息(如大小、修改时间) |
| `hadoop fs -expunge` | 清空 HDFS 垃圾回收站(TrASh) |
| `hadoop fs -checkSUM ` | 计算文件的校验和 |
### 基本语法
1. 删除数据库。
```hive
DROP DATABASE IF EXISTS eshop CASCADE;
```
2. 创建数据库。
```hive
CREATE DATABASE IF NOT EXISTS eshop;
```
3. 切换上下文。
```hive
USE eshop;
```
4. 创建外部表。
```hive
CREATE EXTERNAL TABLE IF NOT EXISTS dim_user_info
(
user_id STRING,
user_name STRING,
sex STRING,
age INT,
city STRING,
first_active_time STRING,
level INT,
extra1 STRING,
extra2 MAP
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
COLLECTION ITEMS TERMINATED BY ','
MAP KEYS TERMINATED BY ':'
LINES TERMINATED BY '\n'
STORED AS TEXTFILE;
5. 加载数据。
```hive
LOAD DATA LOCAL INPATH '/home/hadoop/data/user_info/user_info.txt' OVERWRITE INTO TABLE dim_user_info;
```
```hive
LOAD DATA INPATH '/user/data/user_info.txt' OVERWRITE INTO TABLE dim_user_info;
```
6. 创建分区表。
```hive
CREATE TABLE IF NOT EXISTS fact_user_trade
(
user_name STRING,
piece INT,
price DOUBLE,
pay_amount DOUBLE,
goods_category STRING,
pay_time BIGINT
)
PARTITIONED BY (dt STRING)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
LINES TERMINATED BY '\n'
STORED AS TEXTFILE;
```
7. 设置动态分区。
```hive
-- 设置使用动态分区
SET hive.exec.dynamic.partition=true;
-- 设置动态分区为非严格模式(严格模式至少要指定一个动态分区列)
SET hive.exec.dynamic.partition.mode=nonstrict;
-- 一次SQL操作最多能创建多少个动态分区(跨节点)
SET hive.exec.max.dynamic.partitions=1000;
-- 每个节点上最多能创建多少个动态分区
SET hive.exec.max.dynamic.partitions.pernode=10000;
```
8. 修复分区。
```hive
MSCK REPAIR TABLE fact_user_trade;
```
9. 数据提取。
```hive
-- 开启本地模式自动判断
SET hive.exec.mode.local.auto=true;
-- 设置MAPREDUCE文件数量
SET hive.exec.mode.local.auto.input.files.max=128;
-- 设置MAPREDUCE文件大小
SET hive.exec.mode.local.auto.input.bytes.max=134217728;
-- 设置Reduce任务个数为1
SET mapreduce.job.reduces=1;
-- 查询北京女用户的姓名取前10个
SELECT user_name
FROM dim_user_info
WHERE city='beijing'
AND sex='female'
LIMIT 10;
-- 查询2019年3月24日购买了food类商品的用户名、购买数量和支付金额(不聚合)
SELECT user_name
, piece
, pay_amount
FROM fact_user_trade
WHERE dt='2019-03-24'
AND goods_category='food';
-- 统计用户 ELLA 在2018年的总支付金额和最近最远两次消费间隔天数
SELECT SUM(pay_amount) AS total
, DATEDIFF(
MAX(FROM_UNIXTIME(pay_time, 'yyyy-MM-dd')),
MIN(FROM_UNIXTIME(pay_time, 'yyyy-MM-dd'))
) AS gap_days
FROM fact_user_trade
WHERE YEAR(dt)='2018'
AND user_name='ELLA';
```
10. 分组聚合。
```hive
-- 查询2019年1月到4月,每个品类有多少人购买,累计金额是多少
SELECT goods_category
, COUNT(DISTINCT user_name) AS total_user
, SUM(pay_amount) AS total_pay
FROM fact_user_trade
WHERE dt BETWEEN '2019-01-01' AND '2019-04-30'
GROUP BY goods_category;
-- 查询2019年4月支付金额超过5万元的用户
SELECT user_name
, SUM(pay_amount) AS total
FROM fact_user_trade
WHERE dt BETWEEN '2019-04-01' AND '2019-04-30'
GROUP BY user_name
HAVING SUM(pay_amount) > 50000;
-- 查询2018年购买的商品品类在两个以上的用户数
SELECT COUNT(t.user_name)
FROM (SELECT user_name
, COUNT(DISTINCT goods_category) AS total
FROM fact_user_trade
WHERE YEAR(dt)='2018'
GROUP BY user_name
HAVING COUNT(DISTINCT goods_category)>2) AS t;
-- 查询2019年4月支付金额最多的用户前5名
SELECT user_name
, SUM(pay_amount) AS total
FROM fact_user_trade
WHERE dt BETWEEN '2019-04-01' AND '2019-04-30'
GROUP BY user_name
ORDER BY total DESC
LIMIT 5;
-- 统计不同年龄段的用户数
SELECT CASE WHEN age < 20 THEN '20岁以下'
WHEN age < 30 THEN '30岁以下'
WHEN age < 40 THEN '40岁以下'
ELSE '40岁以上'
END AS age_seg,
COUNT(DISTINCT user_id) AS total
FROM dim_user_info
GROUP BY CASE WHEN age < 20 THEN '20岁以下'
WHEN age < 30 THEN '30岁以下'
WHEN age < 40 THEN '40岁以下'
ELSE '40岁以上'
END;
-- 统计激活时间在2018年,年龄段在20-30岁、30-40岁的用户婚姻状况
SELECT age_seg,
IF(marriage_status = 1, '已婚', '未婚') AS marriage_status,
COUNT(*) AS total
FROM (SELECT CASE WHEN age < 20 THEN '20岁以下'
WHEN age < 30 THEN '20-30岁'
WHEN age < 40 THEN '30-40岁'
ELSE '40岁以上'
END AS age_seg,
extra2['marriage_status'] AS marriage_status
FROM dim_user_info
WHERE TO_DATE(first_active_time) BETWEEN '2018-01-01' AND '2018-12-31'
) AS t
WHERE age_seg in ('20-30岁', '30-40岁')
GROUP BY age_seg, IF(marriage_status = 1, '已婚', '未婚');
-- 统计每个用户购买过哪些品类的商品
SELECT user_name,
COLLECT_SET(goods_category) AS categories
FROM fact_user_trade
GROUP BY user_name;
-- 将数组拼接成字符串
SELECT user_name
, CONCAT_WS(', ', COLLECT_SET(goods_category)) AS categories
FROM fact_user_trade
GROUP BY user_name;
-- 将数据聚合成映射类型(map)
SELECT user_name
, STR_TO_MAP(CONCAT_WS(',', COLLECT_LIST(CONCAT(goods_category, ':', cnt)))) AS category_cnt_map
FROM (SELECT user_name
, goods_category
, COUNT(*) AS cnt
FROM fact_user_trade
GROUP BY user_name, goods_category) AS t
GROUP BY user_name;
```
11. 数据抽样。
~~~hive
-- 数据抽样
SELECT *
FROM fact_user_trade
WHERE RAND() < 0.1;
SELECT *
FROM fact_user_trade
TABLESAMPLE(BUCKET 1 OUT OF 10 ON user_name);
-- 二进制存储支持(如ORC)
-- SELECT *
-- FROM fact_user_trade
-- TABLESAMPLE(BYTE 100M);
~~~
12. 横向展开。
```hive
-- 创建视图
CREATE OR REPLACE VIEW v_user_categories
AS
SELECT user_name
, COLLECT_SET(goods_category) AS categories
FROM fact_user_trade
WHERE dt BETWEEN '2019-04-01' and '2019-04-30'
GROUP BY user_name;
CREATE OR REPLACE VIEW v_user_categories_map
AS
SELECT user_name
, STR_TO_MAP(CONCAT_WS(',', COLLECT_LIST(CONCAT(goods_category, ':', cnt)))) AS category_cnt_map
FROM (SELECT user_name
, goods_category
, COUNT(*) AS cnt
FROM fact_user_trade
WHERE dt BETWEEN '2019-04-01' AND '2019-04-30'
GROUP BY user_name, goods_category) AS t
GROUP BY user_name;
-- 横向展开数组(array)
SELECT user_name
, category
FROM v_user_categories
LATERAL VIEW EXPLODE(categories) t AS category;
-- 横向展开映射(map)
SELECT user_name
, category
, cnt
FROM v_user_categories_map
LATERAL VIEW EXPLODE(category_cnt_map) t AS category, cnt;
```
### 建表操作
#### 数据类型
Hive 的数据类型大体分为三类:原始类型、复杂类型、嵌套类型。
| 数据类型 | 类型说明 | 使用场景 |
| ------------- | -----------------------------------------------------| ------------- |
| TINYINT | 1 字节有符号整数,取值范围 -128~127。 | |
| SMALLINT | 2 字节有符号整数,取值范围 -32768 ~ 32767。 | |
| INT | 4 字节有符号整数,取值范围 -2147483648~2147483647。 | |
| BIGINT | 8 字节有符号整数,取值范围 -9223372036854775808~9223372036854775807。 | 计数、ID |
| BOOLEAN | 布尔值,TRUE 或者 FALSE。 | |
| FLOAT | 单精度浮点数(4 字节)。 | |
| DOUBLE | 双精度浮点数(8 字节)。 | |
| DECIMAL(P, S) | 高精度小数,P=总位数,S=小数位数。 | 订单金额 |
| STRING | 长度可变字符串 | 文本、JSON |
| CHAR | 固定长度字符串 | |
| VARCHAR | 限定最大长度字符串 | |
| BINARY | 二进制数据 | |
| TIMESTAMP | 时间戳 | 精确到毫秒 |
| DATE | 日期 | |
| INTERVAL | 时间间隔类型 | |
| STRUCT | 和C语言中的结构体类似,`STRUCT` | 玩家行为 |
| MAP | 由键值对构成的元素的集合,`MAP` | 商品属性 |
| ARRAY | 具有相同类型的变量的容器,`ARRAY` | 装备列表 |
复杂类型和嵌套类型的用法如下所示。
```hive
CREATE TABLE complex
(
c1 ARRAY,
c2 MAP,
c3 STRUCT,
c4 STRUCT>>
);
SELECT c1[0]
, c2['key']
, c3.b
, c4.addrs[0].city
FROM complex;
```
Hive 数据类型支持两种转换:
1. 隐式转换:TINYINT → INT → BIGINT → DOUBLE → STRING、FLOAT → DOUBLE。
2. 显示转换:
```hive
SELECT CAST('123' AS INT);
SELECT CAST(3.14159 AS DECIMAL(5,2));
```
#### 表类型
Hive 中的表类型如下所示:
| 表类型 | 定义/创建方式 | 存储位置 | 生命周期 | 特点 | 应用场景 |
| ------------------------------ | ------------------------------------------------------------ | ------------------------------------------------------- | -------------------------------------------- | ------------------------------------------- | --------------------------------- |
| **内部表 (Managed Table)** | `CREATE TABLE t1 (id INT, name STRING); ` | 数据存放在 Hive 仓库目录下 (`/user/hive/warehouse/...`) | **表删除时数据也被删除** | Hive 全权管理元数据和数据 | 临时性数据、实验性数据 |
| **外部表 (External Table)** | `CREATE EXTERNAL TABLE t2 (id INT, name STRING) LOCATION '/data/t2'; ` | 数据存放在用户指定目录 | **表删除时数据保留**,只删除元数据 | 元数据和数据分离,便于共享 | 数据共享、避免误删、数据湖场景 |
| **分区表 (Partitioned Table)** | `CREATE TABLE sales (id INT, amount INT) PARTITIONED BY (dt STRING, region STRING); ` | 每个分区对应一个子目录 | 分区字段不存储在表数据文件里,而作为路径目录 | 提高查询效率(按分区裁剪数据) | 时间序列、地域划分、日志数据 |
| **分桶表 (Bucketed Table)** | `CREATE TABLE users (id INT, name STRING) CLUSTERED BY (id) INTO 8 BUCKETS; ` | 每个分桶对应一个文件 | 分桶数固定 | 数据按哈希分布到桶文件,便于采样、Join 优化 | 等值 Join、大表抽样、数据均衡分布 |
| **临时表 (Temporary Table)** | `CREATE TEMPORARY TABLE tmp (id INT); ` | 仅存在于当前会话内存中 | 会话结束后自动销毁 | 不会落盘,不更新 Hive 元数据 | 临时计算、会话级中间结果 |
| **视图 (View)** | `CREATE VIEW v1 AS SELECT ...; ` | 不存储数据,只存元数据定义 | 与底层表绑定 | 类似虚拟表 | 数据安全、SQL 复用、封装复杂查询 |
#### 修饰符
创建表的时候可以使用的修饰符如下:
| 关键字 | 作用 | 写了时的效果 | **不写时的默认值** |
| ----------------------------------- | ------------------ | ------------------------------------------------------------ | ------------------------------------------------------------ |
| **EXTERNAL** | 指定外部表 | `CREATE EXTERNAL TABLE ... LOCATION ...` → 表和数据分离,删表不删数据 | **内部表 (Managed Table)**,删表时数据目录会一起删除 |
| **PARTITIONED BY** | 定义分区字段 | `PARTITIONED BY (dt STRING, city STRING)` → 数据写到子目录 `/table/dt=2025-08-26/city=Beijing/` | **非分区表**,所有数据放在一个目录下 |
| **CLUSTERED BY ... INTO N BUCKETS** | 分桶 | `CLUSTERED BY (user_id) INTO 8 BUCKETS` → 数据按哈希分布到 8 个文件桶 | **不分桶**,数据就是普通文件 |
| **STORED AS** | 文件存储格式 | 常用:`TEXTFILE`、`SEQUENCEFILE`、`ORC`、`PARQUET` | **TEXTFILE**(文本文件) |
| **ROW FORMAT** | 指定行格式和 SerDe | 比如 `ROW FORMAT DELIMITED FIELDS TERMINATED BY ','` 或 `ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.JsonSerDe'` | **LazySimpleSerDe**(默认分隔符 `\001`,就是不可见的 Ctrl+A) |
| **LOCATION** | 指定 HDFS 路径 | `LOCATION '/user/hive/custom_path'` → 表数据存放到自定义路径 | 默认放到 **仓库目录**:`/user/hive/warehouse/.db/
/` |
| **TBLPROPERTIES/DBPROPERTIES** | 存储一些元数据属性 | `TBLPROPERTIES ('creator'='Hao')` | **空**,除非手动添加 |
| **COMMENT** | 表/字段备注 | `COMMENT '用户交易事实表'` | **空** |
#### ROW FORMAT
| 写法 | 说明 | 常见场景 |
| ------------------------------------------------------------ | ----------------- | ------------------- |
| `ROW FORMAT DELIMITED FIELDS TERMINATED BY ','` | 按分隔符解析 | CSV/TSV/文本 |
| `ROW FORMAT DEFAULT` | 默认格式,同下 | CSV/TSV/文本 |
| `ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.LazySimpleSerDe'` | 默认 SerDe,同上 | 文本表(\001 分隔) |
| `ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OpenCSVSerde'` | 更智能的 CSV 解析 | 有引号/转义的 CSV |
| `ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'` | 用正则匹配行 | 日志类数据 |
| `ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.JsonSerDe'` | JSON 格式解析 | JSON 文件 |
| `ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.AvroSerDe'` | Avro 格式 | JSON + 二进制压缩 |
| `ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.ParquetHiveSerDe'` | Parquet 格式 | Parquet 数据 |
| `ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OrcSerde'` | ORC 格式 | ORC 数据 |
> **说明**:只有使用**非默认格式(CSV/JSON/Regex)** 时才需要显式指定 SERDE。
### 写入数据
| 写入方式 | 示例语法 | 特点 | 适用场景 |
| ------------------------------------- | ------------------------------------------------------------ | ----------------------------------------------------- | --------------------------------------- |
| **INSERT INTO** | `INSERT INTO TABLE sales PARTITION (dt='2025-08-26') SELECT * FROM tmp_sales; ` | 向表/分区 **追加数据**,不会覆盖原有内容 | 日常数据追加写入(日志、交易流水) |
| **INSERT OVERWRITE** | `INSERT OVERWRITE TABLE sales PARTITION (dt='2025-08-26') SELECT * FROM tmp_sales; ` | 覆盖目标表/分区的数据(先删后写) | 周期性全量刷新数据(如 T+1 日报、月报) |
| **LOAD DATA** | `LOAD DATA INPATH '/user/hadoop/data.txt' INTO TABLE sales; ` | **移动文件**到 Hive 表目录(不做解析),速度快 | 已有 HDFS 文件直接导入 Hive |
| **LOAD DATA LOCAL** | `LOAD DATA LOCAL INPATH '/home/user/data.txt' INTO TABLE sales; ` | 从 **本地文件系统**拷贝数据到 Hive 表 | 本地临时数据快速导入 |
| **CREATE TABLE AS SELECT (CTAS)** | `CREATE TABLE new_sales AS SELECT * FROM sales WHERE dt='2025-08-26'; ` | 新建表并写入查询结果,一步到位 | 生成中间表/派生表,数据探索 |
| **INSERT + Directory (写 HDFS)** | `INSERT OVERWRITE DIRECTORY '/tmp/export/' ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' SELECT * FROM sales; ` | 把查询结果写到 **HDFS 目录**,可指定分隔符/格式 | 数据导出,和其他系统交互 |
| **INSERT + LOCAL Directory (写本地)** | `INSERT OVERWRITE LOCAL DIRECTORY '/home/user/export/' ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' SELECT * FROM sales; ` | 把结果写到 **本地目录** | 小规模结果导出,本地分析 |
| **外部表写入 (External Table)** | `CREATE EXTERNAL TABLE ext_sales (...) LOCATION '/data/sales'; ` | 外部表只管理元数据,实际写入依赖 `LOAD DATA`/`INSERT` | 共享数据目录,防止误删 |
| **动态分区写入** | `SET hive.exec.dynamic.partition=true;` `SET hive.exec.dynamic.partition.mode=nonstrict;` `INSERT OVERWRITE TABLE sales PARTITION (dt) SELECT id, amount, dt FROM tmp; ` | 自动根据字段值生成分区目录 | 大规模分区表装载数据 |
### 常用函数
#### 数学函数 (Math Functions)
| 函数 | 说明 | 示例 |
| -------------------------- | ------------------------ | -------------------------- |
| `abs(x)` | 绝对值 | `abs(-10) = 10` |
| `round(x[, d])` | 四舍五入,d 为保留小数位 | `round(3.14159, 2) = 3.14` |
| `floor(x)` | 向下取整 | `floor(3.9) = 3` |
| `ceil(x)` | 向上取整 | `ceil(3.1) = 4` |
| `rand()` | 生成 [0,1) 随机数 | `rand()` |
| `pow(x, y)` / `power(x,y)` | 幂运算 | `pow(2,3) = 8` |
| `sqrt(x)` | 开平方 | `sqrt(16) = 4` |
| `exp(x)` | e^x | `exp(1) ≈ 2.718` |
| `ln(x)` | 自然对数 | `ln(e) = 1` |
| `log10(x)` | 以 10 为底对数 | `log10(100) = 2` |
#### 字符串函数 (String Functions)
| 函数 | 说明 | 示例 |
| ----------------------------------- | ---------------- | ----------------------------------------------- |
| `length(str)` | 字符串长度 | `length('hive') = 4` |
| `upper(str)` | 转大写 | `upper('hive') = HIVE` |
| `lower(str)` | 转小写 | `lower('HIVE') = hive` |
| `concat(str1,str2,…)` | 拼接字符串 | `concat('hive','sql') = hivesql` |
| `concat_ws(sep,str1,str2,…)` | 用分隔符拼接 | `concat_ws('-', 'a','b','c') = a-b-c` |
| `substr(str, start, len)` | 截取子串 | `substr('hive',2,2) = iv` |
| `instr(str, substr)` | 返回子串位置 | `instr('hive','iv') = 2` |
| `split(str, regex)` | 字符串分割成数组 | `split('a,b,c',',') = ['a','b','c']` |
| `regexp_extract(str, pattern, idx)` | 正则提取 | `regexp_extract('abc123','([0-9]+)',1) = 123` |
| `regexp_replace(str, pattern, rep)` | 正则替换 | `regexp_replace('abc123','[0-9]','X') = abcXXX` |
| `trim(str)` | 去掉首尾空格 | `trim(' hi ') = hi` |
| `lpad(str,n,pad)` | 左填充到 n 长度 | `lpad('hi',5,'*') = ***hi` |
| `rpad(str,n,pad)` | 右填充到 n 长度 | `rpad('hi',5,'*') = hi***` |
#### 日期时间函数 (Date & Time Functions)
| 函数 | 说明 | 示例 |
| ---------------------------- | ---------------- | ----------------------------------------------------- |
| `current_date` | 当前日期 | `2025-09-15` |
| `current_timestamp` | 当前时间戳 | `2025-09-15 22:00:00` |
| `unix_timestamp()` | 当前时间戳(秒) | `1694784000` |
| `from_unixtime(ts, fmt)` | 时间戳转字符串 | `from_unixtime(1694784000,'yyyy-MM-dd') = 2025-09-15` |
| `to_date(str)` | 字符串转日期 | `to_date('2025-09-15 22:00:00') = 2025-09-15` |
| `year(dt)` | 提取年 | `year('2025-09-15') = 2025` |
| `month(dt)` | 提取月 | `month('2025-09-15') = 9` |
| `day(dt)` / `dayofmonth(dt)` | 提取日 | `day('2025-09-15') = 15` |
| `hour(ts)` | 提取小时 | `hour('2025-09-15 22:30:00') = 22` |
| `minute(ts)` | 提取分钟 | `minute('2025-09-15 22:30:00') = 30` |
| `second(ts)` | 提取秒 | `second('2025-09-15 22:30:00') = 0` |
| `datediff(dt1,dt2)` | 日期相差天数 | `datediff('2025-09-15','2025-09-10') = 5` |
| `add_months(dt,n)` | 日期加 n 月 | `add_months('2025-09-15',2) = 2025-11-15` |
| `date_add(dt,n)` | 日期加 n 天 | `date_add('2025-09-15',10) = 2025-09-25` |
| `date_sub(dt,n)` | 日期减 n 天 | `date_sub('2025-09-15',10) = 2025-09-05` |
#### 条件函数 (Conditional Functions)
| 函数 | 说明 | 示例 |
| ------------------------------------- | ---------------------- | ------------------------------------------------ |
| `if(cond, t, f)` | 条件判断 | `if(1=1,'yes','no') = yes` |
| `case when ... then ... else ... end` | 多条件判断 | `case when age>18 then 'adult' else 'child' end` |
| `coalesce(x1,x2,...)` | 返回第一个非 NULL 值 | `coalesce(null,'hive','sql') = hive` |
| `nvl(x, y)` | 如果 x 为 NULL,返回 y | `nvl(null,0) = 0` |
#### 聚合函数 (Aggregate Functions)
| 函数 | 说明 | 示例 |
| ----------------- | -------------- | --------------- |
| `count(*)` | 计数 | `count(*)` |
| `sum(x)` | 求和 | `sum(price)` |
| `avg(x)` | 平均值 | `avg(score)` |
| `max(x)` | 最大值 | `max(age)` |
| `min(x)` | 最小值 | `min(age)` |
| `collect_set(x)` | 去重集合 | `['a','b','c']` |
| `collect_list(x)` | 包含重复的集合 | `['a','b','a']` |
#### 类型转换函数 (Type Conversion Functions)
| 函数 | 说明 | 示例 |
| ----------------- | ------------ | -------------------------- |
| `cast(x AS type)` | 类型转换 | `cast('123' as int) = 123` |
| `typeof(x)` | 返回字段类型 | `typeof(123) = int` |
#### 复杂类型函数 (Complex Types)
| 函数 | 说明 | 示例 |
| ---------------------------- | -------------- | ------------------------------------------- |
| `size(array/map)` | 获取大小 | `size(array('a','b')) = 2` |
| `map_keys(map)` | 返回所有 key | `map_keys(map('a',1,'b',2)) = ['a','b']` |
| `map_values(map)` | 返回所有 value | `map_values(map('a',1,'b',2)) = [1,2]` |
| `sort_array(array)` | 数组排序 | `sort_array(array(3,1,2)) = [1,2,3]` |
| `array_contains(array, val)` | 是否包含元素 | `array_contains(array('a','b'),'a') = true` |
#### 窗口函数 (Window Functions)
常用于 **排名、累计计算、分组内计算**。
| 函数 | 说明 | 示例 |
| --------------------- | ------------------------ | ----------------------------------------------------------- |
| `row_number()` | 分组内行号 | `row_number() over(partition by dept order by salary desc)` |
| `rank()` | 排名(有并列,跳跃排名) | `rank() over(order by score desc)` |
| `dense_rank()` | 排名(有并列,不跳跃) | `dense_rank() over(order by score desc)` |
| `lag(col,n,default)` | 往前取第 n 行值 | `lag(salary,1,0) over(order by id)` |
| `lead(col,n,default)` | 往后取第 n 行值 | `lead(salary,1,0) over(order by id)` |
| `first_value(col)` | 分组内第一个值 | `first_value(salary) over(order by id)` |
| `last_value(col)` | 分组内最后一个值 | `last_value(salary) over(order by id)` |
| `sum(col) over(...)` | 窗口内累计和 | `sum(sales) over(partition by region order by month)` |
#### 应用举例
1. `FROM_UNIXTIME`:将时间戳转换成日期
```hive
SELECT FROM_UNIXTIME(pay_time, 'yyyy-MM-dd hh:mm:ss')
FROM fact_user_trade LIMIT 10;
```
3. `DATEDIFF`:计算两个日期的时间差
```Hive
-- 用户首次激活时间与设定参照时间的间隔
SELECT user_name, DATEDIFF('2019-4-1', to_date(firstactivetime))
FROM dim_user_info LIMIT 10;
```
4. `IF`:根据条件返回不同的值
```Hive
-- 不同性别高级等用户数量
SELECT sex
, IF(level > 5, '高', '低') AS level_type
, COUNT(DISTINCT user_id) AS total
FROM dim_user_info
GROUP BY sex, IF(level > 5, '高', '低');
```
4. `SUBSTR`:字符串取子串
```Hive
-- 统计每个月激活的新用户数
SELECT SUBSTR(first_active_time, 1, 7) AS month
, COUNT(DISTINCT user_id) AS total
FROM dim_user_info
GROUP BY substr(first_active_time, 1, 7);
```
6. `GET_JSON_OBJECT`:从 JSON 字符串中取出指定的`key`对应的`value`,如:`GET_JSON_OBJECT(info, '$.first_name')`。
```Hive
-- 统计不同手机品牌的用户数
SELECT GET_JSON_OBJECT(extra1, '$.phonebrand') AS phone
, COUNT(DISTINCT user_id) AS total
FROM user_info
GROUP BY GET_JSON_OBJECT(extra1, '$.phonebrand');
```
> **说明**:MySQL 对应的函数名字叫`JSON_EXTRACT`。
### 分组聚合
| 操作 | 示例语法 | 功能说明 | 结果特点 | 典型应用场景 |
| ----------------- | ------------------------------------------------------------ | ---------------------- | ------------------------------------------- | ------------------------ |
| **GROUP BY** | `SELECT region, product, SUM(amount) FROM sales GROUP BY region, product; ` | 按指定列分组 | 只输出 **一个维度组合** 的聚合 | 单维度或固定组合汇总 |
| **GROUPING SETS** | `SELECT region, product, SUM(amount) FROM sales GROUP BY GROUPING SETS ((region, product), (region), (product), ()); ` | 一次性指定多个分组组合 | 输出指定的 **多个维度组合结果**,可包含总计 | 报表统计时只关心部分组合 |
| **CUBE** | `SELECT region, product, SUM(amount) FROM sales GROUP BY CUBE(region, product); ` | 自动生成所有维度的组合 | 输出 **所有维度组合**(2^n 种) | OLAP 全量多维分析 |
### 抽样操作
| 抽样方式 | 语法示例 | 核心语义 | 是否随机 | 可重复性 | 精度/偏差 | 依赖前提 | 性能与注意点 | 典型用途 |
| ------------------------------------ | ------------------------------------------------------------ | ------------------------------------------------- | -------------- | --------------------------- | ------------------------- | -------------------------------------------- | ------------------------------------------ | ---------------------------- |
| **BUCKET 抽样(物理桶)** | `SELECT * FROM t TABLESAMPLE(BUCKET 2 OUT OF 8);` | 选取分桶表的**第2个物理桶**(总8桶) | 否 | 稳定(由分桶写入决定) | 与建表分桶分布一致 | 表必须是 **CLUSTERED BY ... INTO 8 BUCKETS** | 只读命中部分文件,快;但只在**分桶表**可用 | 大表等比例取样/一致性校验 |
| **BUCKET 抽样(逻辑桶)** | `SELECT * FROM t TABLESAMPLE(BUCKET 1 OUT OF 4 ON user_id);` | 按 `hASh(user_id)` 把数据映射到4个逻辑桶,取第1桶 | 伪随机(哈希) | 稳定(同 key 结果一致) | 近似 1/4,受 key 倾斜影响 | 无需分桶表 | 只扫命中行;分布受 key 倾斜影响 | 训练/评估集一致切分、AB 分流 |
| **概率抽样(Bernoulli)** | `SELECT * FROM t WHERE RAND() < 0.1;` | 按 10% 概率独立抽取每行 | 是 | 可用 `RAND(42)` 固定种子 | 期望10%,小样本波动大 | 无 | 全表扫描;易受数据量影响 | 快速下采样、探索性分析 |
| **按组固定样本数** | `SELECT * FROM (SELECT *, ROW_NUMBER() OVER(PARTITION BY gid ORDER BY RAND()) rn FROM t) x WHERE rn ≤ 100;` | 每组(`gid`)随机取 **固定 N 条** | 是 | 可用 `RAND(42)` | 各组样本量严格相等 | 需支持窗口函数 | 两次扫描+排序,成本中等 | 类均衡采样、按省份/品类取样 |
| **每组比例抽样** | `WHERE RAND() < CASE WHEN gid='A' THEN 0.2 ELSE 0.05 END` | 按组设定不同抽样率 | 是 | 可固定种子 | 期望比例,组内波动 | 无 | 全表扫描 | 不同业务线/权重抽样 |
| **LIMIT 截取(非随机)** | `SELECT * FROM t LIMIT 1000;` | 取前 N 行(非随机) | 否 | 稳定(受文件/分片顺序影响) | 有偏(非随机) | 无 | 最快;仅用于调试预览 | 开发调试、字段检查 |
| **每桶/每Reducer取 Top-N(非随机)** | `... DISTRIBUTE BY k SORT BY k LIMIT 100;`(或每组 `ROW_NUMBER`) | 每个分片/组取前 N | 否 | 稳定 | 有偏(按排序规则) | 需分发/排序 | 适合并行 TopN,不是随机抽样 | TopN per group、分片抽取 |
### 排序操作
| 排序方式 | 语法示例 | 核心语义 | Reducer 数 | 是否全局有序 | Shuffle/排序行为 | 性能与注意点 | 典型用途 |
| --------------------------- | --------------------------------------------------------- | ----------------------------------------------- | ---------------------- | --------------------------- | ------------------------------------------ | -------------------------------------------------------- | -------------------------- |
| **ORDER BY** | `SELECT * FROM t ORDER BY ts DESC;` | **全局排序** | **1 个**(单 reducer) | 是 | 所有数据进 1 个 reducer 做总排序 | 最慢;单点瓶颈;大结果易 OOM;适合小结果集或配合 `LIMIT` | 导出小结果、最终展示 |
| **ORDER BY … LIMIT** | `SELECT * FROM t ORDER BY score DESC LIMIT 1000;` | 全局 Top-N | 1 个 | 是 | 仍单 reducer,但 `LIMIT` 可提前剪枝 | 可接受;Top-N 常用写法 | 全局 Top-N |
| **SORT BY** | `SELECT * FROM t SORT BY ts DESC;` | **每个 reducer 内部排序**(局部有序) | 多个 | 否 | Map 输出按 key 分区到多 reducer;各自排序 | 快于 ORDER BY;结果整体**不全局有序** | 大表分片排序、并行导出 |
| **DISTRIBUTE BY** | `SELECT * FROM t DISTRIBUTE BY key;` | 控制**按 key 分发**到 reducer | 多个 | 否 | 相同 key 去同一 reducer;无排序 | 常与 SORT BY 搭配使用 | 为后续聚合/排序分区 |
| **DISTRIBUTE BY + SORT BY** | `SELECT * FROM t DISTRIBUTE BY key SORT BY key, ts DESC;` | **同 key 同分片 + 分片内排序** | 多个 | 否(但**每个 key 内有序**) | 同一 key 的记录在同一 reducer 内按规则有序 | 常用;利于下游 merge/sort-bASed 处理 | 按用户/商品时间序列排序 |
| **CLUSTER BY** | `SELECT * FROM t CLUSTER BY key;` | `DISTRIBUTE BY key` **+ `SORT BY key`(升序)** | 多个 | 否 | 语法糖,**不能指定 ASC/DESC** | 简洁,但排序方向不可控 | 分桶写入/等值 Join 预排序 |
| **分区内排序** | `... WHERE dt='2025-08-26' SORT BY ts;` | 只处理某个分区的数据 | 依配置 | 分区内局部有序 | 同 SORT BY | 缩小数据量显著提速 | 分区数据导出、窗口函数前置 |
### 横向展开
`LATERAL VIEW`是 Hive 里一个非常重要的语法,主要用于和表生成函数(如:`EXPLODE`)结合,把一行数据拆成多行。最常见的应用场景是处理 ARRAY、MAP、 JSON 等类型的字段,也可以实现从宽表到窄表的转换。
| 用法 | 示例语法 | 功能说明 | 典型应用场景 |
| ------------------------------------ | ------------------------------------------------------------ | ------------------------------- | ---------------------- |
| **LATERAL VIEW explode(array)** | `SELECT order_id, item FROM orders LATERAL VIEW explode(items) t AS item; ` | 将数组拆成多行,每个元素一行 | 订单明细、事件埋点 |
| **LATERAL VIEW posexplode(array)** | `SELECT order_id, pos, item FROM orders LATERAL VIEW explode(items) t AS pos, item; ` | 数组拆成多行,同时输出元素下标 | 保留顺序的点击流分析 |
| **LATERAL VIEW explode(map)** | `SELECT user_id, k, v FROM user_tags LATERAL VIEW explode(tags) t AS k, v; ` | Map 拆成多行,得到 (key, value) | 用户标签、属性键值对 |
| **LATERAL VIEW json_tuple(json, …)** | `SELECT log_id, ip, device FROM event_log LATERAL VIEW json_tuple(log_json,'ip','device') t AS ip, device; ` | 从 JSON 中抽取字段并生成列 | 日志解析、半结构化数据 |
| **LATERAL VIEW inline(array)** | `SELECT order_id, col1, col2 FROM orders LATERAL VIEW inline(item_structs) t AS col1,col2; ` | struct 数组展开成多行多列 | 一行存多维属性时拆分 |
| **LATERAL VIEW stack(n, …)** | `SELECT user_id, subject, score FROM user_score LATERAL VIEW stack(3,'math',math,'eng',english,'phy',physics) t AS subject, score; ` | 将多列转为多行 (列转行) | 宽表转长表、UNPIVOT |
### HiveSQL vs. MySQL
| **特性** | **Hive SQL** | **MySQL SQL** | **区别说明** |
| --------------------- | ------------------------------------------------------------ | ------------------------------------------------------------ | ------------------------------------------------------------ |
| **表分区** | `PARTITIONED BY`(分区):创建表时使用分区来按某一字段划分数据,能加速查询时的数据筛选。 | 不支持分区。 | Hive可以通过分区将数据分开存储,适合大数据场景。MySQL没有类似的分区机制。 |
| **表分桶** | `CLUSTERED BY`(分桶): 将表数据根据某一字段进行分桶,适合用于大表连接优化。 | 不支持分桶。 | Hive支持通过分桶优化连接操作,MySQL不支持分桶功能。 |
| **存储格式** | `STORED AS`:支持ORC、Parquet等列式存储格式。 | 使用行式存储,如InnoDB。 | Hive支持列式存储格式,优化查询和压缩,而MySQL主要使用行式存储。 |
| **查询引擎** | 支持MapReduce、Tez、Spark等多种执行引擎。 | 仅支持InnoDB引擎。 | Hive的查询可以通过不同的执行引擎(如Tez或Spark)优化执行效率,而MySQL只能使用单一引擎。 |
| **复杂查询支持** | 支持LATERAL VIEW、MAP、ARRAY等复杂数据结构处理。 | 不支持LATERAL VIEW等复杂的数据类型和处理。 | Hive支持更复杂的嵌套查询和复杂数据类型,MySQL不支持类似功能。 |
| **JOIN类型** | 支持MapJoin(Map-side Join):小表加载到内存中进行Map阶段的连接,避免了Shuffle。 | 支持标准的INNER JOIN、LEFT JOIN、RIGHT JOIN、OUTER JOIN等。 | Hive的MapJoin优化可以加速小表与大表的连接操作,而MySQL没有MapJoin这种优化策略。 |
| **自定义函数(UDF)** | 支持用户定义函数(UDF)和用户定义表函数(UDTF)。 | 支持用户定义函数(UDF)和触发器。 | Hive更侧重于自定义函数的灵活性,MySQL则更注重与表操作相关的函数。 |
| **查询优化** | 支持分区裁剪(Partition Pruning)、列裁剪(Column Pruning)、动态分区插入等优化。 | 基于索引的优化,但不支持类似Hive的列裁剪和分区裁剪。 | Hive拥有更多的针对大数据的查询优化机制,而MySQL主要依赖于索引和查询缓存等。 |
| **索引** | 支持`CREATE INDEX`:但通常不建议在Hive中使用索引,性能开销较大。 | 支持`CREATE INDEX`,索引是MySQL查询性能的关键之一。 | Hive中索引的使用相对较少且较为消耗资源,而MySQL通过索引大大提高了查询性能。 |
| **数据类型** | 支持`ARRAY`、`MAP`、`STRUCT`等复杂数据类型。 | 只支持基本数据类型,如`INT`、`VARCHAR`等。 | Hive支持更丰富的数据类型,特别是在处理结构化数据时,MySQL相对简单。 |
| **NULL值处理** | 支持`IS NULL`、`IS NOT NULL`,但有时对NULL值的处理可能与MySQL有所不同,具体行为可能会受到执行引擎的影响。 | 支持`IS NULL`、`IS NOT NULL`,NULL值处理比较一致。 | Hive和MySQL都支持NULL值判断,但在大数据量查询时,Hive的NULL处理可能表现不如MySQL精确。 |
| **聚合函数** | 支持常见的聚合函数(如`SUM()`、`COUNT()`、`AVG()`等),并扩展支持`APPROX_COUNT_DISTINCT()`等近似聚合函数。 | 支持常见的聚合函数(如`SUM()`、`COUNT()`、`AVG()`等)。 | Hive提供了`APPROX_COUNT_DISTINCT()`等高效的近似聚合函数,更适合处理海量数据,而MySQL的聚合函数通常是精确计算的。 |
| **支持子查询** | 支持子查询,但对于大数据集的子查询可能不如MySQL高效,通常需要通过优化(如`MAPJOIN`)来加速。 | 支持子查询,MySQL的子查询优化较好,尤其在小数据量查询时表现优异。 | Hive的子查询在大数据量下性能可能不如MySQL,MySQL对子查询的优化更成熟。 |
| **表创建语法** | Hive创建表时需要指定存储格式、分区、文件格式等,示例如下: | MySQL创建表时,主要关注字段类型、索引等,示例如下: | Hive的表创建更复杂,涉及存储格式和分区等,适用于大数据场景,而MySQL的表创建更加简洁。 |
| **物化视图** | Hive支持创建**物化视图**(Materialized View),在某些情况下可以提升查询性能。 | MySQL不直接支持物化视图,通常通过临时表或应用层缓存实现类似功能。 | Hive提供物化视图,允许预先计算并存储查询结果,从而提高查询效率。MySQL没有原生的物化视图支持。 |
| **查询缓存** | Hive不支持查询缓存,通常通过MapJoin、索引等方式进行性能优化。 | MySQL支持查询缓存,可以缓存常见查询的结果以提高查询效率。 | MySQL具有强大的查询缓存机制,而Hive通常依赖其他优化策略来提高性能。 |
| **字符串函数** | Hive支持字符串函数,如`CONCAT()`, `LENGTH()`, `SUBSTRING()`等。 | MySQL也支持字符串函数,且函数的支持程度较全面。 | Hive和MySQL支持相似的字符串操作,但Hive的字符串处理通常更适合大数据分析应用。 |
| **NULL默认值** | Hive中字段通常不支持为NULL指定默认值,插入数据时通常使用`INSERT INTO`语句。 | MySQL允许在创建表时为字段指定NULL或默认值。 | Hive不直接支持字段默认值,而MySQL允许为字段设置默认值(包括NULL)。 |
### 性能优化
Hive SQL查询性能优化方法有很多种,从表结构设计、查询优化到执行引擎调整等多个方面都有不同的优化方式。
| **优化方法** | **描述** | **适用场景** |
| ---------------------------------- | ------------------------------------------------------------ | ------------------------------------------------------------ |
| **分区**(Partitioning) | 将表按某个字段(如日期)进行分区。通过分区裁剪,只扫描符合条件的分区,减少扫描的数据量。 | 当数据量大且查询常根据某个字段(如时间、地区等)过滤时使用。 |
| **分桶**(Bucketing) | 将数据根据某个字段的哈希值分成固定数量的桶。用于优化大表与小表的连接操作,特别是在进行聚合时。 | 当需要高效的连接操作和聚合时,尤其是多次对某列进行操作时。 |
| **列裁剪**(Column Pruning) | 查询时仅选择需要的列,减少不必要的列扫描。 | 当查询中只需要表的部分列时。 |
| **分区裁剪**(Partition Pruning) | 查询时通过裁剪掉不符合条件的分区,只扫描满足条件的分区。 | 当表有分区并且查询包含分区字段的过滤条件时。 |
| **压缩存储格式**(ORC、Parquet) | 使用列式存储格式(如ORC、Parquet),比行式存储格式(如TextFile)更高效,尤其是在读取大量数据时。 | 当表的数据量大,特别是需要快速扫描时。 |
| **MapJoin**(Map-side Join) | 小表与大表连接时,将小表加载到内存中在Map阶段完成连接,避免了Shuffle和Reduce阶段的开销。 | 当小表足够小,能够加载到内存中时,进行小表和大表的连接。 |
| **合适的Join类型** | 使用合适的Join类型(如Sort Merge Join或Bucketed Join)可以优化连接操作的效率。 | 当两张表都根据相同列进行分桶或排序时。 |
| **合理使用Hive执行引擎** | 选择合适的执行引擎(MapReduce、Tez、Spark)可以提高查询效率。例如,Tez或Spark通常比MapReduce更高效。 | 根据数据量和查询类型选择不同的执行引擎。 |
| **使用合适的文件格式** | 选择合适的文件格式(如ORC、Parquet)可以提高存储和读取效率,特别是对于大规模数据操作。 | 需要高效存储和读取时。 |
| **开启动态分区插入** | 通过设置`hive.exec.dynamic.partition=true`,可以实现动态分区插入,避免手动指定每个分区。 | 当数据需要按分区动态插入时,避免手动指定分区。 |
| **减少数据扫描**(推迟计算) | 使用`WHERE`子句避免在执行查询时扫描不必要的数据,尽量在早期阶段过滤数据。 | 当查询中涉及大量数据时,尽量在查询的早期阶段减少扫描的数据量。 |
| **分批次执行** | 对查询结果使用`LIMIT`进行分页查询,或者使用数据抽样(`TABLESAMPLE`)来减少查询的数据量。 | 当数据量过大,且对数据的完整性要求不高时。 |
| **适当使用索引** | 创建索引加速查询,尤其是对常用查询条件的列创建索引。 | 当某些列经常用作查询条件时。 |
| **查询缓存** | 启用Hive的查询缓存,缓存结果集,提高相同查询的效率。 | 当相同的查询频繁执行时。 |
| **减少MapReduce任务数量** | 通过调整`mapreduce.map.memory.mb`和`mapreduce.reduce.memory.mb`等参数,减少MapReduce任务的数量,提升计算效率。 | 当查询中涉及多个复杂的MapReduce任务时。 |
| **合理选择表的存储格式** | 为表选择合适的存储格式,避免存储格式不匹配导致性能问题。比如,ORC和Parquet格式在大数据查询中效率较高。 | 当查询的数据量很大,尤其是在读取和聚合时。 |
| **物化视图**(Materialized View) | 创建物化视图,预先计算并存储查询结果,减少重复计算的开销。 | 当某些查询结果被频繁使用时,使用物化视图来提高查询效率。 |
| **并行执行**(Parallel Execution) | 使用并行执行功能,设置`hive.exec.parallel=true`,可以并行执行多个查询任务,减少执行时间。 | 当需要执行多个查询且能够并行时。 |