OpenDocuments
GitHub, Notion, Google Drive, Confluence, S3, 로컬 파일, 웹 소스의 문서를 검색하는 자체 호스팅 RAG 플랫폼


English | 한국어
---
## OpenDocuments란?
**OpenDocuments는 흩어진 회사 문서를 AI로 검색 가능한 지식 베이스로 바꿔 주는 오픈 소스 자체 호스팅 RAG(Retrieval-Augmented Generation) 플랫폼입니다.** GitHub, Notion, Google Drive, Confluence, S3, Swagger/OpenAPI, 로컬 파일, 웹 페이지 같은 소스에 연결하고, 하이브리드 벡터 + 키워드 검색으로 인덱싱한 뒤, 자연어 질문에 출처를 인용하며 답변합니다.
OpenDocuments는 다음이 필요할 때 잘 맞습니다.
- **엔터프라이즈 AI 검색** 및 독점 지식 베이스 검색 도구의 자체 호스팅 대안
- 엔지니어링 문서, 제품 스펙, 정책, 스프레드시트, API 문서, 회의록을 위한 **출처 기반 AI 문서 검색**
- 민감한 문서를 자체 인프라에 남겨둘 수 있도록 Ollama와 함께 실행되는 **로컬 우선 RAG 스택**
- Claude Code, Cursor, Windsurf 등 MCP 클라이언트를 위한 **AI 코딩 어시스턴트용 지식 베이스**
- CLI, Web UI, HTTP API, SDK, 플러그인 시스템, 임베드 가능한 위젯을 갖춘 **TypeScript 우선 RAG 플랫폼**
```bash
npm install -g opendocuments
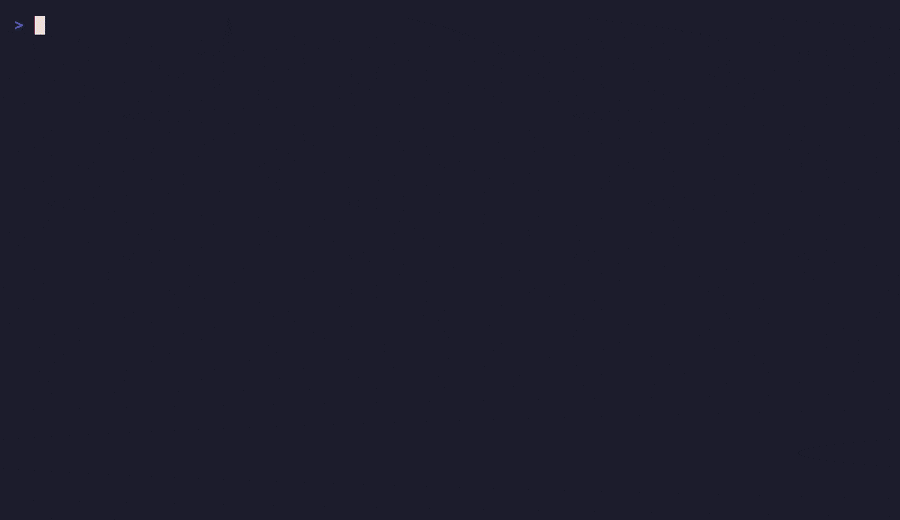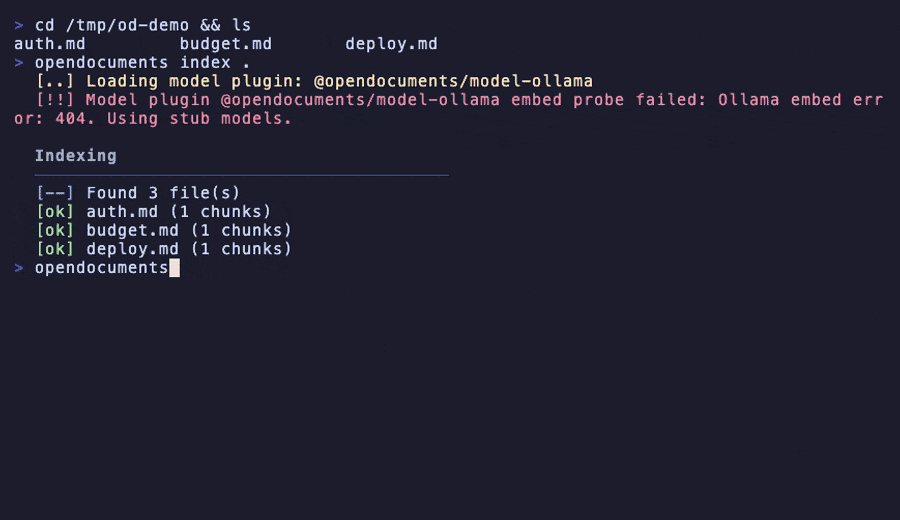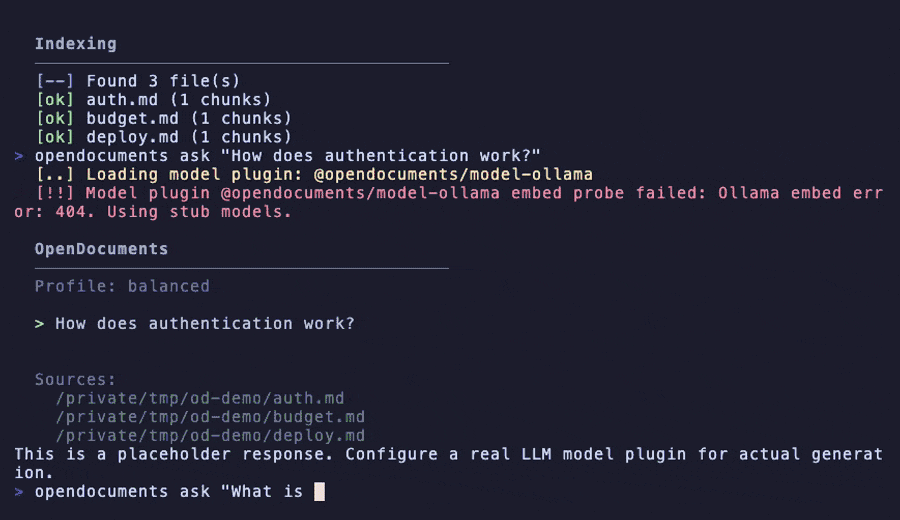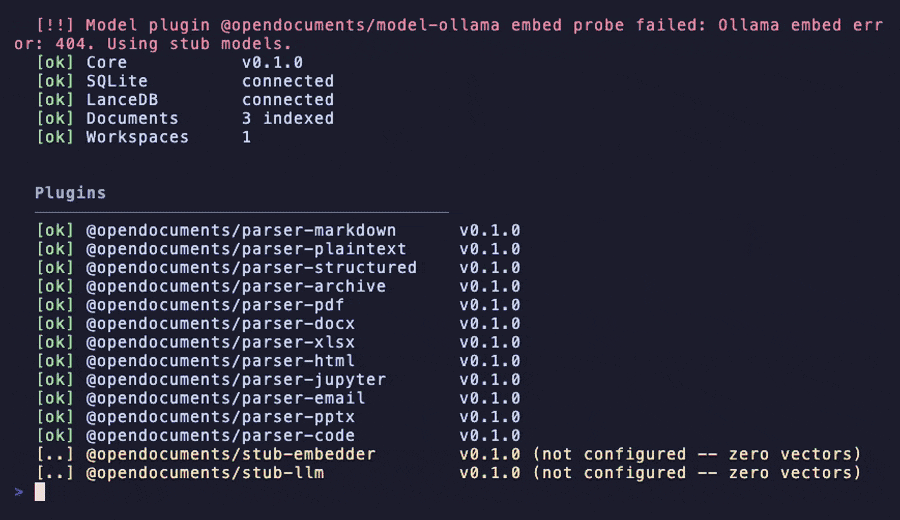
opendocuments init
opendocuments start
```
`http://localhost:3000`을 열고 문서를 인덱싱한 다음, 출처가 포함된 답변을 받아보세요.
## 왜 OpenDocuments인가?
팀의 지식은 여러 저장소에 갇혀 있습니다.
- **엔지니어링 문서**는 GitHub README와 Wiki 페이지에 있고
- **제품 스펙**은 Notion 데이터베이스 곳곳에 흩어져 있으며
- **예산 리포트**는 Google Drive의 Excel 파일 안에 있고
- **API 문서**는 아무도 읽지 않는 Swagger 스펙으로 자동 생성되며
- **회의록**은 Confluence 스페이스에 묵혀 있고
- **온보딩 가이드**는 S3의 `.docx` 파일 속에 묻혀 있습니다
누군가 _"우리 인증 시스템은 어떻게 동작해?"_ 또는 _"AI 팀의 Q3 예산이 얼마였지?"_ 라고 물으면, 여러 도구를 오가며 15분씩 찾아야 합니다. OpenDocuments는 모든 콘텐츠를 호스팅 벤더로 옮기지 않고도 검색을 중앙화합니다.
## OpenDocuments가 질문에 답하는 방식
OpenDocuments는 **문서 소스에 연결**하고, **각 문서를 파싱 및 청킹**한 뒤, **메타데이터는 SQLite에, 벡터는 LanceDB에 저장**합니다. 이후 **검색, 재순위화, 근거 기반 답변 생성**을 수행합니다. 모든 답변에는 출처 인용, 신뢰도 점수, 원본 문서 링크를 포함할 수 있습니다.
한 줄로 말하면, **OpenDocuments는 조직 문서를 위한 비공개 AI 검색 엔진**입니다.
## 주요 기능
| 기능 | 의미 |
| --------------------------- | --------------------------------------------------------------------------------------------------------------- |
| **자체 호스팅 RAG** | 전체 문서 검색 스택을 자체 인프라에서 실행 |
| **출처 인용 AI 답변** | 자연어로 질문하고 어떤 문서가 답변을 뒷받침하는지 확인 |
| **하이브리드 검색** | 벡터 검색, FTS5 키워드 검색, 재순위화, HyDE, 다중 쿼리 검색, 부모 문서 회수를 결합 |
| **넓은 소스 지원** | GitHub, Notion, Google Drive, Confluence, S3/GCS, Swagger/OpenAPI, 웹 페이지, 웹 검색, 업로드, 로컬 파일 인덱싱 |
| **다양한 파일 형식** | Markdown, PDF, DOCX, XLSX, CSV, HTML, Jupyter 노트북, 이메일, 코드, PPTX, JSON, YAML, TOML 등 파싱 |
| **로컬 또는 클라우드 모델** | Ollama 로컬 모델 또는 OpenAI, Anthropic, Google, xAI 같은 클라우드 제공자 사용 |
| **MCP 서버** | Claude Code, Cursor, Windsurf 등 MCP 클라이언트가 내부 지식 베이스를 검색 |
| **팀 모드** | API 키, 역할, 속도 제한, PII 마스킹, 감사 로그, 알림, OAuth SSO, 워크스페이스 격리 추가 |
| **확장 가능한 플러그인** | TypeScript로 커스텀 파서, 커넥터, 모델 제공자, 미들웨어 구축 |
## OpenDocuments와 대안 비교
| 비교 대상 | OpenDocuments를 선택할 때 |
| --------------------------------------------- | ------------------------------------------------------------------------------------------------------------------ |
| **OpenDocuments vs 호스팅 엔터프라이즈 검색** | 인프라와 데이터 흐름을 제어할 수 있는 자체 호스팅 오픈 소스 AI 검색 플랫폼이 필요할 때 |
| **OpenDocuments vs 벡터 데이터베이스** | 커넥터, 파서, 청킹, 검색, 채팅, 인용, 인증, CLI, Web UI, MCP까지 포함된 완성형 RAG 애플리케이션 레이어가 필요할 때 |
| **OpenDocuments vs 챗봇 래퍼** | 일반 채팅 UI가 아니라 실제 문서 코퍼스에 근거한 답변이 필요할 때 |
| **OpenDocuments vs RAG 직접 구축** | 플러그인 수준 확장성을 유지하면서 필요한 구성 요소가 갖춰진 TypeScript 모노레포가 필요할 때 |
| **OpenDocuments vs 로컬 전용 스크립트** | 팀 모드, API 접근, 동기화 가능한 커넥터, 백업, 관리자 도구가 있는 운영 지향 시스템이 필요할 때 |
### 최근 개선 사항
- **RAG 정확도 전면 개선**: 구조 보존 청킹, 컨텍스트 접두사, HyDE + 다중 쿼리 검색, 부모 문서 회수, proposition augmentation, 재순위화, 적응형 컨텍스트 피팅
- **워크스페이스 범위 팀 모드**: 관리자/채팅/문서 API가 인증된 워크스페이스 안에서만 동작하며, 공유 대화 링크와 세션 및 API 키 인증 지원
- **백업 및 복원 CLI**: SQLite + LanceDB 데이터를 스냅샷으로 저장하고 한 명령으로 인스턴스 복구
- **플러그인 강화**: 플러그인 검색/설치 라우트가 관리자 전용이며 검증된 npm 인자 실행 사용
- **원터치 Ollama 설정**: `init`이 Ollama를 자동 감지하고 누락된 모델 pull 제안
- **`.env` 자동 로딩**: `.env`의 API 키를 자동 로드하여 수동 export 불필요
- **멀티턴 대화**: 후속 질문을 위해 이전 컨텍스트 기억
- **저하 모드 경고**: 모델이 설정되지 않았을 때 수정 방법과 함께 명확한 배너 표시
- **향상된 진단**: `opendocuments doctor`가 Ollama 연결, 모델 가용성, 설정 유효성 검사
- **보안 강화**: FTS5 injection 방지, 파일 업로드 sanitization, OAuth state 제한, 워크스페이스 격리
---
## 실제 사용 사례
### 엔지니어링 팀
> _"내부 API에 어떻게 인증해야 해?"_
OpenDocuments는 GitHub 저장소의 `docs/auth.md`에서 답변을 가져오고, 관련 Swagger 엔드포인트를 연결하며, 코드베이스의 코드 예시까지 한 번에 제공합니다.
```bash
# 저장소와 API 문서 인덱싱
opendocuments index ./docs
opendocuments connector sync github
opendocuments ask "How does JWT token refresh work in our API?"
```
### 운영 및 HR 팀
> _"도쿄 오피스 원격 근무 정책이 뭐야?"_
OpenDocuments는 Confluence HR 스페이스, Google Drive의 직원 핸드북, 최신 정책 업데이트 이메일을 함께 검색합니다. 일부 문서는 한국어이고 일부는 영어여도 괜찮습니다.
```bash
opendocuments ask "도쿄 오피스 원격 근무 정책이 뭐야?" --profile precise
# 교차 언어 검색이 한국어와 영어 문서를 모두 찾습니다
```
### 제품 매니저
> _"v2.0과 v3.0 기능 스펙을 비교해줘"_
OpenDocuments는 질문을 분해하고 두 버전의 스펙을 검색한 뒤, 각 원본 문서를 인용하며 구조화된 비교 표를 제시합니다.
### AI 지원 개발(MCP)
OpenDocuments를 **Claude Code**, **Cursor** 또는 MCP 호환 AI 도구의 지식 베이스로 사용할 수 있습니다.
```json
{
"mcpServers": {
"opendocuments": {
"command": "opendocuments",
"args": ["start", "--mcp-only"]
}
}
}
```
이제 AI 코딩 어시스턴트가 코드를 작성하는 동안 조직 전체 문서 코퍼스를 검색할 수 있습니다.
### 자체 호스팅 지식 베이스
자체 인프라에 배포하세요. Ollama를 통해 로컬 LLM을 사용하면 데이터가 **네트워크 밖으로 나가지 않습니다**. 클라우드 의존성, 벤더 락인, 구독 비용이 없습니다.
```bash
OPENDOCUMENTS_MODEL_PROVIDER=ollama \
OPENDOCUMENTS_MODEL_BASE_URL=http://ollama:11434 \
OPENDOCUMENTS_MODEL_LLM=qwen2.5:14b \
OPENDOCUMENTS_MODEL_EMBEDDING=mxbai-embed-large \
docker compose --profile with-ollama up -d
# 모든 것이 로컬에서 실행됩니다: LLM, 임베딩, 벡터 검색, Web UI
```
---
## 빠른 시작
OpenDocuments CLI로 로컬 AI 문서 검색 엔진을 실행하는 가장 빠른 방법입니다.
### 1. 설치
```bash
npm install -g opendocuments
```
### 2. 초기화
```bash
opendocuments init
```
대화형 마법사가 다음을 수행합니다.
- 하드웨어(CPU, RAM)를 감지하고 최적의 LLM 추천
- **로컬**(Ollama) 또는 **클라우드**(OpenAI, Claude, Gemini, Grok) 모델 선택
- **Ollama 자동 감지** 및 누락된 모델 자동 pull 제안
- 저장 전 **클라우드 API 키 검증**
- 플러그인 프리셋 선택: `Developer`, `Enterprise`, `All`, `Custom`
- `opendocuments.config.ts`와 `.env` 생성(API 키 자동 로드)
### 3. 시작
```bash
opendocuments start
```
**http://localhost:3000**을 열면 채팅 UI, 문서 관리자, 관리자 대시보드를 볼 수 있습니다.
> **처음 실행하나요?** 모델이나 코퍼스가 준비되지 않으면 Web UI가 질문을 잠그고 정확한 복구 단계를 표시합니다. 일반 `start`는 모델을 다운로드하지 않습니다. 전체 진단은 `opendocuments doctor`를 실행하세요.
### 4. 문서 인덱싱
```bash
# 로컬 디렉터리 인덱싱(지원 파일을 재귀적으로 검색)
opendocuments index ./docs
# watch 모드: 파일 변경 시 자동 재인덱싱
opendocuments index ./docs --watch
# 또는 Web UI에서 파일 드래그 앤 드롭
```
### 5. 질문하기
```bash
opendocuments ask "What's our deployment process?"
```
---
## 동작 방식
OpenDocuments는 소스 커넥터, 형식 파서, 청킹, 임베딩, 메타데이터 저장소, 벡터 저장소, 검색 프로필, 답변 생성, 인용, 보안 제어를 갖춘 표준 RAG 아키텍처를 사용합니다.
```
Your Documents OpenDocuments You
───────────── ────────────── ───
GitHub repos ──┐
Notion pages ──┤ ┌─────────────┐
Google Drive ──┤ ── Ingest ──► │ Parse │
Confluence ──┤ │ Chunk │ "How does
S3 buckets ──┤ │ Embed │ auth work?"
Swagger specs──┤ │ Store │ │
Local files ──┤ └──────┬───────┘ │
Web pages ──┘ │ ▼
┌──────┴───────┐ ┌─────────────┐
│ SQLite │ │ RAG Engine │
│ (metadata) │◄─┤ Search │
│ │ │ Rerank │
│ LanceDB │ │ Generate │
│ (vectors) │ │ Cite sources│
└──────────────┘ └──────┬──────┘
│
▼
"Auth uses JWT
tokens with
refresh flow.
[Source: auth.md]"
```
### RAG 파이프라인
1. **의도 분류** -- 코드, 개념, 데이터, 비교 요청 중 무엇인지 이해합니다
2. **쿼리 분해** -- 복잡한 질문을 더 나은 검색을 위한 하위 쿼리로 나눕니다
3. **교차 언어 검색** -- 질문 언어와 관계없이 한국어와 영어 문서를 모두 찾습니다
4. **하이브리드 검색** -- Reciprocal Rank Fusion으로 dense 벡터 검색(의미)과 FTS5 sparse 검색(키워드)을 결합합니다
5. **재순위화** -- 키워드 겹침과 모델 기반 관련성으로 결과를 채점합니다
6. **신뢰도 점수** -- 답변을 확신하지 못할 때 솔직하게 알려줍니다
7. **환각 방지** -- 각 문장이 검색된 출처에 근거하는지 검증합니다
8. **3계층 캐싱** -- L1 쿼리 캐시(5분), L2 임베딩 캐시(24시간), L3 웹 검색 캐시(1시간)
---
## 지원 파일 형식
| 형식 | 확장자 | 파싱 방식 |
| ---------------- | ----------------------------------------------------------------------------- | ------------------------------------------- |
| Markdown | `.md`, `.mdx` | 제목 계층과 코드 블록 분리 |
| Plain Text | `.txt` | 직접 텍스트 인덱싱 |
| PDF | `.pdf` | 페이지 단위 추출, 스캔 문서용 OCR fallback |
| Word | `.docx` | 제목 감지와 함께 HTML 변환 |
| Excel / CSV | `.xlsx`, `.xls`, `.csv` | 시트 인식 테이블 청킹(헤더 + 행) |
| HTML | `.html`, `.htm` | 구조 보존 추출, script/nav 제거 |
| Jupyter Notebook | `.ipynb` | Markdown 셀 + 언어 감지된 코드 셀 |
| Email | `.eml` | 헤더(from/to/subject/date) 파싱 + 본문 추출 |
| Source Code | `.js`, `.ts`, `.py`, `.java`, `.go`, `.rs`, `.rb`, `.php`, `.swift`, `.kt` 등 | 함수/클래스 단위 청킹과 import 추출 |
| PowerPoint | `.pptx` | 슬라이드 단위 텍스트 추출 |
| Structured Data | `.json`, `.yaml`, `.yml`, `.toml` | 설정 및 스키마 인덱싱 |
| Archive | `.zip` | Placeholder(전체 추출 예정) |
**Fallback Chains**: 파서가 실패하면 다음 파서가 자동으로 시도됩니다.
```typescript
parserFallbacks: {
'.pdf': ['@opendocuments/parser-pdf', '@opendocuments/parser-ocr'],
}
```
---
## 데이터 소스
| 소스 | 인덱싱 대상 | 인증 | 동기화 방식 |
| ------------------------------------ | ----------------------------------------- | -------------------------- | -------------------- |
| **로컬 파일** | 파일시스템의 모든 지원 형식 | 없음 | 파일 감시(`--watch`) |
| **파일 업로드** | Web UI 드래그 앤 드롭 | 없음 | 즉시 |
| **GitHub** | README, Wiki, 코드 파일, Issues | Personal Access Token | Polling / webhook |
| **Notion** | 페이지, 데이터베이스, 모든 블록 타입 | Integration Token | Polling |
| **Google Drive** | Docs, Sheets, Slides, 업로드 파일 | OAuth / Service Account | Polling |
| **Amazon S3 / Google Cloud Storage** | 버킷의 모든 지원 형식 | AWS / GCP credentials | Polling |
| **Confluence** | 스페이스 전체 Wiki 페이지 | API Token + Email | Polling |
| **Swagger / OpenAPI** | 파라미터와 스키마가 포함된 API 엔드포인트 | 없음(공개 스펙) | 수동 |
| **Web Crawler** | 등록한 모든 URL | 선택 사항(cookies/headers) | 주기적 |
| **Web Search (Tavily)** | 답변에 병합되는 실시간 웹 결과 | Tavily API Key | Query-time |
---
## 모델 제공자
### 클라우드 제공자
| 제공자 | 모델 | 임베딩 | 적합한 용도 |
| ------------- | ------------------------------------------------------------ | ---------------------------- | --------------------------- |
| **OpenAI** | GPT-5.4, GPT-5.4-mini, GPT-4.1, o3, o4-mini | text-embedding-3-small/large | 범용, 비전, 추론 |
| **Anthropic** | Claude Opus 4.6, Claude Sonnet 4.6, Claude Haiku 4.5 | -- (별도 제공자 사용) | 긴 컨텍스트(1M), 코딩, 분석 |
| **Google** | Gemini 3.1 Pro, Gemini 3.1 Flash Lite, Gemini 3.0 Deep Think | text-embedding-005 | 멀티모달, 다국어 |
| **xAI** | Grok 4, Grok 4 Heavy, Grok 4.1 Fast | Grok embedding | 실시간 지식, 코드 |
### 로컬 모델(Ollama)
| 모델 | 활성 파라미터 | 전체 파라미터 | 비전 | 한국어 | 적합한 용도 |
| -------------------------- | ------------- | ------------- | ---- | --------- | ----------------------- |
| **Qwen 3.5 27B** | 27B (dense) | 27B | Yes | Excellent | 범용(32GB+ RAM) |
| **Qwen 3.5 9B** | 9B (dense) | 9B | Yes | Excellent | 중급 사양(16GB RAM) |
| **Qwen 3.5-122B-A10B** | 10B (MoE) | 122B | Yes | Excellent | 고품질, 효율적 |
| **Llama 4 Scout** | 17B (MoE) | 109B | Yes | Good | 10M 컨텍스트 윈도우 |
| **Llama 4 Maverick** | 17B (MoE) | 400B | Yes | Good | 최고 수준 오픈소스 품질 |
| **DeepSeek V3.2** | 37B (MoE) | 671B | No | Good | 코딩, 추론 |
| **Gemma 3 27B** | 27B | 27B | Yes | Good | 경량, 140+ 언어 |
| **Gemma 3 4B** | 4B | 4B | Yes | Good | 저사양 머신(8GB RAM) |
| **K-EXAONE** | 23B (MoE) | 236B | No | Best | 한국어 특화 |
| **EXAONE Deep 32B** | 32B | 32B | No | Best | 한국어 추론 |
| **Phi-4 Reasoning Vision** | 15B | 15B | Yes | Fair | 컴팩트 멀티모달 |
### 임베딩 모델
| 모델 | 차원 | 한국어 | 멀티모달 | 위치 |
| -------------------------- | ---- | --------- | -------- | -------------- |
| **BGE-M3** | 1024 | Excellent | No | Ollama(기본값) |
| **text-embedding-3-large** | 3072 | Good | No | OpenAI |
| **text-embedding-005** | 768 | Good | No | Google |
| **nomic-embed-text** | 768 | Fair | No | Ollama(경량) |
### 자동 추천
`opendocuments init`은 하드웨어를 감지하고 최적 모델을 추천합니다.
| 하드웨어 | 추천 모델 | 추천 임베딩 |
| -------------- | ----------------------------------- | ---------------------- |
| 32GB+ RAM, GPU | Qwen 3.5 27B 또는 Llama 4 Scout | BGE-M3 |
| 16GB RAM | Qwen 3.5 9B | BGE-M3 |
| 8GB RAM | Gemma 3 4B | nomic-embed-text |
| Any (cloud) | Claude Sonnet 4.6 또는 GPT-5.4-mini | text-embedding-3-large |
---
## 세 가지 사용 방법
### 1. Web UI
`http://localhost:3000`에서 전체 기능을 갖춘 대시보드를 사용할 수 있습니다.
| 페이지 | 할 수 있는 일 |
| -------------- | ------------------------------------------------------------------------------------------------------------------------ |
| **Chat** | 스트리밍 답변, 출처 인용, 신뢰도 점수, 피드백 버튼과 함께 질문합니다. fast/balanced/precise 프로필을 전환할 수 있습니다. |
| **Documents** | 인덱싱된 문서 탐색, 드래그 앤 드롭 업로드, 문서 상세 보기, 휴지통/복원 방식의 soft-delete. |
| **Collections** | 문서를 목적별 지식 모음으로 구성하고 컬렉션 멤버십을 관리합니다. |
| **Connectors** | 커넥터 동기화 상태와 마지막 동기화 시간 확인. |
| **Activity** | 런타임 상태, 모델 준비 상태, 인덱싱 활동을 확인합니다. |
| **Plugins** | health indicator와 함께 설치된 플러그인 확인. |
| **Workspaces** | 워크스페이스 격리와 팀 모드 설정을 확인합니다. |
| **Settings** | 다크/라이트 테마 전환, RAG 프로필 변경, 서버 버전 확인. |
| **Admin** | 통계 대시보드, 검색 품질 메트릭, 페이지네이션된 쿼리 로그, 플러그인 상태, 커넥터 상태, 감사 로그. |
**키보드 단축키**: `Cmd+K`로 Command Palette를 열고, `Cmd+1-5`로 페이지를 이동합니다.
### 2. CLI
파워 유저와 자동화를 위한 19개 명령어를 제공합니다.
```bash
# 질문하기
opendocuments ask "What's the deploy process?"
opendocuments ask # 대화형 REPL 모드
opendocuments search "auth middleware" --top 10 # LLM 없는 벡터 검색
# 문서 관리
opendocuments index ./docs --watch # 인덱싱 + 변경 시 자동 재인덱싱
opendocuments document list # 모든 인덱싱 문서 확인
opendocuments document delete # Soft-delete
# 커넥터 관리
opendocuments connector sync # 모든 커넥터 동기화
opendocuments connector status # 동기화 상태 확인
# 스크립팅용 pipe 지원
cat README.md | opendocuments ask "Summarize this" --stdin
opendocuments ask "List endpoints" --json | jq '.sources[].sourcePath'
# 관리
opendocuments doctor # Health check
opendocuments auth create-key --name "ci-bot" --role member
opendocuments backup --output ./backup
```
### 3. MCP 서버
AI 지원 워크플로우를 위한 19개 도구를 제공합니다. Claude Code, Cursor, Windsurf, 모든 MCP 클라이언트와 함께 동작합니다.
```bash
opendocuments start --mcp-only
```
AI 어시스턴트는 다음을 할 수 있습니다.
- 코딩 중 조직 문서 검색
- 새 파일이 생성될 때 인덱싱
- 문서 상태와 커넥터 health 확인
- 설정 조회
---
## RAG 프로필
| | `fast` | `balanced` | `precise` |
| -------------------------------- | ----------------------- | ---------------------------- | ------------------------------- |
| **속도** | ~1s | ~3s | ~5s+ |
| **검색 깊이** | 10 docs | 20 docs | 50 docs |
| **의미 기반 청킹** | On | On | On |
| **재순위화** | Off | On | On |
| **Cross-encoder** | Off | Off | On |
| **교차 언어** | Off | 한국어 + 영어 | 한국어 + 영어 |
| **컨텍스트 접두사** | Off | On | On |
| **다중 쿼리 확장** | Off | 3x paraphrases | 5x paraphrases |
| **HyDE** | Off | Off | On |
| **부모 문서 검색** | Off | On | On |
| **청크 보강** (propositions/HQs) | Off | Off | On |
| **쿼리 분해** | Off | Off | 복잡한 쿼리 분할 |
| **웹 검색** | Off | 로컬 결과가 약할 때 fallback | 항상 병합 |
| **환각 방지** | Off | 출처 근거 확인 | 엄격 모드(검증 안 된 내용 주석) |
| **추천 용도** | 빠른 조회, 8B 로컬 모델 | 일상 사용, 14B+ 모델 | 중요한 질문, 클라우드 LLM |
언제든 전환할 수 있습니다: CLI 플래그(`--profile precise`), Web UI 토글, 설정 파일.
### 검색 품질
OpenDocuments는 구조 보존 청킹, 컨텍스트 검색, HyDE + 다중 쿼리 + 부모 문서 검색, proposition augmentation, cross-encoder reranker를 포함하는 재설계된 RAG 파이프라인을 제공합니다. 모든 기능은 위 표의 프로필별로 제어됩니다. 전체 추가 목록은 [`packages/core/CHANGELOG.md`](packages/core/CHANGELOG.md)를 참고하세요.
평가 harness로 자체 데이터셋에서 benchmark할 수 있습니다.
```bash
cd packages/core && npx tsx tests/_fixtures/run-eval.ts
```
보고되는 메트릭: hit@3, hit@5, MRR, nDCG@5 — intent별 및 aggregate.
---
## 보안
### 개인 모드(기본값)
설정이 필요 없습니다. 인증도 없습니다. localhost 전용이며 바로 동작합니다.
### 팀 모드
```typescript
// opendocuments.config.ts
export default defineConfig({ mode: "team" });
```
| 기능 | 동작 방식 |
| ----------------------- | --------------------------------------------------------------------------------------------------------------------- |
| **API Keys** | `od_live_` prefix, SHA-256 hash 저장, 평문 저장 없음. 특정 작업으로 scope 지정 가능, 만료 설정 가능. |
| **Roles** | `admin`(전체 권한), `member`(읽기 + 쓰기), `viewer`(읽기 전용) |
| **Rate Limiting** | 기본 60 req/min, 키별 override. lazy cleanup을 사용하는 in-memory 방식. |
| **PII Redaction** | 클라우드 LLM으로 보내기 전 이메일, 전화번호, 카드 번호, IP를 자동 마스킹. 패턴과 방식(replace/hash/remove) 설정 가능. |
| **Audit Log** | 인증 이벤트, 문서 접근, 설정 변경 기록. admin API로 조회 가능. |
| **Security Alerts** | brute-force 시도, 비정상 데이터 export, API 키 남용 탐지. |
| **OAuth SSO** | HttpOnly cookie session을 사용하는 Google 및 GitHub 로그인. |
| **Workspace Isolation** | 모든 벡터 검색에 `workspace_id` 필터 강제. 문서, 대화, API 키가 워크스페이스 범위로 제한됩니다. |
---
## 설정
```typescript
// opendocuments.config.ts
import { defineConfig } from "opendocuments-core";
export default defineConfig({
workspace: "my-team",
mode: "personal",
model: {
provider: "ollama",
llm: "qwen3.5:27b",
embedding: "bge-m3",
},
rag: { profile: "balanced" },
connectors: [
{ type: "github", repo: "org/repo", token: process.env.GITHUB_TOKEN },
{ type: "notion", token: process.env.NOTION_TOKEN },
{ type: "web-crawler", urls: ["https://docs.example.com"] },
],
plugins: ["@opendocuments/parser-pdf", "@opendocuments/parser-docx"],
security: {
dataPolicy: {
autoRedact: {
enabled: true,
patterns: ["email", "phone", "credit-card"],
},
},
audit: { enabled: true },
},
storage: { db: "sqlite", vectorDb: "lancedb", dataDir: "~/.opendocuments" },
});
```
---
## Docker 배포
```bash
# 클라우드 LLM(제공자, 실제 API URL, 모델, 키 지정)
OPENDOCUMENTS_MODEL_PROVIDER=openai \
OPENDOCUMENTS_MODEL_BASE_URL=https://api.openai.com/v1 \
OPENDOCUMENTS_MODEL_API_KEY="$OPENAI_API_KEY" \
OPENDOCUMENTS_MODEL_LLM=gpt-4o \
OPENDOCUMENTS_MODEL_EMBEDDING=text-embedding-3-small \
docker compose up -d
# 로컬 LLM(Ollama) 포함
OPENDOCUMENTS_MODEL_PROVIDER=ollama \
OPENDOCUMENTS_MODEL_BASE_URL=http://ollama:11434 \
OPENDOCUMENTS_MODEL_LLM=qwen2.5:14b \
OPENDOCUMENTS_MODEL_EMBEDDING=mxbai-embed-large \
docker compose --profile with-ollama up -d
# API 키용 .env 파일 사용
docker compose --env-file .env up -d
```
Docker 이미지는 모든 패키지와 플러그인을 포함합니다. 데이터는 named volume에 유지됩니다. 설정 파일을 mount하세요.
```bash
docker run -v ./opendocuments.config.ts:/app/opendocuments.config.ts \
-v opendocuments-data:/data -p 3000:3000 opendocuments
```
---
## 플러그인 개발
커스텀 파서, 커넥터, 모델 제공자를 만들 수 있습니다.
```bash
opendocuments plugin create my-parser --type parser
cd my-parser
npm install
npm run test
npm run dev # Watch mode
opendocuments plugin publish # npm에 publish
```
플러그인 타입은 네 가지입니다: `parser`, `connector`, `model`, `middleware`. 각 타입은 lifecycle hook(`setup`, `teardown`, `healthCheck`, `metrics`)을 갖춘 typed interface를 제공합니다.
커뮤니티 플러그인은 `opendocuments-plugin-*` 네이밍 규칙을 따릅니다.
전체 플러그인 개발 가이드는 [CONTRIBUTING.md](CONTRIBUTING.md)를 참고하세요.
---
## TypeScript SDK
```typescript
import { OpenDocumentsClient } from "@opendocuments/client";
const client = new OpenDocumentsClient({
baseUrl: "http://localhost:3000",
apiKey: "od_live_...",
});
const result = await client.ask("How does auth work?");
console.log(result.answer); // "Auth uses JWT tokens with..."
console.log(result.sources); // [{ sourcePath: 'docs/auth.md', score: 0.92 }]
console.log(result.confidence); // { level: 'high', score: 0.87 }
```
---
## 임베드 가능한 위젯
내부 도구에 채팅 위젯을 추가할 수 있습니다.
```html
```
---
## 개발
```bash
git clone https://github.com/joungminsung/OpenDocuments.git
cd OpenDocuments
npm run setup # Install + build (one command)
npm run test # 51개 테스트 작업, 600개 이상 테스트
npm run dev # Watch mode
```
### 아키텍처
| 패키지 | 역할 | 테스트 |
| ----------------------- | ---------------------------------------------------------------------- | ------ |
| `@opendocuments/core` | 플러그인 시스템, RAG 엔진, ingest pipeline, storage, auth, security | 437 |
| `@opendocuments/server` | HTTP API(Hono), MCP 서버, auth middleware, widget | 75 |
| `@opendocuments/cli` | 20개 CLI 명령어(Commander.js) | 9 |
| `@opendocuments/web` | 9개 페이지 React SPA(Vite + Tailwind) | -- |
| `@opendocuments/client` | TypeScript SDK | 5 |
| 5개 모델 플러그인 | Ollama, OpenAI, Anthropic, Google, Grok | 40 |
| 8개 파서 플러그인 | PDF, DOCX, XLSX, HTML, Jupyter, Email, Code, PPTX | 40 |
| 8개 커넥터 플러그인 | GitHub, Notion, GDrive, S3, Confluence, Swagger, WebCrawler, WebSearch | 42 |
규칙, 테스트 패턴, 플러그인 개발 가이드는 [CONTRIBUTING.md](CONTRIBUTING.md)를 참고하세요.
---
## 문서
| 가이드 | 설명 |
| ------------------------------------------------------------ | ------------------------------------- |
| [빠른 시작](#빠른-시작) | 설치, 모델 준비, 첫 인덱싱 확인 |
| [아키텍처](docs/architecture.ko.md) | 패키지 구조, 데이터 흐름, 설계 결정 |
| [Plugin API: Parsers](docs-site/plugins/parser-api.md) | 커스텀 문서 파서 만들기 |
| [Plugin API: Connectors](docs-site/plugins/connector-api.md) | 외부 데이터 소스 연결 |
| [Plugin API: Models](docs-site/plugins/model-api.md) | 커스텀 AI 제공자 추가 |
| [TypeScript SDK](docs-site/sdk/guide.md) | 프로그래밍 방식 API 클라이언트 |
| [Security Policy](SECURITY.md) | 취약점 제보 |
| [Contributing](CONTRIBUTING.md) | 개발 환경 설정, 규칙, 플러그인 가이드 |
---
## 자주 묻는 질문
### OpenDocuments는 무엇에 사용하나요?
OpenDocuments는 회사 문서 위에 비공개 AI 검색 엔진을 구축하는 데 사용합니다. 팀은 GitHub 저장소, Notion 페이지, Google Drive 파일, Confluence 스페이스, S3 버킷, API 스펙, 로컬 파일, 웹 페이지를 가로질러 질문하고 출처가 포함된 답변을 받을 수 있습니다.
### OpenDocuments는 오픈 소스인가요?
네. OpenDocuments는 오픈 소스이며 [MIT License](LICENSE)로 배포됩니다.
### OpenDocuments는 자체 호스팅인가요?
네. OpenDocuments는 자체 호스팅 배포를 위해 설계되었습니다. 개발 중에는 로컬에서 실행하고, Docker로 배포하거나 자체 인프라에 호스팅할 수 있습니다.
### 클라우드 LLM으로 데이터를 보내지 않고 실행할 수 있나요?
네. Ollama와 로컬 임베딩 모델을 사용하도록 설정하면 LLM, 임베딩, 벡터 검색, 메타데이터 데이터베이스, Web UI, CLI, MCP 서버를 자체 인프라에서 실행할 수 있습니다.
### 어떤 데이터 소스를 지원하나요?
OpenDocuments는 로컬 파일, 파일 업로드, GitHub, Notion, Google Drive, Amazon S3, Google Cloud Storage, Confluence, Swagger/OpenAPI 스펙, 등록된 웹 페이지, Tavily 기반 웹 검색을 지원합니다.
### 어떤 파일 형식을 인덱싱할 수 있나요?
OpenDocuments는 Markdown, plain text, PDF, DOCX, XLSX, CSV, HTML, Jupyter 노트북, 이메일, 소스 코드, PPTX, JSON, YAML, TOML 및 기타 지원 플러그인 형식을 인덱싱할 수 있습니다.
### Claude Code나 Cursor와 함께 동작하나요?
네. OpenDocuments에는 MCP 서버가 포함되어 있어 Claude Code, Cursor, Windsurf 같은 MCP 호환 AI 도구가 개발을 지원하는 동안 인덱싱된 문서 코퍼스를 검색할 수 있습니다.
### 벡터 데이터베이스와 무엇이 다른가요?
벡터 데이터베이스는 임베딩을 저장합니다. OpenDocuments는 그 주변의 RAG 플랫폼을 제공합니다: 커넥터, 파서, 문서 청킹, 하이브리드 검색, 재순위화, 답변 생성, 인용, Web UI, CLI, HTTP API, SDK, MCP 서버, 인증, 플러그인까지 포함합니다.
### 호스팅 엔터프라이즈 검색과 무엇이 다른가요?
OpenDocuments는 오픈 소스이자 자체 호스팅입니다. AI 문서 검색, 출처 인용, 플러그인 확장성, 문서/임베딩/메타데이터/모델 호출이 어디에서 실행되는지에 대한 제어권을 원하는 팀을 위해 만들어졌습니다.
---
## 라이선스
[MIT](LICENSE)