# 将文本表示为张量
## [课前测验](https://ff-quizzes.netlify.app/en/ai/quiz/25)
## 文本分类
在本节的第一部分中,我们将专注于**文本分类**任务。我们将使用 [AG News](https://www.kaggle.com/amananandrai/ag-news-classification-dataset) 数据集,该数据集包含如下新闻文章:
* 类别:科技
* 标题:Ky.公司获得研究肽类的资助(美联社)
* 正文:美联社 - 一家由路易斯维尔大学化学研究员创立的公司获得了一项开发资助...
我们的目标是根据文本将新闻项目分类到某个类别中。
## 表示文本
如果我们想用神经网络解决自然语言处理(NLP)任务,我们需要一种方法将文本表示为张量。计算机已经通过诸如 ASCII 或 UTF-8 等编码将文本字符表示为数字,这些数字映射到屏幕上的字体。
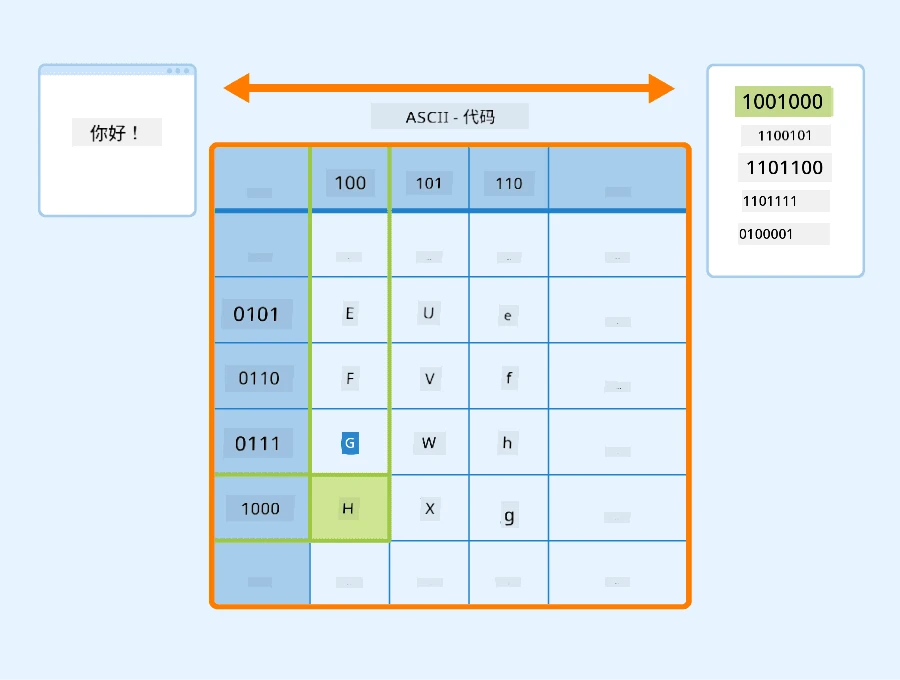 > [图片来源](https://www.seobility.net/en/wiki/ASCII)
作为人类,我们理解每个字母**代表**什么,以及所有字符如何组合形成句子的单词。然而,计算机本身并没有这样的理解,神经网络需要在训练过程中学习这些含义。
因此,我们可以使用不同的方法来表示文本:
* **字符级表示**,即将文本中的每个字符表示为一个数字。假设我们的文本语料库中有 *C* 个不同的字符,那么单词 *Hello* 将被表示为一个 5x*C* 的张量。每个字母对应于一个独热编码的张量列。
* **词级表示**,即我们创建一个包含文本中所有单词的**词汇表**,然后使用独热编码表示单词。这种方法更好一些,因为单个字母本身没有太多意义,因此通过使用更高级的语义概念——单词——我们简化了神经网络的任务。然而,由于词汇表的规模较大,我们需要处理高维稀疏张量。
无论采用哪种表示方式,我们首先需要将文本转换为**标记**序列,一个标记可以是字符、单词,甚至是单词的一部分。然后,我们使用**词汇表**将标记转换为数字,这个数字可以通过独热编码输入到神经网络中。
## N-Grams
在自然语言中,单词的确切含义只能在上下文中确定。例如,*神经网络* 和 *捕鱼网络* 的含义完全不同。考虑上下文的一种方法是基于单词对构建模型,并将单词对视为单独的词汇标记。这样,句子 *I like to go fishing* 将被表示为以下标记序列:*I like*,*like to*,*to go*,*go fishing*。这种方法的问题在于词汇表的规模显著增长,并且像 *go fishing* 和 *go shopping* 这样的组合被表示为不同的标记,尽管它们使用了相同的动词,但并没有共享任何语义相似性。
在某些情况下,我们可能会考虑使用三元组(tri-grams)——三个单词的组合。因此,这种方法通常被称为**n-grams**。此外,使用字符级表示时,n-grams 通常大致对应于不同的音节。
## 词袋模型和 TF/IDF
在解决文本分类等任务时,我们需要能够用一个固定大小的向量表示文本,这个向量将作为最终密集分类器的输入。最简单的方法之一是组合所有单个单词的表示,例如通过将它们相加。如果我们将每个单词的独热编码相加,我们将得到一个频率向量,显示每个单词在文本中出现的次数。这种文本表示被称为**词袋模型**(BoW)。
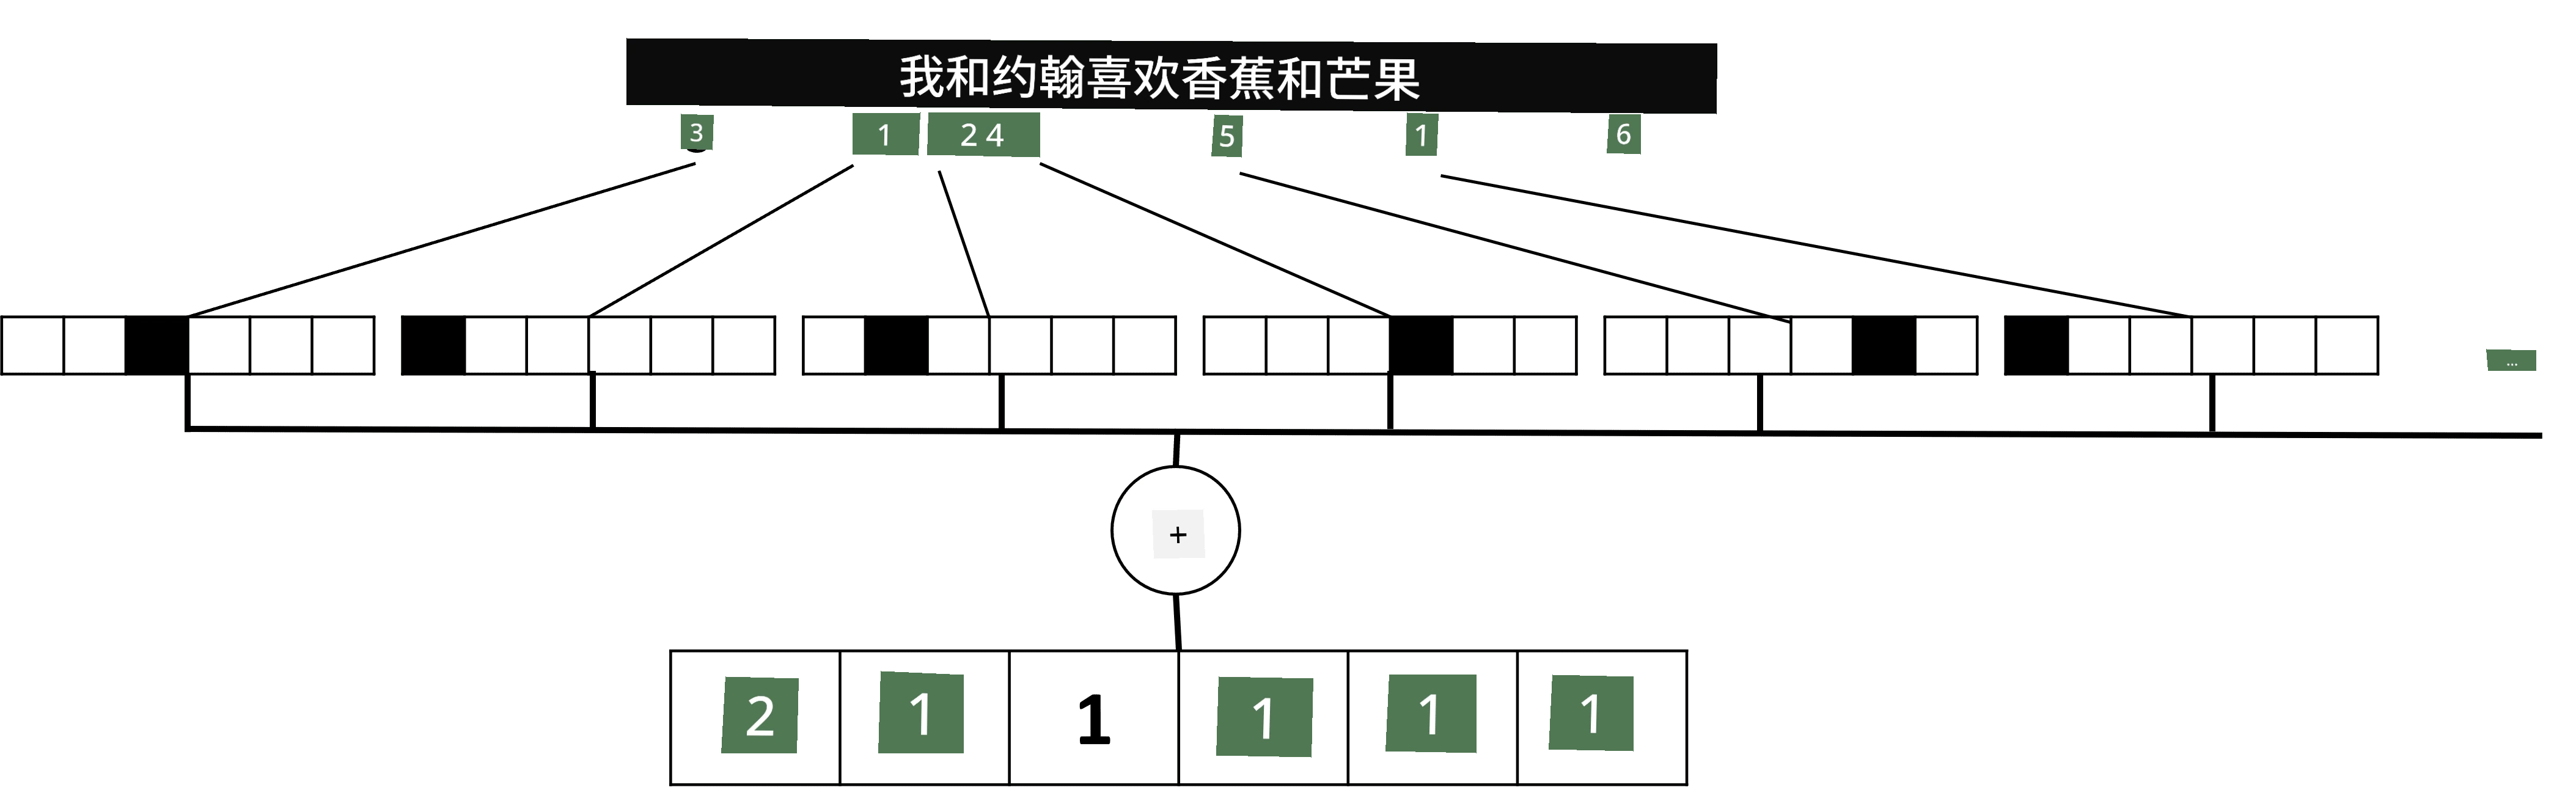 > 图片由作者提供
词袋模型本质上表示了文本中出现了哪些单词以及它们的数量,这确实可以很好地指示文本的内容。例如,关于政治的新闻文章可能包含 *总统* 和 *国家* 等词,而科学出版物可能包含 *对撞机*、*发现* 等词。因此,单词频率在许多情况下可以很好地指示文本内容。
词袋模型的问题在于某些常见单词,例如 *and*、*is* 等,出现在大多数文本中,并且它们的频率最高,从而掩盖了真正重要的单词。我们可以通过考虑单词在整个文档集合中出现的频率来降低这些单词的重要性。这就是 TF/IDF 方法的主要思想,该方法在本课附带的笔记本中有更详细的介绍。
然而,这些方法都无法完全考虑文本的**语义**。我们需要更强大的神经网络模型来实现这一点,我们将在本节后续内容中讨论。
## ✍️ 练习:文本表示
通过以下笔记本继续学习:
* [使用 PyTorch 表示文本](TextRepresentationPyTorch.ipynb)
* [使用 TensorFlow 表示文本](TextRepresentationTF.ipynb)
## 总结
到目前为止,我们已经学习了可以为不同单词添加频率权重的技术。然而,这些技术无法表示单词的含义或顺序。正如著名语言学家 J. R. Firth 在1935年所说:“单词的完整意义总是与上下文相关,任何脱离上下文的意义研究都不能被认真对待。”我们将在课程后续内容中学习如何通过语言建模从文本中捕获上下文信息。
## 🚀 挑战
尝试使用词袋模型和不同的数据模型完成一些其他练习。你可以参考这个 [Kaggle 比赛](https://www.kaggle.com/competitions/word2vec-nlp-tutorial/overview/part-1-for-beginners-bag-of-words) 来获得灵感。
## [课后测验](https://ff-quizzes.netlify.app/en/ai/quiz/26)
## 复习与自学
在 [Microsoft Learn](https://docs.microsoft.com/learn/modules/intro-natural-language-processing-pytorch/?WT.mc_id=academic-77998-cacaste) 上练习你的文本嵌入和词袋模型技术。
## [作业:笔记本](assignment.md)
---