# 检索增强生成(RAG)和向量数据库
[](https://youtu.be/4l8zhHUBeyI?si=BmvDmL1fnHtgQYkL)
在搜索应用课程中,我们简要了解了如何将您自己的数据集成到大型语言模型(LLMs)中。本课将进一步深入探讨在LLM应用中为您的数据建立基础的概念、该过程的机制以及数据存储方法,包括嵌入向量和文本。
> 视频即将发布
## 引言
本课将涵盖以下内容:
- RAG简介,什么是RAG以及为什么在人工智能(AI)中使用它。
- 了解什么是向量数据库并为我们的应用创建一个。
- 一个如何将RAG集成到应用中的实际示例。
## 学习目标
完成本课后,您将能够:
- 解释RAG在数据检索和处理中的重要性。
- 设置RAG应用并将您的数据应用于LLM
- 在LLM应用中有效整合RAG与向量数据库。
## 我们的场景:用我们自己的数据增强LLM
本课中,我们希望将自己的笔记添加到教育创业项目中,使聊天机器人能够获取更多不同学科的信息。利用我们现有的笔记,学习者能够更好地学习和理解不同主题,从而更容易复习备考。为了创建我们的场景,我们将使用:
- `Azure OpenAI:` 我们将用来创建聊天机器人的大型语言模型
- `AI初学者课中的神经网络内容:` 这是我们为LLM设备基础的数据信息
- `Azure AI搜索` 和 `Azure Cosmos DB:` 向量数据库,用于存储数据和创建搜索索引
用户将能够根据笔记创建练习测验、复习卡片并将其总结成简明的概述。让我们先了解什么是RAG以及它是如何工作的:
## 检索增强生成(RAG)
由LLM驱动的聊天机器人处理用户提示以生成响应。它设计为交互式的,能够与用户就广泛话题进行交流。然而,其响应仅限于所提供的上下文和其基础训练数据。例如,GPT-4的知识截止于2021年9月,意味着它缺乏此时间点之后发生事件的知识。此外,用于训练LLM的数据不包括机密信息,如个人笔记或公司的产品手册。
### RAG(检索增强生成)的工作原理
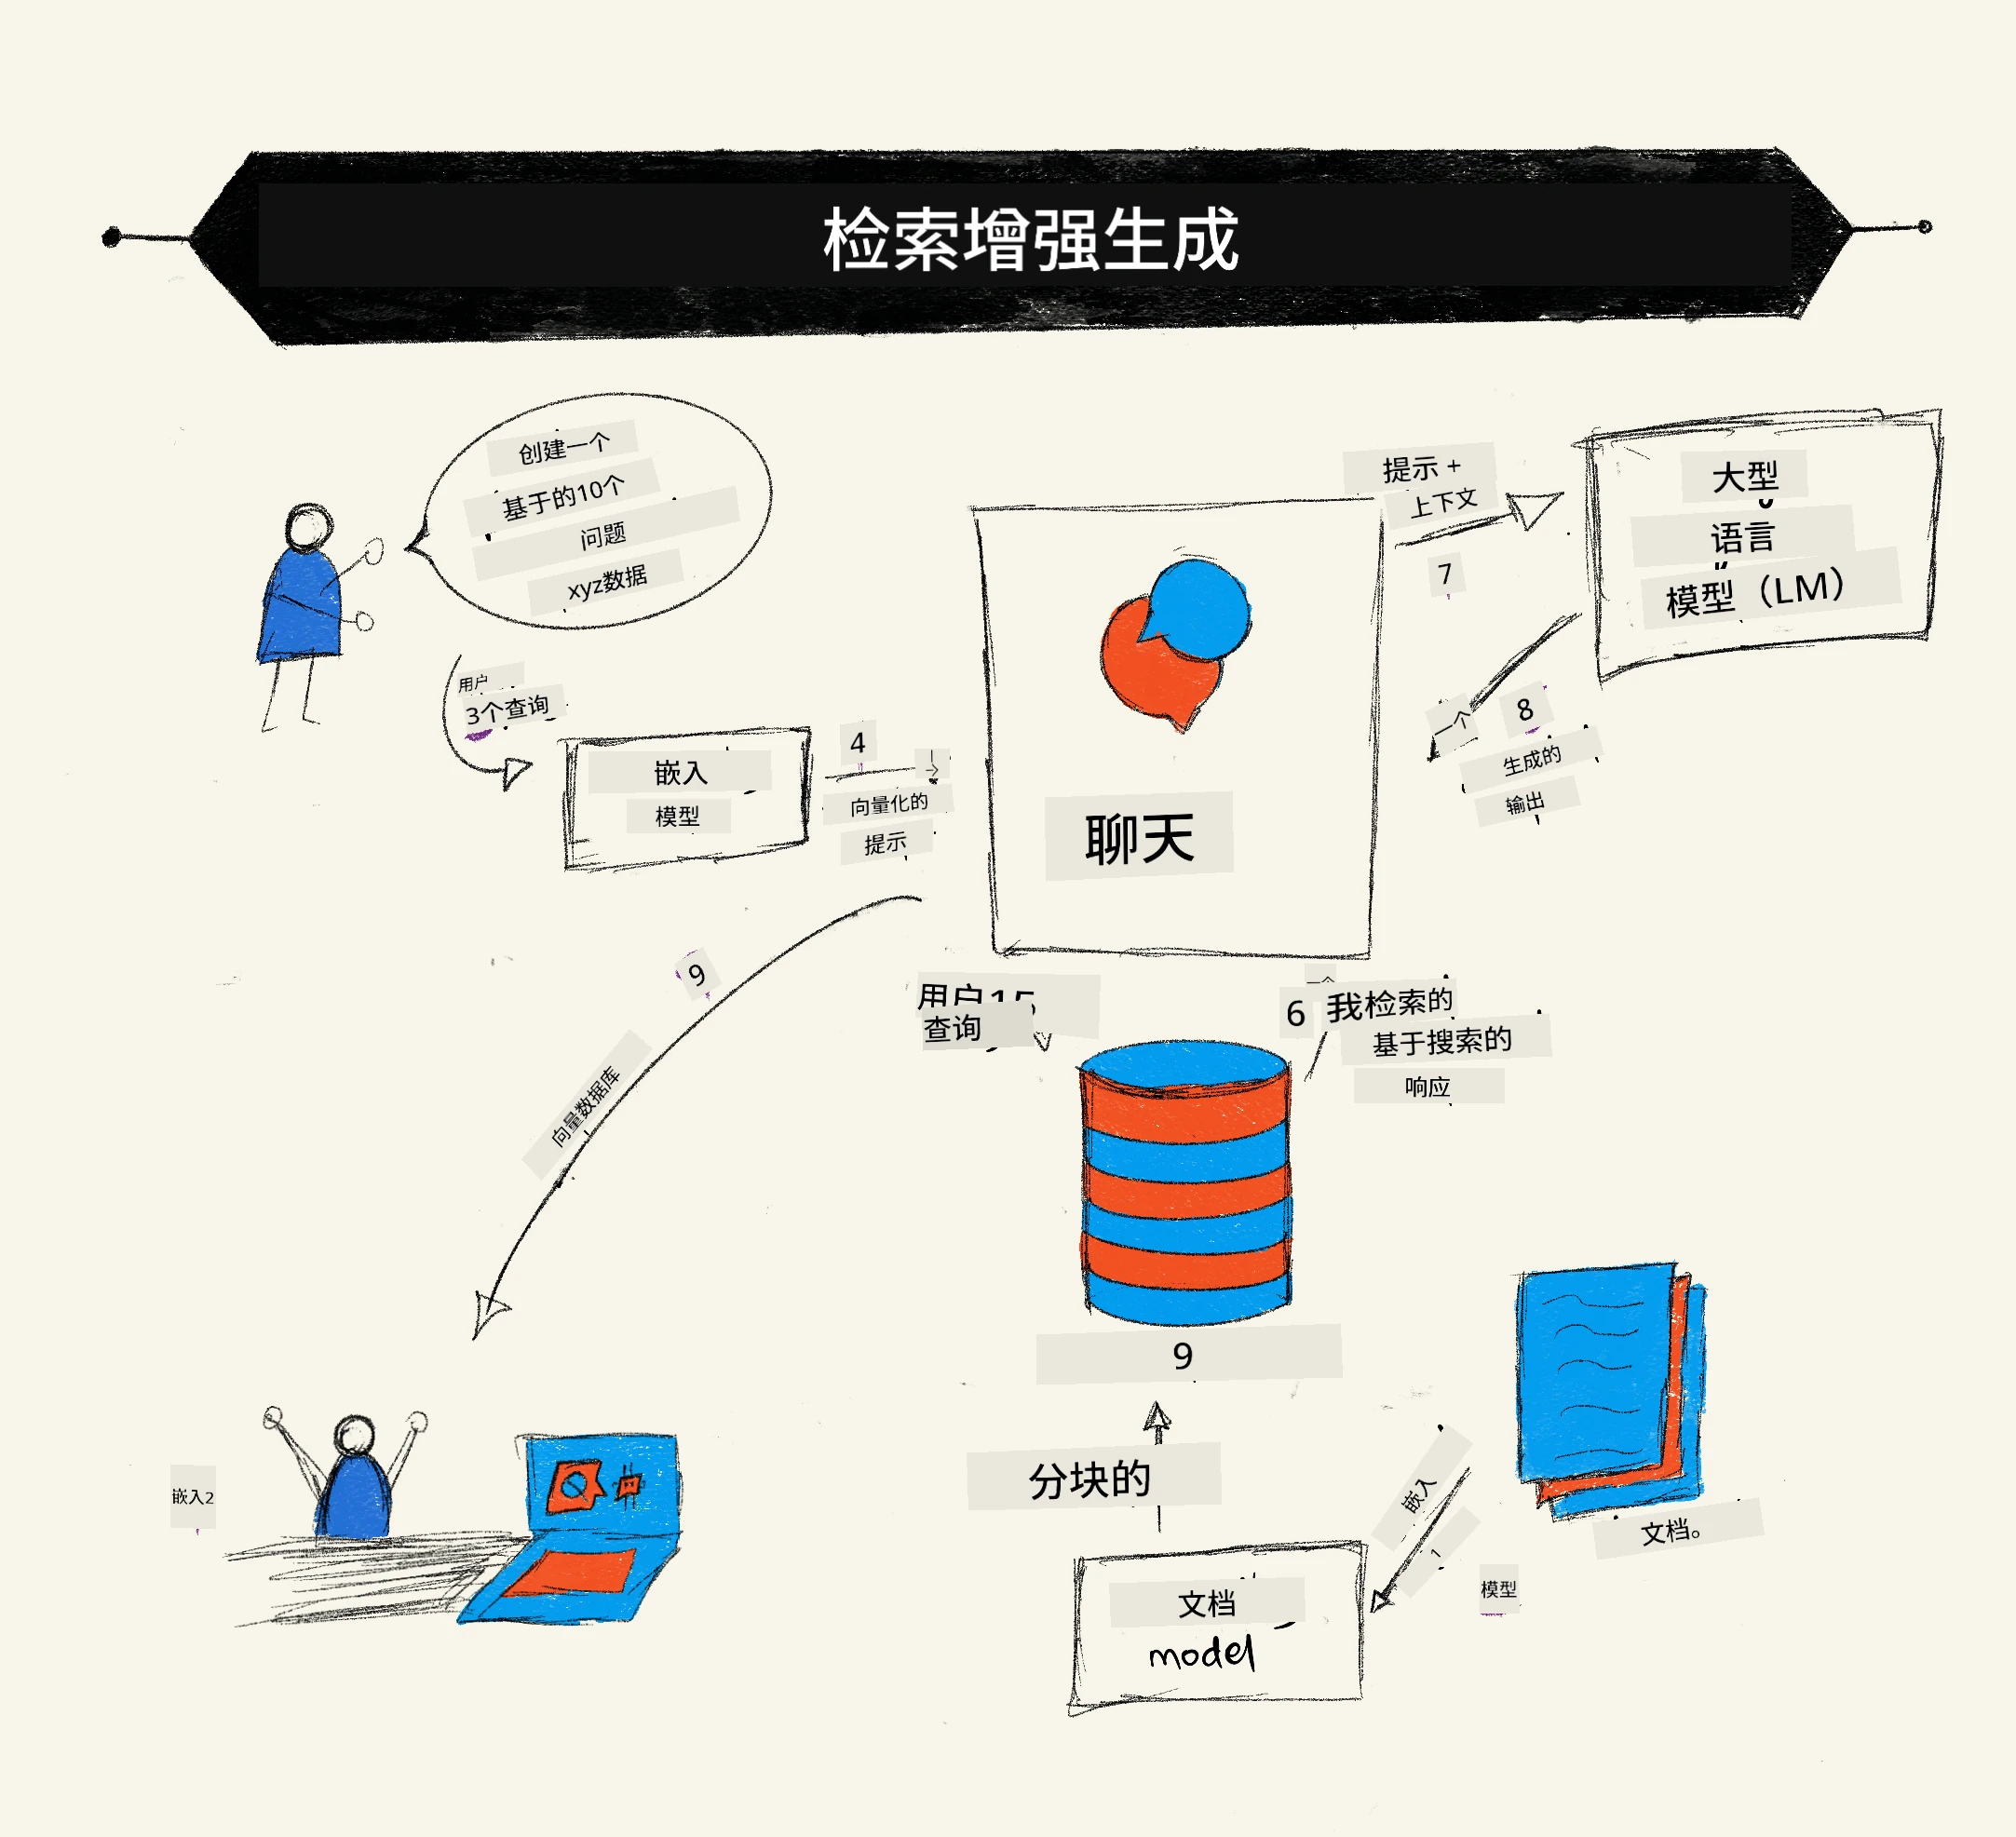
假设您想部署一个能根据笔记创建测验的聊天机器人,您需要连接知识库。这就是RAG发挥作用的地方。RAG的工作流程如下:
- **知识库:** 在检索之前,需要摄取并预处理这些文档,通常是将大型文档拆分成较小的块,转化为文本嵌入并存储在数据库中。
- **用户查询:** 用户提出问题
- **检索:** 当用户提问时,嵌入模型会从知识库中检索相关信息,提供更多上下文以融入提示中。
- **增强生成:** LLM基于检索的数据增强其响应。这使得生成的回答不仅基于预训练数据,同时还融合了来自附加上下文的相关信息。检索到的数据用于增强LLM的回答,然后LLM返回答案给用户。
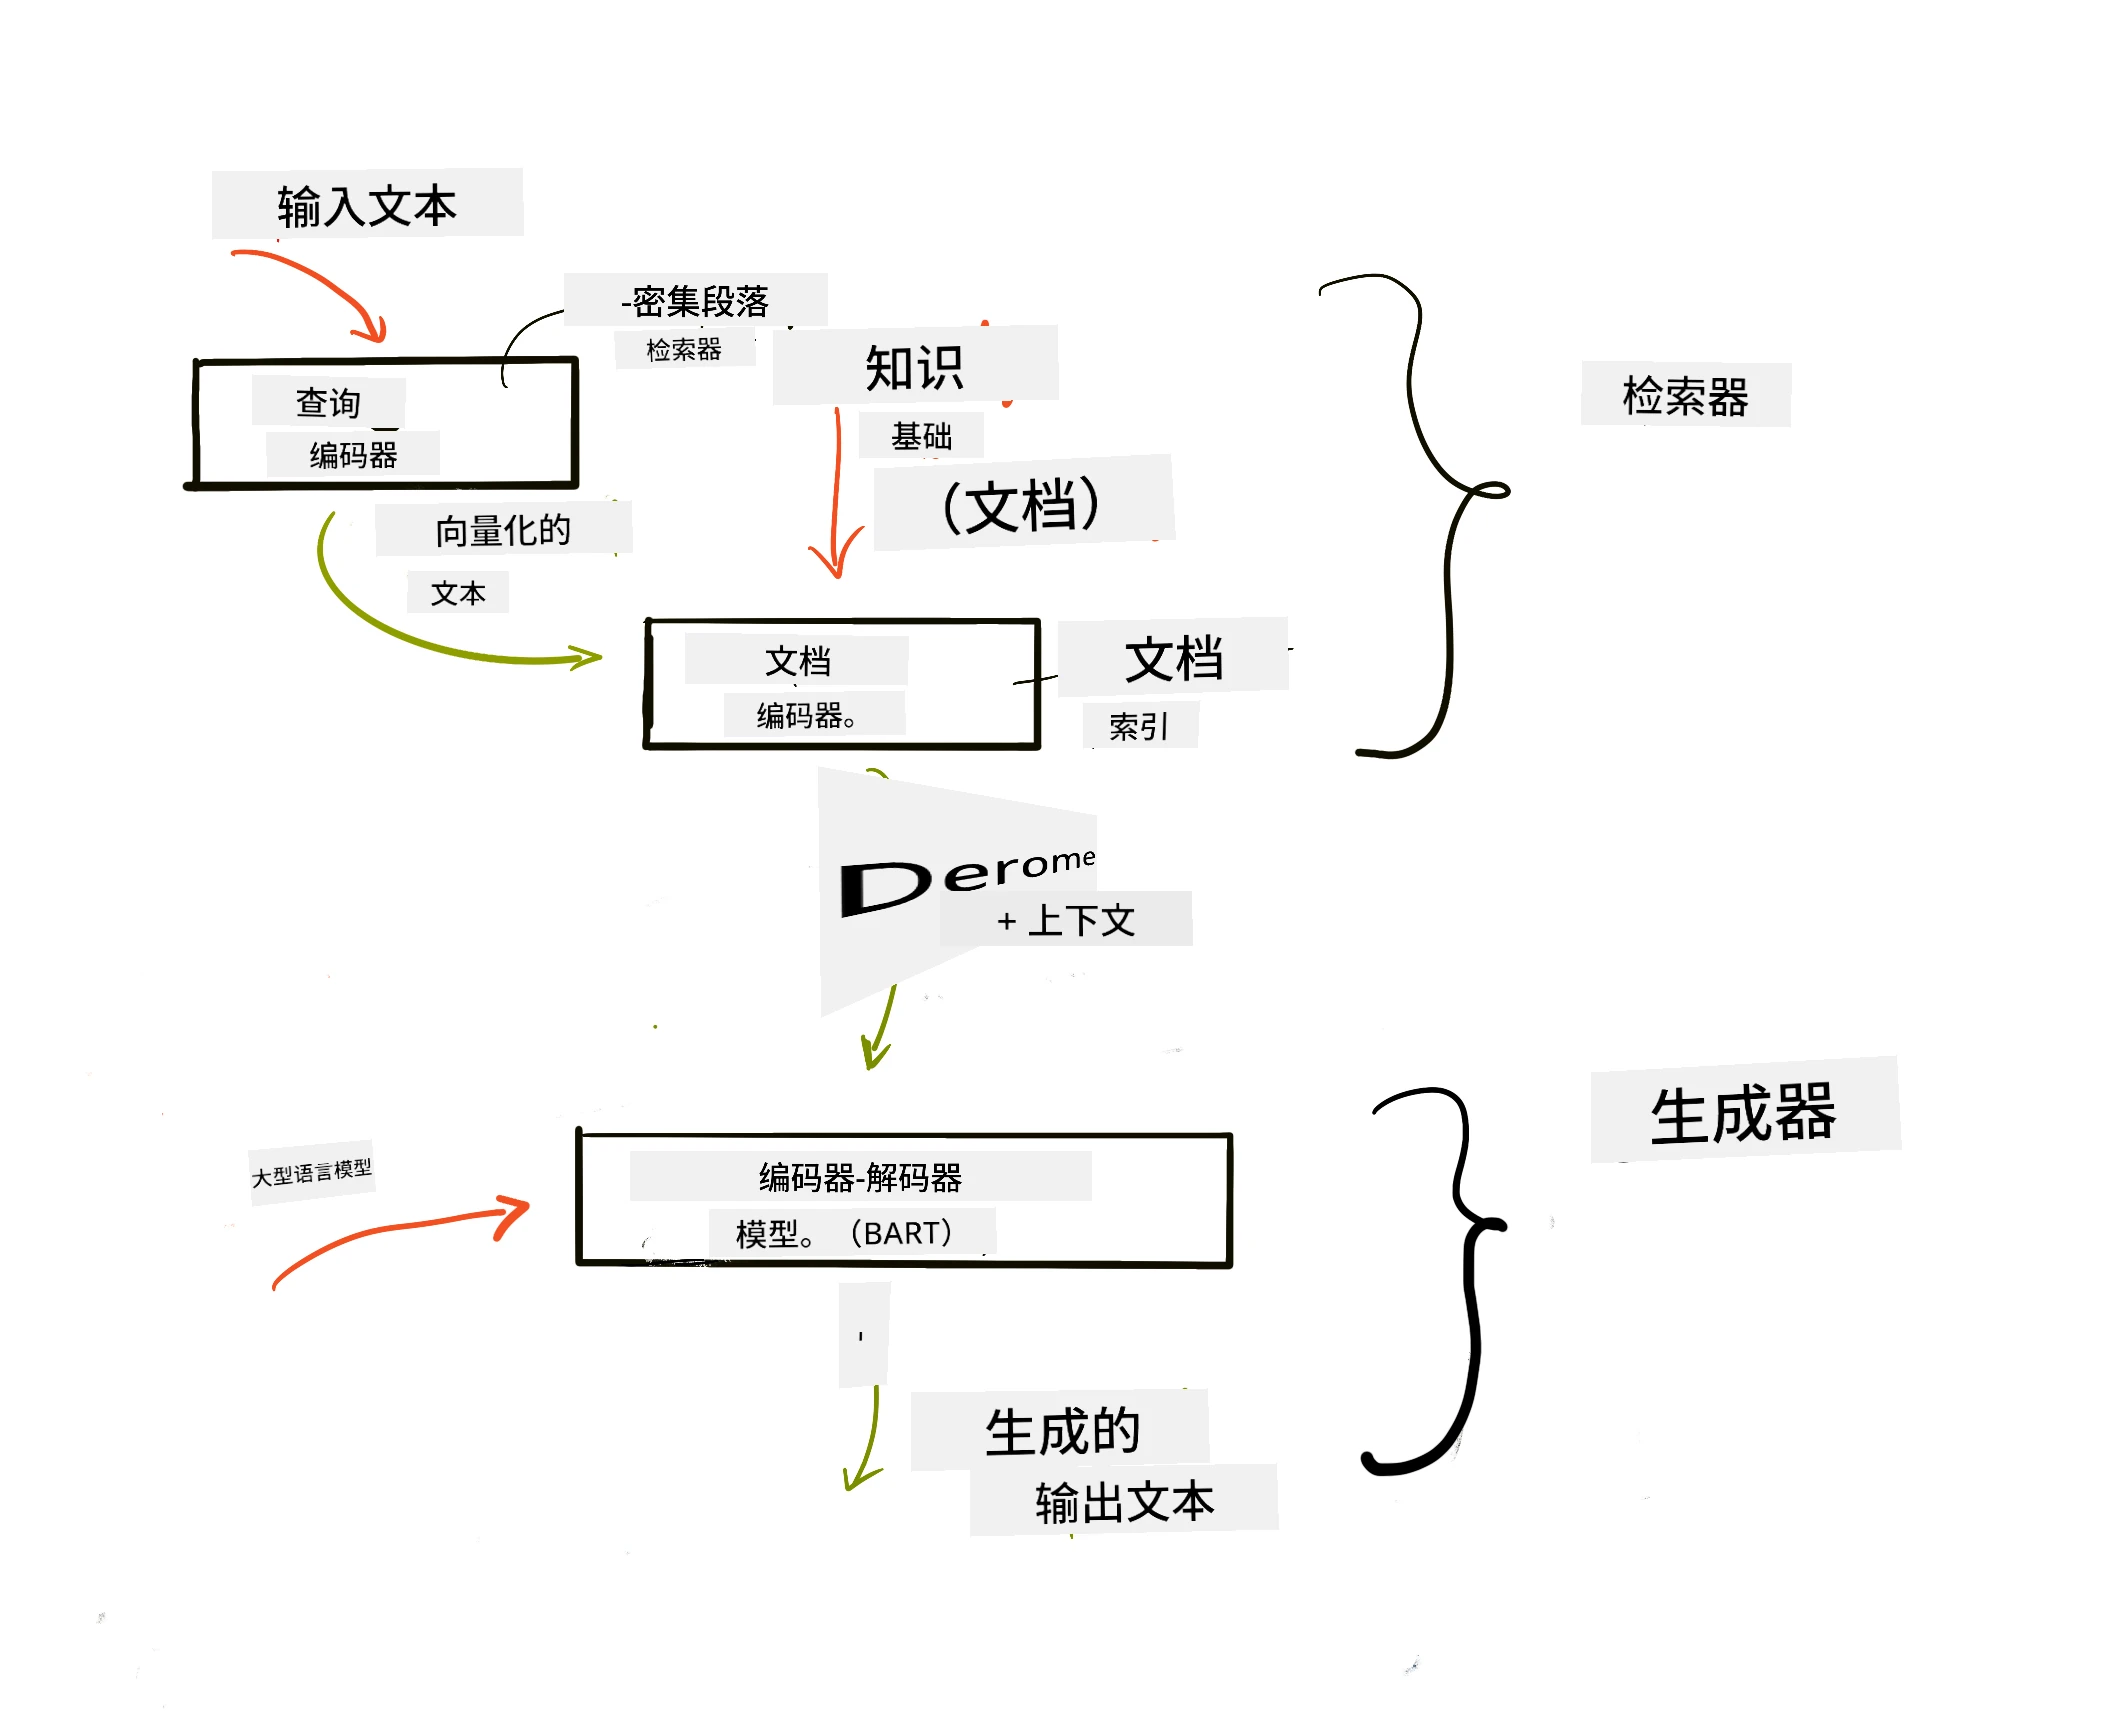
RAG架构使用转换器实现,由编码器和解码器两部分组成。例如,当用户提问时,输入文本会被“编码”为捕获单词含义的向量,向量被“解码”到我们的文档索引中,并基于用户查询生成新的文本。LLM利用编码器-解码器模型生成输出。
根据论文[《面向知识密集型自然语言处理任务的检索增强生成》](https://arxiv.org/pdf/2005.11401.pdf?WT.mc_id=academic-105485-koreyst),实现RAG有两种方法:
- **_RAG-Sequence_**: 使用检索到的文档预测用户查询的最佳答案
- **RAG-Token**: 利用文档生成下一个标记(token),然后检索它们来回答用户查询
### 为什么要使用RAG?
- **信息丰富性:** 确保文本回答是最新且实时的,从而通过访问内部知识库提升领域特定任务的表现。
- 通过利用知识库中的可验证数据为用户查询提供上下文,减少错误生成。
- **成本效益高:** 相较于微调LLM,使用RAG更经济。
## 创建知识库
我们的应用基于个人数据,即“AI初学者”课程中的神经网络课件。
### 向量数据库
向量数据库不同于传统数据库,它是一种专门设计用来存储、管理和搜索嵌入向量的数据库。它存储文档的数值表示。将数据拆分为数值嵌入使我们的AI系统更容易理解和处理数据。
我们将嵌入存储到向量数据库中,因为LLM对输入的token数量有限制。由于无法将整个嵌入传递给LLM,我们需要将其拆分为块,当用户提问时,会返回与问题最匹配的嵌入及对应提示。拆分块还能减少通过LLM传递token的数量,从而降低成本。
一些常见的向量数据库包括Azure Cosmos DB、Clarifyai、Pinecone、Chromadb、ScaNN、Qdrant和DeepLake。你可以使用Azure CLI通过以下命令创建Azure Cosmos DB模型:
```bash
az login
az group create -n -l
az cosmosdb create -n -r
az cosmosdb list-keys -n -g
```
### 从文本到嵌入
在存储数据之前,需要先将其转换为向量嵌入。如果处理的是大型文档或长文本,可以根据预期查询进行分块。分块可以在句子级别,也可以在段落级别。由于分块是通过周围词汇推断意义,可以为分块添加其他上下文,例如添加文档标题,或包括分块前后的部分文本。分块示例如下:
```python
def split_text(text, max_length, min_length):
words = text.split()
chunks = []
current_chunk = []
for word in words:
current_chunk.append(word)
if len(' '.join(current_chunk)) < max_length and len(' '.join(current_chunk)) > min_length:
chunks.append(' '.join(current_chunk))
current_chunk = []
# 如果最后一块没有达到最小长度,仍然添加它
if current_chunk:
chunks.append(' '.join(current_chunk))
return chunks
```
分块后,我们可以使用不同的嵌入模型将文本转为嵌入。可用的模型包括word2vec、OpenAI的ada-002、Azure计算机视觉等。选择哪个模型取决于你使用的语言、编码的内容类型(文本/图像/音频)、可编码的输入大小和嵌入输出长度。
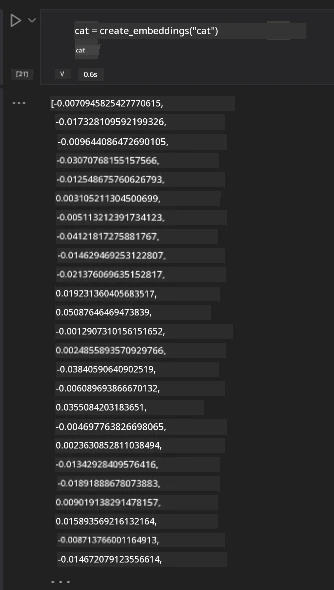
使用OpenAI的 `text-embedding-ada-002` 模型嵌入文本的示例如下:
## 检索和向量搜索
当用户提问时,检索器使用查询编码器将问题转换为向量,然后在文档搜索索引中查找与输入相关的向量。一旦完成,它会将输入向量和文档向量转换回文本,传递给LLM。
### 检索
检索指系统快速从索引中查找满足搜索条件的文档。检索器的目标是找到可为LLM提供上下文背景并基于您的数据进行定位的文档。
在数据库中执行搜索有多种方式,如:
- 关键词搜索 - 用于文本检索
- 向量搜索 - 利用嵌入模型将文本文档转换为向量表示,支持基于单词语义意义的语义搜索。检索通过查询与用户问题向量最相近的文档向量实现。
- 混合搜索 - 结合关键词和向量搜索
检索面临的挑战是在数据库中没有类似响应时,系统会返回最优信息。可以使用设置最大相关距离或采用结合关键词与向量搜索的混合搜索等策略。本课我们将使用混合搜索,将数据存入含有块及其嵌入向量的DataFrame中。
### 向量相似度
检索器会在知识库中搜索相互靠近的嵌入,即最近邻,因为这些文本相似。在用户提问场景中,用户查询先被嵌入,再匹配相似的嵌入。通常使用余弦相似度衡量不同向量间的相似度,该指标基于两向量间的夹角。
其他相似度度量包括欧氏距离,即向量端点之间的直线距离,以及点积,测量两个向量对应元素乘积的和。
### 搜索索引
执行检索前需构建知识库的搜索索引。索引存储嵌入,且即使在大型数据库中也能快速检索最相似的数据块。我们可以在本地创建索引,如下:
```python
from sklearn.neighbors import NearestNeighbors
embeddings = flattened_df['embeddings'].to_list()
# 创建搜索索引
nbrs = NearestNeighbors(n_neighbors=5, algorithm='ball_tree').fit(embeddings)
# 要查询索引,可以使用 kneighbors 方法
distances, indices = nbrs.kneighbors(embeddings)
```
### 重新排序
查询数据库后,可能需要从最相关结果开始对结果排序。重新排序LLM利用机器学习提升搜索结果的相关性,按相关度排序。使用Azure AI搜索时,系统自动通过语义重新排序器完成此过程。以下为利用最近邻算法的重新排序示例:
```python
# 查找最相似的文档
distances, indices = nbrs.kneighbors([query_vector])
index = []
# 打印最相似的文档
for i in range(3):
index = indices[0][i]
for index in indices[0]:
print(flattened_df['chunks'].iloc[index])
print(flattened_df['path'].iloc[index])
print(flattened_df['distances'].iloc[index])
else:
print(f"Index {index} not found in DataFrame")
```
## 整合实现
最后一步是将LLM加入流程中,实现基于我们的数据生成响应。实现方式如下:
```python
user_input = "what is a perceptron?"
def chatbot(user_input):
# 将问题转换为查询向量
query_vector = create_embeddings(user_input)
# 查找最相似的文档
distances, indices = nbrs.kneighbors([query_vector])
# 向查询中添加文档以提供上下文
history = []
for index in indices[0]:
history.append(flattened_df['chunks'].iloc[index])
# 结合历史和用户输入
history.append(user_input)
# 创建消息对象
messages=[
{"role": "system", "content": "You are an AI assistant that helps with AI questions."},
{"role": "user", "content": "\n\n".join(history) }
]
# 使用响应API生成回复
response = client.responses.create(
model="gpt-5-mini",
max_output_tokens=800,
input=messages,
store=False,
)
return response.output_text
chatbot(user_input)
```
## 评估我们的应用
### 评估指标
- 回答质量:确保回答听起来自然、流畅且像人类。
- 数据基础性:评估回答是否来自提供的文档。
- 相关性:评估回答是否匹配并与所问问题相关。
- 流畅性:回答语法是否通顺合理。
## RAG(检索增强生成)和向量数据库的用例
许多用例中,函数调用能提升您的应用,包括:
- 问答系统:将企业数据接入聊天机器人,员工可用其提问。
- 推荐系统:创建匹配最相似项目的系统,如电影、餐馆等。
- 聊天机器人服务:存储聊天记录,根据用户数据个性化对话。
- 基于向量嵌入的图像搜索,适用于图像识别和异常检测。
## 总结
我们已经涵盖了RAG的基本领域,从将数据添加到应用,到用户查询和输出。为简化RAG的创建,您可以使用诸如Semantic Kernel、Langchain或Autogen等框架。
## 作业
为继续学习检索增强生成(RAG),你可以构建:
- 使用你选择的框架为应用构建前端
- 利用LangChain或Semantic Kernel等框架,重新创建你的应用。
恭喜你完成本课 👏。
## 学习不会停止,继续前行
完成本课后,欢迎浏览我们的[生成式AI学习合集](https://aka.ms/genai-collection?WT.mc_id=academic-105485-koreyst),持续提升你的生成式AI知识!
---
**免责声明**:
本文件由 AI 翻译服务 [Co-op Translator](https://github.com/Azure/co-op-translator) 翻译完成。尽管我们力求准确,但请注意,自动翻译可能包含错误或不准确之处。原始语言版文件应视为权威来源。对于重要信息,建议使用专业人工翻译。我们对因使用本翻译而产生的任何误解或误释不承担责任。