Figure 1: We address the reconstruction accuracy drop of high spatial-compression autoencoders.
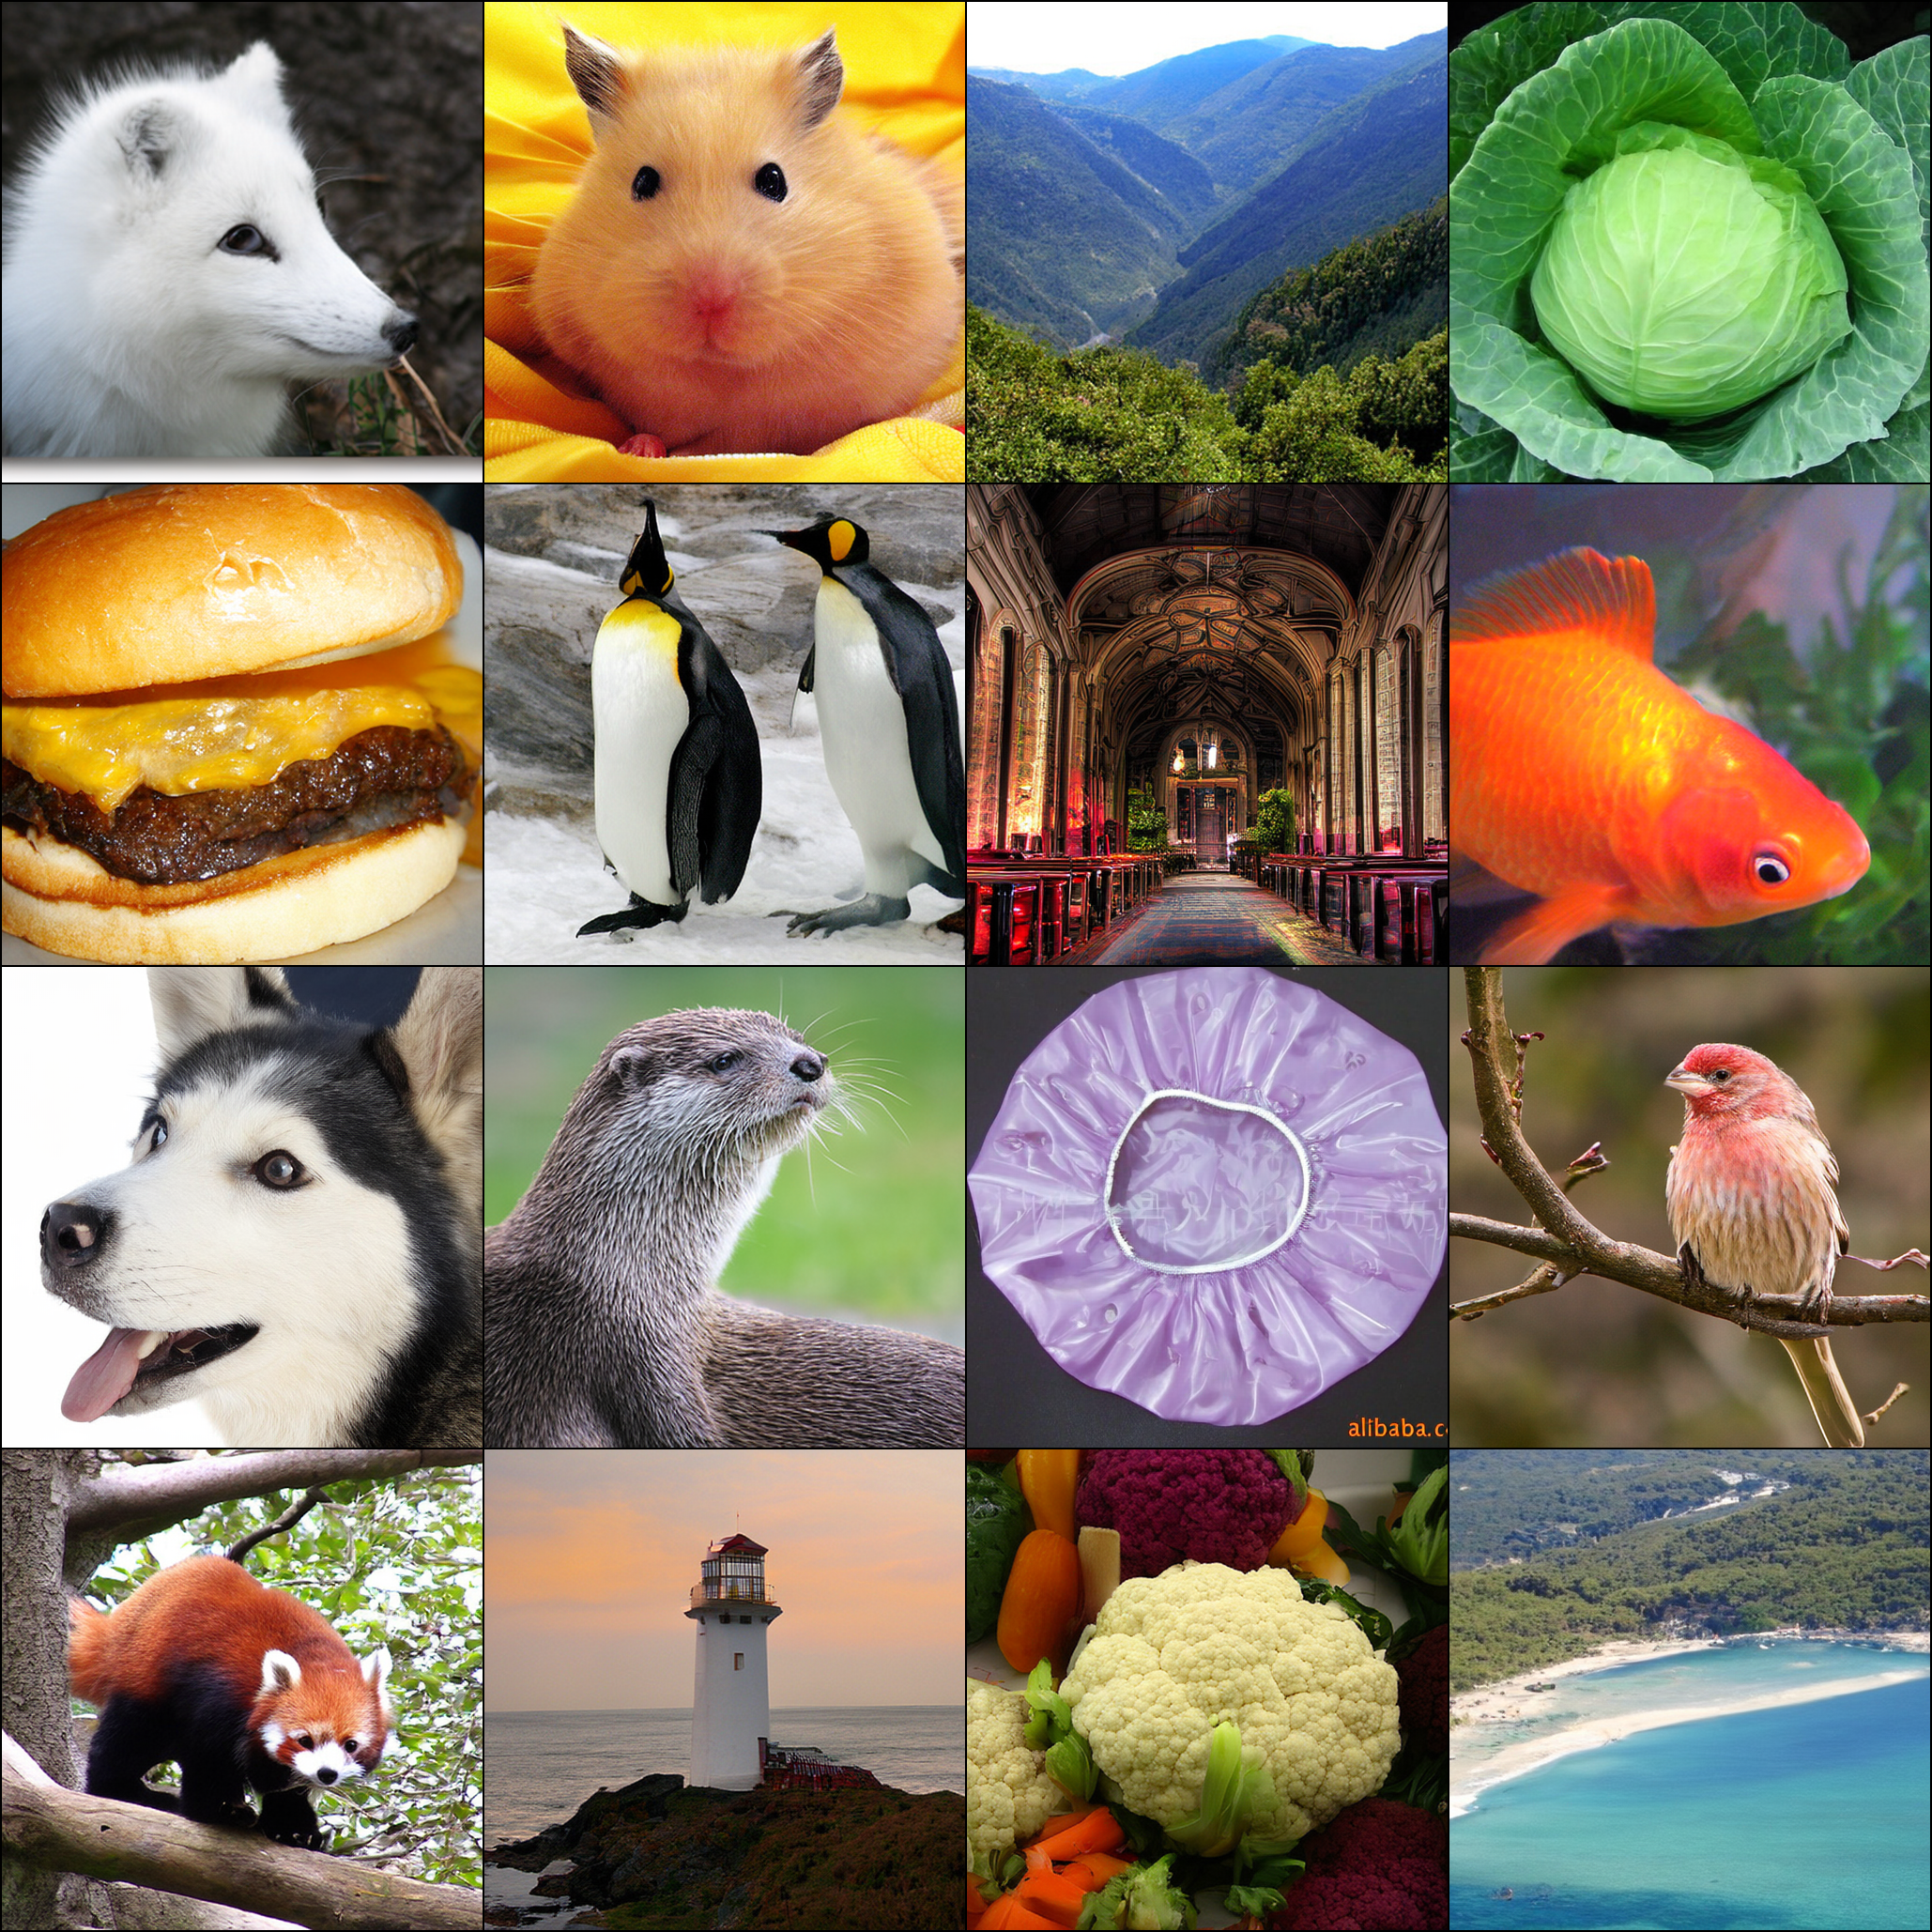
Figure 2: DC-AE speeds up latent diffusion models.

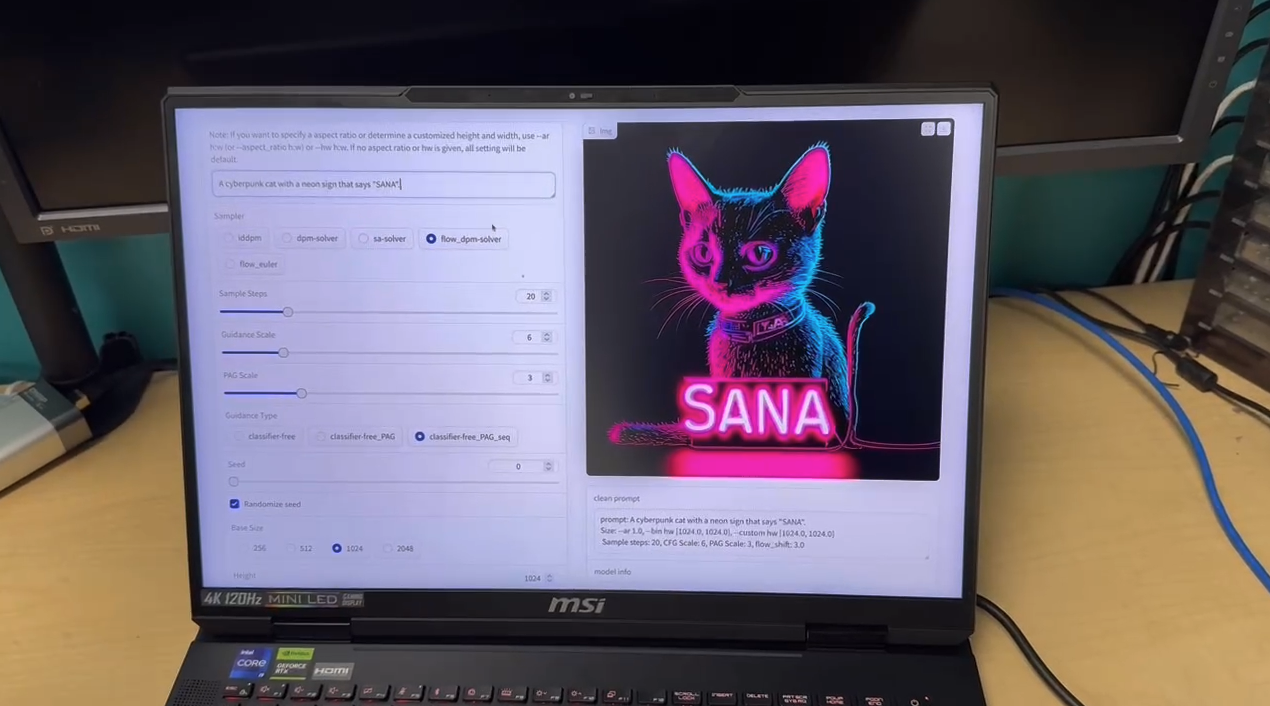
Figure 3: DC-AE enables efficient text-to-image generation on the laptop. For more details, please check our text-to-image diffusion model SANA.
## Abstract We present Deep Compression Autoencoder (DC-AE), a new family of autoencoder models for accelerating high-resolution diffusion models. Existing autoencoder models have demonstrated impressive results at a moderate spatial compression ratio (e.g., 8x), but fail to maintain satisfactory reconstruction accuracy for high spatial compression ratios (e.g., 64x). We address this challenge by introducing two key techniques: (1) Residual Autoencoding, where we design our models to learn residuals based on the space-to-channel transformed features to alleviate the optimization difficulty of high spatial-compression autoencoders; (2) Decoupled High-Resolution Adaptation, an efficient decoupled three-phases training strategy for mitigating the generalization penalty of high spatial-compression autoencoders. With these designs, we improve the autoencoder's spatial compression ratio up to 128 while maintaining the reconstruction quality. Applying our DC-AE to latent diffusion models, we achieve significant speedup without accuracy drop. For example, on ImageNet 512x512, our DC-AE provides 19.1x inference speedup and 17.9x training speedup on H100 GPU for UViT-H while achieving a better FID, compared with the widely used SD-VAE-f8 autoencoder. ## Usage ### Deep Compression Autoencoder (Diffusers) ```bash pip install -U diffusers ``` ```python from PIL import Image import torch import torchvision.transforms as transforms from torchvision.utils import save_image from diffusers import AutoencoderDC device = torch.device("cuda") dc_ae: AutoencoderDC = AutoencoderDC.from_pretrained(f"mit-han-lab/dc-ae-f64c128-in-1.0-diffusers", torch_dtype=torch.float32).to(device).eval() transform = transforms.Compose([ transforms.ToTensor(), transforms.Normalize(0.5, 0.5), ]) image = Image.open("assets/fig/girl.png") x = transform(image)[None].to(device) latent = dc_ae.encode(x).latent y = dc_ae.decode(latent).sample save_image(y * 0.5 + 0.5, "demo_dc_ae.png") ``` Alternatively, you can also use the following script to get the reconstruction result. ``` bash python -m applications.dc_ae.demo_dc_ae_model_diffusers model=dc-ae-f32c32-in-1.0-diffusers run_dir=.demo/reconstruction/dc-ae-f32c32-in-1.0-diffusers input_path_list=[assets/fig/girl.png] ``` ### Deep Compression Autoencoder (EfficientViT) | Autoencoder | Latent Shape | Training Dataset | Note | | :---------------------------------------------------------------------------------: | :-----------------------------------------: | :-------------------: | :----: | | [dc-ae-f32c32-in-1.0](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0) | $32\times\frac{H}{32}\times\frac{W}{32}$ | ImageNet | | | [dc-ae-f64c128-in-1.0](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0) | $128\times\frac{H}{64}\times\frac{W}{64}$ | ImageNet | | | [dc-ae-f128c512-in-1.0](https://huggingface.co/mit-han-lab/dc-ae-f128c512-in-1.0) | $512\times\frac{H}{128}\times\frac{W}{128}$ | ImageNet | | | [dc-ae-f32c32-mix-1.0](https://huggingface.co/mit-han-lab/dc-ae-f32c32-mix-1.0) | $32\times\frac{H}{32}\times\frac{W}{32}$ | A Mixture of Datasets | | | [dc-ae-f64c128-mix-1.0](https://huggingface.co/mit-han-lab/dc-ae-f64c128-mix-1.0) | $128\times\frac{H}{64}\times\frac{W}{64}$ | A Mixture of Datasets | | | [dc-ae-f128c512-mix-1.0](https://huggingface.co/mit-han-lab/dc-ae-f128c512-mix-1.0) | $512\times\frac{H}{128}\times\frac{W}{128}$ | A Mixture of Datasets | | | [dc-ae-f32c32-sana-1.0](https://huggingface.co/mit-han-lab/dc-ae-f32c32-sana-1.0) | $32\times\frac{H}{32}\times\frac{W}{32}$ | A Mixture of Datasets | The autoencoder used in [SANA](https://github.com/NVlabs/Sana) | | [dc-ae-f32c32-sana-1.1](https://huggingface.co/mit-han-lab/dc-ae-f32c32-sana-1.1) | $32\times\frac{H}{32}\times\frac{W}{32}$ | A Mixture of Datasets | [Improved decoder from dc-ae-f32c32-sana-1.0](../../assets/docs/dc_ae_sana_1.1.md) | ```python # build DC-AE models # full DC-AE model list: https://huggingface.co/collections/mit-han-lab/dc-ae-670085b9400ad7197bb1009b from efficientvit.ae_model_zoo import DCAE_HF dc_ae = DCAE_HF.from_pretrained(f"mit-han-lab/dc-ae-f64c128-in-1.0") # encode from PIL import Image import torch import torchvision.transforms as transforms from torchvision.utils import save_image from efficientvit.apps.utils.image import DMCrop device = torch.device("cuda") dc_ae = dc_ae.to(device).eval() transform = transforms.Compose([ DMCrop(512), # resolution transforms.ToTensor(), transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)), ]) image = Image.open("assets/fig/girl.png") x = transform(image)[None].to(device) latent = dc_ae.encode(x) print(latent.shape) # decode y = dc_ae.decode(latent) save_image(y * 0.5 + 0.5, "demo_dc_ae.png") ``` Alternatively, you can also use the following script to get the reconstruction result. ``` bash python -m applications.dc_ae.demo_dc_ae_model model=dc-ae-f32c32-in-1.0 run_dir=.demo/reconstruction/dc-ae-f32c32-in-1.0 input_path_list=[assets/fig/girl.png] ``` ### Efficient Diffusion Models with DC-AE | Autoencoder | Diffusion Model | Params (M) | MACs (G) | ImageNet 512x512 FID (without cfg) | ImageNet 512x512 FID (with cfg) | | :------------------------------------------------------------------: | :------------------------------------------------------------------------------------------------------------------: | :-----: | :----: | :-----------: | :----------: | | [DC-AE-f32](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0) | [UViT-S](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0-uvit-s-in-512px) | 44.79 | 12.27 | 46.12 | 18.08 | | [DC-AE-f32](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0) | [DiT-XL](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0-dit-xl-in-512px) | 674.89 | 118.68 | 9.56 | 2.84 | | [DC-AE-f32](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0) | [DiT-XL (train batch size 1024)](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0-dit-xl-in-512px-trainbs1024) | 674.89 | 118.68 | 6.88 | 2.41 | | [DC-AE-f32](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0) | [UViT-H](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0-uvit-h-in-512px) | 500.87 | 133.25 | 9.83 | 2.53 | | [DC-AE-f64](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0) | [UViT-H](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0-uvit-h-in-512px) | 500.87 | 33.25 | 13.96 | 3.01 | | [DC-AE-f64](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0) | [UViT-H (train 2000k steps)](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0-uvit-h-in-512px-train2000k) | 500.87 | 33.25 | 12.26 | 2.66 | | [DC-AE-f32](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0) | [UViT-2B](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0-uvit-2b-in-512px) | 1580.40 | 414.91 | 8.13 | 2.30 | | [DC-AE-f64](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0) | [UViT-2B](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0-uvit-2b-in-512px) | 1580.40 | 104.65 | 7.78 | 2.47 | | [DC-AE-f64](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0) | [UViT-2B (train 2000k steps)](https://huggingface.co/mit-han-lab/dc-ae-f64c128-in-1.0-uvit-2b-in-512px-train2000k) | 1580.40 | 104.65 | 6.50 | 2.25 | | [DC-AE-f32](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0) | [USiT-H](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0-usit-h-in-512px) | 500.87 | 33.25 | 3.80 | 1.89 | | [DC-AE-f32](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0) | [USiT-2B](https://huggingface.co/mit-han-lab/dc-ae-f32c32-in-1.0-usit-2b-in-512px) | 1580.40 | 414.91 | 2.90 | 1.72 | ```python # build DC-AE-Diffusion models # full DC-AE-Diffusion model list: https://huggingface.co/collections/mit-han-lab/dc-ae-diffusion-670dbb8d6b6914cf24c1a49d from efficientvit.diffusion_model_zoo import DCAE_Diffusion_HF dc_ae_diffusion = DCAE_Diffusion_HF.from_pretrained(f"mit-han-lab/dc-ae-f64c128-in-1.0-uvit-h-in-512px-train2000k") # denoising on the latent space import torch import numpy as np from torchvision.utils import save_image torch.set_grad_enabled(False) device = torch.device("cuda") dc_ae_diffusion = dc_ae_diffusion.to(device).eval() seed = 0 torch.manual_seed(seed) torch.cuda.manual_seed_all(seed) eval_generator = torch.Generator(device=device) eval_generator.manual_seed(seed) prompts = torch.tensor( [279, 333, 979, 936, 933, 145, 497, 1, 248, 360, 793, 12, 387, 437, 938, 978], dtype=torch.int, device=device ) num_samples = prompts.shape[0] prompts_null = 1000 * torch.ones((num_samples,), dtype=torch.int, device=device) latent_samples = dc_ae_diffusion.diffusion_model.generate(prompts, prompts_null, 6.0, eval_generator) latent_samples = latent_samples / dc_ae_diffusion.scaling_factor # decode image_samples = dc_ae_diffusion.autoencoder.decode(latent_samples) save_image(image_samples * 0.5 + 0.5, "demo_dc_ae_diffusion.png", nrow=int(np.sqrt(num_samples))) ``` ## Evaluate Deep Compression Autoencoder - Download the ImageNet dataset to `~/dataset/imagenet`. - Generate reference for FID computation: ```bash torchrun --nnodes=1 --nproc_per_node=8 -m applications.dc_ae.generate_reference \ dataset=imagenet imagenet.resolution=512 imagenet.image_mean=[0.,0.,0.] imagenet.image_std=[1.,1.,1.] split=test \ fid.save_path=assets/data/fid/imagenet_512_val.npz ``` - Run evaluation: ```bash # full DC-AE model list: https://huggingface.co/collections/mit-han-lab/dc-ae-670085b9400ad7197bb1009b torchrun --nnodes=1 --nproc_per_node=8 -m applications.dc_ae.eval_dc_ae_model dataset=imagenet_512 model=dc-ae-f64c128-in-1.0 run_dir=tmp # Expected results: # fid: 0.2167766520628902 # psnr: 26.1489275 # ssim: 0.710486114025116 # lpips: 0.0802311897277832 ``` ## Demo DC-AE-Diffusion Models ``` bash # full DC-AE-Diffusion model list: https://huggingface.co/collections/mit-han-lab/dc-ae-diffusion-670dbb8d6b6914cf24c1a49d torchrun --nnodes=1 --nproc_per_node=1 -m applications.dc_ae.demo_dc_ae_diffusion_model model=dc-ae-f64c128-in-1.0-uvit-h-in-512px-train2000k run_dir=.demo/diffusion/dc-ae-f64c128-in-1.0-uvit-h-in-512px-train2000k ``` Expected results: