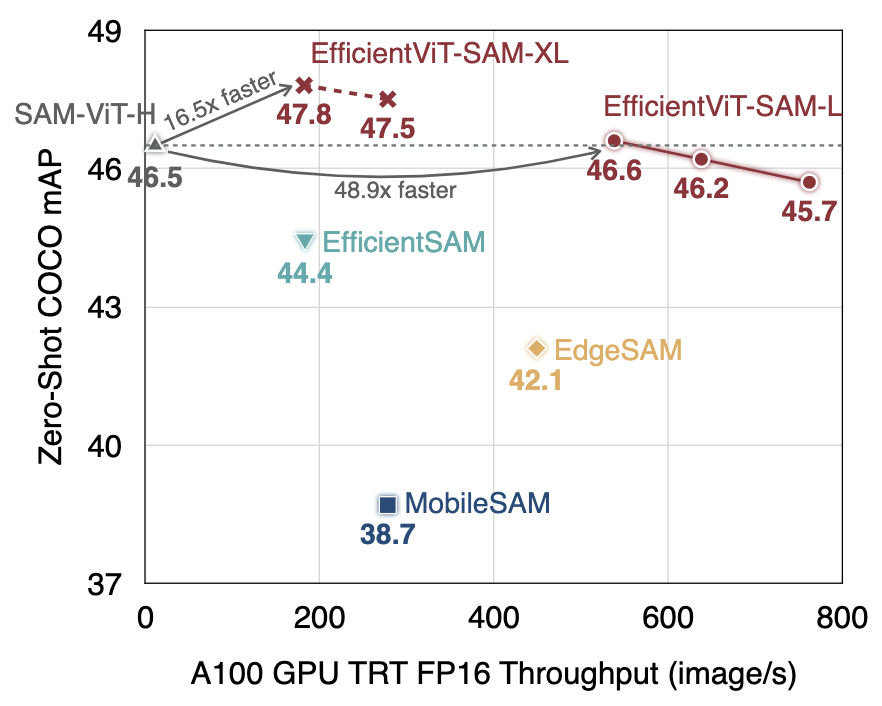
Table1: Summary of All EfficientViT-SAM Variants. COCO mAP and LVIS mAP are measured using ViTDet's predicted bounding boxes as the prompt. End-to-end Jetson Orin latency and A100 throughput are measured with TensorRT and fp16.
## Usage ```python # segment anything from efficientvit.sam_model_zoo import create_efficientvit_sam_model efficientvit_sam = create_efficientvit_sam_model(name="efficientvit-sam-xl1", pretrained=True) efficientvit_sam = efficientvit_sam.cuda().eval() ``` ```python from efficientvit.models.efficientvit.sam import EfficientViTSamPredictor efficientvit_sam_predictor = EfficientViTSamPredictor(efficientvit_sam) ``` ```python from efficientvit.models.efficientvit.sam import EfficientViTSamAutomaticMaskGenerator efficientvit_mask_generator = EfficientViTSamAutomaticMaskGenerator(efficientvit_sam) ``` ## Evaluation ### Box-Prompted Zero-Shot Instance Segmentation #### Ground Truth Bounding Box ```bash # COCO torchrun --nproc_per_node=8 applications/efficientvit_sam/eval_efficientvit_sam_model.py --dataset coco --image_root ~/dataset/coco/val2017 --annotation_json_file ~/dataset/coco/annotations/instances_val2017.json --model efficientvit-sam-xl1 --prompt_type box # expected results: all=79.927, large=83.748, medium=82.210, small=75.833 ``` ```bash # LVIS torchrun --nproc_per_node=8 applications/efficientvit_sam/eval_efficientvit_sam_model.py --dataset lvis --image_root ~/dataset/coco --annotation_json_file ~/dataset/coco/annotations/lvis_v1_val.json --model efficientvit-sam-xl1 --prompt_type box # expected results: all=79.886, large=91.577, medium=88.447, small=74.412 ``` #### Detected Bounding Box ```bash # COCO torchrun --nproc_per_node=8 applications/efficientvit_sam/eval_efficientvit_sam_model.py --dataset coco --image_root ~/dataset/coco/val2017 --annotation_json_file ~/dataset/coco/annotations/instances_val2017.json --model efficientvit-sam-xl1 --prompt_type box_from_detector --source_json_file ~/dataset/coco/source_json_file/coco_vitdet.json # expected results: # Average Precision (AP) @[ IoU=0.50:0.95 | area= all | maxDets=100 ] = 0.478 ``` ```bash # LVIS torchrun --nproc_per_node=8 applications/efficientvit_sam/eval_efficientvit_sam_model.py --dataset lvis --image_root ~/dataset/coco --annotation_json_file ~/dataset/coco/annotations/lvis_v1_val.json --model efficientvit-sam-xl1 --prompt_type box_from_detector --source_json_file ~/dataset/coco/source_json_file/lvis_vitdet.json # expected results: # Average Precision (AP) @[ IoU=0.50:0.95 | area= all | maxDets=300 catIds=all] = 0.444 ``` ### Point-Prompted Zero-Shot Instance Segmentation ```bash # COCO torchrun --nproc_per_node=8 applications/efficientvit_sam/eval_efficientvit_sam_model.py --dataset coco --image_root ~/dataset/coco/val2017 --annotation_json_file ~/dataset/coco/annotations/instances_val2017.json --model efficientvit-sam-xl1 --prompt_type point --num_click 1 # expected results: all=59.757, large=62.132, medium=63.837, small=55.029 ``` ```bash # LVIS torchrun --nproc_per_node=8 applications/efficientvit_sam/eval_efficientvit_sam_model.py --dataset lvis --image_root ~/dataset/coco --annotation_json_file ~/dataset/coco/annotations/lvis_v1_val.json --model efficientvit-sam-xl1 --prompt_type point --num_click 1 # expected results: all=56.624, large=72.442, medium=71.796, small=47.750 ``` ## Visualization Please run [demo_efficientvit_sam_model.py](demo_efficientvit_sam_model.py) to visualize our segment anything models. Example: ```bash # segment everything python applications/efficientvit_sam/demo_efficientvit_sam_model.py --model efficientvit-sam-xl1 --mode all # prompt with points python applications/efficientvit_sam/demo_efficientvit_sam_model.py --model efficientvit-sam-xl1 --mode point # prompt with box python applications/efficientvit_sam/demo_efficientvit_sam_model.py --model efficientvit-sam-xl1 --mode box --box "[150,70,640,400]" ``` ## Deployment ### ONNX Export ```bash # Export Encoder python applications/efficientvit_sam/deployment/onnx/export_encoder.py --model efficientvit-sam-xl1 --output assets/export_models/efficientvit_sam/onnx/efficientvit_sam_xl1_encoder.onnx ``` ```bash # Export Decoder python applications/efficientvit_sam/deployment/onnx/export_decoder.py --model efficientvit-sam-xl1 --output assets/export_models/efficientvit_sam/onnx/efficientvit_sam_xl1_decoder.onnx --return-single-mask ``` ```bash # ONNX Inference python applications/efficientvit_sam/run_efficientvit_sam_onnx.py --model efficientvit-sam-xl1 --encoder_model assets/export_models/efficientvit_sam/onnx/efficientvit_sam_xl1_encoder.onnx --decoder_model assets/export_models/efficientvit_sam/onnx/efficientvit_sam_xl1_decoder.onnx --mode point ``` ### TensorRT Export ```bash mkdir -p assets/export_models/efficientvit_sam/tensorrt/ # Export Encoder trtexec --onnx=assets/export_models/efficientvit_sam/onnx/efficientvit_sam_xl1_encoder.onnx --minShapes=input_image:1x3x1024x1024 --optShapes=input_image:4x3x1024x1024 --maxShapes=input_image:4x3x1024x1024 --saveEngine=assets/export_models/efficientvit_sam/tensorrt/efficientvit_sam_xl1_encoder.engine ``` ```bash # Export Decoder trtexec --onnx=assets/export_models/efficientvit_sam/onnx/efficientvit_sam_xl1_decoder.onnx --minShapes=point_coords:1x1x2,point_labels:1x1 --optShapes=point_coords:16x2x2,point_labels:16x2 --maxShapes=point_coords:16x2x2,point_labels:16x2 --fp16 --saveEngine=assets/export_models/efficientvit_sam/tensorrt/efficientvit_sam_xl1_decoder.engine ``` ```bash # TensorRT Inference python applications/efficientvit_sam/run_efficientvit_sam_trt.py --model efficientvit-sam-xl1 --encoder_engine assets/export_models/efficientvit_sam/tensorrt/efficientvit_sam_xl1_encoder.engine --decoder_engine assets/export_models/efficientvit_sam/tensorrt/efficientvit_sam_xl1_decoder.engine --mode point ``` ## Training Download the [distilled models](https://huggingface.co/mit-han-lab/efficientvit-sam/tree/main/distilled_model) and place them under `assets/checkpoints/efficientvit_sam/distilled_model/`. ```bash torchrun --nproc_per_node=8 applications/efficientvit_sam/train_efficientvit_sam_model.py applications/efficientvit_sam/configs/efficientvit_sam_xl1.yaml --data_provider.root ~/dataset/sam/ --path .exp/efficientvit_sam/efficientvit_sam_xl1 --resume ``` ## Reference If EfficientViT or EfficientViT-SAM is useful or relevant to your research, please kindly recognize our contributions by citing our papers: ```bibtex @inproceedings{cai2023efficientvit, title={Efficientvit: Lightweight multi-scale attention for high-resolution dense prediction}, author={Cai, Han and Li, Junyan and Hu, Muyan and Gan, Chuang and Han, Song}, booktitle={Proceedings of the IEEE/CVF International Conference on Computer Vision}, pages={17302--17313}, year={2023} } @article{zhang2024efficientvit, title={EfficientViT-SAM: Accelerated Segment Anything Model Without Performance Loss}, author={Zhang, Zhuoyang and Cai, Han and Han, Song}, journal={arXiv preprint arXiv:2402.05008}, year={2024} } ```