# wgpu-kit
> 浏览器创意编程 GPU 工具包:20 万粒子物理 120fps,只需 5 行代码。(所有 fps 均为**可见帧**)
> WebGPU 计算的全套样板——设备、缓冲、管线、dispatch、双缓冲、读回、错误行号映射——打包成两层简单 API。
[](https://github.com/nanfengw0w/wgpu-kit/actions/workflows/ci.yml) [](https://www.npmjs.com/package/wgpu-kit) [](LICENSE)
English: [README.md](README.md) · [API 参考(中文)](docs/API.zh-CN.md) · [API 参考(中文)](docs/API.zh-CN.md) · [API Reference (English)](docs/API.md) · **[在线演示](https://nanfengw0w.github.io/wgpu-kit/)**
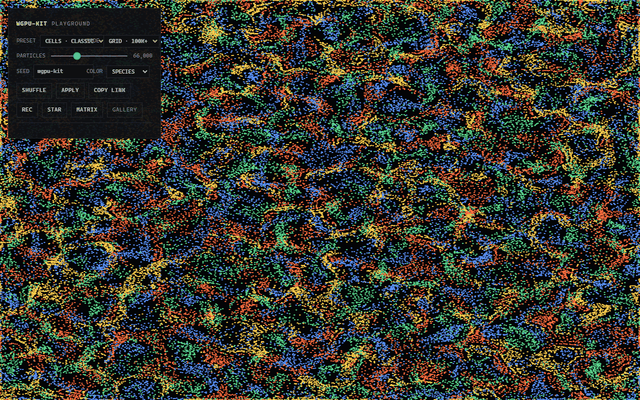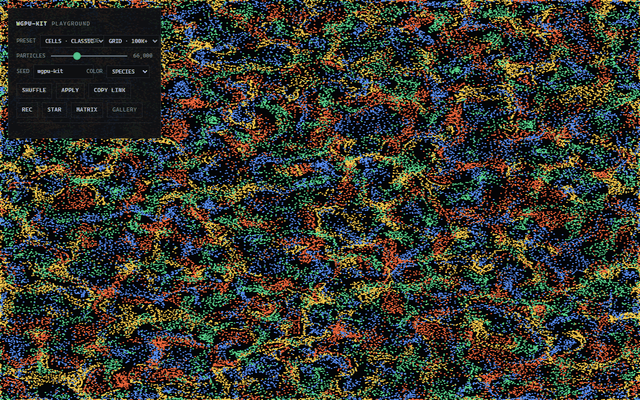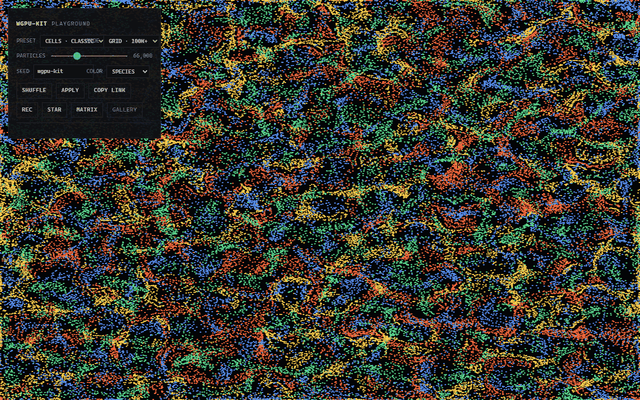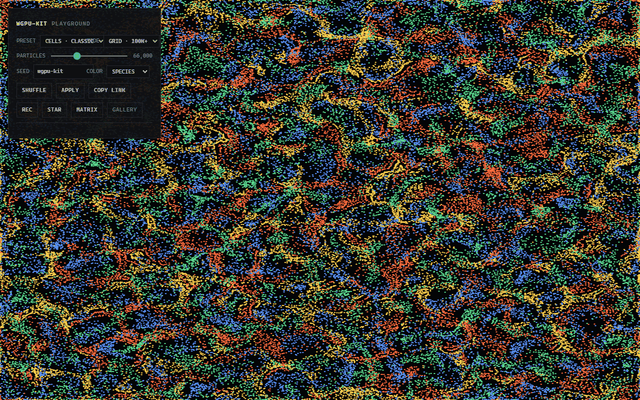
## 快速开始
```bash
npm i wgpu-kit
```
**5 行,10 万粒子:**
```ts
import { particles } from 'wgpu-kit';
const sim = await particles({ count: 100_000, forces: 'cells' });
await sim.attach(canvas);
function frame() { sim.tick(); requestAnimationFrame(frame); }
frame();
```
**自定义 GPU 计算**——你只写"单个元素怎么变"的函数:
```ts
import { elementKernel, Buffer } from 'wgpu-kit';
const pos = await Buffer.create('vec2f', 100_000);
const vel = await Buffer.create('vec2f', 100_000);
const integrate = elementKernel({
state: { pos: 'vec2f' },
inputs: { vel: 'vec2f' },
uniforms: { dt: 'f32' },
code: `
fn userFn(idx: u32, dt: f32) {
pos[idx] = (pos[idx] + vel[idx] * dt) * 0.99;
}
`,
});
await integrate.run({ pos, vel }, { dt: 0.02 });
```
## 入口一览
| 导入 | 用途 |
| --- | --- |
| `wgpu-kit` | elementKernel 核心 + Buffer / PingPong / rawKernel + **类型化 schema** + **pack 平台** |
| `wgpu-kit/particles` | 粒子生命:力矩阵预设、自适应世界、热更新 |
| `wgpu-kit/life` | 图灵斑图 / 粘菌 / Boids / 软体触手 |
| `wgpu-kit/fields` | 向量场平迹 |
| `wgpu-kit/image` | GPU 滤镜管线(blur/sharpen/edge/…) |
| `wgpu-kit/react` | `` |
| `wgpu-kit/three` | three.js 快照互通 |
| `wgpu-kit/media` | 画布录制(webm/mp4) |
| `wgpu-kit/observe` | GPU 计时 / 设备诊断 / 画布助手 |
| `wgpu-kit/vite` | WGSL kernel 热重载 |
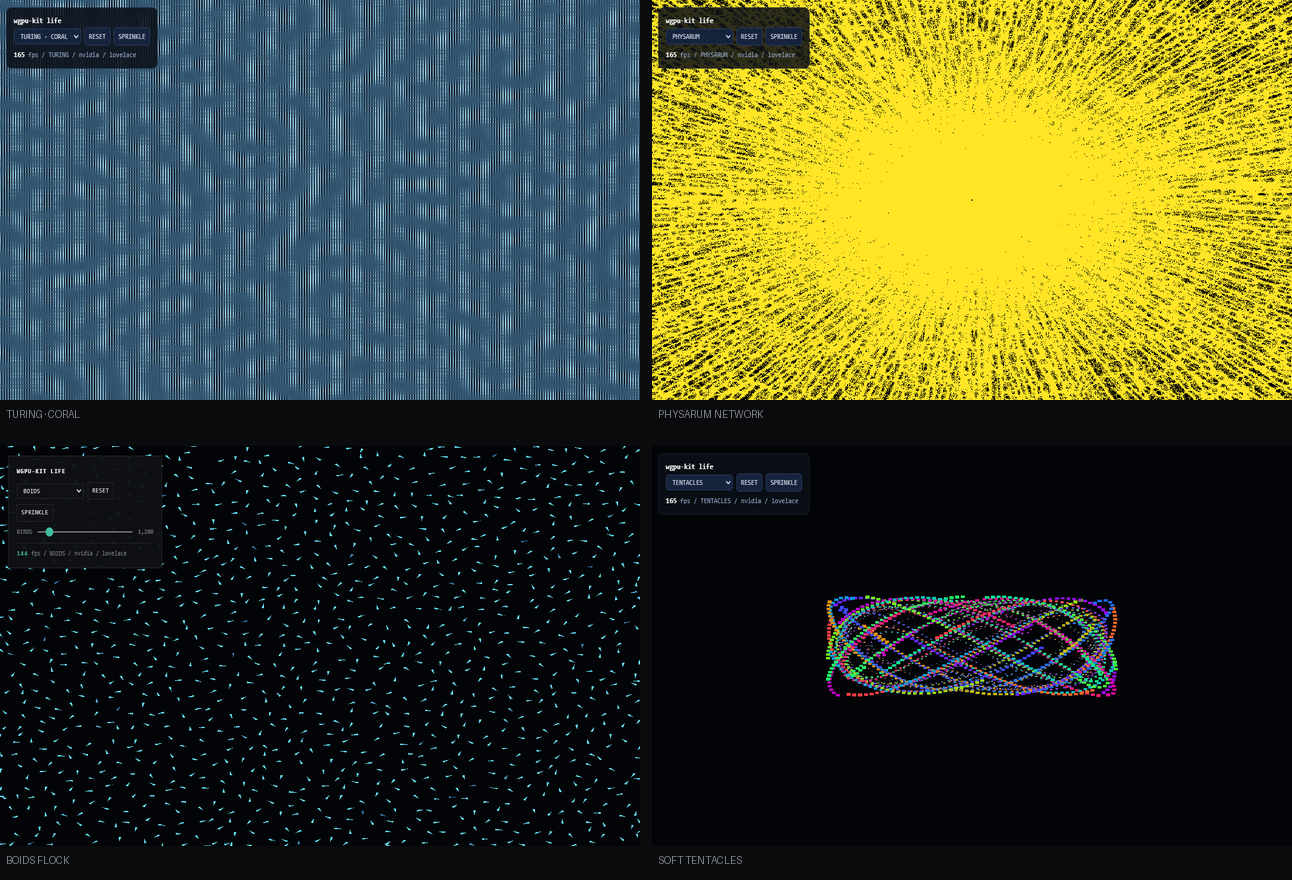
*life 包:图灵斑图 / 粘菌 / Boids / 软体触手 — [打开演示](https://nanfengw0w.github.io/wgpu-kit/life.html)。*
## 类型化 schema
WGSL 仍是 WGSL,但**字段表不再是会写错的字符串**。声明一次,TS 行类型、
WGSL struct 代码和 GPU 缓冲全部同源;拼错字段是编辑器里的红线,不是运行时错误:
```ts
import { defineSchema, elementKernel } from 'wgpu-kit';
const Boid = defineSchema({ pos: 'vec2f', vel: 'vec2f', species: 'u32' });
type Boid = SchemaInfer; // { pos: {x,y}, vel: {x,y}, species: number }
const bufs = await Boid.buffers(count);
bufs.pos.write([{ x: 1, y: 2 }, /* … */]); // ❌ 写成 `{ z: 0 }` 编译期就报
const k = elementKernel({ state: Boid.fields, code: 'fn userFn(idx: u32) { … }' });
await k.run(bufs.raws());
const rows = await bufs.pos.read(); // 返回带类型的行对象
```
诚实边界:WGSL 函数体**内部**的拼写错误仍由 WGSL 编译器报错(带你的行号映射)。
完整的 WGSL 类型检查是编译器工程;本层消灭的是 JS/WGSL **schema 漂移**和
无类型的 buffer 读写。
## 平台,不是功能列表
内置包没有任何特权。`definePack` 就是内置包自己用的契约——统一生命周期、
统计、自验证 `probe()` 和注册表:
```ts
import { definePack, registerPack, listPacks } from 'wgpu-kit';
const orbit = definePack({
name: 'orbit',
description: 'my N-body toy',
create: async (config) => {
// … 用 elementKernel / rawKernel 搭你的模拟 …
return {
tick() { /* … */ },
async probe() { return { energyDrift: 0.003 }; }, // verify harness 会收集
destroy() { /* … */ },
};
},
});
registerPack(orbit);
listPacks(); // [{ name: 'particles', … }, { name: 'fields', … }, { name: 'orbit', … }]
```
`probe()` 是平台的关键约定:第三方包在验证 harness 里享受与内置包完全相同
的待遇——正确性是契约的一部分,不是恩赐。
## 数字(全部可复现)
三种都是真实数字,量的是不同的东西,**别混着读**(双口径全表见
[docs/BENCHMARK.md](docs/BENCHMARK.md),由 `npm run bench` 生成):
- **显示帧率**:playground 里实际看到的 fps,由浏览器节流(探针:URL 加
`?verify=10` 自报);
- **管线饱和吞吐**:3 帧在途泵送——每帧提交不等完成、在途满 3 帧排空一次,
这是 GPU 的持续吞吐上限(`npm run bench` 的"管线 fps"列);
- **同步延迟**:每帧 `tick()` 后等 GPU 完成——单帧往返上界,用于算法 A/B。
| 指标 | 数值 | 口径 | 环境 |
| --- | --- | --- | --- |
| 粒子端到端 | 200,000 @ ~120fps · 66,000 @ ~144fps | 显示 | RTX 4060 Laptop,playground 探针 |
| 粒子计算(grid)同步 | 16k → 200k:3.6 → 36ms/帧 | 同步 | `npm run bench` → docs/BENCHMARK.md |
| 邻域算法 | grid 近似 O(N),66k 时比暴力快 8.5× | 同步 A/B | 同会话 |
| 库体积 | core gzip ~15kB,含类型化 schema 与 pack 平台(共享上下文构建) | — | gzip 预算由 build 强制 |
所以:如果你用每帧 `device.queue.onSubmittedWorkDone()` 去测 grid@200k,
看到的会是 ~30ms——那是同步延迟列,和 120fps 不矛盾。
## 三条设计铁律
1. **第二层 5 分钟出活,第一层不封顶**——`rawKernel` 与原生 `GPUBuffer` 逃生舱常开;
2. **错误说人话**——WGSL 编译失败映射回你的代码行号;
3. **基准即文档**——所有数字可复现;gzip 体积预算由 `npm run build` 强制核对。
## 验证
41+ 自动化探针在真实 GPU 上经 headless Chromium harness 运行(随库附带:
`tests/` + `scripts/verify.mjs`)——包括**物理等价性回归**(n2 / tiled / grid
三种邻域算法结构发散即构建失败),以及扫描不变量与冻结带检测(确定性拦截
半格失效类 bug)。
**CI 中**:正确性子集(smoke / packages / grid 不变量)在每次 push 时于
Chrome 的 SwiftShader WebGPU 上运行——无需 GPU——物理正确性不会在机器之间
悄悄回退。fps 类探针在 CPU 适配器上没有意义,按设计只在真机上跑。
## 支持矩阵
| 浏览器 | 状态 |
| --- | --- |
| Chrome / Edge 113+(含无头) | ✅ 全部验证在此完成(RTX 4060,D3D 后端) |
| Safari 18+ / Firefox | 🔶 WebGPU 可用即应工作;未实测,issue 欢迎 |
| WebGL2 / 无 WebGPU | ❌ 不做降级(设计决策);`detect.html` 可诊断 |
## 许可
[MIT](LICENSE)