Confucius4-T3PO:基于帕累托前沿策略优化的流式翻译
Confucius4-T3PO (simul**T**aneous **T**ranslation via pare**T**o **P**olicy **O**ptimization) 是由网易有道 AI 团队研发的**140 亿参数真流式文本同传翻译模型**,基于高质量同传数据构建 -> 翻译模型流式化冷启动 -> Pareto-Aware的强化学习进行质量-延迟的联合优化。Confucius4-T3PO 支持流式文本输入与实时`READ`/`WRITE`决策机制:在接收每个细粒度文本chunk后,模型动态判断是否继续等待更多上下文,或是立即输出增量译文。与此同时,模型依托交错历史协议组织输入序列,支持 KV-Cache 复用,减少重复计算开销。
本模型为文本到文本(text-to-text)同传模型,本身不支持语音输入。如需支持语音同传,可外接流式自动语音识别(ASR)模型进行串联,我们同步开源了面向同传场景的流式 ASR 模型 [R2T2](https://huggingface.co/netease-youdao/Confucius4-R2T2)。此外还提供[在线演示 Demo](https://t3po.youdao.com),以及可本地部署的 Web UI 与流式客户端。
### 模型特点
- **真流式文本翻译:** 支持基于字、词的细粒度 chunk 输入,已提交译文只追加、不改写,通过交错历史保留稳定前缀,从而复用 KV cache,降低重复计算开销。
- **可调节的延迟档位:** 支持在多个质量—延迟档位间灵活切换,适配从低延迟到高质量的不同同传场景。
- **保留通用指令能力:** 训练并未破坏 Qwen 基座模型本身的通用指令能力,因此可以在此基础上扩展出许多定制化能力,例如术语约束。
- **跨语种泛化能力:** 模型具备一定的跨语种泛化能力。我们观察到未训练的日译中方向同样支持流式同传,但除中英外的语种方向质量尚未经过严格评估。
上述能力源于我们提出的两项核心技术。一是高质量同传分段数据构建算法:该算法支持从常规平行数据中自动构建低延迟的流式翻译数据,能够为模型提供良好的、适配性更高的流式化冷启动先验,无需依赖人工同传语料。二是面向质量—延迟前沿优化的强化学习算法:我们针对同传场景中质量与延迟的冲突目标优化问题,提出了一套Frontier-Aware的强化学习优化算法,显著推进了策略模型的 Pareto 前沿。关于训练方法、数据与更多实现细节,我们将在后续发布的技术报告中详细阐述。
## 目录
- [1 评测结果](#1-评测结果)
- [2 模型下载](#2-模型下载)
- [3 快速入门](#3-快速入门)
- [4 启动本地 Web UI 演示](#4-启动本地-Web-UI-演示)
- [5 联系方式](#5-联系方式)
- [6 引用](#6-引用)
## 1 评测结果
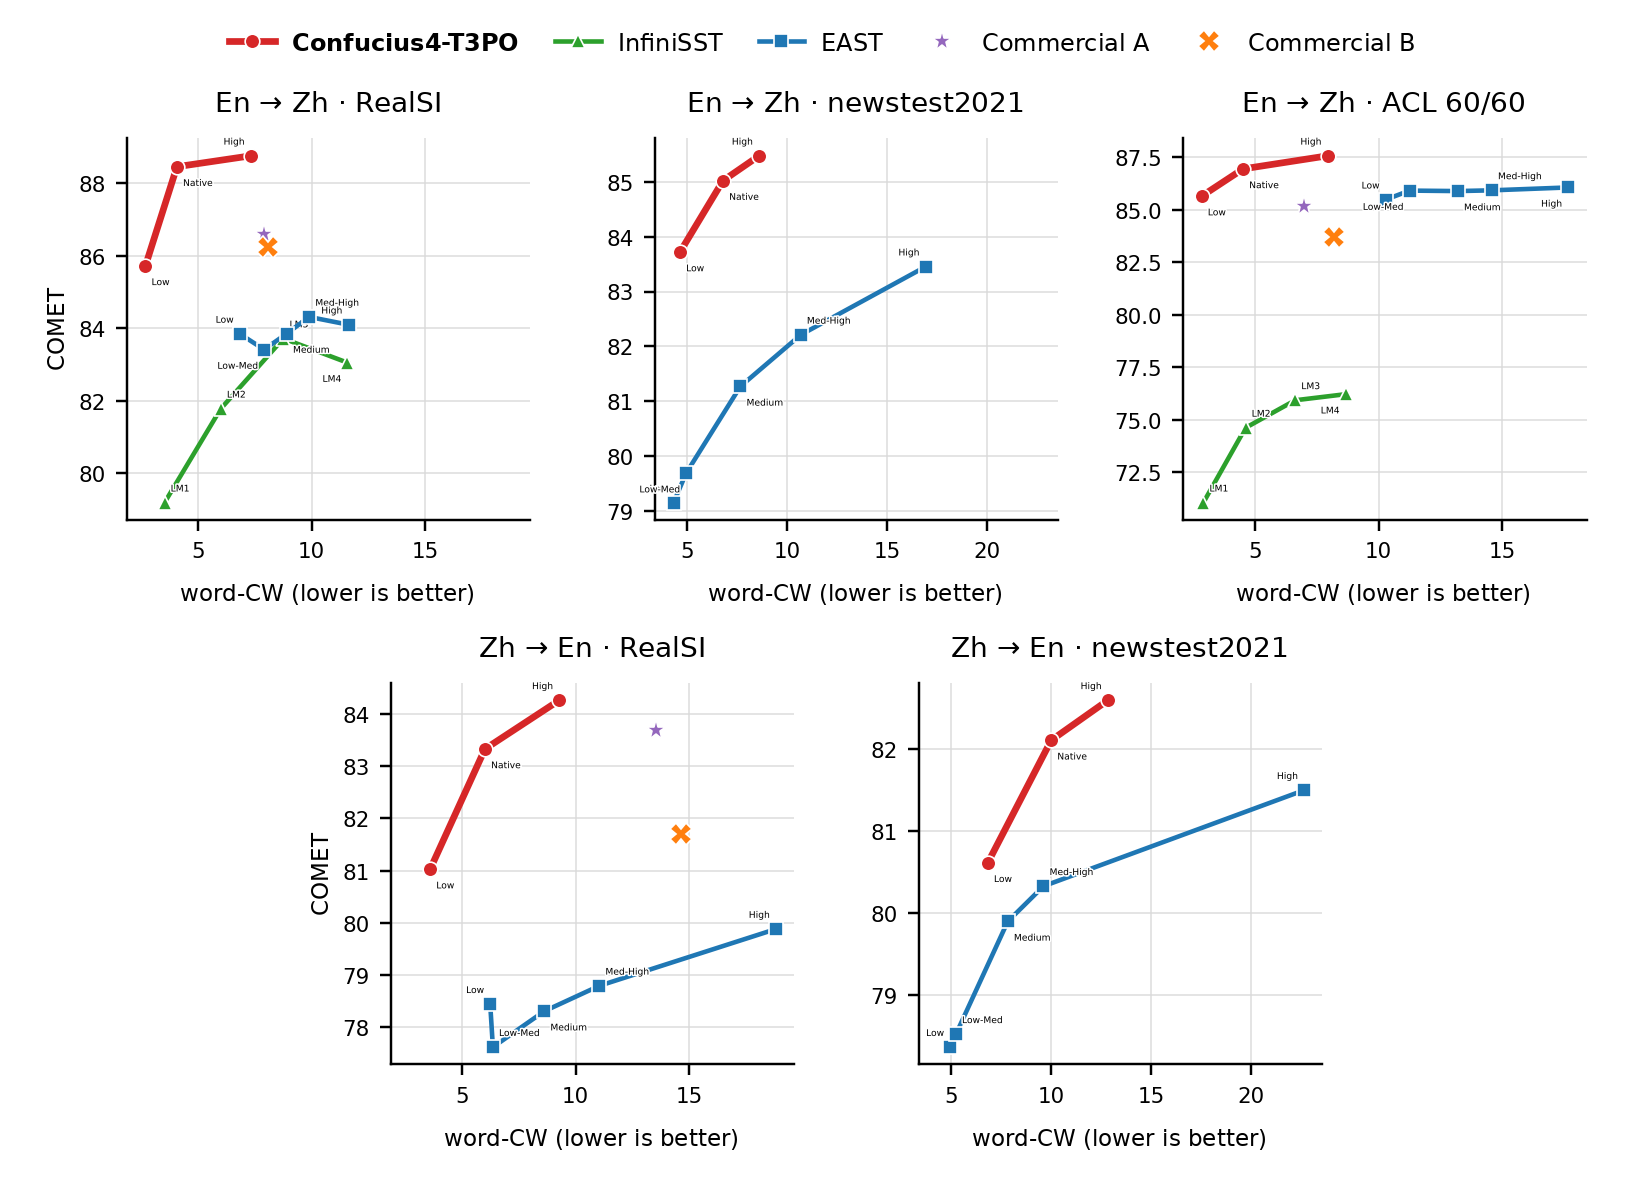
我们在多个中英双向同传开源测试集上对 Confucius4-T3PO 进行了评测,并与开源模型 [InfiniSST](https://aclanthology.org/2025.findings-acl.157.pdf)、[EAST](https://aclanthology.org/2025.findings-acl.1045.pdf) 以及主流商业同传系统 A 和 B 进行了对比。
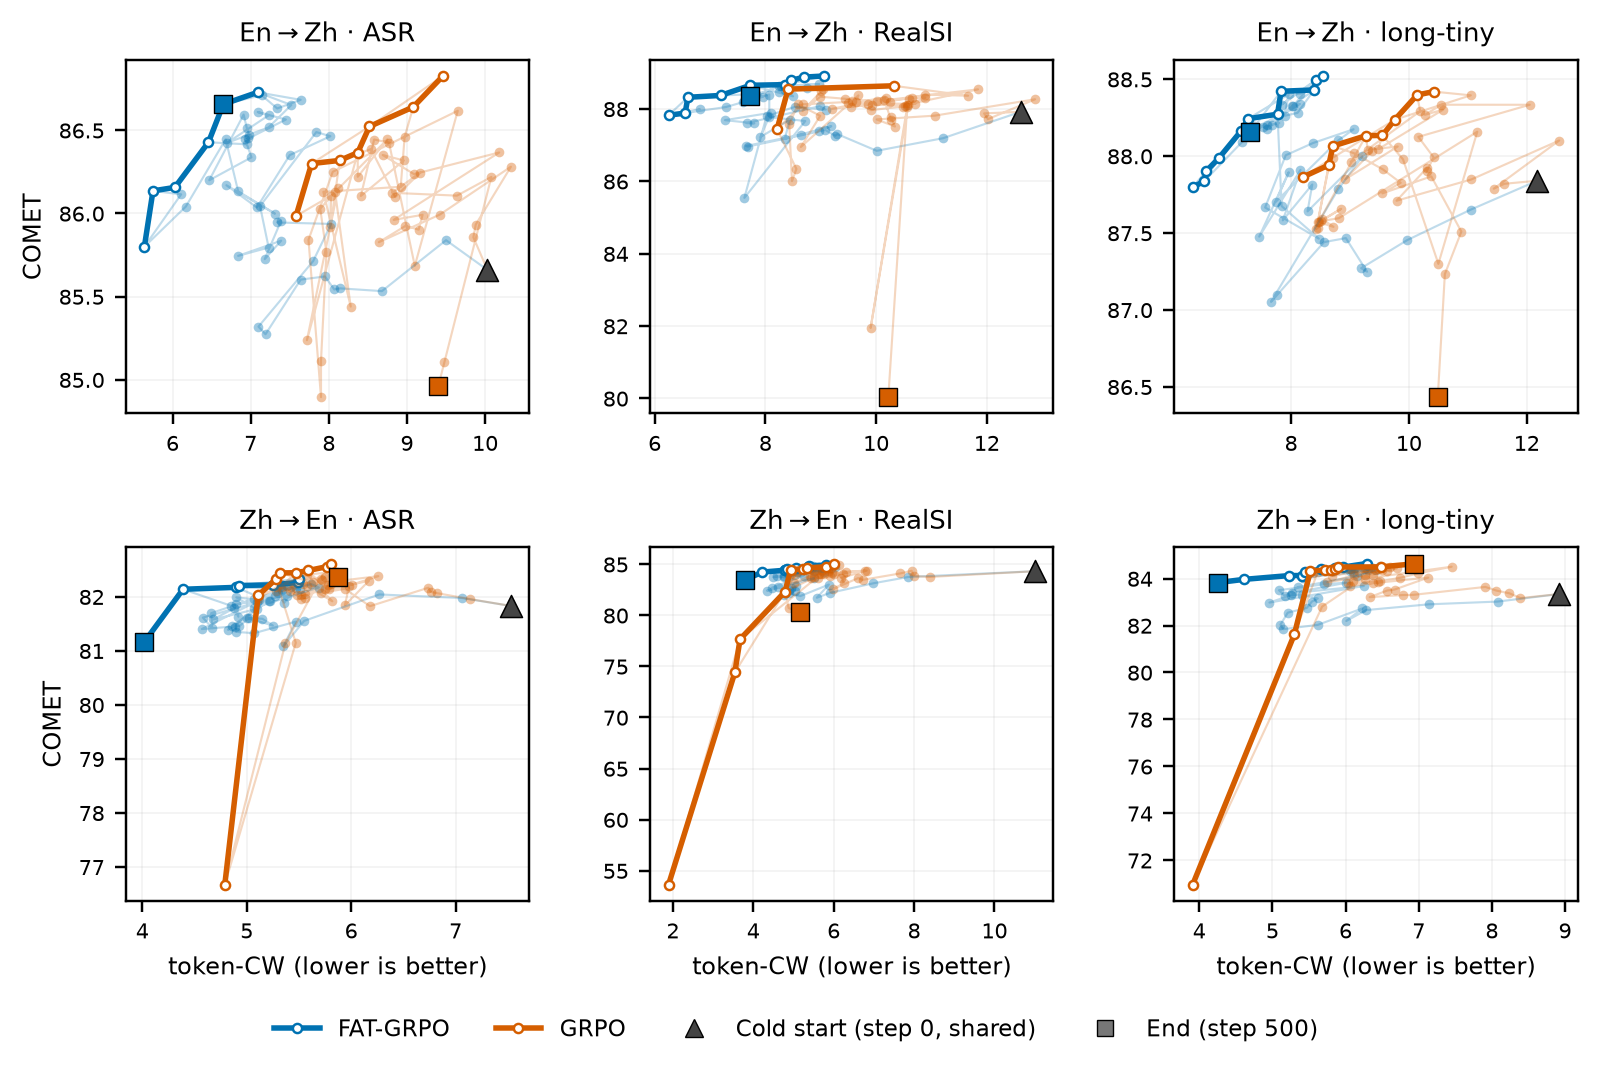
如下图所示,与原始 GRPO 相比,我们提出的训练方法能够更充分地探索并推进质量-延迟的 Pareto 前沿,同时有效避免延迟滑落至质量崩溃的极低区间,保持了训练的稳定性。
## 2 模型下载
| **模型** | **HuggingFace** | **ModelScope** |
| :------: | :------------: | :----------: |
| Confucius4-T3PO | [🤗 HuggingFace](https://huggingface.co/netease-youdao/Confucius4-T3PO) | [ModelScope](https://modelscope.cn/models/netease-youdao/Confucius4-T3PO) |
| Confucius4-T3PO-GGUF | [🤗 HuggingFace](https://huggingface.co/netease-youdao/Confucius4-T3PO-GGUF) | [ModelScope](https://modelscope.cn/models/netease-youdao/Confucius4-T3PO-GGUF) |
## 3 快速入门
### 3.1 安装依赖
```bash
python -m venv .venv && . .venv/bin/activate
pip install -e '.[models]'
```
### 3.2 拉取模型
```bash
# HuggingFace
hf download netease-youdao/Confucius4-T3PO \
--local-dir ./Confucius4-T3PO
# ModelScope
pip install modelscope
modelscope download --model netease-youdao/Confucius4-T3PO \
--local_dir ./Confucius4-T3PO
```
### 3.3 部署 vLLM 服务
使用 vLLM 运行推理服务:
```bash
vllm serve ./Confucius4-T3PO \
--served-model-name Confucius4-T3PO \
--dtype auto \
--port 8010
```
服务就绪后确认:
```bash
curl http://127.0.0.1:8010/v1/models
```
然后配置本项目连接该服务:
```bash
cp .env.example .env
# 编辑 .env:
# VLLM_BASE_URL=http://127.0.0.1:8010/v1
# VLLM_MODEL=Confucius4-T3PO
```
`TRANSLATION_BACKEND` 保持默认的 `auto` 即可:设置了 `VLLM_BASE_URL` 就自动走
vLLM,否则回退到本进程加载 HuggingFace 权重。
> 服务默认无鉴权。若要暴露到本机以外,请用 `vllm serve --api-key ` 并在
> `.env` 中同步设置 `VLLM_API_KEY`。
### 3.4 推理示例
命令行(stdin 每行是一个新的源文本增量):
```bash
printf '大家\n好,\n今天\n我们\n测试\n流式\n翻译。\n' \
| python -m inference.text_inference \
--backend openai \
--base-url http://127.0.0.1:8010/v1 \
--model-id Confucius4-T3PO \
--direction zh2en \
--json-events
```
Python API:
```python
import asyncio
from inference.text_inference import StreamingTextTranslator
async def main() -> None:
translator = StreamingTextTranslator(
model_id="Confucius4-T3PO", # 即 vllm 的 --served-model-name
direction="zh2en",
backend="openai",
base_url="http://127.0.0.1:8010/v1",
)
for chunk in ["这是", "一个", "流式", "翻译示例。"]:
for event in await translator.feed(chunk):
if event["type"] == "translation":
print(event["text"], flush=True)
# 输入结束后强制翻译尾部缓冲区
for event in await translator.flush():
if event["type"] == "translation":
print(event["text"], flush=True)
asyncio.run(main())
```
加载权重、快速验证和单机调试:
```bash
python -m inference.text_inference --model-id ./Confucius4-T3PO --direction zh2en --text '大家好。'
```
### 3.5 延迟档位
评测结果中的三个质量—延迟操作点可以通过 `--latency-mode`(`low`/`native`/`high`)直接选择,档位通过给终止 token 施加 `logit_bias = -tau * scale` 实现:`tau` 为正压低终止 token、减少等待动作,为负则相反;`tau = 0` 即为 native,请求与原生完全一致:
```bash
printf '这个\n方法的\n核心\n思想是\n'
python -m inference.text_inference \
--backend openai --base-url http://127.0.0.1:8010/v1 \
--model-id Confucius4-T3PO --direction zh2en \
--latency-mode native --json-events
```
如需自行扫描,可用 `--wait-margin-threshold ` 覆盖预设值。
## 4 启动本地 Web UI 演示
基于 FastAPI + WebSocket 的交互式网页 Demo,支持麦克风、标签页音频和音频文件输入。 沿用 [3.3](#33-部署-vllm-服务) 的 `.env` 配置:
```bash
bash scripts/start.sh
```
访问 http://127.0.0.1:8000/ 即可体验。若未配置 ASR,页面上的文本调试面板仍可
用于验证翻译效果。
### 4.1 接入流式 ASR
语音输入可通过 WebSocket 转发到独立发布的
[Confucius4-R2T2](https://huggingface.co/netease-youdao/Confucius4-R2T2)
流式 ASR 服务。可参考该仓库的说明单独部署,在本项目的 `.env` 中指向它:
```bash
# .env
ASR_WS_URL=ws://127.0.0.1:8093/asr_stream_api_v1
ASR_SECRET_KEY=test0102
```
> `ASR_SECRET_KEY` 需与 R2T2 服务端接受的密钥一致。R2T2 当前发布版本把它硬编码为
> `test0102`,生产部署时请在 R2T2 侧改为真实密钥并同步此处。
`ASR_WS_URL` 留空则音频输入不可用,页面上的文本调试面板仍可用于验证翻译效果。
`ASR_LANGUAGE` 留空时按会话的 `direction` 自动选择 `Chinese`/`English`;设为
`zhen` 则强制使用 R2T2 的中英混合识别模式。
### 4.2 接口说明
- `GET /api/v1/health`:健康检查。
- `POST /api/v1/translate`:文本增量翻译。首次请求需带 `direction`,响应返回
`session_id`;后续请求携带该 `session_id` 续传,`end=true` 触发尾部 flush
并释放会话。首次请求可带 `latency_mode`(`low`/`native`/`high`)选择延迟档位。
- `GET /api/v1/session/{session_id}/stats`:查询会话的分段与 `WAIT`/`TRANS` 统计。
- `WS /ws/simul-demo`:语音流式翻译。握手后先发
`{"type":"init","direction":"zh2en","latency_mode":"native"}`(`latency_mode`
可省略),服务回 `init_ok` 后开始发送 16kHz
单声道 PCM16LE 音频帧。运行中可发 `{"type":"pause"}` / `{"type":"resume"}`
控制,发 `{"type":"end"}` 结束并触发尾部 flush。
服务端下行事件:`init_ok`、`loading`(`component` 为 `translation` 或 `asr`)、
`asr`(`text` 为 R2T2 转发的新增文本片段,`reset` 为真时表示一句话识别结束,
会同步触发一次翻译尾部 flush)、`translation`、`metrics`、`pause_ok`、
`resume_ok`、`ended`、`error`。完整字段见
[`inference/server.py`](inference/server.py) 与
[`inference/asr.py`](inference/asr.py)。
## 5 联系方式
欢迎加入我们的社区,提出问题、分享想法,并与其他用户和开发者交流。
### 5.1 微信群
扫描下方二维码,加入我们的微信群:
 ### 5.2 商务联系
如需更高并发、更高质量的工业、国产化、私有化部署,或有商务咨询与合作洽谈需求,欢迎通过以下方式联系我们。
- **电话:** +86 010-82558901
- **邮箱:** [AIcloud_Business@corp.youdao.com](mailto:AIcloud_Business@corp.youdao.com)
### 5.3 GitHub Issues
欢迎在本仓库的 [Issues](https://github.com/netease-youdao/Confucius4-T3PO/issues) 中参与讨论、提出问题、反馈缺陷或提供改进建议!
## 6 引用
技术报告发布后,我们会在此补充正式的引用信息。
```bibtex
@misc{Confucius4-T3PO,
author = {NetEase Youdao Team},
title = {Confucius4-T3PO: simulTaneous Translation via pareTo Policy Optimization},
url = {},
month = {Sep},
year = {2026}
}
```