# PrismCat
[English](./README.md) | [简体中文](./README_CN.md)
  
> **你永远不知道 SDK 在你的 Prompt 里偷偷塞了多少东西 —— 直到你用了 PrismCat。**
PrismCat 是一个**自托管的 LLM API 透明代理与调试控制台**。
只需改一行 `base_url`,即可完整记录你的应用与 OpenAI / Claude / Gemini / Ollama 等任意 LLM API 之间的所有通信 —— 包括流式响应 (SSE)。
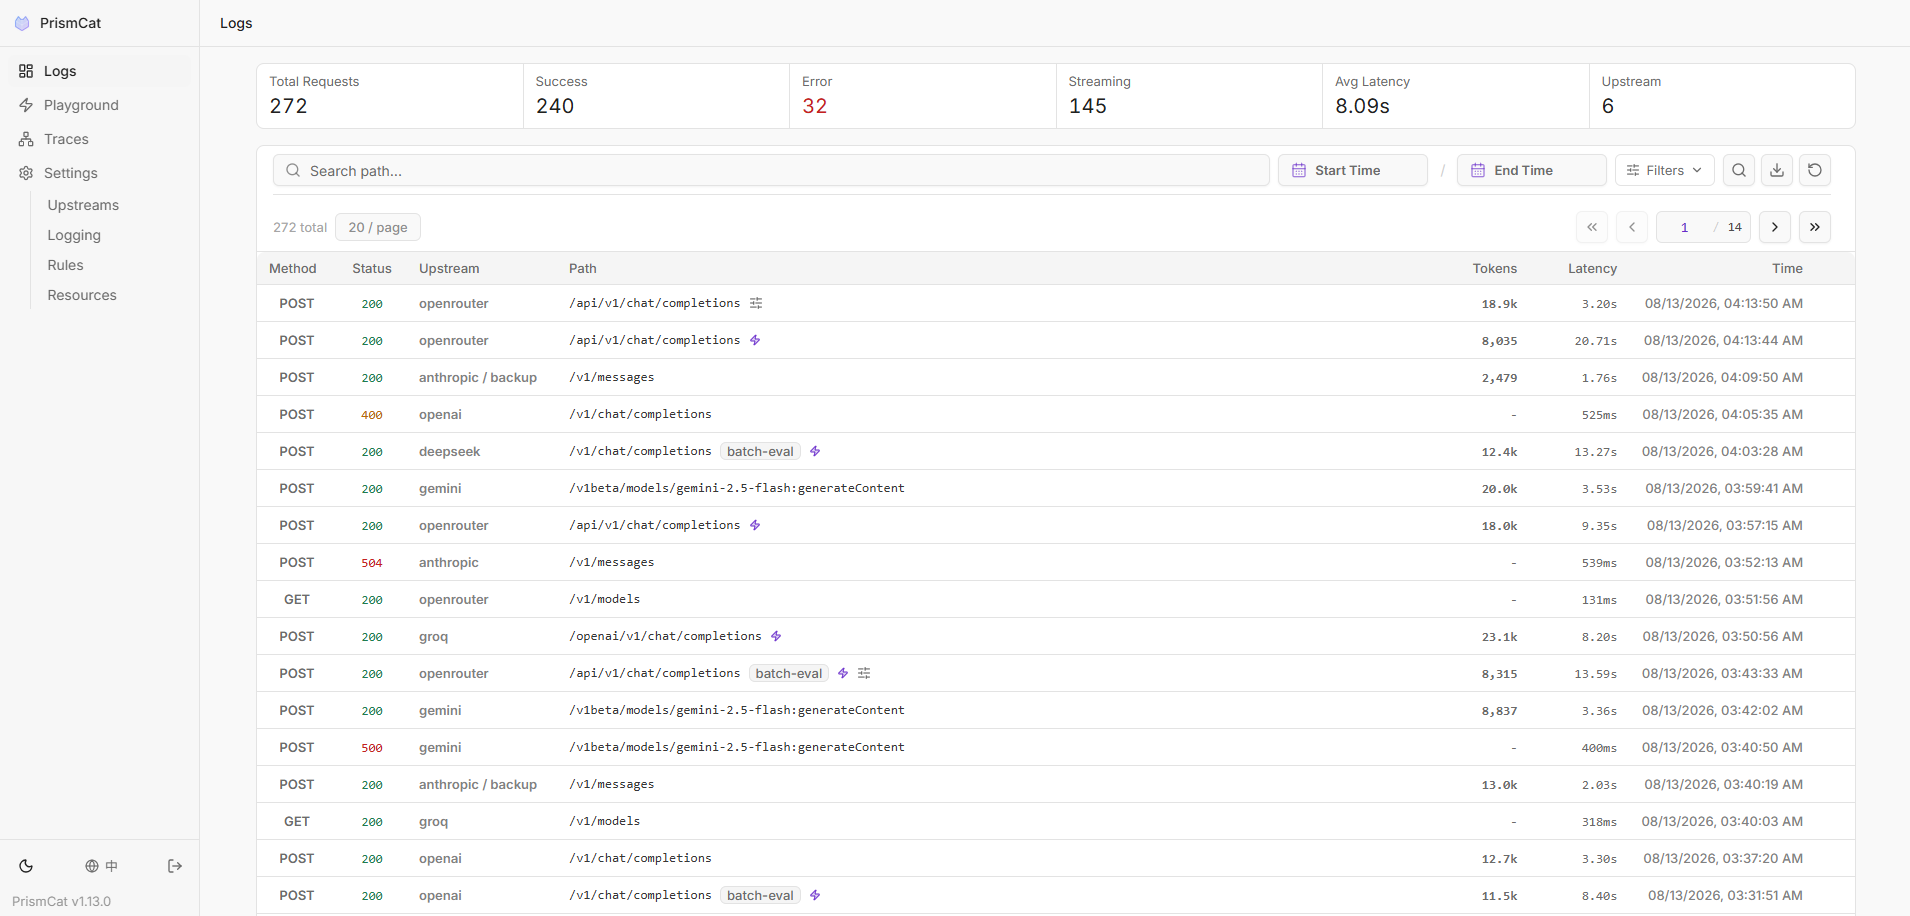 ## 这些场景你熟悉吗?
| | PrismCat |
|---|---|
| "为什么 Token 消耗这么大?我的 Prompt 明明很短啊" | 看到 SDK / 框架偷偷注入的 system prompt 和 few-shot 示例 |
| "Agent 跑着跑着就失控了,不知道它中间干了什么" | 每次调用都已经记下来了,几天后照样能回溯完整行为链路 |
| "流式输出有时候会卡住或截断" | 完整记录每一个 SSE chunk,分得清是模型、网关还是客户端的问题 |
| "Function Calling 返回的 JSON 总是格式错误" | 抓到模型返回的原始文本,在 Playground 里改 Prompt 重发 |
| "多人共用一个 API Key,谁的请求出了问题?" | 用 `X-PrismCat-Tag` 给请求打标签,按用户或项目筛选 |
| "我用 Ollama 跑本地模型,想看看实际通信" | 加一个上游指向 `http://localhost:11434` —— 它就是个通用 HTTP 代理 |
---
## 30 秒上手
### 1. 启动
前往 [Releases](https://github.com/paopaoandlingyia/PrismCat/releases) 下载对应系统的压缩包。
| 平台 | 启动方式 |
|------|---------|
| **Windows** | 双击 `prismcat.exe`,自动隐藏至系统托盘 |
| **macOS** | 解压 `prismcat-*-macos-universal.zip`,把 `PrismCat.app` 拖进「应用程序」后打开,常驻顶部菜单栏 |
| **Linux / macOS 命令行** | 终端执行 `./prismcat` |
| **Docker** | 参见 [Docker 部署](#docker-部署) |
> **macOS 首次打开**:应用暂未经过 Apple 公证,第一次需要在「应用程序」里右键 `PrismCat.app` →「打开」,或在终端执行 `xattr -dr com.apple.quarantine /Applications/PrismCat.app`。数据保存在 `~/Library/Application Support/PrismCat`。
打开浏览器访问 **`http://localhost:8711`** 进入控制面板。
### 2. 添加上游
在 Settings 页面添加一个上游,例如:
| 名称 | 目标地址 |
|------|---------|
| `openai` | `https://api.openai.com` |
PrismCat 会自动生成一个代理地址:**`http://openai.localhost:8711`**
### 3. 改一行代码,开始抓包
```python
from openai import OpenAI
client = OpenAI(
base_url="http://openai.localhost:8711/v1", # ← 只改这里
api_key="sk-..."
)
# 其余代码和平时完全一样
response = client.chat.completions.create(
model="gpt-4o",
messages=[{"role": "user", "content": "Hello!"}],
)
```
回到控制面板,你已经能看到完整的请求和响应了。就这么简单。
---
## 它是怎么工作的?
PrismCat 使用**子域名路由**实现透明代理。当你在 Settings 里添加一个名为 `openai` 的上游后:
```
你的应用 PrismCat OpenAI
│ │ │
│ openai.localhost:8711 │ api.openai.com │
│ ─────────────────────────>│ ────────────────────────────>│
│ │ 记录请求 ✓ │
│<─────────────────────────│<────────────────────────────│
│ │ 记录响应 ✓ │
```
**为什么用子域名?** 因为它是真正的"透明代理"——你的请求路径(如 `/v1/chat/completions`)完全不需要改动。无论你用哪种 SDK、哪种语言,只要它支持自定义 `base_url`,直接把域名指向 PrismCat 就行了。甚至可以串联多级代理(App → PrismCat → 中转站 → OpenAI),每一环都无感接入。
> **💡 关于 `*.localhost`**:现代浏览器和大多数操作系统都会将 `*.localhost` 自动解析为 `127.0.0.1`,无需配置 hosts 文件。如果你的环境不支持,可以参考 [备选:路径路由模式](#备选路径路由模式) 或手动添加 hosts 条目。
---
## 核心特性
### 完整的流量观测
- 记录完整的请求头、请求体、响应头、响应体,支持关键字搜索与高亮
- **SSE 流式响应**完整捕获,支持查看原始流或合并后的完整文本
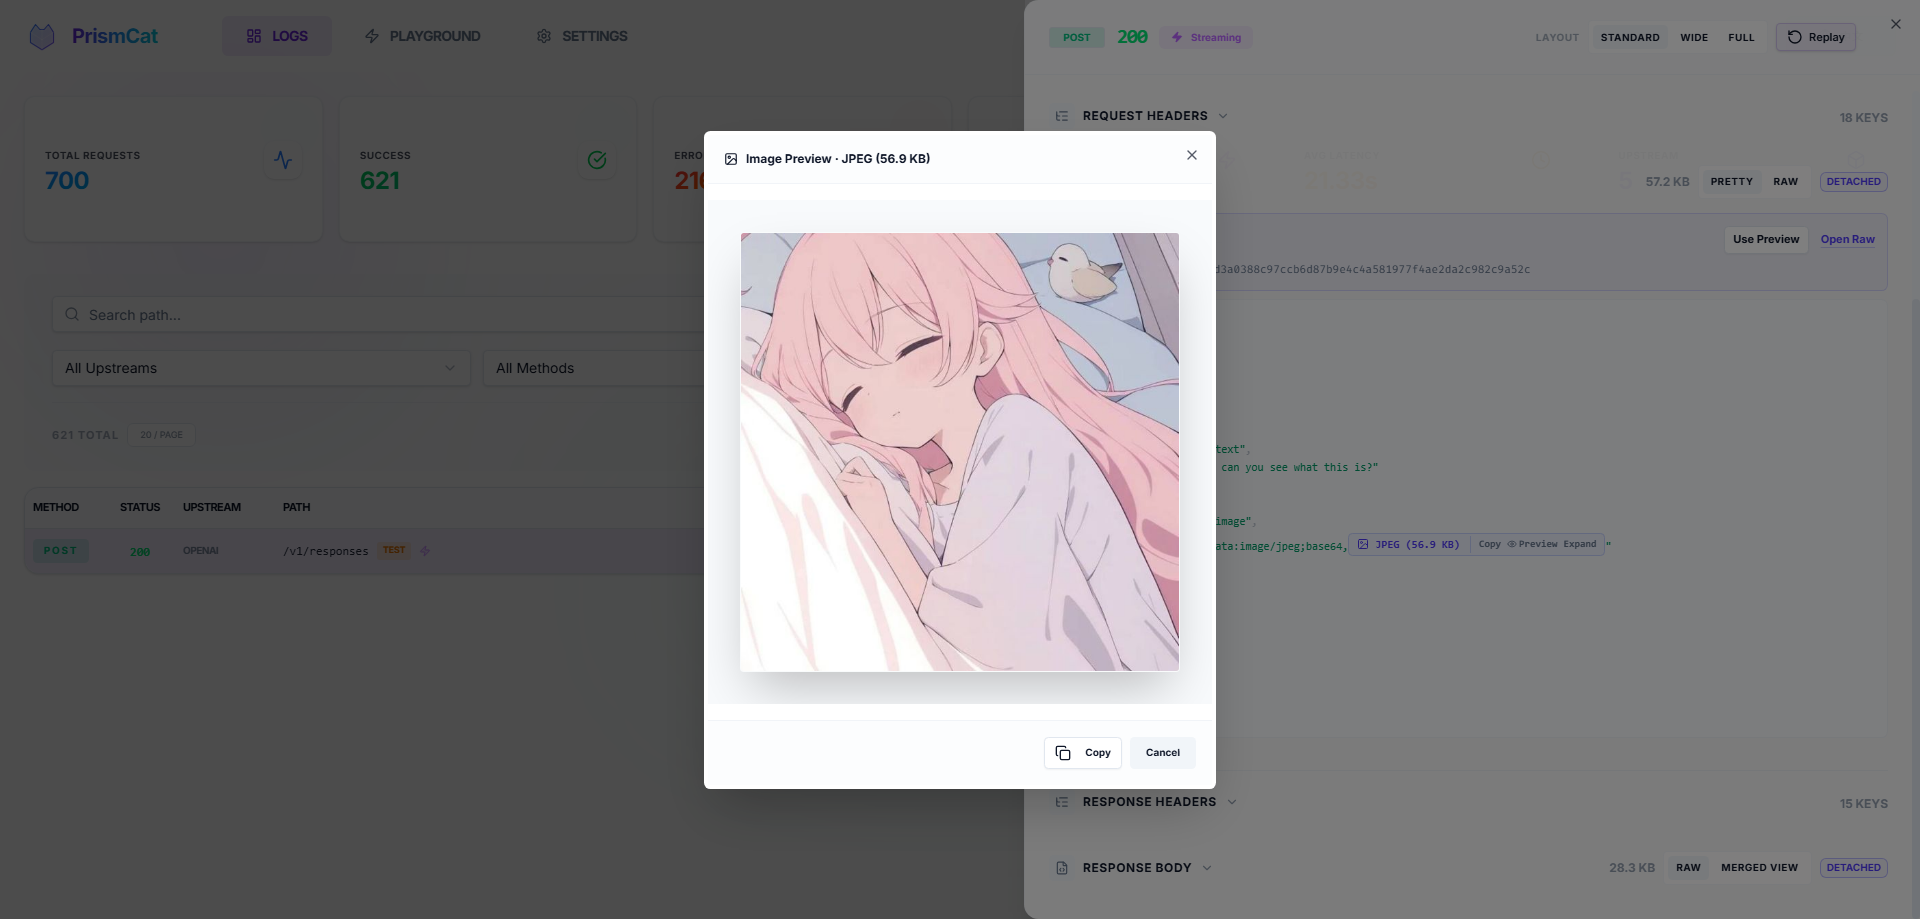
- JSON 自动格式化美化,大段 Base64(如内嵌图片)智能折叠并支持一键预览,告别刷屏
- 任意请求一键复制为可执行的 **cURL 命令**
### 一键重放 (Playground)
看到一条失败的请求?点击 **Replay**,在浏览器里直接修改 Prompt、参数,一键重发,秒级定位问题。不用重新跑你的 Python/Node 脚本。
### Trace 关联 & 用量追踪
自动将相关请求关联为 Trace 链路,并从响应中提取 Token 用量。内置 OpenAI、Anthropic、Gemini 提取规则,也支持自定义。
### 目标预设
一个稳定的代理入口,背后挂多组完整目标,在 Settings 里一键切换,客户端不用动。
- 每组预设把目标 URL、超时、出站代理、规则绑定捆在一起,不会出现"新地址配旧 Key"
- 适合生产/预发、直连/代理线路、地域节点、租户凭据,以及真实服务与 mock/replay 之间切换
- 切换只影响新请求;正在进行的流式请求会用开始时的那组目标走完
### 参数覆盖(需手动启用)
无需改动业务代码即可改写外发请求——对 JSON Body 执行 set / remove / default / append / prepend,还可 set 或 remove 请求头。每条规则按 method / path / JSON 内容匹配命中,日志详情页可看到原始请求 vs. 最终请求的逐字段 diff。
> **🔒 严格 opt-in,PrismCat 不会自作主张。** 默认就是透明转发——必须 (1) 手动打开总开关、(2) 定义规则、(3) 把规则绑定到具体上游,三步全做完请求才会被改写。任何一步没配置,请求都按字节原样透传。
### 隐私与安全
- **纯本地部署**,数据存在本地 SQLite + 文件系统,不经过任何第三方服务器
- 自动对 `Authorization`、`api-key` 等敏感头部脱敏
### 日志标签
请求时加一个 Header `X-PrismCat-Tag: my-tag`,即可在 UI 里按标签筛选。多人 / 多项目共用一个代理时特别有用。
### 极简部署
单个二进制文件,没有任何外部依赖。Windows 支持系统托盘静默运行,Docker 原生支持。
### 常驻运行,随时复盘
按 7×24 小时静默运行的黑匣子设计 —— 不需要"出了 bug 才想起来开抓包"。
- 自动清理过期日志、大 body 分离存储,连续跑几个月也不会撑爆数据库
- 几天后照样能回看某个自主 Agent 到底发了什么、模型到底回了什么
---
## 和其他工具有什么不同?
| | PrismCat | mitmproxy | Langfuse / Helicone |
|---|---------|-----------|---------------------|
| 部署方式 | 单二进制 / Docker | 本地安装 + 证书配置 | SaaS 或自建复杂后端 |
| 针对 LLM 优化 | ✅ JSON 美化、Base64 折叠、SSE 合并 | ❌ 通用 HTTP 抓包 | ✅ 但偏向生产监控 |
| 一键重放 | ✅ 内置 Playground | ❌ | 部分支持 |
| 接入方式 | 改 `base_url` | 全局代理 / 证书 | 侵入 SDK 代码 |
| 数据归属 | 完全本地 | 完全本地 | 依赖外部服务 |
| 流式响应回看 | ✅ 原始流 + 合并视图 | 体验差 | 部分支持 |
| 长期运行 | ✅ 自动清理、静默常驻 | 临时调试工具 | ✅ 但依赖外部基础设施 |
---
## Docker 部署
### Docker Compose
创建 `docker-compose.yml`:
```yaml
services:
prismcat:
image: ghcr.io/paopaoandlingyia/prismcat:latest
container_name: prismcat
ports:
- "8711:8711"
environment:
# 控制台访问 Host。本地用 localhost;服务器部署时填你的域名或 IP。
- PRISMCAT_UI_HOSTS=localhost,127.0.0.1
# 子域名路由的基础域名。裸 IP 部署请开启路径路由,而不是把 IP 填到这里。
- PRISMCAT_PROXY_DOMAINS=localhost
# 裸 IP / 无泛域名部署时:把 PRISMCAT_UI_HOSTS 改成你的 IP,并开启路径路由。
# - PRISMCAT_UI_HOSTS=你的IP
# - PRISMCAT_ENABLE_PATH_ROUTING=true
# 公网部署建议设置控制台密码;也可留空后首次访问 UI 时设置
- PRISMCAT_UI_PASSWORD=your_strong_password
- PRISMCAT_RETENTION_DAYS=30
volumes:
- ./data:/app/data
restart: always
```
```bash
docker compose up -d
```
### Docker Run
```bash
docker run -d --name prismcat \
-p 8711:8711 \
-e PRISMCAT_UI_HOSTS=localhost,127.0.0.1 \
-e PRISMCAT_PROXY_DOMAINS=localhost \
-e PRISMCAT_UI_PASSWORD=your_strong_password \
-e PRISMCAT_RETENTION_DAYS=30 \
-v ./data:/app/data \
--restart always \
ghcr.io/paopaoandlingyia/prismcat:latest
```
---
## 备选:路径路由模式
如果你的环境无法正确解析 `*.localhost`,或者你是用裸 IP 部署、没有泛域名,可以在 Settings 中开启 **路径路由模式**,通过路径前缀代替子域名:
```python
# 路径路由模式 —— 无需子域名解析
client = OpenAI(
base_url="http://localhost:8711/_proxy/openai/v1", # 服务器上可替换为 http://你的IP:8711/_proxy/openai/v1
api_key="sk-..."
)
```
也可以通过配置文件或环境变量开启:
```yaml
# config.yaml
server:
enable_path_routing: true
path_routing_prefix: "/_proxy"
```
```bash
# 或通过环境变量
PRISMCAT_ENABLE_PATH_ROUTING=true
```
> **注意**:路径路由模式下,请求路径会被添加前缀(如 `/_proxy/openai/...`),某些 SDK 的路径拼接逻辑可能需要额外注意。子域名模式不存在这个问题。
---
## 生产部署 (Nginx + 泛域名)
公网部署推荐使用泛域名解析(如 `*.prismcat.example.com`)配合 Nginx:
```nginx
server {
listen 80;
server_name prismcat.example.com *.prismcat.example.com;
location / {
proxy_pass http://127.0.0.1:8711;
proxy_set_header Host $host; # 必须:透传 Host 用于子域名路由
# SSE / 流式响应必须配置
proxy_http_version 1.1;
proxy_set_header Connection "";
proxy_buffering off;
client_max_body_size 50M;
}
}
```
然后在 PrismCat 的 `proxy_domains` 中添加 `prismcat.example.com`。控制台可通过 `prismcat.example.com` 访问,上游 `openai` 可通过 `openai.prismcat.example.com` 访问。
---
## 配置参考
配置文件位于 `data/config.yaml`,首次启动自动创建。大多数选项可通过 UI 的 Settings 页面修改。
完整配置示例
```yaml
server:
port: 8711
ui_password: "" # 控制台密码;留空时首次访问 UI 设置
proxy_domains: # 子域名路由的基础域名
- localhost
logging:
max_request_body: 5242880 # 请求内容最多保存 5MB
max_response_body: 33554432 # 响应内容最多保存 32MB
sensitive_headers: # 自动脱敏的 Header
- Authorization
- api-key
- x-api-key
detach_body_over_bytes: 2097152 # 超过 2MB 的内容按需加载
body_preview_bytes: 524288 # 内联可读预览;长期高频运行可适当调小
early_request_body_snapshot: false
logging_rules:
# 首次启动时从内置 ai_models.json 生成;之后完全由用户维护。
model_path_templates_initialized: false
model_path_templates: []
storage:
retention_days: 30 # 日志保留天数,0 = 永久
upstreams:
openai:
target: "https://api.openai.com"
timeout: 300 # 整个上游请求和响应过程的总超时;新配置默认 5 分钟
response_header_timeout: 60 # 高级:等待状态码/响应头;0 = 禁用,且始终受总超时约束
response_body_first_byte_timeout: 30 # 高级:收到响应头后等待首个响应体字节,适用于所有响应
response_body_idle_timeout: 15 # 高级:响应体开始后连续无新数据的最长时间,每次收到数据重新计时
sse_keepalive: # 可选;默认关闭,心跳不会延长总超时
mode: off # off、after_headers,或 full(包含等待响应头阶段)
interval: 15 # 上游静默多久后向下游发送 SSE 注释
outbound_proxy: "env" # env、direct,或 http://127.0.0.1:7890 这样的代理 URL
logging_path_filter: # all、allowlist 或 denylist;Ant 与 RE2 正则可混用
mode: allowlist
rules:
- matcher: ant
pattern: "/v1/responses"
- matcher: regex
pattern: "^/v1/chat/completions$"
gemini:
target: "https://generativelanguage.googleapis.com"
timeout: 300
response_header_timeout: 0
response_body_first_byte_timeout: 0
response_body_idle_timeout: 0 # 0 = 禁用对应阶段超时
outbound_proxy: "http://127.0.0.1:7890"
# 可选:同一稳定入口下的多个完整目标预设。
# target 与 targets 互斥;旧的单目标格式仍然兼容。
codex:
active_target: primary
targets:
primary:
url: "https://api.openai.com"
timeout: 300
outbound_proxy: "env"
request_overrides:
enabled: false
rule_names: []
backup:
url: "https://api.example.com"
timeout: 300
outbound_proxy: "direct"
request_overrides:
enabled: false
rule_names: []
`sse_keepalive.mode` 的 `after_headers` 仅在确认上游返回成功且未压缩的 `text/event-stream` 后注入 `: ping` 注释。`full` 还会根据 `Accept: text/event-stream`、`alt=sse` 或 JSON 顶层 `stream: true` 覆盖响应头前的等待;第一枚心跳发出后 HTTP 200 已提交,之后的上游 401、429 或 5xx 只能记录到 PrismCat 日志,下游表现为流中断。现有配置中明确写入的 `timeout` 不会随默认值变化而自动迁移。
# 请求参数覆盖(默认关闭)
# 支持的操作:JSON Body set / remove / default / append / prepend;Header set / remove
request_overrides:
enabled: false
max_body_bytes: 1048576
upstreams: {}
rules: []
# Token 用量提取(默认关闭)
# 内置 OpenAI、Anthropic、Gemini 规则,也可自定义 paths
usage_extraction:
enabled: false
upstreams: {}
rules: [] # 完整内置规则见 config.example.yaml
```
---
## 常见问题
Q: openai.localhost 无法访问?
大多数现代系统会自动将 `*.localhost` 解析为 `127.0.0.1`。如果不行:
1. 手动在 hosts 文件中添加 `127.0.0.1 openai.localhost`
2. 或者开启 [路径路由模式](#备选路径路由模式) 作为替代
3. 或者使用自己的泛域名(参见 [Nginx 部署](#生产部署-nginx--泛域名))
Q: Streaming 感觉卡住了?
如果你在反向代理(如 Nginx)后面使用 PrismCat,务必确认:
- `proxy_buffering off;`
- `proxy_http_version 1.1;`
Nginx 默认会缓冲整个响应再转发,这会导致流式输出看起来像是"卡住"了。
Q: 支持哪些 LLM 服务?
PrismCat 是通用 HTTP 代理,与具体的 LLM 服务无关。只要是走 HTTP/HTTPS 的 API 都能用,包括但不限于:
- OpenAI / Azure OpenAI
- Anthropic Claude
- Google Gemini
- Ollama / LM Studio(本地模型)
- 各类中转站 / API 聚合服务
Q: 会影响请求速度吗?
PrismCat 使用异步日志写入,代理本身的延迟通常在 1ms 以内。日志记录不会阻塞请求的转发和响应。
---
## 社区
- [LinuxDo 讨论帖](https://linux.do/t/topic/1623556/33)
---
## 支持 PrismCat
如果 PrismCat 帮你节省了调试 LLM 应用的时间,也欢迎请我喝杯咖啡:
[在爱发电支持 PrismCat](https://afdian.com/a/etgpao)
---
## License
[MIT License](LICENSE)