이 출력을 읽을 만한가? 이 명령을 이 작업에서 통과시켜도 되나? 일이 정말 끝났나? 코딩 에이전트는 세션 하나에서 이런 질문에 수백 번 답해요. 큰 모델이나 고정된 규칙에 맡기면, 그 대가는 세 가지로 돌아와요.
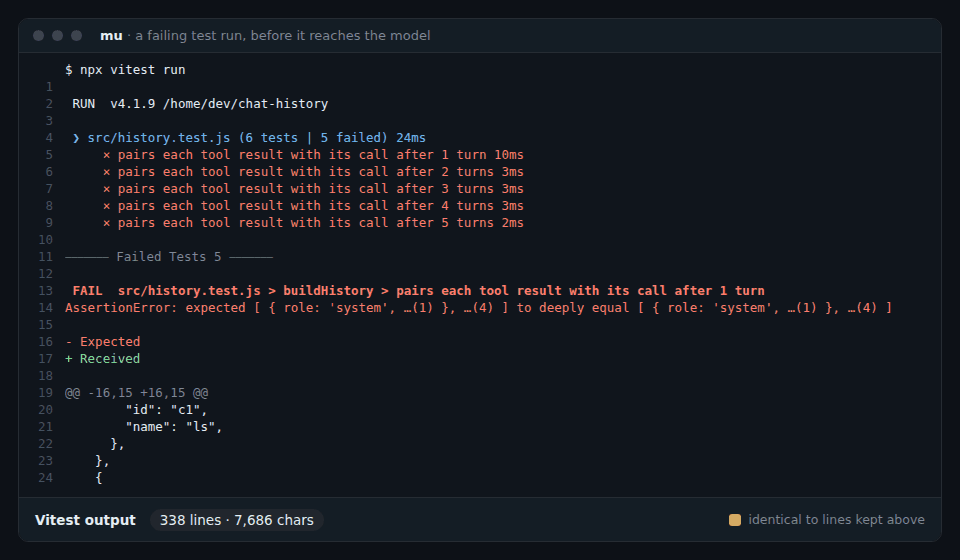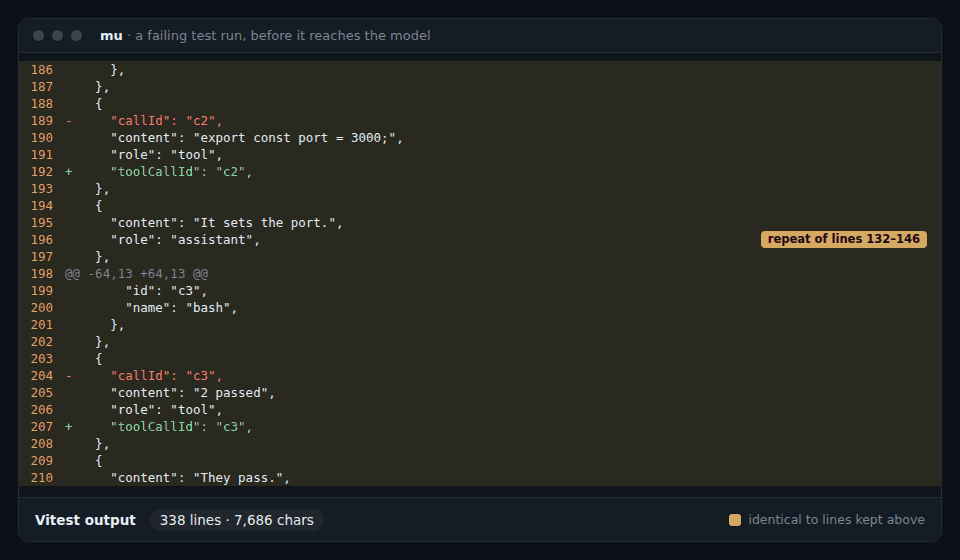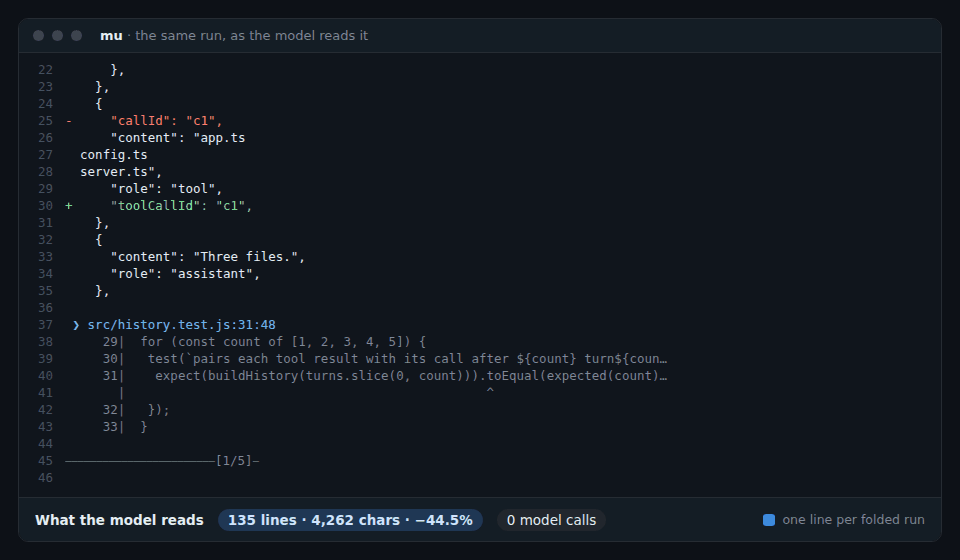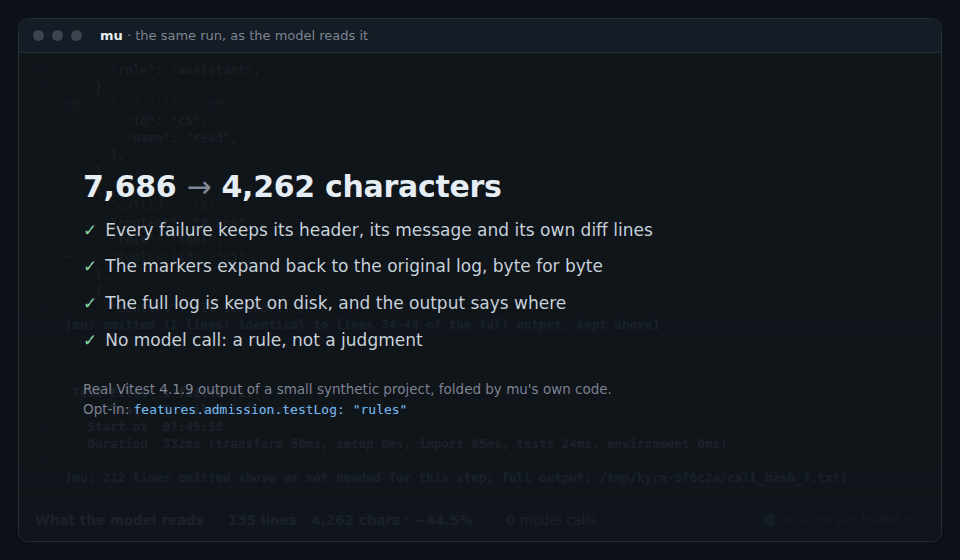
- **낭비되는 토큰.** 2,000줄짜리 테스트 로그가 통째로 컨텍스트에 들어가고, 그 뒤의 요청마다 그 값을 다시 내요. mu의 판정기는 긴 출력을 조각조각 읽고 작업에 필요한 부분만 들여보내요. 나머지는 포인터 뒤에 보관해요. 오래된 결과는 요약 없이 버리고, 여러분이 곧 돌아올 것 같으면 프롬프트 캐시가 만료되기 전에 갱신해요. 테스트 로그 줄이기(기본값은 꺼짐)는 똑같이 반복되는 내용을 한 바이트도 잃지 않고 하나로 접어요. Jest 실패 로그에서는 글자 수를 40%, 실제 실패 테스트 로그 71개 전체에서는 19.5% 줄였어요([실측](#실측) 참고).
- **읽지도 않고 누르는 '허용'.** 에이전트가 한 단계마다 물어보니, 내용을 읽지 않고 허용을 계속 누르거나 아예 확인을 꺼 버리죠. 기본값인 *판정 모드*에서는 작업에 분명히 필요한 것은 판정기가 통과시키고, 나머지만 여러분에게 물어요. 위험한 명령은 규칙이 먼저 잡고, 웹 페이지와 MCP 출력에서는 모델이 읽기 전에 AI를 겨냥한 지시를 걸러 내요.
- **하다 마는 실행.** "다음으로 테스트를 돌릴게요"라고 하고는 그 턴이 끝나요. 판정기는 중간에 멈춘 실행이나 아무것도 검증하지 않은 "완료"를 알아채고, 에이전트를 다시 일로 돌려보내요.
이런 질문을 하나하나 큰 모델에 물으면 토큰과 주의력이 들고, 고정된 규칙은 너무 자주 틀려요. mu는 **판정기**에 물어요. 판정기는 작고 빠른 모델로, 답의 범위가 정해진 질문에 한 번에 하나씩 답해요. 판정 지점은 에이전트 루프에 40개 있고, 그중 34개는 처음부터 판정대로 움직여요. 모든 판정은 확률, 걸린 시간과 함께 로컬 판정 장부에 남아요(`mu ledger`, `/status`, 데스크톱 앱의 판정 탭). 어떤 판정 지점이든 섀도 모드로 돌릴 수 있어요. 묻고 기록만 할 뿐 아무것도 바꾸지 않으니, 판정기를 비교해 보고 맡길 수 있어요.
- **mu**: 명령줄 버전이에요. pi가 하는 모든 것에 판정 커널을 더했어요.
- **mu 데스크톱**: mu와 런타임이 들어 있는 데스크톱 앱이에요. 내려받고, 모델을 연결하고, 시작하면 돼요.
- **판정 모델**: 기본값은 TypeSafe가 호스팅하는 Jev예요. 예/아니요, 선택, 점수 질문에 답하고, 답마다 확률을 붙이고, 모든 판정을 판정 장부에 남겨요. 어떤 판정 모델이든 그 자리를 대신할 수 있어요. Mac에서 돌아가는 mu 자체 모델 mude 1.0, Hugging Face의 다른 의사결정 모델, 직접 운영하는 System One 서버, 어떤 LLM이든요.
**목차:** [빠른 시작](#빠른-시작) · [한 턴의 흐름](#한-턴의-흐름) · [판정 지점](#판정-지점) · [판정기](#판정기) · [실측](#실측) · [하이브](#하이브) · [쉬운 말 보드](#쉬운-말-보드) · [데스크톱 앱](#데스크톱-앱) · [명령줄](#명령줄) · [문서](#문서) · [기여하기](#기여하기)
## 빠른 시작
**데스크톱 앱.** [Releases](https://github.com/qybaihe/mu/releases/latest)에서 macOS, Windows, Linux용 설치 파일을 내려받아 열고, ChatGPT로 로그인하거나 어떤 프로바이더의 API 키든 붙여 넣으세요. 따로 설치할 것은 없어요.
**명령줄.**
```bash
npm i -g mu-agent # Node.js 22.19 이상
mu setup # 모델 연결
mu # 현재 디렉터리에서 세션 시작
```
시작할 때 판정기 키는 필요 없어요. 키를 설정하기 전까지는 OpenCode Zen의 무료 Jev가 답해요. 판정 지점 40개 중 34개가 처음부터 판정을 반영하고, 판정은 모두 기록돼요(`/status`, `mu ledger`, 데스크톱 앱의 판정 탭). 판정기가 어떻게 할지 기록만 하고 싶다면 `~/.mu/agent/mu.json`에 `{"modes": {"default": "shadow"}}`를 적으세요. 자세한 내용은 [Getting started](../getting-started.md)(영어).
## 한 턴의 흐름
```
사용자 ──▶ input.preflight · task.frame · input.interjection
│
▼
모델 ──▶ 도구 호출 ──▶ tool.risk · tool.constraint · tool.approval ──▶ 실행
▲ │
│ tool.injection web pages and MCP output: instructions aimed at the AI are withheld
│ tool.admission chunk by chunk: into the context, or archived behind a pointer
│ context.forget · context.compact when the context grows │
└────────────────────────────────────────────────────────────────────┘
턴 종료 ──▶ turn.completion · turn.continue · turn.drift · turn.rewind · memory.applied · board.read · cache.warming
```
## 판정 지점
판정 지점마다 `active`(켬, 기본값), `shadow`(묻고 기록하지만 아무것도 바꾸지 않음. 판정기를 켜기 전에 비교해 보는 용도), `off`(끔) 중 하나로 둘 수 있고, 판정기도 따로 지정할 수 있어요: `jev`, `mude`(로컬), `classifier:/`, `llm:/`, 또는 `mude,jev` 같은 캐스케이드.
**입력**
| 판정 지점 | 질문 | 효과 |
| --- | --- | --- |
| `input.preflight` | 어떤 종류의 메시지이며, 얼마나 깊이 생각해야 하는가? | 모델에게 한 줄 힌트, 필요하면 이번 턴의 추론 수준도 정함 |
| `task.frame` | 새 작업인가, 반드시 지킬 제약인가, 정정인가, 하위 목표인가, 아니면 변화 없음인가? | 변화가 있을 때만 작업 프레임을 다시 씀: 목표, 여러분의 제약(원문 그대로, 출처와 함께), 인수 조건 |
| `input.interjection` | 에이전트가 일하는 중에 메시지가 옴: 지금 끊을까, 이 단계 뒤에 할까? | 턴을 끊거나, 메시지를 기다리게 함 |
**컨텍스트**
| 판정 지점 | 질문 | 효과 |
| --- | --- | --- |
| `skills.disclosure` | 이 작업과 관련 있는 스킬은 무엇인가? | 그 스킬만 프롬프트에 들어가고, 나머지는 찾으면 나오는 상태로 남음 |
| `capability.disclosure` | 이 작업에 설치된 팩이나 MCP 서버가 필요한가? | 필요할 때만 열고 프로세스를 시작함 |
| `tool.admission` | 긴 도구 출력의 청크마다: 지금 중요한가? | 중요한 것은 컨텍스트로, 나머지는 보관하고 포인터만 남김 |
| `tool.admission.test-log` | 테스트 로그에서 무엇이 반복인가? | 완전히 같은 반복은 무손실로 하나로 접음. 필요하면 나머지에서 판정기가 고름 |
| `context.forget` | 컨텍스트가 임계값을 넘으면, 어떤 도구 결과가 오래되었는가? | 나가는 요청에서 각각 한 줄짜리 툼스톤이 됨 |
| `context.compact` | 이 구간을 남길까, 잘라 낼까? | 기본값은 꺼짐. 판정에 따른 압축. 요약은 쓰지 않음 |
| `memory.recall` | 이 작업에 맞는 교훈은 무엇인가? | 이번 턴으로 가져옴 |
| `memory.capture` | 이 메시지는 에이전트를 바로잡는 것인가, 규칙을 정하는 것인가? | 교훈이 됨 |
| `memory.outcome` | 한참 헤맨 끝에 찾은 탈출구는 교훈으로 남길 만한가? | 여러분이 아니라 실행에서 얻은 교훈 |
| `memory.worth` | 모델이나 서브 에이전트가 제안한 교훈: 다시 쓸 만한가, 일회성인가, 이미 아는 것인가? | 남기거나 버림 |
| `memory.merge` | 기존 교훈과 같은가, 더 정확한가, 모순되는가? | 중복 없음. 더 정확한 쪽이 옛것을 대체함 |
| `memory.applied` | 불러온 교훈이 이번 턴에 지켜졌는가? | 자주 불려 나오지만 한 번도 지켜지지 않은 교훈은 사용 중지됨 |
| `skill.capture` | 잘 끝난 긴 실행: 같은 단계로 다음 같은 종류의 작업을 할 수 있는 절차였는가? | 스킬로 초안이 작성되어 당신을 기다림: `/skills accept`로 설치 |
| `cache.warming` | 프롬프트 캐시가 만료되기 전에 여러분이 돌아올 것인가? | 캐시를 갱신하거나, 만료되게 둠 |
**도구 및 안전**
| 판정 지점 | 질문 | 효과 |
| --- | --- | --- |
| `tool.risk` | 규칙에 걸린 명령: 여러분이 요청한 것인가? | 확신이 없으면 여러분에게 물어봄 |
| `tool.approval` | '판정 모드'에서: 이 명령, 프로젝트 밖의 이 변경, 이 외부 동작, 이 서브 에이전트가 작업에 분명히 필요한가? | 판정기가 확신한 것만 실행하고, 나머지는 여러분에게 물어봄 |
| `tool.constraint` | 무언가를 바꾸는 호출 전에: 여러분이 밝힌 제약을 넘는가? | 호출을 막음 |
| `tool.injection` | 웹 페이지, 검색 결과, MCP 서버의 출력, 명령이 다른 컴퓨터에서 가져온 내용(`curl`, `gh issue view`)을 단락마다: AI를 겨냥한 지시가 들어 있는가? | 그 단락은 모델에 닿지 않고, 그 자리에 안내 한 줄이 남음. 그런 단락을 읽은 하위 에이전트의 보고서에는 경고가 붙음 |
| `tool.description` | MCP 도구 자체의 설명을, 처음 나타날 때와 바뀔 때: 이 도구를 호출하는 것 이상(비밀 읽기, 데이터를 다른 곳으로 보내기, 당신에게 숨기기)을 AI에게 요구하는가? | 그 도구는 모델의 도구 목록에서 빠지고 호출도 거부되며, 당신에게 알려짐 |
| `files.locate` | 여러분의 설명에 맞는 파일은 무엇인가? | grep을 줄줄이 돌리는 대신 후보에 순위를 매김 |
| `judge.items` | 모델이 직접 만든 예/아니요 질문을 여러 항목(파일, 로그 줄, 리뷰 지적) 하나하나에 | `judge_items` 도구로 항목마다 확률을 돌려줘서, 전부 읽지 않아도 됨 |
| `browser.step` | 관찰, 판정 한 번, 실행: 다음 동작은 무엇이고, 어느 요소에 하는가? | 내장 브라우저가 한 단계 나아감 |
| `review.triage` | `/review`의 지적 사항마다: 동작을 바꾸는가, 이번 변경에 관한 것인가? | 지적 사항을 P0부터 P3까지 등급으로 나눔 |
| `diagnostics.delivery` | 편집 후 새로 생긴 언어 서버 진단: 지금 알릴까, 다음에 멈출 때 알릴까, 알리지 말까? | 오류는 모델에게 전달, 스타일 경고는 전달하지 않음 |
**턴**
| 판정 지점 | 질문 | 효과 |
| --- | --- | --- |
| `turn.drift` | 몇 단계마다: 작업이 아직 목표를 향하고 있는가? | 제자리걸음은 규칙이, 옆길로 새는 것은 판정기가 잡아냄 |
| `turn.rewind` | 같은 실패가 계속 반복됨: 이 방법은 막다른 길인가? | 체크포인트로 되돌아감 |
| `turn.completion` | 모델이 다 했다고 함: 그걸 검증한 것이 있는가? | 없으면 한 번 짚어 줌 |
| `turn.continue` | "다음으로 테스트를 돌릴게요"로 끝났거나, 시킨 일인데 진행해도 되는지 물으며 끝남: 하다 말고 멈췄는가? | 하던 일로 돌려보냄. 메시지마다 최대 두 번, 되돌리기 어려운 단계로는 밀지 않음 |
| `output.drift` | 모델이 쓰는 동안: 출력의 끝부분이 여러분의 제약을 넘는가? | 기본값은 꺼짐. 쓰는 도중에 바로잡음 |
| `goal.met` | 목표 모드에서 큰 모델이 답을 내지 못할 때: 조건이 충족되었는가? | `/goal`의 폴백 |
| `board.read` | 일이 어디까지 왔는가(객관식)? | 쉬운 말 보드에 쓰임 |
| `notify.routing` | 컨텍스트 예산 같은 이벤트: 모델에게 지금 알릴까, 나중에 알릴까, 알리지 말까? | 알맞은 때에 모델에게 알림 |
**협업**
| 판정 지점 | 질문 | 효과 |
| --- | --- | --- |
| `swarm.routing` | 위임한 이 작업에는 어떤 역할, 어떤 모델 등급, 어떤 추론 수준이 맞는가? | 딱 맞는 서브 에이전트 |
| `swarm.patch` | 서브 에이전트의 패치가 작업 범위 안에 머물렀는가? | 작업, 경로, 줄 수로 판정 |
| `hive.publish` | 비(bee)의 발견이 공유 보드에 올릴 만한가? | 게시하거나, 혼자 간직함 |
| `hive.deliver` | 보드의 메모가 이 비의 작업과 관련 있는가? | 관련 있을 때만 전달 |
| `hive.relate` | 새 발견이 앞선 발견을 뒤집는가, 모순되는가, 뒷받침하는가? | 정정과 이견이 옛 메모를 가진 비에게 전달됨 |
판정 지점마다의 기능 스위치와 옵션: [docs/reference/decision-points.md](../reference/decision-points.md)(영어).
## 판정기
- **Jev**(클라우드). TypeSafe가 호스팅하는 판정 모델로, 답의 범위가 정해진 질문에 확률과 함께 답해요. TypeSafe, OpenRouter, Vercel AI Gateway, OpenCode Zen, Cloudflare Workers AI, 또는 같은 프로토콜을 쓰는 어떤 서비스로든 부를 수 있고, 서비스마다 키가 따로 있어요(`TYPESAFE_API_KEY`, `MU_JUDGE_OPENROUTER_API_KEY`, `AI_GATEWAY_API_KEY`, `OPENCODE_API_KEY`, `CLOUDFLARE_API_KEY`와 `CLOUDFLARE_ACCOUNT_ID`). 데스크톱 앱의 '판정기' 페이지에서 고를 수 있고, 기본값은 키가 설정된 첫 번째 서비스예요. 키가 하나도 없으면 OpenCode Zen의 기간 한정 무료 Jev 1.13이 답해요. 판정에 필요한 내용은 OpenCode로 가지만 모델 학습에는 쓰이지 않고, mu가 하루에 한 번 알려 줘요. 키를 설정하면(`mu setup`이나 '판정기' 페이지) 다음 질문부터 그 키를 써요. 만든 사람들의 실제 세션에서 잰 값으로, HTTP/2 웜 연결에서 질문 하나에 약 0.3초, 도구 출력 16청크를 요청 하나로 판정하는 데 0.44초가 걸렸고, 상태는 한 번만 과금됐어요.
- **OpenAI의 판정 모델** `gpt-6-luna`. OpenAI의 [Decisions API](https://developers.openai.com/api/docs/guides/decisions)로 OpenAI API 키(`MU_JUDGE_OPENAI_KEY` 또는 mu가 이미 가진 OpenAI 키)를 써서 답해요. `mu setup --judge openai`나 설정 → 판정기에서 고를 수 있어요.
- **mude 1.0**(로컬, Apple 실리콘 Mac). 코딩에 맞게 최적화한 mu 자체 의사결정 모델이에요. `mu judge mude install`로 설치하고 판정기로 삼아요.
- **Hugging Face의 다른 의사결정 모델**(로컬, Apple 실리콘 Mac). `mu judge model add <링크>`(또는 데스크톱 앱 설정의 '판정기')로 mude 1.0과 같은 방식으로 패키징된 모델을 추가하고 판정기로 삼아요. Laya는 이제 mu에 들어 있지 않아요. `mu.json`에 아직 Laya가 있으면 mude 1.0이 설정돼 있을 때는 mude 1.0이 그 자리를 맡고, 아니면 남은 판정기나 Jev를 쓰며, mu가 한 번 알려 줘요.
- **pi 모델 카탈로그의 어떤 분류 모델이든** 계층 하나로 쓸 수 있어요: `classifier:/`. Cloudflare의 Clef(`clef`, `clef-flash`), OpenRouter와 Vercel AI Gateway의 System One 모델, llama.cpp 분류 모델 등.
- **어떤 LLM이든** 계층 하나로 쓸 수 있어요: `llm:/`.
만든 사람들의 실제 세션에서 얻은 효과예요. 도구 출력이 청크 단위로 들어오고 오래된 결과는 요약 없이 내려놓기 때문에 컨텍스트가 가득 차는 일은 드물어요. 테스트 로그 정리는 기본값이 꺼짐인데, 켜면 완전히 같은 반복을 접어서 Jest 실패 로그의 글자 수를 40%, 실제 실패 테스트 로그 71개 전체에서 19.5% 줄였고, 잃은 글자는 하나도 없어요([실측](#실측) 참고). 프롬프트 캐시가 만료되기 전에 커널이 여러분이 돌아올지 판단하고, 돌아올 것 같으면 캐시를 갱신해요.
### mubench 1.0: 의사결정 모델 비교
mubench는 mu가 의사결정 모델을 위해 만든 벤치마크예요. 메인 보드의 문항은 모두 오픈소스 저장소에서 진행한 실제 코딩 세션에서 mu가 의사결정 모델에 보낸 요청을 그대로 옮긴 거예요. 답은 그 결과가 치르게 하는 비용으로 채점하고, 모든 모델을 의사결정 모델 없는 mu와 비교해요. 0은 차이가 없다는 뜻이고, 100은 그 비용을 모두 없앴다는 뜻이에요. 구성한 시나리오의 서브 보드까지 담은 전체 리더보드는 [usemu.dev/ko/mubench](https://usemu.dev/ko/mubench/)에 있어요.
결정 정확도는 더 단순한 별도 지표예요. 모델이 맞힌 검사 항목의 비율로, 실수의 비용과 상관없이 모든 검사 항목을 똑같이 세요.
## 실측
작은 결정을 판정기에 맡기면 에이전트가 일을 더 많이 끝낼까요, 아니면 비용만 줄까요? 지금까지 측정은 두 가지예요. 작업 전체를 엔드투엔드로 본 것과, 실패한 테스트 실행에서 무엇이 모델에 들어가는지 본 것이에요. 둘 다 무엇을 보여 주지 않는지도 적었어요.
### 작업 전체: Terminal-Bench 2.1
같은 모델, 같은 작업, 같은 제한 시간으로 작업마다 세 번씩 돌렸어요. Terminal-Bench 2.1에서 mu의 시도는 68.2%가 통과했고, mu의 기반인 pi는 58.7%였어요. mu는 두 가지 실패가 모두 적었어요. 끝내지 못한 채 시간이 다 된 시도도, 끝까지 했지만 결과가 틀린 시도도 더 적었어요.
| 작업 88개 × 3회, MiMo v2.6 Pro | mu · Jev | mu · mude 프리릴리스 | pi |
| --- | --- | --- | --- |
| 통과한 시도 | **264회 중 180회(68.2%)** | 264회 중 174회(65.9%) | 264회 중 155회(58.7%) |
| pi와의 차이, 95% 구간 | +9.5%p(+3.8~+15.2) | +7.2%p(+1.5~+13.3) | |
| mu가 pi보다 더 자주 / 덜 통과한 작업 | 25 / 8 | 25 / 10 | |
| 실패한 시도: 시간 초과로 미완료 / 끝냈지만 틀림 | 65 / 19 | 71 / 19 | 81 / 28 |
| 통과 1회당 에이전트 시간 | 23.6분 | 22.2분 | 27.4분 |
| 통과 1회당 비용 | $0.067 | $0.063 | $0.069 |
이 측정의 범위:
- Terminal-Bench 2.1을 Harbor 0.24.0으로 돌렸고, 작업마다 정해진 제한 시간을 썼어요. 에이전트가 시간을 다 써도 Harbor는 남은 상태로 테스트를 돌리기 때문에, 시간 초과가 되고도 통과하는 시도가 있어요. pytorch-model-recovery는 합계에서 뺐어요. 처음 실행에서 테스트 환경이 그 지시문을 pi와 mu에 전달하지 않았기 때문이에요. 기록된 세 번의 시도에서는 모든 구성이 이 작업을 매번 통과했으니, 빼도 비교는 달라지지 않아요.
- 모든 구성이 MiMo v2.6 Pro, 추론 수준 high예요. 대조군은 pi 1.4.0이에요. mu는 mu-agent 0.1.12(pi 1.3.0 기반)이고 기본 설정 그대로예요. Jev는 1.14 버전이에요. mude 열은 24층짜리 프리릴리스 빌드로, 같은 Mac에서 돌렸어요. mude 1.0은 이 빌드로 만든 20층 모델이고 Terminal-Bench에서는 아직 돌리지 않았어요. mu 0.2.x도 마찬가지예요.
- 작업마다 세 번, 2026-10-22부터 2026-10-24까지, Apple 실리콘 16GB Mac 한 대에서 돌렸어요. 재실행은 인프라 장애일 때만 했고, 규칙은 미리 정했어요. Rosetta 때문에 작업 4개는 어떤 구성으로도 풀 수 없어서, 절대 통과율은 x86_64보다 약 4.5%p 낮고 공개 리더보드와 비교할 수 없어요.
시도별 결과는 [docs/benchmarks/terminal-bench-2.1.csv](../benchmarks/terminal-bench-2.1.csv)에, 방법은 [docs/benchmarks/terminal-bench-2.1.md](../benchmarks/terminal-bench-2.1.md)(영어)에 있어요. mu와 pi를 돌린 Harbor 어댑터와, CSV로 이 표를 다시 계산하는 스크립트는 [bench/harbor/](../../bench/harbor/)에 있어요.
### 모델에 들어가는 것: 실패한 테스트 로그
아래 숫자는 저장소에 들어 있는 스크립트로 잰 결과예요. 반복 접기는 2026-10-25에 [`test-log-repeats.ts`](../../kyrn/spikes/judge-bench/test-log-repeats.ts)로, 목표에 맞춘 선별은 2026-09-21에 [`test-log-replay.ts`](../../kyrn/spikes/judge-bench/test-log-replay.ts)로 쟀어요. 후자의 오프라인 비교는 지금 코드에서도 결과가 같아요. 방법과 전체 표는 [kyrn/docs/09-test-log-admission.md](../../kyrn/docs/09-test-log-admission.md)(중국어)에 있어요.
**완전히 같은 반복.** 실패한 실행은 실패한 테스트마다 같은 diff, DOM 덤프, 스택을 한 번씩 출력하곤 해요. mu는 첫 번째 것을 남기고, 그 뒤의 반복은 어느 줄을 반복하는지 적은 한 줄로 바꿔요. 모델은 부르지 않아요. 표시를 펼치면 원래 로그와 바이트 단위로 같고, 전체 로그는 디스크에 남아 있으며 출력 끝에 그 위치가 적혀요. 얼마나 줄지는 테스트 러너에 따라 달라요. Jest와 pytest는 실패마다 diff와 스택을 통째로 출력하지만, Vitest의 기본 리포터는 덜 반복해요.
**목표에 따른 선별.** 자세한 리포터를 쓰면 무엇을 남길지는 여러분이 무엇을 물었는지에 달려 있어요. 실패를 디버깅할 때 통과한 테스트는 잡음이지만, 어떤 테스트가 실행됐는지 물을 때는 증거예요. 판정기는 요청 하나로, 통과한 테스트 블록과 테스트 출력 블록마다 "목표에 아직 필요한가?"를 질문받아요. 요약과 모든 실패는 질문 대상이 아니에요. 판정기가 "필요 없음"에 0.9 이상의 확률을 줄 때만 그 블록을 빼요. 이 측정에서 판정기는 당시 기본값이던 Jev 1.13이고, Jev 1.14로는 다시 돌리지 않았어요.
*Perfect judge*(완벽한 판정기)는 레이블을 직접 읽어요. 올바른 판정기가 줄일 수 있는 최대치예요. *Keep failures only*(실패만 남기기)는 늘 "빼라"고 답하는 판정기로, 목표를 보지 않는 필터가 하는 일과 같아요. 이 조사에서 실제로 보낸 Jev 요청은 모두 282건이고, 정가로 약 $0.017이었어요. 기본 질문 방식에서 요청 하나의 소요 시간 중앙값은 345ms예요.
둘 다 기본값은 꺼짐이에요. `~/.mu/agent/mu.json`에 `"features": { "admission": { "testLog": "rules" } }`를 쓰거나 데스크톱 앱 설정에서 '테스트 로그 정리'를 켜면 반복이 접혀요. `"jev"`로 하면 남은 부분 중 지금 목표에 필요한 것을 판정기가 골라요. `/mu mode tool.admission.test-log shadow`를 실행하면 선별 결과는 기록만 돼요.
이 숫자가 말해 주지 않는 것:
- 선별 사례는 합성 프로젝트에서 실제로 나온 Vitest, node:test, pytest 출력에 손으로 쓴 경계 사례 13개를 더한 것이에요. 목표와 레이블은 만든 사람들이 썼어요. 조정에 쓰지 않은 목표는 먼저 레이블을 붙이고 한 번만 돌렸고, 그 뒤로 아무것도 바꾸지 않았어요.
- 무엇이 모델에 들어가고 무엇을 잃었는지를 잰 것이지, 그다음 모델이 작업을 끝냈는지를 잰 것이 아니에요.
- 접기 표본은 대부분 CI 로그예요. 오픈소스 프로젝트 12개(재기 전에 테스트 러너를 기준으로 골랐어요)에서는 최근 실패한 실행을 6번씩, mu 자체 CI에서는 2026-09-22 이후 실패한 테스트 실행을 가져왔어요. 실행마다 실패 로그 하나를 mu의 bash 도구가 넘기는 모양(마지막 2,000줄 또는 50KB)으로 잘랐어요. 만든 사람들의 세션에서 나온 7개는 예전 표본이에요. 최근 세션에서는 에이전트가 테스트 출력을 대부분 `tail`로 넘겨서, admission이 시작되는 4,000자에 이르는 로그가 거의 없었어요.
- Go와 Cargo 출력은 테스트 로그로 인식되지 않아서 접지 않아요.
그래프의 데이터
| 목표에 따른 선별 | 조정에 쓴 목표(29): 줄인 비율 | 잃은 필요한 줄 | 조정에 쓰지 않은 목표(9): 줄인 비율 | 잃은 필요한 줄 |
| --- | --- | --- | --- | --- |
| mu · Jev | 40.2% | 72개 중 0개 | 46.4% | 19개 중 0개 |
| 완벽한 판정기 | 52.5% | 72개 중 0개 | 46.5% | 19개 중 0개 |
| 실패만 남기기 | 61.9% | 72개 중 9개 | 59.4% | 19개 중 6개 |
| 실패한 테스트 로그, 실행마다 하나 | 로그 | 글자 수 | 접힘 |
| --- | --- | --- | --- |
| Jest, 오픈소스 프로젝트 4개 | 14 | 584,229 | 40.1% |
| pytest, 오픈소스 프로젝트 2개 | 5 | 255,721 | 26.7% |
| Vitest, 오픈소스 프로젝트 6개 | 18 | 530,853 | 9.2% |
| Vitest, mu 자체 CI | 27 | 942,761 | 6.0% |
| Vitest, 만든 사람들의 세션(2026-09-21) | 7 | 139,820 | 51.0% |
| 합계 | 71 | 2,453,384 | 19.5% |
## 하이브
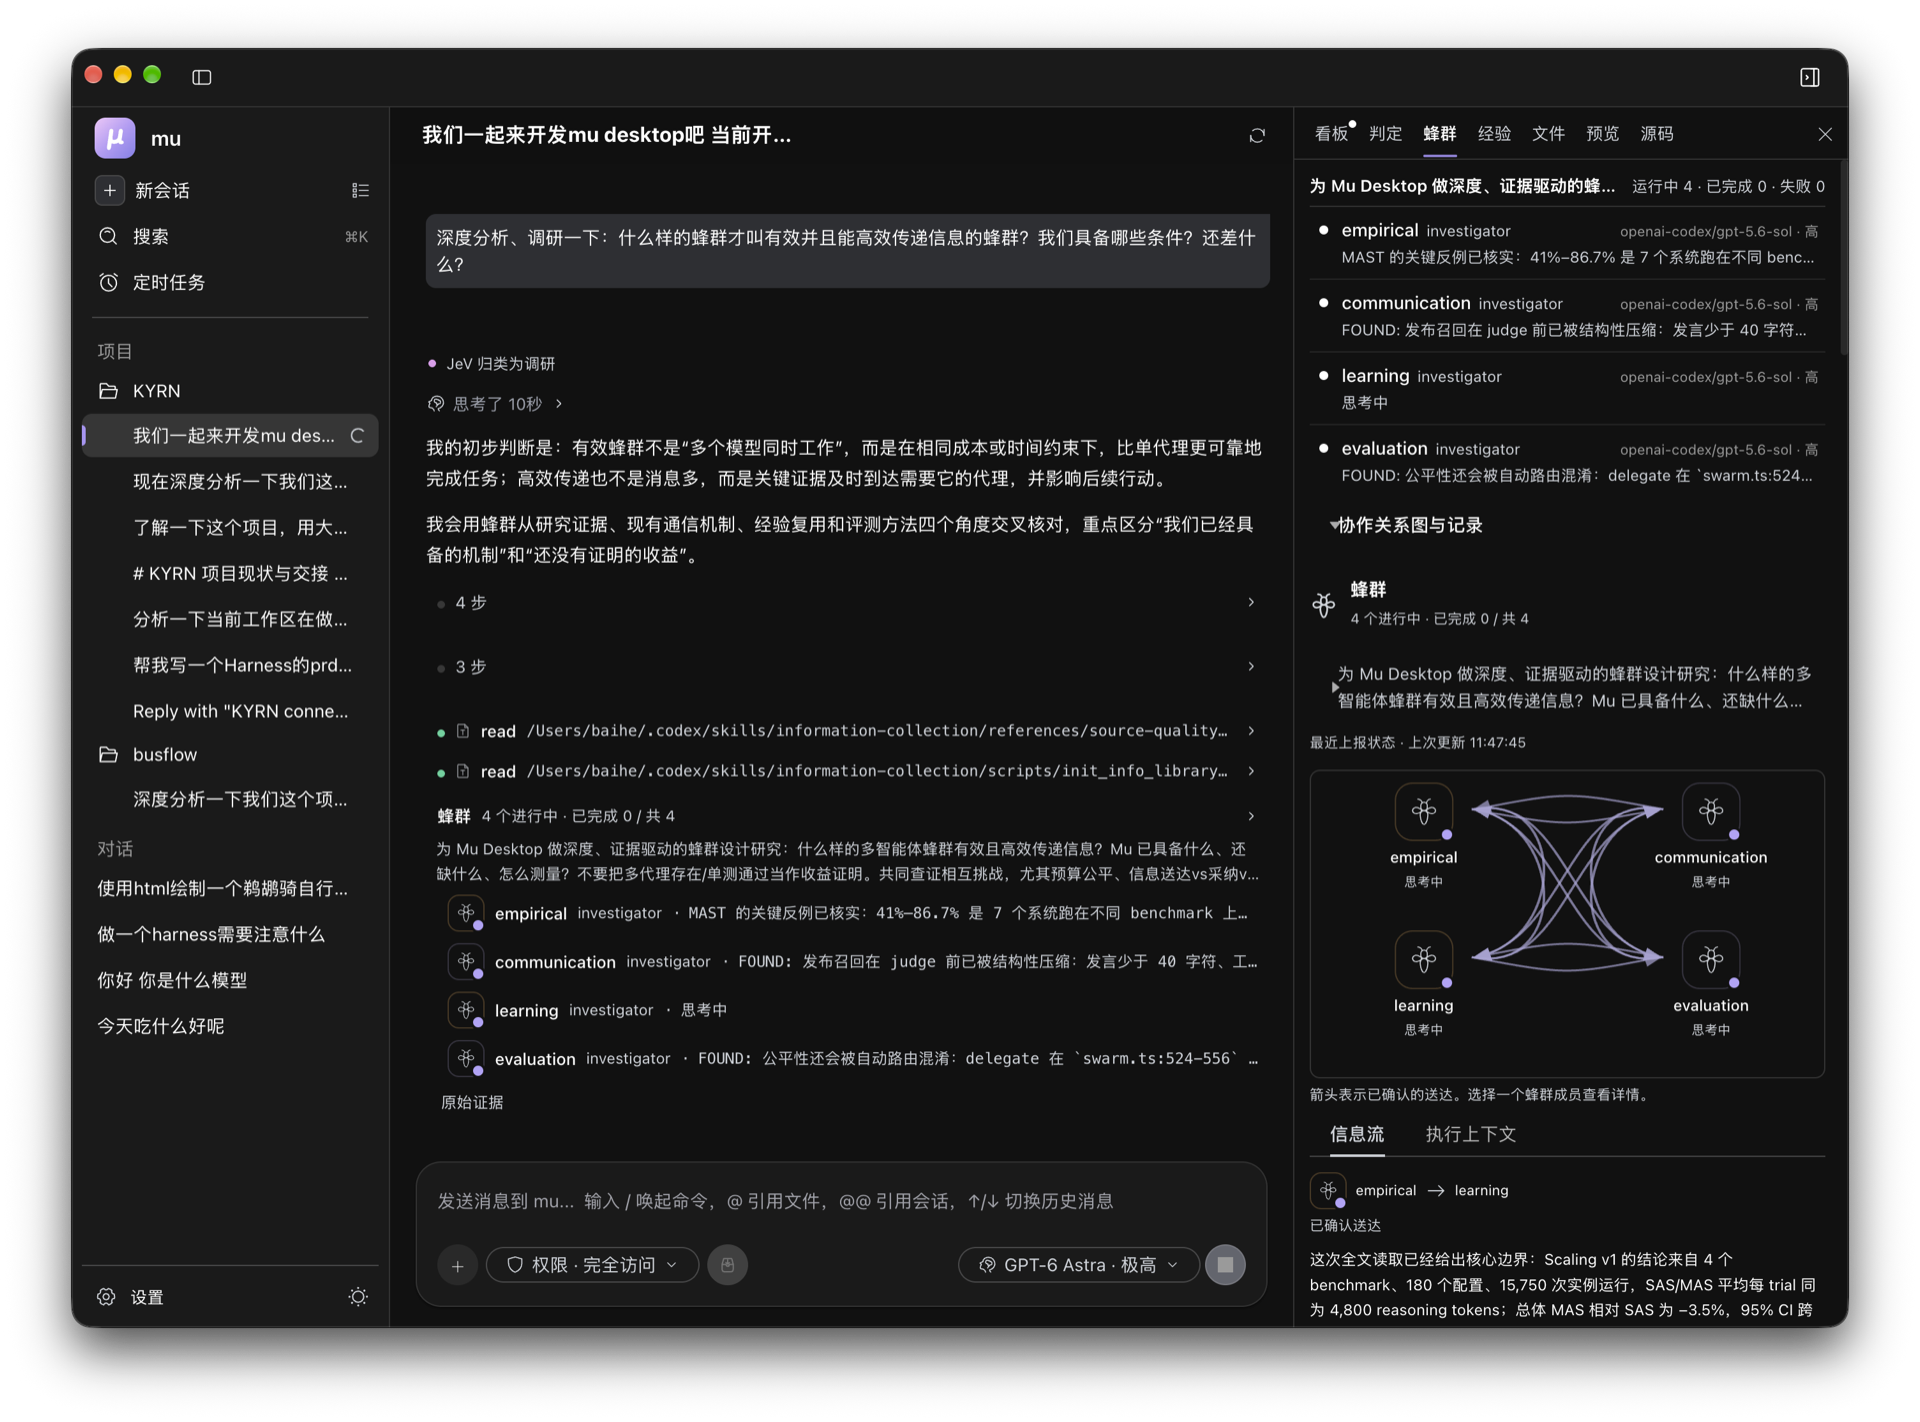
하이브는 비 2마리에서 6마리로 이루어지고, 비마다 자기 관심사가 있어요. 비는 코드를 읽고, 명령을 실행하고, 브라우저를 쓰지만, 코드를 고치지는 않아요. 변경은 메인 모델이 해요. 비가 말을 한 차례 마칠 때마다 `hive.publish`가 한 번 물어요. 여기에 공유할 만한 발견, 막다른 길, 결정, 블로커가 있는가? 공유할 만한 것은 추가만 되는 공유 보드에 올라가요. 새 메모가 올라올 때마다 `hive.deliver`가 다른 비 하나하나에 대해 한 번씩 물어요. 이것이 그 비의 관심사와 닿아 있는가? 그렇다면 메모에 "지시가 아니라 발견"이라고 표시해서 전달해요.
보드는 쌓이기만 하기 때문에, 나중 결론이 앞선 결론을 뒤집을 수 있어요. 어떤 비가 테스트가 안 돌아간다고 보고했다가, 환경 변수 하나를 지우고 나서 돌아가게 만드는 식이에요. `hive.relate`는 두 메모 사이의 관계를 읽어요. '뒤집음', '모순', '뒷받침' 중 하나예요. 뒤집힌 결론은 정정이 되어 옛 결론을 가진 모든 비에게 전달돼요. 서로 모순되는 두 메모는 둘 다 남고 이견으로 표시돼요. 1분 안에 아무도 결론을 내지 않으면 검증 비를 보내요.
이 모든 일이 벌어지는 현장이 데스크톱 앱의 하이브 탭이에요. 비마다 한 줄씩 역할, 모델, 지금 하는 일이나 방금 한 말을 보여 줘요. 지도에는 누가 누구에게 발견을 전달했는지가 그려져요. 전달이 많을수록 선이 굵고, 정정과 이견은 각자 따로 표시되며, 발견이 도착하는 순간 그 선이 빛나요. 정보 흐름에는 전달된 메시지의 원문이 모두 있고, 판정 기록에는 모든 판정이 있어요. 대화 안의 하이브 카드에는 작은 지도가 들어 있고, 누르면 이 탭이 열려요.
`/swarm`은 비마다 무엇을 하는지 보여 주고, `/swarm stop`은 지금 바로 보고를 요청하고, `/swarm kill`은 비들을 끝내요. 시간이 다 된 비에게는 보고를 요청하고, 보고가 없으면 끝내요. 멈춰 버린 모델이나 도구는 워치독이 처리해요. 하이브는 언제나 돌아와요.
## 쉬운 말 보드
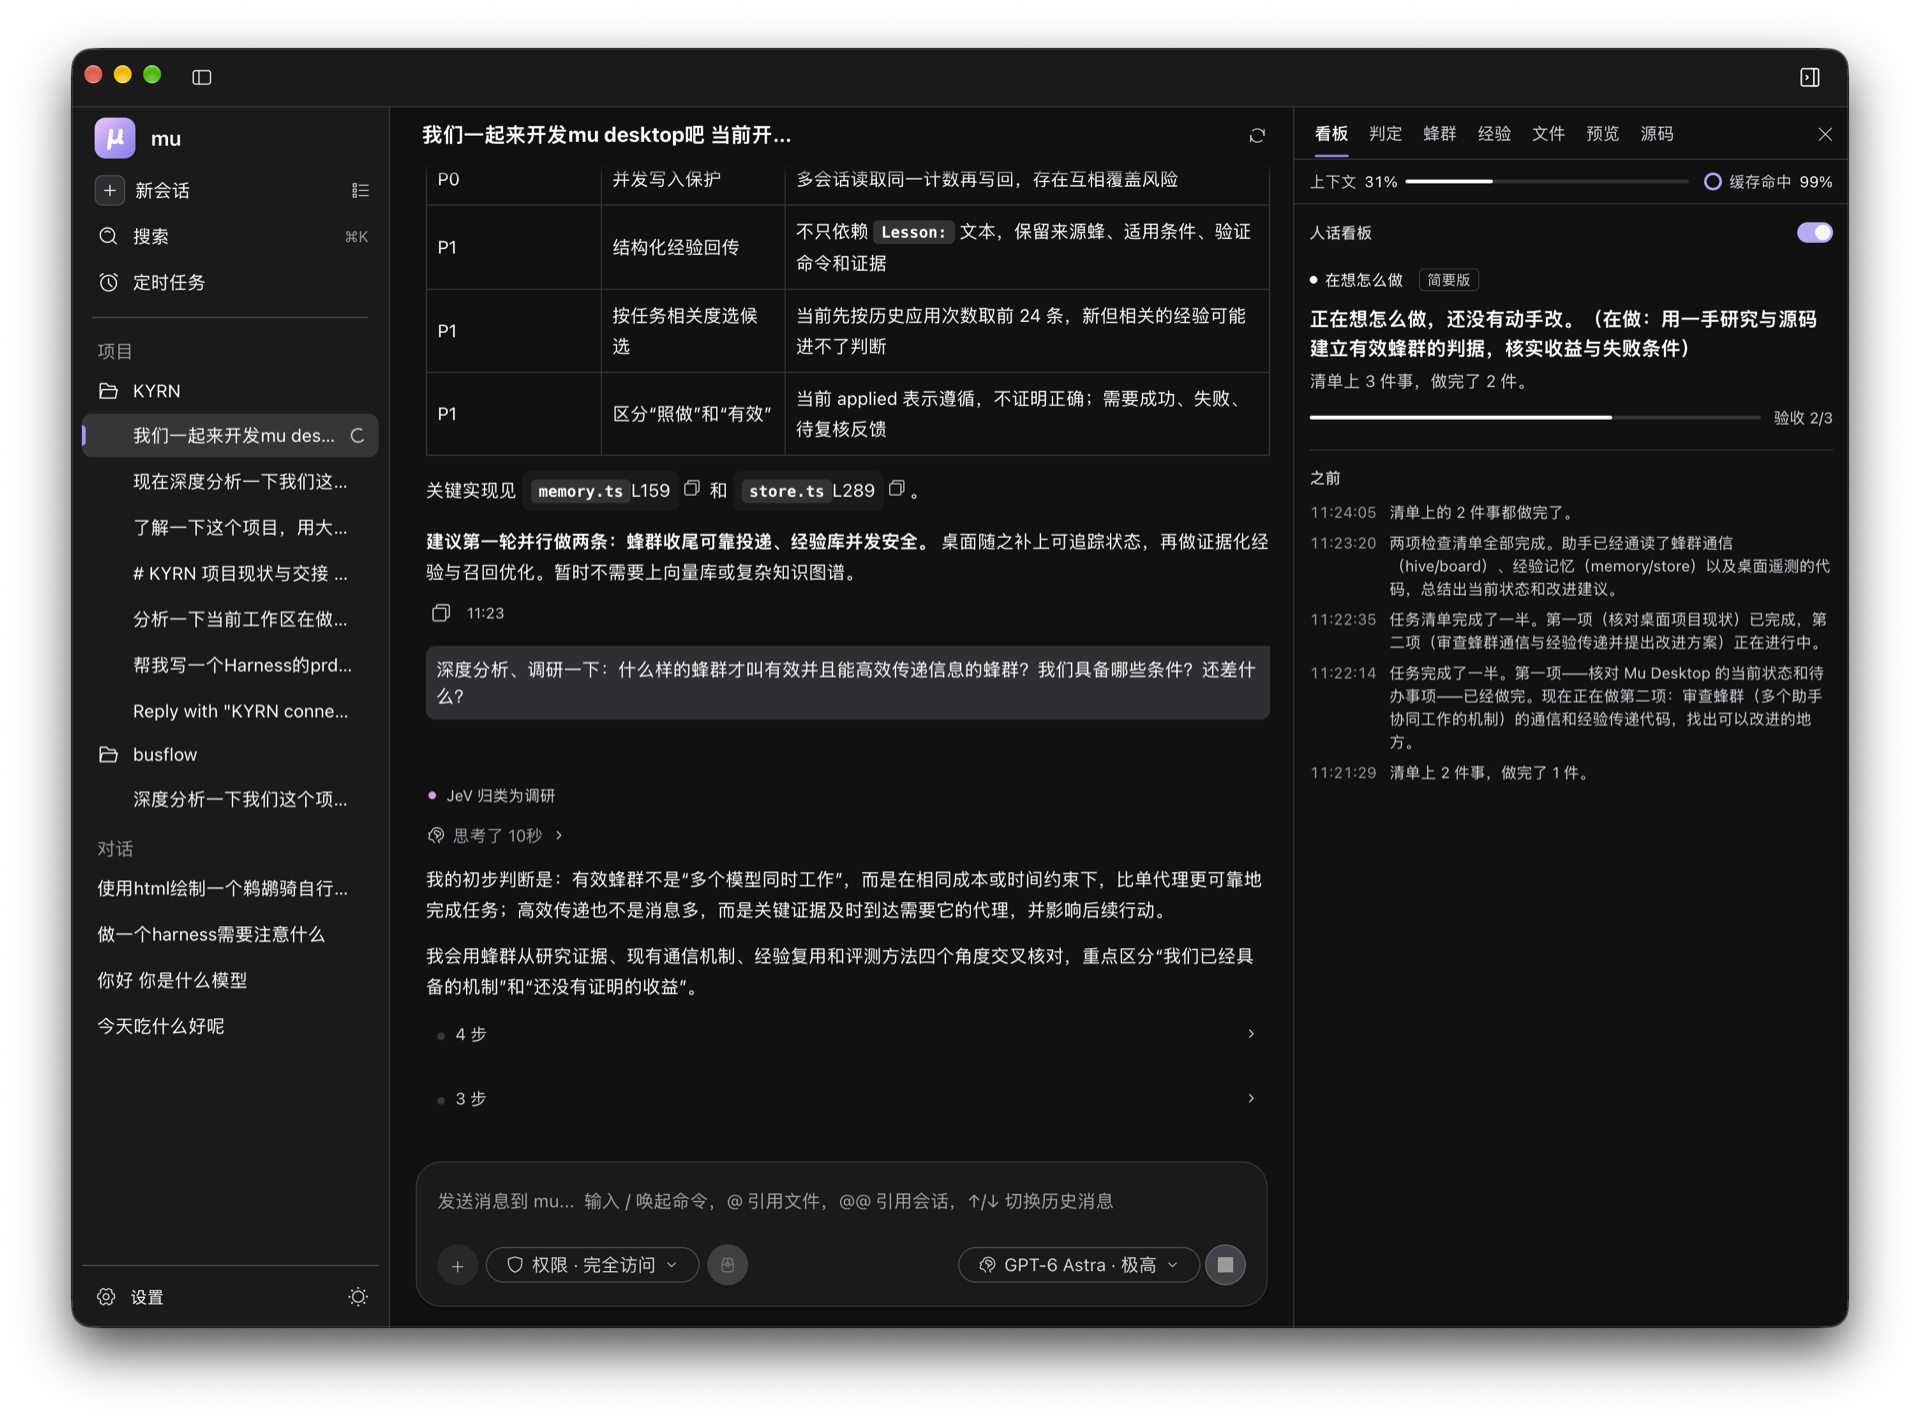
보드를 켜 두면(`/board`, 또는 데스크톱 앱 보드 탭의 스위치), 에이전트가 한 걸음 뗄 때마다 보드에 쉬운 말 한 줄이 바로 붙어요. 어떤 파일을 바꿨는지, 검증이 통과했는지 실패했는지, 어떤 명령을 실행했는지요. 파일을 연달아 읽으면 「파일 N개를 봤어요」 한 줄로 접히고 숫자만 올라가요. 일하는 도중에 에이전트가 무언가 말할 때마다 `board.read`가 판정기에게 그게 새 소식인지 물어요. 새 소식이면, 쉽게 말한다는 한 가지 이유만으로 고른 모델(`/board model`)이 그 자리에서 사람에게 다시 말해 주고, 보드의 현재 상태도 함께 갱신해요. 지금 무엇을 하고 있는지, 체크리스트 항목 중 몇 개가 끝났는지, 여러분을 기다리는 것이 무엇인지요. 실행이 끝났을 때의 요약은 기록의 마지막 줄이 되고, 과정은 그 위에 남아요. 그래서 「끝났다」만이 아니라, 무엇을 했는지가 늘 보여요.
보드는 권한 모드, 목표, 서브 에이전트를 따라가고, 에이전트가 방향을 바꾸면 보드의 표현도 바뀌어요. 맨 위의 두 숫자는 컨텍스트 사용량과 캐시 적중률이에요.
## 데스크톱 앱
mu와 런타임이 들어 있는 데스크톱 앱이에요. Node를 설치할 필요가 없고, 처음 실행할 때도 아무것도 내려받지 않아요. 명령줄에 있는 것은 모두 있고, 여기에 대화 옆 작업 패널이 더해져요.
**보드** · **판정**(실시간 판정 장부: 모든 판정과 그 질문) · **하이브** · **교훈** · **파일** · **미리보기** · **소스** · **브라우저**(에이전트가 한 단계씩 조작하는 내장 브라우저. 목표, 일시 정지, 중지 포함)
아래쪽 막대에서 커널 상태를 늘 볼 수 있어요. 어떤 판정기가 답하고 어디서 도는지, 켜진 판정 지점이 몇 개인지, 대화 중이라면 지금까지의 판정 수, 마지막 판정에 걸린 시간, 사용 중인 컨텍스트까지 보여 줘요. 권한 모드와 목표는 입력창에 있고, `⌘K`로 명령어 팔레트를 열어요. 모델 로그인은 앱 안에서 해요. ChatGPT로 로그인하거나, pi가 지원하는 어떤 프로바이더의 API 키든 쓸 수 있어요. Claude Code, Codex CLI, ZCode의 대화는 가져와서 이어 갈 수 있어요.
macOS(Apple 실리콘 / Intel), Windows(x64 / Arm), Linux(x64 / Arm)용 빌드는 GitHub Actions에서 만들어 [Releases](https://github.com/qybaihe/mu/releases)에 올려요.
## 명령줄
```bash
npm i -g mu-agent
mu # 현재 디렉터리에서 대화형 세션 시작
mu doctor # 설치, 판정기, 연결 상태 점검
```
Node 22.19 이상이 필요해요. `mu -p "prompt"`는 한 번 실행하고 결과를 출력하고, `mu -c`는 마지막 세션을 이어 가요. `mu import --list`는 Claude Code, Codex, ZCode 대화를 찾아 주고, `mu import `은 그 대화를 기록 전체와 함께 가져와요. 나중에 다시 가져오면 그 뒤에 새로 생긴 내용이 더해져요. `mu ledger [n]`은 최근 n개 세션에서 판정기가 내린 판정을 출력해요. 명령줄과 데스크톱 앱은 계정, 설정, 교훈을 함께 써요.
| 명령어 | 하는 일 |
| --- | --- |
| `/status` | 판정기, 판정 지점별 모드, 컨텍스트에서 뺀 것, 최근 판정 |
| `/mu judge ` | 어떤 판정기가 어떤 순서로 답할지: `jev`, `mude,jev`, `jev-opencode-free`, `openai`, `classifier:/`, `llm:/` |
| `/mu route ` | 판정 지점 하나에 따로 판정기를 지정하기 |
| `/mu mode ` | 판정 지점 하나를 전환하기 |
| `/frame` | 작업 프레임: 목표, 여러분의 제약과 그 출처, 인수 조건 |
| `/goal ` | 조건이 충족될 때까지 계속 작업하기, `/goal clear`로 끝내기 |
| `/permissions` | 전체 접근 / 판정 모드 / 최소 권한 |
| `/board` | 쉬운 말 보드 켜고 끄기 |
| `/remember`, `/lessons`, `/forget` | 교훈 하나 남기기, 목록 보기, 하나 사용 중지하기 |
| `/skills` | mu가 실행에서 초안을 쓴 스킬: 읽기, 설치, 버리기 |
| `/review`, `/commit` | 변경 사항을 리뷰하고 지적 사항을 P0부터 P3까지 나누기, 커밋 작성하기 |
| `/checkpoints`, `/rewind` | 체크포인트 목록 보기, 그중 하나로 되돌아가기 |
| `/agents`, `/swarm` | 서브 에이전트 보내기, 일하는 비를 하나하나 지켜보기 |
| `/browse`, `/jobs` | 내장 브라우저, 백그라운드 작업 |
| `/capabilities`, `/ledger` | 설치된 기능 확장과 그중 열린 것, 최근 판정 |
| `/import-chat` | Claude Code, Codex 또는 ZCode 대화 가져오기 |
| `/doctor` | 설정과 연결 점검하기 |
pi의 자체 명령(`/model`, `/thinking`, `/login`, `/resume`, `/tree`, `/fork`, `/compact`, `/export` 등)은 그대로예요. 다만 `/login`에는 Claude 구독 로그인이 없어요(Anthropic이 다른 앱의 제공을 허용하지 않아서요). Anthropic API 키를 쓰세요. `MU_JUDGE=mude,jev mu`로 실행하면 그 실행에서만 판정기를 바꿀 수 있어요.
## 프라이버시
키는 이 컴퓨터를 떠나지 않아요. mu는 모델이나 런타임을 스스로 내려받지 않고, 내려받아야 하는 것은 모두 먼저 물어봐요. 판정기는 질문에 필요한 필드만 봐요(키가 없으면 그 필드는 OpenCode Zen의 무료 Jev로 가요. `--local-only`를 붙인 mude 1.0, `mu setup --judge off`(판정기에 아무것도 묻지 않고, mu의 기능은 규칙대로 계속 동작해요), `MU_JUDGE=off` 중 하나를 쓰면 전부 이 컴퓨터에 남아요). 모든 판정은 로컬에 기록되고, 전부 읽어 볼 수 있어요.
## 문서
- [Getting started](../getting-started.md) · [설정](../configuration.md) · [판정기](../judges.md) · [문제 해결](../troubleshooting.md)(영어)
- 참고: [모든 판정 지점](../reference/decision-points.md) · [모든 기능과 옵션](../reference/features.md) · [변경 기록](../../CHANGELOG.md)
- 기여자용: [mu의 동작 방식](../architecture.md) · [판정 지점 추가하기](../adding-a-decision-point.md) · [번역](../translations.md)
## 기여하기
버그 제보, 수정, 새 판정 지점, 판정기 측정, 번역을 환영해요. 영어나 중국어로 써 주세요. 먼저 [CONTRIBUTING.md](../../CONTRIBUTING.md)를 읽어 주세요. [`good first issue`](https://github.com/qybaihe/mu/labels/good%20first%20issue) 라벨이 붙은 이슈부터 시작하기 좋아요.
```bash
npm install --ignore-scripts # 의존성 설치, 라이프사이클 스크립트는 실행하지 않음
npm run hydrate:model-catalog # 저장소에 고정된 카탈로그로 모델 목록 생성(오프라인)
node kyrn/bin/mu.mjs # 이 체크아웃에서 mu 실행
npm run check # 포맷, 린트, 타입 검사
./test.sh # 테스트 (모델이 필요한 테스트는 키가 없으면 건너뜀)
```
데스크톱 앱은 `desktop/`에 있어요. `bun install` 다음에 `KYRN_ROOT="$(cd .. && pwd)" bun run start`를 실행하면 이 저장소의 mu를 쓰는 개발 빌드가 시작돼요(먼저 루트에서 `npm install`을 실행하세요).
참여하는 모든 사람은 [행동 강령](../../CODE_OF_CONDUCT.md)을 따라요. 보안 문제는 [SECURITY.md](../../SECURITY.md)에 적힌 대로 비공개로 제보해 주세요.
## 출처와 라이선스
mu는 MIT 라이선스예요([LICENSE](../../LICENSE), 데스크톱 앱은 [desktop/LICENSE](../../desktop/LICENSE)). [pi](https://github.com/earendil-works/pi)(코딩 에이전트, MIT)를 바탕으로 만들었어요. pi의 작성자들에게 감사드려요. 몇몇 판정 지점은 다른 프로젝트의 아이디어를 바탕으로 해요. 프롬프트 인젝션 검사의 질문 방식은 [hermes-jev-skills](https://github.com/kerpopule/hermes-jev-skills)에서, 이어서 하기 검사와 일괄 판정 도구는 [oh-my-pi](https://github.com/can1357/oh-my-pi)를 따랐어요. 판정 커널에 쓰인 서드파티 코드는 [THIRD_PARTY_NOTICES.md](../../packages/kyrn-judge/THIRD_PARTY_NOTICES.md)에 정리되어 있어요.
데스크톱 앱은 [AionUi](https://github.com/iOfficeAI/AionUi)의 포크에서 시작했어요. AionUi에서 가져온 파일은 [desktop/APACHE-FILES.txt](../../desktop/APACHE-FILES.txt)에 정리되어 있고 계속 Apache License 2.0을 따라요([desktop/NOTICE](../../desktop/NOTICE) 참고).
## 커뮤니티
- 질문과 아이디어: [Discussions](https://github.com/qybaihe/mu/discussions). 중국어 토론은 [linux.do](https://linux.do)에서도.
- 버그 제보와 요청: [Issues](https://github.com/qybaihe/mu/issues/new/choose).
- 그 밖에: [SUPPORT.md](../../SUPPORT.md).