

English · 中文 · 不用 App 怎么用 · 安装指南 · 量化说明 · AGENTS.md
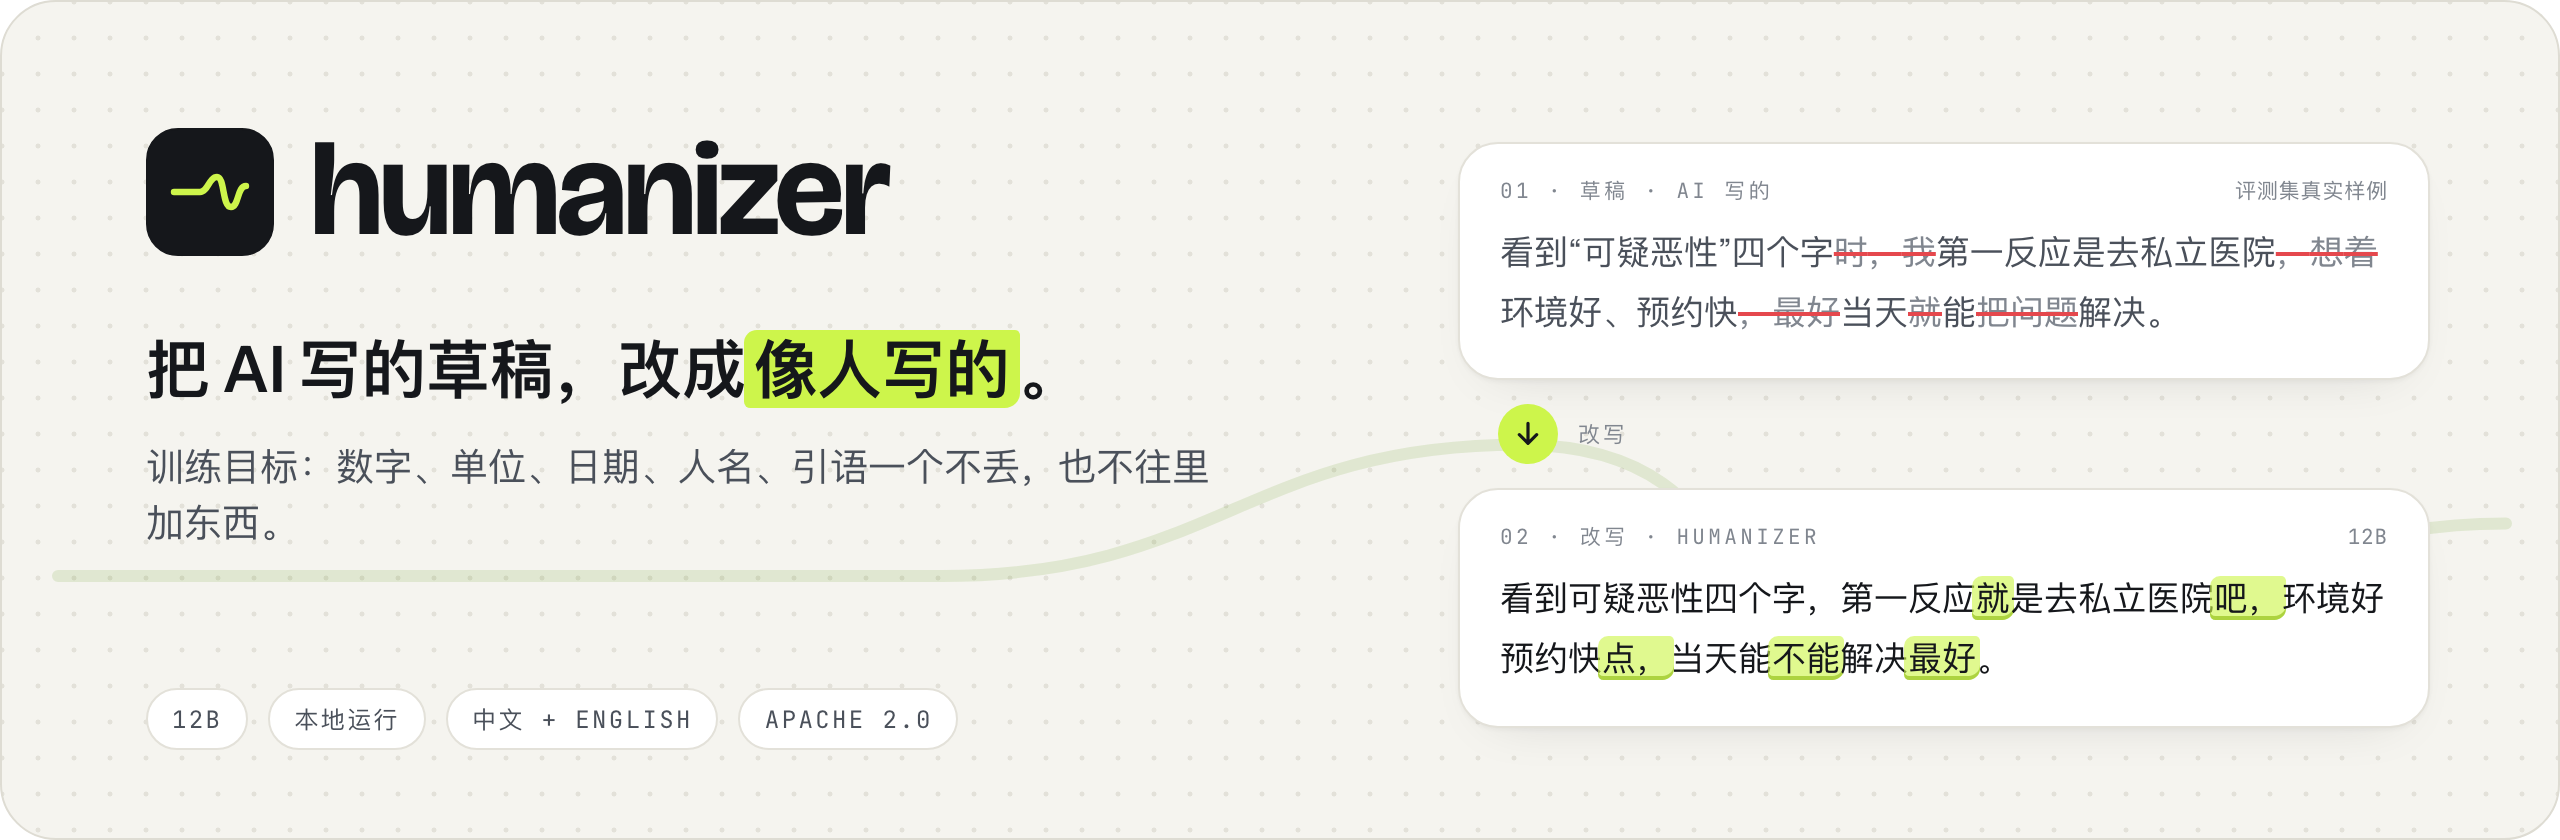
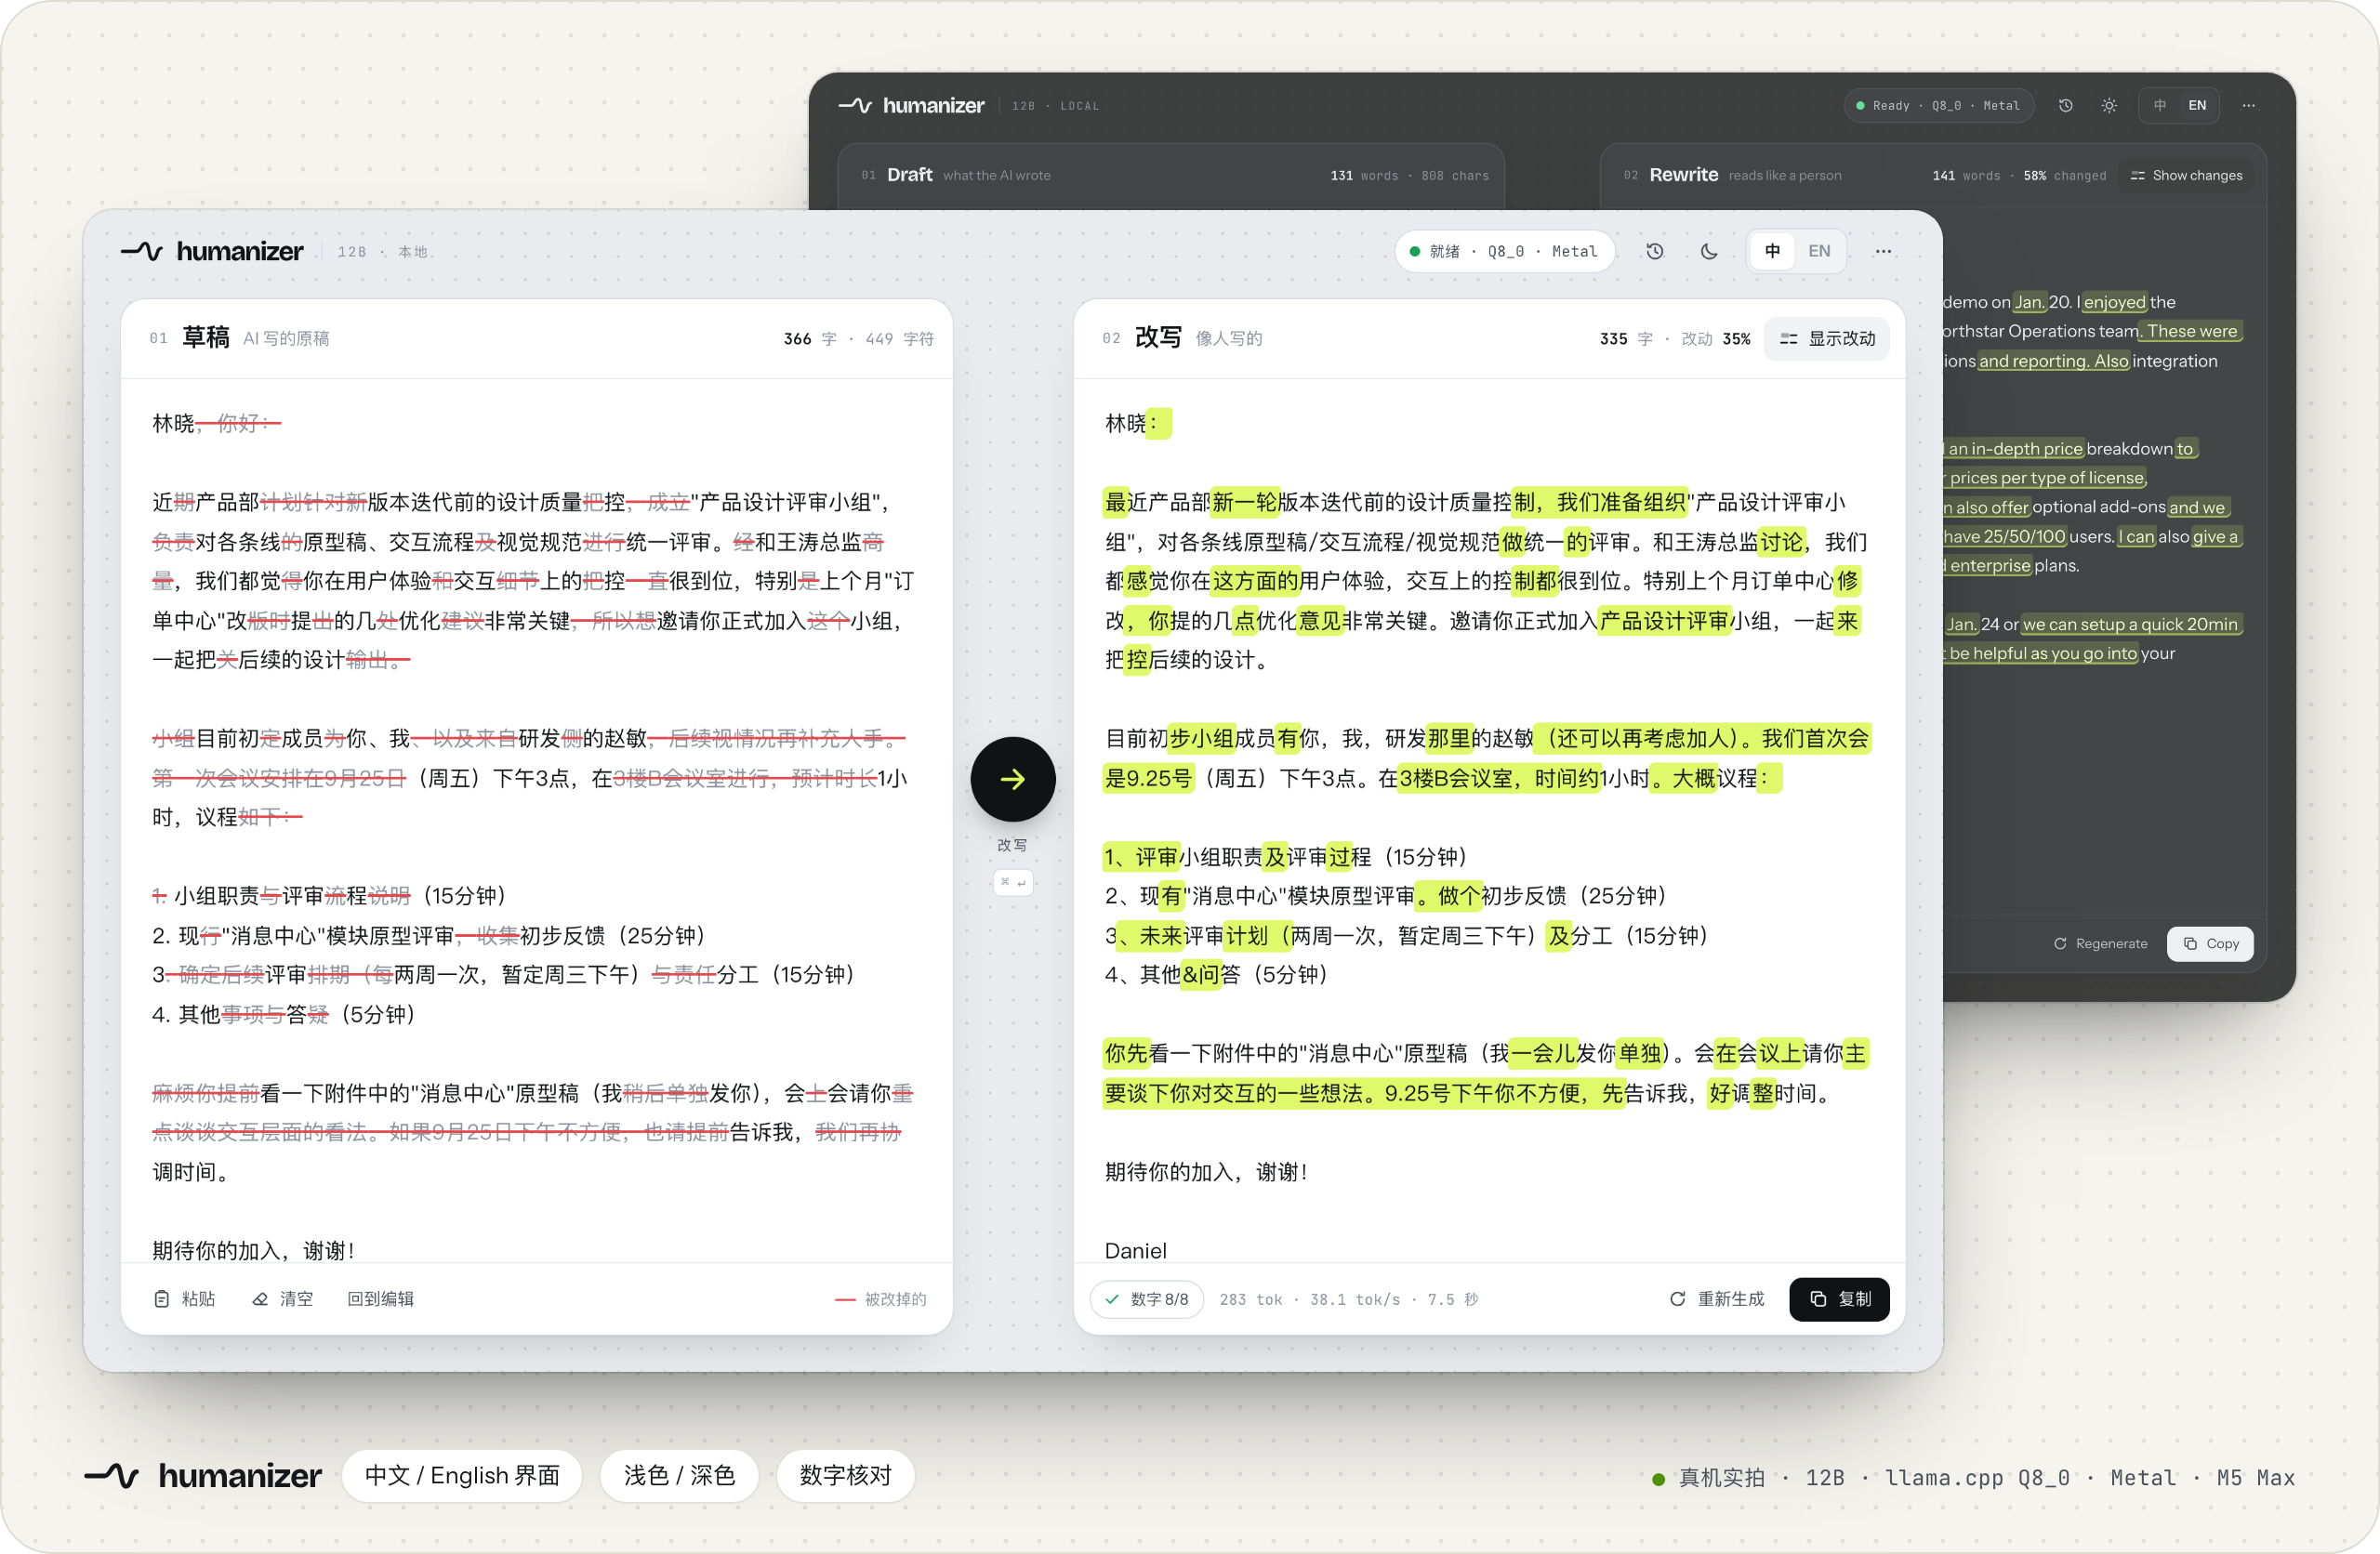 **humanizer** 是一个 12B 的改写模型:把 AI 写的草稿(邮件、作文、报告、论坛帖,中英文都行)改成读起来像人写的。训练目标是数字、单位、日期、人名、引语一个不丢,也不往里加东西,而且在你自己的电脑上跑。
**快速开始**:下载 App(**[Mac,Apple 芯片](https://github.com/sgaofen/humanizer-local-model/releases/download/app-v0.3.4/Humanizer-0.3.4-macos-arm64.dmg)** 或 **[Windows](https://github.com/sgaofen/humanizer-local-model/releases/download/app-v0.3.4/Humanizer-0.3.4-windows-x64-setup.exe)**),打开后贴草稿就行,之后完全离线。不用 App:[一行 llama.cpp 命令](#方式二一行命令llamacpp),或者把 [AGENTS.md](AGENTS.md) 交给你的编程 Agent。
## 改写前后
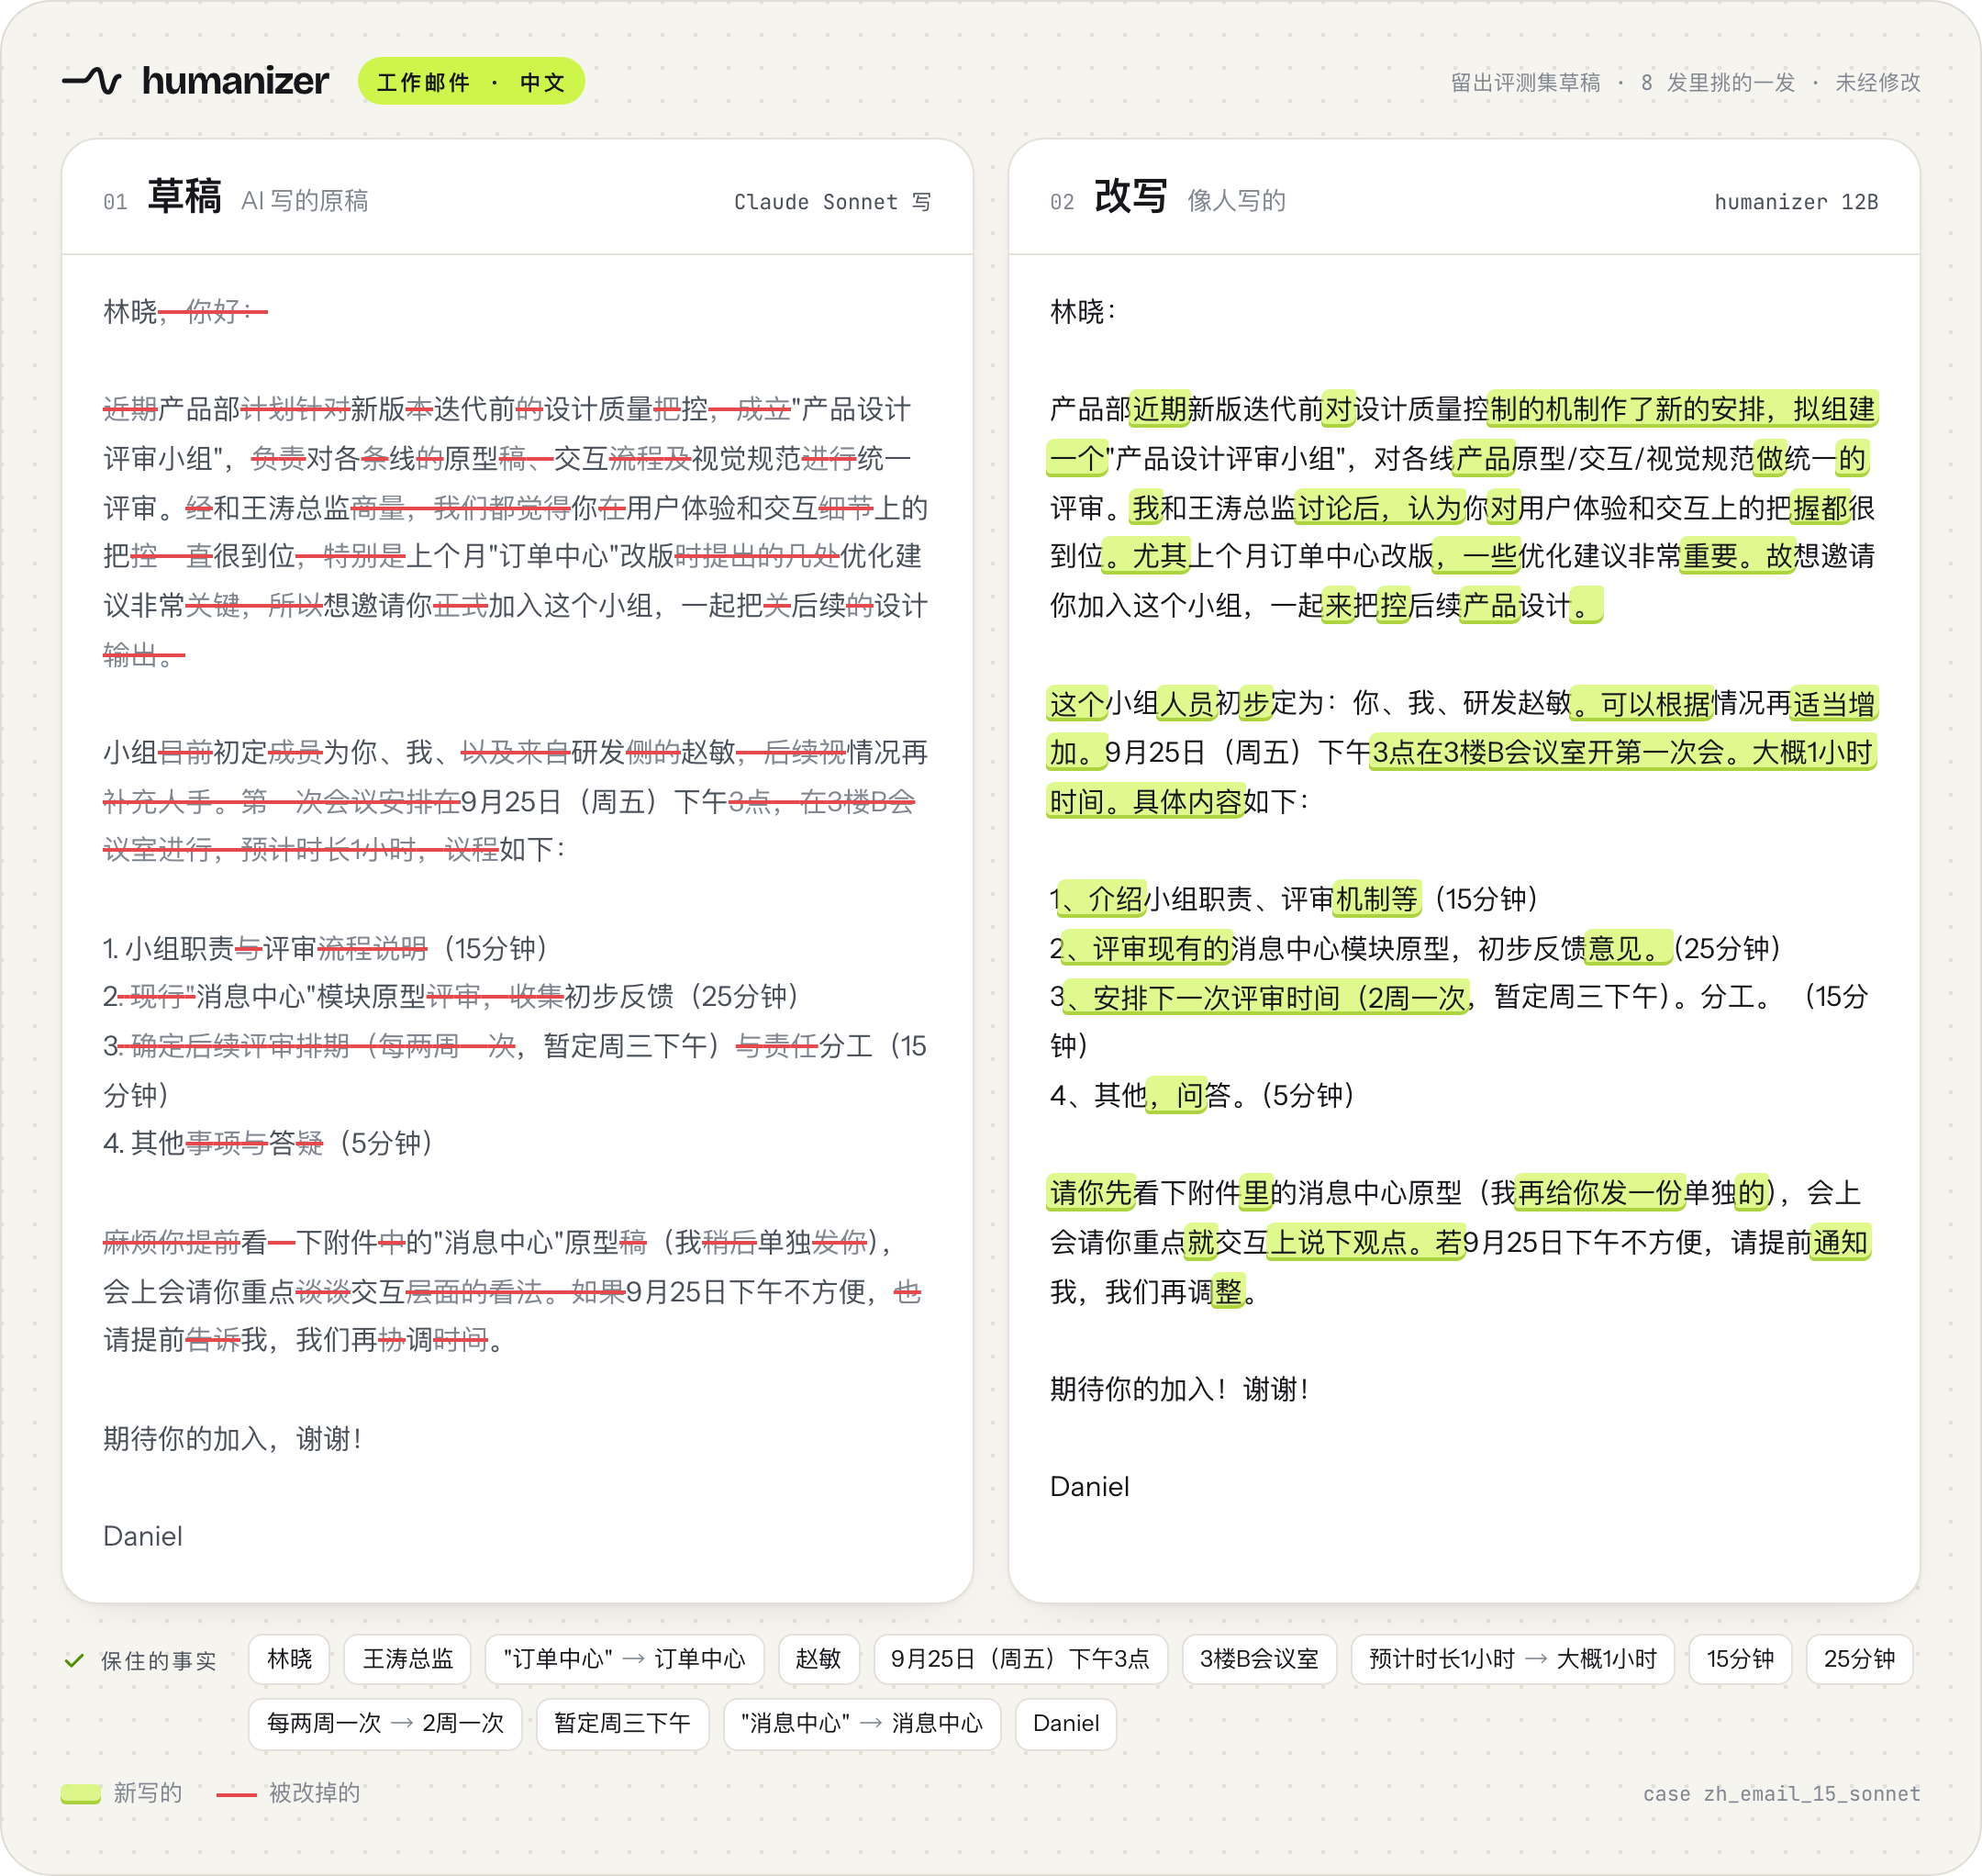
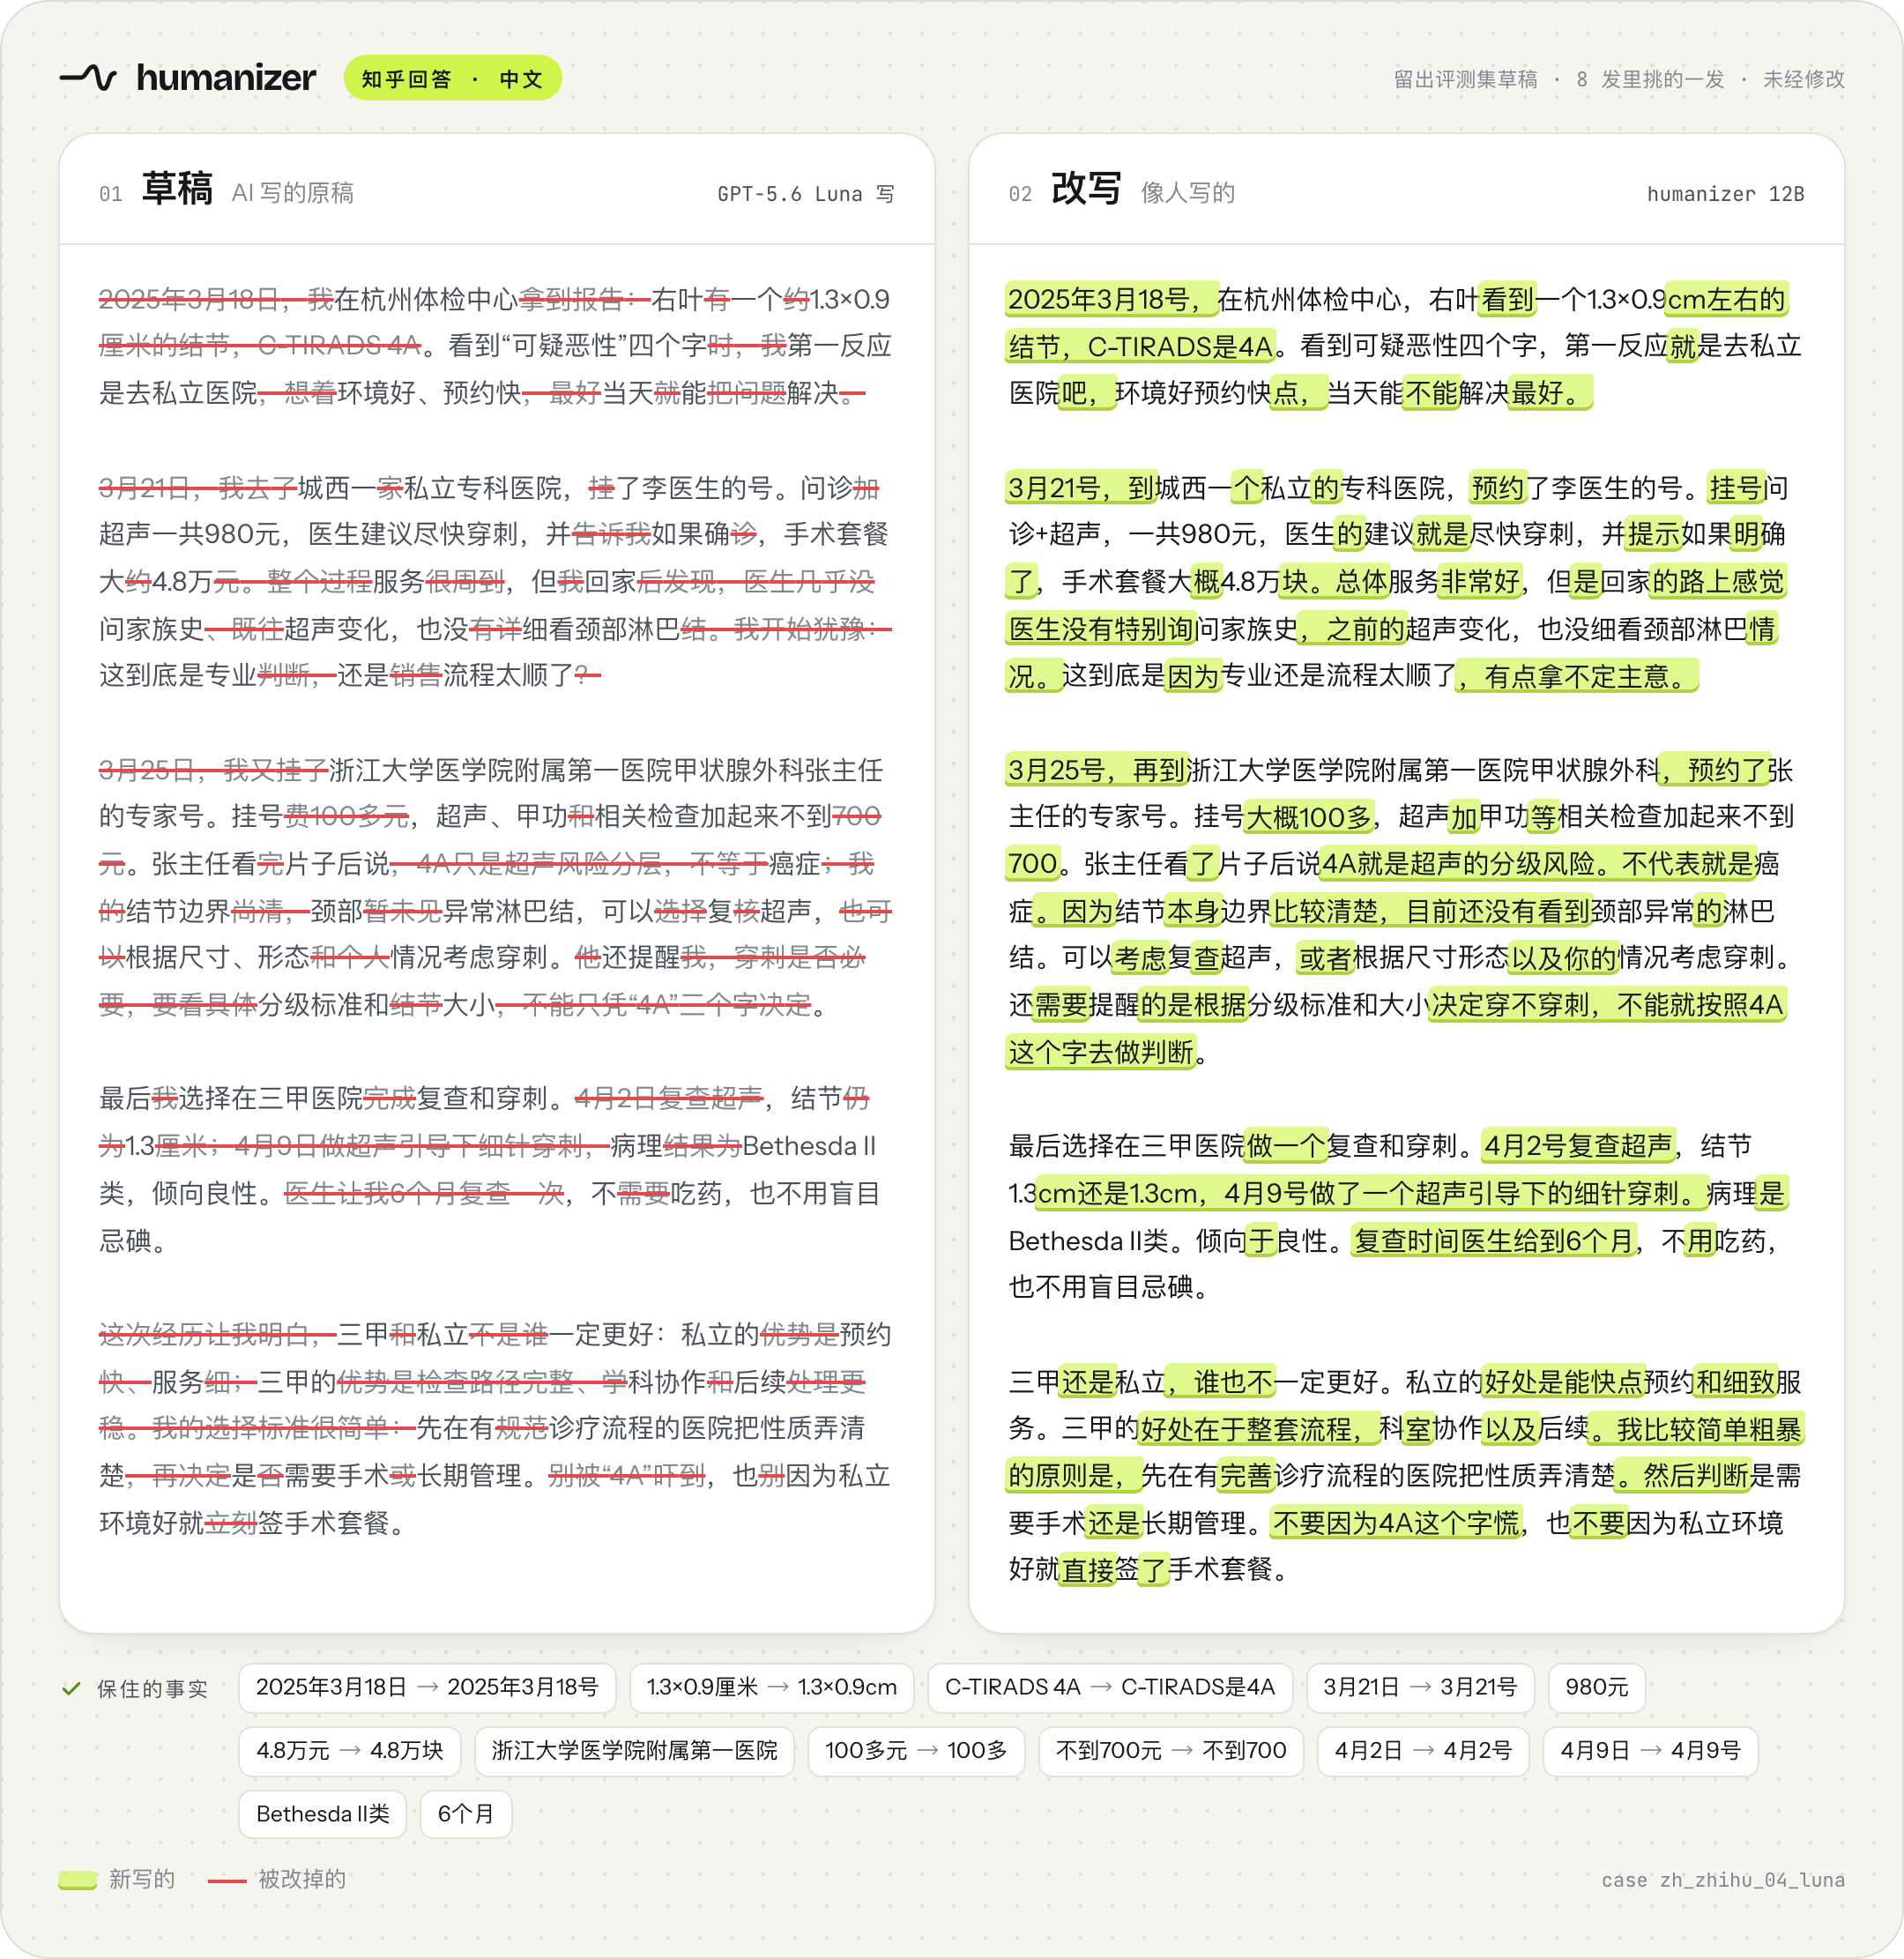
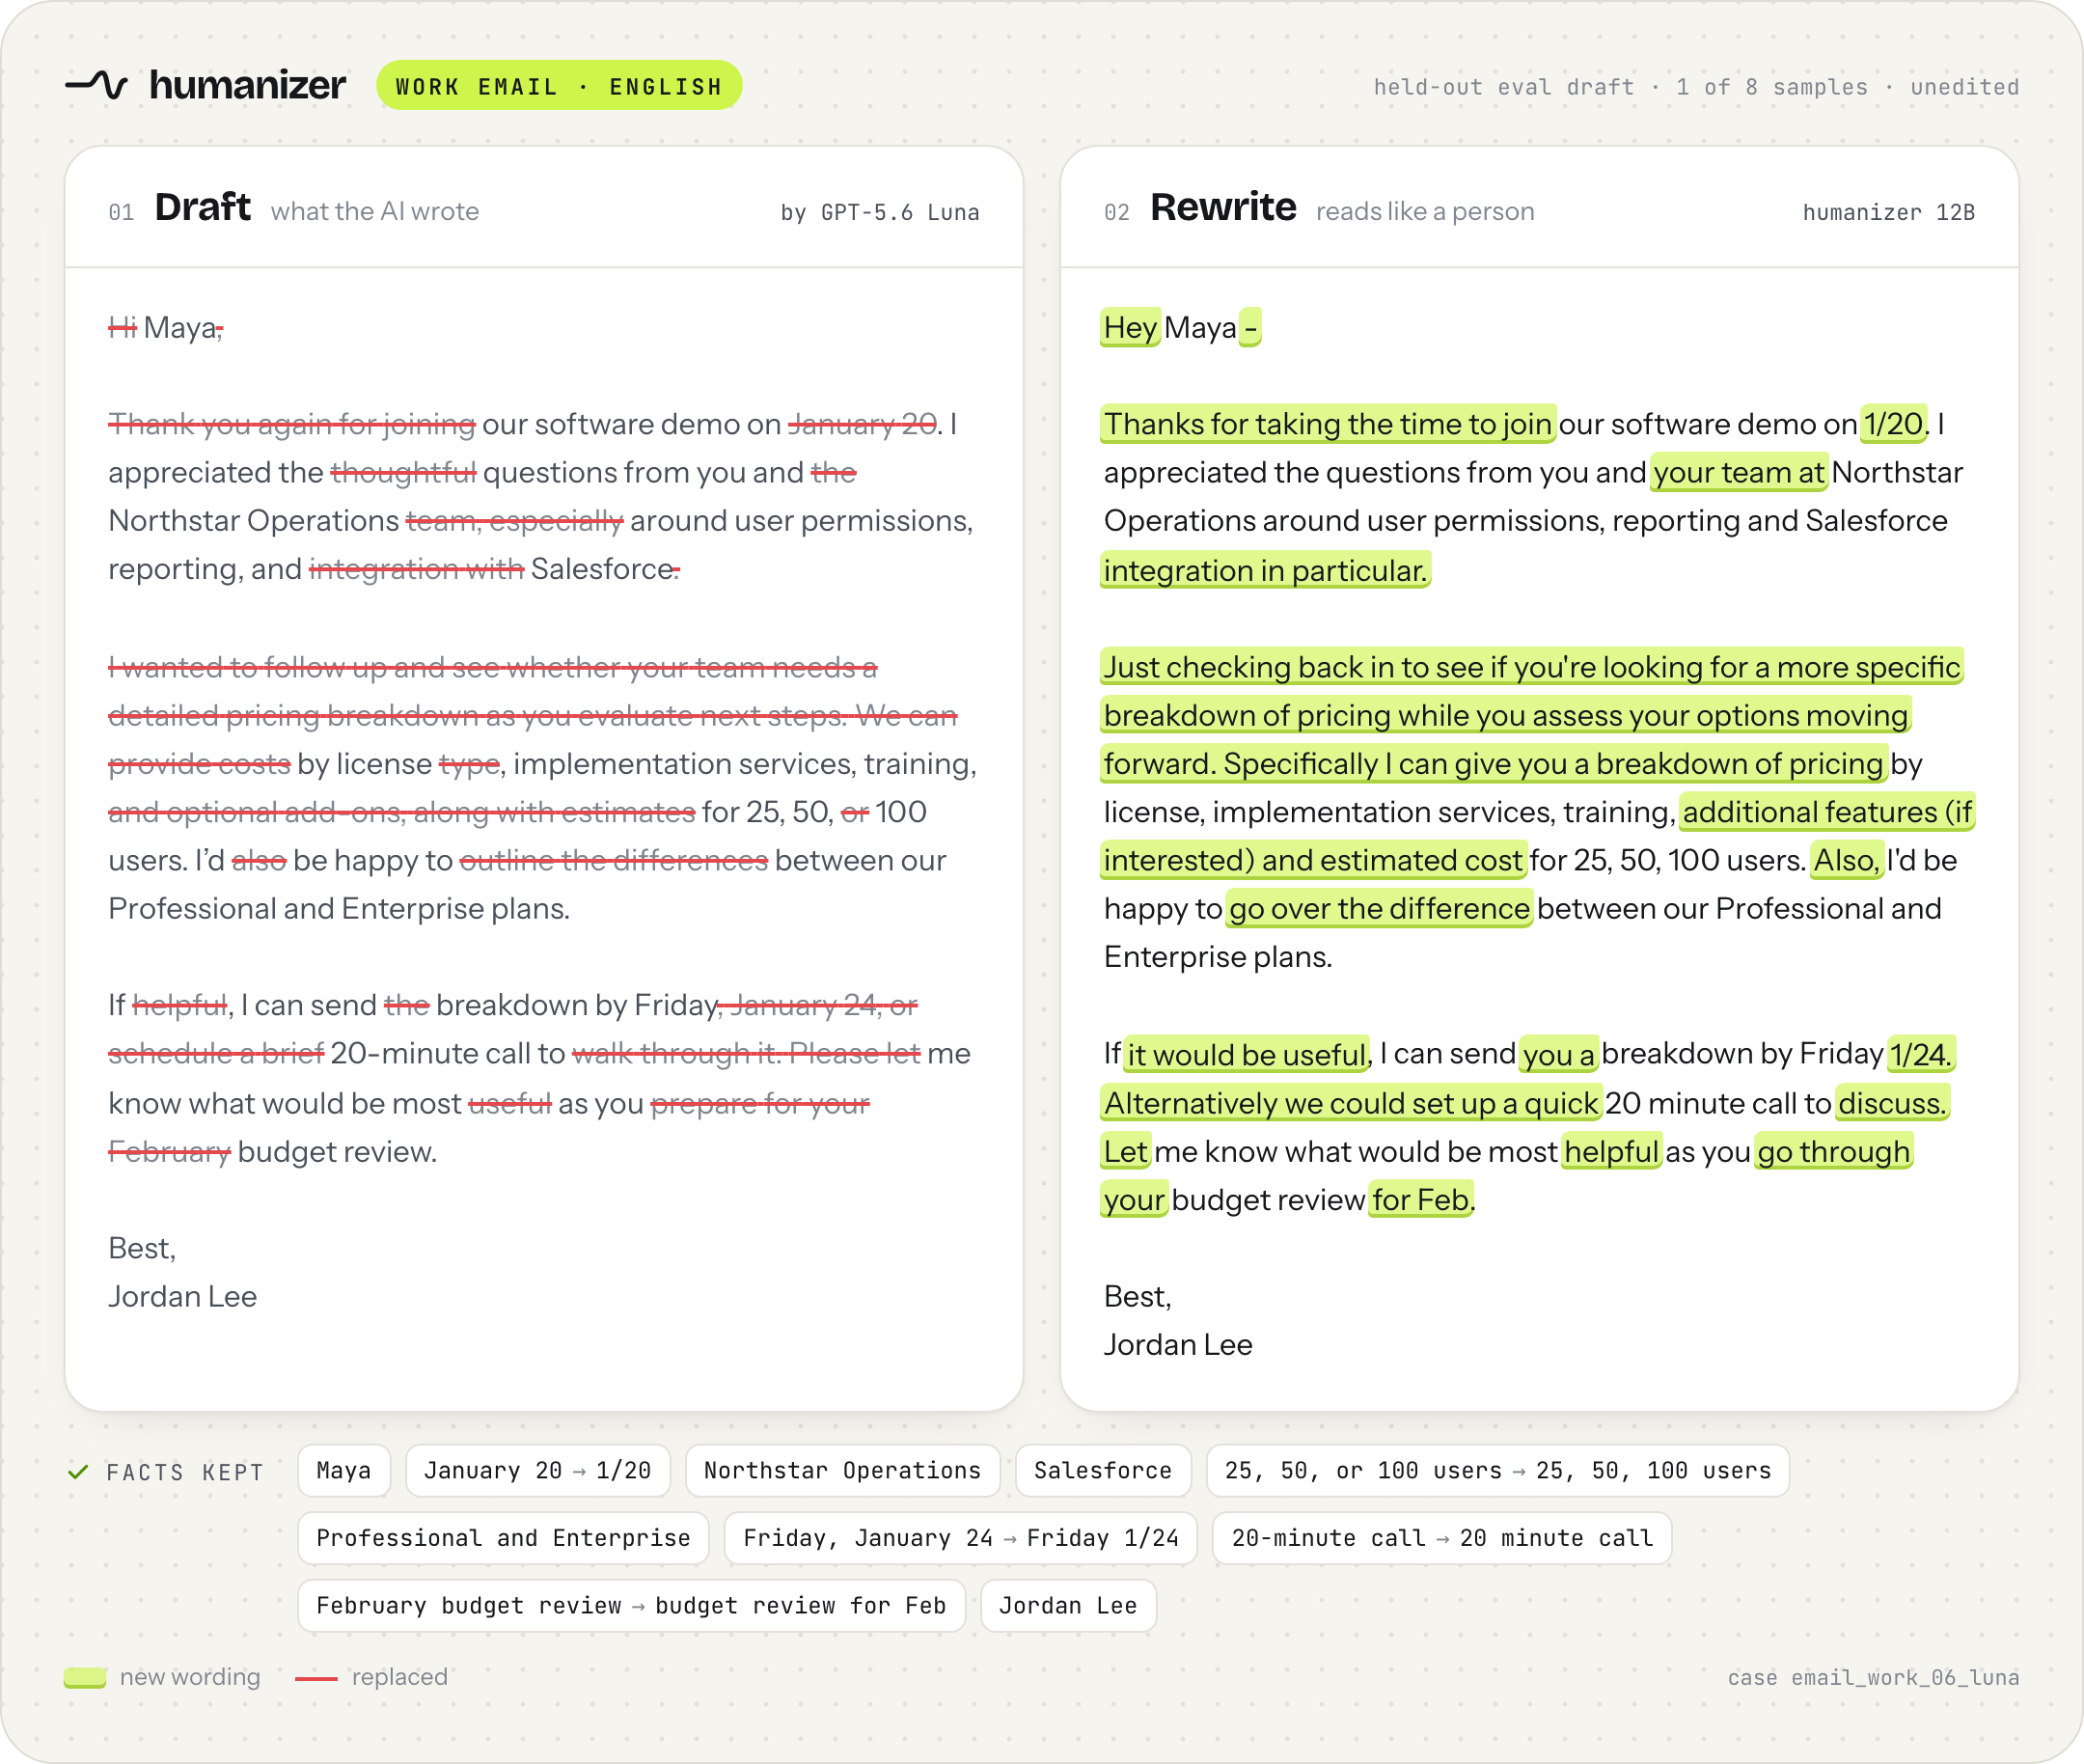
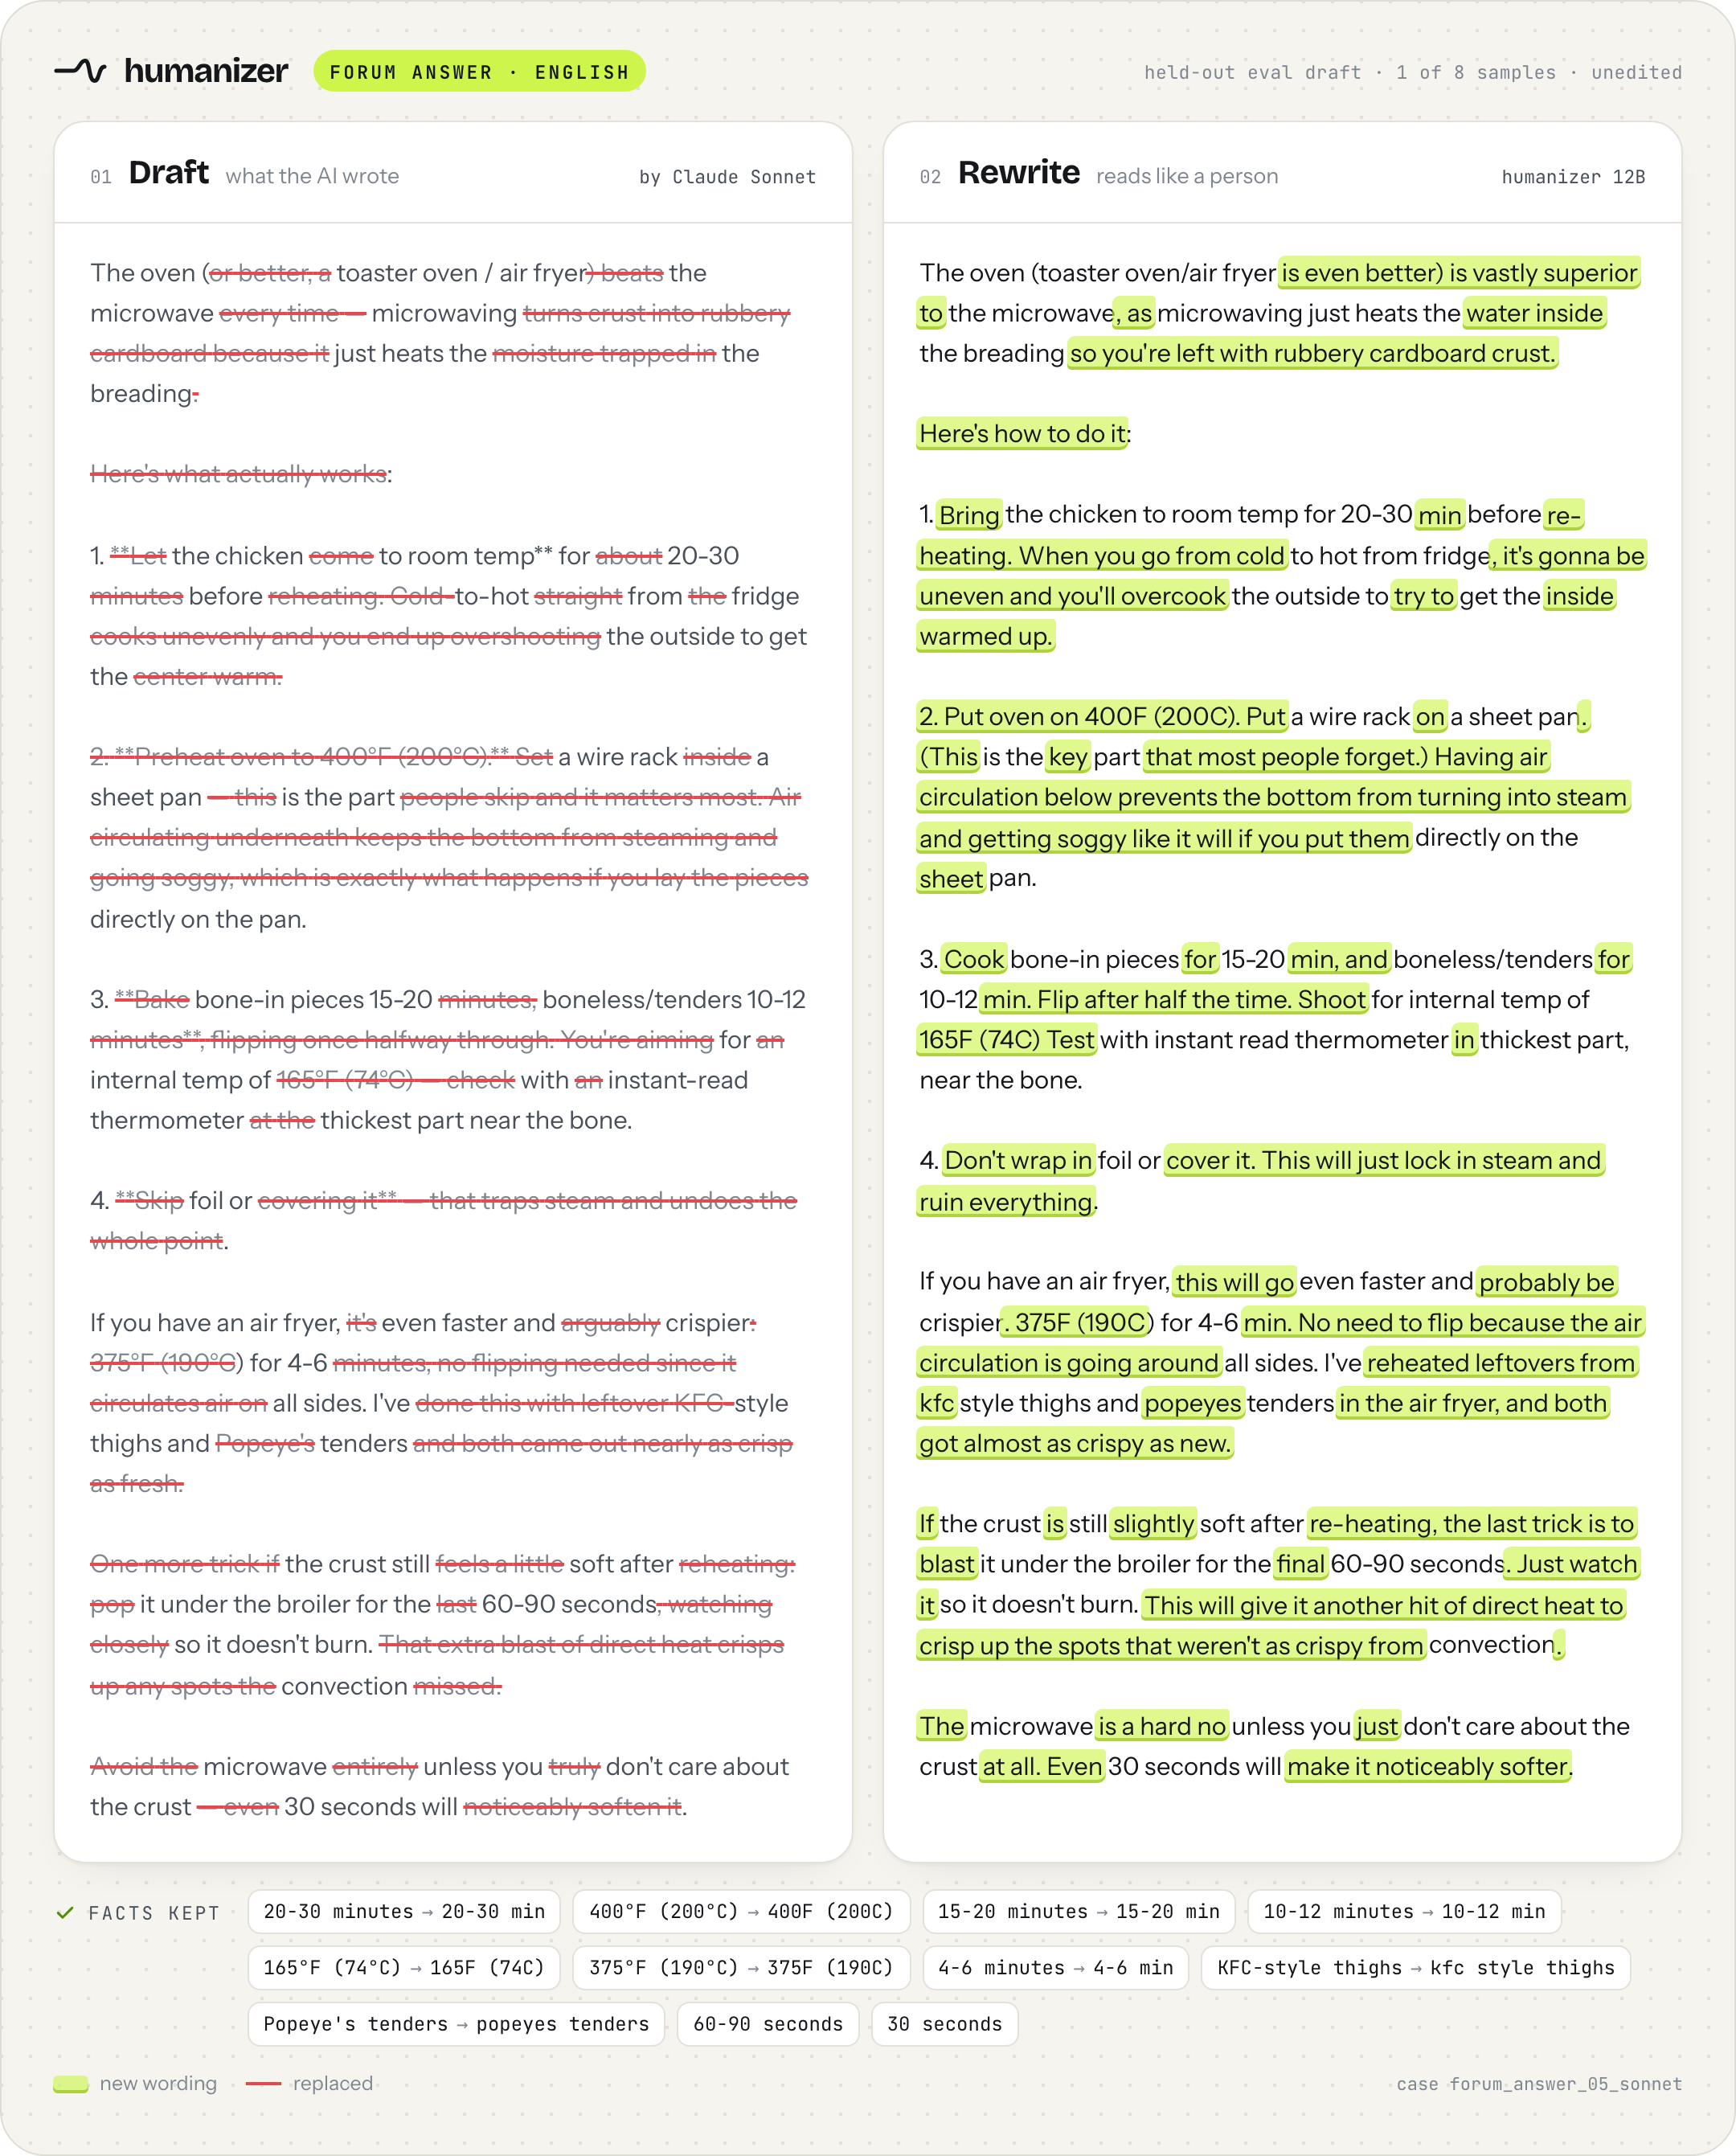
下面四篇草稿来自留出评测集(训练时从没见过)。每篇我们用本版的 `humanizer-12b-Q8_0.gguf` 文件(llama.cpp,和 App 相同的设置)生成 8 发,在事实判官判为通过的几发里挑了读起来最好的一发。右边就是这一发,**未经任何修改**,只为显示统一了空白;每篇 8 发全文都在 [eval/outputs/examples-12b-Q8_0_x8.json](eval/outputs/examples-12b-Q8_0_x8.json)。荧光笔 = 新写的,删除线 = 被改掉的原文。这四篇里的每个数字和人名我们也人工核对过。
这是挑出来的,不是每一发都这样。放到整个评测集上,模型还是会改错细节:中文 204 篇改写里,判官标出 54 篇,共 236 处,其中 212 处只是一个词或一个短语(比如草稿的“本月20日前后”被写成“20号以前”)。**发出去之前请通读一遍,特别是数字、日期和人名**。详见[评测细节](#评测细节)。
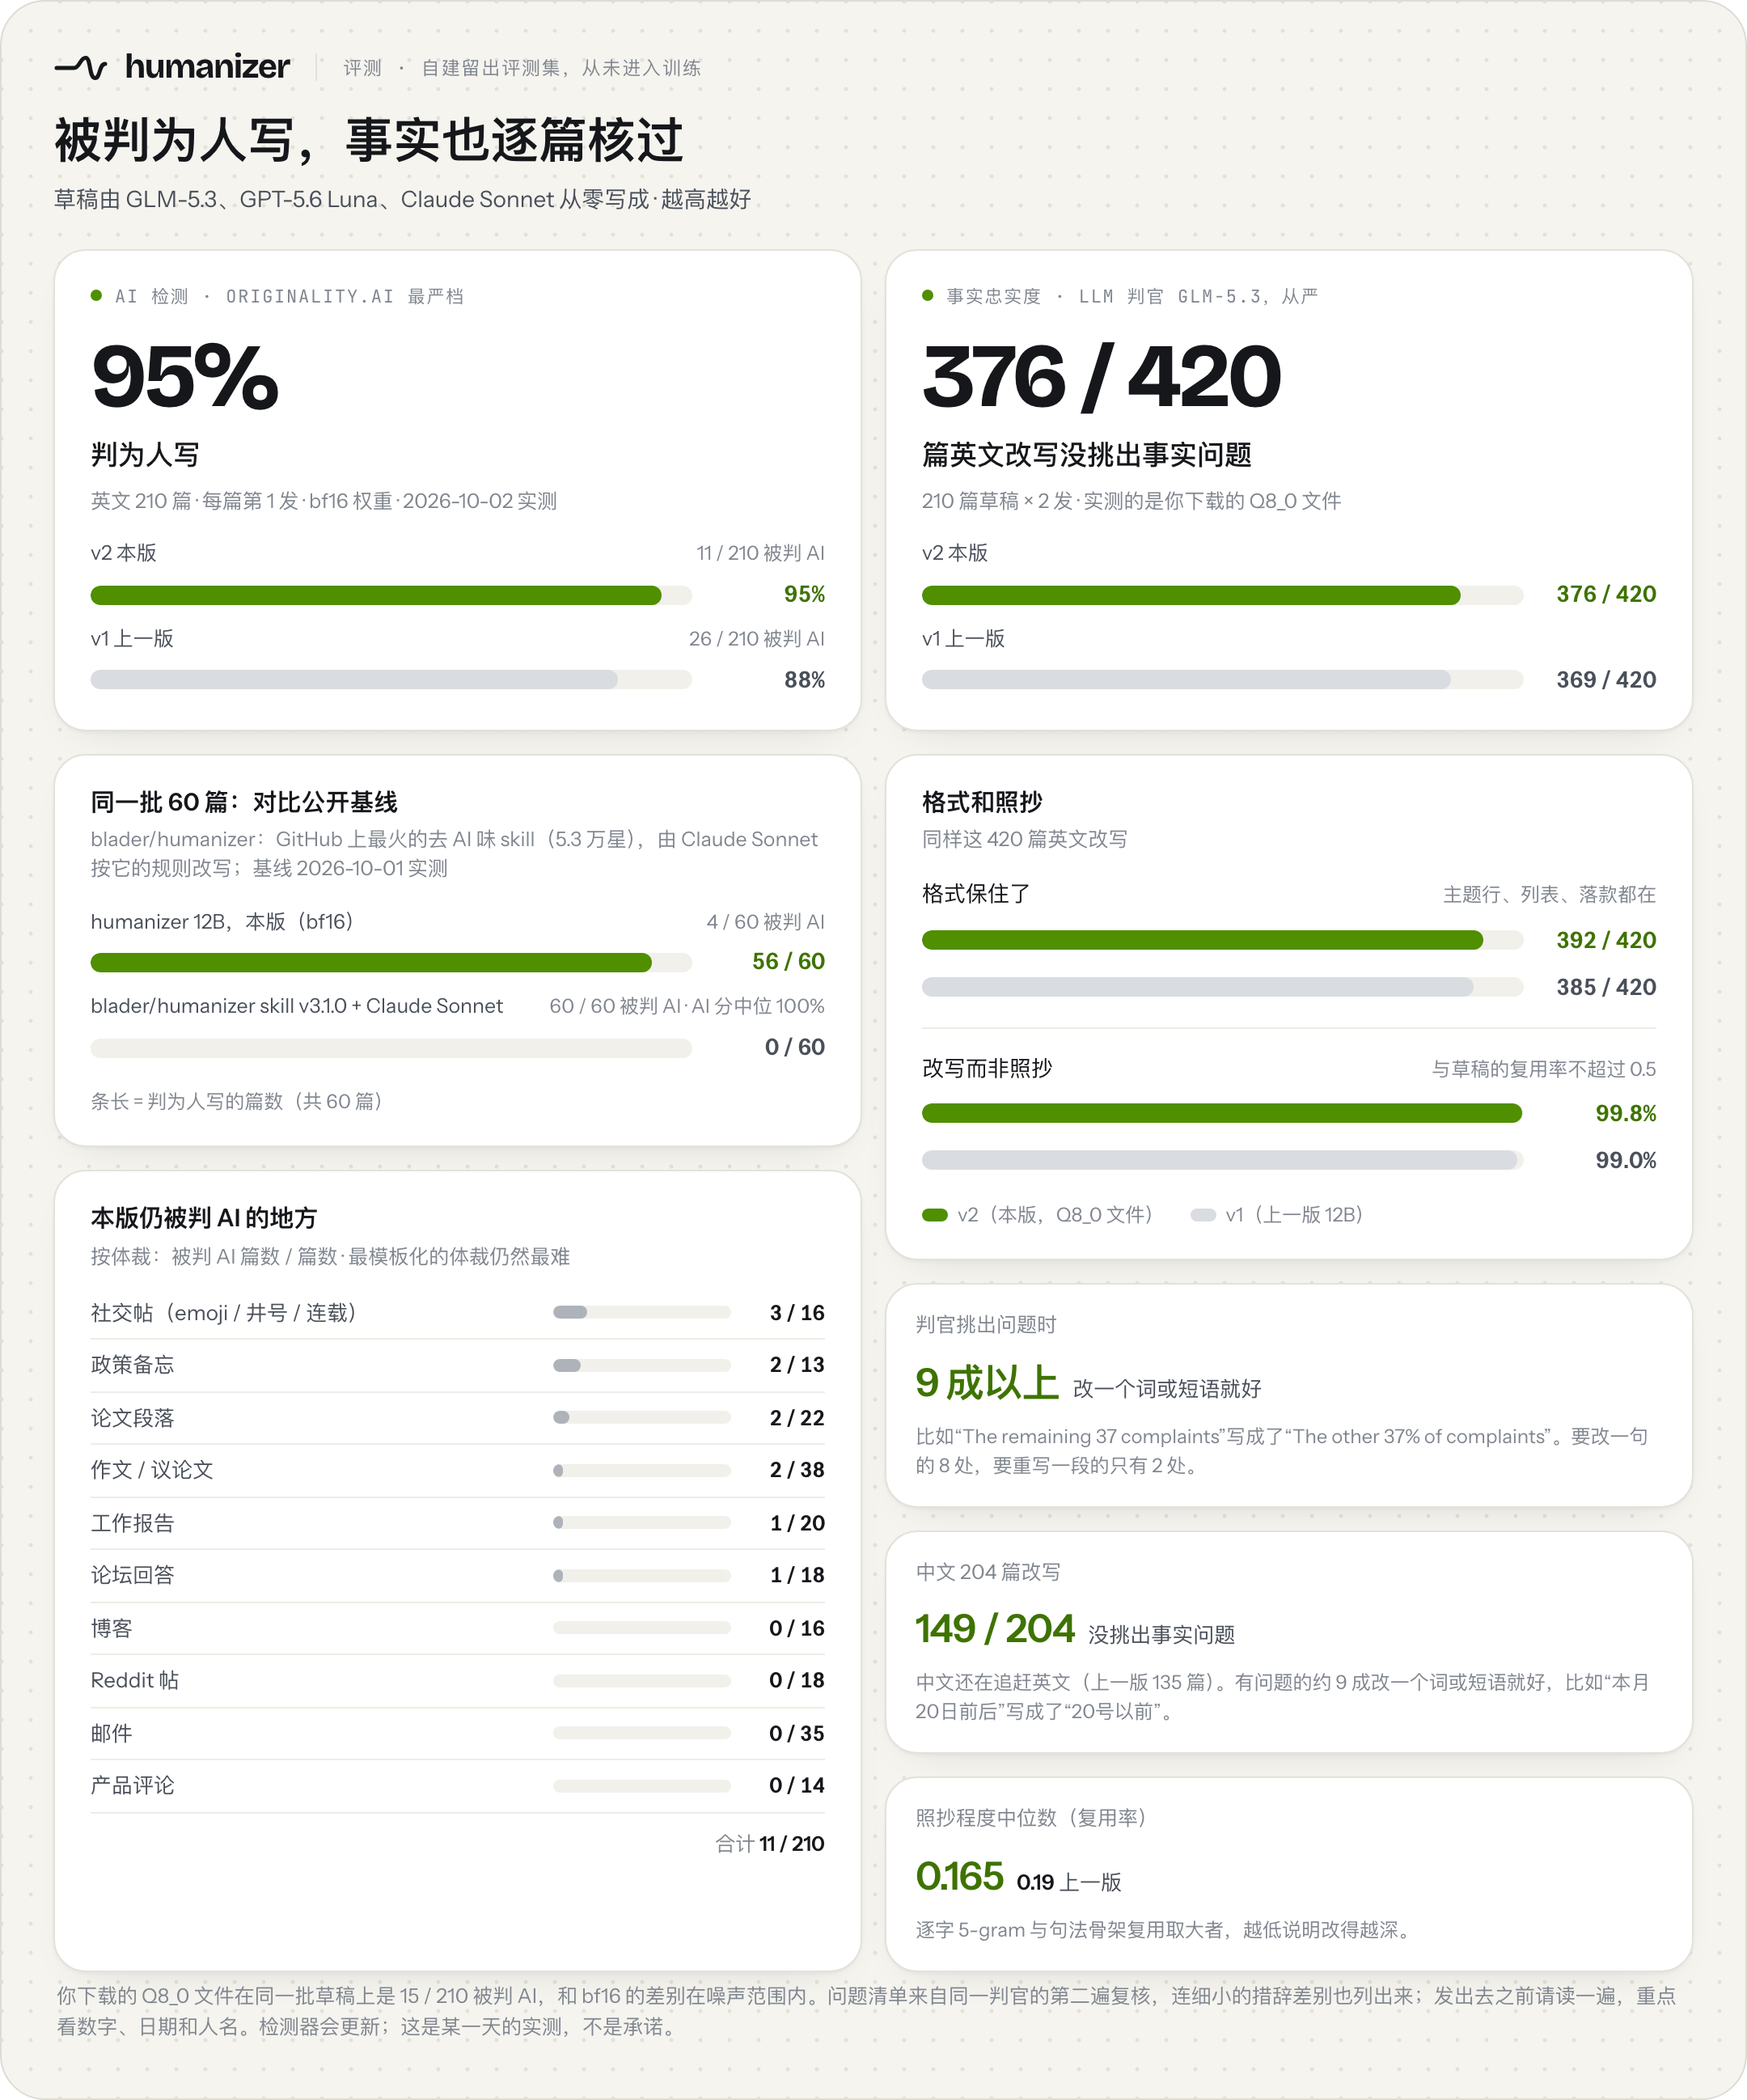 **Originality.ai 最严档把 95% 的改写判为人写**(英文 210 篇,bf16 权重,2026-10-02 实测):210 篇里 11 篇被判 AI,上一版是 26 篇;训练全程没有用过任何 AI 检测器。**英文 420 篇改写里,有 376 篇判官没挑出事实问题**(从严的 LLM 判官,实测的是你下载的 `humanizer-12b-Q8_0.gguf` 文件);挑出问题的,9 成以上改一个词或短语就好。中文 204 篇改写里,149 篇没挑出事实问题。方法、各体裁结果和中文细节见[评测细节](#评测细节)。
## 量化:文件更小,离完整模型更近
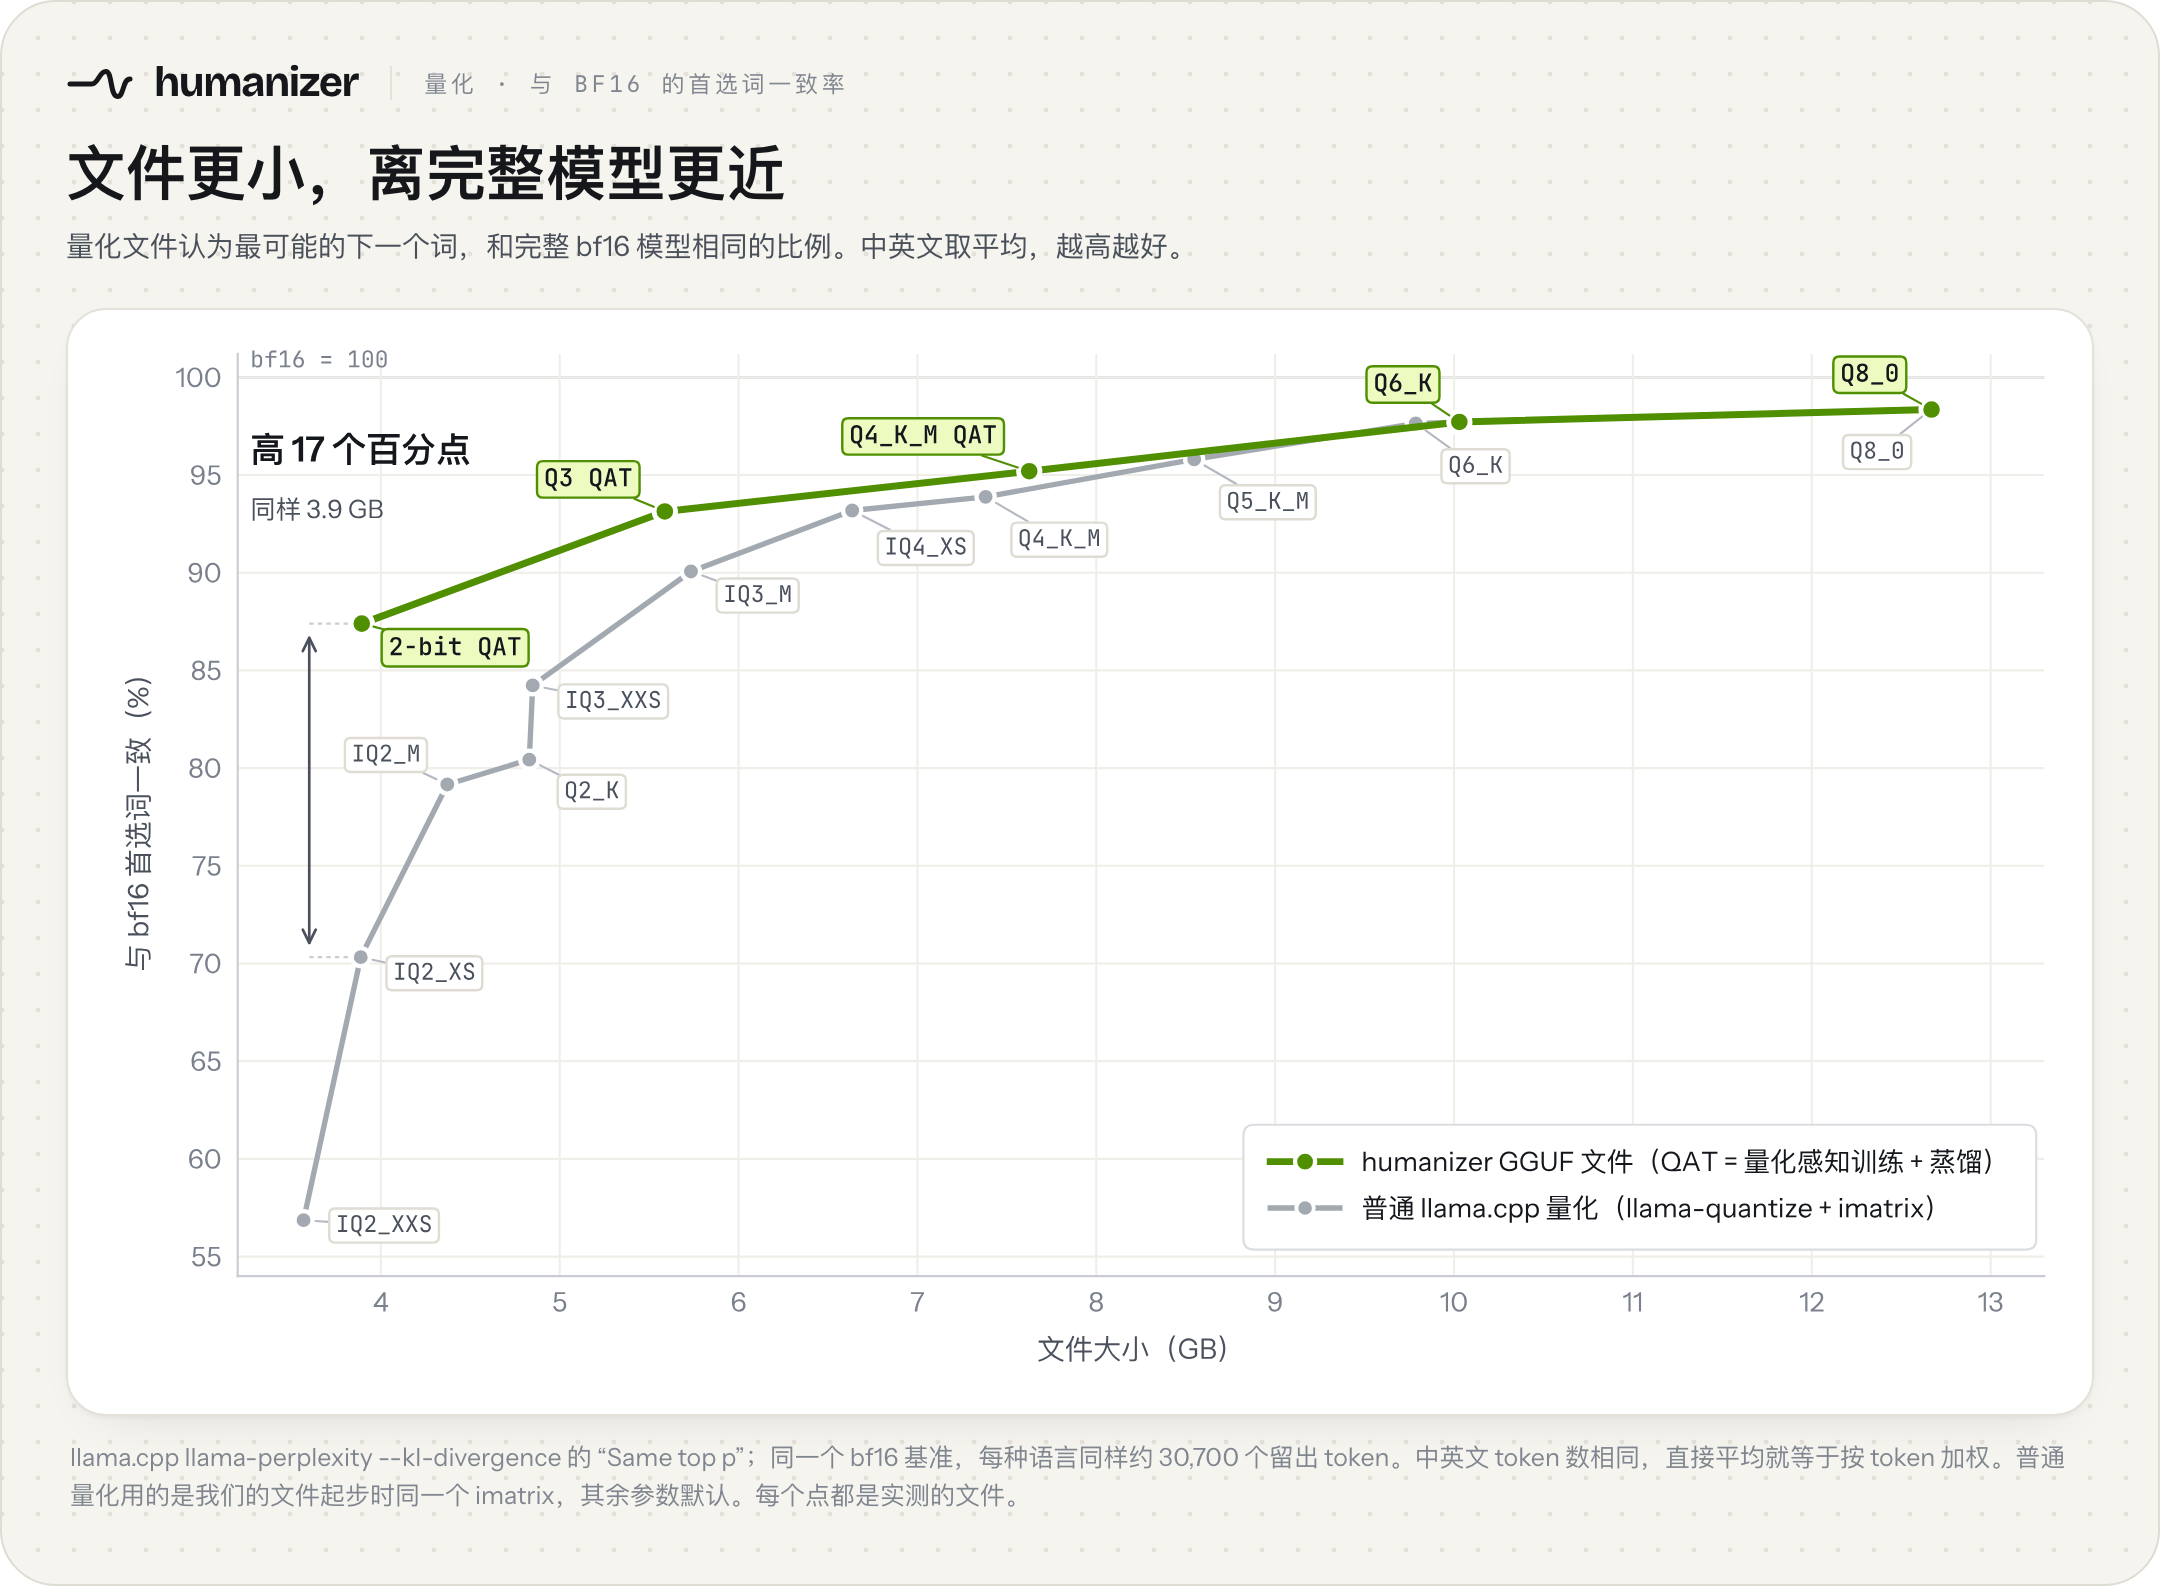 大多数 GGUF 都是 `llama-quantize` 一步量出来的,把每个权重直接取整到目标类型;我们的 2-bit、Q3 和 Q4_K_M 多做了几步。2-bit 和 Q3 先逐个张量测它被压缩后对模型的影响有多大,敏感的张量多给位数,不敏感的少给。三个文件都再逐层训练,让量化后的模型去贴近完整模型的输出(量化感知训练),最后用完整的 bf16 模型当老师,在中英文改写数据上做蒸馏。拿 2-bit 文件来说,同样大小的普通量化和 bf16 首选词一致的比例是 70%,这几步依次把它提到 81%、85%、87%。产出的仍是普通 GGUF,任何新版 llama.cpp 都能直接跑;Q6_K 和 Q8_0 是普通量化,因为在这个大小已经几乎没有损失可以找回。
每个点背后的数字、KL、各档事实检查和每个文件的做法:[docs/QUANTIZATION.zh.md](docs/QUANTIZATION.zh.md)。
**目录**:[快速开始](#快速开始) · [改写前后](#改写前后) · [评测细节](#评测细节) · [怎么训的](#怎么训的) · [用法](#用法) · [局限](#局限) · [协议](#协议)
## 快速开始
> [!TIP]
> **想让 AI Agent 帮你装?** 把 **[AGENTS.md](AGENTS.md)**(或 [llms.txt](llms.txt))丢给它:里面写了该下哪个文件、怎么起服务、逐字的提示词,以及装好后的自检方法。
### 方式一:App(最省事)
| 你的电脑 | 下载 |
|---|---|
| **Mac**(Apple 芯片,M1 及以后) | [`Humanizer-0.3.4-macos-arm64.dmg`](https://github.com/sgaofen/humanizer-local-model/releases/download/app-v0.3.4/Humanizer-0.3.4-macos-arm64.dmg),或到 **[Releases](https://github.com/sgaofen/humanizer-local-model/releases/latest)** 下最新版 |
| **Windows**(x64) | [`Humanizer-0.3.4-windows-x64-setup.exe`](https://github.com/sgaofen/humanizer-local-model/releases/download/app-v0.3.4/Humanizer-0.3.4-windows-x64-setup.exe)(或免安装的 [`.zip`](https://github.com/sgaofen/humanizer-local-model/releases/download/app-v0.3.4/Humanizer-0.3.4-windows-x64-portable.zip)),或到 **[Releases](https://github.com/sgaofen/humanizer-local-model/releases/latest)** 下最新版 |
双击后 App 会在浏览器里打开。第一次运行时它会看你的内存、推荐一个档位,从 Hugging Face 下载一次模型;之后完全离线。左边贴草稿,右边流式出改写,新写的部分用荧光笔标出,被改掉的部分在原稿上划掉。在 M5 Max 上,一封百来词的英文邮件约 3.6 秒,一封 300 字左右的中文邮件约 8.5 秒。
0.3.2 新增:可以导入 Word(`.docx`)或 PDF 文件里的文字;在草稿里选中一段文字点「原样保留」,改写时这段一字不改(两项都来自 [@meharrkapoorr](https://github.com/meharrkapoorr) 的贡献)。0.3.3:保留的文字在草稿和改写里都会标出来;改写完草稿仍能直接改,改完再点改写即可。0.3.4:长草稿自动分段改写,可以中途停下、关掉页面,回来接着改(来自 [@meharrkapoorr](https://github.com/meharrkapoorr) 的贡献);已经在 LM Studio 或别的 OpenAI 兼容服务里跑着模型的话,「…」→「外部模型服务」可以直接用它,不再启动自带引擎([详细说明](docs/USAGE.zh.md#8-lm-studio));「…」→「更改存储位置」可以把运行目录和模型放到别的盘,比如 D 盘(来自 [@DongyuAI](https://github.com/DongyuAI) 的贡献)。
App 有五个档位:Q8_0(最好)、Q6_K(测不出损失)、Q4_K_M(略有损失)、Q3(小幅损失,英文的事实小错略多)和 2-bit(AI 检测表现最好,事实小错多一些)。它按内存推荐一档,8 GB 的机器也能用;随时可以在「…」菜单 →「更换模型档位」里换。详见[选哪一档](docs/INSTALL.zh.md#选哪一档)。
**更新**:App 每天自动查一次 GitHub 和 Hugging Face(可以关掉),有新版本或模型文件更新时,顶栏会出现一个不打扰的小提示。点「…」→「检查更新」能看到改了什么、一键更新;模型、设置和历史记录都保留。检查更新从 0.3.2 起支持;0.3.1 及更早的版本需要手动更新一次(下载上面的版本装在旧版上面即可)。详见[检查更新](docs/INSTALL.zh.md#检查更新)。
App 目前没有代码签名,macOS 和 Windows 第一次打开都会拦一下,处理方法见[安装指南](docs/INSTALL.zh.md#第一次打开被拦)。
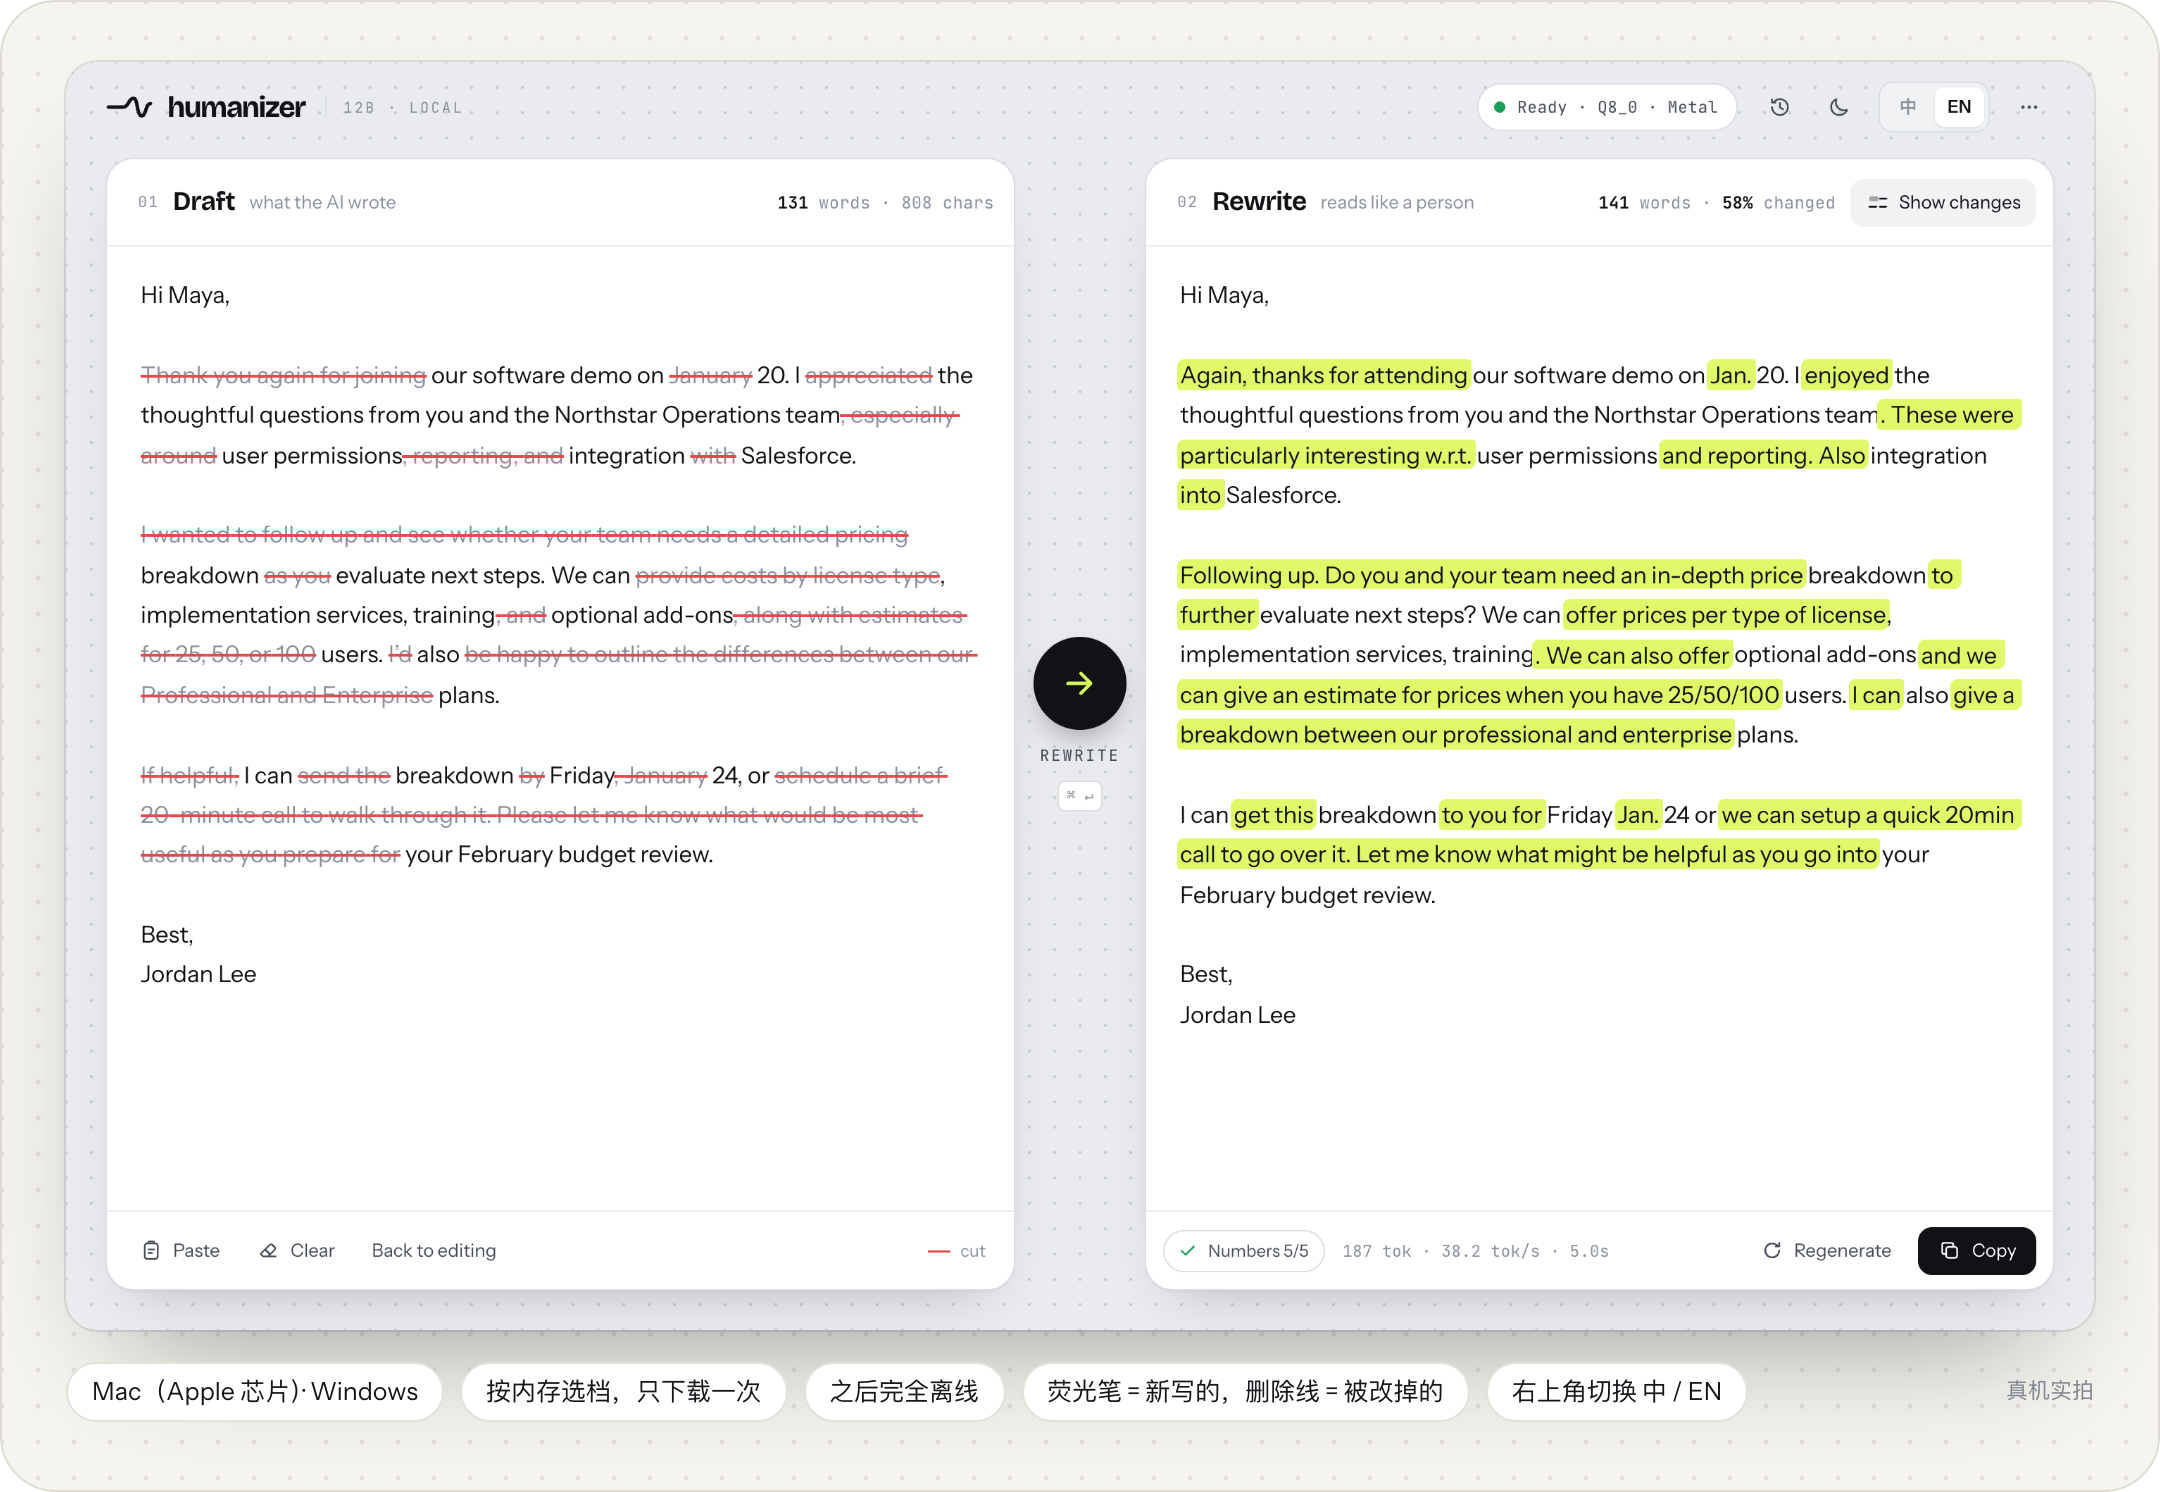 以上都是 App 跑 12B 模型的真机截图(llama.cpp Q8_0,Metal,M5 Max),底栏里的速度是真实的。
### 方式二:一行命令(llama.cpp)
```bash
# 1) 起本地服务;第一次会下载 humanizer-12b-Q8_0.gguf(约 12.7 GB)
# 16 GB 内存的机器:换成 humanizer-12b-Q6_K.gguf(约 10.0 GB);内存更少:
# humanizer-12b-Q4_K_M.gguf(7.6 GB)、humanizer-12b-Q3-QAT.gguf(5.6 GB)或 humanizer-12b-IQ2_XS-QAT.gguf(3.9 GB)
llama-server --hf-repo jialinyyzz/humanizer --hf-file humanizer-12b-Q8_0.gguf -c 8192 -np 1 -ngl 99 --port 8080
# 2) 另开一个终端:改写 draft.txt(需要 curl 和 jq)
curl -sLO https://huggingface.co/jialinyyzz/humanizer/resolve/main/prompt_format.json
jq -n --rawfile d draft.txt --slurpfile f prompt_format.json \
'{prompt: ($f[0].instr + "\n\n" + ($d | sub("^\\s+"; "") | sub("\\s+$"; "")) + $f[0].sep),
temperature: 1.0, top_p: 0.95, top_k: 0, min_p: 0, repeat_penalty: 1.0, n_predict: 2048}' \
| curl -s http://127.0.0.1:8080/completion -d @- | jq -r .content
```
这是纯文本续写模型,不是聊天模型:用 `/completion`,不要用 `/v1/chat/completions`。接到别的程序之前请先看[提示词格式](#提示词格式)。
### 方式三:命令行 `hz`(适合 Agent 和长文档)
`hz` 一行命令改写整个文件:短稿、长篇 Markdown 或 `.docx` 都行。它自己去找方式一的 App 或方式二的 llama-server(macOS 上 App 装了没开会自动拉起),标题、代码块、表格和链接原样保留,正文分块改写,每块都检查有没有丢数字、是不是照抄。需要 Python 3.8 及以上,没有别的依赖。
```bash
pipx install git+https://github.com/sgaofen/humanizer-local-model # 或者:pip install git+https://github.com/sgaofen/humanizer-local-model
hz draft.txt # 打印改写结果
hz paper.md -o paper.out.md # 长篇 Markdown:结构保留,正文分块改写
hz report.docx -o report.out.docx # .docx 需要 python-docx:pipx inject humanize-model python-docx
hz paper.md --json # 每块的统计,给脚本和 Agent 用
```
改完它会在 stderr 列出哪些块丢了草稿里的数字、或者多出了草稿里没有的数字,告诉你该看哪里。全文还是要通读一遍:人名和句子意思它查不了,也不承诺任何检测器结果。`.docx` 里改写过的段落统一用第一个 run 的格式,段内的粗体、斜体会丢。在 M5 Max 上用 App,一篇 1,200 词的英文 Markdown 用了 41 到 54 秒。详见 [USAGE.zh.md 第 14 节](docs/USAGE.zh.md#14-命令行工具-hz)。
国内下载慢可以给命令前面加 `HF_ENDPOINT=https://hf-mirror.com`(App 里也能直接选 hf-mirror.com)。
> [!IMPORTANT]
> **不用 App?请看 [docs/USAGE.zh.md](docs/USAGE.zh.md)(不用 App 怎么用)**。里面有 llama.cpp(服务和一次性跑)、MLX、transformers、vLLM、Ollama、LM Studio 的完整步骤,可以直接复制;还有批量改写一个文件夹的脚本、长文和中文怎么处理,以及排错表。
## 评测细节
所有数字都来自我们自建的评测集:**312 篇草稿**(英文 210 篇、中文 102 篇),18 种体裁:邮件、给教授的邮件、工作报告、政策备忘、论文段落、学生作文、议论文、博客、Reddit、论坛回答、产品评论、社交帖;中文有邮件、知乎、随笔、社媒、报告、论文。草稿由三个前沿模型从零写成,各约三分之一:GLM-5.3、GPT-5.6 Luna、Claude Sonnet。这些草稿都没有进训练。每篇改写 2 发。所有输出和判词都在 [eval/](eval/)。
### AI 检测(外部核对)
**95% 判为人写**。检测器 Originality.ai,API v3,**AI Allowance 0%(最严档)**,**2026-10-02** 实测,**英文 210 篇**,每篇取第 1 发,**bf16 权重**:**210 篇里 11 篇被判 AI**。
| 模型 | 被判 AI | 判为人写 |
|---|---|---|
| **humanizer 12B v2,本版(bf16)** | **11 / 210(5%)** | **95%** |
| humanizer 12B v1,上一版 | 26 / 210(12%) | 88% |
本版被判 AI 的次数不到上一版的一半。同一批草稿里,只有上一版被判 AI 的 20 篇,只有本版被判 AI 的 5 篇(配对检验 p = 0.004)。你下载的 `humanizer-12b-Q8_0.gguf` 文件在同一批草稿上是 15 / 210(7%),和 bf16 的差别在噪声范围内(配对检验 p = 0.48)。
**公开基线**。[`blader/humanizer`](https://github.com/blader/humanizer)(v3.1.0,5.3 万星)是 GitHub 上最火的去 AI 味 skill。我们让 Claude Sonnet 按它的规则改写同一批 60 篇:**60 / 60 全被判 AI**(AI 分中位数 100%)。本版(bf16)在这 60 篇上被判 AI 的是 **4 / 60**。两者是不同类型的工具(给通用模型的一套规则 vs. 专门微调的改写模型),所以这里比的是同一批输入上的结果,不是方法本身。
**还会失败的地方**。最模板化的体裁仍然最难:
| 体裁 | 被判 AI |
|---|---|
| 带 emoji、井号或“1/ 2/”连载的社交帖 | **3 / 16** |
| 正式政策备忘 | **2 / 13** |
| 论文段落 | 2 / 22 |
| 作文 / 议论文 | 2 / 38 |
| 工作报告 | 1 / 20 |
| 论坛回答 | 1 / 18 |
| 博客 | 0 / 16 |
| Reddit 帖 | 0 / 18 |
| 邮件(工作邮件、给教授的邮件) | 0 / 35 |
| 产品评论 | 0 / 14 |
| **合计** | **11 / 210** |
检测器会更新,这只是一个检测器在某一天的结果,不代表其他检测器或其他时间。
### 事实忠实度
**英文 420 篇改写里,有 376 篇判官没挑出事实问题**(LLM 判官 GLM-5.3,每篇一票、从严判;210 篇草稿 × 每篇 2 发),实测的是你下载的 `humanizer-12b-Q8_0.gguf` 文件。上一版是 420 篇里 369 篇。图在[本页开头](#评测结果)。
| | **v2,本版(Q8_0 文件)** | v1,上一版 12B |
|---|---|---|
| 没挑出事实问题(数字、事件、意思都没改;越高越好) | **376 / 420** | 369 / 420 |
| 丢了格式要素(如主题行、列表、落款;越低越好) | **28 / 420** | 35 / 420 |
| 照抄程度中位数(复用率;越低越好) | **0.165** | 0.19 |
| 复用率超过 0.5 的输出(越低越好) | **0.2%** | 1.0% |
*复用率*取逐字 5-gram 照抄和句法骨架复用两者中较大的那个,越低说明改得越深。
**判官挑出问题的,大多改一下就好**。我们让同一个判官再过一遍:对照草稿重读每篇被标出的改写,把每处问题和要改多少都列出来。这一遍连细小的措辞差别都会列。列出来的修改里,9 成以上(135 处里 125 处)改一个词或短语就好,比如草稿里的“The remaining 37 complaints”(剩下的 37 条投诉)被写成了“The other 37% of complaints”(另外 37% 的投诉);要改一句的 8 处,要重写一段的 2 处。
**中文还在追赶英文**。中文 204 篇改写里,判官在 **149 篇**里没挑出事实问题(上一版 135 篇;其余 55 篇里有 7 篇只是多加了一点内容)。有问题的,约 9 成(236 处里 212 处)改一个词或短语就好:比如“本月20日前后”写成了“20号以前”。要改一句的 21 处,要重写一段的 3 处。
**说明:事实判官是故意设得从严的**。在另一次对同一判官模型的抽查里,我们让第二个判官(Claude Opus)重读了它判为“严重”的 150 篇改写(来自训练过程,不是这里的评测集)。对第一个判官点名的那条事实,Opus 认为确实是严重错的有 99 篇,只算轻微的 41 篇(比如“可能减少”写成了“会减少”,或者一个长名字被写短了),事实其实没变的 10 篇。所以有些被标出的地方只是无害的措辞变化。发出去之前,数字、日期和人名还是请自己读一遍。
**发出去之前还是请读一遍**,重点看数字、日期、人名和每个论断的方向。App 会检查草稿里的每个数字是否都出现在改写里,对不上的会标出来(只比阿拉伯数字)。
## 怎么训的
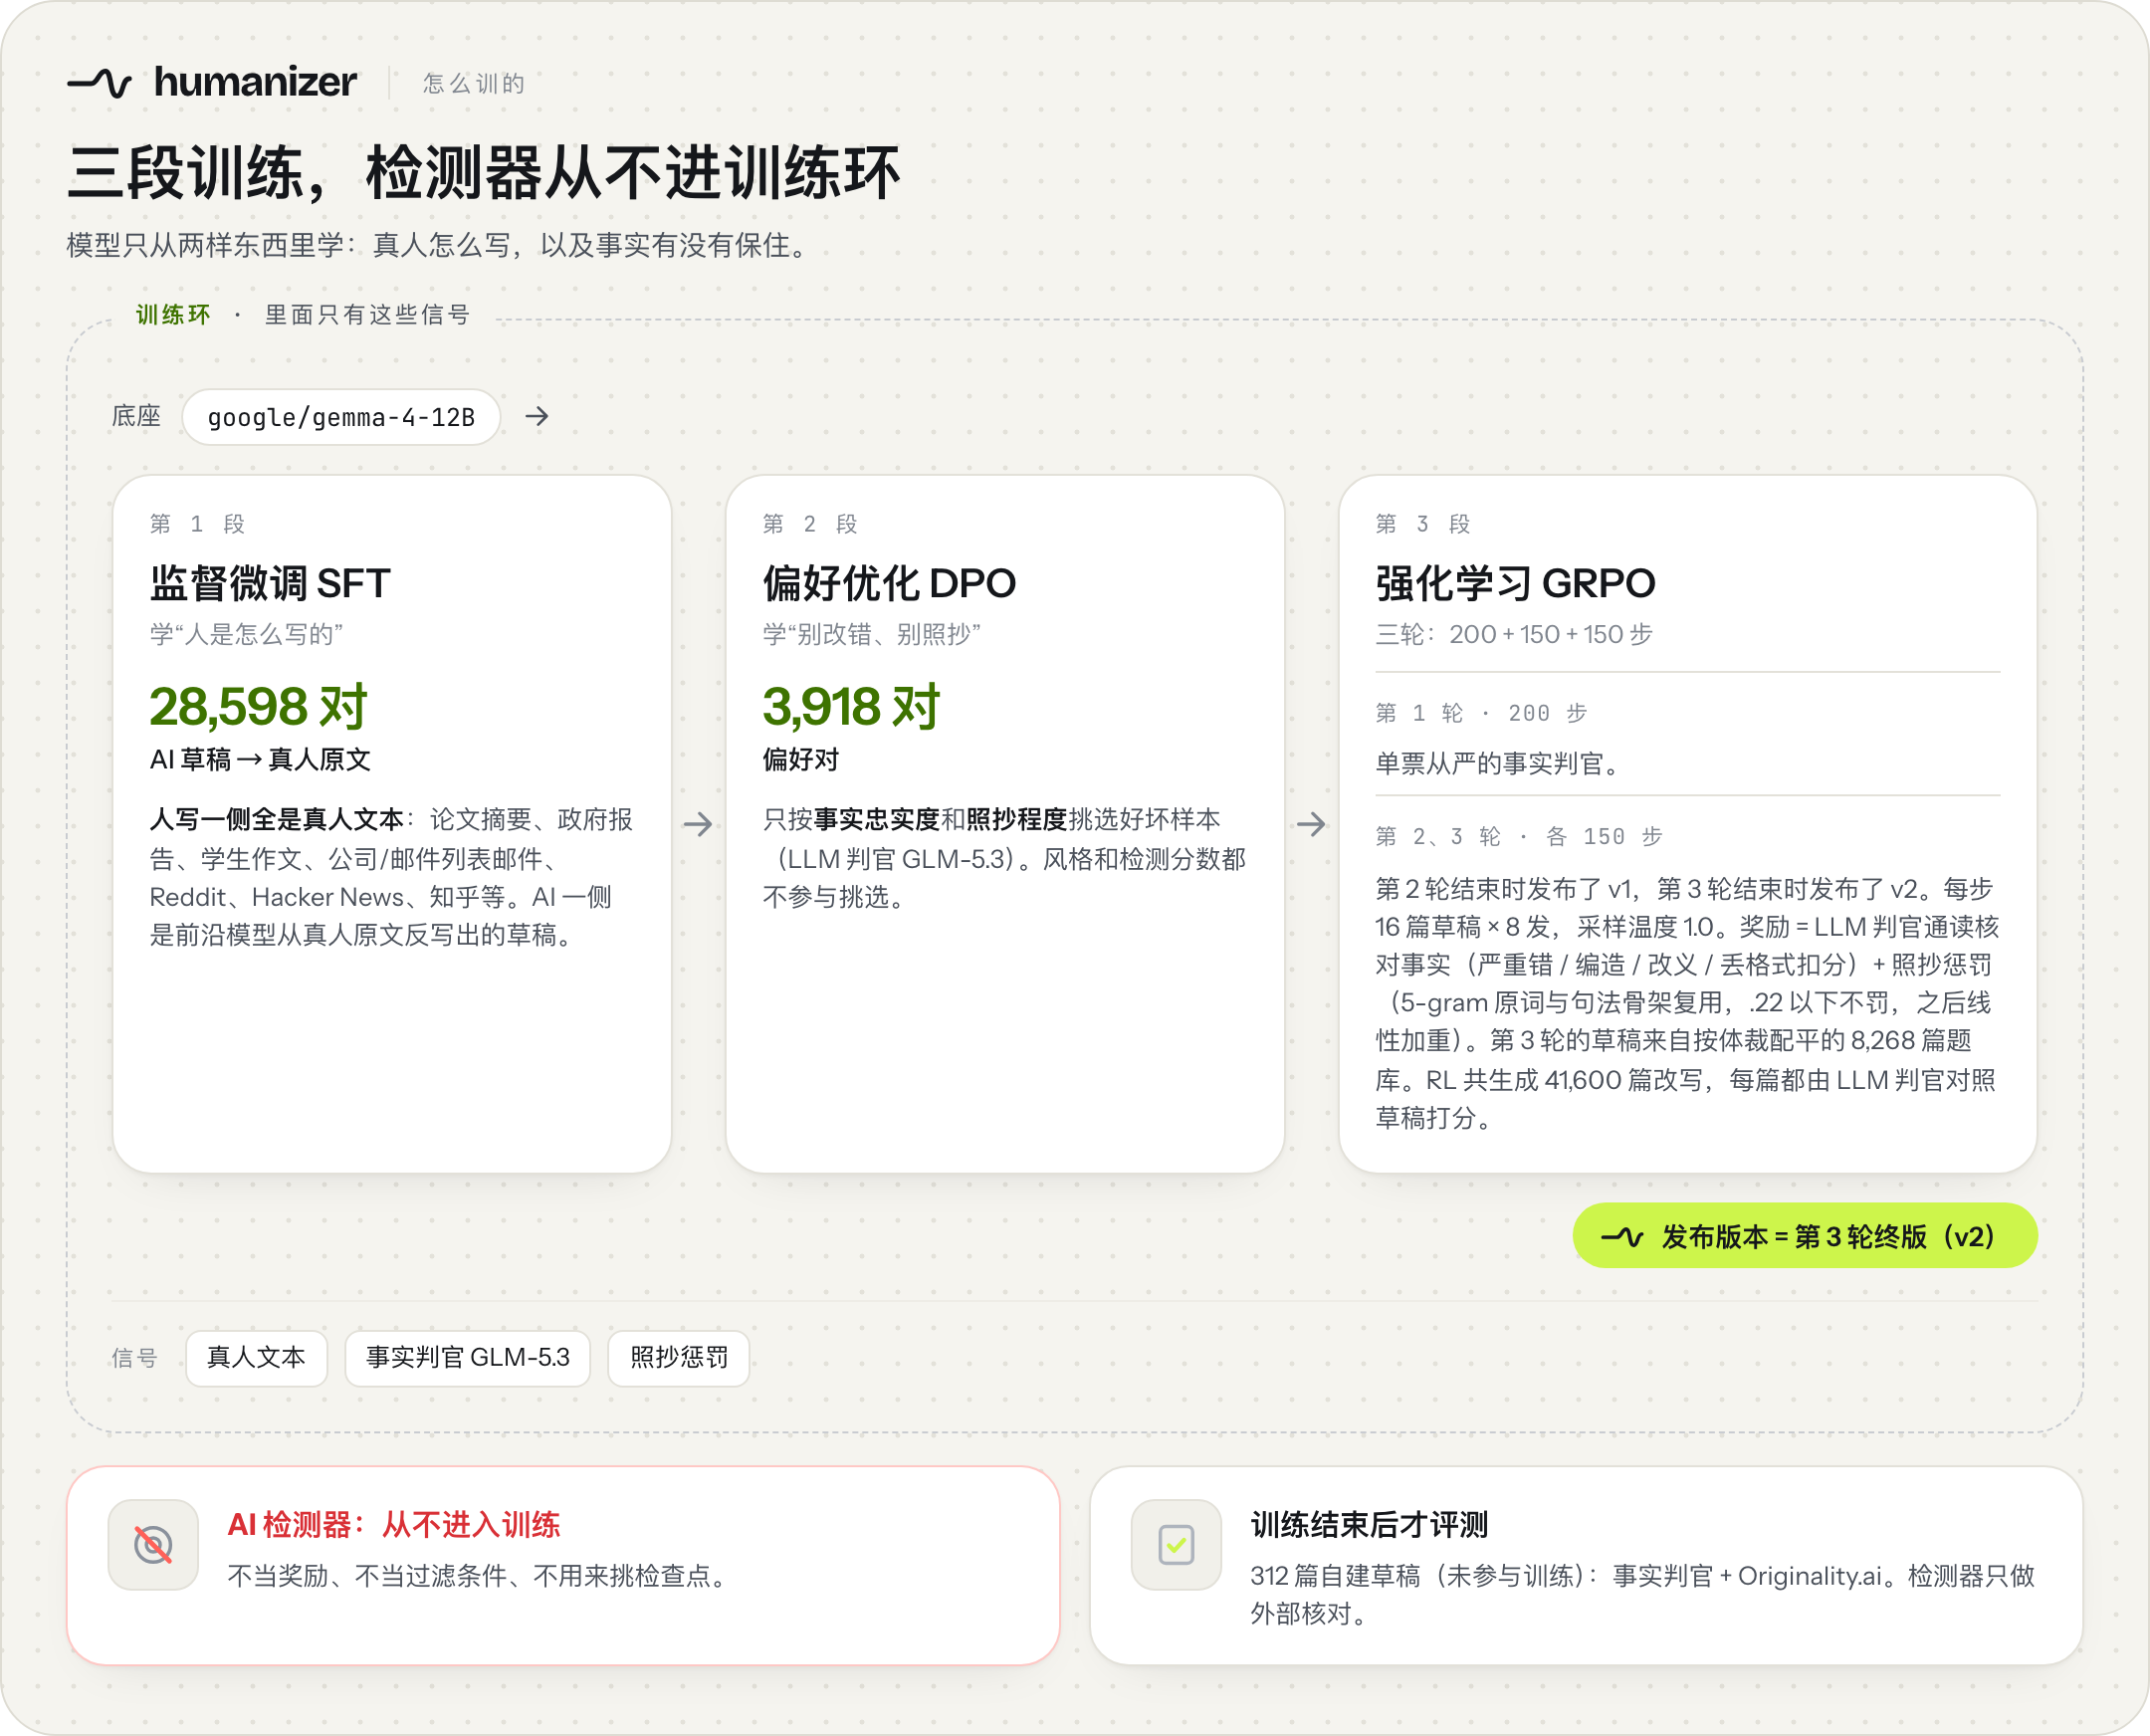 **训练全程没有用任何 AI 检测器**:不当奖励,不当过滤条件,也不用来挑检查点。模型只从两样东西里学:真人怎么写,以及事实有没有保住。本页的检测器数字只是外部核对。
1. **监督微调(SFT),28,598 对**“AI 草稿 → 真人原文”。人写一侧全是真人文本:论文摘要、政府报告、学生作文、公司和邮件列表邮件、Reddit、Hacker News、知乎等;AI 一侧是前沿模型照着真人原文反写出来的草稿。
2. **DPO,3,918 对偏好对**,只按事实忠实度和照抄程度挑选(LLM 判官 GLM-5.3)。
3. **强化学习(GRPO)分三轮,共 500 步**。第 1 轮 200 步,用单票从严的事实判官;第 2、3 轮各 150 步(第 2 轮结束时发布了 v1,第 3 轮结束时发布了 v2):每步 16 篇草稿 × 8 发,采样温度 1.0。奖励 = LLM 判官把改写和草稿对照通读、核对事实(严重错、编造、改了意思、丢格式都扣分),再加照抄惩罚(逐字 5-gram 与句法骨架复用,.22 以下不罚,之后线性加重)。第 3 轮的草稿来自一个按体裁配平的题库,共 8,268 篇。RL 全程共生成 41,600 篇改写,每一篇都由 LLM 判官对照草稿打分。
4. **本版(v2)就是第 3 轮的最后一个检查点。**
**训练数据:**训过 v2 的每一条都列在 **[jialinyyzz/humanizer-data](https://huggingface.co/datasets/jialinyyzz/humanizer-data)** 里,每个训练步骤一个 config(SFT、DPO、RL)。开放许可的文本带全文;协议不允许转发的来源只给 ID,附重建脚本。怎么构建的见 [docs/DATA.zh.md](docs/DATA.zh.md)。训练代码之后会公开。
## 用法
**完整文档见 [docs/USAGE.zh.md](docs/USAGE.zh.md)**([Hugging Face](https://huggingface.co/jialinyyzz/humanizer/blob/main/USAGE.zh.md) 上也有):每种运行方式的逐步说明、批处理脚本、长文、中文、排错。下面是要点。
### Hugging Face 上的文件
| 文件 | 大小 | Mac 峰值内存 ¹ | 与 bf16 首选词一致 ² | 事实检查:英文改写标出篇数 ³ | 同 60 篇被判 AI ⁴ | 适合 |
|---|---|---|---|---|---|---|
| `humanizer-12b-Q8_0.gguf` | 12.7 GB | 13.7 GB | 98.4% | 44 / 420 | 7 / 60 | 32 GB 及以上内存。**推荐**,质量最好。 |
| `humanizer-12b-Q6_K.gguf` | 10.0 GB | 约 11.0 GB | 97.7% | 56 / 420 | 未测 | 16 GB 内存。测不出损失。 |
| `humanizer-12b-Q4_K_M.gguf` | 7.6 GB | 10.0 GB | 95.2% | 58 / 420 | 未测 | 14 GB 左右内存,或硬盘紧张时。略有损失;做过量化感知训练。 |
| `humanizer-12b-Q3-QAT.gguf` | 5.6 GB | 8.0 GB | 93.1% | 64 / 420 | 4 / 60 | 12 GB 内存。小幅损失;英文事实小错略多。 |
| `humanizer-12b-IQ2_XS-QAT.gguf` | 3.9 GB | 6.2 GB | 87.4% | 70 / 420 | **0 / 60** | 8 GB 内存;最小(2-bit)。AI 检测表现最好,事实小错多一些:发出前核对数字和名字。 |
| `humanizer-12b-bf16.gguf` | 23.8 GB | 约 24.8 GB | 100%(基准) | 52 / 420 | 4 / 60 | 未量化权重的单文件 GGUF,作参考或自己量化用。 |
| `model.safetensors` 及 `config.json`、`generation_config.json`、`tokenizer.json`、`tokenizer_config.json` | 约 24 GB(bf16) | | | | | transformers、vLLM、转 MLX。 |
| `prompt_format.json` | 很小 | | | | | 指令和分隔符原文。 |
¹ `llama-server`(Metal)在 M5 Max 上、用 App 的设置改写时的最大内存;Q6_K 和 bf16 是估算。要给系统留出空间(App 会留约 4 GB)。
² 量化文件认为最可能的下一个词和 bf16 相同的比例,中英文取平均(llama.cpp `--kl-divergence`)。
³ [评测细节](#事实忠实度)里那个从严的事实判官(GLM-5.3,每篇一票),每个文件判全部 420 篇英文改写。每个文件列出的问题都有约 9 成只是一个词、一个数字或一个短语。Q8_0、Q6_K、Q4_K_M 和 bf16 的差别在噪声范围内;Q3 和 2-bit 小错稍多。中文结果见 [docs/QUANTIZATION.zh.md](docs/QUANTIZATION.zh.md)。
⁴ Originality.ai 最严档,每个文件都用同一批 60 篇英文草稿。检测器会更新,这只是某一天的一次测量。
### 量化版本
所有 GGUF 文件另有一个专门的仓库:**[jialinyyzz/humanizer-GGUF](https://huggingface.co/jialinyyzz/humanizer-GGUF)**;`jialinyyzz/humanizer` 里的文件照旧保留,这里的下载命令不受影响。和普通 llama.cpp 量化的对比见[开头的图](#量化文件更小离完整模型更近)。每个文件与 bf16 的 KL、事实检查和 AI 检测结果、完整对比表以及每个文件是怎么做的,见 **[docs/QUANTIZATION.zh.md](docs/QUANTIZATION.zh.md)**。sha256 校验值见 [USAGE.zh.md](docs/USAGE.zh.md)。
### 提示词格式
**这是文本续写模型,不是聊天模型**。没有系统提示词,没有轮次标记。把下面这段原样发过去,让模型往下写:
```
Rewrite the text below so it reads like a person wrote it, not a language model.
Reorganize it as you see fit. Vary sentence length on purpose. Cut hedging,
throat-clearing, and any sentence that only announces what comes next.
Prefer the concrete word over the abstract one. It is fine to sound uneven.
Every fact, number, unit, date, name and quotation must survive unchanged.
<你的草稿,去掉首尾空白>
### Rewritten:
```
写成代码:`prompt = INSTR + "\n\n" + draft.strip() + "\n\n### Rewritten:\n\n"`。`INSTR` 就是上面第一段(到 “unchanged.” 为止,结尾不带换行)。`prompt_format.json`(字段 `instr`、`sep`)和 [`humanizer/promptfmt.py`](humanizer/promptfmt.py) 里也有同样的内容。
- **逐字照抄**。模型就是在这个格式上训的,指令改写过或少一个空行,效果都会变差。自检:`sha256(build_prompt("X"))` 的前 16 位十六进制必须是 `cc51d66b4c593fbe`。
- **只靠 EOS 停**。不要把 `"###"` 设成停止符,极少数输出里本来就有它,会被截断。
- **采样**:temperature 1.0、top-p 0.95,别的都关掉(top-k 关、min-p 关、重复惩罚 1.0)。llama-server 默认开着 top-k 40 和 min-p 0.05,要像上面的例子那样显式关掉。
- 输出长度留草稿 token 数的 2.5 倍左右(App 的范围是 256 到 2048 token)。
- **内置默认值**:2026-10-04 起,每个 GGUF 文件的元数据里也写好了这组采样设置,请求里没设采样参数时,llama.cpp 和基于它的软件就会用它们。
- **聊天软件**:2026-10-04 起,GGUF 文件里自带一个对话模板,把最后一条用户消息拼成上面这段提示词(系统提示词和之前的对话都不用)。所以 llama-server 的 `/v1/chat/completions`(带 `--jinja`,新版默认就开)能用,一条消息一篇草稿:同一个 seed 下,它和续写接口给出的是同一篇改写。用文件自带模板的聊天软件(比如 LM Studio 的聊天页面)应该也一样(我们没测过)。更早下载的文件没有这个模板,safetensors 权重也没有。
### llama.cpp
装好 llama.cpp([Releases](https://github.com/ggml-org/llama.cpp/releases)、`brew install llama.cpp` 或 `winget install llama.cpp`),按[快速开始](#方式二一行命令llamacpp)起 `llama-server`(`-np 1` 让一个请求独占 8192 token 的上下文),然后用任何语言调用。Python 只用标准库:
```python
import json, urllib.request
pf = json.load(open("prompt_format.json"))
draft = open("draft.txt", encoding="utf-8").read()
body = {"prompt": pf["instr"] + "\n\n" + draft.strip() + pf["sep"],
"temperature": 1.0, "top_p": 0.95, "top_k": 0, "min_p": 0, "repeat_penalty": 1.0,
"n_predict": 2048}
req = urllib.request.Request("http://127.0.0.1:8080/completion", json.dumps(body).encode(),
{"Content-Type": "application/json"})
print(json.load(urllib.request.urlopen(req))["content"].strip())
```
App 自带的是 llama.cpp `b11335`。
### MLX(Apple 芯片)
```bash
pip install mlx-lm # 我们用的是 mlx-lm 0.32.0
mlx_lm.convert --hf-path jialinyyzz/humanizer --mlx-path humanizer-mlx-8bit -q --q-bits 8 --q-group-size 64
```
```python
import json
from huggingface_hub import hf_hub_download
from mlx_lm import load, generate
from mlx_lm.sample_utils import make_sampler
pf = json.load(open(hf_hub_download("jialinyyzz/humanizer", "prompt_format.json")))
model, tok = load("humanizer-mlx-8bit")
draft = open("draft.txt", encoding="utf-8").read()
print(generate(model, tok, prompt=pf["instr"] + "\n\n" + draft.strip() + pf["sep"],
max_tokens=2048, sampler=make_sampler(temp=1.0, top_p=0.95)))
```
### transformers(CUDA)
```python
import json, torch
from huggingface_hub import hf_hub_download
from transformers import AutoModelForCausalLM, AutoTokenizer
repo = "jialinyyzz/humanizer"
pf = json.load(open(hf_hub_download(repo, "prompt_format.json")))
tok = AutoTokenizer.from_pretrained(repo)
model = AutoModelForCausalLM.from_pretrained(repo, dtype=torch.bfloat16, device_map="auto")
draft = open("draft.txt", encoding="utf-8").read()
ids = tok(pf["instr"] + "\n\n" + draft.strip() + pf["sep"], return_tensors="pt").to(model.device)
out = model.generate(**ids, do_sample=True, temperature=1.0, top_p=0.95, top_k=0, max_new_tokens=2048)
print(tok.decode(out[0, ids["input_ids"].shape[1]:], skip_special_tokens=True).strip())
```
权重是用 transformers 5.14.1 存的。请保留 `top_k=0`:它关掉了随权重附带的 `generation_config.json` 里默认的 top-k 64,和 App 一致(App 不用 top-k)。
### vLLM、Ollama 和 LM Studio
**vLLM**:见 [docs/USAGE.zh.md#6-vllm](docs/USAGE.zh.md#6-vllm)。`SamplingParams` 里传 `top_k=-1`(关闭);用 `vllm serve` 时加 `--generation-config vllm`,免得把 `generation_config.json` 里的 top-k 64 当成默认值。
Ollama 和 LM Studio 我们自己都没测过,完整步骤见 [docs/USAGE.zh.md](docs/USAGE.zh.md#7-ollama)。
**Ollama** 不用 GGUF 里存的对话模板,会给你的文本套上它自己的 Gemma 模板,这会把这个模型搞坏。请用下面这个 `Modelfile` 建模型:它的模板把最后一条用户消息当作草稿,拼出上面的提示词(我们用 Go 的 `text/template` 渲染过,逐字相同,但没有在 Ollama 里实际跑过)。之后可以 `ollama run humanizer` 或调 `/api/chat`,一条消息一篇草稿;也可以调 `/api/generate`,带上 `"raw": true` 和完整提示词。
```
FROM ./humanizer-12b-Q8_0.gguf
TEMPLATE """{{- $draft := "" }}{{- range .Messages }}{{- if eq .Role "user" }}{{- $draft = .Content }}{{- end }}{{- end }}Rewrite the text below so it reads like a person wrote it, not a language model.
Reorganize it as you see fit. Vary sentence length on purpose. Cut hedging,
throat-clearing, and any sentence that only announces what comes next.
Prefer the concrete word over the abstract one. It is fine to sound uneven.
Every fact, number, unit, date, name and quotation must survive unchanged.
{{ $draft }}
### Rewritten:{{ "\n\n" }}"""
PARAMETER temperature 1.0
PARAMETER top_p 0.95
PARAMETER top_k 0
PARAMETER min_p 0
PARAMETER repeat_penalty 1.0
PARAMETER num_ctx 8192
PARAMETER num_predict 2048
```
```bash
ollama create humanizer -f Modelfile
```
**LM Studio**:2026-10-04 及之后下载的 GGUF 应该可以直接用聊天页面:系统提示词留空,一条消息一篇草稿,采样照上面设。不管哪天下载的文件,都可以开本地服务,把完整提示词发到文本续写接口 `/v1/completions`。
### 速度
在 M5 Max 上实测:
| 运行方式 | 速度 | 例子 |
|---|---|---|
| llama.cpp Q8_0,Metal(App 用的就是这个) | 约 36–38 token/s | 百来词的英文邮件约 3.6 秒;300 字左右的中文邮件约 8.5 秒 |
| MLX 8 bit | 英文约 30 token/s,中文约 38 token/s | 百来词的邮件约 9 秒 |
### 社区贡献:Apple Silicon 上更快的解码
[jayyun98](https://huggingface.co/jayyun98) 为 humanizer 训练了一个投机解码草稿模型:[Humanizer-12B-Draftfit-DSpark](https://huggingface.co/jayyun98/Humanizer-12B-Draftfit-DSpark)。按作者在 M5 Pro + MLX 上的测试,速度约为原来的 1.5 倍(34.5 对 22.8 token/s),输出和单独跑 humanizer 逐 token 一致。它需要和主模型一起运行,安装方法见其模型页。这是社区项目,我们还没有自己测过。
## 局限
- **细节还可能出错**。英文 420 篇改写里,从严的 LLM 判官在 376 篇里没挑出事实问题;有问题的,9 成以上改一个词或短语就好,比如“37 complaints”(37 条投诉)变成了“37% of complaints”(37% 的投诉)。发出去之前还是请读一遍,重点看数字、日期和人名。
- **中文还在追赶英文**:中文 204 篇改写里 149 篇判官没挑出事实问题;有问题的,约 9 成改一个词或短语就好。
- **模板化体裁仍然最难过检测器**:带 emoji、井号或编号连载的社交帖(3/16 被判 AI),正式政策备忘(2/13)。
- **格式不一定保得住**。420 发里有 28 发丢了格式要素;分段、列表和标题标记有时会变。
- **偶尔会换语言**。夹着技术术语的英文口语短稿,模型偶尔会把整篇写成中文。App(0.3.1 及以后)和 `hz` 会自动检测语言并重新生成(中文草稿写成英文也会被拦下)。自己用 llama.cpp 等直接调用的话:英文草稿的输出里出现大段中文,就用同样的参数再采一次。
- **随意体裁里语气会跑**。Reddit 一类的帖子里,它有时会加上原文没有的俚语或粗口。
- **检测器会变**。上面的检测数字是某一天的一次测量,不保证在任何检测器上的结果。
- **App**:改写照抄太多时不会自动重采,请点“重新生成”。App 还没有代码签名;Windows 版还没在真机上跑过(只有 CI 冒烟测试)。
- 这是给你改自己草稿的写作工具。学校、单位或出版方对 AI 辅助有规定的,请按规定来。
## 协议
代码和权重:[Apache License 2.0](LICENSE)。
humanizer 由 [google/gemma-4-12B](https://huggingface.co/google/gemma-4-12B) 微调而来,Google 以 Apache 2.0 发布该底座。本项目与 Google 无隶属或背书关系。训练数据不随项目分发。
本仓库原名 `sgaofen/humanizer`;模型仓库原名 `jialinyyzz/humanizer-gemma-4-e4b`(更早的一个小模型,已不再提供,文件留在 Hugging Face 的提交历史里)。第一个 12B 版(v1,2026-10-01)也在提交历史里;现在的模型是 v2(2026-10-02)。
链接:[Hugging Face](https://huggingface.co/jialinyyzz/humanizer) · [App 下载](https://github.com/sgaofen/humanizer-local-model/releases/latest) · [安装指南](docs/INSTALL.zh.md) · [AGENTS.md](AGENTS.md) · [llms.txt](llms.txt)