中文 | English | 日本語
# Step-Audio
## 🔥🔥🔥 ニュース!!
* 2025年6月10日: 👋 技術レポート [Step-Audio-AQAA](https://arxiv.org/abs/2506.08967) をリリースしました。
* 2025年2月17日: 👋 推論コードとモデルの重みをリリースしました。[Step-Audio-Chat](https://huggingface.co/stepfun-ai/Step-Audio-Chat), [Step-Audio-TTS-3B](https://huggingface.co/stepfun-ai/Step-Audio-TTS-3B) および [Step-Audio-Tokenizer](https://huggingface.co/stepfun-ai/Step-Audio-Tokenizer)。
* 2025年2月17日: 👋 マルチターンオーディオベンチマーク [StepEval-Audio-360](https://huggingface.co/datasets/stepfun-ai/StepEval-Audio-360) をリリースしました。
* 2025年2月17日: 👋 技術レポート [Step-Audio-Report](https://arxiv.org/abs/2502.11946) をリリースしました。
## 目次
1. [紹介](#1-紹介)
2. [モデル概要](#2-モデル概要)
3. [モデルのダウンロード](#3-モデルのダウンロード)
4. [モデルの使用方法](#4-モデルの使用方法)
5. [ベンチマーク](#5-ベンチマーク)
6. [オンラインエンジン](#6-オンラインエンジン)
7. [引用](#7-引用)
## 1. 紹介
Step-Audioは、音声理解と生成を統合した業界初の製品レベルのオープンソースリアルタイム音声対話システムであり、多言語対話(例:日本語、英語、中国語)、音声感情(例:喜び、悲しみ)、方言(例:関西弁、広東語)、音声速度および韻律スタイルの調整をサポートします。Step-Audioは、以下の4つの主要な技術革新を示しています:
- **1300億パラメータのマルチモーダルモデル**:単一の統合モデルで、音声認識、意味理解、対話、音声クローン、音声生成を実行します。1300億パラメータのStep-Audio-Chatバリアントをオープンソース化しました。
- **生成データエンジン**:従来のTTSが手動データ収集に依存することを排除し、1300億パラメータのマルチモーダルモデルを使用して高品質の音声を生成します。このデータを活用して、リソース効率の高いStep-Audio-TTS-3Bモデルをトレーニングし、制御可能な音声合成のための指示フォロー機能を強化しました。
- **細かい音声制御**:指示ベースの制御設計を通じて、複数の感情(怒り、喜び、悲しみ)、方言(関西弁、広東語など)、および音声スタイル(ラップ、アカペラハミング)をサポートし、多様な音声生成ニーズに対応します。
- **強化されたインテリジェンス**:ToolCallメカニズムの統合とロールプレイングの強化を通じて、エージェントの複雑なタスクにおけるパフォーマンスを向上させます。
## 2. モデル概要
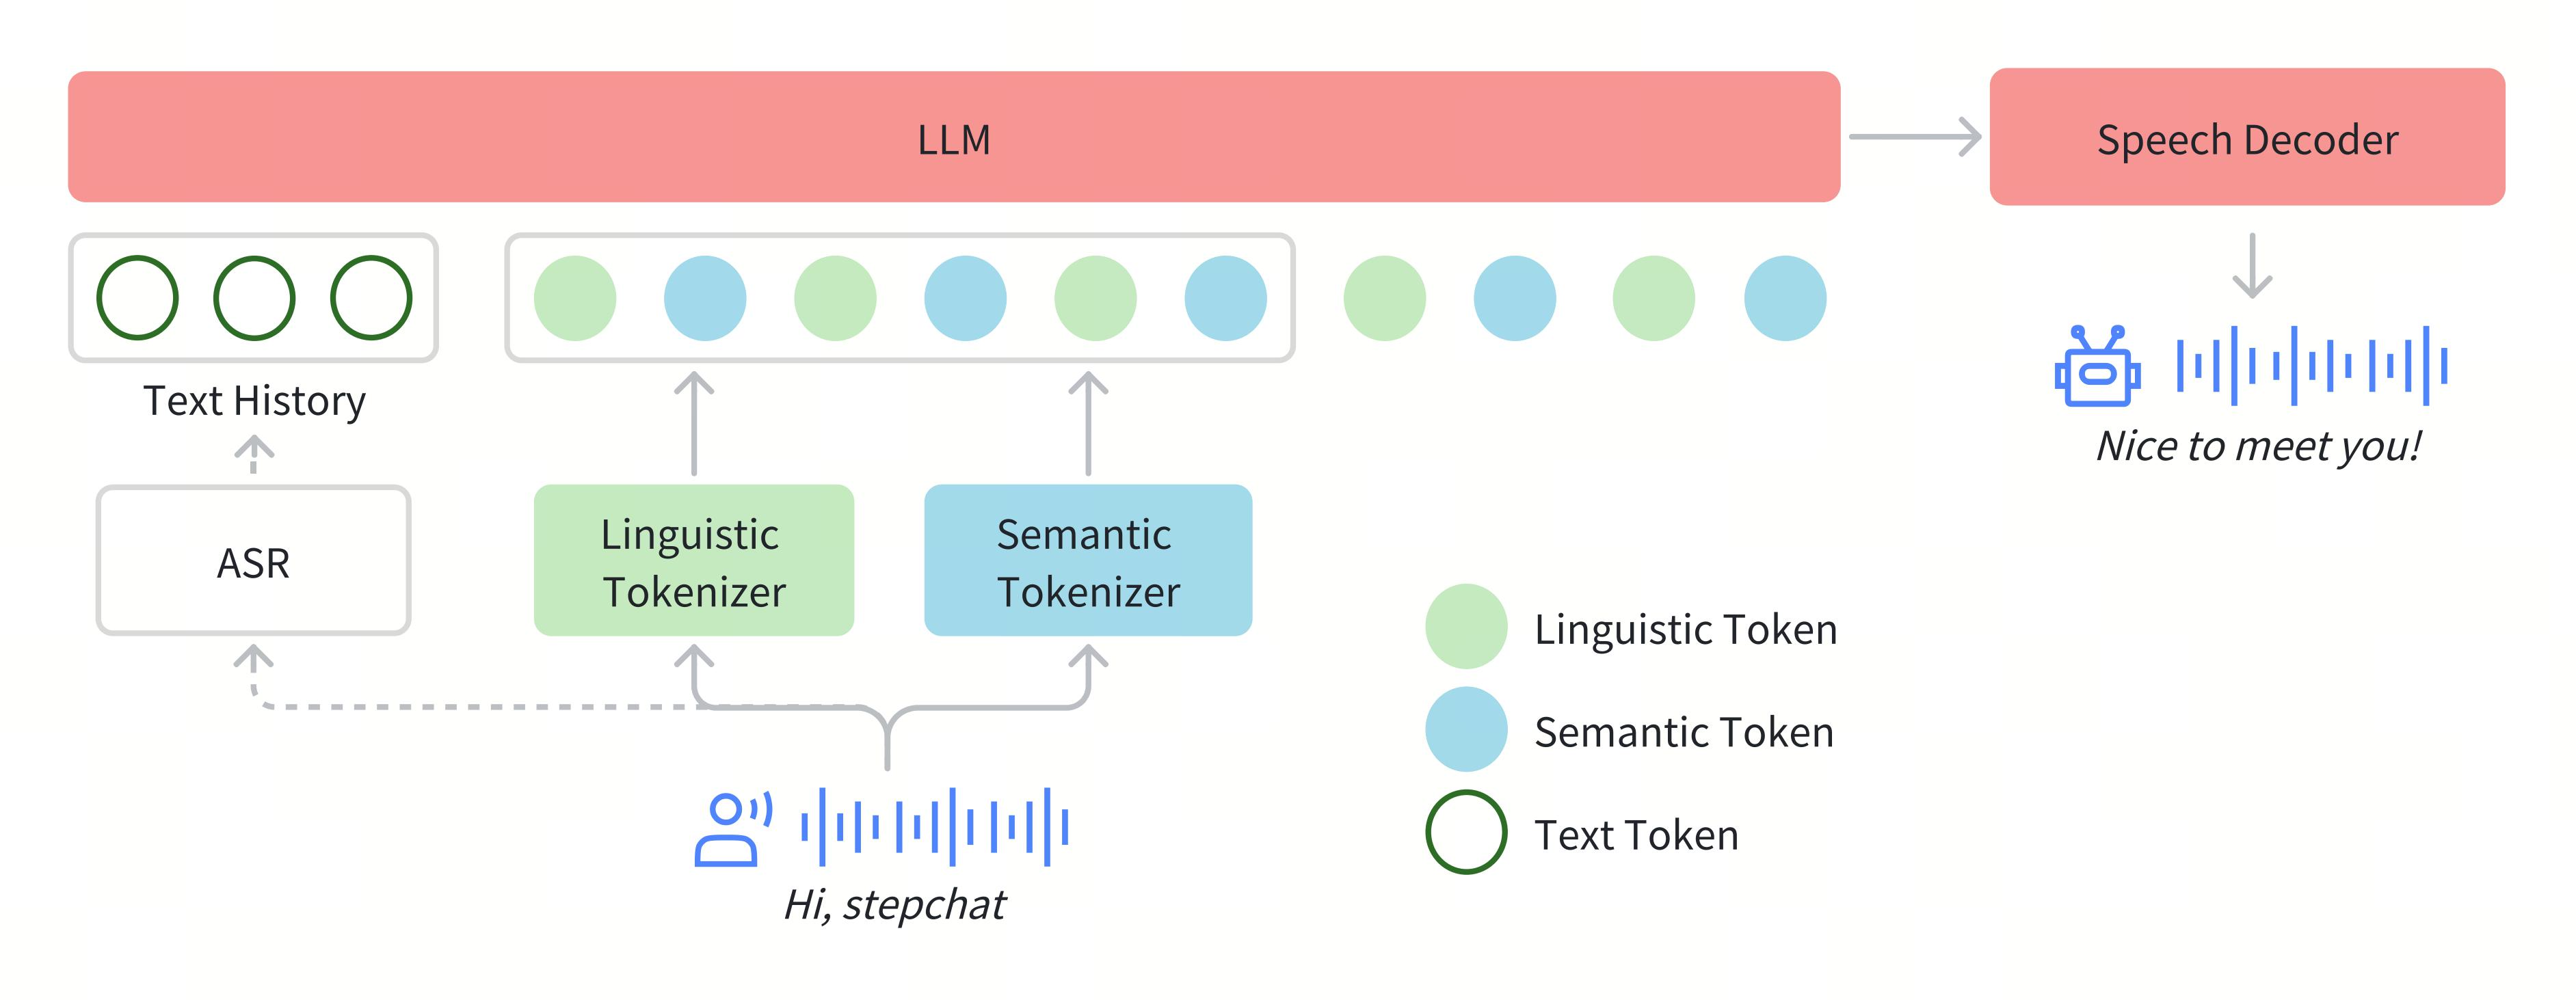
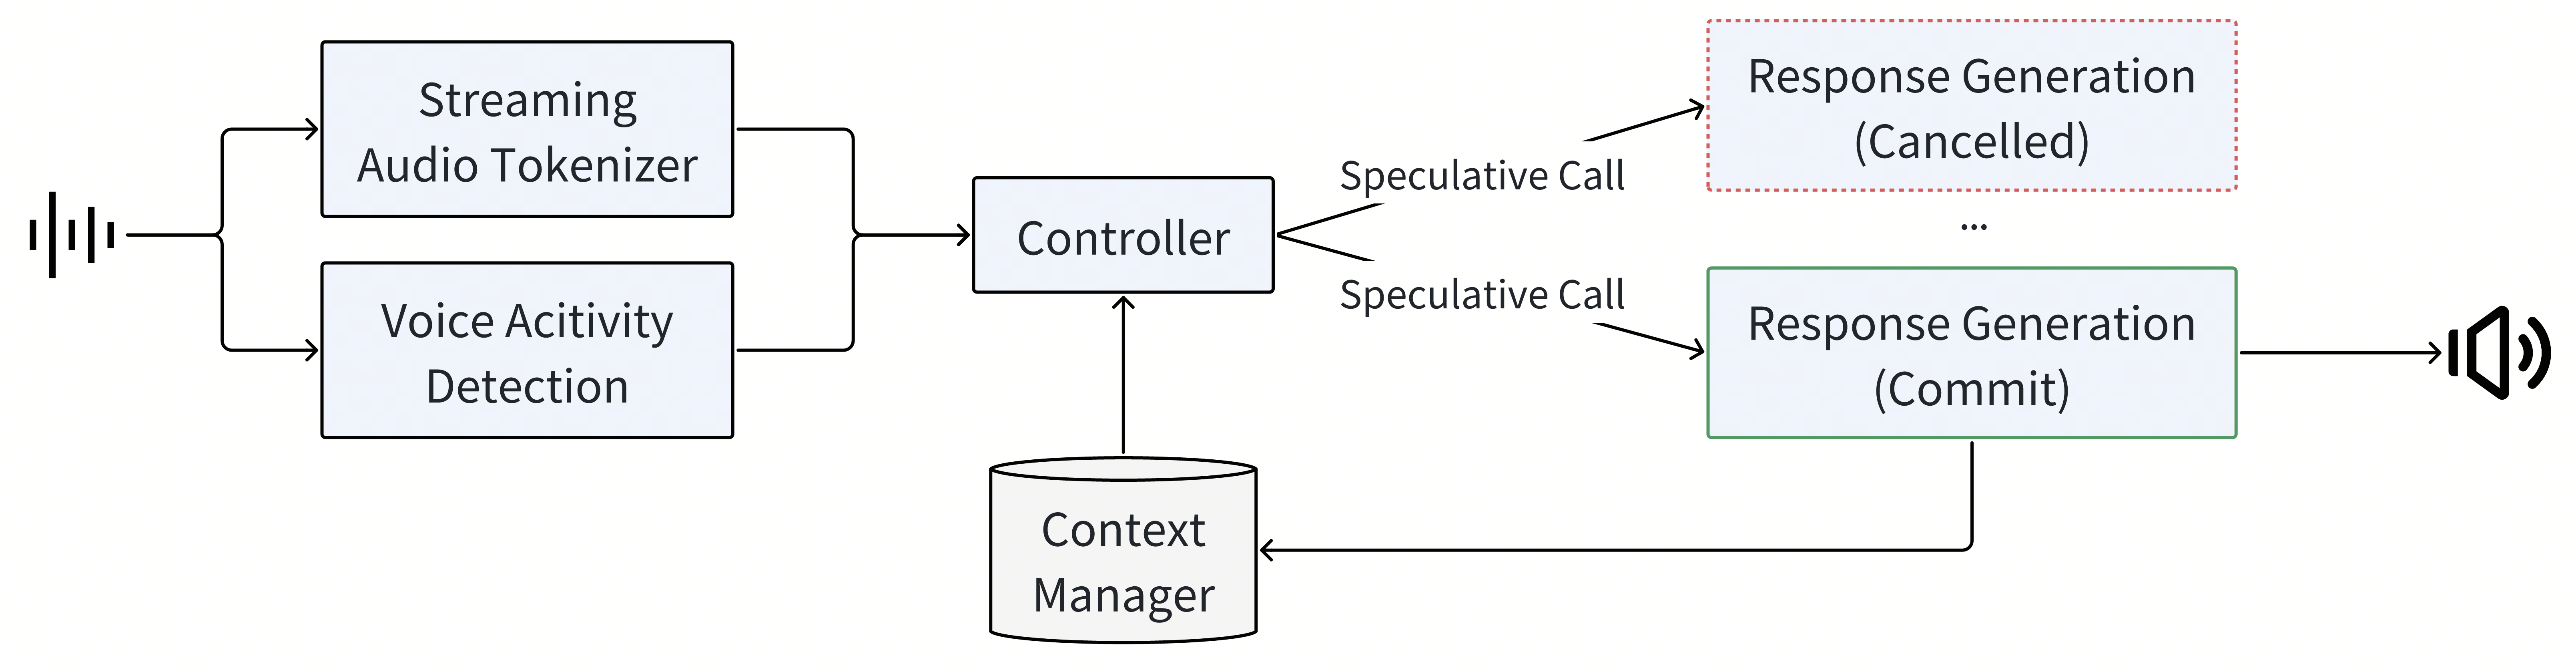
Step-Audioでは、音声ストリームをトークン化するために、並列のセマンティック(16.7Hz、1024エントリのコードブック)および音響(25Hz、4096エントリのコードブック)トークナイザーを組み合わせたデュアルコードブックフレームワークを使用し、2:3の時間的インターリーブを行います。1300億パラメータのLLM基盤(Step-1)は、音声コンテキスト化継続的事前トレーニングおよびタスク固有の後トレーニングを通じて強化され、強力なクロスモーダル音声理解を実現します。フローマッチングとニューラルボコーダを組み合わせたハイブリッド音声デコーダを使用し、リアルタイムの波形生成を最適化します。推論パイプラインは、投機的応答生成(40%のコミット率)およびテキストベースのコンテキスト管理(14:1の圧縮率)を特徴とするストリーミング対応アーキテクチャを備えています。
### 2.1 トークナイザー
セマンティックトークナイザーと音響トークナイザーを効果的に統合するために、トークンレベルのインターリーブアプローチを実装しています。セマンティックトークナイザーは1024のコードブックサイズを使用し、音響トークナイザーはより大きな4096のコードブックサイズを使用して、より細かい音響の詳細をキャプチャします。異なるトークンレートを考慮して、2つのセマンティックトークンごとに3つの音響トークンをペアリングする2:3の時間的アライメント比を確立します。
### 2.2 言語モデル
Step-Audioの音声情報を効果的に処理し、正確な音声-テキストアライメントを実現するために、1300億パラメータの事前トレーニングされたテキストベースの大規模言語モデル(LLM)であるStep-1に基づいて、音声継続的事前トレーニングを実施しました。
### 2.3 音声デコーダ
Step-Audioの音声デコーダは、セマンティックおよび音響情報を含む離散音声トークンを、自然な音声を表す連続的な時間領域の波形に変換する重要な機能を果たします。デコーダアーキテクチャには、フローマッチングモデルとメルから波形へのボコーダが組み込まれています。生成された音声の明瞭度と自然さを最適化するために、音声デコーダはデュアルコードインターリーブアプローチを使用してトレーニングされ、生成プロセス全体でセマンティックおよび音響機能のシームレスな統合を確保します。
### 2.4 リアルタイム推論パイプライン
リアルタイムの対話を可能にするために、最適化された推論パイプラインを設計しました。その中心には、状態遷移を管理し、投機的応答生成を調整し、重要なサブシステム間のシームレスな調整を確保するコントローラーモジュールがあります。これらのサブシステムには、ユーザーの音声を検出する音声活動検出(VAD)、リアルタイムで音声を処理するストリーミングオーディオトークナイザー、応答を処理および生成するStep-Audio言語モデルおよび音声デコーダ、および会話の連続性を維持するコンテキストマネージャが含まれます。
### 2.5 後トレーニングの詳細
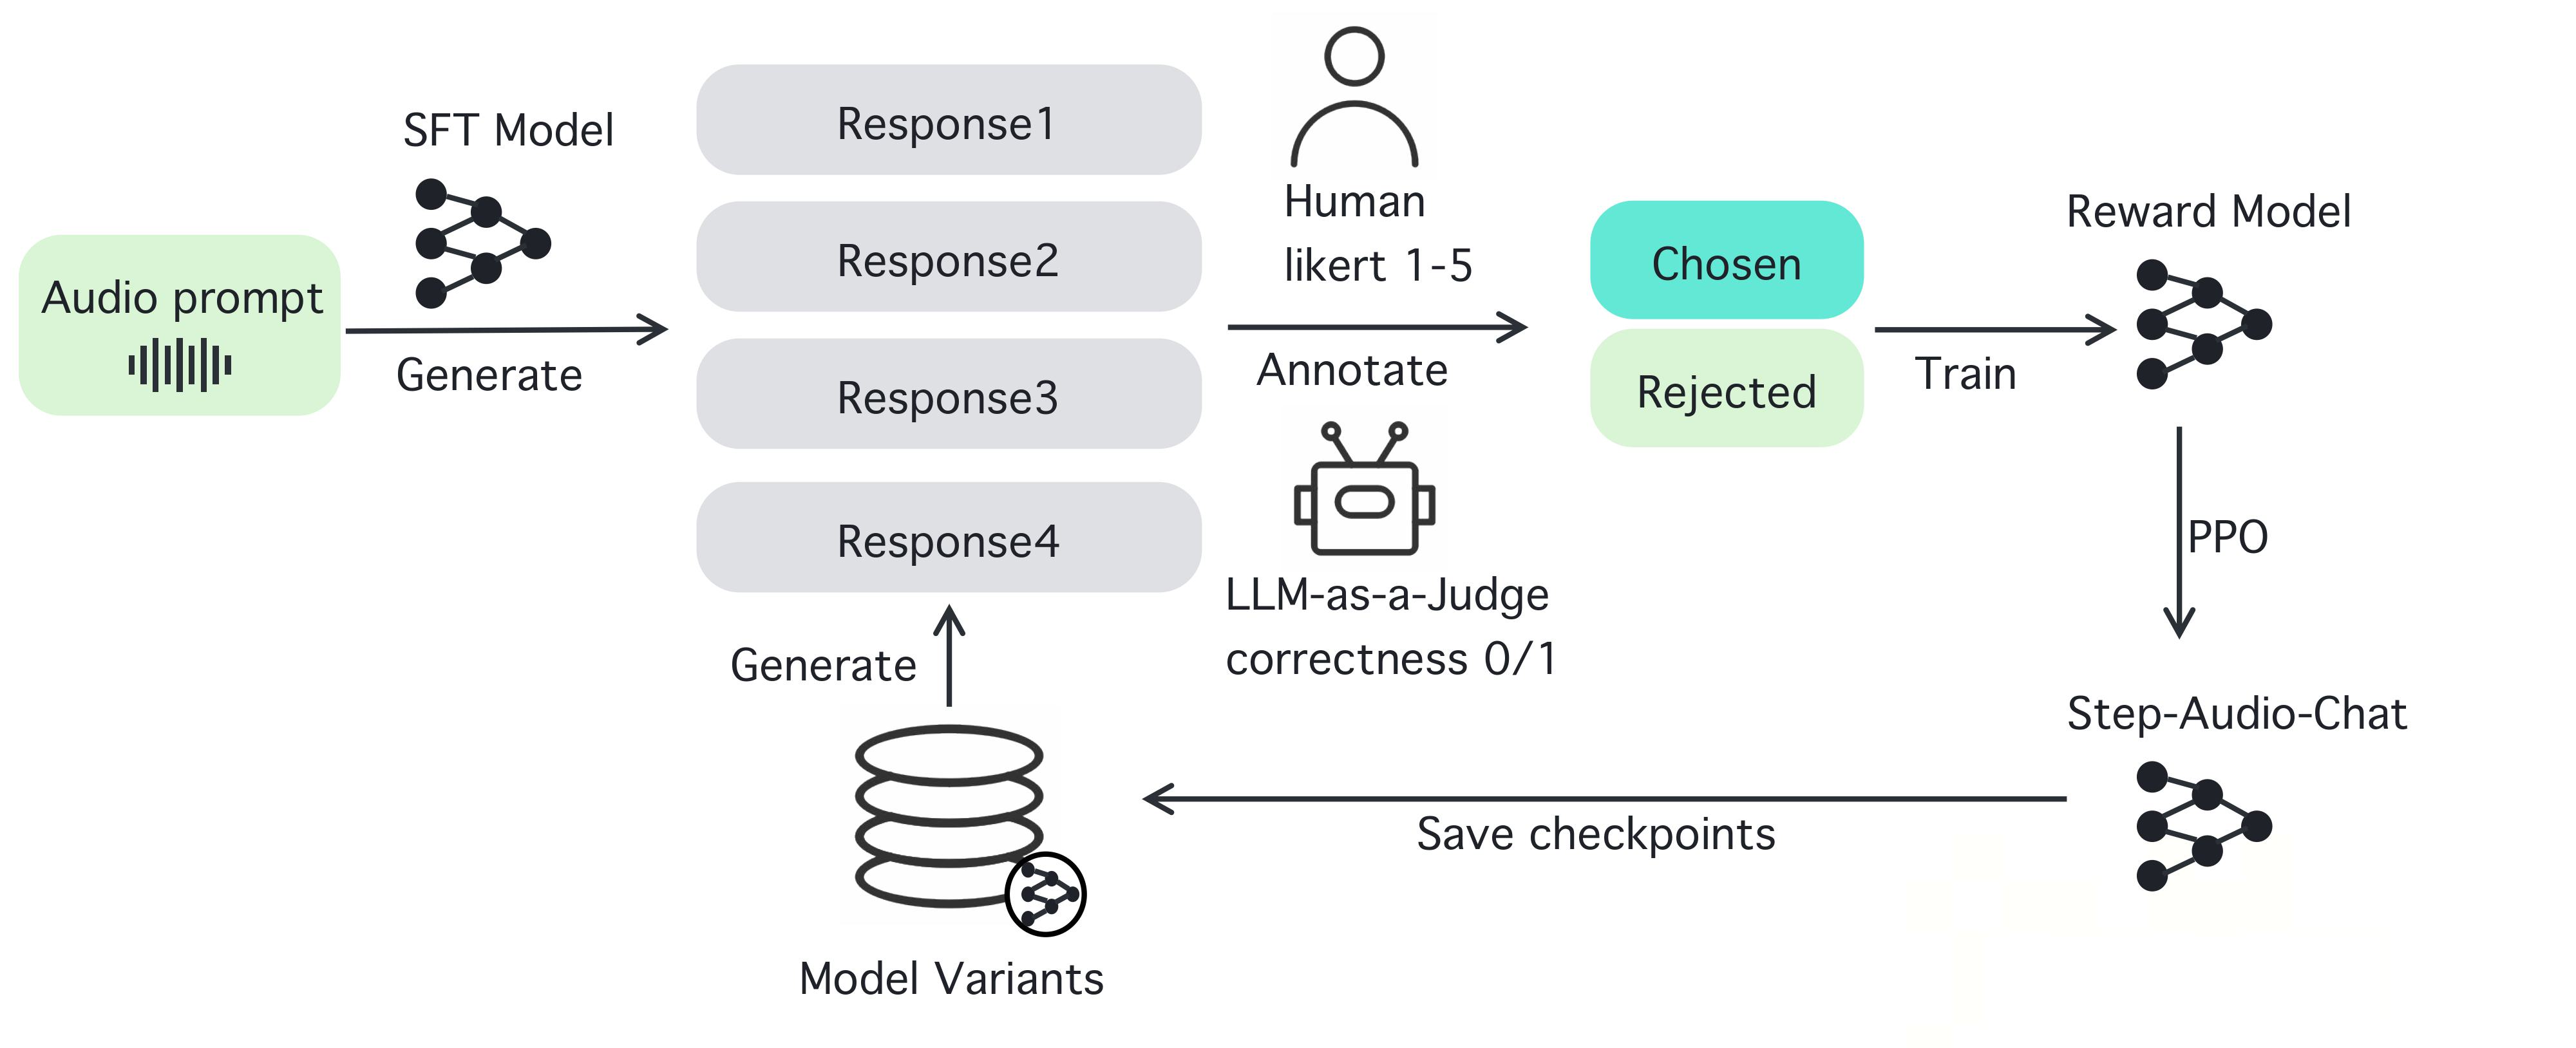
後トレーニングフェーズでは、自動音声認識(ASR)およびテキストから音声への変換(TTS)のタスク固有の監督付き微調整(SFT)を実施しました。音声入力テキスト出力(AQTA)タスクについては、多様な高品質データセットを使用してSFTを実施し、人間のフィードバックからの強化学習(RLHF)を組み合わせて応答品質を向上させ、感情表現、音声速度、方言、および韻律の細かい制御を可能にしました。
## 3. モデルのダウンロード
### 3.1 Huggingface
| モデル | リンク |
|-------|-------|
| Step-Audio-Tokenizer | [🤗huggingface](https://huggingface.co/stepfun-ai/Step-Audio-Tokenizer) |
| Step-Audio-Chat | [🤗huggingface](https://huggingface.co/stepfun-ai/Step-Audio-Chat) |
| Step-Audio-TTS-3B | [🤗huggingface](https://huggingface.co/stepfun-ai/Step-Audio-TTS-3B) |
### 3.2 Modelscope
| モデル | リンク |
|-------|-------|
| Step-Audio-Tokenizer | [modelscope](https://modelscope.cn/models/stepfun-ai/Step-Audio-Tokenizer) |
| Step-Audio-Chat | [modelscope](https://modelscope.cn/models/stepfun-ai/Step-Audio-Chat) |
| Step-Audio-TTS-3B | [modelscope](https://modelscope.cn/models/stepfun-ai/Step-Audio-TTS-3B) |
## 4. モデルの使用方法
### 📜 4.1 要件
次の表は、Step-Audioモデル(バッチサイズ=1)を実行するための要件を示しています:
| モデル | 設定
(サンプル周波数) | GPU最小メモリ |
|------------|--------------------------------|----------------|
| Step-Audio-Tokenizer | 41.6Hz | 1.5GB |
| Step-Audio-Chat | 41.6Hz | 265GB |
| Step-Audio-TTS-3B | 41.6Hz | 8GB |
* CUDAサポートのあるNVIDIA GPUが必要です。
* モデルは、4つのA800 80G GPUでテストされています。
* **推奨**:より良い生成品質のために、80GBメモリを持つ4つのA800/H800 GPUを使用することをお勧めします。
* テストされたオペレーティングシステム:Linux
### 🔧 4.2 依存関係とインストール
- Python >= 3.10.0([Anaconda](https://www.anaconda.com/download/#linux)または[Miniconda](https://docs.conda.io/en/latest/miniconda.html)の使用を推奨)
- [PyTorch >= 2.3-cu121](https://pytorch.org/)
- [CUDA Toolkit](https://developer.nvidia.com/cuda-downloads)
```bash
git clone https://github.com/stepfun-ai/Step-Audio.git
conda create -n stepaudio python=3.10
conda activate stepaudio
cd Step-Audio
pip install -r requirements.txt
git lfs install
git clone https://huggingface.co/stepfun-ai/Step-Audio-Tokenizer
git clone https://huggingface.co/stepfun-ai/Step-Audio-Chat
git clone https://huggingface.co/stepfun-ai/Step-Audio-TTS-3B
```
モデルをダウンロードした後、where_you_download_dirは次の構造を持つ必要があります:
```
where_you_download_dir
├── Step-Audio-Tokenizer
├── Step-Audio-Chat
├── Step-Audio-TTS-3B
```
#### Docker 実行環境
dockerを使用してStep-Audioの実行に必要な環境を作成します
```bash
# Dockerイメージのビルド
docker build . -t step-audio
# Dockerコンテナの実行
docker run --rm -ti --gpus all \
-v /your/code/path:/app -v /your/model/path:/model \
-p 7860:7860 \
step-audio \
-- bash
# vLLM Dockerイメージのビルド
docker build -f Dockerfile-vllm -t step-audio-vllm .
# vLLM Dockerコンテナの実行
docker run --rm -ti --gpus all \
-v /your/code/path:/app -v /your/model/path:/model \
-p 7860:7860 \
-p 8000:8000 \
step-audio-vllm \
-- bash
```
### 🚀 4.3 推論スクリプト
#### オフライン推論
エンドツーエンドの音声/テキスト入力と音声/テキスト出力で推論を行います。
```bash
python offline_inference.py --model-path where_you_download_dir
```
#### TTS推論
デフォルトのスピーカーを使用してTTSを推論するか、新しいスピーカーでクローンを作成します
```bash
python tts_inference.py --model-path where_you_download_dir --output-path where_you_save_audio_dir --synthesis-type use_tts_or_clone
```
クローンモードには、次の形式のスピーカー情報辞書が必要です:
```bash
{
"speaker": "speaker id",
"prompt_text": "content of prompt wav",
"wav_path": "prompt wav path"
}
```
#### Webデモの起動
オンライン推論のためにローカルサーバーを起動します。
4つのGPUが利用可能で、すべてのモデルをダウンロード済みであると仮定します。
```bash
# Step-Audio-Chat デモ
python app.py --model-path where_you_download_dir
# Step-Audio-TTS-3B デモ
python tts_app.py --model-path where_you_download_dir
```
#### vLLMを用いた対話モデル推論(推奨)
Step-Audio-Chatは130Bパラメータの大規模言語モデルであり、テンソル並列処理をサポートするvLLMを使用した推論を推奨します。
* vLLMはTokenizerおよびTTSをロードしないため、音声入力による推論には対応していません
現在の公式vLLMはStep 1モデルアーキテクチャに対応していないため、当社の[開発ブランチ](https://github.com/stepfun-ai/vllm/tree/add-step1-model)を使用したローカルインストールを推奨します。
本モデルのAttentionメカニズムはALIBIの変種実装を採用しているため、公式flash attentionライブラリとの互換性がありません。[Step-Audio-Chat](https://huggingface.co/stepfun-ai/Step-Audio-Chat/tree/main/lib)リポジトリにカスタム版flash attentionライブラリを提供しています。モデル実行前に必ず環境変数へカスタムライブラリのパスを追加してください。
```bash
export OPTIMUS_LIB_PATH=where_you_download_dir/Step-Audio-Chat/lib
vllm serve where_you_download_dir/Step-Audio-Chat --dtype auto -tp $tp --served-model-name step-audio-chat --trust-remote-code
# vLLMチャットの呼び出し例
python call_vllm_chat.py
```
## 5. ベンチマーク
### 5.1 ASR結果の比較
|
隠れた特徴モデリング |
離散音声トークンモデリング |
|
Whisper Large-v3 |
Qwen2-Audio |
MinMo |
LUCY |
Moshi |
GLM-4-voice Base |
GLM-4-voice Chat |
Step-Audio Pretrain |
Step-Audio-Chat |
| Aishell-1 |
5.14 |
1.53 |
- |
2.4 |
- |
2.46 |
226.47 |
0.87 |
1.95 |
| Aishell-2 ios |
4.76 |
3.06 |
2.69 |
- |
- |
- |
211.3 |
2.91 |
3.57 |
| Wenetspeech test-net |
9.68 |
7.72 |
6.64 |
8.78 |
- |
- |
146.05 |
7.62 |
8.75 |
| Wenet test-meeting |
18.54 |
8.4 |
7.6 |
10.42 |
- |
- |
140.82 |
7.78 |
9.52 |
| Librispeech test-clean |
1.9 |
1.6 |
1.6 |
3.36 |
5.7 |
2.82 |
75.39 |
2.36 |
3.11 |
| Librispeech test-other |
3.65 |
3.6 |
3.82 |
8.05 |
- |
7.66 |
80.3 |
6.32 |
8.44 |
| AVG |
7.28 |
4.32 |
- |
- |
- |
- |
146.74 |
4.64 |
5.89 |
### 5.2 TTS
#### 5.2.1 GLM-4-VoiceとMinMoのコンテンツ一貫性(CER/WER)のパフォーマンス比較。
| モデル |
test-zh |
test-en |
| CER (%) ↓ |
WER (%) ↓ |
| GLM-4-Voice |
2.19 |
2.91 |
| MinMo |
2.48 |
2.90 |
| Step-Audio |
1.53 |
2.71 |
#### 5.2.2 SEEDテストセットでのTTSモデルの結果。
* StepAudio-TTS-3B-Singleは、デュアルコードブックバックボーンとシングルコードブックボコーダの組み合わせを示します。
| モデル |
test-zh |
test-en |
| CER (%) ↓ |
SS ↑ |
WER (%) ↓ |
SS ↑ |
| FireRedTTS |
1.51 |
0.630 |
3.82 |
0.460 |
| MaskGCT |
2.27 |
0.774 |
2.62 |
0.774 |
| CosyVoice |
3.63 |
0.775 |
4.29 |
0.699 |
| CosyVoice 2 |
1.45 |
0.806 |
2.57 |
0.736 |
| CosyVoice 2-S |
1.45 |
0.812 |
2.38 |
0.743 |
| Step-Audio-TTS-3B-Single |
1.37 |
0.802 |
2.52 |
0.704 |
| Step-Audio-TTS-3B |
1.31 |
0.733 |
2.31 |
0.660 |
| Step-Audio-TTS |
1.17 |
0.73 |
2.0 |
0.660 |
#### 5.2.3 デュアルコードブック再合成とCosyVoiceのパフォーマンス比較。
| トークン |
test-zh |
test-en |
| CER (%) ↓ |
SS ↑ |
WER (%) ↓ |
SS ↑ |
| Groundtruth |
0.972 |
- |
2.156 |
- |
| CosyVoice |
2.857 |
0.849 |
4.519 |
0.807 |
| Step-Audio-TTS-3B |
2.192 |
0.784 |
3.585 |
0.742 |
### 5.3 AQTAチャット
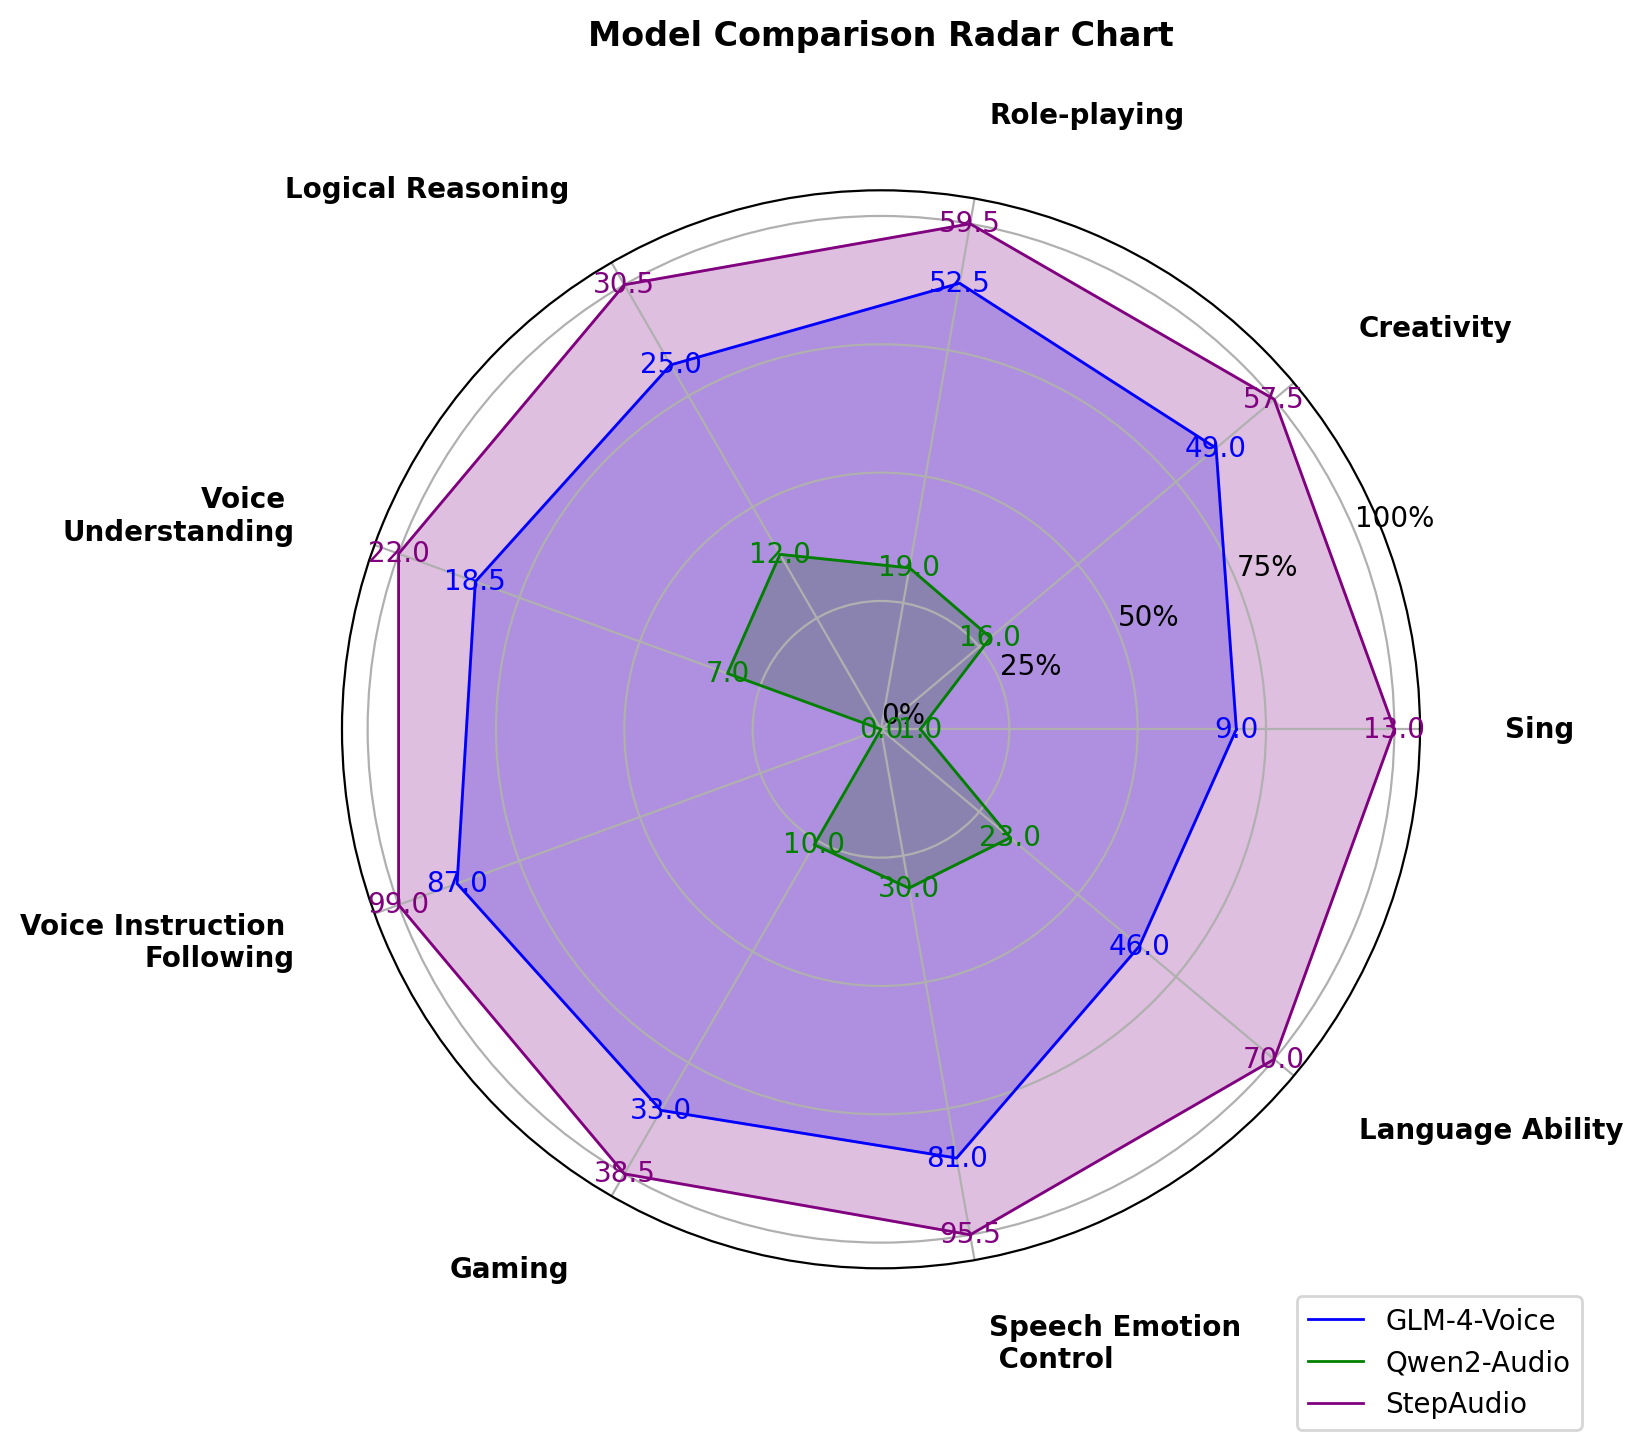
[**StepEval-Audio-360**](https://huggingface.co/datasets/stepfun-ai/StepEval-Audio-360) を新しいベンチマークとしてリリースしました。これは、実際のユーザーからの137のマルチターンの日本語プロンプトで構成されており、生成された応答の品質を次の次元で評価するように設計されています:音声指示のフォロー、音声理解、論理的推論、ロールプレイング、創造性、歌唱、言語能力、音声感情制御、ゲーム。
#### 5.3.1 StepEval-Audio-360
#### LLM評価指標(GPT-4o)
StepEval-Audio-360での音声チャットの基本機能の比較。
| モデル |
事実性(% ↑) |
関連性(% ↑) |
チャットスコア ↑ |
| GLM4-Voice |
54.7 |
66.4 |
3.49 |
| Qwen2-Audio |
22.6 |
26.3 |
2.27 |
| Moshi* |
1.0 |
0 |
1.49 |
| Step-Audio-Chat |
66.4 |
75.2 |
4.11 |
* 注:Moshiは「\*」でマークされており、参考として考慮する必要があります。
#### レーダーチャート(人間の評価)
 #### 5.3.2 公開テストセット
| モデル |
Llama Question |
Web Questions |
TriviaQA* |
ComplexBench |
HSK-6 |
| GLM4-Voice |
64.7 |
32.2 |
39.1 |
66.0 |
74.0 |
| Moshi |
62.3 |
26.6 |
22.8 |
- |
- |
| Freeze-Omni |
72.0 |
44.7 |
53.9 |
- |
- |
| LUCY |
59.7 |
29.3 |
27.0 |
- |
- |
| MinMo |
78.9 |
55.0 |
48.3 |
- |
- |
| Qwen2-Audio |
52.0 |
27.0 |
37.3 |
54.0 |
- |
| Step-Audio-Chat |
81.0 |
75.1 |
58.0 |
74.0 |
86.0 |
* 注:TriviaQAデータセットで「\*」でマークされた結果は参考として考慮されます。
#### 5.3.3 音声指示のフォロー
| カテゴリ |
指示のフォロー |
音声品質 |
| GLM-4-Voice |
Step-Audio |
GLM-4-Voice |
Step-Audio |
| 言語 |
1.9 |
3.8 |
2.9 |
3.3 |
| ロールプレイング |
3.8 |
4.2 |
3.2 |
3.6 |
| 歌唱 / ラップ |
2.1 |
2.4 |
2.4 |
4 |
| 音声制御 |
3.6 |
4.4 |
3.3 |
4.1 |
## 6. オンラインエンジン
Step-Audioのオンラインバージョンは、[跃问](https://yuewen.cn)のアプリバージョンからアクセスでき、いくつかの印象的な例も見つけることができます。
 ## 7. 例
### 音声クローン
| 役割 | プロンプト音声 | クローン音声 |
|:-------:|:-------:|:-------:|
|于谦| [google drive](https://drive.google.com/file/d/1N9EJypafFwmeL0R152GoL_CVGbYn1_9A/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/prompt_wav_yuqian.wav)|[google drive](https://drive.google.com/file/d/1Zs_1QrCUuoSqtUSdn2ENIor-k5baQdDV/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/clone_wav_yuqian.wav)|
|李雪琴| [google drive](https://drive.google.com/file/d/15SkZ29hksELYi1NDOxYOPu-kRTLSyke_/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/prompt_wav_lixueqin.wav)|[google drive](https://drive.google.com/file/d/11Le4qMqL2DmWpf7RFRpKUXERIR9TtKC0/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/clone_wav_lixueqin.wav)|
### 速度制御
| プロンプト | 応答 |
|:-------:|:-------:|
|Human: 早口言葉を言ってください
Assistant: すもももももももものうち
Human: もっと早く言えますか?|[google drive](https://drive.google.com/file/d/1mAH-NRrOVZo4tv6gdAZkyJg8kRuTNNGC/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/speed_control1.wav)|
|Human: 早口言葉を言ってください
Assistant: すもももももももものうち
Human: もっと早く言えますか?
Assistant: すもももももももものうち
Human: もっとゆっくり言ってください。|[google drive](https://drive.google.com/file/d/1FhRnKo8uGrtO-cWg4qkrg8iDoNRbtqSX/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/speed_control2.wav)|
### 高EQ(感情制御 & トーン制御)
| プロンプト | 応答 |
|:-------:|:-------:|
|Human: もっとかわいく話してみてください。|[google drive](https://drive.google.com/file/d/19IROE6_6h2UQVNniCmDTnrhxKRMOFHq3/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/tone_control.wav)|
|Human: どうしよう、人生がうまくいかない。|[google drive](https://drive.google.com/file/d/1JlLbOlzmdrokVdxtwy1S8eeWqsZR2Vmc/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/emotional_control1.wav)|
|Human: すごいですね。|[google drive](https://drive.google.com/file/d/19ga1RpguDP5r0Xfl1r5GY1J-kzbmHvJb/preview)
[audio file](https://github.com/stepfun-ai/Step-Audio/tree/main/examples/emotional_control2.wav)|
### 多言語(例:日本語、英語、中国語)
| プロンプト | 応答 |
|:-------:|:-------:|
|Human: "It's raining cats and dogs" ってどういう意味ですか?
Assistant: "It's raining cats and dogs" というのは、非常に激しい雨が降っていることを意味します。実際に猫や犬が空から降ってくるわけではありません!これは激しい雨を表現するための面白い言い方です。|[google drive](https://drive.google.com/file/d/1LEIvdR5ANMzWX8GOTqUPTNrynNS1xx--/preview)
[audio file](https://github.com


