# 差距是口径,不是模型
2026-09-21 · 消融实验 · 只改题面,不改模型
首轮公开榜单跑下来,Qwen-Image-2.1 在 GenEval 组合题上只有 **4/7**(另两家 7/7),看着像「组合能力不行」。
但这里有个前提:官方推荐口径是**提示词增强 + 2K 分辨率 + 40 步**,我们首轮一样都没按(原题面 + 20 步)。
## 只动一个变量
固定:同一台机器、同一张卡、**2048²、20 步、seed 42**。
唯一的变化:把 GenEval 的原题面改写成「官方增强器风格」的长描述。
| 原题面 | 结果 |
|---|---|
| `a photo of two clocks` | 原题面**只画一个钟** → 长描述**正好两个** |
| `purple wine glass + black apple` | 原题面**丢苹果** → 长描述**两个都在,颜色绑定也对** |
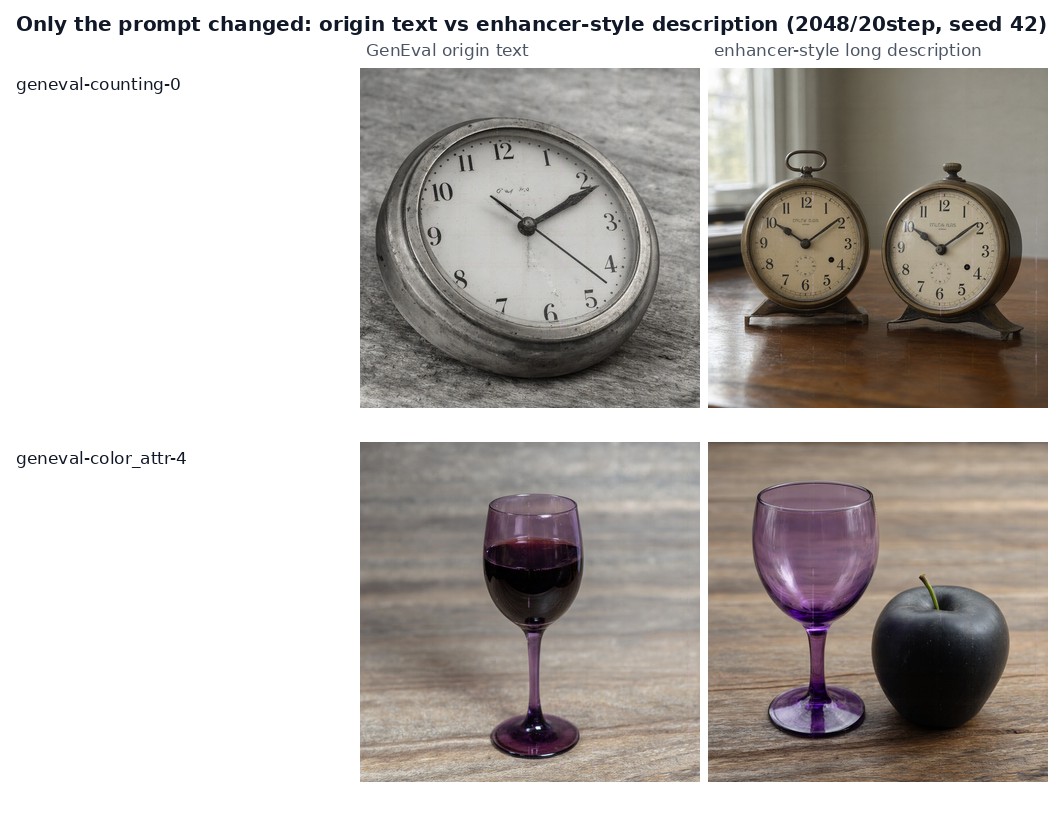
**结论**:这类失败是「短请求不吃」,不是「不会画」。榜单成绩和实际体验的落差,很大一块来自
「有没有按官方口径喂提示词」,而不是模型能力本身。
## 但别把 2K/40 步当成万能药
同一轮里还测了「上 2K、上 40 步」这一档:**文字渲染没有提升**,代价却是 **172 s/张**。
也就是说:
- 想要组合题成绩 → 关键在**提示词增强**,不在分辨率
- 想要文字正确 → 关键在**模型本身**,堆步数没用
## 口径提醒
- 每题**只出 1 张、单 seed**,是抽样体检,不是榜单成绩
- 组合题与长描述题**由人眼判读**,不是官方 Mask2Former / mPLUG+CLIP 自动打分
- 消融臂的「长描述」是**人工模仿**增强器风格写的,**不是**官方增强器输出
- 三家步数不同(Qwen 20 / SenseNova 8 / FLUX 4),口径是「各自最佳配置」
数据:`results/round2-*.csv`、`images/round2/`|脚本:`scripts/rewrite_ablation.py`