# WeChat Mac RPA


**中文** | [English](README_EN.md)
让 AI 像人一样"看"着微信界面,自动回复消息。默认 OCR / SmartPipeline 模式**不碰协议、不读数据库、不注入代码**;可选 WeFlow 模式会读取用户授权的本地数据库副本,用于初始化历史记忆。
基于**多模态视觉感知**与**LLM Agent**的 macOS 微信自动化框架。默认模式不是协议逆向或 Hook,而是把微信当作纯黑盒 GUI 应用:用计算机视觉读取界面,用大语言模型理解对话,用系统级自动化操作界面。
核心设计:**感知 → 推理 → 行动 → 记忆 → 数据飞轮**,五个子系统构成完整的认知闭环。每一次认知循环的完整链路都被结构化日志逐条记录,形成**可追溯、可回归、可量化**的生产质量资产。
---
## 快速开始
- **环境**:macOS 12+,Python 3.10+,微信 Mac 版
- **依赖**:`pip install -r requirements.txt`
- **配置**:复制 `.env.example` 为 `.env`,填入 API Key;复制 `prompts/persona.md.example` 为 `data/persona.md`,填写本地人设
- **隐私**:`.env` 与 `data/` 默认不进入 Git;不要把 API Key、聊天记录或真实人设提交到仓库
- **权限**:Bot 依赖 macOS 辅助功能/屏幕录制权限,详见下文[权限说明](#权限说明)
- **启动**:`python3 run_bot.py`
- **管理后台(LaunchAgent 常驻)**:
```bash
# 首次加载(用户登录时自动启动,崩溃自动重启)
launchctl bootstrap gui/$(id -u) ~/Library/LaunchAgents/com.wechat-mac-rpa.admin.plist
launchctl enable gui/$(id -u)/com.wechat-mac-rpa.admin
launchctl kickstart gui/$(id -u)/com.wechat-mac-rpa.admin
```
常用操作:
- 查看状态:`launchctl list | grep com.wechat-mac-rpa.admin`
- 手动重启:`launchctl kickstart -k gui/$(id -u)/com.wechat-mac-rpa.admin`
- 停止服务:`launchctl bootout gui/$(id -u)/com.wechat-mac-rpa.admin`
- 日志:`tail -f logs/admin-launchd.log logs/admin.log`
- 前台调试用:`python3 scripts/admin.py`
- **测试**:开发环境先执行 `pip install -r requirements-dev.txt`,再运行 `python3 -m pytest src/tests -v`
- **OCR Benchmark**:`python3 scripts/benchmark_qwen_vl_ocr.py`
- **生成报告**:`python3 scripts/generate_ocr_benchmark_report.py`
详细安装与配置指南见 `docs/01-quickstart/AI_QUICKSTART.md`。
---
## 权限说明
Bot 通过 macOS 公开 API 与微信交互,需要以下系统权限:
| 权限 | 用途 | 设置位置 |
|------|------|---------|
| **屏幕录制** | `screencapture` 截取微信窗口画面 | 系统设置 → 隐私与安全 → 屏幕录制 → 终端/运行 Bot 的应用 |
| **辅助功能** | AppleScript 控制微信窗口(点击、输入、激活) | 系统设置 → 隐私与安全 → 辅助功能 → 终端/运行 Bot 的应用 |
| **自动化** | System Events 进程间通信(keystroke、click) | 首次运行时会弹窗授权 |
> 如果截图失败、点击无效或消息发到其他应用,请首先检查上述权限是否已授予。
> 权限必须授予**实际启动 Bot 的应用**。生产运行建议使用普通终端或 LaunchAgent;不要直接从 Codex、Claude Code 等自动化开发环境启动。截图失败时可先运行 `screencapture -x /tmp/wechat-test.png`:如果系统截图也失败,应先排查宿主权限或微信运行环境,而不是修改项目截图逻辑。
---
## 系统架构
### 总览:五层认知闭环
```mermaid
graph LR
subgraph Perception["感知层"]
C[窗口截图]
P[视觉理解 + 布局解析]
W[全量聊天记录初始化]
end
subgraph Reasoning["推理层"]
R[去重 → 路由 → Agent]
end
subgraph Action["行动层"]
A[UI 交互抽象]
end
subgraph Memory["记忆层"]
M[LLM Wiki + 向量数据库]
end
subgraph Flywheel["数据飞轮"]
D[人工 Review → Judge → AB Test → 回归]
end
C --> P
P -->|PerceptionResult| R
R -->|ActionResult| A
A -->|反馈| M
M -->|上下文| R
W -->|全量聊天记录初始化| M
A -->|生产数据| D
D -->|质量反馈| R
```
---
### 感知层:把像素变成结构化数据
感知层的任务是**忠实还原界面上的文字、布局和状态**,不"理解"对话,只负责提取。
当前两条感知管道并行运行:
- **SmartPipeline**(主力):本地预判 + 多模态 API 兜底。先用像素 Diff 判断截图是否有实质变化,无变化时零 API 调用直接跳过;有变化时调用多模态大模型提取消息内容。
- **VisionPipeline**(Fallback):纯本地 OCR 备用管道,在多模态 API 不可用时降级运行。
WeFlowPipeline 不直接参与感知,而是作为**记忆系统的初始化来源**:启动时从微信数据库导出全量历史聊天记录,按聊天聚合后注入 GlobalStore,让 Bot 上线第一天就拥有完整的背景知识。
```mermaid
graph TB
Capture[窗口截图] --> Hash{全图哈希比对}
Hash -->|相同| Reuse[复用上轮结果
零 API 调用]
Hash -->|变化| Diff{分区像素 Diff}
Diff -->|消息区/列表区有变化| API[多模态 API
qwen3.6-flash]
Diff -->|均静止| Skip[本地跳过]
API --> Layout[布局解析]
Layout --> Result["PerceptionResult
结构化消息 + 坐标"]
```
---
### 推理层:决定说什么、用什么工具
推理层是 Bot 的"大脑"。它不直接操作界面,只决定**说什么**和**用什么工具**。
核心设计是**二级路由**:先用轻量调用判断用户意图是否匹配某个复杂 Skill,再决定投入哪条推理路径。
- **轻量化 Agent**(日常路径):运行完整的 ReAct 循环——分析意图 → 调用工具 → 观察结果 → 重新推理。Agent 自行决定调用 `search_memory`、`web_search`、`browse_url` 等工具,也可以加载 Skills 进行深度组合推理。
- **Hermes 路径**:匹配到复杂 Skill 且 Hermes 模型可用时,切换长上下文模型,加载完整 Skill 正文进行单轮深度推理,不启用 ReAct 工具循环。
```mermaid
graph TB
Input["PerceptionResult"] --> Dedup["LCS 跨 tick 去重
精确哈希 + 文字相似度 + 图片 2-gram"]
Dedup --> Router{Skills 路由}
Router -->|日常对话| Agent[轻量化 Agent
ReAct 循环]
Router -->|复杂 Skill| Hermes[Hermes
长上下文单轮推理]
Agent --> Tools[工具调用
search / web / browse]
Tools --> Memory[记忆检索]
Memory --> Agent
Agent --> Output["回复决策
ActionResult"]
Hermes --> Output
```
感知层以固定间隔输出一帧消息列表,但聊天历史不会消失——大部分消息在上一轮已经见过。如果 Bot 把旧消息当成新消息,就会重复回复。我们用 **LCS(最长公共子序列)**做跨 tick 消息对齐,对齐基于多维度模糊匹配:精确哈希匹配、文字相似度、图片 2-gram Jaccard 相似度。对齐后只有真正的新消息进入后续流程,旧消息被静默丢弃。
---
### 记忆系统:三层记忆构成完整上下文
Bot 的 prompt 不是只依赖长期 Wiki,而是由**三层记忆**共同组装:工作记忆提供即时上下文,会话记忆提供人物与关系,长期记忆提供跨时间的背景知识。
```
Prompt = 工作记忆(最近对话原文) + 会话记忆(人物 / 关系 / 偏好) + 长期记忆(Wiki / 向量召回)
```
#### 工作记忆(Working Memory)
工作记忆是 Bot 对当前对话的即时感知,通常取**最近 N 条对话原文**(如最近半小时或最近 20 条)。它解决的是"刚才说了什么"的问题:
- 未完成的用户意图与追问链
- 最近的指代、省略、上下文依赖
- 当前活跃的语气、节奏与话题边界
工作记忆直接从 session 存储中按时间窗口截断获取,不做复杂召回,保证时效性和准确性。
#### 会话记忆(Session Memory)
会话记忆描述**当前对话对象和当前会话状态**,通常从长期记忆中实时召回后,以"人物卡"形式固定在 prompt 顶部:
- **基础画像**:对方姓名、身份、与 Bot 的关系(如同事、朋友、家人)
- **社会关系**:家庭成员、同事圈、共同群聊、亲疏层级
- **用户偏好**:沟通风格、常用表达方式、敏感话题、历史忌口
- **会话状态**:当前活跃话题、待跟进事项、已确认/待确认的信息
这一层让 Bot 知道"对面是谁"、"我和ta什么关系"、"现在聊到哪了"。
#### 长期记忆(Long-term Memory)
长期记忆跨越单次会话,保存时间线更长的背景知识。它把 **历史聊天记录** 当作原始输入数据,向上抽象出两个索引层:
- **LLM Wiki**:由 LLM 从原始对话中提炼、结构化的长期事实(按联系人/群聊独立维护),增量更新,标注来源。
- **BGE 语义索引**:对原始对话做 `BAAI/bge-small-zh-v1.5` 嵌入,提供语义级历史原文检索。
**原始输入数据**
- **历史导出**:`data/exports/b/` 下的 JSON 消息导出文件。
- **运行时对话**:Bot 收到的新消息,可通过 `history_search.add_message()` 实时加入检索。
**索引构建**
```bash
# 首次全量构建(约 1 小时)
python3 scripts/update_history_index.py
# 后续单条增量(管理工具)
python3 scripts/update_history_index.py \
--add-one '{"id":"...","text":"...","sender":"...","chat_type":"single"}'
python3 scripts/update_history_index.py --remove-one "MSG_ID"
```
- 编码器使用 **ONNX Runtime**,无需 `torch` / `transformers`。
- 默认模型路径为仓库内的 `models/bge-small-zh-v1.5`,可通过 `WECHAT_BGE_MODEL_PATH` 覆盖。
- 输出 `data/memory/cache/vector_index_dense_messages.pkl`,可通过 `WECHAT_HISTORY_INDEX_PATH` 覆盖。
**线上召回**
- **`search_memory` 工具**:同时召回:
- **LLM Wiki 摘要**:人物/群聊的关键事实与关系。
- **历史聊天原文**:语义相似的原始对话片段(含上下文)。
- 语义索引支持运行时单条增量:`history_search.add_message(msg)` 先写入内存缓冲区,检索时与持久化主索引合并;需要持久化时可通过 `--add-one` 写回 pkl。
**人工 Overrides**:通过外挂 JSON 实现任意字段覆写,LLM 更新时不会破坏人工修改。
聊天记录、记忆索引等持久化数据保存在本地。启用外部 LLM / 多模态 API 时,完成推理所需的对话 Prompt 或微信截图会发送给所配置的 API 服务商。
```mermaid
graph TB
subgraph Prompt["Prompt 上下文 = 三层记忆"]
WM[工作记忆
最近 N 条原文]
SM[会话记忆
人物卡 / 关系 / 偏好]
LM[长期记忆片段
Wiki 摘要 + 历史原文]
end
WM --> Context[注入 LLM 上下文]
SM --> Context
LM --> Context
subgraph LongTerm["长期记忆生产"]
Export["历史导出
data/exports/b"]
Runtime["运行时对话
增量消息"]
Wiki["LLM Wiki
结构化 Markdown"]
VectorDB["BGE 语义索引
ONNX / 512dim"]
KeywordRecall["LLM Wiki 关键字召回"]
VectorRecall["BGE 语义召回"]
Merge["search_memory
Wiki + 历史原文"]
end
Export --> Wiki
Export --> VectorDB
Runtime --> Wiki
Runtime -.增量.-> VectorDB
Wiki --> KeywordRecall
VectorDB --> VectorRecall
KeywordRecall --> Merge
VectorRecall --> Merge
Merge --> LM
```
---
### 行动层:把文本变成界面操作
行动层负责把推理层的决策翻译成对微信 GUI 的实际操作。面对不稳定的 GUI 环境(窗口可能被遮挡、焦点可能丢失、剪贴板可能被污染),我们用 **UIInteractor** 抽象所有坐标级交互,上层 Action 基于该抽象实现,便于替换底层自动化方案。
行动层目前覆盖四类核心动作,均基于同一套 UI 抽象,内置安全机制(frontmost 验证、异常熔断、剪贴板清理):
- **消息发送**:文本通过 AppleScript 写入剪贴板并粘贴到输入框,发送前做剪贴板内容回读验证。
- **文件/图片发送**:文件通过 AppleScript 将 POSIX 文件对象设置到剪贴板,再粘贴发送;图片发送复用同一剪贴板通道。`send_file` 作为动态工具向 Agent 暴露,可发送 `data/shareable_files.json` 白名单中的文件。
- **聊天切换**:从感知层获取左侧聊天列表项,坐标转换后调用 `cliclick` 点击目标聊天;加入 1 秒全局点击冷却,避免高频连点导致微信窗口布局异常。
- **登录恢复**:检测扫码/掉线弹窗,自动点击登录按钮并等待重连。
Bot 每个 tick 检测并切换到未读数最高的聊天逐个处理,同一目标在短时间内不会重复切换。
```mermaid
graph TB
Decision["回复决策"] --> UI["UIInteractor 抽象
点击 / 聚焦 / 输入"]
UI --> Send["消息发送"]
UI --> Media["文件 / 图片发送"]
UI --> Switch["聊天切换"]
UI --> Recovery["登录恢复"]
Send --> Verify["剪贴板验证"]
Media --> Verify
Verify --> Log["结构化日志"]
```
---
### 数据飞轮:有限人工标注,无限自动迭代
数据飞轮的精髓不是"人来一条一条修 badcase",而是**用有限的人工标注成本,换一瓶优质的 LLM as Judge;再用这瓶 Judge 作为自动实验评估标准,无限地迭代 Bot**。
人工 review 是稀缺资源,所以只投在最关键的地方——校准 Judge。一旦 Judge 的打分与人工判断足够一致,它就能接管后续所有 Bot 实验的评估工作:每天产生的大量 tick_log、每一次 prompt 改动、每一个路由策略调整,都可以让 Judge 自动评分,不再需要人逐条过目。
```mermaid
graph LR
subgraph Flywheel["数据飞轮:有限人工标注 → 无限自动迭代"]
Prod[Bot 生产运行] --> Tick[tick_log
结构化日志]
Tick --> Sample[候选 Case 采样]
Sample -->|少量有限| Review[人工 Review
Gold Truth 标注]
Review --> JudgeEval[Judge 质量评估
人工 vs Judge 一致性]
JudgeEval -->|分歧率高| JudgeIter[迭代 Judge Prompt
修正误判 / 细化 Rubric]
JudgeIter --> JudgeEval
JudgeEval -->|优质 Judge| AutoJudge["LLM as Judge
自动实验评估标准"]
Tick -->|大量无标注| AutoJudge
AutoJudge -->|自动评分| PromptOpt[优化 Bot Prompt
系统提示 / 工具 / 约束]
PromptOpt --> ABTest[AB Test
实验组 vs 对照组
Judge 自动打分]
ABTest -->|显著提升| Merge[合并上生产]
Merge --> Prod
ABTest -->|不显著或退化| PromptOpt
end
```
#### 设计思想:Judge 就是 Reward Model
这个数据飞轮的设计思想与 **On-Policy 强化学习**非常相似:
| 数据飞轮 | 强化学习 |
|---|---|
| 少量人工标注 | 人类偏好监督数据 |
| LLM as Judge | Reward Model |
| Bot 回复生成 | Actor |
| Prompt / 工具 / 约束优化 | 策略更新 |
| 新策略上线后继续生产 tick_log | On-Policy:新策略采样新数据 |
区别只在于,这里的 Actor 优化不是通过梯度更新模型参数,而是通过人工分析 reward 信号、调整 prompt / 工具 / 约束等"策略配置",再用 AB Test 验证新策略是否确实提升了 reward。所以这是一个**人工设计策略 + 自动评估验证**的 on-policy 循环:新策略上线后继续产生新的 tick_log,再采样、标注、校准 Judge,周而复始。
这个类比也解释了为什么 Judge 的质量如此关键:**一个带偏的 Reward Model 会把 Actor 带偏**。只有 Judge 足够可信,Bot 的迭代方向才不会歪。
#### 回路一:用有限人工标注校准 Judge
人工 review 只发生在回路一,且是**少量、有策略的采样标注**。每一例人工标注都被同时用于两件事:训练我们自己对 case 的判断标准,以及评估 Judge 是否跟上了这个标准。
- **Judge 质量评估**:持续对比人工标注与 Judge 评分,计算一致性、误判率、分歧率。分歧率就是 Judge 这瓶"度量衡"的误差。
- **Judge Prompt 迭代**:当分歧率超过阈值时,暂停 Judge 自动评估,分析典型误判模式,迭代 Judge 的 Rubric、示例和边界定义——不是让 Judge 去拟合某一条 case,而是让它的评分标准更贴近人的真实偏好。
- **回归验证**:更新后的 Judge 必须先在 **Judge Quality benchmark** 上通过回归验证,确认它既没有丢失旧能力、也没有引入新偏见,才能重新作为实验评估标准。
#### 回路二:用优质 Judge 无限迭代 Bot
Judge 一旦可信,回路二就可以大规模自动化运转,**人工不再参与逐条评估**。
- **自动质量评估**:每天的生产 tick_log 由 Judge 自动打分,筛选出值得关注的候选 case 供下一轮少量人工抽检;AB Test 中的实验组与对照组由同一版 Judge 评分,保证评估口径一致。
- **根因分析**:从 Judge 评分和抽检样本中提取共性问题,定位是系统提示、工具定义、约束条件还是记忆召回出了问题。
- **通用规则修复**:禁止 case-by-case 打补丁。所有修复必须表达为可复用的规则或配置变更,并在 benchmark 上验证。
- **AB Test 验证**:任何提示词、模型、路由策略的改动,必须先跑 AB Test。只有实验组相比对照组显著提升才允许合并上生产;不显著或退化则回炉重优化。
这就是数据飞轮的杠杆:**人在回路一中投入的每一分钟,都在放大回路二的自动化能力**。Judge 越准,Bot 迭代越快、人工投入越少。
---
## 工程基础设施
- **Benchmark Dashboard**:自动生成可视化报告,汇总各 benchmark 的历史趋势与当前状态
- **管理后台**:内置 FastAPI 开发者后台(`scripts/admin.py`),提供 Dashboard、Tick 查看、人工标注、截图 OCR、Benchmark 报告、实验管理
- **全链路 Profile**:整个链路植入统一的性能打点,覆盖截图、OCR、布局、生成、记忆、发送各阶段
---
## Benchmark
| Benchmark | 结果 |
|-----------|-----:|
| **Reply Quality** | **91.7%**(22/24) |
| **Tool Decision · 常规** | **100%**(22/22) |
| **Memory Search** | **96.6%**(28/29) |
| **OCR · 代表性场景通过率** | **93.1%**(27/29) |
| **OCR · Chat Name** | **96.6%** |
| **OCR · Message Count** | **93.1%** |
| **OCR · Sender** | **93.6%** |
| **OCR · Text** | **93.5%** |
---
## 项目结构
```
wechat-mac-rpa/
├── src/
│ ├── bot/ # L5: 主循环编排
│ ├── perception/ # L3.5: SmartPipeline / VisionPipeline / WeFlowPipeline
│ ├── layout/ # L3: 布局解析
│ ├── message/ # L3: 消息提取
│ ├── session/ # L4: 全局消息存储(LCS 去重 + 持久化)
│ ├── reply/ # L4: 回复生成(Agent 运行时 + 双模型路由)
│ ├── memory/ # L4: 记忆系统(工作 / 会话 / 长期记忆 + LLM Wiki + Overrides)
│ ├── tools/ # L4: 工具注册 + 内置工具
│ ├── action/ # L4: UI 交互 / 消息发送 / 聊天切换 / 登录恢复
│ ├── capture/ # L2: 窗口截图
│ ├── ocr/ # L2: macOS Vision 文字识别
│ ├── models/ # L1: 领域模型
│ ├── db/ # L1: SQLite 数据模型与 Repository(聊天记录唯一权威源)
│ ├── llm/ # LLM 客户端(Kimi 本地代理 / DashScope API)
│ ├── logging/ # 结构化日志与全链路追踪
│ ├── utils/ # L1-L5 共享工具
│ ├── badcase/ # Badcase 闭环(数据库 / 生成器 / Judge / 审核)
│ └── tests/ # 9 个 benchmark 套件 + 单元测试
├── tests_integration/ # 集成测试(真实截图 + 端到端)
├── scripts/ # 后台 / Dashboard 生成 / 实验框架 / 数据迁移
│ └── db/ # 数据库迁移、备份、去重脚本
├── docs/ # 完整文档体系
│ ├── 01-quickstart/
│ ├── 02-architecture/
│ ├── 03-guides/
│ ├── 04-troubleshooting/
│ └── 05-meta/
├── data/ # 运行时数据(gitignored)
│ ├── debug/ # tick 级 debug JSON
│ ├── logs/ # 运行日志
│ ├── screenshots/ # 截图存档
│ ├── memory/wiki/ # 用户/群聊/话题 wiki
│ ├── memory/cache/ # BGE 语义索引(vector_index_dense_messages.pkl)
│ ├── benchmark_history/ # Benchmark 历史数据
│ ├── experiments/ # 实验结果归档
│ └── cases.db # Badcase 核心数据库
├── prompts/ # 系统 prompt 模板
├── skills/ # 可插拔 Skill(Markdown)
├── models/ # 模型配置与缓存
└── run_bot.py # 生产环境入口
```
---
## 数据模型
运行时的聊天记录以 **SQLite** 为唯一权威源,`GlobalStore` 启动时从 DB 加载、保存时回写 DB,不再依赖易丢失的 JSON 分片。Phase 1 实现三张核心表:
| 表 | 说明 | 关键约束 |
|---|---|---|
| `chatrooms` | 聊天会话(群聊 / 私聊) | `chatroom_id` 全局唯一,解决同名群问题 |
| `messages` | 单条聊天消息 | `UNIQUE(chatroom_id, wxid, create_time, content_hash)` |
| `chat_members` | 群成员关系 | `UNIQUE(chatroom_id, wxid)` |
```mermaid
erDiagram
CHATROOM ||--o{ MESSAGE : contains
CHATROOM ||--o{ CHAT_MEMBER : has
CHATROOM {
int id PK
string chatroom_id UK
string display_name
string chat_type
float first_seen_at
float last_active_at
}
MESSAGE {
int id PK
int chatroom_id FK
string wxid
string content
string message_type
float create_time
string content_hash
}
CHAT_MEMBER {
int id PK
int chatroom_id FK
string wxid
string group_nickname
bool is_active
}
```
- 完整系统数据模型(含 `persons`、`aliases`、`facts`、`wiki` 等未来 Phase)见 [`docs/02-architecture/DATA_MODEL_SPEC.md`](docs/02-architecture/DATA_MODEL_SPEC.md)。
- Phase 1 MVP 详细设计见 [`docs/02-architecture/DATA_MODEL_PHASE1.md`](docs/02-architecture/DATA_MODEL_PHASE1.md)。
- 常用 DB 维护脚本:
- `python scripts/db/migrate_exports_to_db.py`:批量导入导出文件到 DB
- `python scripts/db/deduplicate_db.py`:按复合键去重
- `python scripts/db/migrate_content_hash.py`:content_hash 算法迁移
- `python scripts/db/backup_chat_db.py --retention 7`:自动备份与清理
---
## 核心术语
| 术语 | 说明 |
|------|------|
| **Tick** | Bot 主循环的一次迭代(当前启动入口间隔 15 秒;底层方法默认参数 5 秒),包含 感知 → 去重 → 决策 → 回复 |
| **Perception** | 感知层,将微信窗口截图转换为结构化数据(聊天名、消息列表、未读数等) |
| **Layout** | 布局解析,把 OCR 文字元素按 UI 区域分组(聊天列表、标题栏、消息区等) |
| **SmartPipeline** | 感知层实现之一:OCR + 视觉模型 API,带像素 diff 缓存,降低 API 调用频率 |
| **WeFlow** | 感知层实现之一:通过 WeChatDB 导出历史消息,用于首次全量初始化 |
| **GlobalStore** | 全局消息存储,负责跨 tick 去重、会话状态维护和持久化 |
| **Judge** | LLM-as-a-Judge,用于评估回复质量、自动标注 badcase |
| **Skill** | Markdown 格式的可插拔知识卡片,可被工具动态加载 |
## 文档索引
| 文档 | 说明 |
|------|------|
| [快速开始](docs/01-quickstart/AI_QUICKSTART.md) | 环境配置、依赖安装、首次启动 |
| [架构设计](docs/02-architecture/ARCHITECTURE.md) | L1-L5 分层架构、依赖规则、边界约束 |
| [数据模型 Phase 1](docs/02-architecture/DATA_MODEL_PHASE1.md) | SQLite DB-only 架构:chatrooms / messages / chat_members |
| [数据模型全量设计](docs/02-architecture/DATA_MODEL_SPEC.md) | 含 persons、aliases、facts、wiki 等未来 Phase 设计 |
| [API 接口速查](docs/02-architecture/API_SURFACE.md) | 当前生产代码的公共接口,可直接复制粘贴 |
| [模块索引](docs/02-architecture/MODULE_INDEX.md) | "消息识别错了"→改哪个文件 |
| [编码原则](docs/02-architecture/CODING_PRINCIPLES.md) | 类型注解、单一职责、单向依赖 |
| [项目进度](docs/03-guides/PROJECT_STATUS.md) | 当前状态、活跃问题、benchmark 结果 |
| [性能优化 Spec](docs/02-architecture/specs/PERFORMANCE_SPEC.md) | 全链路 profiling 点、瓶颈分析、优化方案 |
| [踩坑记录](docs/04-troubleshooting/LESSONS_LEARNED.md) | 历史教训、常见错误模式 |
---
## License
本项目采用 [MIT License](LICENSE) 开源。
---
## 数据安全与 WeFlow
- **OCR / SmartPipeline 模式**:Bot 仅通过 macOS 公开 API 截取微信窗口画面,不读取微信本地数据库。
- **WeFlow 模式**:可选启用,用于首次启动时全量导出历史消息以初始化记忆。该导出基于用户已授权的本地 WeChat 数据库副本,Bot 不会修改或上传原始数据库。
- API Key、原始数据库、聊天记录和记忆索引保存在本地 `.env`、`data/` 目录,不上传至本项目自建服务器。启用外部 LLM / 多模态 API 时,相关 Prompt 或截图会按功能需要发送给所配置的 API 服务商,请同时遵守服务商的数据政策。
## 免责声明
本项目仅用于个人学习和研究目的。使用自动化工具操作微信可能违反微信用户协议,请自行评估风险。本项目作者不对任何使用后果负责。
---
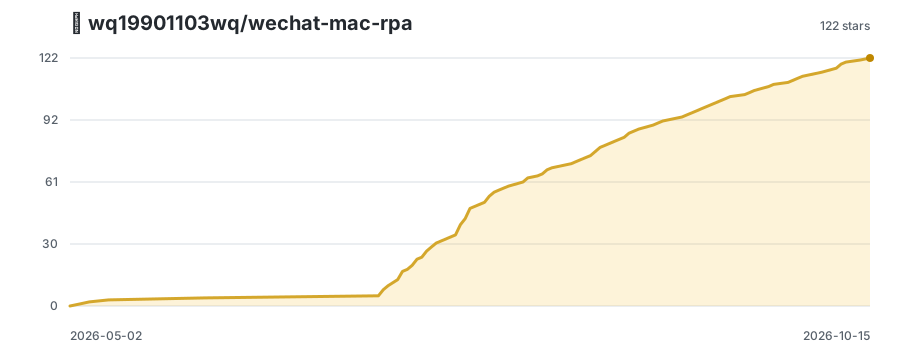
## Star History
[](https://github.com/wq19901103wq/wechat-mac-rpa/stargazers)
---
如果这个项目对你有启发,欢迎点个 ⭐ 支持一下——这是开源项目最好的鼓励。