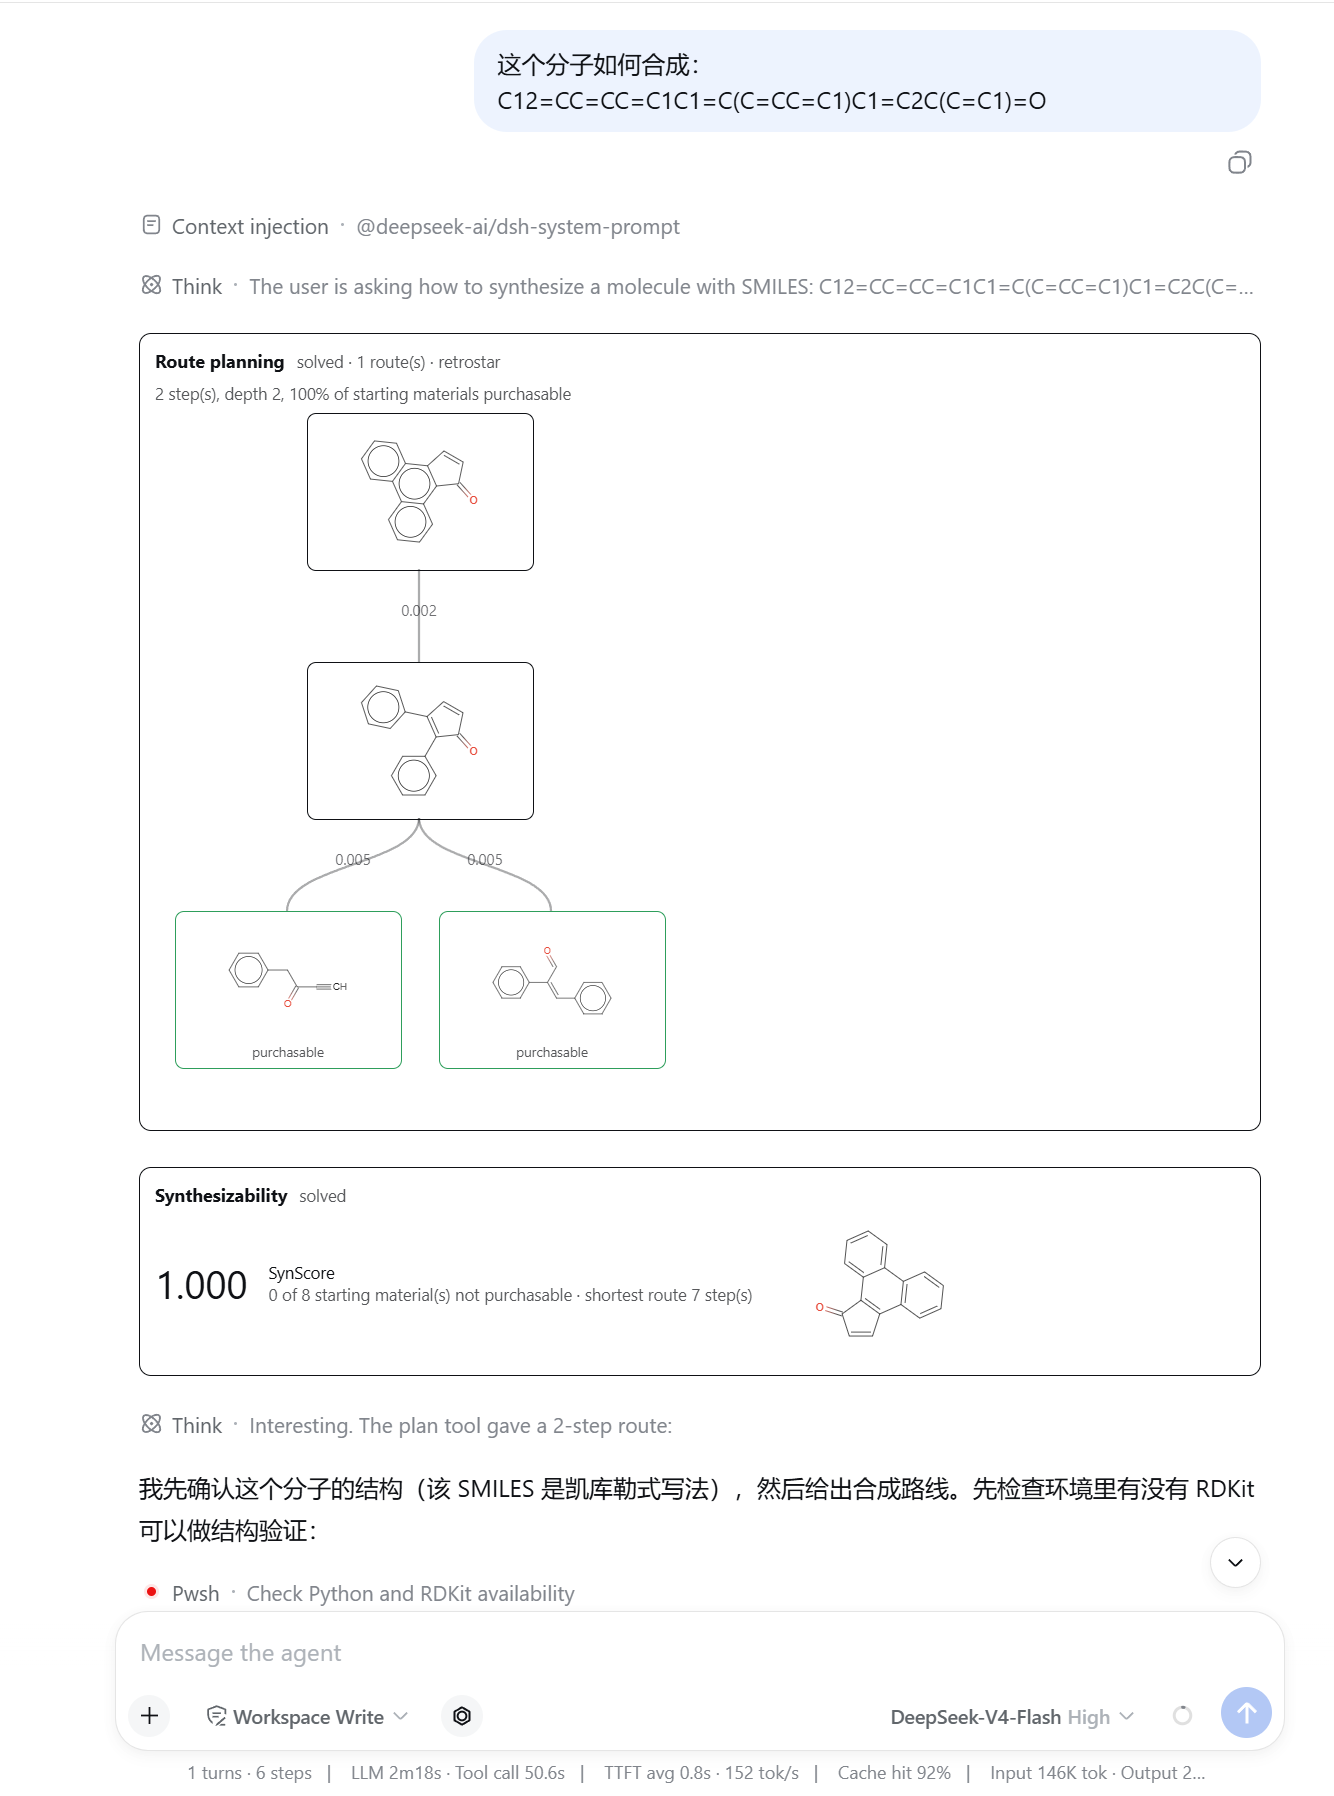
"这个分子如何合成?"——模型规划路线并评分。两步,两个起始原料都可购, 每步的分数标在边上,SynScore 1.000。
## 安装 ```sh dsh plugin --profile web add github:zbc0315/dsh-synomega ``` 这里的 `web` 是要装进哪个 **profile**。profile 就是"由哪些插件按什么顺序叠起来"的一份配置, 物理上是 `$DSH_HOME/profiles/` 下的一个目录;`dsh web` 启动的就是名为 `web` 的那个。 你平时怎么启动 dsh,就装进哪个 profile;写一个不存在的名字会自动创建。 构建产物已随仓库提交,所以从 git 安装不需要构建步骤,也不需要 `allowBuilds` 授权。 (发到 npm 之后,`dsh plugin --profile web add dsh-synomega` 效果相同。) 装完启动一次 dsh 即可。首次激活时插件会在后台把 Python 侧准备好——在 `$DSH_HOME/plugins/synomega` 下建一个 Python 3.12 虚拟环境,`pip install synomega[gnn]`, 然后下载逆合成模型、可购砌块库和正向模型(合计约 450 MB,只下一次)。这个过程**不会挡住 dsh 启动**; 准备期间调用工具,返回的是当前进度("正在下载模型"),并提示模型稍后重试,而不是报错。 准备过程会加跨进程锁:如果你手动跑安装脚本的同时又启动了 dsh,后者会等前者完成, 而不是把同一批文件下载两遍。 **需要 Python 3.10 或更新,而很多机器上的系统 `python3` 都更旧。** 装了 [uv](https://docs.astral.sh/uv/) 的话插件会自己拉一个合适的解释器; 否则把配置项 `python` 指向一个已有的 3.10+ 解释器。 想提前装好而不是等首次激活: ```sh node node_modules/dsh-synomega/scripts/setup.mjs # 含神经后端 node node_modules/dsh-synomega/scripts/setup.mjs --no-extras --no-assets # 只装纯模板后端 ``` ## 五个工具 | 工具 | 回答的问题 | |---|---| | `synomega_retro` | *什么能反应生成 X?* —— 产物的单步切断,按分数排序 | | `synomega_forward` | *这些反应物给什么?* —— 反应产物,按分数排序 | | `synomega_plan` | *X 怎么合成?* —— 一直拆到可购砌块的完整路线 | | `synomega_score` | *X 能不能做、有多难?* —— SynScore,用于排序的连续 0–1 分 | | `synomega_evolve` | *这堆东西混一起能生成什么?* —— 从反应物池长出的正向合成网络 | 每个工具都返回结构化的规范值(Code Mode 里可以直接用),外加一段给模型看的紧凑文本。 插件还注册了一段系统提示词,教模型什么问题该用哪个工具、分子参数必须是 SMILES、 以及安装后第一次调用会慢(要下模型)。 **SynScore** 是 `1/(U+1)^U`,`U` 是最优路线里买不到的起始原料个数: 全都买得到是 1.0,差一个 0.5,差两个 0.11,找不到路线是 0。 用 `score` 给候选分子排序,用单独的 `solved` 布尔值跟文献的 solve rate 对比—— 这两个回答的是不同问题,不要混。 ## 画分子 输入框左侧那排控件旁边有一个苯环按钮。点开它会在对话上方弹出 [Ketcher](https://github.com/epam/ketcher) 分子编辑器;画完点**插入**, 所画结构会以 SMILES 追加到当前这条消息里,你已经打好的字不动。 之所以要这个:另一条路是手抄。手敲的 SMILES 很容易错得不显眼,而错的那个照样能解析—— `CC(=O)Nc1ccccc1O` 和 `CC(=O)Nc1ccc(O)cc1` 只差一个取代位,却是两种化合物。 编辑器在**第一次点击时**从它自己的 GitHub release 下载一次(约 35 MB,留下约 30 MB), 存进 `$DSH_HOME/plugins/synomega/ketcher/<版本>/`,用写死的 SHA-256 校验,之后由本 harness 自己伺服。 本地伺服才使它与主页面**同源**——对话框能直接读出所画的结构,断网后编辑器照常可用。 没人打开画板就不会下载任何东西。 想改行为:`ketcher.prefetch: true` 改成激活时就下;`ketcher.url` 指向镜像或 `file://` 本地副本; `ketcher.enabled: false` 干脆不要这个按钮。没有 web 服务的组合(headless、命令行)根本不会注册这条路由。 ## 可视化 浏览器侧在 harness 的 keyed slot `tool.call.toolview` 上为每个工具注册了一个视图, 结果就以卡片形式画在对话里: - **逆合成 / 正向** —— 每个候选画成 `反应物 → 产物`,带分数条 - **路径规划** —— 路线画成树,分子在节点上、反应分数标在边上; 可购与不可购的起始原料用不同颜色区分;找到多条路线时可以切换 - **SynScore** —— 分数配上它来自的那条路线 - **演化** —— 分子按 depth 分列,每个带累积分数 分子结构由 [smiles-drawer](https://github.com/reymond-group/smilesDrawer) 绘制, 树布局用 [d3-hierarchy](https://github.com/d3/d3-hierarchy)。两个库都打进了 bundle, 页面不会去外部取任何东西。**画不出来的 SMILES 会退回显示文本**而不是留个空框, **被截断的树会明确标注**——一条被裁剪的路线绝不能看起来像完整路线。 卡片完全由持久化在工具结果上的元数据绘制,所以重新打开旧对话会画出一模一样的图。 没有浏览器界面的部署(headless、命令行)拿到的是文本形式:**信息不丢,只是不好看**。 ### 单步正向预测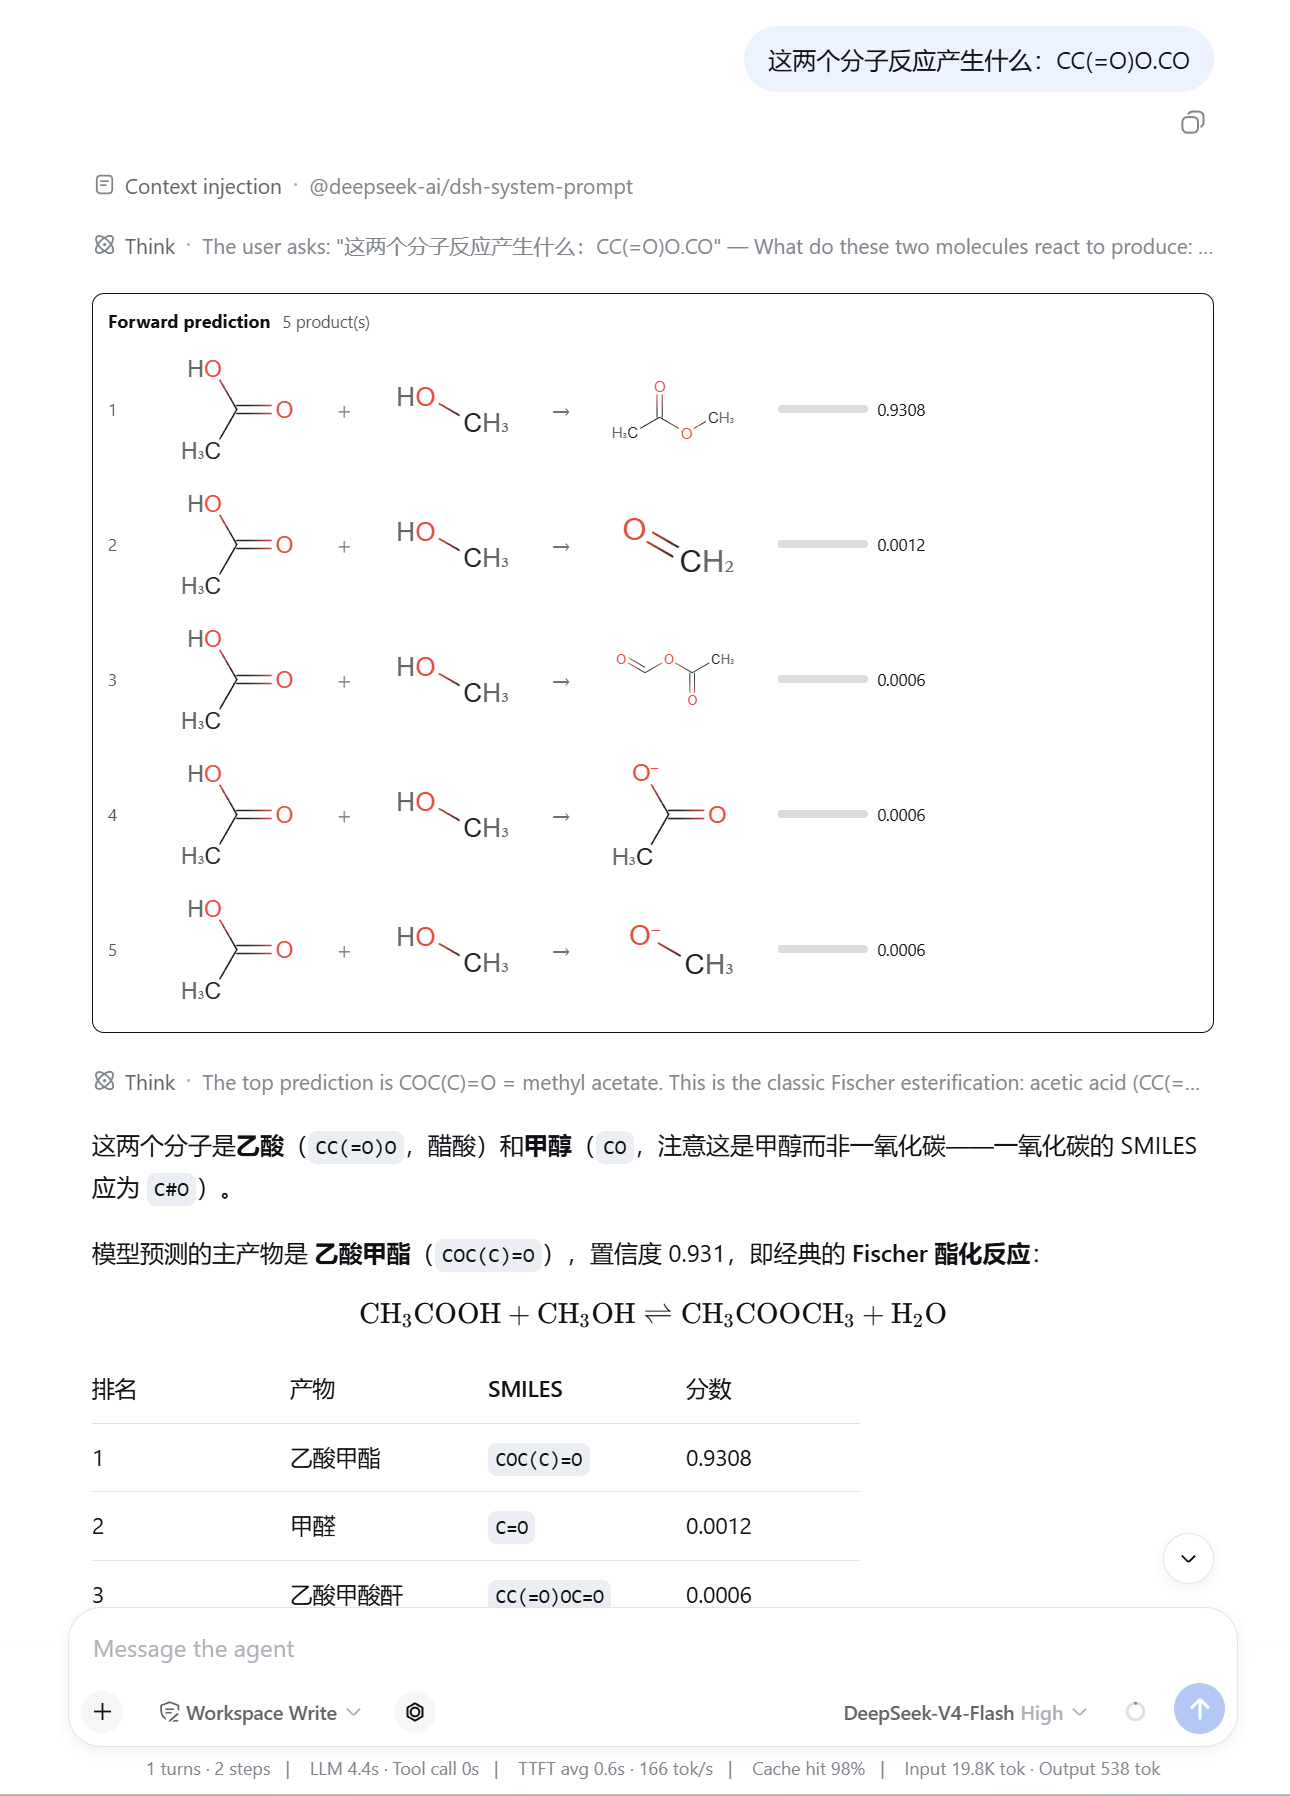 乙酸 + 甲醇,给出前五个候选。乙酸甲酯 0.9308,其余低了三个数量级——模型据此判定是
Fischer 酯化并写了出来。注意它顺手澄清的那句:`CO` 是**甲醇**不是一氧化碳(后者应写作 `C#O`)。
这正是输入框那个分子画板要防的一类错误。
### 多组分正向演化
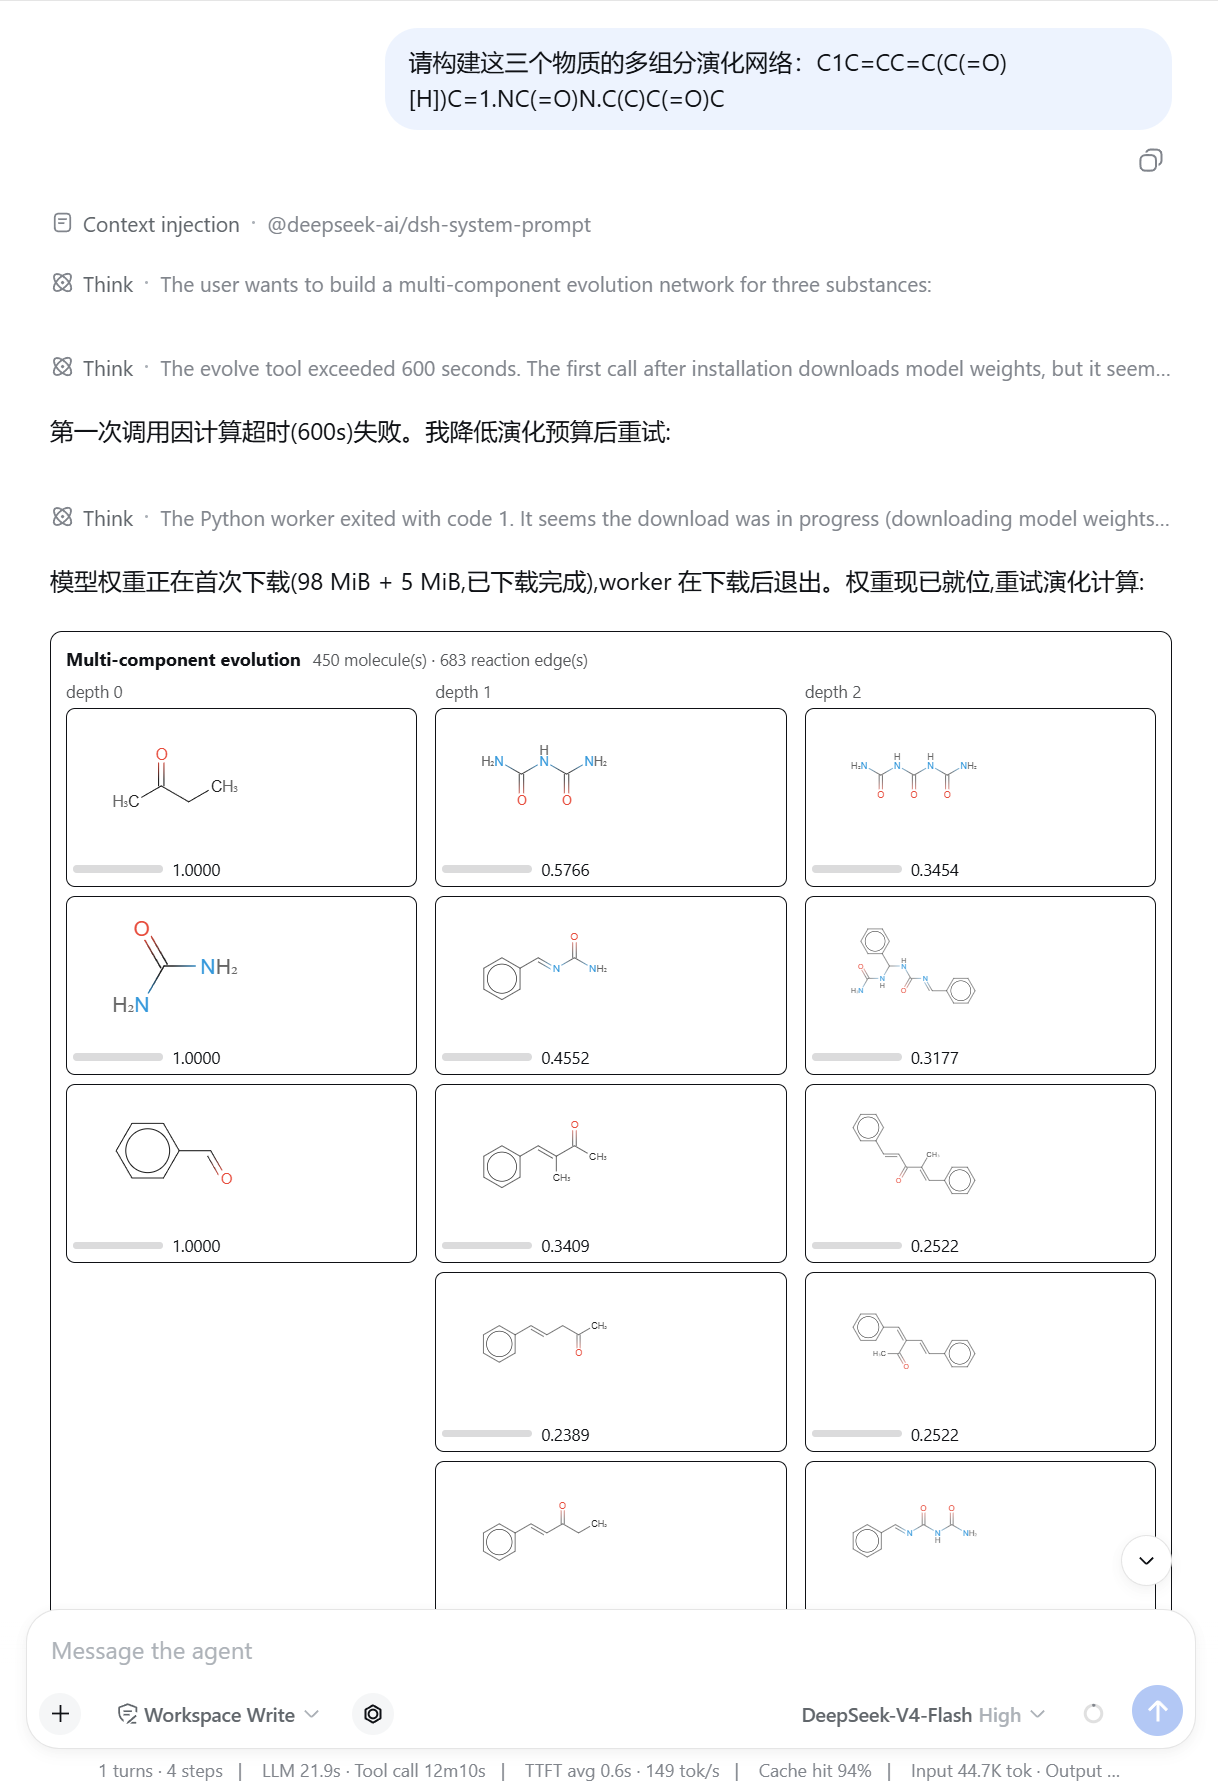 丁酮、尿素、苯甲醛三者向前演化,得到 450 个分子、683 条反应边,按 depth 分列,
每个分子带累积分数。depth 0 是你投进去的三个物质,右边各列是网络实际到达的地方。
## 配置
全部写在 `cordis.yml` 里。值得知道的几项:
| 键 | 默认 | 含义 |
|---|---|---|
| `autoSetup` | `true` | 激活时准备 Python 环境 |
| `python` | — | 显式指定解释器路径;给了就不建虚拟环境 |
| `extras` | `['gnn']` | PyPI extras。`[]` 只装纯模板后端:不要 torch,快很多,但没有神经预测 |
| `mirror` | `'auto'` | 资产镜像(`ustc` / `github`) |
| `algorithm` | `'retrostar'` | 搜索算法(`retrostar` / `mcts` / `bfs`) |
| `plausibility` | `false` | 用合理性模型筛候选。默认关:它不提升 top-k 召回,还加延迟 |
| `search` | 宽度 50、60 秒、500 次扩展 | 搜索预算。这是部署策略,不是给模型调的参数 |
| `timeouts` | 2 分钟 / 10 分钟 | 各操作的超时(单步 / 搜索) |
| `visualize` | `true` | 是否产出卡片元数据 |
| `maxTreeNodes` | `120` | 画路线树时的节点上限 |
| `ketcher.enabled` | `true` | 是否在输入框提供分子画板 |
| `ketcher.prefetch` | `false` | 激活时就下载画板,而不是等第一次用 |
| `ketcher.version` | `'3.17.0'` | 安装哪个 Ketcher 版本 |
| `ketcher.url` | — | 发行包地址;支持 `file://`,给没有网络的机器用 |
## 工作原理
```
浏览器 在 tool.call.toolview 上注册的卡片(smiles-drawer、d3-hierarchy)
↑ 画的是工具结果里持久化的那份元数据
在 conversation.input.left 上占的一个座位(同源 iframe 里的 Ketcher)
↑ HTTP,/dsh-synomega/ketcher
Host 一个 Cordis 插件:五个工具 + 提示词段落 + 环境准备 + 那条路由
↑ ndjson 走 stdin/stdout
Python 一个常驻 worker,模型加载后一直留在内存里
```
Python 侧常驻是因为 SynOmega 加载模型要好几秒;每次调用都付这笔开销的话,路径规划根本没法用。
请求严格串行处理——推理不保证线程安全,并发只会让每个调用都更慢。
## 已知限制
- **正在跑的预测打断不了。** Python 推理没有安全的中断点,所以取消的调用会立刻结束,
它最终算出的结果被丢弃。如果一个被放弃的调用超过 `hardKillMs` 还没回来,worker 会被杀掉重启。
- **预测是排序过的候选,不是保证。** 正向预测 top-1 在基准上约 0.64;路线是提案,不是验证过的实验步骤。
- **首次调用要下几百 MB。** 断网、计费网络、或者要求可复现的环境里,
请先用 `scripts/setup.mjs` 预取,把下载当成一件需要明确同意的事。
- **分子画板是另一笔下载。** Ketcher 本身是个 30 MB 的浏览器应用;
它是首次使用时才取,而不是打包进插件,所以新装的环境要付一次这个代价,
完全断网的环境需要把 `ketcher.url` 指到本地副本。
- **逆合成是双用途技术。** 提示词段落把"什么是可以做的"这个判断交给部署自身的安全策略;
本插件不自行决定哪些请求可以满足。
## 许可
MIT。