
EasyRead
让你更舒服地读论文
导入 PDF,后台逐页翻译;公式、表格照原文排好,随时对照原文,边读边划线、记笔记、提问。
本地运行,文献库默认保存在电脑上,也可以放进你自己的网盘同步文件夹
简体中文 · English
▶ 在线试读一篇 · 项目主页 · 下载




## 它和“把 PDF 丢给翻译软件”有什么不一样
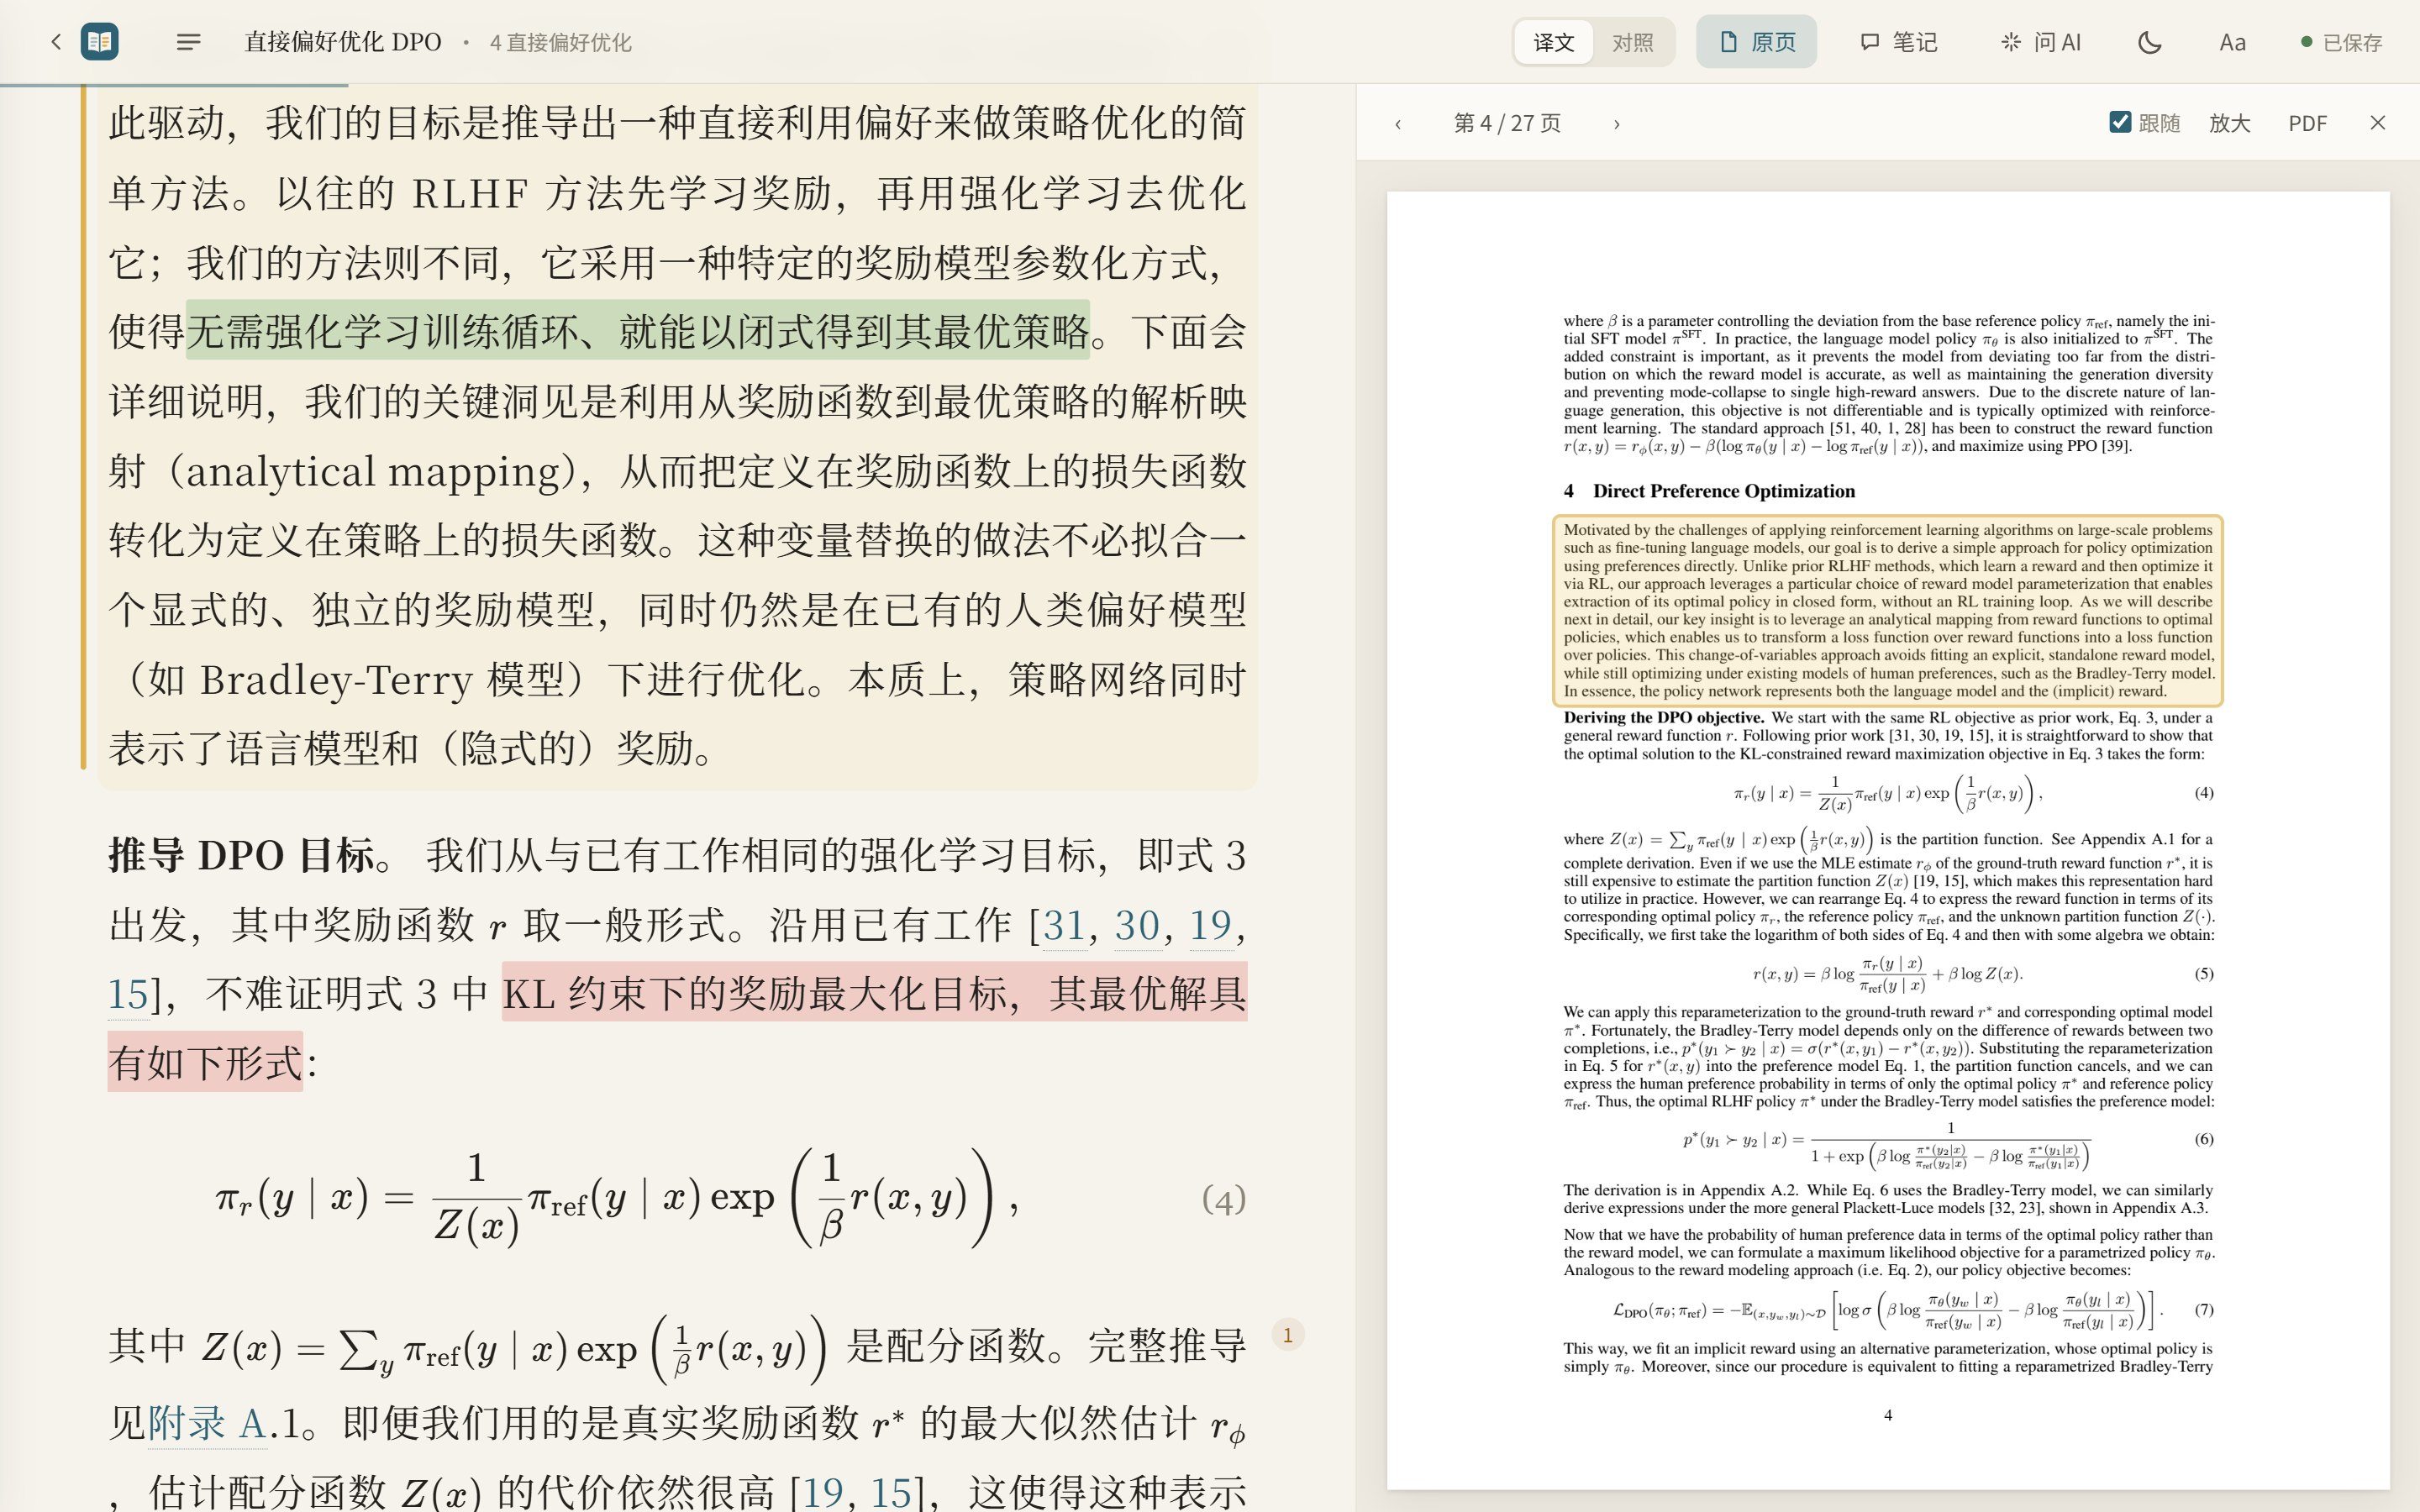
- **像读一本排好版的中文书。** 宋体正文、舒服的行宽和行距,公式用 KaTeX 按原文重排,表格是三线表,参考文献保留原文。顶栏一键切深色。
- **随时核对原文。** 一键切“对照”,每段下面附英文;右侧可以开原页,跟着阅读位置翻页,还会框出当前段落在原页的位置。
- **在论文里找内容。** 按 Ctrl / ⌘ + F 同时搜索原文和译文,显示匹配数、高亮结果,用 Enter / Shift + Enter 跳到下一处 / 上一处
- **翻译和解释分开。** 正文只放忠实的译文;AI 的解释、回答放在页边,一眼就能分清哪句是论文说的。
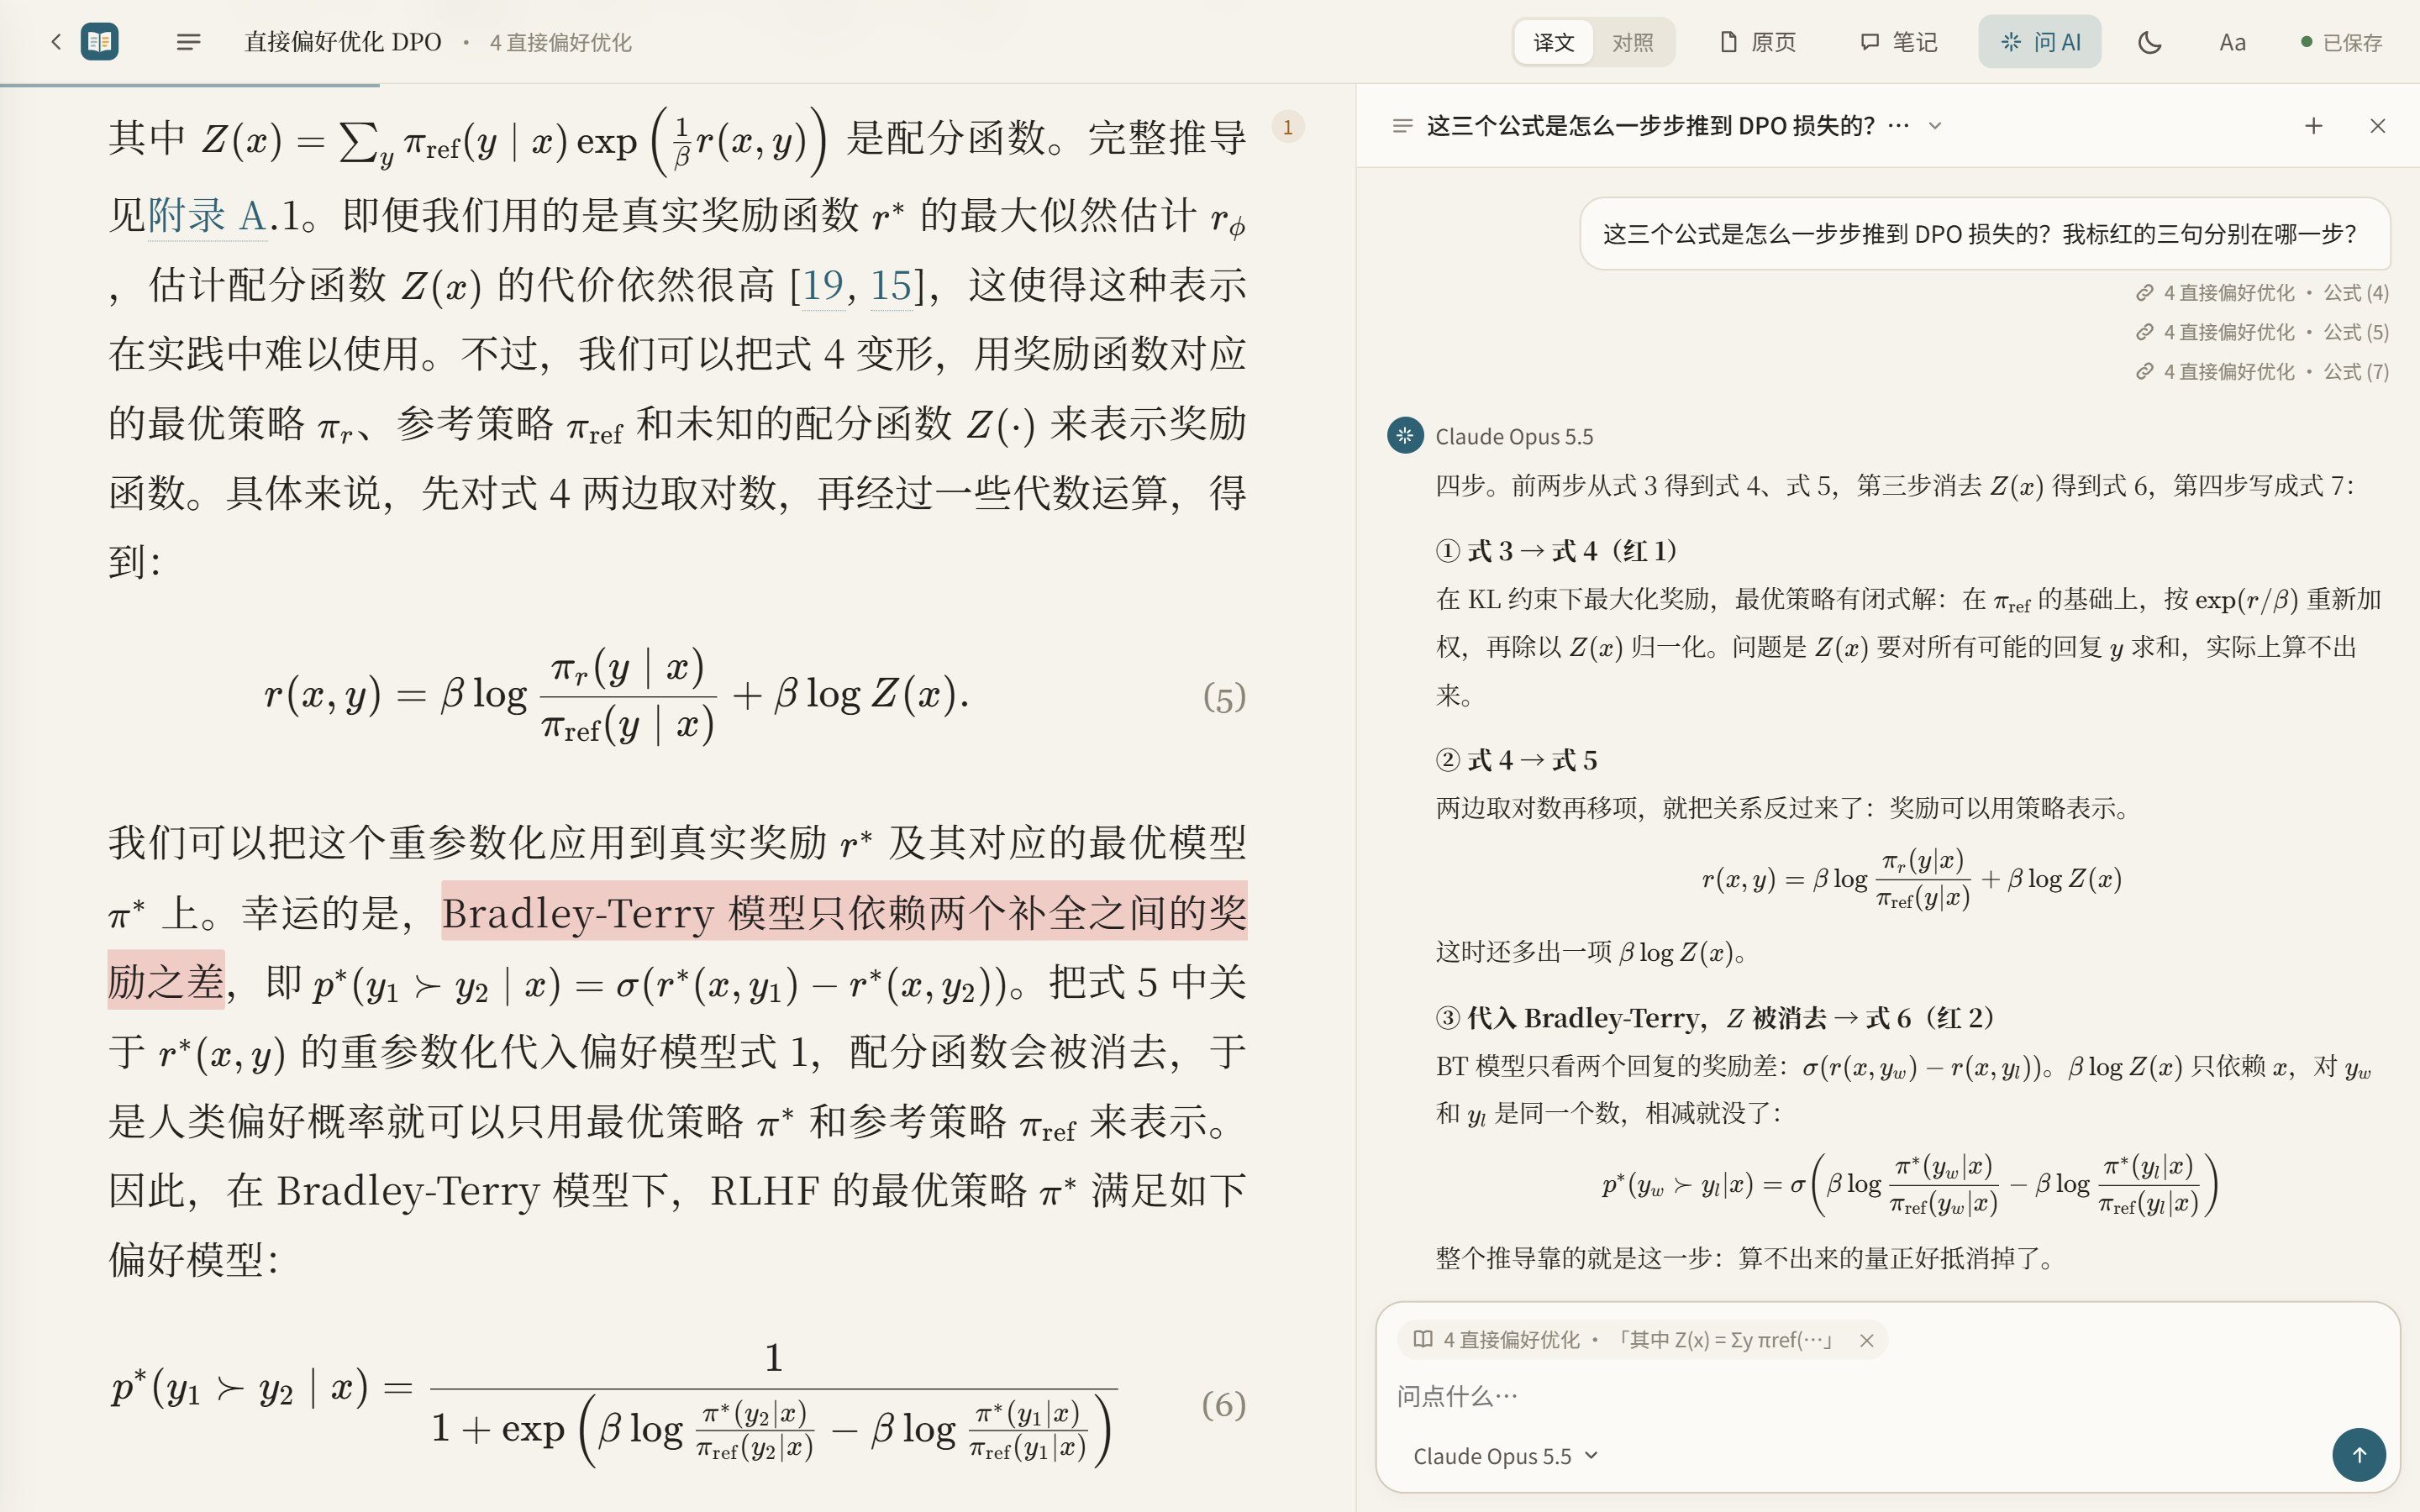
- **边读边问 AI。** 右侧“问 AI”面板实时对话,回答逐字流出来;可以一次引用好几段(选中文字拖进输入框就行)。问“我标红的那些公式有什么联系”,它会按颜色找出你的划线。可以开多个对话,模型单独选:Claude、GPT(Codex)、DeepSeek、通义、本机 Ollama……好的回答一键放到页边。
- **ASD-STE100 问答。** 在“问 AI”的“回答方式”里选择这个模式,用简明中文回答问题或总结论文,保留专业术语、公式和数值。模式按对话保存,支持复制、放到页边和导出 Markdown。[ASD-STE100](https://www.asd-ste100.org/STE_faq.html) 是英文标准;这个模式借鉴其短句、主动表达和术语一致等原则,提供中文写作辅助,不将中文答案标为符合英文标准或已认证。正文过长时只提供节选,回答需说明依据范围。
中文提示词另参考 [asd-ste100-skill](https://github.com/danyuchn/asd-ste100-skill) 的语义保留原则:保留条件、范围和“可能/建议/必须”等语气强度,不为简短而丢失精度。
- **精读问答。** “回答方式”里的第三档,适合想弄明白“作者为什么这么做、这个结论能撑多远”的时候:先还原作者要解决的问题,分清哪些设计拿掉就塌、哪些是顺手加的,把关键公式代进具体数字算一遍,再核对正文数字和图表、基线对照条件是否对齐。论文没报告的就直说没报告,不替作者补数字。和简明回答一样会把全文发给模型,用量更多。
- **边读边批注。** 选中文字四色荧光笔或下划线、写笔记、提问;问题一键让 AI 回答,笔记可以让 AI 点评。笔记面板按正文顺序汇总批注,可以筛选、滚动回看;点击卡片定位正文,点“编辑”才改笔记。通过缩略图选择或从正文拖拽,把图表关联到笔记,展开查看或修改图表名称;正文里的图表引用可以悬停预览。可以勾选导出成 Markdown(放进 Obsidian、Notion)
- **译文可以改。** 双击一段直接改;术语表里改一个译法,全文替换。
- **不只是 arXiv。** 拖进任何 PDF;或者填 arXiv 编号、DOI、论文标题、论文网页(OpenReview、ACL、NeurIPS、bioRxiv、PMC、期刊页面),自动找到公开的 PDF 并补全作者、年份、出处。
- **从 Zotero 搬过来。** 导入对话框里点“从 Zotero 迁移整个文献库”,自动找到 Zotero 的数据文件夹,把有 PDF 的论文连同分类(多级照样分层)、标题、作者、年份、期刊、DOI、摘要一起搬进来;只读 Zotero 的数据库副本,不改动 Zotero,可以重复迁移。也能“导入整个文件夹”:选一个放论文的文件夹,子文件夹的层级就是分类的层级。两种都在后台导入、可以中途停止,导入后不翻译,想读哪篇再译哪篇。
- **链接本地 PDF。** Zotero 和文件夹批量导入可勾选“链接本地 PDF,不复制原文件”,命令行可用 `--link`。原 PDF 留在原位,缓存、笔记和进度留在 EasyRead;删除论文不会删除原 PDF。链接需要原路径一直可访问,已有论文不会因重复导入而改变存储方式。[用法](docs/linked-local-pdfs.md)
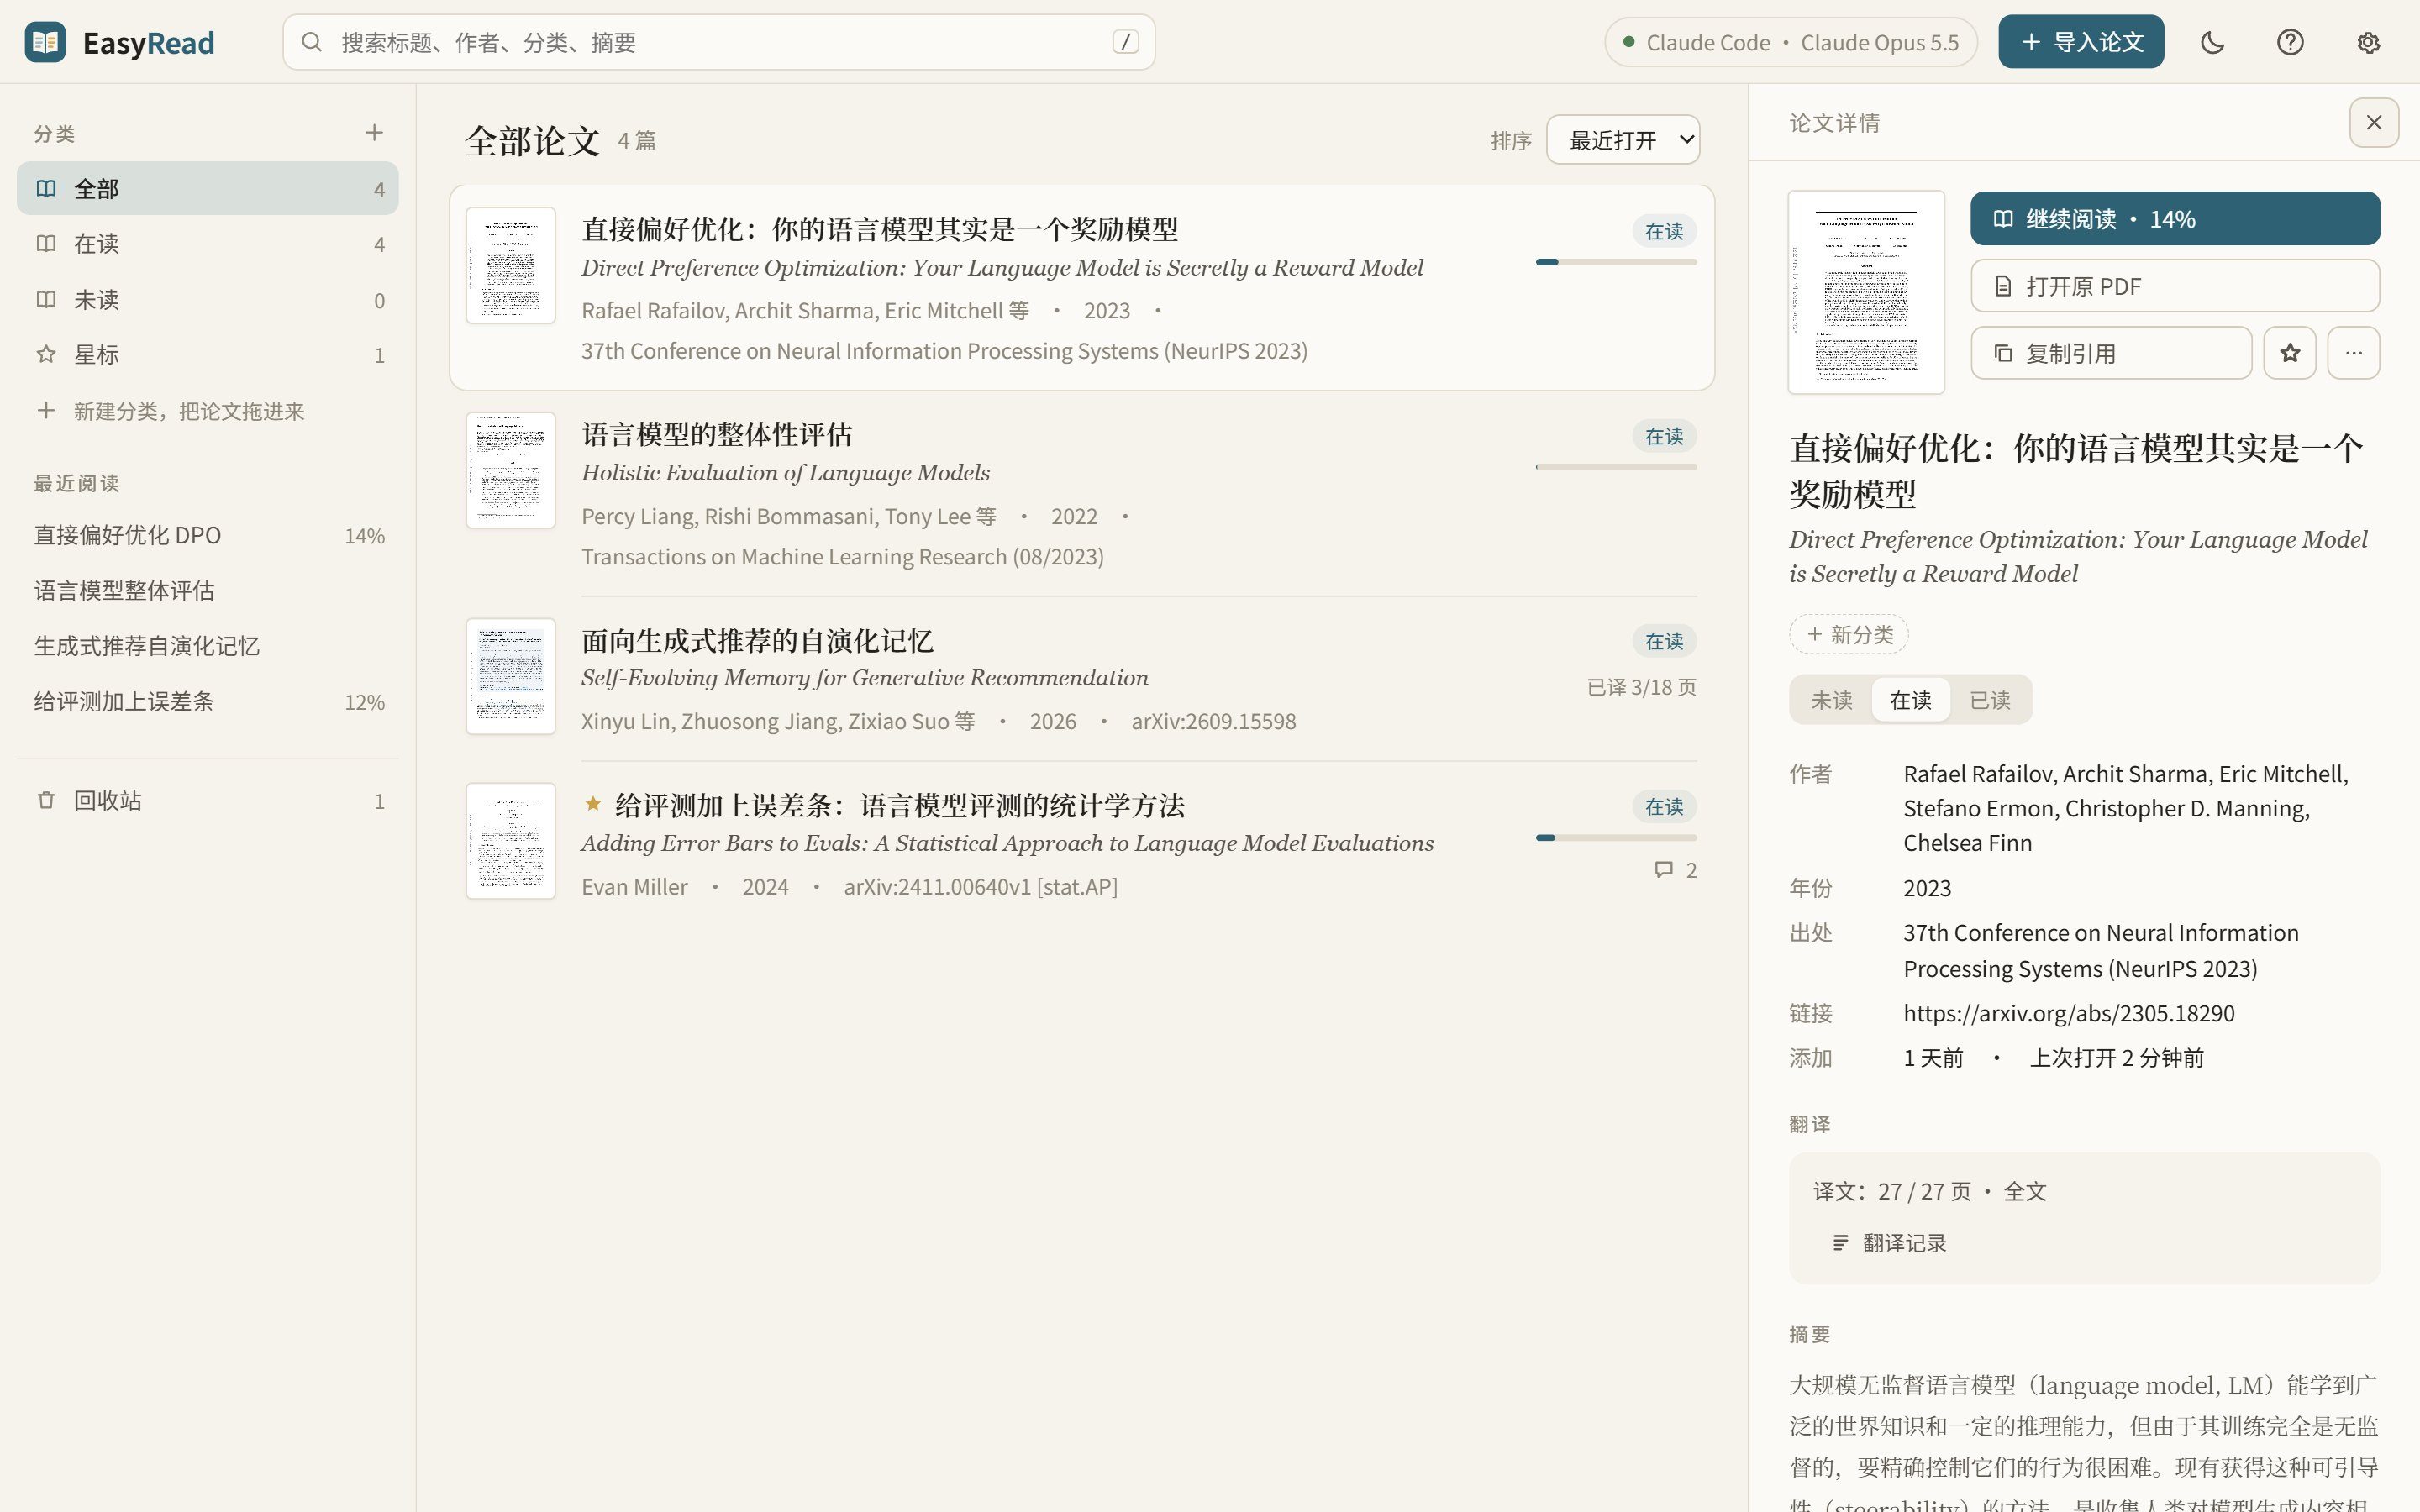
- **文献库。** 侧栏像聊天软件:论文和分类都能置顶;自己建分类(右键改名、删除,把论文拖进去),分类可以分层(右键“新建子分类”“移到…”,点父分类列出所有子分类的论文),内置分类可以隐藏;最近阅读、搜索、未读 / 在读 / 已读、星标、阅读进度、复制引用(GB/T 7714、APA、BibTeX)、导出单文件离线 HTML 发给别人,或者“导出手机版”(只读、体积小,传到手机上用浏览器打开)。删掉的论文先进回收站,可以恢复。快捷键可以自定义。
- **云文献库与批量引用。** 在“设置 → 云文献库”里把文献库迁移到其他磁盘或网盘同步文件夹,也能接入已有的库;原库保留,复制后核对,重启生效。论文列表和分类支持批量复制或保存 GB/T 7714、APA、BibTeX 引用
- **用了多少心里有数。** 每次翻译、每条 AI 回答都记下用了多少 token;用 Claude 订阅时,还能看到 5 小时 / 7 天额度用到多少、什么时候重置。
- **不会丢东西。** 每次修改先存在浏览器,本地服务确认写进文件才删;翻译方后来改了你改过的段落,只提示,不覆盖。
## 翻译用什么模型:你来选
| 引擎 | 要什么 | 说明 |
|---|---|---|
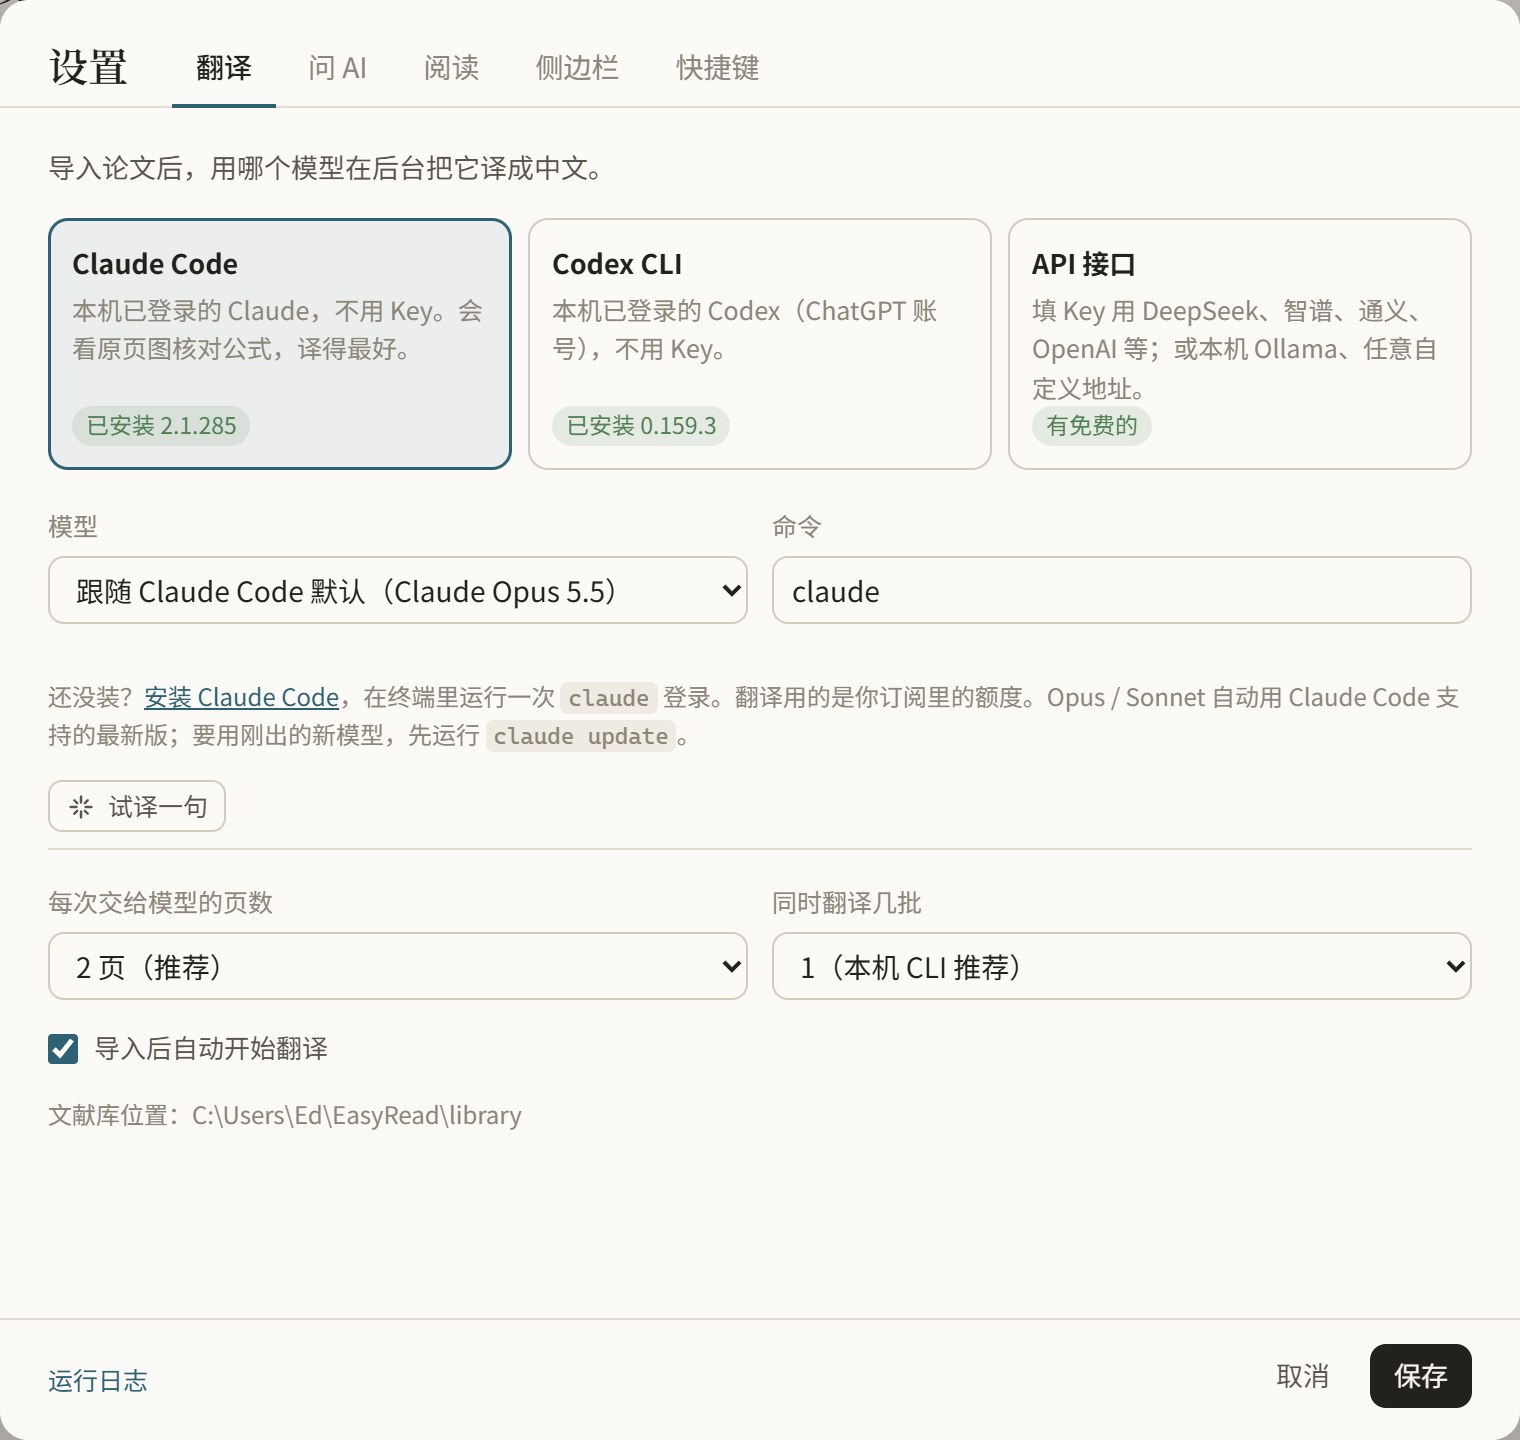
| **Claude Code**(推荐) | 装好并登录 [Claude Code](https://docs.claude.com/en/docs/claude-code/setup) | 不用 Key,用你订阅的额度;会自己看原页图核对公式,译文最好 |
| **Codex CLI** | 装好并登录 [Codex](https://github.com/openai/codex) | 不用 Key,用 ChatGPT 账号 |
| **CodeBuddy CLI** | 按[官方 CLI 文档](https://www.codebuddy.cn/docs/cli/headless)安装并登录,账号需有 CLI 使用权益 | 不用 Key;模型名自己填,留空用 CLI 默认模型。[当前免费体验版不含 CLI](https://www.codebuddy.cn/docs/workbuddy/Pricing),与 WorkBuddy 同账号共享积分 |
| **ZCode CLI(实验性)** | 按[官方 CLI 指南](https://github.com/zai-org/ZCode/tree/main/apps/zcode-cli/docs/usage)安装并登录,使 `zcode` 在 PATH 中可用 | 复用本机登录态;模型和推理选项在 ZCode 中选择。支持翻译、问 AI 和图片附件(需模型支持);真实账号调用尚待验证 |
| **Grok Build / Antigravity CLI / Cursor CLI** | 装好并登录 [Grok Build](https://x.ai/cli)、[Antigravity CLI](https://antigravity.google/docs/cli) 或 [Cursor CLI](https://cursor.com/docs/cli/installation) | 不用 Key,用各自的订阅;模型名自己填,留空用它的默认 |
| **API 接口 · 国内直连**:DeepSeek / 智谱 / 阿里云百炼 / Kimi / 硅基流动 / 魔搭 | API Key | 智谱 GLM-4.7-Flash、硅基流动小模型免费;DeepSeek 一篇 20 页论文几毛钱 |
| **API 接口 · 海外(要梯子)**:OpenAI / Anthropic / Gemini / OpenRouter / Groq / Cerebras | API Key | Gemini、OpenRouter、Groq、Cerebras 有免费额度 |
| **API 接口 · 本机**:Ollama / LM Studio | 本机装 [Ollama](https://ollama.com) 或 [LM Studio](https://lmstudio.ai) | 完全离线、免费,推荐 qwen3.5:9b(显卡小用 4b) |
| **API 接口 · 自定义地址**:任意 OpenAI 兼容接口、中转站 | 地址 + Key | Chat Completions 和 Responses 两种格式都支持;接口名称和地址可保存复用,Key 按地址分别保存;点“获取模型列表”从接口拉模型名 |
不想让它导入后马上翻译,在设置里关掉“导入后自动开始翻译”就行,之后可以让对话里的 agent 来译。
设置里会自动检测本机装了什么,点“试译一句”马上知道能不能用。某一页翻译失败(限流、网络、额度)会自动重试,还不行就先跳过、接着译后面的页,最后一键“重试失败的页”。
默认逐篇翻译,单篇内部仍可分段并发。在“设置 → 模型 → 翻译”中可将“同时翻译几篇”设为 1–4 篇,重启后生效。多篇并行会叠加分段并发,增加内存和模型限流风险,建议保持默认 1 篇;详见[配置说明](docs/paper-concurrency.md)
**生成译图(可选)**:在“设置 → 模型 → 翻译设置”打开“生成译图”,默认使用 **Codex 订阅**:需要安装支持内置生图的 Codex CLI,并使用 ChatGPT 登录,不需要另填 API Key。生图消耗订阅额度,具体限制见 [Codex 生图用量说明](https://learn.chatgpt.com/docs/pricing)。不可用或额度不足时,回退到原图和文字译文,**不会自动调用单独计费的 API**。也可主动选择“图片 API(单独计费)”,填写兼容 Images Edits 的地址、模型和 Key。
翻译先保存正文和图内文字,再按这篇论文的目标语言生成译图,尽量保留原图布局。图片沿用正文的“原文/译文/双语”设置:分别显示原图、译图或两者,双语顺序也同步。有可用译图时不重复展示图内文字译文;没有可用译图或加载失败时,显示原图和文字译文。离线导出保留相同的切换和兜底能力。功能默认关闭;开启后自动为后续翻译生图,并显示已有论文的补图入口。生成结果不保证逐像素保真,图表细节可与原图对照。
**已翻译论文补图或重新生图**:先在设置中开启“生成译图”,然后打开论文,在标题下点击“为本文生成译图”,只补齐缺失或已过期的译图;单张图片下可点击“生成译图 / 重新生成译图”,也可从图片右键菜单操作,无需重译正文。关闭开关时,这些入口和失败重试入口都会隐藏,已有译图保留;正在运行的任务仍可查看进度和取消。手动修改过的图内文字会作为生成参考;旧论文没有保存图内文字时,直接根据原图翻译。失败时保留已有图片、译文和笔记。
## 安装
**最省事:下载安装包**(不用装 Python)。在 [Releases](https://github.com/Edwardxlai/easyread/releases/latest) 下载:
- **Windows**:`EasyRead-Setup-x.x.x.exe`,双击安装。没有代码签名,如果弹出“Windows 已保护你的电脑”,点“更多信息 → 仍要运行”。
- **macOS**(Apple 芯片):`EasyRead-x.x.x-arm64.dmg`,把 EasyRead 拖进“应用程序”;第一次打开被系统拦截时,按下面对应的提示处理
- **Linux**:`EasyRead-x.x.x.AppImage`,`chmod +x` 后运行。
- 如果 Linux 提示缺少 `libfuse.so.2`,可按 [AppImage 官方说明](https://docs.appimage.org/user-guide/troubleshooting/fuse.html)配置 FUSE,或在独立目录运行 `./EasyRead-x.x.x.AppImage --appimage-extract`,再运行 `./squashfs-root/AppRun`;无需关闭沙箱
论文和设置存在哪:Windows 安装版在安装目录下的 `data` 文件夹(装在 D 盘就在 D 盘,更新和卸载都会保留);macOS、Linux 在用户目录下的 `EasyRead` 文件夹(和 pip 安装版同一个位置)。卸载重装不会丢。
以后升级:Windows、macOS 安装版和直接打开的 Linux AppImage 都可以在程序里更新,有新版本时顶栏会提示(也可以在右上角问号里手动检查),点“更新”,可以放到后台下载,下好后点“更新并重启”。解压运行的 AppImage 和从源码运行的照旧从 Releases 下载新版。macOS 和 Linux 从 1.3.2 及以前升级时,要先手动下载 1.3.3 一次;macOS 要把 EasyRead 放在“应用程序”里才能在程序里更新。
### macOS 首次打开
1. **提示“无法验证开发者”或“Apple 无法验证是否包含恶意软件”**:先点“完成”(不要点“移到废纸篓”),打开“系统设置 → 隐私与安全性”,向下找到安全性提示,点“仍要打开”;在确认窗口点“打开”,按提示输入登录密码或使用 Touch ID
2. **提示“已损坏,无法打开”**:先从 [EasyRead 官方 Releases](https://github.com/Edwardxlai/easyread/releases/latest) 重新下载,并把应用拖进“应用程序”;文件也可能确实损坏或被改动,不能只凭这条提示判断原因。只有确认文件来自这个官方仓库、并信任该文件后,才在“终端”执行下面的命令,再重新打开 EasyRead;这条命令移除隔离属性,不会修复损坏的文件
```bash
xattr -dr com.apple.quarantine /Applications/EasyRead.app
```
3. **为什么会出现验证提示**:目前的 macOS 安装包用的是项目自己的自签名证书(为了应用内更新),不是 Apple 开发者证书,也没有经过公证,因此可能被系统拦截;代码完全开源,也可以[从源码运行](#run-from-source)
如果系统提示“将损坏你的电脑”,或明确检测出恶意软件并要求移到废纸篓,请停止安装,不要用上面的步骤绕过;按 [Apple 官方说明](https://support.apple.com/zh-cn/102445) 处理
**或者从源码运行**:需要 [Python 3.10+](https://www.python.org/downloads/)。
先从 [Releases](https://github.com/Edwardxlai/easyread/releases/latest) 下载最新版的 zip 解压(或者 `git clone` 本仓库)。
**Windows**:双击 `start.cmd`。第一次会自动装好环境(一分钟左右),之后双击直接打开。
**macOS / Linux**:在解压出来的目录里运行
```bash
./start.sh
```
这样启动的,浏览器里的 EasyRead 页面全部关掉后,后台服务过十几秒会自己退出;还有翻译在跑的话,等译完再退。
每次推送都会在 Windows、macOS、Linux 上自动装一遍、跑测试、启动一次(见上面的“测试”徽章)。
**或者用 pip**(数据放在 `~/EasyRead`):
```bash
pip install git+https://github.com/Edwardxlai/easyread
easyread
```
浏览器会打开 `http://127.0.0.1:8765`。服务只监听本机。
## 桌面版(Electron)
桌面版复用同一套本地 Python 服务和 Web 界面,由 Electron 负责启动服务并显示窗口。开发环境需要 Node.js 22+、Python 3.10+ 和 PyInstaller:
```bash
npm install
python -m pip install pyinstaller
npm run dev
```
生成可分发安装包:
```bash
npm run dist
```
输出在 `dist/electron/`:Windows 为 NSIS 安装程序,macOS 为 DMG(另有一个给应用内更新用的 zip),Linux 为 AppImage。macOS 包由 `scripts/mac_sign.cjs` 用固定的自签名证书签名,证书从环境变量 `MAC_SIGN_P12`、`MAC_SIGN_P12_PASSWORD` 读(发版时来自仓库 Secrets);本机没设时退回临时签名,这样打出的包不能应用内更新。推送 `v*` 标签后,GitHub Actions 会在三个系统上构建,并把这些安装包自动附加到 GitHub Release;源码 zip 仍会由 GitHub 保留。打包后的文献库和设置:Windows 存在安装目录下的 `data`(安装目录写不进去时退回 `~/EasyRead`),macOS、Linux 存在 `~/EasyRead`。
## 怎么用
1. 右上角“设置” → “模型”:添加要用的模型,点卡片选“设为翻译”。翻译和“问 AI”用的模型都在这一页管理。
2. 把 PDF 拖进窗口;或者粘贴 arXiv 编号、arXiv / OpenReview 链接、PDF 直链(在文献库页面直接 `Ctrl+V` 也行)。长论文可以选“只译正文”,或者“指定页”只译第几页到第几页。导入时还能选这次用哪个模型;“导入后”选“读英文原文”就只排版、不翻译,想看中文了随时点“翻译成中文”。
整篇翻译默认超过 60 页时会先确认,可以选择全部翻译、只译前 60 页或先不译;上限在“设置 → 模型”里修改,填 0 表示不询问
3. 翻译在后台一页页进行,已译的部分马上能读,没译到的页先显示原页。一次导入超过 5 篇时会先问要不要全部翻译(默认只导入);想停下来,点列表顶部的“停止翻译”,已译的部分保留。
4. 读的时候点一下段落出现操作条;选中文字可以划线、写笔记、提问。快捷键在“设置 → 快捷键”里查看和修改;遇到问题点右上角的问号。
5. 论文默认译成中文,也可以在导入时选择繁体中文、英语、日语、韩语、西班牙语、法语、德语或意大利语,或在“设置 → 阅读 → 论文译成”里修改默认语言;界面语言独立设置,支持中文和英文,也可以跟随系统
## 和 AI agent 一起读
EasyRead 自带命令行,Claude Code / Codex 这类 agent 可以在对话里直接读你的笔记和问题、把回答写到对应段落旁边,也可以亲自翻译或重译某几页。技能说明在 [`skill/paper-reading/SKILL.md`](skill/paper-reading/SKILL.md),把这个目录放进 `~/.claude/skills/` 或 `~/.codex/skills/` 即可。
想让 agent 把一篇论文**讲透**而不是只译出来——还原作者真实的思考起点、把关键公式落到能自己算的例子、再把结论的边界查一遍——用 [`skill/paper-xray/SKILL.md`](skill/paper-xray/SKILL.md)。它读的是同一份 `library//`,谈出来的东西照样写成锚在段落旁的讨论条目。
```bash
easyread list # 列出文献库
easyread import 论文.pdf # 或 arXiv 编号 / 链接
easyread status ID # 进度、我改过的译文、笔记、待回答的问题
easyread discuss ID --from 回答.json # 把讨论写到页边
easyread export ID # 导出单文件离线 HTML
```
完整命令见 `easyread --help`,数据格式见 [docs/data-format.md](docs/data-format.md)。
## 常见问题
**能翻译成中文以外的语言吗?** 能,目前支持简体中文、繁体中文、英语、日语、韩语、西班牙语、法语、德语和意大利语。在“设置 → 阅读 → 论文译成”里修改默认语言,也可以在导入时单独选择;读德语、法语等非英语论文时也可以译成英语。不需要翻译时,可以直接读英文原文
**翻译到一半失败了?** 文献库里点这篇,右侧“翻译”一栏会写原因和失败的页,点“重试”。“翻译记录”里有每一批的详细情况;设置底部“运行日志”能看到服务本身的日志。
**用 Claude Code 要挂梯子吗?** 和你平时在终端里用 `claude` 一样:平时要,这里也要。不想折腾就在设置的“API 接口”里选智谱、硅基流动(都有免费模型)或本机 Ollama,国内直连。
**Claude Code 额度用完了?** 等额度恢复后点“重试”,或者在设置里临时换成 API / Ollama,已经译好的页不会重译。
**数据存在哪?** 默认保存在本机;在“设置 → 云文献库”里可以迁移到其他磁盘或网盘同步文件夹,上传和同步由你自己的网盘客户端完成。翻译和提问时,相关内容会发给你选择的模型。Windows 安装版在安装目录的 `data\library\`(1.3.1 及以前放在 `~/EasyRead`,升级后第一次打开会自动搬过去);从源码运行时在项目目录的 `library/`;pip 安装后在 `~/EasyRead/library/`。每篇论文一个文件夹,里面是原 PDF、原页图和几个 JSON(译文、你的笔记、AI 讨论、对话记录),设置和界面偏好在 `config.json`、`prefs.json`。可以直接备份或同步。为什么不用数据库见 [docs/data-format.md](docs/data-format.md#为什么用-json-文件而不是数据库)。
**能离线看、发给别人吗?** 能。文献库里右键一篇论文 → “导出离线 HTML”,得到一个单文件网页(命令行是 `easyread export ID`)。对方不用装 EasyRead,双击用浏览器打开就能读:译文、公式、原页图、你的划线和笔记都在里面,也能切对照、开原页、接着划线。原页图是打包进去的,所以文件不小(27 页的论文约 10 MB)。在离线版里新做的划线和笔记只存在打开它的那个浏览器里;想并回文献库,在左侧“说明”里点“导出我的修改”得到一个 JSON,再运行 `easyread merge ID --from 导出.json`。
想放到网站上(比如 GitHub Pages),用 `easyread demo ID --out 目录`:图片另存成文件、按需加载,还会带上问 AI 的对话记录(只能看)。
## 开发
没有前端构建:`easyread/web/` 下是纯 HTML/CSS/JS,改完刷新即可。后端只用 Python 标准库加 PDF 处理库。
```bash
python -m unittest discover tests # 翻译调度等单元测试
node tests/e2e.cjs library/<论文ID> # 浏览器端到端测试(需要 Playwright 和一篇已译好的论文)
```
设计取舍见 [docs/design.md](docs/design.md),版本变化见 [CHANGELOG.md](CHANGELOG.md)。
## 许可
MIT。公式渲染用 [KaTeX](https://katex.org)(MIT)。
在线演示用的论文是 Rafailov 等人的 *Direct Preference Optimization: Your Language Model is Secretly a Reward Model*([arXiv:2305.18290](https://arxiv.org/abs/2305.18290),CC BY 4.0),中文译文由 EasyRead 调用 Claude 生成,演示里的划线和笔记是示例。
## 贡献者
- [@Wang-auspicious](https://github.com/Wang-auspicious) — Electron 桌面版打包与发布流程;论文精读技能 paper-xray([#40](https://github.com/Edwardxlai/easyread/pull/40));问 AI 的“精读”回答方式([#41](https://github.com/Edwardxlai/easyread/pull/41))
- [@bisuwuss-netizen](https://github.com/bisuwuss-netizen) — 修复桌面安装包漏打 PDF 依赖、双栏论文原页定位;“问 AI”和笔记里的 Markdown 表格与引用块;模型 JSON 解析、学术阅读提示词与多篇论文并行翻译([#64](https://github.com/Edwardxlai/easyread/pull/64),默认 1 篇,可手动开启至 4 篇)
- [@MeshedPoto](https://github.com/MeshedPoto) — 并行翻译时 PDFium 随机报错、跨栏段落原页高亮、macOS 桌面版稳定性、HTTPS 证书与流式回答的一批修复;v1.3 的 ASD-STE100 中文问答和公式显示修复;v1.3.1 的图片裁剪修复([#22](https://github.com/Edwardxlai/easyread/pull/22))
- [@Lzy22301093](https://github.com/Lzy22301093) — 异常表格校验与渲染修复,避免单个表格导致整篇译文空白([#17](https://github.com/Edwardxlai/easyread/pull/17))
- [@NGman-s](https://github.com/NGman-s) — 整页都是上一页续文时不再误报翻译失败([#30](https://github.com/Edwardxlai/easyread/pull/30))
- [@TWwWT1](https://github.com/TWwWT1) — 裁切分页 PDF 导入时内存暴涨([#28](https://github.com/Edwardxlai/easyread/issues/28))、打开时卡在加载中([#35](https://github.com/Edwardxlai/easyread/issues/35))的补丁
- [@kevin9327](https://github.com/kevin9327) — 网页元数据里的撇号不再截断标题和作者名([#37](https://github.com/Edwardxlai/easyread/pull/37))
- [@Zhoushuren12](https://github.com/Zhoushuren12) — 文献库后台刷新时列表不再上下跳动([#43](https://github.com/Edwardxlai/easyread/pull/43))
- [@02Ychase](https://github.com/02Ychase) — 论文里有代码时翻译不再整批失败([#44](https://github.com/Edwardxlai/easyread/pull/44));删除正在翻译的论文后后台队列不再卡住([#56](https://github.com/Edwardxlai/easyread/pull/56))
- [@88lin](https://github.com/88lin) — 图按原页大小显示,不再一律撑满版心([#47](https://github.com/Edwardxlai/easyread/pull/47))