


Website ·
Discord ·
English · 简体中文 · 繁體中文 · Italiano · 日本語
**小さなエンジン、巨大なモデル。** ストレージ・RAM・VRAM を単一の推論階層として扱う
(AI メモリのマルチティア化)ことで、**744B から 2.8T パラメータのフロンティア MoE モデル**を、
コンシューマー向けや異種混在のハードウェア上で、エンジン依存ゼロの純粋な C で実行します。
現在動作するのは 9 つのファミリーです: **GLM-5.2/5.3**(744B)、**GLM-5.3-Flash**(321B、
ビジョン対応)、**Inkling**(975B)、**Kimi K3**(2.8T)、**DeepSeek V4 Flash**(284B)、**DeepSeek V4.1 Flash**(552B、ビジョン対応)、
**Qwen3.8-Flash-Next**(125B + 51B n-gram)、**Qwen3.6**(35B-A3B)、そして
**OLMoE**(7B)——
それぞれが C ファイル 1 つで、同じ `coli chat` / `coli serve` / `coli web` フロントエンドを共有します。
[全モデル一覧 ↓](#other-supported-models)
> **Colibrì は今日すぐに動かせる推論エンジンであり、同時にオープンな研究
> プラットフォームでもあります。** 主な目標は、ソフトウェアとハードウェアの境界全体——
> モデルフォーマット、メモリ階層、ストレージ I/O、配置、スケジューリング、カーネル、
> 投機的デコード、CPU/GPU のオーバーラップ——にわたって推論側の性能を追求し、
> 大規模モデルが希少なハードウェアに依存せず、より低コストで動くようにすることです。
Colibrì は VRAM・RAM・ストレージを単一のマルチティア階層として扱い、意図的に
攻めたシステム上のアイデアを試す場となっています。そのため **速度に SLA はありませんが、
セマンティクスは厳格に保証します**。実験は再現可能なエンドツーエンドの計測によって
採用に値することを示さなければならず、デフォルトのポリシーは **モデルの精度やルーターの
セマンティクスを黙って変更することは決してありません**。高速メモリが不足すると速度は
落ちるかもしれませんが、それによってモデルが密かに別物になることはあってはなりません。
```
$ ./coli chat
🐦 colibri v1.12.1 — GLM-5.2 · 744B MoE · int4 · streaming CPU
✓ ready in 32s · resident 9.9 GB
› ciao!
◆ Ciao! 😊 Come posso aiutarti oggi?
```
## 動作の様子
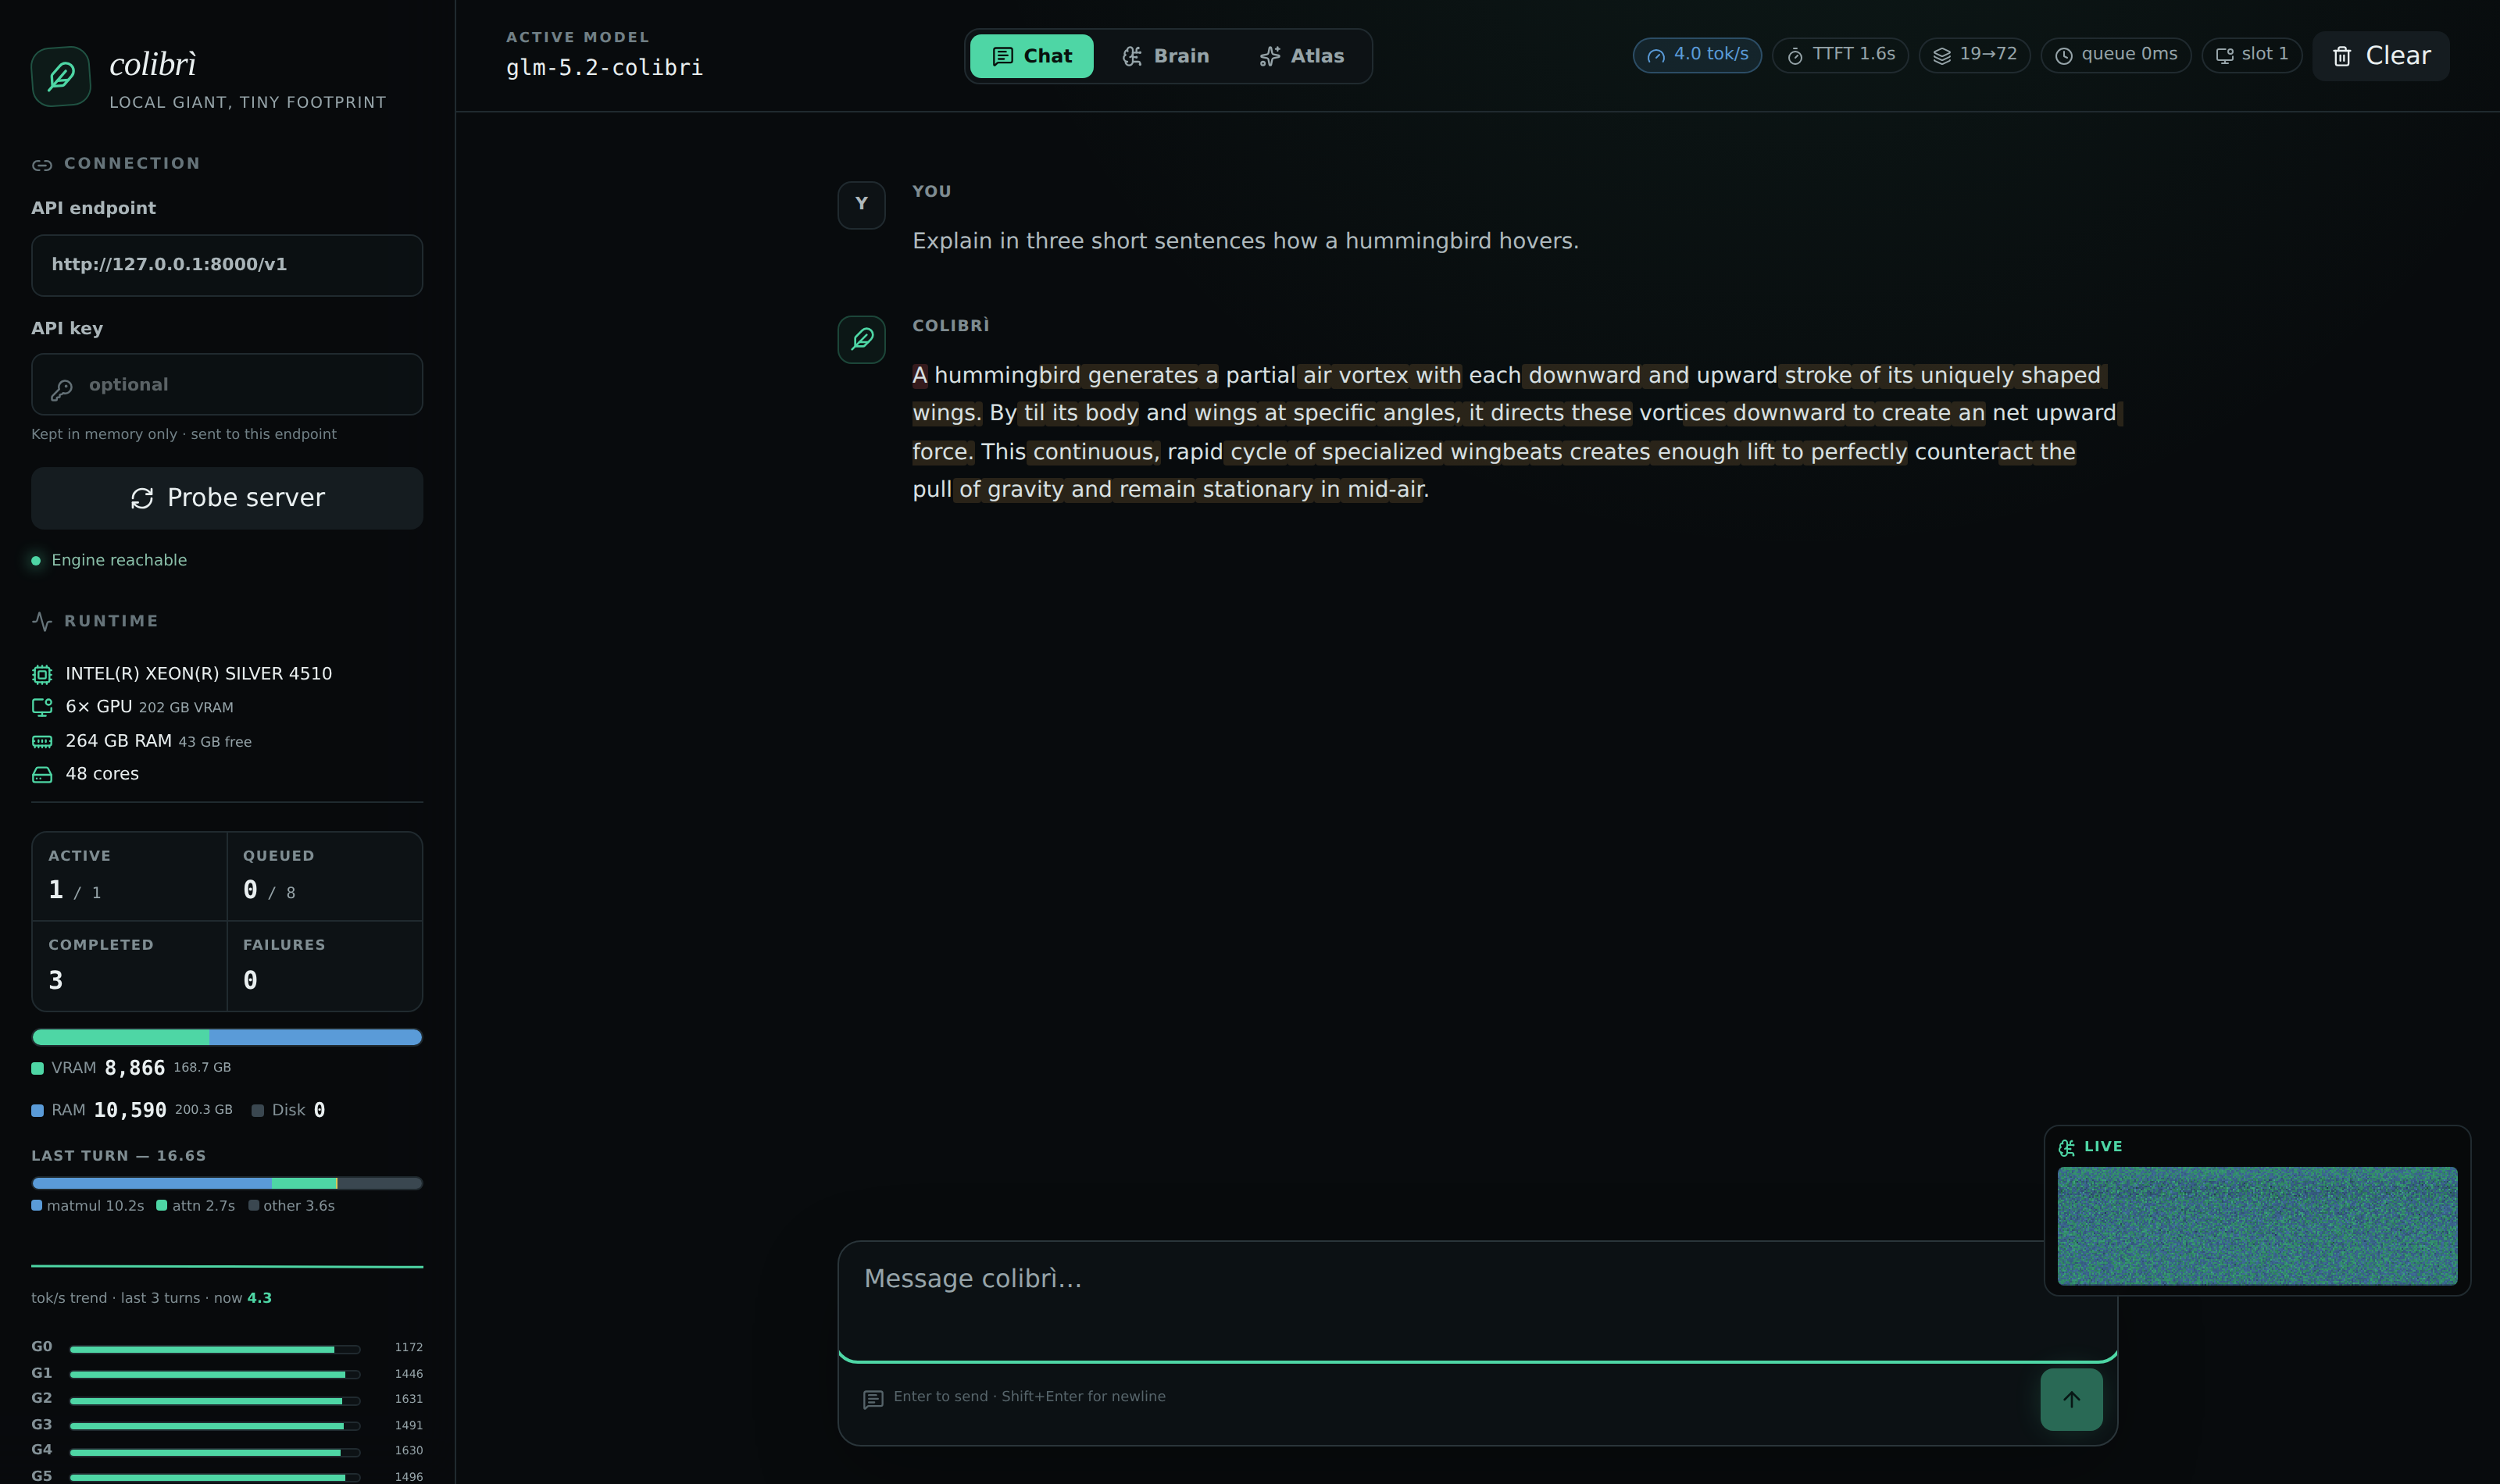
Web ダッシュボード(./coli web): 744B モデルが 4 tok/s、TTFT 1.6 秒、ディスク 0 で動作 —
6× RTX 5090 上でエキスパートを完全常駐させ、ライブのトークンメトリクス、ターンごとの時間内訳、
VRAM/RAM/ディスクのティアバー、隅にはライブのミニ脳を表示しています。
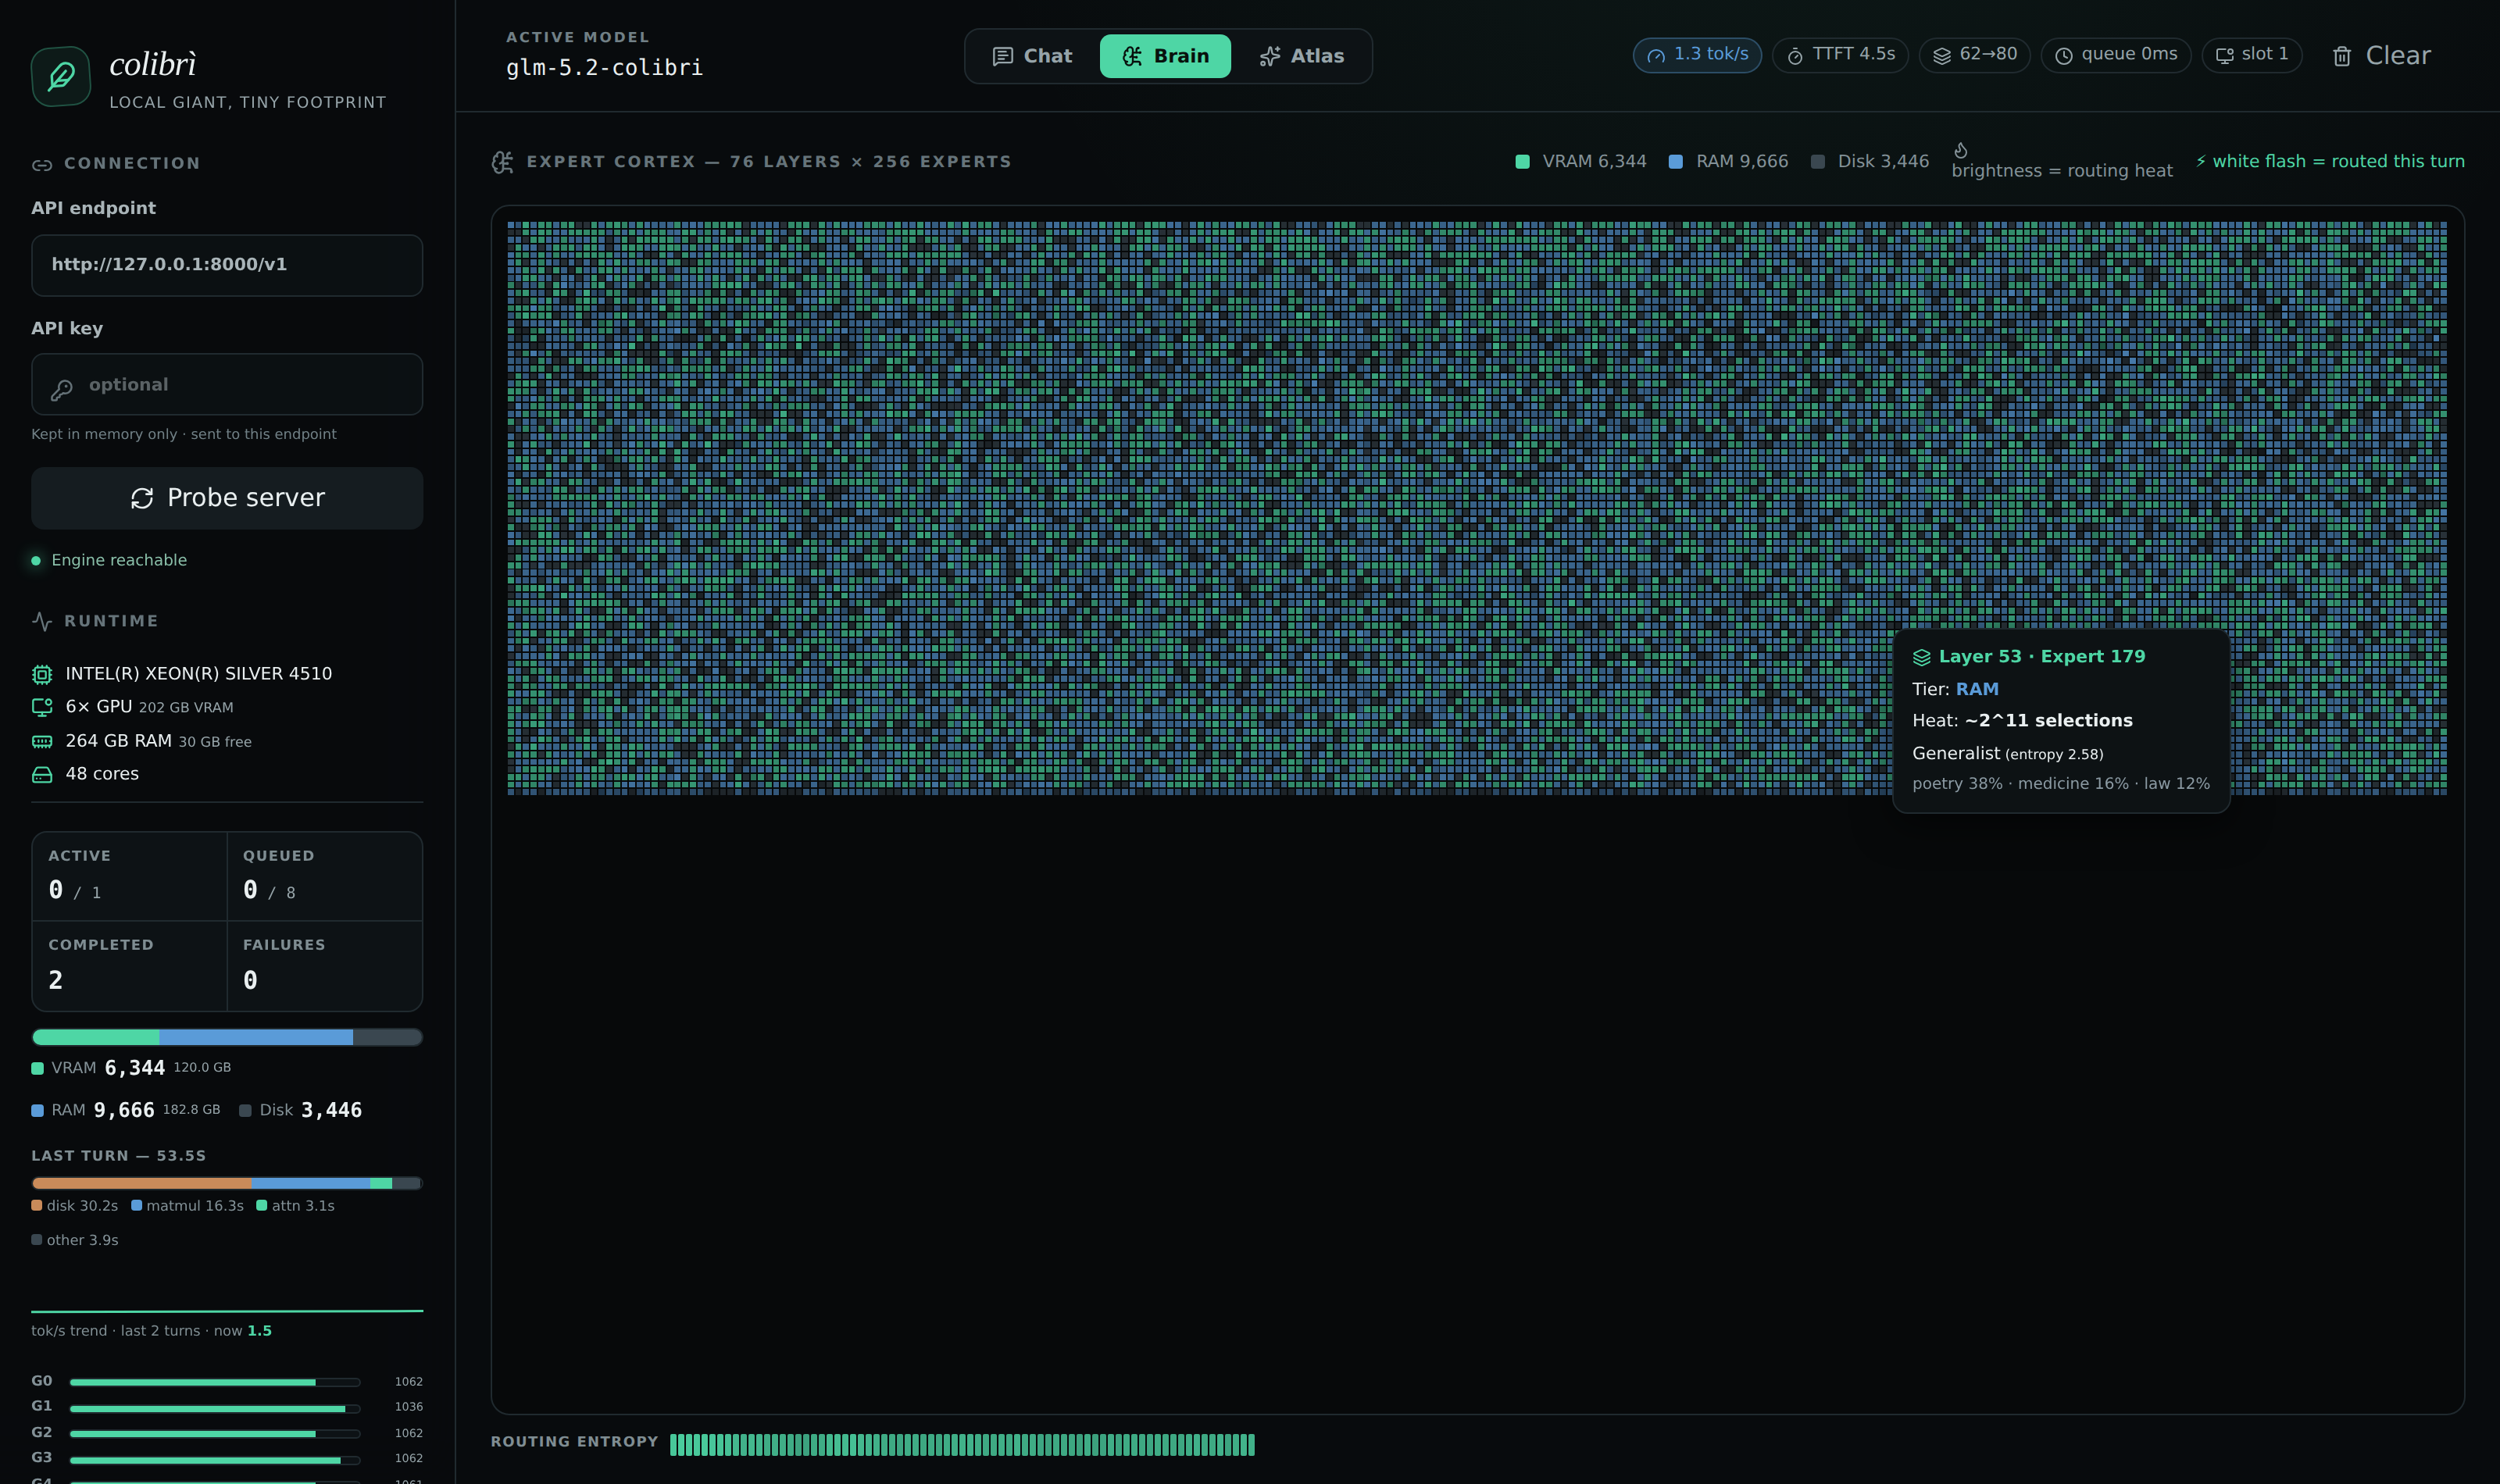
Brain ページの Explore 表示: GLM-5.2 の計測されたエキスパートアトラスを皮質として描画します。
特性が明らかになった 13,260 個のエキスパートが 10 の領域(Python、SQL、数学、詩、法律、中国語…)に分かれ、位置は学習された埋め込みではなく
計測されたルーティング親和性です。領域を選ぶとその中に入れます。Live routing 表示は実際に動いているモデルに切り替わり、
エキスパートごとに 1 セル、色はストレージのティア、1 ターンでルーティングされたエキスパートは白く光ります。
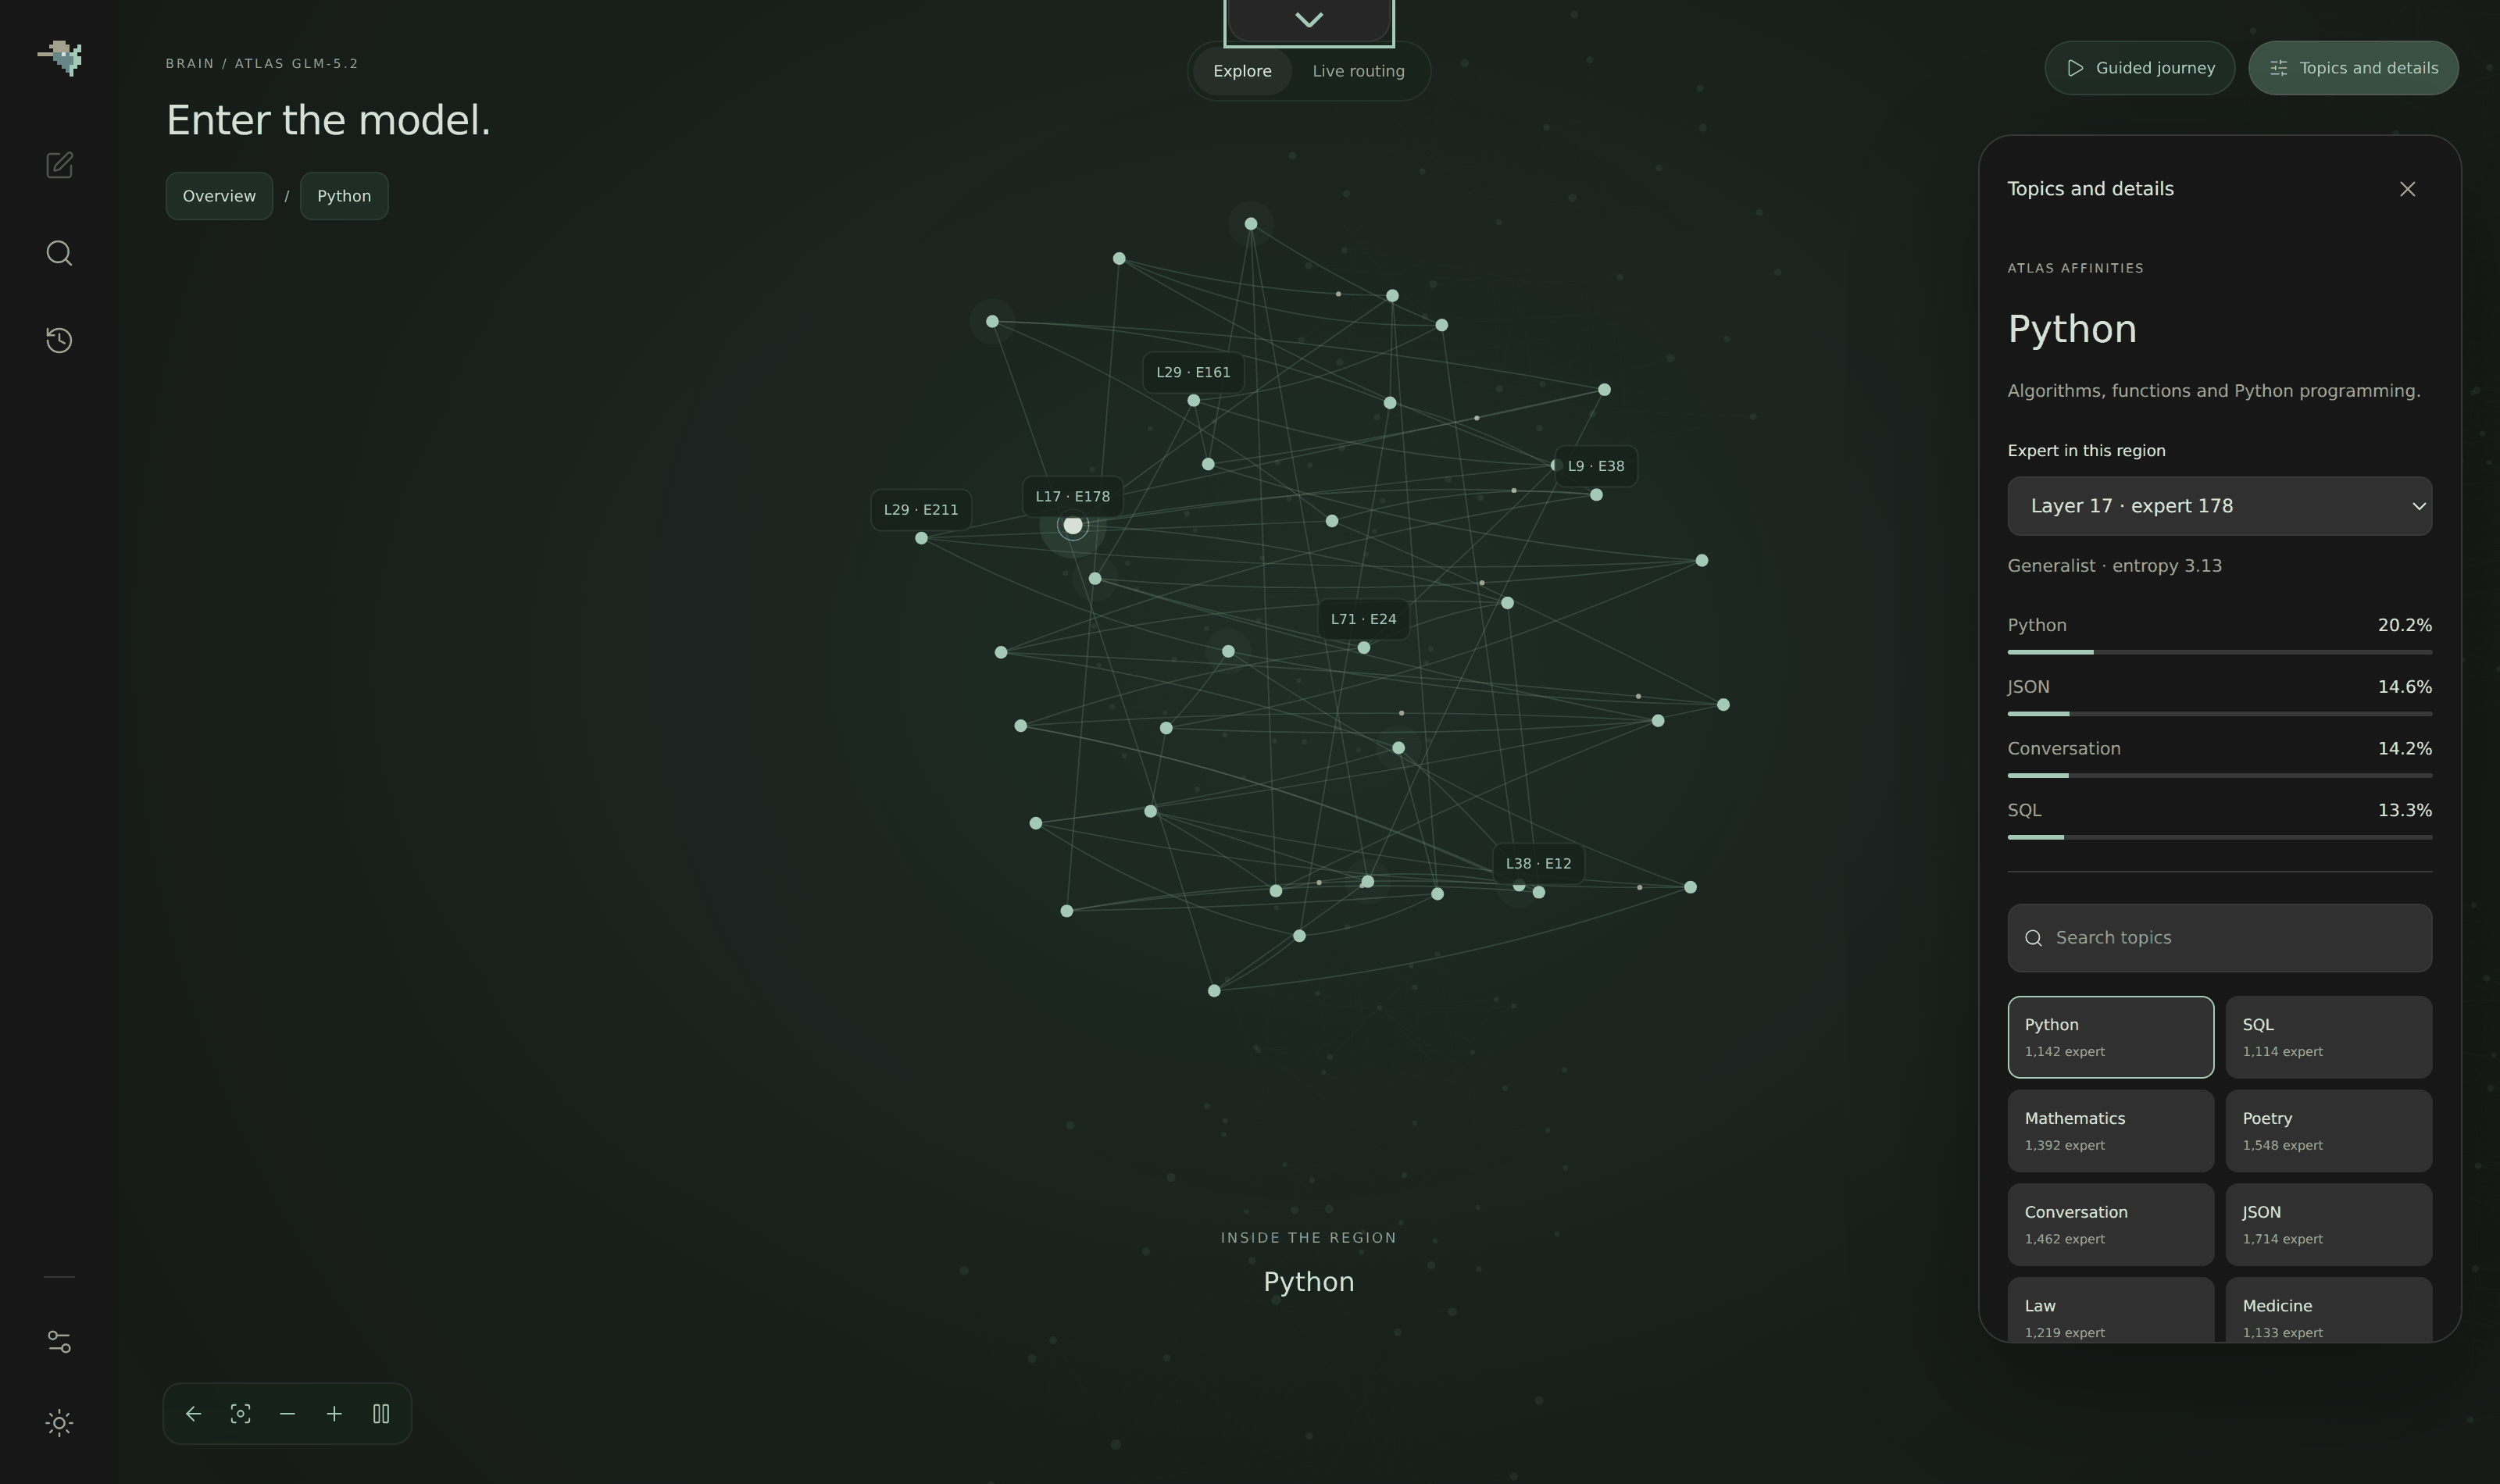
Python 領域の内部: 1,142 個のエキスパートが星座として並び、それぞれにレイヤーと番号のラベルが付きます。パネルはその 1 つ、
レイヤー 17 のエキスパート 178 を表示しています。エントロピー 3.13 のジェネラリストで、計測された親和性は Python 20.2%、JSON 14.6%、
会話 14.2%、SQL 13.3% です。
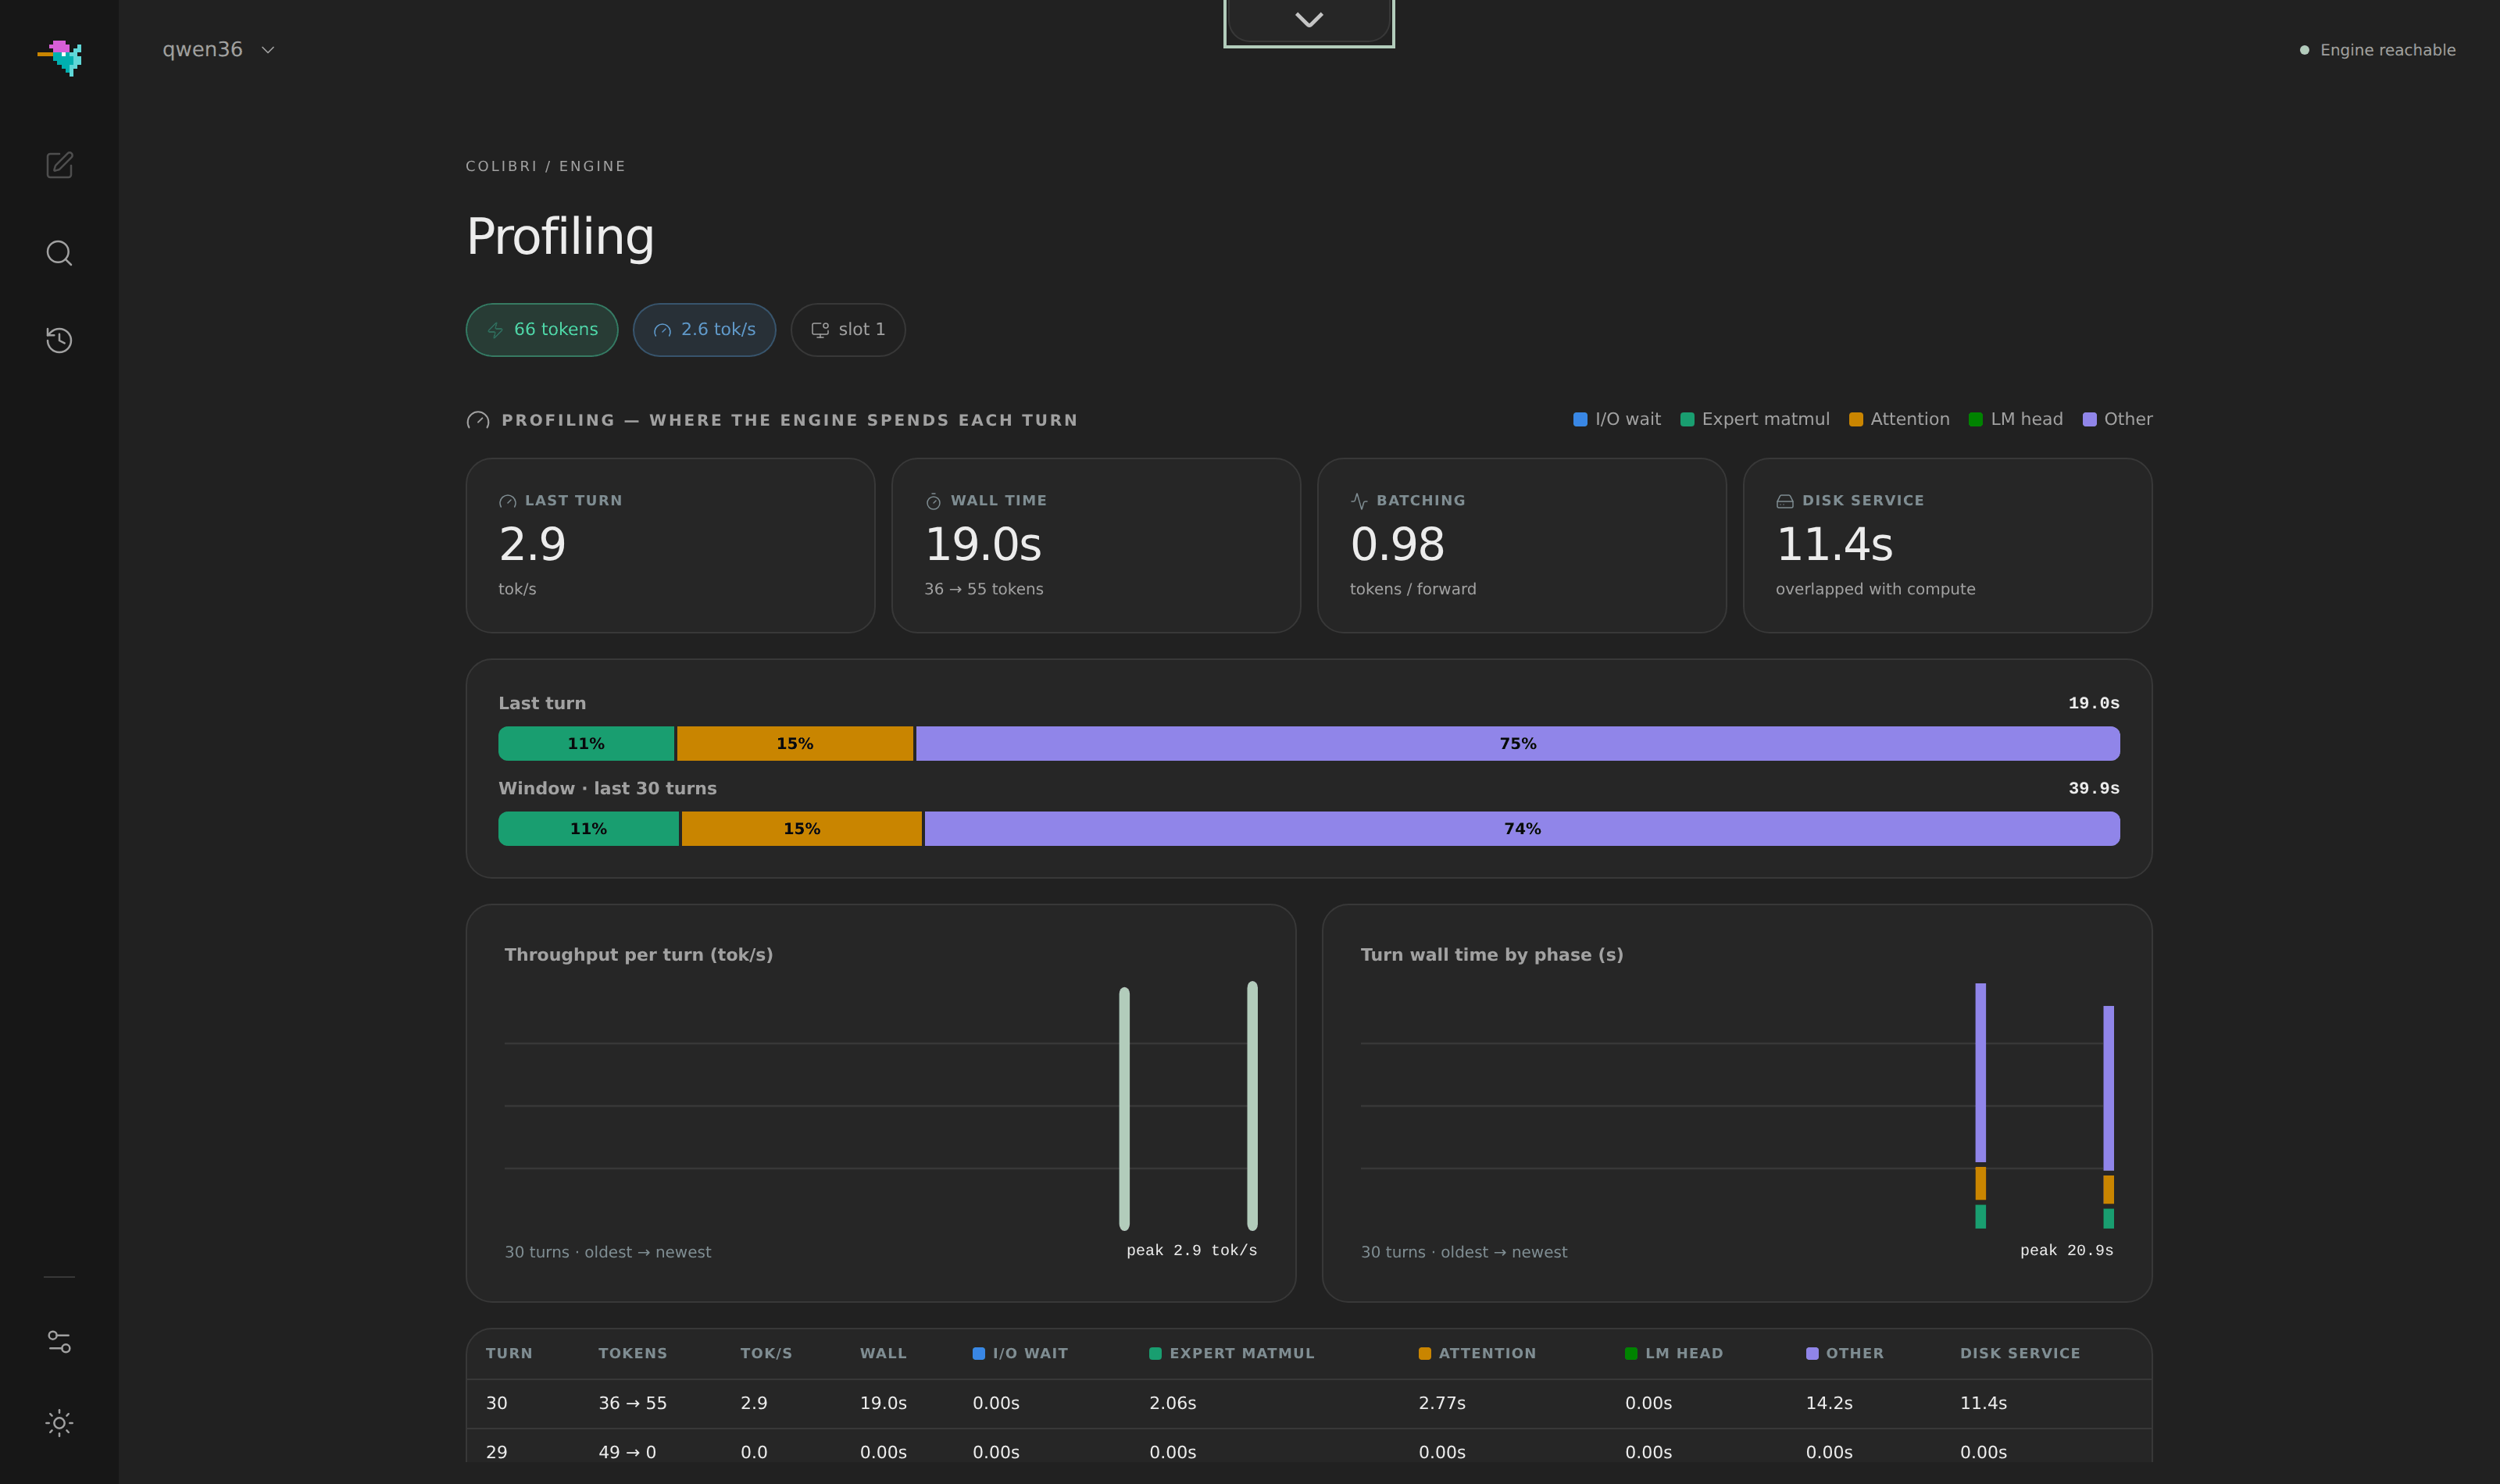
Profiling ページ: エンジンが各ターンで時間を使う場所をフェーズごとに示し、直近 30 ターンを推移として表示します。
ここでは CPU マシン上の Qwen3.6: プロンプト 36 トークンと生成 55 トークンで壁時計時間 19.0 秒、2.9 tok/s、
ディスクサービス 11.4 秒は計算と重なっています。
## 研究のミッション
Colibrì があれば、プライベートなフロンティアモデルへのアクセスが、ハイパースケーラー級ハードウェアの入手可能性に制限されることはありません。
マルチティア機能によって、Colibrì は **推論エンジンのパイプラインを積極的に最適化し、
プロプライエタリなハードウェアへの依存を取り除きます**。
私たちの実務上のミッションには、重みの表現方法と移動方法を変えること、何を VRAM・RAM・
ストレージに置くかを決めること、異種計算資源をオーバーラップさせること、起動と同期の
オーバーヘッドを減らすこと、スパース性と再利用を活用すること、そして新しいデコード
アルゴリズムを試すことが含まれます。慣習的だからという理由だけで守られるものはなく、
マイクロベンチマークで速く見えるという理由だけで採用されるものもありません。決め手となるのは
実機でのエンドツーエンドの推論結果であり、スループット、レイテンシ、メモリ、コストと
並んで、正しさと品質も計測されます。
その実際的な帰結が **アクセシビリティ** です。すでに持っているハードウェアで
744B パラメータのモデルを動かし、すべてのエキスパートが発火する様子をリアルタイムで眺め、
それを実現しているコードを変更できます。API の向こうにある知能を借りるのではなく、
それを *手にする* ——調べ、計測し、改善する——のです。エンジンは意図的に小さく保たれており、
次の有用な最適化は、それを計測しようとする誰からでも生まれ得ます。
## コア技術と計測結果
- **ティア容量に縛られない単一の階層。** VRAM・RAM・NVMe は同じ重みを置く配置ティアです。
高速メモリの制約は速度を変えるだけで、モデルのセマンティクスは変えません。
- **重みのための JIT。** すべてのエキスパートをロードする代わりに、計測されたルーティングの熱量が
レイヤーごとの LRU、学習されたピン留めホットストア、1 レイヤー先のプリフェッチを駆動します。
繰り返しのあるワークロードでは効果がありますが、履歴は過学習し得るし、先読みは一部の
ホストでは逆効果になり得るため、どちらも約束ではなく計測可能なポリシーとして扱われます。
- **I/O はエンジンの一部。** バッチ化されたエキスパートの和集合、読み込みと計算のオーバーラップ、
`O_DIRECT`、重み付きデュアル SSD ストライピングによって、ストレージのレイテンシが
タダであるかのように装うのではなく、ストリーミング経路そのものに取り組みます。`O_DIRECT` は
ドライブ依存であり、デュアル SSD はまだより幅広いコミュニティによるエンドツーエンドの A/B を必要としています。
- **異種混在実行。** CPU、CUDA、Metal、NUMA メモリ、部分的または完全なエキスパート常駐は
1 つのランタイムを共有し、マシンに応じて組み合わせられます。どの組み合わせが有利かは、
計算能力、帯域幅、常駐状況、ワークロードによって決まります。
- **別のモデルにすることなく状態を圧縮。** トークン単位で完全一致するフォワード検証、
57 分の 1 に縮小された MLA KV 状態、永続化されたウォームな会話、忠実な DSA により、
最適化を正しさに結び付けています。これらはメモリ・レイテンシ・正しさの特性であり、
一律のスループット向上を主張するものではありません。
- **元が取れる場合にだけ使う投機的デコード。** ネイティブ MTP と文法強制ドラフトは
エンドツーエンドで計測され、受理率が検証コストに見合わない場合は無効化できます。
## 未検証の仮説、実験、そして協力の方法
Colibrì は、制御されたエンドツーエンドの A/B が示すまで、最適化を仮説として扱います。
現在の主な問いは次のとおりです:
| 仮説 | これまでのエビデンス | まだ必要な実験 |
|---|---|---|
| ルーティング履歴は単純な LRU よりもうまくエキスパートを配置できる | 学習されたピンは繰り返しのワークロードを改善するが、プロンプトに過学習し得る | コーディング、チャット、多言語、長コンテキストのワークロードにわたる、ホールドアウトかつセッション横断の A/B |
| 複数の SSD は独立した帯域幅をデコード速度に変えられる | 重み付きミラー/分割ルーティングは実装・検証済みで、帯域幅モデルは妥当 | 実際に独立したコントローラ上での、コールドキャッシュ状態の 1 ドライブ対 2 ドライブによる GLM-5.2 実行 |
| ハードウェアを考慮したプランナーは、各マシンの最適構成に自動で近づける | RAM/VRAM の予算といくつかのバックエンドは現在すでに検出される | 生成されたプランを、ラップトップ、ワークステーション、NUMA ホスト、マルチ GPU システムにわたる制御されたパラメータスイープと比較する |
| ロスレスまたは品質上限付きの表現で、重みの移動を意味のあるほど減らせる | 正しさ/品質ゲート付きのフォーマットと量子化のアブレーションが存在する | 圧縮率だけでなく、品質、移動バイト数、レイテンシ、有用トークンあたりのコストを同時に再現する |
| ルーティングを考慮した投機的デコードは、ほぼ完全常駐に達する前でも元が取れる | MTP と文法ドラフトは動作するが、MTP はエキスパートヒット率約 85% 付近で 32% の損失も計測されている | 受理率、エキスパートヒット率、バッチの和集合、ドラフト深さにわたる損益分岐面をマッピングする |
| CPU/GPU のオーバーラップは、ボトルネックを移すだけでなく転送と同期を隠蔽できる | CUDA と Metal での改善はあるが、高速な CPU や低い常駐率ではそれが打ち消され得る | PCIe、ユニファイドメモリ、完全常駐マシンにわたる、ステージごとのプロファイルと 1 変数ずつの A/B |
協力したいですか? いずれかの行を選び、ネガティブな結果も公開してください。ハードウェア、
コミット、モデル/コンテナ、正確なコマンド、プロンプト、キャッシュ状態、スループット、
TTFT、エキスパートヒット率、読み込みバイト数、品質チェックを記録し、1 つの変数だけを変えて
再実行し、生のログを添付してください。まずは
[CONTRIBUTING.md](CONTRIBUTING.md) から始め、
[ベンチマークプロトコル](docs/benchmarking.md) と比較したうえで、
[実験 issue を作成](https://github.com/JustVugg/colibri/issues/new) してください。
ここでは、説明のつかない速い数値よりも、よく制御された失敗のほうが価値があります。
## アイデア
744B の Mixture-of-Experts モデルは、1 トークンあたり約 40B のパラメータしか活性化せず、
そのうちトークンごとに入れ替わるのは約 11 GB(ルーティングされるエキスパート)だけです:
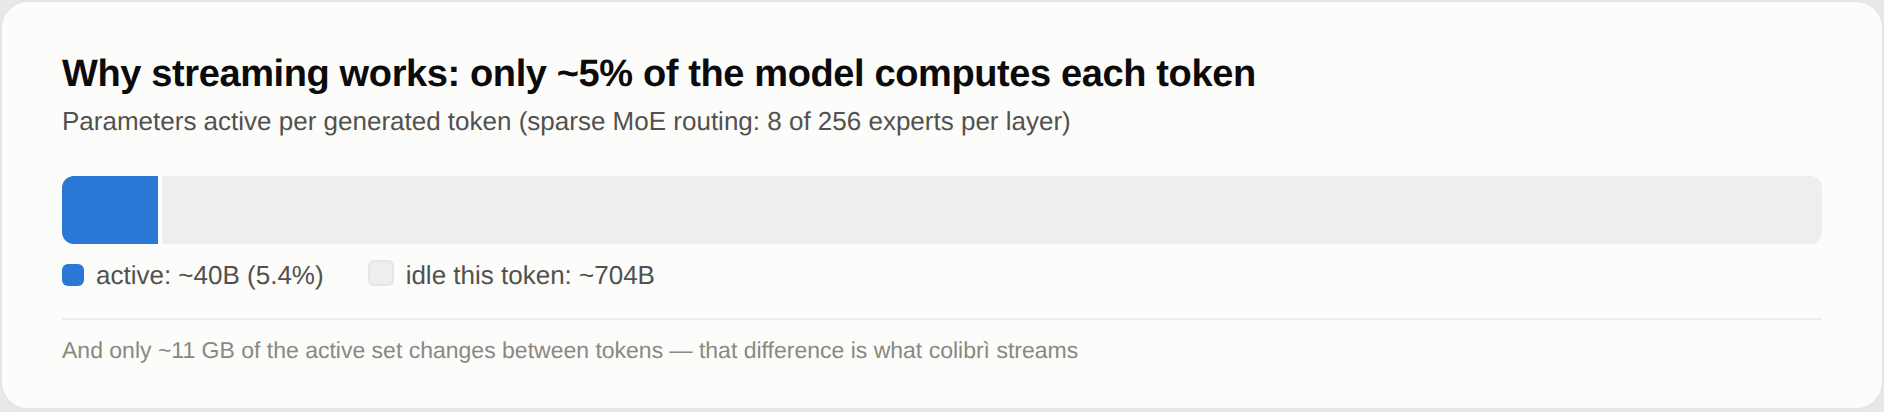
つまり、モデルは高速メモリに *収まる* 必要はなく、**配置** されればよいのです:
- **密な部分**(アテンション、共有エキスパート、埋め込み — 約 17B パラメータ)は
**int4 で RAM に常駐** します(約 9.9 GB)。
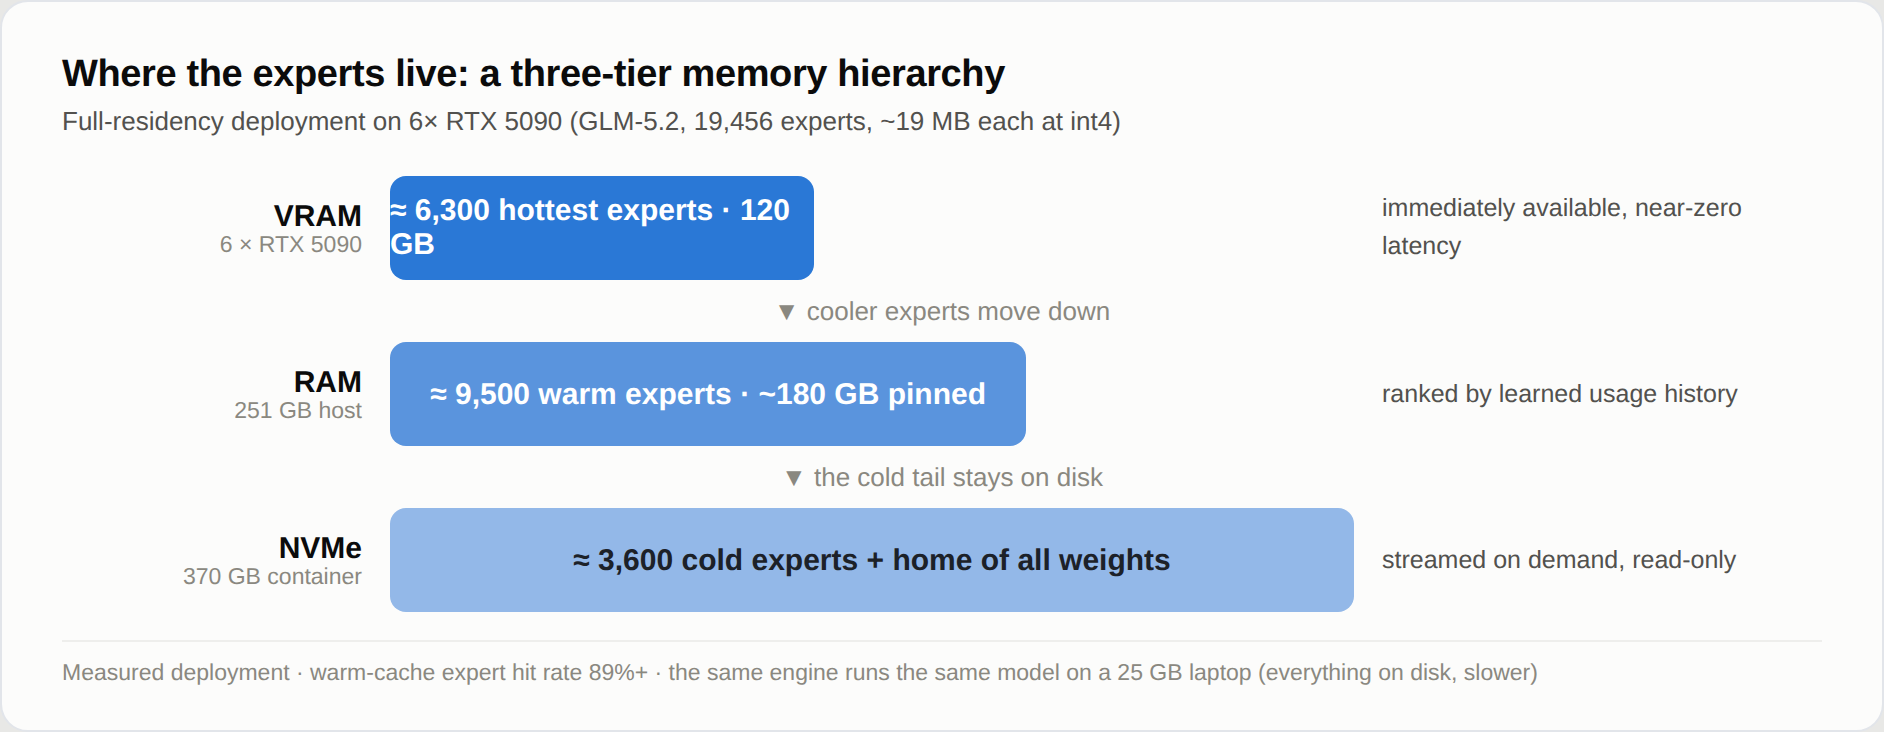
- **19,456 個のルーティングエキスパート**(75 MoE レイヤー × 256 + MTP ヘッド、int4 で各約 19 MB)は
**ディスク上** に置かれ(約 370 GB)、レイヤーごとの LRU キャッシュ、学習されたピン留めホットストア、
オプションの VRAM ティアとともに **オンデマンドでストリーミング** されます。
コアアルゴリズムは **重みのための JIT** だと考えてください。コンパイラの JIT は
プログラム全体をコンパイルすることはなく、実際に実行される部分を観察して、ホットパスを
ジャストインタイムでコンパイルします。colibrì は 744B のパラメータ空間に対して同じ賭けをします。
パラメータは保持すべき常駐状態ではなく、ルーターが必要だと証明したまさにそのときに、
異種混在のストレージ階層(VRAM / RAM / NVMe)にわたって **ステージングされるデータ** なのです。
計測されたルーティングの熱量がどのエキスパートをどのティアに置くかを決め、ルーターは
1 レイヤー先を走ってプリフェッチがステージングのレイテンシを隠し、そして JIT と同様に、
エンジンはあなたのワークロードを学習します。使えば使うほど、適切なエキスパートがホットになっていきます。
これが機能するのは、ルーティングに計測可能な構造があるからです(
[エキスパートアトラス](https://github.com/JustVugg/colibri/issues/175) を参照)。
そして構造はキャッシュ可能です。
エンジンは単一の C ファイル(`c/colibri.c`)と小さなヘッダ群だけで構成されています。BLAS も、
実行時の Python も、GPU も必要ありません。
### ローカルクラスタモード
コーディネーターはトークン生成、ルーティング、KV 状態をローカルに保持し、ディスクを
バックエンドとするエキスパートワーカーが、ルーティングされた FFN を他の Mac 上で実行します。
あるレイヤーでルーティングされたバッチの和集合は 1 つの永続 TCP リクエストとして送られるため、
1 トークンでエキスパートごとにラウンドトリップが発生することはありません。
オプションの登録サービスを起動します:
```bash
./coli cluster coordinator --host 0.0.0.0 --port 8765
```
各ワーカーで、同じ変換済みモデルをローカルに用意したうえで:
```bash
./coli cluster worker --model /nvme/glm52_i4 --port 9100 \
--coordinator http://COORDINATOR:8765 --advertise-host WORKER_IP
```
ディスカバリーを使ってコーディネーターを実行するか、静的な構成では `--cluster-workers
HOST:PORT,...` を指定します:
```bash
./coli serve --model /nvme/glm52_i4 \
--cluster-coordinator http://127.0.0.1:8765
```
ワーカーが設定されていない限りトランスポートは無効なので、既存の単一マシンでの経路は
変わりません。密レイヤーのシャーディングやブラウザ/WebGPU ワーカーは、別の今後の拡張ポイントです。
## 仕組み
### トークンごとの経路
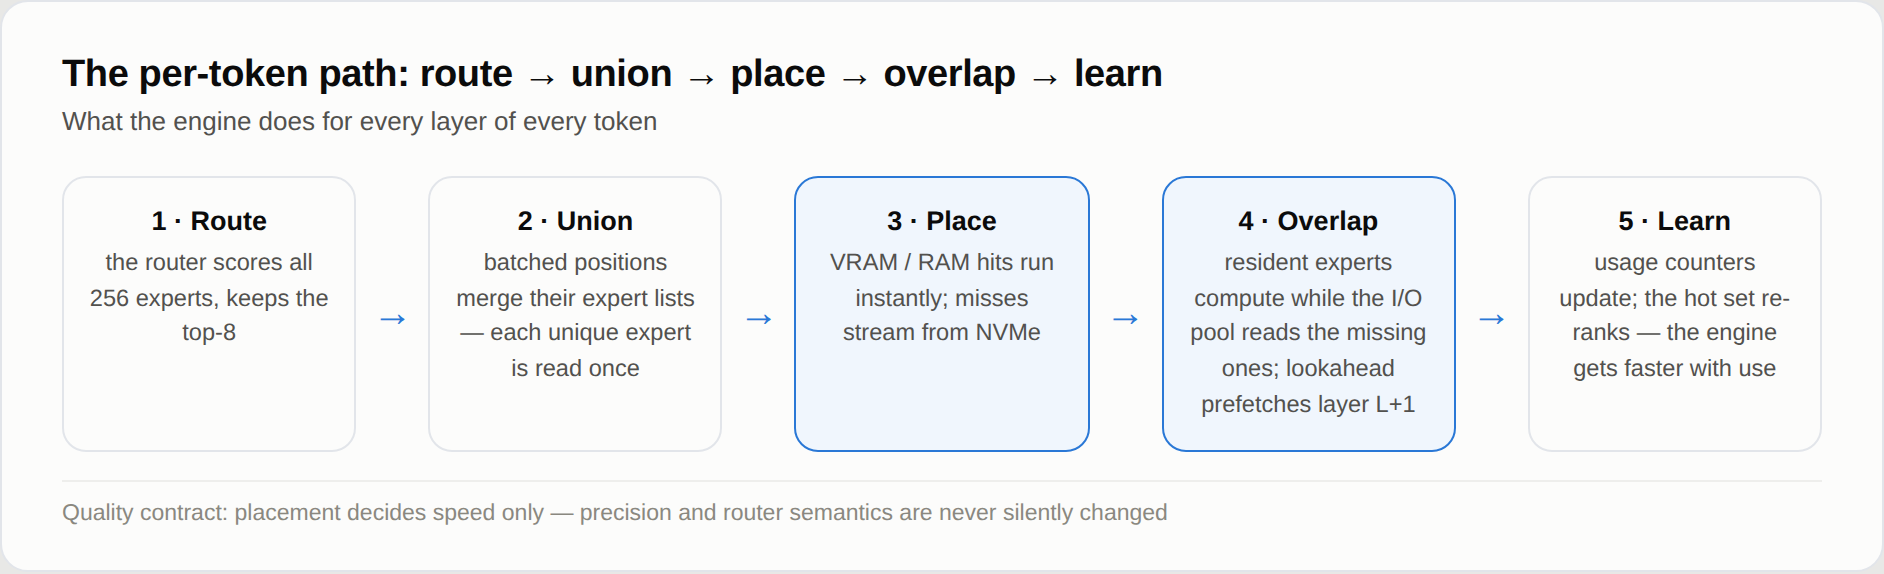
すべてのトークンのすべてのレイヤーが、同じ 5 つのステップをたどります。設計上の目標は、
**配置が決めるのは常に速度だけ** ということです。エキスパートが VRAM から応答しようと
ディスクから応答しようと、ルーターの判断も重みの精度も同じです。
### 1 つのメモリ要件ではなく、1 つのメモリ階層
### デュアル SSD: モデルのコピー 2 つで、読み込み帯域幅を 2 倍に
ほとんどのマシンでデコードはディスク律速であり、エキスパートの読み込みは読み取り専用です。そこで **2 台目の SSD** があるなら、そこにモデルの完全なコピーを置き、エンジンに両方のドライブから同時にストリーミングさせましょう:
```bash
COLI_MODEL=/fast/glm52_i4 COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat
COLI_DISK_WEIGHTS=9,3 ... # オプション: プライマリ,ミラーの帯域幅比(未指定なら起動時に計測)
```
各エキスパートは、2 台のドライブの計測された(または宣言された)帯域幅で重み付けされた決定論的ハッシュによって一方のドライブに割り当てられます。そのため readahead/PILOT のプリフェッチと要求時の読み込みは常に同じドライブに当たり、二重にキャッシュされることはありません。合計帯域幅は両ドライブの和になります — 9 GB/s + 3 GB/s の組み合わせでは、高速なドライブ単体よりもエキスパートの読み込みが約 33% 速くなり、OMP 並列のピン留め/ウォームアップのロードも両方からストリーミングされます。知っておくべき詳細:
- ミラーは **起動時に検証** されます(ファイルごとのサイズと safetensors ヘッダがプライマリとバイト単位で一致する必要があります)。一致しない、または欠けているファイルは黙ってプライマリのままになるので、**部分的なミラーでも問題ありません** — 一部のシャードしか置けない小さめの 2 台目 SSD でも効果があります。
- ミラーには **一切書き込まれません**: `.coli_usage`、`.coli_kv` およびすべてのサイドカーファイルはプライマリに残ります。
- ミラーでの読み込みエラーはプライマリにフォールバックします(警告 1 回、クラッシュなし)。そのため実行中に 2 台目のドライブを抜いても、サーバーが落ちるのではなく性能が低下するだけです。
- ルーティングがトークンを変えることはありません — 両コピーはバイト単位で同一であり、実行ごとの `MIRROR:` 統計行にはドライブごとに提供した GB 数が表示されます。
同じエンジンがあらゆる規模をカバーします。25 GB のラップトップではすべてがディスクから
ストリーミングされ(遅いが正しい)、大きなホストではエキスパート全体が常駐し
(`CUDA_EXPERT_GB=auto PIN_GB=all`)、ディスクはデコード経路から完全に外れます。
ティアの間には **学習キャッシュ** があります。エンジンは *あなたの* ワークロードがどの
エキスパートにルーティングされるかを記録し(`.coli_usage`、ターンごとに更新)、最もホットな
ものを自動でピン留めします — colibrì は文字どおり、使えば使うほど速くなります。マルチソケットの
ホストでは、`COLI_NUMA=1` によって常駐する重みをメモリコントローラ間でインターリーブします
([#82](https://github.com/JustVugg/colibri/issues/82))。
モデル全体を置けない 2 台目のドライブ向けに、Colibri はすでに学習しているエキスパート履歴から
部分ミラーの優先順位を付けられます。まずいくつかの代表的なプロンプトを実行して `.coli_usage` に
ワークロードを反映させてから、ミラーを計画・ステージング・検証します:
```bash
./c/coli mirror plan --model /fast/glm52_i4 --mirror /second/glm52_i4 \
--budget-gib 200 --reserve-gib 20
./c/coli mirror stage --model /fast/glm52_i4 --mirror /second/glm52_i4 \
--budget-gib 200 --reserve-gib 20
./c/coli mirror verify --model /fast/glm52_i4 --mirror /second/glm52_i4
```
プランナーは safetensors ヘッダを直接読み、`COLI_MODEL_DIRS` から分割モデルのディレクトリをたどり、
最もホットなルーティングエキスパートを提供できるシャードを優先します。ステージングがプライマリの
モデルを変更することはありません。一時ファイル経由でコピーし、指定された空き容量の予備を確保し、
すべてのシャードを SHA-256 で検証し、既存のミラーシャードを削除することはなく、選択された
ミラーの準備が整って初めてレシートをアトミックに公開します。
### ディスクを二度待たない
ミスはコストが高いため、エンジンは工夫の大部分をミスの回避とオーバーラップに費やします。
各エキスパートの 3 つの行列は隣接して格納され、1 回の `pread` で読み込まれます。上限付きの
非同期 I/O プール(`PIPE=1`、デフォルト)は、常駐しているエキスパートが計算している間に
欠けているエキスパートをロードします。バッチ化された位置では一意なエキスパートを 1 回だけ読み込み
(**batch-union**)、ルーター先読みスレッド(`PILOT=1`)が次のレイヤーのエキスパートを
プリフェッチします — ルーティングは **1 レイヤー先を 71.6% の精度で予測可能** であることが計測されています。
GPU では、常駐パイプライン(`COLI_CUDA_PIPE=2`)が残差ストリームをレイヤーをまたいでデバイス上に
保持するため、CPU のエキスパートループは中断されずに実行されます。Apple Silicon では実験的な
[Metal バックエンド](docs/metal.md) がユニファイドメモリ GPU 上でバッチ化されたエキスパート演算を行い、
[Vulkan バックエンド](docs/vulkan.md) はエキスパートティア、密な射影、MLA アテンションのコアを、
Vulkan 1.2 ドライバを持つあらゆる GPU にもたらします — Mesa/RADV 経由の AMD カードも含まれます
(RX 580 のようにベンダーのスタックがサポートを終了したカードでは唯一のバックエンドであり、
RDNA4 では ROCm と互角です — [ベンチマークに関するメモ](docs/vulkan.md) を参照)。
> **実際の NVMe では `DIRECT=1` を計測してください。** O_DIRECT はページキャッシュをバイパスし、
> DRAM キャッシュと帯域幅に余裕のあるドライブでは大きな改善になることが多いです(Blackwell/Windows
> マシンで `PIPE=1` と併用してデコード +34% を計測、GB10 の iobench で 4.25→9.69 GB/s)。
> ただしドライブ依存であり、QLC/DRAM レスや仮想化されたディスクでは効果なし〜逆効果になり得ます。
> まず試して、ハードウェアが報いてくれる設定を残してください。
### 忠実なモデル、圧縮された状態
フォワードパスは `transformers` のオラクルに対して検証されています(teacher-forcing で
通常 30〜32/32。小さなオラクルの 2 つの位置は浮動小数点上のほぼ同値で、ツールチェーンに依存します)。
MLA アテンションは圧縮された KV 状態を保存します — 1 トークンあたり 32,768 個ではなく 576 個の
浮動小数点数(**57 分の 1**)— そしてそれを再起動をまたいで永続化します(`.coli_kv`)。
会話は再プリフィルなしでウォームな状態から再開され、中断されなかったセッションとバイト単位で同一です。
DSA スパースアテンション(GLM-5.2 の lightning indexer)は忠実に実装されており、全キーを強制的に
選択させたときに密なアテンションを正確に再現することで検証されています。
### 投機的デコードを、誠実に
GLM-5.2 のネイティブ MTP ヘッドがトークンをドラフトし、メインモデルが 1 回のバッチ化された
フォワードでそれを検証します — 効果がある場合はフォワードあたり 2.2〜2.8 トークン。苦労して
得た 2 つのルールがデフォルトとして組み込まれています。MTP ヘッドは **int8** でなければならないこと
(int4 のヘッドは受理率が 0〜4% に崩壊します、[#8](https://github.com/JustVugg/colibri/issues/8))、
そしてドラフトと検証は **同じ関数** を計算しなければならないこと — `SPEC_PIN=1` は両者を
1 つのカーネルファミリーに固定します(詳しい調査の経緯は [#163](https://github.com/JustVugg/colibri/issues/163) にあります)。
文法強制ドラフト([`GRAMMAR=file.gbnf`](docs/grammar-draft.md))は、制約付き JSON 出力で
ほぼタダで受理率を上げます。投機的デコードが正味でプラスになるかはキャッシュの温まり具合に
依存します — 計測し、効果がなければ `DRAFT=0` を使ってください。
## 何を実現しているか
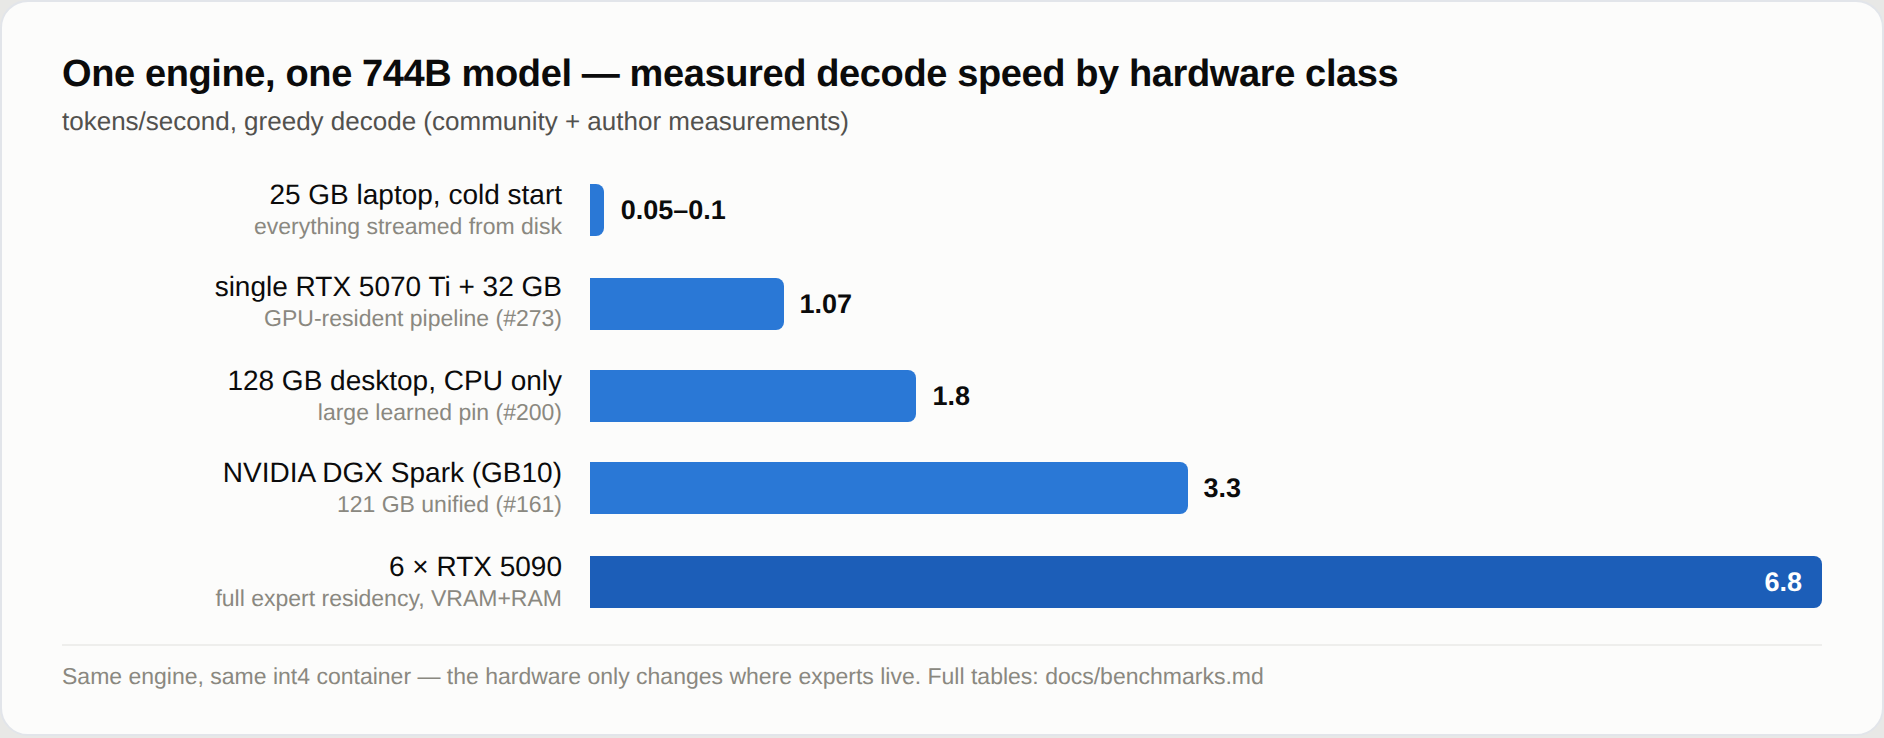
同じエンジン、同じ int4 コンテナ — ハードウェアが変えるのはエキスパートの置き場所だけです。
[完全なベンチマーク表](docs/benchmarks.md) からのハイライト:
- **6× RTX 5090、完全常駐:** デコード 5.8〜6.8 tok/s、TTFT 約 13 秒
([実験ログ](docs/experiments/glm52-6x5090-2026-07-12.md))
- **128 GB の CPU のみのデスクトップ:** ウォーム時 約 1.8 tok/s([#200](https://github.com/JustVugg/colibri/issues/200))
- **RTX 5070 Ti 1 枚のラップトップ級マシン:** GPU 常駐パイプラインで 1.07 tok/s
([#273](https://github.com/JustVugg/colibri/issues/273))
- **25 GB の開発マシン:** コールド時 0.05〜0.1 tok/s — このプロジェクトが始まった実証済みの下限であり、
今も誠実なベースラインです。
品質は仮定ではなく計測されています。int4 コンテナの量子化コストと、スケール粒度/回転の
アブレーションは [docs/benchmarks.md](docs/benchmarks.md#quality-benchmark) と
[#108](https://github.com/JustVugg/colibri/issues/108)/[#81](https://github.com/JustVugg/colibri/issues/81) にあります。
## はじめに
必要なものは 2 つです: **プログラム**(数百 KB)と **モデル**(372 GB)。
全プラットフォーム向けの手順は [クイックスタートガイド](docs/quickstart.md) にあります。
### 1. colibri を入手する
**ビルド済みリリースをダウンロード** — Linux、macOS、Windows に対応し、コンパイラは不要です。
[Releases](https://github.com/JustVugg/colibri/releases) から自分のプラットフォーム用の
アーカイブを取得して展開します:
```bash
mkdir colibri && tar xzf colibri-v1.8.0-linux-x86_64.tar.gz -C colibri && cd colibri
python3 coli info # engine ready ✓
```
中にはエンジン(`colibri`、Windows では `colibri.exe`)、`coli` ランチャー、その Python
ヘルパーが入っています。名前の変更や設定は不要です — `coli` は自分の隣にあるエンジンを見つけます。
必要なのは [Python 3](https://www.python.org/downloads/) のインストールだけです。ランチャーと
API ゲートウェイは Python スクリプトですが、エンジン自体は依存ゼロの純粋な C です。
**またはソースからビルド** — OpenMP 対応の `gcc`(または clang)が必要です:
```bash
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh # gcc/OpenMP を確認し、ビルドとセルフテストを実行
```
`coli` を PATH に置きたい場合は、チェックアウトから `pip install -e .` を実行すると登録されます
(エンジンは引き続き `c/` にあります — wheel ではなく、クローンからの editable インストールです)。
### 2. モデルを入手する
変換済みの **GLM-5.2 int4** コンテナが Hugging Face にあります — **int8 MTP ヘッド** 付きの
**グループスケール(gs64)** ビルドを使ってください。サイズは約 **372 GB** なので、
十分な容量のある、できれば高速なディスクに置いてください:
**https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp**
> ⚠️ 古い行単位 int4 のミラー(`mateogrgic/…`、`jlnsrk/…`)ではなく、上記の **gs64** コンテナを
> 使ってください。それらは品質が約 9 ポイント劣ることが計測されており、
> [#455](https://github.com/JustVugg/colibri/issues/455) で報告された当初の思考モードのループや
> 終わらない生成の根本原因でした。gs64 コンテナは制御された行単位の A/B で見られたそれらの問題を
> 解消しましたが、繰り返しや EOS 欠乏に対する汎用的なガードではありません。MTP ヘッドも
> **int4 ではなく int8** である必要があります
> (int4 → ドラフト受理率 0%、[#8](https://github.com/JustVugg/colibri/issues/8)):
> `ls -l /out-mtp-*` — int8(正しい)なら 3 ファイルで `3527131672 / 5366238584 / 1065950496`、
> または単一の `out-mtp-00000.safetensors` で `9959321520` バイトです
> (推奨コンテナの現在のアップロードは 1 ファイルで配布されています: 中身は同じ
> int8 テンソルで、1 要素 1 バイトのものが 777 個です)。
あるいは FP8 のソースから自分で変換することもできます — 756 GB 全体を一度にディスクに置く必要のない、
再開可能なコマンド 1 つで行えます:
```bash
./coli convert --model /nvme/glm52_i4 # シャードごとにダウンロード+変換(python、初回のみ)
```
#### その他の対応モデル
GLM-5.2 がリファレンスモデルですが、同じストリーミング手法でさらに 6 つのファミリーが動作します。
それぞれが **兄弟エンジン** です — C ファイル 1 つで独自のアーキテクチャを持ち、同じ
`coli chat` / `coli serve` / `coli web` フロントエンドを使います(ランチャーはモデルの
`config.json` からバイナリを選びます):
> **それぞれに必要なもの。** これらは大きく異なり、2 つを並べて読んだ人が要件が矛盾していると
> 誤解したこともあります([#191](https://github.com/JustVugg/colibri/issues/191))。矛盾してはいません —
> 別々のモデルなのです。**どれも GPU は必要ありません。**
>
> | モデル | 重み用のディスク | RAM | GPU |
> |---|---|---|---|
> | **OLMoE** | 約 7 GB(int8 コンテナ) | 8 GB | 不要 |
> | **GLM-5.2/5.3** | 約 372 GB | 最低 16 GB、快適には 24 GB | 不要 |
> | **GLM-5.3-Flash** | 変換後 約 195 GB | 25 GB(int4 の重み 12 GB + エキスパートキャッシュ) | 不要 |
> | **Inkling** | 約 469 GB | int4 密コンテナ使用時 25 GB、未使用時 約 120 GB | 不要 |
> | **Kimi K3** | 約 1.6 TB | 32 GB 以上 | 不要 |
> | **DeepSeek V4 Flash** | 約 167 GB(REAP 150B: 約 85 GB) | 最低 16 GB、快適には 32 GB | オプション。GTX 10 シリーズ以降の任意の NVIDIA カード(Pascal/Turing は `CUDA_ARCH=portable-pre-ampere NO_TC=1` で、RTX 50 で最良)により、プリフィルが 5〜10 倍、デコードが約 2.5 倍高速化 |
> | **Qwen3.8-Flash-Next** | 約 185.5 GB(公式 FP8 チェックポイント) | 最低 16 GB、デフォルトのコンテキストで快適には 24 GB | 非対応。CPU のみ |
> | **Qwen3.6-35B-A3B** | 約 20 GB(int4-gs64 コンテナ) | 24 GB(RAM への完全常駐が必要) | オプション。CUDA VRAM エキスパートティアは 8 GB カード 2 枚で **1.44 -> 10.05 tok/s(7.0 倍)** を計測、出力は CPU とビット単位で同一 |
>
> GPU はあくまで速くするだけです。エキスパートはディスクからストリーミングされるため、速度は
> ディスクで決まります — 遅いドライブでは 1 秒あたり 1 トークン未満、高速なドライブでキャッシュが
> 温まっていれば 1 秒あたり数トークンを想定してください。
| ファミリー | 総数 / アクティブ | 重み | ビルド | ドキュメント |
|---|---|---|---|---|
| **GLM-5.2/5.3** | 744B / 40B | [`mastouri/…-int4-g64-with-int8-mtp`](https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp)(372 GB) | `make -C c glm` | このページ |
| **Inkling**(Thinking Machines) | 975B / 41B | [`nbeerbower/Inkling-colibri-int4`](https://huggingface.co/nbeerbower/Inkling-colibri-int4)(469 GB) | `make -C c inkling` | [inkling.md](docs/inkling.md) |
| **GLM-5.3-Flash**(Z.ai) | 321B / 40B | [`zai-org/GLM-5.3-Flash`](https://huggingface.co/zai-org/GLM-5.3-Flash) — ルーティングエキスパートを **int4-gs64** に変換、密部分は BF16 のままで精度はロード時に選択。ビジョン対応 | `make -C c glm53` | [glm53-flash.md](docs/glm53-flash.md) |
| **Kimi K3**(Moonshot) | 2.8T / 104B | [`moonshotai/Kimi-K3`](https://huggingface.co/moonshotai/Kimi-K3) — オリジナルのチェックポイント、ルーティングエキスパートは **ネイティブ MXFP4** のまま | `make -C c kimi_k3` | [kimi_k3.md](docs/kimi_k3.md) |
| **DeepSeek V4 Flash** | 284B / 13B | 公式のシャード化チェックポイント — ルーティングエキスパートは **ネイティブ fp4**、密部分は fp8-e4m3 のまま。**REAP で枝刈りした 150B**([`puwaer/DeepSeek-V4-Flash-0731-reap-150b`](https://huggingface.co/puwaer/DeepSeek-V4-Flash-0731-reap-150b)、85 GB、256 個中 132 個のエキスパート)も同じエンジンで変換なしにロード可能 | `make -C c deepseek-v4` | [deepseek-v4.md](docs/deepseek-v4.md) |
| **DeepSeek V4.1 Flash** | 552B / 16B | 公式チェックポイント、**変換不要**: エキスパートはすでに fp4、密部分は fp8-e4m3。そのうち 203 GB は一度に数百バイトずつディスクから読まれる n-gram メモリで、ルーティングエキスパートのコストは GLM-5.2 の 12.7 GB に対して **1 トークンあたり 4.5 GB**。ビジョン、ツール呼び出し、DSpark ドラフトヘッドはすべて有効 | `make -C c deepseek_v41` | [deepseek-v41.md](docs/deepseek-v41.md) |
| **Qwen3.8-Flash-Next**(Alibaba) | 125B + 51B n-gram / 6B | [`Qwen/Qwen3.8-Flash-Next-FP8`](https://huggingface.co/Qwen/Qwen3.8-Flash-Next-FP8) — オリジナルのチェックポイント。PLE はページング可能なまま、エキスパートは **ネイティブのブロック FP8** のまま | `make -C c qwen38`(CPU のみ) | [qwen38.md](docs/qwen38.md) |
| **Qwen3.6**(Alibaba) | 35B / 3B | [`Kreuzzelg/qwen36-35b-a3b-colibri-i4-gs64`](https://huggingface.co/Kreuzzelg/qwen36-35b-a3b-colibri-i4-gs64)(約 20 GB、**推奨**)— Gated Attention + Gated DeltaNet のハイブリッド | `make -C c qwen36`(VRAM エキスパートティアには `CUDA=1`) | [qwen36.md](docs/qwen36.md) |
| **OLMoE**(AI2) | 7B / 1B | `c/tools/convert_olmoe_merged.py` で変換 — **int8** コンテナ、約 7 GB | `make -C c olmoe` | — |
Qwen3.6 には変換済みコンテナが 3 つあります: **int4-gs64**(推奨 — int8 のアンカーに対するコサイン類似度は
行単位と比べて 0.98777 → 0.99313、KL は 0.109 → 0.080 と計測されており、量子化誤差が約 44% 少ない)、
A/B のベースラインとしての [int4 行単位](https://huggingface.co/Kreuzzelg/qwen36-35b-a3b-colibri-i4)、
そして [KAT-Coder v2.5](https://huggingface.co/Kreuzzelg/kat-coder-v2.5-dev-colibri-i4-gs64) です。
KAT-Coder は同じエンジンでそのまま動きます — アーキテクチャが同一のチェックポイントであれば、
専用のコードパスなしで動作します。`CUDA=1` を使うと、VRAM エキスパートティアは
**8 GB カード 2 枚で 1.44 → 10.05 tok/s(7.0 倍)** を計測し、出力は CPU の経路とビット単位で同一でした。
Kimi K3 は変換不要です。QAT で学習された MXFP4 エキスパートはオリジナルの Hugging Face シャードから
直接ストリーミングされ、bf16 の密な重みセットはロード時に量子化されます。長いエージェントセッションでは、
リカレント状態のチェックポイントをオプトインできます(RAM 上に `COLI_K3_CKPT=N` スロット、または
`COLI_K3_CKPT_DIR` でディスクに退避)。編集されたプロンプトやフォローアッププロンプトは、残っている
最も深いチェックポイントを復元して末尾だけを再プリフィルするため、会話全体を SSM レイヤーで
再生し直す必要がありません。Vulkan ホストでは `K3_VK_UP=auto` が、計測された帯域幅から
エキスパートティアのアップロード量を決めます。エンジンの KDA と MLA の経路は、CI でベンダー実装に
対してトークン単位で完全一致することが検証されています。
Inkling は int4 のエキスパートと **bf16 の密な重み**(常駐 49.4 GB)で提供されています。それを
保持できないホスト向けに、[inkling.md](docs/inkling.md) には密な重みセットを 15.3 GB にする
ワンパスのツールがあり、975B を 25 GB のマシンで動かせます — トレードオフも誠実に書かれています。
### 3. 実行する
```bash
COLI_MODEL=/nvme/glm52_i4 ./coli chat # RAM 予算、キャッシュ、MTP を自動検出
COLI_MODEL=/nvme/glm52_i4 ./coli plan # 計画された VRAM/RAM/ディスクの配置を確認
COLI_MODEL=/nvme/glm52_i4 ./coli doctor # 読み取り専用の準備状況チェック
COLI_MODEL=/nvme/glm52_i4 ./coli doctor --deep # テンソル/シャード/インデックス/ミラーの厳密な事前チェック
COLI_MODEL=/nvme/glm52_i4 ./coli tune # このマシンで最速かつ安全な実行プロファイルを計測して保存
./coli web --model /nvme/glm52_i4 # API + ダッシュボード、ブラウザを開く
./coli serve --model /nvme/glm52_i4 # API + ダッシュボード、ブラウザなし(ヘッドレス)
```
Windows ではリリースアーカイブに `coli.cmd` が同梱されています。ダブルクリックでクイックスタート、
または cmd や PowerShell から `coli.cmd chat --model D:\glm52_i4` を実行してください。
ソースのチェックアウトからは、同じコマンドを `python coli chat --model
D:\glm52_i4` として実行できます。`.exe` ファイルはエンジンでありランチャーではありません。
単体で起動するとロードするモデルがないため、すぐに終了します。
実行時のエンジンは純粋な C です — Python は初回のみの変換ツールとオプションの
API ゲートウェイでしか使われません。
#### 同じコマンドでどのモデルも動く
`coli` はモデルの `config.json` を読み、対応するエンジンバイナリを選び、そのファミリーの
チャットテンプレートを適用します — そのため **モデルが変わってもコマンドラインは何も変わりません**。
使いたいエンジンを一度ビルドしたら、あとは `COLI_MODEL` を適切なディレクトリに向けるだけです:
```bash
make -C c glm # GLM-5.2
make -C c inkling # Inkling
make -C c kimi_k3 # Kimi K3
COLI_MODEL=/nvme/glm52_i4 ./coli chat # TUI
COLI_MODEL=/nvme/inkling_i4 ./coli chat
COLI_MODEL=/nvme/kimi_k3 ./coli chat
./coli web --model /nvme/inkling_i4 # API + ダッシュボード、ブラウザを開く
./coli web --model /nvme/kimi_k3
./coli serve --model /nvme/inkling_i4 # API + ダッシュボード、ブラウザなし
```
GLM 以外のエンジンでは、`coli chat` がローカルでゲートウェイを起動して TUI をそれに接続します。
そのため TUI、API、ダッシュボードはすべて同じアーキテクチャ対応のチャットテンプレートを通り、
テンプレートを自分で指定する必要はありません。
モデルごとに異なる点が 2 つあり、どちらも各モデルのページに記載されています:
- **RAM に余裕のないホストでの Inkling** には、int4 の密コンテナと小さなエキスパートキャッシュが
必要です: `./coli chat --model /nvme/inkling_i4 --cap 2`
([inkling.md](docs/inkling.md) を参照 — デフォルトの `--cap 8` では、常駐セットに加えて
約 14 GB のキャッシュが必要です)。
- **Kimi K3** は MXFP4 エキスパートをオリジナルのチェックポイントからストリーミングするため、
変換するものはありません — ただしスナップショットは約 1.6 TB です
([kimi_k3.md](docs/kimi_k3.md) を参照)。
### 4. さらに詳しく
| トピック | ドキュメント |
|---|---|
| ベンチマーク、コミュニティのデータポイント、品質計測 | [docs/benchmarks.md](docs/benchmarks.md) |
| 再現可能なベンチマークプロトコルと最低限のレポート | [docs/benchmarking.md](docs/benchmarking.md) |
| チューニング項目、ポリシー、学習キャッシュ、プリフェッチ | [docs/tuning.md](docs/tuning.md) |
| Windows 11 ネイティブビルド(+ CUDA DLL) | [docs/windows.md](docs/windows.md) |
| CUDA バックエンド、VRAM エキスパートティア、完全常駐 | [docs/cuda.md](docs/cuda.md) |
| Vulkan バックエンド(任意の GPU: RADV 経由の AMD、ROCm がサポートを終了したカードを含む) | [docs/vulkan.md](docs/vulkan.md) |
| Apple Silicon Metal バックエンド | [docs/metal.md](docs/metal.md) |
| OpenAI 互換 API、KV スロット、Web ダッシュボード | [docs/api.md](docs/api.md) |
| 実験的なレイヤーセグメント埋め込み ABI | [docs/segment-runtime.md](docs/segment-runtime.md) |
| 実験的なトークナイザ/埋め込み/ヘッドの Edge ABI | [docs/edge-runtime.md](docs/edge-runtime.md) |
| 文法強制ドラフト(構造化出力) | [docs/grammar-draft.md](docs/grammar-draft.md) |
| 環境変数一覧 | [docs/ENVIRONMENT.md](docs/ENVIRONMENT.md) |
## DeepSeek V4
**DeepSeek V4 Flash** は公式チェックポイントを変換なしでストリーミングします。ルーティング
エキスパートは **ネイティブ fp4** のまま、密な重みセットは UE8M0 ブロックスケール付きの
**fp8-e4m3** のままです。MLA + DSA スパースアテンション、43 レイヤー、256 個のルーティング
エキスパートと 1 個の共有エキスパート、top-6。x86-64/aarch64 の Linux と Windows/MSYS2(CPU)に
対応し、オプションの CUDA ティア(Windows ではランタイム DLL、Linux では `CUDA=1` による直接リンク、
WSL2 で検証済み)は、すべてのステージを CPU 基準に保ちつつステージごとにフォールバックします。
```bash
cd c
make deepseek-v4
python ./coli chat --model /path/to/DeepSeek-V4-Flash --ram 32
# coli run / coli serve / coli web も可
# Windows CUDA ティア: make cuda-dsv4-dll CUDA_ARCH=portable (RTX 50 では + make cuda-dsv4-dg-dll)
```
新しく追加された 2 つのオプトイン GPU レバーがあり、コミュニティによる計測値を求めています。
どちらもデフォルトでオフで、未設定時はバイト単位で同一です。`DSV4_HYBRID=1` は、実行時に計測した
帯域幅を使って、VRAM ティアのミスを GPU のフィル分岐と CPU の分岐に振り分けます。
`COLI_CUDA_MOE_DOUBLE=1`(`COLI_CUDA_MOE_BATCH=1` と併用)は、現在のレイヤーを計算している間に
次のレイヤーのエキスパートセット全体を 2 つ目の VRAM バンクにプリフェッチし、VRAM が足りなければ
単一バンクにフォールバックします。
CUDA ティアは Pascal と Turing のカード(GTX 10 / RTX 20 シリーズ)でも動作するようになりました:
`CUDA_ARCH=portable-pre-ampere NO_TC=1` でビルドしてください。
グリーディデコードで KV スロットは 1 つです。ツール呼び出しは、V4 ネイティブのプロンプトと DSML の
呼び出しブロックで HTTP ゲートウェイを通じて接続されています。文法はサポートされていません。
[エンジンごとの API マトリクス](docs/api.md#tool-calling-support) を参照してください。プレフィックス
チェックポイント(メモリ上 + ディスク上)により、システムプロンプトの初回プリフィル後は、
エージェントセッションやフォローアップのターンが数秒で始まります。RTX 5080 + NVMe 2 台での計測:
3324 トークンのプリフィルが 90 秒、8.3k トークンの初回ターンが初回のみ約 4 分、以降の
セッション/ターンは 6〜9 秒、3k コンテキストでデコード約 1.6 tok/s — 詳細は
[docs/deepseek-v4.md](docs/deepseek-v4.md) を参照してください。
**RAM を与えてください。** 43 × 256 個のルーティングエキスパートはディスク上で約 137 GiB あり、
1 トークンがそのうち 301 個に触れるため、エキスパートキャッシュのヒット率が tok/s を決めます —
`--ram` は最も価値のある単一の設定項目であり、変わるのは速度だけで、出力は決して変わりません。
**投機的ドラフトは存在しますが、オフです。** DSpark のマルコフドラフターと完全な MTP はどちらも
実装・検証済みです。ドラフトはフォワードパスを節約できますが、トークンを変えることは決してありません。
受理されたトークンはすべてターゲット自身の argmax だからです。実際のマルチターンチャットで計測したところ、
受理率は 15 個中 1 個と 24 個中 10 個で、このエンジンのリカレントなアテンション状態について
棄却されたサフィックスを再生するコストがドラフトによる節約を上回りました — 14 トークンの回答 1 つに
495 秒かかりました。そのため `V4_DRAFT` と `V4_MTP` はデフォルトで `0` とし、より高速なストレージで
再挑戦する人のために、コードは計測値とともに残してあります。
CUDA ティア(ビルド、DLL の選択、GPU の対応範囲)、環境変数リファレンス、性能値、
チェックポイントの検証、生成された小さな独立オラクルについては
[docs/deepseek-v4.md](docs/deepseek-v4.md) を参照してください。
## 今後の展望
- **推論システムの研究こそがプロダクトです。** 現在の階層は LRU + 学習されたピンセットです。
進行中の作業は、モデルフォーマット、圧縮、配置、スケジューリング、I/O、CPU/GPU カーネル、
異種混在のオーバーラップ、KV 状態、ルーティングを考慮した投機的デコードにわたります。
目的はハードウェア要件と有用トークンあたりのコストを下げることです。すべてはこのプロジェクトの
やり方で取り込まれます: エンドツーエンドで計測され、レビューされ、オープンに開発されます。
- **より多くのオープンモデル。** ティアリングアルゴリズムはモデルに依存しません。ルーティング
エキスパートを持つ MoE であれば、どれも同じ方法でステージングできます。現在 9 つのファミリーが
動作しています(GLM-5.2、GLM-5.3-Flash、Inkling、Kimi K3、DeepSeek V4 Flash、DeepSeek V4.1 Flash、
Qwen3.8-Flash-Next、Qwen3.6、OLMoE)。さらなるオープンウェイトのファミリー — 候補には
**MiniMax** も含まれます — は、最初の 8 つと同じ方法でエンジンを獲得します:
誰かがエンドツーエンドで計測したときにです。
## プロジェクトへの支援
colibrì は、RAM 25 GB の 12 コアのラップトップ上で、1 人のプロジェクトとして始まりました。
今ではその数値は、実機を持つコミュニティから集まっています。役に立ったと感じたら:
- ⭐ リポジトリにスターを付けて共有してください。
- 🐛 あなたのハードウェアでのベンチマーク数値を添えて issue を作成してください — データポイントは
何よりもこのプロジェクトを前進させます。
- 💬 [Discord コミュニティ](https://discord.gg/RXV83nSZdk) に参加して、実験、ハードウェアでの結果、
研究の方向性について議論してください。
- 💬 開発のスポンサーやハードウェアの寄贈については、GitHub の issue からご連絡ください。
## リポジトリ構成
```
Makefile ルートのビルド/チェックのエントリポイント
c/
├── colibri.c GLM-5.2 エンジン (make glm)
├── inkling.c Inkling エンジン (make inkling)
├── kimi_k3.c Kimi K3 エンジン (make kimi_k3)
├── deepseek_v4.c DeepSeek V4 Flash エンジン (make deepseek-v4)
├── qwen38.c Qwen3.8-Flash-Next テキストエンジン (make qwen38)
├── qwen36.c Qwen3.6 エンジン (make qwen36)
├── olmoe.c OLMoE エンジン (make olmoe)
│
├── st.h safetensors のインデックスと範囲読み込み
├── quant.h 正規のコンテナデコーダ
├── expert_ffn.h MoE エンジン共通のルーテッドエキスパート FFN カーネル(planar int4、レイヤーランナー)
├── tok.h, json.h トークナイザと JSON パーサ
├── compat.h Windows/macOS 用シム(POSIX 名を一か所に)
├── expert_store.h ストリーミングエキスパートキャッシュ
├── route_trace.h ルーティングのテレメトリと .coli_usage(エンジン非依存)
├── kv_prefix.h ターンをまたいだ KV プレフィックスの再利用
│
├── backend_cuda.* オプションの CUDA ティア (CUDA=1)
├── backend_metal.* オプションの Metal ティア (METAL=1)
├── backend_vulkan.* オプションの Vulkan ティア (VULKAN=1)
│
├── Makefile ビルドとローカルチェック
├── coli ユーザー向け CLI
├── openai_server.py OpenAI 互換 HTTP ゲートウェイ
├── resource_plan.py `coli plan` と `coli doctor` の背後にある RAM/VRAM プランナー
├── tools/ オフライン変換、フィクスチャ、ベンチマーク
├── scripts/ 長時間実行の変換ヘルパー
└── tests/ 依存関係のない C と Python のテスト
web/ ブラウザ UI(純粋な OpenAI API クライアント)
desktop/ Web UI をラップする Tauri v2 デスクトップシェル
docker/ コンテナイメージ
docs/ リファレンスドキュメント、実験、メディア
```
**モデルファミリーごとに `.c` を 1 つ、共有の単一ヘッダの上に。** エンジンは自身のアーキテクチャだけを
持ち、それ以外は持ちません。2 つのエンジンが共に必要とするもの — safetensors リーダー、コンテナ
デコーダ、トークナイザ、エキスパートキャッシュ — は両者がインクルードするヘッダに置かれるため、
修正は一度にすべてのエンジンに届きます。このルールは飾りではありません。ここで繰り返し発生する
不具合は、ある仕組みが 1 つのエンジンにだけ入り、兄弟エンジンに届かなかったケースなのです。
リポジトリのルートからは、`make`、`make check`、`make clean` がエンジンの Makefile に委譲されます。
## なぜ「colibrì」なのか
ハチドリ(イタリア語で colibrì)は体重わずか数グラムで、空中にとどまり、1 日に千もの花を訪れます。
このエンジンは、7,440 億パラメータの巨人をハチドリの食事量で生かし続けます: RAM 25 GB、
CPU 12 コア、そしてディスクへのたっぷりの忍耐です。
## 謝辞
colibrì はエンジンにすぎず、それが動かす知性は贈り物です。フロンティア級の重みをオープンに
公開しているチーム — **Z.ai**(GLM)、**Moonshot AI**(Kimi)、**Alibaba Qwen**、**MiniMax**、
**Allen AI**(OLMoE)— そして、ベンチマークを取り、バイセクトし、アトラスの実行を再現し、
パッチを送ってくれたすべてのコントリビューターに感謝します。
このプロジェクトは、オープンウェイトが何を可能にするかの証明です。
このプロジェクトのエキスパート配置、圧縮、ルーティングの実験は、以下のオープンな研究と
システムのアイデアやエビデンスにも基づいています:
- 出力を考慮した、ドメイン固有のエキスパート重要度については
[REAP](https://github.com/CerebrasResearch/reap) と
[EASY-EP](https://github.com/RUCAIBox/EASYEP)。
- 類似度に基づくエキスパートの再ルーティングについては [SERE](https://github.com/JL-Cheng/SERE)、
キャッシュ局所性を考慮したルーターのファインチューニングについては
[ReMoE](https://github.com/BUAA-OSCAR/ReMoE)。
- ルーティングに導かれたエキスパートのマージと圧縮については
[MC-SMoE](https://github.com/UNITES-Lab/MC-SMoE)。
- 共有エキスパート基底と低ランクのエキスパート差分については
[MoBE](https://github.com/inclusionAI/MoBE) と
[D²-MoE](https://github.com/lliai/D2MoE)。
- CPU/GPU ハイブリッドのエキスパートスケジューリングについては
[HybriMoE](https://github.com/PKU-SEC-Lab/HybriMoE)、エキスパート通信と計算のオーバーラップについては
[ScMoE](https://arxiv.org/abs/2404.05019)、分散オンデマンドのエキスパートロードについては
[OD-MoE](https://arxiv.org/abs/2512.03927)。
- 比較を再現可能にしているオープンな推論システムとエキスパートオフロードの取り組みについては
[vLLM](https://github.com/vllm-project/vllm)、
[llama.cpp](https://github.com/ggml-org/llama.cpp)、
[kTransformers](https://github.com/kvcache-ai/ktransformers)。
エンジンはアイデアだけでなく、具体的なエンジニアリングの成果の上にも成り立っています。以下はいずれも
現在ツリー内で使われているか、再実装されています:
- [safetensors](https://github.com/huggingface/safetensors) — すべてのエンジンが読むコンテナ
(`c/st.h`)。fp8 と I64 の dtype を含みます。
- [tiktoken](https://github.com/openai/tiktoken) — `c/tok.h` はその `byte_pair_encode` を
正確に再実装しており、連結した結果の語彙 ID が最も小さい隣接ペアをマージするため、
tiktoken 由来の語彙にはマージリストが不要です。
- [llama.cpp](https://github.com/ggml-org/llama.cpp) — `c/grammar.h` の GBNF 文法サブセットは
その構文とスタック集合による PDA に従っており、Metal の経路はその
`newBufferWithBytesNoCopy` による常駐テクニックを借用しています。
- [vLLM](https://github.com/vllm-project/vllm) — エンジンが位置ごとに一致させている出力
セマンティクスのリファレンス(例: 最終ノルムが LM ヘッドに対してどこに入るか)。
- [transformers](https://github.com/huggingface/transformers) — オラクル:
CI はランダム初期化モデルをこれに対してトークン単位で再現します。
- [DietGPU](https://github.com/facebookresearch/dietgpu) — 実験的な圧縮エキスパートティア
(`COLI_ANS`)の背後にある GPU ANS コーデック。
- [rocWMMA](https://github.com/ROCm/rocWMMA) — HIP バックエンドは CUDA の
`nvcuda::wmma` の fragment/mma_sync API をこれにマッピングしており(`c/backend_gpu_compat.h`)、
それによって 1 つの .cu ソースを両ベンダー向けにコンパイルできます。
## ライセンス
Apache 2.0。GLM-5.2 の重みは Z.ai により MIT ライセンスで公開されています。