---
Soup, LLM ince ayarının zahmetini basit bir iş akışına dönüştürür. Tek yapılandırma, tek komut, bitti.
```bash
pip install "soup-cli[train]" # ince ayar için [train] ekleyin; yalın `soup-cli` hafif CLI'dır
soup init --template chat
soup train
```
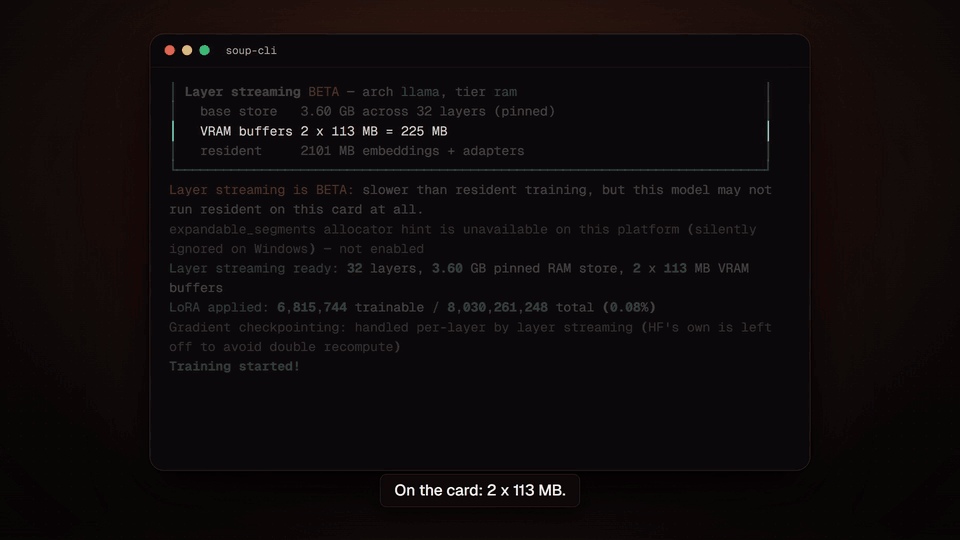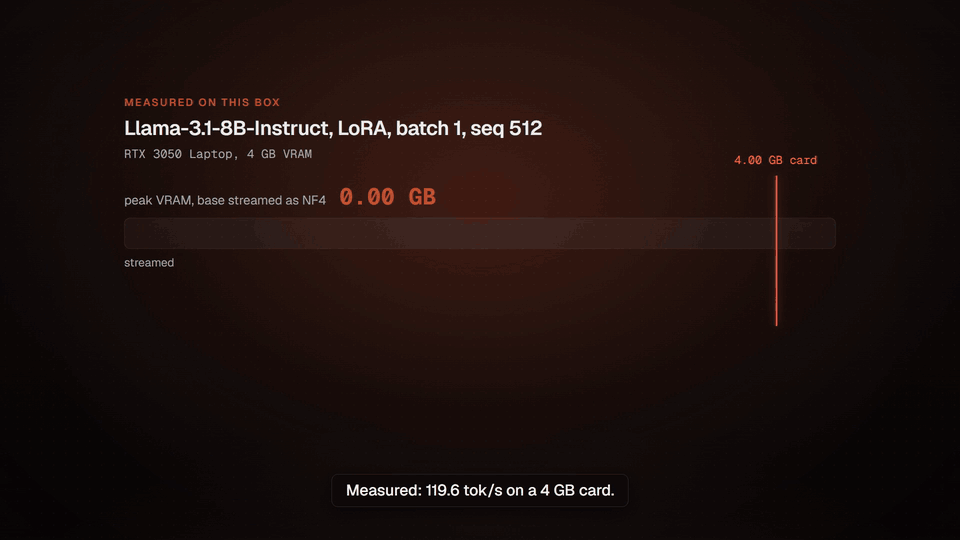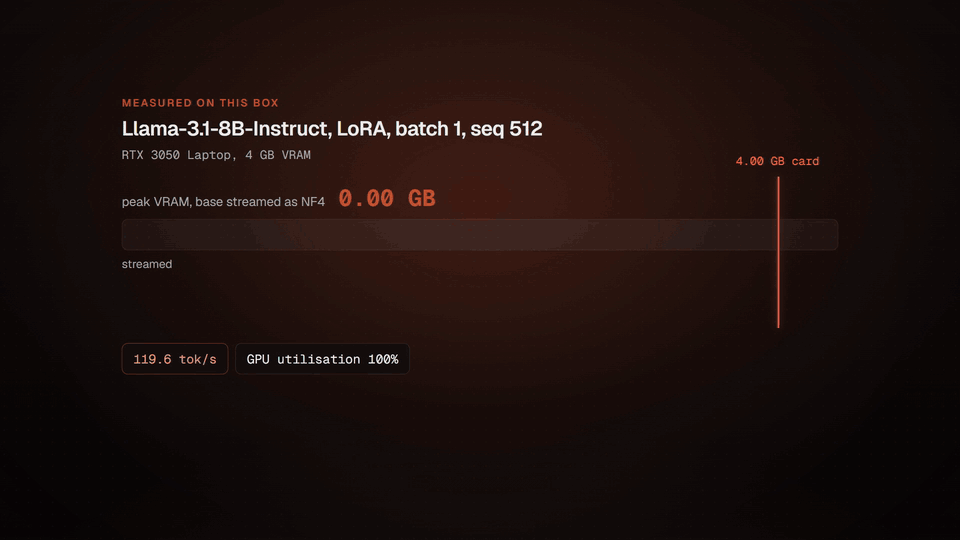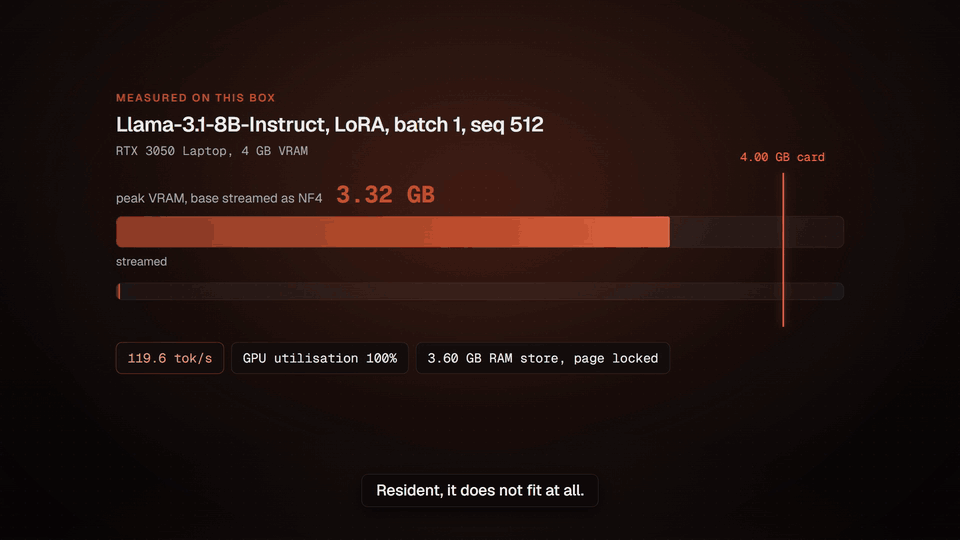
**4 GB dizüstü GPU'da 8B bir modele ince ayar yapın.** Katman akışı, dondurulmuş tabanı VRAM'in
dışında tutar ve GPU'ya her seferinde bir kod çözücü katman besler. RTX 3050 Laptop 4 GB üzerinde
ölçüldü: Llama-3.1-8B-Instruct + NF4 ile **952 MHz'de 119.6 tok/s, 3.32 GB tepe** (onarım öncesi) — normal, belleğe tamamen
yerleşik bir çalıştırmayla bit düzeyinde özdeş ve bir H100 üzerinde aynı 3.32 GB'da 113.00 tok/s
ile bağımsız olarak yeniden üretildi. (Her iki rakam da 32B'de %4.8 yavaşlamaya yol açan v0.73.0 sonuç-doğruluğu
onarımından önce, v0.72.2'de ölçüldü. Onarım sonrası çalıştırma, başka bir
RTX 3050 Laptop 4 GB üzerinde (@umran666, #1103), **1935–1957 MHz'de 208.6 tok/s, 2.40 GB tepe**
veriyor. Bu, aynı oturumda ölçülen GEMM tavanının %59'una denk geliyor; onarım öncesi satırda oran
%68'di: birim saat frekansı başına yaklaşık %14 daha yavaş, yani ham 1.74x kazanç bir hızlanma değil,
saat frekansı farkıdır. Büyük katman akışı da iki satır arasında bellek düzenini değiştirdi; bu yüzden
bu oran bile bire bir karşılaştırma değildir — [kayıt](benchmarks/gate-v0.72.2-nf4.md).)
İsteğe bağlıdır (`stream_layers: true`) ve hâlâ BETA —
[nasıl çalışır](docs/performance-and-quantization.md#layer-streaming-beta-v0720-nf4-v0722-disk--wider-archs-v0723-preference-losses-v0724) ·
[tüm ölçümler](benchmarks/) · [makale](https://doi.org/10.5281/zenodo.21771064) ·
**[ücretsiz bir Colab T4'te kendiniz doğrulayın](notebooks/proof-4gb.ipynb)** (süreci 4 GB ile
sınırlar, ardından akışlı bir modelin normal bir modelle bit düzeyinde özdeş olduğunu doğrular)
Llama-3.1-8B-Instruct + NF4, LoRA, batch boyutu 1, dizi uzunluğu 512, RTX 3050 Laptop 4 GB üzerinde — 3.32 GB tepe, 119.6 tok/s, 952 MHz'de (onarım öncesi, v0.72.2; #331 sonrası: 1935 MHz'de 208.6 tok/s, 2.40 GB, doğrudan karşılaştırılamaz, @umran666, #1103). Tam video (90 sn)
## Neden Soup?
LLM eğitmek hâlâ zahmetli. Deneyimli ekipler bile zamanlarının %30-50'sini modelleri iyileştirmek
yerine altyapıyla boğuşarak geçiriyor. Soup bunu çözer.
- **SSH yok.** Bozuk bir GPU makinesine bir daha asla SSH ile bağlanmayın.
- **Tek yapılandırma.** İhtiyacınız olan tek şey basit bir YAML dosyası.
- **Her şey otomatik.** Toplu iş boyutu, GPU algılama, niceleme — halledilir.
- **Yerelde çalışır.** QLoRA ile kendi GPU'nuzda eğitin. Bulut gerekmez.
## Yenilikler
**v0.77.2 — v0.77.1'den sonra `main`'in bir kesiti: 159 pull request, bunların 153'ü bakımcı
dışındaki 30 kişiden.** Büyük kısmı düzeltme. Ayrıca yeni özellikler ve v0.77.1'in kabul ettiğini
reddedebilen iki kural getiriyor; bu yüzden bir sunucuyu ya da bir `task: sft` yapılandırmasını
yükseltmeden önce [v0.77.2 sürüm notlarını](https://github.com/MakazhanAlpamys/Soup/releases/tag/v0.77.2) okuyun. 0.76.x'ten geliyorsanız önce
`soup doctor --config soup.yaml` komutunu çalıştırın ve [v0.77.0 sürüm notlarını](https://github.com/MakazhanAlpamys/Soup/releases/tag/v0.77.0) okuyun.
- **`soup profile --model `, `soup.yaml` olmadan "sığar mı?" sorusunu yanıtlıyor.** Çalıştırmayı
modelin `config.json` dosyasından fiyatlıyor; sonucu `--seq`, `--batch`, `--method`, `--lora-r`,
`--optimizer` ve `--gradient-checkpointing` belirliyor; Apple Silicon'da Metal'in çalışma kümesiyle
karşılaştırıyor. `soup plan` ve `soup apply` artık `--minillm-on-policy` alıyor.
- **Apple Silicon'da daha fazla eğitim.** `preference_loss: dpo`, `orpo` ya da `simpo` ile
`task: preference` yerel MLX eğiticisini çalıştırıyor, MLX GRPO 4-bit `mlx-community` tabanlarında
eğitiliyor ve MLX Adafactor yapılandırılmış öğrenme oranını ve çizelgesini izliyor.
- **İki yeni DPO tarifi:** `qwen3.5-0.8b-dpo` ve `qwen3.5-27b-dpo`.
- **Daha yakın VRAM tahminleri.** Optimizer adımı kendi başına bir aşama; bir PRM adımına tek konumun
logit'leri yazılıyor; parçalanmış bir FSDP ya da ZeRO çalıştırması kart başına fiyatlanıyor;
`stream_loss_chunk` adımına son katmanının yeniden hesaplaması yazılıyor; Unsloth'un LoRA hedefleri
yükleyicisinin seçtiği gibi hesaplanıyor.
- **Sessiz üzerine yazmalar ve boş sonuçlar azaldı.** Daha fazla komut, bir girdiyi adlandıran
`--output` değerini reddediyor (`soup data ingest`, `persona-mix`, `generate` ve diğerleri);
`soup ship --adapter` hiçbir şeyi değiştirmeyen bir adaptörü reddediyor; `soup distill-prompt`,
`soup data evolve`, `gen-magpie` ve `filter --perplexity` boş ya da filtrelenmemiş bir dosya yazmak
yerine hata veriyor.
- **Tercih ve RL düzeltmeleri.** `data.max_length` SimPO ve KTO için yeniden geçerli, PPO istenince
politikasını checkpoint'liyor (4-bit ve 8-bit altında artık çökmüyor) ve `soup merge` adaptörün
eğitildiği taban commit'ini yüklüyor.
- **Metin yazıldığı gibi gösteriliyor.** Onlarca komut yolları, adları ve iletileri köşeli
parantezler ve `:name:` metni korunarak, terminal denetim karakterleri kaldırılarak yazdırıyor.
**Bilmeniz gereken davranış değişiklikleri.** `soup serve --tool-auth-token`, `A-Z`, `a-z`, `0-9`,
`_` ve `-` karakterlerinden oluşan 16 ila 128 karakter olmalı (aksi halde çıkış kodu 2).
`task: sft`, `reasoning_effort`, `train_on_eot`, `use_flash_attn` ve `use_liger` ayarlarını,
bunları hiç uygulamayan görü, ses, MLX, Unsloth, RAFT ve önceden belirteçlenmiş yollarda reddediyor.
`soup completions` betiklerinin yeniden üretilmesi gerekiyor.
`soup data from-traces --signal thumbs_up`, MLX Adafactor, `soup merge` ve VRAM ön kontrolü
v0.77.1'den farklı bir sonuç verebilir.
Eski sürümlerin öne çıkanları [GitHub Releases](https://github.com/MakazhanAlpamys/Soup/releases) sayfasında.
## Hızlı Başlangıç
### 1. Kurulum
Soup bir komut satırı uygulamasıdır; bu yüzden en temiz kurulum ona kendi ortamını verir ve
`soup`'u `PATH`'inize ekler:
```bash
# Hafif çekirdek: CLI + yapılandırma + veri araçları, PyTorch yok
pipx install soup-cli
uv tool install soup-cli # aynı fikir, zaten uv kullanıyorsanız
# Eğitim yığınını ekleyin (torch, transformers, peft, trl, datasets, …)
pipx install "soup-cli[train]"
# Her şey (train + serve + ui + data) tek seferde
pipx install "soup-cli[all]"
# Ya da GitHub'dan (en son geliştirme sürümü)
pipx install "git+https://github.com/MakazhanAlpamys/Soup.git"
```
Zaten bir virtualenv'in, bir Colab not defterinin ya da bir Docker imajının içinde misiniz? Aynı
adlar ve eklerle doğrudan `pip` kullanın:
```bash
pip install soup-cli
pip install "soup-cli[train]"
pip install "soup-cli[all]"
pip install git+https://github.com/MakazhanAlpamys/Soup.git
```
Kendi kodunuzdan da `import soup_cli` yapmak istiyorsanız `pipx` yerine `pip` kullanın; çünkü
pipx uygulamayı kasıtlı olarak diğer her şeyden yalıtır.
Eklerin tam tablosu (`fast`, `mlx`, `serve`, `eval`, `ui`, `vision`, `audio`, …)
[`docs/models.md`](docs/models.md#optional-extras) içinde yer alır.
> **`error: externally-managed-environment` mı?** Bu,
> [PEP 668](https://peps.python.org/pep-0668/)'dir; bir Soup sorunu değil. Debian 12,
> Ubuntu 23.04 ve sonrası `pip`'in sistem Python'una yazmasını engeller, çünkü bu dosyaları
> `apt` de yönetir. `pipx` ve `uv tool`, Soup'a kendi ortamını vererek bunu aşar; yukarıda ilk
> sırada yer almalarının nedeni budur. `python3 -m venv .venv && source .venv/bin/activate`
> ardından düz `pip` de aynı ölçüde işe yarar.
> **Tek tırnak değil, çift tırnak.** `"soup-cli[train]"` her kabukta çalışan tek yazımdır —
> `cmd.exe`, PowerShell, bash ve zsh. `'soup-cli[train]'` biçimini eski bir öğreticiden (tutorial)
> kopyaladıysanız ve pip reddettiyse, nedeni budur:
> [nedeni ve hatanın tam metni](docs/models.md#quoting-the-extra).
`soup init`, `soup data …` ve diğer veri/inceleme komutları hafif kurulumda çalışır.
İnce ayar (`soup train`) `[train]` ekini gerektirir.
### 2. Bir yapılandırma oluşturun
```bash
soup init # etkileşimli sihirbaz
soup init --template chat # ya da bir şablondan başlayın
```
Şablonlar: `chat`, `code`, `tool-calling`, `medical`, `reasoning`, `vision`, `kto`, `orpo`,
`simpo`, `ipo`, `bco`, `rlhf`, `pretrain`, `moe`, `longcontext`, `embedding`, `audio`.
### 3. Eğitin, test edin, yayınlayın
```bash
soup train --config soup.yaml # LoRA, niceleme, toplu işleme — hepsi halledilir
soup chat --model ./output # modelinizle konuşun
soup push --model ./output --repo you/my-model
soup merge --adapter ./output # LoRA'yı tabana birleştirin
soup export --model ./output --format gguf --quant q4_k_m # Ollama / llama.cpp için GGUF
```
Diğer dışa aktarma hedefleri (ONNX, TensorRT, BitNet) ve dağıtım seçenekleri
[`docs/serving-and-export.md`](docs/serving-and-export.md) içinde yer alır.
## Web Arayüzü
Tarayıcı mı tercih edersiniz? `soup ui`; deneyler, eğitim kurulumu, canlı metrikler, veri kümesi
keşfi ve modelle sohbet için yerel bir pano sunar.
```bash
pip install "soup-cli[ui]"
soup ui
# http://127.0.0.1:7860/?token= adresini açar
```
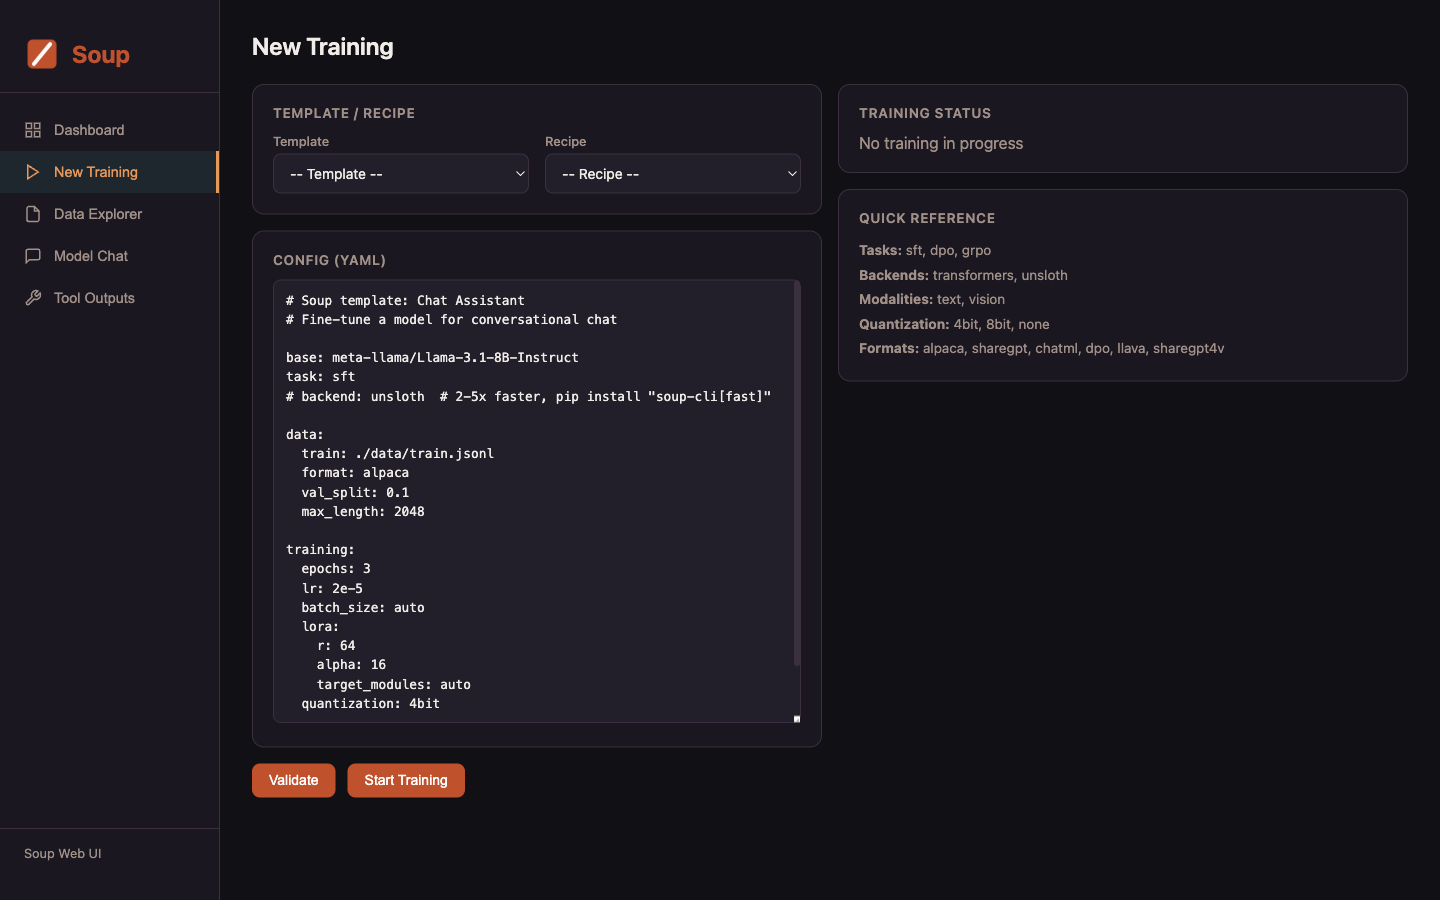
[Web Arayüzü belgeleri](docs/serving-and-export.md#web-ui)
## Yapılandırma
Eksiksiz bir `soup.yaml`:
```yaml
base: meta-llama/Llama-3.1-8B-Instruct
task: sft
# backend: unsloth # 2-5 kat daha hızlı, pip install "soup-cli[fast]"
data:
train: ./data/train.jsonl
format: alpaca
val_split: 0.1
training:
epochs: 3
lr: 2e-5
batch_size: auto
lora:
r: 64
alpha: 16
quantization: 4bit
output: ./output
```
`config/schema.py` her alanın tek doğru kaynağıdır. Gelişmiş veri, eğitim ve PEFT seçenekleri
[Belgeler](#belgeler) altında belgelenmiştir.
> **Bilinmeyen yapılandırma anahtarları v0.75'ten beri reddediliyor.** Hiçbir modelin
> tanımlamadığı bir anahtar — `quantizaton` gibi bir yazım hatası ya da yalnızca daha yeni bir
> Soup sürümünde bulunan bir alan — eskiden şema doğrulamasından sorunsuz geçip atılıyordu; yani çalıştırma,
> o ayar hiç uygulanmadan devam ediyordu. v0.74 bunu yükleme anında, muhtemelen kastettiğiniz
> alanı belirterek bildiriyordu; **v0.75**'ten itibaren aynı yapılandırma doğrudan reddediliyor;
> bu yüzden anahtarın yoksayılmasına güvenmek yerine onu düzeltin ya da kaldırın. Bkz.
> [Bilinmeyen yapılandırma anahtarları](docs/backends-and-ops.md#unknown-config-keys).
## Belgeler
Tam özellik başvurusu [`docs/`](docs/) içinde. Buradan başlayın:
| Rehber | Kapsam |
|---|---|
| [Eğitim görevleri ve yöntemleri](docs/training.md) | SFT, DPO/GRPO/PPO/KTO/ORPO/SimPO/IPO/BCO, araç çağırma, PRM, ön eğitim, damıtma, sınıflandırma, görsel/ses/TTS, unlearning (öğrenileni silme), RAFT/RA-DIT, döngü sertleştirme algılayıcıları |
| [PEFT, uzun bağlam ve verimlilik](docs/peft-and-efficiency.md) | DoRA, LoRA+, rsLoRA, VeRA, OLoRA, NEFTune, PiSSA, ReLoRA, optimizer ve PEFT çeşitliliği, LLaMA Pro, GaLore, YaRN/LongLoRA, paketleme, müfredat, otomatik ayarlama |
| [Performans ve niceleme](docs/performance-and-quantization.md) | QAT, FP8, Niceleme Menüsü (I + II), KV önbelleği, NVFP4, kaydetme biçimleri, Cut Cross-Entropy, gradyan checkpointing'i (kontrol noktası), çekirdekler, aktivasyon boşaltma, katman akışı, çoklu GPU / DeepSpeed / FSDP |
| [Veri mühendisliği](docs/data.md) | Biçimler, Axolotl/LF eşdeğeri ardışık düzen, veri araçları, sentetik üretim ve forge, kalite karneleri, iz (trace) araçları, uzak veri kümeleri, karıştırma, tarif DAG'ları |
| [Değerlendirme ve sondalar](docs/evaluation.md) | Değerlendirme tasarımı/kapısı, değerlendirme kapılı eğitim, kıyaslamalar, NLG metrikleri, kalibrasyon, Elo arenası, teşhis, eğitim sonrası X-ray sondaları, A/B, kayma, ayarlanabilirlik, `soup advise` |
| [Model servisi ve dışa aktarma](docs/serving-and-export.md) | OpenAI uyumlu sunucu, toplu çıkarım, kıyaslama, birleştirme/dışa aktarma, Anthropic Messages uç noktası, spekülatif kod çözme (kendi taslak modelinizi eğitin + ölçün), dağıtım otomatik pilotu, Web Arayüzü, Agent Forge |
| [Adaptörler, model kayıt defteri ve yönetişim](docs/adapters-and-governance.md) | Adaptör yaşam döngüsü/yönetimi, model kayıt defteri, Soup Cans, veri çarkı (`soup loop`), bilgi düzenleme, yönlendirme (steering), tedarik zinciri kontrolleri (scan/sign/BOM/attest/audit/airgap) |
| [Uyumluluk ve yönetişim için hızlı başlangıç](docs/compliance.md) | HIPAA/SOC2/EU-AI-Act/SR-11-7 `init` şablonları, köken bilgisi (BOM/attest/repro-receipt), denetim günlüğü, air-gap, model kartı otomatik üretimi (`soup card`), CI kapısı (`soup ci init`) |
| [Arka uçlar, platform ve operasyon](docs/backends-and-ops.md) | MLX/Unsloth arka uçları, alternatif hub'lar, HF Hub entegrasyonu, otomatik pilot, deney takibi, plan/apply, ortam kilit dosyaları, donanım uygunluğu, kabuk otomatik tamamlama, eklentiler (plugin), yardımcı komutlar |
| [Komut başvurusu](docs/commands.md) | Tam `soup` komut listesi |
| [Desteklenen modeller ve ekler](docs/models.md) | Önerilen model aileleri, VRAM boyut rehberi, pip isteğe bağlı bağımlılık grupları (extras) matrisi |
## Veri Biçimleri
Alpaca, ShareGPT, ChatML, tercih çiftleri (DPO / ORPO / SimPO / IPO / KTO), görü, ses, ASR, düz
metin, gömme (embedding), RAFT ve daha fazlası — hepsi JSONL, JSON, CSV, Parquet veya TXT'den
otomatik algılanır; bu yüzden çoğu durumda `data.train`'i bir dosyaya yöneltirsiniz ve başka hiçbir
şey değişmez. Her biçim için adım adım çözümlü bir örnekle şemalar ve veri ardışık düzeni (uzak URI'ler,
akış, parçalama, iç içe geçirme, sözcük dağarcığı genişletme, belge içe aktarma)
[`docs/data.md`](docs/data.md#data-formats) içinde; [yerel Sesame CSM ses eğitimi](docs/training.md#native-sesame-csm) ise ayrı belgelenmiştir.
## Yaygın Komutlar
```bash
soup train --config soup.yaml # eğitin (SFT/DPO/GRPO/PPO/KTO/ORPO/SimPO/IPO/...)
soup infer --model ./output --input prompts.jsonl --output results.jsonl # toplu çıkarım
soup chat --model ./output # etkileşimli sohbet
soup serve --model ./output # OpenAI uyumlu API sunucusu
soup ui # yerel tarayıcı panosu
soup merge --adapter ./output # LoRA'yı taban modele birleştirin
soup export --model ./output --format gguf # dağıtım için dışa aktarın
soup eval benchmark --model ./output # değerlendirin
soup data inspect ./data/train.jsonl # veri kümesi istatistikleri
soup recipes list # 100+ hazır model tarifi
soup autopilot --model --data d.jsonl --goal chat # sıfır yapılandırma
soup doctor # GPU / bağımlılıklar / ortamı denetleyin
```
Tam komut listesi [`docs/commands.md`](docs/commands.md) içinde.
## Desteklenen Modeller
Soup, [HuggingFace Hub](https://huggingface.co/models?pipeline_tag=text-generation) üzerindeki
**herhangi** bir metin üretim modeliyle çalışır — `AutoModelForCausalLM` ile yükleniyorsa, sıfır
yapılandırma değişikliğiyle çalışır. Llama 3.x/4, Qwen 2.5/3, Gemma 3, Mistral, Mixtral, DeepSeek
R1/V3, Phi-4 ve 100'den fazlası hazır tarifler olarak gelir (`soup recipes list`).
| VRAM | En büyük model (QLoRA 4-bit) | Örnek |
|---|---|---|
| 8 GB | ~7B | Llama-3.1-8B, Mistral-7B |
| 16 GB | ~14B | Phi-4-14B, Qwen2.5-14B |
| 24 GB | ~34B | CodeLlama-34B, Yi-1.5-34B |
| 48 GB | ~70B | Llama-3.3-70B |
| 80 GB+ | 70B+ (tam) veya MoE | Mixtral-8x22B, DeepSeek-V3 |
Tam model + görü tabloları ve isteğe bağlı ekler matrisi [`docs/models.md`](docs/models.md) içinde.
## Docker
CUDA ya da PyTorch'u yerel olarak kurmadan Soup'u çalıştırın (imaj her sürümde GHCR'a yayımlanır):
```bash
docker pull ghcr.io/makazhanalpamys/soup:latest
docker run --gpus all -v $(pwd):/workspace ghcr.io/makazhanalpamys/soup train --config soup.yaml --yes
docker compose up # ya da yerel olarak derleyin
```
## Gereksinimler
- Python 3.11, 3.12 veya 3.13 (CI'ın test ettiği sürümler bunlar; PyTorch yığını orada henüz
doğrulanmadığı için 3.14+ şimdilik desteklenmiyor)
- CUDA'lı GPU (önerilen), Apple Silicon (MPS) veya CPU (deneysel — çok yavaş)
- QLoRA ile 7B modeller için 8 GB+ VRAM
Tüm eğitim görevleri test amacıyla CPU'da çalışır (niceleme otomatik olarak kapatılır). İsteğe bağlı
ekler (`train`, `all`, `fast`, `vision`, `qat`, `serve`, `serve-fast`, `ui`, `eval`, `deepspeed`,
`liger`, `mlx`, `onnx`, `tensorrt`, …) [`docs/models.md`](docs/models.md#optional-extras) içinde
listelenmiştir.
## Sorun Giderme
```bash
soup doctor # GPU, sistem kaynakları, bağımlılıklar ve sürüm tek yerde
```
CUDA wheel paketleri, sürüm uyumsuzlukları: [`docs/backends-and-ops.md`](docs/backends-and-ops.md#troubleshooting).
## Geliştirme
```bash
git clone https://github.com/MakazhanAlpamys/Soup.git
cd Soup
pip install -e ".[dev]"
ruff check src/soup_cli/ tests/ # lint
pytest tests/ -v # birim testleri (hızlı, GPU yok)
pytest tests/ -m smoke -v # duman testleri (küçük bir model indirir, eğitir)
pytest tests/ -m gpu --no-cov -v # GPU testleri (CUDA kartı gerekir; sonuçları bildirin, bkz. CONTRIBUTING.md)
pre-commit install # isteğe bağlı: commit'te ruff lint+format
```
Tam iş akışı için [CONTRIBUTING.md](CONTRIBUTING.md)'ye, bir güvenlik açığı bildirmek için
[SECURITY.md](SECURITY.md)'ye bakın. Telemetri yalnızca siz açıkça etkinleştirirseniz çalışır (`SOUP_TELEMETRY=1`,
varsayılan olarak kapalı; bkz. [Gizlilik Politikası](docs/backends-and-ops.md#privacy-policy)).
## Soup'u Destekleyin
Soup Apache-2.0 lisanslı ve ücretsizdir — ve öyle kalacak. Tek bir 4 GB dizüstü bilgisayarda, herkesin gözü önünde, açık kaynak
olarak geliştirilir ve sürdürülür; bu belgelerdeki her performans rakamının iddia edilmek yerine
ölçülmüş olmasının nedeni budur.
Soup size bir eğitim çalıştırması kazandırdıysa, [depoya yıldız vermek](https://github.com/MakazhanAlpamys/Soup)
en çok işe yarar ve hiçbir maliyeti yoktur. Çalışmayı doğrudan finanse etmek isterseniz:
**[❤️ Bağış yapın](https://buy.stripe.com/4gMcN441k3pha3T19ye7m04)** — tek seferlik, istediğiniz
miktarda (ödeme sayfasında *Tutarı değiştir* / *Change amount* seçeneğini kullanın). Ödemeler,
bakımcının kayıtlı işletmesi **MePlay, Inc.** adına Stripe tarafından işlenir — ödeme sayfasında ve
kart ekstrenizde "Soup" değil, bu ad görünür.
Bağışlar, donanıma bağlı işler için GPU süresi satın alır — çoklu GPU, 8B+ doğrulama, Apple
Silicon — tek bir 4 GB dizüstünün ulaşamadığı işler.
Tam da bu kalemleri ilerletmenin diğer yolu **donanımın kendisidir**. Bunlar doğrulanmamış iddialar
yerine dürüst "\ gerektirir" kapılarının arkasında yayımlanır; dolayısıyla daha büyük bir
makineye — ya da kullanılmayan GPU kredilerine — erişiminiz varsa,
[`help wanted`](https://github.com/MakazhanAlpamys/Soup/issues?q=is%3Aissue+is%3Aopen+label%3A%22help+wanted%22)
issue'lardan birini çalıştırıp sayıları paylaşmak, GPU süresini finanse etmek kadar yardımcı olur.
Bu issue'lar, bugün donanım yüzünden tam olarak neyin engellendiğini söyler.
## Katkıda Bulunanlar
Topluluk tarafından geliştirildi ❤️ — katkıda bulunan herkese teşekkürler. Bkz.
[CONTRIBUTORS.md](CONTRIBUTORS.md).
[](https://github.com/MakazhanAlpamys/Soup/graphs/contributors)
## İletişim
Hatalar ve özellik istekleri [issue takipçisine](https://github.com/MakazhanAlpamys/Soup/issues),
sorular [Discussions](https://github.com/MakazhanAlpamys/Soup/discussions)'a aittir — ikisi de daha
hızlı yanıtlanır ve aynı sorunu yaşayan bir sonraki kişiye yardım eder.
Canlı sohbet, kurulum yardımı ve karşılıklı konuşarak çözülmesi daha kolay olan her şey için
[Discord](https://discord.gg/dgd2pJcjwP)'a ya da [Telegram topluluğuna](https://t.me/souptasters)
katılın. Altı ay sonra hâlâ bulunabilir olması gereken her şey Issues'a ya da Discussions'a aittir —
bir Discord yanıtı tek bir kişiye yardım eder, bir issue ise aynı şeyle karşılaşan herkese.
[Davranış Kuralları](CODE_OF_CONDUCT.md) orada da geçerlidir.
Herkese açık olmaya uygun olmayan her şey için — güvenlik bildirimleri (bkz. [SECURITY.md](SECURITY.md)),
Davranış Kuralları meseleleri ya da basın — **team@trysoup.dev** adresine e-posta gönderin. Bu,
projenin adresidir ve Soup'la ilgili her şey için doğru adres budur. **makazanalpamys@gmail.com**
bakımcının kişisel adresidir; aynı kişiye ulaşır ve iyi bir yedektir.
## Soup'a Atıf
Katman akışı — dondurulmuş tabanı ana bilgisayar RAM'inden her seferinde bir kod çözücü katman
olarak aktararak 4 GB dizüstü GPU'da 8B bir model eğitmek — bir ön baskıda, akışlı bir çalıştırmayı
belleğe yerleşik bir çalıştırmaya karşı doğrulayan doğruluk protokolüyle birlikte anlatılır (ileri
ve geri geçiş ayrı ayrı belirtilir; çünkü bunlar tek değil, iki iddiadır).
> Makazhan, A. (2026). *Exact Layer Streaming: LoRA Fine-Tuning of an 8B Model on a 4 GB Laptop
> GPU* (v3). Zenodo. https://doi.org/10.5281/zenodo.21918325
**Sürüm 3 (13 Ağustos 2026) günceldir.** Başlık ve iddia değişmedi — 4 GB'da 8B — ve v1'den bu yana
ölçülmüş hiçbir sayı değişmedi. v3'ün yaptığı şey **yayımladığımız bir açıklamayı geri çekmektir**;
bu aynı zamanda makalenin ne işe yaradığını anlatmanın en kısa yoludur:
- **v3'te geri çekildi: "katman akışını sınırlayan GPU değil, ana bilgisayardan cihaza aktarımdır."**
Bu, aşağıdaki H100 yeniden üretiminden yapılmış bir *çıkarımdı* ve hiç ölçülmemişti. 11 Ağustos'ta
ölçtük ve yayımlanan yapılandırmada yanlış: ana bilgisayardan cihaza giden her baytı silmek
**%1.4** kazandırıyor, hesaplama akışı adımın **%0.20**'sinde bir kopyayı bekliyor ve
adım, o kartın aynı oturumdaki GEMM tavanının **%71.3**'ünde çalışıyor. Akışa özgü en büyük
maliyet, %9.8 ile katman başına NF4 ters nicelemesi
([kayıt](benchmarks/probe-v0.73.0-what-bounds-streaming.md)). Her ölçüm geçerliliğini koruyor;
yeniden üretim daha zayıf bir biçimde ayakta kalıyor — kısıt her iki makinede ortak ve GPU'nun
hesaplama gücü değil.
- **Özgününe hiç benzemeyen donanımda yeniden üretim** (v2'de eklendi): RTX 3050'de (952 MHz'de)
119.6 tok/s'ye karşı bir H100'de medyan 113.00, aynı 3.32 GB tepede. İkisi de #331 onarımından
önce ölçüldü ve makalenin bildirdiği rakamlar bunlardır. #331 sonrası satır (@umran666, #1103),
1935–1957 MHz'de 208.6 tok/s ve 2.40 GB tepedir; aynı oturumda ölçülen GEMM tavanının %68'ine
karşı %59'u. Ham 1.74x kazanç bir hızlanma değil, saat frekansı farkıdır; satırlar arasında bellek
düzeni de değişti, bu yüzden bu oran bile bire bir karşılaştırma değildir
([kayıt](benchmarks/gate-v0.72.2-nf4.md)).
- **Sessiz bir yanlış gradyan kusuru, bulundu ve onarıldı.** Katman başına ~165 MiB'ın üzerindeki
NF4'te ileri geçiş bit düzeyinde özdeş kaldı ve kayıp eğrisi sağlıklı göründü, ama gradyanlar
yanlıştı. Neden, upstream kütüphanede adıyla belirtildi ve orada bildirildi; onarım, gerçek 32B
ve 72B modellerde kontrol çalıştırmalarına karşı doğrulama kapısından geçirildi.
- **Gerçek model boyutlarında bit düzeyinde özdeşlik**, üç katmanlı oyuncak modeller yerine: ileri geçiş
0.5B'den 72B'ye, geri geçiş 8B ve 14B'de.
- **Eğitilmiş model kalitesi, ilk kez ölçüldü** ve belleğe yerleşik bir çalıştırmadan ayırt
edilemiyor.
- **DeepSpeed ile karşılaştırma** — bizi pohpohlamayan sonuç dahil: sekiz kartlık ZeRO-3, belleğe
yerleşik eğiten tek bir karttan daha yavaş.
- **Sınırlamalar bölümü yeniden yazıldı**: v1'in on maddesinden biri kapandı, dördü daha daraldı ve
yedi yeni madde eklendi.
Kullandığınız sürüme atıf yapın. `10.5281/zenodo.21771064` kavram DOI'sidir ve her zaman en son
sürüme (bugün v3) çözümlenir; v1 ve v2 kendi sürüm DOI'leriyle atıf yapılabilir durumda kalır ve
düzenlenmez — yukarıdaki geri çekme, neyi ne zaman iddia ettiğimizin kaydı bozulmadan kalsın diye
tam da bu yüzden yeni bir sürümdür.
Makaledeki her sayının arkasındaki ölçüm kayıtları, yazıldığı haliyle [`benchmarks/`](benchmarks/)
içinde yayımlanmıştır — başarısızlıklar, yanlış çıkan varsayımlar ve ölçülüp sonra atılan sayılar
dahil.
```bibtex
@misc{makazhan2026exact,
title = {Exact Layer Streaming: LoRA Fine-Tuning of an 8B Model on a 4 GB Laptop GPU},
author = {Makazhan, Alpamys},
year = {2026},
publisher = {Zenodo},
version = {v3},
doi = {10.5281/zenodo.21918325},
url = {https://doi.org/10.5281/zenodo.21918325}
}
```
## Lisans
[Apache-2.0](LICENSE). Copyright 2026 Makazhan Alpamys and the Soup contributors. Soup'u veya değiştirilmiş bir kopyasını yeniden dağıtırsanız lisansın 4. ve 6. maddeleri sizin için geçerlidir: her kopyayla birlikte `LICENSE` ve `NOTICE` dosyalarını koruyun, değiştirdiğiniz dosyaları işaretleyin ve Soup adını eserin kaynağını belirtmenin ötesinde kullanmayın.