English | 中文
Hy-Nomas: Towards Free-Form Interactive
World Generation
**Hy-Nomas** 是一个通过多轮文本与相机控制的自由形式交互式世界生成模型。采用低显存推理配置可在单张 RTX 4090 上运行,支持下游任务 LoRA 微调,并提供交互式 Web Demo。
🖥️ 交互式演示 |
🌐 项目网站 |
📄 技术报告
## 🔥 最新动态
- 🤝 **2026 年 10 月 26 日 — 社区集成:** Hy-Nomas 已支持 [SGLang](https://github.com/sgl-project/sglang/pull/46124)、[ComfyUI](https://github.com/PedroMarinhoDev/ComfyUI-Hy-Nomas) 和 [Reactor Runtime](reactor/README.md),详情请见[社区贡献](#-社区贡献)。
- 📄 **2026 年 10 月 26 日 — 技术报告:** 更新 [Hy-Nomas 技术报告](https://github.com/Tencent-Hunyuan/Hy-Nomas/blob/main/Hy_Nomas_Tech_Report.pdf)。
- 🌍 **2026 年 10 月 25 日 — WanGP 支持:** [@deepbeepmeep](https://x.com/deepbeepmeep) 在 [WanGP v18.81](https://github.com/deepbeepmeep/WanGP) 中加入 Hy-Nomas 世界生成,支持键盘探索和文本事件控制。详见[公告](https://x.com/deepbeepmeep/status/2114503683295662230)与[集成提交](https://github.com/deepbeepmeep/WanGP/commit/c4d3efce4cd896c6e14fcb82787577bfc3181b99)。
- 🛠️ **2026 年 10 月 23 日 — Diffusers 推理:** 新增 [Diffusers 推理示例](#使用-diffusers-推理)。
- 🎮 **2026 年 10 月 21 日 — 交互式演示:** 在[在线演示](https://hy-nomas.hy.tencent.com/demo)中体验多轮文本和相机控制,也可参考[部署指南](apps/README.md)自行运行。
- 🚀 **2026 年 10 月 21 日 — 首次代码发布:** 训练与推理代码包含 [LoRA 微调](#lora-微调)和[单 GPU 推理](#低显存-gpu-推理)。下载[模型权重](https://huggingface.co/tencent/Hy-Nomas)即可开始探索。
## 🎥 演示
https://github.com/user-attachments/assets/e7a2528c-4ccc-461c-8f09-207650f1f0bd
## 🧩 社区贡献
如果你在项目中开发或使用 Hy-Nomas,欢迎告诉我们。
- **WanGP** — [WanGP](https://github.com/deepbeepmeep/WanGP),由 [@deepbeepmeep](https://x.com/deepbeepmeep) 提供:v18.81 支持 Hy-Nomas 文本生成世界、键盘导航与相机控制、文本事件控制及可调历史记忆,可保存并继续探索,或将探索过程录制为视频。详见[公告](https://x.com/deepbeepmeep/status/2114503683295662230)与[集成提交](https://github.com/deepbeepmeep/WanGP/commit/c4d3efce4cd896c6e14fcb82787577bfc3181b99)。
- **SGLang** — [SGLang Diffusion](https://github.com/sgl-project/sglang),由 [@sgl_project](https://x.com/sgl_project) 提供:Hy-Nomas 支持已合入 `main` 分支,可运行离线视频任务和实时流式会话,详见[集成 PR](https://github.com/sgl-project/sglang/pull/46124)。
- **ComfyUI** — [ComfyUI-Hy-Nomas](https://github.com/PedroMarinhoDev/ComfyUI-Hy-Nomas),由 [@LatentSpacer](https://x.com/LatentSpacer) 提供:支持视频片段串联生成和交互式 WASD 相机控制。
- **Reactor Runtime** — [Hy-Nomas 集成指南](reactor/README.md),由 [@Rising0321](https://github.com/Rising0321) 贡献:提供流式服务和浏览器演示,支持实时更新提示词、WASD/方向键相机控制,以及上传相机轨迹,同时保留世界历史。详见[集成 PR](https://github.com/Tencent-Hunyuan/Hy-Nomas/pull/3)。
感谢各位贡献者基于 Hy-Nomas 构建社区集成!
正在使用 Hy-Nomas 构建项目?欢迎分享社区项目、工具集成、教程和 LoRA 适配器。你可以[提交 Issue](https://github.com/Tencent-Hunyuan/Hy-Nomas/issues),或通过 Pull Request 将项目添加到本节。 参与本仓库开发请参阅[贡献指南](CONTRIBUTING.md)。
---
## 目录
- [🔥 最新动态](#-最新动态)
- [🎥 演示](#-演示)
- [🧩 社区贡献](#-社区贡献)
- [模型介绍](#模型介绍)
- [核心特性](#核心特性)
- [使用指南](#使用指南)
- [环境配置](#环境配置)
- [模型资源](#模型资源)
- [推理](#推理)
- [使用源码推理](#使用源码推理)
- [低显存 GPU 推理](#低显存-gpu-推理)
- [使用 Diffusers 推理](#使用-diffusers-推理)
- [交互式演示](#交互式演示)
- [Reactor Runtime](#reactor-runtime)
- [Web Demo](#web-demo)
- [LoRA 微调](#lora-微调)
- [SFT 数据准备](#sft-数据准备)
- [离线序列打包](#离线序列打包)
- [训练与合并](#训练与合并)
- [贡献指南](CONTRIBUTING.md)
- [安全问题报告](SECURITY.md)
- [许可证](#许可证)
- [联系我们](#联系我们)
---
## 模型介绍
**Hy-Nomas** 是一个自由形式交互式视频世界生成模型,支持自由形式的多轮文本提示词控制或相机控制。本仓库提供训练、推理、交互式演示和数据标注代码。
## 核心特性
- **分段生成:** 通过片段级提示词或相机控制信号,自回归地逐段生成世界,并维护贯穿整个生成过程的 KV 缓存以保持一致性。
- **自由形式提示词控制:** 使用任意类型的自由形式用户提示词控制世界生成,创造想象中的物体、风格、场景和动作。
- **相机控制:** 将相机轨迹与文本提示词一起作为生成条件。
- **蒸馏推理:** 推理使用 8 步去噪,并采用经过微调的 PixelUMM 解码器,对 32 通道 DCAE-V 潜变量进行解码。
- **交互式演示:** Web 界面支持多轮生成,并在片段边界进行解码。
- **微调与数据准备:** 使用自定义视频数据集进行 LoRA 微调,并通过我们的标注流程从本地视频准备训练数据。
## 使用指南
### 环境配置
请选择以下两种环境配置方式之一。**强烈推荐使用预打包 Docker 镜像**,其中已配套准备 Python 环境、PyTorch 和所需的 CUDA 注意力内核。
#### 方式一:使用预打包 Docker 镜像(推荐)
请准备 Linux 主机、兼容的 NVIDIA 驱动、Docker 和 NVIDIA Container Toolkit。在仓库根目录执行:
```bash
export HY_NOMAS_IMAGE="hynomasoss/hynomasoss:cu130"
docker pull "$HY_NOMAS_IMAGE"
docker run --rm -it --gpus all --ipc=host --network=host \
-v "$PWD:/workspace/Hy-Nomas" \
-w /workspace/Hy-Nomas \
"$HY_NOMAS_IMAGE" bash
```
后续命令均在容器内执行,直接使用镜像预装的 Python 环境。将模型资源放在挂载的仓库目录中,或额外挂载模型目录;下方启动命令应填写容器内可见的模型路径。
#### 方式二:手动安装
请准备 Linux、Python 3.12+、uv、兼容的 NVIDIA 驱动、CUDA 13.0 Toolkit(`nvcc`)和 C++ 编译器。在仓库根目录执行:
```bash
uv sync --extra all
source .venv/bin/activate
```
`all` 依赖组包含 PyTorch 2.10.0(CUDA 13.0)、FlashAttention 2、FlashAttention 3 和 MagiAttention。`pyproject.toml` 已配置 PyTorch CUDA 包源、FA3 官方源码地址,并为注意力内核关闭构建隔离,使其可以使用环境中的 PyTorch 进行编译。内核编译可能需要一些时间。
### 模型资源
模型仓库包含 DiT 生成模型、LoRA 适配器、视频自编码器与解码器,以及用于在线提示词增强的 Nomas-PE。
从 Hugging Face 下载 `tencent/Hy-Nomas` 的全部模型权重,保留仓库目录结构:
```bash
export Hy_Nomas_Model_Path=/path/to/Hy-Nomas
hf download tencent/Hy-Nomas --local-dir "${Hy_Nomas_Model_Path}"
```
只需将 `Hy_Nomas_Model_Path` 设置为实际下载目录一次。后续命令会复用已设置的值;新终端未设置时默认使用 `/path/to/Hy-Nomas`。点击下方模型名称,即可在 Hugging Face 上查看其文件。
| 类别 | 模型资源 | 用途 |
|:---|:---|:---|
| DiT | **[基础自回归 DiT(FP32)](https://huggingface.co/tencent/Hy-Nomas/tree/main/DiT/base_ar)** | 未蒸馏检查点,用于 segment forcing LoRA 微调。 |
| DiT | **[蒸馏 DiT(FP32)](https://huggingface.co/tencent/Hy-Nomas/tree/main/DiT/distilled)** | 用于 4/6/8 步快速推理和交互式演示的检查点,也作为合并微调后 LoRA 适配器的基础模型。 |
| DiT | **[量化蒸馏 DiT(INT8)](https://huggingface.co/tencent/Hy-Nomas/tree/main/DiT/distilled_int8)** | 量化检查点,用于低显存推理,包括单 GPU 部署。 |
| DiT | **[Cinematic LoRA](https://huggingface.co/tencent/Hy-Nomas/tree/main/DiT/lora_weights/cinematic)** | 使用电影感数据训练的 LoRA 适配器,可合并到蒸馏 DiT 中,以提升生成世界的视觉质量。 |
| DiT | **[Robotics LoRA](https://huggingface.co/tencent/Hy-Nomas/tree/main/DiT/lora_weights/dual_arm_robotics)** | 使用 [RealSource-World](https://huggingface.co/datasets/RealmanRobot/RealSource-World) 真实机械臂数据集训练的 LoRA 适配器,可合并到蒸馏 DiT 中,以增强生成世界的机器人仿真能力。 |
| VAE | **[DCAE-V](https://huggingface.co/tencent/Hy-Nomas/tree/main/VAE/DCAE-V)** | 视频自编码器,用于将训练视频编码为潜变量,并对潜变量进行解码。 |
| VAE | **[微调版 PixelUMM 解码器](https://huggingface.co/tencent/Hy-Nomas/tree/main/VAE/PixelUMM_FT)** | 用于将生成的 DCAE-V 潜变量解码为视频帧的解码器。 |
| VAE | **[量化版 PixelUMM 解码器(FP8)](https://huggingface.co/tencent/Hy-Nomas/tree/main/VAE/PixelUMM_FT_FP8)** | 使用 FP8 权重的解码器,用于降低显存占用并加速解码。 |
| PE | **[Nomas-PE](https://huggingface.co/tencent/Hy-Nomas/tree/main/PE)** | 交互式演示使用的在线提示词增强模型,将用户指令转换为结构化的生成提示词。 |
### 推理
#### 使用源码推理
在仓库根目录使用 `configs/experiment/inference.yaml` 启动,覆盖模型路径、提示词文件和输出目录:
```bash
export Hy_Nomas_Model_Path="${Hy_Nomas_Model_Path:-/path/to/Hy-Nomas}"
bash scripts/inference/inference_from_config.sh configs/experiment/inference.yaml \
dit_weight="${Hy_Nomas_Model_Path}/DiT/distilled/diffusion_pytorch_model_ema_0_995.safetensors" \
model.vae.checkpoint="${Hy_Nomas_Model_Path}/VAE/PixelUMM_FT/diffusion_pytorch_model.safetensors" \
inference.prompt=/path/to/prompts.json \
inference.save_path=./outputs/distill
```
#### 低显存 GPU 推理
使用 `configs/experiment/single_gpu_low_mem_inference.yaml`,**Hy-Nomas 支持 NVIDIA GeForce RTX 4090 单卡推理**。该配置通过以下优化降低显存占用:
- **INT8 DiT 权重与 KV cache:** 使用 INT8 存储权重及缓存的 Key/Value,DiT 线性层和注意力仍使用 BF16 计算。
- **滑动窗口历史:** 限制保留的历史上下文,避免 KV cache 随生成片段持续增长。
- **CPU offload:** 文本编码器、DiT 和 VAE 仅在各自处理阶段移入 GPU,完成后移回 CPU。
- **单卡计算内核:** DiT 使用 FlexAttention,解码使用 CUTLASS FP8,并关闭序列并行(`sp_size=1`)。
请使用兼容的 INT8 DiT 检查点和 FP8 解码器检查点。在 `nvidia-smi` 仅能看到一张 GPU 的主机或容器中执行:
```bash
export Hy_Nomas_Model_Path="${Hy_Nomas_Model_Path:-/path/to/Hy-Nomas}"
bash scripts/inference/inference_from_config.sh configs/experiment/single_gpu_low_mem_inference.yaml \
dit_weight="${Hy_Nomas_Model_Path}/DiT/distilled_int8/diffusion_pytorch_model_ema_0_995_int8.safetensors" \
model.vae.checkpoint="${Hy_Nomas_Model_Path}/VAE/PixelUMM_FT_FP8/diffusion_pytorch_model_fp8.safetensors" \
inference.prompt=/path/to/prompts.json \
inference.save_path=./outputs/single_gpu
```
CPU offload 需要足够的系统内存来存放模型,并会增加 CPU–GPU 数据传输开销。峰值显存占用取决于分辨率和片段长度。
#### 使用 Diffusers 推理
升级 diffusers 以使用 `HyNomasModularPipeline`。
```bash
pip install -e "diffusers[hy-nomas] @ git+https://github.com/jiaxiangc/diffusers.git@hy-nomas"
```
Hy-Nomas 支持多轮交互生成。以下示例生成两个各 5 秒的视频片段。
```python
import json
import torch
from diffusers import HyNomasModularPipeline
from diffusers.utils import export_to_video
pipe = HyNomasModularPipeline.from_pretrained("tencent/Hy-Nomas-Diffusers")
pipe.load_components(dtype=torch.bfloat16)
pipe.to(device="cuda", dtype=torch.bfloat16)
# Use the FlashAttention and MagiAttention kernels installed with Hy-Nomas.
pipe.transformer.enable_reference_attention(text_backend="flash_varlen", deterministic=True)
prompts = [
{
"Style": "Cinematic fantasy", "perspective_view": "Third-person view",
"subject_list": [{
"subject_id": "fox", "display_name": "a small orange fox",
"subject_attribute": "Orange fur, white chest, and a fluffy tail.",
}],
"segments": [{
"visual_description_long": (
"A small orange fox stands on a stone path in a luminous forest. "
"Blue fireflies drift between the trees."
),
"contained_actions": [{
"start_time": "00:00.000", "end_time": "00:05.000",
"action_description": "The fox walks slowly along the path.",
}],
}],
},
{
"segments": [{
"description_change": "Glowing blue flowers open beside the path as the fox continues forward.",
"contained_actions": [{
"start_time": "00:00.000", "end_time": "00:05.000",
"action_description": "The fox passes the flowers and looks around.",
}],
}],
},
]
videos = pipe(
prompt=[json.dumps(prompt) for prompt in prompts],
height=704,
width=1280,
num_frames=240,
segment_latent_lengths=[30, 30],
fps=24,
num_inference_steps=4,
generator=torch.Generator("cpu").manual_seed(42),
output="videos",
)
export_to_video(videos[0], "hy_nomas_video.mp4", fps=24, quality=None)
```
### 交互式演示
#### Reactor Runtime
[Reactor 集成指南](reactor/README.md)提供流式服务和浏览器演示,支持实时更新提示词、WASD/方向键相机控制,以及上传相机轨迹,同时保留世界历史。已测试的配置使用八张 B200 GPU、Docker 和 NVIDIA Container Toolkit、[Reactor CLI](https://docs.reactor.inc/deploy/platform/installation)及 Node.js 22。
在仓库根目录运行:
```bash
cd reactor
reactor build
reactor run --gpus '"device=0,1,2,3,4,5,6,7"' --shm-size 8g --port 8080
```
等待 `curl -fsS http://localhost:8080/health` 返回 `available`。在另一终端中,从仓库根目录运行:
```bash
cd reactor/demo
npm ci
npm run dev -- --port 5173
```
打开 **http://localhost:5173**,将 Runtime endpoint 设为 **http://localhost:8080**,点击 **Connect**,输入提示词后点击 **Start world**。点击视频后可使用 WASD 和方向键探索。**Update prompt** 可更新后续片段而无需重启。远程 GPU 部署请参阅 [SSH 与 WebRTC 指南](reactor/README.md#remote-servers-and-ssh)。
#### Web Demo
访问[在线交互式演示](https://hy-nomas.hy.tencent.com/),体验 Hy-Nomas。
请参阅[演示部署指南](apps/README.md),了解如何启动 Web 网关和 GPU 工作进程、配置模型资源,以及在单机或多机上运行。演示默认使用 `configs/experiment/inference.yaml`。
## LoRA 微调
### SFT 数据准备
使用 [captioning-harness](captioning_harness/README.md) 从本地视频准备训练数据。该流程对每个片段进行标注,使用 DCAE-V 编码视频帧,并将结果打包为用于 SFT 的 Arrow 或 Parquet 文件。有关部署 K3 服务、运行标注与打包、附加归一化相机轨迹的详细说明,请参阅该指南。
### 离线序列打包
从已编码的训练文件生成 packing plan,在仓库根目录执行:
```bash
python scripts/data_processing/build_sft_packing_plan.py \
--input /path/to/train.arrow \
--output /path/to/train_packing.json \
--max-seq-len 360000 \
--num-groups 16 \
--seed 42
```
示例生成 16 组,对应 DP16 × SP8(128 张 GPU)。组数应为数据并行度的整数倍、不超过样本数,且在 `--max-seq-len` 限制下有足够容量。训练时使用相同的训练文件及行顺序,并通过 `dataset.token_packing_sorted_groups_path` 传入生成的 JSON。详情见[序列打包说明](captioning_harness/README.md#offline-sequence-packing)。
### 训练与合并
LoRA 微调以**未蒸馏检查点**为基础,使用 segment forcing 训练流程。训练完成后,将学到的 LoRA 权重合并到对应的**蒸馏后检查点**,生成新的合并检查点用于推理。
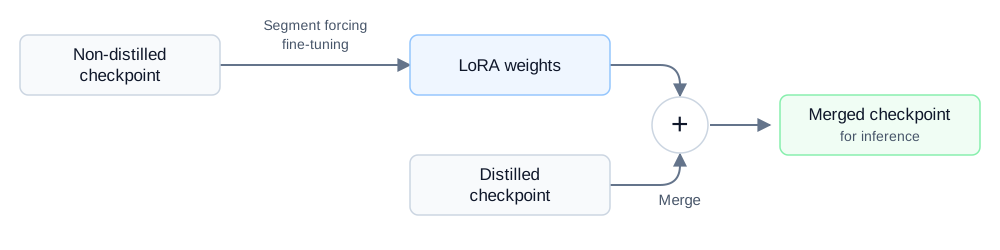
`configs/experiment/sft.yaml` 已启用 LoRA:rank/alpha 为 256,dropout 为 0,使用 Muon 优化器、恒定学习率 `1e-4`,训练 2,000 步。仅训练 LoRA 参数。
```bash
export Hy_Nomas_Model_Path="${Hy_Nomas_Model_Path:-/path/to/Hy-Nomas}"
bash scripts/train/train_from_config.sh configs/experiment/sft.yaml \
dit_weight="${Hy_Nomas_Model_Path}/DiT/base_ar/diffusion_pytorch_model_fp32.safetensors" \
model.vae.checkpoint="${Hy_Nomas_Model_Path}/VAE/DCAE-V/dc-ae-v-1.0-f32t4c32-bf16.pt" \
dataset.data_file=/path/to/train.arrow \
dataset.token_packing_sorted_groups_path=/path/to/train_packing.json \
output_dir=./outputs/segment_lora
```
训练配置使用 SP8;128 张 GPU 对应 DP16 × SP8。请根据硬件设置启动规模,并为相应的数据并行度生成 packing plan。
先导出保存的 LoRA 检查点,再将其合并到架构和参数形状匹配的蒸馏后检查点:
```bash
export Hy_Nomas_Model_Path="${Hy_Nomas_Model_Path:-/path/to/Hy-Nomas}"
python -m scripts.train.export_lora_checkpoint \
./outputs/segment_lora/checkpoints/global_step-2000 \
./outputs/segment_lora/adapter
python -m scripts.train.merge_lora \
--base "${Hy_Nomas_Model_Path}/DiT/distilled/diffusion_pytorch_model_ema_0_995.safetensors" \
--adapter ./outputs/segment_lora/adapter \
--output ./outputs/merged_model.safetensors
```
在[推理命令](#推理)中设置 `dit_weight=./outputs/merged_model.safetensors` 即可使用合并后的模型。
## 许可证
本项目采用 [Apache License 2.0](LICENSE) 许可证。
## 致谢
感谢 [Gemma 4](https://deepmind.google/models/gemma/gemma-4/)、[Qwen3.8](https://qwen.ai/blog?id=qwen3.8)、[Kimi-K3](https://github.com/MoonshotAI/Kimi-K3)、[DCAE-V](https://github.com/dc-ai-projects/DC-Gen) 和 [MagiAttention](https://github.com/SandAI-org/MagiAttention) 团队为社区作出的宝贵贡献,以及为本项目提供支持的模型、研究成果和工具。
## 联系我们
如有问题、非安全相关的缺陷报告或建议,请在本仓库提交 issue,或通过邮箱 [hy_nomas@tencent.com](mailto:hy_nomas@tencent.com) 联系我们。贡献指南见 [CONTRIBUTING.md](CONTRIBUTING.md);疑似安全漏洞请按照 [SECURITY.md](SECURITY.md) 私下报告。
---
Hy-Nomas · 自由形式交互式世界生成。


