ContextAtlas
为 AI Agent 提供稳定、可复用、可观测的代码上下文基础设施
Hybrid Retrieval · Project Memory · MCP Server · Retrieval Observability


English ·
文档 ·
首次使用 ·
部署手册 ·
CLI ·
MCP
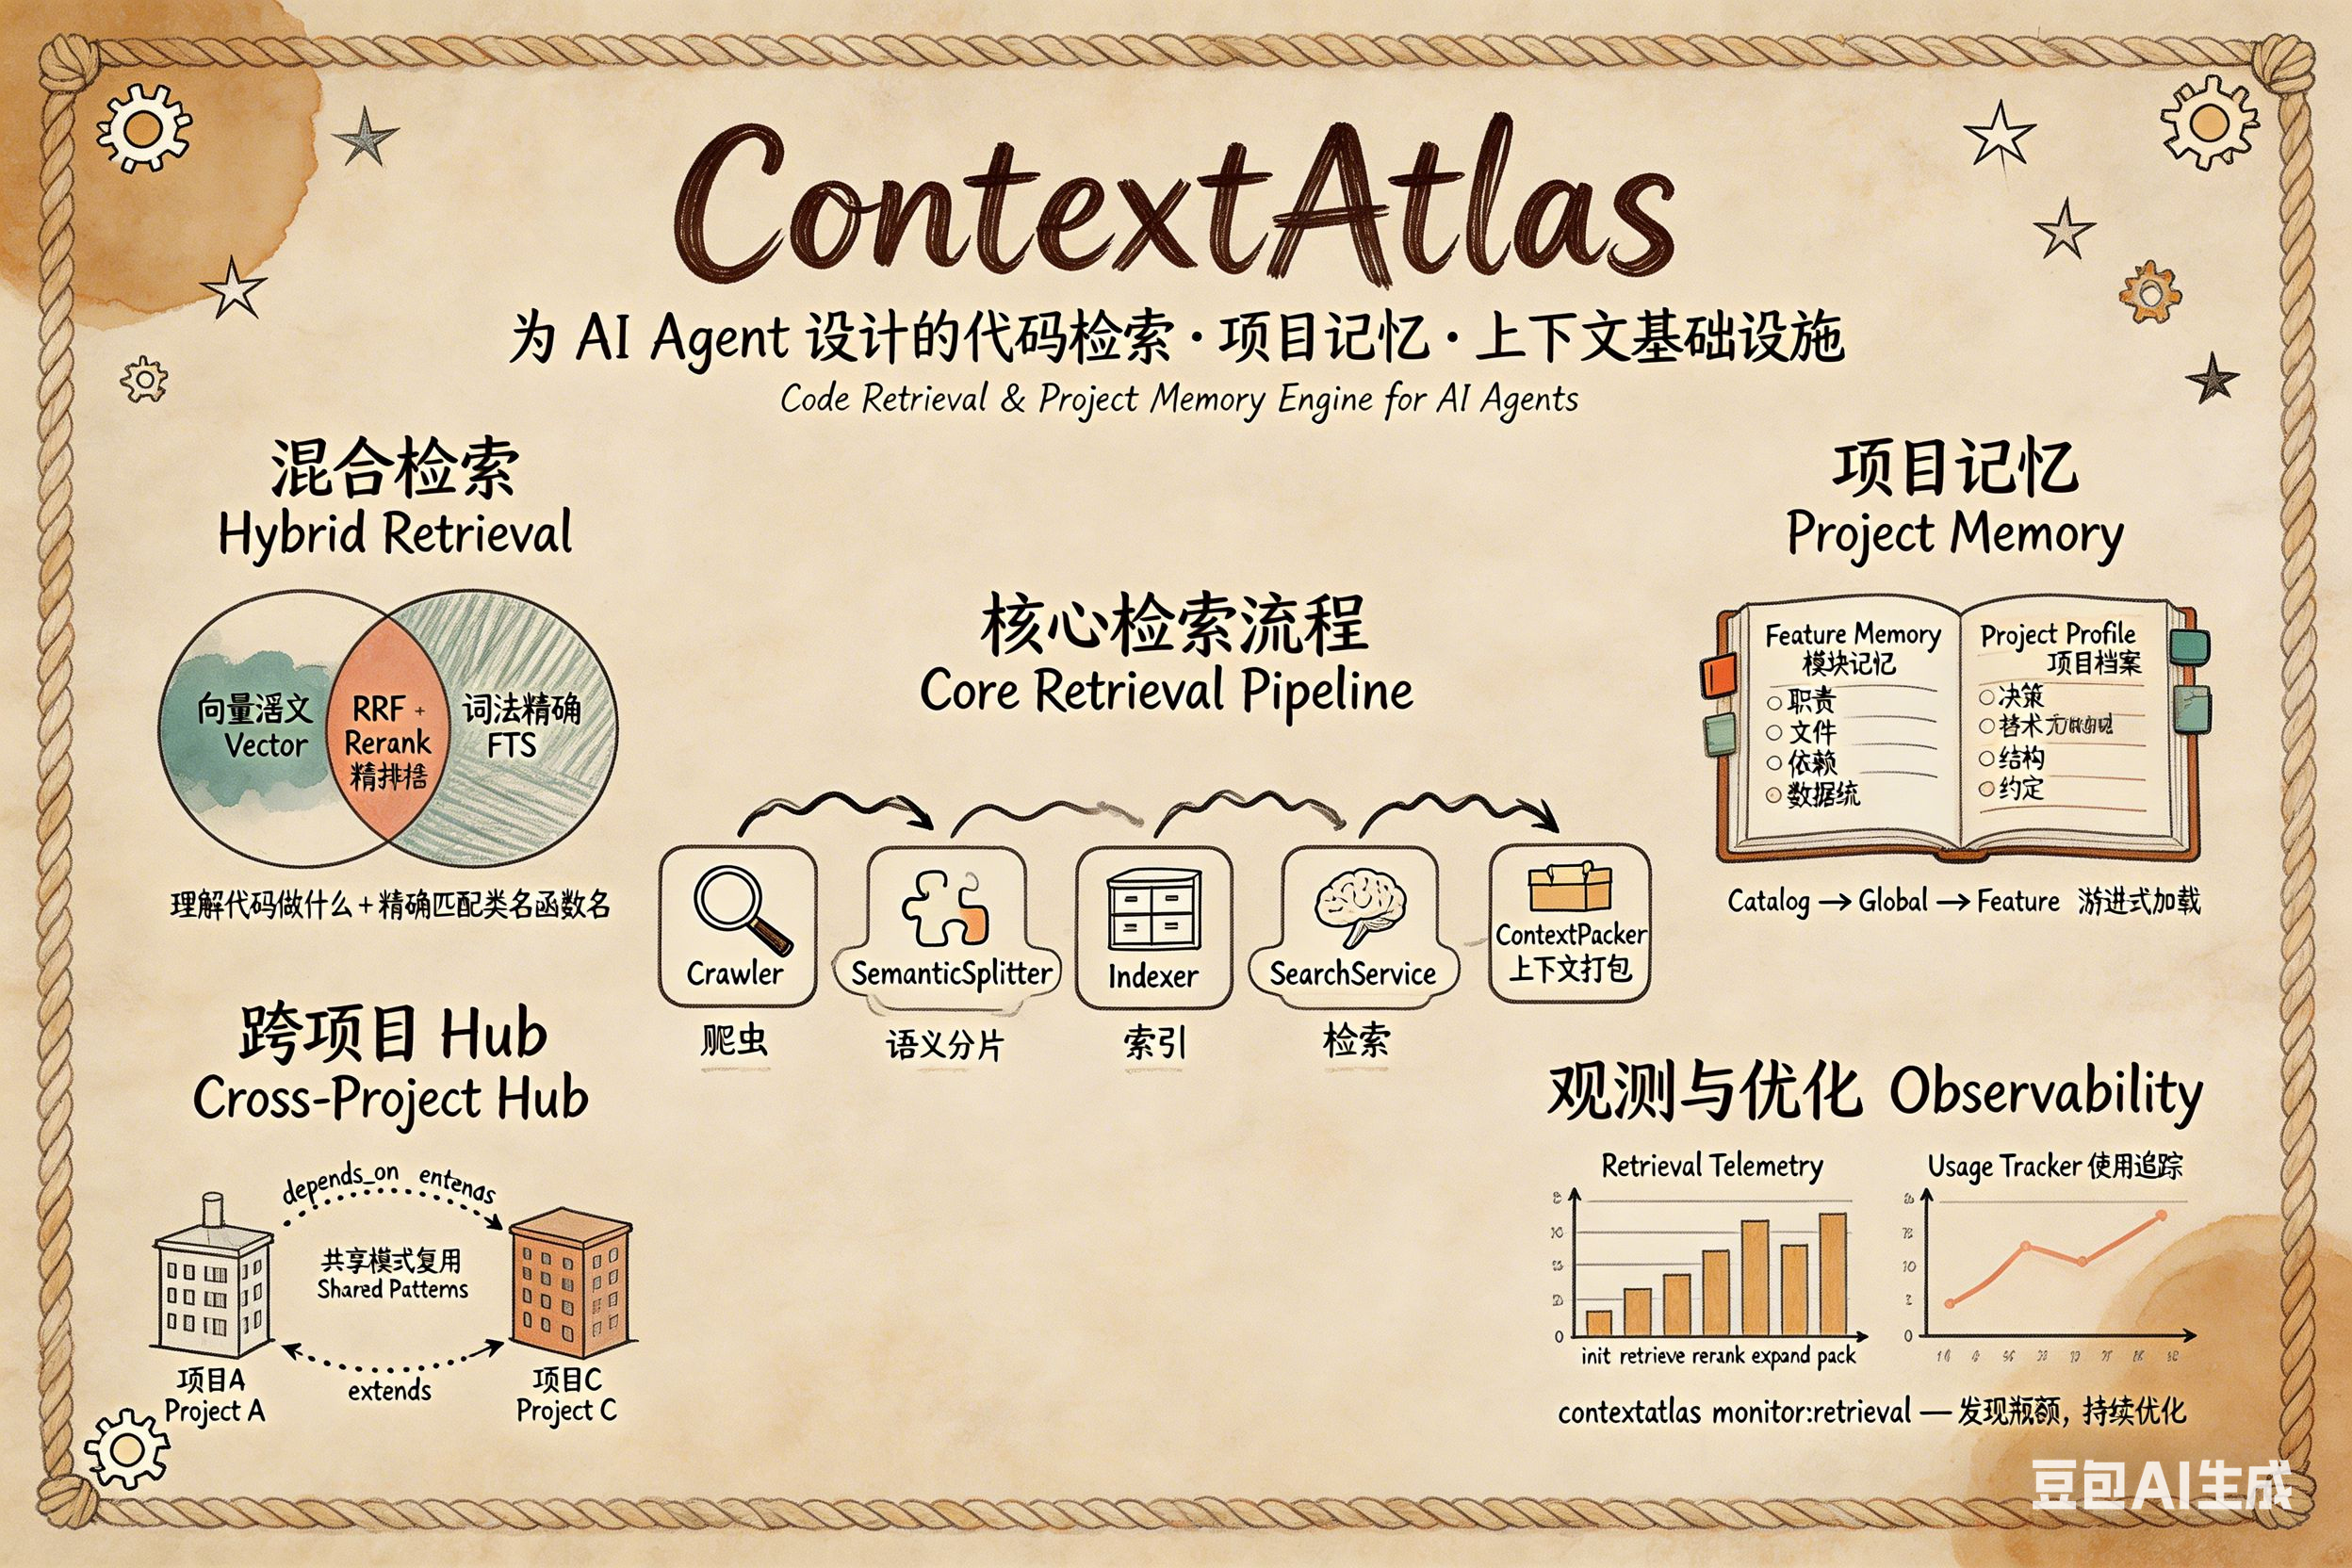
**ContextAtlas** 是一个面向 AI 编程 Agent 的开源上下文基础设施——提供混合代码检索、项目记忆和检索可观测能力,可通过 CLI、MCP 服务器或嵌入式库接入。它结合 Tree-sitter 语义分片、LanceDB 向量搜索、SQLite FTS5 全文检索和 Token 感知的上下文打包,为 Claude Code、Codex 和自定义 Agent 工作流提供高质量、结构化的代码上下文。
## 更新记录
- `2026-04-15`:新增 git hook 自动维护,`--quick` 健康检查(260x 提速)、幽灵索引目录清理和三层 hook 防护(防抖 + 快速模式 + 每日节流)。
- `2026-04-14`:将 11 个 Memory MCP 工具的业务逻辑下沉到 application 层,完成三层架构分离(CLI / MCP adapter → application → domain),并清零全量 TypeScript 编译错误。
- `2026-04-10`:`codebase-retrieval` 默认附带轻量直接图谱摘要,MCP 元数据、测试与更新日志同步到位。
- `2026-04-09`:为索引计划增加 churn / cost 策略、把长期记忆迁到独立表 + FTS5,并完成默认路径硬化、阈值配置化、运维告警口径对齐与文档同步。
- `2026-04-08`:新增 embedding gateway、本地缓存与多上游切换能力,并补齐 Hugging Face 接入与 MCP 上下文生命周期工具。
- `2026-04-07`:围绕索引链路完成轻量计划、快照复制优化、队列可观测、fallback 稳定性和性能基准建设。
- `2026-04-06`:收口默认主路径、记忆治理和运维可观测能力,让首次使用、反馈闭环和健康检查更清晰。
## 目录
- [为什么需要 ContextAtlas](#为什么需要-contextatlas)
- [适合什么场景](#适合什么场景)
- [核心能力](#核心能力)
- [技术栈](#技术栈)
- [安装](#安装)
- [配置](#配置)
- [快速开始](#快速开始)
- [接入方式](#接入方式)
- [架构概览](#架构概览)
- [文档导航](#文档导航)
- [友情链接](#友情链接)
- [License](#license)
ContextAtlas 不是单一的“代码搜索工具”。它解决的是更实际的工程问题:
- agent 能不能在大仓库里更快找到正确代码
- agent 能不能把项目理解沉淀下来,而不是每次重读整个仓库
- 检索、索引和记忆系统本身能不能被观测、优化和治理
如果你正在构建 Claude Code、MCP 客户端或自定义 agent workflow,ContextAtlas 提供的是一层 **context infrastructure**:检索、记忆、上下文打包和观测。
## 为什么需要 ContextAtlas
在真实项目里,AI agent 失败往往不是因为“模型不够聪明”,而是因为上下文系统不可靠:
- 找不到真正相关的代码
- 找到的是碎片,缺少依赖和上下文
- 同一个模块反复理解,无法沉淀稳定知识
- 索引过期、检索退化、预算耗尽却没有观测信号
ContextAtlas 把这些问题拆成一套可组合的基础能力:
- **找**:混合检索找到相关实现
- **补**:图扩展和 token packing 补足局部上下文
- **存**:项目记忆、长期记忆、跨项目 Hub 沉淀知识
- **看**:索引健康、检索 telemetry、usage 和 alert 让系统可观测
ContextAtlas 决定的是**提供什么上下文**,而不是**如何执行任务**。它不处理 Agent 推理、工作流编排或业务 API 操作。
## 适合什么场景
- 作为 coding agent 的仓库检索后端
- 作为 MCP server,为外部客户端提供代码检索和记忆工具
- 作为本地 CLI / skill backend,嵌入脚本、CI 或 agent workflow
- 作为跨项目知识中枢,复用模块职责、决策记录和协作经验
## 核心能力
| 能力 | 说明 |
|------|------|
| **Hybrid Retrieval** | 向量召回 + FTS 词法召回 + RRF 融合 + rerank |
| **Context Expansion** | 基于邻居、breadcrumb、import 的局部上下文扩展 |
| **Token-aware Packing** | 在有限 token 预算内优先保留高价值上下文 |
| **Project Memory** | Feature Memory、Decision Record、Project Profile |
| **Long-term Memory** | 保存无法从代码稳定推导的规则、偏好、外部参考 |
| **Cross-project Hub** | 跨仓库共享模块记忆、依赖链和关系图谱 |
| **Async Indexing** | SQLite 队列 + daemon 消费 + 快照原子切换 |
| **Observability** | retrieval monitor、usage report、index health、memory health、alert evaluation |
## 技术栈
- **TypeScript / Node.js 20+**
- **Tree-sitter**:语义分片
- **SQLite + FTS5**:元数据、检索、队列、memory hub
- **LanceDB**:向量存储
- **Model Context Protocol SDK**:MCP server
## 安装
```bash
npm install -g @codefromkarl/context-atlas
```
产品身份映射:
- 仓库名:`ContextAtlas`
- npm 包名:`@codefromkarl/context-atlas`
- CLI 命令:`contextatlas`
可执行命令:
- `contextatlas`
- `cw`(短别名)
文档默认统一使用 `contextatlas`,`cw` 保留为兼容短别名。
## 配置
先初始化配置目录和示例环境变量:
```bash
contextatlas init
# 选择接入模式:
contextatlas setup:local --mode cli-skill # 终端 + skill 集成
# 或
contextatlas setup:local --mode mcp # MCP 客户端集成
```
默认配置文件位置:
```bash
~/.contextatlas/.env
```
至少需要配置:
```bash
EMBEDDINGS_API_KEY=
EMBEDDINGS_BASE_URL=
EMBEDDINGS_MODEL=
RERANK_API_KEY=
RERANK_BASE_URL=
RERANK_MODEL=
```
索引更新策略还支持以下可选参数:
```bash
INDEX_UPDATE_CHURN_THRESHOLD=0.35
INDEX_UPDATE_COST_RATIO_THRESHOLD=0.65
INDEX_UPDATE_MIN_FILES=8
INDEX_UPDATE_MIN_CHANGED_FILES=5
```
- `INDEX_UPDATE_CHURN_THRESHOLD`:改动文件占比达到阈值时,`index:plan` / `index:update` 更倾向直接建议 `full`
- `INDEX_UPDATE_COST_RATIO_THRESHOLD`:估算增量处理成本接近全量时触发 `full`
- `INDEX_UPDATE_MIN_FILES` / `INDEX_UPDATE_MIN_CHANGED_FILES`:只有仓库规模和改动规模都达到门槛时,才启用上述升级策略
- `contextatlas index:diagnose`:直接回显当前阈值和升级判定配置,适合排查“为什么升级成 full / 为什么仍保持 incremental”
> `init` 会写入一份可直接编辑的示例 `.env`,包括默认的 SiliconFlow endpoint 和推荐模型配置。
> `setup:local --mode ` 仅写入所选模式的配置文件。模式选择指引见 [首次使用](./docs/guides/first-use.md)。
> setup 后建议运行 `contextatlas health:full`,一次性自检索引、记忆、图谱、契约和 MCP 进程状态。
更多配置与部署细节见 [部署手册](./docs/guides/deployment.md) 和 [CLI 文档](./docs/reference/cli.md)。
## 快速开始
如果你是第一次接入,先看 [首次使用](./docs/guides/first-use.md)。
### 1)确认主路径入口
```bash
contextatlas start /path/to/repo
```
### 2)初始化并填写 API 配置
```bash
contextatlas init
# 编辑 ~/.contextatlas/.env
```
### 3)索引仓库
```bash
contextatlas index /path/to/repo
```
### 4)本地检索
```bash
contextatlas search \
--repo-path /path/to/repo \
--information-request "用户认证流程是如何实现的?"
```
### 5)启动守护进程(推荐)
```bash
contextatlas daemon start
```
### 6)作为 MCP Server 暴露给客户端
```bash
contextatlas mcp
```
## 接入方式
ContextAtlas 支持两种互斥的接入模式,通过 `setup:local --mode ` 选择:
- **cli-skill**:终端 + skill 集成,所有操作通过 `contextatlas` CLI 命令完成,不暴露 MCP server
- **mcp**:MCP 客户端集成,通过 Claude Desktop、Cursor、Codex MCP 等标准工具协议调用
详见 [首次使用](./docs/guides/first-use.md) 中的模式选择指引。
### 1. 作为本地 CLI / Skill Backend(cli-skill 模式)
适合:
- 自定义 agent skills
- shell workflow / CI 脚本
- 本地调试与检索分析
示例:
```bash
# 检索
contextatlas search --repo-path /path/to/repo --information-request "支付重试策略在哪里实现?"
# 项目记忆
contextatlas memory:find "search"
contextatlas decision:list
# 健康检查
contextatlas health:full
```
### 2. 作为 MCP Server(mcp 模式)
适合:
- 支持 MCP 的桌面客户端
- 需要以标准 tool 调用 ContextAtlas 能力的 agent 系统
如果只希望 MCP 客户端看到只读检索、图谱、契约和记忆读取工具,可使用 `contextatlas setup:local --mode mcp --toolset retrieval-only`。
Claude Desktop 配置示例:
```json
{
"mcpServers": {
"contextatlas": {
"command": "contextatlas",
"args": ["mcp"],
"env": {
"CONTEXTATLAS_EXPOSURE_MODE": "mcp"
}
}
}
}
```
ContextAtlas 的 MCP 工具覆盖:
- 代码检索
- 项目记忆
- 长期记忆
- 跨项目 Hub
- 自动记录与建议写回
## 架构概览
```text
索引:Crawler / Scanner → Chunking → Indexing → Vector / SQLite Storage
检索:Vector + FTS Recall → RRF → Rerank → Graph Expansion → Context Packing
记忆:Project Memory / Long-term Memory / Hub → CLI / MCP Tools
```
ContextAtlas 更关注“给 agent 什么上下文”,而不是“替 agent 完成任务决策”。更完整的边界说明见 [仓库定位](./docs/architecture/repository-positioning.md) 和 [工程定位文档](./docs/architecture/harness-engineering.md)。
## 文档导航
| 文档 | 用途 |
|------|------|
| [文档总览](./docs/README.md) | 文档目录统一入口,区分稳定文档、计划、更新日志和归档材料 |
| [2026-04-15 更新总结](./docs/changelog/2026-04-15.md) | 快速健康检查、幽灵索引清理与 git hook 自动运维闭环 |
| [2026-04-10 更新总结](./docs/changelog/2026-04-10.md) | `codebase-retrieval` 默认附带图谱摘要,并同步 MCP 文档与测试口径 |
| [首次使用](./docs/guides/first-use.md) | 10 分钟跑通默认闭环,先理解包名、CLI 名和第一条查询 |
| [2026-04-07 更新总结](./docs/changelog/2026-04-07.md) | 索引 7 个阶段优化总结,覆盖轻量计划、快照复制、健康修复、队列可观测性、fallback、存储裁剪与 benchmark |
| [部署手册](./docs/guides/deployment.md) | 安装、部署场景、MCP 集成、运维建议 |
| [CLI 命令参考](./docs/reference/cli.md) | 所有 CLI 命令的分类说明和示例 |
| [MCP 工具参考](./docs/reference/mcp.md) | MCP 工具总览、参数和调用顺序 |
| [项目记忆详解](./docs/project/project-memory.md) | Feature Memory、Decision Record、Catalog 路由 |
| [仓库定位](./docs/architecture/repository-positioning.md) | 仓库角色、设计思路、系统边界 |
| [工程定位文档](./docs/architecture/harness-engineering.md) | ContextAtlas 在 harness engineering 中的定位 |
| [产品路线图](./docs/product/roadmap.md) | 后续版本规划和演进方向 |
| [后续任务执行清单](./docs/plans/next-tasks-execution-checklist.md) | 将当前未完全关闭的后续事项整理为可执行任务板 |
| [迭代执行计划(2026-04-08)](./docs/archive/iterations/2026-04-08/iteration-plan.md) | 按迭代批次拆分后续任务,便于直接排期执行 |
## 贡献
欢迎通过以下方式参与改进 ContextAtlas:
- 提交 issue 报告 bug 或文档问题
- 提交 PR 修复检索、记忆、监控或文档问题
- 补充真实使用场景、部署经验和 benchmark 数据
- 改进 README、CLI 文档和 MCP 工具示例
如果你准备提交代码,建议先:
1. 运行 `pnpm build` 确认可以构建
2. 确认命令示例、README 和文档与当前实现一致
3. 尽量把功能、文档和运维说明一起补齐
## 开发
```bash
pnpm build
pnpm build:release
pnpm dev
node dist/index.js
```
## 友情链接
https://linux.do/
## License
MIT