zero-to-sglang


📚 《从零手搓SGLang》
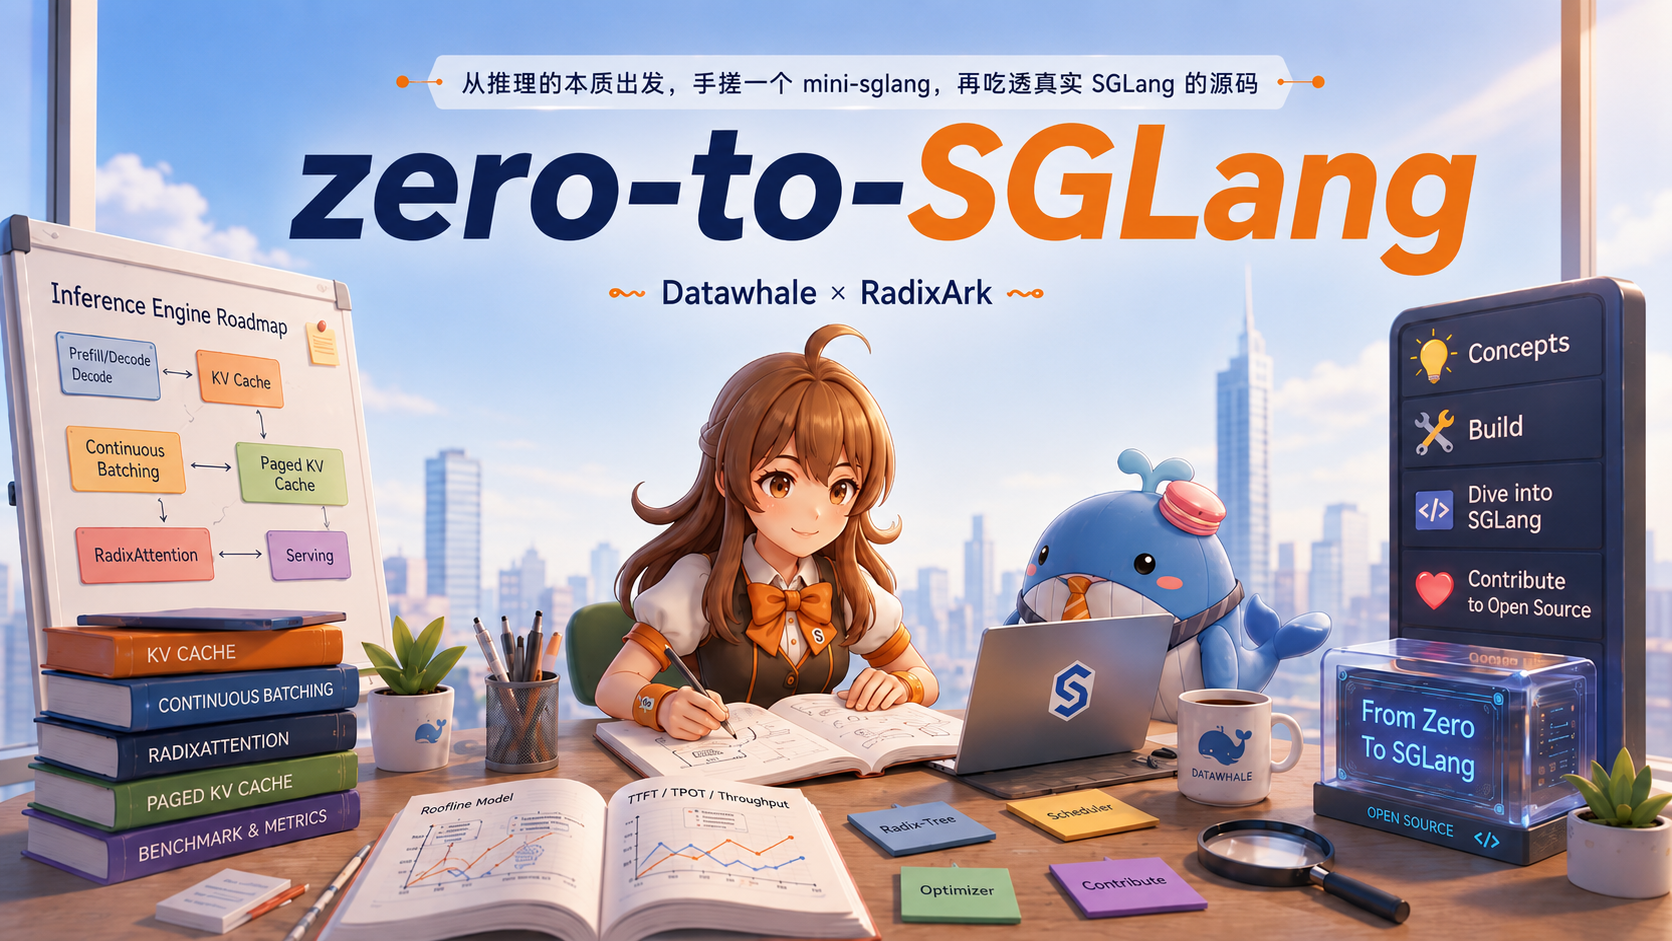
A hands-on tutorial on LLM inference: build a mini-sglang from scratch, then read the real SGLang source.
从推理的本质出发,手搓一个 mini-sglang,再吃透真实 SGLang 的源码
Datawhale × RadixArk
---
## 🎯 项目介绍
大模型已经从「训练」卷到「推理」了。应用爆发之后,推理成本和延迟成了真正的瓶颈:同样一块卡,好的推理引擎能多扛好几倍的请求。但市面上讲推理引擎的教程不多,要么只讲概念不动手,要么直接让你啃 SGLang 源码,从哪儿下手都不知道。
这门课想补上这个缺口。前半部分,我们从推理最核心的问题讲起:KV Cache 为什么要有、prefill 和 decode 差在哪、compute-bound 和 memory-bound 到底是什么意思。中间部分,带着你从零手搓一个 mini-sglang:前向、生成、KV Cache、HTTP 服务、Continuous Batching、Paged KV Cache、RadixAttention,一样一样加上去。后半部分,回到真实的 SGLang,讲清楚它那些前沿优化具体是怎么做的,最后教你怎么给 SGLang 提第一个像样的 PR。
本项目由 Datawhale 和 RadixArk(SGLang 团队创立的公司)共同发起,值得信赖!SGLang 在推理框架领域技术扎实、迭代活跃,认可这个项目的话,欢迎去 [sglang官方仓库](https://github.com/sgl-project/sglang) 点个 ⭐。
## ✨ 你能学到什么
- 📖 读懂推理:KV Cache、prefill/decode、compute-bound vs memory-bound,这些概念到底在说什么
- 🏗️ 手搓引擎:从 0 到 1 写出一个 mini-sglang,每一步都落在代码上
- 🛠️ 看懂真实引擎:RadixAttention、Paged KV Cache、Continuous Batching 这些 SGLang 核心是怎么实现的
- ⚙️ 摸到前沿:量化、分层缓存、DP Attention / EP / PP、Prefill-Decode 分离
- 🚀 参与开源:学会 profiling 和 trace 分析,走通 SGLang 的 PR 全流程
## 📋 前置要求
- **Python 编程**:熟练使用 Python,有基本的软件工程习惯
- **深度学习基础**:熟悉 PyTorch,了解神经网络的基本原理
- **数学基础**:线性代数、概率统计,知道矩阵运算和注意力机制的大致计算即可
- **GPU 编程(可选)**:了解 CUDA 基础概念会更好,不懂也没关系,Part I 会从零补齐
- **硬件(可选)**:Part I 不需要 GPU;Part II 大部分内容能在 CPU 上调试,完整的实现和性能测试建议用 GPU(云服务也行)
## 🔗 相关链接
- **仓库地址**:https://github.com/datawhalechina/zero-to-sglang
- **SGLang 官方**:https://github.com/sgl-project/sglang
- **mini-sglang 参考实现**:https://github.com/sgl-project/mini-sglang
## 📖 课程目录
> 状态图例:✅ 已完成 🔄 更新中 📝 待完善 🚧 筹备中 ⏸️ 暂缓
>
> 标注 **粗体** 的章节由 SGLang 官方成员编写。
| 章节 | 关键内容 | 状态 |
|------|----------|------|
| Part 0 — 开课之前 | | |
| [0.1 Coding Ethics and Open-Source Spirit(编码伦理与开源精神)](course-material/ch/part0/Part0-编码伦理与开源精神.md) | 对自己代码负责、沟通时说人话、Profile 永远是第一步、开源精神 | ✅ |
| [0.2 Deploy Your First SGLang Server(部署你的第一个 SGLang 服务)](course-material/ch/part0/Part0-部署你的第一个SGLang服务.md) | 环境设置,在你自己的 GPU 上用 SGLang 跑起 Qwen3-0.6B | ✅ |
| Part I — 基础概念(concepts only,无代码、无 GPU) | | |
| [1. Introduction to LLM](course-material/ch/part1/第1章_LLM入门.md) | LLM 的定义与发展脉络、Transformer 架构、自回归生成、关键基础概念 | ✅ |
| [2. Introduction to inference](course-material/ch/part1/第2章_推理入门.md) | 训练 vs 推理、prefill/decode、compute-bound vs memory-bound、Roofline model| ✅ |
| [3. Introduction to GPU](course-material/ch/part1/第3章_GPU入门.md) | GPU 架构基础、LLM 推理在 GPU 上的执行流程、从硬件理解推理瓶颈 | ✅ |
| [4. KV Cache: The Core Data Structure of Inference](course-material/ch/part1/第4章_推理的核心数据结构入门.md) | 从 Attention 推导 KV Cache、cache 生命周期、显存占用定量分析 | ✅ |
| [5. Introduction to Benchmark](course-material/ch/part1/第5章_Benchmark入门.md) | TTFT / TPOT / ITL / Goodput 等核心指标、百分位与尾延迟、怎么设计/跑/读 benchmark | ✅ |
| Part II — 从零手搓 Mini SGL | | |
| [1. mini-sglang:推理引擎长什么样](course-material/ch/part2/第1章_mini-sglang:推理引擎长什么样.md) | 推理引擎的总体架构、模块划分、本部分的 roadmap | ✅ |
| [2. **Inside SGLang: The Path of a Request**(概念)](course-material/ch/part2/第2章_一个请求的旅程.md) · [代码走读](course-material/ch/part2/第2章_一个请求的旅程_代码.md) | 一个请求从进入到返回的完整生命周期 | ✅ |
| [3. Your First 200 Lines: Forward Pass and Generation(概念)](course-material/ch/part2/第3章_前向与生成.md) · [代码走读](course-material/ch/part2/第3章_前向与生成_代码.md) | Embedding、Attention、LM Head 与生成循环的源码走读 | ✅ |
| [4. KV Cache: From O(n²) to O(n)(概念)](course-material/ch/part2/第4章_KVCache优化.md) · [代码走读](course-material/ch/part2/第4章_KVCache优化_代码.md) | 缓存实现与注意力计算优化 | ✅ |
| [5. HTTP 服务与并发(概念)](course-material/ch/part2/第5章_HTTP服务与并发.md) · [代码走读](course-material/ch/part2/第5章_HTTP服务与并发_代码.md) | HTTP 基础与请求流程、并发隔离、流式返回与取消的实现 | ✅ |
| [6. Continuous Batching and the Scheduler(概念)](course-material/ch/part2/第6章_ContinuousBatching与调度.md) · [代码走读](course-material/ch/part2/第6章_ContinuousBatching与调度_代码.md) | 连续批处理、调度器状态、资源限制与延迟和吞吐的取舍 | ✅ |
| [7. Paged KV Cache and Memory Management(概念)](course-material/ch/part2/第7章_PagedKVCache与显存管理.md) | 分页 KV Cache 与显存管理 | ✅ |
| [8. RadixAttention and Prefix Caching(概念)](course-material/ch/part2/第8章_RadixAttention与前缀缓存.md) · [代码走读](course-material/ch/part2/第8章_RadixAttention与前缀缓存_代码.md) | RadixAttention 与前缀缓存 | ✅ |
| [9. Multi-process & Tensor Parallelism(概念)](course-material/ch/part2/第9章_多进程与张量并行.md) · [代码走读](course-material/ch/part2/第9章_多进程与张量并行_代码.md) | 多进程与张量并行 | ✅ |
| [10. Speculative Decoding(概念)](course-material/ch/part2/第10章_投机解码.md) · [代码走读](course-material/ch/part2/第10章_投机解码_代码.md) | 起草与验证、贪心和随机采样的接受规则、拒绝校正与性能取舍 | ✅ |
| Part III — 高级推理技术(深入真实 SGLang) | | |
| [1. **Attention Backends(FlashInfer / Triton / FA3 / FlashMLA)**](course-material/ch/part3/第1章_注意力后端.md) | Attention 后端职责、分块计算、实现取舍与选择 | ✅ |
| 2. **Quantization and Low-Precision Inference** | 量化与低精度推理 | 🚧 |
| [3. **Hierarchical Caching**](course-material/ch/part3/第3章_分层缓存.md) | L1/L2/L3 缓存层级、前缀匹配、备份恢复、预取与性能取舍 | ✅ |
| 4. **Scaling Out: DP Attention, EP, PP** | 横向扩展:DP Attention / EP / PP | 🚧 |
| 5. **Prefill-Decode Disaggregation** | Prefill-Decode 分离 | 🚧 |
| Part IV — 如何为 SGLang 做贡献(可选) | | |
| 1. **Deploying SGLang with the Cookbook** | 使用 Cookbook 部署 SGLang | 🚧 |
| 2. **Measuring It All: Profiling and Trace Analysis** | Profiling 与 Trace 分析 | 🚧 |
| 3. **SGLang PR Workflow** | SGLang PR 全流程 | 🚧 |
## 🗓️ 编写进度
起始日期:2026 年 8 月 24 日(周一)。每章约一周,加粗章节由 SGLang 官方成员编写。
| 部分 | 时间安排 | 状态 |
|------|----------|------|
| Part 0 — 开课之前 | 已完成 | ✅ |
| Part I — 基础概念 | 8.24 ~ 9.06 编写,9.07 ~ 9.13 review | ✅ |
| Part II — 从零手搓 Mini SGL | 9.14 ~ 10.04 编写,10.05 ~ 10.10 review | 🔄 |
| Part III — 高级推理技术 | 10.10 ~ 11.15 | 🔄 |
| Part IV — 如何为 SGLang 做贡献 | 11.16 ~ 12.6 | 🚧 |
## 🚀 快速开始
```bash
# 克隆仓库
git clone https://github.com/datawhalechina/zero-to-sglang.git
cd zero-to-sglang
# 安装基础依赖(根据具体章节需求安装)
```
### 学习路径
1️⃣ 读 Part I,先把推理的整体认知建立起来(不需要 GPU)\
2️⃣ 跟着 Part II,从 0 到 1 手搓一个 mini-sglang\
3️⃣ 进 Part III,对照真实 SGLang 源码理解前沿优化\
4️⃣ 完成 Part IV,走通 profiling、trace 分析和 PR 全流程
### 项目结构
```
zero-to-sglang/
├── course-material/ # 课程正文
│ ├── ch/ # 中文(在线阅读 /ch/)
│ │ ├── part0/ # Part 0:开课之前
│ │ ├── part1/ # Part I:基础概念(已完成)
│ │ ├── part2/ # Part II:从零手搓 Mini SGL(更新中)
│ │ ├── part3/ # Part III:高级推理技术(规划中)
│ │ ├── part4/ # Part IV:如何为 SGLang 做贡献(规划中)
│ │ └── WRITING_TEMPLATE.md
│ └── eng/ # English(在线阅读 /eng/,翻译中)
│ ├── part0/
│ └── WRITING_TEMPLATE.md
├── community/ # 社区贡献专区:手搓记录、踩坑、学习笔记
│ ├── ch/
│ └── eng/
├── docs/.vitepress/ # VitePress 站点配置
├── README.md # 项目说明(English,默认入口)
├── README_zh.md # 项目说明(中文)
├── README_en.md # 旧英文入口(指向 README.md)
└── .gitignore # Git 忽略配置
```
## 🤝 如何贡献
我们是一个开放的开源社区,欢迎任何形式的贡献。动手之前,请先读一遍 [Part 0](course-material/ch/part0/Part0-编码伦理与开源精神.md),了解我们期望的编码伦理与开源精神。
1. 改进课程正文
- 🐛 发现内容、公式、代码有错:提 Issue,或者直接改了提 PR
- 📝 补充章节内容、优化表述:提 PR。章节划分和编号按[写作模板](course-material/ch/WRITING_TEMPLATE.md)里的大纲来,不要自行增删、合并章节
- 🌐 参与翻译:按[英文写作模板](course-material/eng/WRITING_TEMPLATE.md)把章节翻译成英文,放在 `course-material/eng/` 下
- 💡 对课程有想法:开 Issue 讨论
2. 分享你的实践
- 🔧 跟着 Part II 自己手搓了一遍 mini-sglang,把过程中遇到的 bug 和解法记下来
- ⚠️ 部署 SGLang、配环境时踩过的坑,或者你觉得文档没写清楚、值得提醒别人的地方
- 📒 读完某一章后按自己理解整理的学习笔记,或者补充的推导、实验等等
内容放在 `community/ch/`(英文放 `community/eng/`)对应的目录下。
提 PR 的流程
1. Fork 本仓库,从 `main` 切一个分支
2. PR 具体要求见 [community/ch/PR_requirement.md](community/ch/PR_requirement.md),提交之前请逐条核实
## ❓ 常见问题
Q: 没有 GPU 可以学吗?
可以。Part I 完全不涉及 GPU;Part II 的大部分代码能在 CPU 上调试,但完整的性能验证和 Part III 的深入内容建议用 GPU(云服务也行)。
Q: 需要先精通 CUDA 吗?
不需要。这门课从推理的概念出发,Part III 才会深入 Attention Backends 等底层内容,到时候再按需补就行。
## 💬 读者交流群
欢迎加入 zero-to-sglang 读者交流群,与大家一起交流学习、答疑解惑:
读者交流群 |
群已满,可加微信 `xuhu96736` 拉你进群
## 👥 贡献者
*注:我们感谢每一位为项目做出贡献的开发者!*
### 特别感谢
- 感谢 Datawhale 和 SGLang 团队对项目的支持
- Datawhale:[@1iyouzhen](https://github.com/1iyouzhen)、[@xuhu0115](https://github.com/xuhu0115)、[@kangkang-Adam](https://github.com/kangkang-Adam)
- SGLang:[@Ccyest](https://github.com/Ccyest)、[@fcranzhou](https://github.com/fcranzhou)
- 感谢 [@Sm1les](https://github.com/Sm1les) 对本项目的帮助与支持
- 感谢所有为本项目做出贡献的开发者们 ❤️
## 🎓 引用
如果 zero-to-sglang 对您的研究或工作有所帮助,欢迎引用:
```bibtex
@misc{zero_to_sglang2026,
title = {zero-to-sglang: Building an LLM Inference Engine from Scratch},
author = {TODO},
year = {2026},
url = {https://github.com/datawhalechina/zero-to-sglang},
note = {GitHub repository}
}
```
## ⭐ Star History
如果这个项目对你有帮助,欢迎给个 Star ⭐️!
## 📄 许可证
 本作品采用 [知识共享署名-非商业性使用-相同方式共享 4.0 国际许可协议](http://creativecommons.org/licenses/by-nc-sa/4.0/) 进行许可。
---
让更多人能系统性地学会 LLM 推理引擎的构建
Made with ❤️ by Datawhale & RadixArk