####
####
Comfyui_llm_party tem como objetivo, com base na [comfyui](https://github.com/comfyanonymous/ComfyUI), uma interface de usuário extremamente minimalista, desenvolver um conjunto completo de biblioteca de nós para a construção de fluxos de trabalho de LLM. Isso permitirá que os usuários construam seus próprios fluxos de trabalho de LLM de forma mais rápida e conveniente, além de integrar facilmente em seus próprios fluxos de trabalho de imagem.
## Demonstração de resultados
https://github.com/user-attachments/assets/945493c0-92b3-4244-ba8f-0c4b2ad4eba6
## Visão Geral do Projeto
ComfyUI LLM Party permite desde a chamada de múltiplas ferramentas LLM, configuração rápida de personagens para construir seu assistente de IA personalizado, até a aplicação de Word Vector RAG e GraphRAG para gerenciamento local de bancos de dados de conhecimento da indústria; desde um pipeline de agentes inteligentes simples, até a construção de modos de interação complexos entre agentes inteligentes em padrão radial e circular; desde a necessidade de usuários individuais de integrar seus aplicativos sociais (QQ, Feishu, Discord), até o fluxo de trabalho tudo-em-um LLM+TTS+ComfyUI que os trabalhadores de streaming precisam; desde o primeiro aplicativo LLM que alunos comuns precisam para um fácil início, até as diversas interfaces de ajuste de parâmetros frequentemente utilizadas por pesquisadores e a adaptação de modelos. Tudo isso, você pode encontrar respostas no ComfyUI LLM Party.
## Início Rápido
0. Se você nunca usou o ComfyUI e encontrou alguns problemas de dependência ao instalar o LLM party no ComfyUI, clique [aqui](https://drive.google.com/file/d/1T9C7gEbd-w_zf9GqZO1VeI3z8ek8clpX/view?usp=sharing) para baixar o pacote portátil do ComfyUI **windows** que inclui o LLM party. Atenção! Este pacote portátil contém apenas os dois plugins: party e manager, e é exclusivo para sistemas Windows.(Se você precisar instalar o LLM party em um comfyui existente, esta etapa pode ser pulada.)
1. Arraste os seguintes fluxos de trabalho para o seu comfyui e use [comfyui-Manager](https://github.com/ltdrdata/ComfyUI-Manager) para instalar os nós ausentes.
- Use a API para chamar LLM: [start_with_LLM_api](workflow/start_with_LLM_api.json)
- Chamando o LLM com aisuite: [iniciar_com_aisuite](workflow/start_with_aisuite.json)
- Gerencie LLM local com ollama: [start_with_Ollama](workflow/ollama.json)
- Use LLM local em formato distribuído: [start_with_LLM_local](workflow/start_with_LLM_local.json)
- Use LLM local em formato GGUF: [start_with_LLM_GGUF](workflow/start_with_GGUF.json)
- Use VLM local em formato distribuído: [start_with_VLM_local](workflow/start_with_VLM_local.json) Atualmente, já é suportado [Llama-3.2-Vision](https://huggingface.co/meta-llama/Llama-3.2-11B-Vision-Instruct)/[Qwen/Qwen2.5-VL](https://huggingface.co/Qwen/Qwen2.5-VL-3B-Instruct)/[deepseek-ai/Janus-Pro](https://huggingface.co/deepseek-ai/Janus-Pro-1B)
- Use VLM local em formato GGUF: [start_with_VLM_GGUF](workflow/start_with_llava.json)
- Utilizar a API para invocar LLM e gerar palavras-chave para SD, bem como criar imagens: [start_with_VLM_API_for_SD](workflow/start_with_VLM_API_for_SD.json)
- Utilizar ollama para invocar minicpm e gerar palavras-chave para SD, bem como criar imagens: [start_with_ollama_minicpm_for_SD](workflow/start_with_ollama_minicpm_for_SD.json)
- Utilizar o qwen-vl local para gerar palavras-chave para SD e criar imagens: [start_with_qwen_vl_local_for_SD](workflow/start_with_qwen_vl_local_for_SD.json)
2. Se você estiver usando a API, preencha seu `base_url` (pode ser uma API de retransmissão, certifique-se de que termine com `/v1/`) e `api_key` no nó de carregamento da API LLM. Exemplo: `https://api.openai.com/v1/`
3. Se você estiver usando ollama, ative a opção `is_ollama` no nó de carregamento da API LLM, não é necessário preencher `base_url` e `api_key`.
4. Se você estiver usando um modelo local, preencha o caminho do seu modelo no nó de carregamento do modelo local, por exemplo: `E:\model\Llama-3.2-1B-Instruct`. Você também pode preencher o ID do repositório do modelo no Huggingface no nó de carregamento do modelo local, por exemplo: `lllyasviel/omost-llama-3-8b-4bits`.
5. Devido ao alto limiar de uso deste projeto, mesmo que você escolha o início rápido, espero que possa ler pacientemente a página inicial do projeto.
## Atualizações Recentes
1. O nódo LLM API agora suporta o modo de saída em streaming, que exibirá na consola o texto retornado pela API em tempo real, permitindo que você veja a saída da API sem precisar esperar que toda a solicitação seja concluída.
2. Foi adicionada a saída reasoning_content ao nódo LLM API, que permite separar automaticamente o raciocínio e a resposta do modelo R1.
3. Uma nova ramificação do repositório chamada only_api foi criada, a qual contém apenas a parte da chamada à API. Isso facilita para os usuários que precisam apenas fazer chamadas à API, basta usar o comando `git clone -b only_api https://github.com/heshengtao/comfyui_LLM_party.git` na pasta `custom node` do `comfyui`, e em seguida seguir o plano de implementação do ambiente na página principal deste projeto para que possam utilizar essa ramificação. Atenção! Se precisar garantir que não haja outra pasta chamada `comfyui_LLM_party` na pasta `custom node`.
1. O nó de carregador local do VLM já suporta [deepseek-ai/Janus-Pro](https://huggingface.co/deepseek-ai/Janus-Pro-1B), fluxo de trabalho de exemplo: [Janus-Pro](workflow/deepseek-janus-pro.json)
1. O nó de carregador local VLM já é compatível com [Qwen/Qwen2.5-VL-3B-Instruct](https://huggingface.co/Qwen/Qwen2.5-VL-3B-Instruct), mas você precisa atualizar o transformer para a versão mais recente (```pip install -U transformers```), fluxo de trabalho de exemplo: [qwen-vl](workflow/qwen-vl.json)
1. Foi adicionado um novo nó de hospedagem de imagens, que atualmente suporta a hospedagem de imagens de https://sm.ms (o domínio na região da China é https://smms.app) e https://imgbb.com. No futuro, mais serviços de hospedagem de imagens serão suportados. Exemplo de fluxo de trabalho: [Hospedagem de Imagens](workflow/图床.json)
1. ~~O serviço de hospedagem de imagens imgbb, que é compatível por padrão com party, foi atualizado para o domínio [imgbb](https://imgbb.io). O serviço anterior não era amigável para usuários da China continental, por isso foi alterado.~~ Sinto muito informar que o serviço API de hospedagem de imagens em https://imgbb.io parece ter sido descontinuado, portanto, o código voltou para o original https://imgbb.com. Agradeço a compreensão de todos. No futuro, atualizarei um nó que suporte mais serviços de hospedagem de imagens.
1. A ferramenta [MCP](https://modelcontextprotocol.io/introduction) foi atualizada, você pode modificar a configuração no arquivo '[mcp_config.json](mcp_config.json)' na pasta do projeto party para ajustar o servidor MCP ao qual deseja se conectar. Você pode encontrar aqui vários parâmetros de configuração dos servidores MCP que deseja adicionar: [modelcontextprotocol/servers](https://github.com/modelcontextprotocol/servers). A configuração padrão deste projeto é o servidor Everything, um servidor utilizado para testar se o servidor MCP opera corretamente. Fluxo de trabalho de referência: [start_with_MCP](workflow/start_with_MCP.json). Nota para desenvolvedores: o nó da ferramenta MCP pode se conectar ao servidor MCP configurado e, em seguida, converter as ferramentas do servidor em ferramentas que o LLM pode usar diretamente. Ao configurar diferentes servidores locais ou em nuvem, você pode experimentar todas as ferramentas LLM disponíveis no mundo.
## Instruções de Uso
1. Para instruções sobre o uso dos nós, consulte: [怎么使用节点](https://github.com/heshengtao/Let-LLM-party)
2. Se houver problemas com o plugin ou se você tiver outras dúvidas, sinta-se à vontade para entrar no grupo QQ: [931057213](img/Q群.jpg) |discord:[discord](https://discord.gg/f2dsAKKr2V).
4. Para mais fluxos de trabalho, você pode consultar a pasta [workflow](workflow).
## Tutoriais em vídeo

 ## Suporte ao Modelo
1. Suporte a todas as chamadas de API no formato openai (combinado com [oneapi](https://github.com/songquanpeng/one-api), é possível chamar quase todas as APIs LLM, além de suportar todas as APIs de encaminhamento), a escolha do base_url deve seguir o exemplo em [config.ini.example](config.ini.example), atualmente testados incluem:
* [openai](https://platform.openai.com/docs/api-reference/chat/create) (Perfeitamente compatível com todos os modelos OpenAI, incluindo as séries 4o e o1!)
* [ollama](https://github.com/ollama/ollama) (Recomendado! Se você estiver chamando localmente, é altamente recomendável usar o método ollama para hospedar seu modelo local!)
* [Azure OpenAI](https://azure.microsoft.com/zh-cn/products/ai-services/openai-service/)
* [llama.cpp](https://github.com/ggerganov/llama.cpp?tab=readme-ov-file#web-server) (Recomendado! Se você quiser usar o modelo no formato gguf local, pode usar a API do projeto llama.cpp para acessar este projeto!)
* [Grok](https://x.ai/api)
* [通义千问/qwen](https://help.aliyun.com/zh/dashscope/developer-reference/compatibility-of-openai-with-dashscope/?spm=a2c4g.11186623.0.0.7b576019xkArPq)
* [智谱清言/glm](https://open.bigmodel.cn/dev/api#http_auth)
* [deepseek](https://platform.deepseek.com/api-docs/zh-cn/)
* [kimi/moonshot](https://platform.moonshot.cn/docs/api/chat#%E5%9F%BA%E6%9C%AC%E4%BF%A1%E6%81%AF)
* [doubao](https://www.volcengine.com/docs/82379/1263482)
* [讯飞星火/spark](https://xinghuo.xfyun.cn/sparkapi?scr=price)
* [Gêmeos](https://developers.googleblog.com/zh-hans/gemini-is-now-accessible-from-the-openai-library/)(O antigo nó do carregador de API do Gêmeos foi descontinuado na nova versão, por favor utilize o nó do carregador de API LLM, selecionando o base_url: https://generativelanguage.googleapis.com/v1beta/openai/)
2. Suporte a todas as chamadas de API compatíveis com [aisuite](https://github.com/andrewyng/aisuite):
* [anthropic/claude](https://www.anthropic.com/)
* [aws](https://docs.aws.amazon.com/solutions/latest/generative-ai-application-builder-on-aws/api-reference.html)
* [vértice](https://cloud.google.com/vertex-ai/docs/reference/rest)
* [huggingface](https://huggingface.co/)
3. Compatível com a maioria dos modelos locais na biblioteca transformer (o tipo de modelo no nó da cadeia de modelos LLM local foi alterado para LLM, VLM-GGUF e LLM-GGUF, correspondendo ao carregamento direto de modelos LLM, carregamento de modelos VLM e carregamento de modelos LLM no formato GGUF). Se o seu modelo LLM no formato VLM ou GGUF relatar um erro, faça o download da versão mais recente do llama-cpp-python em [llama-cpp-python](https://github.com/abetlen/llama-cpp-python/releases). Os modelos atualmente testados incluem:
* [ClosedCharacter/Peach-9B-8k-Roleplay](https://huggingface.co/ClosedCharacter/Peach-9B-8k-Roleplay) (recomendado! modelo de interpretação de papéis)
* [lllyasviel/omost-llama-3-8b-4bits](https://huggingface.co/lllyasviel/omost-llama-3-8b-4bits) (recomendado! modelo de sugestões ricas)
* [meta-llama/Llama-2-7b-chat-hf](https://huggingface.co/meta-llama/Llama-2-7b-chat-hf)
* [Qwen/Qwen2-7B-Instruct](https://huggingface.co/Qwen/Qwen2-7B-Instruct)
* [openbmb/MiniCPM-V-2_6-gguf](https://huggingface.co/openbmb/MiniCPM-V-2_6-gguf/tree/main)
* [lmstudio-community/Meta-Llama-3.1-8B-Instruct-GGUF](https://huggingface.co/lmstudio-community/Meta-Llama-3.1-8B-Instruct-GGUF/tree/main)
* [meta-llama/Llama-3.2-11B-Vision-Instruct](https://huggingface.co/meta-llama/Llama-3.2-11B-Vision-Instruct)
* [Qwen/Qwen2.5-VL-3B-Instruct](https://huggingface.co/Qwen/Qwen2.5-VL-3B-Instruct)
* [deepseek-ai/Janus-Pro](https://huggingface.co/deepseek-ai/Janus-Pro-1B)
4. Download do modelo:
* [Endereço da nuvem Quark](https://pan.quark.cn/s/190b41f3bbdb)
* [Link do Baidu Cloud](https://pan.baidu.com/share/init?surl=T4aEB4HumdJ7iVbvsv1vzA&pwd=qyhu), código de extração: qyhu
## Download
Utilize um dos métodos abaixo para instalar
### Método 1:
1. No [gerenciador comfyui](https://github.com/ltdrdata/ComfyUI-Manager), pesquise por `comfyui_LLM_party` e instale com um clique
2. Reinicie o comfyui
### Método Dois:
1. Navegue até a pasta raiz do ComfyUI e acesse a subpasta `custom_nodes`.
2. Clone este repositório: `git clone https://github.com/heshengtao/comfyui_LLM_party.git`
### Método Três:
1. Clique em `CODE` no canto superior direito.
2. Clique em `download zip`.
3. Extraia o arquivo compactado baixado na subpasta `custom_nodes` da pasta raiz do ComfyUI.
## Implantação do Ambiente
1. Navegue até a pasta do projeto `comfyui_LLM_party`.
2. No terminal, digite `pip install -r requirements.txt` para implantar as bibliotecas de terceiros necessárias para este projeto no ambiente do ComfyUI. Verifique se você está instalando no ambiente do ComfyUI e fique atento a erros do `pip` no terminal.
3. Se você estiver usando o lançador do ComfyUI, você precisará digitar no terminal `caminho na configuração do lançador\python_embeded\python.exe -m pip install -r requirements.txt` para realizar a instalação. A pasta `python_embeded` geralmente está no mesmo nível da sua pasta `ComfyUI`.
4. Se você encontrar problemas de configuração do ambiente, pode tentar usar as dependências do `requirements_fixed.txt`.
## Configuração
* É possível configurar o idioma no `config.ini`, atualmente existem apenas duas opções: chinês (zh_CN) e inglês (en_US), sendo o idioma padrão o do seu sistema.
* É possível configurar no `config.ini` se deseja uma instalação rápida; `fast_installed` está configurado por padrão como `False`. Se você não precisa utilizar o modelo GGUF, pode defini-lo como `True`.
* Você pode configurar o APIKEY utilizando um dos métodos a seguir:
### Método Um:
1. Abra o arquivo `config.ini` na pasta do projeto `comfyui_LLM_party`.
2. Insira seu `openai_api_key` e `base_url` no `config.ini`.
3. Se você estiver utilizando o modelo ollama, insira `http://127.0.0.1:11434/v1/` em `base_url`, coloque `ollama` em `openai_api_key` e insira o nome do seu modelo em `model_name`, por exemplo: llama3.
4. Se você deseja utilizar ferramentas de busca do Google ou Bing, insira seu `google_api_key`, `cse_id` ou `bing_api_key` no `config.ini`.
5. Se você pretende usar entrada de imagem para LLM, recomenda-se o uso do serviço de hospedagem de imagens imgbb, insira seu `imgbb_api` no `config.ini`.
6. Cada modelo pode ser configurado separadamente no arquivo `config.ini`, utilizando como referência o arquivo `config.ini.example`. Após a configuração, basta inserir `model_name` no nó.
### Método Dois:
1. Abra a interface do comfyui.
2. Crie um nó de modelo de linguagem grande (LLM) e insira diretamente seu `openai_api_key` e `base_url` no nó.
3. Se você estiver utilizando o modelo ollama, utilize o nó LLM_api, insira `http://127.0.0.1:11434/v1/` em `base_url`, coloque `ollama` em `api_key` e insira o nome do seu modelo em `model_name`, por exemplo: llama3.
4. Se você deseja usar entrada de imagem para LLM, recomenda-se o uso do serviço de hospedagem de imagens imgbb, insira seu `imgbb_api_key` no nó.
## Registro de Atualizações
**[Click here](change_log.md)**
## Próximos passos:
1. Mais adaptações de modelos;
2. Mais formas de construir agentes;
3. Mais recursos de automação;
4. Mais recursos de gestão de base de conhecimento;
5. Mais ferramentas, mais personas.
## Outro projeto de código aberto útil meu:
[super-agent-party](https://github.com/heshengtao/super-agent-party) é um aplicativo de companheiro de desktop 3D em IA com possibilidades infinitas! Já suporta RAG, busca na web, memória de longo prazo, interpretador de código, MCP, A2A, Comfyui, robô QQ e muito mais!

## Isenção de responsabilidade:
Este projeto de código aberto e seu conteúdo (doravante denominado "projeto") são fornecidos apenas para fins de referência e não implicam em qualquer garantia expressa ou implícita. Os contribuintes do projeto não assumem qualquer responsabilidade pela integridade, precisão, confiabilidade ou adequação do projeto. Qualquer ação que dependa do conteúdo do projeto deve ser realizada por sua própria conta e risco. Em nenhuma circunstância os contribuintes do projeto serão responsáveis por quaisquer perdas ou danos indiretos, especiais ou consequenciais decorrentes do uso do conteúdo do projeto.
## Agradecimentos Especiais


 ## Agradecimentos
Alguns nós deste projeto foram inspirados pelos seguintes projetos, agradecemos suas contribuições à comunidade de código aberto!
1. [pythongosssss/ComfyUI-Custom-Scripts](https://github.com/pythongosssss/ComfyUI-Custom-Scripts)
2. [lllyasviel/Omost](https://github.com/lllyasviel/Omost)
## Suporte:
### Siga-nos
1. Se desejar acompanhar as últimas funcionalidades deste projeto, fique à vontade para seguir nossa conta no Bilibili: [派酱](https://space.bilibili.com/26978344)
2. [youtube@LLM-party](https://www.youtube.com/@LLM-party)
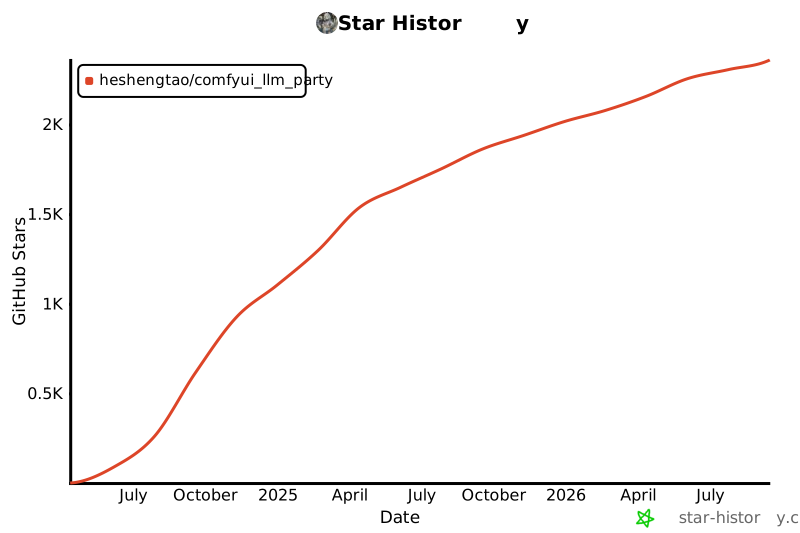
## Histórico de Estrelas
[](https://star-history.com/#heshengtao/comfyui_LLM_party&Date)


